

Mise à jour du 28 octobre 2026 : Ollama se hisse à la troisième place grâce à des résultats de test précis (145.48 et 92.87 jetons par seconde sur le benchmark Ada de la RTX 5000, soit le meilleur des trois à ce jour). La FAQ pour débutants reflète désormais cet écart de vitesse, et la colonne « Guide » propose un lien vers une prise en main d’Ollama. Le 19 octobre, Open WebUI occupait la deuxième place, avec 115.32 et 75.06 jetons par seconde, contre 123 et 82 pour Jan. Article initialement publié le 19 août 2026.
Il existe quatre raisons d'exécuter un modèle de langage sur son propre matériel, et une seule est d'ordre idéologique. Confidentialité : un document transmis à un modèle local ne quitte jamais la machine, ce qui inclut l'intégralité des échanges concernant le code client, les contrats, les données patient et les produits non commercialisés.
Structure des coûts : l’IA dans le cloud est facturée à l’usage, et les charges de travail automatisées augmentent suffisamment vite le nombre de jetons pour qu’un poste de travail performant soit rentable ; votre matériel est facturé au prix de l’électricité. Disponibilité : aucune limite de débit, aucune interruption de service, aucun e-mail de dépréciation ne perturbe votre flux de travail un mardi. Contrôle : le modèle que vous avez validé est celui que vous utilisez jusqu’à nouvel ordre.
En revanche, les modèles cloud de pointe restent plus performants, et pour les tâches automatisées à long terme, l'écart est bien réel. Les modèles locaux ont atteint la parité pour les tâches limitées : chat, résumé de code, code monofichier et questions-réponses sur des documents. Or, cela correspond à la majeure partie des activités quotidiennes de la plupart des gens. Si votre priorité est la performance maximale à tout prix, optez pour le cloud. Si votre priorité est la confidentialité, le coût ou le contrôle, le local est une solution viable aujourd'hui, et cette page vous guidera.
Ce cadre de référence devrait définir votre budget matériel, car le choix de la mémoire est avant tout une question de dépenses liées à l'IA locale. 16 Go de VRAM ou 32 Go de mémoire unifiée suffisent pour les modèles de 7 à 8 milliards d'octets, qui gèrent les tâches limitées mentionnées précédemment. Entre 24 et 32 Go de VRAM, ou 48 Go de mémoire unifiée, on atteint les modèles de 30 milliards d'octets, où la programmation agentique cesse d'être une simple démonstration. Enfin, 96 à 128 Go de mémoire unifiée permettent d'exécuter les modèles de plus de 100 milliards d'octets, qui atteignent des performances de pointe. Un surdimensionnement peut vous faire gagner en vitesse, mais un sous-dimensionnement empêchera le chargement des modèles que vous souhaitiez.
Nos guides « Meilleurs ordinateurs portables pour l'IA locale » et « Meilleurs ordinateurs de bureau pour l'IA locale » classent les machines par catégorie. Cette page explique comment les exécuter.
Le secteur logiciel n'a pas connu la même évolution que le matériel. Environ un tiers des outils recommandés dans les résultats de recherche sont aujourd'hui obsolètes, et la plupart des sites qui les recommandent ne s'en sont même pas aperçus.
Cette page répertorie les outils compatibles et les matériels sur lesquels ils fonctionnent (données d'octobre 2026). Pour l'instant, le classement est basé sur les étoiles GitHub, car il s'agit d'un indicateur neutre et vérifiable. Nous précisons lorsqu'un outil est propriétaire et n'a donc pas de nombre d'étoiles. Chaque nom d'outil dans les tableaux renvoie à son téléchargement officiel. Au fur et à mesure que chaque outil est testé en laboratoire, la colonne « Guide » est mise à jour avec un tutoriel d'installation pratique et nos propres résultats, à partir de janvier.
Cette page est régie par trois règles, à commencer par la distinction entre un modèle local et un agent local . Plusieurs produits s'exécutent sur votre machine tandis que chaque appel d'inférence est acheminé vers le cloud du fournisseur ; il s'agit d'une mesure de confidentialité, et non d'une fonctionnalité hors ligne. Ces outils sont listés séparément en bas de page afin de maintenir la distinction claire. Deuxièmement, chaque entrée comporte une configuration matérielle minimale réaliste, car l'indication « fonctionne sur un ordinateur portable » est insignifiante sans précision sur la mémoire. Troisièmement, nous consignons les éléments obsolètes, avec leurs dates, dans la FAQ.
Les choix
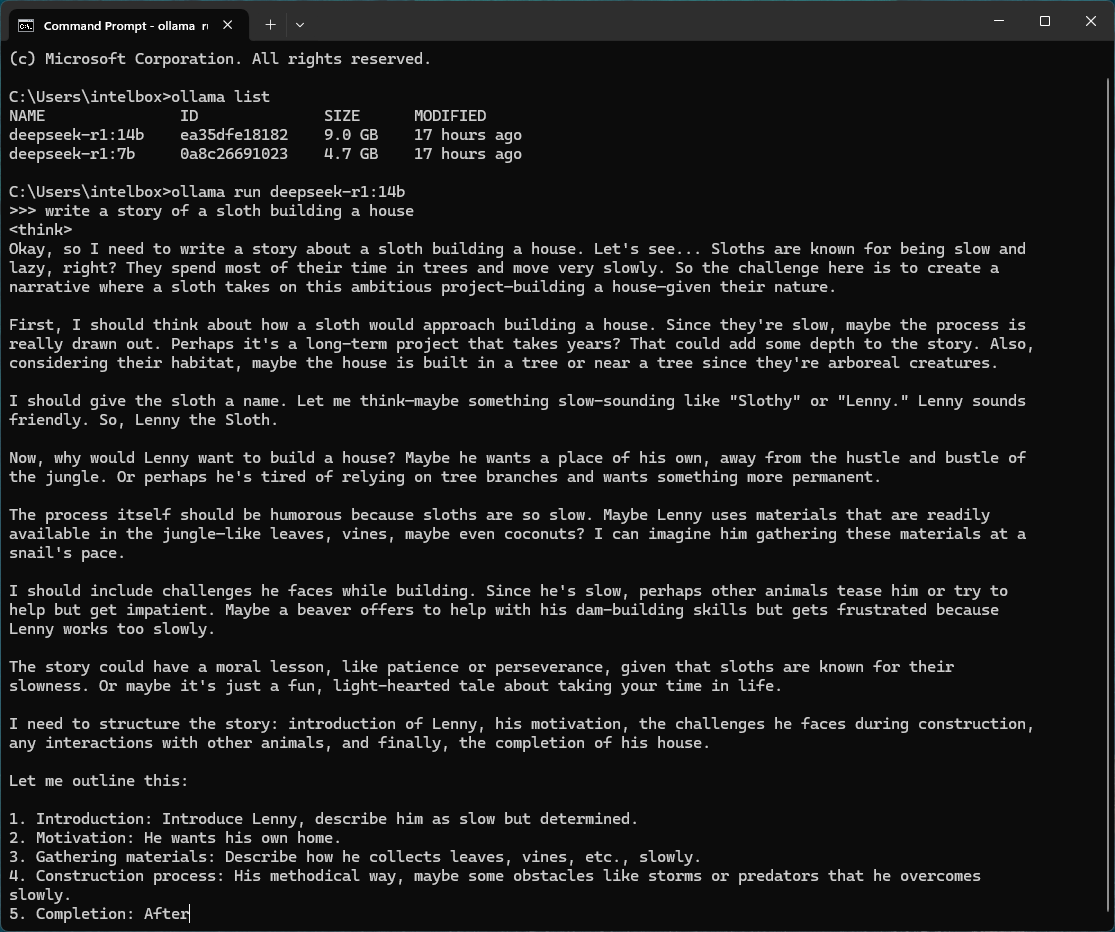
Meilleure durée d'exécution globale pour un LLM local : Ollama
Ollama est la solution par défaut, et celle avec laquelle la plupart des autres outils communiquent. Sous licence MIT, avec environ 179 000 étoiles sur GitHub, elle propose désormais une interface graphique de bureau en plus de l'interface en ligne de commande. Elle permet de télécharger des modèles en une seule commande, expose un point d'accès compatible OpenAI sur localhost et, depuis janvier 2026, est compatible avec l'API Anthropic Messages, permettant ainsi à Claude Code d'accéder à un modèle local. Configuration minimale : 8 Go de RAM système pour un modèle de 3 milliards d'individus, 16 Go pour un modèle de 7 à 8 milliards d'individus et 24 Go de VRAM pour un modèle de 30 milliards d'individus.
C'est également la plateforme la plus rapide de cette page, comme le confirment nos propres mesures. Lors de notre prise en main d'Ollama , sur les mêmes fichiers de test Ada pour RTX 5000 et les mêmes fichiers de modèle que les guides Jan et Open WebUI, Ollama 0.40.11 a décodé Jan V3.5 4B à une vitesse médiane de 145.48 jetons par seconde et Jan V2 VL High à 92.87, soit respectivement 18 % et 13 % de plus que Jan, avec un déchargement GPU complet et sans configuration CUDA. Les compromis se situent au niveau de l'application de bureau : l'importation de fichiers GGUF existants nécessite un fichier de modèle et PowerShell, un modèle de vision importé perd la prise en charge des images sans son fichier de projecteur, et la recherche Web requiert un compte et a renvoyé une erreur HTTP 402.
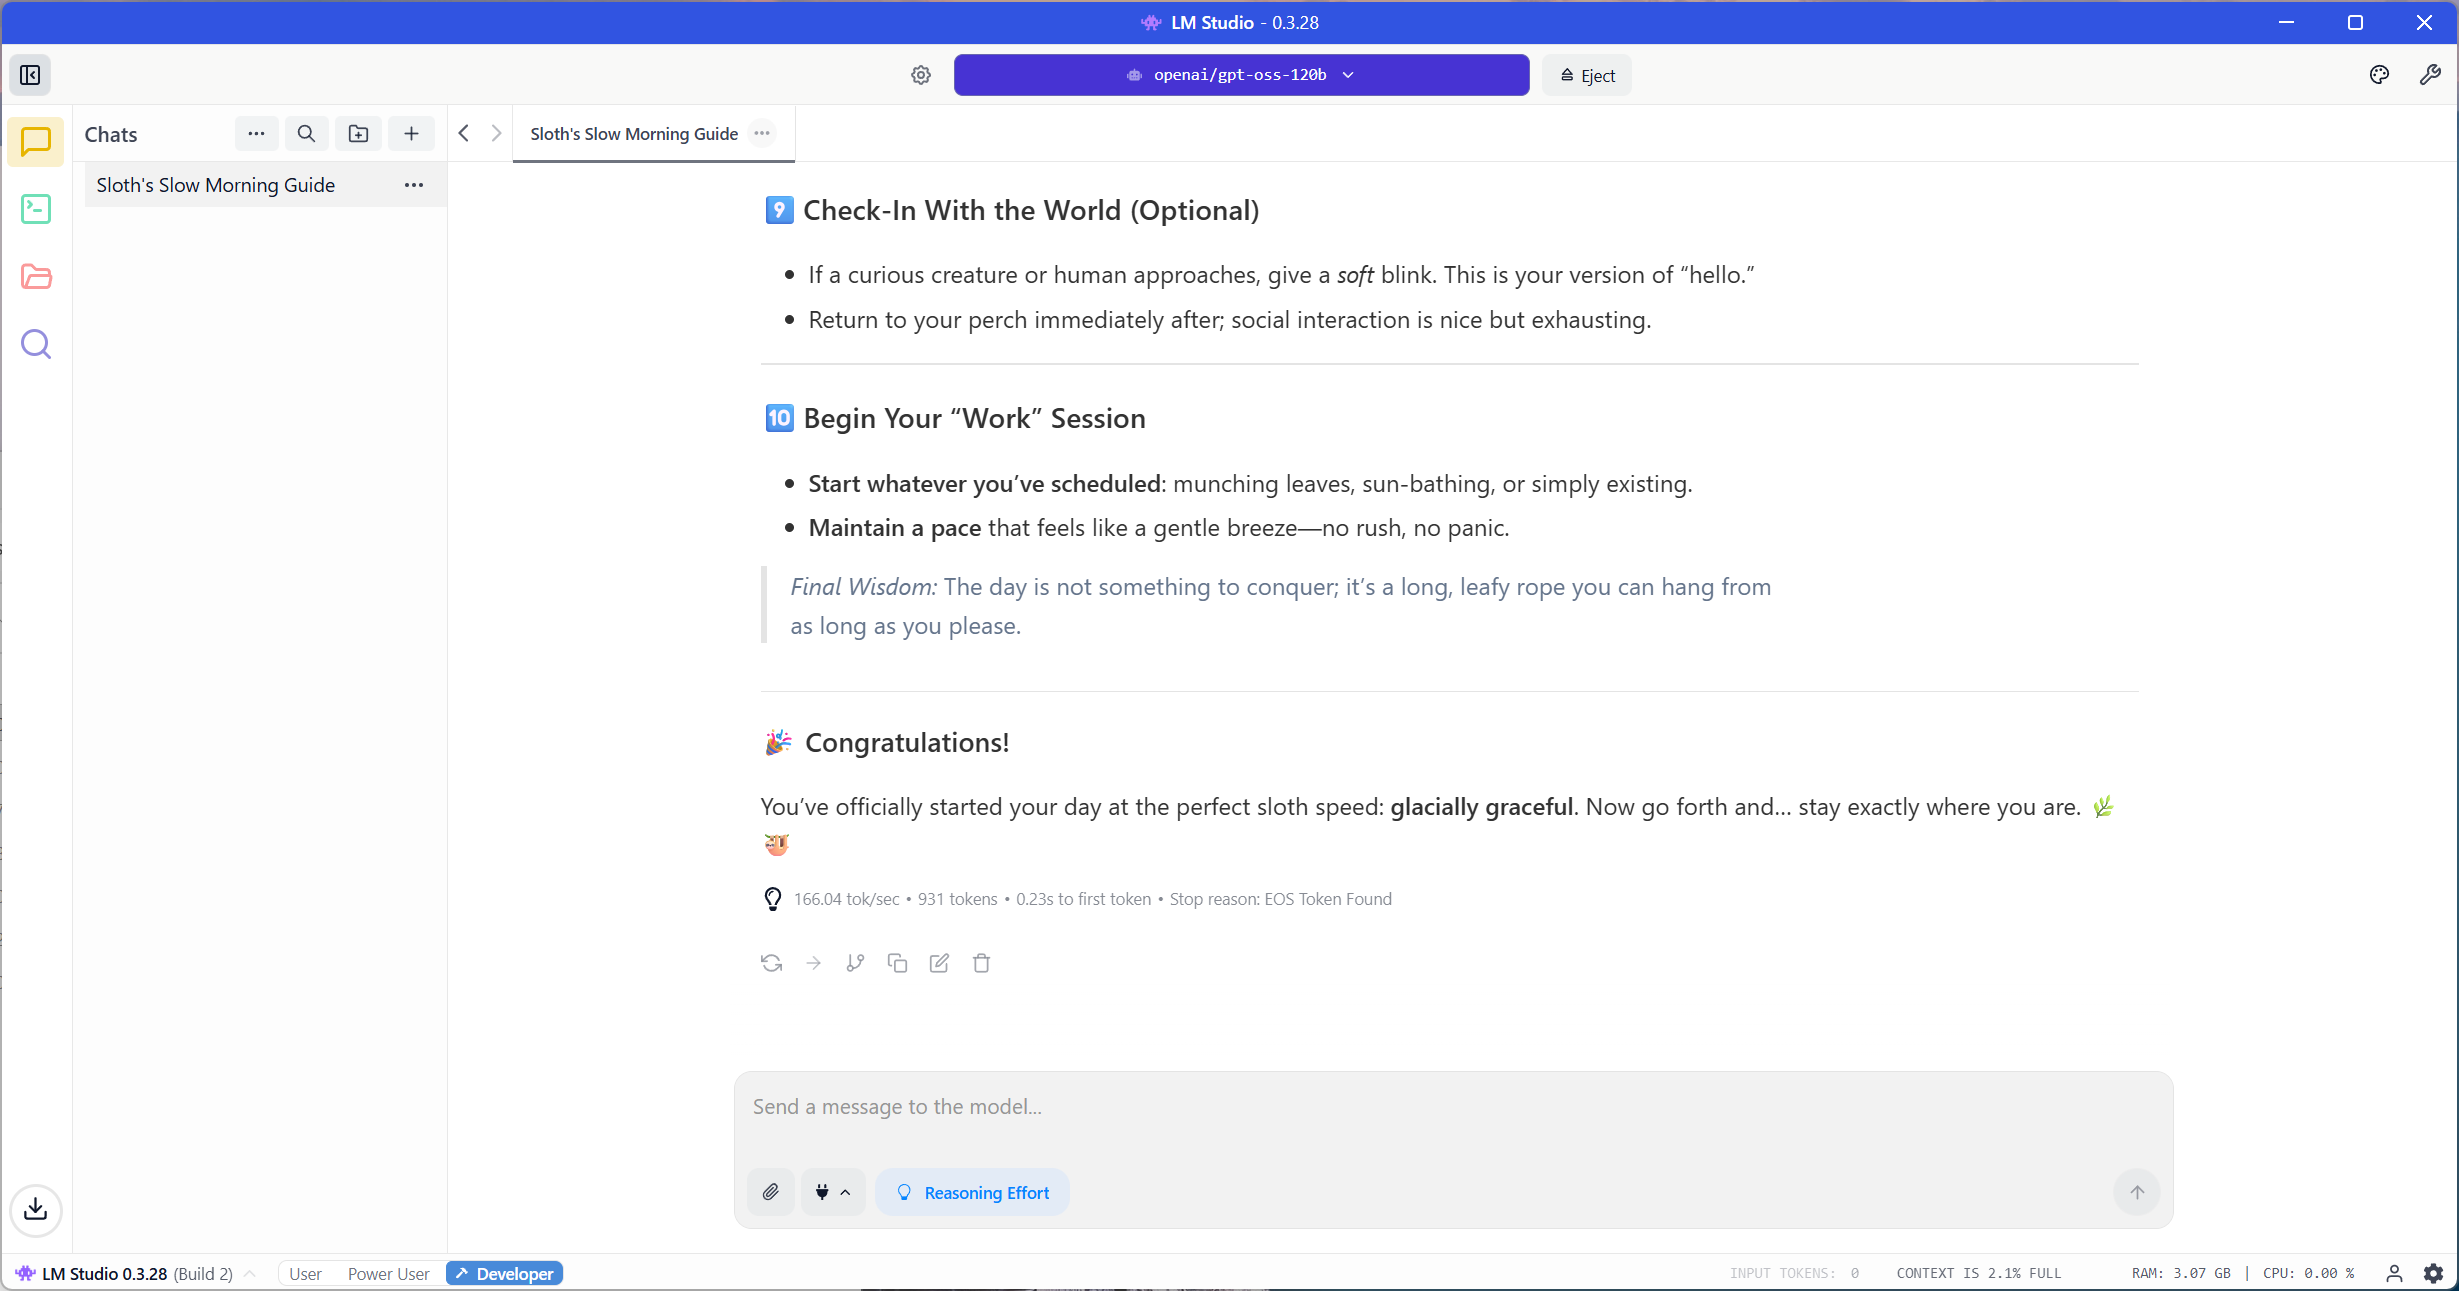
Idéal pour l'évaluation des performances matérielles : LM Studio
Logiciel propriétaire, il n'a donc pas de note globale, mais il mérite amplement sa place. LM Studio intègre llama.cpp et MLX et offre un accès aux commandes essentielles pour mesurer les performances d'une machine plutôt que de l'utiliser : couches de déchargement GPU, choix de la quantification, longueur du contexte et comportement multi-GPU. Son utilisation commerciale est gratuite depuis juillet 2025. C'est cet outil qui permet d'obtenir la plupart des chiffres de jetons par seconde sur nos cartes de stations de travail et d'ordinateurs portables. Configuration minimale : 16 Go de RAM ; 24 Go de VRAM ou 32 Go de mémoire unifiée pour des performances optimales.
Meilleur moteur sous-jacent : llama.cpp
Presque tout le reste sur cette page dépend de llama.cpp. Sous licence MIT, ce projet compte environ 124 700 étoiles et plusieurs versions étiquetées sont publiées quotidiennement. Il présente un intérêt particulier pour les développeurs de matériel : la liste des technologies sous-jacentes est impressionnante et couvre CUDA, ROCm, Metal, Vulkan, SYCL, CANN et OpenCL. De plus, les ingénieurs des fabricants y contribuent directement en apportant des optimisations. L'amélioration du préremplissage Intel Arc dans la version 8688 a permis d'obtenir un gain de performance d'environ 5x, et tous les utilisateurs d'Ollama et de LM Studio en ont bénéficié sans installation supplémentaire. Configuration minimale : fonctionne uniquement sur le processeur ; 8 Go de RAM sont nécessaires pour une utilisation optimale.
Meilleure application de bureau privilégiant le local : Jan
Apache 2.0, environ 44 100 étoiles, version 0.8.6 (octobre 2026). Jan intègre llama.cpp ; aucune autre installation n’est donc nécessaire, et l’application fonctionne même sans câble réseau. Cela peut paraître simple, mais il suffit de constater le nombre d’applications de cette catégorie qui sont des clients cloud avec un champ Ollama. C’est l’application idéale à recommander à un collègue qui n’ouvrira jamais son terminal.
C'est également la première plateforme de cette page dont les résultats sont basés sur nos propres mesures : sur notre banc d'essai RTX 5000 Ada, Jan V3.5 4B a décodé en moyenne 123 jetons par seconde et Jan V2 VL High 82, avec respectivement 4.8 Go et 8.2 Go de mémoire GPU, l'accélération GPU étant activée dès le premier lancement et sans configuration CUDA. Le guide complet, de l'installation à l'API compatible OpenAI, est disponible dans notre guide pratique de Jan ; le document RAG est la seule partie de l'application qui n'y est pas abordée. Configuration minimale : 8 Go de RAM.
Meilleur document local RAG : AnythingLLM
MIT, environ 64 800 étoiles. Ce logiciel intègre une base de données vectorielles et gère le découpage et l'intégration de données sans configuration, ce qui en fait la solution de chat documentaire la plus simple d'utilisation sur ordinateur. Deux points importants : une vulnérabilité datant de mars 2026, classée CVSS 9.6, permettait l'exécution de code à distance déclenchée par la réponse du modèle. Corrigée dans la version 1.11.2, il est impératif de mettre à jour le logiciel avant utilisation. Par ailleurs, la télémétrie est activée par défaut dans une application présentée comme étant principalement destinée à un usage local ; vous pouvez la désactiver dans les paramètres. Configuration minimale requise : 16 Go de RAM pour le traitement de documents.
Meilleure solution multi-utilisateurs auto-hébergée : Open WebUI
Avec environ 149 000 étoiles et une configurabilité de récupération extrêmement poussée, nous avons testé le serveur v0.12.2. Initialement hébergé sur un serveur personnel avec Docker comme point d'entrée, il est désormais installé via une application de bureau Windows, intégrant un environnement Python et son propre environnement d'exécution llama.cpp. Attention : la licence a été modifiée en avril 2025, passant de BSD-3 à une licence personnalisée non approuvée par l'OSI. Cette dernière interdit la suppression de la marque Open WebUI et prévoit une exception pour les utilisateurs de moins de cinquante personnes sur une période de trente jours. Si vous l'utilisez sans modification à petite échelle, rien ne changera pour vous.
Il s'agit de la deuxième plateforme présentée sur cette page avec nos propres résultats. Sur nos fichiers de test et de modèle de janvier, Open WebUI Desktop a décodé Jan V3.5 4B à une médiane de 115.32 jetons par seconde et Jan V2 VL High à 75.06, soit 6.2 % et 8.5 % de moins que Jan sur une version différente de llama.cpp. La configuration diffère : nous avons utilisé la version b11612 de llama.cpp, ajouté manuellement les DLL d'exécution CUDA et restauré un contexte de 8 192 jetons après une réinstallation qui a permis d'allouer jusqu'à 169 984 jetons par emplacement.
Les préréglages, la saisie d'images, la recherche Web DDGS et l'API locale fonctionnaient alors parfaitement, comme le détaille notre guide pratique d'Open WebUI . Configuration minimale : un environnement d'exécution distinct et 4 Go pour le conteneur, ou l'application de bureau avec son fichier llama.cpp intégré.
Meilleur agent de codage local : Cline
Apache 2.0, environ 63 900 étoiles. Cline a investi davantage que ses concurrents dans l'ingénierie locale, notamment avec une invite de commande système compacte conçue spécifiquement pour Ollama et LM Studio, et un accès natif aux outils par famille de modèles. Sa documentation est étonnamment transparente quant aux avantages du cloud. Configuration minimale : 24 Go de VRAM ou 36 Go de mémoire unifiée, et contexte défini à 32 Ko ou plus.
Meilleure programmation de terminal hors ligne : Aider
Apache 2.0, environ 48 300 étoiles, et l'option locale la plus fiable sur le plan architectural, pour une raison qu'il est important de comprendre. Aider n'utilise pas du tout les appels d'outils JSON. Il analyse les formats de comparaison et d'édition de fichiers entiers à partir de texte brut, évitant ainsi le principal problème qui affecte la plupart des agents sur les modèles locaux. Le bémol concerne la maintenance : un seul auteur a réalisé 96 % des modifications, et le rythme de publication a considérablement diminué, avec environ une version stable prévue pour 2026. Configuration minimale : 24 Go de VRAM ou 36 Go de mémoire unifiée.
Meilleure plateforme d'agent auto-hébergée : OpenHands
MIT, environ 84 500 étoiles. OpenHands documente correctement les modèles locaux et, plus utile encore, indique quand le problème ne vient pas de votre configuration : sa documentation précise que si l’agent se comporte comme un chatbot ou rencontre constamment des échecs avec les outils, c’est le modèle qui est limitant. Il requiert un minimum de 22 Ko de contexte et en recommande 32 Ko. Configuration minimale : 24 Go de VRAM pour les modèles quantifiés, ou 64 Go de mémoire unifiée.
Meilleure surprise gratuite hors ligne : l’interface de ligne de commande GitHub Copilot
Depuis avril 2026, l'interface de ligne de commande Copilot fonctionne avec Ollama, vLLM et Foundry Local. L'authentification GitHub est facultative et aucun abonnement Copilot n'est requis. L'option COPILOT_OFFLINE désactive toute télémétrie et communication réseau, et ses sous-agents héritent de votre fournisseur local. La plupart des articles comparatifs le présentent encore comme étant exclusivement disponible dans le cloud. À noter : l'extension IDE continue d'envoyer les suggestions de saisie au cloud, même avec l'option « apportez votre propre clé ». Configuration minimale : un modèle avec une fenêtre de contexte de 128 Ko, soit 32 Go de VRAM ou 64 Go de mémoire unifiée.
Meilleur serveur recommandé par un fournisseur : Lemonade
Apache 2.0, qui compte environ 5 400 étoiles, est le seul outil externe à AMD que nous recommandons pour ses seules qualités. Maintenu par les ingénieurs d'AMD, il fonctionne sur NVIDIA CUDA, Apple Metal, Vulkan et sur les processeurs classiques, ainsi que sur les NPU Radeon et Ryzen AI. Des mises à jour sont disponibles environ toutes les deux semaines et son application de bureau a été migrée d'Electron vers Tauri en avril 2026. Configuration minimale : 16 Go de RAM ; processeur Ryzen AI série 300 ou supérieur pour l'utilisation d'un NPU.
Meilleur RAG local à l'échelle du système de fichiers : Nexa AI Hyperlink
Nexa AI Hyperlink est un logiciel propriétaire et gratuit qui indexe l'intégralité de votre système de fichiers et fournit des citations intégrées. Il figure dans cette liste car il est le seul nouvel outil RAG local à avoir publié des chiffres d'accélération sur du matériel grand public : une indexation environ trois fois plus rapide et une inférence deux fois plus rapide sur une RTX 5090, le temps d'indexation d'un dossier de 1 Go passant d'environ quinze minutes à quatre ou cinq minutes. Configuration minimale : une carte graphique RTX récente et 16 Go de RAM.
Durée d'exécution : Qu'est-ce qui exécute le modèle ?
Ces cinq éléments sont les moteurs, et tout ce qui se trouve dans les deux tableaux suivants est une interface qui communique avec l'un d'eux ; le tableau est donc classé par nombre d'étoiles GitHub, comme le reste de la page.
La colonne « Guide » recoupe ici la section consacrée aux applications ; son contenu est donc adapté en conséquence : Ollama bénéficie d’un guide dédié car il s’agit du choix privilégié et du backend vers lequel pointent la plupart des autres outils ; LM Studio apparaît dans les deux tableaux et dispose d’un guide ; llama.cpp est traité dans les applications qui l’intègrent, à commencer par la prise en main de janvier ; et MLX est traité dans LM Studio sur Apple Silicon. vLLM est un moteur de serveur, et son test est déjà inclus dans notre évaluation du cluster GB300 à deux tours.
| Runtime | Étoiles | License | Matériel minimum | ACCÉLÉRATION | Guide |
|---|---|---|---|---|---|
| Ollama | ~ 179,000 | MIT | 8 Go de RAM (3B), 16 Go (7-8B), 24 Go de VRAM (classe 30B) | CUDA, ROCm, Metal, Vulkan | Guide pratique d'Ollama |
| lama.cpp | ~ 124,700 | MIT | 8 Go de RAM, fonctionnement du processeur uniquement | CUDA, ROCm, Metal, Vulkan, SYCL, CANN, OpenCL | Couvert par le Janvier et Ouvrir l'interface utilisateur Web pratiques |
| MLX / mlx-lm | ~ 27,500 | MIT | Apple Silicon, 16 Go unifiés | Métal ; backend CUDA ajouté en 2026 | Via le guide LM Studio (à venir) |
| Studio LM | Source fermée | Propriété exclusive, libre d'utilisation commerciale | 16 Go de RAM ; 24 Go de VRAM ou 32 Go unifiés | Regroupe llama.cpp et MLX | À venir |
| vLLM | Production au service | Apache 2.0 | 24 Go de VRAM sol réaliste | CUDA, ROCm | Testé dans notre revue du groupe GB300 |
Applications de bureau et RAG local
Il s'agit des applications installées par un lecteur, et la colonne « Local-First » est celle qu'il faut lire attentivement : elle distingue les logiciels qui exécutent un modèle sur votre machine des logiciels qui ont ajouté un champ pour une URL Ollama.
| Application | Étoiles | License | Priorité au local | Matériel minimum | Guide |
|---|---|---|---|---|---|
| Ouvrir l'interface utilisateur Web | ~ 149,000 | Personnalisé, non approuvé par l'OSI | Serveur performant, ainsi qu'une application de bureau Windows intégrant llama.cpp | Environnement d'exécution séparé + 4 Go pour le conteneur, ou l'application de bureau | Guide pratique Open WebUI |
| N'importe quoiLLM | ~ 64,800 | MIT | Compatible ; télémétrie activée par défaut | 16GB RAM | À venir |
| Janvier | ~ 44,100 | Apache 2.0 | Oui, regroupe llama.cpp | 8GB RAM | Guide pratique de janvier |
| Studio LM | Source fermée | Propriétaire | Oui | 16 Go de RAM ; 24 Go de VRAM pour que ce soit intéressant | À venir |
| Msty | Source fermée | Propriétaire, niveau gratuit | Oui, les bundles Ollama, MLX, lama.cpp | 8GB RAM | À venir |
| Lien vers l'IA Nexa | Source fermée | Propriétaire, gratuit | Oui, indexation sur l'appareil | Carte graphique RTX moderne, 16 Go de RAM | À venir |
Outils de codage et d'agentivité
Ce sont les applications les plus gourmandes en ressources matérielles de cette page, car les applications nécessitant un grand espace de travail et des sessions longues requièrent une large fenêtre de contexte. À partir de 32 Go de VRAM ou 64 Go de mémoire unifiée, il ne s'agit plus d'une simple démonstration.
| Outil | Étoiles | License | Chemin local | Matériel minimum | Guide |
|---|---|---|---|---|---|
| Mains ouvertes | ~ 84,500 | MIT | LM Studio, Ollama, vLLM, SGLang | 24 Go de VRAM ou 64 Go unifiés ; 32 Ko de contexte | À venir |
| cline | ~ 63,900 | Apache 2.0 | Ollama, LM Studio, compatible avec OpenAI | 24 Go de VRAM ou 36 Go unifiés | À venir |
| Oie | ~ 52,900 | Apache 2.0 | Ollama de première classe ; maintenant Fondation Linux | 24 Go de VRAM ou 36 Go unifiés | À venir |
| Aider | ~ 48,300 | Apache 2.0 | Ollama, compatible avec OpenAI ; aucun outil d'appel | 24 Go de VRAM ou 36 Go unifiés | À venir |
| Zed | v1.0, avril 2026 | Apache 2.0 | LM Studio, Ollama, llama.cpp | 24 Go de VRAM ou 36 Go unifiés | À venir |
| CLI copilote GitHub | Source fermée | Propriétaire, aucun abonnement requis | Ollama, vLLM, Fonderie Locale | 32 Go de VRAM ou 64 Go unifiés ; 128 Ko de contexte | À venir |
Initiatives des fournisseurs
Chaque fabricant de semi-conducteurs et de systèmes d'exploitation propose des solutions pour l'IA locale, et cette catégorie mérite une ligne budgétaire distincte, car la terminologie est confuse et le taux d'abandon élevé. La tendance observée en 2026 est constante : les fabricants ont cessé de concurrencer les solutions tierces et ont commencé à les alimenter. NVIDIA a abandonné ses deux produits d'IA locale et publie désormais des optimisations pour Ollama, llama.cpp et ComfyUI. AMD s'associe à LM Studio. Qualcomm a intégré ses capacités NPU en portant une application existante.
Ce que les outils propriétaires permettent de faire et qu'Ollama et LM Studio ne peuvent pas, c'est accéder au NPU . llama.cpp n'utilise pas le NPU ; par conséquent, sur une machine IA équipée d'un Snapdragon ou d'un Ryzen, ces outils laissent le moteur neuronal à 0 % d'utilisation. Si vous avez payé pour une puissance de 40 à 60 TOPS, seul un chemin d'accès propriétaire l'exploite. Il faut donc adapter ses attentes, car les NPU actuels plafonnent aux modèles 7B, et le principal avantage réside dans l'autonomie de la batterie pour les tâches nécessitant un fonctionnement continu sur de petits modèles, et non dans le débit. Un GPU dédié est toujours plus rapide qu'un NPU.
| Vendeur | En quoi ça consiste | Type | Matériel requis | Statut | Guide |
|---|---|---|---|---|---|
| Limonade AMD | Serveur, interface graphique et kit de développement logiciel ; environ 5 400 étoiles, Apache 2.0 | Application + serveur | 16 Go de RAM ; processeur Ryzen AI 300+. Fonctionne également sur les processeurs NVIDIA, Apple et CPU. | Actif, expéditions environ toutes les deux semaines | À venir |
| Intel OpenVINO GenAI | Environnement d'exécution et SDK ; ~10 700 étoiles | SDK | Processeur Core Ultra, série Arc A/B ; 16 Go de RAM | Actif, 2026.3 en août 2026 | Suivi, pas de guide prévu |
| Modèles de la Fondation Apple | Modèles embarqués exposés par le système d'exploitation | Cadre du système d'exploitation | Apple Silicon ; déjà installé | Actif ; ouvert à tous les fournisseurs lors de la WWDC 2026 | Suivi, pas de guide prévu |
| Microsoft Foundry Local | Kit de développement logiciel (SDK) et interface de ligne de commande (CLI) pour l'inférence locale ; environ 2 400 étoiles | SDK | Windows, macOS, Linux ; NPU/GPU/CPU | GA avril 2026 ; catalogue de modèles sélectionnés | Suivi, pas de guide prévu |
| AMD GAIA | Application LLM locale pour Ryzen AI ; environ 1 400 étoiles, MIT | Application + SDK | Configuration minimale requise : processeur Ryzen AI série 300 ; 16 Go de RAM, 64 Go de stockage recommandés | Actif, v0.20.0 Juin 2026 | Suivi, pas de guide prévu |
| Terrain de jeu Intel AI | Application de bureau ; ~900 étoiles | Application | Arc série A 8 Go+, Arc série B, Core Ultra | Actif mais toujours en version bêta après deux ans | Suivi, pas de guide prévu |
| Qualcomm GenieX | Environnement d'exécution GGUF embarqué pour NPU Snapdragon | Runtime | Snapdragon X / X Elite, 8 Elite | Aperçu pour les développeurs, juillet 2026 | Suivi, pas de guide prévu |
| Projet NVIDIA G-Assist | Assistant 8B intégré pour le contrôle du système | Application | Carte graphique RTX série 20 ou ultérieure, 6 Go de VRAM | Actif mais toujours étiqueté pré-lancement | Suivi, pas de guide prévu |
Cette appellation contribue à la confusion, car « RTX AI Garage » de NVIDIA sonne comme un produit, alors qu'il s'agit d'une série d'articles de blog. La plateforme Microsoft a été renommée à plusieurs reprises : les API Copilot Runtime sont devenues les API Windows AI, Azure AI Foundry est devenu Microsoft Foundry, et DirectML est désormais en mode maintenance, ne proposant que des correctifs de sécurité. Qualcomm AI Hub est un service cloud qui provisionne des appareils physiques à distance, et non une application exécutée localement.
Ce qui casse généralement
La plupart des signalements indiquant que les modèles locaux « ne fonctionnent pas » sont dus à des problèmes de configuration, et non à des problèmes liés au modèle lui-même. Quatre d'entre eux, en particulier, représentent une part importante de ces signalements, et il est essentiel que les spécialistes du matériel informatique en soient conscients avant d'incriminer le silicium.
1. Par défaut, Ollama utilise un contexte de 4 096 jetons. En cas de dépassement, aucune erreur n'est signalée : le contexte est tronqué silencieusement et une boucle d'agents s'interrompt sans problème. Tout système de gestion de données sérieux nécessite davantage de jetons : OpenHands requiert au minimum 22 000 jetons et recommande 32 000, Codex nécessite 32 000 jetons, Copilot CLI 128 000 et Cline 262 144. Ce paramètre est probablement la cause la plus fréquente des rapports d'échec que vous trouverez en ligne.
2. La quantification du cache KV dégrade spécifiquement les appels d'outils , et ce avant même que la qualité générale du rendu ne soit visiblement affectée. La documentation de llama.cpp le signale explicitement. Si vous utilisez un agent, désactivez cette option.
3. Le nombre d'outils est un facteur limitant. Au-delà de cinq ou six outils environ, certains modèles cessent silencieusement d'émettre des appels d'outils JSON valides et commencent à intégrer du XML dans le corps de la réponse, ce que le système interprète comme « aucun outil utilisé ». Un agent populaire intégrait onze outils par défaut et a rendu son propre modèle recommandé incompatible jusqu'à début 2026. Nous avons rencontré un cas similaire lors de nos tests Open WebUI : les instructions d'outils intégrées ont poussé une courte requête de test au-delà d'un contexte de 8 192 jetons. La conséquence pratique est contre-intuitive : charger de nombreux serveurs MCP est activement préjudiciable aux modèles locaux, contrairement aux modèles de pointe.
4. Q4_K_M représente le seuil pratique. En dessous, la fiabilité des appels d'outils diminue plus rapidement que la qualité générale ; le modèle semble donc fonctionner correctement tout en étant incapable de réaliser la moindre opération.
La mémoire est la contrainte
Pour chaque outil présenté sur cette page, la quantité de mémoire accessible par l'accélérateur détermine les programmes que vous pouvez exécuter. Voici les combinaisons les plus fréquemment citées pour les applications multi-agents, et celles que nous comptons vérifier en laboratoire.
| Hardware | Modèle | numérique | Débit déclaré |
|---|---|---|---|
| RTX 5090, 32 Go | Qwen3.6-35B-A3B Q4_K_M | ~ 21GB | 160-180 tok/s, 262K contexte |
| RTX 5090, 32 Go | Qwen3-Coder-30B-A3B Q4_K_M | ~ 19GB | 50-90 tok/s sur classe 24 Go |
| RTX 5090, 32 Go | Devstral Small 24B Q4_K_M | ~ 14GB | Conçu spécifiquement pour l'appel d'outils |
| RTX PRO 6000, 96 Go | GPT-OSS 120B MXFP4 | ~ 63GB | La classe 100B sur une seule carte graphique pour station de travail ; le GPU testé en laboratoire |
| Ordinateur portable RTX PRO 5000, 24 Go GDDR7 | Qwen3-Coder-30B-A3B Q4_K_M | ~ 19GB | Le plus gros GPU pour ordinateur portable que nous ayons testé (ThinkPad P16 Gen 3) ; sa classe de 30 octets est tout à fait adaptée au contexte. |
| Mémoire unifiée de 96 à 128 Go, série M | gpt-oss-120b Q6_K | ~ 93GB | 14-20 tok/s ; JSON d'appel d'outil le plus propre de tous les modèles à poids ouvert |
Il est important de le préciser, car le marketing omet de le mentionner : les modèles open-weight les plus volumineux ne sont pas des stations de travail. Le GLM-5.2 compte environ 744 milliards de paramètres et nécessite environ 744 Go en FP8, soit l’équivalent d’un nœud de centre de données à huit GPU. Le Kimi K2 et le DeepSeek V4 appartiennent à la même catégorie. Tout guide vous conseillant de les exécuter sur un ordinateur de bureau est erroné.
Les chiffres de débit ci-dessus proviennent de tests tiers publiés et de documents fournisseurs ; ils ne correspondent pas encore aux résultats des laboratoires de StorageReview, à l’exception des chiffres de décodage de Jan, Open WebUI et Ollama présentés ci-dessus. Nous les remplacerons par nos propres données au fur et à mesure de l’avancement de chaque sélection dans le cadre du processus d’évaluation.
Outils privilégiant le cloud : pourquoi ne figurent-ils pas ici ?
Un agent local n'est pas un modèle local , et les outils ci-dessous illustrent la différence : chacun s'exécute sur votre machine tout en envoyant chaque appel d'inférence à un cloud fournisseur.
| Outil | Prise en charge des modèles locaux | Note |
|---|---|---|
| Curseur | Non | La documentation officielle indique que toutes les requêtes transitent par les serveurs Cursor ; les touches personnalisées fonctionnent uniquement avec les principaux fournisseurs de cloud, et la saisie semi-automatique utilise toujours les modèles Cursor. Acquis par SpaceX en 2026. |
| Devin Desktop (anciennement Windsurf) | Non | Renommé en juin 2026. Tous les modèles sont hébergés dans le cloud. |
| Google Antigravité | Non | La documentation indique explicitement qu'il est impossible d'utiliser Ollama, LM Studio ou un point de terminaison personnalisé. |
| Gemini CLI | Non | Le support local n'existe que dans les forks communautaires. |
| Qodo | Non | « Sur site » fait référence à une infrastructure auto-hébergée qui utilise encore des modèles cloud. |
| GitHub Copilot dans l'IDE | Partiel | Le chat peut utiliser des modèles locaux ; les suggestions de saisie restent dans le cloud même avec BYOD (Bring Your Own Key). |
| ChatGPT | Non | Les applications de bureau et mobiles sont des clients pour les modèles cloud d'OpenAI. Les modèles gpt-oss à pondération ouverte d'OpenAI s'exécutent localement, mais via les environnements d'exécution mentionnés ci-dessus, et non via l'application ChatGPT. |
| Claude | Non | Les applications Claude et Cowork fonctionnent sur les modèles cloud d'Anthropic. Claude Code peut être connecté à un modèle local via l'API compatible Anthropic d'Ollama, ce qui fonctionne mais constitue une configuration non prise en charge. |
| assistants d'agent général | Non | Les outils de cette catégorie s'exécutent sur votre machine mais dépendent d'un modèle cloud pour le raisonnement. |
On trouve de nombreux guides expliquant comment connecter Cursor à Ollama. Or, la documentation de Cursor elle-même les contredit. Si le fonctionnement hors ligne est indispensable, cette distinction est cruciale.
Qu’en est-il de la génération d’images et de vidéos ?
La génération d'images locale est l'une des plus importantes communautés d'IA locale. ComfyUI, à elle seule, surpasse la plupart des outils classés par étoiles sur GitHub, et la génération vidéo locale s'impose comme l'application grand public la plus gourmande en VRAM. Elle mérite son propre classement, et elle en aura un ; ajouter une quatrième catégorie à cette page la nuirait à sa visibilité. En attendant, la logique matérielle présentée ici s'applique directement : le traitement d'images et de vidéos est encore plus gourmand en mémoire que les modèles de langage, et les mêmes niveaux de performance s'appliquent.
Comment fonctionne cette page
Trois règles régissent le classement, et la première est que le classement se base pour l'instant sur le nombre d'étoiles GitHub. Ce n'est pas idéal, mais c'est neutre, vérifiable et cela ne nous oblige pas à prétendre avoir testé des outils que nous n'avons pas testés. Les outils propriétaires sont signalés comme tels et ne reçoivent aucune note artificielle. À mesure que nos propres tests identifieront des outils nettement supérieurs, le classement évoluera pour refléter les résultats mesurés, et nous le signalerons ; Jan, Open WebUI et Ollama disposent désormais de résultats de tests en laboratoire, ce qui marque le début de cette évolution. Deuxièmement, chaque entrée comporte une valeur minimale de mémoire, car c'est cette valeur qui détermine si un modèle peut être chargé.
Troisièmement, la colonne Guide constitue un engagement spécifique aux produits sélectionnés : chaque produit classé fait l’objet d’une présentation détaillée de son installation, accompagnée de nos chiffres sur notre matériel ; l’environnement d’exécution fourni avec une application est traité dans le guide de cette application ; et les initiatives des fournisseurs sont répertoriées dans leur tableau, même sans guide. Le lien apparaît ici lors de la publication de chaque guide.
FAQ sur les outils LLM locaux
Par quel outil LLM local devrais-je commencer ?
Ollama est idéal si vous êtes à l'aise avec le terminal, LM Studio si vous préférez une interface graphique, et Jan si vous souhaitez une solution prête à l'emploi, sans installation supplémentaire. Ces trois logiciels sont gratuits, fonctionnent entièrement hors ligne et utilisent tous le même fichier llama.cpp, garantissant ainsi un comportement identique pour les modèles. En revanche, la vitesse diffère : lors de nos tests de performance Ada sur RTX 5000, Ollama a décodé les mêmes fichiers de modèles 13 à 18 % plus rapidement que Jan. La différence réside donc dans l'interface et la version fournie par chaque logiciel.
Qu'est-il advenu de NVIDIA ChatRTX, GPT4All et Continue.dev ?
Ils ont disparu, tout comme un nombre surprenant de leurs concurrents, et c'est l'information la plus importante à connaître avant de suivre une recommandation obsolète. NVIDIA ChatRTX a été déprécié le 21 janvier 2026, son dépôt archivé et son forum d'assistance verrouillé, sans qu'aucun remplaçant n'ait été annoncé.
GPT4All est le cas le plus complexe : aucun commit n’a été effectué depuis douze mois et sa dernière version date de février 2025. Pourtant, le dépôt n’est pas archivé et affiche toujours un nombre élevé d’étoiles, ce qui laisse penser qu’il est actif. Il n’a jamais pris en charge qu’un nombre restreint de formats de quantification et ne peut pas charger la plupart des versions actuelles des modèles.
Continue.dev , pendant deux ans la solution de référence pour la programmation de modèles locaux, a été racheté par Cursor et arrêté en juin 2026. Roo Code a fermé ses portes en mai 2026, Void a été archivé en juin 2026, Twinny en novembre 2025 et Reor en mars 2026. Khoj a mis fin à son service hébergé en avril 2026, mais la version auto-hébergée reste disponible. Côté fournisseurs, Intel IPEX-LLM a été archivé en janvier 2026 et signalé pour des failles de sécurité connues, sans solution de migration publiée, et NVIDIA RTX AI Toolkit a été déprécié en novembre 2025.
De combien de VRAM ai-je besoin pour exécuter un LLM local ?
Pour le chat, 8 Go de RAM système permettent d'exécuter un modèle 3B, et 16 Go permettent d'exécuter un modèle 7 à 8B de manière acceptable sur le seul processeur. Pour une vitesse utile, il est préférable d'utiliser le modèle en mémoire vidéo (VRAM) ou en mémoire unifiée : 16 Go gèrent les modèles 7 à 14B, 24 Go atteignent les modèles 30B au quatrième trimestre, et à partir de 32 Go, le développement d'agents devient fluide. Au-delà, la capacité prime sur la bande passante, ce qui explique pourquoi les machines dotées de 96 à 128 Go de mémoire unifiée exécutent des modèles qu'aucune carte graphique grand public ne peut gérer.
Les outils LLM locaux utilisent-ils mon NPU ?
Généralement non, car llama.cpp ne possède pas de backend NPU. Par conséquent, Ollama et LM Studio désactivent le moteur neuronal sur une machine IA Snapdragon ou Ryzen et s'exécutent sur le CPU ou le GPU. L'accès au NPU nécessite actuellement de passer par un fournisseur : Qualcomm GenieX, AMD Lemonade avec son environnement d'exécution NPU, Intel OpenVINO ou le Neural Engine d'Apple via les frameworks du système d'exploitation. L'avantage réside dans l'autonomie de la batterie et un fonctionnement continu à faible consommation, car les NPU actuels atteignent des performances maximales d'environ 7 milliards de dollars et un GPU dédié offre systématiquement un meilleur débit.
Dois-je exécuter l'IA locale sous Windows ou Linux ?
Pour les applications de bureau présentées sur cette page, Windows et macOS offrent une expérience plus fluide. LM Studio, Jan, AnythingLLM et Ollama s'installent nativement, les pilotes GPU sont disponibles aux sources habituelles et aucune application ne nécessite de terminal. Linux se distingue par son architecture légèrement inférieure : les moteurs de serveur de production, vLLM et SGLang, sont conçus pour Linux en priorité, la gestion multi-GPU repose de fait sur cette plateforme, et certaines des technologies d'accélération les plus récentes y sont disponibles en avant-première, notamment la prise en charge du NPU IA Ryzen d'AMD, arrivée sur Linux et nécessitant un noyau très récent.
L'écart est plus faible qu'auparavant. AMD a unifié ses versions ROCm pour Windows et Linux en 2026, et WSL2 couvre la majeure partie du reste, ce qui permet à des outils basés sur Docker comme Open WebUI de fonctionner parfaitement sur une machine Windows. En pratique : si vous installez une application de bureau, restez sur votre système d'exploitation actuel ; si vous configurez un serveur dédié ou recherchez toutes les optimisations possibles, optez pour Linux.
Les modèles locaux sont-ils suffisamment performants pour remplacer un modèle cloud pour le développement ?
Tout dépend de la tâche, et la différence est plus marquée que ne le laissent entendre la plupart des analyses. Pour des tâches limitées (génération de fichiers uniques, tests unitaires, code répétitif et explication du code), les modèles open-weight actuels sur un poste de travail performant sont à peu près équivalents aux modèles cloud de pointe. En revanche, pour des tâches automatisées à long terme (refactorisations de plusieurs fichiers dans un vaste dépôt), ils sont nettement moins performants, et les conséquences sont fâcheuses : des opérations inactives silencieuses et des tâches signalées avec assurance qui n’ont jamais été réalisées. Si votre motivation pour une solution locale est la confidentialité, les exigences d’isolation physique ou le coût, elle est viable aujourd’hui. Si votre motivation est la capacité, elle ne l’est pas encore.
L'exécution d'un modèle en local est-elle plus sûre que l'utilisation d'un service cloud ?
Pour la résidence des données, oui, et c'est la raison pour laquelle la plupart des gens optent pour une solution locale. En matière de sécurité logicielle, la réponse est non par défaut : une application d'IA locale, notée CVSS 9.6 en mars 2026, pourrait être amenée à exécuter du code sur le système hôte via le flux de données généré par le modèle, car l'application de bureau était fournie avec des paramètres par défaut non sécurisés. « Local » signifie que vos données restent sur place, mais cela ne signifie pas que le logiciel est plus sécurisé, car cette catégorie inclut beaucoup de code évolutif.
Qu'est-ce qu'un bac à sable pour agents d'IA, et en ai-je besoin pour une IA locale ?
Un environnement isolé (sandbox) est un environnement isolé, généralement un conteneur ou une machine virtuelle légère, où un agent d'IA exécute les commandes et le code qu'il génère. Ainsi, une erreur ou une instruction malveillante ne peut pas affecter le système hôte. Son utilité est justifiée par le fait que les agents ne se contentent pas de répondre à des questions : ils exécutent des commandes shell, modifient des fichiers et naviguent sur Internet. Chacune de ces actions est pilotée par les résultats du modèle, qui peuvent être manipulés. L'exécution locale du modèle ne modifie en rien ces calculs.
Le sandboxing vise à isoler les actions de l'agent, et non l'emplacement du modèle. La vulnérabilité d'exécution de code décrite précédemment l'a précisément démontré sur une application fonctionnant en local. Certains outils présentés sur cette page intègrent le sandboxing, et ceux qui exécutent des agents avec un accès hôte illimité méritent une attention particulière avant d'être utilisés sur une machine critique. À mesure que l'adoption des agents se généralise en entreprise, le sandboxing deviendra sans aucun doute une fonctionnalité essentielle, et nous commencerons à en tenir compte dans notre évaluation de ces outils.
Le matériel local peut-il exécuter des charges de travail multi-agents avec des dizaines de sous-agents ?
Nous sommes à la pointe du progrès, et en résumé, une station de travail unique atteint rapidement ses limites. Les charges de travail multi-agents génèrent des sous-agents, chacun avec son propre contexte. Côté inférence, chaque contexte actif nécessite son propre cache clé-valeur en mémoire ; l’empreinte mémoire augmente donc avec la concurrence et la taille du modèle. La question de la gestion de ces caches lorsqu’ils saturent la mémoire est un problème d’ingénierie à part entière. Notre étude approfondie sur le déchargement du cache clé-valeur vers la mémoire flash , réalisée sur du matériel Dell et Solidigm, est la meilleure publication que nous ayons faite sur ce sujet.
Une machine capable de gérer sans problème une session d'agent de classe 30B peut généralement traiter quelques sessions parallèles via un serveur de traitement par lots avant que la latence ne se dégrade. La gestion de plusieurs dizaines de sous-agents simultanés nécessite un serveur doté d'une mémoire suffisante pour héberger de nombreux contextes actifs et d'un moteur de traitement comme vLLM, conçu pour le traitement par lots continu. Il existe également une limite de qualité, car la fiabilité des modèles locaux diminue déjà avec l'augmentation du nombre d'outils, et l'orchestration multiplie les outils et les transferts.
Selon nous, le traitement d'un seul agent ou de quelques agents constitue aujourd'hui une tâche légitime sur un poste de travail, tandis que la gestion de grands parcs de sous-agents relève de l'infrastructure. Cette frontière, ainsi que le matériel nécessaire pour la franchir, sont des sujets que nous prévoyons d'explorer plus en détail.


 Amazon