

Mise à jour du 2 octobre 2026 : La carte NetApp ajoute Novus — métadonnées pNFS séparées des nœuds de données AFF A90, disponibles dès maintenant — le Claims Tracker enregistre son affirmation de « stockage le plus rapide au monde » avec la projection Omdia à l’appui, et l’introduction du tracker distingue désormais la provenance auditée par les analystes des tests internes du fournisseur.
Tous les grands fournisseurs de solutions de stockage prétendent vendre la meilleure baie de stockage, et pendant des années, la vitesse était le seul critère de qualité. Presque aucun n'autorise les tests indépendants. Dell, Everpure (anciennement Pure Storage), VAST, Weka, IBM, NetApp et Huawei revendiquent tous le leadership en matière de performances, et la quasi-totalité des chiffres avancés proviennent de tests internes, assortis de la mention « les performances réelles peuvent varier ».
Cette page a pour but de clarifier la situation. Nous classons les données de performance de stockage en trois catégories et attribuons une étiquette à chaque chiffre : résultats de benchmarks audités (MLPerf Storage, IO500, SPC-1, où les fournisseurs soumettent leurs résultats selon des règles publiées), données fournies par les fournisseurs (fiches techniques et chiffres de lancement sans vérification indépendante) et résultats des tests effectués par StorageReview (systèmes que nous avons mesurés nous-mêmes). Lorsqu'un fournisseur refuse de nous autoriser à tester sa baie, nous le précisons ; l'absence de données vérifiables fait partie intégrante de la situation.
Les leaders du stockage IA
Ce sont les fournisseurs qui apparaissent lors de la création d'un cluster d'entraînement d'IA ou d'un néocloud. Nous ne les classons pas, car aucun critère unique n'a fait consensus. Nous fournissons toutefois à chacun les mêmes informations : la nature de la plateforme, son déploiement au nom d'un client, sa validation par NVIDIA, l'existence d'un résultat de benchmark audité et les performances annoncées qui restent à vérifier. Dès qu'un fournisseur fait l'objet d'une actualité concernant l'un de ces points, son profil est mis à jour.
Les quatre premiers sont des spécialistes du stockage natif à l'IA. Les autres sont des fournisseurs de solutions de stockage d'entreprise établis, proposant des gammes de produits d'IA. Les deux groupes obtiennent des déploiements concrets ; ils arrivent avec des niveaux de preuve très différents.
Données VAST
Plateforme : Système d’exploitation VAST AI, basé sur l’architecture DASE (Disaggregated, Shared-Everything). Des conteneurs de calcul sans état gèrent un pool de baies NVMe via NVMe-oF et offrent un espace de noms unique pour l’accès aux fichiers, aux objets et aux bases de données. Supports QLC avec tampon d’écriture de type mémoire de classe stockage.
Déploiements notables : CoreWeave, dans le cadre d’un accord pluriannuel de 1.17 milliard de dollars annoncé en novembre 2025, que VAST décrit comme son plus important client. VAST a également été intégré à l’extension xAI Colossus Frontier AI Factory et alimente les serveurs d’IA de Mistral Compute fonctionnant sur des cartes NVIDIA GB300 NVL72.
Validation NVIDIA : partenaire de lancement certifié NVIDIA Storage et validé pour DGX SuperPOD.
Résultat de l'audit : Aucun. VAST n'a jamais soumis de données à MLPerf Storage.
Affirmations publiques : VAST et AMD annoncent conjointement un temps d’obtention du premier jeton neuf fois plus rapide grâce au déchargement du cache KV sur Instinct, d’après des tests effectués par le fournisseur. La série F d’avril 2026, valorisée à 30 milliards de dollars, crée des attentes, mais ne reflète pas nécessairement les performances réelles.
Notre couverture de l'année écoulée :
- VAST et AMD annoncent un temps d'obtention du premier jeton neuf fois plus rapide grâce au déchargement du cache KV. (Jul 2026)
- Cloudera et VAST s'attaquent à la pénurie de GPU. (Jul 2026)
- VAST alimente les usines d'IA de Mistral Compute sur GB300 NVL72 (Mai 2026)
- VAST dévoile son système d'exploitation d'IA agentive (Février 2026)
- VAST Amplify vise à rendre les SSD existants 6 fois plus grands. (Jan 2026)
- VAST introduit une architecture d'inférence native DPU (Jan 2026)
WEKA
Plateforme : NeuralMesh, le système de fichiers parallèle défini par logiciel (anciennement WekaFS), commercialisé sous forme de logiciel et d’appliances WEKApod. NeuralMesh Axon intègre le même plan de données au sein des serveurs GPU, permettant ainsi aux disques NVMe locaux de rejoindre le cluster au lieu de rester inactifs.
Déploiements nommés : Nebius utilise NeuralMesh comme niveau premium de son cloud d’IA. Andromeda a standardisé son infrastructure sur NeuralMesh auprès d’une cinquantaine de fournisseurs de GPU en juillet 2026. WEKA fait également partie de l’architecture multi-fournisseurs de CoreWeave.
Validation NVIDIA : partenaire de lancement certifié NVIDIA Storage, avec les validations DGX SuperPOD et BasePOD.
Résultat audité : WEKA a été soumis à MLPerf Storage v1.0 en septembre 2024, mais pas à la v2.0 en août 2025. Ses chiffres audités les plus récents datent d’une génération.
Données non vérifiées : le WEKApod 3 avec NeuralMesh 6 est annoncé à 1.1 EB et 10.2 TB/s dans un seul rack. Ces chiffres proviennent du fournisseur et ne sont étayés par aucun audit.
Bon à savoir : HPE a mis fin à ses partenariats avec WEKA, Qumulo et Scality en novembre 2025 ; WEKA n’est donc plus disponible pour les acheteurs via le canal HPE.
Notre couverture de l'année écoulée :
- Andromeda standardise NeuralMesh auprès de plus de 50 fournisseurs de GPU (Jul 2026)
- WEKApod 3 franchit la barrière de l'exaoctet dans un seul rack (Jul 2026)
- NeuralMesh AIDP est désormais disponible pour tous. (Mar 2026)
- NeuralMesh s'intègre à NVIDIA STX pour la mémoire d'inférence (Mar 2026)
- Plateformes de nouvelle génération WEKApod Prime et Nitro (Nov 2025)
DDN
Plateforme : Deux lignes. EXAScaler, le système de fichiers parallèle dérivé de Lustre qui sous-tend les appliances AI400X3 et AI400X3M, gère l’entraînement. Infinia, une plateforme objet clé-valeur qui a intégré la mutualisation et la prise en charge POSIX dans la version 2.4, cible les charges de travail d’inférence et de production d’IA.
Déploiements notables : xAI Colossus, annoncé en novembre 2024 avec 200 000 GPU, sur EXAScaler et Infinia. DDN recense également de nombreuses installations de laboratoires nationaux et de calcul haute performance antérieures au cycle de l’IA.
Validation NVIDIA : partenaire de lancement certifié NVIDIA pour le stockage, avec validation DGX SuperPOD.
Résultat audité : Oui, et il est à jour. Sous MLPerf Storage v2.0, l’AI400X3 a maintenu un débit de 120.68 Go/s sur le réseau 3D U-Net à travers plusieurs nœuds et a géré les points de contrôle Llama3-8b à 30.6 Go/s en lecture et 15.3 Go/s en écriture depuis un boîtier 2U. D’après les résultats, DDN est le système le plus performant de cette liste.
Affirmations publiques : accélération du cache KV via NVIDIA Dynamo, validée conjointement avec Nebul plutôt que par un organisme indépendant.
Notre couverture de l'année écoulée :
- DDN lance l'AI400X3M à l'ISC 2026 (Juin 2026)
- Infinia 2.4 ajoute la prise en charge multi-locataire et POSIX (Jul 2026)
- DDN et Nebul valident l'accélération du cache KV (Jul 2026)
DDN a dominé MLPerf Storage v2.0 en termes de densité de performance, mais n'a pas participé à la phase v3.0.
Espace marteau
Plateforme : La plateforme de données globale Hammerspace, et son niveau 0, transforment les disques NVMe locaux déjà présents dans les serveurs GPU en une capacité partagée compatible avec les points de contrôle. Elle repose sur des standards, utilise le protocole NFS parallèle (NFS 4.2 avec FlexFiles) et s’exécute sur des serveurs classiques plutôt que sur un dispositif propriétaire. L’absence de boîtier Hammerspace visible est un atout majeur de cette architecture.
Déploiements nommés : Meta a documenté le déploiement de Hammerspace sur deux clusters H100 de 24 576 GPU sur son propre blog technique. Il s’agit du compte rendu le plus précis, provenant d’un opérateur et non du fournisseur, d’un déploiement de stockage IA à grande échelle présenté sur cette page.
Validation NVIDIA : Aucune. Hammerspace ne possède aucune certification DGX SuperPOD, DGX BasePOD, architecture de référence NCP ni désignation de stockage certifié NVIDIA.
Résultat audité : Oui, pour MLPerf Storage v1.0 et v2.0. En v2.0, le niveau 0 a atteint 420.8 Go/s sur le réseau 3D U-Net, réparti sur cinq nœuds avec un taux d’utilisation de l’accélérateur de 96.4 %, alimentant 140 H100 simulés. Hammerspace présente le meilleur taux de participation auditée de cette liste et le taux de validation NVIDIA le plus faible, contrairement à la quasi-totalité des autres acteurs.
Notre couverture : Hammerspace n'a pas été testé par StorageReview, et notre couverture récente est limitée. Il s'agit d'une lacune de notre part, et non d'un reproche envers la plateforme.
Hammerspace, un participant à la version 2.0, n'a pas non plus participé à la phase 3.0.
Dell Technologies
Plateforme : Trois éléments, destinés à différentes étapes du processus. PowerScale est la gamme NAS à extension horizontale, avec des nœuds 3 % flash de la série F. ObjectScale est la couche S3, qui a pris le relais de RDMA et du déchargement du cache KV en 2026. Lightning File System est un nouveau système de fichiers parallèle disponible depuis avril 2026 et qui représente la solution de Dell face à DDN, VAST et WEKA.
Déploiements nommés : Nous n’avons pas pu confirmer de déploiement d’entraînement d’IA à grande échelle sur le stockage Dell. La référence publique la plus concrète est Subaru, qui exploite un laboratoire d’IA pour la sécurité des conducteurs sur PowerScale. Pour un fournisseur de cette envergure, cela représente un écart important par rapport aux succès annoncés par les fournisseurs de solutions néo-cloud spécialisés en IA.
Validation NVIDIA : partenaire de lancement certifié NVIDIA Storage, et PowerScale a obtenu la certification du programme NVIDIA Cloud Partner en juillet 2025.
Résultat de l'audit : Aucun. Dell n'a jamais soumis de données à MLPerf Storage.
Affirmations publiques : Dell présente Lightning comme le système de fichiers parallèle le plus rapide au monde, s’appuyant sur des analyses internes, et annonce un stockage exascale avec des débits de plusieurs téraoctets par seconde par rack. Ces informations figurent dans le tableau de suivi des affirmations ci-dessous. Un point important à noter pour les acheteurs : Lightning est disponible pour tous, mais son déploiement est limité aux configurations d’usine dédiées à l’IA, et la plupart des clients ne le verront pas dans un devis standard.
Notre couverture de l'année écoulée :
- Dell conserve sa position de leader dans le Magic Quadrant 2026 de Gartner pour le stockage d'entreprise (Août 2026)
- ObjectScale atteint 9.83 Po dans un format 2U avec 245 To de SSD Kioxia et S3 via RDMA. (Août 2026)
- Dell surpasse les ventes cumulées des cinq premiers fabricants du classement IDC en matière de stockage externe au premier trimestre. (Jul 2026)
- Réinitialisation de PowerStore Gen 3 (Mai 2026)
- Analyse approfondie de PowerStoreOS 5.0, la partie logicielle de la réinitialisation de la Gen 3 (Sep 2026)
- Système de fichiers Lightning et stockage exascale à la GTC 2026 (Mar 2026)
- Notre test du PowerEdge R5715, un serveur 2U axé sur le stockage que nous avons testé en conditions réelles. (Mar 2026)
HPE
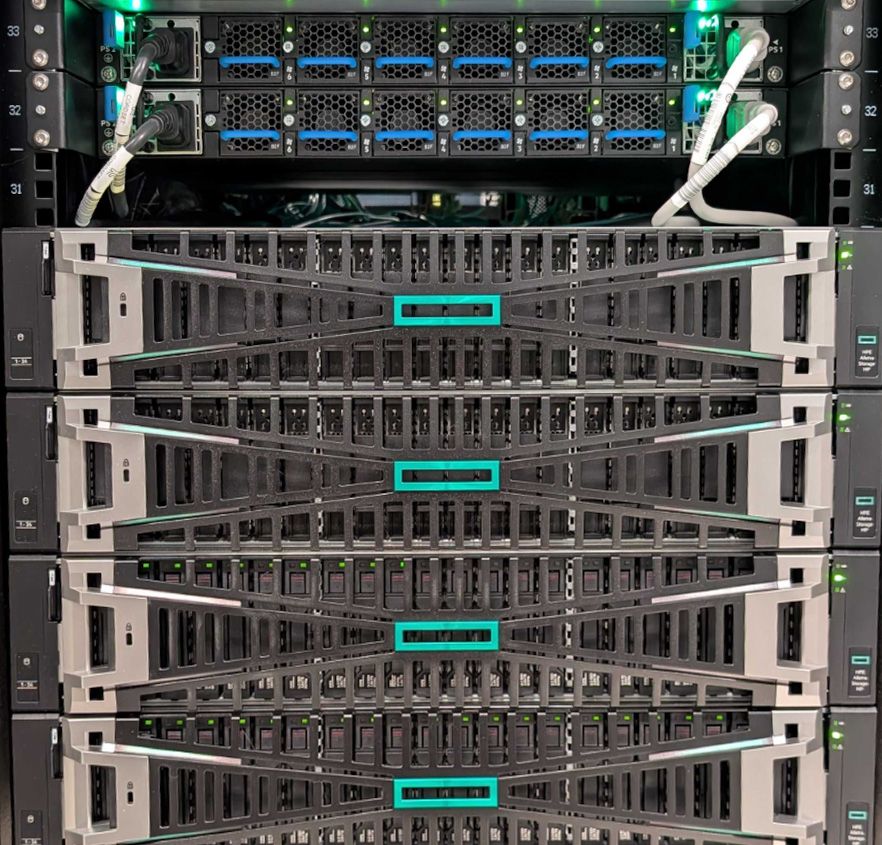
Plateforme : Alletra Storage MP, déclinée en B10000 pour le stockage bloc et X10000 pour le stockage objet, et GreenLake pour le stockage fichier. HPE commercialise également les solutions de calcul et de réseau associées, qui constituent la majeure partie de son offre de stockage IA.
Déploiements nommés : configurations Sovereign AI et AI Factory où HPE fournit l’ensemble de la pile technologique. Aucun déploiement NeoCloud nommé comparable aux exemples VAST, WEKA ou DDN mentionnés ci-dessus.
Validation NVIDIA : partenaire de lancement certifié NVIDIA Storage, avec les validations DGX BasePOD et SuperPOD.
Résultat audité : HPE a figuré dans tous les classements MLPerf Storage, de la version 1.0 à la version 3.0, devançant ainsi Dell et NetApp en termes de participation. Attention toutefois aux résultats concernant les fichiers : les meilleurs résultats de HPE en matière d’IA pour les fichiers proviennent de soumissions conjointes avec WEKA. Or, HPE a mis fin à ce partenariat, ainsi qu’à ceux de Qumulo et Scality, en novembre 2025. Ces résultats ne correspondent donc plus à un produit commercialisé par HPE aujourd’hui.
Notre couverture de l'année écoulée : Nous avons testé la plateforme Alletra en conditions réelles.
- HPE conserve sa position de leader dans le Magic Quadrant 2026 de Gartner pour le stockage d'entreprise (Août 2026)
- Tests pratiques du système de stockage Alletra MP B10000 avec NIST CSF 2.0 (Juin 2026)
- Alletra Storage MP X10000 avec le nœud Data Protection Accelerator (Février 2026)
- CloudCasa ajoute une reprise après sinistre Kubernetes pour le B10000 (Juin 2026)
- MLPerf Storage v3.0 : 345.8 Gio/s sur 3D U-Net avec le K3000, l’un des deux seuls fournisseurs de cette page à avoir soumis ce cycle.
IBM
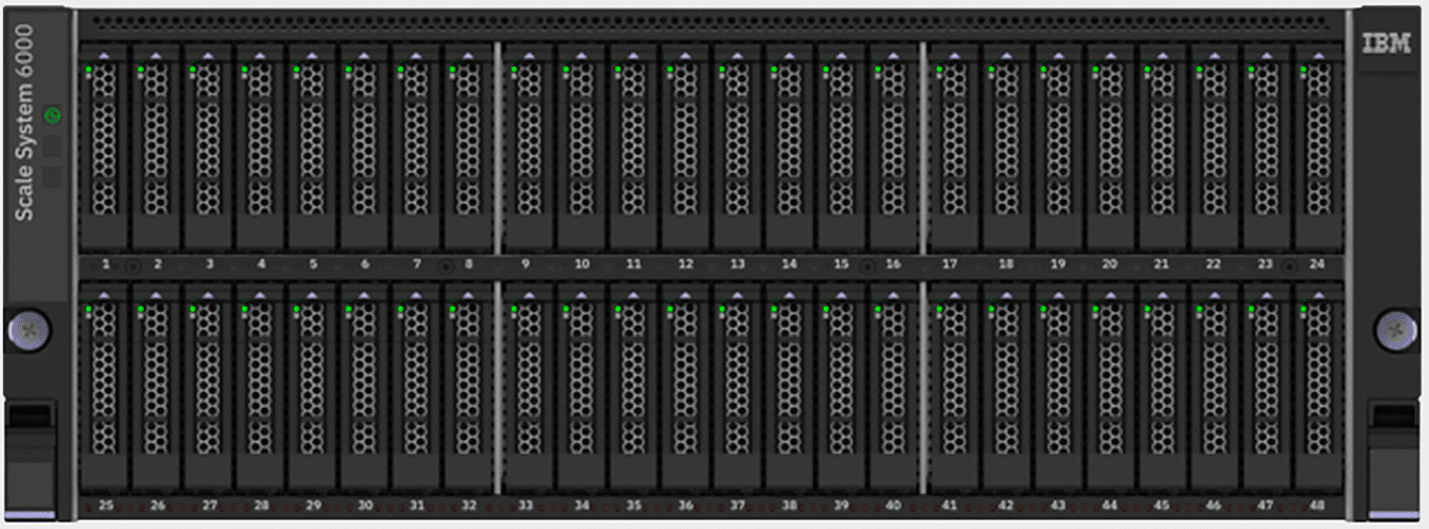
Plateforme : IBM Storage Scale, le système de fichiers parallèle issu de la lignée GPFS, vendu sous forme de logiciel et sous forme d’appliances Storage Scale System, avec Fusion l’intégrant pour Kubernetes et les pipelines d’IA.
Déploiements nommés : Ils font partie de l’architecture multi-fournisseurs de CoreWeave. IBM Cloud construit également, en partenariat avec Together AI, un cluster d’inférence HGX B300 dédié de 240 millions de dollars, annoncé pour août 2026 ; toutefois, la couche de stockage n’a pas été divulguée.
Validation NVIDIA : partenaire de lancement certifié NVIDIA pour le stockage.
Résultat audité : Oui, dans MLPerf Storage v2.0, y compris la charge de travail de création de points de contrôle, où Storage Scale a enregistré une vitesse de lecture de 656.7 Gio/s sur un modèle Llama 3.1 de 1 To. La restauration des points de contrôle est la métrique qui détermine la part d'une session d'entraînement Frontier perdue suite à une panne, et très peu de fournisseurs ont publié de données auditées à ce sujet.
Performances annoncées : Aucune performance exceptionnelle dans la catégorie des baies les plus rapides. IBM met en avant l’évolutivité et l’intégration de Storage Scale plutôt qu’un débit record.
Notre couverture de l'année écoulée :
- IBM conserve sa position de leader dans le Magic Quadrant 2026 de Gartner pour le stockage d'entreprise (Août 2026)
- IBM et Together AI ont investi 240 millions de dollars dans un cluster d'inférence HGX B300 dédié. (Août 2026)
- IBM introduit le stockage prenant en compte le contenu pour les charges de travail RAG (Apr 2026)
- Système Flash de nouvelle génération avec IA agentive (Février 2026)
- Système de stockage Scale System 6000, stockage unifié pour l'IA et le HPC (Nov 2025)
- Notre test du système IBM FlashSystem 5300, une prise en main de la baie compacte d'IBM et un aperçu utile du comportement des systèmes plus grands (Sep 2024)
Everpure (anciennement Pure Storage)
Plateforme : FlashBlade//EXA est la solution IA, séparant les métadonnées et les chemins de données pour une mise à l’échelle indépendante du plan de données. FlashBlade//S et FlashArray couvrent le reste. Everpure conçoit ses propres modules DirectFlash au lieu d’acheter des SSD finis, ce qui explique pourquoi ses performances en termes de densité et d’endurance ne suivent pas celles du marché. La société est devenue légalement Everpure le 23 février 2026.
Déploiements nommés : Ils font partie de l’architecture multi-fournisseurs de CoreWeave. Nous n’avons pas pu confirmer de déploiement nommé pour l’entraînement de l’IA sur FlashBlade//EXA en particulier.
Validation NVIDIA : partenaire de lancement certifié NVIDIA pour le stockage.
Résultat audité : MLPerf Storage v3.0 (septembre 2026), première soumission d'Everpure : 877.5 Gio/s en écriture de points de contrôle et 833.0 Gio/s en lecture sur 30 nœuds de données FlashBlade//EXA, soit les meilleurs scores de points de contrôle de la session, ainsi que le meilleur résultat de cache KV de la session à 1 623,4 Gio/s. Ce résultat détient également le record SPECstorage Solution 2020_ai_image avec 6 300 tâches d'IA (publié le 17 février 2026). Bien qu'il s'agisse d'un benchmark et d'un modèle de charge de travail différents, c'est une véritable soumission réalisée selon un règlement publié et après un processus d'évaluation. Ce résultat est donc pris en compte.
Affirmations publiques : FlashBlade//EXA est présenté comme la plateforme de stockage de données la plus performante du marché, avec un débit projeté supérieur à 10 To/s dans un seul espace de noms. Ce débit est projeté et non mesuré.
Notre couverture de l'année écoulée :
- Everpure domine les deux axes du Magic Quadrant 2026 de Gartner pour la deuxième année consécutive (Août 2026)
- Everpure lance Data Stream pour les pipelines d'IA d'entreprise (Juin 2026)
- Améliorations apportées à l'intelligence des données et au cloud de données d'entreprise (Juin 2026)
- Test de la carte Emulex SecureHBA avec l'Everpure XL130 R5 : il ne s'agit pas d'un test d'intelligence artificielle, mais d'une prise en main du matériel Everpure. (Mar 2026)
- MLPerf Storage v3.0 (septembre 2026) : première soumission, écriture de point de contrôle de 877.5 Gio/s et lecture de 833 Gio/s sur FlashBlade//EXA, plus lecture du cache KV de 1 623 Gio/s, les plus grands nombres de points de contrôle et d'inférences du tour. Couverture complète de la version 3.0.
NetApp
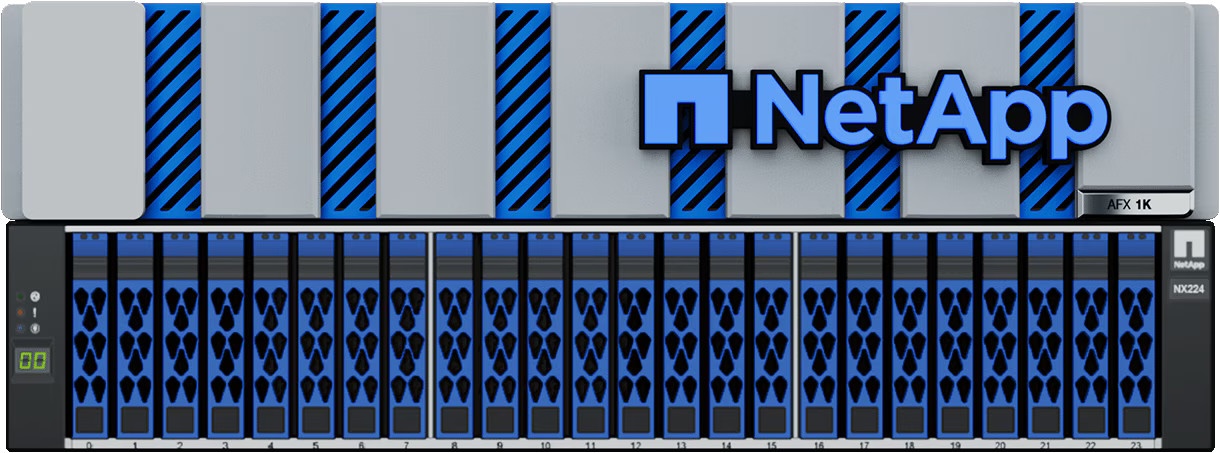
Plateforme : AFX, annoncée en octobre 2025, est une architecture ONTAP 100 % flash désagrégée, conçue pour les pipelines de données d’IA, avec le moteur de données d’IA intégré. AIPod est la conception de référence validée par NVIDIA. Novus, annoncée lors d’INSIGHT 2026 et disponible à la commande dès maintenant, se positionne au-dessus d’AFX pour les usines d’IA : les métadonnées pNFS sont transférées vers des nœuds Data Director exécutés sur des serveurs Supermicro compatibles, tandis que des paires AFF A90 HA transportent les données. Les clients utilisent pNFS Linux standard, sans agent propriétaire sur les serveurs GPU.
Déploiements nommés : aucun à l’échelle de l’entraînement de l’IA n’a pu être confirmé. Les éléments publics les plus probants sont des architectures validées plutôt que des noms de clients, notamment les conceptions FlexPod AI avec Cisco datant de juin 2026.
Validation NVIDIA : partenaire de lancement certifié NVIDIA pour le stockage, avec la certification DGX SuperPOD.
Résultat de l'audit : aucun résultat sur MLPerf Storage, plateforme dans laquelle NetApp n'a jamais participé. Concernant Novus, NetApp cite un test audité par Omdia démontrant une mise à l'échelle quasi linéaire lorsque des clusters ONTAP sont intégrés dans un même espace de noms ; le débit annoncé de 100 To/s est une modélisation réalisée par Omdia à partir de ce test, et non un résultat mesuré.
Notre couverture de l'année écoulée :
- Novus sépare les métadonnées pNFS des nœuds de données AFF A90, visant un débit de 100 To/s (Oct 2026)
- NetApp conserve sa position de leader dans le Magic Quadrant 2026 de Gartner pour le stockage d'entreprise (Août 2026)
- HCLTech associe Keystone à U4X pour le stockage IA basé sur la consommation (Août 2026)
- NetApp acquiert DataPelago pour le traitement de données GPU (Jul 2026)
- StorageGRID 12.1 ajoute un espace de noms fédéré et jusqu'à 12 To/s (Juin 2026)
- FlexPod a validé des architectures d'IA avec Cisco (Juin 2026)
- Le lancement d'AFX (Oct 2025)
Note concernant Huawei
Huawei a enregistré le débit absolu le plus élevé sur MLPerf Storage v2.0, soit 698 Gio/s sur un réseau 3D U-Net, grâce à un système OceanStor A800 à double nœud de 8U alimentant 255 serveurs H100 simulés. Ce résultat figure dans le tableau audité ci-dessous. Nous ne l'avons pas inclus dans les profils des leaders car son acquisition n'est pas envisageable pour les acheteurs aux États-Unis, en Europe et sur la plupart des marchés couverts par cette page. Le chiffre est exact, mais la disponibilité est incertaine. Le Magic Quadrant de Gartner 2026 établit le même équilibre, mais dans l'autre sens, en maintenant Huawei dans son quadrant des leaders grâce à la performance d'OceanStor hors Amérique du Nord.
Ce que disent les analystes
Le positionnement des analystes constitue une catégorie de preuves à part entière : non pas un audit de performance, mais une évaluation indépendante de l’exécution et de la vision, plus proche des critères d’achat réels de ces systèmes. Dans le Magic Quadrant 2026 de Gartner pour les plateformes de stockage d’entreprise , les six mêmes fournisseurs occupent le quadrant des leaders que l’année précédente : Everpure, Huawei, HPE, NetApp, Dell et IBM. Everpure se distingue par sa capacité d’exécution et sa vision, la plus aboutie pour la deuxième année consécutive. Deux points importants sont à souligner. Gartner évalue le marché du stockage principal et suit le segment des solutions de stockage de fichiers et d’objets hautes performances dans une étude distincte. C’est dans ce segment que se situent les spécialistes de l’IA mentionnés précédemment. Leur absence du Quadrant relève donc d’une limite de catégorie, et non d’un jugement de valeur. Enfin, lorsque six des huit fournisseurs évalués obtiennent le label de leader, ce label en lui-même est peu informatif pour les acheteurs ; ce sont les positions relatives des fournisseurs qui sont significatives.
Qu'est-ce qui pourrait changer cette liste ?
Quatre éléments, classés par ordre d'importance : un fournisseur nous donne accès à sa plateforme pour la tester selon notre méthodologie, qu'il s'agisse de matériel hébergé sur place ou d'un déploiement plus important ; un fournisseur soumet sa plateforme à un audit en cours, comme MLPerf Storage ou SPECstorage ; un opérateur, et non un fournisseur, documente un déploiement, à l'instar de Meta avec Hammerspace ; ou un fournisseur perd une certification ou un partenariat essentiel à son positionnement actuel, comme ce fut le cas lors de la scission entre WEKA et HPE, qui a modifié la manière dont les deux entreprises abordent les acheteurs d'IA. Nous mettons à jour les profils en fonction de ces événements.
Ce que révèlent réellement les indicateurs de référence audités
En 2026, la course aux performances de stockage se jouera principalement sur le domaine de l'entraînement des IA et des fournisseurs de néocloud qui le prennent en charge. Ce segment est le seul à disposer d'un benchmark fiable et audité : MLCommons MLPerf Storage. La version actuelle, la v3.0 (septembre 2026), a été publiée et compte 19 organisations participantes et 143 résultats. Pour la première fois, ce benchmark couvre l'intégralité du pipeline d'IA : débit d'entraînement, sauvegarde des données et deux nouveaux tests d'inférence (base de données vectorielle et cache clé-valeur), ainsi que la prise en charge du stockage d'objets S3, utilisé par environ un sixième des participants. La v3.0 ayant déplacé ses accélérateurs simulés de H100 vers B200, les résultats ne sont pas comparables à ceux des versions précédentes. MLPerf Storage ne désigne pas de vainqueur unique ; différents systèmes excellent sur différentes charges de travail et selon différentes métriques.
| Système | Résultat vérifié (MLPerf Storage v3.0) | Classe |
|---|---|---|
| Lame Flash Everpure//EXA | Écriture de points de contrôle à 877.5 Gio/s et lecture à 833 Gio/s sur 30 nœuds de données ; lecture du cache KV à 1 623 Gio/s | Responsable du point de contrôle et de l'inférence |
| YanRongTech F9000X | 543.9 Gio/s sur le réseau U-Net 3D alimentant 99 accélérateurs B200 simulés | Débit de formation le plus élevé soumis |
| TuringData F9200 | 541.5 Gio/s sur le réseau 3D U-Net à partir de trois nœuds de stockage ; Checkpoint-70B à 539.9 Gio/s en lecture et 307.1 Gio/s en écriture | nouveau venu en matière de densité de performance |
| Azure Managed Lustre | Écriture de point de contrôle à 642.2 Gio/s à partir d'un déploiement cloud géré de 4 096 Tio | Premier service cloud hyperscale soumis |
| NVIDIA AIStore | 20 soumissions via le stockage d'objets S3 sur OCI, AWS et GCP | Stockage d'objets dans le territoire des systèmes de fichiers parallèles |
Du côté du calcul haute performance (HPC), la liste IO500 (édition ISC 2026) est dominée par Sugon ParaStor (SCNet) avec une bande passante mesurée de 26 888 Gio/s sur 500 nœuds clients. Les systèmes Intel DAOS (Argonne Aurora, LRZ) occupent plusieurs places de tête, et Weka est présent via Samsung SSC-24. Le renouvellement des fournisseurs de stockage v3.0 est aussi important que les chiffres : les leaders du débit v2.0 (DDN, Huawei, Hammerspace et Lightbits) sont absents cette année, tandis que 11 nouveaux participants font leur apparition, dont Azure et NVIDIA. Retrouvez l’analyse complète dans notre dossier MLPerf Storage v3.0.
Qui alimente réellement les Néoclouds ?
Les succès de déploiement ne constituent pas des indicateurs de performance, mais témoignent concrètement des choix des opérateurs lorsque la performance est leur priorité. Il est important de noter que les plus grandes plateformes d'IA sont multi-fournisseurs ; aucune entreprise de stockage ne possède l'intégralité de ces sites.
| IA Cloud | Stockage | DÉTAILS |
|---|---|---|
| CoreWeave | VAST Data (avec WEKA, DDN, IBM Storage Scale et Everpure dans la pile) | Accord pluriannuel de 1.17 milliard de dollars, novembre 2025, le plus gros client de VAST |
| xAI Colosse | DDN EXAScaler et Infinia, avec VAST Data ajouté dans l'extension Frontier AI Factory | DDN a annoncé en novembre 2024 un objectif de 100 000 GPU ; compatibilité multi-fournisseurs prévue fin 2025 |
| Nébius | WEKA NeuralMesh | Niveau Premium de Nebius AI Cloud, annoncé en juin 2025 |
| Ensemble IA | IBM Cloud (systèmes HGX B300) | Un accord de 240 millions de dollars a été annoncé en août 2026 ; la couche de stockage n'a pas encore été divulguée. |
Le traqueur de réclamations
Voici les performances annoncées les plus rapides dans le secteur du stockage IA. Aucune n'a été vérifiée indépendamment à l'échelle annoncée ; la plupart sont mentionnées en note de bas de page par leurs fournisseurs comme étant issues de tests internes, et la source la plus fiable du tableau est un test audité par un analyste, à l'origine d'un titre accrocheur.
| Réclamation du fournisseur | Numéro | Statut |
|---|---|---|
| Everpure FlashBlade//EXA, « la plateforme de stockage de données la plus performante du secteur » (mars 2025) | Lectures projetées de plus de 10 To/s dans un seul espace de noms | Prévisions du fournisseur; aucune soumission auditée |
| Système de fichiers Dell Lightning, « le système de fichiers parallèle le plus rapide au monde » (disponibilité générale en avril 2026) | Jusqu'à 150 Go/s par unité de rack, selon une analyse interne de Dell | Déclaration du fournisseur ; aucune soumission vérifiée |
| Stockage exascale Dell (GTC 2026) | Jusqu'à 6 To/s par rack | Déclaration du fournisseur ; aucune soumission vérifiée |
| Huawei OceanStor Dorado nouvelle génération (septembre 2024) | Capacité maximale de 100 millions d'IOPS selon les spécifications, avec une latence de 0.03 ms. | Spécifications du fournisseur ; un test Omdia commandé par Huawei a mesuré 2.58 millions d’IOPS soutenues à 70 microsecondes sur une charge de travail Oracle RAC réelle, une vérification concrète utile des valeurs maximales indiquées dans les fiches techniques. |
| WEKA, WEKApod 3 avec NeuralMesh 6, annonce d'une capacité exaoctet sur un seul rack (juillet 2026) | 1.1 EB et 10.2 To/s dans un seul rack | Déclaration du fournisseur : WEKA a été soumis pour la dernière fois à MLPerf Storage dans la version 1.0 et a été ignoré dans la version 2.0. |
| VAST Data et AMD, déchargement du cache KV sur Instinct (juillet 2026) | Délai d'obtention du premier jeton 9 fois plus rapide | Tests conjoints avec les fournisseurs ; VAST n'a jamais été soumis à MLPerf Storage |
| Accélération du cache KV avec DDN et Nebul grâce à NVIDIA Dynamo (juillet 2026) | Accélération annoncée par le fournisseur pour les charges de travail d'inférence | Validation par un partenaire, et non audit indépendant ; DDN dispose de résultats MLPerf Storage v2.0 à jour |
| NetApp Novus, « le stockage le plus rapide au monde » (octobre 2026) | Débit de lecture séquentielle projeté de 100 To/s sur un seul espace de noms pNFS | Mise à l'échelle quasi linéaire vérifiée par Omdia sur un cluster plus petit ; le chiffre de 100 To/s est une projection d'Omdia issue de ce test, et non une mesure. |
Qu'est-il arrivé à SPC-1 ?
La norme SPC-1 était la référence du secteur en matière de stockage par blocs, mais elle est aujourd'hui en sommeil : les fournisseurs américains l'ont quasiment abandonnée vers 2018, laissant le marché dominé par les fournisseurs chinois. Le record actuellement reconnu n'est pas le résultat de Huawei, pourtant souvent cité. ExponTech WDS V3 détient le meilleur score reconnu avec 27.2 millions d'IOPS SPC-1 (validé en novembre 2023), devant Inspur et ses 23.0 millions. Le fameux score de Huawei, à 21.0 millions en 2020, occupe désormais la quatrième place. Une soumission FlashNexus plus élevée, à 30.0 millions d'IOPS, est en attente de validation depuis février 2025 et ne sera considérée comme un record que lorsque le Storage Performance Council l'aura validée.
Comment fonctionne cette page
Trois règles. Premièrement, chaque chiffre est accompagné de sa source de preuve : soumission auditée, affirmation du fournisseur ou mesure StorageReview. Deuxièmement, nous ne reprenons pas les superlatifs dont nous ne pouvons pas vérifier les données actuelles ; plusieurs affirmations de « plus rapide » figurant sur cette page datent de plusieurs années et sont signalées comme telles. Troisièmement, tout fournisseur peut figurer sur la partie vérifiée de cette page : soumettez vos données à MLPerf Storage ou IO500, ou autorisez-nous à effectuer des tests selon notre méthodologie standard. Cette page traite uniquement du stockage IA et néocloud. Le stockage bloc et fichier pour entreprises et le stockage pour PME font l’objet de pages distinctes, car les preuves disponibles diffèrent pour chaque segment. Nous mettons à jour les profils des leaders au fur et à mesure des actualités et effectuons une vérification complète lors de la publication d’un nouveau cycle d’audit.
FAQ sur le stockage le plus rapide
Quel est le système de stockage le plus rapide au monde ?
Il n'existe pas de réponse unique et vérifiée, et toute personne qui en donne une ne fait que citer un fournisseur. D'après les données auditées de septembre 2026 : le FlashBlade//EXA d'Everpure a enregistré le meilleur score de point de contrôle MLPerf Storage v3.0 avec 877.5 Gio/s en écriture ; le F9000X de YanRongTech a dominé le débit d'entraînement avec 543.9 Gio/s ; le ParaStor de Sugon est en tête du classement de bande passante IO500 ; et ExponTech détient le record d'IOPS SPC-1 reconnu. Les chiffres les plus élevés annoncés, y compris les projections de Dell concernant le stockage exascale par rack, restent à ce jour non vérifiés de manière indépendante.
Quel est le stockage le plus rapide pour l'entraînement de l'IA ?
D'après MLPerf Storage v3.0, le seul benchmark audité de stockage IA, YanRongTech, TuringData et UBIX se distinguent par leur débit d'entraînement, tandis qu'Everpure domine la création de points de contrôle et l'inférence de caches KV et qu'Azure est le service cloud le plus performant. Si l'on considère les solutions déployées par les principaux opérateurs d'IA, VAST, DDN et WEKA dominent le marché du néocloud, bien qu'aucune des trois n'ait été soumise à MLPerf Storage v3.0. Ces deux types de données sont présentés ci-dessus, avec la mention correspondante.
Pourquoi existe-t-il si peu de tests de performance indépendants pour les baies de stockage d'entreprise ?
La plupart des fournisseurs de stockage d'entreprise interdisent contractuellement la publication des résultats de benchmarks, et les principaux fabricants de baies ont abandonné les benchmarks publics qu'ils utilisaient auparavant, notamment SPC-1, vers 2018. Les fournisseurs de solutions d'IA ont partiellement inversé la tendance, la participation à MLPerf Storage étant devenue une condition de vente. Cette page est mise à jour au fur et à mesure de la publication de nouveaux résultats audités.
Le chiffrement résistant à l'informatique quantique doit-il être pris en compte lors de l'achat d'un système de stockage d'images ?
Pour les secteurs réglementés, oui, et les échéances sont plus proches qu'il n'y paraît. La directive CNSA 2.0 de la NSA exige que les nouvelles installations du Système national de sécurité (NSS) soient conformes d'ici janvier 2027, avec la mise hors service des systèmes non conformes d'ici fin 2030. Par ailleurs, les cadres réglementaires NIS2 et DORA de l'UE imposent leurs propres exigences en matière de chiffrement. La norme FC-SP-3, une fois finalisée, transforme cette exigence en une simple formalité d'achat plutôt qu'en un projet : les cartes HBA compatibles FC-SP-3 chiffrent le trafic SAN en transit à débit maximal grâce à des algorithmes post-quantiques. Le chiffrement s'effectuant au niveau de la couche transport, la baie de serveurs reçoit des données qu'elle peut compresser, dédupliquer et analyser afin de détecter les anomalies liées aux ransomwares, anomalies que le chiffrement au niveau applicatif des services ne parvient pas à contourner. Spécifier la connectivité FC-SP-3 lors des renouvellements réguliers (tous les trois à cinq ans) permet d'obtenir un SAN entièrement chiffré d'ici 2030. Côté matériel, les équipements sont déjà disponibles sur le segment milieu de gamme : chaque Dell PowerStore Gen 3 est équipé de cartes Fibre Channel compatibles EDIF dans ses emplacements OCP. Dell prévoit d'intégrer le chiffrement du réseau via une mise à jour logicielle non intrusive PowerStoreOS 5.1, comme détaillé dans notre analyse approfondie de PowerStoreOS 5.0 . Notre analyse approfondie de FC-SP3 couvre la norme, les échéances et les modèles de déploiement.


 Amazon