

Lors de son événement Advancing AI à San José, AMD a dévoilé la série Instinct MI350, sa dernière génération de GPU, ainsi qu'une feuille de route ambitieuse pour les futures plateformes d'accélération de l'IA. Basée sur l'architecture avancée CDNA4, la série MI350 promet des gains de performances substantiels pour les charges de travail d'IA exigeantes. Cette annonce comprenait également un aperçu de la future gamme Instinct, soulignant l'engagement d'AMD en faveur de l'innovation continue dans le domaine du matériel d'IA.
Série AMD Instinct MI350
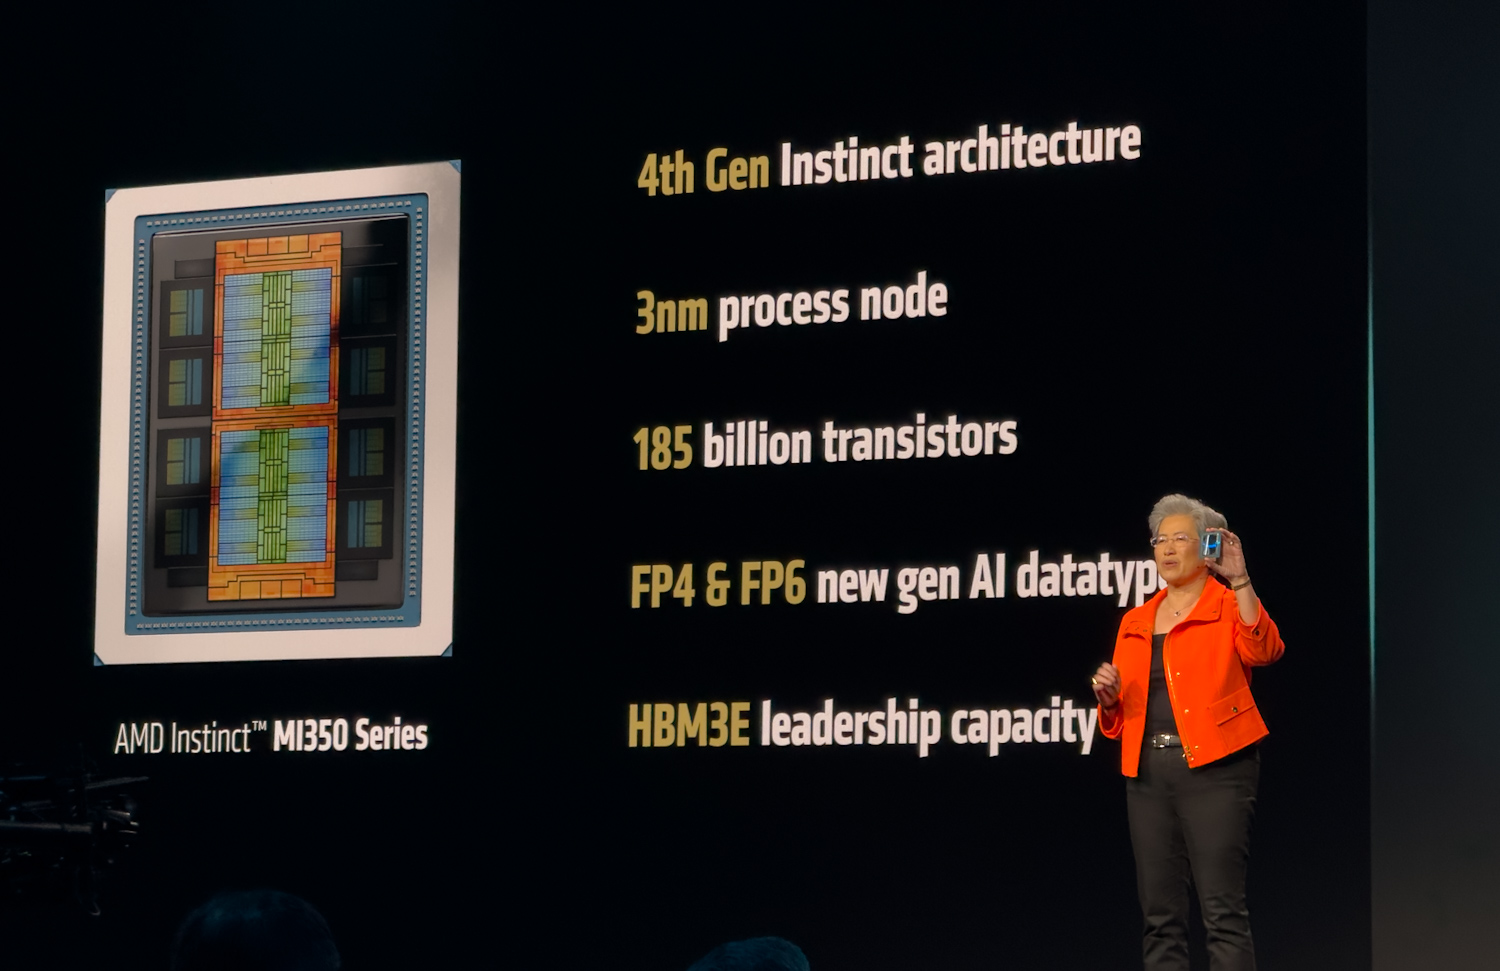
La gamme AMD Instinct MI350 , basée sur la nouvelle architecture CDNA4, représente une avancée majeure dans le domaine du calcul IA. Spécialement conçue pour les charges de travail d'IA, l'architecture CDNA4 introduit des moteurs matriciels améliorés, la prise en charge de nouveaux formats de données et des gains significatifs en matière d'efficacité énergétique.
Architecture avancée de packaging et de chiplet : les fondements du MI350
La série MI350 s'appuie sur la technologie avancée de packaging de puces 3D d'AMD, évoluant à partir de la série MI300 avec des améliorations clés.
Conception et fabrication de chiplets
Le GPU est composé de huit Accelerator Compute Chiplets (XCD), principaux moteurs de calcul. Ces XCD sont fabriqués selon un procédé avancé de gravure 3 nm Node 3+, une amélioration par rapport à la technologie 5 nm utilisée dans la série MI300, contribuant ainsi significativement à une meilleure efficacité énergétique. Chaque XCD intègre quatre moteurs de shader, chacun contenant huit unités de calcul CDNA4 actives, soit 32 unités de calcul par XCD et un total de 256 unités de calcul pour l'accélérateur.

Les XCD sont complétés par deux matrices d'E/S (IOD), une réduction par rapport aux quatre IOD de la série MI300. Fabriquées selon un procédé de 6 nm, ces IOD gèrent l'accès mémoire, les opérations d'E/S et la communication entre puces. Cette conception simplifiée à deux IOD, combinée à des interconnexions internes plus larges, permet de maintenir les objectifs de bande passante tout en réduisant la consommation d'énergie.
Intégration physique et unité logique
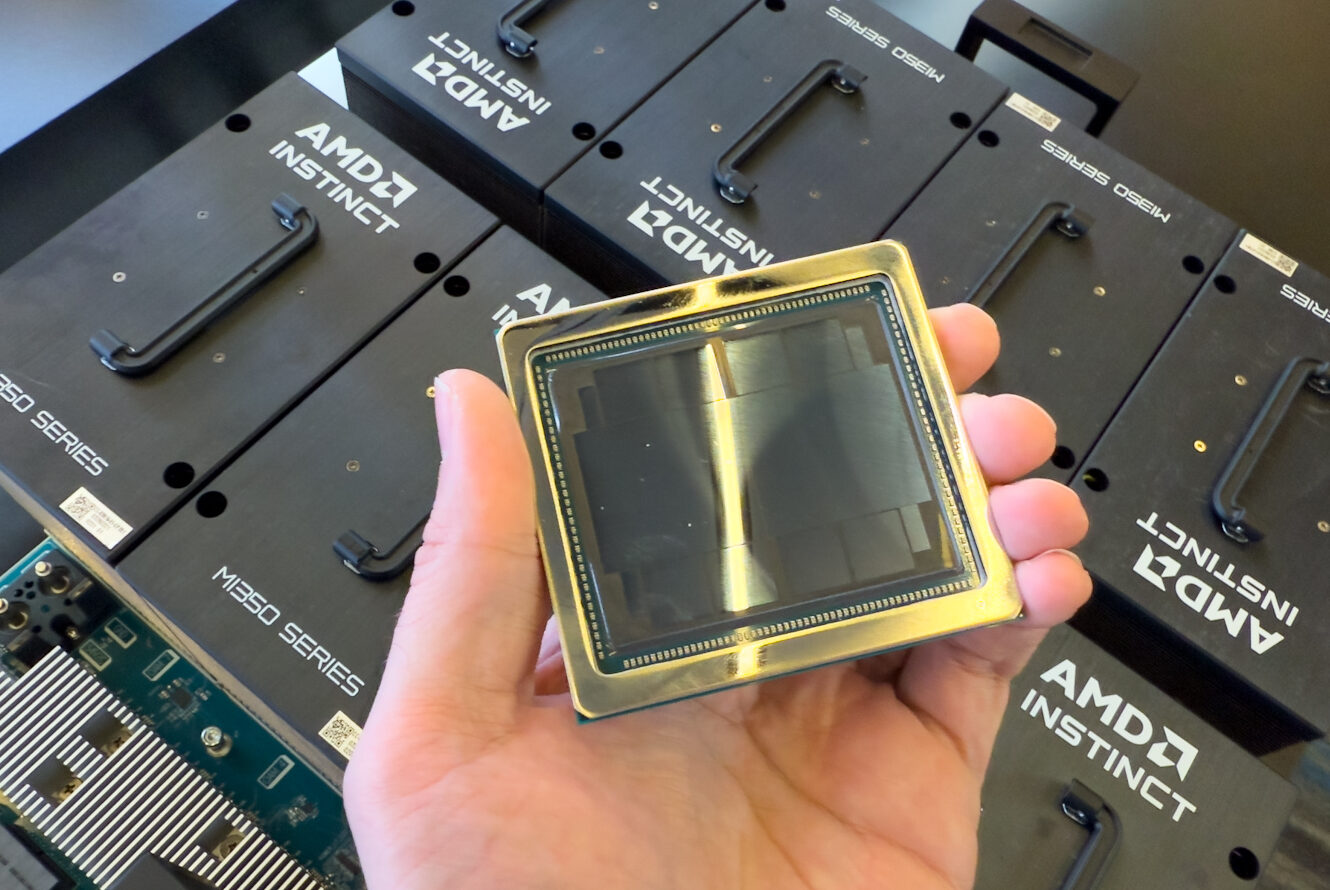
L'assemblage physique implique le montage des XCD et des piles mémoire HBM3E sur un interposeur de type puce sur wafer sur substrat (COOS). Un aspect essentiel de cette conception est la liaison hybride des XCD aux IOD situés en dessous. Cette technique de liaison hybride 3D crée des interconnexions exceptionnellement denses et à large bande passante entre les puces de calcul et d'E/S, dépassant largement les constructions 2.5D traditionnelles, ce qui est essentiel pour alimenter efficacement les XCD, gourmands en énergie. De plus, cette intégration 3D avancée contribue à réduire l'empreinte globale du GPU, ce qui peut améliorer le rendement de fabrication et la fiabilité opérationnelle.
Malgré la complexité de sa construction en chiplets, le MI350 fonctionne logiquement comme un GPU unique et unifié. Chaque XCD constitue un complexe de calcul accéléré, doté de ressources globales, dont un processeur de commandes et un cache L4 de 2 Mo.
Sous-système de mémoire amélioré
Pour alimenter efficacement les puissants cœurs CDNA4, la série MI350 intègre un sous-système mémoire considérablement amélioré. Elle est équipée de huit piles de mémoire HBM3E, offrant une capacité totale de 288 Go par GPU. Chaque pile de 36 Go, composée de 12 périphériques 24 Gbit/s, fonctionne à la vitesse maximale de 3 Gbit/s par broche HBM8E.
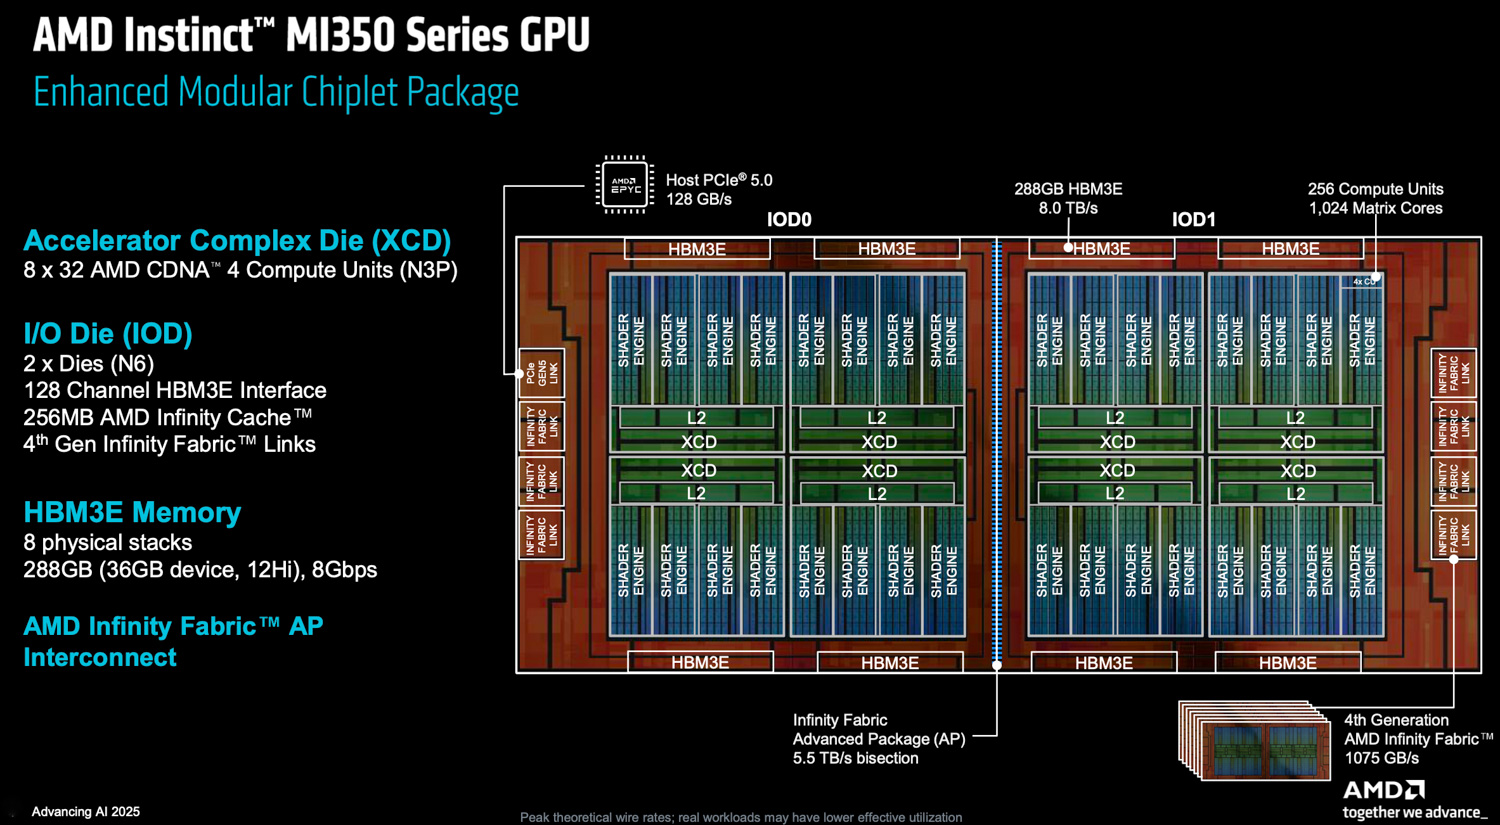
L'architecture conserve également l'Infinity Cache d'AMD, un cache mémoire crucial situé entre le HBM et les caches Infinity Fabric/L2. Ce cache comprend 128 canaux, chacun soutenu par 2 Mo de cache, pour un total de 256 Mo pour le GPU. Pour optimiser l'efficacité de la distribution de la bande passante à faible consommation, AMD a élargi les bus réseau intégrés aux IOD et les fait fonctionner à une tension réduite. Cette optimisation réduit l'énergie par bit, permettant à la série MI350 d'atteindre une bande passante mémoire par watt environ 1.3 fois supérieure à celle de son prédécesseur, la série MI300.
De plus, pour gérer efficacement la mémoire physique de 288 Go, les Universal Translation Caches (UTC), analogues aux CPU Translation Lookaside Buffers (TLB), ont été considérablement améliorés. La série MI350 introduit des contrôles de taille de page plus précis en UTC L1 et L2, ainsi que des capacités accrues. Ces améliorations permettent une plus grande portée des TLB et une gestion plus efficace de la mémoire virtuelle.
Améliorations du tissu Infinity
La technologie Infinity Fabric d'AMD demeure essentielle à l'évolutivité et aux performances de communication inter-GPU du MI350. La bande passante de la liaison Infinity Fabric AP reliant les deux IOD a été considérablement augmentée à 5.5 To/s, facilitant ainsi le transfert efficace des données entre les deux moitiés du GPU.
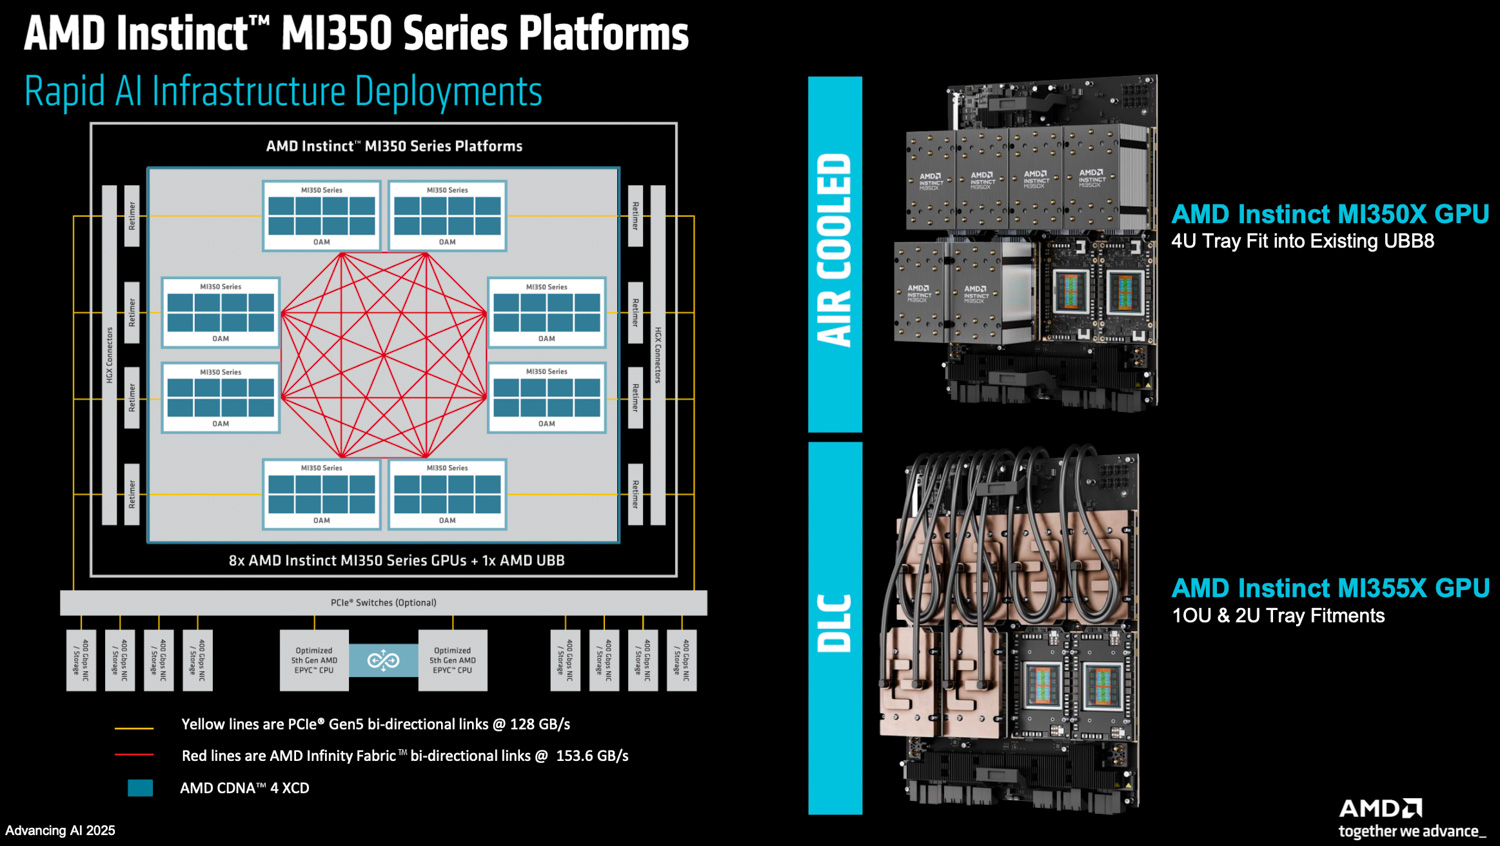
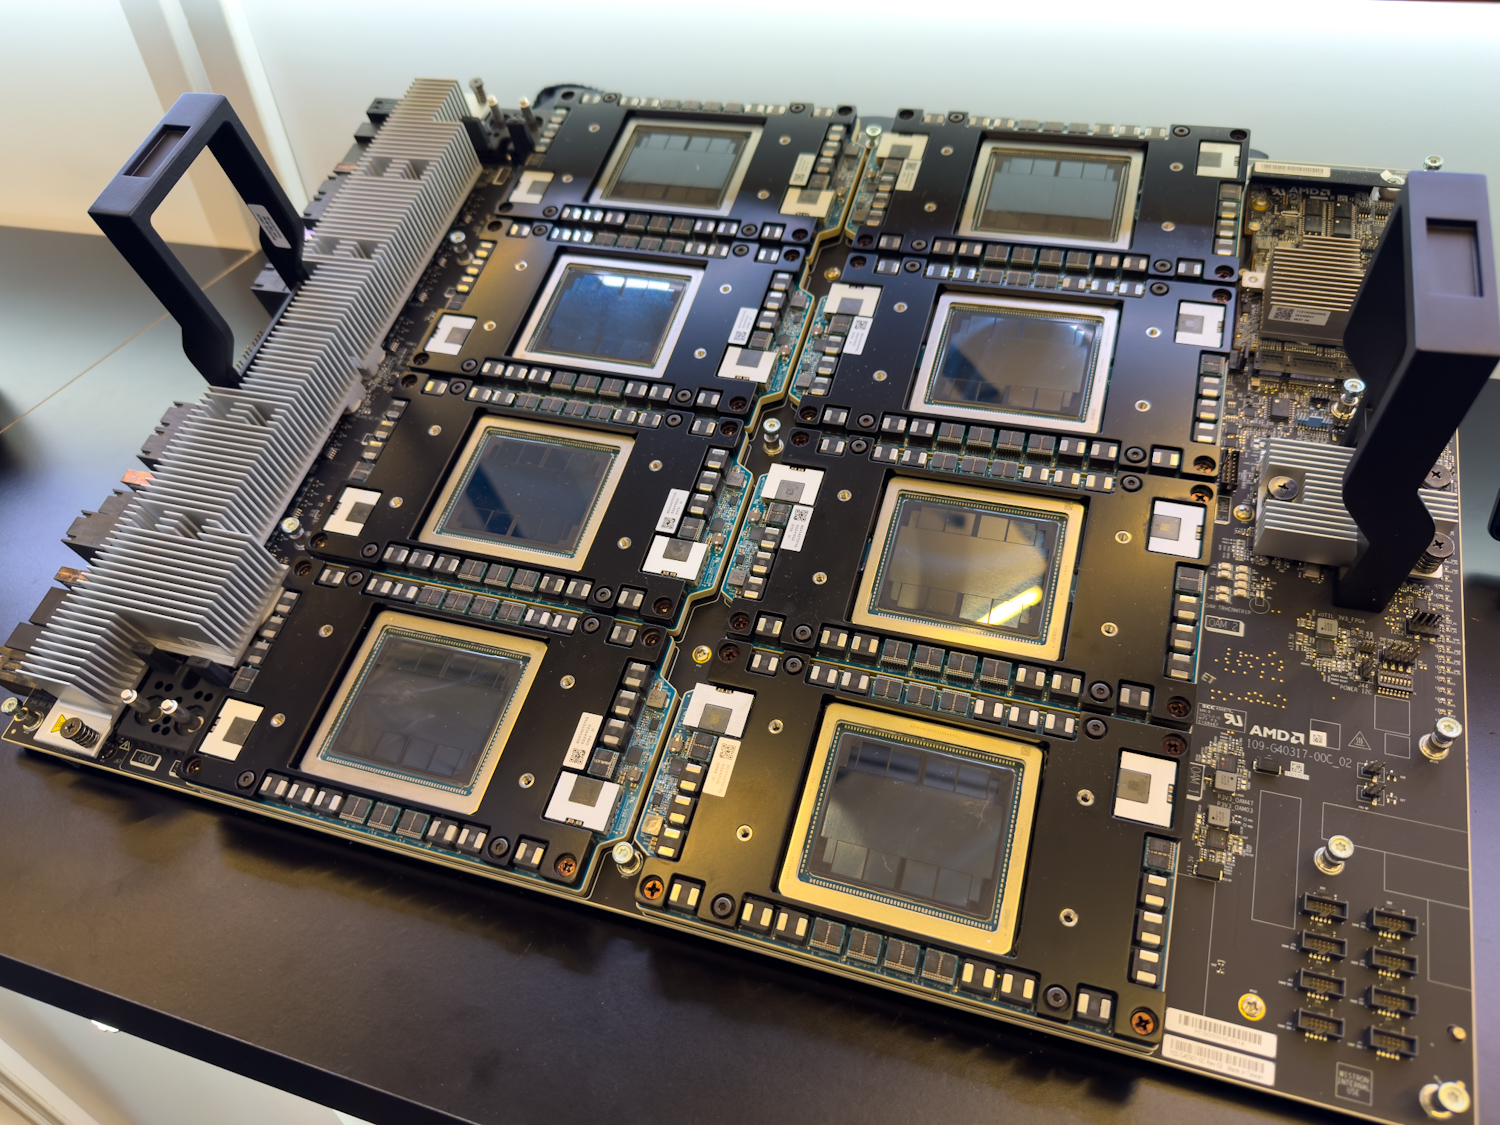
Pour la communication externe, chaque GPU MI350 dispose de sept liaisons Infinity Fabric, permettant une connectivité directe entre GPU dans des configurations telles qu'une plateforme UBB 8 à 2.0 GPU. Ces liaisons fonctionnent à 38.4 Gbit/s par broche. Dans une configuration OAM à 8 GPU, cette configuration offre une bande passante bisectionnelle d'environ 153.6 Go/s dans chaque direction par liaison. AMD a également perfectionné les techniques de compression et de compactage des données sur ces liaisons externes afin d'optimiser la bande passante effective. En interne, Infinity Fabric garantit à tous les XCD un accès entrelacé complet et précis à l'intégralité de l'espace mémoire HBM3E sur les deux IOD, présentant la mémoire comme une ressource unique, plate et unifiée pour les unités de calcul.
Architecture du cœur de calcul CDNA4
Au cœur de la puissance de traitement du MI350, l' unité de calcul CDNA4 a subi une importante refonte architecturale adaptée à l'IA.
Les capacités mathématiques matricielles bénéficient d'une amélioration substantielle : les unités de calcul MI350 offrent un débit multiplié par deux par unité de calcul pour les opérations 2 bits (BF16, FP16) et 16 bits (FP8, INT8) par rapport à leurs homologues MI8. La série MI300 introduit également la prise en charge matérielle des formats micro-échelle OCP MX, notamment FP350 et FP6, qui évoluent proportionnellement à partir de FP4. L'implémentation d'AMD permet notamment à FP8 de fonctionner au même rythme de calcul que FP6. Cette décision stratégique positionne AMD comme leader sur FP4, un format émergent offrant un potentiel pour l'entraînement de l'IA. De plus, une nouvelle UAL vectorielle a été ajoutée, prenant en charge les opérations 6 bits et capable d'accumuler les résultats BF2 dans FP16, améliorant ainsi le débit de certaines opérations vectorielles de faible précision.
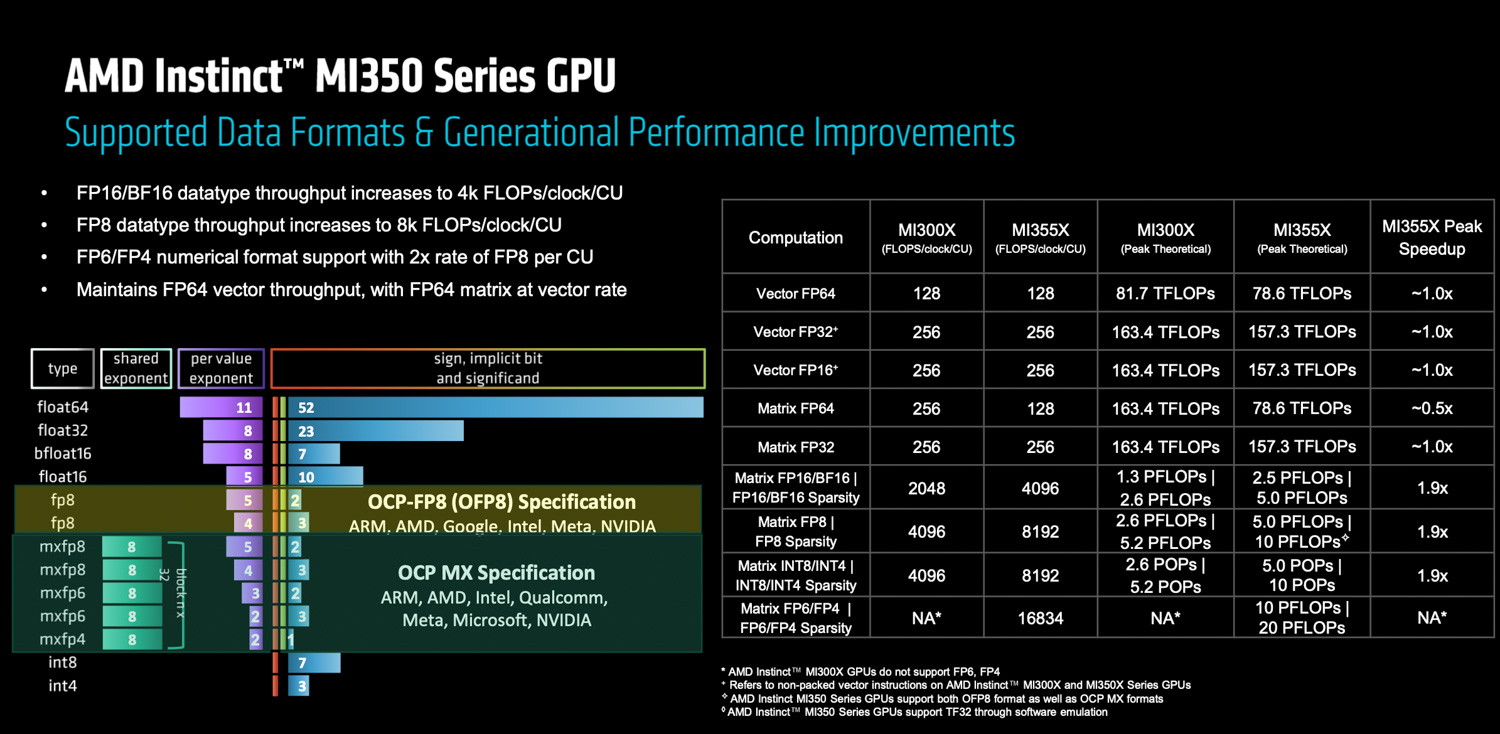
Pour prendre en charge ces débits tensoriels améliorés, la taille du partage de données locales (LDS) par unité de calcul a été augmentée, et de nouvelles fonctionnalités optimisent la bande passante pour le chargement des données de la mémoire globale vers le LDS. Compte tenu des goulots d'étranglement potentiels dans des opérations telles que le softmax et les mécanismes d'attention, le débit des fonctions transcendantes a également été augmenté parallèlement aux améliorations du cœur du tenseur.
Plusieurs autres améliorations architecturales contribuent aux performances et à la flexibilité :
- Arrondi stochastique pris en charge par le matériel : atténue le biais lors de la conversion de FP32 vers des formats de précision inférieure en injectant de l'entropie.
- Instruction Logical Operator 3 (LUT3) : offre aux programmeurs une plus grande flexibilité pour la mise en œuvre d'opérations logiques personnalisées à trois entrées.
- Nouveaux opérateurs Min-Max : permettent aux programmeurs de contrôler la propagation NaN pendant les comparaisons, leur permettant soit de propager les valeurs NaN, soit de sélectionner le nombre à virgule flottante non NaN, contribuant ainsi à une gestion robuste des données d'IA.
Bien que l'IA soit au cœur de ses préoccupations, la série MI350 conserve la prise en charge des opérations à virgule flottante 64 bits (FP64) en unités vectorielles et matricielles. Cependant, une différence essentielle par rapport au MI300 réside dans le fait que, sur le MI350, les opérations matricielles FP64 s'exécutent à la même vitesse que les unités vectorielles FP64, soit la moitié de la vitesse matricielle FP64 du MI300.
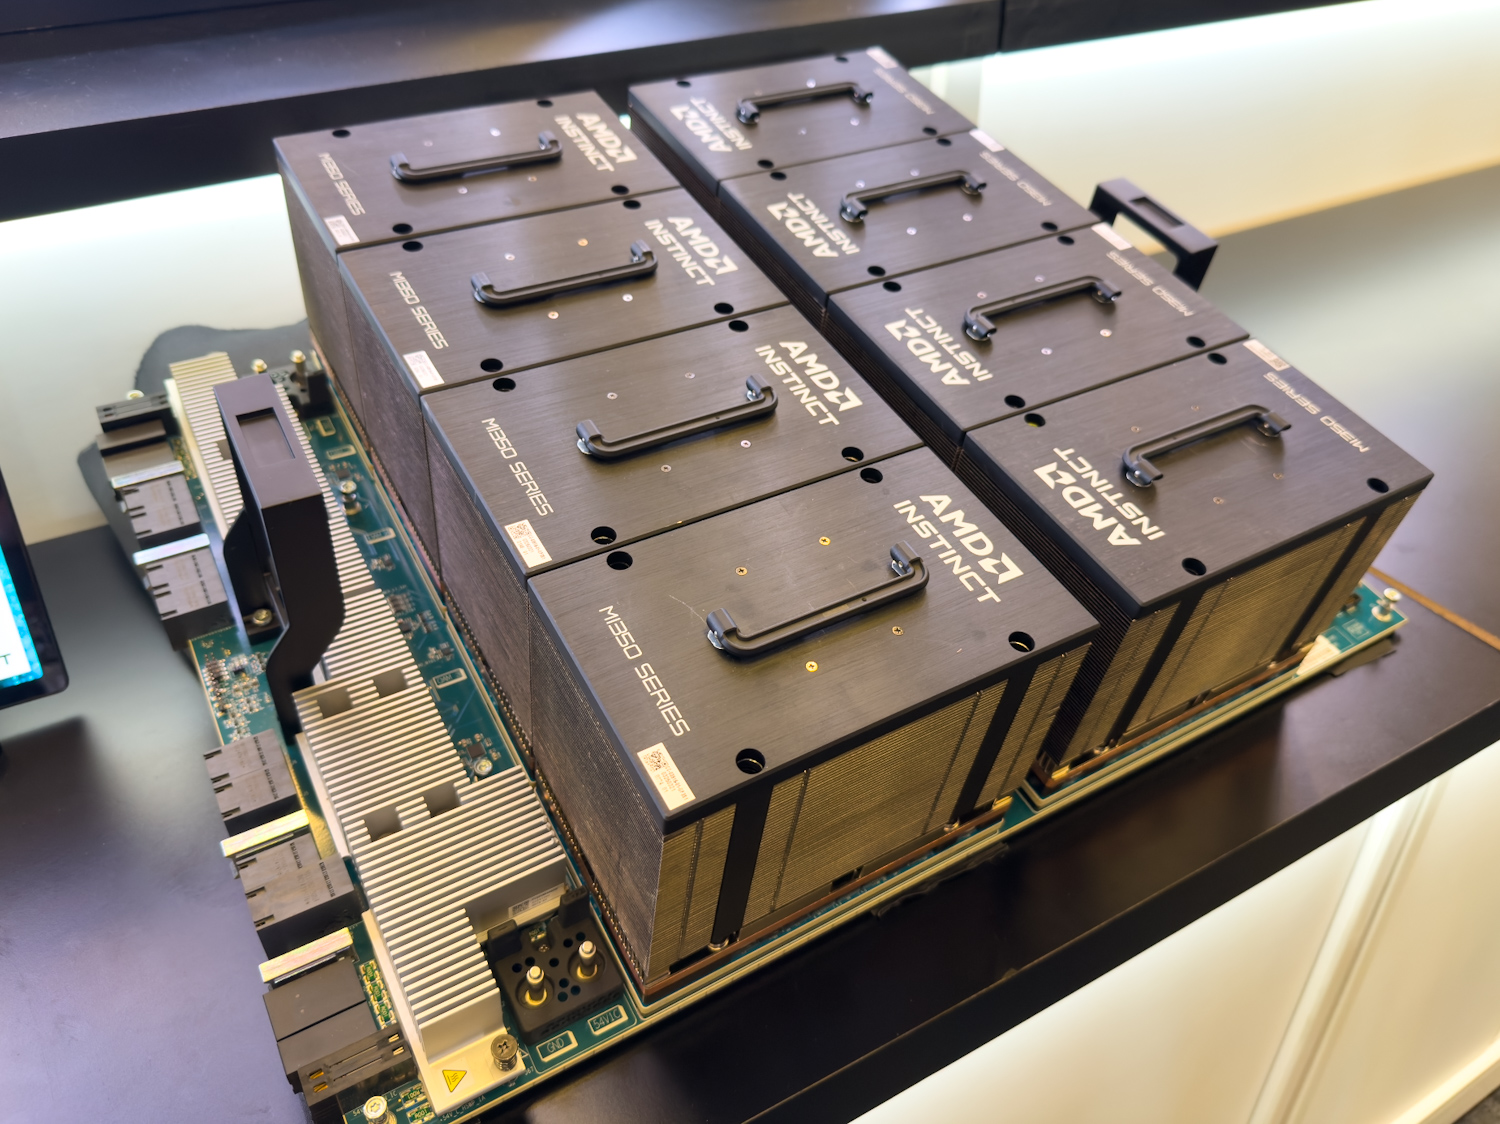
Enfin, la combinaison d'une bande passante HBM3E plus élevée et d'un nombre légèrement réduit d'UC (256 sur les MI350X/355X contre 304 sur le MI300X) signifie que chaque UC de la série MI350 bénéficie d'une bande passante mémoire globale par cycle d'horloge accrue. Ceci est crucial pour accélérer les opérations GEMM (General Matrix Multiply) et l'arithmétique vectorielle à bande passante limitée.
Partitionnement pour la flexibilité : partitionnement NPS et calcul
La série AMD MI350 dispose de capacités de partitionnement améliorées, offrant une allocation très flexible de ses ressources substantielles pour maximiser l'utilisation et l'efficacité sur diverses charges de travail.
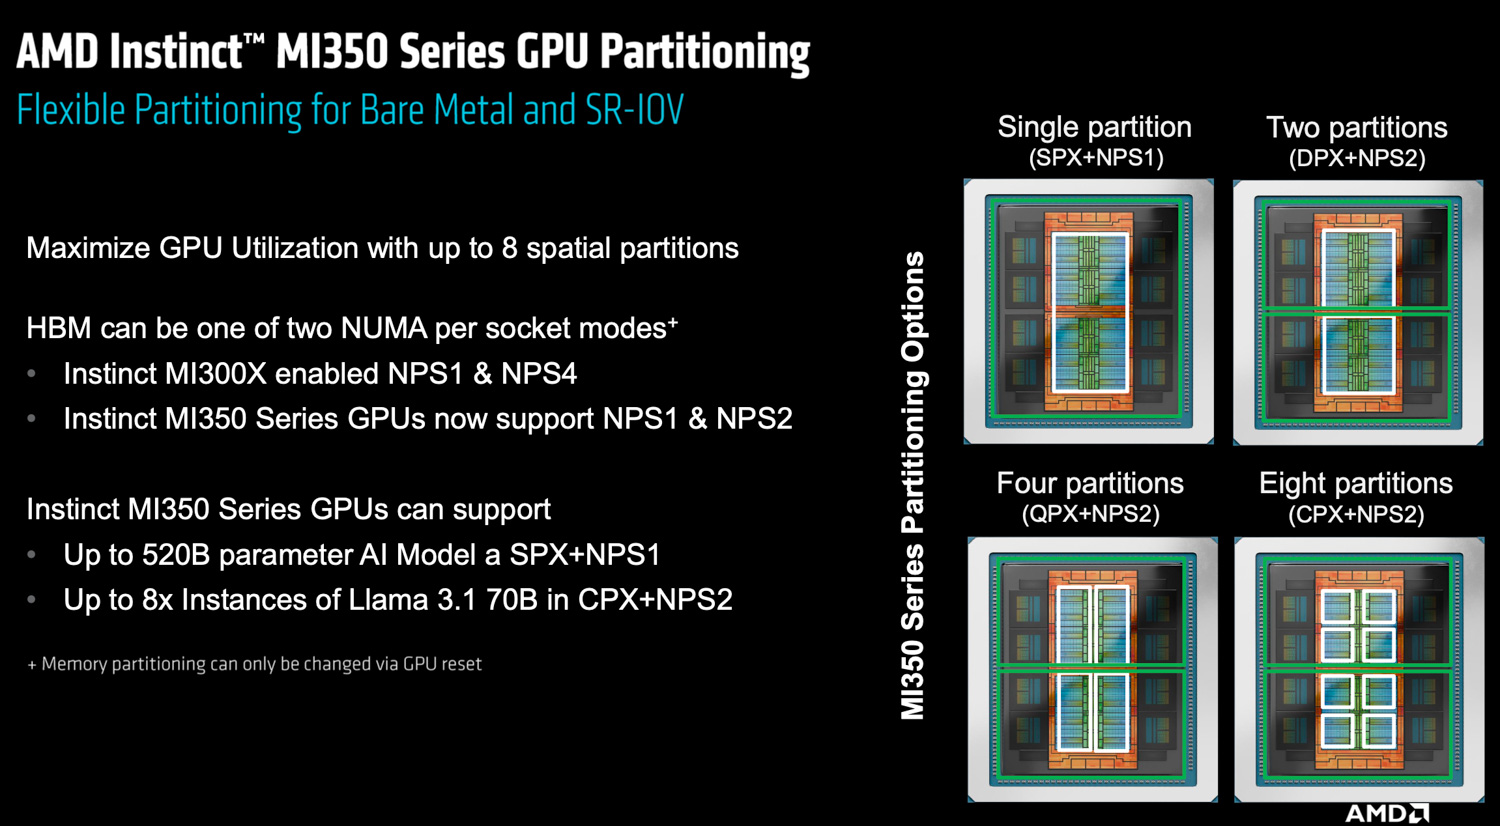
Pour la gestion de la mémoire, le MI350 propose deux modes NUMA (Non-Uniform Memory Access) principaux :
- NPS1 : traite l'intégralité de la mémoire HBM288E de 3 Go comme un domaine NUMA unique et unifié en entrelaçant l'accès aux données sur les huit piles HBM.
- NPS2 : divise la mémoire en deux domaines NUMA distincts, chacun correspondant à l'un des deux IOD et à ses quatre piles HBM associées. Alors que l'accès mémoire au sein de chaque IOD en mode NPS2 reste entrelacé à granularité fine, il devient grossier entre les IOD. Ce mode, notamment associé au partitionnement de calcul, permet d'optimiser la localisation spatiale.
Il est à noter qu'AMD a choisi de ne pas prendre en charge le mode NPS4 sur le MI350 (qui était disponible sur le MI300). Cette décision découle du couplage mémoire plus étroit entre les deux IOD de la nouvelle architecture, ce qui a réduit les gains de performances potentiels d'une subdivision supplémentaire de la mémoire.
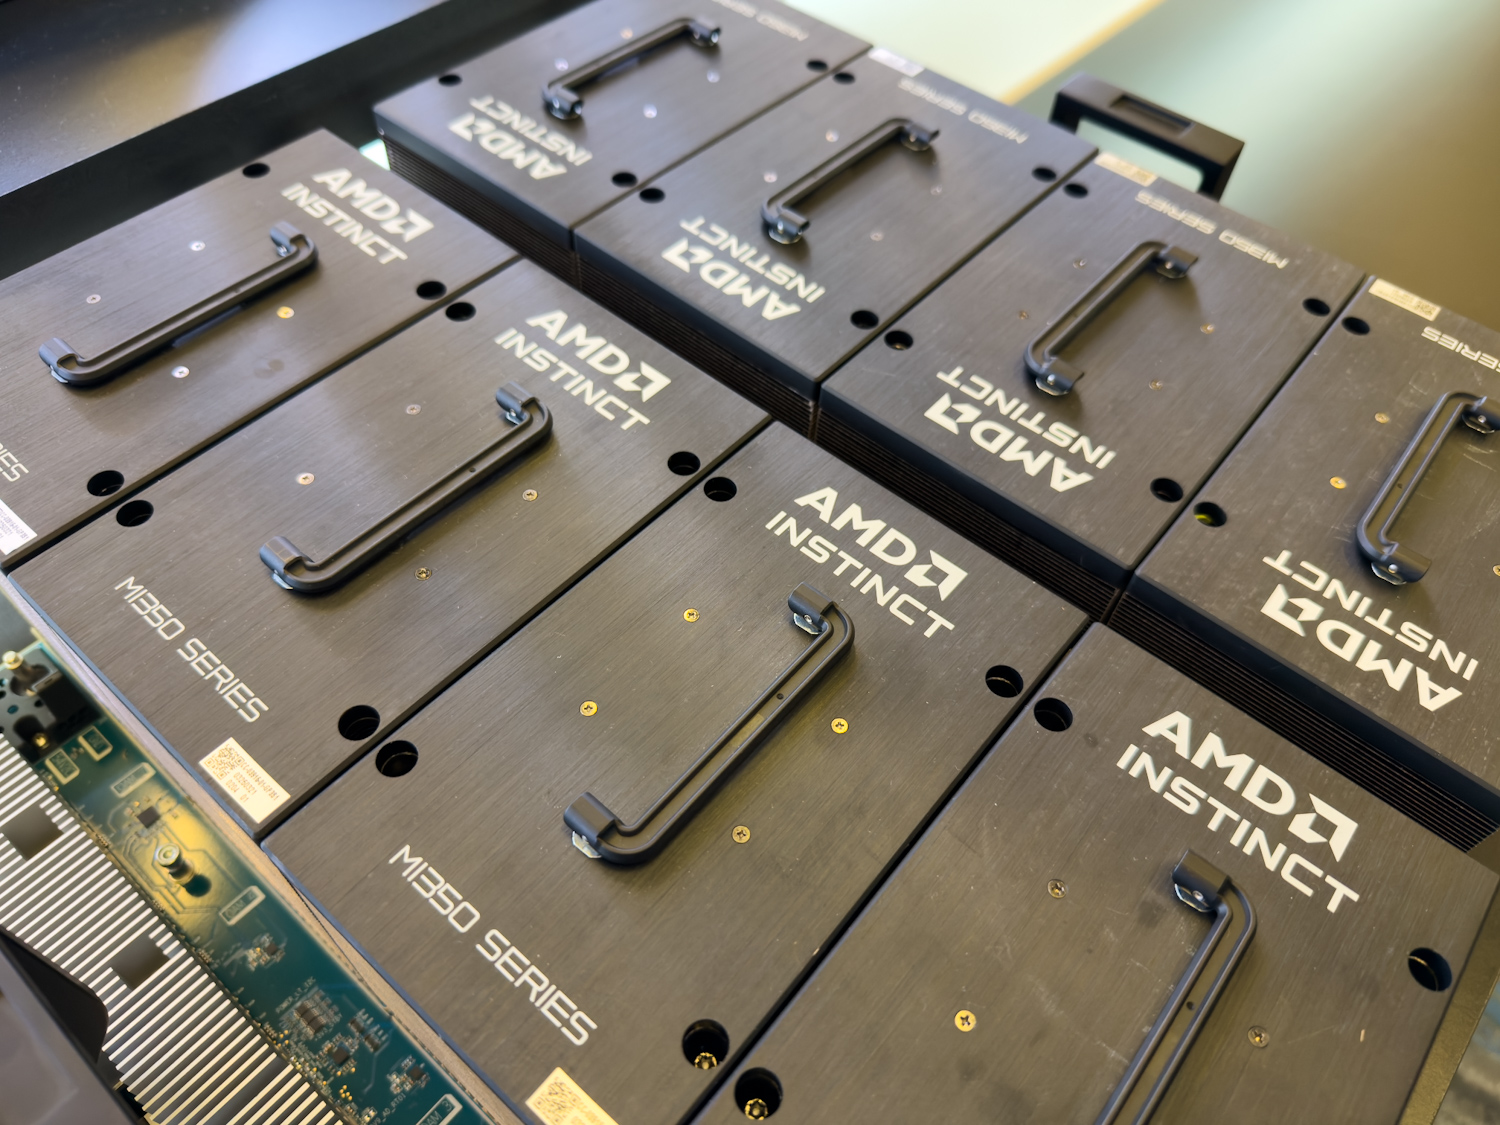
Côté calcul, le GPU peut être configuré pour fonctionner selon plusieurs modes :
- SPX (Single Partition Execution) : le GPU fonctionne comme un moteur unique et puissant, généralement utilisé avec le mode mémoire NPS1.
- DPX, QPX, OPX (exécution de partition double, quadruple, octale) : le GPU peut être divisé en deux, quatre ou même huit partitions de calcul indépendantes, respectivement.
Ces partitions de calcul peuvent être associées à des configurations de mémoire NPS1 ou NPS2, avec la contrainte que la granularité de la partition de calcul doit être au moins aussi fine, voire plus fine, que la partition de mémoire (par exemple, le mode SPX est incompatible avec le partitionnement de mémoire NPS2).
Ces options de partitionnement polyvalentes sont prises en charge aussi bien dans les déploiements bare metal que via SR-IOV (Single Root I/O Virtualization), ce qui les rend idéales pour les environnements virtualisés multi-locataires. Par exemple, dans un environnement cloud ou de centre de données, un seul GPU MI350 peut être segmenté logiquement pour servir simultanément plusieurs utilisateurs ou applications. Chaque locataire reçoit une tranche dédiée de mémoire et de ressources de calcul, garantissant ainsi la qualité de service et la sécurité, un atout particulièrement précieux lorsque différentes machines virtuelles nécessitent un accès isolé au matériel GPU.
MI350X vs. MI355X : adapté à différents déploiements
La série MI350 est présentée avec deux variantes principales, répondant à différents besoins de déploiement et enveloppes thermiques :
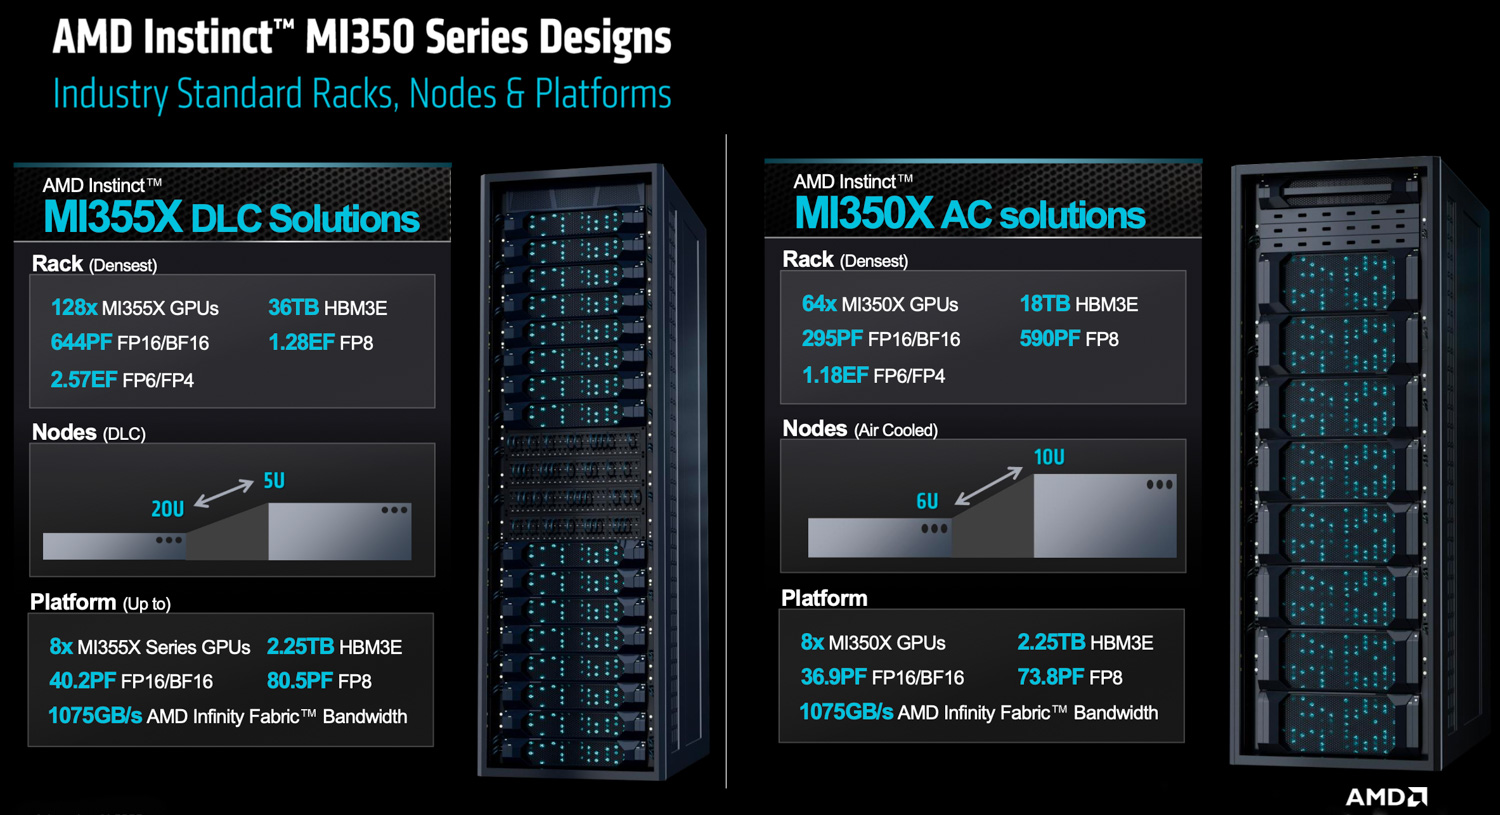
- MI350X : Cette variante est conçue pour une consommation énergétique réduite, avec une puissance thermique nominale (TDP) allant jusqu'à un kilowatt. Elle prend en charge les déploiements refroidis par air, offrant une compatibilité accrue avec les infrastructures de centres de données existantes.
- MI355X : Fonctionnant à une puissance système plus élevée allant jusqu'à 1.4 kilowatts TDP, le MI355X est principalement destiné aux déploiements refroidis par liquide, lui permettant de fournir des performances maximales.
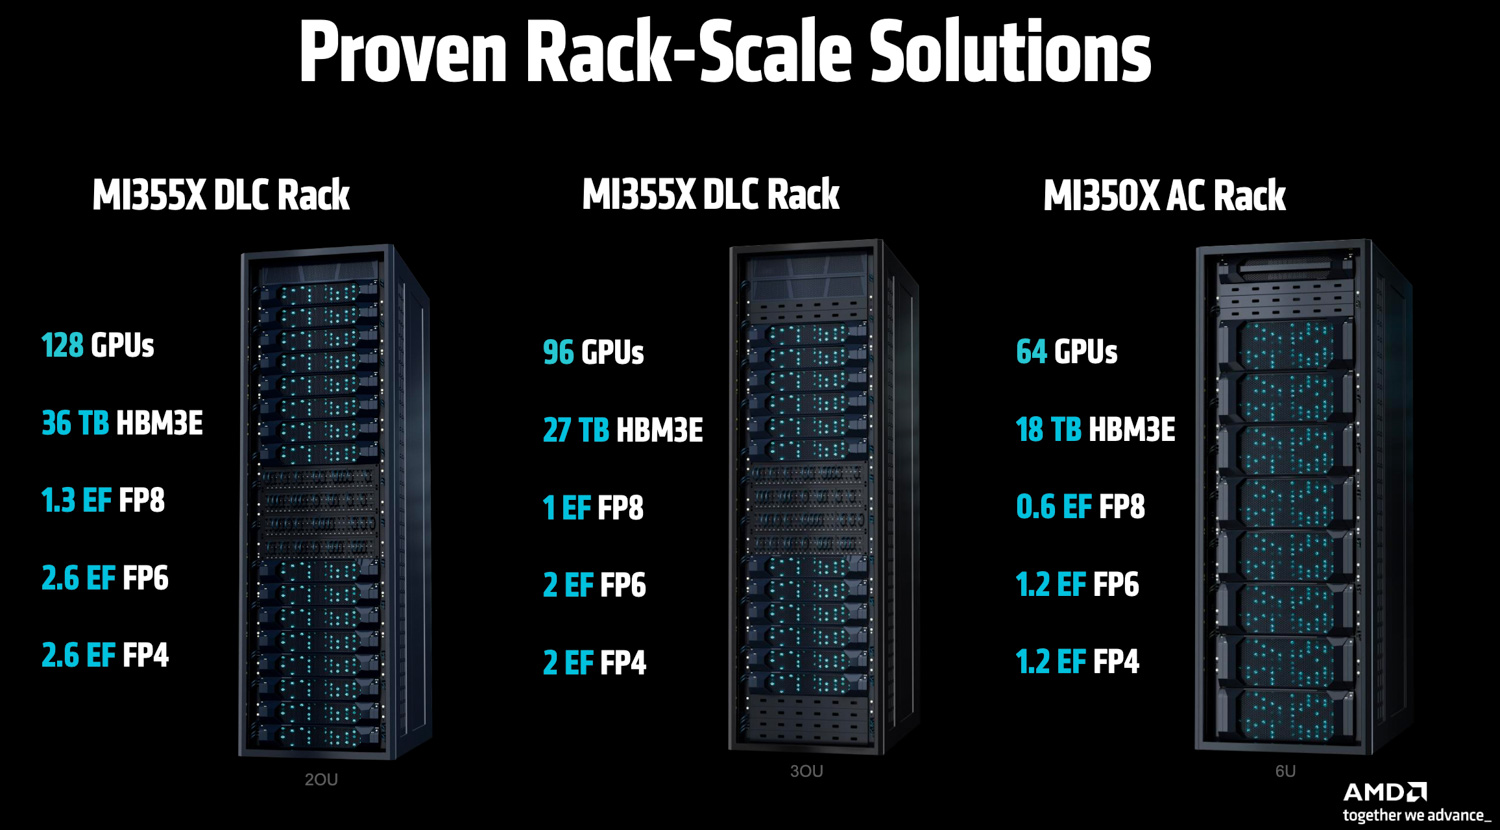
Bien que les deux variantes reposent sur le même matériel de base, l'enveloppe de puissance opérationnelle supérieure du MI355X permet des fréquences d'horloge soutenues plus élevées. Cela se traduit par un gain de performances d'environ 20 % par rapport au MI350X en conditions réelles de travail de bout en bout. Ces modèles sont disponibles en trois configurations de rack validées.
Réseau AMD Pensando Pollara
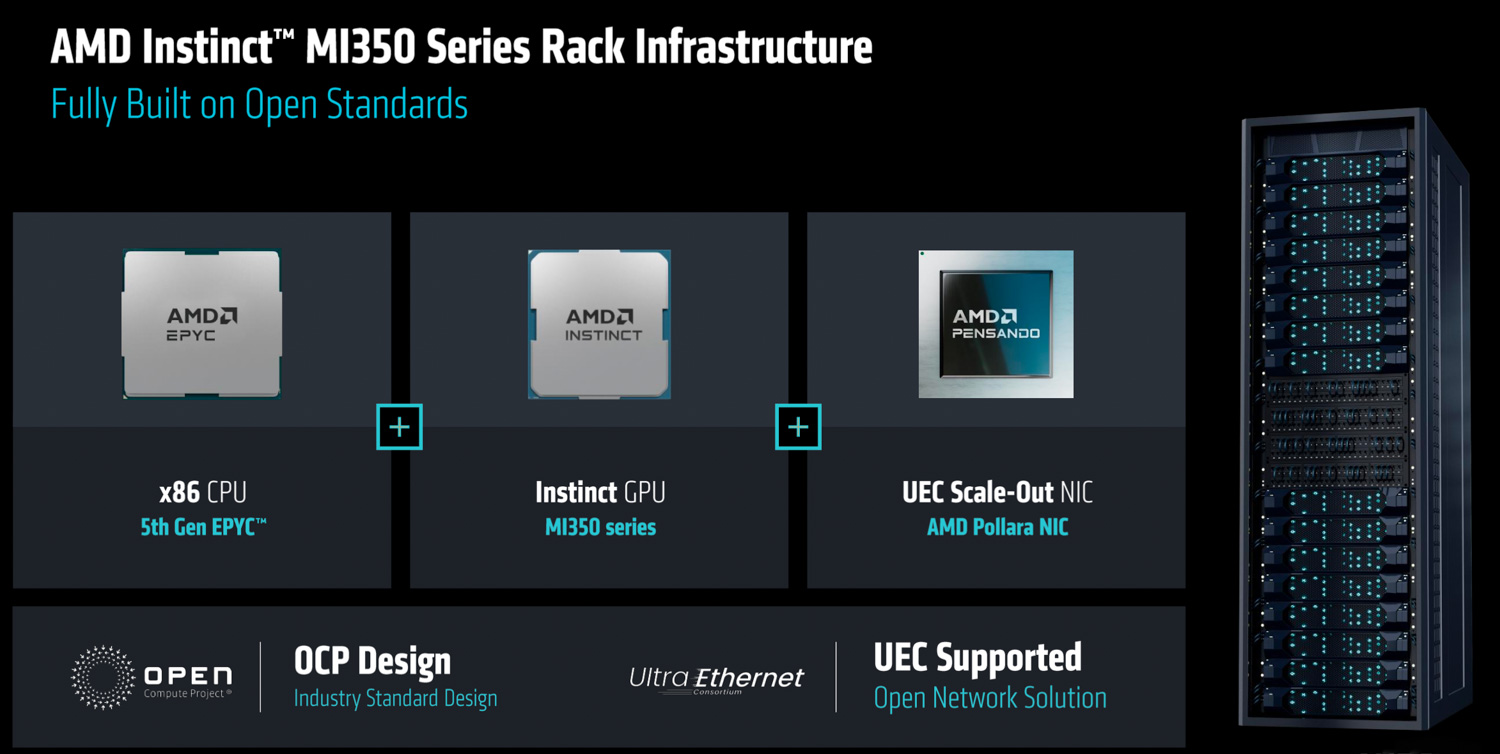
Outre les nouveaux GPU, AMD a présenté en détail ses solutions réseau Pollara, mettant en avant des avancées architecturales significatives conçues pour répondre aux exigences croissantes des systèmes d'intelligence artificielle à grande échelle. La carte réseau IA Pollara 400, basée sur la technologie issue de l'acquisition de Pensando par AMD, introduit un nouveau niveau de programmabilité et d'intelligence pour les réseaux IA.

Le cœur de l'innovation de Pollara réside dans son architecture programmable. Contrairement aux équipements à fonction fixe, la carte réseau Pollara intègre un cœur MPU programmable P4. Cette conception est cruciale car les exigences des réseaux d'IA sont en constante évolution, avec l'émergence rapide de nouveaux protocoles, mécanismes de transport et besoins en télémétrie. La programmabilité permet à la carte réseau Pollara de s'adapter aux mises à jour logicielles, permettant ainsi le déploiement de schémas de gestion du trafic personnalisés, de nouveaux algorithmes d'équilibrage de charge et de mécanismes de contrôle de congestion sur mesure, sans remplacement de matériel. Cette flexibilité est essentielle pour pérenniser les centres de données d'IA et répondre rapidement à l'évolution des charges de travail.
Pour pallier les goulots d'étranglement courants du réseau, Pollara introduit la multidiffusion. Pour la communication entre GPU, les données d'une même connexion peuvent être distribuées simultanément sur plusieurs liaisons réseau physiques. Cette approche améliore l'utilisation et le débit global du réseau en évitant la congestion sur un chemin spécifique. La carte réseau gère elle-même les complexités de cette distribution, notamment la réorganisation des paquets qui peuvent arriver à destination dans le désordre.
L'efficacité du réseau est optimisée grâce à l'accusé de réception sélectif pour les retransmissions. Dans les réseaux traditionnels, la perte d'un seul paquet peut déclencher la retransmission d'une longue séquence de données. Pollara met également en œuvre une méthode plus précise où seuls les paquets perdus sont renvoyés. Cela réduit considérablement les données redondantes sur le réseau, améliorant ainsi la bande passante effective. La solution réseau Pollara est également conçue pour un fonctionnement robuste dans divers environnements réseau, y compris ceux présentant des pertes de connexion. Elle intègre un contrôle de congestion sophistiqué, programmable et prenant en compte le chemin emprunté. Cette capacité réduit la dépendance à des architectures réseau parfaitement sans perte, qui peuvent s'avérer complexes et coûteuses à mettre en œuvre et à maintenir à l'échelle massive requise par les clusters d'IA modernes.

AMD participe également activement au consortium Ultra Ethernet, contribuant à l'élaboration et à la mise en œuvre de ses normes. L'UEC vise à définir un Ethernet de nouvelle génération optimisé pour l'IA, en mettant l'accent sur un équilibrage de charge efficace, une fiabilité accrue et un contrôle de congestion spécifique à l'IA. L'adhésion à ces normes ouvertes favorise l'interopérabilité et favorise un écosystème plus large.
Enfin, la technologie Pollara est conçue pour un fonctionnement synergique au sein de la plateforme AMD, permettant ainsi la co-innovation entre les composants CPU, GPU et carte réseau. Cela inclut des fonctionnalités telles que le déchargement collectif des opérations, où la carte réseau gère des tâches de communication spécifiques gourmandes en ressources réseau (celles ne nécessitant pas de calcul GPU). Cela libère les ressources GPU pour leurs tâches de traitement principales.
ROCm 7 : un écosystème logiciel ouvert pour l'IA avancée
Ces innovations matérielles sont confortées par l'annonce de ROCm 7, la dernière évolution de la plateforme logicielle ouverte d'AMD, conçue pour optimiser les performances et l'accessibilité. Prévue pour une avant-première publique aujourd'hui avant sa sortie officielle en août, AMD annonce que ROCm 7 offre une amélioration spectaculaire de 3 à 3.5 fois supérieure des performances d'inférence et d'apprentissage sur le matériel existant par rapport à son prédécesseur.
Pour les entreprises, AMD lance ROCm AI Enterprise, une suite complète offrant des outils de gestion de cluster, de MLOps et de création d'applications pour des déploiements à grande échelle. Parallèlement, AMD offre aux développeurs individuels un accès à un nouveau cloud de développement, avec des crédits GPU gratuits pour encourager l'expérimentation. Cet effort d'accessibilité va encore plus loin : ROCm 7 étend officiellement la prise en charge aux appareils clients, notamment les ordinateurs portables et les stations de travail sous Windows, permettant ainsi aux développeurs de créer et de tester des applications d'IA en toute fluidité sur l'ensemble de l'écosystème AMD.
La route à suivre
AMD se consacre à un cycle d'innovation rapide et annuel, avec une feuille de route de produits qui s'étend au-delà de sa série MI350.

Avec un lancement prévu en 2026, AMD développe la série MI400, qui constituera le cœur d'une solution rack entièrement intégrée, nom de code Helios. Cette plateforme est spécialement conçue pour entraîner des modèles d'IA de pointe et gérer des tâches d'inférence distribuées à grande échelle. Le système Helios sera une plateforme AMD intégrée, intégrant les futurs processeurs EPYC (nom de code Venice), les GPU Instinct MI400 et la nouvelle génération de réseaux Pensando, notamment la carte réseau IA Vulcano 800G. Une pile logicielle ROCm complète, incluant un gestionnaire de matrice dédié pour le déploiement et la gestion automatisés, sera également intégrée à cette solution. Privilégiant les normes ouvertes, le rack Helios sera conforme aux spécifications OCP. Il exploitera l'Ultra Ethernet (UEC) pour la mise à l'échelle du réseau entre les racks et introduira l'Ultra Accelerator Link (UAL 1.0) pour l'intensification des communications au sein d'un même rack.

Le GPU Instinct MI400 est spécialement conçu pour les applications d'IA à très grande échelle. Ses spécifications préliminaires annoncent des performances impressionnantes, avec notamment 40 pétaflops de performances FP4 et 20 pétaflops de performances FP8. Chaque GPU devrait intégrer 432 gigaoctets de mémoire HBM, offrant une bande passante mémoire HBM d'environ 20 To/s, et offrir une bande passante scale-out de 300 gigaoctets par seconde. En complément du GPU, la carte réseau IA Vulcano 800G sera compatible UEC et prendra en charge UAL et PCIe Gen6, ce dernier offrant une bande passante deux fois supérieure à celle du PCIe Gen6. Cette carte réseau devrait offrir jusqu'à huit fois plus de bande passante scale-out par GPU que la génération Polara précédente. AMD a des objectifs de performance ambitieux pour la solution rack Helios, prévoyant des performances IA jusqu'à dix fois supérieures sur les modèles Frontier les plus avancés par rapport au MI355. Contre Vera Rubin en 2026, Helios vise à offrir des FLOPS bruts compétitifs, 50 % de capacité HBM en plus, 50 % de bande passante mémoire HBM en plus et jusqu'à 50 % de bande passante évolutive en plus.
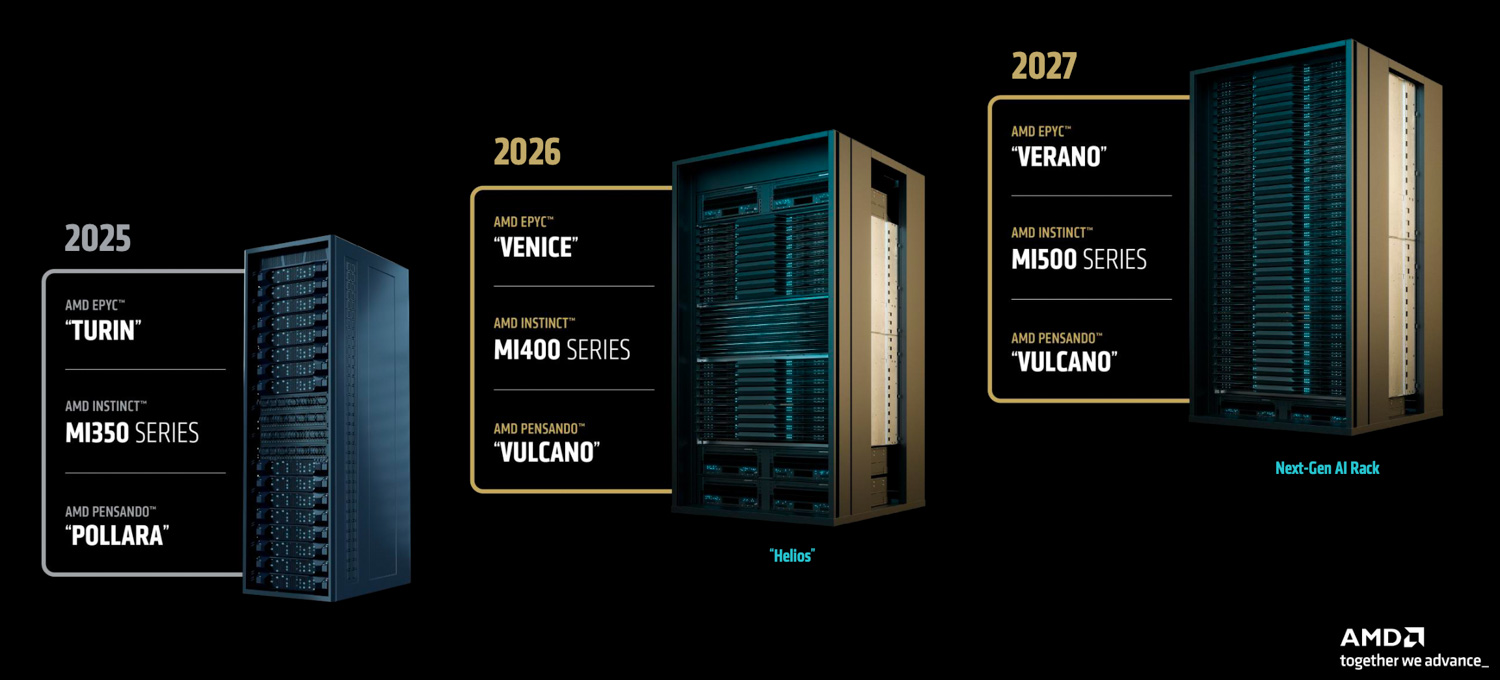
La feuille de route d'AMD s'étend encore davantage, le développement de la série MI500 étant déjà bien avancé et les architectures rack suivantes étant prévues pour 2027 et au-delà. Ces futures plateformes intégreront la série MI500, ainsi que les processeurs EPYC de nouvelle génération (nom de code Verano), et de nouvelles avancées de la technologie réseau Pensando. Aucune information complémentaire n'a toutefois été divulguée lors de l'événement.


 Amazon