

Plus tôt cette année, Intel a publié les résultats de performances entre Intel Habana Gaudi2 et NVIDIA, leader du marché des GPU, qui illustrent l'engagement d'Intel en faveur de l'IA et prouvent que l'IA n'est pas une catégorie unique. Dans le même temps, un développement conjoint entre les chercheurs d'Intel AI et Microsoft Research a créé BridgeTower, un transformateur multimodal pré-entraîné fournissant des tâches de langage de vision de pointe. Hugging Face a intégré ce modèle dans sa bibliothèque open source pour l'apprentissage automatique.
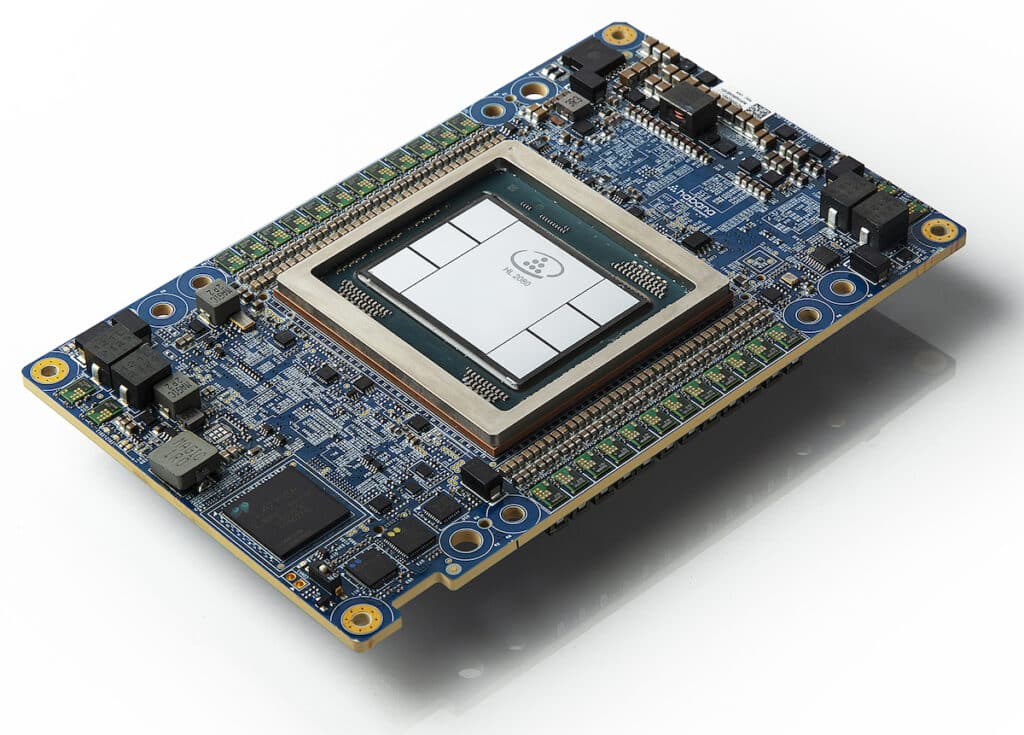
Carte mezzanine Habana Gaudi2 (Crédit : Intel Corporation)
Hugging Face a publié les résultats initiaux des tests de performance dans un article de blog sur son site web et a mis à jour les résultats des tests d'entraînement d'IA pour Habana Gaudi2 et le GPU H100 de NVIDIA. D'après ces résultats, Gaudi2 surpasse le H100 pour l'acquisition du modèle BridgeTower de transformateur multimodal. De plus, grâce à Habana optimisé , Gaudi2 atteint des performances 2.5 fois supérieures à celles du A100. Ces résultats confirment non seulement la place de Gaudi2 dans le domaine de l'IA, mais aussi dans celui de l'entraînement vision-langage.
Optimum Habana est l'interface entre les bibliothèques Transformers et Diffusers et le processeur Gaudi (HPU) de Habana. Il fournit des outils qui facilitent le chargement, la formation et l'inférence de modèles sur des paramètres mono- et multi-HPU pour diverses tâches en aval.
Fond de la tour du pont
Les modèles de langage de vision utilisent des encodeurs unimodaux pour acquérir des représentations de données. Les données sont ensuite combinées ou entrées dans un encodeur multimodal. BridgeTower se distingue par ses couches de pont uniques, reliant les couches supérieures d'encodeurs unimodaux à chaque couche d'encodeur multimodal, permettant une combinaison efficace de données visuelles et textuelles à différents niveaux.
BridgeTower, formé sur seulement 4 millions d'images, établit de nouvelles normes de performances, offrant une précision de 78.73 % au test Visual Question Answering (VQAv2). Cela dépasse le meilleur modèle précédent de 1.09 pour cent. À grande échelle, le modèle a une précision encore plus élevée de 81.15 %, surpassant les modèles formés sur des ensembles de données beaucoup plus volumineux.
En tant que modèle de langage de vision de premier plan, les performances de BridgeTower sont dues à sa capacité à charger rapidement des données à l'aide d'un matériel spécial. Ces méthodes rapides de chargement de données sont bénéfiques pour les modèles de vision, qui sont souvent confrontés à des problèmes de chargement de données.
Informations sur le matériel
Les tests de référence mis à jour étaient basés sur les derniers matériels et logiciels de NVIDIA et Habana Labs. Le GPU NVIDIA H100 Tensor Core est le GPU INVIDIA le plus récent et le plus rapide, avec un moteur Transformer pour les exécutions spécialisées et 80 Go de mémoire. Utilisant la troisième itération de la technologie Tensor Core, le GPU Nvidia A100 Tensor Core est largement disponible auprès des fournisseurs de cloud, avec 80 Go de mémoire pour une vitesse supérieure à son homologue de 40 Go.
Habana Labs Habana Gaudi2 est le matériel d'IA de deuxième génération de Habana Labs qui peut héberger jusqu'à 8 HPU, chacun avec 96 Go de mémoire. Il est censé avoir des fonctionnalités conviviales et, combiné à Optimum Habana, facilite le transfert de codes basés sur Transformers vers Gaudi.
Détails de l'analyse comparative
Le test impliquait d'affiner un modèle BridgeTower avec 866 millions de paramètres et de s'entraîner en anglais à l'aide de diverses techniques sur plusieurs ensembles de données. L'étape suivante impliquait un réglage plus précis à l'aide de l'ensemble de données du New Yorker Caption Contest. Toutes les plates-formes ont utilisé les mêmes paramètres et ont traité des lots de 48 échantillons chacun pour des résultats cohérents.
Un défi dans de telles expériences est le chargement fastidieux des données d’image. Idéalement, les données brutes devraient être directement envoyées aux appareils pour être décodées. L’accent est désormais mis sur l’optimisation de ce processus de chargement de données.
Optimisation du chargement des données
Pour un chargement plus rapide des images sur le processeur, l’augmentation des sous-processus peut être utile. À l'aide des TrainingArguments de Transformers, l'argument dataloader_num_workers=N peut définir le nombre de sous-processus CPU pour le chargement des données. Le paramètre par défaut est 0, ce qui signifie que les données sont chargées par le processus principal, mais cela peut ne pas être efficace. L’augmenter peut améliorer la vitesse, mais cela augmentera également la consommation de RAM. Le paramètre recommandé est le nombre de cœurs de processeur. Cependant, il est préférable d’expérimenter d’abord pour déterminer la configuration optimale.
Ce benchmark comportait trois exécutions distinctes :
- Une exécution de précision mixte sur huit appareils, où le chargement des données partage le même processus avec d'autres tâches (dataloader_num_workers=0).
- Une exécution similaire mais avec un sous-processus dédié au chargement des données (dataloader_num_workers=1).
- La même configuration mais avec deux sous-processus dédiés (dataloader_num_workers=2).
Chargement de données accéléré par le matériel avec Optimum Habana
Pour améliorer encore la vitesse, déplacez les tâches de chargement de données du CPU vers des dispositifs accélérateurs, tels que les HPU sur Gaudi2 ou les GPU sur A100/H100, en utilisant le pipeline multimédia de Habana. Au lieu de traiter entièrement les images sur le processeur, les images codées peuvent être envoyées directement aux appareils pour décodage et augmentation. Cette approche maximise la puissance de calcul de l'appareil mais peut augmenter la consommation de mémoire de l'appareil.
Deux méthodes efficaces pour améliorer les flux de travail de formation avec des images consistent à allouer davantage de ressources de chargement de données et à utiliser des dispositifs accélérateurs pour le traitement des images. Lors de la formation de modèles de langage de vision avancés tels que BridgeTower, ces optimisations rendent Habana Gaudi2 avec Optimum Habana nettement plus rapide que ses homologues NVIDIA. Habana Gaudi2 est convivial, avec seulement quelques arguments de formation supplémentaires nécessaires.


 Amazon