

Microsoft a lancé Maia 200, un nouvel accélérateur d'inférence personnalisé conçu pour optimiser la rentabilité de la génération de jetons d'IA à grande échelle. Il s'agit de la première plateforme matérielle et logicielle de l'entreprise spécifiquement optimisée pour l'inférence IA.
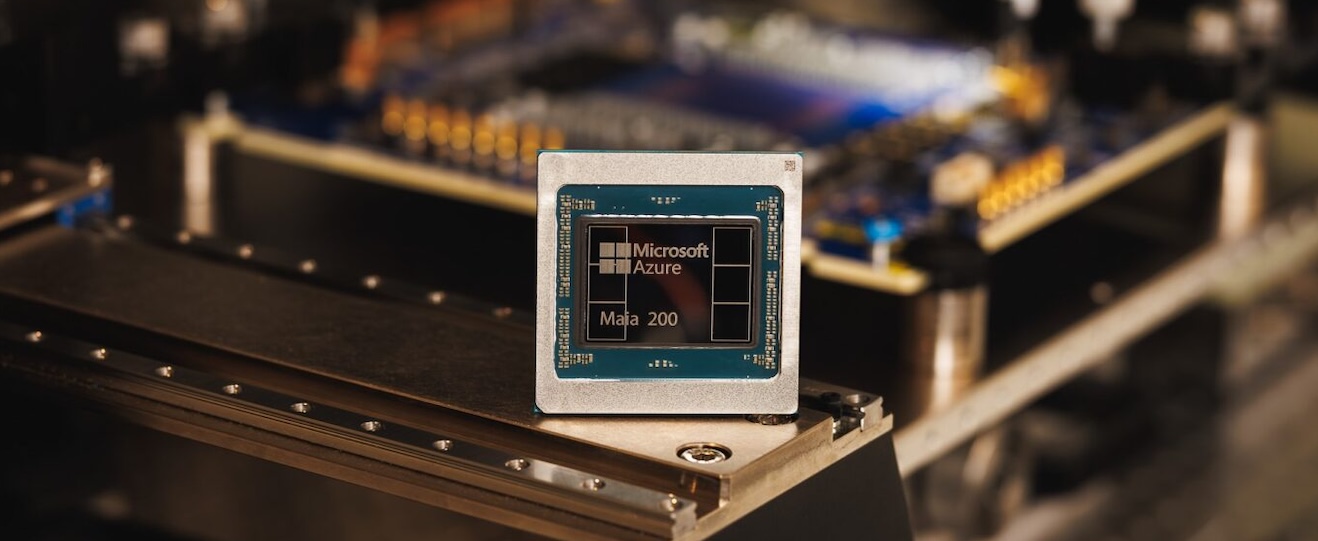
Microsoft conçoit l'inférence IA autour d'une « frontière d'efficacité » qui équilibre les performances et la précision avec le coût, la latence et la consommation énergétique. En pratique, cette frontière varie selon la charge de travail : les copilotes interactifs privilégient une faible latence, la synthèse par lots et la recherche mettent l'accent sur le débit par dollar investi, et le raisonnement avancé exige des performances soutenues avec de longues fenêtres de contexte et une exécution en plusieurs étapes. Le message de Microsoft est clair : l'infrastructure ne peut plus être unique et Azure doit proposer un ensemble d'options de service adaptées aux différents profils d'inférence.
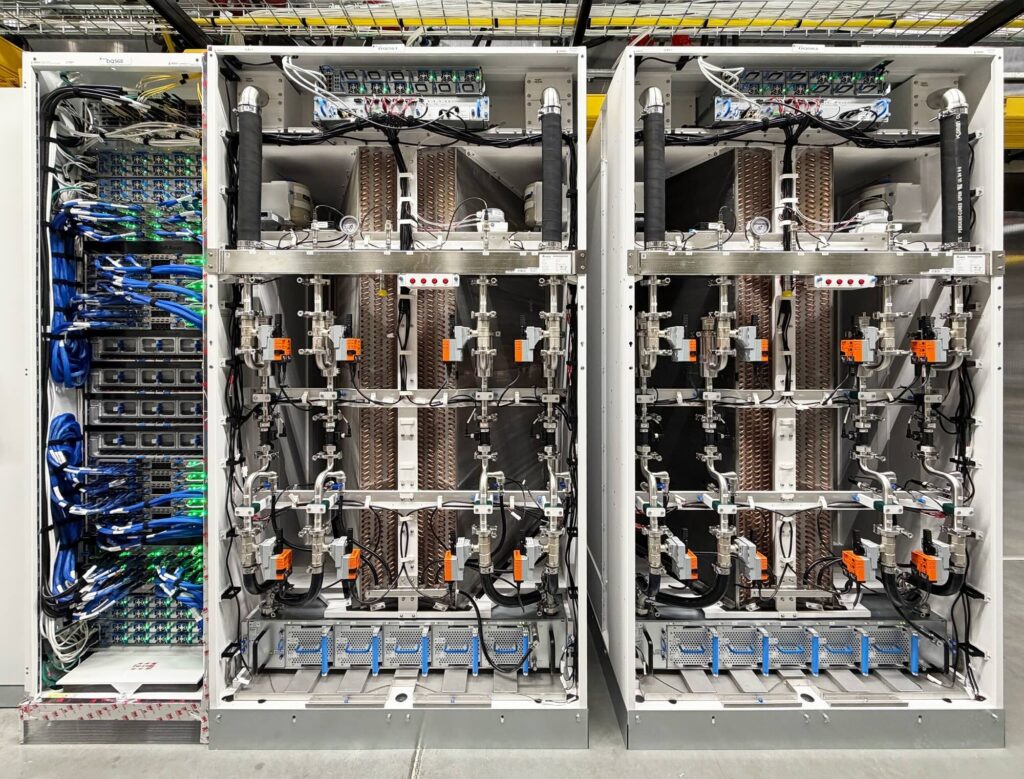
Microsoft Maia Rack
Microsoft affirme que Maia repose sur une approche intégrée couvrant les logiciels, les puces, les systèmes et les centres de données, et revendique une amélioration de 30 % des performances par dollar investi par rapport au matériel de dernière génération actuellement déployé dans son parc. L'entreprise présente cette conception intégrée comme un atout fondamental à mesure que les applications multi-agents gagnent en complexité et se généralisent.
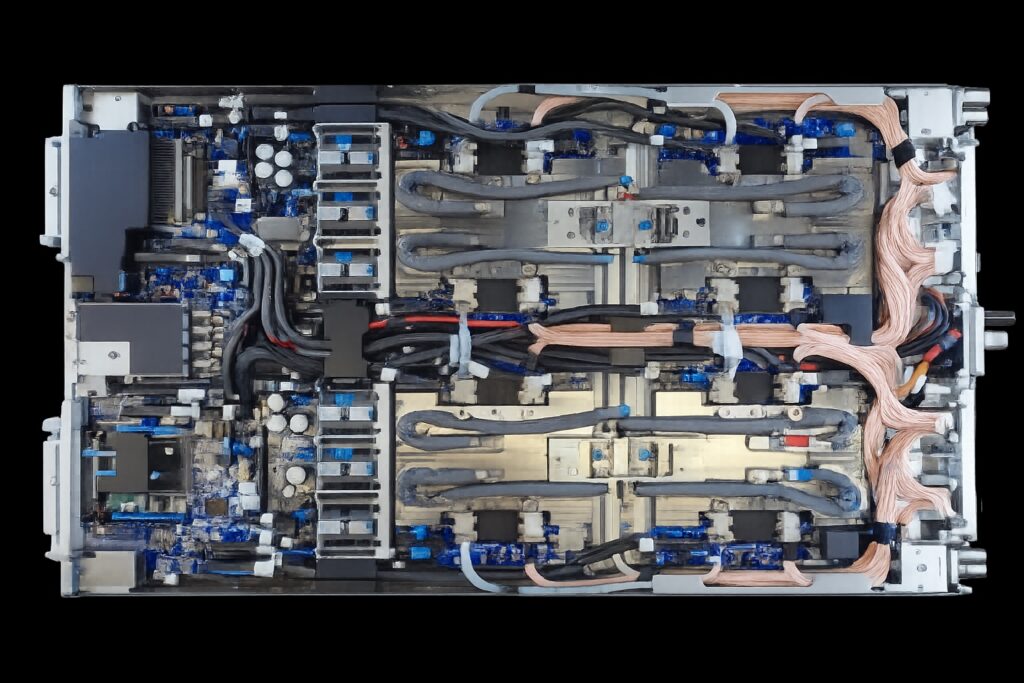
Lame serveur Microsoft Maia 200
Maia 200 : Principales caractéristiques architecturales et spécifications maximales
Maia est construit autour d'une exécution à précision étroite, d'une hiérarchie de mémoire conçue pour réduire le trafic hors puce et d'une conception évolutive Ethernet destinée à maintenir l'efficacité de l'inférence multi-accélérateur.
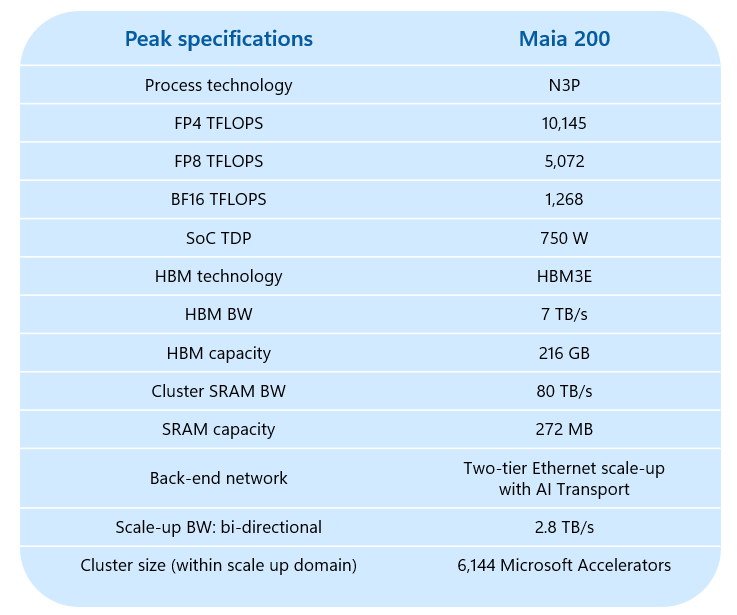
Microsoft met en avant plusieurs spécifications et points de conception de pointe. Maia utilise des chemins de données optimisés à haute précision sur le processus N3 de TSMC et atteint une puissance de calcul maximale de 10.1 pétaOPS en FP4. Microsoft mise sur le FP4 comme format d'inférence économique, visant un meilleur rendement énergétique (en jetons par dollar et par watt).
La mémoire est un élément essentiel. Maia combine 272 Mo de SRAM intégrée avec 216 Go de HBM3e, et Microsoft annonce une bande passante HBM de 7 To/s. L'objectif est de maintenir les ensembles de travail critiques en local, de réduire la demande en bande passante HBM grâce à une meilleure localisation et d'améliorer l'efficacité énergétique en minimisant les transferts hors puce.
Pour le transfert de données, Maia associe un sous-système DMA multiniveau à un réseau sur puce hiérarchique afin de garantir des performances prévisibles pour les charges de travail hétérogènes et gourmandes en mémoire. Microsoft met l'accent sur la synergie entre le transfert de données et le calcul, ainsi que sur la prise en charge structurée des architectures optimisées pour les tenseurs.
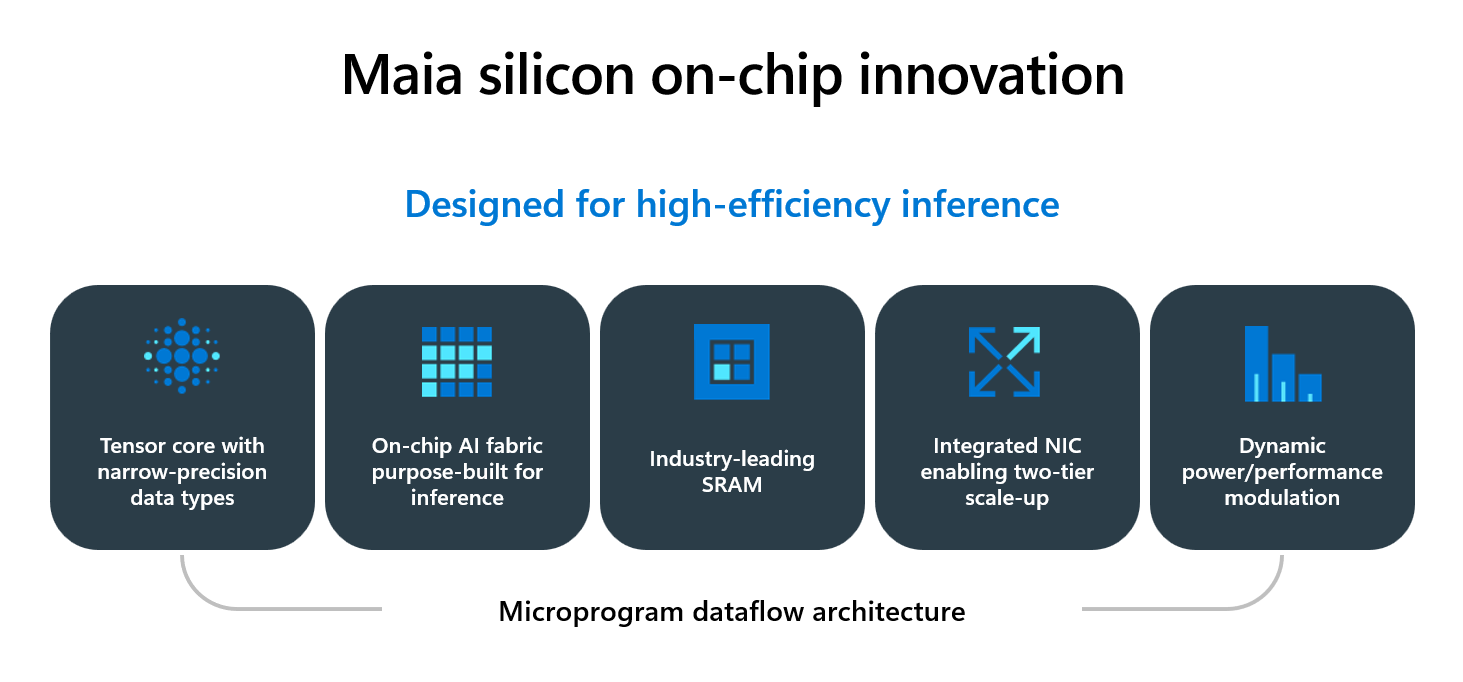
Pour la montée en charge, Maia intègre une carte réseau et une interconnexion Ethernet avec une bande passante bidirectionnelle de 2.8 To/s. Microsoft indique que cette architecture prend en charge une architecture à deux niveaux pouvant accueillir jusqu'à 6 144 accélérateurs, garantissant une communication à haut débit et faible latence pour les grands clusters d'inférence.
Microarchitecture basée sur des tuiles et des clusters
L'architecture de calcul de Maia est organisée de manière hiérarchique. L'unité de base est une tuile qui combine une unité tensorielle de tuile (TTU) pour les opérations matricielles et les convolutions avec un processeur vectoriel de tuile (TVP), faisant office de moteur SIMD programmable. Chaque tuile est alimentée par une mémoire SRAM de tuile multibanque (TSRAM) et utilise un moteur DMA au niveau de la tuile pour transférer les données sans interrompre le pipeline de calcul. Un processeur de contrôle léger orchestre la distribution des tâches, avec des sémaphores matériels assurant une synchronisation précise entre les transferts et les calculs.
Les tuiles sont regroupées en clusters, ce qui permet de partager la mémoire via la SRAM de cluster (CSRAM) et introduit un second niveau d'accès direct à la mémoire (DMA) pour acheminer les données entre la CSRAM et la mémoire HBM co-encapsulée. Microsoft souligne également la redondance des tuiles et de la SRAM afin d'améliorer le rendement et la facilité de fabrication tout en préservant la cohérence du modèle de programmation.
Focalisation de précision étroite : FP4 et précision mixte
Microsoft mise fortement sur la précision étroite comme levier d'efficacité d'inférence, s'appuyant sur des résultats industriels démontrant que le FP4 permet de préserver la précision d'inférence tout en réduisant les coûts de calcul et de mémoire. L'unité de traitement de données (TTU) de Maia est optimisée pour le FP8, le FP6 et le FP4, et prend en charge les modes de précision mixte, tels que les activations FP8 multipliées par les poids FP4. Le processeur de données (TVP) prend en charge le FP8 ainsi que le BF16, le FP16 et le FP32 pour les opérateurs qui tirent parti d'une précision plus élevée. Un module de mise en forme intégré convertit les formats basse précision à la vitesse de la ligne afin d'éviter les goulots d'étranglement lors du calcul.
Microsoft affirme que le débit FP4 sur Maia est 2 fois supérieur à celui du FP8 et 8 fois supérieur à celui du BF16, positionnant ainsi l'architecture pour un nombre plus élevé de jetons par seconde et des performances accrues par watt dans les déploiements nécessitant une inférence importante.
Sous-système de mémoire optimisé pour la localité et le déterminisme
La mémoire SRAM intégrée de Maia est répartie entre des pools au niveau des clusters et au niveau des tuiles, et les deux niveaux sont entièrement gérés par logiciel. Microsoft présente cela comme un contrôle déterministe du placement et de la localité, soit directement par les développeurs, soit via des décisions du compilateur et de l'environnement d'exécution.
L'entreprise décrit plusieurs modèles d'utilisation prévus : les noyaux GEMM peuvent conserver les tuiles intermédiaires dans la TSRAM afin d'éviter les allers-retours vers la HBM ; les noyaux d'attention peuvent épingler localement les tenseurs clés et les produits partiels pour réduire la surcharge liée aux transferts ; et la communication collective peut mettre en mémoire tampon les charges utiles dans la CSRAM pendant que l'accumulation se déroule dans la TSRAM afin d'éviter la surcharge de la HBM lors des opérations multi-nœuds. Microsoft souligne également l'utilité de la CSRAM comme mémoire tampon transitoire pour les pipelines inter-noyaux, dans le but de réduire les blocages dans les chaînes d'opérateurs denses et les charges de travail fusionnées.
Transfert de données : NoC personnalisé et DMA multi-niveaux
Microsoft considère que les performances d'inférence sont souvent limitées par les transferts de données plutôt que par le débit de calcul maximal. C'est pourquoi Maia investit massivement dans des transferts prévisibles et une signalisation de contrôle à faible latence. L'interconnexion sur puce est décrite comme un maillage couvrant les clusters, les tuiles, les contrôleurs de mémoire et les unités d'E/S, avec des plans logiques distincts pour le trafic tensoriel à large bande passante et le trafic de contrôle sensible à la latence. Cette séparation vise à éviter que la synchronisation, les interruptions et les petits messages ne soient bloqués par des transferts massifs.
Microsoft mentionne également la diffusion hiérarchique pour réduire les lectures HBM redondantes, le trafic de cluster localisé pour maintenir les mouvements importants au sein du cluster, l'accès SRAM de tuile à tuile pour le partage intra-cluster sans solliciter la HBM, et des mécanismes QoS pour prioriser le trafic de contrôle et de sortie urgent. Les moteurs DMA sont organisés en niveaux selon les rôles de tuile, de cluster et de réseau, permettant des transferts simultanés entre les niveaux de mémoire et les liaisons hors puce pendant que le calcul se poursuit.
Mise à l'échelle des réseaux : carte réseau intégrée, Ethernet et ATL
Pour l'inférence multi-accélérateurs, Maia utilise une carte réseau intégrée et une architecture Ethernet évolutive basée sur la couche de transport IA (ATL) de Microsoft. Microsoft précise qu'ATL fonctionne de bout en bout sur un réseau Ethernet standard et est conçue pour être compatible avec les commutateurs multi-fournisseurs courants, tout en ajoutant des fonctionnalités de transport telles que la pulvérisation de paquets, le routage multipath et le contrôle de flux résistant à la congestion.
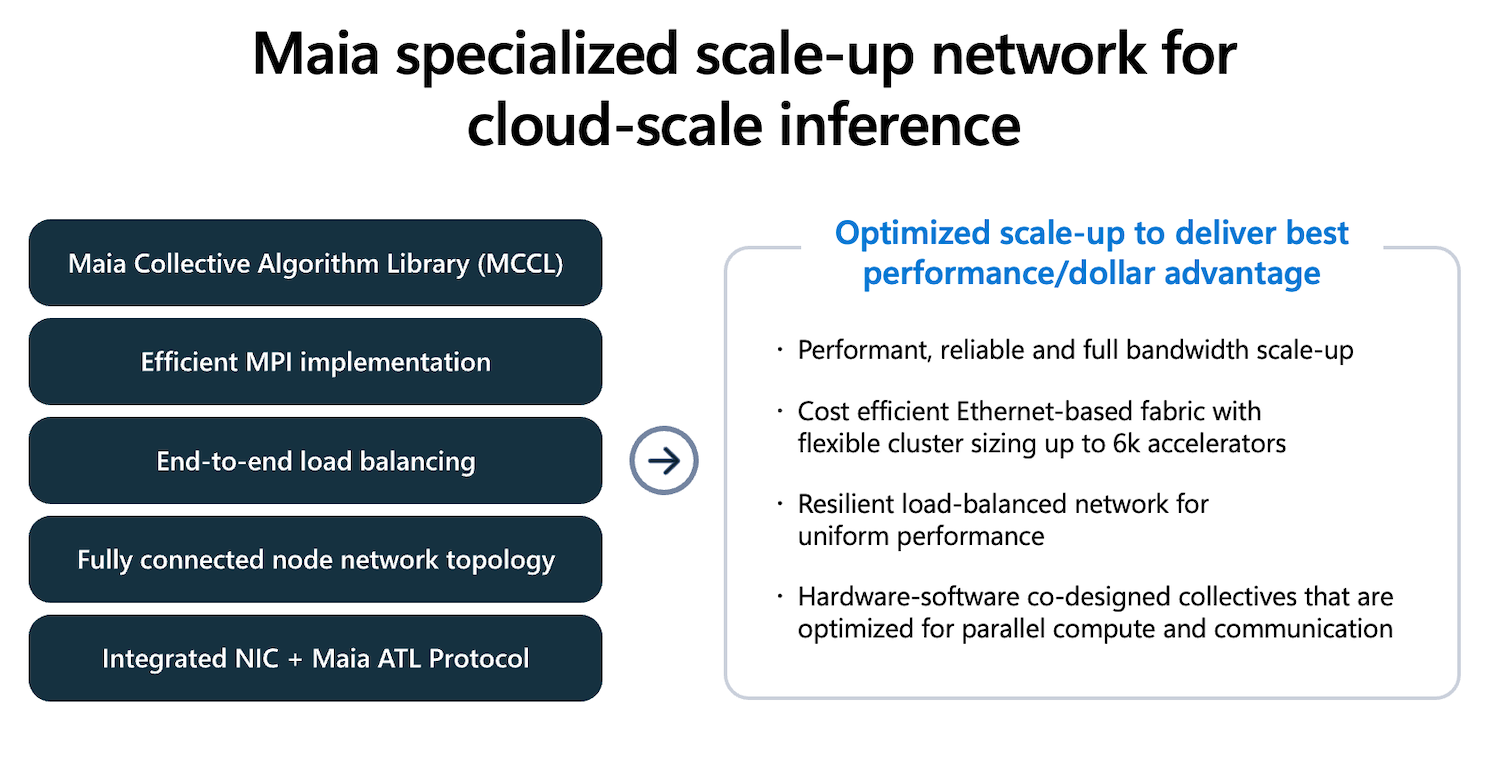
Microsoft décrit également un choix de topologie visant à réduire la dépendance aux commutateurs externes pour le trafic local parallèle des tenseurs. Son architecture Fully Connected Quad (FCQ) regroupe quatre accélérateurs par des liaisons directes, évitant ainsi de solliciter le réseau commuté pour les opérations collectives locales à haute intensité. Un second niveau permet ensuite d'étendre la capacité au-delà du domaine FCQ vers des clusters plus importants, que Microsoft considère comme « optimaux » pour les modèles de synchronisation d'inférence, contrairement au comportement global de type entraînement.
Côté logiciel, Microsoft met en avant la bibliothèque de communication collective Microsoft (MCCL), conçue conjointement avec le matériel pour optimiser la montée en charge. L'entreprise souligne le chevauchement des opérations de calcul et d'E/S, les collectifs hiérarchiques, la sélection dynamique des algorithmes et l'ordonnancement en pipeline pour masquer la latence et réduire la charge sur le réseau.
Modèle d'intégration et de déploiement Azure
Microsoft présente Maia comme une solution native d'Azure plutôt que comme un accélérateur autonome. Conçue pour s'aligner sur les normes Azure en matière de racks, d'alimentation et de mécanique utilisées par les systèmes GPU tiers, Maia simplifie le déploiement et la maintenance et permet de gérer des parcs d'accélérateurs hétérogènes au sein d'un même centre de données.
Maia est conçue pour les environnements à refroidissement par air et par liquide, et propose notamment une option de refroidissement liquide de deuxième génération pour les racks haute densité. Sur le plan opérationnel, la plateforme s'intègre au plan de contrôle Azure pour la gestion du cycle de vie, la surveillance de l'état, le déploiement des mises à jour de firmware et les flux de travail de parc, afin de minimiser l'impact sur les services lors des mises à niveau et de la maintenance.
Microsoft indique que Maia fera partie de son infrastructure d'IA hétérogène, prenant en charge de nombreux modèles, notamment les derniers modèles GPT-5.2 d'OpenAI, et sera utilisée pour alimenter les charges de travail d'IA dans Microsoft Foundry et Microsoft 365 Copilot. L'entreprise souligne que les charges de travail peuvent être planifiées, partitionnées et surveillées à l'aide des mêmes outils que les parcs de GPU d'Azure, ce qui vise la portabilité et la possibilité d'optimiser les performances par dollar, la latence ou la capacité sans avoir à repenser l'orchestration.
Chaîne d'outils de développement : kit de développement logiciel Maia 200, chemin Triton et contrôle de bas niveau
Microsoft décrit un kit de développement logiciel (SDK) Maia 200 compatible avec des points d'entrée familiers tels que PyTorch, tout en offrant plusieurs niveaux de contrôle. Parmi les options figurent le compilateur Maia Triton pour la génération du noyau, des bibliothèques de noyau optimisées pour l'architecture par tuiles et par clusters, ainsi que le langage parallèle imbriqué (NPL) de Microsoft pour la gestion explicite des déplacements de données, du placement de la SRAM et de l'exécution parallèle.
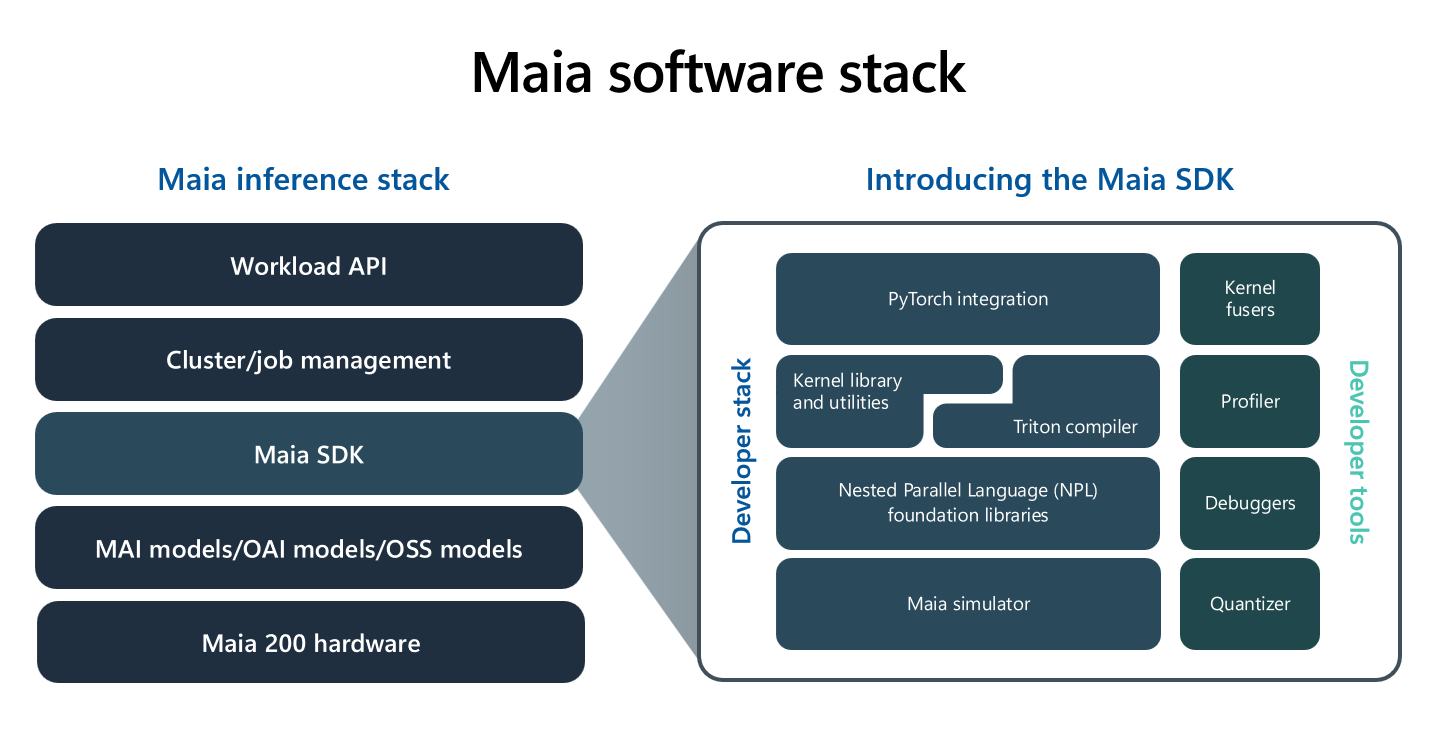
Le kit de développement logiciel (SDK) comprend également un simulateur, un pipeline de compilation, un profileur, un débogueur, ainsi que des outils de quantification et de validation. Microsoft le présente comme un moyen de prototyper et d'optimiser les performances dès les premières étapes, de diagnostiquer les goulots d'étranglement et d'améliorer l'utilisation des ressources sur l'ensemble de la pile logicielle.
En résumé
Microsoft positionne Maia 200 comme une plateforme d'inférence dédiée, axée sur le rapport performances/prix et performances énergétiques, avec une architecture privilégiant le calcul haute précision, la gestion logicielle de la SRAM et une infrastructure Ethernet évolutive intégrée directement sur la puce. L'entreprise revendique un gain de 30 % en performances par dollar investi par rapport à son parc matériel actuel, grâce à une optimisation coordonnée des puces, du réseau, des systèmes et des opérations Azure.


 Amazon