

MinIO a annoncé MemKV, un système de stockage de contexte en mémoire conçu pour pallier un goulot d'étranglement croissant dans les environnements d'inférence IA à grande échelle. Deuxième composant essentiel de son portefeuille aux côtés d'AIStor , MemKV étend l'infrastructure de données de MinIO à la couche mémoire, offrant un contexte persistant et partagé pour les charges de travail d'IA multi-agents exécutées sur des clusters GPU.
À mesure que les systèmes d'IA évoluent des interactions à réponse unique vers le raisonnement et l'exécution de tâches en plusieurs étapes, la préservation du contexte tout au long des cycles d'inférence devient cruciale. Dans les architectures actuelles, le contexte est fréquemment perdu en raison de la capacité limitée des couches de mémoire adjacentes au GPU, telles que la HBM et la DRAM. Ceci contraint les GPU à recalculer le contexte précédemment généré, ce qui augmente la latence, l'utilisation des ressources de calcul et la consommation d'énergie. MinIO qualifie ce phénomène de surcharge de recalcul qui s'accroît à grande échelle, notamment dans les environnements hyperscale et cloud.
MemKV est conçu pour atténuer ce problème en fournissant une couche de mémoire partagée et persistante capable d'une récupération en quelques microsecondes à l'échelle du pétaoctet. En conservant le contexte lors des opérations d'inférence, la plateforme réduit les calculs redondants et améliore l'efficacité globale du système. Lors de tests internes, MinIO a constaté des améliorations du temps d'obtention du premier jeton aux niveaux de concurrence de production. Dans un déploiement représentatif avec 128 GPU et des fenêtres de contexte de 128 000 jetons, l'utilisation des GPU est passée d'environ 50 % à plus de 90 %, ce qui a permis de réaliser d'importantes économies sur les coûts de calcul annuels.
La direction de MinIO a souligné que la surcharge liée au recalcul, historiquement masquée dans les déploiements de petite taille, devient une source d'inefficacité structurelle à grande échelle. Avec la croissance des clusters GPU, le coût de la régénération répétée du contexte augmente, tant en termes de consommation d'énergie que d'exigences d'infrastructure, rendant indispensables des systèmes de mémoire dédiés pour des opérations d'IA durables.
Résoudre le compromis entre la mémoire et l'échelle
L'infrastructure d'IA traditionnelle impose un compromis entre vitesse et échelle. Les mémoires hautes performances telles que la HBM et la DRAM offrent une latence de l'ordre de la microseconde, mais leur capacité est limitée et leur coût élevé. À l'inverse, les systèmes de stockage offrent une grande échelle, mais introduisent une latence de l'ordre de la milliseconde, ce qui les rend inadaptés à l'inférence en temps réel et au raisonnement sur des contextes longs.
MemKV est conçu pour combler cet écart en introduisant une couche de mémoire partagée qui combine un accès à faible latence et une capacité à grande échelle. Conçue pour fonctionner sur NVIDIA BlueField-4 STX et intégrée à NVIDIA Dynamo et NIXL, la plateforme permet à un cluster GPU entier d'accéder à un pool commun de données de contexte à des vitesses adaptées aux exigences d'inférence. Cette approche élimine la nécessité de transférer le contexte entre différentes couches de mémoire et de stockage, réduisant ainsi la latence et améliorant le débit.
Architecture optimisée pour les charges de travail d'inférence
MemKV est spécialement conçu pour le traitement des données d'inférence et correspond à la description de la couche G3.5 de MinIO dans la hiérarchie mémoire du GPU. Il offre une capacité de l'ordre du pétaoctet sur une infrastructure NVMe tout en conservant des temps d'accès de l'ordre de la microseconde, découplant ainsi efficacement la capacité mémoire des ressources de calcul du GPU.
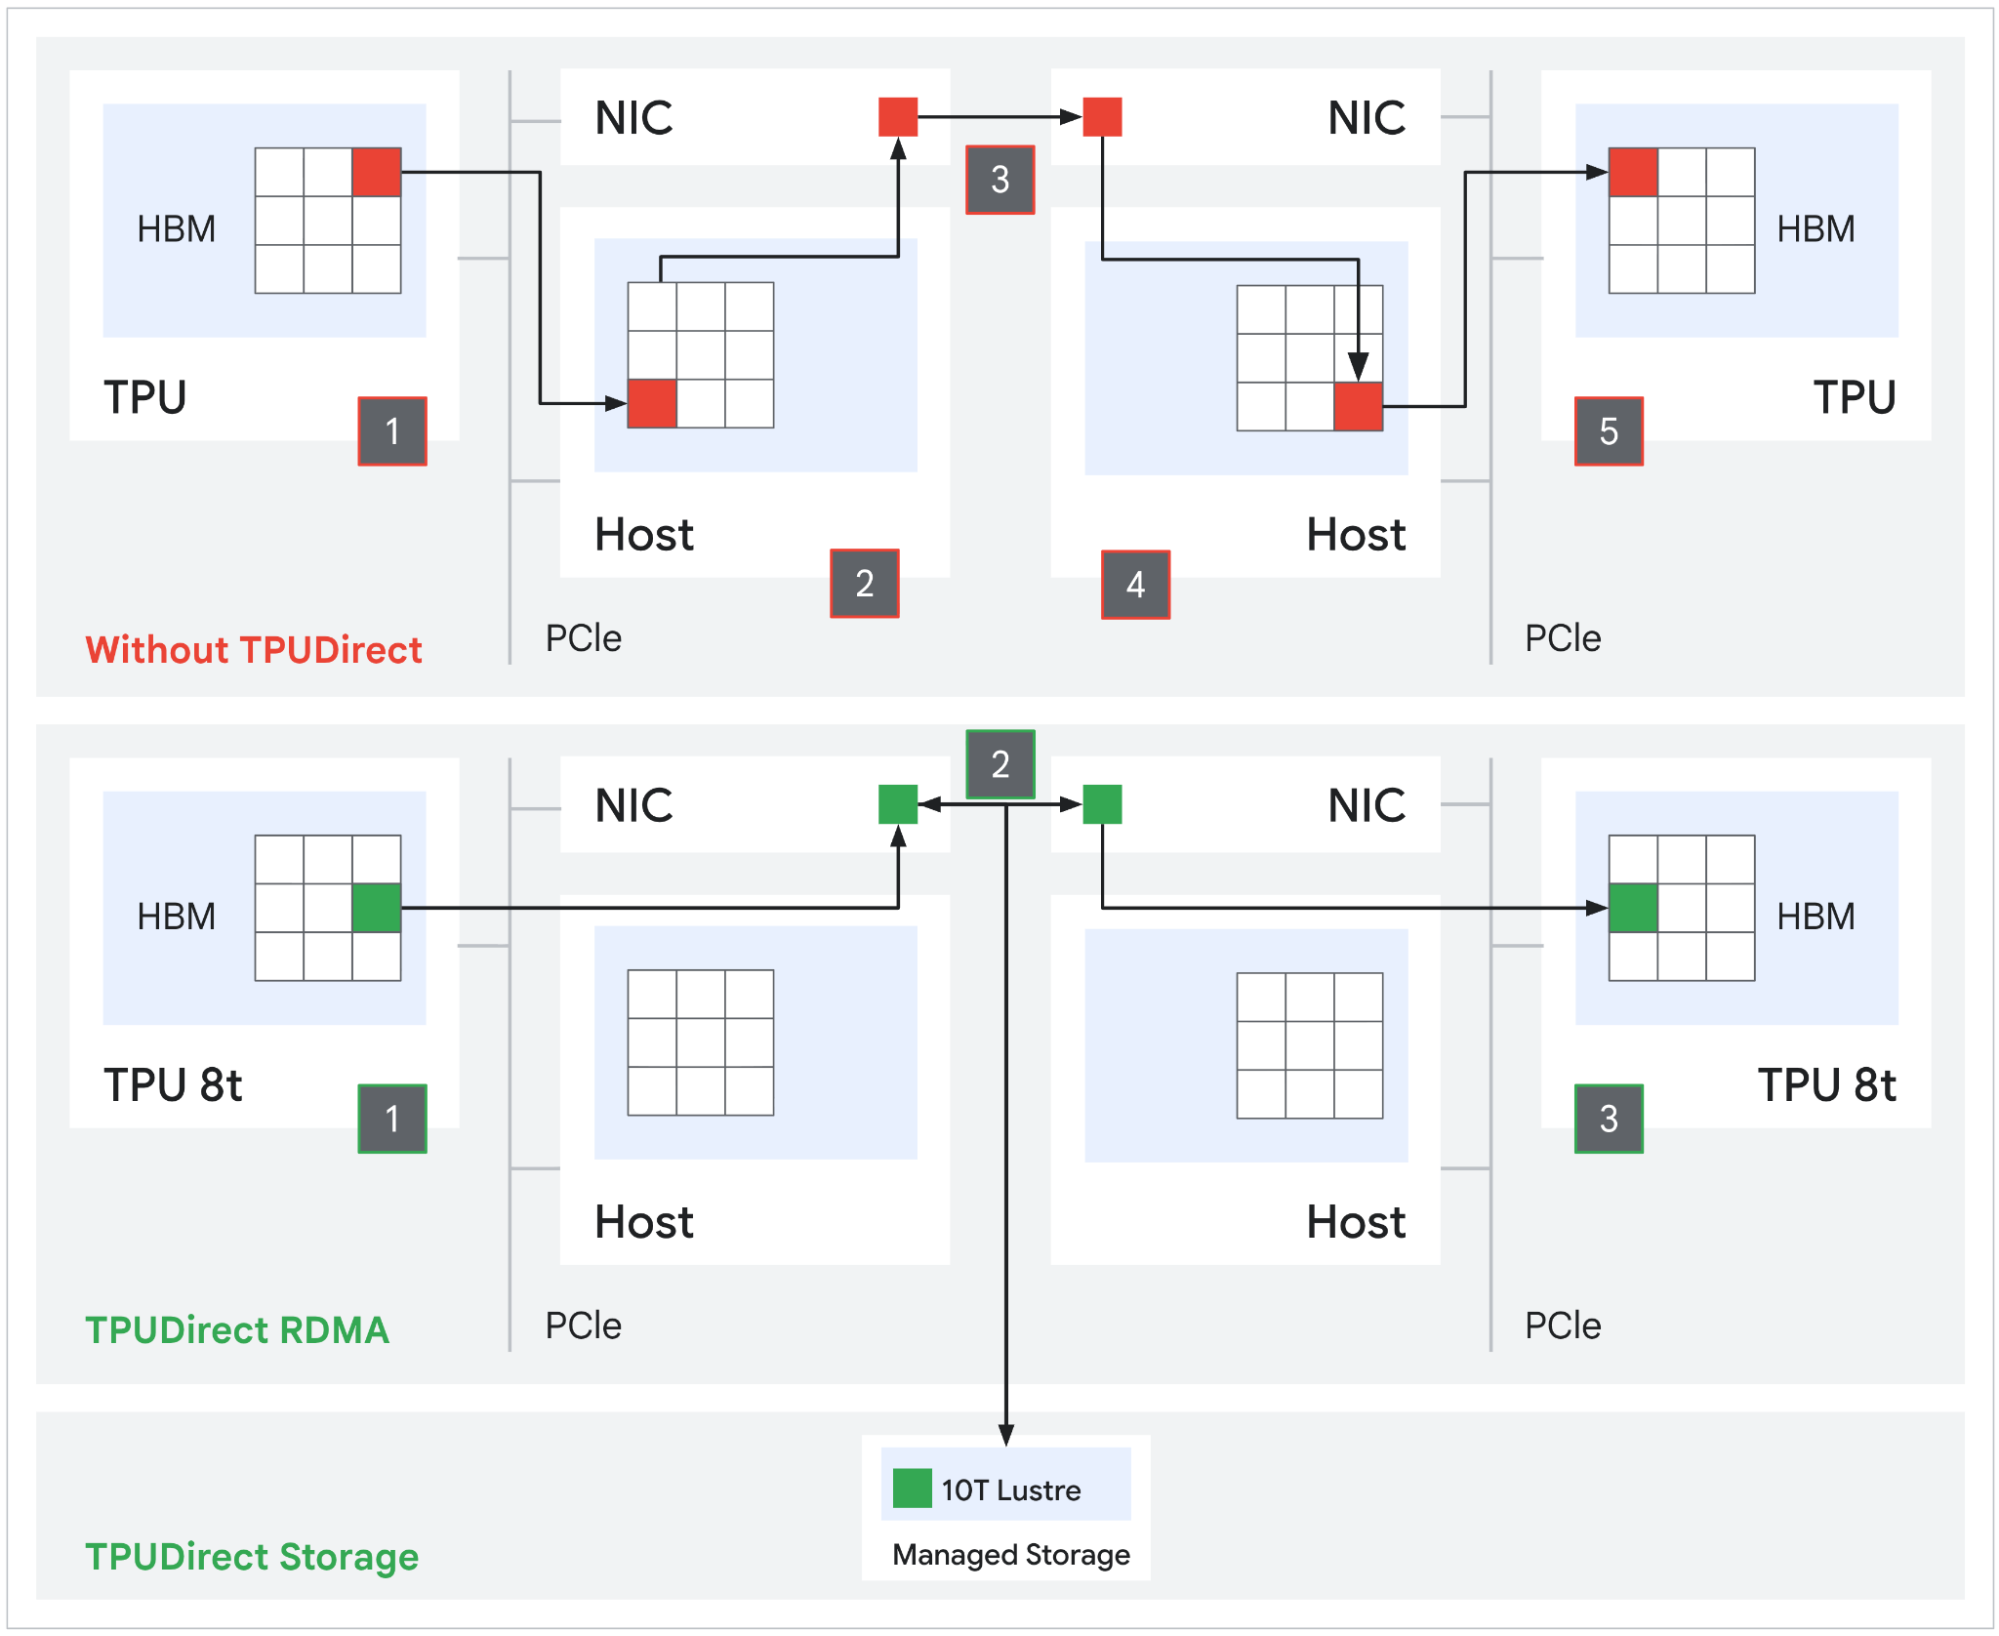
Le système s'affranchit des abstractions de stockage traditionnelles en transférant les données directement du NVMe vers le chemin de données de l'IA via un transport RDMA de bout en bout . Ceci élimine la surcharge liée aux protocoles HTTP, à la traduction du système de fichiers et aux serveurs de stockage intermédiaires, courants dans les architectures orientées objet et fichiers.
Source: Google
L'architecture repose notamment sur une exécution native sur NVIDIA BlueField-4 STX sous forme de binaire ARM64 intégré à la couche de stockage, réduisant ainsi la dépendance aux nœuds de stockage x86 externes. Les transferts de données s'effectuent via RDMA de la mémoire GPU vers NVMe, court-circuitant les architectures de stockage classiques. MemKV utilise également des blocs de plus grande taille, de 2 Mo à 16 Mo, optimisés pour le débit du GPU plutôt que pour les anciens blocs de stockage de 4 Ko. Les performances réseau sont compatibles avec les technologies haut débit modernes, notamment NVIDIA Spectrum-X Ethernet et PCIe Gen6, permettant des transferts de données quasi instantanés au sein du cluster.
Disponibilité
MinIO MemKV est disponible immédiatement.


 Amazon