

Les infrastructures d'IA sont réputées pour leur forte consommation de ressources, et les entreprises sont constamment confrontées au défi d'optimiser l'utilisation des GPU. Dell Technologies, via sa plateforme AI Factory, relève ce défi en intégrant Run:ai , la solution d'orchestration récemment acquise par NVIDIA . Dans un article de blog récent , Dell a souligné comment Run:ai maximise l'utilisation des ressources et accélère les résultats de l'IA, transformant ainsi la manière dont les entreprises déploient et gèrent les ressources GPU à grande échelle.
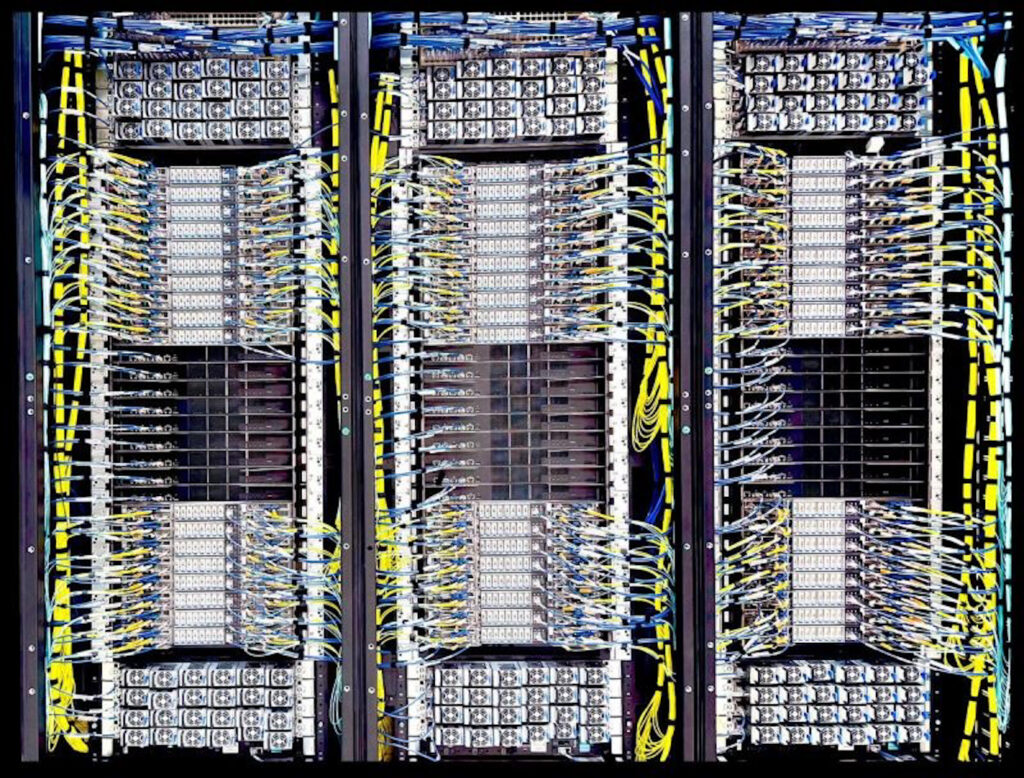
Cluster Dell NVL72
Qu'est-ce que Run:ai exactement ?
Run:ai est une plateforme d'orchestration basée sur Kubernetes, spécialement conçue pour les charges de travail centrées sur les GPU. Fondée en 2018, Run:ai a gagné en popularité en s'attaquant à un problème majeur du secteur : l'utilisation inefficace des GPU. Traditionnellement, les GPU affectés aux charges de travail d'IA sont souvent inutilisés ou sous-utilisés. Run:ai résout ce problème en mutualisant dynamiquement et en planifiant intelligemment les ressources GPU, permettant ainsi une allocation fractionnée des GPU, des déploiements multi-GPU efficaces et une gestion transparente dans les environnements hybrides, cloud et sur site.
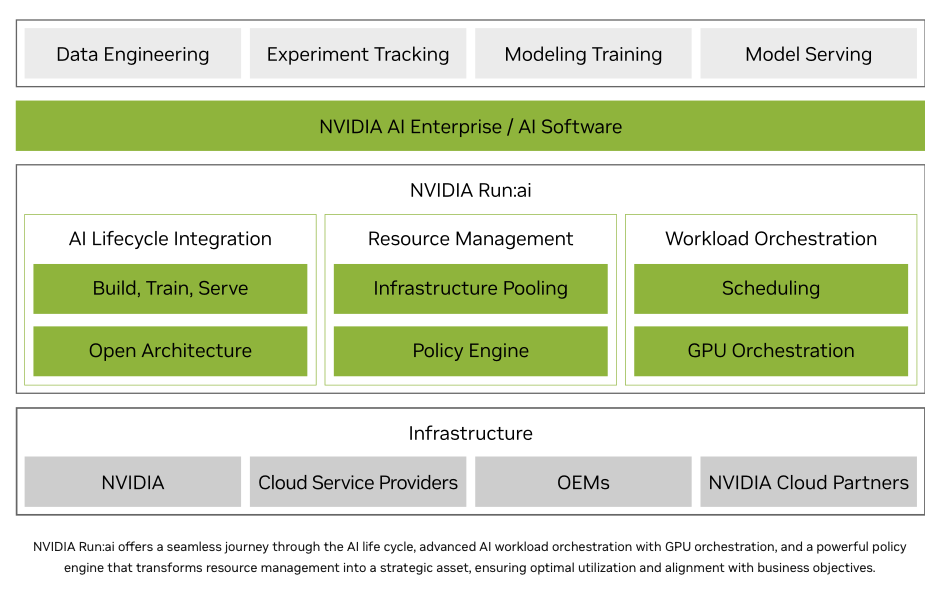
Consciente du potentiel de Run:ai pour transformer radicalement l'infrastructure de l'IA, NVIDIA a finalisé son acquisition en décembre 2024 pour environ 700 millions de dollars. Fait intéressant, NVIDIA s'est engagée à terme à rendre Run:ai open source, témoignant ainsi de sa volonté de favoriser une large adoption au sein de son écosystème, au-delà de ses plateformes matérielles. Cette initiative devrait accélérer l'innovation et améliorer l'efficacité de l'ensemble du secteur.
Pour ceux qui souhaitent approfondir leurs connaissances techniques sur la gestion des ressources, la documentation NVIDIA détaille l'importance de Run:ai pour l'orchestration des charges de travail sur les systèmes GB200 NVL72. Elle met en lumière une lacune critique : Kubernetes ne reconnaît pas nativement l'architecture MNNVL de NVIDIA, ce qui complexifie la gestion et la planification des charges de travail sur ces domaines hautes performances. Run:ai simplifie cette complexité en détectant automatiquement les domaines NVLink et en facilitant la soumission des charges de travail distribuées. Ainsi, les pods sont correctement placés sur les nœuds dotés d'interconnexions NVLink, ce qui élimine le besoin de connaissances matérielles approfondies ou de configuration manuelle pour chaque tâche. Ces fonctionnalités démontrent comment la plateforme rationalise les opérations dans les environnements de formation denses, permettant aux entreprises d'exploiter pleinement la puissance des configurations matérielles avancées, telles que le GB200 NVL72.
Pourquoi cela est important pour l'entreprise
Pour les organisations exécutant des charges de travail gourmandes en ressources GPU, notamment celles impliquant l'IA générative et les grands modèles de langage, la sous-utilisation des GPU représente un risque majeur : un gaspillage d'investissement. Run:ai s'attaque directement à ces inefficacités ; NVIDIA indique que les organisations utilisant cette plateforme peuvent constater une amélioration de l'utilisation des GPU jusqu'à cinq fois supérieure.
Ce niveau d'optimisation améliore non seulement le retour sur investissement, mais transforme également fondamentalement l'efficacité opérationnelle. Les équipes auparavant limitées par des ressources limitées et des processus de planification complexes disposent désormais des outils nécessaires pour déployer davantage de modèles simultanément, évoluer rapidement et expérimenter de manière plus intensive, le tout sans investissement matériel supplémentaire. Si ces méthodologies sont courantes dans les déploiements HPC à grande échelle, le niveau d'efficacité requis pour optimiser l'utilisation des GPU est moins courant en entreprise.
Dynamique générale de l'industrie
Plusieurs grands fournisseurs d’infrastructures adoptent la plateforme, signalant un élan croissant dans le paysage informatique de l’entreprise.
Dell continue de développer sa plateforme AI Factory, basée sur les technologies NVIDIA, notamment Run:ai. L'utilisation de Run:ai par Dell illustre comment les entreprises peuvent passer d'une allocation manuelle et cloisonnée des ressources à une planification automatisée et dynamique, gage d'une efficacité accrue dans les environnements mutualisés.
HPE propose Run:ai sur sa plateforme GreenLake Marketplace, en l'intégrant à Ezmeral pour permettre une planification GPU avancée, une allocation fractionnée et une orchestration d'infrastructure hybride. Les clients peuvent ainsi déployer et gérer des charges de travail d'IA avec une précision et une évolutivité accrues.
Cisco intègre Run:ai à ses serveurs UCS série X et à sa plateforme d'opérations cloud Intersight. Cette solution met en avant la gestion des quotas, le partage fractionné des GPU et la surveillance en temps réel pour prendre en charge les déploiements d'IA à grande échelle sur site.
Nous avons présenté quelques-uns des partenaires de Run:ai. NVIDIA possède une longue liste de logos, comme indiqué ci-dessus. De nombreux OEM et fournisseurs de plateformes cloud de premier plan s'associent à Run:ai pour proposer des solutions d'infrastructure d'IA plus innovantes et plus performantes.



 Amazon