

Pliops a annoncé un partenariat stratégique avec vLLM Production Stack , une implémentation de référence open source à l'échelle d'un cluster, conçue pour optimiser les charges de travail d'inférence de modèles de langage (LLM) de grande envergure. Ce partenariat est crucial à l'approche de la conférence GTC 2025, qui réunira la communauté de l'IA. En combinant le système de stockage clé-valeur (KV) avancé de Pliops avec l'architecture robuste de vLLM Production Stack, cette collaboration établit une nouvelle référence en matière de performance, d'efficacité et d'évolutivité pour l'IA.
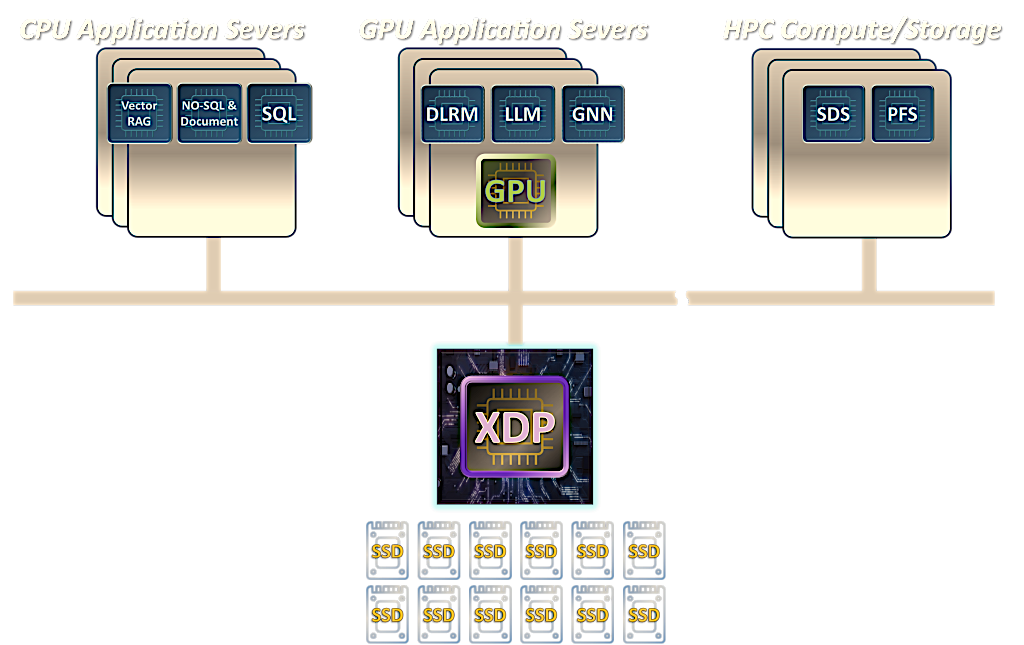
Junchen Jiang, directeur du laboratoire LMCache de l'Université de Chicago, a souligné le potentiel de cette collaboration, soulignant sa capacité à améliorer l'efficacité et les performances de l'inférence LLM. La solution commune offre des capacités avancées de recherche et de récupération vectorielles grâce à l'introduction d'un nouveau niveau de mémoire à l'échelle du pétaoctet sous la mémoire à large bande passante (HBM). Les caches KV calculés sont conservés et récupérés efficacement grâce à un stockage intelligent désagrégé, accélérant ainsi l'inférence vLLM.
Pour une introduction aux Pliops, consultez notre article approfondi.
À propos de ce KVCache
La plupart des grands modèles de langage utilisent des architectures de transformateurs, qui s'appuient sur des mécanismes d'attention impliquant des matrices de requête, de clé et de valeur. Lors de la génération séquentielle de jetons, les transformateurs calculent l'attention de manière répétée, ce qui nécessite le recalcul des matrices de clé et de valeur (KV) précédentes, ce qui augmente les coûts de calcul. La mise en cache KV résout ce problème en stockant les matrices KV précédemment calculées, permettant ainsi leur réutilisation dans les prédictions de jetons ultérieures, améliorant ainsi considérablement l'efficacité et le débit de la génération.
Cependant, cela pose de nouveaux défis. Les caches KV peuvent devenir très volumineux, notamment lors de longues générations ou d'inférences par lots, avec des tailles de lots typiques de 32, et finir par dépasser la mémoire disponible. Pour pallier cette limitation, un backend de stockage de cache KV devient essentiel.
Pliops XDP LightningAI
Le déploiement de XDP LightningAI de Pliops dans les centres de données représente un changement radical en termes de rentabilité, permettant des économies substantielles par rapport aux architectures traditionnelles. En intégrant des serveurs XDP LightningAI dédiés à l'infrastructure existante, les entreprises peuvent réaliser des économies considérables, notamment une optimisation de 67 % de l'espace rack, une réduction de 66 % de la consommation électrique, une réduction annuelle de 58 % des dépenses d'exploitation et une baisse de 69 % des coûts d'investissement initiaux.
Pliops poursuit son développement avec son processeur Extreme Data Processor (XDP), l'ASIC XDP-PRO, complété par une pile logicielle d'IA complète et des nœuds distribués. Utilisant une interface d'E/S clé-valeur initiée par GPU, cette solution offre une évolutivité et des performances sans précédent. XDP LightningAI de Pliops offre des améliorations de performances de bout en bout substantielles, permettant des gains jusqu'à 8 fois supérieurs pour l'inférence vLLM, accélérant ainsi considérablement les charges de travail d'IA générative (GenAI). Grâce à l'intégration de technologies de pointe telles que DeepSeek, Pliops garantit une adaptabilité robuste aux futurs développements de l'IA.
Pliops a présenté ces avancées lors du salon AI DevWorld, soulignant comment XDP LightningAI révolutionne les performances des LLM en réduisant considérablement la puissance de calcul et les coûts. Cette démonstration illustre l'engagement de Pliops à favoriser l'innovation durable en matière d'IA à l'échelle de l'entreprise.
Collaboration continue
Pliops permet aux organisations de maximiser le potentiel des informations basées sur l'IA et de maintenir un avantage concurrentiel dans un paysage technologique en évolution rapide en fournissant un accès instantané à des données exploitables et en garantissant un chemin d'intégration transparent.
La future feuille de route de la collaboration comprend l'intégration essentielle de la pile KV-IO de Pliops dans la pile de production, progressant vers des fonctionnalités avancées telles que la mise en cache rapide sur les conversations multi-tours, le déchargement évolutif du cache KV et des stratégies de routage rationalisées.


 Amazon