

Suite au lancement initial de la plateforme DGX Spark de NVIDIA, différents constructeurs intègrent désormais l'architecture GB10 Grace Blackwell dans leurs propres systèmes de bureau compacts. Si la carte mère et les puces restent standardisées, des différences apparaissent au niveau du châssis, du refroidissement, de la configuration du stockage et des performances globales. Dans ce test, nous nous concentrons sur la solution proposée par GIGABYTE avec l'AI TOP ATOM.
À l'intérieur, on retrouve la même puce GB10 Superchip, associant un processeur Arm à 20 cœurs, l'accélération IA Blackwell et 128 Go de mémoire LPDDR5X unifiée. Cette architecture supporte une puissance de calcul FP4 jusqu'à 1 pétaflops et la modélisation de jusqu'à 200 milliards de paramètres, la positionnant ainsi comme une solution IA de niveau station de travail.
Le serveur AI TOP ATOM est logé dans un châssis compact d'un litre mesurant 150 x 150 x 50.5 mm et alimenté par un adaptateur externe de 240 W. Bien que son cœur de calcul soit identique à celui des autres systèmes Spark, nous analysons comment les choix de conception de GIGABYTE influencent la gestion thermique, les performances en charge soutenue, le stockage et l'utilisation quotidienne.
Les options de stockage peuvent atteindre 4 To de NVMe Gen5, et le système est livré avec NVIDIA DGX OS basé sur Ubuntu, ce qui le rend opérationnel immédiatement pour les charges de travail d'IA. En résumé, bien que le matériel de calcul principal reste identique à celui des autres systèmes de la gamme Spark, l'expérience utilisateur, la gestion thermique, l'acoustique et l'aspect général dépendent des atouts que GIGABYTE propose dans ce boîtier compact.
Dans cet article, nous examinerons comment la version de GIGABYTE de la plateforme Spark se compare en termes de charges de travail soutenues, de comportement de refroidissement et d'utilisation quotidienne, et si son format compact introduit des compromis notables.
| Spécifications | GIGABYTE AI TOP ATOM (GB10) |
|---|---|
| Dimensions et poids | |
| Hauteur | 2 " |
| Largeur | 5.9 " |
| Profondeur | 5.9 " |
| Poids | 2.64 kg |
| Processeur | |
| Type de processeur | NVIDIA GB10 (Grace Blackwell Superchip) (20 cœurs) |
| Graphiques intégrés | GPU NVIDIA Blackwell (intégré) |
| Mémoire | |
| Type de mémoire | LPDDR5x (mémoire système unifiée) |
| Configuration de la mémoire | 128 Go LPDDR5x, mémoire système unifiée |
| Bande passante mémoire | 273 Go/s (8533 MT/s) |
| Système d'exploitation | |
| Systèmes d'exploitation pris en charge | Système d'exploitation NVIDIA DGX |
| Ports et emplacements externes | |
| Ports réseau | Un port RJ45 (10GbE) Carte réseau NVIDIA ConnectX-7 (200G × 2 QSFP) |
| Ports USB | Trois ports USB 3.2 Gen 2×2 Type-C (20 Gbit/s) Un port USB 3.2 Gen 2×2 Type-C avec PD intégré |
| Port(s) vidéo | Un port HDMI 2.1a |
| Port de l'adaptateur secteur | USB Type-C (PD IN) |
| Emplacement de sécurité | Aucun |
| Sans-fil | |
| WiFi | WiFi 7 (AW-EM637, 2×2) |
| Bluetooth | Bluetooth 5.4 |
| Stockage | |
| options de stockage | Jusqu'à 4 To NVMe Gen5 (chiffrement automatique pris en charge) |
| Adaptateur secteur | |
| Type | Adaptateur externe 240 W (USB Type-C) |
Conception et construction du TOP ATOM de GIGABYTE AI
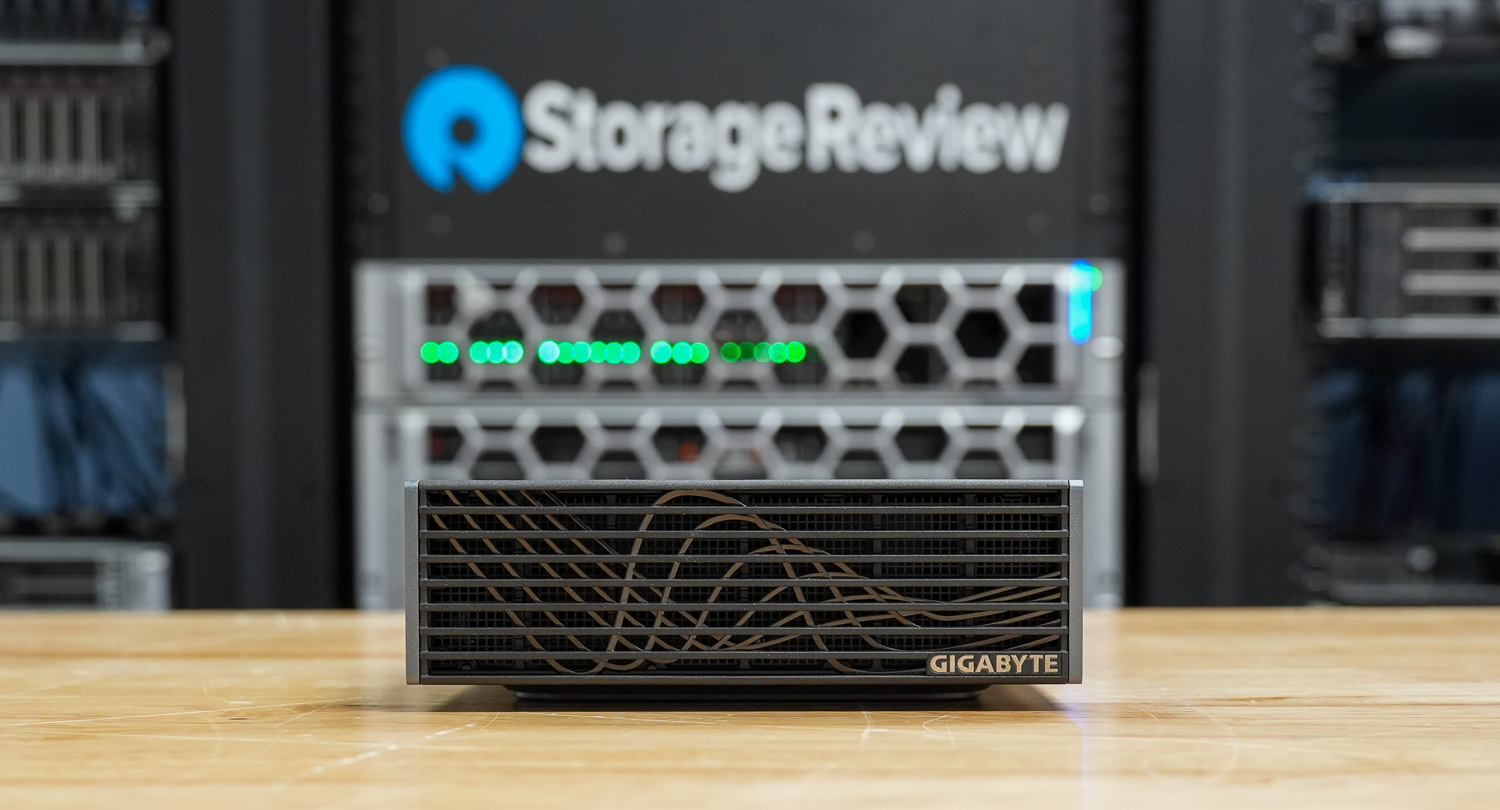
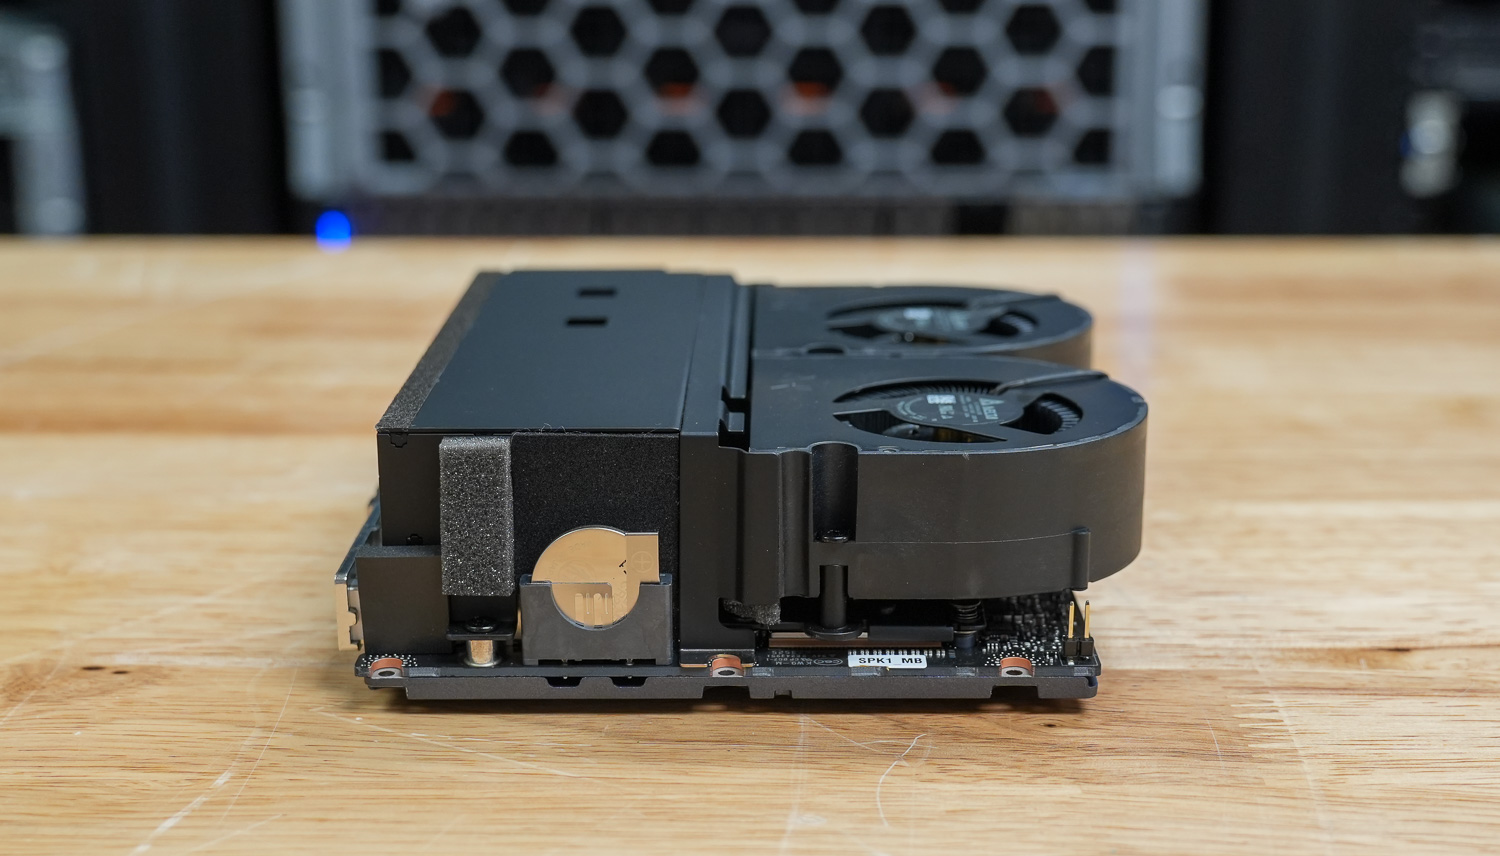
La carte mère GIGABYTE AI TOP ATOM conserve le format 150 x 150 mm caractéristique des systèmes basés sur l'architecture Spark, avec une hauteur de 50.5 mm et un poids de 1.2 kg. Suffisamment compacte pour trouver sa place sur un bureau, elle offre une sensation de robustesse et de densité lorsqu'on la prend en main. Sa finition mate et sombre lui confère un aspect plus professionnel.
Au lieu d'une simple grille plate en façade, toute la face avant est composée de lamelles horizontales et d'un subtil motif ondulé en arrière-plan, ce qui lui confère profondeur et texture selon l'angle de vue. Le design est axé sur le refroidissement. Le logo GIGABYTE est placé dans le coin inférieur, et l'absence de ports de données et de bouton d'alimentation en façade permet de conserver un design épuré et une circulation d'air optimale.
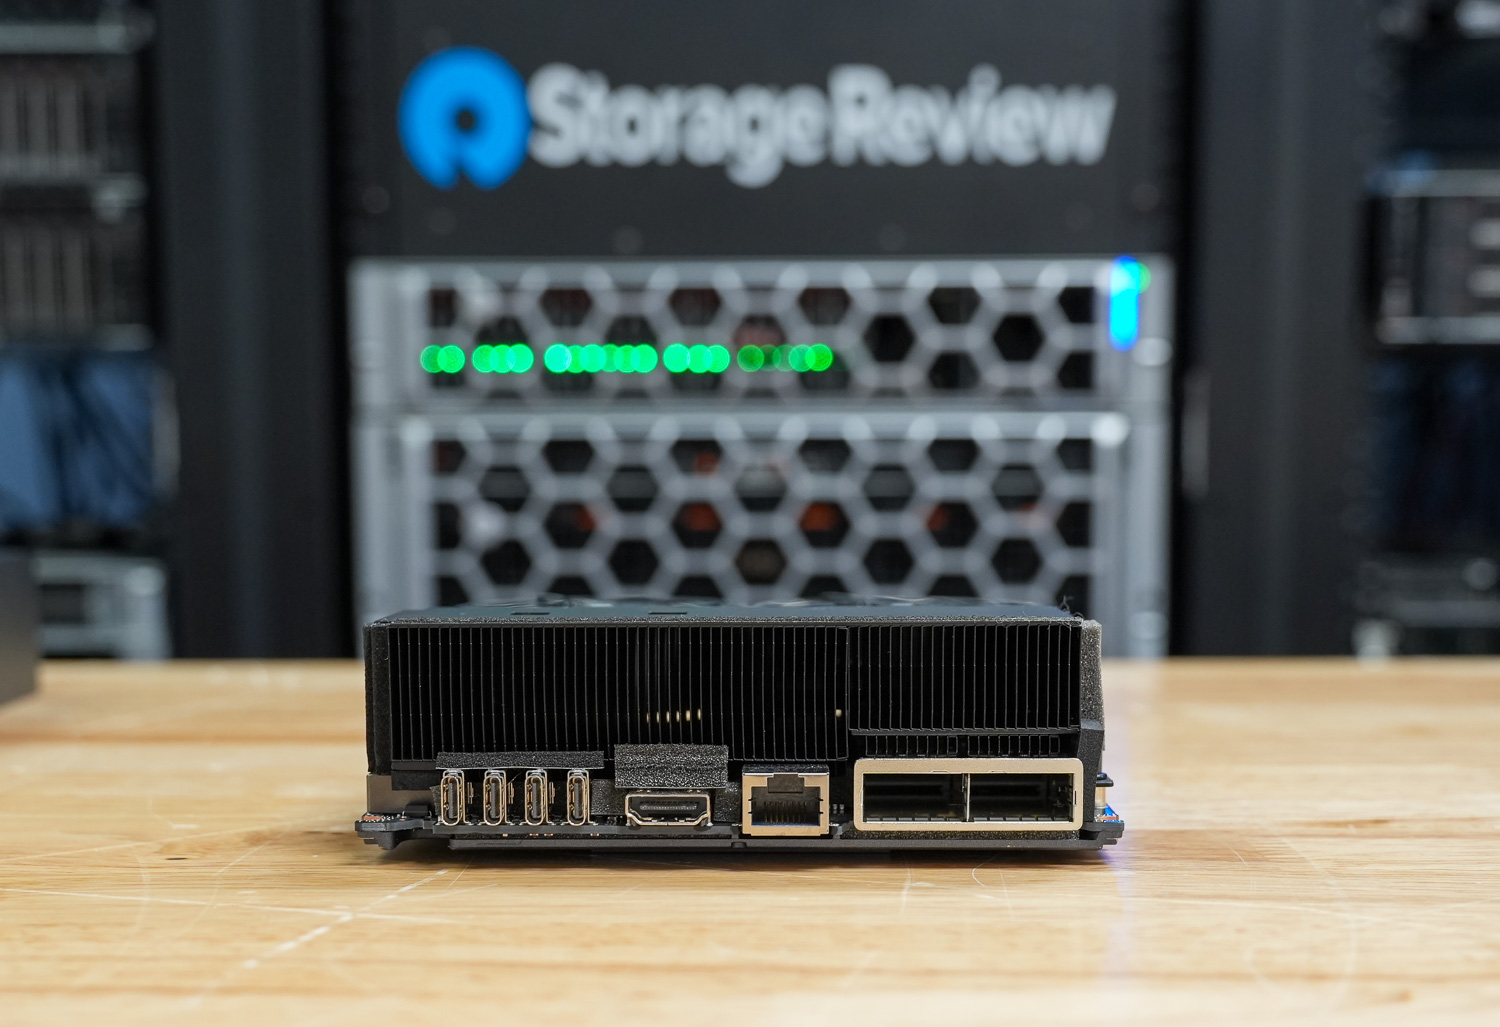
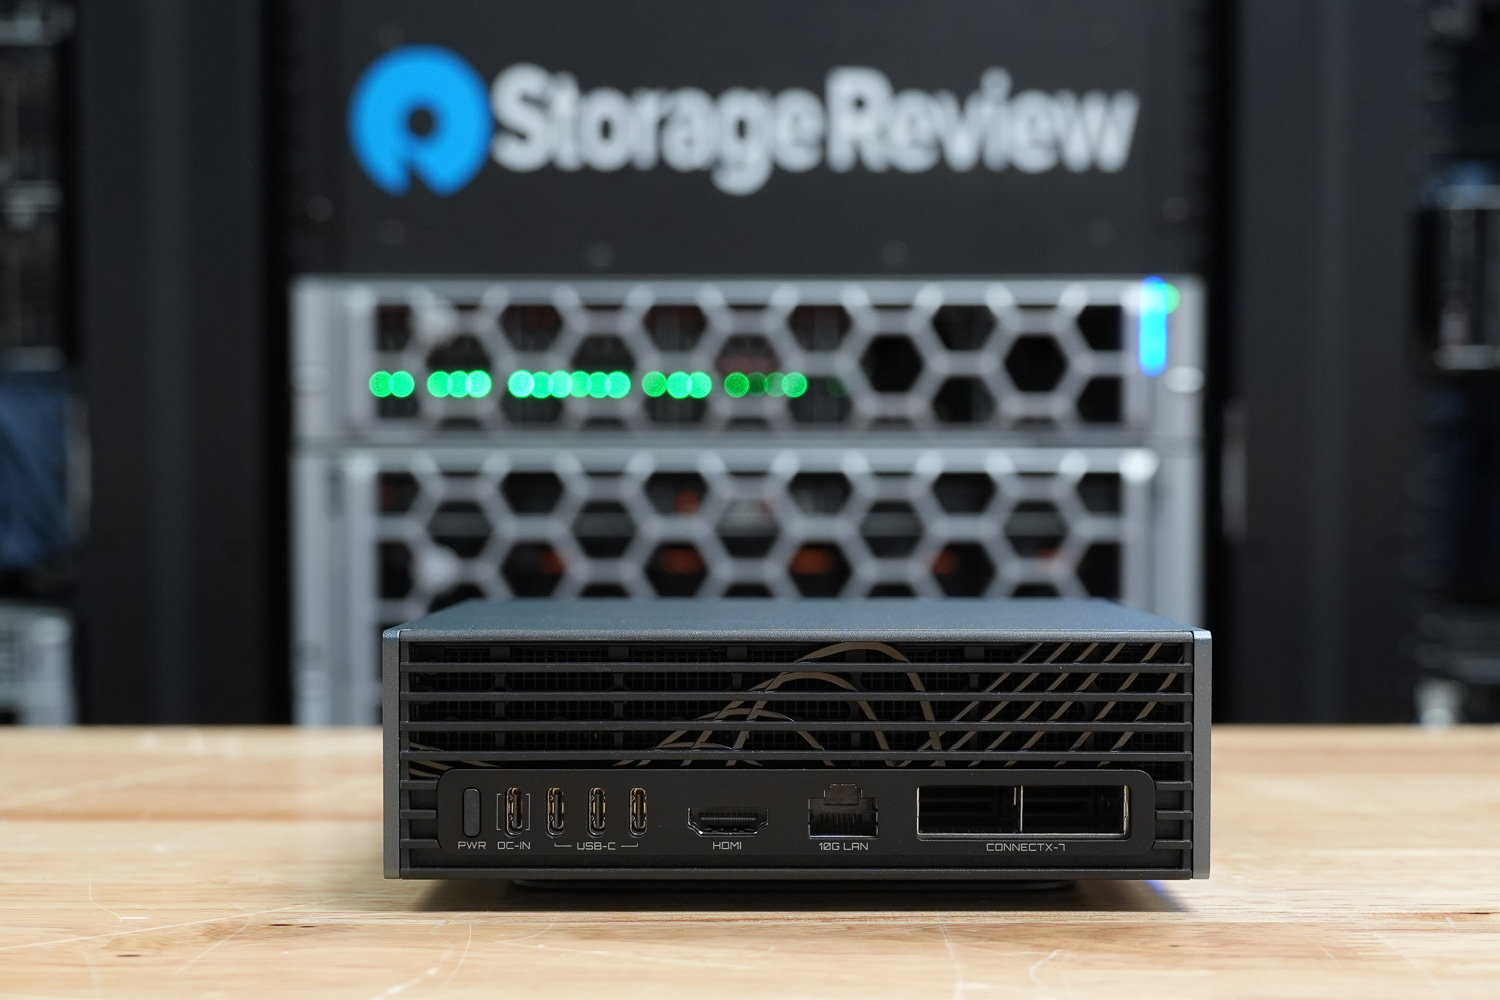
Toute la connectique se trouve sur le panneau arrière. On y trouve trois ports USB 3.2 Gen 2×2 Type-C (jusqu'à 20 Gbit/s) et un quatrième port USB Type-C dédié à l'alimentation. Pour la sortie vidéo, un port HDMI 2.1a est présent. Côté réseau, un port RJ-45 10 GbE est associé à une carte réseau intelligente NVIDIA ConnectX-7, compatible avec les transferts de données haut débit et permettant de connecter plusieurs systèmes pour une configuration plus étendue. Sur le panneau latéral, GIGABYTE a intégré un emplacement pour verrou Kensington Nano.
À l'intérieur, le TOP ATOM dédié à l'IA fonctionne avec le superprocesseur NVIDIA GB10 Grace Blackwell, combinant un processeur Arm à 20 cœurs et une carte graphique Blackwell intégrée. Il est doté de 128 Go de mémoire unifiée LPDDR5x sur une interface 256 bits, offrant une bande passante allant jusqu'à 273 Go/s. Comme les autres systèmes GB10, le processeur et la carte graphique partagent le même pool de mémoire, un élément clé de la conception de ces machines pour la gestion des charges de travail d'IA.
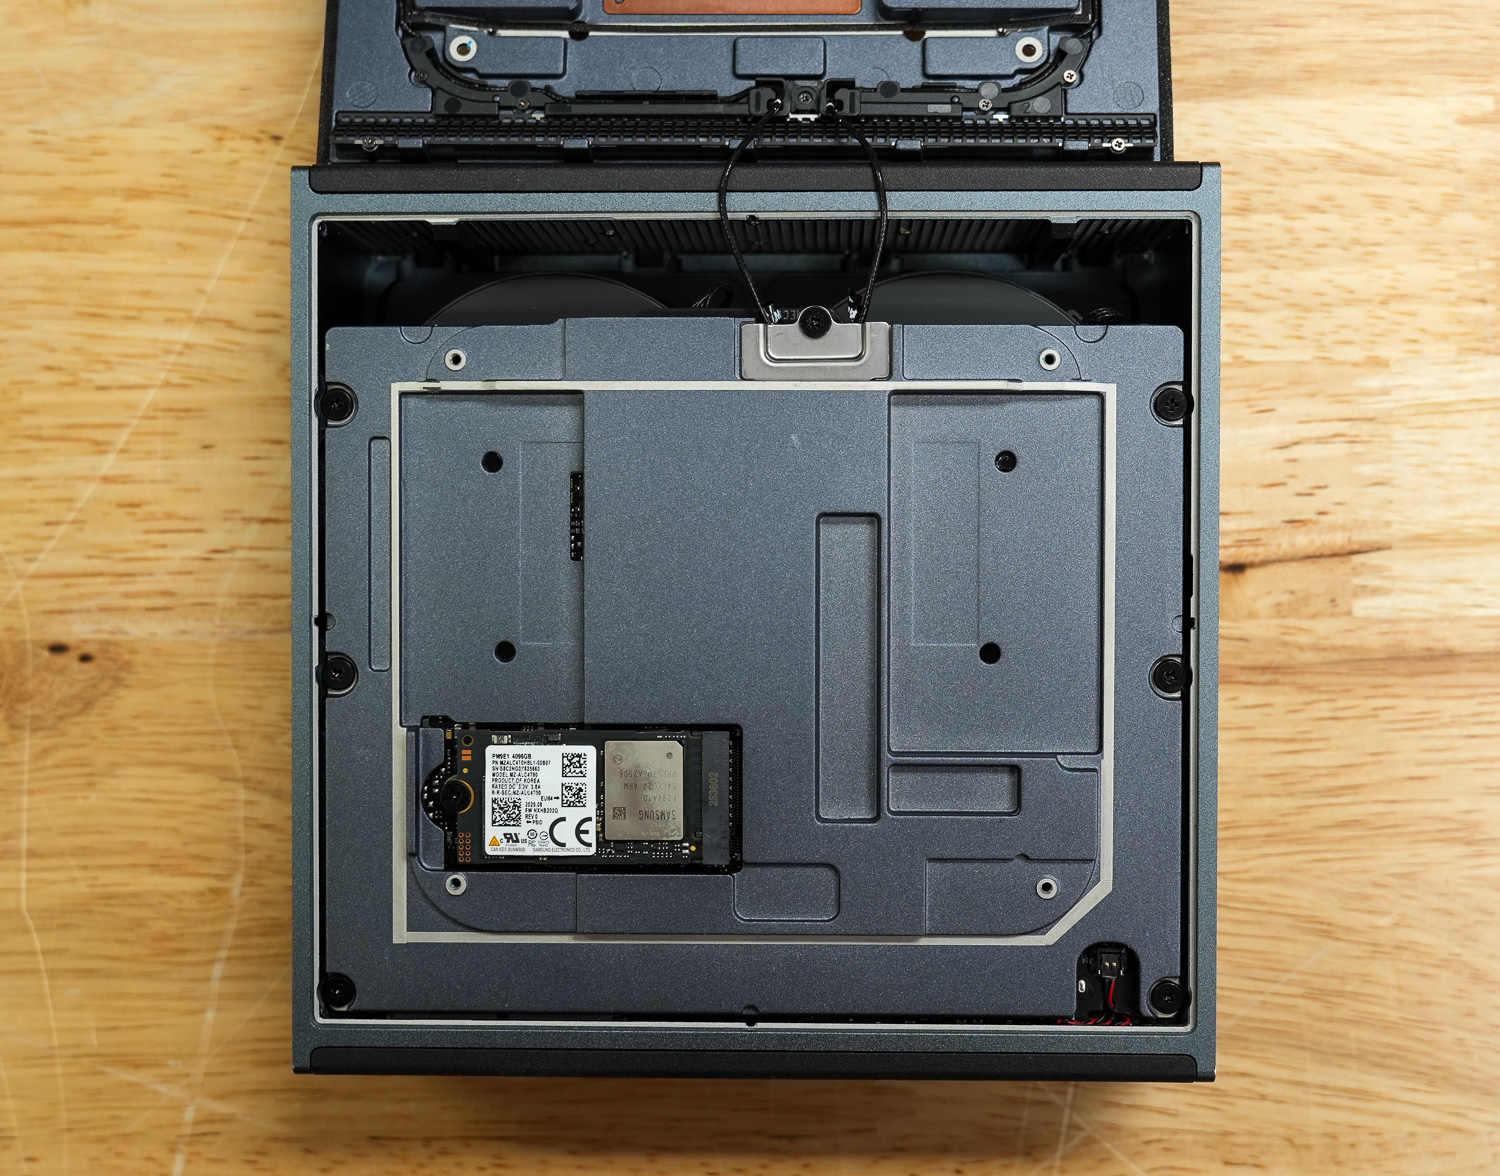
La capacité de stockage peut atteindre 4 To via un SSD NVMe Gen5, selon la configuration, et l'alimentation est fournie par un adaptateur externe de 240 W. La connectivité sans fil inclut le Wi-Fi 7 et le Bluetooth 5.4, ainsi qu'une interface réseau 10 GbE intégrée pour une connexion filaire performante.
Tests thermiques de la GIGABYTE AI TOP ATOM
Pour évaluer la dissipation thermique des composants de la GIGABYTE AI TOP ATOM, nous l'avons comparée à celle de la Founders Edition et de modèles de fabricants comme Asus, Acer et Dell. Nous avons analysé ce sujet plus en détail dans notre article « Spark Thermal Testing ».
Nous avons surveillé l'ensemble du système sur une période donnée, avec une charge de travail en trois phases, augmentant progressivement l'utilisation sur environ une heure. Cela nous a permis d'observer le système en utilisation prolongée et à différents stades de charge. Nous avons surveillé les températures du processeur, du GPU, du réseau et des disques NVMe, ainsi que la consommation électrique totale.
Température CPU
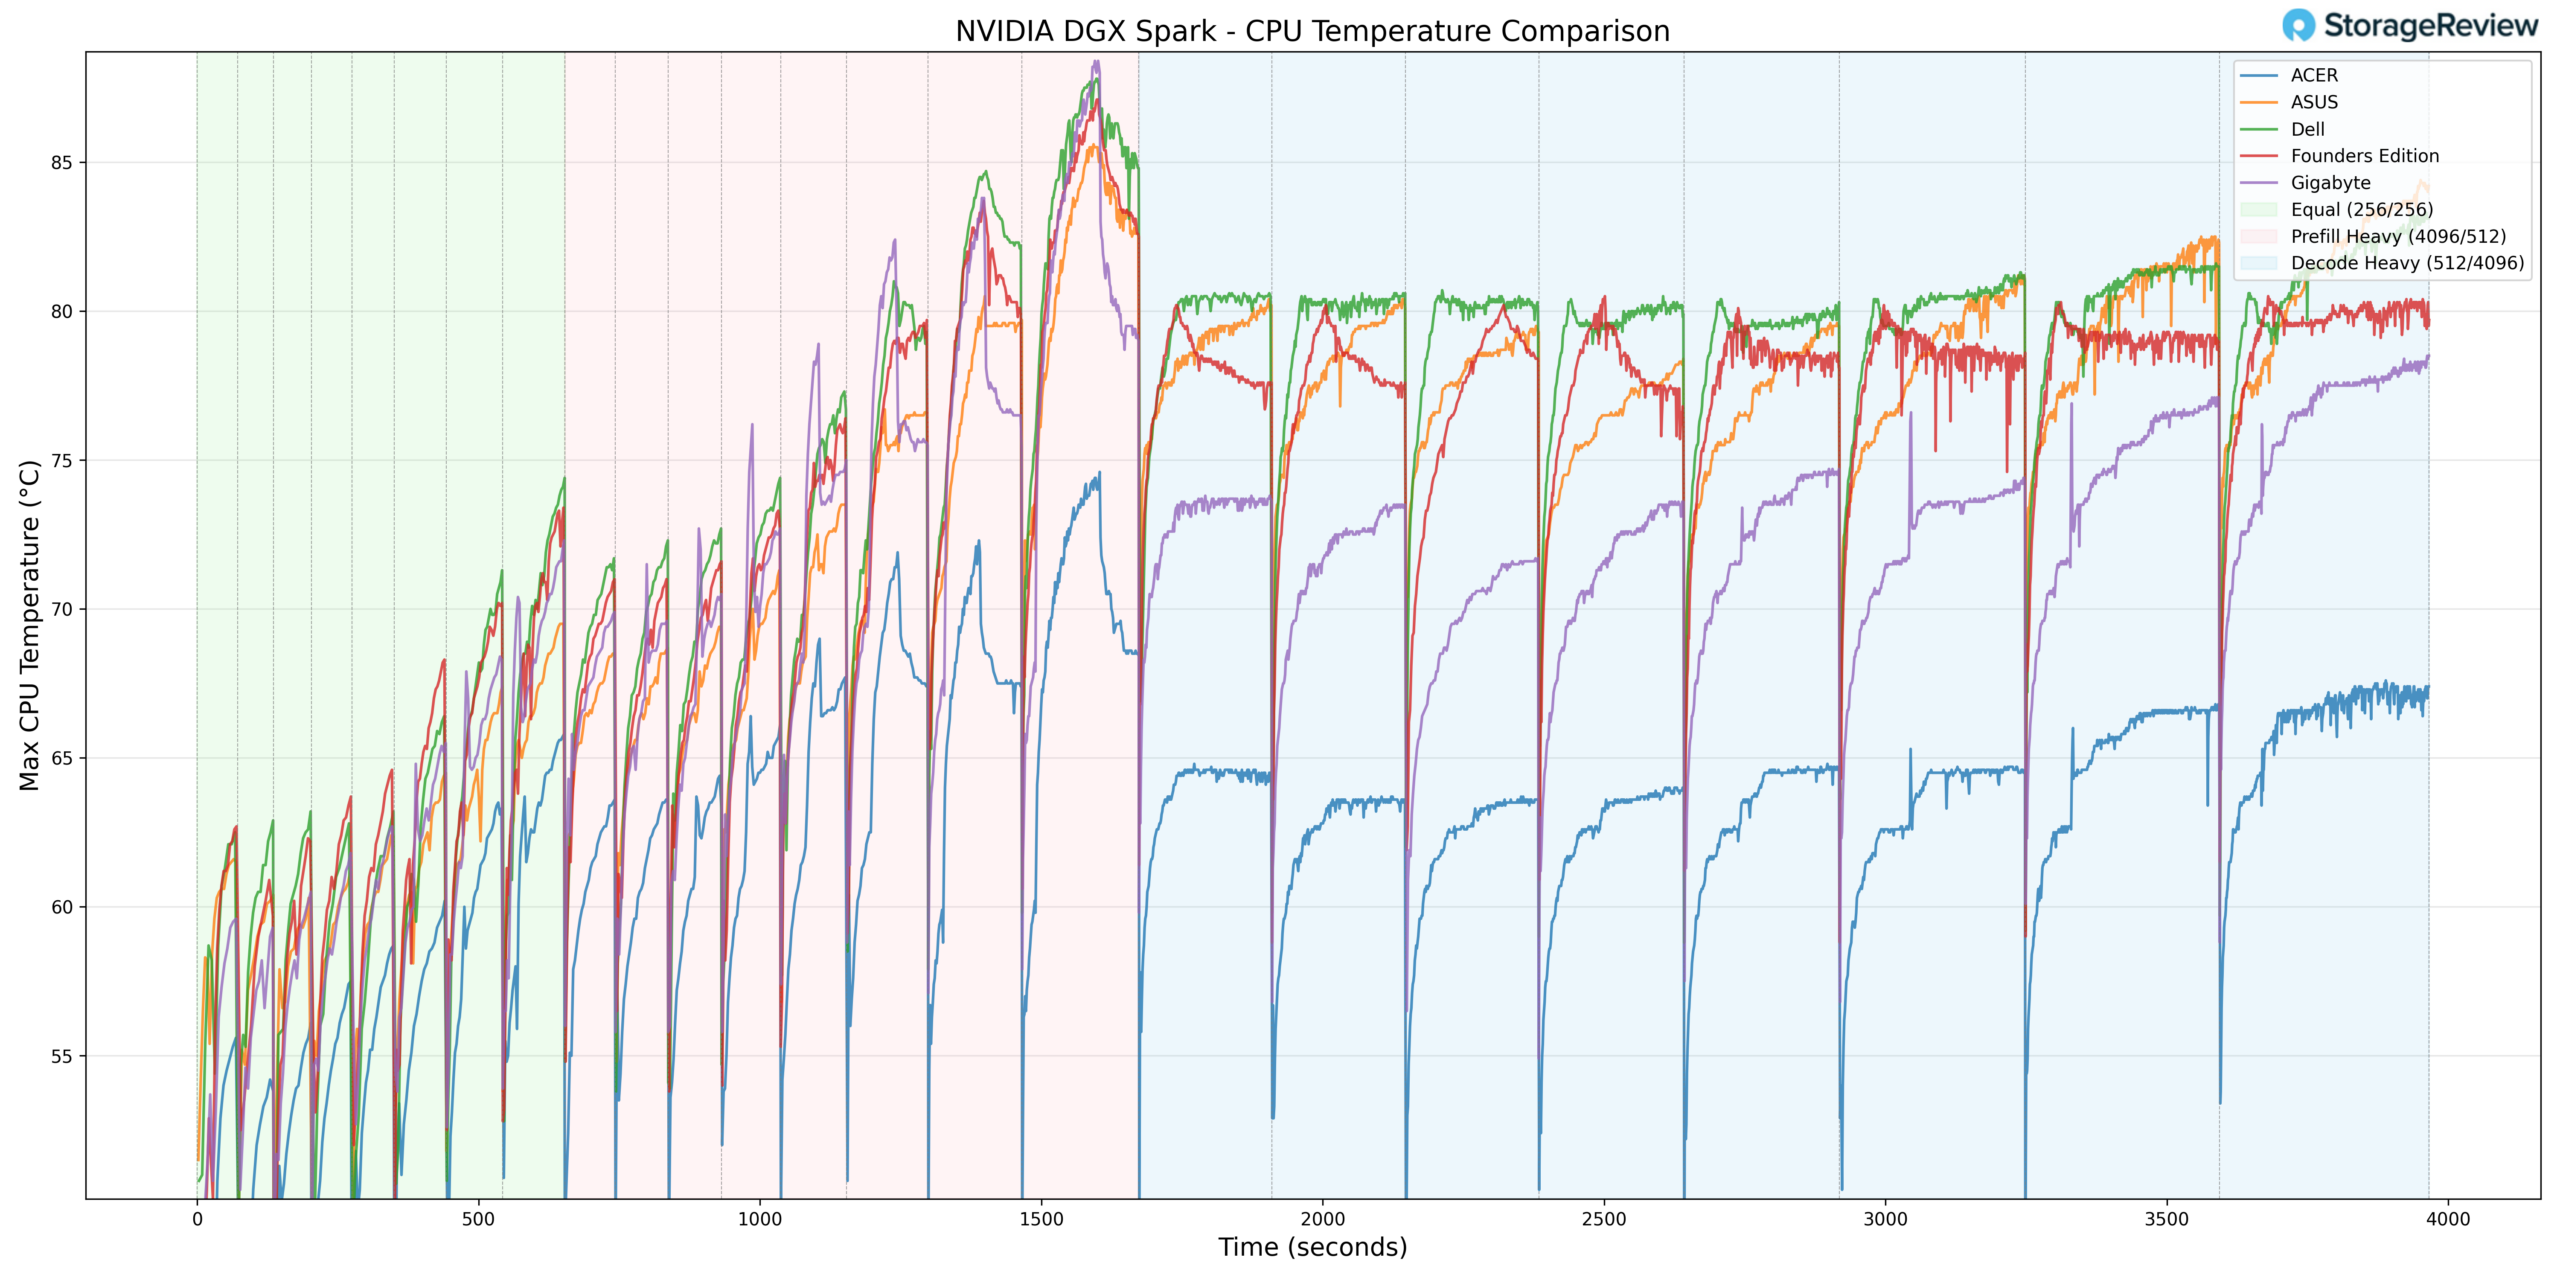
Lors des tests thermiques du processeur, le système GIGABYTE a atteint une température maximale de 90 °C pendant les transitions de préremplissage intensives. Cela le place dans la limite supérieure des températures maximales observées pour les processeurs du groupe de comparaison lors de fortes variations de charge de travail.
Une fois la transition vers les charges de travail Equal ISL/OSL puis Decode Heavy effectuée, la courbe de température s'est stabilisée au lieu de continuer à augmenter. Sous charge soutenue, le processeur est resté dans une plage thermique contrôlée, démontrant que le pic de température le plus élevé était lié à des variations de courte durée plutôt qu'à une capacité de refroidissement insuffisante à long terme.
En conditions de faible charge ou d'inactivité, le processeur a enregistré une température minimale de 38.7 °C. Cette faible valeur de référence témoigne d'une dissipation thermique efficace au repos et indique que le système de refroidissement conserve une marge de manœuvre suffisante en dehors des phases de forte sollicitation.
Globalement, les processeurs GIGABYTE ont affiché des températures de pointe plus élevées, mais ont conservé un comportement stable en continu une fois les charges de travail normalisées.
Température GPU
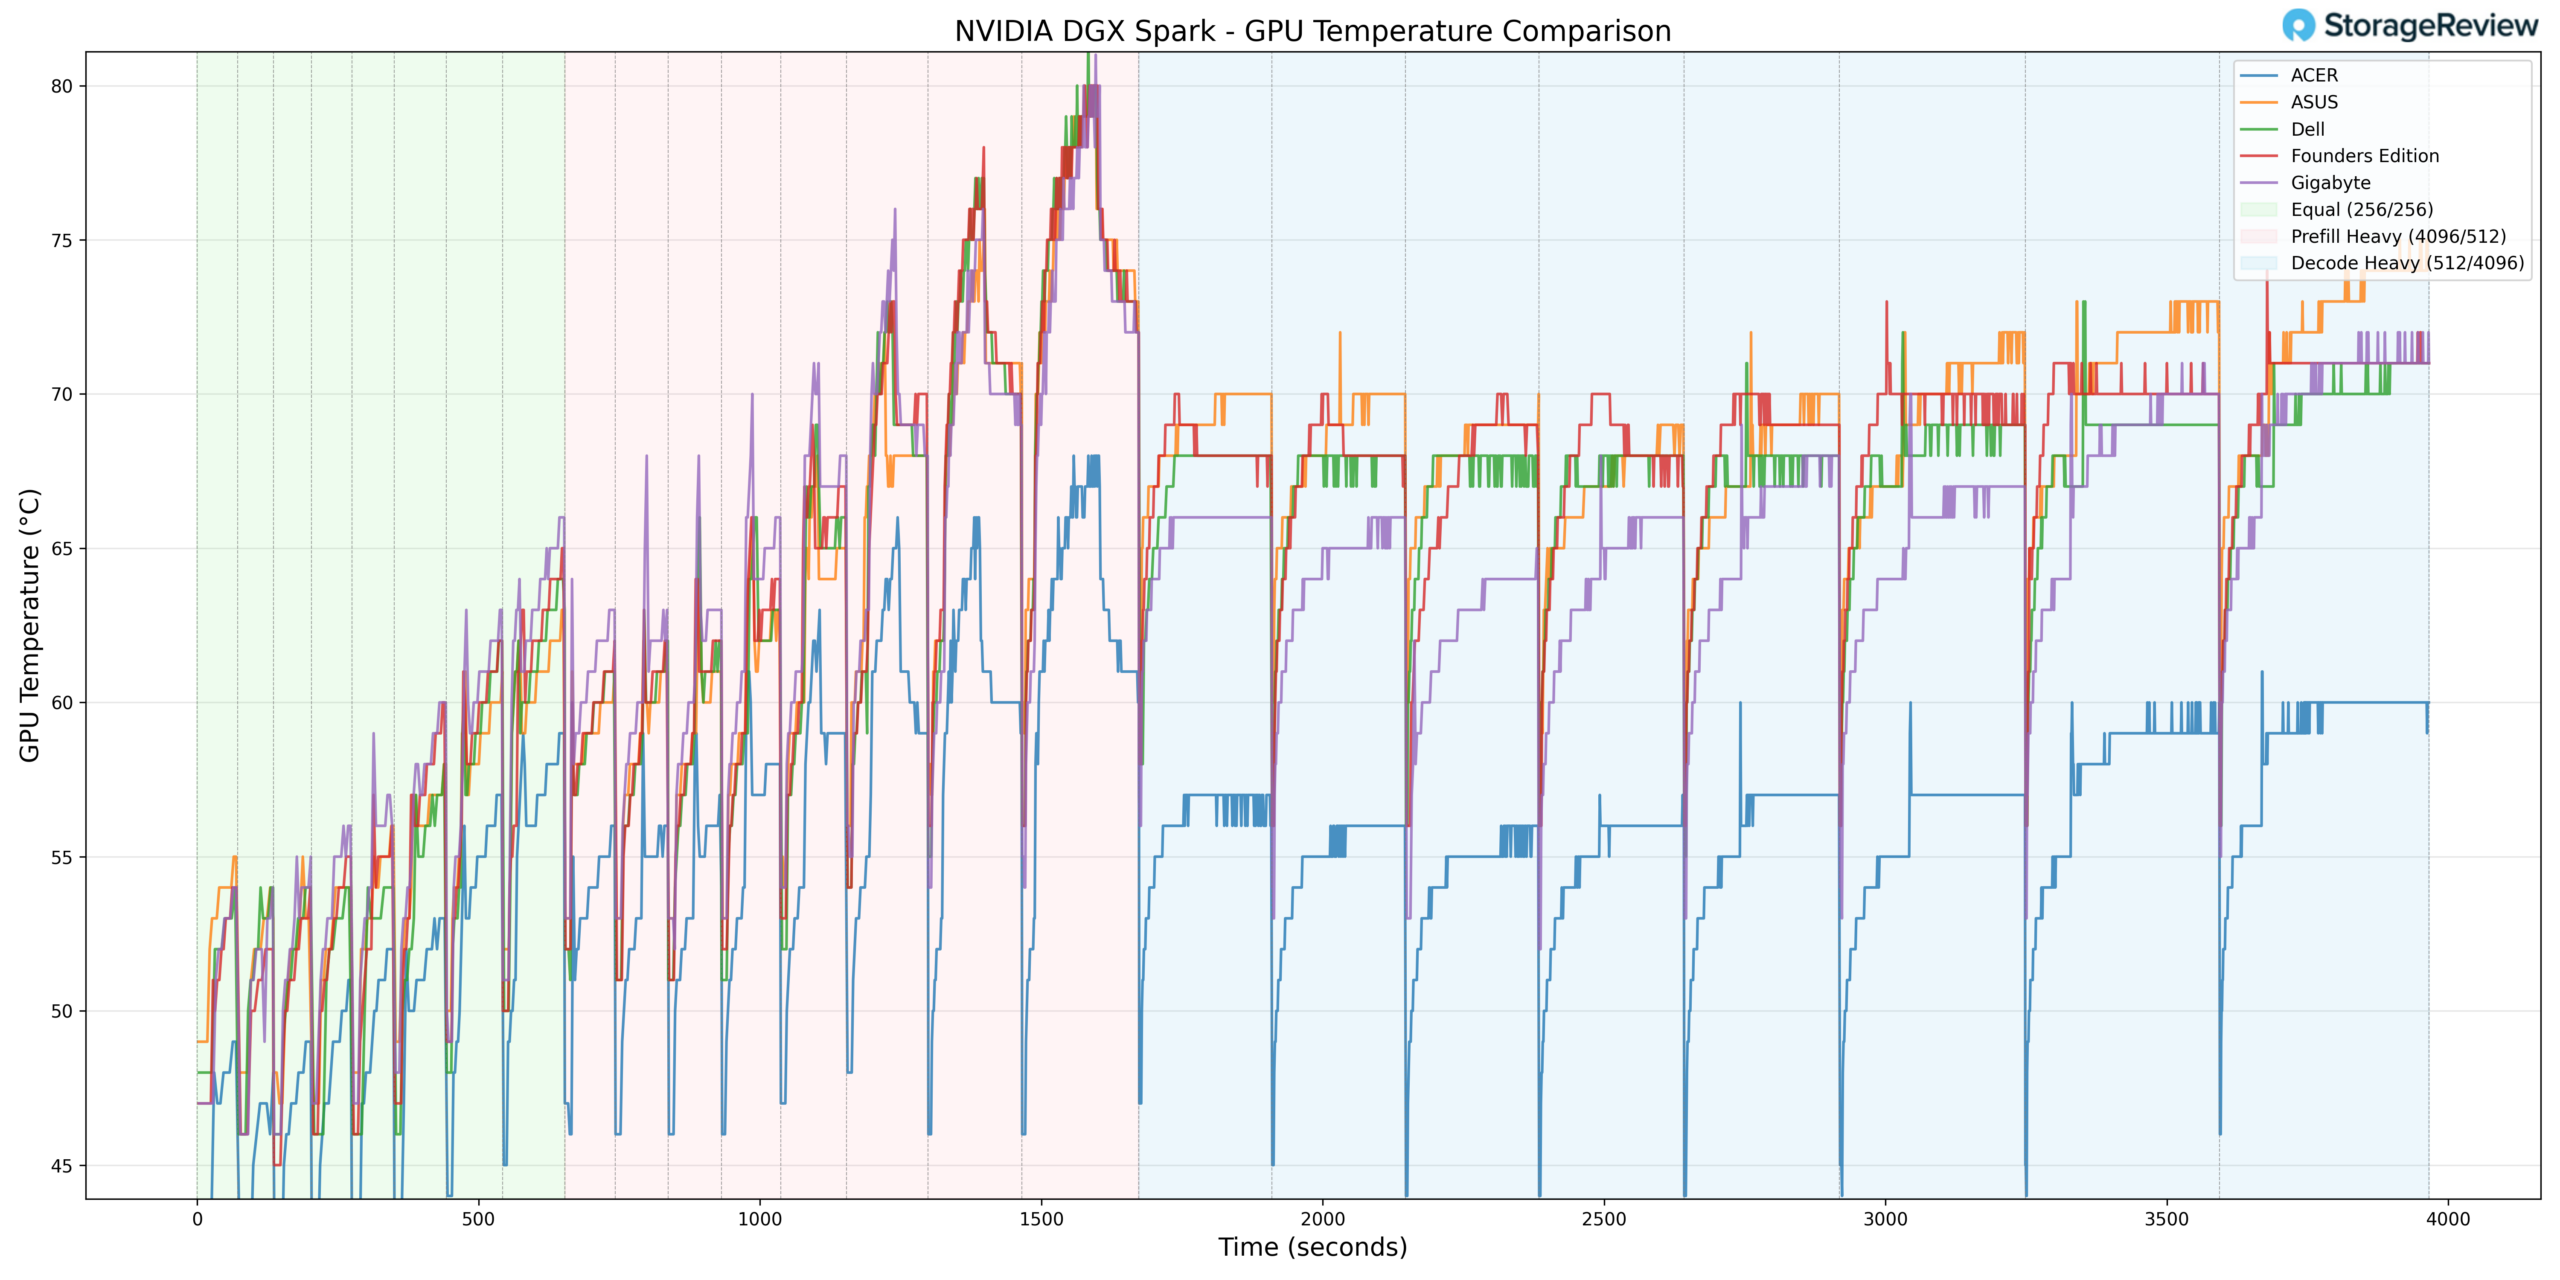
Les températures du GPU ont suivi une tendance similaire. Lors d'une activité de pré-remplissage intense, le GPU a atteint une température maximale de 81 °C. Cela le place parmi les GPU les plus chauds du groupe lors de fortes accélérations ponctuelles, mais reste dans les spécifications de fonctionnement attendues pour la plateforme GB10.
Lorsque la charge de travail est passée aux phases Equal ISL/OSL et Decode Heavy, les températures du GPU se sont stabilisées au lieu de continuer à augmenter.
Au repos ou en cas de faible utilisation, le GPU a enregistré une température minimale de 37 °C, ce qui indique un contrôle thermique de base solide lorsque le système n'est pas soumis à une forte charge de calcul.
Dans l'ensemble, le comportement du GPU de GIGABYTE reflète une utilisation intensive en période de pointe associée à une température stable et soutenue.
Température NVMe
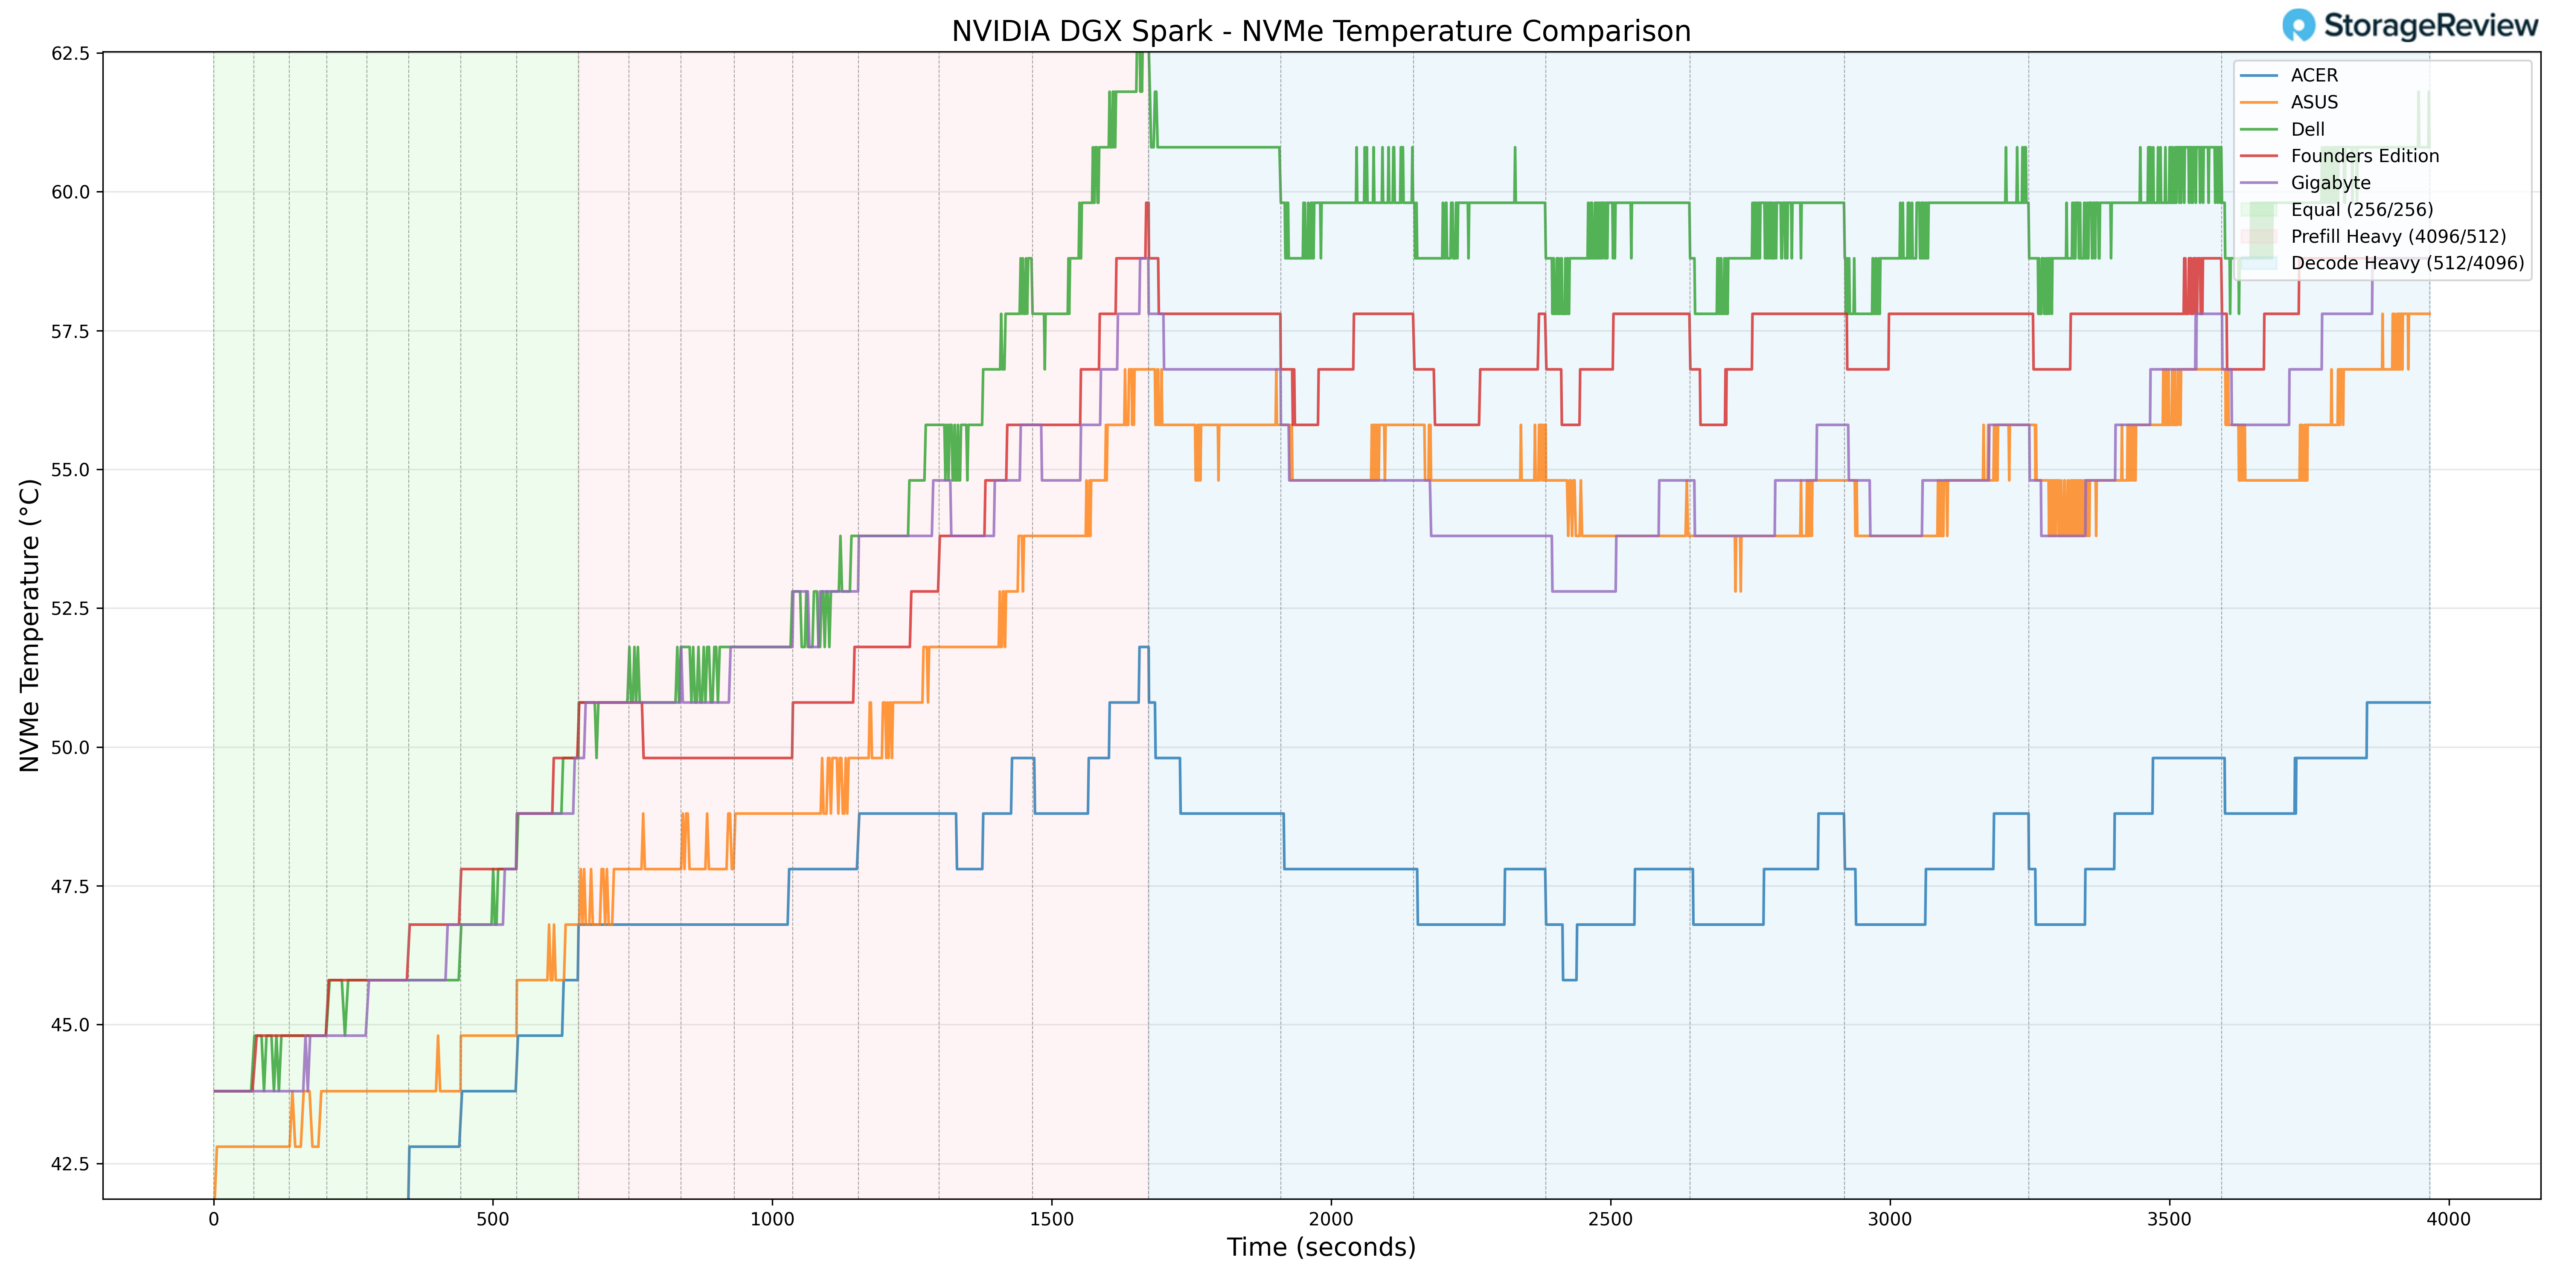
La température du stockage est restée bien maîtrisée tout au long des tests. Le disque NVMe a enregistré une température maximale de 59.8 °C lors des phases de fonctionnement les plus exigeantes. Ce pic est demeuré largement inférieur aux seuils de limitation thermique habituels, ce qui suggère une ventilation adéquate ou un positionnement interne optimal du disque dans le boîtier.
Lors des phases de charge de travail plus légères, la température du disque NVMe est descendue à un minimum de 37.8 °C, confirmant que les performances thermiques du stockage ne sont pas limitées au repos.
Comparé à certaines implémentations compactes destinées aux ordinateurs de bureau, le fait de rester en dessous de 60 °C sous charge témoigne d'une gestion thermique du stockage efficace.
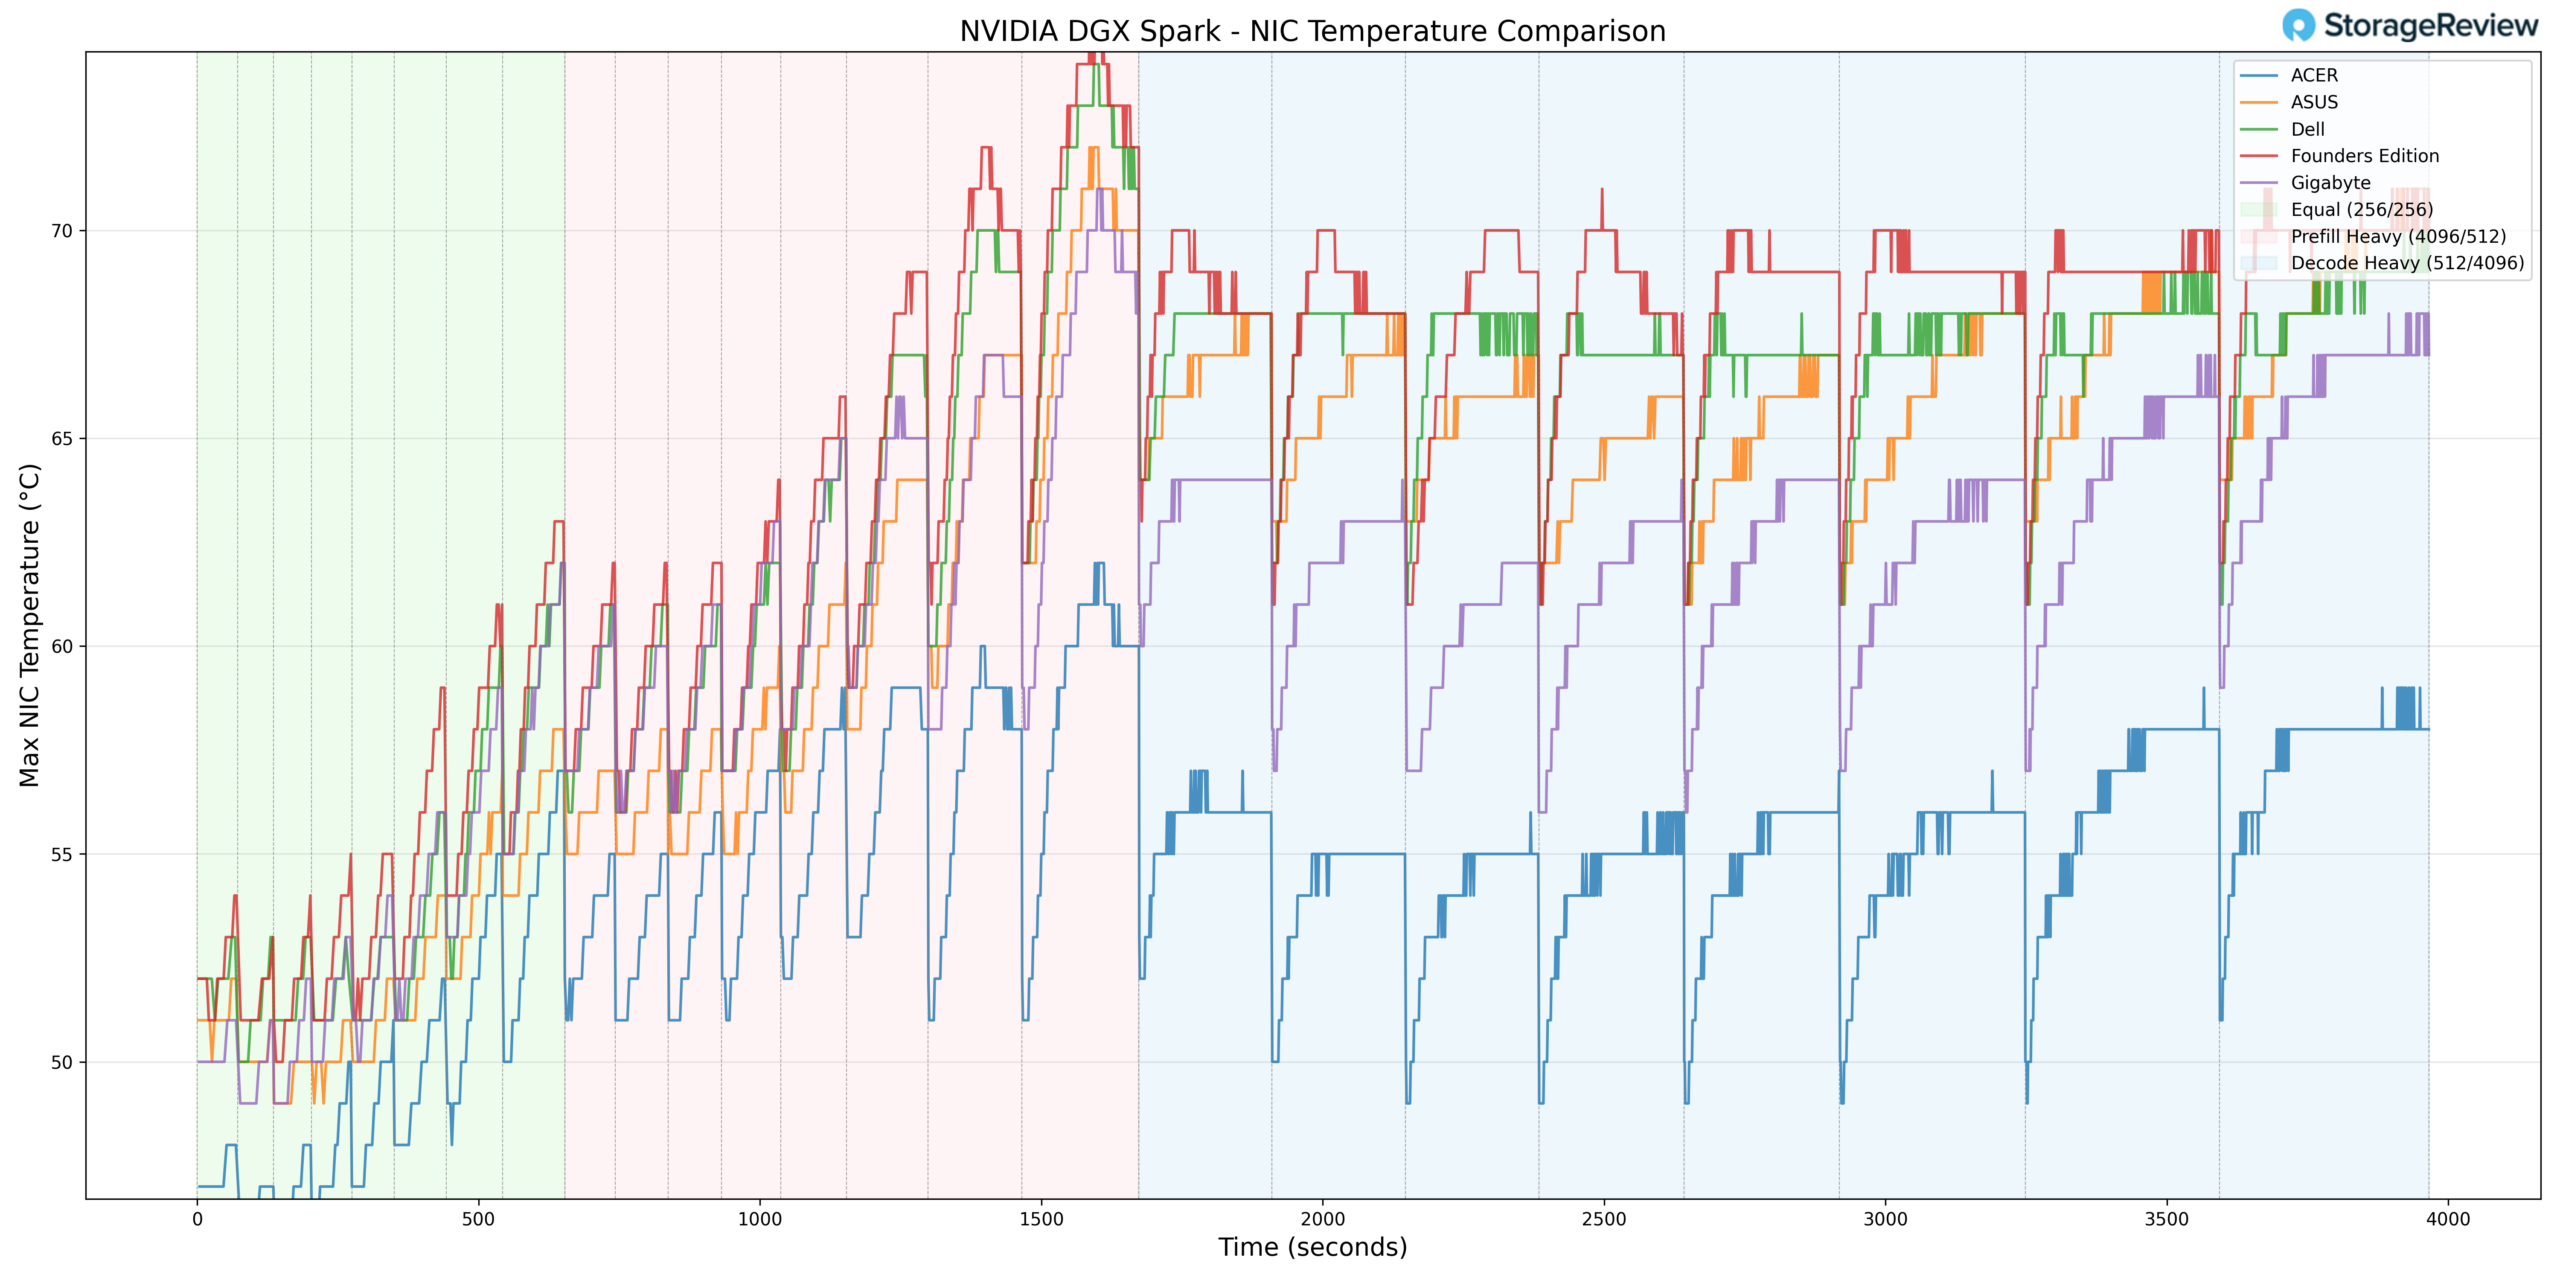
Température NIC
La température des cartes réseau a atteint un pic de 72 °C lors des phases de forte charge, ce qui correspond à un débit élevé pendant les transitions de pré-remplissage et de décodage. Bien que le contrôleur réseau se situe ainsi dans la partie la plus chaude de la pile lors des pics d'activité, la température est restée dans les limites de tolérance opérationnelles et n'a pas présenté de pics.
La température minimale du NIC enregistrée était de 41°C, reflétant un comportement de base normal pendant les phases plus légères.
Globalement, la carte réseau a suivi de manière prévisible la charge globale du système et n'a pas présenté de mise à l'échelle anormale.
Consommation électrique du GPU
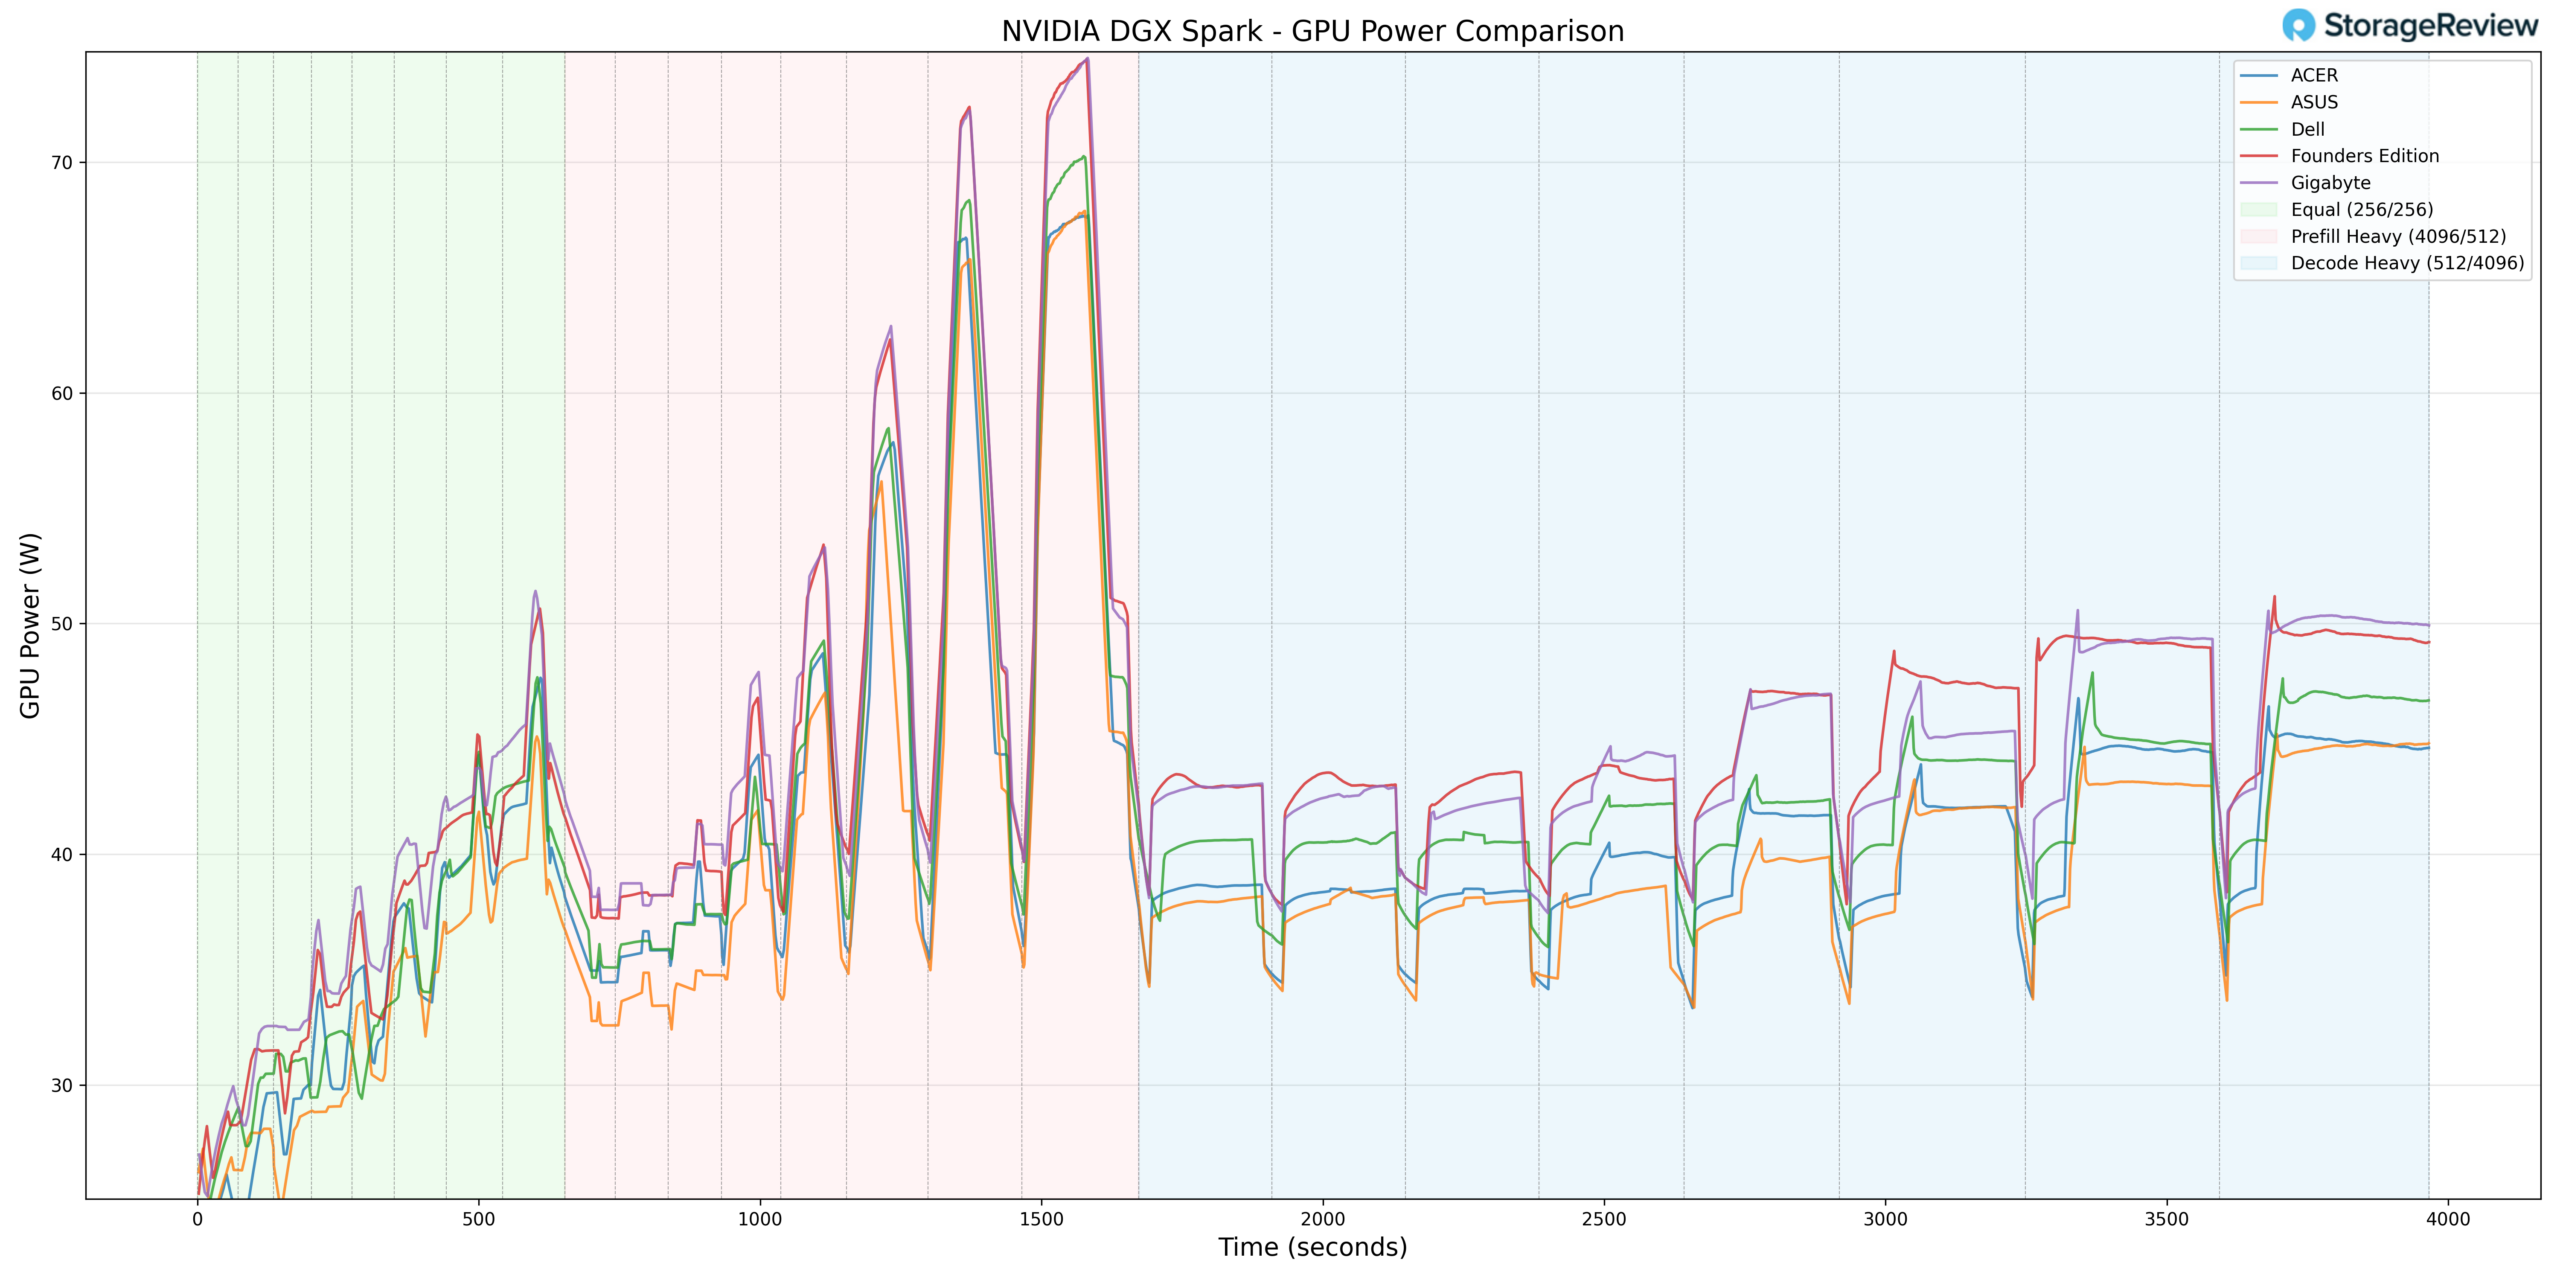
Le comportement de la consommation du GPU permet de mieux comprendre les pics de température observés. GIGABYTE a atteint une consommation maximale de 75.54 W lors des transitions de pré-remplissage intensif. Cela la place dans la partie supérieure des enveloppes de consommation observées parmi les unités GB10 testées.
Plutôt que de limiter artificiellement la puissance du GPU, GIGABYTE semble autoriser des pics de consommation proches de la limite, ce qui est directement lié aux températures maximales plus élevées du GPU. Lorsque les charges de travail passent à des phases de décodage soutenues, la consommation électrique se stabilise en conséquence.
Du point de vue de la consommation énergétique, le système GIGABYTE ne semble pas être excessivement sollicité. Au contraire, ses pics de température plus élevés lors des phases de forte intensité correspondent à des choix d'allocation de puissance axés sur les performances plutôt qu'à une conception thermique non maîtrisée.
Résumé thermique
Lors des tests de surveillance du processeur, du GPU, du NVMe et de la carte réseau, la GIGABYTE GB10 a affiché des températures de repos compétitives et des pics de consommation plus élevés lors des transitions nécessitant un préremplissage important. Le processeur a atteint 90 °C et le GPU 81 °C en pleine accélération, tandis que le NVMe est resté sous les 60 °C et la carte réseau a atteint 72 °C. La consommation électrique du GPU a culminé à 75.54 W, indiquant des pics de consommation proches de sa limite.
Sous des charges de travail de décodage soutenues, les températures se sont stabilisées sans augmentation supplémentaire, ce qui suggère que si GIGABYTE permet des performances agressives sur une courte durée, elle maintient des températures prévisibles et contrôlées lors d'un fonctionnement prolongé.
Tests de performance de GIGABYTE AI TOP ATOM
Pour évaluer le GIGABYTE AI TOP ATOM, nous avons testé les unités Spark à l'aide du benchmark vLLM Online Serving, le moteur d'inférence et de diffusion à haut débit le plus répandu pour les grands modèles de langage. Ce benchmark simule des charges de travail de production réelles en envoyant des requêtes simultanées à un serveur vLLM en cours d'exécution et en mesurant des indicateurs clés, tels que le débit total de jetons (jetons par seconde), le temps d'obtention du premier jeton et le temps de traitement par jeton de sortie, sous différentes conditions de charge.
Nos tests ont porté sur un large éventail de modèles, des architectures denses aux types de données à micro-échelle. Ils ont évalué les performances dans trois scénarios de charge de travail : ISL/OSL égaux, préremplissage intensif et décodage intensif. Ces scénarios représentent différents modèles de service réels, allant de charges d'entrée et de sortie équilibrées au traitement intensif des invites et à la génération de jetons limitée par la bande passante mémoire.
Outre le GIGABYTE AI TOP ATOM, nous avons comparé ses performances à celles du NVIDIA Founders Edition Spark, ainsi qu'à celles de systèmes OEM d'Asus, d'Acer et de Dell. Cela nous a permis de situer les résultats de GIGABYTE dans un contexte concurrentiel plus large et de déterminer ses points forts, ses points faibles ou ses faiblesses, selon les modèles et les types de charges de travail.
GPT-OSS-120B
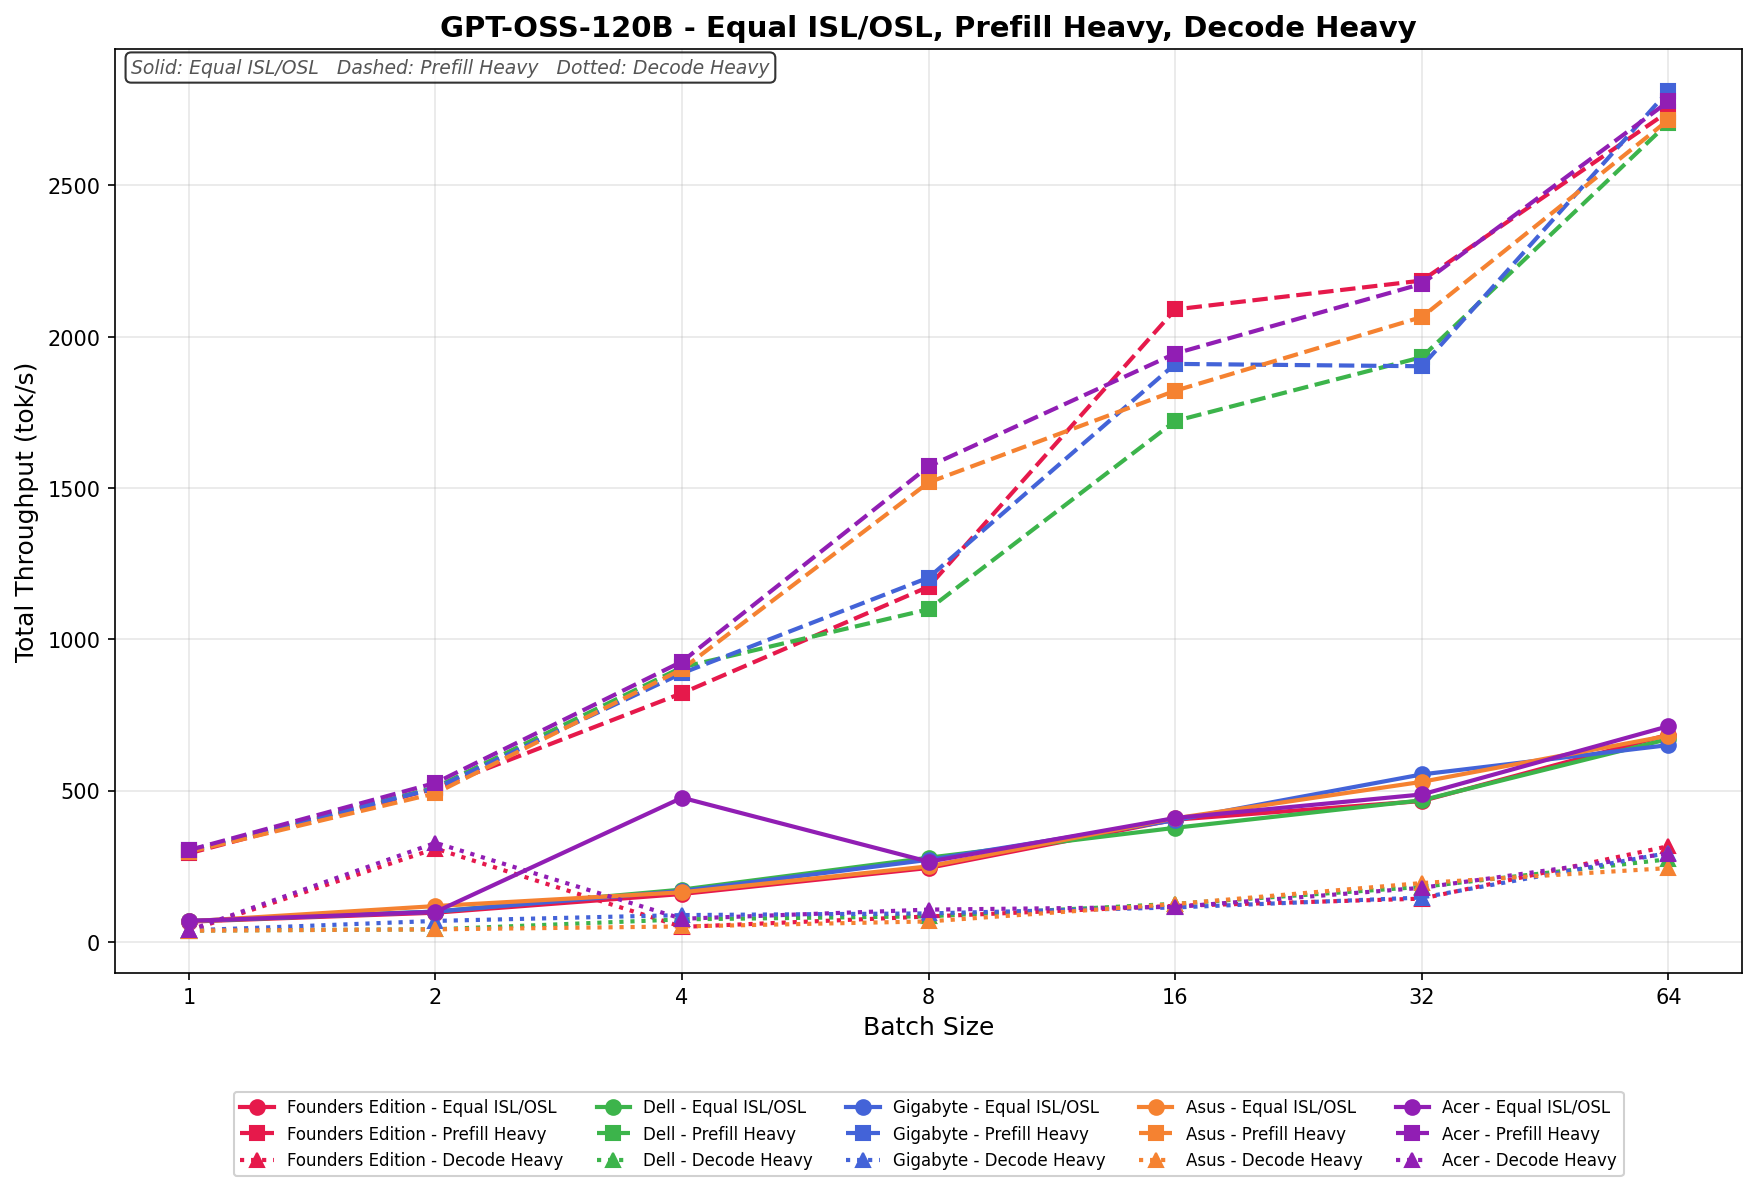
En termes d'ISL/OSL égaux, le processeur GIGABYTE affiche des performances allant de 60.71 à 649.62 tok/s, se maintenant ainsi en milieu de classement et se rapprochant des performances de Dell et Asus pour les lots de grande taille. La progression est stable et linéaire jusqu'au lot 32, avec des gains continus au lot 64, même si le processeur ne surpasse pas tout à fait les meilleurs dans les cas les plus exigeants.
Le débit de pré-remplissage élevé commence à 304.63 tok/s et atteint 2 771,38 tok/s pour une taille de lot de 64. La croissance est soutenue jusqu'au lot 16, où GIGABYTE se classe brièvement troisième, avant de se rapprocher du reste du groupe pour les lots plus importants. La mise à l'échelle est globalement rapide et compétitive, notamment pour les lots de taille moyenne.
Decode Heavy varie de 47.01 à 299.41 tok/s, avec une mise à l'échelle progressive et cohérente sur l'ensemble du balayage par lots.
GPT-OSS-20B
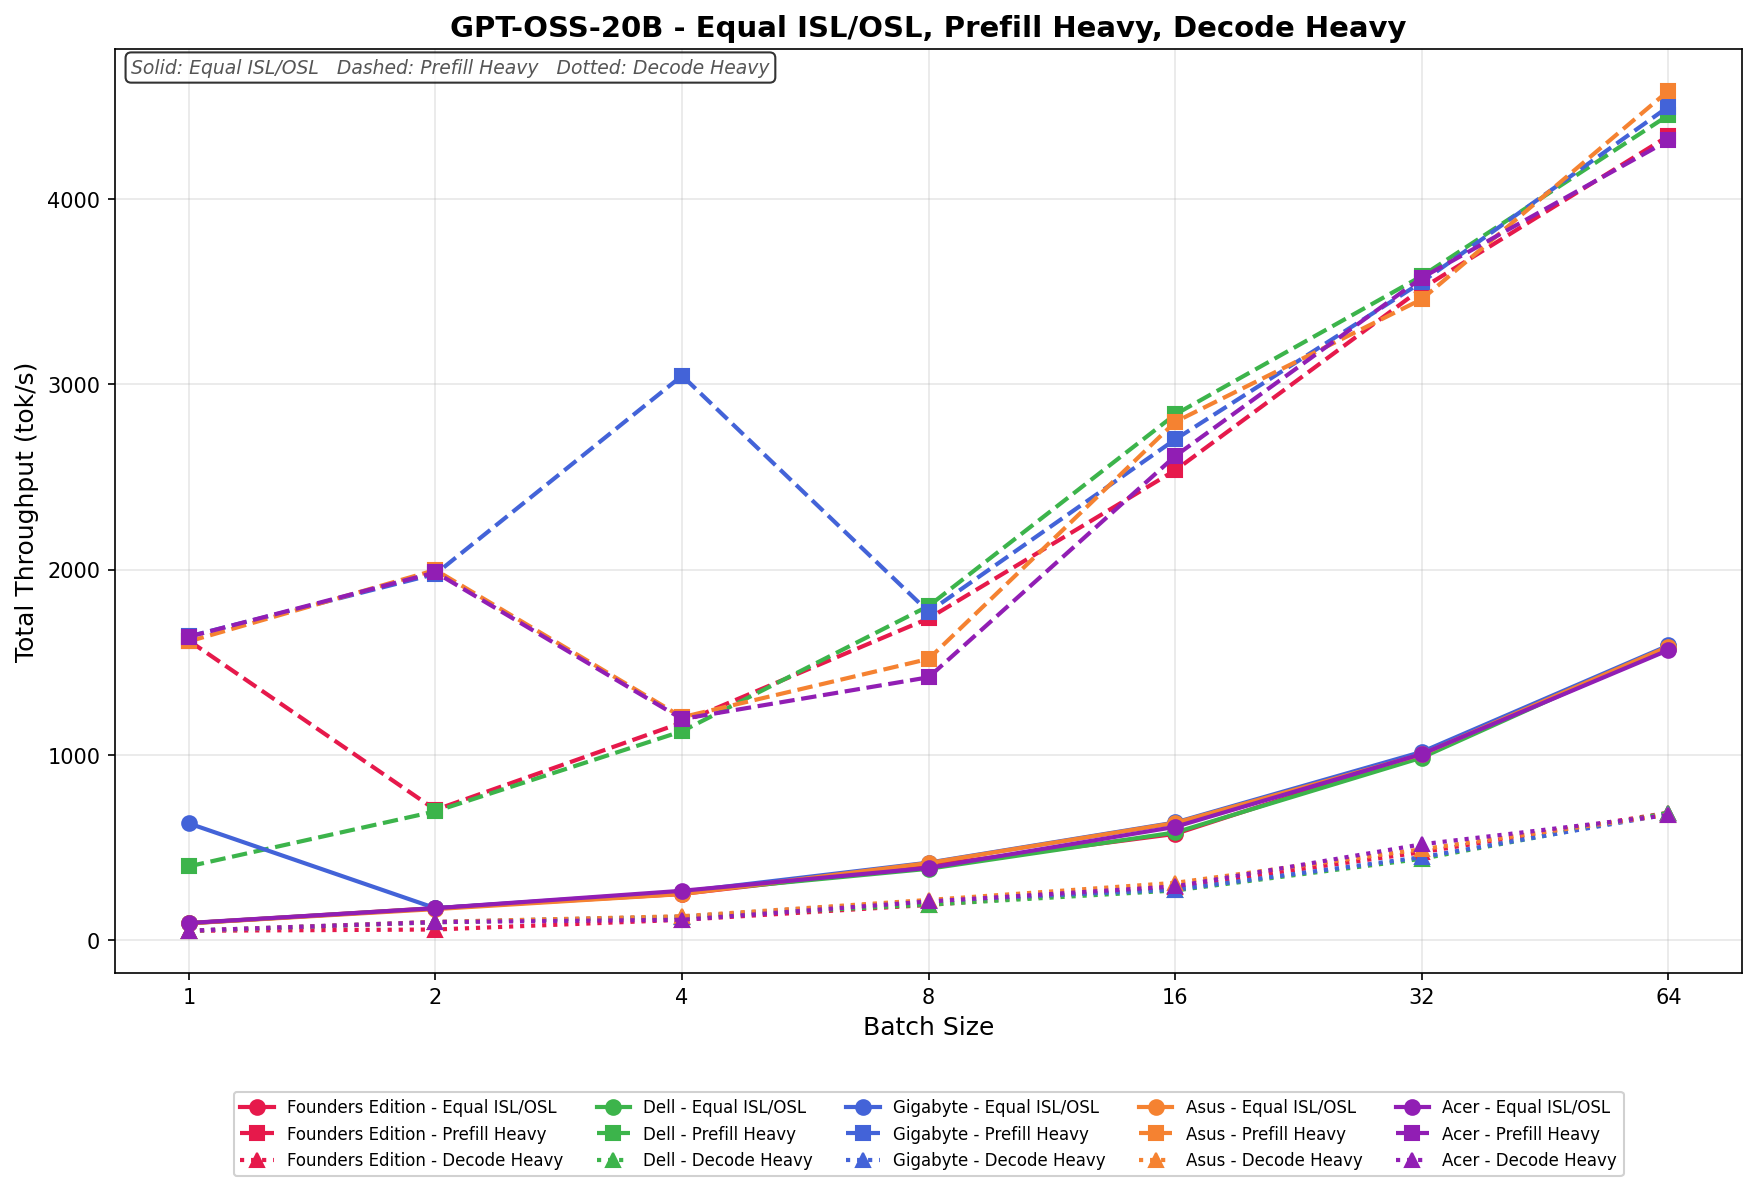
En termes d'ISL/OSL égaux, le GIGABYTE affiche des performances allant de 641.73 à 1 587,62 tok/s, avec un démarrage rapide dès le lot 1, avant une légère baisse au lot 2, puis une progression constante pour les lots plus importants. À partir du lot 8, les performances se normalisent et suivent de près celles des autres processeurs, se classant parmi les meilleurs au lot 64.
Le préremplissage intensif commence à 1 650,32 tok/s et atteint un pic de 4 401,27 tok/s pour une taille de lot de 64. À partir du lot 16, la mise à l'échelle est constante et compétitive, suivant le rythme de Dell et d'Asus pour les tailles de lot supérieures.
Le taux de décodage intensif varie de 63.18 à 688.44 tok/s, avec une augmentation linéaire nette sur toute la plage de valeurs. Les gains sont progressifs mais constants, très proches de ceux des autres plateformes et reflètent le comportement d'échelle plus contraint typique des charges de travail de décodage intensif.
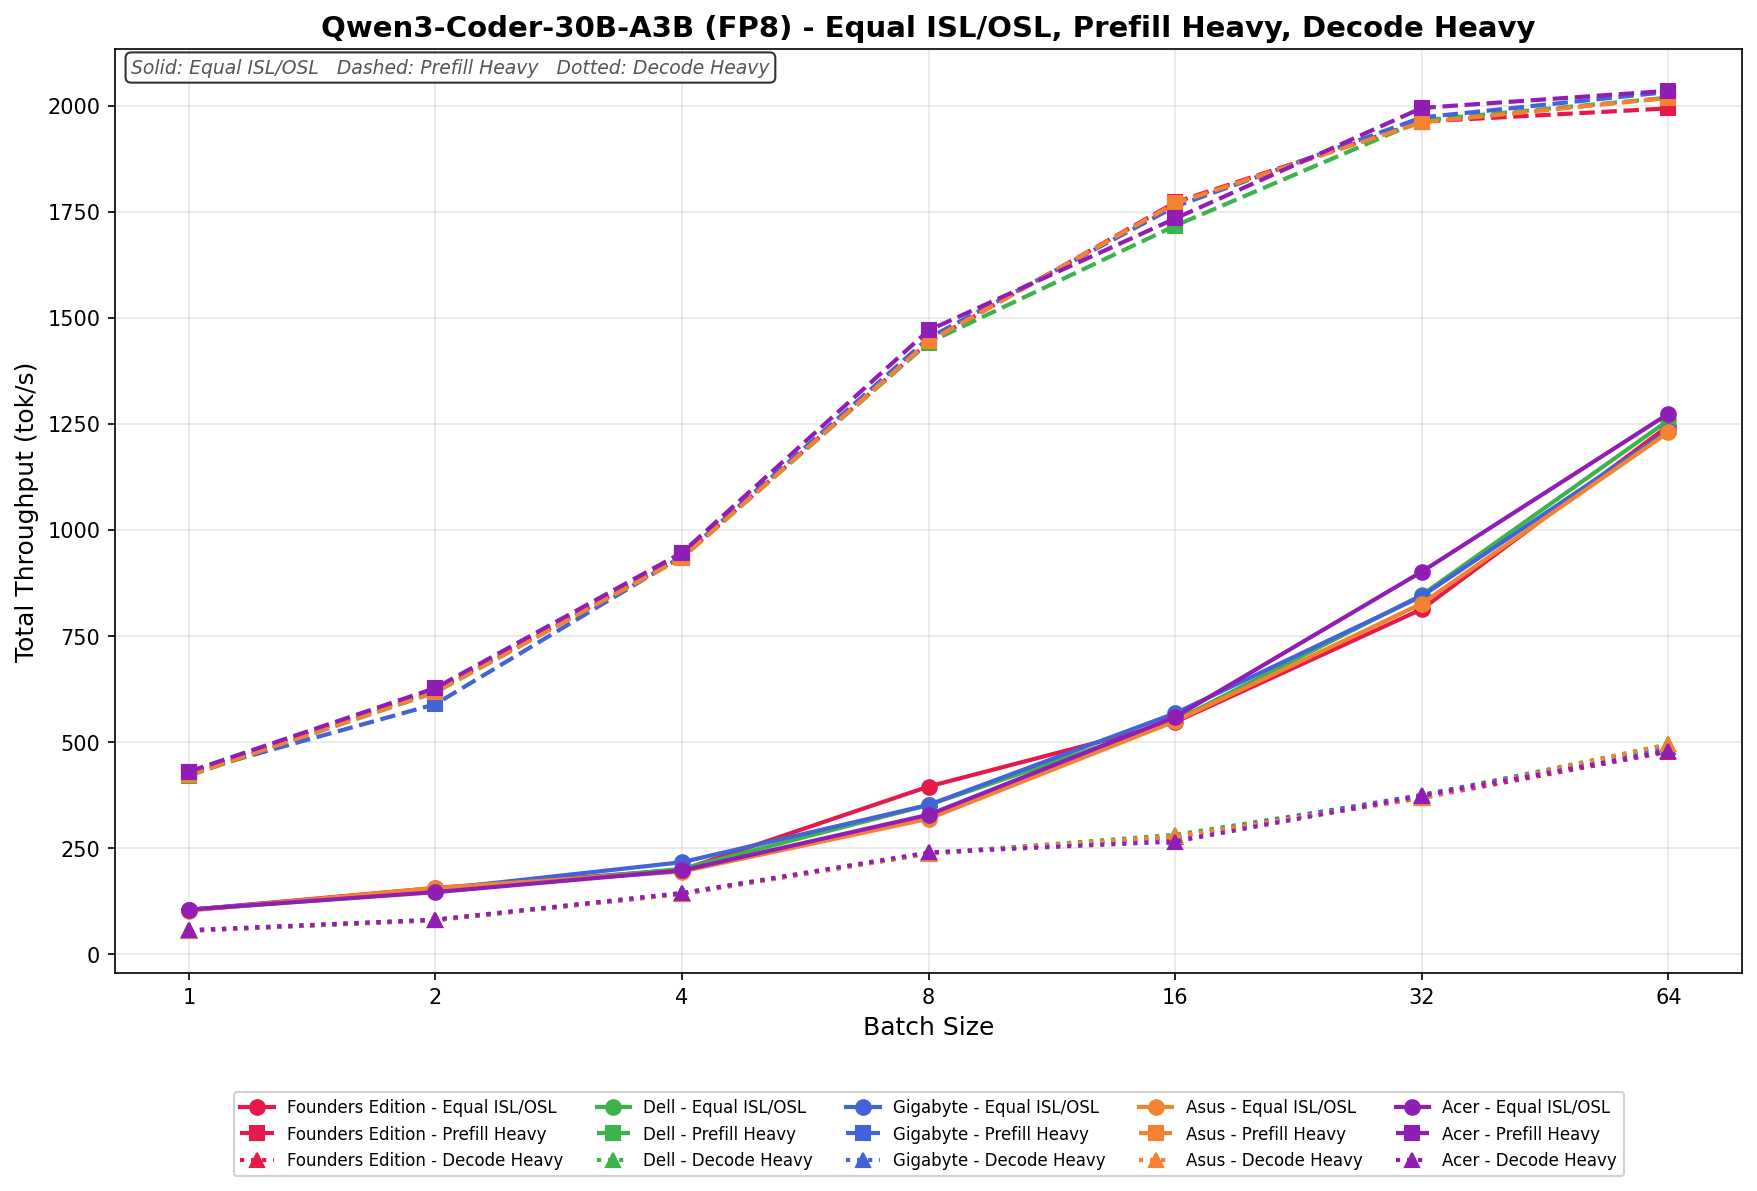
Codeur Qwen3 30B A3B FB8
En termes d'ISL/OSL égaux, les performances de GIGABYTE passent de 101.27 à 1 251,84 tok/s, affichant une progression linéaire et constante tout au long des tests. Elles restent très proches de celles de Dell et Asus jusqu'au lot 16, puis continuent de progresser régulièrement jusqu'au lot 64, se classant parmi les meilleures sans aucune anomalie notable.
Le pré-remplissage lourd commence à 428.66 tok/s et passe à 2 026,94 tok/s lorsque la taille du lot augmente à 64. La croissance est régulière et constante pour toutes les tailles de lot, GIGABYTE restant étroitement associé au reste du marché.
Le décodage lourd varie de 61.18 à 482.73 tok/s, avec des gains progressifs prévisibles à mesure que la taille des lots augmente.
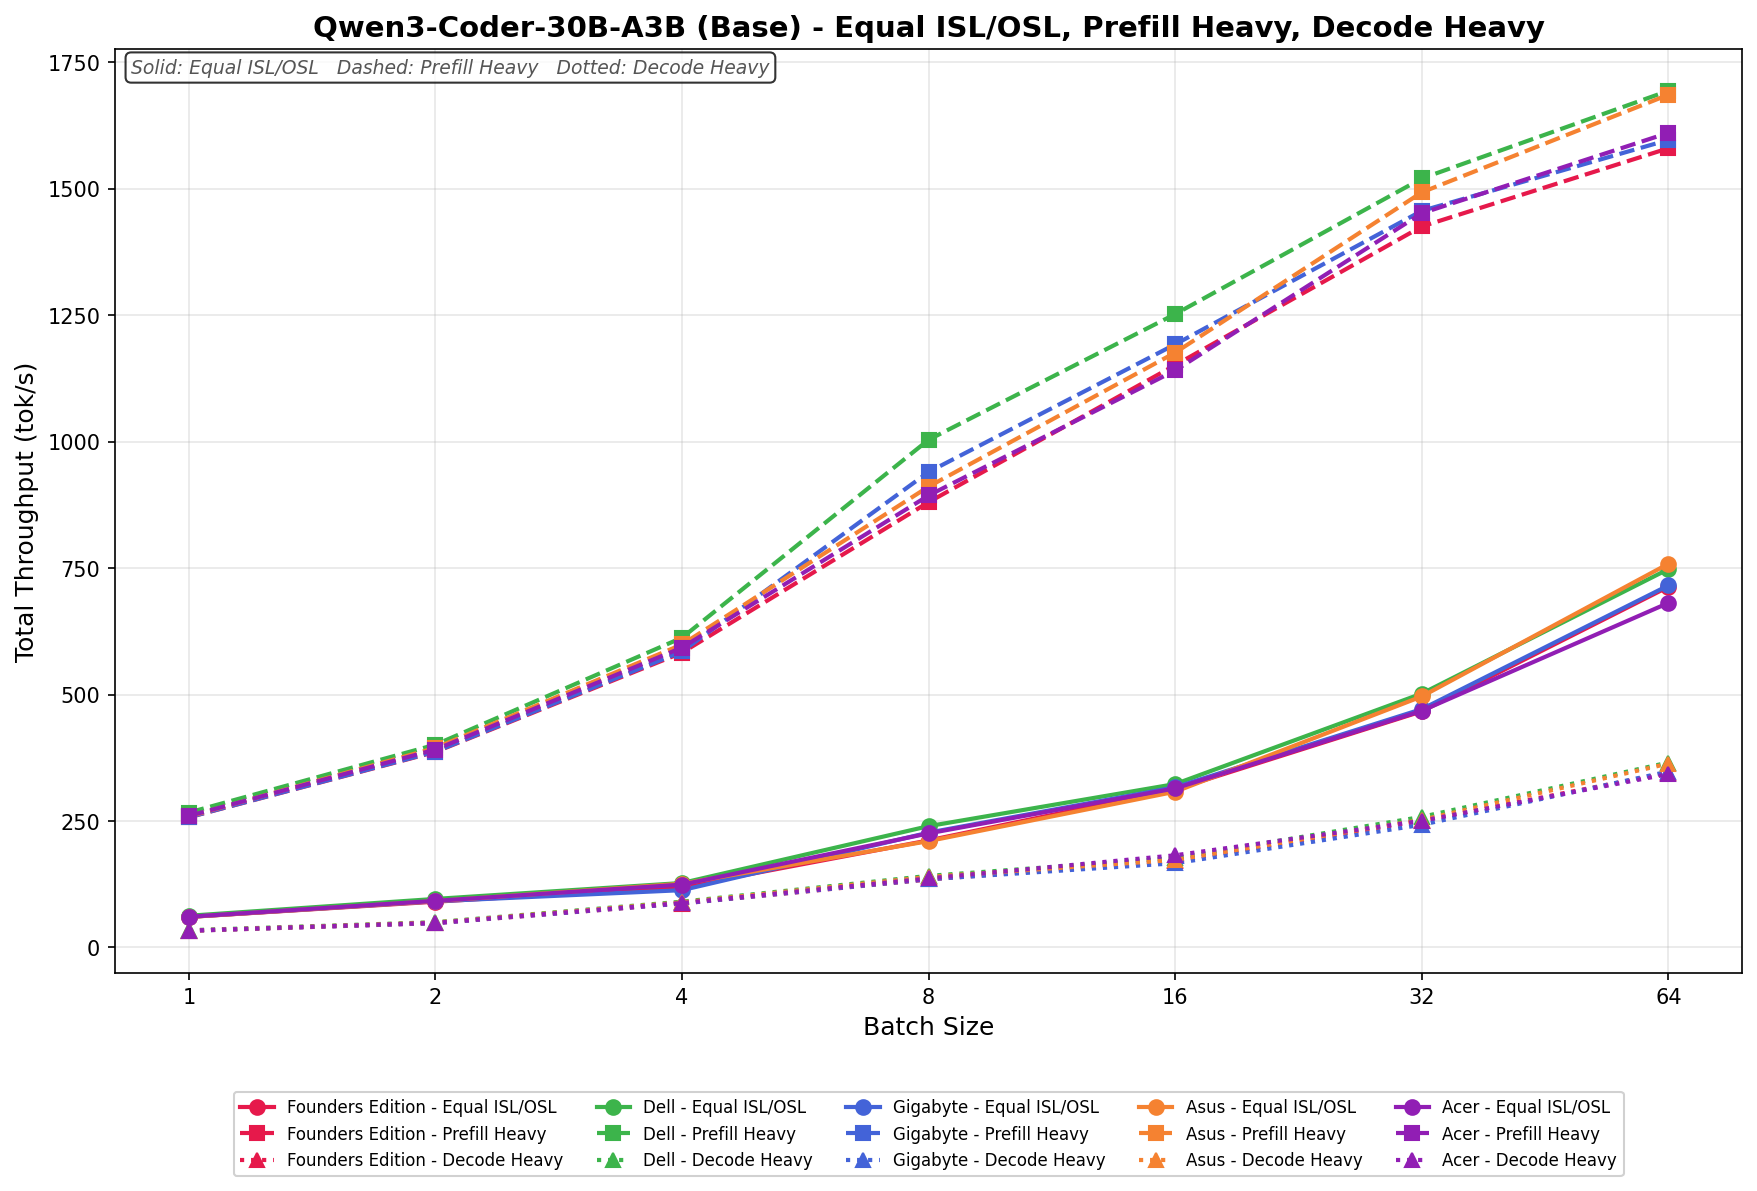
Base de codage Qwen3 30B A3B
En Equal ISL/OSL, le débit de mémoire GIGABYTE passe de 63.42 à 721.08 tok/s, progressant de manière constante sur l'ensemble des lots. Ses performances restent globalement conformes à celles des autres processeurs jusqu'au lot 16 et continuent de progresser de façon linéaire jusqu'au lot 64, se maintenant ainsi dans la course sans déviation notable de son comportement linéaire.
Le pré-remplissage lourd commence à 258.11 tok/s et monte à 1 603,74 tok/s pour une taille de lot de 64.
Le décodage lourd varie de 33.57 à 349.82 tok/s, avec une mise à l'échelle linéaire incrémentale sur toute la plage de balayage.
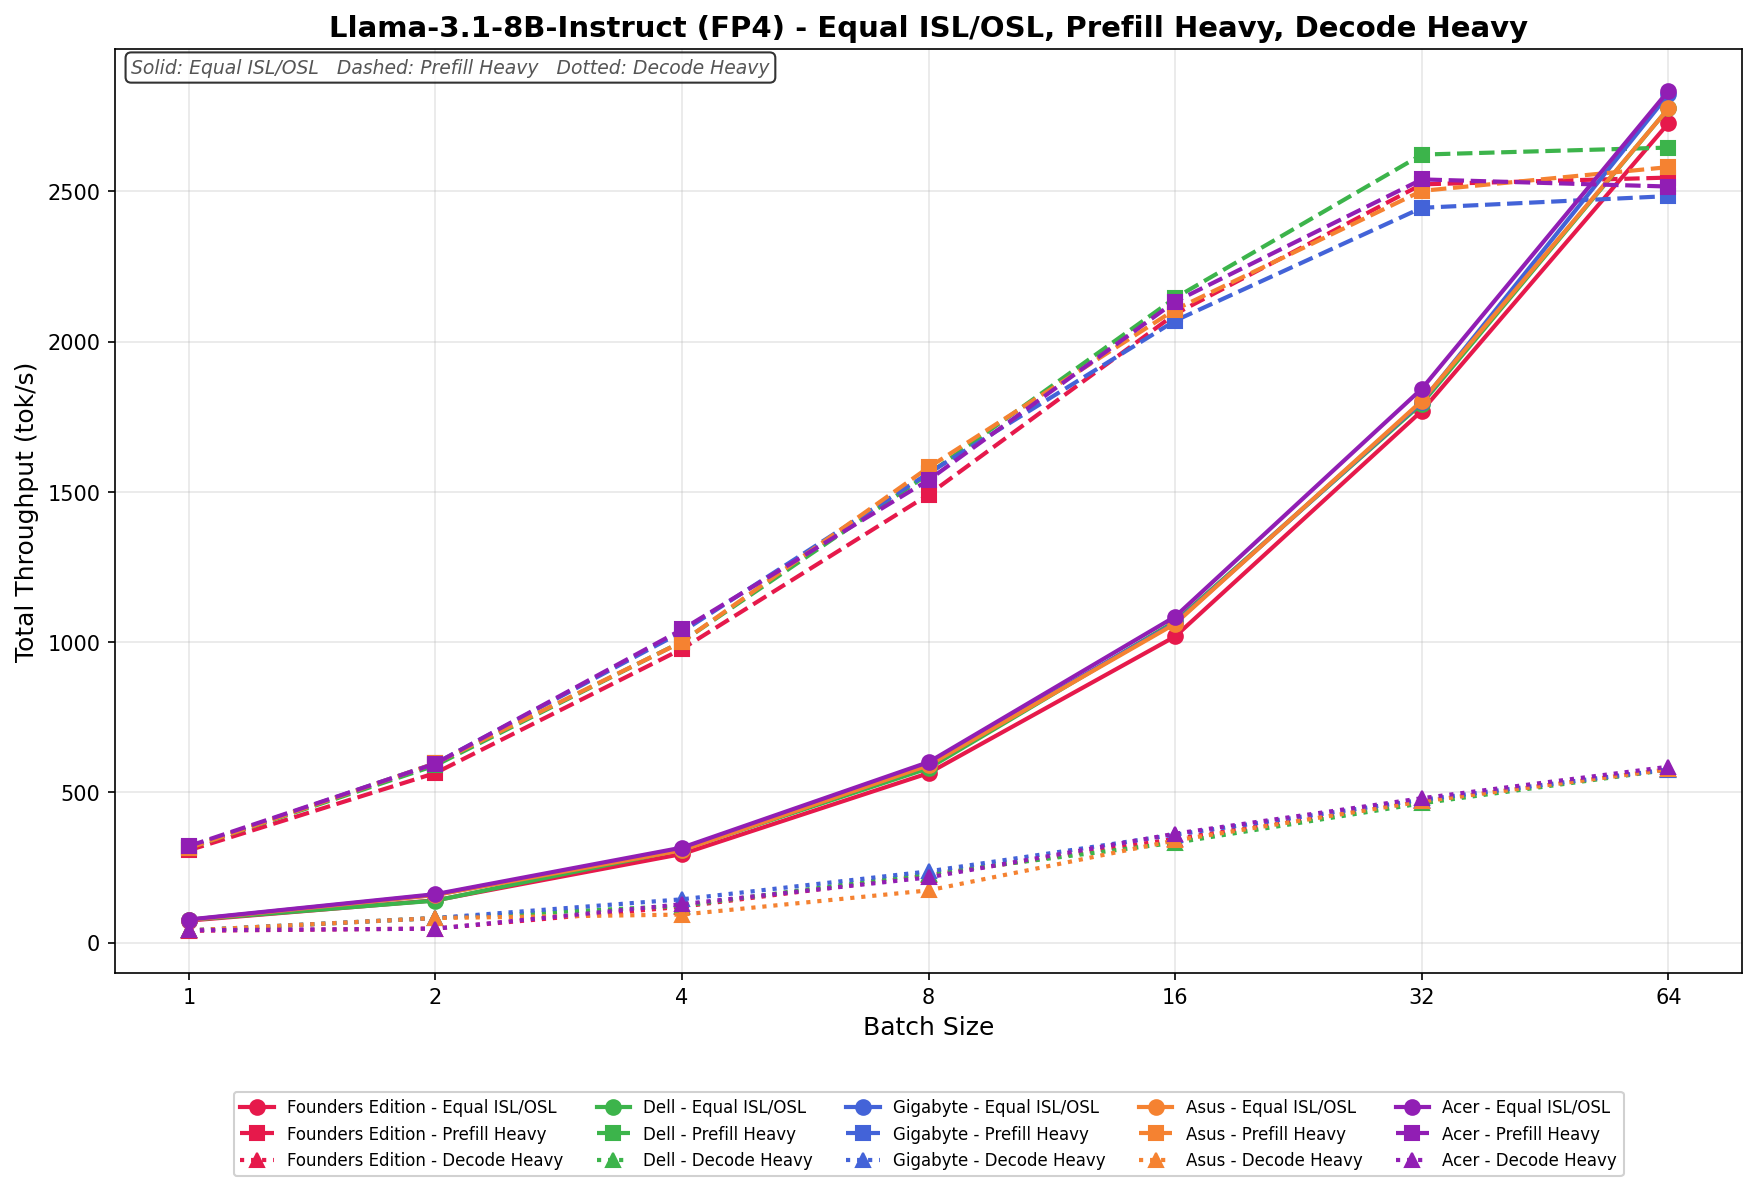
Llama 3.1 8B Instruction FP4
En mode ISL/OSL égal, le débit (GIGABYTE) passe de 69.84 à 2 756,91 tok/s au cours du traitement par lots. La montée en charge est progressive et bien équilibrée jusqu'au lot 32, où le débit se rapproche des performances de pointe, avant de connaître une forte augmentation au lot 64, le plaçant parmi les systèmes les plus performants à des niveaux de concurrence élevés.
Prefill Heavy commence à 321.67 tok/s et atteint 2 493,52 tok/s pour une taille de lot de 64. La croissance est stable jusqu'au lot 16, puis commence à ralentir légèrement pour les tailles de lot plus élevées par rapport au meilleur, ce qui indique une efficacité de mise à l'échelle solide mais non dominante pour les grands lots.
Le décodage lourd varie de 48.92 à 575.84 tok/s, avec des gains progressifs constants à mesure que la taille du lot augmente.
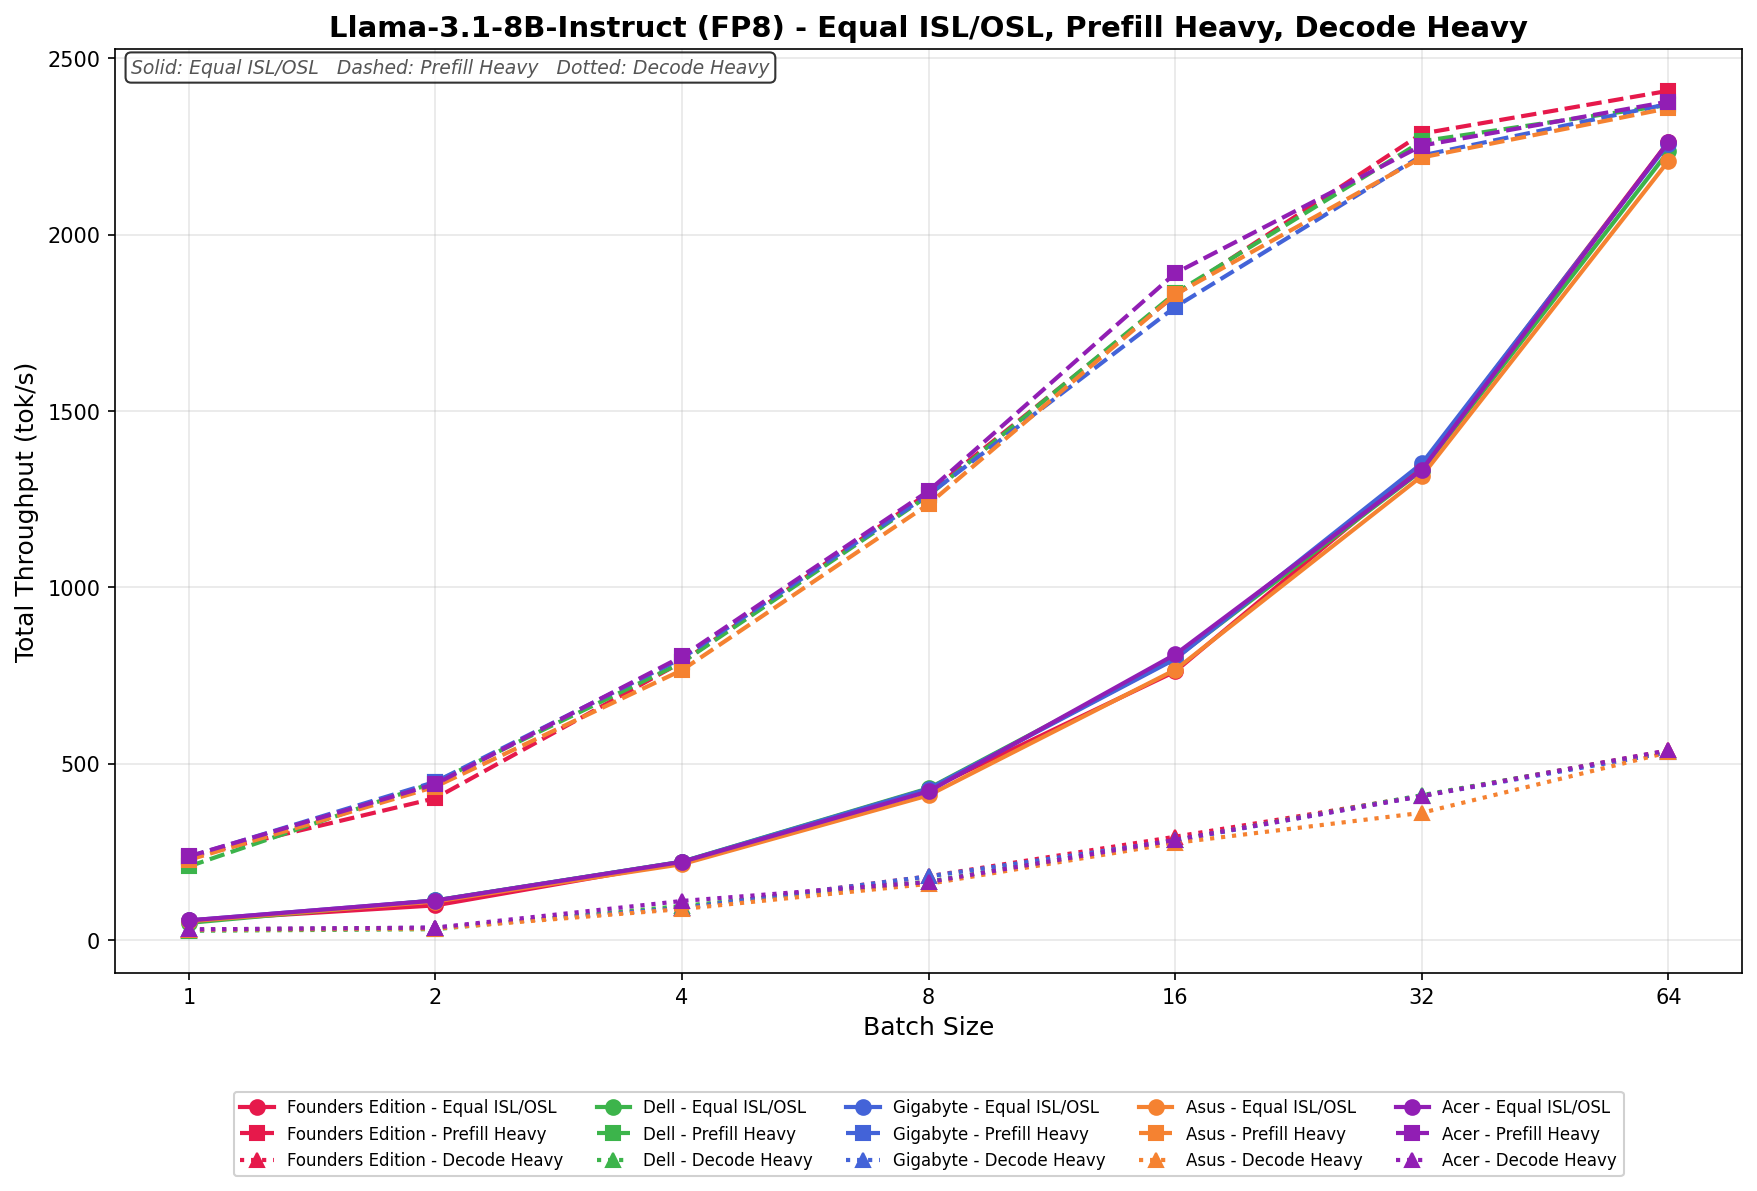
Llama 3.1 8B Instruction FP8
En Equal ISL/OSL, GIGABYTE passe de 54.12 à 2 314,87 tok/s, montrant une croissance linéaire et régulière jusqu'au lot 32 et une forte impulsion au lot 64 qui lui permet de rester compétitif à des niveaux de concurrence plus élevés.
Le pré-remplissage lourd commence à 226.43 tok/s et atteint 2 332,19 tok/s pour une taille de lot de 64. L’échelle est cohérente sur toute la plage de balayage, suivant de près le champ plus large et maintenant une efficacité solide pour les tailles de lot plus importantes.
Le décodage intensif atteint des performances allant de 32.88 à 522.41 tok/s, avec des gains progressifs et constants à mesure que la taille des lots augmente. Comme prévu, la mise à l'échelle reste plus limitée que pour les charges de travail égales et préremplies.
Stockage direct du GPU
L'un des tests que nous avons menés sur le Spark était le test MagnumIO GPU Direct Storage (GDS). GDS est une fonctionnalité développée par NVIDIA qui permet aux GPU de contourner le CPU lors de l'accès aux données stockées sur des disques NVMe ou d'autres périphériques de stockage haute vitesse. Au lieu de faire transiter les données par le CPU et la mémoire système, GDS permet une communication directe entre le GPU et le périphérique de stockage, réduisant ainsi considérablement la latence et améliorant le débit.
Gigabyte a intégré le SSD Samsung PM9E1 Gen5 de 4 To dans l'AI TOP ATOM, qui est à ce jour le disque M.2 2242 MHz le plus rapide du marché. On retrouve le même SSD dans le FE Spark et l'Acer Veriton GN100.
Comment fonctionne le stockage direct GPU
Traditionnellement, lorsqu'un GPU traite des données stockées sur un disque NVMe, ces données doivent d'abord transiter par le CPU et la mémoire système avant d'atteindre le GPU. Ce processus engendre des goulots d'étranglement, le CPU jouant le rôle d'intermédiaire, ce qui ajoute de la latence et consomme des ressources système précieuses. Le GPU Direct Storage élimine cette inefficacité en permettant au GPU d'accéder directement aux données depuis le périphérique de stockage via le bus PCIe. Ce chemin direct réduit la surcharge liée aux transferts de données, permettant ainsi des transferts plus rapides et plus efficaces.
Les charges de travail de l’IA, en particulier celles impliquant l’apprentissage profond, sont très gourmandes en données. La formation de grands réseaux neuronaux nécessite le traitement de téraoctets de données, et tout retard dans le transfert de données peut entraîner une sous-utilisation des GPU et des temps de formation plus longs. Le stockage direct GPU relève ce défi en garantissant que les données sont transmises au GPU le plus rapidement possible, en minimisant les temps d’inactivité et en maximisant l’efficacité de calcul.
En outre, GDS est particulièrement utile pour les charges de travail impliquant la diffusion de grands ensembles de données, comme le traitement vidéo, le traitement du langage naturel ou l'inférence en temps réel. En réduisant la dépendance au processeur, GDS accélère le déplacement des données et libère les ressources du processeur pour d'autres tâches, améliorant ainsi encore les performances globales du système.
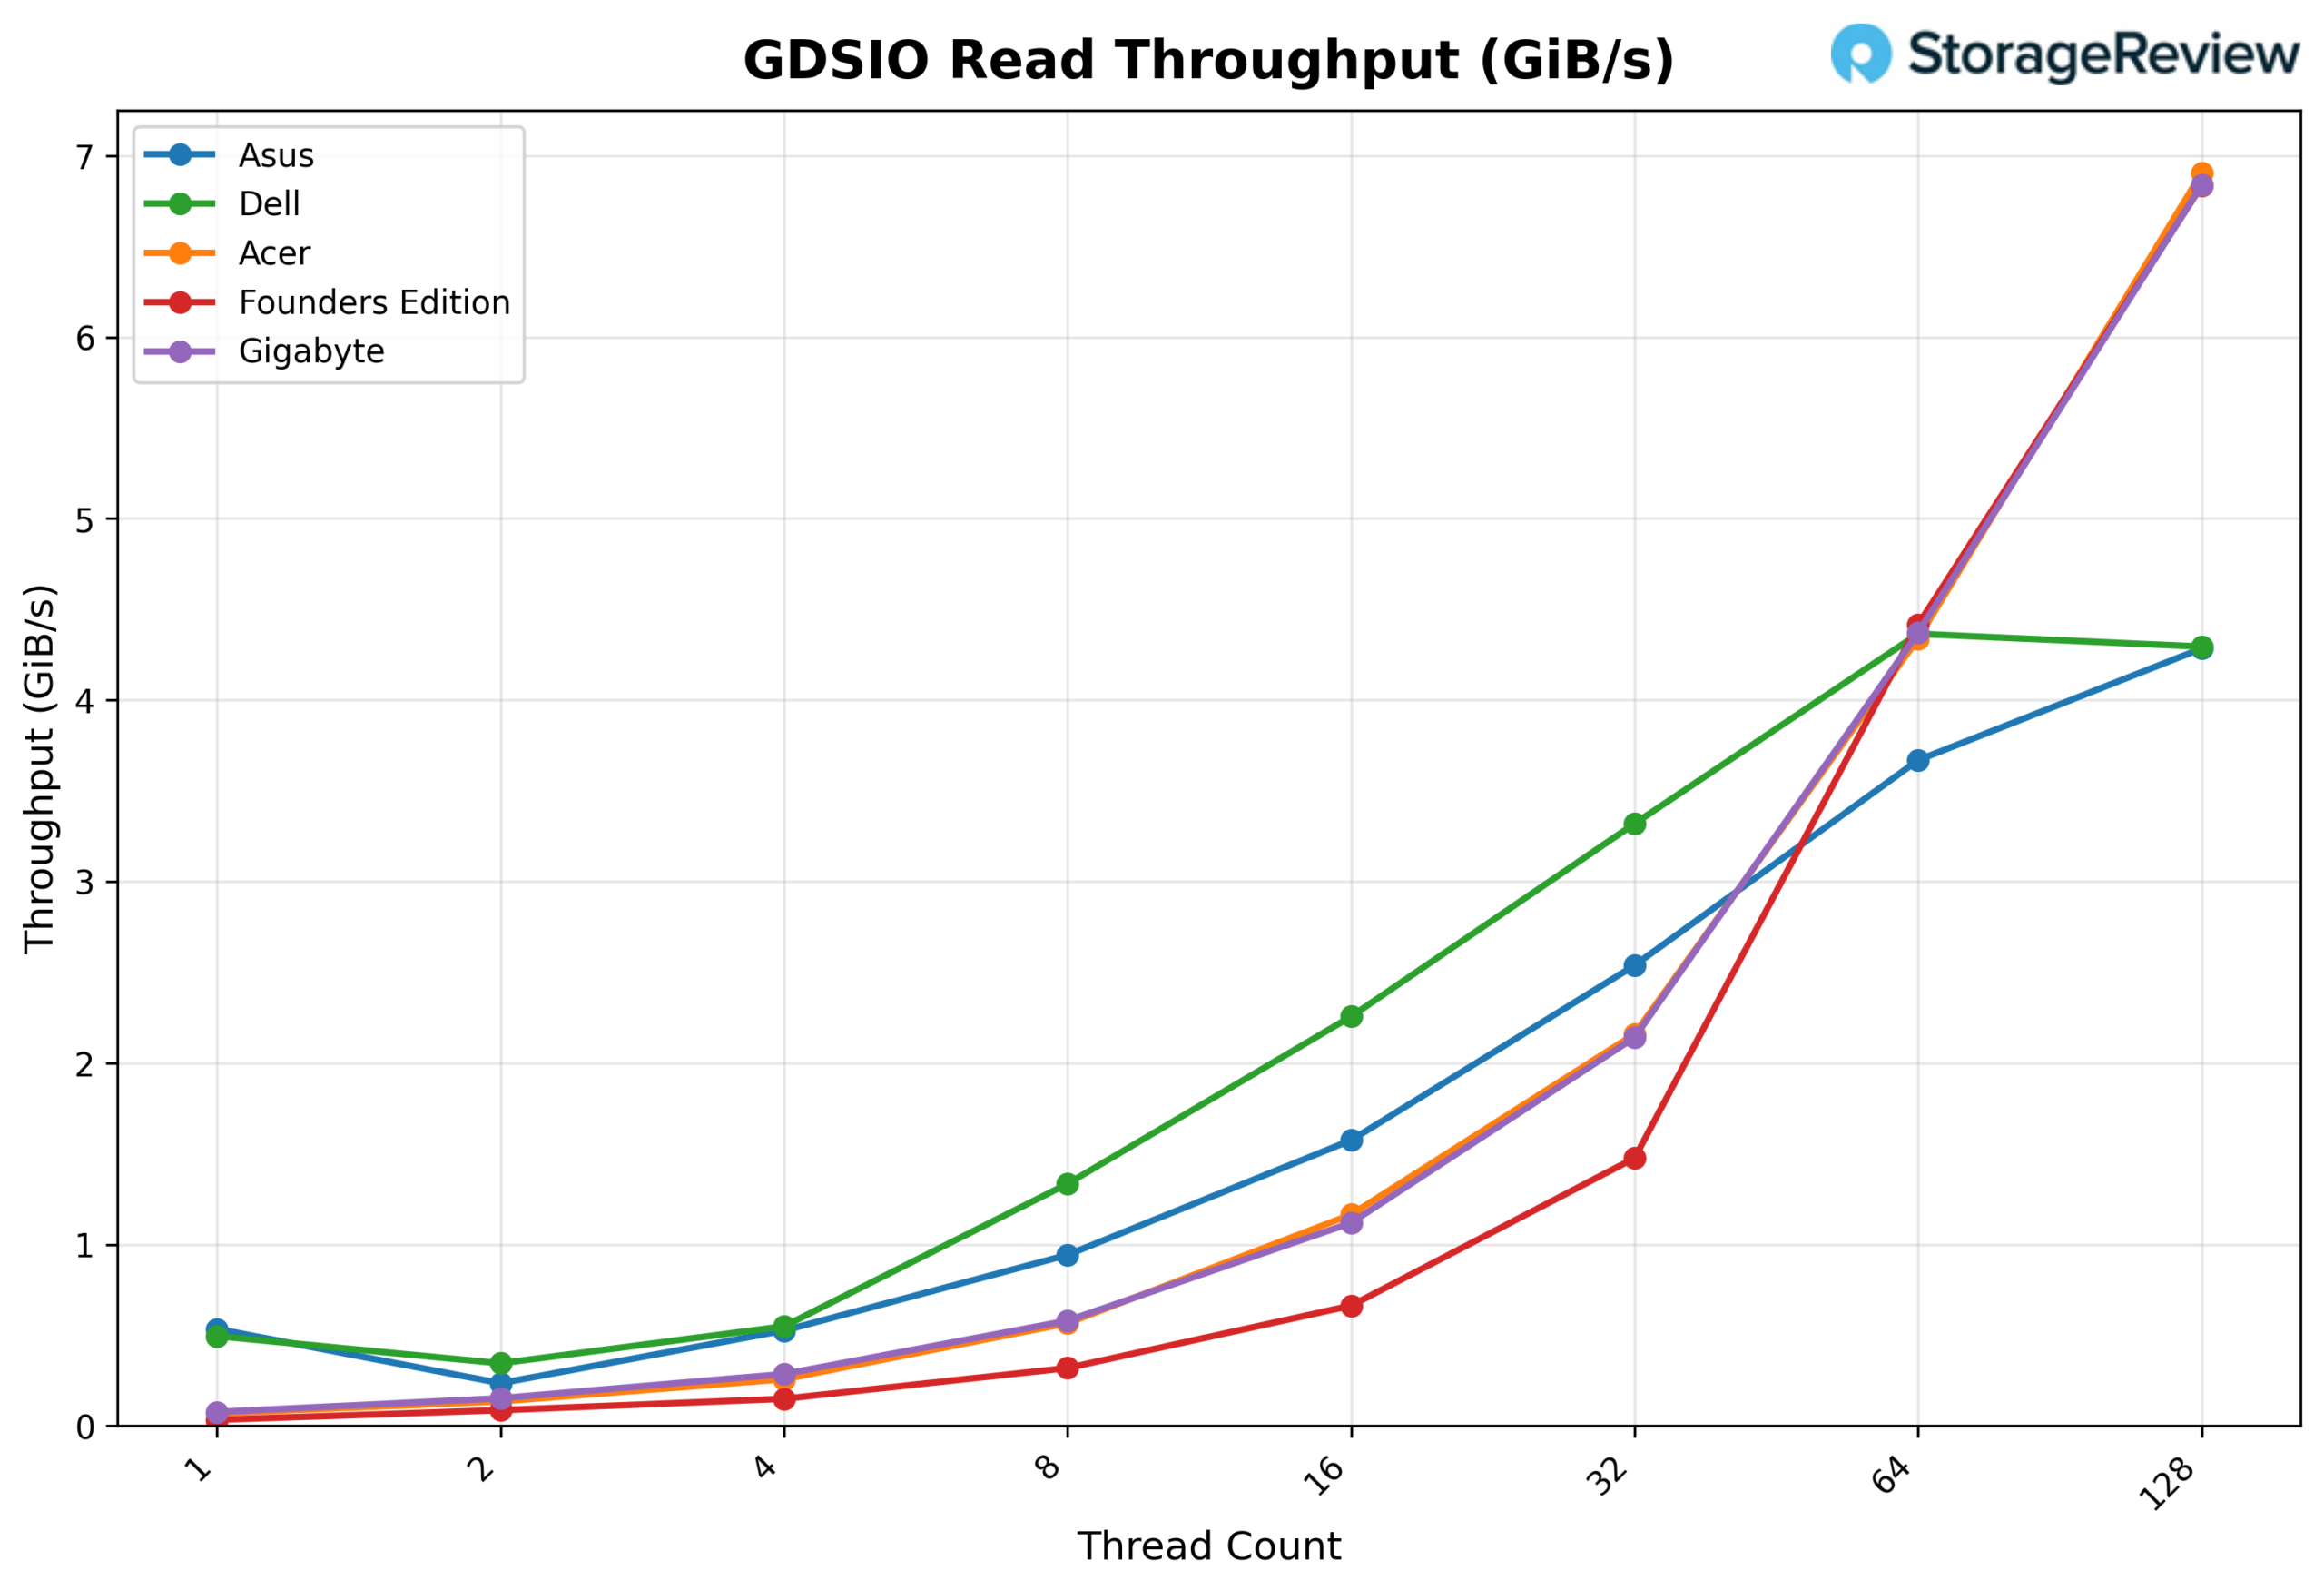
Débit de lecture GDSIO : 16 k
En ce qui concerne le débit de lecture GDSIO 16K, la carte GIGABYTE affiche environ 0.08 Gio/s avec 1 cœur et atteint 0.58 Gio/s avec 8 cœurs. Elle continue ensuite de progresser régulièrement à 16 cœurs (1.12 Gio/s) et 32 cœurs (2.14 Gio/s), avant de connaître une forte hausse à 64 cœurs pour atteindre 4.37 Gio/s. À 128 cœurs, le débit de la GIGABYTE atteint 6.84 Gio/s, sans montrer de signe de ralentissement à ce niveau de performance.
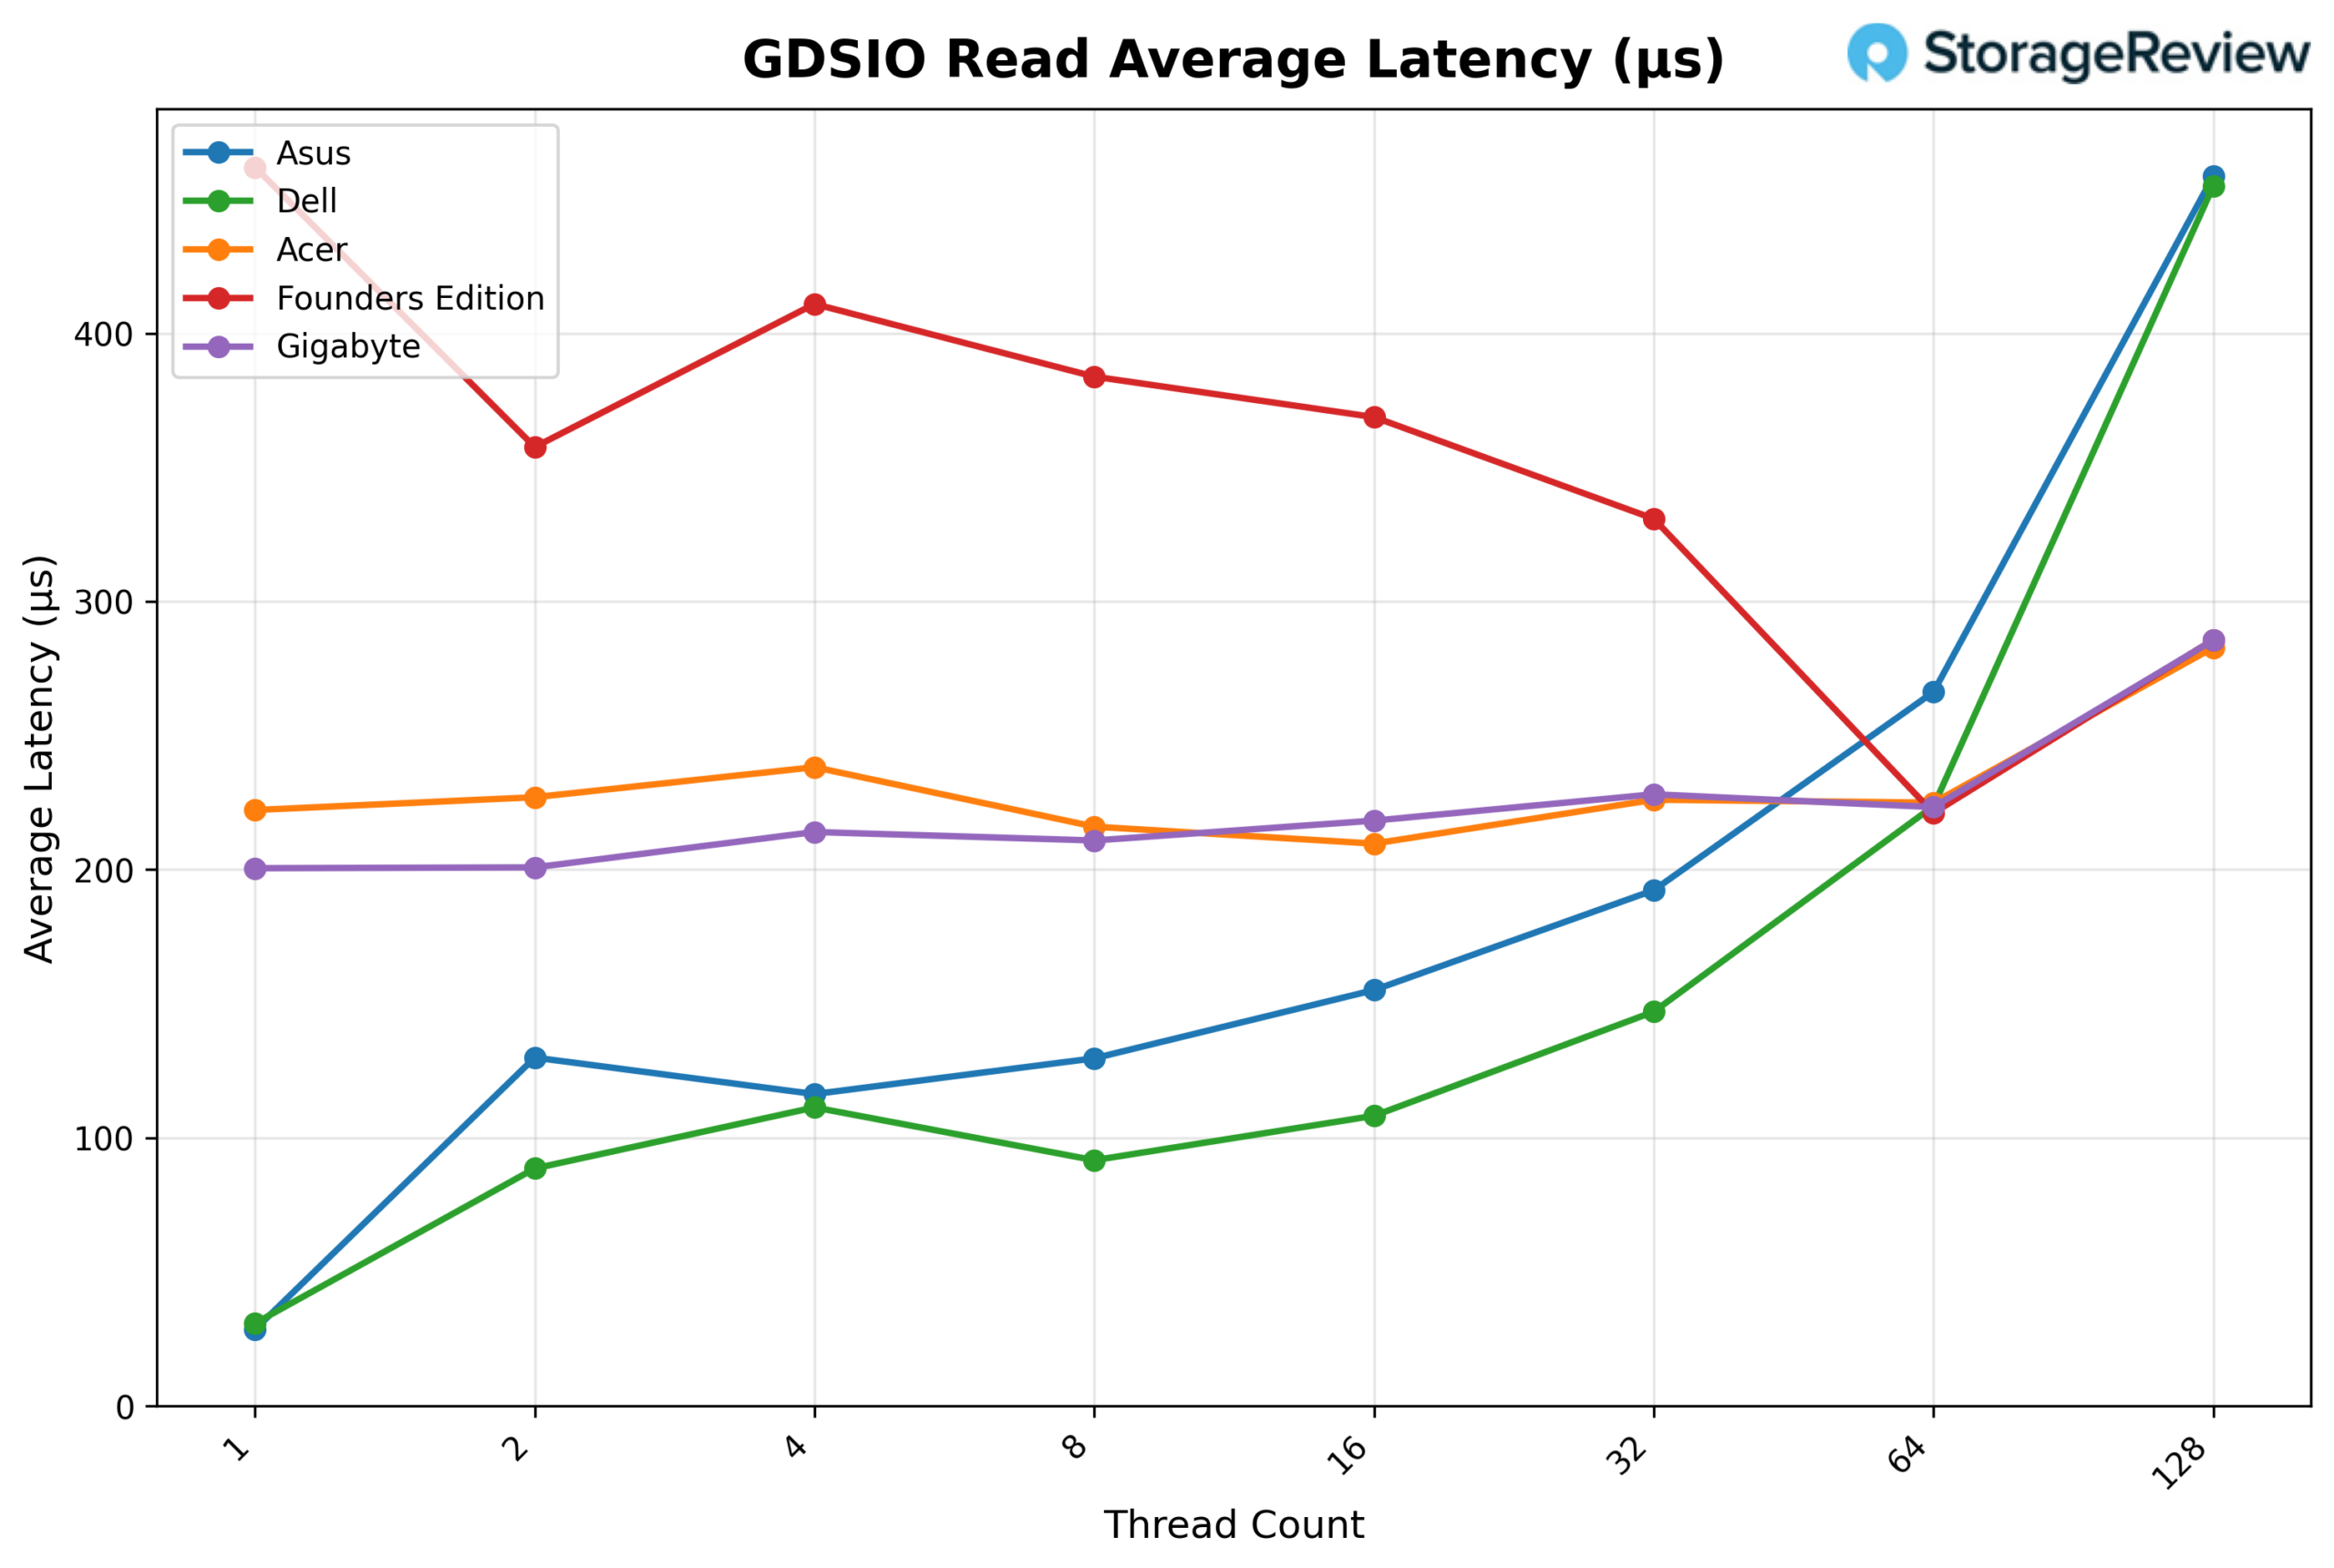
Latence moyenne de lecture GDSIO : 16 Ko
En analysant la latence moyenne de lecture GDSIO (16K), on constate que GIGABYTE affiche une latence très stable sur la majeure partie de la courbe. Elle débute à environ 0.201 ms avec un seul thread et reste très constante entre 0.21 et 0.23 ms, de 2 à 64 threads (par exemple, 0.211 ms à 8 threads, 0.218 ms à 16 threads, 0.228 ms à 32 threads et 0.223 ms à 64 threads). Ce n'est qu'à 128 threads que la latence augmente sensiblement, pour atteindre environ 0.286 ms, tandis que le débit continue de croître.
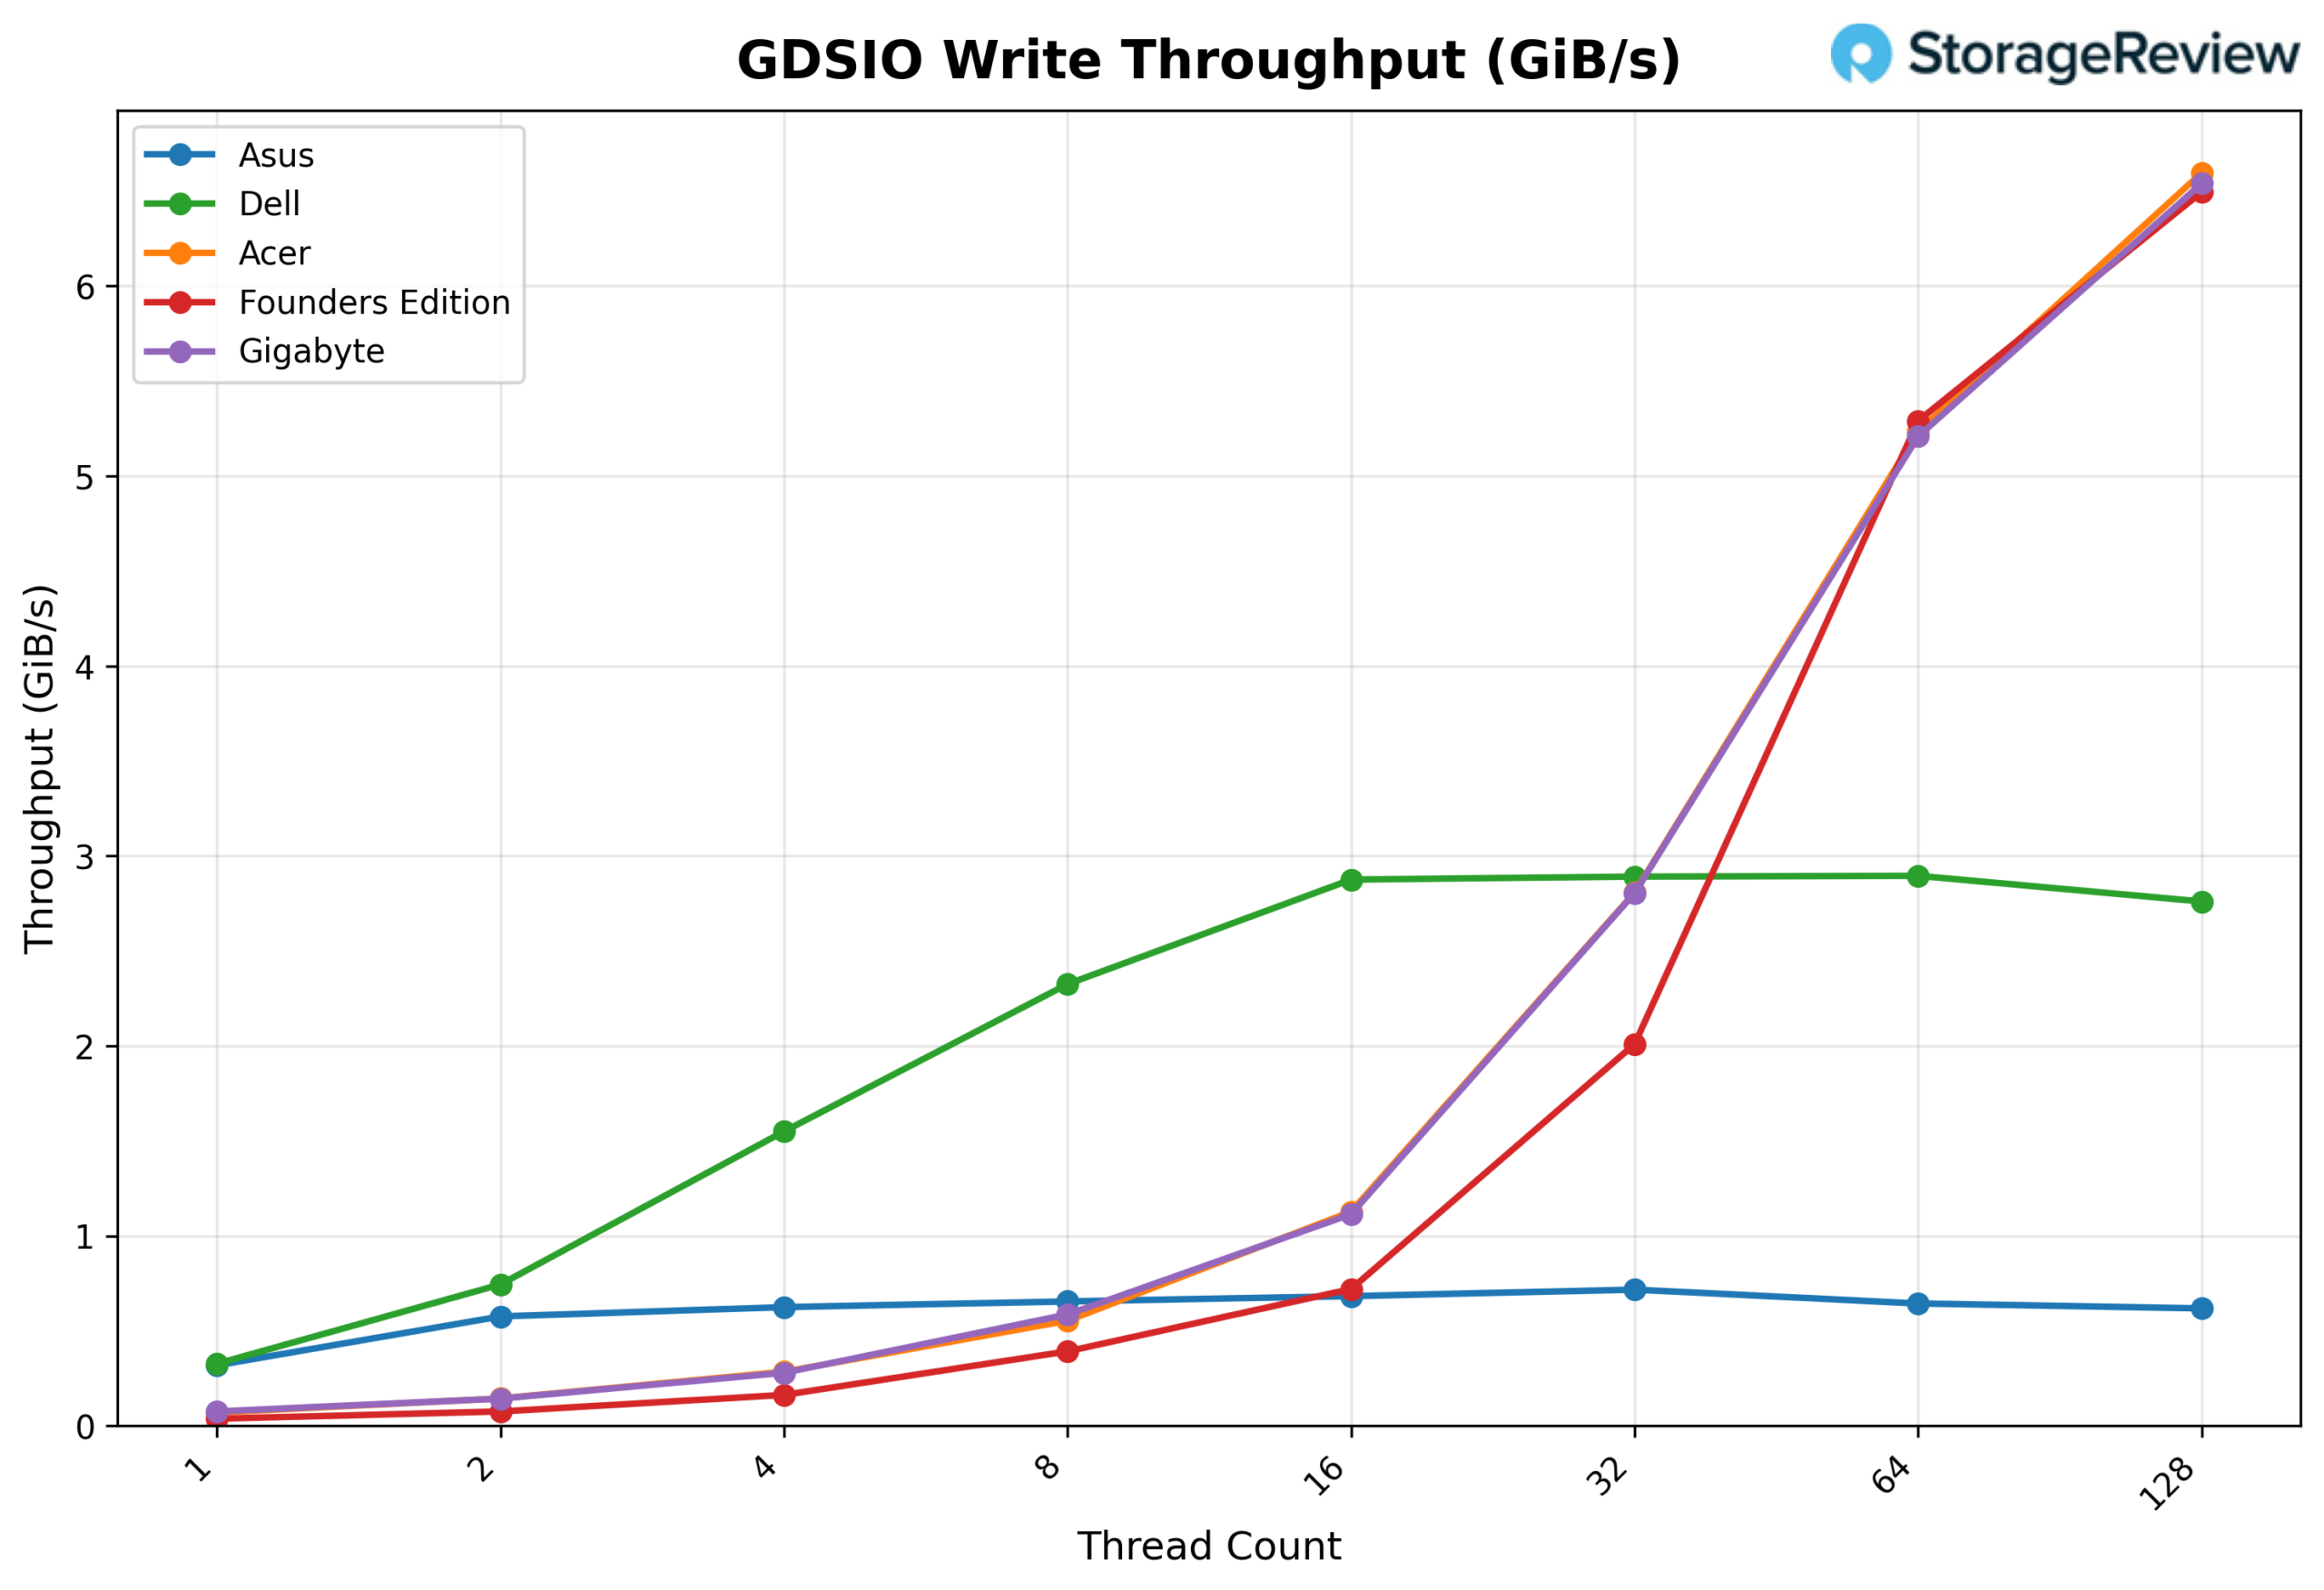
Débit d'écriture GSDIO : 16 Ko
En ce qui concerne le débit d'écriture GDSIO 16K, la carte GIGABYTE affiche un débit initial d'environ 0.08 Gio/s avec 1 cœur, qui progresse régulièrement jusqu'à 0.14 Gio/s avec 2 cœurs et 0.28 Gio/s avec 4 cœurs. Les performances continuent de s'améliorer sensiblement avec 8 cœurs (0.59 Gio/s) et 16 cœurs (1.11 Gio/s), avant de connaître une accélération plus marquée avec 32 cœurs (2.80 Gio/s). La progression reste soutenue avec 64 cœurs (5.21 Gio/s) et atteint un pic de 6.54 Gio/s avec 128 cœurs, témoignant d'une croissance continue sans stagnation précoce.
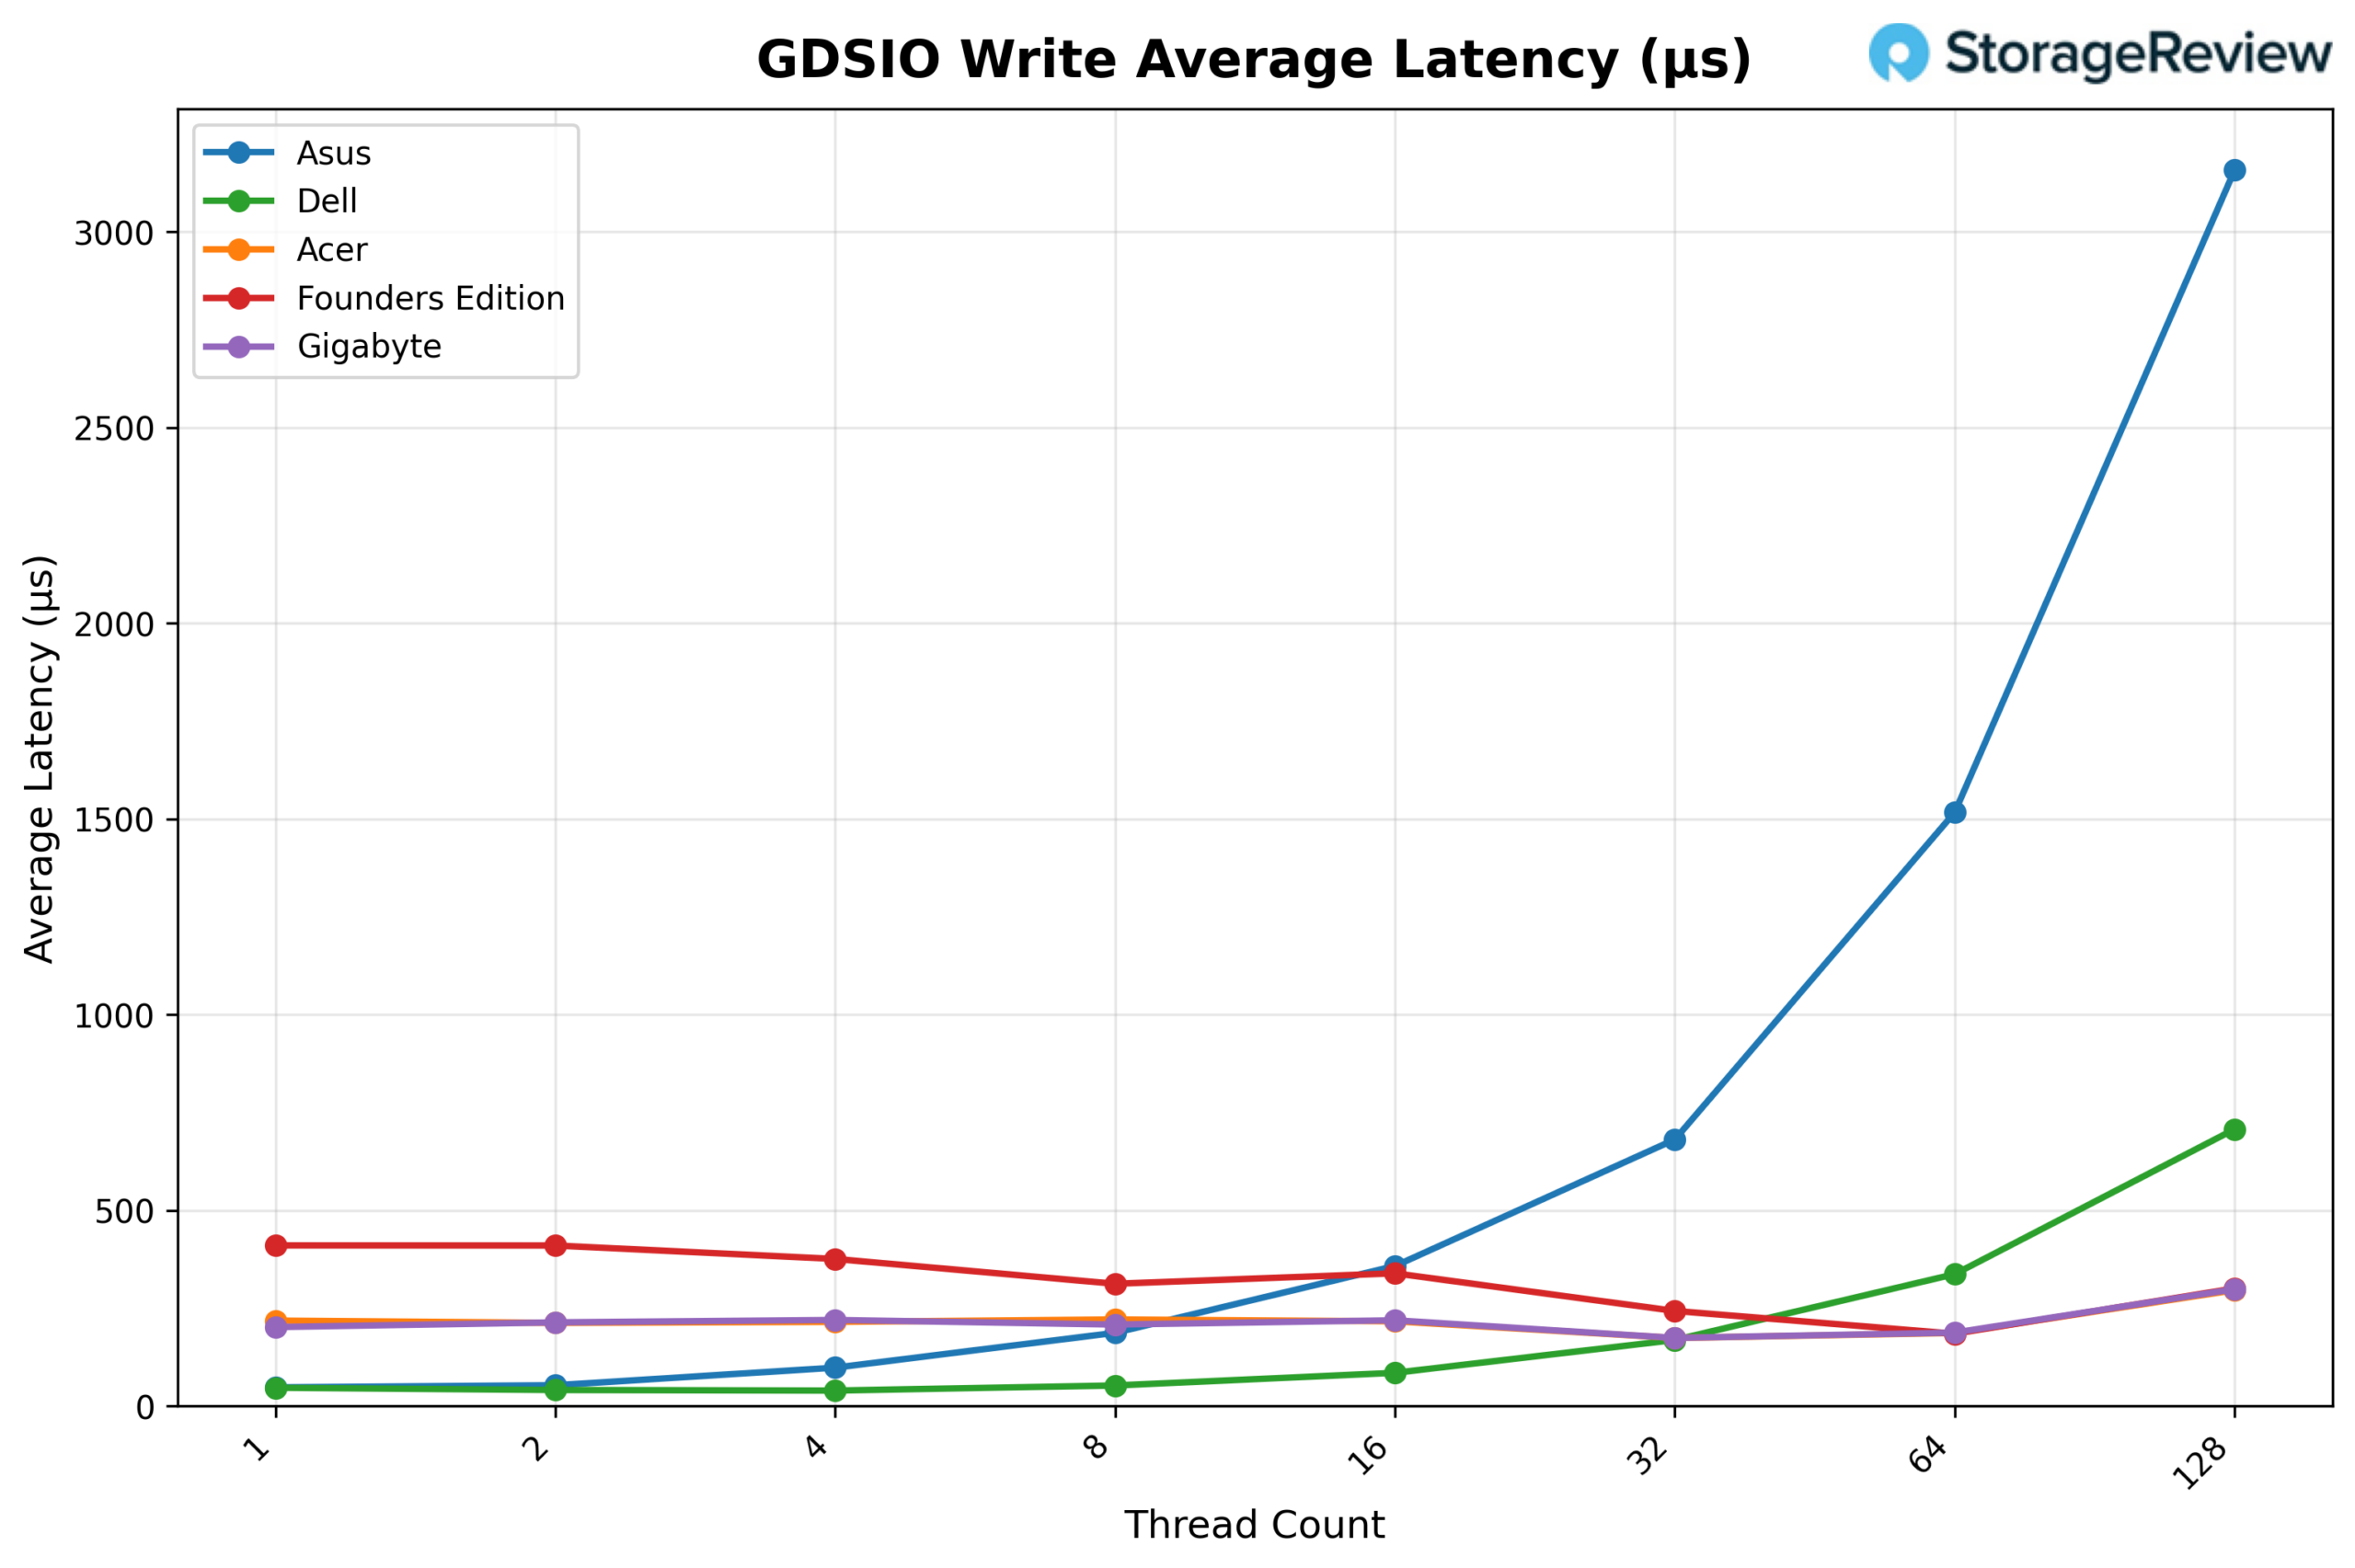
Latence d'écriture moyenne GDSIO : 16 Ko
En analysant la latence d'écriture moyenne GDSIO (16K), on constate que GIGABYTE maintient une latence relativement stable sur la majeure partie de la courbe. Elle débute à environ 0.20 ms avec 1 thread et se maintient entre 0.21 et 0.22 ms jusqu'à 16 threads. À 32 threads, la latence s'améliore légèrement pour atteindre environ 0.17 ms, puis augmente modérément à 64 threads (0.19 ms). Ce n'est qu'à 128 threads que la latence augmente sensiblement, pour atteindre environ 0.30 ms, ce qui correspond au débit maximal.
Débit de lecture GDSIO : 1 Mbit/s
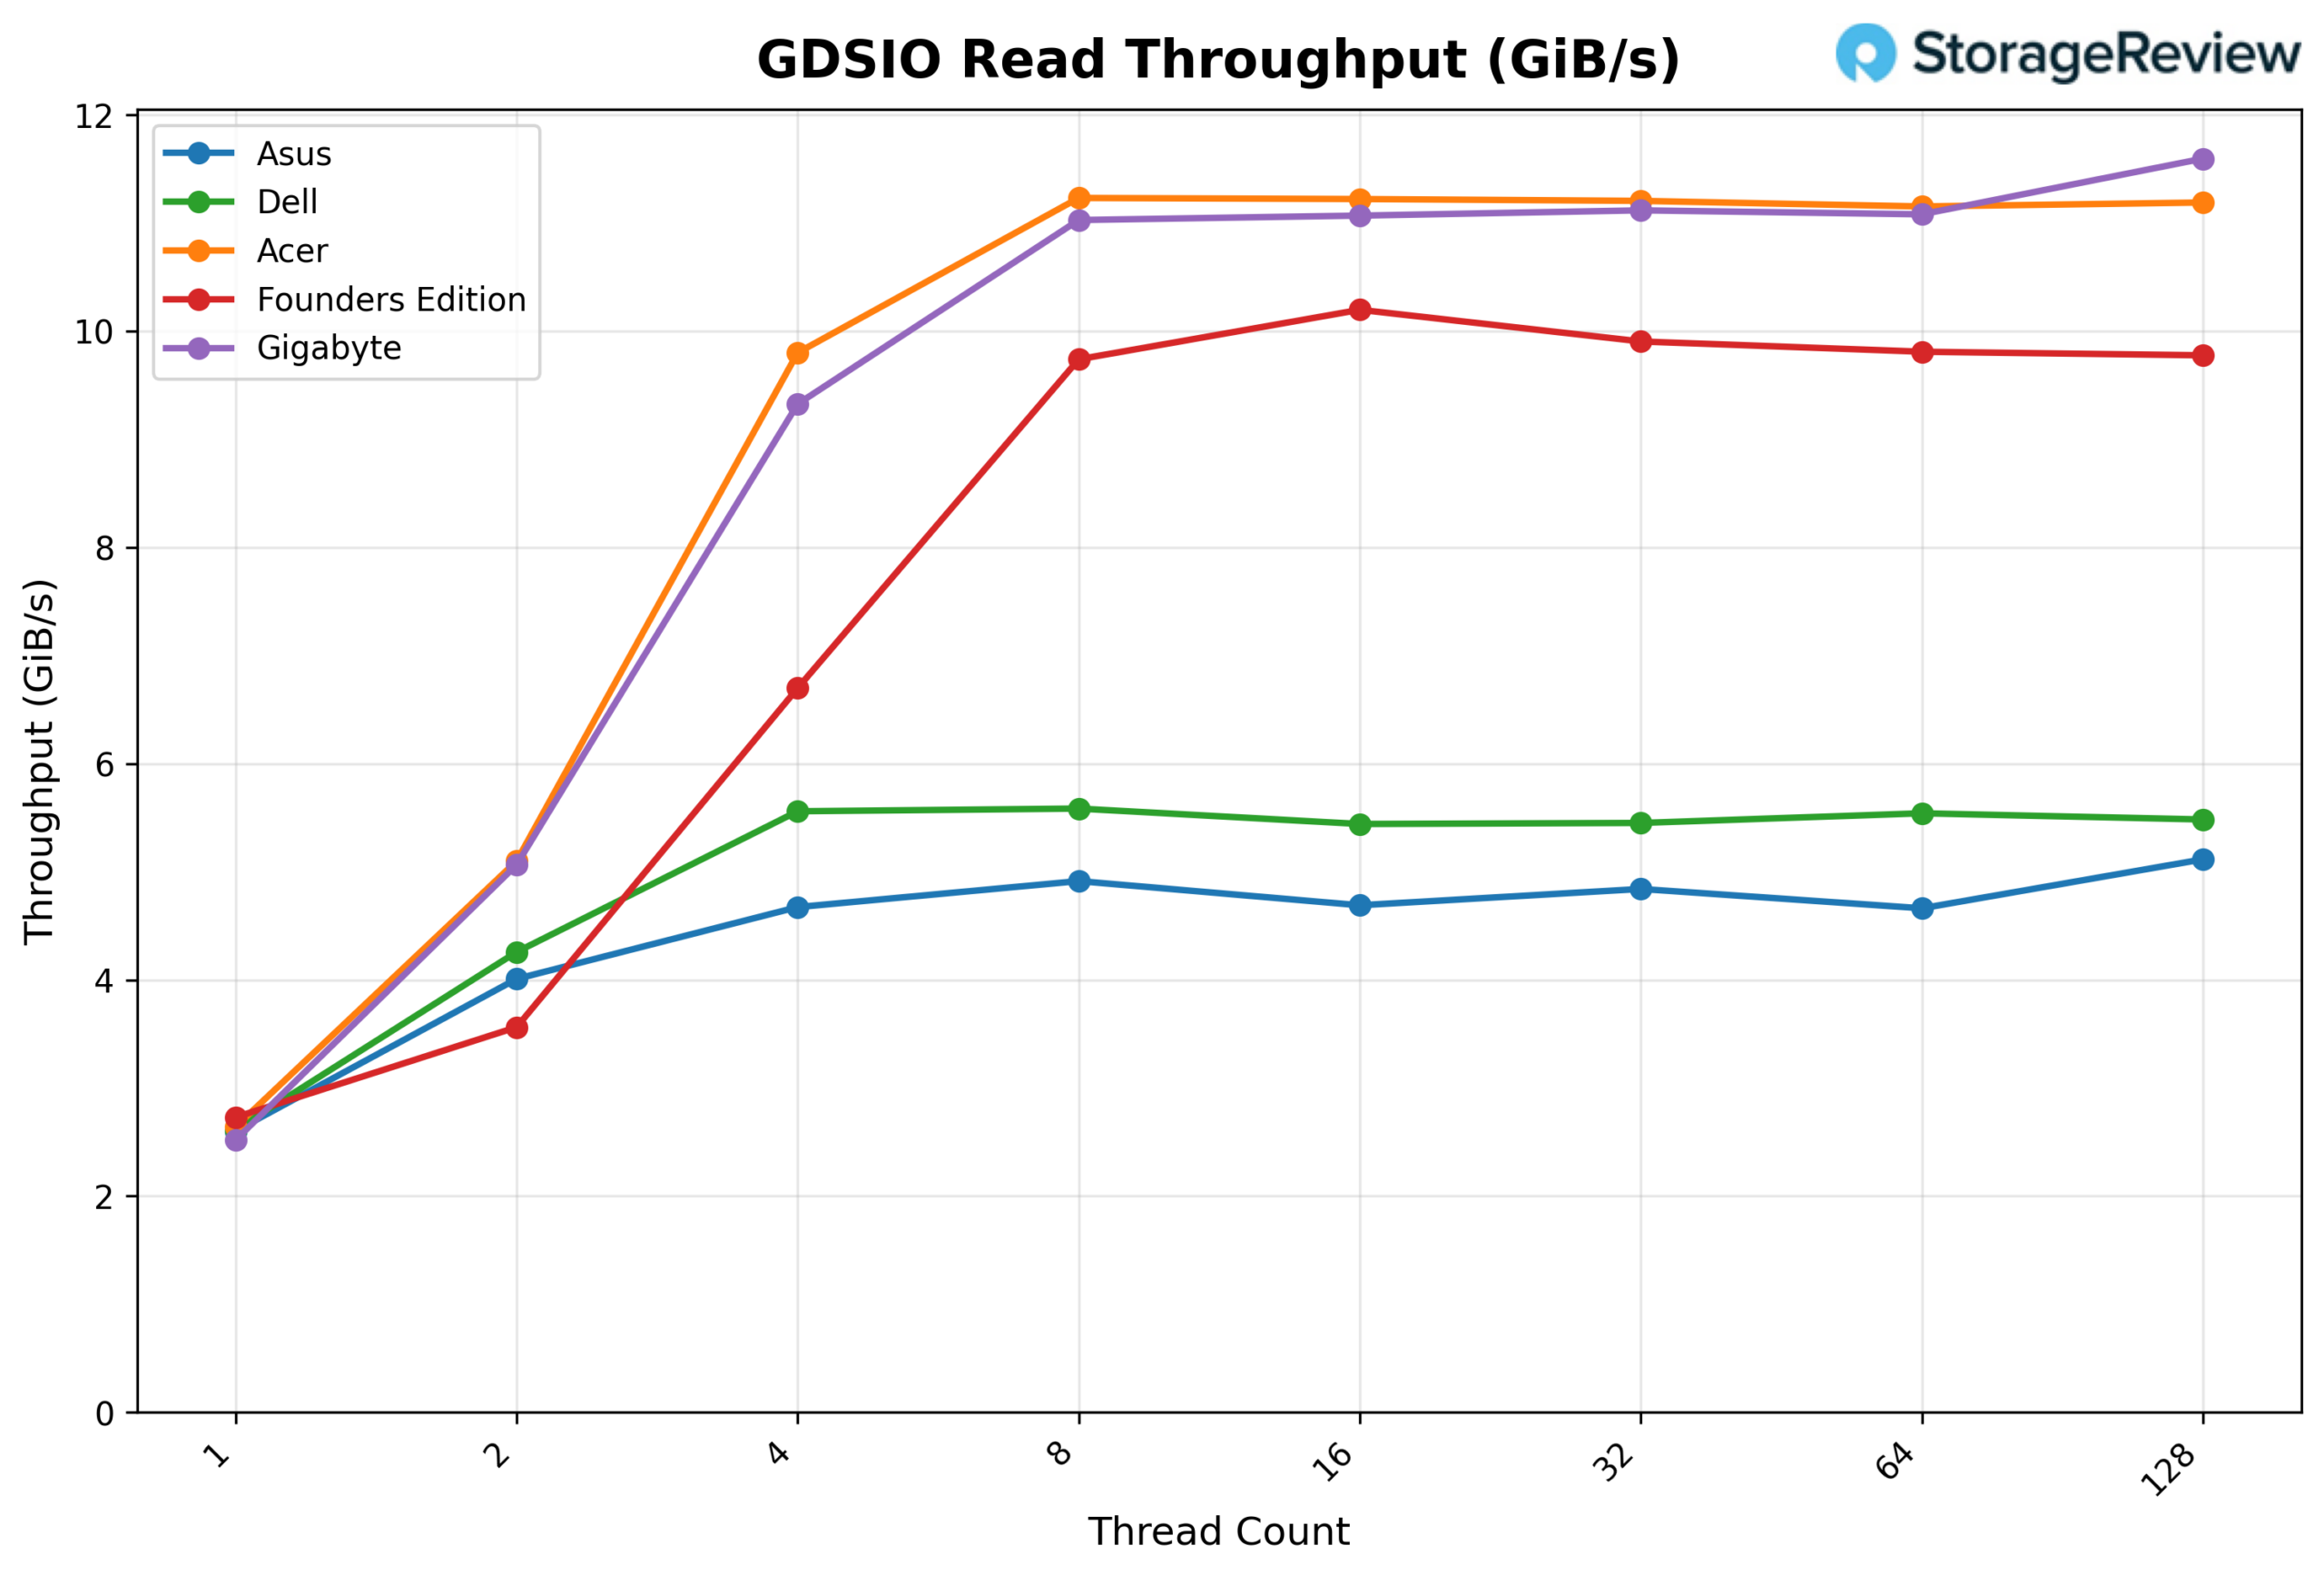
En ce qui concerne le débit de lecture GDSIO 1M, le GIGABYTE atteint 2.52 Gio/s avec 1 thread, puis 5.07 Gio/s avec 2 threads et 9.33 Gio/s avec 4 threads. À 8 threads, le débit atteint 11.03 Gio/s, après quoi la plateforme sature. Les performances restent constantes à 16 threads (11.07 Gio/s), 32 threads (11.12 Gio/s) et 64 threads (11.08 Gio/s), affichant un plateau stable. À 128 threads, le débit augmente légèrement pour atteindre 11.60 Gio/s, soit le meilleur résultat observé lors de ce test.
Latence moyenne de lecture GDSIO : 1 Mbit/s
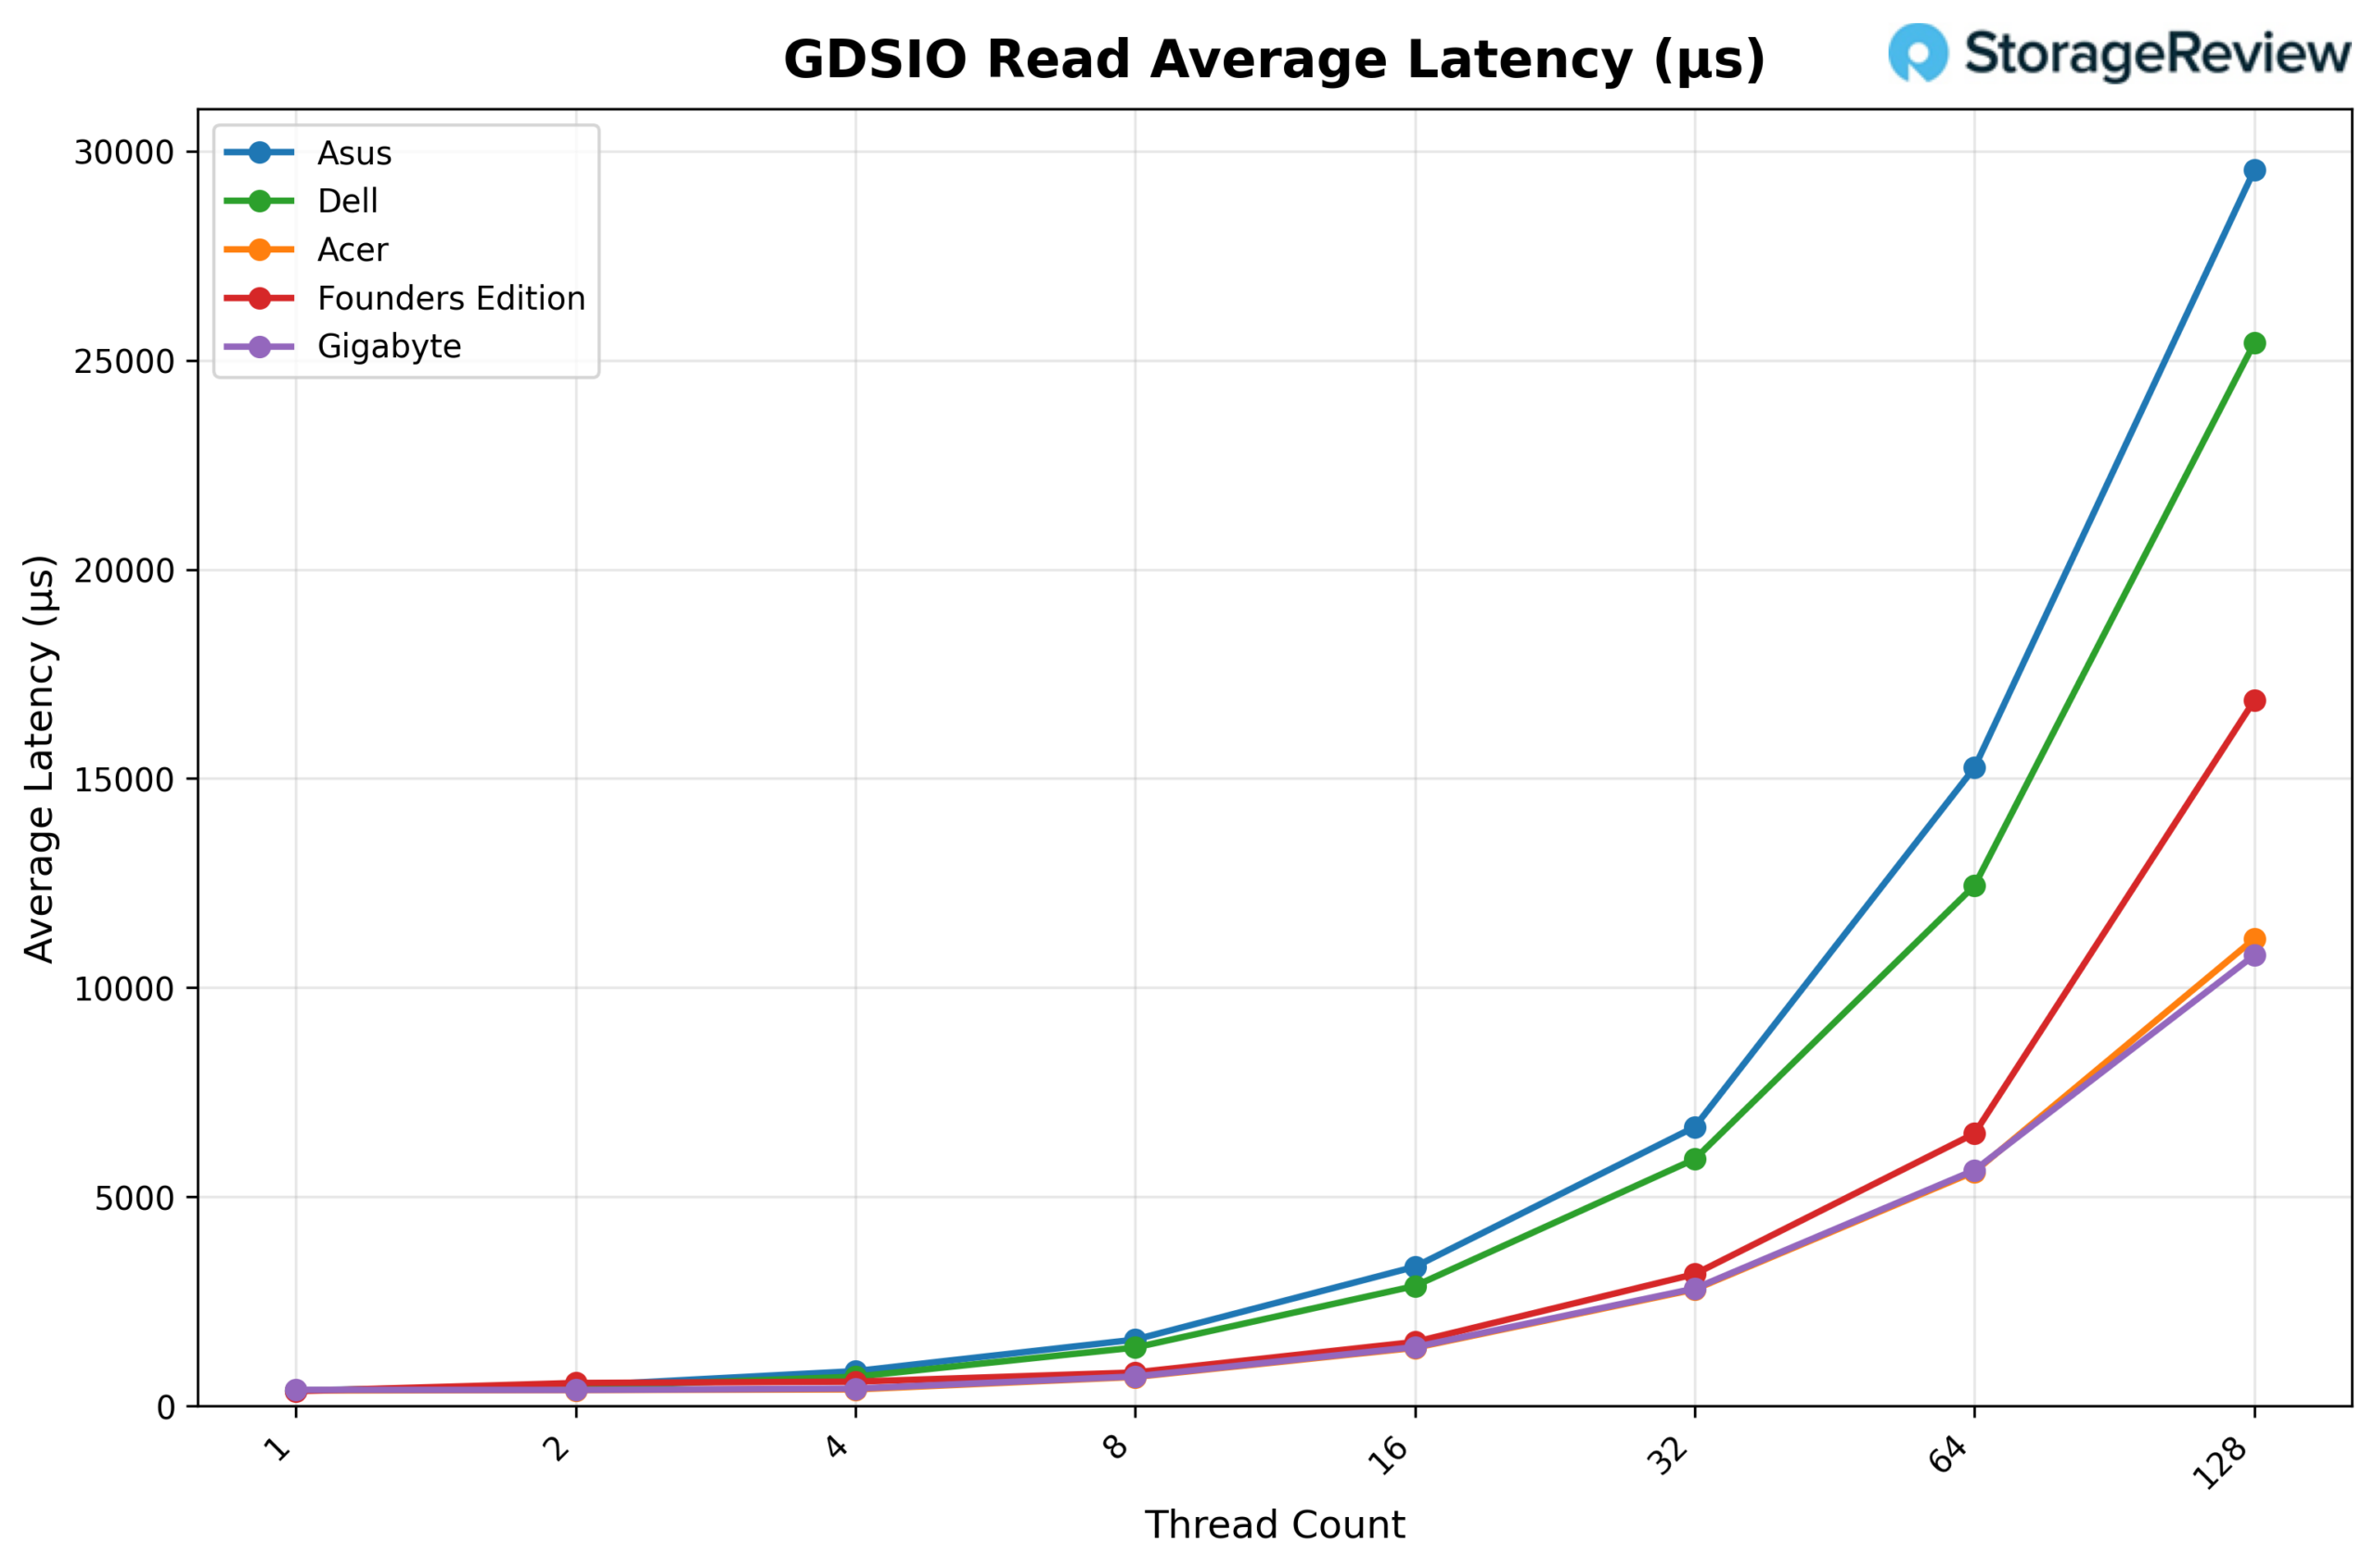
En analysant la latence moyenne de lecture GDSIO (1 Mo), on constate que GIGABYTE affiche une latence d'environ 0.39 ms avec 1 thread, et qu'elle reste similaire avec 2 threads (0.39 ms) et 4 threads (0.42 ms). La latence augmente avec la concurrence, atteignant 0.71 ms avec 8 threads, 1.41 ms avec 16 threads et 2.81 ms avec 32 threads. Cette tendance à la hausse se poursuit avec 64 threads (5.64 ms) et culmine à 10.78 ms avec 128 threads, correspondant aux niveaux de concurrence les plus élevés, tandis que le débit demeure globalement stable.
Débit d'écriture GDSIO : 1 Mbit/s
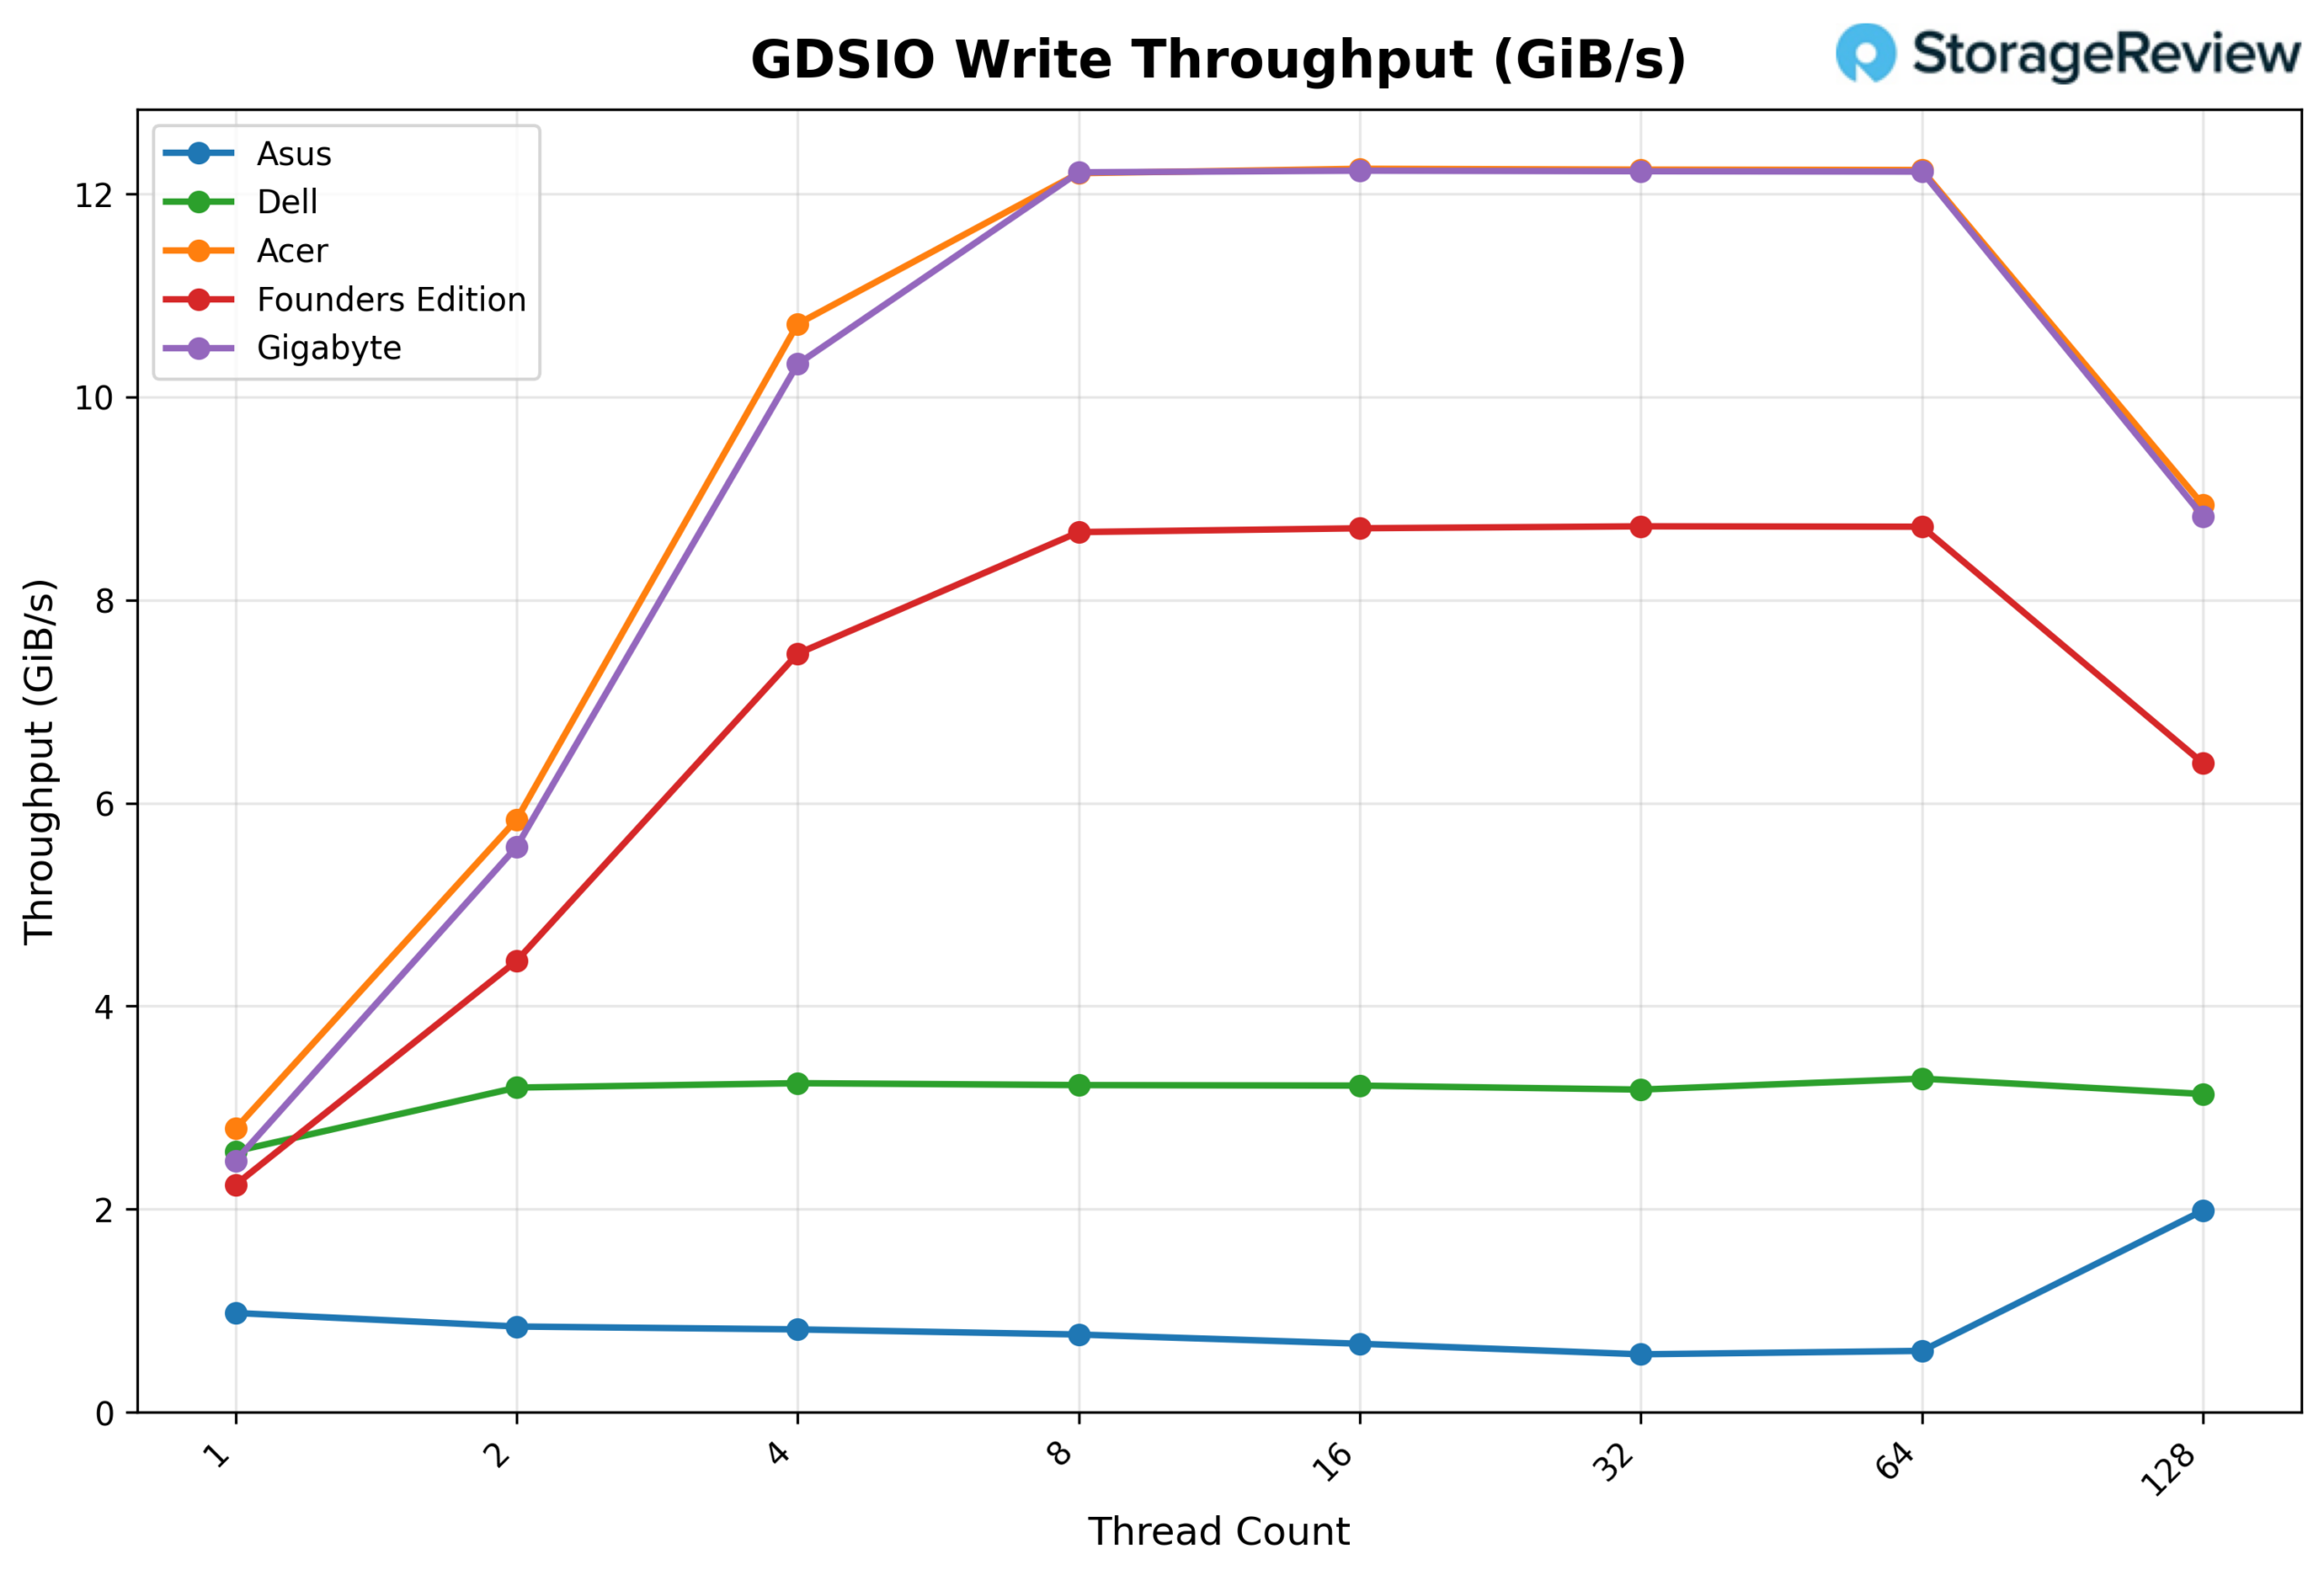
En ce qui concerne le débit d'écriture GDSIO 1M, le GIGABYTE atteint 2.48 Gio/s avec 1 thread, puis grimpe rapidement à 5.57 Gio/s avec 2 threads et à 10.32 Gio/s avec 4 threads. À 8 threads, le débit atteint 12.21 Gio/s, saturant ainsi la plateforme. Les performances restent stables à 16 threads (12.23 Gio/s), 32 threads (12.22 Gio/s) et 64 threads (12.22 Gio/s), ce qui indique un plafonnement précoce. À 128 threads, le débit chute à 8.82 Gio/s, suggérant que le système a dépassé sa plage de concurrence optimale.
Latence d'écriture moyenne GDSIO : 1 Mbit/s
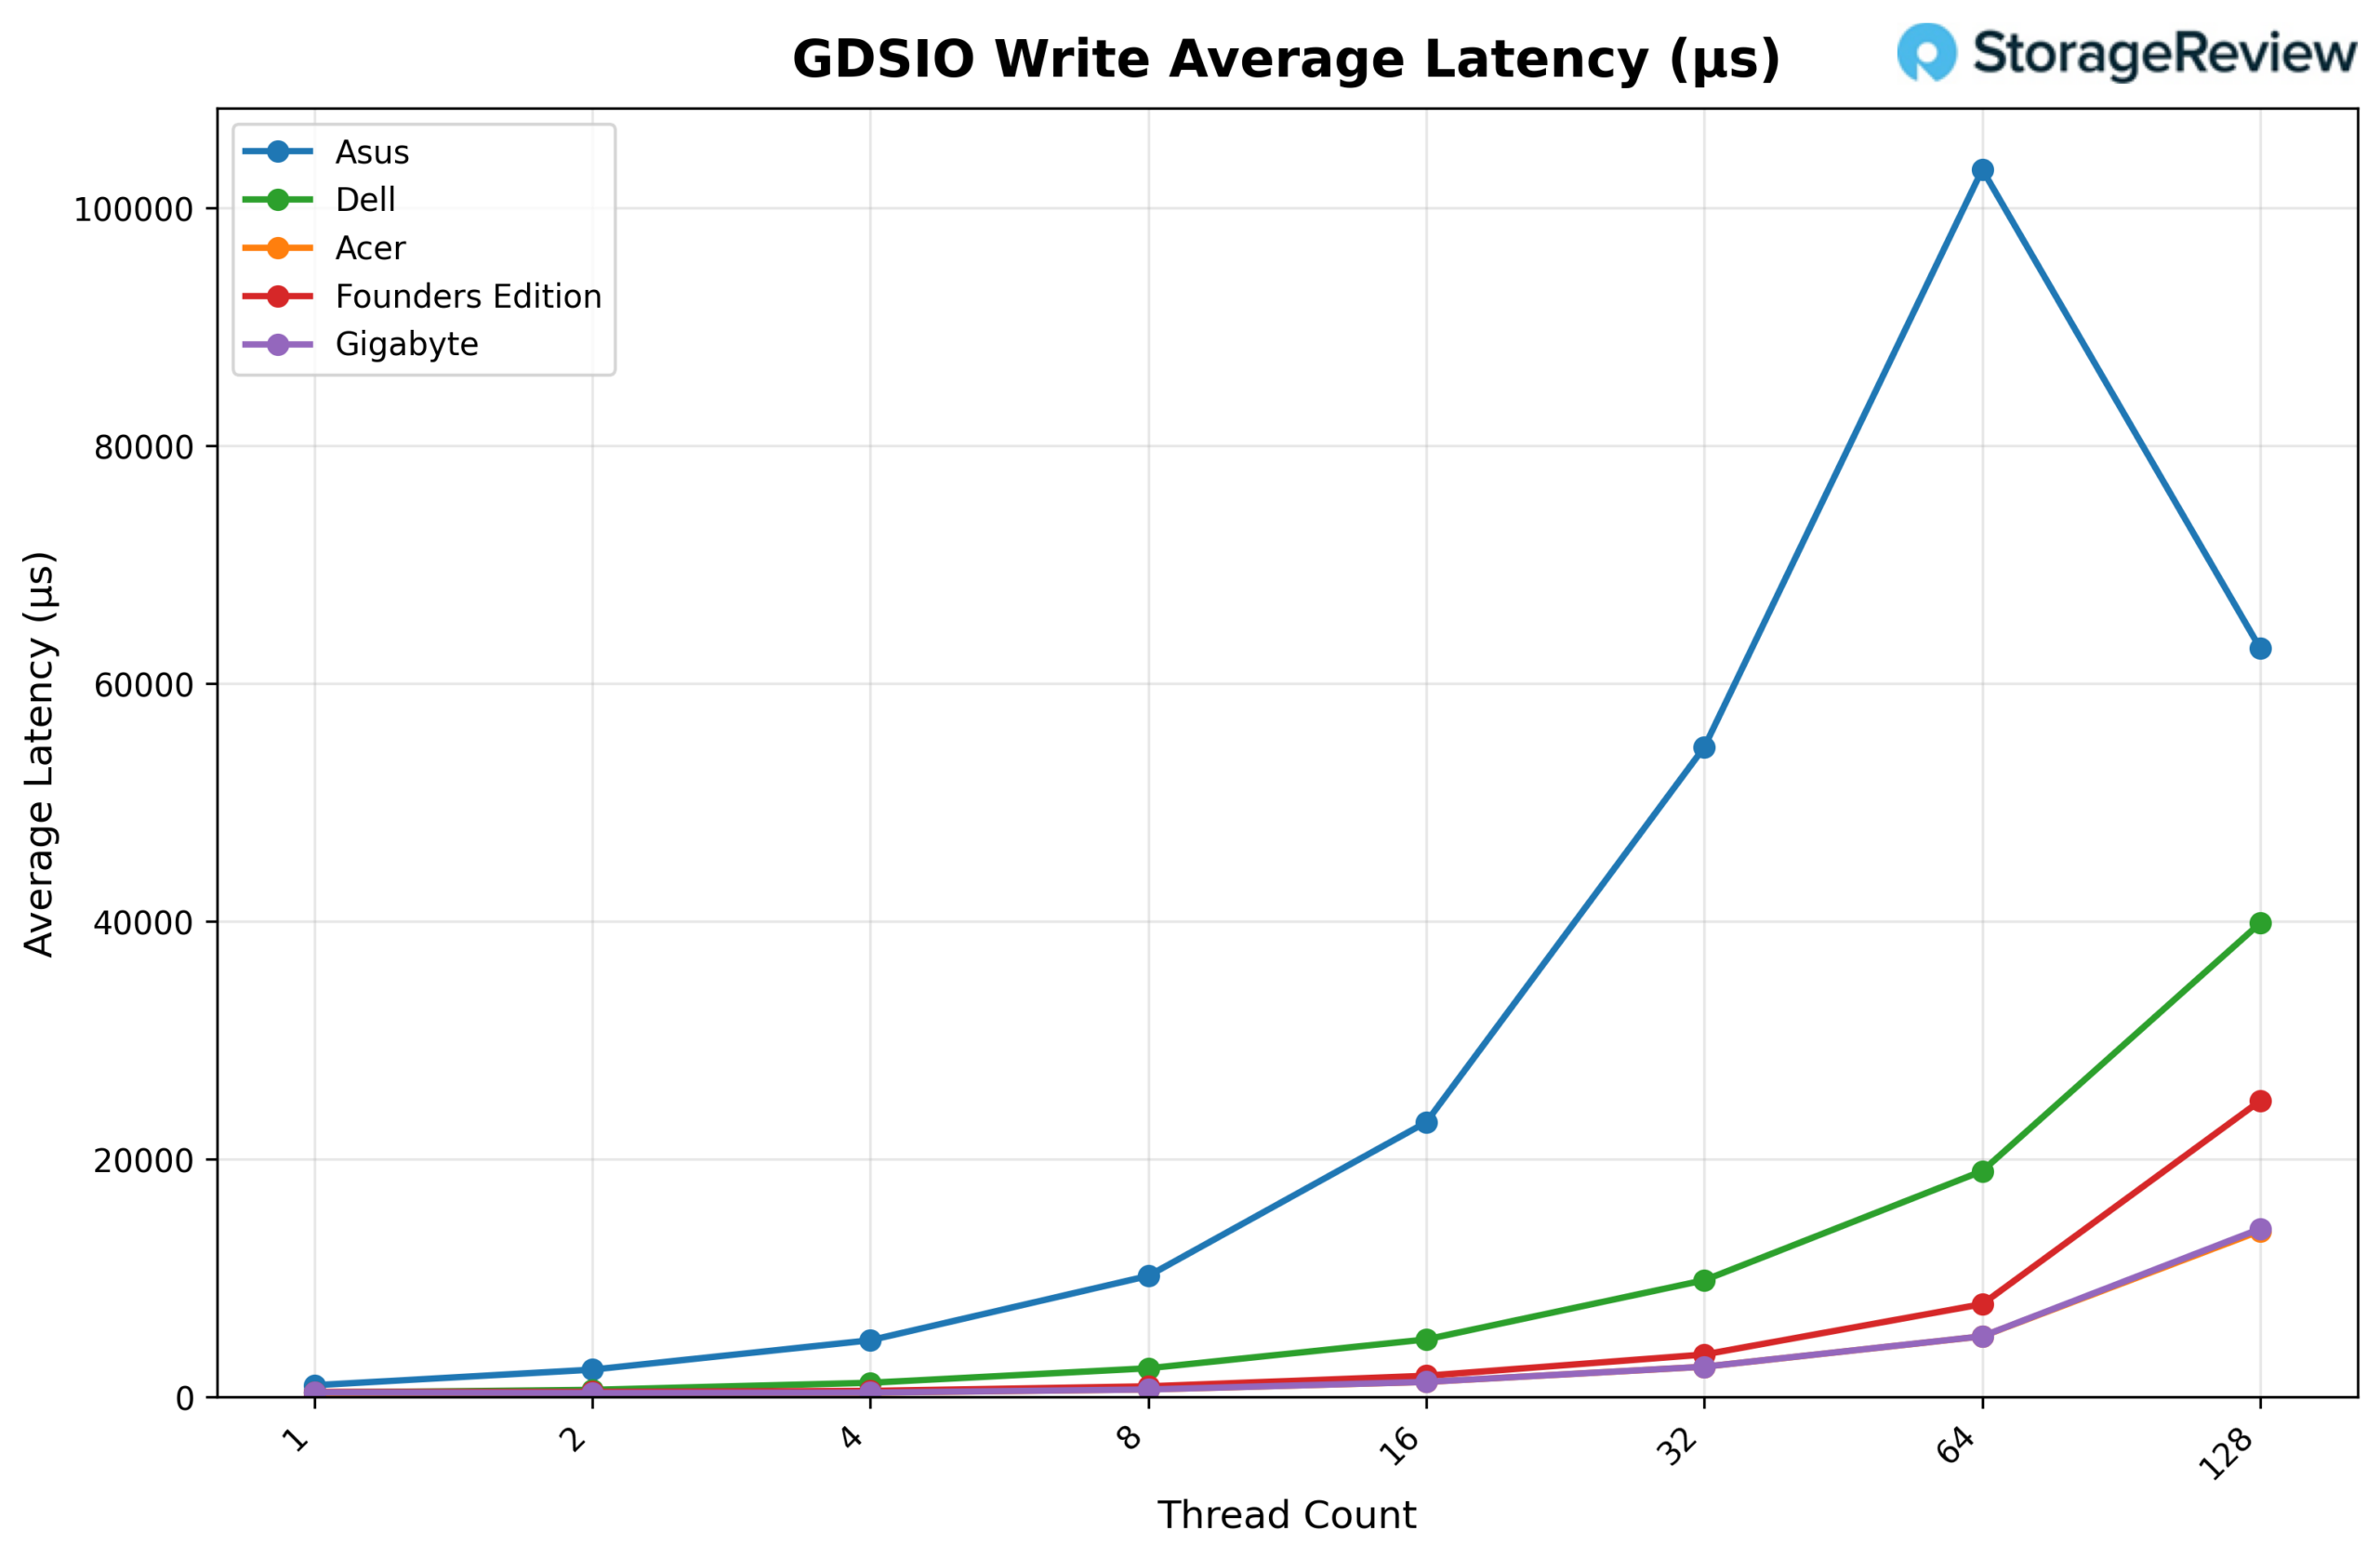
En analysant la latence d'écriture moyenne GDSIO (1 Mo), on constate que GIGABYTE affiche une latence d'environ 0.39 ms avec 1 thread et reste relativement stable avec 2 threads (0.35 ms) et 4 threads (0.38 ms). La latence augmente sensiblement avec le nombre de threads, atteignant 0.64 ms à 8 threads, 1.28 ms à 16 threads et 2.56 ms à 32 threads. La tendance à la hausse se poursuit à 64 threads (5.11 ms) avant de connaître une augmentation significative à 128 threads, avec une latence de 14.16 ms, ce qui correspond à la baisse de débit observée au niveau de concurrence le plus élevé.
Conclusion
La GIGABYTE AI TOP ATOM est une autre implémentation de la plateforme Spark basée sur le GB10 de NVIDIA, construite sur la même carte et avec la même puce que celles testées sur l'ensemble de la gamme. Comme prévu, les performances de calcul des cœurs sous vLLM sont très proches de celles des autres modèles du marché. Pour les modèles GPT-OSS, Qwen3-Coder et Llama 3.1, le comportement en termes de passage à l'échelle est resté prévisible, avec un débit de pré-remplissage élevé et des performances d'égalisation et de décodage stables malgré l'augmentation de la concurrence.
Sur le plan thermique, GIGABYTE a toléré des pics de consommation légèrement plus importants. Le processeur a atteint 90 °C et le GPU 81 °C lors de transitions nécessitant un préremplissage important, la consommation du GPU culminant à 75.54 W. Une fois la charge de travail normalisée, les températures se sont stabilisées sans signe de bridage thermique durable. En pratique, ces pics plus élevés reflètent davantage des décisions d'allocation de puissance de courte durée qu'une instabilité.
Ce qui distingue clairement cette unité, c'est son stockage. Grâce au SSD Samsung PM9E1 Gen5 de 4 To, GIGABYTE a obtenu des résultats GDSIO parmi les plus performants du groupe Spark. Les débits de lecture et d'écriture ont évolué de manière fluide sur des charges de travail de 16 000 et 1 million de threads, avec une saturation rapide aux niveaux de concurrence attendus et une augmentation de la latence principalement observée aux nombres de threads les plus élevés.
Comme tous les systèmes Spark partagent la même architecture GB10, les écarts de performances en matière d'inférence IA restent faibles. En pratique, le choix se base davantage sur la conception du châssis, le comportement thermique en cas de forte sollicitation, la configuration du stockage et la compatibilité avec le fournisseur que sur des différences fondamentales de puissance de calcul.
Page produit – GIGABYTE AI TOP ATOM
Classement : Le GIGABYTE AI TOP ATOM fait partie des ordinateurs testés et figure dans notre classement des meilleurs ordinateurs de bureau pour l’IA locale.


 Amazon