

La demande de contenu vidéo rapide et de haute qualité n'a jamais été aussi forte. Dans le paysage médiatique actuel, les petites équipes de presse, les créateurs de contenu indépendants et les équipes de production d'événements doivent capturer, monter et publier des séquences de qualité professionnelle en temps réel, souvent sans l'aide d'une équipe de post-production ni d'une infrastructure centralisée.
C'est pourquoi la recherche IA sur site, assurée par des systèmes de production en périphérie, devient incontournable, face à l'explosion du volume de séquences et à la nécessité croissante de les réutiliser. En permettant aux équipes de travailler directement avec les séquences au moment de la capture, les workflows en périphérie éliminent les goulots d'étranglement et permettent aux créateurs de consacrer moins de temps à la recherche et à la gestion des séquences, et plus de temps à la production du meilleur contenu possible.
Axle AI , une plateforme de gestion et d'automatisation des ressources multimédias basée sur l'IA, est spécialement conçue pour les flux de travail décentralisés et dynamiques. Associée à du matériel de pointe, comme le serveur HPE ProLiant DL145 Gen11, un GPU NVIDIA L4 et des SSD Solidigm PCIe Gen5, elle offre un environnement de production puissant et portable. Elle met des fonctionnalités multimédias professionnelles assistées par l'IA à la portée des équipes les plus réduites.
Présentation de l'architecture du système
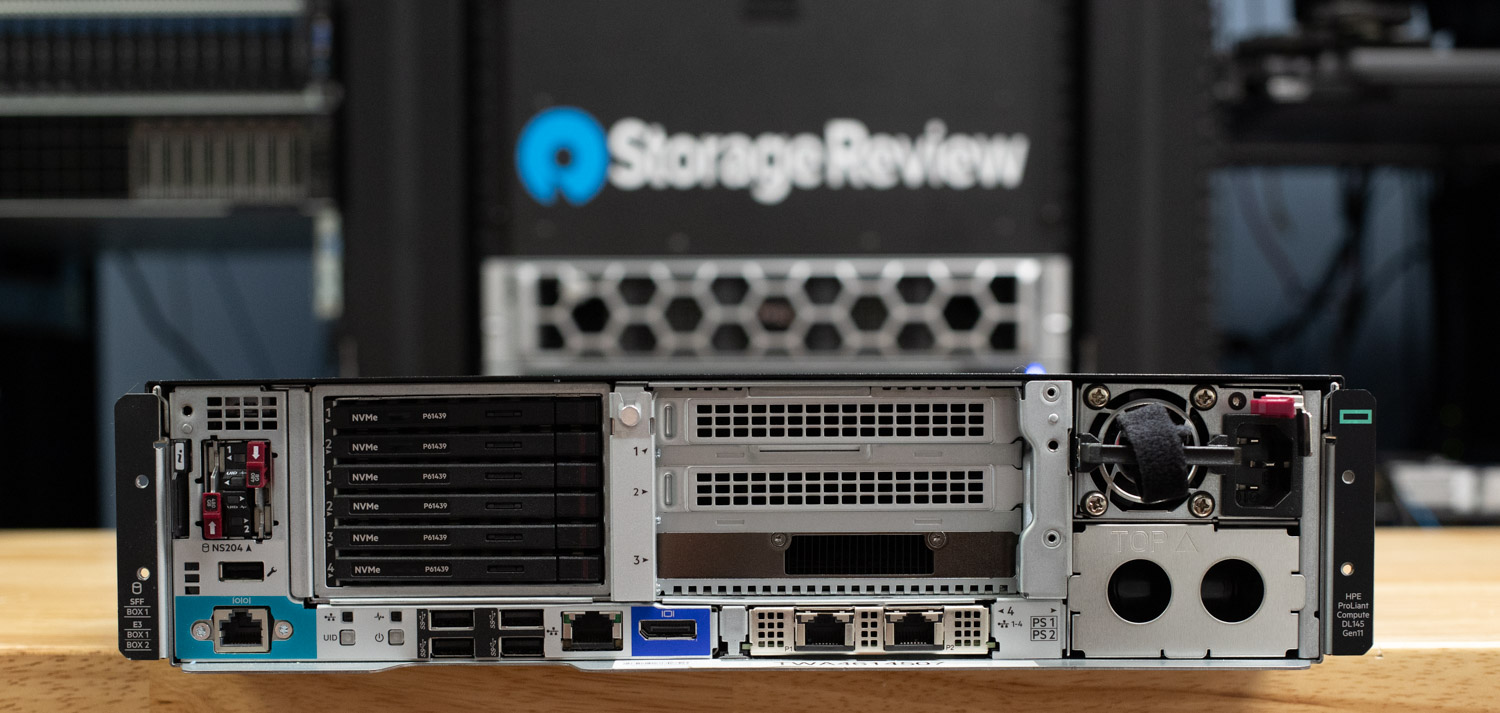
Le serveur edge HPE ProLiant DL145 Gen11 est un candidat idéal pour les déploiements Axle AI sur le terrain et lors d'événements où l'espace, l'alimentation et le refroidissement sont limités. Avec sa conception 2U à faible profondeur (16 cm seulement), ce serveur est spécialement conçu pour la portabilité et l'installation dans des espaces restreints tels que des racks mobiles et des flight cases. Contrairement aux équipements professionnels traditionnels, il supporte une plage de températures de fonctionnement étendue de -5 °C à 55 °C, ce qui le rend adapté aux environnements moins contrôlés. Malgré sa taille compacte, il offre des fonctionnalités professionnelles telles qu'une alimentation redondante et des options de disque de démarrage, ce qui le rend idéal pour les équipes qui ont besoin d'une infrastructure edge robuste sans la surcharge d'un matériel standard.
Côté processeur, le DL145 prend en charge les processeurs AMD EPYC série 8004 (Siena), compatibles avec 8 à 64 cœurs. Notre système de test est équipé d'un EPYC 8434P, offrant 48 cœurs et 96 threads. Avec un TDP de 200 W, il offre un excellent compromis entre efficacité et puissance de calcul, ce qui le rend idéal pour les charges de travail intensives. Ce processeur prend en charge 96 lignes PCIe 5.0 et propose six canaux de mémoire DDR5, permettant des vitesses jusqu'à 4 800 MT/s avec une excellente bande passante mémoire. Alors que la configuration minimale requise pour Axle AI est de 16 cœurs et 32 Go de RAM, notre configuration dépasse largement ces exigences avec 48 cœurs et 256 Go de mémoire DDR5.
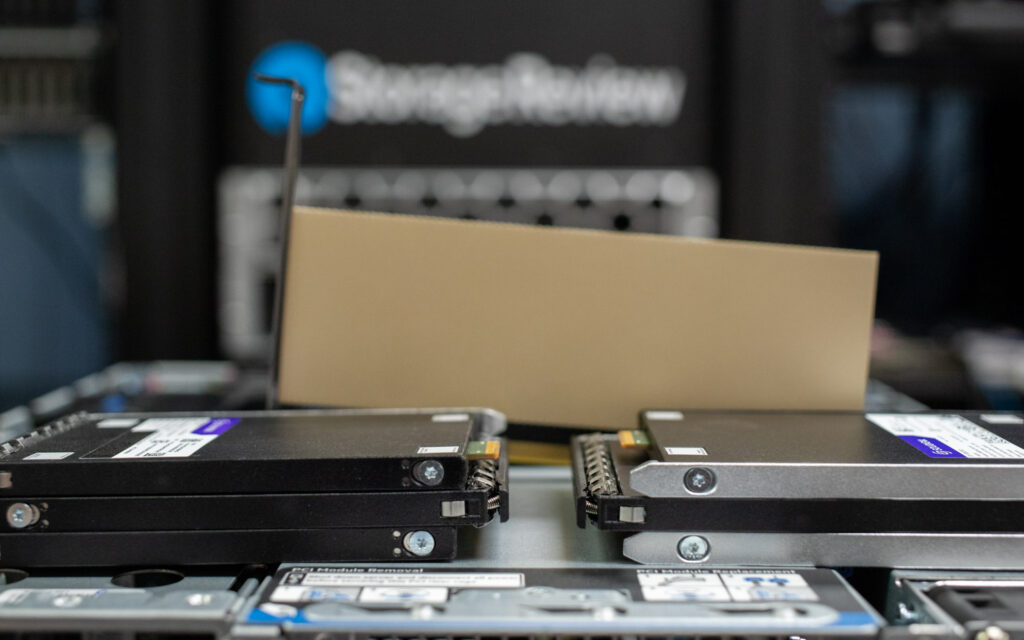
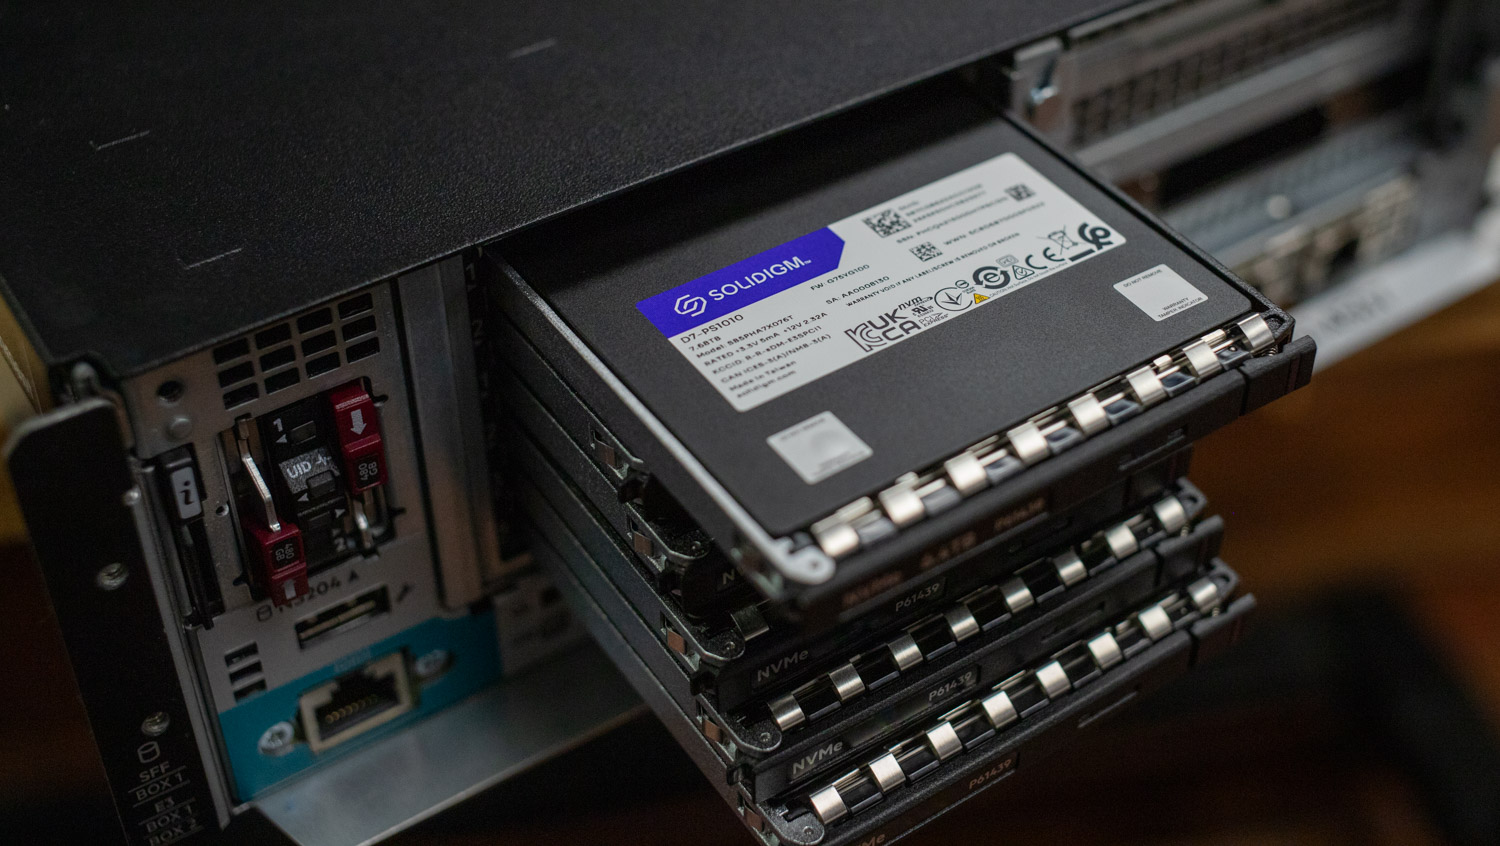
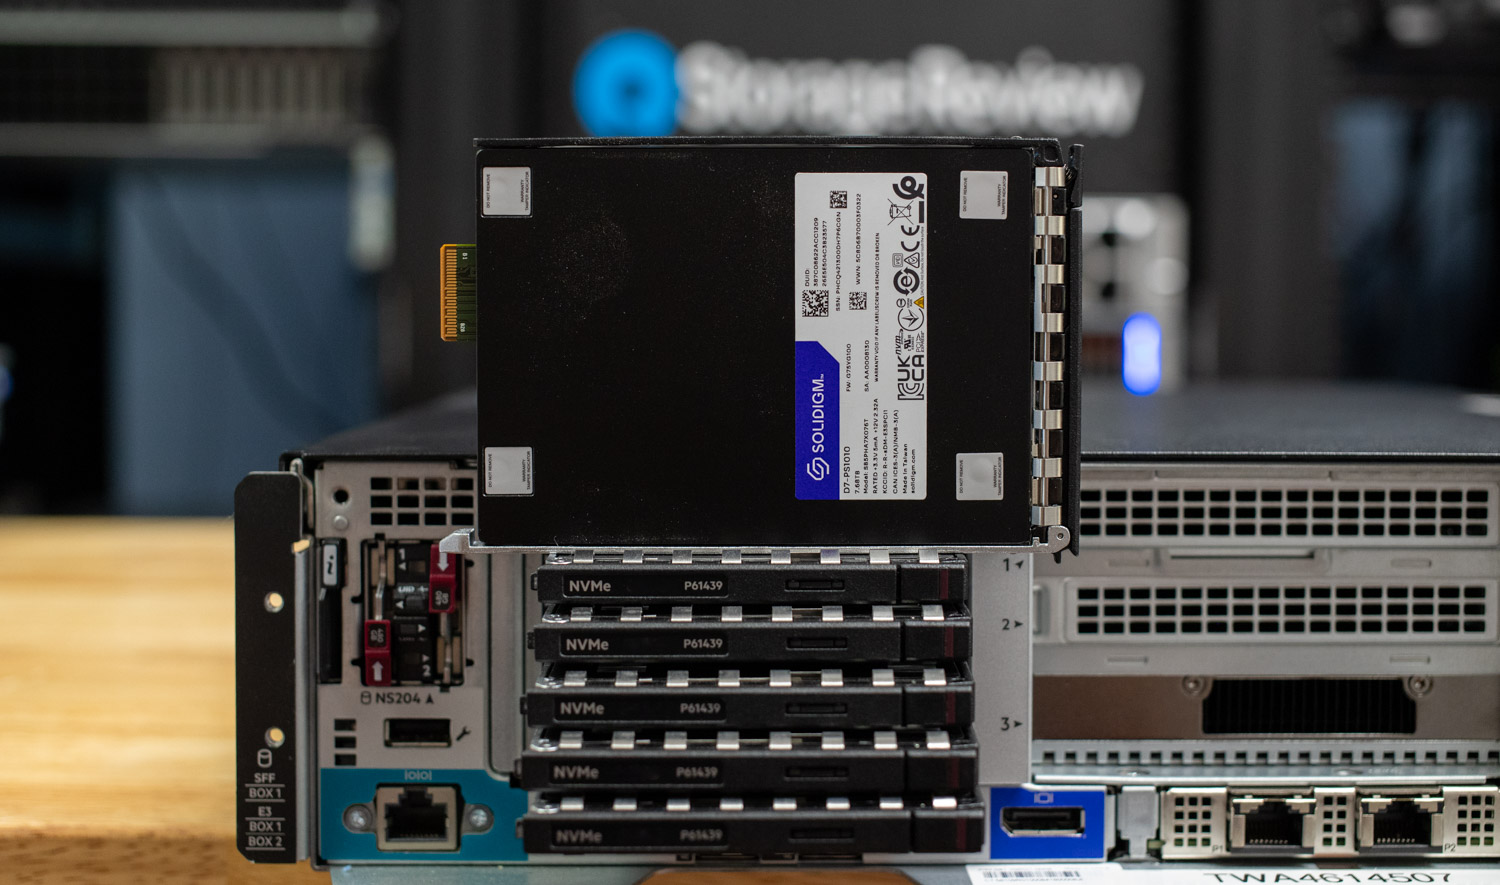
Les performances de stockage sont essentielles pour tout pipeline multimédia, et le DL145 prend en charge jusqu'à six disques NVMe EDSFF E3.S pour répondre à ces exigences. Dans notre configuration, nous avons utilisé six SSD Solidigm D7-PS1010 E3.S, chacun d'une capacité de 7.68 To. Ces disques PCIe 5.0 x4 offrent des vitesses de lecture allant jusqu'à 14,500 10,000 Mo/s et d'écriture jusqu'à 46 50 Mo/s, pour un stockage haut débit de près de 15.36 To. Conçus pour les workflows d'IA et multimédia, ces SSD offrent une efficacité énergétique impressionnante et peuvent offrir un débit jusqu'à 92 % supérieur à celui des disques NVMe classiques dans certaines phases du pipeline. Pour les équipes nécessitant une capacité supplémentaire, cette configuration peut évoluer jusqu'à XNUMX To par disque, offrant ainsi un stockage rapide et dense de XNUMX To dans un format compact.
La carte DL145 prend en charge jusqu'à trois GPU à simple emplacement. Dans notre configuration, nous avons utilisé un seul GPU NVIDIA L4, un accélérateur basse consommation basé sur l'architecture Ada Lovelace. Conçu pour le traitement vidéo, l'inférence IA, le calcul visuel et les charges de travail de virtualisation, le L4 offre des performances robustes tout en consommant seulement 72 watts. Il est doté de 24 Go de VRAM GDDR6 et se connecte via une interface PCIe 4.0 x16 pour l'alimentation et les données. Axle AI recommande un minimum de 16 Go de VRAM, et le L4 dépasse largement cette exigence avec 8 Go supplémentaires, garantissant ainsi une marge suffisante pour les tâches multimédias haute résolution et les opérations basées sur l'IA.
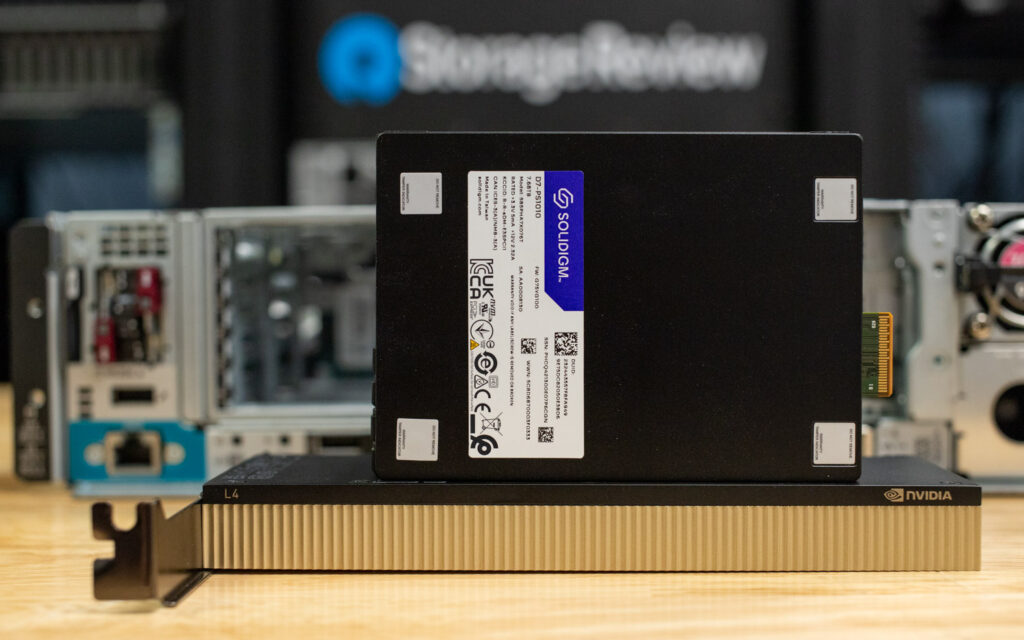
GPU Nvidia L4 à emplacement unique
Pour la couche applicative, nous avons déployé Axle AI MAM et Axle AI Tags à l'aide de l'environnement virtuel Proxmox (8.3.5). Le système est configuré avec deux machines virtuelles dédiées : l'une exécutant Axle AI MAM et l'autre Axle AI Tags. Cette structure assure une séparation claire entre la gestion des médias et le traitement des métadonnées par l'IA, tout en garantissant une communication fluide entre les composants.
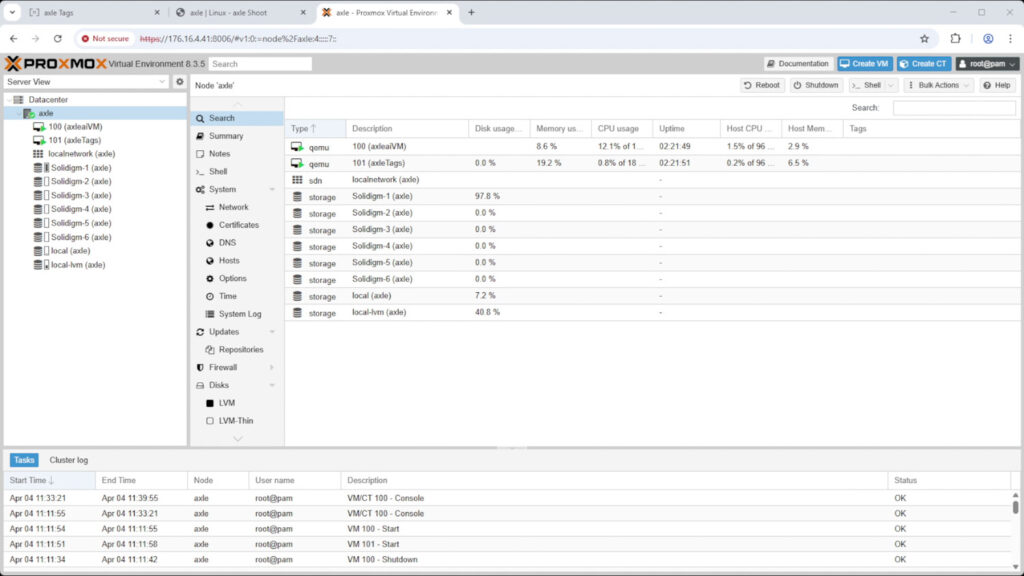
Résumé de l'environnement et du matériel Proxmox
Fonctionnant en parallèle avec MAM, Axle AI Tags offre des fonctionnalités d'IA sur site, notamment la recherche sémantique vectorielle, la reconnaissance d'objets et de logos, et la détection de visages entraînables. Déployé dans un conteneur Docker, il exploite le GPU NVIDIA L4 via un pass-through PCIe pour une inférence efficace et en temps réel. L'interface d'apprentissage et d'administration basée sur un navigateur permet des réglages flexibles, et sa conception modulaire prend en charge les configurations matérielles Intel/NVIDIA ou AMD/NVIDIA. Entièrement intégré à MAM dans notre configuration, Axle AI Tags offre également une compatibilité avec l'API REST pour une utilisation avec d'autres plateformes.
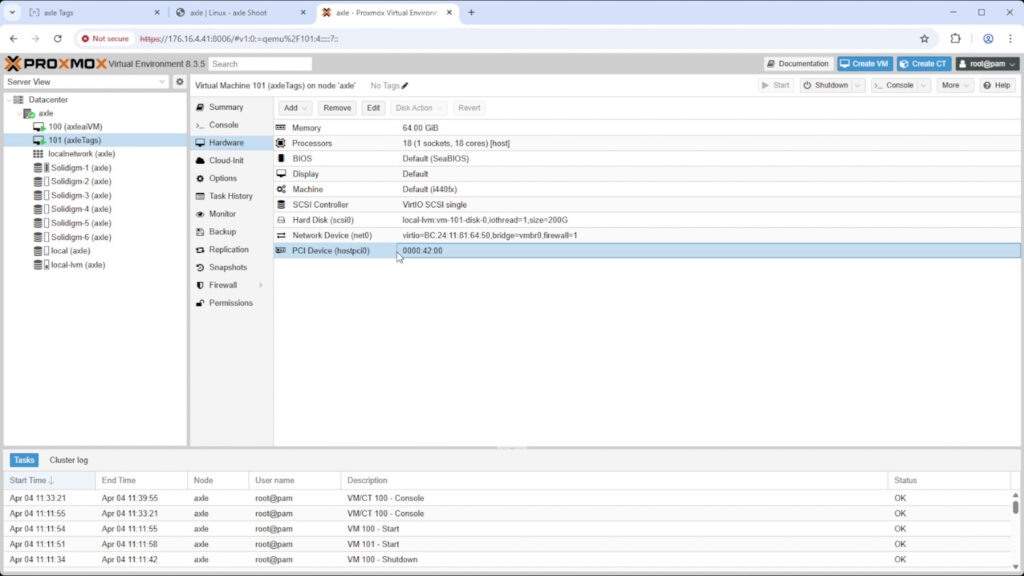
Configuration matérielle de la machine virtuelle Axle AI Tags
Les disques Solidigm PS1010 sont intégrés à la machine virtuelle Axle AI MAM, garantissant un accès rapide et à faible latence aux images. En virtualisant l'ensemble de la pile et en attribuant des ressources de calcul dédiées à chaque composant, cette configuration offre une disponibilité accrue, une meilleure gestion des ressources et une prise en charge multi-utilisateurs bien supérieure à celle d'un seul poste de travail. Elle est donc idéale pour un environnement de production collaboratif à haut volume.
Ensemble, ces composants forment une solution matérielle étroitement intégrée qui permet des flux de travail multimédia rapides, locaux et optimisés par l'IA. Il s'agit d'une plateforme efficace et prête à l'emploi pour les équipes distantes qui ont besoin de performances fiables dans des environnements où l'espace et la puissance sont limités, mais où le traitement par l'IA reste essentiel.
Performances HPE ProLiant DL145 Gen11
Avant de passer à l'analyse comparative, le tableau ci-dessous présente la configuration système du HPE ProLiant DL145 Gen11. Les tests avec Axle AI ont été réalisés sur une installation virtualisée exécutant Proxmox, et le système a été migré vers Ubuntu Server 22.04.5 afin de mesurer les performances de stockage lors de nos tests GDSIO et FIO.
| HPE ProLiant DL145 génération 11 | Présentation du matériel |
|---|---|
| Processeur | Un seul processeur AMD EPYC 8434P |
| RAM | 256 Go de mémoire DDR5 ECC |
| Stockage | 6 SSD Solidigm D7-PS1010 E3s 7.68 To |
| Stockage de démarrage | Port NS204 2x peuplé (480 Go Samsung PM9A3 M.2) |
| GPU | NVIDIA L4 unique |
| Système d'exploitation | Ubuntu Server 22.04.5 |
Performance synthétique de pointe
Le test FIO est un outil d'analyse comparative flexible et puissant permettant de mesurer les performances des périphériques de stockage, notamment les SSD et les disques durs. Il évalue des paramètres tels que la bande passante, les IOPS (opérations d'entrée/sortie par seconde) et la latence sous diverses charges de travail, telles que les opérations de lecture/écriture séquentielles et aléatoires. Ce test est conçu pour capturer les performances maximales et soumettre le système de stockage à de multiples charges de travail, ce qui le rend particulièrement utile pour comparer différents périphériques ou configurations. Dans ce cas, un test sur toute la surface a été réalisé, testant la capacité totale des disques afin d'obtenir une vue complète de leurs performances soutenues.
Lors du test de lecture séquentielle utilisant des blocs de 128 K, le système a fourni une bande passante de 56.4 Go/s et a maintenu 430,000 1.78 IOPS avec une latence moyenne de 45.4 milliseconde. Les performances d'écriture séquentielle à la même taille de bloc ont atteint 346,000 Go/s, produisant 2.22 4 IOPS et une latence moyenne de 46.6 millisecondes. Pour les opérations de lecture aléatoire utilisant des blocs de 11.4 K, le système a atteint 0.269 Go/s avec 4 millions d'IOPS et une faible latence moyenne de 29.1 milliseconde, soulignant le potentiel de haut débit de la baie de stockage NVMe dans des conditions d'accès intensifs. Les opérations d'écriture aléatoire à 7.1 K ont mesuré 0.432 Go/s, atteignant XNUMX millions d'IOPS avec une latence moyenne de XNUMX milliseconde, confirmant une solide capacité d'écriture soutenue, même en cas d'accès fragmenté.
| Résumé du benchmark HPE DL145 Gen 11 FIO | Bande passante – Go/s | IOPS | Latence moyenne |
|---|---|---|---|
| Lecture séquentielle (128 Ko) | 56.4 GB / s | 430K | 1.78 ms |
| Écriture séquentielle (128 Ko) | 45.4 GB / s | 346K | 2.22 ms |
| Lecture aléatoire (4 Ko) | 46.6 GB / s | 11.4M | 0.269 ms |
| Écriture aléatoire (4K) | 29.1 GB / s | 7.1M | 0.432 ms |
Stockage direct du GPU
L'un des tests que nous avons menés sur ce banc d'essai était le test Magnum IO GPU Direct Storage (GDS). GDS est une fonctionnalité développée par NVIDIA qui permet aux GPU de contourner le CPU lors de l'accès aux données stockées sur des disques NVMe ou d'autres périphériques de stockage haute vitesse. Au lieu de faire transiter les données par le CPU et la mémoire système, GDS permet une communication directe entre le GPU et le périphérique de stockage, réduisant ainsi considérablement la latence et améliorant le débit.
Comment fonctionne le stockage direct GPU
Traditionnellement, lorsqu'un GPU traite des données stockées sur un disque NVMe, les données doivent d'abord transiter par le processeur et la mémoire système avant d'atteindre le GPU. Ce processus introduit des goulots d'étranglement, car le processeur devient un intermédiaire, ce qui ajoute de la latence et consomme de précieuses ressources système. Le stockage direct GPU élimine cette inefficacité en permettant au GPU d'accéder directement aux données depuis le périphérique de stockage via le bus PCIe. Ce chemin direct réduit la surcharge associée au déplacement des données, permettant des transferts de données plus rapides et plus efficaces.
Les charges de travail de l’IA, en particulier celles impliquant l’apprentissage profond, sont très gourmandes en données. La formation de grands réseaux neuronaux nécessite le traitement de téraoctets de données, et tout retard dans le transfert de données peut entraîner une sous-utilisation des GPU et des temps de formation plus longs. Le stockage direct GPU relève ce défi en garantissant que les données sont transmises au GPU le plus rapidement possible, en minimisant les temps d’inactivité et en maximisant l’efficacité de calcul.
En outre, GDS est particulièrement utile pour les charges de travail impliquant la diffusion de grands ensembles de données, comme le traitement vidéo, le traitement du langage naturel ou l'inférence en temps réel. En réduisant la dépendance au processeur, GDS accélère le déplacement des données et libère les ressources du processeur pour d'autres tâches, améliorant ainsi encore les performances globales du système.
Lecture séquentielle GDSIO
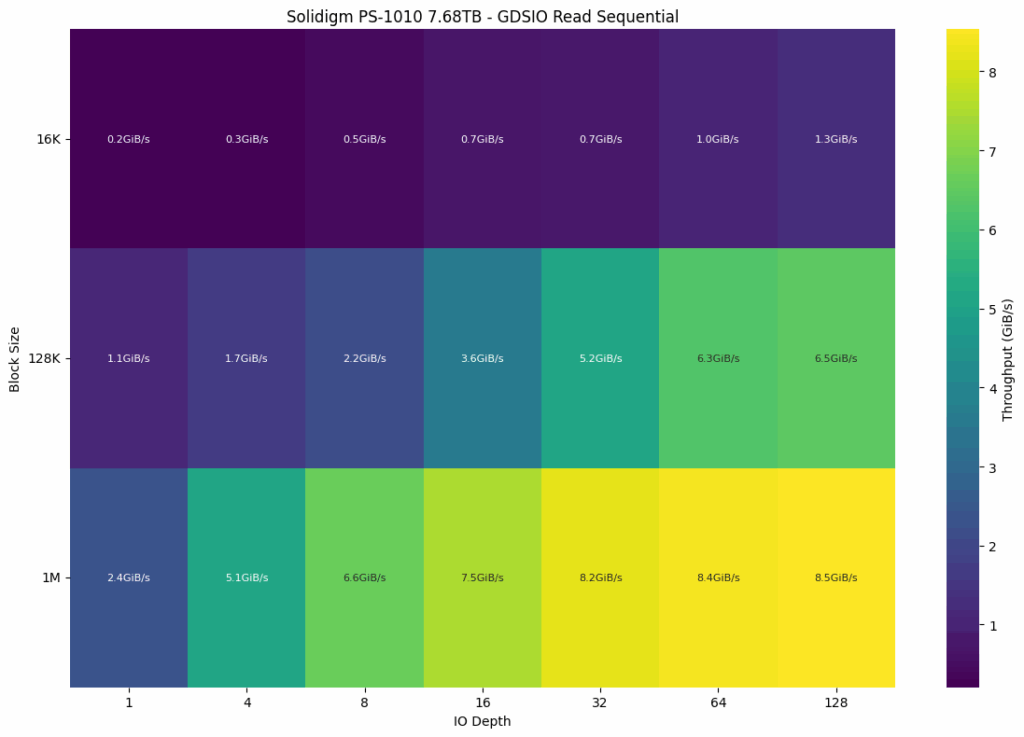
Lors du test de lecture séquentielle GDSIO du disque Solidigm PS1010 de 7.68 To, les performances ont évolué de manière significative avec la taille des blocs et la profondeur des E/S. Avec la plus petite taille de bloc de 16 Ko, le débit a commencé à seulement 0.2 Gio/s avec une profondeur de file d'attente de 1, puis a progressivement augmenté jusqu'à 1.3 Gio/s avec une profondeur de 128 Ko, ce qui montre une évolutivité limitée à cette granularité. Avec 128 Ko de blocs, les performances ont progressé de manière plus spectaculaire, commençant à 1.1 Gio/s et atteignant 6.5 Gio/s avec la profondeur la plus élevée. Les meilleurs résultats ont été obtenus avec une taille de bloc de 1 Mo, où le débit a atteint initialement 2.4 Gio/s et a culminé à 8.5 Gio/s avec une profondeur de file d'attente de 128 Ko, ce qui indique que le profil de performances optimal du disque est atteint avec des lectures séquentielles volumineuses et des files d'attente plus profondes.
Écriture séquentielle GDSIO
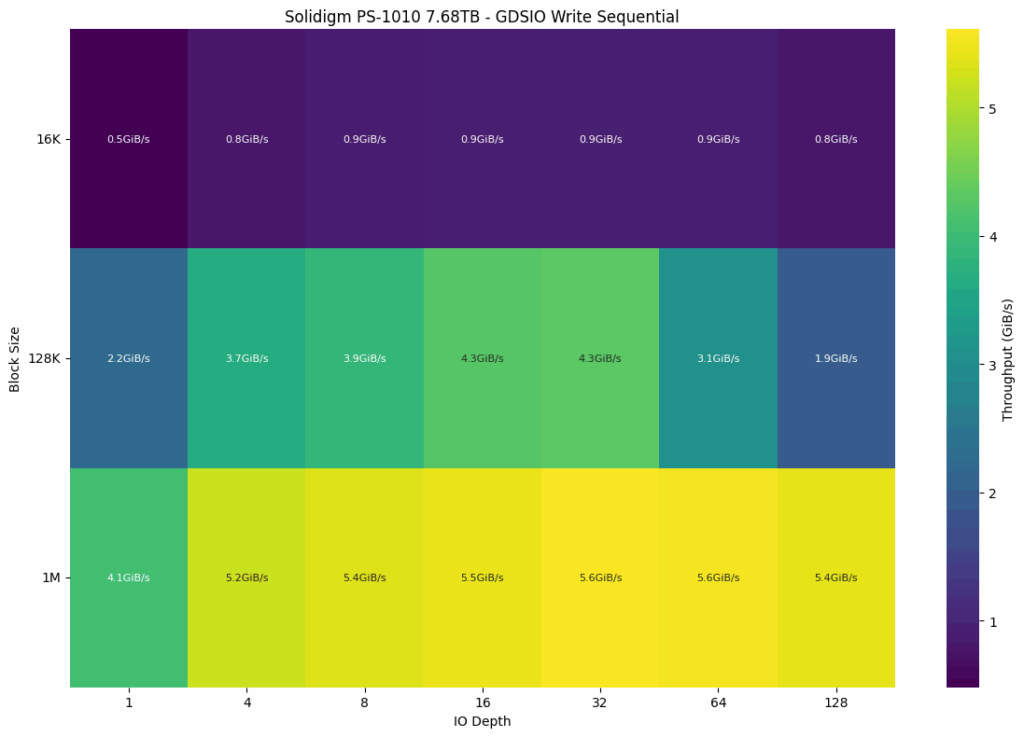
Les performances d'écriture séquentielle du Solidigm PS1010 présentent une évolutivité solide pour des tailles de blocs plus importantes, mais accusent une légère régression pour des profondeurs de file d'attente plus élevées dans les charges de travail de taille moyenne. Avec la plus petite taille de bloc de 16 Ko, les vitesses d'écriture ont débuté à 0.5 Gio/s et ont atteint un pic modeste à 0.9 Gio/s entre les profondeurs de file d'attente de 8 à 64, avant de chuter légèrement à 0.8 Gio/s à la profondeur de 128. Avec 128 Ko de blocs, les performances ont débuté à 2.2 Gio/s, ont atteint un pic de 4.3 Gio/s à la profondeur de 32, puis ont chuté à seulement 1.9 Gio/s à la profondeur de file d'attente la plus élevée, ce qui indique une saturation ou une limitation potentielle des écritures. Les meilleures performances soutenues ont été obtenues avec des tailles de bloc de 1 M, où le débit a évolué nettement de 4.1 Gio/s à la profondeur de 1 à 5.6 Gio/s aux profondeurs de 32 et 64, restant stable jusqu'à la profondeur de 128.
Résumé du GDSIO
Ce tableau fournit une analyse détaillée des mesures de performance GDSIO pour la latence et les IOPS collectées sur le SSD Solidigm D7-PS1010, mesurées pour des tailles de bloc de 16 Ko, 128 Ko et 1 Mo avec une profondeur d'E/S de 128. Avec une profondeur de file d'attente de 128, la latence et les IOPS évoluent de manière prévisible avec la taille du bloc. La lecture d'un bloc de 16 Ko a duré en moyenne 1.549 ms avec 82.3 Ko d'IOPS, tandis que la latence d'écriture était de 2.429 ms avec 52.6 Ko d'IOPS. Avec 128 Ko, la latence de lecture a atteint 2.414 ms (52.9 Ko d'IOPS) et la latence d'écriture 8.050 ms (15.9 Ko d'IOPS). À 1 Mo, la latence de lecture a atteint 14.643 ms avec 8.7 Ko d'IOPS, et la latence d'écriture a atteint 23.030 ms avec 5.6 Ko d'IOPS.
| Graphique GDSIO (tailles moyennes des blocs 16 128, 1 XNUMX et XNUMX M) | HPE DL145 Gen 11 (6 disques SSD Solidigm D7-PS1010 E3s 7.68 To) |
|---|---|
| (Taille de bloc de 16 Ko, profondeur d'E/S de 128) Lecture moyenne | 1.3 Gio/s (1.549 ms) IOPS : 82.3 K |
| (Taille de bloc de 16 Ko, profondeur d'E/S de 128) Écriture moyenne | 0.8 Gio/s (2.429 ms) IOPS : 52.6 K |
| (Taille de bloc de 128 Ko, profondeur d'E/S de 128) Lecture moyenne | 6.5 Gio/s (2.414 ms) IOPS : 52.9 K |
| (Taille de bloc de 128 Ko, profondeur d'E/S de 128) Écriture moyenne | 1.9 Gio/s (8.050 ms) IOPS : 15.9 K |
| (Taille de bloc de 1 M, profondeur d'E/S de 128) Lecture moyenne | 8.5 Gio/s (14.643 ms) IOPS : 8.7 K |
| (Taille de bloc de 1 M, profondeur d'E/S de 128) Écriture moyenne | 5.4 Gio/s (23.030 ms) IOPS : 5.6 K |
Production médiatique à la pointe
Qu'est-ce qu'Axle AI ?
Axle AI est une plateforme de gestion de ressources multimédia (MAM) sur site, optimisée par l'IA, qui simplifie les workflows vidéo des petites et moyennes équipes médias. Elle automatise des tâches clés, telles que l'ingestion, le marquage et la recherche de médias, sans le coût ni la complexité des systèmes MAM traditionnels. Conçue pour être rapide et simple d'utilisation, Axle AI permet aux équipes de gérer et de diffuser du contenu plus efficacement, qu'elles soient au bureau ou en télétravail.
La plateforme prend en charge l'ensemble du processus de production. Elle ingère automatiquement les séquences, crée des proxys, applique des métadonnées basées sur l'IA grâce à des fonctionnalités telles que la reconnaissance d'objets, la détection de visages et la recherche sémantique, et s'intègre aux outils de montage standard du secteur, notamment Adobe Premiere Pro et DaVinci Resolve. Les équipes peuvent ainsi localiser, monter et publier rapidement du contenu, sans goulots d'étranglement ni retards.
Cas d'utilisation réels
Axle AI bénéficie de la confiance d'équipes médias très diverses, notamment des diffuseurs, des documentaristes, des services vidéo d'entreprise, des agences marketing et des producteurs d'événements en direct. Ces équipes travaillent souvent sur plusieurs sites et ont besoin d'un accès fiable à leurs médiathèques sans nécessiter d'infrastructure lourde.
Avec Axle AI, les utilisateurs peuvent collaborer à distance via une interface web offrant un accès instantané aux médias proxy. Les monteurs peuvent commencer à monter les séquences immédiatement dans leurs systèmes de montage non linéaire (NLE) préférés, tandis que les producteurs et les parties prenantes examinent, étiquetent ou approuvent les clips en temps réel (aucun transfert de fichiers volumineux ni compétence technique particulière n'est requis).
Que vous soyez une équipe de cinq ou de cinquante personnes, Axle AI permet des flux de travail plus rapides et plus efficaces. Son interface simple, son déploiement rapide et sa compatibilité avec les systèmes de stockage existants en font une solution intelligente pour la production multimédia distribuée à haut volume.
La forte demande pour les médias sociaux instantanés a considérablement accéléré le rythme de production médiatique. L'idée est très répandue : « Si vous n'êtes pas le premier, vous êtes le dernier », surtout en ce qui concerne les événements en direct et la création de contenu qui les entoure. Les entreprises de médias avaient besoin d'un moyen efficace d'organiser et de visionner rapidement de grandes quantités de séquences. Des outils comme Axle AI, avec leur capacité à s'adapter aux petites opérations, rendent ce flux de travail pratique sur le terrain. Associé à un flux de travail adapté, comme des caméras capables d'enregistrer simultanément des proxys et des images brutes, les possibilités d'efficacité augmentent.
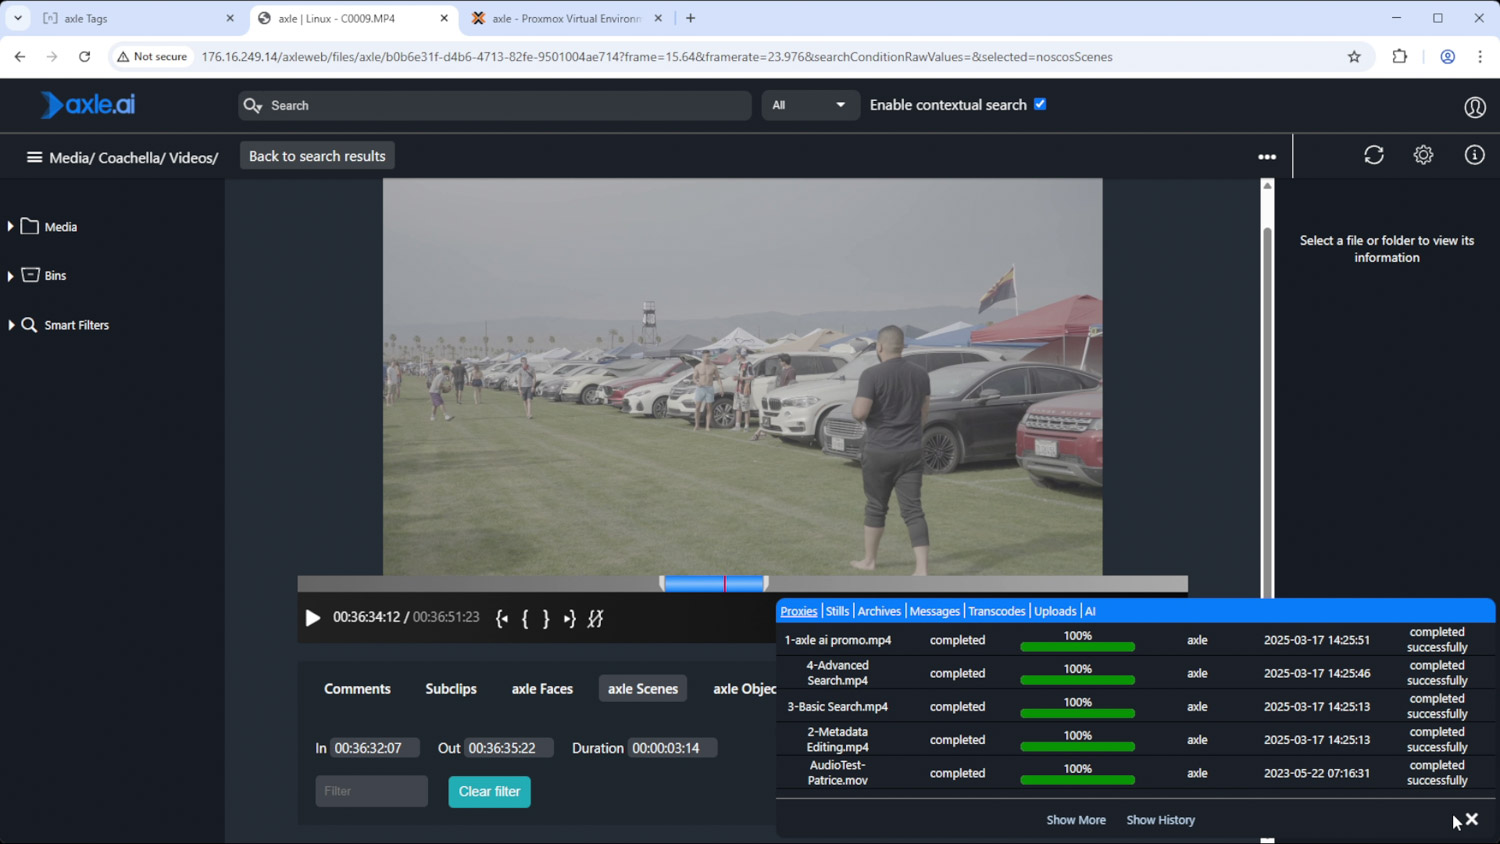
L'enregistrement de médias proxy haute et basse résolution lors de la capture et le traitement immédiat de fichiers proxy plus petits dans Axle AI Tags permettent de rechercher toutes les séquences presque instantanément. Les monteurs peuvent se mettre au travail immédiatement grâce à l'intégration d'Axle AI avec la plupart des principaux logiciels de montage non linéaire comme Adobe Premiere Pro, DaVinci Resolve et Avid Media Composer. Cela allège également considérablement la charge de travail de l'équipe de production, lui permettant de se concentrer sur d'autres tâches ou d'éviter l'épuisement professionnel.
Traditionnellement, la journalisation est l'un des aspects les plus laborieux et souvent négligés du processus de capture multimédia. Axle AI enregistre automatiquement les médias avec des descriptions de scène générées par l'IA, au lieu des simples champs de métadonnées traditionnels. Cela permet au monteur de lire le contenu d'un clip avant de le parcourir. Il propose également des outils de recherche sémantique permettant aux monteurs et aux producteurs de trouver rapidement du contenu pertinent grâce à des concepts et des thèmes, plutôt qu'à des balises spécifiques.
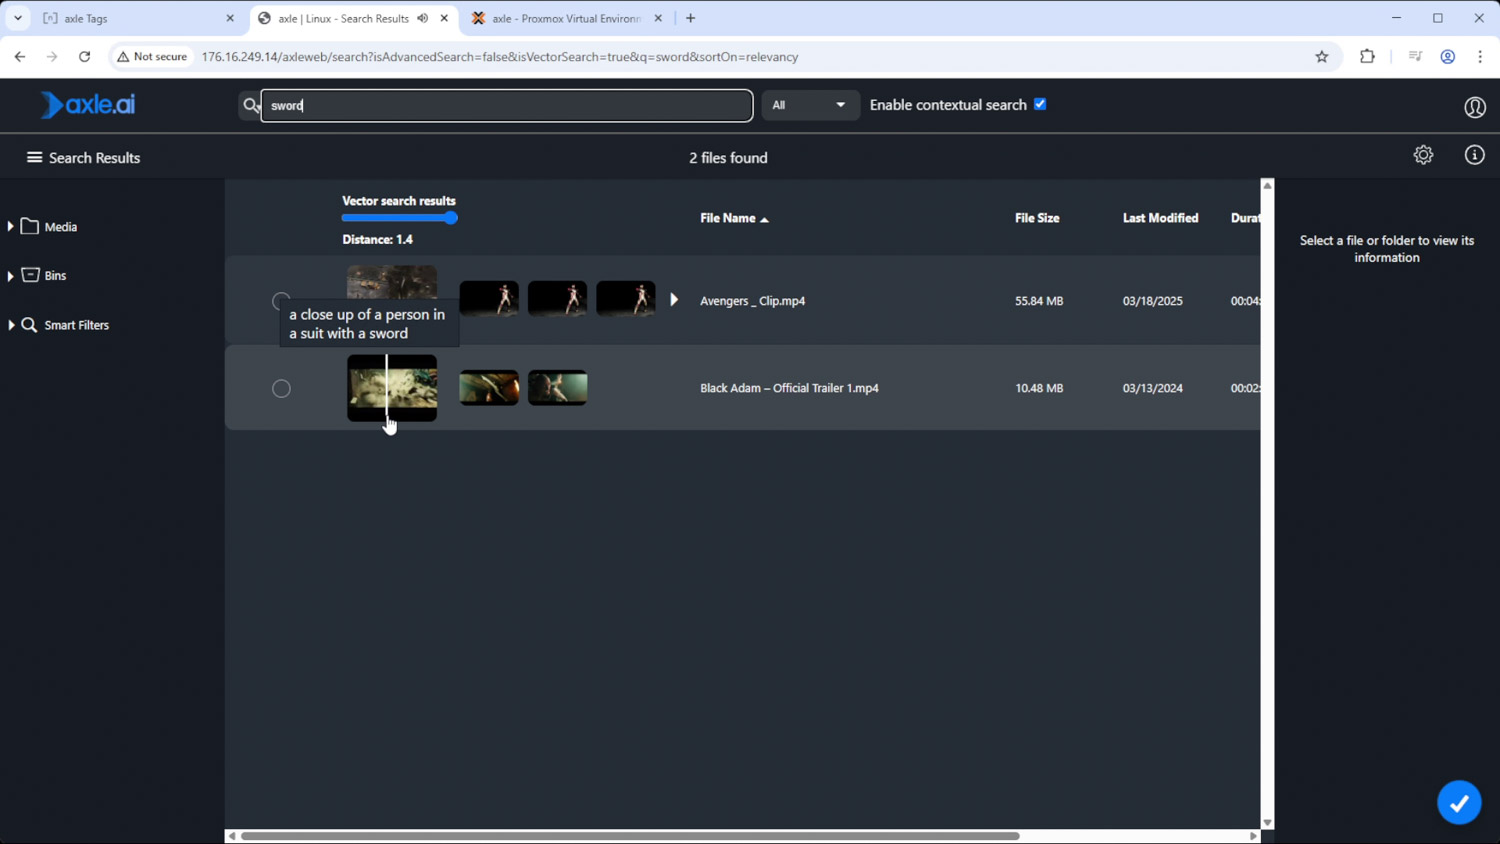
L'évolutivité est également essentielle, car tous les projets ne nécessitent pas une production média rapide et sur site. Axle AI peut être installé sur un système stationnaire plus puissant, avec accès au backlog d'une entreprise média via un partage réseau. Cela permet aux monteurs et aux producteurs de trouver plus rapidement des médias pertinents, voire de découvrir des médias qu'ils n'auraient peut-être pas envisagés auparavant et qui ont été « perdus » dans les archives. Les créateurs de contenu et les diffuseurs peuvent tirer un bénéfice considérable de ce type d'index de backlog, en valorisant davantage les médias qui, autrement, resteraient inactifs sur un serveur. Bien qu'il ne soit pas infaillible, il peut donner aux entreprises média une longueur d'avance sur certains des aspects les plus chronophages du processus de création média.
Le HPE ProLiant DL145 Gen11 sert de base matérielle à ce déploiement d'IA en périphérie, offrant un équilibre impressionnant entre densité de calcul, débit de stockage et accélération GPU dans un format compact. Équipé d'un processeur AMD EPYC 48P 8434 cœurs de la série 8004 à faible consommation d'énergie, ce système est optimisé pour les charges de travail multithread tout en conservant une enveloppe basse consommation. La configuration comprend 256 Go de RAM et un seul GPU NVIDIA L4, un accélérateur hautement performant, parfaitement adapté à l'inférence IA en périphérie. Le stockage est assuré par six SSD Solidigm D7-PS1010 E3.S, d'une capacité de 7.68 To chacun, offrant un stockage flash hautes performances pour les ressources multimédias et les charges de travail gourmandes en métadonnées. Avec la prise en charge de jusqu'à trois GPU simple largeur et de six disques E3.S au total, le DL145 Gen11 est parfaitement positionné pour s'adapter aux cas d'utilisation exigeants de la vidéo et de l'IA. Cette configuration souligne l’importance d’assembler soigneusement les composants matériels modernes, notamment le processeur, le GPU et les SSD, pour permettre des performances exceptionnelles pour les flux de travail d’IA axés sur la périphérie, tels que ceux alimentés par Axle AI.
Conclusion
Axle AI transforme la façon dont le contenu vidéo est produit, en particulier pour les équipes travaillant en temps réel avec des ressources limitées. En combinant une gestion intelligente des ressources multimédias à de puissants outils d'inférence, Axle AI offre un niveau d'automatisation et de réactivité inégalé par les systèmes MAM traditionnels. Associée au serveur edge HPE ProLiant DL145 Gen11, au GPU NVIDIA L4 et aux SSD Solidigm Gen5, la plateforme que nous avons conçue offre un environnement compact et performant, optimisé pour les workflows multimédias modernes. Qu'elle soit utilisée sur le terrain ou dans le cadre d'un pipeline de montage hybride, cette configuration offre un moyen évolutif et efficace d'ingérer, d'étiqueter, de rechercher et de diffuser du contenu vidéo plus rapidement que jamais, sans compromettre la qualité ni le contrôle. Pour les équipes chargées de conserver une longueur d'avance dans un environnement de contenu en constante évolution, la combinaison d'une infrastructure edge et de workflows assistés par l'IA offre un avantage concurrentiel considérable.



 Amazon