

Avec l’essor de la programmation assistée par l’IA, il est temps de donner à vos enfants une plateforme informatique et graphique plus puissante. Certes, il y a des avantages, comme jouer aux derniers jeux, mais un avantage émergent est la possibilité de déployer des outils d’IA avancés et des LLM locaux localement sur le système. Cela contraste fortement avec les plateformes d’entrée de gamme sur lesquelles beaucoup commencent généralement, qui se limitent à la navigation Web ou aux logiciels de productivité uniquement. Dans cet article, nous explorons comment un PC de jeu, doté d’un GPU haut de gamme et d’un stockage rapide, peut servir à la fois de configuration de jeu d’élite et de plateforme efficace pour apprendre à coder avec l’IA.
L'idée d'un PC de jeu transformé en station de travail pour l'IA n'est pas nouvelle ; nous avons abordé ce sujet l'année dernière dans un article comparant le Dell Alienware R16 et le Dell Precision 5860. Si cet article se concentrait sur les différences de performances entre les GPU et les pilotes grand public et professionnels pour diverses charges de travail, celui-ci s'intéressera à la valeur ajoutée qu'un PC de jeu peut apporter à une personne apprenant l'IA. Les outils exploitant l'IA sont également en plein essor, avec de nombreuses annonces centrées sur les nouveaux GPU NVIDIA série 50.
Si vous avez un enfant dans une école primaire ou secondaire, le système fourni sera généralement un Chromebook de base. Ces plates-formes présentent des avantages en termes de coût, de facilité d'entretien et d'accès à la technologie, mais elles ne fonctionnent pas très bien pour les cas d'utilisation avancés. C'est là qu'entre en jeu le PC de jeu domestique, qui peut offrir d'innombrables heures de plaisir de jeu, mais qui est équipé de certains des matériels les plus rentables pour le travail de développement de l'IA.
Tout a commencé lorsque mon fils de 11 ans m’a demandé s’il pouvait utiliser l’IA pour créer un jeu vidéo. Avec un peu d’aide, je lui ai présenté Abacus.AI et je lui ai montré comment créer une invite de texte pour écrire du code Python, installer Python sur Windows et exécuter les jeux qu’il concevait. Tout cela s’est passé en l’espace de 15 minutes. Il n’avait aucune expérience en programmation et je pense que c’était la première fois que j’installais un environnement Python sur Windows. C’était assez remarquable à voir de mes propres yeux.
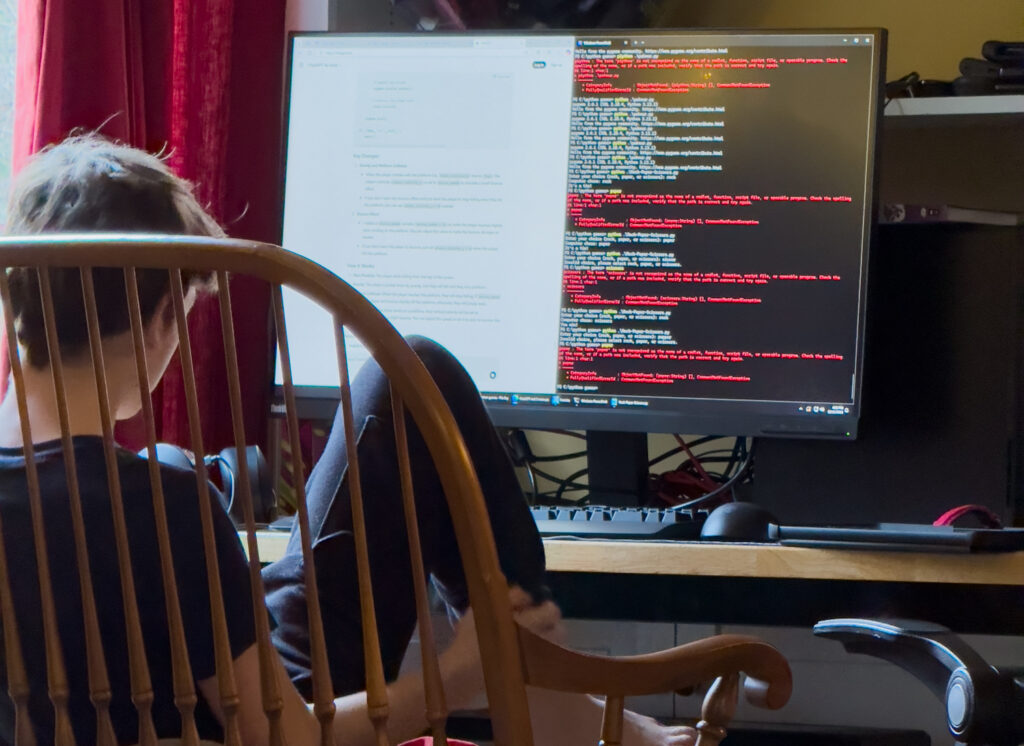
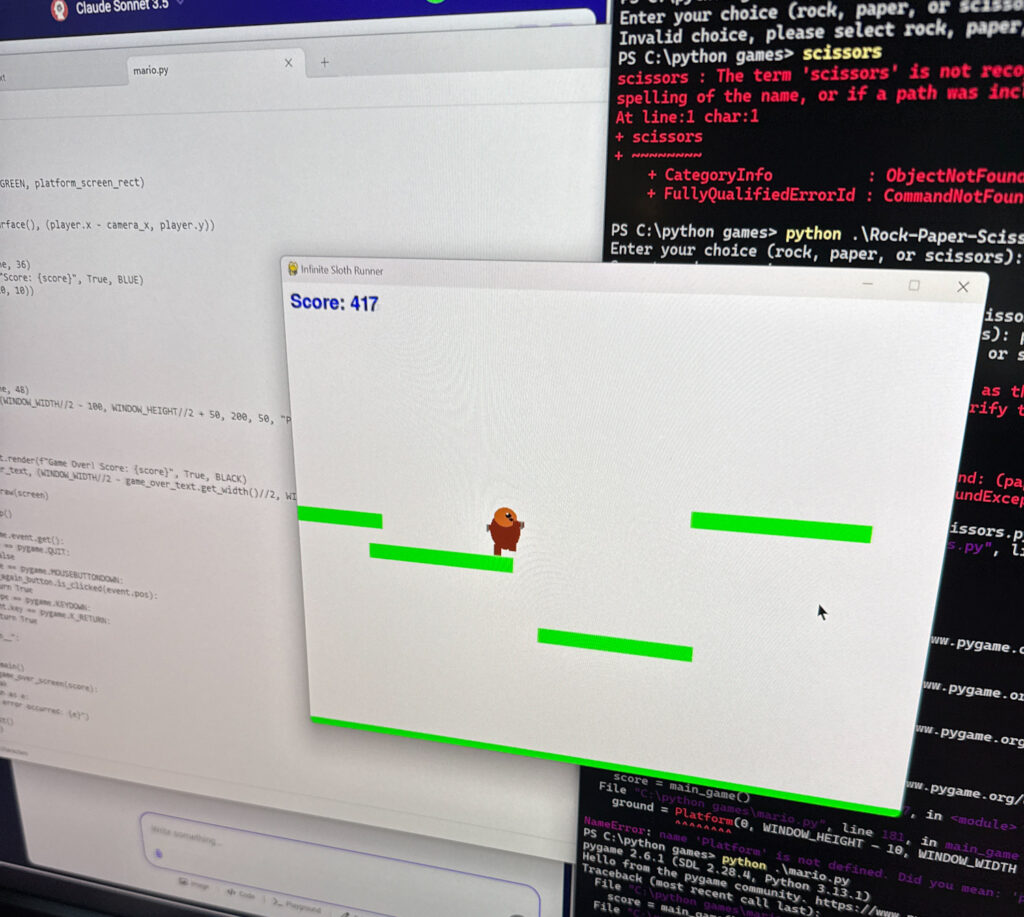
Il avait une idée de jeu différente à essayer. Les premiers étaient des jeux à invite de texte, comme pierre-papier-ciseaux, mais ils ont évolué vers un jeu de plateforme avec une interface graphique. La première version était un petit bloc rouge qui pouvait rebondir au début du jeu et avait besoin d'aide physique. Il a rapidement évolué vers un paresseux qui sautait d'une plateforme à l'autre.
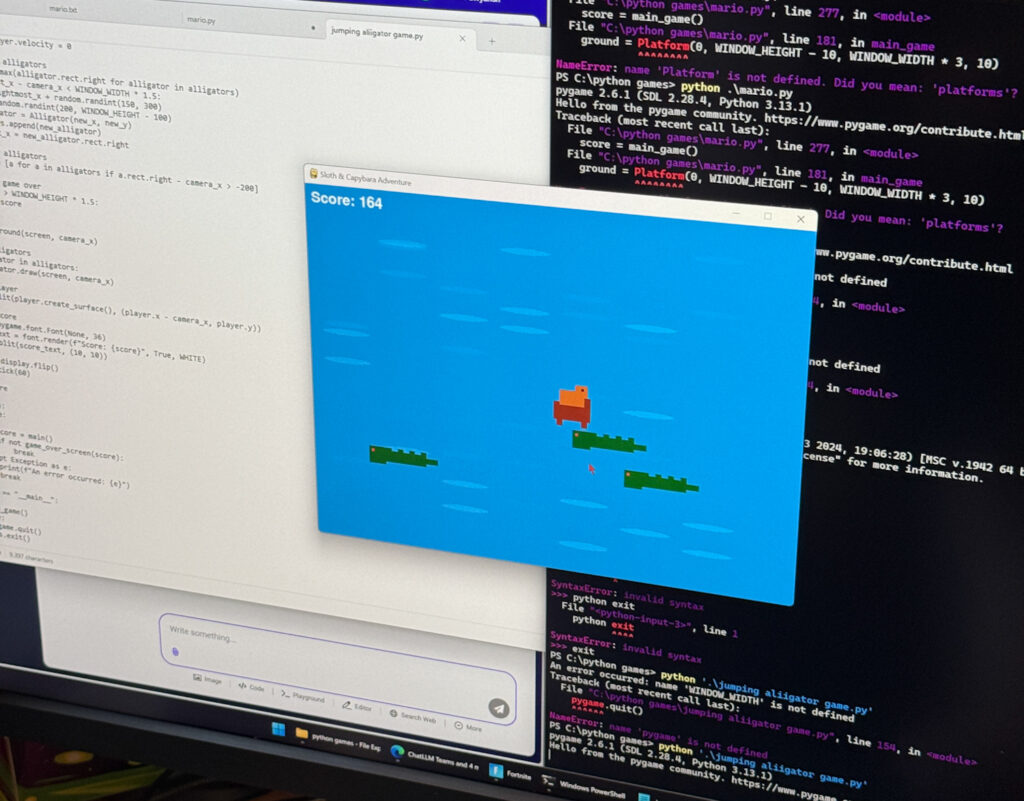
La version finale de ce jeu s'est transformée en un jeu d'aventure de paresseux et de capybara dans lequel les personnages sautent au-dessus d'une eau remplie d'alligators. C'était une expérience surréaliste à vivre, mais elle montre que les enfants peuvent faire des choses étonnantes avec les bons outils devant eux.
Dans cet article, nous allons explorer quelques domaines de l'IA qui peuvent facilement être explorés dans un environnement domestique pour les publics jeunes et plus âgés. Les offres d'IA basées sur le cloud telles qu'Abacus AI, OpenAI et d'autres sont faciles à démarrer et ne nécessitent aucun matériel spécialisé. Ces outils d'IA offrent une large gamme de textes, d'images, de vidéos et d'innombrables autres modèles.
Solutions d'IA basées sur le cloud
Les solutions d'IA basées sur le cloud ont révolutionné notre façon d'interagir avec l'intelligence artificielle et d'apprendre d'elle. Ces plateformes offrent un accès à des modèles de pointe sans nécessiter d'investissement dans du matériel coûteux ; on peut citer comme exemples populaires ChatGPT et Claude d'Anthropic. Cependant, Abacus.ai se distingue par sa polyvalence et son excellent rapport qualité-prix.
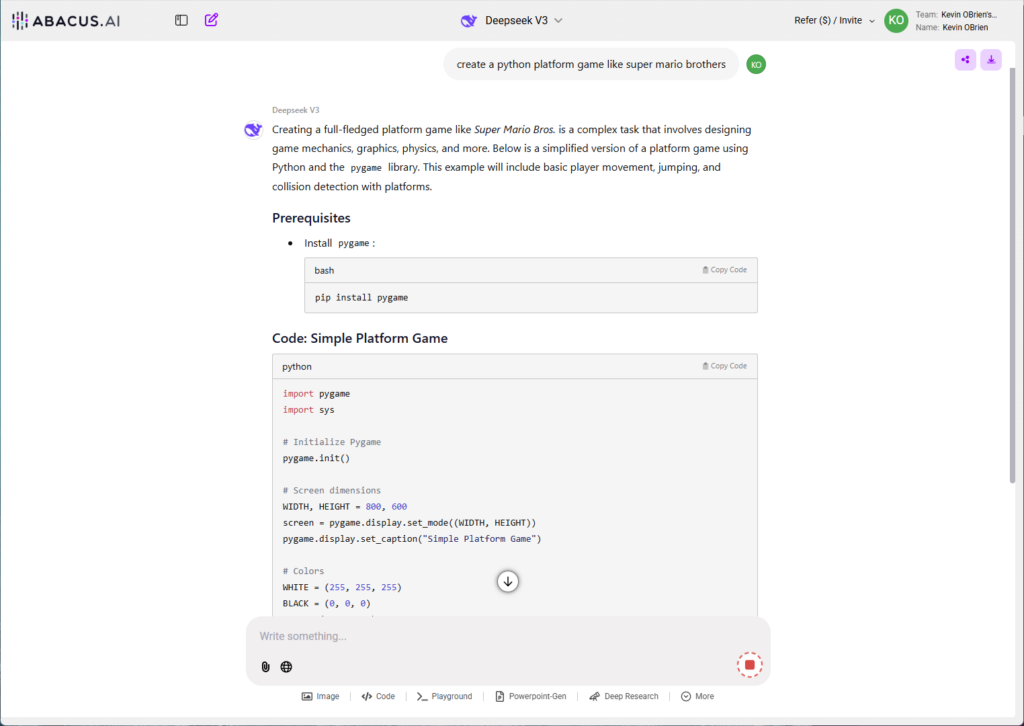
Par exemple, CodeLLM permet aux utilisateurs de coder directement dans un IDE en ligne tout en interagissant avec un chatbot pour une assistance en temps réel. Cette fonctionnalité est parfaite pour les débutants qui apprennent à coder ou les développeurs expérimentés qui cherchent à prototyper rapidement. La fonctionnalité Code Playground va plus loin en permettant aux utilisateurs d'exécuter leur code directement dans le navigateur, éliminant ainsi le besoin de configuration locale. Cela est particulièrement utile pour créer des animations interactives.
Abacus comprend également des fonctionnalités telles que Deep Research, qui intègre l'IA dans les flux de travail de recherche, et un ingénieur IA, qui peut créer automatiquement des robots pour des tâches spécifiques. Ces fonctionnalités facilitent la prise en main de l'IA, que vous exploriez le codage, la génération d'images ou la création d'applications interactives. Même un ordinateur portable ou un Chromebook de base peut devenir un puissant outil d'apprentissage pour les parents ou les enseignants lorsqu'il est associé à une solution basée sur le cloud comme Abacus.AI.
IA locale
Une question naturelle se pose : si les solutions basées sur le cloud sont si bon marché, accessibles et faciles à utiliser, pourquoi s’embêter avec l’IA locale ? La réponse réside dans les avantages uniques qu’offre l’IA locale, qui peuvent en faire un choix convaincant pour certains utilisateurs, en particulier ceux qui disposent de PC de jeu haut de gamme ou qui souhaitent davantage de contrôle sur leurs flux de travail d’IA.
La réponse réside dans la confidentialité, le contrôle et l’accessibilité. L’exécution de modèles d’IA en local garantit que vos données restent sur votre machine, offrant une confidentialité inégalée, et est idéale pour les projets sensibles ou l’utilisation personnelle. Elle offre également un accès hors ligne, ce qui la rend fiable dans les zones à faible connectivité ou en cas de panne de serveur. Pour les gros utilisateurs, l’IA locale peut être plus rentable à long terme, car il n’y a pas de frais récurrents d’utilisation une fois le matériel installé. L’IA locale offre également liberté et flexibilité. Vous pouvez personnaliser et affiner les modèles, expérimenter des options open source et même entraîner vos modèles. De plus, une approche pratique aidera à développer de précieuses compétences techniques.
Configuration matérielle requise
L'exécution d'une IA locale posera quelques problèmes matériels, c'est pourquoi il est logique de réutiliser un système de jeu pour cela. Si certaines suites d'IA locales peuvent exploiter un processeur, dont nous parlerons ci-dessous, presque toutes préfèrent un GPU, en particulier NVIDIA. Actuellement, les GPU NVIDIA sont les plus populaires, la VRAM étant un facteur de blocage. En prenant comme exemple la gamme NVIDIA GeForce série 40, nous décomposons la quantité de VRAM dont dispose chaque carte :
- NVIDIA GeForce RTX 4050 (8 Go de mémoire vidéo)
- NVIDIA GeForce RTX 4060 (12 Go de mémoire vidéo)
- NVIDIA GeForce RTX 4070 (16 Go de mémoire vidéo)
- NVIDIA GeForce RTX 4080 (20 Go de mémoire vidéo)
- NVIDIA GeForce RTX 4090 (24 Go de mémoire vidéo)
En règle générale, à mesure que vous augmentez la taille ou la précision du modèle, les besoins en VRAM augmentent. Voici une répartition des modèles DeepSeek R1 allant de 1.5 à 70 B et des niveaux de précision FP4 à FP8. Vous vous rendrez vite compte que la plupart des GPU grand public seront limités à des tailles de modèles plus petites. L'empreinte VRAM fluctuera également en fonction de ce que vous faites avec le modèle, vous avez donc besoin d'une certaine marge de manœuvre.
| Taille du modèle DeepSeek R1 | Inférence VRAM (FP8) | Inférence VRAM (FP4) |
|---|---|---|
| 1.5B | ~ 1.5 Go | ~ 0.75 Go |
| 7B | ~ 7 Go | ~ 3.5 Go |
| 8B | ~ 8 Go | ~ 4 Go |
| 14B | ~ 14 Go | ~ 7 Go |
| 32B | ~ 32 Go | ~ 16 Go |
| 70B | ~ 70 Go | ~ 35 Go |
Exécution de DeepSeek R1 ou Llama 3.1 localement avec Ollama
Ollama est l'une des méthodes les plus simples pour déployer un modèle de langage local. Son interface conviviale la rend accessible même aux utilisateurs peu techniques. Elle simplifie le téléchargement, la gestion et l'utilisation des modèles de langage. Sous Windows, l'installation d'Ollama est simple : rendez-vous sur le site web d'Ollama , cliquez sur « Télécharger » (choisissez votre système d'exploitation), puis exécutez le fichier d'installation.
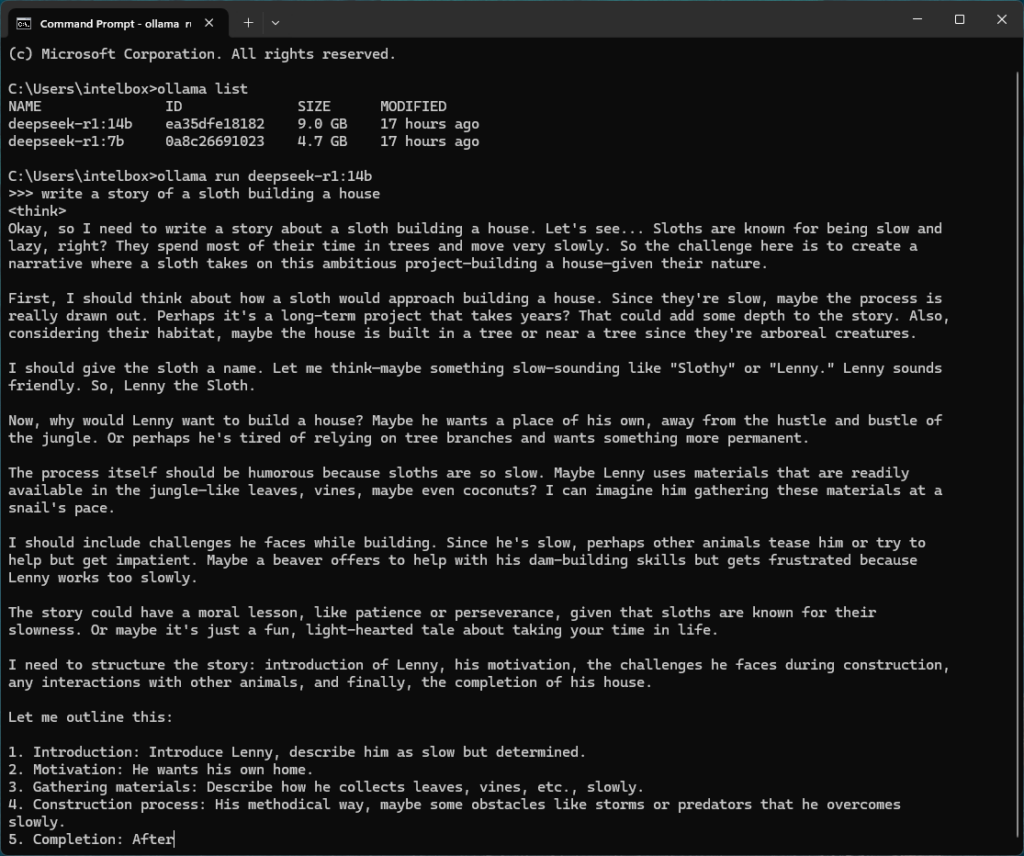
Une fois installée, l'interface de ligne de commande (CLI) d'Ollama permet aux utilisateurs d'extraire et d'exécuter facilement des modèles avec des commandes simples, telles que ollama pull et ollama court . Vous pouvez y accéder en cliquant sur le bouton Démarrer de Windows, en tapant « cmd » et en chargeant votre invite de commande. Vous trouverez ci-dessous un exemple montrant des modèles déjà téléchargés sur le système, démarrant DeepSeek R1 14B et écrivant une histoire sur un paresseux construisant une maison.
Au-delà de la CLI, Ollama propose également Ollama Hub, une interface Web qui offre une expérience utilisateur similaire aux solutions d'IA cloud, la rendant accessible même à ceux qui préfèrent une interface graphique.
Le support communautaire étendu d'Ollama et son cycle de développement rapide le rendent particulièrement attrayant. Il présente également l'avantage de ne prendre que quelques secondes pour l'installer et de permettre à quelqu'un de télécharger ou d'exécuter des modèles est tout aussi rapide. Le délai le plus long pour la plupart des utilisateurs sera lié à la vitesse de connexion Internet, car bon nombre de ces modèles font plusieurs Go.
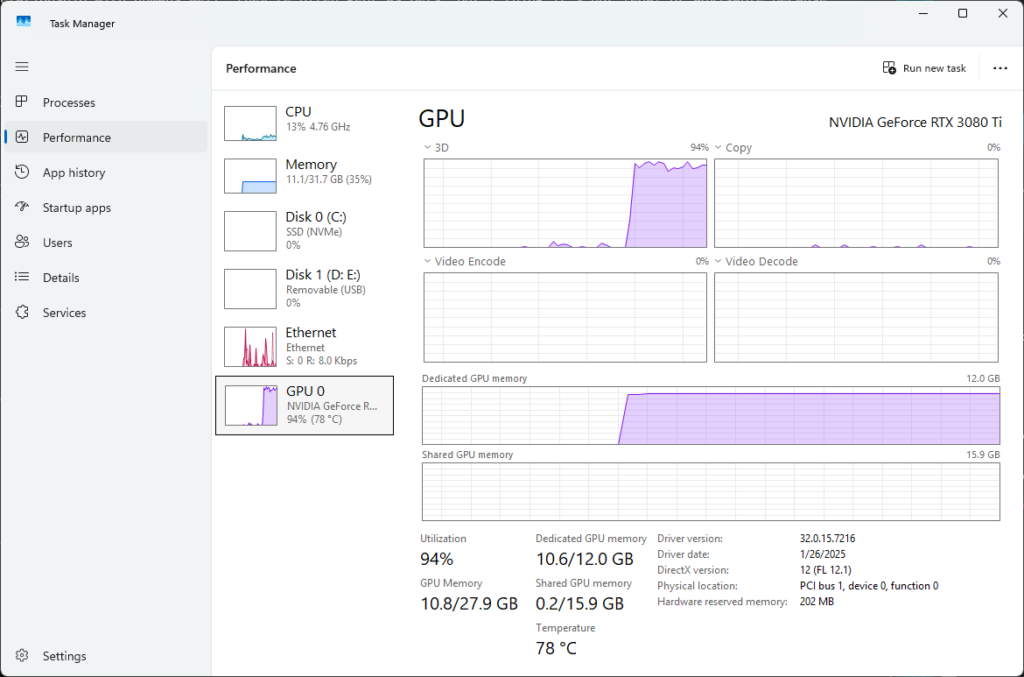
Il est important de noter que si vous avez l'intention d'exécuter un LLM local, chaque modèle aura des exigences système différentes, avec un GPU fortement préféré pour exécuter les choses efficacement. Ollama exécute le modèle DeepSeek R1 14B dans la ressource système ci-dessus, qui utilise un peu moins de 11 Go de VRAM. Pendant que le modèle est chargé, le GPU reste inactif, mais l'utilisation augmentera dès que vous commencerez à interagir avec lui.
Exécution de LLM sur du matériel bas de gamme : modèles quantifiés
Les modèles quantifiés offrent une solution pratique aux utilisateurs travaillant avec des GPU à faible VRAM. Il s'agit essentiellement de versions compressées de LLM qui réduisent les besoins en mémoire, leur permettant de fonctionner sur des GPU moins puissants. Bien que la quantification se fasse au détriment de certaines performances et de la précision, elle rend l'exécution de modèles avancés plus accessible à une gamme plus large de matériel.
Il est également possible d'exécuter des LLM sur des processeurs, bien que cela implique un compromis supplémentaire en termes de performances. L'exécution basée sur le processeur est nettement plus lente que le traitement basé sur le GPU, mais elle peut toujours être une option viable pour les modèles plus petits ou les utilisateurs sans accès à un GPU dédié.
LAMA.CPP
L'un des outils les plus populaires pour exécuter des modèles de langage sur processeur est llama.cpp , une application native C++ conçue pour l'inférence efficace de grands modèles de langage. Malgré son nom, llama.cpp ne se limite pas aux modèles LLaMA. Sa conception légère et son optimisation pour l'utilisation du processeur en font un excellent choix pour les utilisateurs souhaitant expérimenter l'IA locale sur du matériel modeste. En prenant en charge les modèles quantifiés, llama.cpp réduit encore les besoins en ressources, permettant même à du matériel grand public d'exécuter efficacement des modèles de langage avancés.
Génération d'images de diffusion stable avec ComfyUI
Pour la génération d'images locales, ComfyUI est une solution simple pour débuter. Nous avons suivi le guide de Stable Diffusion Art pour lancer l'instance. Les étapes consistent à télécharger l'instance ComfyUI dans une archive 7z portable, à extraire le dossier et à télécharger un point de contrôle de modèle existant.
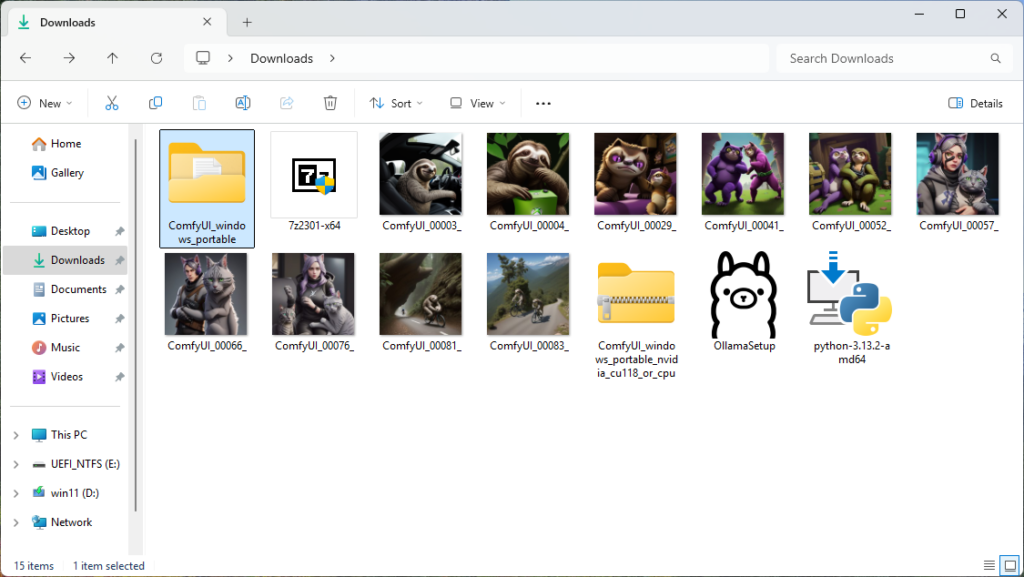
L'exécution de ComfyUI est un peu différente de celle d'Ollama LLM. Ouvrez le dossier contenant l'instance ComfyUI et le point de contrôle enregistré, puis double-cliquez sur le fichier run_cpu si vous avez un système avec des graphiques intégrés ou bas de gamme ou sur run_nvidia_gpu si vous avez une solide carte graphique NVIDIA dédiée.
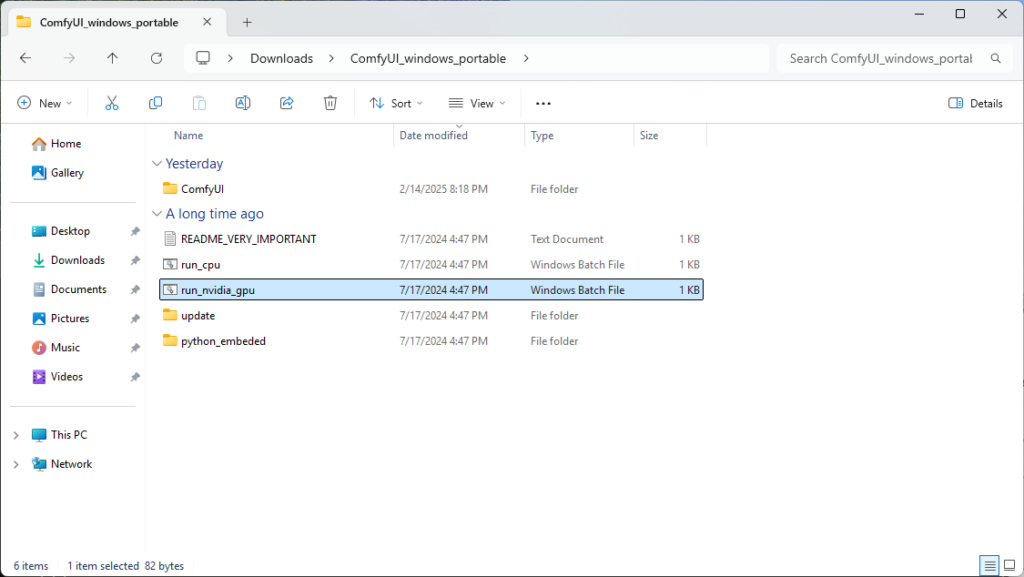
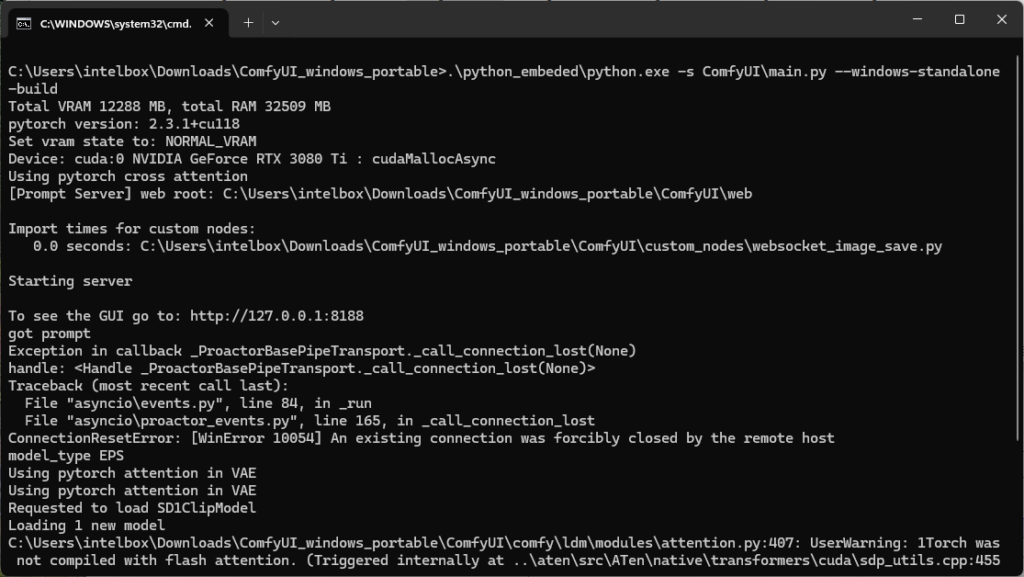
Cela chargera ensuite une invite de commande en arrière-plan. Cela semble relativement complexe, mais charge rapidement un lien vers votre navigateur Web par défaut pour son interface graphique.
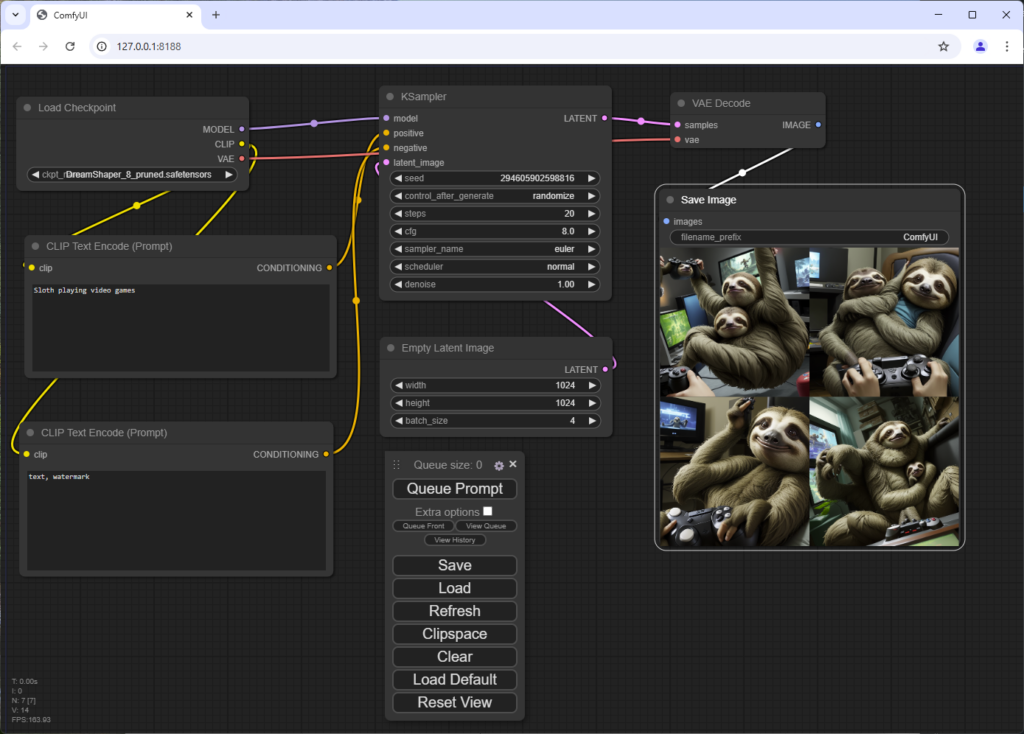
L'interface graphique qui vous sera présentée montre le flux de travail du modèle de génération d'images, bien que vous puissiez vous lancer directement en remplaçant le texte à l'intérieur de l'invite CLIP Text Encode. Dans cet exemple, nous avons généré quatre images d'un paresseux jouant à un jeu vidéo. Dans le champ Empty Latent Image, la largeur et la hauteur des images ont été modifiées de 512 à 1024 pour les agrandir. La « taille du lot » a été modifiée à 4 pour créer des images multiples simultanément.
Réflexions finales : donner du pouvoir à la prochaine génération grâce à l’IA
L'évolution rapide de l'IA et son accessibilité croissante signifient que les PC de jeu d'aujourd'hui peuvent servir à bien plus qu'un simple divertissement. En offrant aux enfants un accès précoce à l'IA via des offres basées sur le cloud ou sur des instances locales avec des systèmes performants, nous leur donnons les outils pour explorer l'apprentissage automatique. Ils peuvent expérimenter la créativité pilotée par l'IA et développer de précieuses compétences en programmation qui seront de plus en plus pertinentes.
Du codage de jeux simples à l’exécution de LLM et à la création d’œuvres d’art alimentées par l’IA, un PC domestique bien équipé peut devenir un environnement d’apprentissage robuste. Qu’il s’agisse d’utiliser des services d’IA basés sur le cloud ou de se lancer dans des déploiements locaux avec des outils comme Ollama, ComfyUI ou bien d’autres, les opportunités pour les jeunes apprenants de s’engager dans l’IA sont plus nombreuses que jamais.
En fin de compte, la décision d’investir dans un système plus performant ne se résume pas à une simple mise à niveau du matériel. Il s’agit également de favoriser la curiosité, la créativité et les compétences techniques. Alors que l’IA continue de façonner l’avenir, permettre aux enfants d’expérimenter ces technologies pourrait être l’un des investissements les plus efficaces pour leur éducation et leur développement.


 Amazon