

In occasione dell'ISC 2026, DDN ha annunciato un'ampia espansione del suo portfolio di piattaforme dati per IA e HPC, introducendo nuove funzionalità hardware, software e di piattaforma progettate per migliorare l'utilizzo delle GPU, accelerare l'inferenza dell'IA e semplificare le implementazioni di infrastrutture di IA su larga scala.
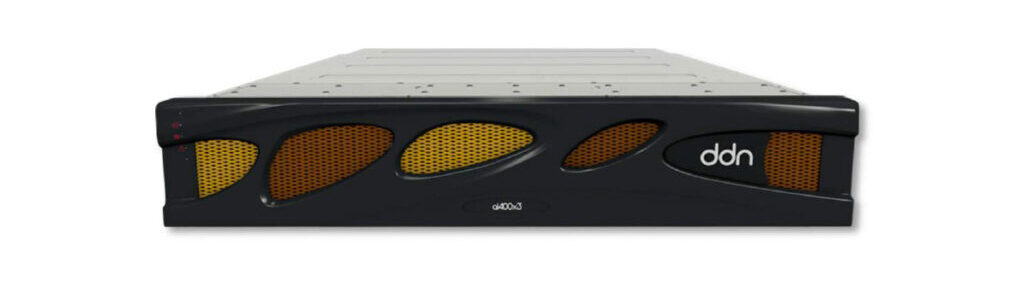
Gli annunci includono l'appliance di storage AI400X3M, la disponibilità generale della tecnologia di accelerazione distribuita KV Cache di DDN integrata con NVIDIA Dynamo e nuove funzionalità di sicurezza, osservabilità e gestione dell'infrastruttura per le piattaforme dati AI dell'azienda.
DDN ha affermato che gli aggiornamenti mirano a risolvere i colli di bottiglia lungo l'intera pipeline di dati dell'IA, tra cui la preparazione dei dati, l'addestramento dei modelli, l'inferenza, la generazione aumentata dal recupero (RAG), i modelli di ragionamento e i carichi di lavoro di IA agentiva. L'azienda si sta concentrando sul miglioramento dell'efficienza dell'infrastruttura aumentando l'utilizzo delle GPU e riducendo al contempo il consumo energetico e i costi dell'infrastruttura.
Alex Bouzari, CEO e co-fondatore di DDN, ha affermato che le moderne infrastrutture di intelligenza artificiale richiedono ben più delle sole risorse di calcolo. Ha sottolineato che una gestione efficiente dei dati, la sicurezza e la visibilità operativa sono diventate componenti fondamentali delle implementazioni di IA in produzione, e che le ultime release dell'azienda mirano a migliorare l'efficienza delle GPU, ridurre i costi di inferenza e accelerare il time-to-first-token.
AI400X3M punta alla densità di prestazioni in ambito AI e HPC.
Il prodotto di punta dell'annuncio è l'AI400X3M, l'appliance più recente basata sul file system parallelo EXAScaler di DDN.
Specifiche del modello AI400X3M
| Cookie di prestazione | |
| Prestazioni di lettura sequenziale | Fino a 190 GB/s |
| Prestazioni di scrittura sequenziale | Fino a 110 GB/s |
| IOPS a caso a caso | 8M |
| Caratteristiche del sistema | |
| Piattaforma | Appliance EXAScaler chiavi in mano per file system parallelo condiviso per intelligenza artificiale con controller di storage attivi/attivi. |
| Porte host per dispositivo | 4x XDR/400GbE OSFP o 8x NDR200/200GbE QSFP112 |
| Supporto per unità | 24 slot PCIe G5 NVMe da 2.5" a doppia porta, sostituibili a caldo. |
| Opzioni di capacità | 120/250/500 TB e 1 PB/2 PB utilizzabili |
| Funzionalità standard del firmware | Mappatura e mascheramento LUN, striping intelligente delle scritture, QoS in lettura, controllo/correzione dell'integrità dei dati, opzioni di interfaccia (CLI, GUI, API Python), syslog in uscita con supporto RELP, messaggi di cambio di stato (tramite e-mail e trap SNMP) |
| Sicurezza e conformità | |
| Sicurezza | IEC/EN/UL/CSA 62368-1, GB4943 |
| EMC | EN 55032 Classe A, EN 55035, EN 61000-3-2, EN 61000-3-3, FCC Parte 15 Classe A, VCCI Classe A, ICES-003 Classe A, GB/T9254 Classe A, BSMI Classe A |
| Ambiente | RoHS, REACH, RAEE, ERP Lotto 9X |
| Attributi fisici | |
| Fattore di forma | Montaggio su rack 2U |
| Dimensioni | Altezza: 3.43 "(87mm) Larghezza: 17.56 "(446mm) Profondità: 33.7″ (856 mm) senza lunetta; 35.2″ (895 mm) in totale Binario portapacchi regolabile: da 26.75″ a 34.0″ (680–860 mm) |
| Peso | 98 libbre (44 kg) a vuoto; 108 libbre (49 kg) massimo |
| Alimentazione e raffreddamento | |
| Tensione di ingresso | 200–240V 50/60 Hz |
| Alimentazione di laboratorio | 2 ingressi IEC60320-C20 ridondanti e sostituibili a caldo. |
| Ambiente operativo | |
| Intervallo di temperatura | 5 ° C a 30 ° C (41 ° F a 86 ° F) |
| Umidità relativa | 8%–80% senza condensa |
| altitudine | 3,117 piedi (950 m) a 30 °C — 10,000 piedi (3,048 m) a 23 °C |
La piattaforma offre una velocità di trasmissione fino a 190 GB/s e prestazioni di lettura superiori fino al 35% rispetto alla generazione precedente. DDN supporta inoltre configurazioni scalabili fino a 30 PB all'interno di un singolo rack, aggiungendo il supporto per dischi ibridi che combinano storage flash e HDD per bilanciare prestazioni, capacità e costi.
L'appliance è progettata per l'addestramento di modelli di intelligenza artificiale, l'inferenza, il checkpointing, la simulazione HPC e altri carichi di lavoro altamente paralleli in cui la velocità di trasmissione dello storage può influire direttamente sull'utilizzo della GPU. La disponibilità generale è prevista entro la fine del terzo trimestre del 2026.
La cache KV distribuita è ora disponibile a livello generale.
In seguito a un'anteprima tecnologica presentata all'NVIDIA GTC 2026, DDN ha lanciato ufficialmente la sua architettura di accelerazione distribuita KV Cache, integrando NVIDIA Dynamo. Questa funzionalità è disponibile sia sulla piattaforma di object storage Infinia che sul file system EXAScaler.
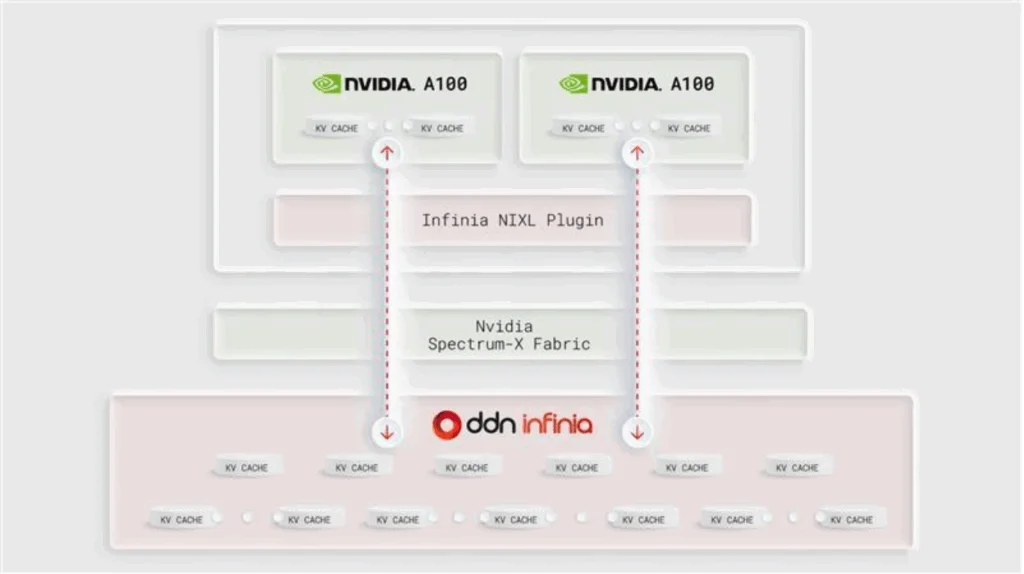
Anziché affidarsi alla memoria locale della GPU per il contesto del modello, l'architettura distribuita memorizza e recupera i dati della cache KV dalla piattaforma dati di DDN, riducendo i colli di bottiglia della memoria durante l'inferenza.
DDN ha affermato che la piattaforma supporta NVIDIA Dynamo, vLLM e altri framework di inferenza moderni, consentendo al contempo la condivisione di una cache KV distribuita su più nodi di inferenza. L'azienda dichiara un caricamento della cache KV fino a 55 volte più veloce per carichi di lavoro di inferenza su larga scala, insieme a un migliore utilizzo della GPU, una generazione di token più rapida e costi infrastrutturali inferiori per implementazioni di modelli linguistici su larga scala.
Questa tecnologia è pensata per apportare benefici all'inferenza a lungo termine, alla generazione potenziata dal recupero, ai modelli di ragionamento e ai flussi di lavoro di intelligenza artificiale agentiva che accedono ripetutamente a contesti di modelli di grandi dimensioni.
Pipeline di dati unificata per l'IA
DDN ha inoltre illustrato la sua strategia più ampia di combinare l'archiviazione di oggetti Infinia per l'inferenza con EXAScaler per l'addestramento dei modelli e il checkpointing, il tutto all'interno di un'unica infrastruttura dati per l'IA.
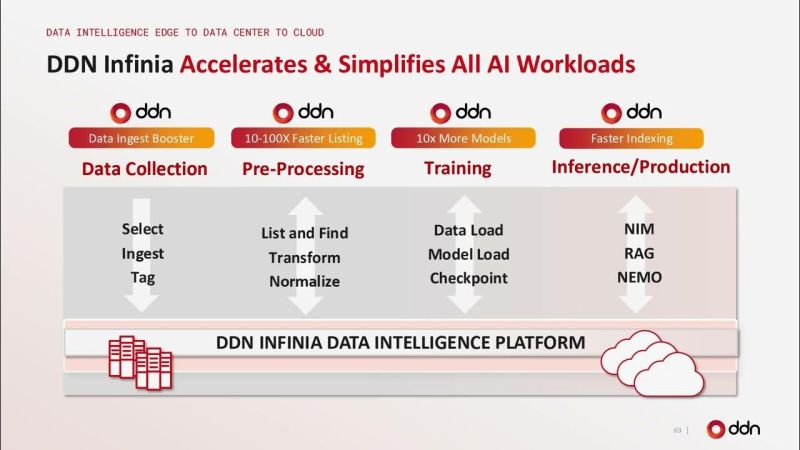
L'azienda ha dichiarato che Infinia offre operazioni sui metadati a bassa latenza, elevata concorrenza e prestazioni degli oggetti ottimizzate per carichi di lavoro intensivi di inferenza, mentre EXAScaler continua a servire ambienti di training ad alte prestazioni. Insieme, le piattaforme sono progettate per eliminare i silos di dati e mantenere un elevato utilizzo della GPU durante l'intero ciclo di vita dell'IA.
Nuove funzionalità di sicurezza e infrastrutturali
Ulteriori miglioramenti della piattaforma si concentrano sui requisiti di implementazione aziendale, tra cui multi-tenancy bare-metal, crittografia e gestione delle chiavi basate su KMIP, integrazione con VictoriaLogs per la visibilità operativa e API multi-tenant ampliate.

Sul fronte dello storage, DDN ha introdotto la funzionalità di pinning intelligente dei file e le Hot Pools con accelerazione NAND, che consentono ai dati a cui si accede più frequentemente di rimanere sulla memoria flash, spostando automaticamente i dati meno utilizzati su dischi rigidi a basso costo. L'azienda ha affermato che queste funzionalità sono progettate per migliorare l'efficienza dello storage e ridurre i requisiti di capacità della memoria flash.
Espansione continua dell'IA nel cloud
DDN ha inoltre evidenziato la continua adozione delle sue offerte di infrastruttura AI cloud, tra cui gli sviluppi di Managed Lustre annunciati con Google Cloud e un'implementazione Salesforce che utilizza Google Cloud Managed Lustre basato su EXAScaler.
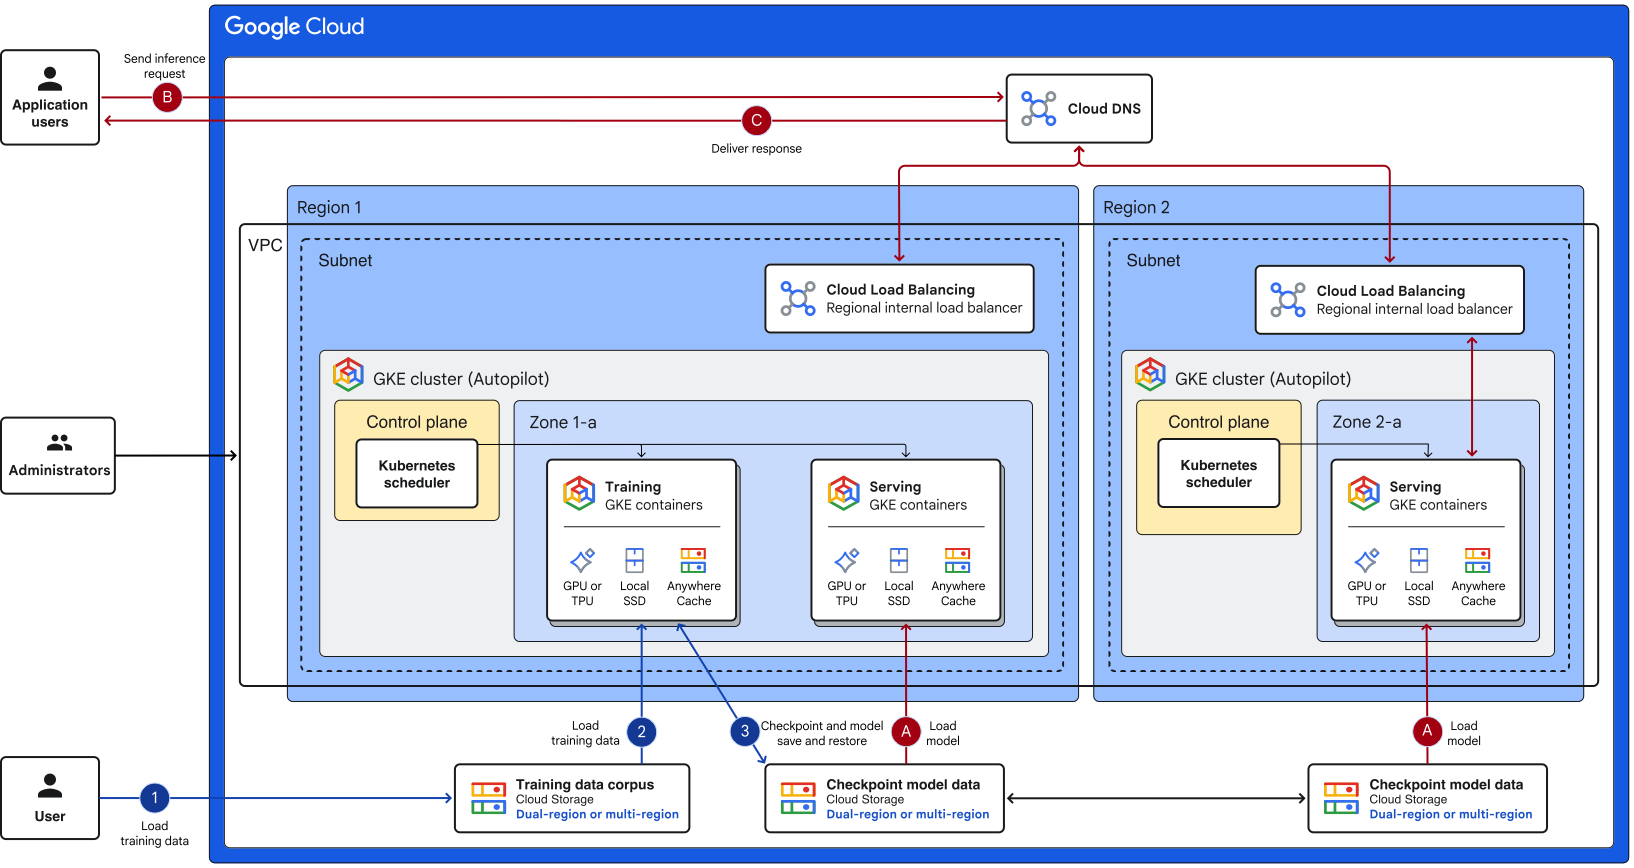
Secondo DDN, l'implementazione di Salesforce ha permesso di ottenere un addestramento del modello 1.5 volte più veloce, una riduzione della latenza I/O del 75% e una diminuzione dei costi di addestramento del 42%, dimostrando l'impatto della riduzione dei colli di bottiglia di archiviazione in ambienti di intelligenza artificiale su larga scala.
Con gli ultimi annunci, DDN continua ad espandere il proprio portfolio oltre lo storage parallelo, includendo l'orchestrazione dei dati AI, l'accelerazione dell'inferenza e la gestione dell'infrastruttura, posizionando le proprie piattaforme per supportare implementazioni di AI in ambito aziendale, cloud, ricerca e governativo, operanti su larga scala con GPU.


 Amazon