

MinIO ha annunciato MemKV, un archivio di memoria di contesto progettato per affrontare un collo di bottiglia crescente negli ambienti di inferenza AI su larga scala. Posizionato come secondo componente principale del portfolio aziendale, insieme ad AIStor , MemKV estende l'infrastruttura dati di MinIO al livello di memoria, puntando a un contesto persistente e condiviso per i carichi di lavoro di IA agentiva che operano su cluster GPU.
Con l'evoluzione dei sistemi di intelligenza artificiale, che passano da interazioni a risposta singola a ragionamenti e attività a più fasi, il mantenimento del contesto tra i cicli di inferenza è diventato fondamentale. Nelle architetture attuali, il contesto viene spesso perso a causa della capacità limitata dei livelli di memoria adiacenti alla GPU, come HBM e DRAM. Ciò costringe le GPU a ricalcolare il contesto generato in precedenza, aumentando la latenza, l'utilizzo delle risorse di calcolo e il consumo energetico. MinIO definisce questo fenomeno come un "costo di ricalcolo" che si amplifica su larga scala, in particolare negli ambienti hyperscale e cloud.
MemKV è progettato per mitigare questo problema fornendo un livello di memoria condivisa e persistente in grado di recuperare dati in microsecondi su scala petabyte. Mantenendo il contesto tra le operazioni di inferenza, la piattaforma riduce i calcoli ridondanti e migliora l'efficienza complessiva del sistema. Nei benchmark interni, MinIO riporta miglioramenti nel tempo di generazione del primo token a livelli di concorrenza di produzione. In un'implementazione rappresentativa con 128 GPU e finestre di contesto da 128 token, l'utilizzo delle GPU è aumentato da circa il 50% a oltre il 90%, con conseguenti significativi risparmi sui costi di calcolo annuali.
I vertici di MinIO hanno osservato che il sovraccarico dovuto al ricalcolo è stato storicamente mascherato nelle implementazioni di dimensioni ridotte, ma diventa un'inefficienza strutturale su larga scala. Con la crescita dei cluster GPU, il costo della rigenerazione ripetuta del contesto aumenta sia in termini di consumo energetico che di requisiti infrastrutturali, rendendo necessari sistemi di memoria dedicati per operazioni di intelligenza artificiale sostenibili.
Affrontare il compromesso tra memoria e scalabilità
Le infrastrutture tradizionali per l'IA impongono un compromesso tra velocità e scalabilità. I livelli di memoria ad alte prestazioni, come HBM e DRAM, offrono latenze dell'ordine dei microsecondi, ma sono limitati in termini di capacità e costosi. Al contrario, i sistemi di archiviazione offrono scalabilità, ma introducono latenze dell'ordine dei millisecondi, inadatte all'inferenza in tempo reale e al ragionamento a lungo termine.
MemKV è progettato per colmare questa lacuna introducendo un livello di memoria condivisa che combina accesso a bassa latenza con capacità su larga scala. Realizzata per funzionare su NVIDIA BlueField-4 STX e integrata con NVIDIA Dynamo e NIXL, la piattaforma consente a un intero cluster di GPU di accedere a un pool comune di dati di contesto a velocità in linea con i requisiti di inferenza. Questo approccio elimina la necessità di trasferire il contesto tra livelli di memoria e di archiviazione separati, riducendo la latenza e migliorando il throughput.
Architettura ottimizzata per carichi di lavoro di inferenza
MemKV è stato progettato specificamente per il percorso dati di inferenza ed è in linea con la descrizione di MinIO del livello G3.5 nella gerarchia di memoria della GPU. Offre una capacità su scala petabyte su infrastrutture basate su NVMe, mantenendo al contempo caratteristiche di accesso a livello di microsecondi, disaccoppiando di fatto la scalabilità della memoria dalle risorse di calcolo della GPU.
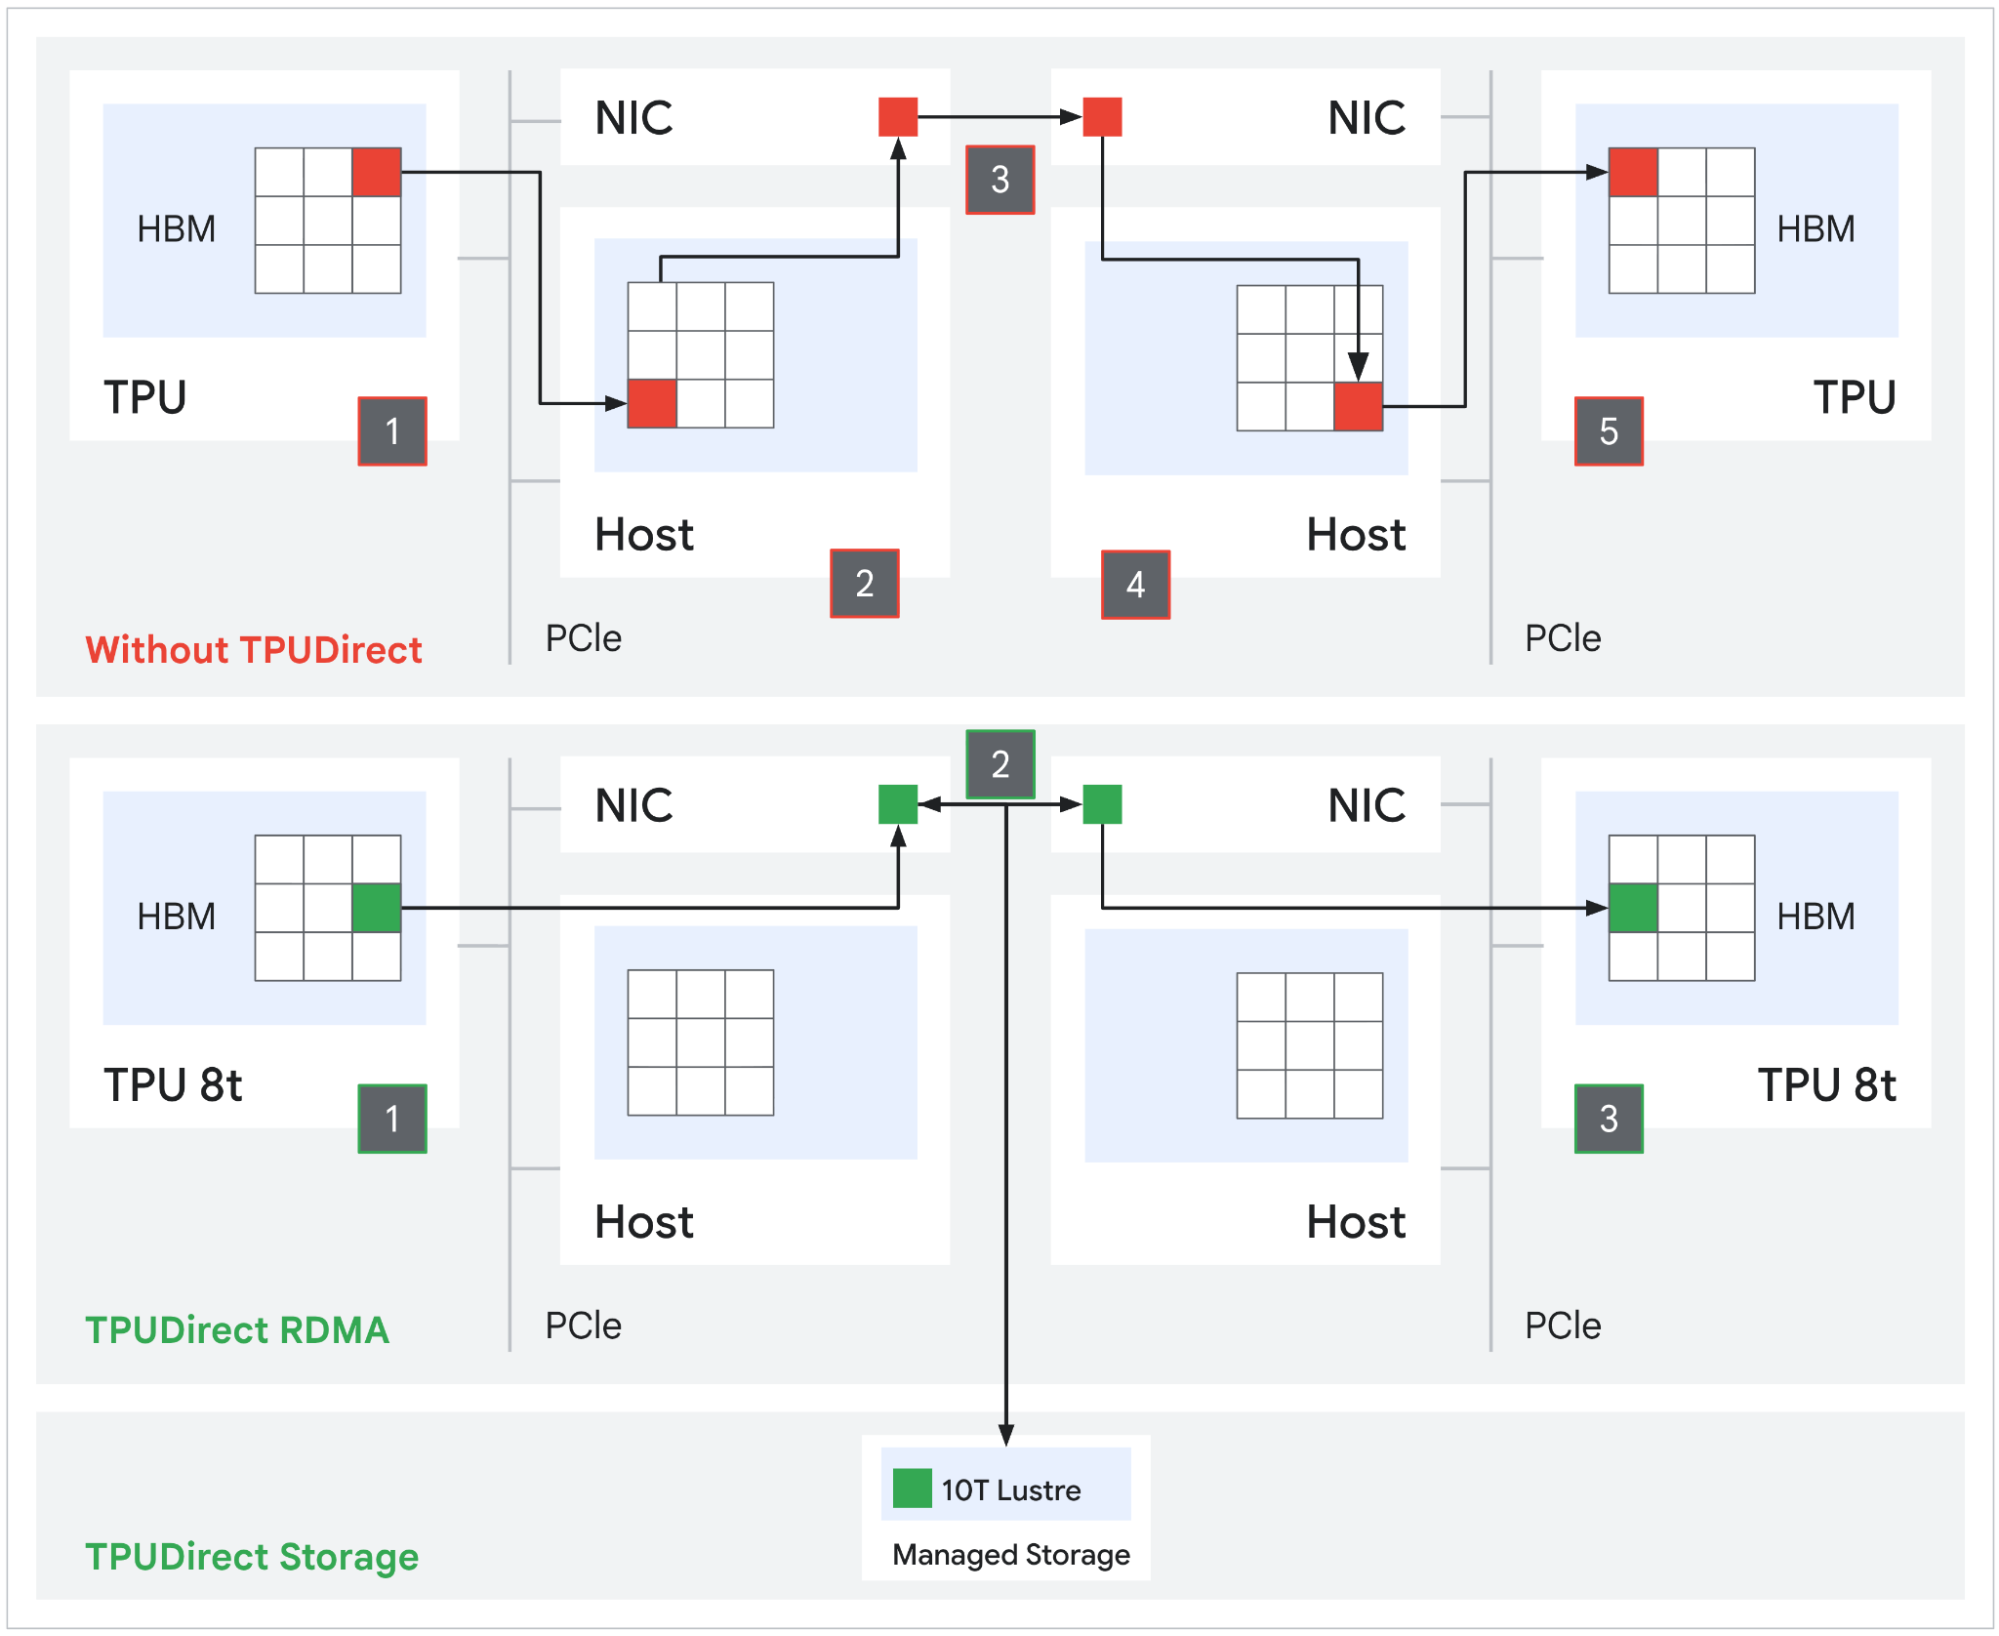
Il sistema evita le tradizionali astrazioni di archiviazione spostando i dati direttamente da NVMe al percorso dati AI tramite trasporto RDMA end-to-end . Ciò elimina il sovraccarico derivante dai protocolli HTTP, dalla traduzione del file system e dai server di archiviazione intermedi, comuni nelle architetture basate su oggetti e file.
Fonte: Google
Tra gli elementi architettonici chiave figurano l'esecuzione nativa su NVIDIA BlueField-4 STX come binario ARM64 incorporato nel livello di storage, riducendo la dipendenza da nodi di storage x86 esterni. I trasferimenti di dati avvengono tramite RDMA dalla memoria GPU a NVMe, bypassando gli stack di storage convenzionali. MemKV utilizza inoltre blocchi di dimensioni maggiori, da 2 MB a 16 MB, ottimizzati per i modelli di throughput della GPU anziché i tradizionali blocchi di storage da 4 KB. Le prestazioni di rete sono allineate alle moderne infrastrutture ad alta velocità, tra cui NVIDIA Spectrum-X Ethernet e PCIe Gen6, consentendo il trasferimento di dati a velocità prossima a quella di linea all'interno del cluster.
Disponibilità
MinIO MemKV è disponibile da subito.


 Amazon