

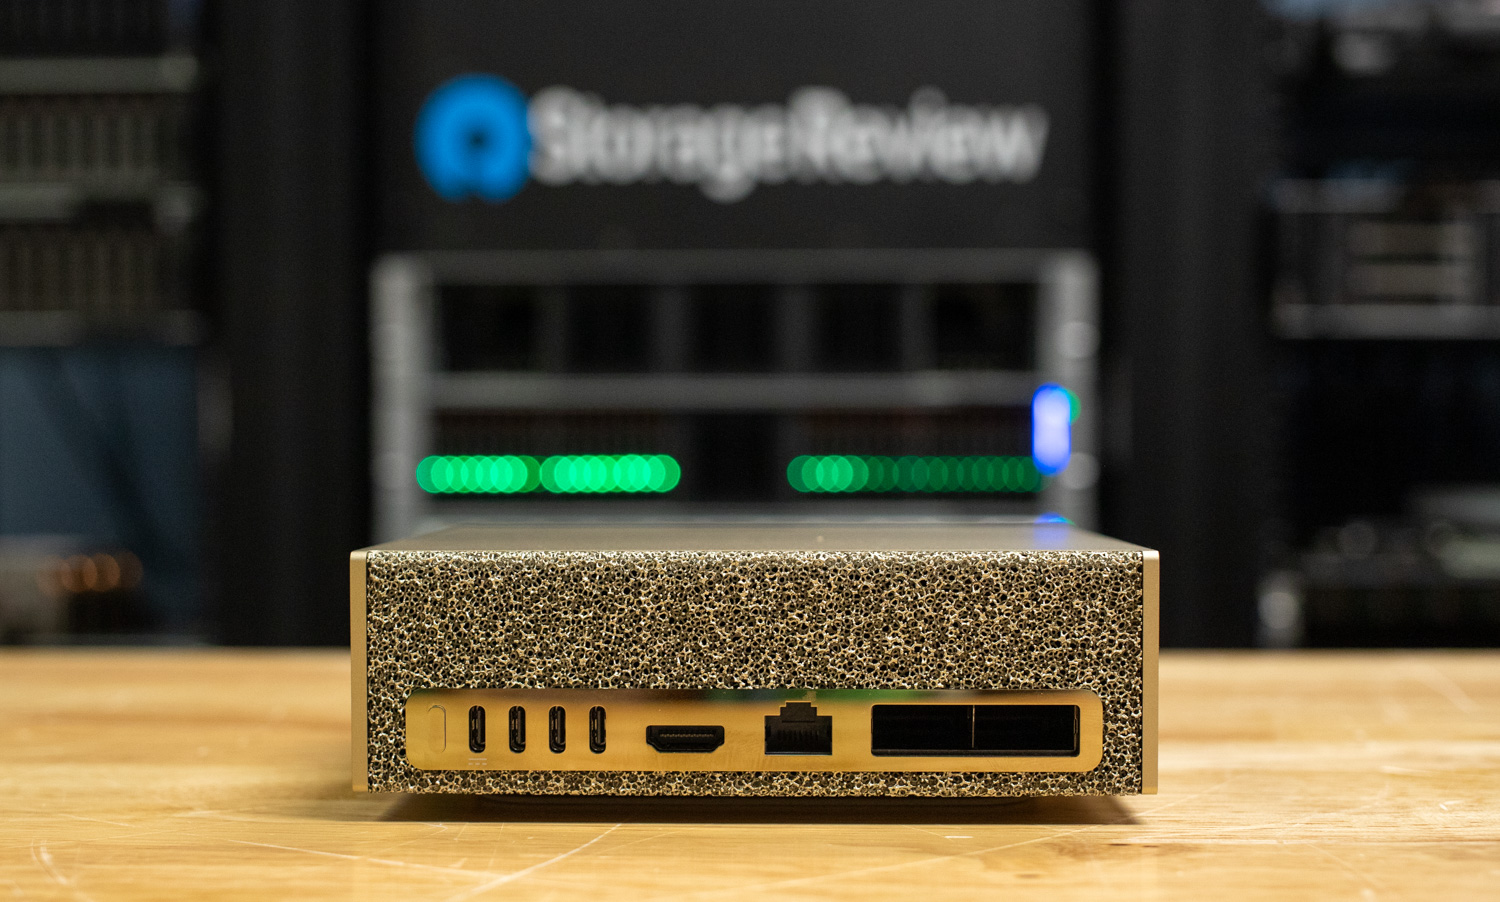
Al CES 2026, NVIDIA ha presentato un aggiornamento software per DGX Spark che ne amplia il ruolo di sistema AI compatto e on-premise. Le modifiche si concentrano su nuovi runtime, formati di quantizzazione e playbook di implementazione che semplificano l'esecuzione locale di modelli open source, flussi di lavoro automatizzati e pipeline di creazione e 3D. L'aggiornamento è destinato ai team che già utilizzano DGX Spark in laboratori, implementazioni edge o ambienti di ingegneria e non introduce nuovo hardware.
Intelligenza artificiale open source in contesti aziendali
NVIDIA ha evidenziato la rapida ascesa dell'intelligenza artificiale open source. I download mensili di framework e modelli di intelligenza artificiale open source sono aumentati da circa sette milioni a giugno 2023 a circa 390 milioni a dicembre 2025. Spark è stato adattato per supportare questa tendenza: PyTorch, vLLM, SGLang, llama.cpp, LlamaIndex e molti modelli della community di Qwen, Meta, Stability e Wan sono ora completamente integrati nel sistema.
Per le aziende che adottano strumenti standardizzati aperti, ciò si traduce in un minor lavoro di integrazione personalizzata e in un funzionamento più affidabile per gli stack che già utilizzano.
Fino a 2.5 volte più veloce dal lancio
NVIDIA afferma che le prestazioni sui carichi di lavoro chiave sono migliorate fino a 2.5 volte rispetto a DGX Spark al momento del lancio. Questo miglioramento è dovuto ai miglioramenti di TensorRT-LLM, alla quantizzazione aggressiva e alle ottimizzazioni della decodifica, piuttosto che a modifiche hardware.
Un esempio specifico è Qwen-235B che utilizza TensorRT-LLM. La transizione dalla quantizzazione FP8 a NVFP4 e l'impiego della decodifica speculativa con Eagle3 più che raddoppiano la produttività. Qwen3-30B con CUDA e Stable Diffusion 3.5 Large con llama.cpp ottengono miglioramenti di circa 1.4 volte. I processi di fine-tuning, sia completi che parametricamente efficienti, mostrano miglioramenti evidenti ma di minore entità, poiché le pipeline PyTorch sono ottimizzate per le GPU di Spark.
Playbook: da “Box on Desk” a flussi di lavoro utilizzabili
Per colmare il divario tra potenza di calcolo pura e soluzioni utilizzabili, NVIDIA sta introducendo nuovi playbook DGX Spark che combinano strumenti, modelli e guide per le attività aziendali più comuni.
I nuovi contenuti includono:
- Inferenza: vLLM, SGLang, TensorRT-LLM, decodifica speculativa, inferenza multimodale, NIM su Spark, quantizzazione NVFP4 e Nemotron-3 Nano locale.
- Ottimizzazione: ottimizzazione multi-Spark PyTorch, FLUX.1 DreamBooth LoRA, LLAMA Factory, NeMo e addestramento efficiente basato su Unsloth.
- Scienza dei dati: CUDA-X Data Science, JAX ottimizzato, text-to-knowledge-graph e flussi di lavoro specifici per dominio come il sequenziamento dell'RNA a singola cellula e l'ottimizzazione quantitativa del portafoglio.
- Strumenti e connettività: ComfyUI, VS Code, DGX Dashboard, RAG in AI Workbench, Tailscale e "Connect Two Sparks" basato su NCCL.
L'attenzione è meno rivolta alle demo appariscenti e più alla ripetibilità. Questi playbook fungono da framework di riferimento pre-validati che possono essere implementati on-premise senza dover rielaborare l'intero stack.
Pipeline video AI 8 volte più veloci con MacBook ibrido e Spark
Nella creazione di contenuti, NVIDIA ha testato flussi di lavoro di generazione video AI abbinando un MacBook Pro M4 Max con DGX Spark tramite ComfyUI e FLUX.1-dev, WAN 2.2 e upscaler accelerati da GPU.
La pipeline di riferimento, con un video 4K di un'auto sportiva rossa in una città futuristica, ha messo in mostra i miglioramenti. L'esecuzione dell'intero flusso di lavoro sul solo MacBook ha richiesto circa otto minuti. Deviando l'elaborazione più pesante su DGX Spark, il tempo è stato ridotto a circa 1 minuto, con un conseguente aumento della velocità di 8 volte.
Questo progresso nasce dall'utilizzo di FLUX.1-dev e WAN 2.2 in NVFP4/NVFP8 quantizzato su Spark, seguito da RTX Video Super Resolution. Per i team di media, design e marketing, questo trasforma il video generativo da un rendering in stile batch a un processo molto più vicino all'iterazione interattiva, mantenendo il controllo all'interno del data center o dell'edge rack.
3D e RTX Remix: Spark come co-processore AI in background
DGX Spark è anche commercializzato come coprocessore per flussi di lavoro 3D basati su RTX Remix. Ad esempio, un sistema RTX 5090 esegue l'ambiente interattivo "Mod". Allo stesso tempo, Spark genera texture AI in batch (ad esempio, 100 materiali) e invia i risultati alla scena senza interrompere gli artisti.
Un confronto prima e dopo con SWAT 4 ha illustrato come i materiali potenziati dall'intelligenza artificiale possano rivitalizzare le risorse legacy. Tuttavia, il principale vantaggio aziendale risiede nella progettazione del flusso di lavoro: Spark funge da motore di background continuo per le attività generative, mentre le workstation principali rimangono attive.
Nsight Copilot: assistente AI CUDA locale
Un'aggiunta degna di nota è Nsight Copilot, che opera localmente su DGX Spark.
Gli sviluppatori possono richiedere attività come "scrivi matmul in fp4 in CUDA" e Nsight Copilot fornisce un esempio completo di cuBLAS-Lt che quantizza gli input FP32 in FP4 sul dispositivo, imposta la scalabilità per tensore, esegue GEMM in FP32 e restituisce l'output FP32. È importante notare che questo processo avviene senza inviare codice o dati a un servizio cloud:
- Nessun costo di inferenza cloud.
- Origine, dati e IP rimangono in sede.
- Le GPU locali gestiscono la latenza e la produttività.
Per le organizzazioni con rigide regole di governance dei dati, ciò consente lo sviluppo assistito dall'intelligenza artificiale, mantenendo al contempo la sicurezza di tutto all'interno della rete.
Agenti, robotica ed edge: dal laboratorio alla produzione
NVIDIA sta espandendo Spark in applicazioni di agentistica e robotica attraverso una partnership con Hugging Face e il robot open source Reachy Mini. DGX Spark gestisce gli agenti, gli LLM, i VLM e i pianificatori, mentre Reachy Mini fornisce una forma fisica adatta alla ricerca, alla formazione e alla prototipazione nell'interazione uomo-robot.
DGX Spark sarà incluso in NVIDIA AI Enterprise entro la fine di gennaio. Questo offrirà alle aziende uno stack software supportato, gestione del ciclo di vita e aggiornamenti di sicurezza per l'esecuzione di Spark in scenari edge e on-premise, come applicazioni di produzione e ispezione intelligenti, retail intelligente e prevenzione delle perdite, e applicazioni sanitarie point-of-care.
Supporto ecosistema e OEM
NVIDIA ha concluso l'aggiornamento evidenziando l'ampio ecosistema: fornitori di modelli (OpenAI, Mistral, Stability, Qwen, Meta, ElevenLabs, Black Forest Labs e altri), strumenti (vLLM, Comfy, LlamaIndex, Docker, Jupyter, Weights & Biases, Anyscale, insieme a codici scientifici come VASP e GROMACS) e un'ampia gamma di OEM, tra cui Dell, Lenovo, HP, ASUS, MSI, Supermicro e altri ancora.
Il messaggio per gli acquirenti aziendali è che DGX Spark non è più solo uno strumento incentrato sugli sviluppatori. È un nodo di piccole dimensioni che si integra perfettamente con gli strumenti esistenti, le relazioni con i fornitori e le strategie di intelligenza artificiale in produzione.


 Amazon