

VAST Data ha lanciato una nuova architettura di inferenza che supporta la piattaforma di storage in memoria del contesto di inferenza NVIDIA. Questo sistema si concentra sulle applicazioni di intelligenza artificiale che prevedono sessioni continue e multi-turn basate su agenti. VAST presenta questa piattaforma come una classe di storage progettata per l'intelligenza artificiale, migliorando l'accesso alla cache chiave-valore (KV), consentendo una rapida condivisione del contesto di inferenza tra i nodi e migliorando l'efficienza energetica. Il progetto utilizza le DPU NVIDIA BlueField-4 e la rete Ethernet Spectrum-X, mentre il sistema operativo AI (AI OS) di VAST fornisce il software necessario per gestire efficacemente questa risorsa infrastrutturale condivisa.
Per saperne di più sull'importanza di KV Cache, consulta questo approfondimento che abbiamo realizzato con Pliops.
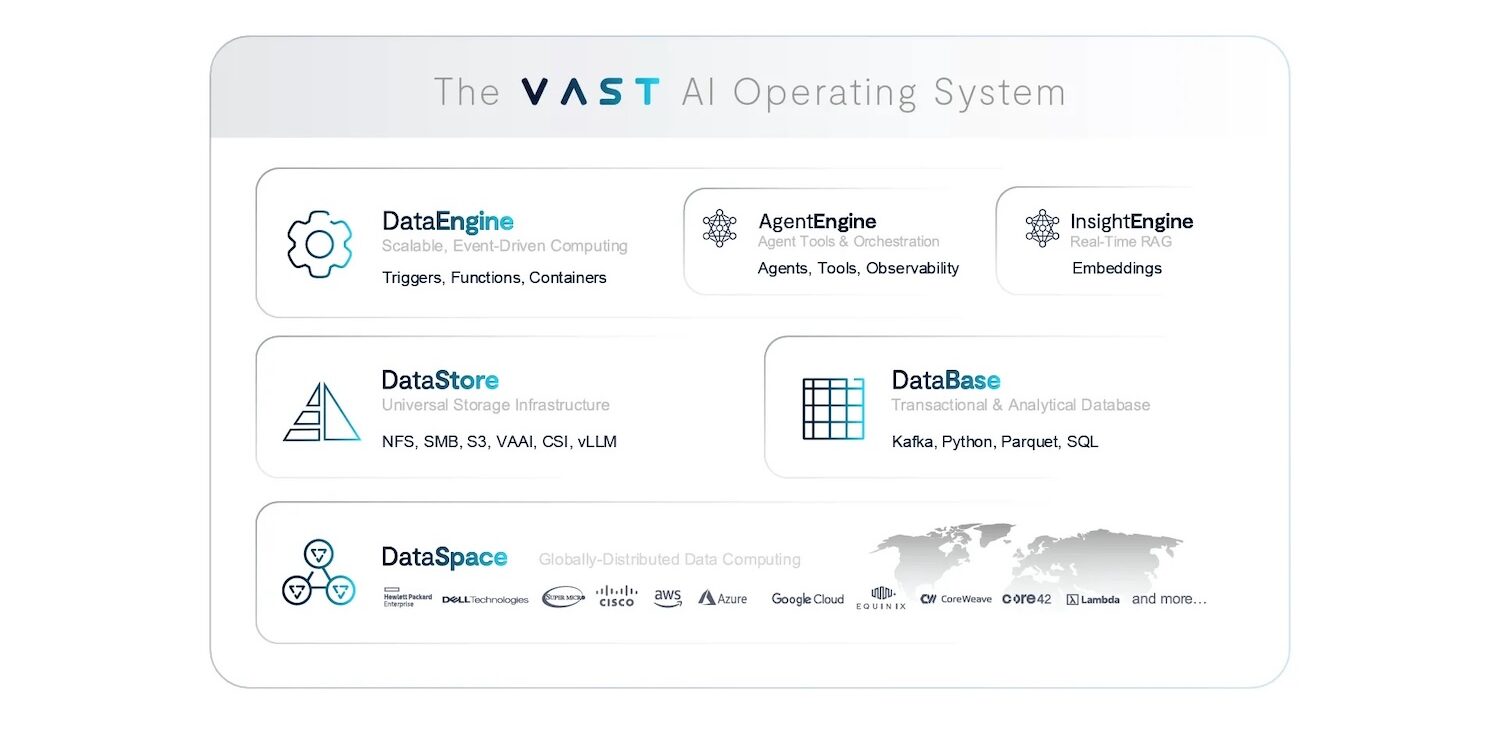
L'annuncio segnala un cambiamento nei fattori che limitano le prestazioni di inferenza nelle applicazioni reali. Con il passaggio dell'inferenza da semplici prompt a ragionamenti continui su più agenti e utenti, l'idea che il contesto rimanga all'interno di un singolo server GPU diventa obsoleta. In queste situazioni, le prestazioni complessive dipendono sempre più dalla qualità dell'archiviazione, del ripristino, del riutilizzo, dell'estensione e della condivisione della cronologia di inferenza durante le operazioni in corso. La cache KV si evolve da un'ottimizzazione interna a un percorso dati primario, influenzando il time-to-first-token (TTFT), l'utilizzo della GPU e l'efficienza del cluster.
Ricostruzione del percorso dei dati di inferenza attorno alle DPU
La strategia di VAST consiste nell'eseguire il software VAST AI OS direttamente sulle DPU NVIDIA BlueField-4. Anziché considerare i servizi di storage e di contesto come componenti esterni accessibili tramite un tipico modello client-server, l'architettura integra questi servizi dati direttamente nel server GPU, dove avviene l'inferenza, supportando al contempo configurazioni di nodi dati dedicati. Questo approccio mira a ridurre al minimo i colli di bottiglia ed eliminare copie e ritardi non necessari che rallentano le prestazioni con l'aumentare della concorrenza.
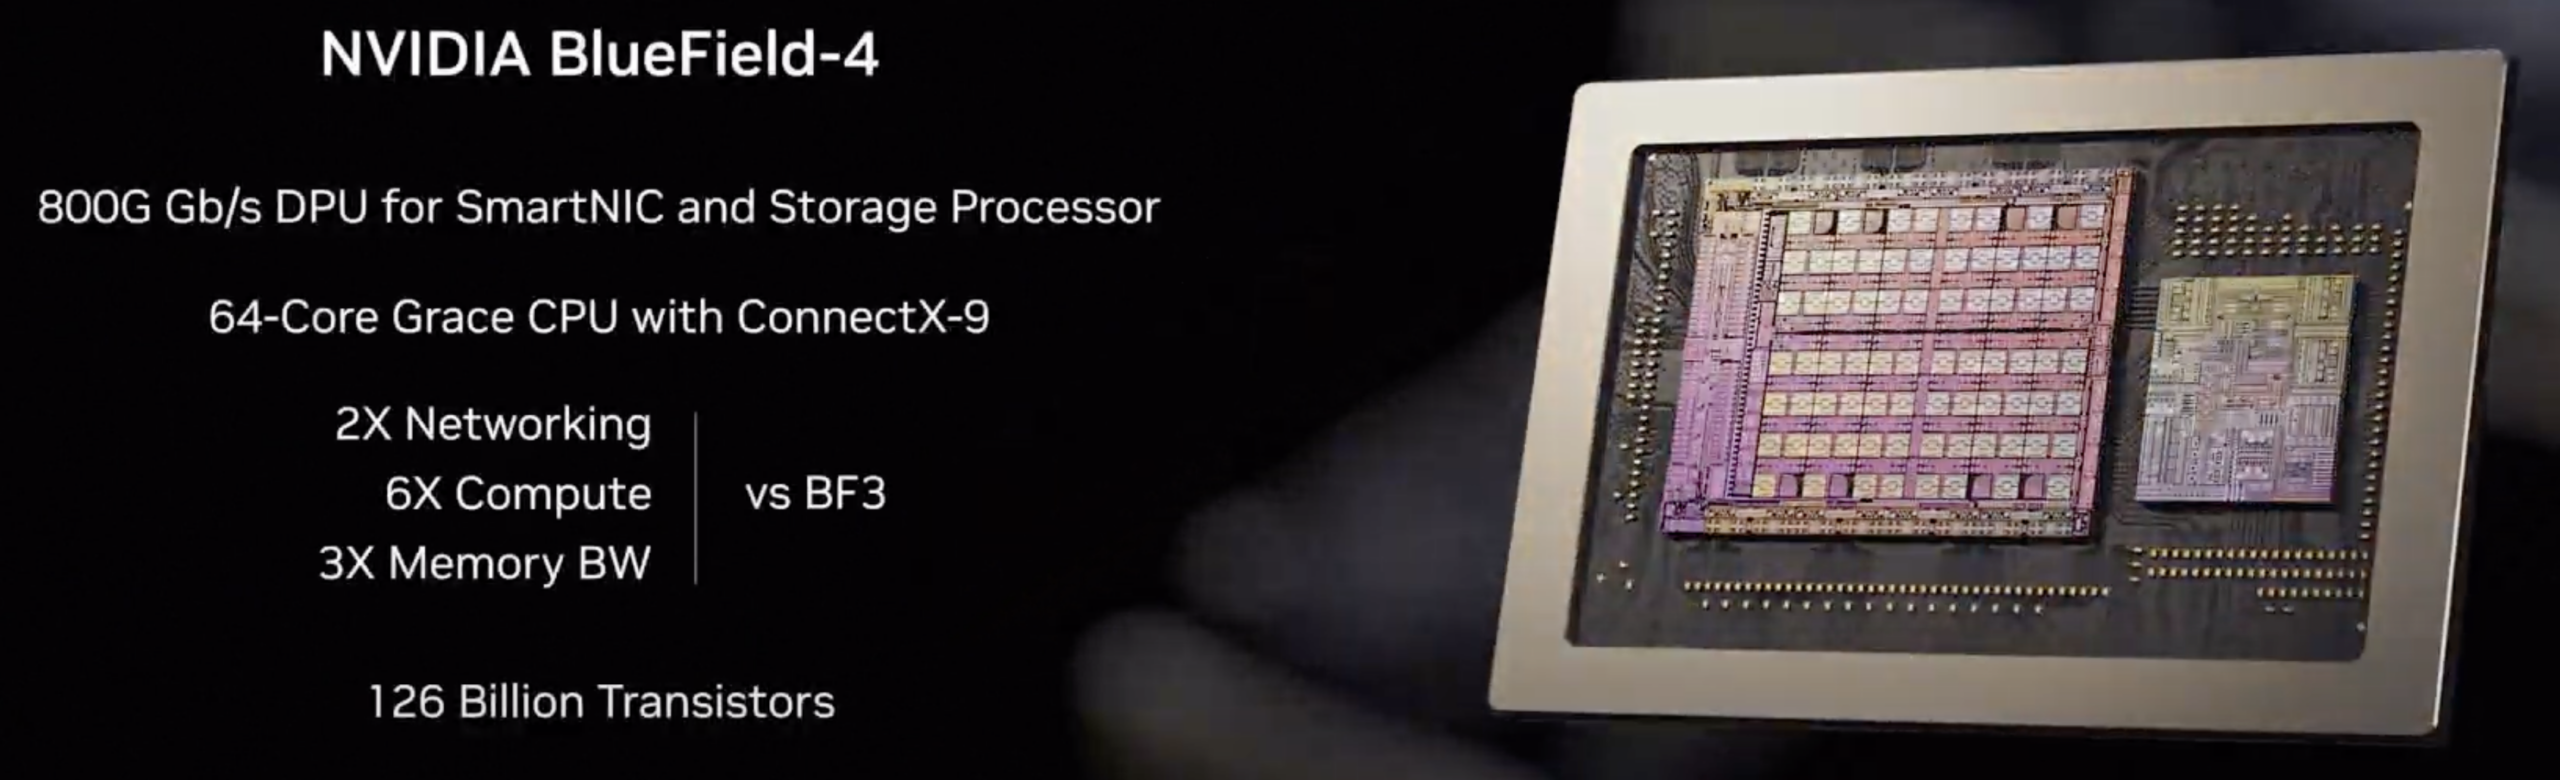
Questo design nativo DPU risponde esplicitamente alle esigenze pratiche dei sistemi di inferenza di grandi dimensioni. Quando centinaia o migliaia di sessioni vengono eseguite contemporaneamente, la gestione della cache KV si trasforma in un lavoro di input/output (I/O) continuo. Il sistema deve leggere rapidamente il contesto per mantenere le sessioni in esecuzione, memorizzarlo per un utilizzo a lungo termine e condividerlo tra i worker per evitare elaborazioni duplicate quando l'infrastruttura incanala le operazioni attraverso percorsi più lenti o richiede un coordinamento esteso. Il TTFT aumenta, causando l'attesa delle GPU anziché l'elaborazione. VAST afferma che lo spostamento del piano dati al server tramite BlueField-4 produce un traffico di contesto più efficiente, una maggiore produttività e una latenza più affidabile, più vicina al ciclo di elaborazione della GPU.
VAST enfatizza inoltre un percorso efficiente dalla memoria GPU allo storage NVMe persistente utilizzando fabric RDMA. Ciò consente un trasferimento fluido del contesto tra server GPU e storage, riducendo la gestione ripetitiva dei dati tipica dei sistemi tradizionali. L'obiettivo è garantire che il trasferimento del contesto rimanga "in banda" con reti ad alte prestazioni, riducendo al minimo il coinvolgimento della CPU e l'overhead lato client.
Contesto condiviso e coerente su larga scala
La nuova architettura si integra con il design parallelo Disaggregated Shared Everything (DASE) di VAST. VAST spiega che questo consente a ciascun host di accedere a uno spazio dei nomi di contesto condiviso e globalmente coerente, senza i costi di coordinamento che tipicamente si presentano su larga scala. Nell'inferenza basata su agenti e di lunga durata, questo dettaglio diventa cruciale. Il contesto non è solo ampio, ma sempre più condiviso.
I sistemi agentici richiedono spesso l'uso simultaneo di strumenti, passaggi di consegne tra più agenti e un comportamento simile alla memoria durante le interazioni. Ciò richiede il riutilizzo del contesto anziché ricrearlo e condividerlo tra i lavoratori dell'inferenza anziché associarlo a un singolo nodo. Se i sistemi non riescono a mantenere la località del contesto a causa di pianificazione, espulsione o ripristino in caso di errore, devono ripristinare e continuare rapidamente le sessioni senza rielaborare lunghe cronologie dei prompt. In questo modo, la cache KV si trasforma in una risorsa cluster vitale, spostando la sfida verso una sua ampia accessibilità senza che diventi un collo di bottiglia nella sincronizzazione.
La prospettiva di VAST è che la combinazione di servizi dati basati su DPU con una configurazione di storage condivisa crei un livello di contesto accessibile a livello globale che rimane efficiente al crescere del numero di sessioni simultanee. Invece di scalare aggiungendo sezioni di contesto isolate, la piattaforma consente ai cluster di espandersi continuando a beneficiare del riutilizzo e della condivisione.
Il contesto come nuovo ambito di prestazione
Il dirigente di VAST, John Mao, ha osservato che il vantaggio competitivo per i grandi sistemi di inferenza si sta spostando dalla pura potenza di calcolo ai sistemi di memoria e contesto. Ha riassunto che i cluster più efficaci non saranno solo quelli con i picchi di FLOPS più elevati, ma saranno quelli in grado di condividere e gestire il contesto in tempo reale. Ha inoltre sottolineato l'importanza dell'accesso istantaneo e on-demand al contesto come area chiave per le prestazioni, avvertendo che senza un rapido recupero e riutilizzo del contesto, le GPU rimangono inattive e l'efficienza ne risente.
Questa visione si allinea con l'esperienza di molti operatori man mano che i modelli si ridimensionano e la durata delle sessioni aumenta. Le flotte di inferenza sono spesso configurate per la massima produzione di token, ma l'esperienza è influenzata dalla latenza di coda e dal TTFT sotto stress. Con l'allungamento dei prompt e la persistenza delle sessioni, aumenta il tempo dedicato alla gestione del contesto. Se il contesto non può essere ripristinato o riutilizzato rapidamente, i cicli GPU vengono sprecati per ripristinare lo stato o attendere lo spostamento dei dati. L'approccio architetturale di VAST tratta la cache KV come un'infrastruttura condivisa, riducendo questi problemi e aumentando l'efficienza complessiva del cluster.
Passare dalla sperimentazione all'inferenza governata e produttiva
VAST presenta inoltre la piattaforma come una soluzione di transizione dalle implementazioni sperimentali ai servizi di inferenza pronti per la produzione, anche in contesti regolamentati. Poiché l'inferenza sta diventando un servizio che genera ricavi con specifici requisiti di sicurezza e conformità, la gestione della cache KV richiede più che velocità: richiede supervisione.
Nelle sessioni lunghe, il contesto può includere prompt sensibili, passaggi di ragionamento, output di strumenti e informazioni fornite dall'utente. Le aziende richiedono sempre più controlli delle policy, misure di isolamento, audit trail e gestione del ciclo di vita per tale contesto. VAST afferma che questi servizi dati nativi dell'IA sono integrati nel sistema operativo dell'IA, consentendo alle organizzazioni di trattare la cache KV come una risorsa gestibile anziché come uno stato temporaneo.
Da una prospettiva operativa, VAST mira ad affrontare le sfide comuni nei grandi ambienti di inferenza: le tempeste di ricostruzione del contesto che si verificano quando le cache vengono perse o non possono essere condivise, e lo spreco di tempo GPU quando il contesto diventa il collo di bottiglia anziché il calcolo. L'azienda ritiene che il miglioramento della persistenza e del riutilizzo del contesto ridurrà la rielaborazione e aumenterà l'utilizzo, migliorando così sia il throughput per watt che il throughput per dollaro con l'aumento delle dimensioni del contesto e della concorrenza di sessione.
NVIDIA: la gestione del contesto guida l'economia di scalabilità
Kevin Deierling, Senior Vice President of Networking di NVIDIA, ha sottolineato l'importanza del contesto nell'intelligenza artificiale, paragonandolo alla memoria umana. Ha affermato che gestire efficacemente il contesto è essenziale per scalare l'inferenza multi-turn e multi-utente, il che a sua volta modifica il modo in cui la memoria di contesto viene gestita su larga scala. Ha osservato che VAST Data AI OS, in combinazione con NVIDIA BlueField-4, supporta questo obiettivo fornendo un percorso dati stabile e ad alta produttività all'aumentare dei carichi di lavoro. Questa partnership è importante perché integra DPU e fabric Ethernet nel contesto di inferenza principale, non solo per l'accesso allo storage primario o per il networking. Il punto chiave è che il contesto rappresenta ora una sfida sia per il networking che per lo storage, oltre a essere un problema per la GPU, e le moderne configurazioni di inferenza richiederanno un'accelerazione mirata e uno spostamento dati affidabile per mantenere le GPU operative in modo efficiente.
Se l'architettura VAST offre i vantaggi promessi, l'effetto reale sarà meno legato ai punteggi massimi dei benchmark e più alla coerenza delle prestazioni del servizio: TTFT inferiore quando sono attive molte sessioni, minori cali di prestazioni all'aumentare del contesto, migliore utilizzo riducendo la ricostruzione del contesto e un percorso più diretto verso l'inferenza multi-nodo in cui la condivisione del contesto è un vantaggio piuttosto che uno svantaggio. Inoltre, spinge l'infrastruttura di inferenza verso un modello più "nativo dell'IA", trattando la cache KV come un livello di memoria gestito, supportato da NVMe persistente e condiviso tra i nodi con limiti di latenza rigorosi.
Conferenza VAST Forward
VAST Data presenterà la sua strategia alla prima conferenza utenti VAST Forward, in programma dal 24 al 26 febbraio 2026 a Salt Lake City, nello Utah. L'azienda prevede di includere sessioni tecniche dettagliate, laboratori pratici e programmi di certificazione, con la partecipazione dei dirigenti , dei clienti e dei partner di VAST .


 Amazon