

Nel corso di diverse generazioni hardware, i fornitori di memorie e reti hanno individuato diversi punti critici nei cluster di calcolo ad alte prestazioni. I produttori di memorie si sono concentrati sulla larghezza di banda della memoria all'interno del package, mentre i fornitori di infrastrutture di rete si sono occupati del throughput tra chassis e tra rack. Oggi, queste due prospettive convergono sullo stesso identico collo di bottiglia: la limitazione della larghezza di banda che ostacola il trasferimento dei dati tra nodi di calcolo distribuiti e pool di memoria.
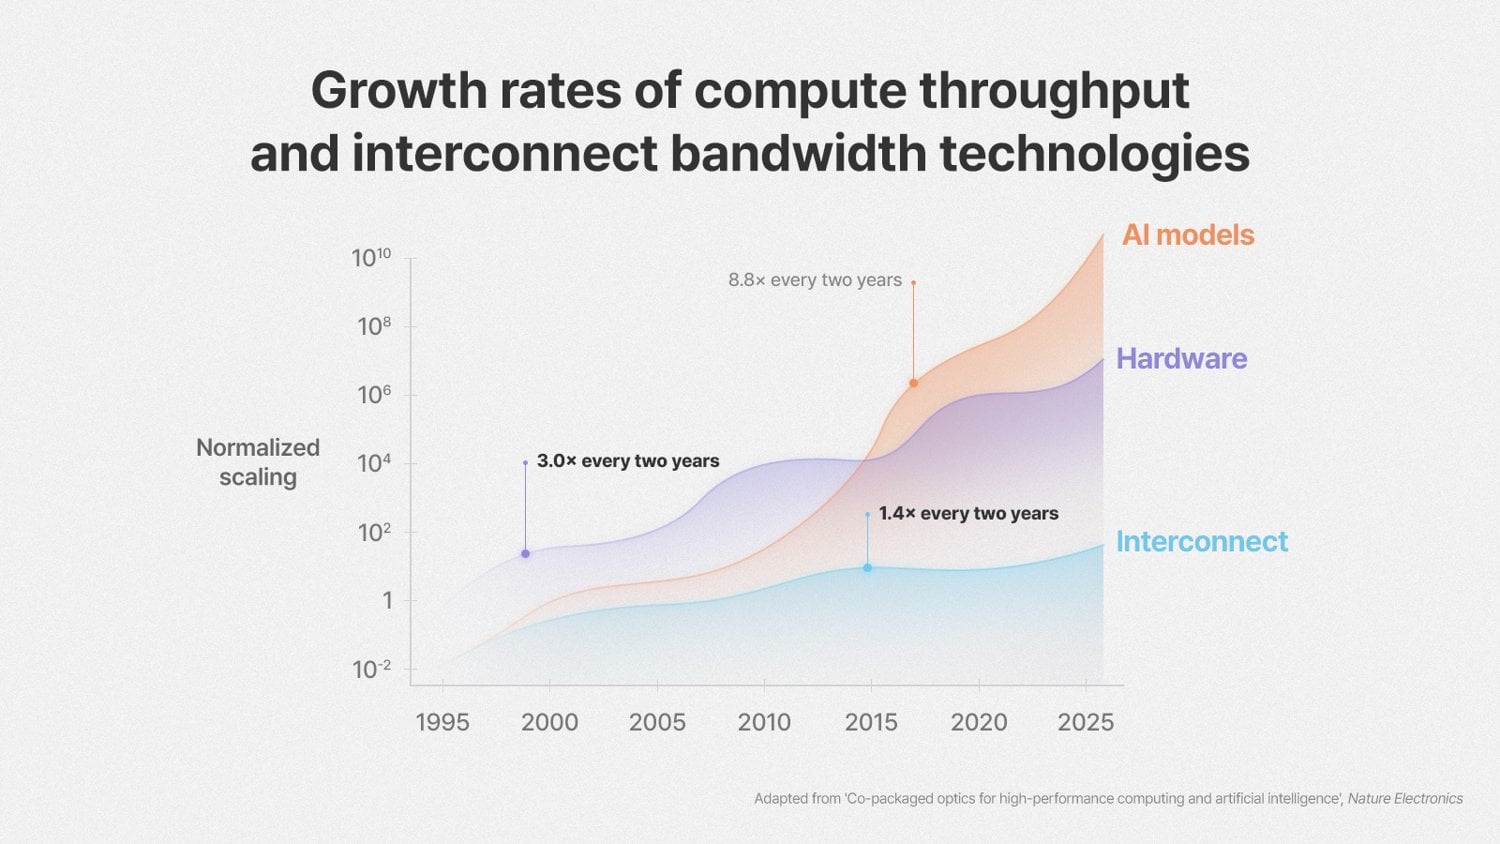
Sebbene la tecnologia High Bandwidth Memory (HBM) abbia risolto efficacemente i limiti di larghezza di banda a livello di pacchetto per i singoli acceleratori AI, i moderni carichi di lavoro di training e inferenza su larga scala si estendono ora su decine di migliaia di processori distribuiti su rack e pod. In queste topologie distribuite, la velocità di elaborazione è storicamente aumentata di circa 3 volte ogni 2 anni, mentre la larghezza di banda dell'interconnessione è aumentata di circa 1.4 volte nello stesso periodo. Il conseguente squilibrio pone il principale collo di bottiglia della scalabilità proprio sul livello fisico dell'interconnessione.
La valutazione deriva da un articolo di approfondimento pubblicato il 20 agosto su Nature Electronics , intitolato "Co-packaged optics for high-performance computing and artificial intelligence", scritto in collaborazione da SK hynix e ricercatori dell'Università della Virginia, dell'Università dell'Illinois Urbana-Champaign, del MIT, della Nanyang Technological University e della Yonsei University. Seunghoon Hong, responsabile del team AI Infra di SK hynix, e il professor Kyusang Lee dell'Università della Virginia hanno ricoperto il ruolo di autori corrispondenti.
| Stage | Risultato |
|---|---|
| Spostamento del collo di bottiglia nella scalabilità dei cluster di IA | |
| HBM nella confezione | Risolto il collo di bottiglia della memoria on-die/package |
| Tracce di rame | Colpisce l'attenuazione fisica / la parete di alimentazione fuori dal chip |
| Integrazione CPO | Fa convergere il tessuto ottico direttamente sul substrato |
Per ovviare a questo limite, SK Hynix, in collaborazione con ricercatori dell'Università della Virginia, UIUC, NTU, MIT e dell'Università Yonsei, ha pubblicato uno studio su Nature Electronics intitolato "Co-packaged optics for high-performance computing and artificial intelligence". L'articolo descrive in dettaglio come le ottiche co-confezionate (CPO) e le interconnessioni ottiche per il calcolo (OCI) debbano evolversi di pari passo con le architetture di memoria e di packaging per supportare la futura scalabilità dei cluster.
I limiti fisici delle interconnessioni in rame
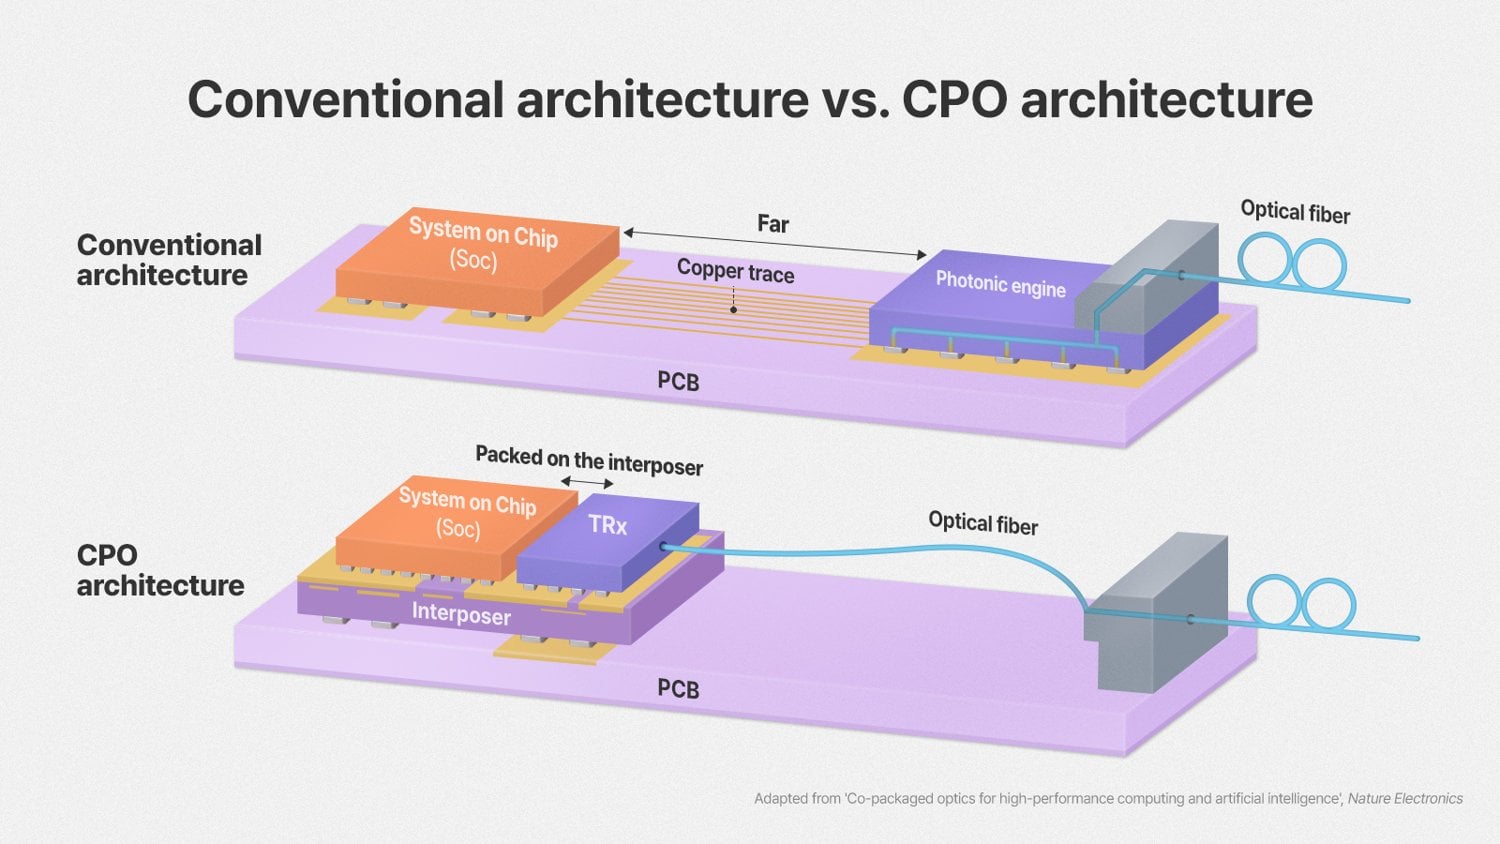
Le interconnessioni elettriche standard basate su tracce di rame e cavi in rame a collegamento diretto rimangono pratiche su brevi distanze. Tuttavia, con l'aumento delle velocità di trasmissione dati, la segnalazione elettrica subisce una forte attenuazione del segnale, una perdita di inserzione e un maggiore consumo energetico. La gestione di segnali ad alta velocità su tracce più lunghe del circuito stampato e su backplane richiede circuiti di equalizzazione e risincronizzazione complessi, che introducono ulteriore latenza e consumano notevoli quantità di energia.
Come l'ottica co-confezionata cambia il percorso
CPO supera questi limiti fisici montando i ricetrasmettitori ottici direttamente sullo stesso substrato del package dei processori o degli acceleratori host. La conversione di segnali elettrici ad alta velocità in canali fotonici direttamente adiacenti al silicio di calcolo riduce al minimo la lunghezza delle tracce elettriche, mitigando la capacità parassita e il degrado del segnale. Questa architettura consente una trasmissione ottica a bassa perdita e ad alta larghezza di banda tra schede, rack e pod, mantenendo al contempo una maggiore densità di banda e una migliore immunità alle interferenze elettromagnetiche.
| Metrico | Specifica dell'obiettivo |
|---|---|
| Specifiche target per i nodi CPO | |
| Densità di larghezza di banda del nodo | > 100 Tb/s per nodo |
| Energy Efficiency | < 1 pJ/bit |
| Latenza di interconnessione chip-to-chip | <10 ns |
| Percorso di integrazione | Interposer 2.5D per eterogeneità 3D |
La roadmap prevede una progressione architetturale che si sposta dai moduli multi-chip 2D standard e dall'integrazione di interposer in silicio 2.5D verso l'impilamento eterogeneo 3D. L'obiettivo architettonico finale prevede l'estensione dei collegamenti ottici direttamente al sottosistema di memoria stesso.
Grazie all'utilizzo di un interposer fotonico per interfacciare direttamente gli stack di memoria con i motori di calcolo, i sistemi possono aggirare le limitazioni di routing convenzionali a livello di scheda. Questo approccio consente la creazione di pool di memoria condivisa disaggregati e a bassa latenza, in cui più motori di calcolo possono accedere alla capacità condivisa tramite un backplane ottico, senza le penalità di serializzazione e deserializzazione tipiche delle reti tradizionali.
Sfide ingegneristiche per l'implementazione commerciale
Il passaggio della tecnologia CPO dalle dimostrazioni di packaging avanzato all'hardware di produzione per data center presenta diverse sfide ingegneristiche ancora irrisolte. L'integrazione di dispositivi fotonici al silicio a basso consumo energetico insieme alla logica host ad alta potenza richiede un isolamento termico sofisticato e soluzioni di raffreddamento avanzate, come la microfluidica o il raffreddamento diretto al package.
Inoltre, l'industria deve sviluppare protocolli di coerenza standardizzati a bassa latenza, in grado di orchestrare transazioni di memoria accoppiate otticamente senza l'overhead di software proprietario. Una commercializzazione affidabile richiederà una co-progettazione hardware end-to-end che abbracci le topologie dei chip DRAM, i controller di memoria personalizzati, i motori fotonici e il packaging eterogeneo dei substrati. Per SK hynix, la roadmap ottica procede di pari passo con quella convenzionale; l'azienda ha presentato in dettaglio HBM4 a 16 strati e NAND a 375 strati con incollaggio wafer all'FMS 2026.


 Amazon