

Supermicro ha annunciato l'ampliamento della capacità produttiva su scala rack e l'aggiornamento delle capacità di raffreddamento a liquido diretto per supportare le prossime piattaforme NVIDIA Vera Rubin NVL72 e NVIDIA HGX Rubin NVL8. L'azienda sta posizionando questa iniziativa per ridurre i tempi di implementazione per infrastrutture di intelligenza artificiale ad alta densità, combinando la progettazione e la produzione interna con sede negli Stati Uniti con il suo approccio Data Center Building Block Solutions (DCBBS) e uno stack tecnologico end-to-end per il raffreddamento a liquido.
Charles Liang, CEO di Supermicro, ha sottolineato che la collaborazione dell'azienda con NVIDIA e la sua metodologia di progettazione basata su blocchi costitutivi mirano ad accelerare la fornitura di piattaforme di intelligenza artificiale avanzate. Ha inoltre evidenziato l'ampia presenza produttiva di Supermicro e la sua competenza nel raffreddamento a liquido come fattori chiave per implementazioni efficienti, affidabili e su larga scala dei sistemi Vera Rubin e Rubin in ambienti iperscalabili e aziendali.
Rack-Scale Flagship: NVIDIA Vera Rubin NVL72 SuperCluster
Al vertice della gamma, Supermicro supporterà NVIDIA Vera Rubin NVL72 SuperCluster. Questo sistema rack-scale integra 72 GPU NVIDIA Rubin e 36 CPU NVIDIA Vera, oltre a NVIDIA ConnectX-9 SuperNIC e DPU NVIDIA BlueField-4. La piattaforma utilizza NVIDIA NVLink 6 per la coerenza intra-rack. È progettata per scalare su NVIDIA Quantum-X800 InfiniBand e NVIDIA Spectrum-X Ethernet, in linea con l'attuale tendenza del settore verso progetti rack-as-a-system per training, inferenza e intelligenza artificiale agentica su larga scala.
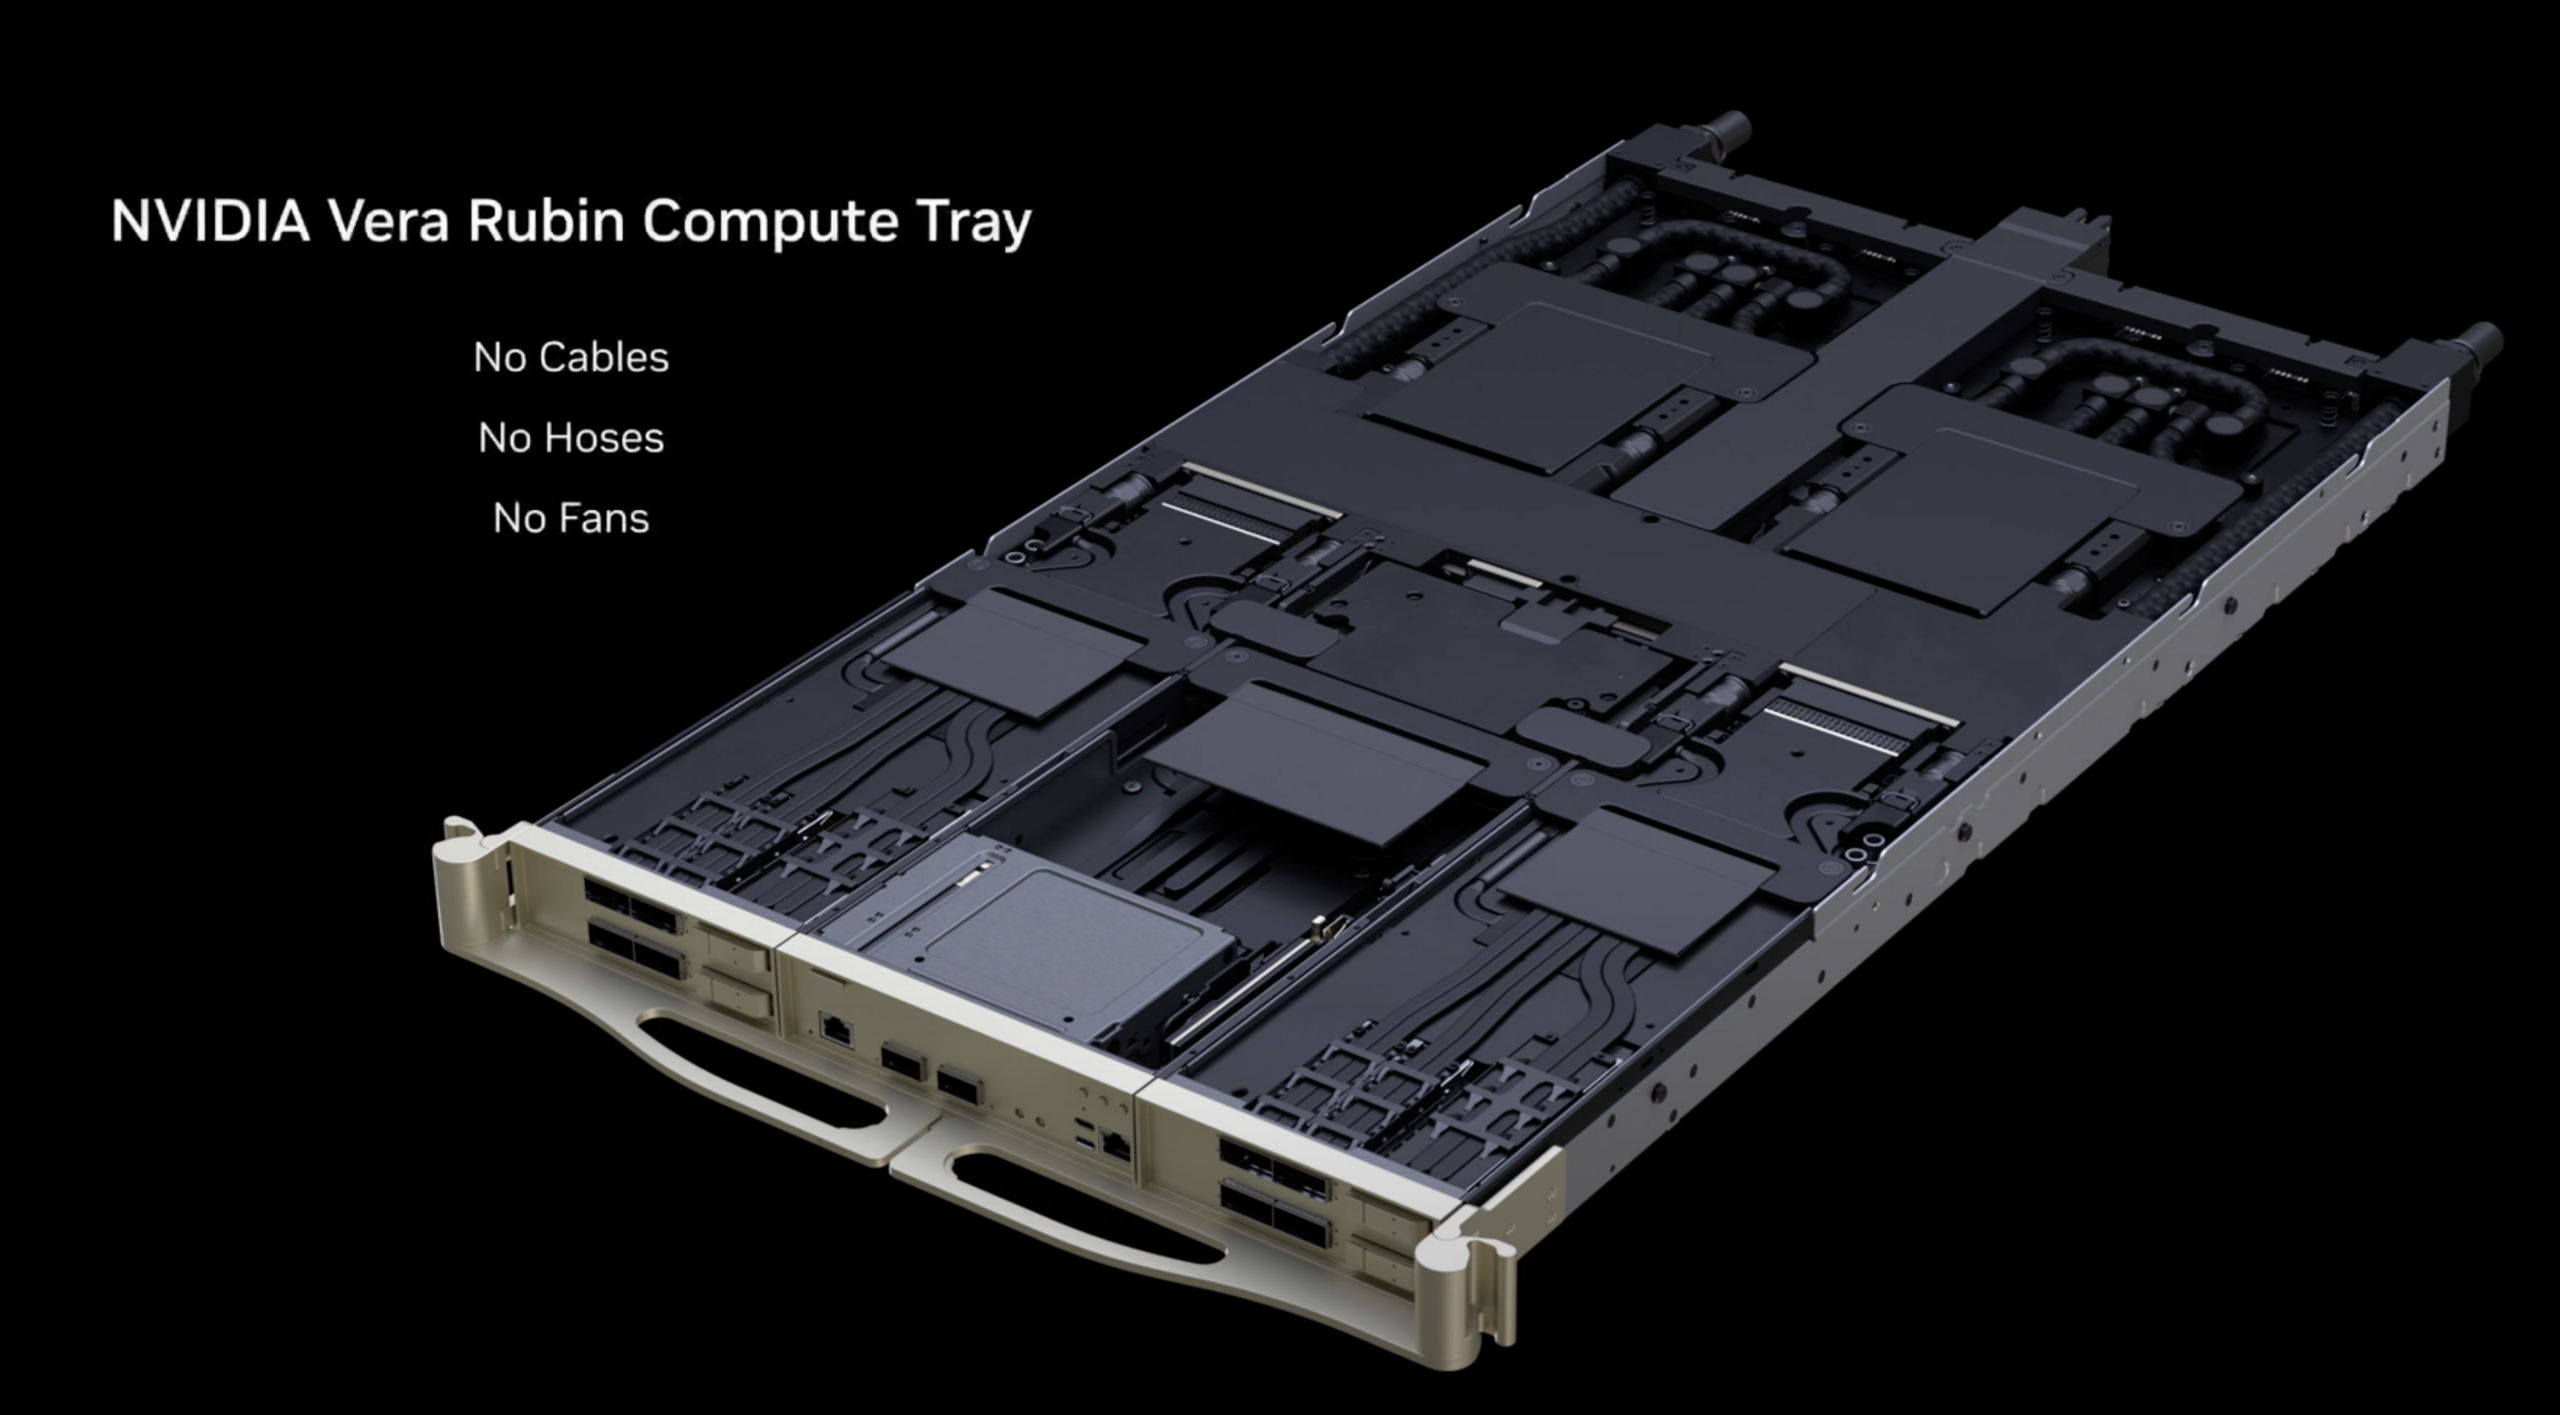
NVIDIA stima che la configurazione NVL72 offra 3.6 exaflop di prestazioni NVFP4, supportate da 1.4 PB/s di larghezza di banda HBM4 e 75 TB di memoria veloce. L'implementazione di Supermicro si basa sull'architettura rack NVIDIA MGX di terza generazione, con particolare attenzione a facilità di manutenzione, affidabilità e disponibilità per supportare operazioni cluster prolungate.
Il raffreddamento è fondamentale per la progettazione. Supermicro sta integrando uno stack di raffreddamento a liquido potenziato per data center con unità di distribuzione del refrigerante (CDU) in-row. L'obiettivo è consentire un raffreddamento ad acqua calda scalabile che riduca il consumo di energia e acqua, mantenendo al contempo densità e prestazioni prevedibili anche in presenza di carichi di lavoro di intelligenza artificiale elevati.
Elaborazione compatta e densa: NVIDIA HGX Rubin NVL8 raffreddato a liquido 2U
Per le aziende e i service provider alla ricerca di un elemento costruttivo più modulare, Supermicro ha anche evidenziato i sistemi NVIDIA HGX Rubin NVL8 2U raffreddati a liquido. Questa piattaforma a 8 GPU è pensata per carichi di lavoro AI e HPC, con NVIDIA che dichiara 400 petaflop di prestazioni NVFP4. La piattaforma è specificata con 176 TB/s di larghezza di banda HBM4 e 28.8 TB/s di larghezza di banda NVLink, con 1600 Gb/s di rete NVIDIA ConnectX-9 tramite SuperNIC.
Supermicro offre un design rack-scale pensato per preservare la flessibilità di implementazione, con opzioni di configurazione che includono CPU x86 di punta, tra cui i processori Intel Xeon e AMD EPYC di nuova generazione. L'azienda ha inoltre evidenziato un design busbar 2U ad alta densità per l'integrazione in rack, abbinato alla tecnologia di raffreddamento a liquido diretto (DLC) di Supermicro per supportare elevati inviluppi di potenza sostenuti senza compromettere la facilità di manutenzione.
Caratteristiche della piattaforma Vera Rubin
Il supporto della piattaforma Supermicro è in linea con diverse funzionalità chiave dell'era Vera Rubin che hanno un impatto diretto sulla progettazione dei cluster e sulla pianificazione operativa, tra cui:
- NVIDIA NVLink 6 è un fabric di interconnessione ad alta velocità che consente una maggiore larghezza di banda e una minore latenza per le comunicazioni GPU-GPU e CPU-GPU. Questo è particolarmente rilevante per l'addestramento e l'inferenza di modelli con un mix molto ampio di esperti, in cui i modelli di comunicazione possono prevalere sulle prestazioni su larga scala.
- La CPU NVIDIA Vera è dotata di core ARM progettati da NVIDIA e si dice che offra un aumento delle prestazioni doppio rispetto alla generazione precedente. La CPU supporta il multithreading spaziale con 88 core e 176 thread, insieme a una larghezza di banda di memoria LPDDR5X di 1.2 TB/s e una maggiore capacità di memoria. Vera aumenta anche l'accoppiamento CPU-GPU con una larghezza di banda NVLink-C2C di 1.8 TB/s per le GPU, citata come doppia rispetto alla generazione precedente.
- Il Transformer Engine di terza generazione di NVIDIA punta all'accelerazione a contesto lungo e precisione stretta, un aspetto diventato fondamentale con l'evoluzione dell'inferenza moderna verso sessioni persistenti, pipeline multi-agente e una maggiore concorrenza. La piattaforma incorpora anche il Confidential Computing di terza generazione, descritto come confidential computing su scala rack con un ambiente di esecuzione affidabile a livello di GPU unificato che protegge e isola modelli, dati e prompt. Per gli operatori che implementano l'intelligenza artificiale in flussi di lavoro regolamentati, il confidential computing e l'isolamento dei limiti di esecuzione tramite GPU sono criteri di selezione della piattaforma sempre più importanti.
- I miglioramenti dell'affidabilità sono resi possibili dal motore RAS di seconda generazione, che include un monitoraggio avanzato dello stato di salute e controlli in tempo reale per ridurre i tempi di inattività. Negli ambienti ad alta densità raffreddati a liquido, il rilevamento dei guasti e la facilità di manutenzione sono essenziali, poiché le finestre di manutenzione sono costose e la tolleranza operativa all'instabilità è bassa.
Networking: Spectrum-X Ethernet Photonics e capacità di elaborazione su rack
Supermicro ha inoltre abbinato il supporto della piattaforma Rubin alla Spectrum-X Ethernet Photonics di NVIDIA, basata sull'ASIC Ethernet Spectrum-6. NVIDIA specifica una commutazione a 102.4 Tb/s su TSMC a 3 nm, con ottiche SerDes co-confezionate da 200 G e buffer completamente condivisi.
L'obiettivo dichiarato è migliorare l'efficienza e la stabilità operativa rispetto alle tradizionali ottiche collegabili, con NVIDIA che cita un'efficienza energetica 5 volte superiore, un'affidabilità 10 volte superiore e un uptime delle applicazioni 5 volte superiore. NVIDIA ha elencato diversi modelli di switch, tra cui l'SN6800 raffreddato a liquido (CPO da 409.6 Tb/s con 512 porte 800G), l'SN6810 (CPO da 102.4 Tb/s con 128 porte 800G) e l'SN6600 (ottica collegabile, 128 porte 800G, disponibile in configurazioni con raffreddamento ad aria o a liquido). Per gli operatori di data center, questi progetti puntano verso fabric Ethernet 800G a densità più elevata con caratteristiche termiche e di potenza migliorate, un aspetto sempre più rilevante poiché la potenza di rete front-end sta diventando una parte misurabile dei budget per i rack.
Integrazione di storage per fabbriche di intelligenza artificiale
Per quanto riguarda lo storage, Supermicro ha evidenziato soluzioni complementari basate sui suoi server di storage all-flash petascale e sui sistemi JBOF. Queste piattaforme supportano le DPU NVIDIA BlueField-4 e una gamma di soluzioni di gestione dei dati, allineando storage e networking con la stessa architettura accelerata su scala rack utilizzata dal livello di elaborazione.
Sebbene Supermicro non abbia fornito dati sulle prestazioni delle piattaforme di storage in questo annuncio, l'enfasi sull'integrazione segnala un continuo passaggio verso progetti full-stack convalidati in cui elaborazione, rete e storage sono qualificati insieme per le implementazioni di fabbriche AI.
Scala di produzione e tempo di messa in linea
Il tema operativo dell'annuncio è la produttività e la velocità di distribuzione. Gli impianti ampliati di Supermicro e lo stack di raffreddamento a liquido sono progettati per semplificare la produzione e la consegna delle piattaforme Vera Rubin e Rubin completamente raffreddate a liquido. Allo stesso tempo, l'architettura DCBBS modulare consente una rapida configurazione, convalida e scalabilità. Per gli acquirenti tecnici aziendali, il fattore differenziante non è tanto la specifica di un singolo chassis quanto piuttosto la consegna prevedibile, la ripetibilità delle build dei rack e la riduzione dei tempi dalla ricezione delle apparecchiature alla messa in servizio di produzione stabile.
Supermicro scommette che, poiché il raffreddamento a liquido diventerà la soluzione predefinita per la densità di intelligenza artificiale di alto livello, i fornitori in grado di industrializzare la produzione e la convalida su scala rack saranno nella posizione migliore per supportare implementazioni su larga scala senza cicli di integrazione estesi.


 Amazon