

Supermicro ha annunciato oggi, in collaborazione con IBM e NVIDIA, una soluzione di storage con cache KV che sposta lo stato chiave-valore alla base dell'inferenza di contesto lungo dalla GPU a un livello condiviso interamente basato su memoria flash. Il pacchetto combina server di storage Supermicro Petascale su processori AMD EPYC 9005, IBM Storage Scale, NVIDIA Dynamo e NVIDIA Spectrum-X Ethernet, e le aziende lo supportano con un'architettura di riferimento validata, pubblicata da IBM come Redbook. Il dato più rilevante è una riduzione di 56 volte del tempo necessario per ottenere il primo token su 130,000 richieste di token, utilizzando una GPU che ricalcola il contesto da zero.
Perché KV Cache ha bisogno di un livello di archiviazione
L'inferenza si svolge in due fasi: la fase di pre-riempimento trasforma il prompt in token e li elabora attraverso il modello per produrre gli stati chiave-valore intermedi, mentre la fase di decodifica genera la risposta un token alla volta in base a tali stati. Mantenere lo stato chiave-valore in una cache persistente consente al sistema di riutilizzarlo per il turno successivo, il passo successivo dell'agente o la richiesta successiva che condivide lo stesso contesto, evitando di dover ricalcolare tutto.
I flussi di lavoro agentici, gli assistenti di programmazione, il RAG a contesto lungo e le applicazioni multi-turno generano una quantità sufficiente di questo stato da sovraccaricare rapidamente la memoria di GPU e CPU, motivo per cui Supermicro, IBM e NVIDIA stanno creando un livello di archiviazione di rete.
In questa architettura, NVIDIA Dynamo gestisce la gerarchia della cache e trasferisce i blocchi tramite NIXL; IBM Storage Scale Erasure Code Edition fornisce il livello di file condiviso; e i server Petascale forniscono la memoria flash e le linee PCIe Gen5 sottostanti. Supermicro afferma che le tre aziende hanno testato lo stack a livello di cluster in condizioni di elevata concorrenza e con traffico di rete "rumoroso" (noisy neighbor), e propone il risultato come una soluzione chiavi in mano con integrazione in rack di fabbrica e implementazione in loco che, a suo dire, riduce i tempi di implementazione da settimane a giorni.
La configurazione testata
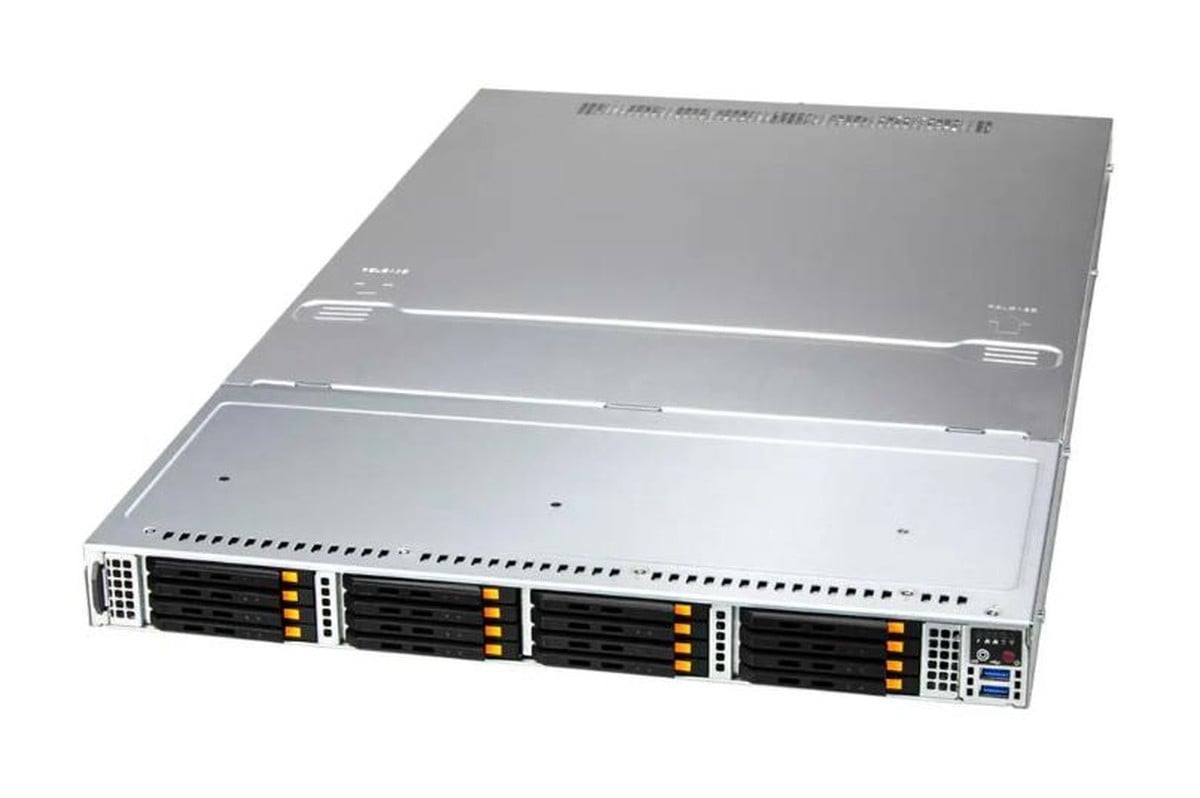
L'architettura di riferimento utilizza otto nodi Supermicro ASG-1115S-NE316R Petascale, ciascuno un sistema 1U con un singolo AMD EPYC 9535 e 16 unità NVMe Micron E3.S da 7.68 TB, per un totale di 122.88 TB di memoria flash grezza in ciascun nodo e circa 983 TB complessivi sugli otto nodi. Ogni nodo è dotato di una scheda NVIDIA BlueField-3 B3220 a doppia porta da 200 Gb sul lato client e di una ConnectX-7 da 400 Gb per il backend di storage, con tre switch Spectrum-X SN5600 in configurazione spine-and-leaf e uplink da 800 Gb/s.
I nodi di storage eseguono RHEL 9.6 e IBM Storage Scale ECE 6.0.0.1 in una configurazione di codifica di cancellazione 8+2P, e IBM stima una velocità di lettura di questo livello a otto nodi pari a 315 GB/s, secondo test precedenti.
| Componente | Architettura di riferimento della cache KV (come testata) |
|---|---|
| Livello di archiviazione | |
| Nodi di archiviazione | 8x Supermicro ASG-1115S-NE316R (1U, singolo socket) |
| CPU per nodo | AMD EPYC 9535, 128 linee PCIe Gen5 (64 per NVMe, 64 per la rete) |
| Flash per nodo | 16 SSD Micron E3.S NVMe da 7.68 TB (122.88 TB grezzi) |
| Rete per nodo | NVIDIA BlueField-3 B3220, doppia porta da 200 Gb (lato client) NVIDIA ConnectX-7 400 GB (backend di archiviazione) |
| Commutazione | 3x NVIDIA Spectrum-X SN5600, spine e leaf, uplink da 800 Gb/s |
| Software di archiviazione | IBM Storage Scale Erasure Code Edition 6.0.0.1, 8+2P RHEL 9.6 |
| Inference Client | |
| Sistema | Supermicro SYS-212GB-FNR (NVIDIA MGX), Ubuntu 24.04 |
| GPU utilizzata per i benchmark | 1x NVIDIA RTX PRO 6000 Blackwell, 19.6 GiB rimanenti per la cache KV dopo i pesi e i grafici CUDA |
| Rete clienti | 2x NVIDIA BlueField-3 B3140H 400 Gb/s, fino a 80 GB/s di larghezza di banda lato client. |
| Modello e software | openai/gpt-oss-120b (MXFP4) vLLM 0.14.1 NVIDIA Dynamo 0.9.0 con NIXL Client di benchmark NVIDIA AIPef |
| Livelli della cache | I livelli host e locale sono impostati a zero; tutti gli 1.4 milioni di token memorizzati nella cache vengono forniti dal livello Storage Scale. |
Il client di benchmark è un singolo sistema Supermicro SYS-212GB-FNR MGX e i risultati provengono da una GPU NVIDIA RTX PRO 6000 Blackwell presente in tale sistema, che esegue il modello openai/gpt-oss-120b in MXFP4 con vLLM 0.14.1 e Dynamo 0.9.0.
Dopo i pesi e i grafici CUDA, sono rimasti 19.6 GiB di memoria GPU per la cache KV, sufficienti per circa 1.14 milioni di token sulla GPU stessa. Per i test, la memoria host e i livelli locali sono stati impostati a zero in modo che ogni blocco memorizzato nella cache provenisse da Storage Scale, quindi i risultati misurano il percorso di archiviazione da solo, senza l'aiuto di una gerarchia mista.
56 volte il tempo di generazione del primo token, 22 volte la velocità di elaborazione.
Senza cache, il tempo per il primo token per il modello 120B è aumentato da 0.572 secondi con 10,000 token di input a 32.14 secondi con 130,000, poiché la GPU ha ricalcolato l'intero contesto. Con la cache KV su Storage Scale, il TTFT è rimasto tra 0.193 e 0.57 secondi nello stesso intervallo, che corrisponde al valore di 56x al traguardo dei 130,000 token e alla differenza di 0.377 secondi citata da Supermicro nel suo annuncio. IBM, Supermicro e NVIDIA hanno eseguito questi test e noi non abbiamo eseguito né verificato i risultati.
Il test di throughput ha inviato 200 richieste su 28 connessioni simultanee, estratte da 100 prompt unici per un totale di 24 milioni di token e 825 GB di dati nella cache KV, con la cache inizialmente vuota. Il test di ricalcolo di base ha completato 0.19 richieste al secondo in 1,048 secondi; il livello Storage Scale ha completato 4.26 richieste al secondo in 46.94 secondi, un guadagno di 22 volte che include il costo di avvio a freddo per il riempimento della cache.
Una terza esecuzione ha aggiunto quattro client che inviavano 200 GB/s di traffico di rete non correlato attraverso la stessa infrastruttura, e la configurazione con cache ha gestito 3.6 richieste al secondo e 55.56 secondi per le 200 richieste, circa nove secondi più lento rispetto all'esecuzione senza cache e comunque 18 volte superiore al valore di riferimento. IBM attribuisce il piccolo aumento di prestazioni all'infrastruttura Spectrum-X che isola il traffico della cache dal carico di background.
"L'IA agente e le applicazioni a contesto lungo dipendono dal riutilizzo efficiente del contesto in più fasi, e NVIDIA Dynamo aiuta a orchestrare l'inferenza distribuita in modo che le aziende possano ottenere una maggiore velocità di elaborazione utilizzabile da ogni GPU", ha affermato Shruti Koparkar, NVIDIA AI Inference Product Lead. "Combinando NVIDIA Dynamo e Spectrum-X Ethernet con i server di storage Supermicro Petascale e IBM Storage Scale, questa soluzione di cache KV crea un livello di storage condiviso ad alte prestazioni in grado di ridurre i calcoli ridondanti, migliorare il time-to-first-token e aiutare i clienti a scalare servizi di inferenza AI resilienti."
Dimensionamento e ciò che non è racchiuso nei numeri
La guida al dimensionamento di IBM indica una configurazione a quattro nodi con 4+2P e il 67% di capacità utilizzabile per modelli da 7 a 34 miliardi di bit e fino a 64 GPU, la configurazione a otto nodi testata con 8+2P e l'80% di utilizzabile per modelli da 70 a 120 miliardi di bit e da 100 a 256 GPU che richiedono una larghezza di banda di lettura da 100 a 300 GB/s, e 16 o più nodi con 16+3P e l'84% di utilizzabile per modelli più grandi e 300 o più GPU a 300 GB/s e oltre. La scalabilità dello storage ECE stesso è scalabile da tre server di storage a 256.
La principale limitazione risiede nella configurazione di test a singola GPU. L'architettura di riferimento è dimensionata per centinaia di GPU, ma tutti i risultati riportati nel documento provengono da una singola RTX PRO 6000 confrontata con un livello di memoria flash a otto nodi da 983 TB, che IBM valuta a 315 GB/s. Pertanto, il carico di archiviazione era ben lontano dalla saturazione e i test non mostrano come si comporta il TTFT quando un cluster completo di GPU accede simultaneamente alla cache.
Supermicro non ha pubblicato né i prezzi né la data di disponibilità della soluzione preconfezionata, e l'annuncio non fornisce dati sull'utilizzo della GPU. L'approccio si colloca nello stesso ambito dell'accelerazione della cache KV integrata in Dynamo di DDN sull'AI400X3M , con la differenza che questa soluzione funziona su server Supermicro standard e con Ethernet, utilizzando il file system di IBM.
"Con l'espansione dei carichi di lavoro di IA dall'addestramento all'inferenza, le aziende e le piattaforme neocloud che implementano carichi di lavoro di inferenza ad alto throughput caratteristici dell'IA agentiva e dell'IA generativa multi-turno a lungo contesto devono eliminare i colli di bottiglia per migliorare l'efficienza delle GPU", ha affermato Charles Liang, presidente e CEO di Supermicro. "La nostra soluzione con IBM e NVIDIA dimostra chiaramente questi vantaggi in termini di prestazioni."



 Amazon