

VAST Data ha ampliato la sua collaborazione con AMD in ambito di infrastrutture AI per provider di servizi cloud e aziende che implementano servizi di addestramento, inferenza, generazione aumentata per il recupero di informazioni e intelligenza artificiale agentiva. Questa iniziativa combina il sistema operativo VAST AI con processori AMD EPYC di sesta generazione , GPU AMD Instinct, hardware di rete AMD e software ROCm.
La collaborazione riflette un più ampio cambiamento infrastrutturale che sta passando da cluster di IA focalizzati sull'addestramento ad ambienti che devono supportare anche il contesto persistente, l'inferenza ad alta concorrenza e i flussi di lavoro degli agenti a più turni. Queste implementazioni pongono maggiore enfasi sul trasferimento dei dati, sulla gestione della cache KV, sull'utilizzo delle GPU e sulla capacità di fornire accesso a bassa latenza a grandi set di dati di modelli e contesti.
VAST posiziona la sua architettura Disaggregated Shared Everything (DASE ) come livello dati condiviso per questi ambienti. La piattaforma combina archiviazione di file e oggetti, database, streaming di eventi e servizi dati sotto un namespace globale unificato. Offre inoltre funzionalità di multi-tenancy e isolamento dei carichi di lavoro per i cloud di intelligenza artificiale che gestiscono carichi di lavoro simultanei di clienti e applicazioni.
Piattaforme EPYC 9006 per sistemi VAST CBox ed EBox
VAST ha scelto i processori AMD EPYC di sesta generazione, precedentemente noti con il nome in codice Venice, per le sue piattaforme CBox ed EBox di nuova generazione. L'azienda prevede di utilizzare questi processori nei sistemi CBox di sesta generazione ed EBox di terza generazione, che sono alla base del sistema operativo VAST AI.
Il supporto per AMD EPYC 9006 introduce la connettività PCIe Gen6 nella piattaforma hardware VAST. VAST afferma che la nuova interfaccia raddoppia la larghezza di banda I/O generazionale, migliorando il throughput di archiviazione di file e oggetti e riducendo la latenza per i servizi dati come database, data warehouse e carichi di lavoro di streaming di eventi forniti tramite VAST DataBase e DataEngine.
Per le infrastrutture di intelligenza artificiale, una maggiore larghezza di banda I/O può contribuire a ridurre i colli di bottiglia tra risorse di calcolo, di rete e di archiviazione NVMe. Ciò è particolarmente rilevante per il caricamento dei modelli, le pipeline di recupero, l'accesso ai checkpoint e i flussi di lavoro con cache KV esternalizzate, dove la sola capacità di memoria della GPU non è sufficiente a mantenere il contesto attivo.
Architettura di riferimento che combina Helios, VAST e DriveNets
VAST, AMD e DriveNets stanno inoltre sviluppando un'architettura di riferimento per l'infrastruttura AI basata sull'infrastruttura AI su rack AMD Helios, sul sistema operativo AI di VAST e sulla rete AI Fabric di DriveNets.

L'architettura di riferimento ha lo scopo di fornire linee guida per l'implementazione di carichi di lavoro di addestramento di modelli, inferenza, apprendimento per rinforzo e cache KV. Include considerazioni sul dimensionamento e sulla disponibilità per le organizzazioni che creano "fabbriche di IA" che richiedono infrastrutture dati condivise e reti ad alte prestazioni, oltre al calcolo GPU.
VAST ha inoltre citato una maggiore collaborazione con i fornitori di software di inferenza TensorMesh e EmbeddedLLM. L'impegno dell'ecosistema si concentra sulle architetture di inferenza per applicazioni di intelligenza artificiale agentiva, sebbene non siano stati divulgati dettagli specifici sulle integrazioni dei prodotti e sulla loro disponibilità.
L'offload della cache KV mira all'inferenza ad alta concorrenza
Un elemento centrale dell'annuncio è il supporto ampliato per la cache KV tramite GPU AMD Instinct , AMD Infinity Context, il software ROCm e il sistema operativo VAST AI.
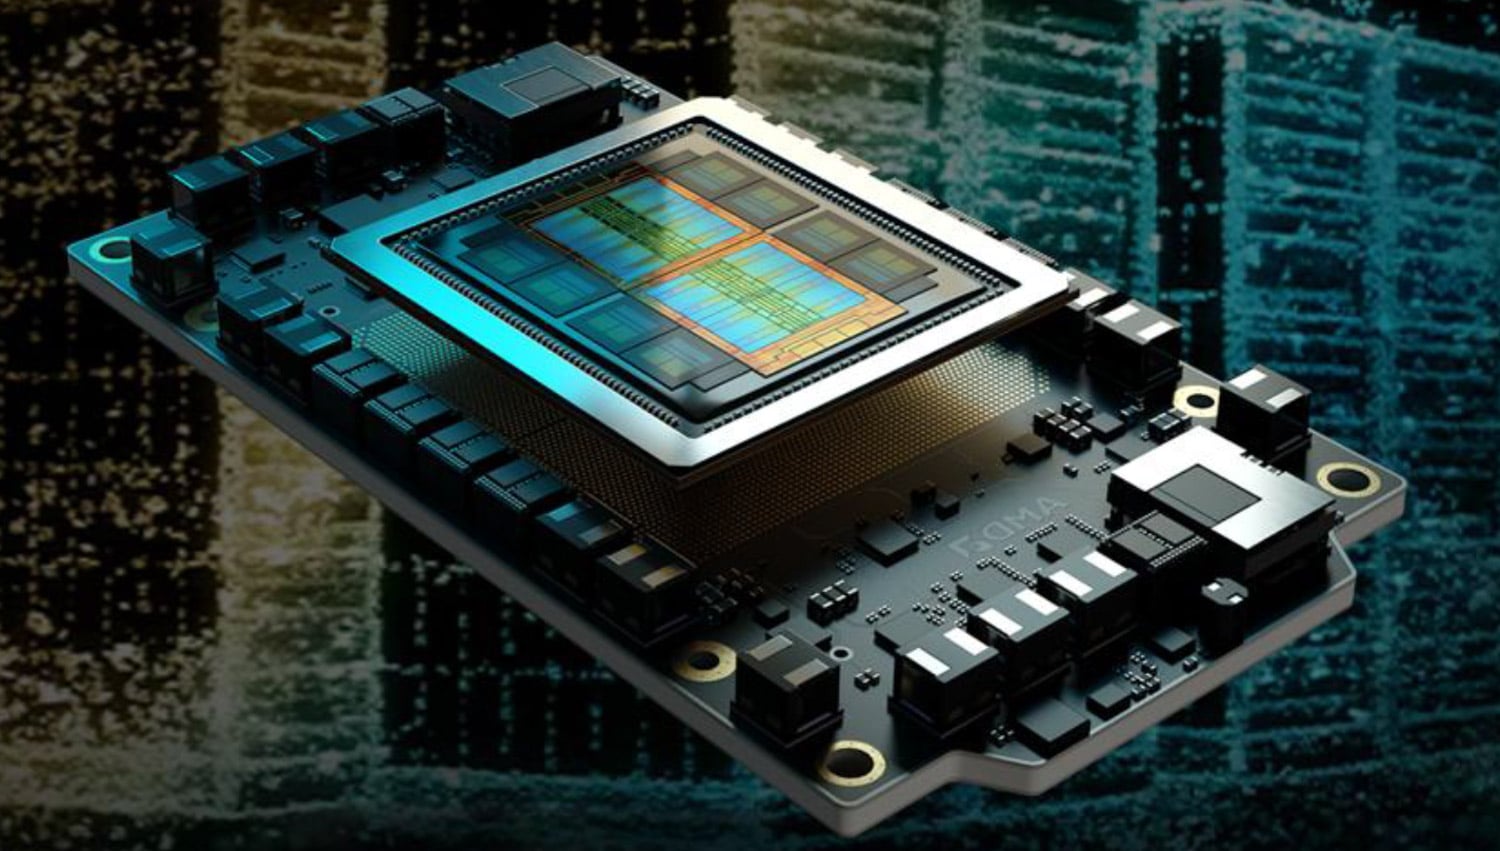
I dati della cache KV memorizzano le informazioni intermedie sullo stato di attenzione generate durante l'inferenza. Conservare questi dati migliora le prestazioni per le interazioni multi-turno e i carichi di lavoro a lungo termine, ma le grandi dimensioni della cache possono consumare una quantità significativa di memoria GPU. Esternalizzare o spostare la cache KV su una piattaforma di archiviazione ad alte prestazioni può liberare memoria GPU per i carichi di lavoro attivi, mantenendo al contempo il contesto per le successive richieste di inferenza.
VAST ha riportato i primi test con una GPU AMD Instinct MI355X che hanno mostrato un miglioramento di 9 volte nel tempo di generazione del primo token e un throughput dei token superiore di 9.7 volte quando si utilizza VAST per l'offload della cache KV in carichi di lavoro di intelligenza artificiale agentica ad alta concorrenza. L'azienda ha sottolineato che questi risultati dipendono dalla configurazione hardware di base, dalle caratteristiche del carico di lavoro e dalla configurazione dello storage.
L'integrazione applica anche le policy del ciclo di vita VAST ai dati della cache KV. Questa funzionalità ha lo scopo di far scadere ed eliminare automaticamente le informazioni memorizzate nella cache, il che risulta rilevante quando il contesto di inferenza contiene dati sensibili, personali o soggetti a normative specifiche.
Pensando Pollara 400 collega le GPU allo storage condiviso
L'architettura utilizza la scheda di rete AMD Pensando Pollara 400 AI per connettere le GPU AMD Instinct al cluster di storage VAST. Secondo VAST, la scheda di rete supporta il trasferimento dati dalla GPU allo storage tramite NFS su TCP e RDMA, consentendo l'accesso ai cluster VAST basati su SSD NVMe per la cache KV e per esigenze di dati di inferenza più ampie.
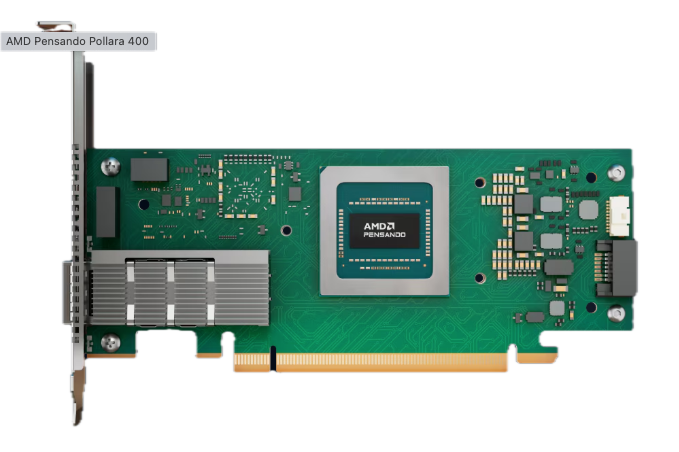
Il design risultante è pensato per supportare ambienti di intelligenza artificiale che necessitano di scalare la gestione del contesto indipendentemente dalla memoria GPU. Anziché trattare lo storage come un livello di persistenza separato, VAST posiziona la piattaforma come un livello di dati ed esecuzione in grado di gestire modelli, database, dati in streaming, dati di file e contesto di intelligenza artificiale su infrastrutture distribuite.
Per i fornitori di servizi cloud per l'IA, l'approccio mira a un maggiore utilizzo delle GPU e a una migliore efficienza operativa, man mano che le implementazioni si evolvono dal noleggio di GPU e dall'addestramento batch verso l'inferenza persistente e i servizi di IA agentiva.


 Amazon