

La AMD Instinct MI350P è la prima nuova GPU PCIe Instinct di AMD in quattro anni, dopo la MI210 del 2022. Porta l'architettura CDNA 4 dell'azienda su una scheda di espansione convenzionale, con prestazioni MXFP4 fino a 4.6 PFLOPS, 144 GB di HBM3E e una larghezza di banda di memoria di 4 TB/s. Il tutto racchiuso in una scheda a doppio slot con raffreddamento ad aria da 600 W, offrendo ai clienti un'ulteriore soluzione per implementare le GPU Instinct senza dover ricorrere alla piattaforma OAM MI350/5X a 8 GPU.
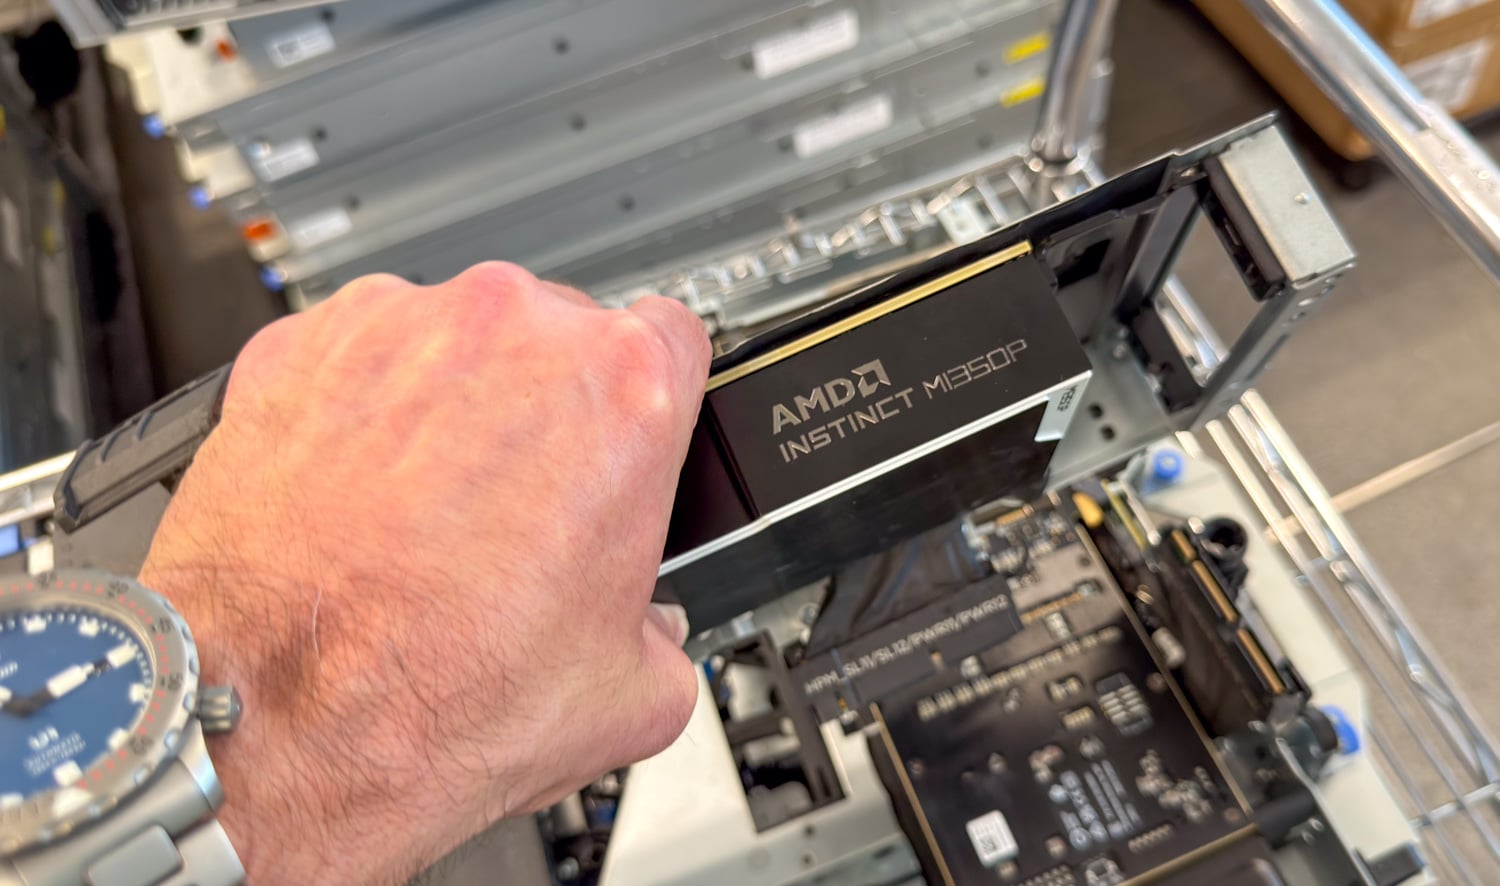
Punti chiave
- La novità principale è la possibilità di installare 144 GB in uno slot PCIe. La MI350P vanta la maggiore quantità di memoria tra tutti gli acceleratori PCIe attualmente in commercio, 3 GB in più rispetto alla H200 NVL e 48 GB in più rispetto alla RTX PRO 6000 Blackwell, con una velocità di trasferimento dati HBM3E di 4 TB/s. Dieci delle quattordici combinazioni di modelli e precisione testate in questa recensione sono state eseguite su una singola scheda.
- Sono state misurate le aree di calcolo tra le due schede NVIDIA. A 450 W, MAMF ha raggiunto 580 TFLOPS in BF16, 1,120 in FP8 e 2,228 in FP4 a blocchi scalati, dal 36 al 38% in più rispetto a una RTX PRO 6000 da 600 W a ogni precisione e dietro alla H200 NVL in BF16 e FP8, che non ha un percorso FP4.
- GPT-OSS è il risultato migliore ottenuto dal MI350P. Su AMDGPU 31.60, ROCm 10.1.0 e vLLM 0.32.0, GPT-OSS-120B ha raggiunto 5,057 token di output al secondo con 128 flussi sul carico di lavoro della chat, il 65% in più rispetto alla RTX PRO 6000 e il 50% in più rispetto alla H200 NVL, e la curva continua a salire attraverso 128 flussi su entrambe le forme di prompt.
- I messaggi di testo di breve durata favoriscono il MI350P; i messaggi di testo lunghi, invece, danno risultati contrastanti. Su prompt da 512 token, la scheda supera la RTX PRO 6000 su ogni modello FP8, BF16 e GPT-OSS dal 35 al 65 percento a 128 stream, e i due confronti FP4 contro NVFP4 sono entro il 5 e il 21 percento, mentre su prompt da 8,192 token è in vantaggio su GPT-OSS e Mistral Small e in svantaggio su Llama, Qwen FP8 e MiniMax-M2.7, dove la sua curva si appiattisce presto.
- I risultati delle due carte sono disponibili su ROCm 7.2.3. DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2, and GLM-5.3 Flash are reported from runs on that stack, because the ROCm 10.1 passes on those models used CPU expert offload and, on DeepSeek, a speculative decoder the NVIDIA runs did not.
- 600W è ancora un punto interrogativo. Dell documenta l'utilizzo di otto MI350P a 600W nel PowerEdge XE7745 ed è previsto un test successivo a piena potenza.
AMD ha inoltre presentato l'MI350P all'IFA 2026 nel suo prototipo Threadripper Halo Station, dove gli stessi acceleratori erano raffreddati a liquido. Il concept della workstation supporta fino a quattro MI350P insieme a un processore Threadripper PRO a 96 core, fornendo una capacità HBM3E aggregata di 576 GB in un'unica macchina; la pagina del prodotto AMD, aggiornata a ottobre, ora indica che il sistema sarà disponibile nel 2027. Questo ci offre due modi di considerare l'MI350P: come un acceleratore PCIe per server e come elemento costitutivo di un sistema AI desktop più ampio, in competizione con macchine come la GB300 DGX Station.
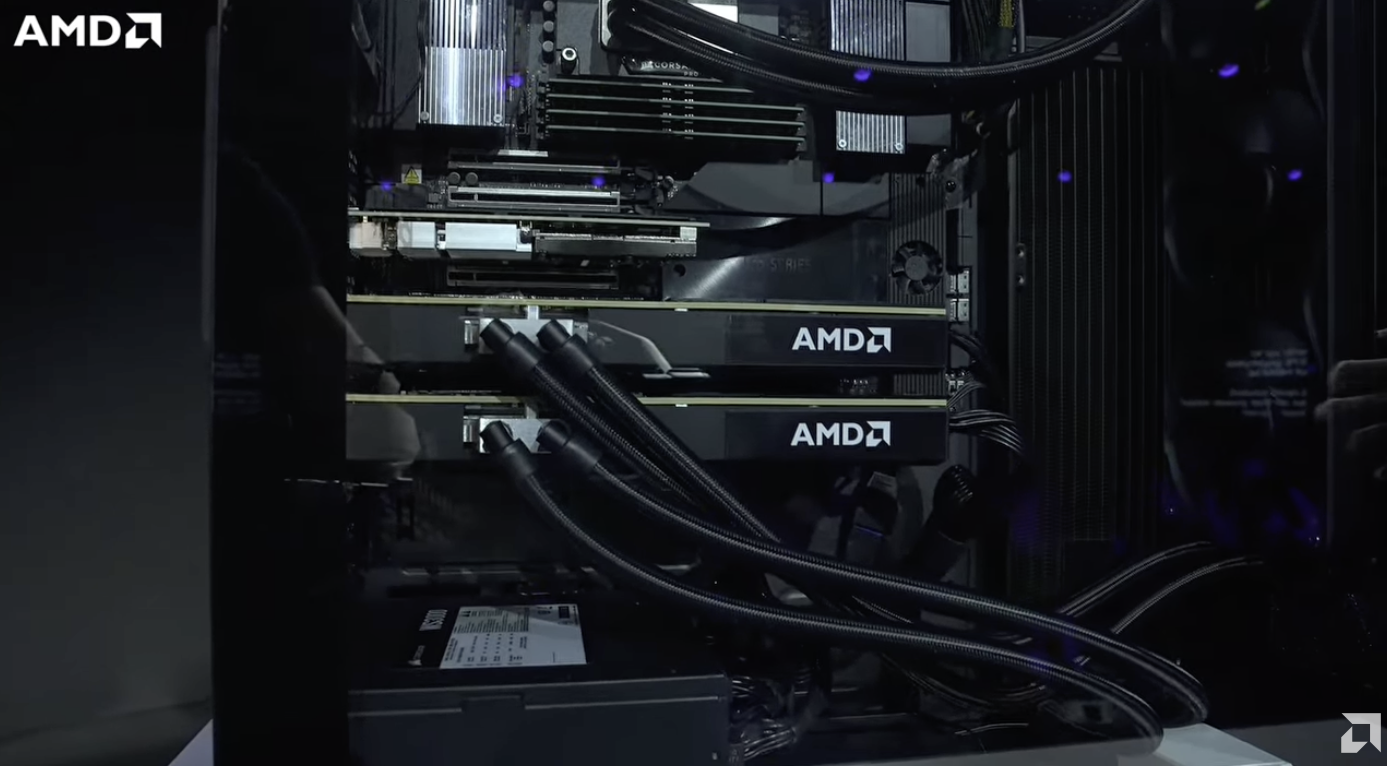
Questa prima analisi si concentra sul contesto server, quindi il confronto rilevante per un acquirente che necessita di un acceleratore PCIe è con la NVIDIA RTX PRO 6000 Blackwell, la scheda che si colloca nella stessa classe di potenza e negli stessi slot, mentre la H200 NVL è presente nelle classifiche come la scheda aggiuntiva NVIDIA più performante per i carichi di lavoro in cui la larghezza di banda della memoria è determinante. Una singola GB300 DGX Station funge da esempio per l'ambiente desktop; si tratta di una macchina di classe diversa, con un prezzo differente, ed è presente per mostrare quanto una GPU Blackwell Ultra completa si posizioni al di sopra di qualsiasi scheda PCIe.
Specifiche del processore AMD Instinct MI350P
I dati pubblicati da AMD indicano che il punto di forza della MI350P risiede nella bassa precisione: 4.6 PFLOPS a MXFP4 e MXFP6, 2.3 PFLOPS a FP8 e 1.15 PFLOPS a FP16 o BF16, tutti valori elevati. L'altra metà della scheda è costituita dal sistema di memoria: 144 GB di HBM3E su un'interfaccia a 4,096 bit a 4 TB/s, dietro una Infinity Cache da 128 MB, su cui si basano i risultati single-stream riportati di seguito. L'alimentazione della scheda è di 600 W con una modalità configurabile a 450 W; l'unità in prova funzionava a 450 W.
La MI350P utilizza la stessa architettura CDNA 4 delle GPU MI350/5X, più grandi e potenti. La MI350P può essere considerata a tutti gli effetti la metà di una MI350X. Per comprenderne il motivo, è utile esaminare la struttura della GPU più grande.
La MI350X è un'architettura a chiplet impilati in 3D, basata sul packaging CoWoS (Chip-on-Wafer-on-Substrate) di TSMC, senza un singolo die monolitico. Otto die di accelerazione, o XCD (Xaccelerator Complex Die), si trovano sopra due die di I/O, con quattro XCD su ciascun die di I/O. La tecnologia Infinity Fabric di AMD collega i chiplet, mentre otto stack HBM3E forniscono la memoria della GPU. CoWoS descrive l'integrazione a livello di package; la configurazione "compute-over-I/O" rappresenta la componente verticale e impilata in 3D del design.

La MI350P adotta metà di tale configurazione: quattro XCD, un die I/O e quattro stack HBM3E. Ogni XCD dispone di 32 unità di calcolo attive, per un totale di 128 CU rispetto alle 256 della MI350X. Anche le risorse di memoria sono dimezzate: 144 GB di HBM3E contro 288 GB, 4 TB/s di larghezza di banda contro 8 TB/s e 128 MB di Infinity Cache contro 256 MB.

| Specificazione | AMD Instinct MI350P |
|---|---|
| Panoramica della piattaforma | |
| Architettura | CDNA 4 |
| Unità di calcolo | 128 |
| Processori di streaming | 8,192 |
| Nuclei della matrice | 512 |
| Processo | TSMC 3nm e 6nm |
| Transistor | 73 miliardi |
| Orologio motore di picco | 2,200MHz |
| Memorie | |
| Ultra-Grande | 144 GB HBM3E |
| Interfaccia | 4,096-bit |
| Larghezza di banda | 4 TB/s |
| Cache dell'ultimo livello | 128MB |
| ECC | Chip completo |
| Prestazioni ottimali (dichiarate da AMD) | |
| MXFP4 | 4.6 PFLOP |
| MXFP6 | 4.6 PFLOP |
| MXFP8 | 2.3 PFLOP |
| OCP FP8 | 2.3 PFLOPS; 4.6 PFLOPS con sparsità strutturata |
| FP16 | 1.15 PFLOPS; 2.3 PFLOPS con sparsità |
| BF16 | 1.15 PFLOPS; 2.3 PFLOPS con sparsità |
| FP32 | 72 TFLOPS |
| FP64 | 36 TFLOPS |
| Alimentazione, raffreddamento e fattore di forma | |
| Tipica potenza di bordo | 600 W massimo; 450 W configurabile |
| Connettore di alimentazione | 12V-2×6 |
| Raffreddamento | Passivo |
| Fattore di forma | Scheda di espansione PCIe, altezza standard, doppio slot |
| Lunghezza della tavola | 10.5 pollici (267 mm) |
| Interfaccia host | PCIe 5.0 x16 |
| Caratteristiche | |
| SR-IOV | Si |
| Infinito Cache | Si |
| RAS | Si |
| Ritiro delle pagine ed evitamento | Si |
Il valore di 600W è massimo e AMD consente di configurare la scheda fino a 450W, potenza a cui ha funzionato nel nostro host 2U. L'H200 NVL ha raggiunto gli stessi valori di 450W nell'R770, ma la RTX PRO 6000 ha funzionato a pieno regime (600W) nell'XE7740, quindi la scheda NVIDIA aveva 150W in più a disposizione in ogni confronto. I risultati a piena potenza saranno disponibili solo con un case in grado di raffreddare una scheda passiva da 600W, e la guida tecnica del Dell XE7745 elenca otto MI350P a 600W.
Un'altra caratteristica da notare: il singolo connettore 12V-2×6 e la scheda a doppio slot da 10.5 pollici, che permette di installare la scheda negli stessi riser attualmente utilizzati per schede come la RTX PRO 6000 o la H200 NVL.

La tabella seguente mette a confronto il MI350P con i tre sistemi NVIDIA presenti nei nostri grafici: la RTX PRO 6000 Blackwell Server Edition, con cui condivide lo slot, l'intervallo di alimentazione e il collegamento host PCIe 5.0 x16; la H200 NVL, la scheda Hopper con la larghezza di banda di memoria corrispondente; e la GB300 DGX Station, una singola GPU Blackwell Ultra abbinata a una CPU Grace tramite NVLink-C2C.
Le righe da leggere per prime sono la capacità di memoria, dove i 144 GB della MI350P rappresentano il valore più alto tra le tre schede PCIe, 3 GB in più rispetto alla H200 NVL e 48 GB in più rispetto alla RTX PRO 6000; la larghezza di banda della memoria, dove i suoi 4 TB/s si collocano tra le due; e la riga FP4, dove AMD dichiara un valore denso e NVIDIA un valore sparso.
| Specificazione | AMD Instinct MI350P | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA H200 NVL PCIe | Stazione NVIDIA GB300 DGX |
|---|---|---|---|---|
| Architettura GPU | CDNA 4 | Blackwell | Hopper | Ultrasottile |
| Fattore di forma | acceleratore PCIe | acceleratore PCIe | acceleratore PCIe | Una GPU Blackwell Ultra abbinata a una CPU Grace a 72 core. |
| Memoria della GPU | 144 GB HBM3E | 96 GB GDDR7 ECC | 141 GB HBM3E | 252 GB HBM3E |
| Larghezza di banda della memoria GPU | 4 TB/s | 1.6 TB/s | 4.8 TB/s | 7.1 TB/s |
| FP4 | 4.6 PFLOPS MXFP4 (Dense) | 4 PFLOPS NVFP4 (sparso) | Nessun formato FP4 nativo | 20 PFLOPS NVFP4 (sparso) |
| FP8 | 2.3 PFLOPS (denso) | 2 PFLOPS (Sparsi) | 3.3 PFLOPS (Sparsi) | 10 PFLOPS (Sparsi) |
| BF16 | 1.15 PFLOPS (denso) | 1 PFLOPS (Sparsi) | 1.6 PFLOPS (Sparsi) | 5 PFLOPS (Sparsi) |
| FP32 | 72 TFLOPS (denso) | 120 TFLOPS (sparso) | 60 TFLOPS (sparso) | 80 TFLOPS (sparso) |
| Connessione host | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | NVLink-C2C tra Grace e GPU, 900 GB/s (BiDi) |
| Connettività multi-GPU | basato su PCIe | basato su PCIe | NVLink a due o quattro vie, fino a 900 GB/s per GPU (BiDi) | Rete ConnectX-8 a 800 Gb/s tra le stazioni |
| Potenza | 450-600 W configurabile | 300-600 W configurabile | 450-600 W configurabile | GPU fino a 1200 W con oscillazione di potenza |
Rispetto alla RTX PRO 6000, la differenza più evidente del MI350P risiede nel sottosistema di memoria. Dispone del 50% di memoria GPU in più e di una larghezza di banda circa 2.5 volte superiore. Per un modello che non rientra comodamente nei 96 GB, la maggiore capacità potrebbe determinare se la potenza di calcolo debba essere distribuita su una singola GPU o su più GPU.
La RTX PRO 6000, tuttavia, è in grado di gestire una gamma più ampia di carichi di lavoro, grazie all'hardware dedicato a grafica, ray tracing e video, oltre alle sue capacità di intelligenza artificiale. La scelta non si basa solo sui valori di potenza di calcolo di picco, ma dipende anche da cos'altro il sistema deve fare.
Tra gli acceleratori PCIe ad alta capacità di memoria, l'H200 NVL rappresenta il confronto più diretto con l'MI350P; le GPU Blackwell per data center, di dimensioni maggiori, appartengono a una categoria diversa. La capacità di memoria è pressoché identica, con 144 GB contro i 141 GB dell'H200, ed entrambe utilizzano HBM3E. Tuttavia, l'H200 offre una larghezza di banda di memoria superiore del 20%, pari a 4.8 TB/s. Le due schede presentano anche una scalabilità differente: tutte e tre le schede PCIe si connettono all'host tramite PCIe, mentre l'H200 NVL aggiunge una connettività GPU-to-GPU dedicata tramite bridge NVLink, che permette di collegare fino a quattro GPU.
I modelli più grandi MI350X e MI355X sono stati progettati per competere con Blackwell, ma l'MI350P dimezza la configurazione hardware. Questo lo avvicina all'H200 NVL in termini di caratteristiche di memoria e posizionamento generale. Un aspetto in cui l'MI350P si distingue ancora è il supporto nativo per MXFP4 e MXFP6, che assume maggiore importanza man mano che l'inferenza si sposta verso una precisione inferiore.
Il sottosistema di memoria più piccolo rappresenta un ulteriore compromesso, poiché AMD non ha compensato la riduzione degli stack HBM con HBM3E più veloce, lasciando il MI350P a 4 TB/s di larghezza di banda e dietro all'H200 NVL in questo parametro. Ciò può limitare le prestazioni nei carichi di lavoro limitati dalla larghezza di banda della memoria, indipendentemente dalla potenza di calcolo disponibile, come dimostrano i risultati relativi alla larghezza di banda della memoria e all'inferenza a prompt lungo che verranno presentati più avanti nella recensione.
Il confronto con DGX Station va nella direzione opposta, perché GB300 Station integra una GPU B300 completa con uno stack HBM disabilitato, un chip di classe data center con un budget energetico da data center, mentre MI350P è metà di un chip di classe data center inserito nell'involucro da 600 W di una scheda di espansione PCIe. AMD ha bisogno di due o quattro MI350P per eguagliare quella singola GPU e, sulla carta, due di esse sono sufficienti: 288 GB e 8 TB/s contro i 252 GB e 7.1 TB/s di Station. Tuttavia, queste risorse risiedono su due schede e un carico di lavoro che le coinvolge entrambe scambia dati tramite PCIe peer-to-peer, il che limita il contributo della seconda scheda.
Cookie di prestazione
Piattaforma di test
L'unità di test MI350P è un Dell PowerEdge R7725 con due processori AMD EPYC 9555 (64 core ciascuno), 1.5 TB di DDR5-6400 su 24 DIMM e due schede MI350P impostate a 450 W, il limite per un server 2U. Le schede RTX PRO 6000 Blackwell Server Edition (600 W) sono state utilizzate nel Dell PowerEdge XE7740 che ospita la nostra configurazione di inferenza a quattro schede, una singola H200 NVL (450 W) è stata utilizzata nel Dell PowerEdge R770 della nostra recensione e i dati GB300 provengono dalla ASUS ExpertCenter Pro ET900N G3 DGX Station che abbiamo recensito a settembre.

L'inventario iDRAC riportato di seguito mostra come sono installate le due schede. Sono posizionate negli slot PCIe 2 e 7, entrambe Gen5 x16 e entrambe risultano funzionanti, e le chiavi del dispositivo, 0-139-0 e 1-199-0, ci vengono lette come una scheda dietro ogni socket EPYC, quindi il traffico parallelo tensoriale tra i due MI350P attraversa il collegamento del socket nel suo percorso tra i root complex. Questa è la configurazione predefinita per un'installazione a due schede in un server 2U, ed è utile tenerla presente in relazione ai risultati a due schede che verranno presentati in seguito.

La visualizzazione della memoria mostra il resto dell'host: 24 DIMM da 64 GB DDR5-6400, dual rank, per un totale di 1,536 GB in un server che arriva fino a 6 TB, il tutto con ECC multi-bit. Il margine di memoria è importante per l'esecuzione di GLM-5.2, dove il checkpoint MXFP4 non trova spazio nei 288 GB di due schede e vLLM trasferisce parte dei pesi degli esperti alla memoria host.

Numero massimo di FLOPS Matmul raggiungibili (MAMF)
Per contestualizzare le prestazioni di calcolo del MI350P, abbiamo eseguito il test MAMF su tutti e quattro i sistemi. MAMF (Maximum Achievable Matmul FLOPS) è una metrica di prestazione pratica progettata per misurare il picco realistico di operazioni in virgola mobile al secondo che un acceleratore raggiunge durante la moltiplicazione di matrici, un benchmark più utile rispetto al picco teorico di FLOPS riportato nelle specifiche. Abbiamo testato ciascun sistema in BF16, FP8 e FP4 a blocchi scalati e abbiamo riportato il miglior risultato denso sostenuto per precisione; le barre tratteggiate moltiplicano il risultato di ciascuna scheda PCIe per il numero di schede utilizzate nelle simulazioni con modelli di grandi dimensioni e sono calcolate senza alcuna misurazione a supporto.

A 450W, una MI350P raggiunge 580 TFLOPS in BF16, 1,120 in FP8 e 2,228 in FP4. La RTX PRO 6000 Blackwell segue con 419, 820 e 1,634, quindi la MI350P ha un vantaggio del 36-38% sulla scheda NVIDIA in ogni precisione, pur funzionando a 150W in meno, con il divario maggiore in BF16 al 38.4%.
I 652 TFLOPS dell'H200 NVL in BF16 e i 1,205 in FP8 lo pongono davanti alla MI350P in entrambi i casi, e non ha un percorso FP4. La GB300 DGX Station si posiziona sopra tutte e tre le schede PCIe con 1,924, 3,802 e 6,024, circa 3.3 volte la MI350P in BF16 e 2.7 volte in FP4; due MI350P sulla carta si avvicinano a 1,160 e 4,456, ancora al di sotto della singola GPU della Station. I valori NVIDIA MAMF in questa recensione provengono dalle nostre ultime prove su ciascuna scheda e sostituiscono i risultati dei nostri test precedenti.
Larghezza di banda della memoria della GPU
La velocità di calcolo grezza è utile solo se l'acceleratore è in grado di fornire dati alle sue unità di esecuzione. Questo è particolarmente importante per l'inferenza, dove la generazione di token durante la fase di decodifica è limitata più dalla larghezza di banda della memoria che dal numero di FLOPS disponibili. Il test di larghezza di banda legge, scrive e copia la memoria della GPU attraverso i kernel di calcolo e il motore di copia, mostrando la larghezza di banda disponibile all'interno di ciascuna GPU rispetto al suo valore nominale.

Una singola MI350P legge la sua memoria HBM3E a 3,291 GB/s e scrive a 3,204 GB/s, circa l'80% della capacità nominale di 4 TB/s, con velocità di copia comprese tra 1,276 e 1,283 GB/s; una copia consuma larghezza di banda due volte, una per leggere la sorgente e una per scrivere la destinazione. La memoria GDDR7 della RTX PRO 6000 raggiunge 1,540 GB/s in lettura e 1,483 GB/s in scrittura, quindi la MI350P offre circa 2.1 volte la larghezza di banda utilizzabile per scheda.
Le velocità di lettura di 4,472 GB/s e di scrittura di 4,156 GB/s dell'H200 NVL superano rispettivamente del 36 e del 30 percento quelle del MI350P, in linea con la sua capacità nominale di 4.8 TB/s contro i 4 TB/s, mentre la GB300 DGX Station raggiunge i 6,869 GB/s. Due MI350P misurati insieme raggiungono 6,529 GB/s in lettura, un valore vicino a quello della Station, ma tale larghezza di banda è occupata da due slot PCIe e un modello che li sfrutta entrambi paga per ogni scambio tramite PCIe.
Inferenza
Dopo aver trattato i test di basso livello, passiamo all'inferenza LLM. Il nostro test di servizio online vLLM utilizza un endpoint compatibile con OpenAI con un numero fisso di flussi simultanei e registra i token di output al secondo durante l'esecuzione. Riportiamo due configurazioni: 512 token in ingresso e 512 in uscita, di dimensioni simili a quelle di una chat e con un elevato utilizzo della decodifica, e 8,192 in ingresso e 1,024 in uscita, di dimensioni simili a quelle di un documento RAG e con un utilizzo intensivo del pre-riempimento. La concorrenza raddoppia a partire da un flusso in più e ogni grafico si arresta al livello di concorrenza più elevato in cui tutte le schede al suo interno sono state completate. Ogni punto corrisponde a due richieste per flusso, quindi i valori a flusso singolo si basano su due richieste e presentano una maggiore varianza tra le diverse esecuzioni rispetto ai punti con concorrenza più elevata.
Ogni modello è stato eseguito sul numero minimo di schede che potevano ospitarlo: una MI350P per tutte le versioni fino a GPT-OSS-120B e MiniMax-M2.7, e due per DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 e GLM-5.3 Flash. I test con RTX PRO 6000 seguono la stessa regola, ovvero due schede RTX contro una MI350P su MiniMax-M2.7 e quattro contro due su MiniMax-M3 e GLM-5.2. Le build a bassa precisione variano a seconda del produttore: quelle di AMD sono MXFP4 fino a Quark, quelle di NVIDIA sono NVFP4 e le coppie FP4 sono etichettate in questo modo. GPT-OSS viene fornito come MXFP4 ed esegue gli stessi pesi su tutte le schede. Le build H200 NVFP4 non sono incluse.
| Modello | MI350P | RTX PRO 6000 Blackwell | H200 NVL | Stazione GB300 DGX |
|---|---|---|---|---|
| Flash GLM-5.3 | 2 schede, MXFP4 | Non correre | Non correre | NVFP4 |
| GLM-5.2 | 2 schede, MXFP4 (trasferimento dei dati nella memoria host) | 4 carte, NVFP4 | Non correre | NVFP4 (circa 215 GB di esperti nella memoria Grace) |
| MiniMax-M3 | 2 schede, MXFP4 | 4 carte, NVFP4 | Non correre | NVFP4 (una selezione di esperti in memoria di Grace) |
| DeepSeek-V4-Flash | 2 carte, FP8 | 2 carte, FP8 | Non correre | FP8 |
| MiniMax-M2.7 | 1 scheda, MXFP4 | 2 carte, NVFP4 | Non correre | NVFP4 |
| GPT-OSS-120B | 1 scheda, MXFP4 | 1 scheda, MXFP4 | 1 scheda, MXFP4 | MXFP4 |
| GPT-OSS-20B | 1 scheda, MXFP4 | 1 scheda, MXFP4 | 1 scheda, MXFP4 | MXFP4 |
| Qwen3-Coder-30B-A3B | 1 scheda, FP8 e BF16 | 1 scheda, FP8 e BF16 | 1 scheda, FP8 e BF16 | FP8 e BF16 |
| Mistral Piccolo 3.1 24B | 1 scheda, FP8 e BF16 | 1 scheda, FP8 e BF16 | 1 scheda, FP8 e BF16 | FP8 e BF16 |
| Lama 3.1 8B | 1 scheda, MXFP4, FP8 e BF16 | 1 scheda, NVFP4, FP8 e BF16 | 1 scheda, FP8 e BF16 | NVFP4, FP8 e BF16 |
Scorrendo la colonna relativa al MI350P, la prima cosa che salta all'occhio con 144 GB è il numero di schede disponibili. Sei dei dieci modelli vengono eseguiti su un singolo MI350P, mentre i 96 GB della RTX PRO 6000 richiedono una seconda scheda per MiniMax-M2.7, e i due checkpoint MXFP4 che rimangono su una coppia di MI350P, MiniMax-M3 e GLM-5.2, necessitano di quattro RTX PRO 6000. GLM-5.2 è l'unico modello che supera persino i 288 GB, e vLLM trasferisce parte dei suoi pesi esperti alla memoria host dell'R7725 per tale esecuzione; il GB300 fa lo stesso con circa 215 GB di pesi esperti nella memoria Grace.
I risultati relativi al MI350P per i modelli a singola scheda grafica sono stati ottenuti il 27 ottobre con AMDGPU 31.60, ROCm 10.1.0 e vLLM 0.32.0. La combinazione validata da Dell è vLLM 0.27 con ROCm 10.0 e AMDGPU 31.5, e noi siamo andati oltre, utilizzando la versione ROCm 10.1 rilasciata il 5 ottobre. Le schede NVIDIA hanno utilizzato il container vLLM 26.08 con CUDA 13.4.1 per tutti i test. La tabella elenca la build utilizzata per ogni esecuzione.
| Modello | Immagine vLLM |
|---|---|
| AMD Instinct MI350P | |
| DeepSeek-V4-Flash-0731 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GLM-5.2 MXFP4 | vllm/vllm-openai-rocm:v0.27.1 (ROCm 7.2.3) |
| Memoria flash GLM-5.3 MXFP4 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GPT-OSS-120B MXFP4 | vLLM 0.32.0 su ROCm 10.1.0, AMDGPU 31.60 (27 ottobre) |
| GPT-OSS-20B MXFP4 | vLLM 0.32.0 su ROCm 10.1.0, AMDGPU 31.60 (27 ottobre) |
| Lama 3.1 8B BF16 | vLLM 0.32.0 su ROCm 10.1.0, AMDGPU 31.60 (27 ottobre) |
| Llama 3.1 8B FP8 | vLLM 0.32.0 su ROCm 10.1.0, AMDGPU 31.60 (27 ottobre) |
| Llama 3.1 8B MXFP4 | vLLM 0.32.0 su ROCm 10.1.0, AMDGPU 31.60 (27 ottobre) |
| MiniMax-M2.7 MXFP4 | vLLM 0.32.0 su ROCm 10.1.0, AMDGPU 31.60 (27 ottobre) |
| MiniMax-M3 MXFP4 | vllm/vllm-openai-rocm:nightly-2a02f6efe319c885e3ccbcecde402e0028f9ec1e (ROCm 7.2.3) |
| Mistral Small 3.1 24B BF16 | vLLM 0.32.0 su ROCm 10.1.0, AMDGPU 31.60 (27 ottobre) |
| Mistral Small 3.1 24B FP8 | vLLM 0.32.0 su ROCm 10.1.0, AMDGPU 31.60 (27 ottobre) |
| Qwen3-Coder-30B BF16 | vLLM 0.32.0 su ROCm 10.1.0, AMDGPU 31.60 (27 ottobre) |
| Qwen3-Coder-30B FP8 | vLLM 0.32.0 su ROCm 10.1.0, AMDGPU 31.60 (27 ottobre) |
| NVIDIA RTX PRO 6000 Blackwell Server Edition (CUDA 13.4.1.012) | |
| DeepSeek-V4-Flash-0731 | nvcr.io/nvidia/vllm:26.08-py3 |
| GLM-5.2 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Lama 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Lama 3.1 8B NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M2.7 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M3 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| NVIDIA H200 NVL (CUDA 13.4.1.012) | |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Lama 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
The four two-card models, DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2, and GLM-5.3 Flash, are reported from runs on ROCm 7.2.3. Our ROCm 10.1 passes on those models used CPU expert offload throughout and, on DeepSeek-V4-Flash, a speculative decoder the NVIDIA runs did not, which makes them a different test, so they are held for a clean pass on the current stack, and the tables label every MI350P row with its stack.
La soluzione preferita da AMD per questi modelli è rappresentata dai suoi container AIM; la versione 2.5 di Enterprise AI Suite, rilasciata il 9 ottobre, è validata su ROCm 10 e include AIM per GPT-OSS-120B, Llama 3.3 70B e Gemma 3 27B, ma la tabella degli acceleratori di AMD elenca per ora un profilo MI350P ottimizzato solo per Wan2.2. Pertanto, la soluzione standard vLLM rimane la scelta preferita dagli acquirenti di MI350P, ed è quella che abbiamo utilizzato per le nostre misurazioni.
Risultati dell'inferenza in sintesi
Di seguito sono riportati 28 grafici, quindi ecco una versione breve in due tabelle: output di token al secondo per ciascun modello alla massima concorrenza, con ogni scheda completata, partendo dal carico di lavoro di dimensioni pari a una chat (512 in, 512 out). I dati relativi al MI350P si riferiscono a una singola scheda da 450 W, salvo diversa indicazione nella riga, con una colonna per lo stack da cui proviene ciascuna riga; la GB300 DGX Station è una singola B300.
| Modello | Schede (MI350P / RTX PRO 6000) | Stack MI350P | Streams | MI350P | RTX PRO 6000 | H200 NVL | Stazione GB300 DGX |
|---|---|---|---|---|---|---|---|
| Flash GLM-5.3 (MXFP4 vs NVFP4) | 2 / nessuno | ROCm 7.2.3 | 32 | 1,462 | Non correre | Non correre | 828 |
| GLM-5.2 (MXFP4 vs NVFP4) | 2 / 4 | ROCm 7.2.3 | 32 | 59 | 40 | Non correre | 139 |
| MiniMax-M3 (MXFP4 vs NVFP4) | 2 / 4 | ROCm 7.2.3 | 32 | 1,509 | 759 | Non correre | 1,041 |
| DeepSeek-V4-Flash | 2 / 2 | ROCm 7.2.3 | 32 | 1,081 | 829 | Non correre | 1,766 |
| MiniMax-M2.7 (MXFP4 vs NVFP4) | 1 / 2 | ROCm 10.1 | 128 | 1,524 | 1,932 | Non correre | 4,793 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 5,057 | 3,064 | 3,376 | 9,280 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 10,726 | 7,937 | 6,022 | 22,041 |
| Qwen3-Coder-30B FP8 | 1 / 1 | ROCm 10.1 | 128 | 6,451 | 3,995 | 7,459 | 12,439 |
| Qwen3-Coder-30B BF16 | 1 / 1 | ROCm 10.1 | 128 | 4,696 | 2,881 | 5,240 | 10,000 |
| Mistral Small 24B FP8 | 1 / 1 | ROCm 10.1 | 128 | 4,458 | 3,242 | 4,624 | 11,075 |
| Mistral Small 24B BF16 | 1 / 1 | ROCm 10.1 | 128 | 3,065 | 2,026 | 3,373 | 7,861 |
| Llama 3.1 8B (MXFP4 vs NVFP4) | 1 / 1 | ROCm 10.1 | 128 | 8,383 | 8,869 | Non correre | 28,400 |
| Llama 3.1 8B FP8 | 1 / 1 | ROCm 10.1 | 128 | 11,045 | 8,073 | 11,054 | 25,602 |
| Lama 3.1 8B BF16 | 1 / 1 | ROCm 10.1 | 128 | 6,819 | 4,740 | 8,069 | 17,074 |
Nella tabella della chat spiccano due risultati: la MI350P supera la RTX PRO 6000 su ogni modello FP8, BF16 e GPT-OSS, dal 35 al 65 percento a 128 stream, è inferiore alle build NVFP4 di NVIDIA solo nella parte alta delle curve Llama e MiniMax-M2.7 e raddoppia approssimativamente la scheda NVIDIA in un singolo stream su Llama 3.1 8B e Mistral Small 24B, dove 4 TB/s di HBM3E svolgono il lavoro.
L'H200 NVL, con il 20% di larghezza di banda in più, mantiene un vantaggio dal 4 al 18% sui modelli densi FP8 e BF16 a 128 flussi e pareggia su Llama 3.1 8B FP8; sui due modelli GPT-OSS l'ordine si inverte e l'MI350P termina con un vantaggio del 50 e del 78%.
La seconda tabella ripete l'esercizio sui prompt da 8,192 token, dove il pre-riempimento domina l'esecuzione e l'equilibrio tra larghezza di banda di calcolo e di memoria si sposta verso le schede NVIDIA.
| Modello | Schede (MI350P / RTX PRO 6000) | Stack MI350P | Streams | MI350P | RTX PRO 6000 | H200 NVL | Stazione GB300 DGX |
|---|---|---|---|---|---|---|---|
| Flash GLM-5.3 (MXFP4 vs NVFP4) | 2 / nessuno | ROCm 7.2.3 | 32 | 760 | Non correre | Non correre | 1,219 |
| GLM-5.2 (MXFP4 vs NVFP4) | 2 / 4 | ROCm 7.2.3 | 16 | 6 | 9 | Non correre | 87 |
| MiniMax-M3 (MXFP4 vs NVFP4) | 2 / 4 | ROCm 7.2.3 | 8 | 524 | 444 | Non correre | 103 |
| DeepSeek-V4-Flash | 2 / 2 | ROCm 7.2.3 | 32 | 621 | 345 | Non correre | 954 |
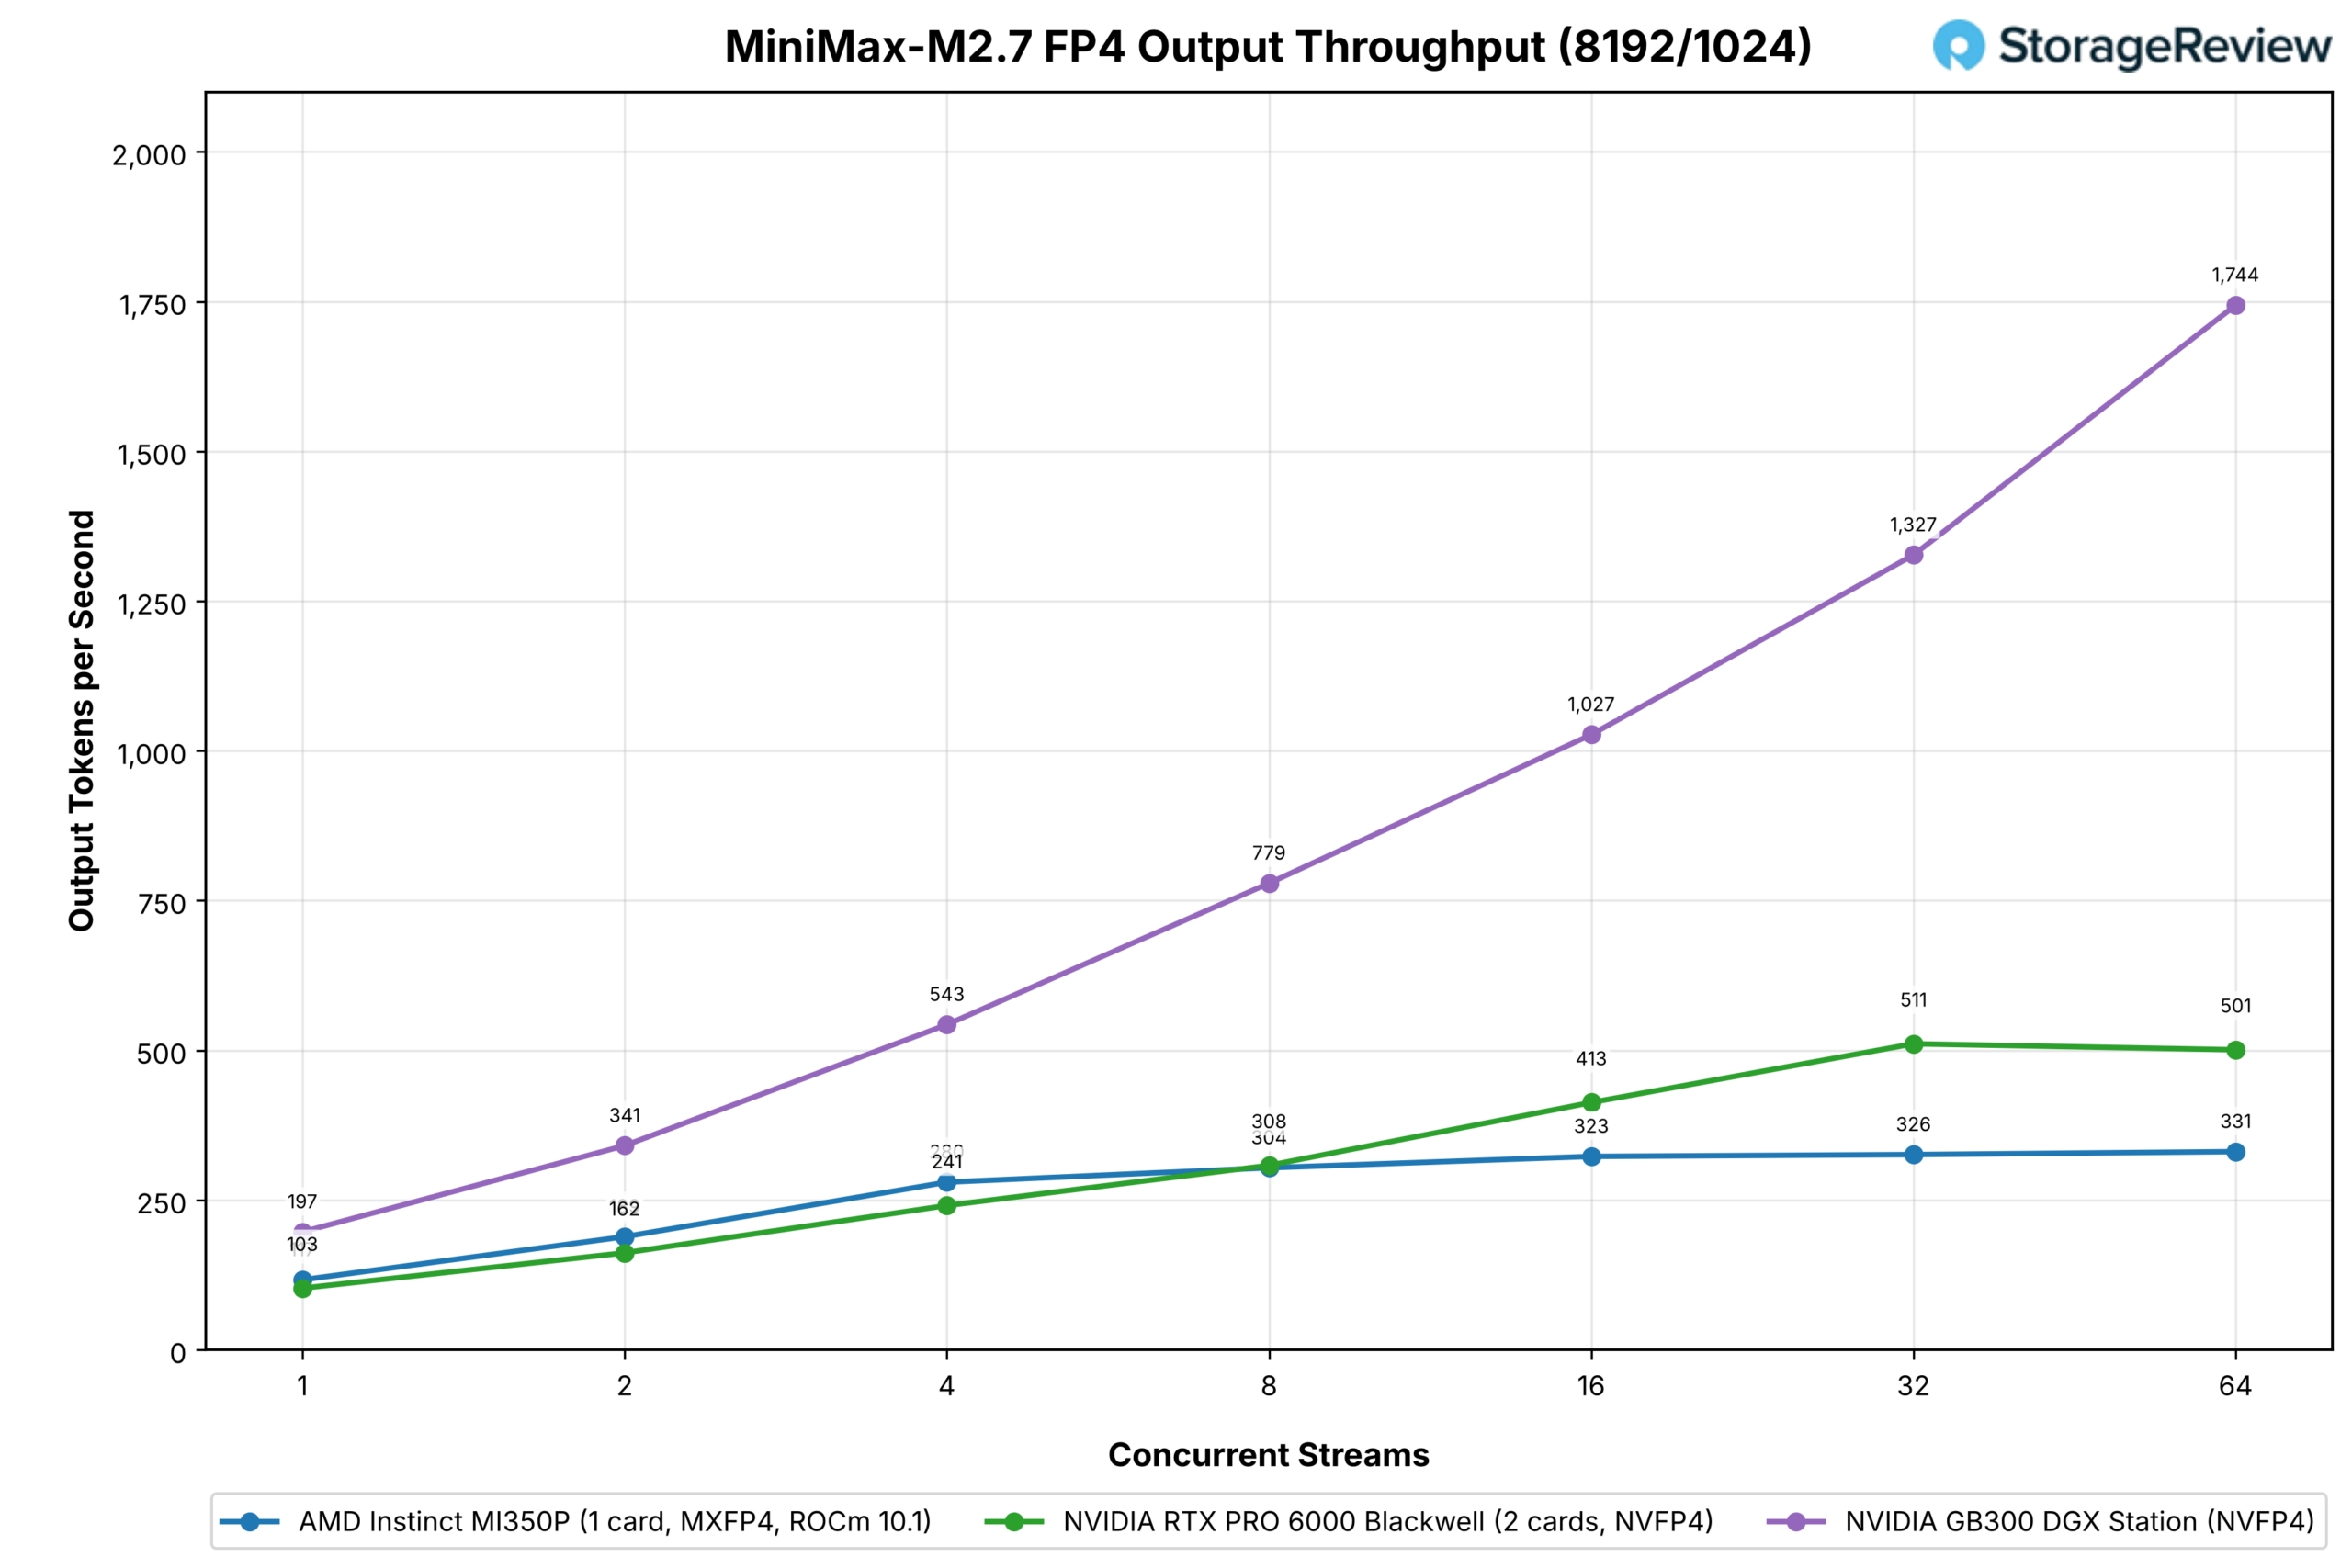
| MiniMax-M2.7 (MXFP4 vs NVFP4) | 1 / 2 | ROCm 10.1 | 64 | 331 | 501 | Non correre | 1,744 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 2,101 | 1,169 | 1,825 | 5,023 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 3,603 | 2,482 | 3,419 | 9,555 |
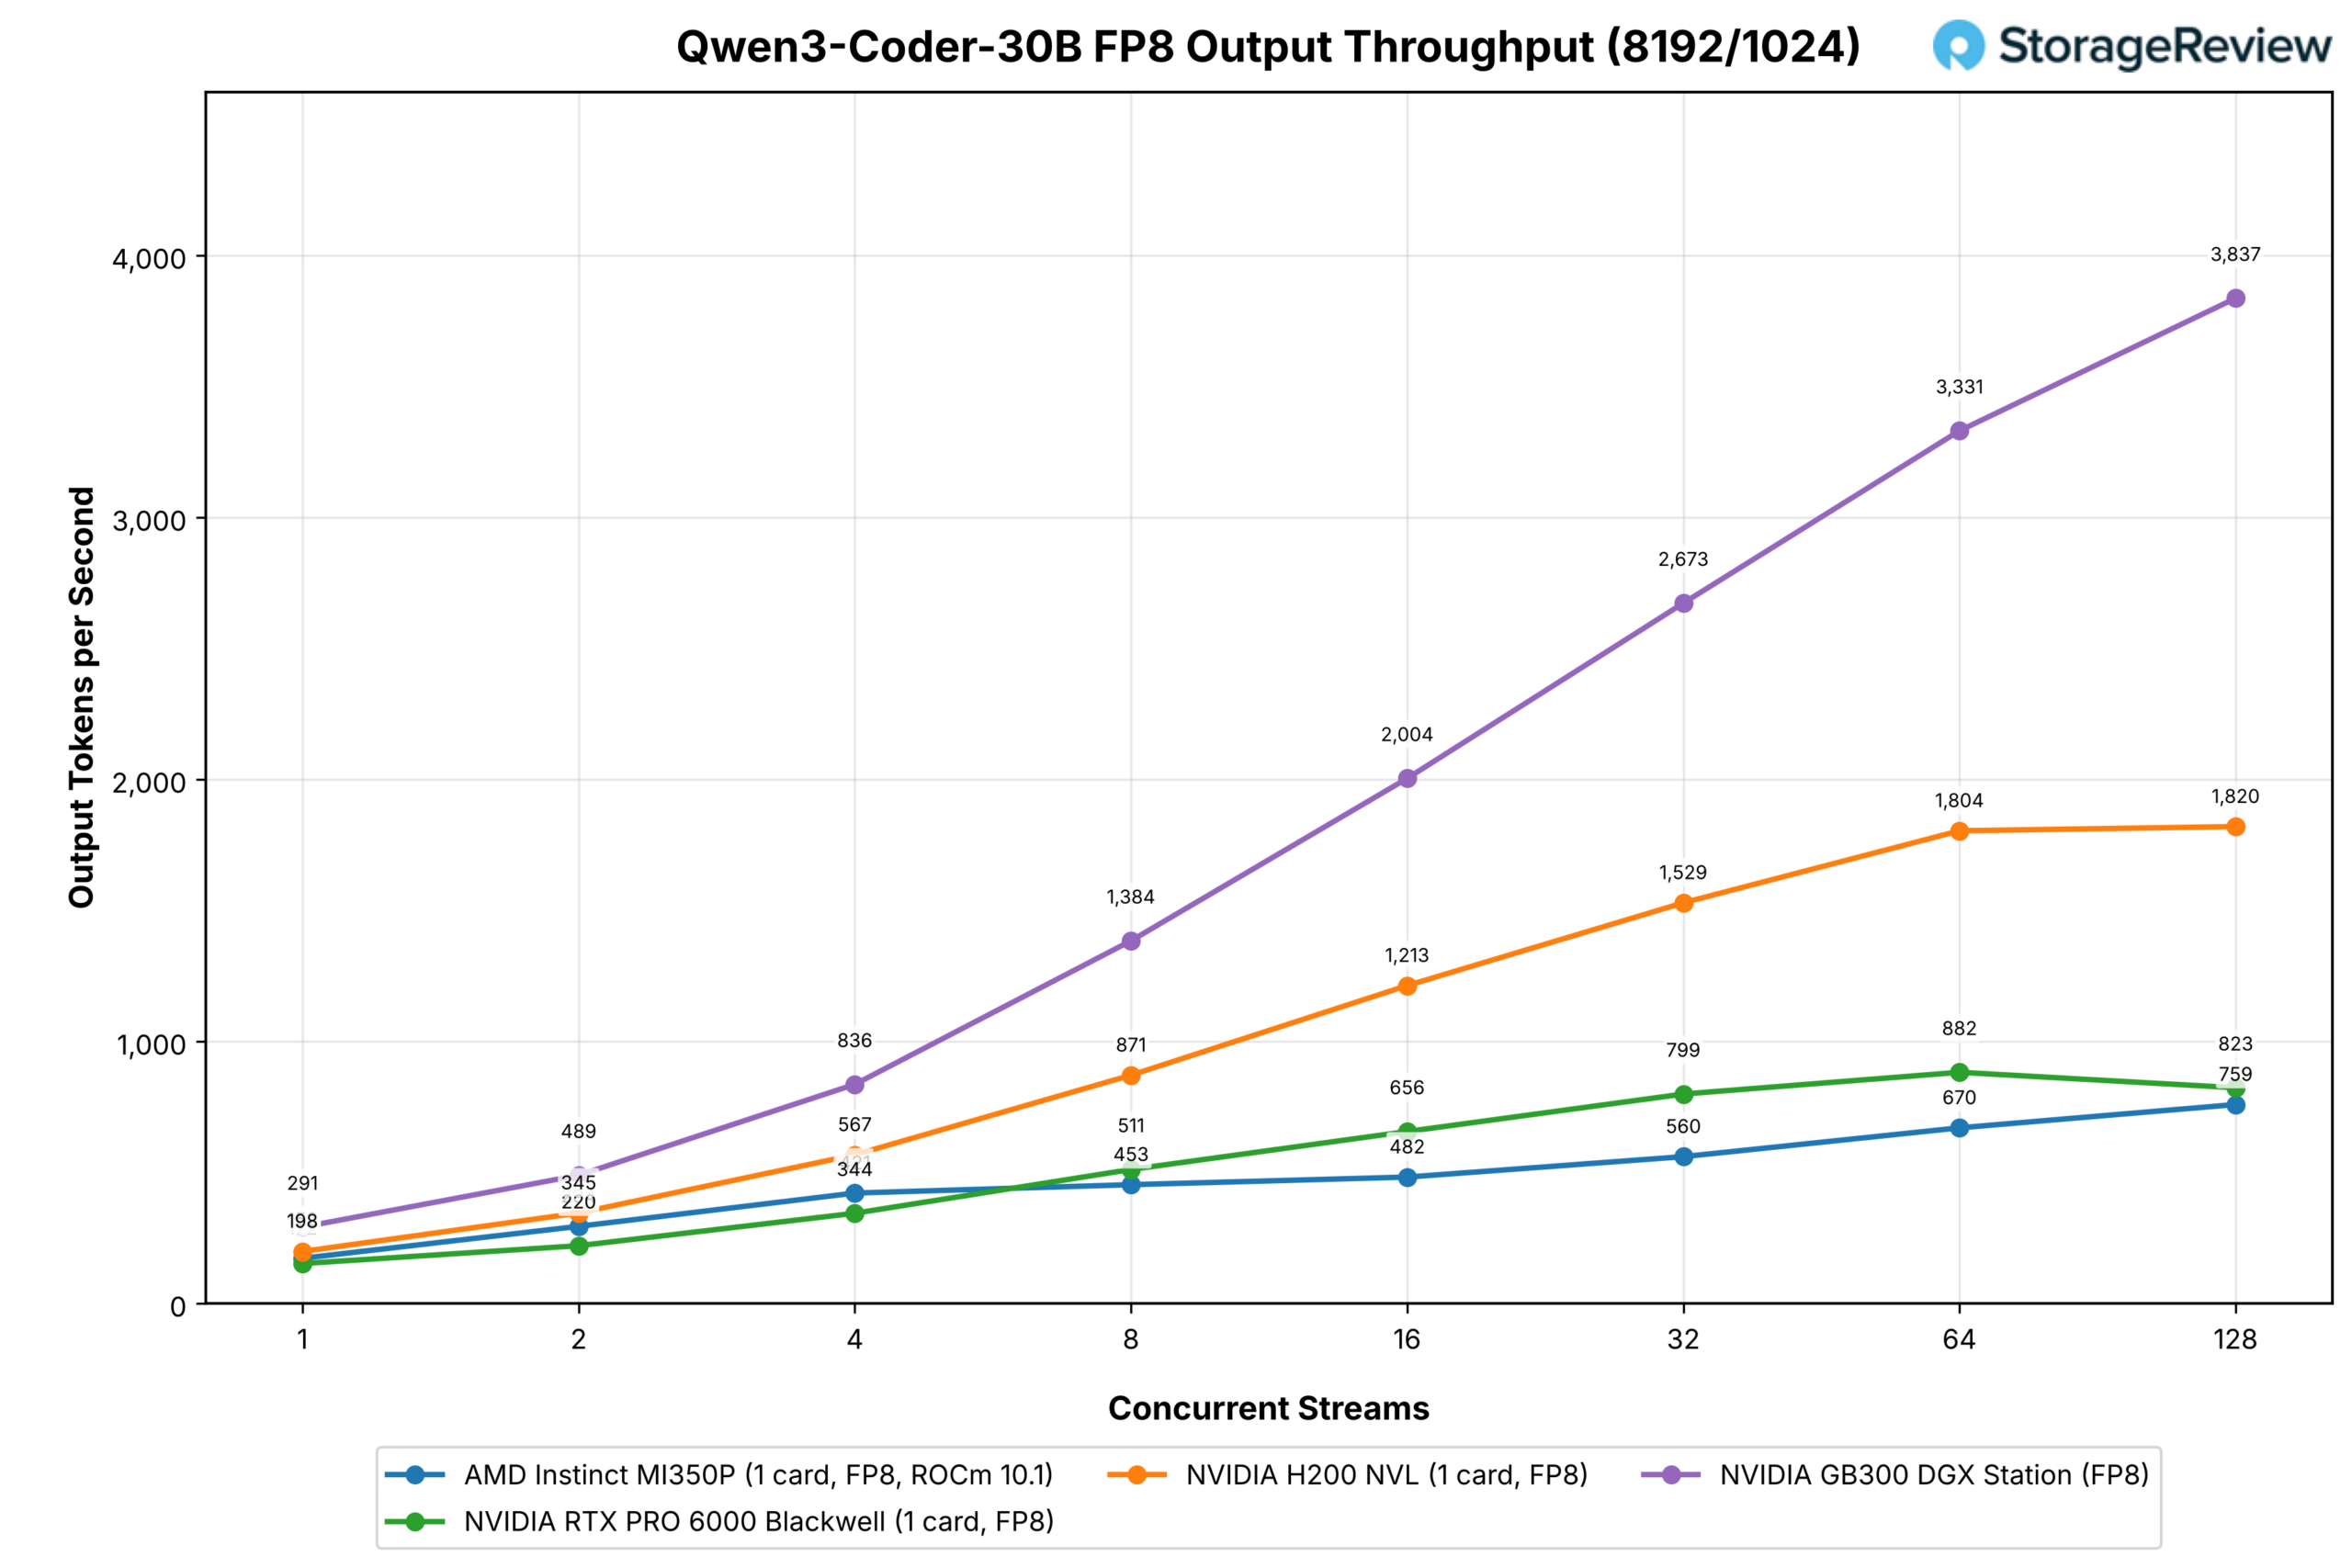
| Qwen3-Coder-30B FP8 | 1 / 1 | ROCm 10.1 | 128 | 759 | 823 | 1,820 | 3,837 |
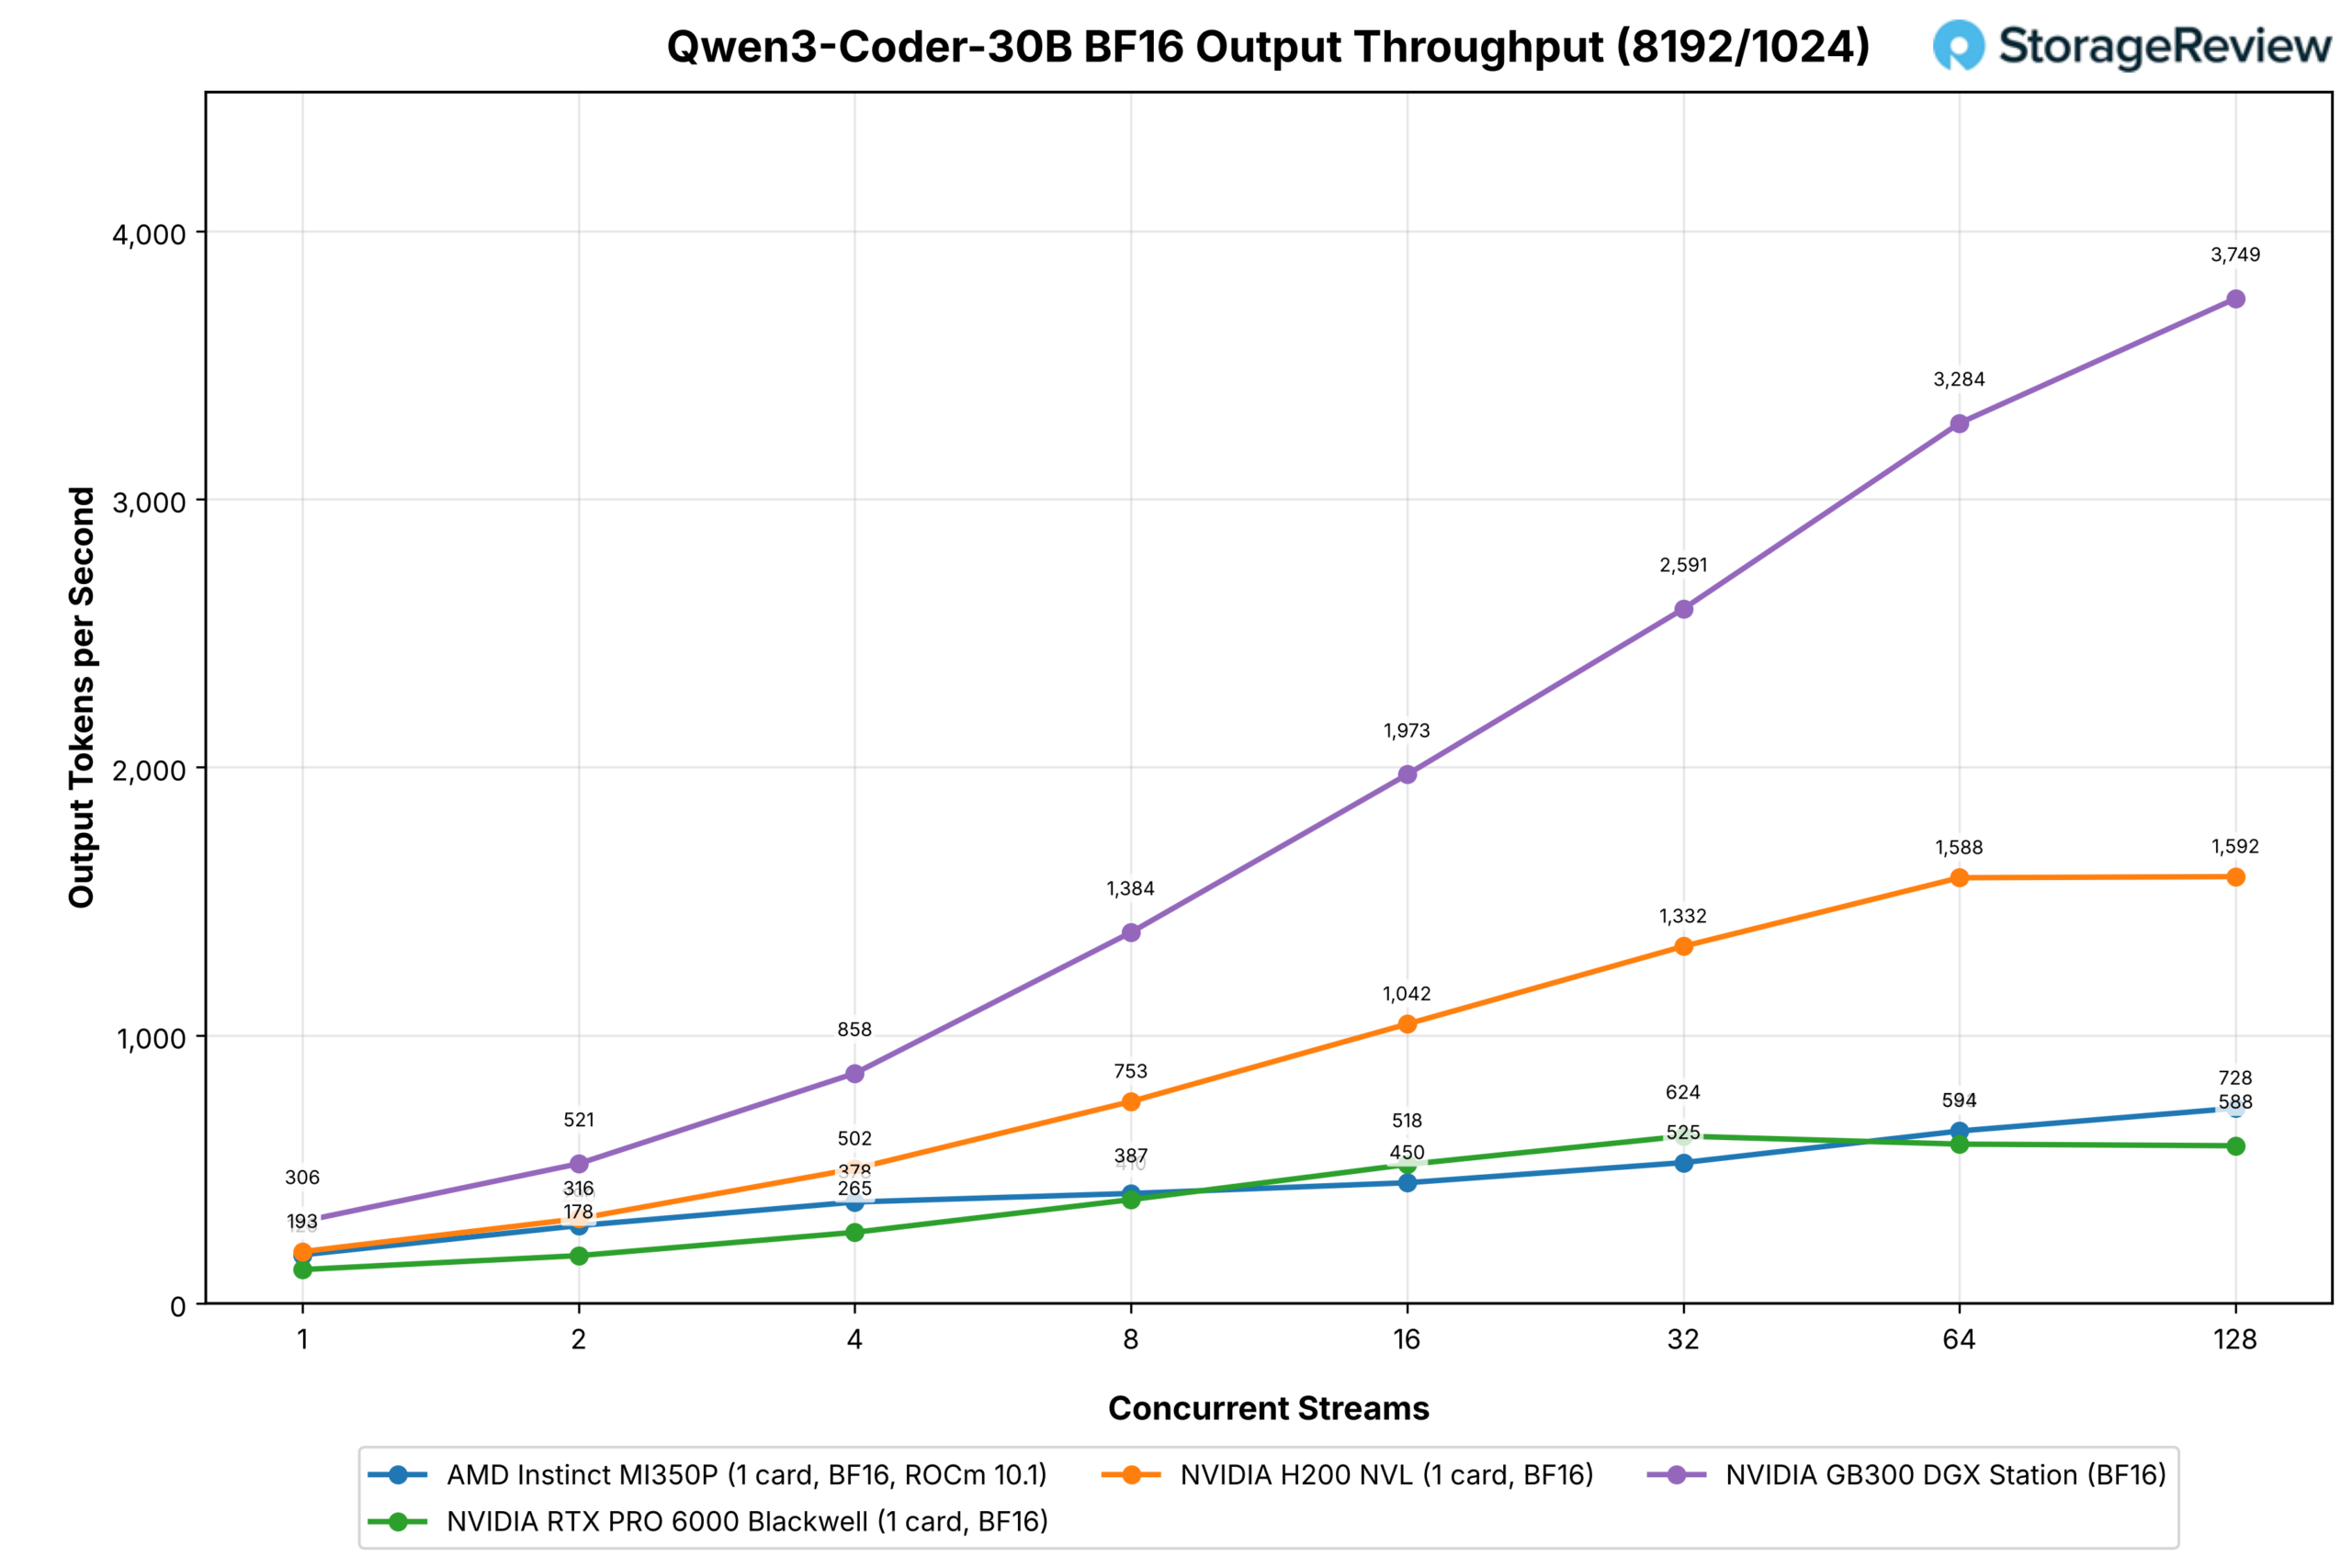
| Qwen3-Coder-30B BF16 | 1 / 1 | ROCm 10.1 | 128 | 728 | 588 | 1,592 | 3,749 |
| Mistral Small 24B FP8 | 1 / 1 | ROCm 10.1 | 128 | 599 | 482 | 799 | 2,302 |
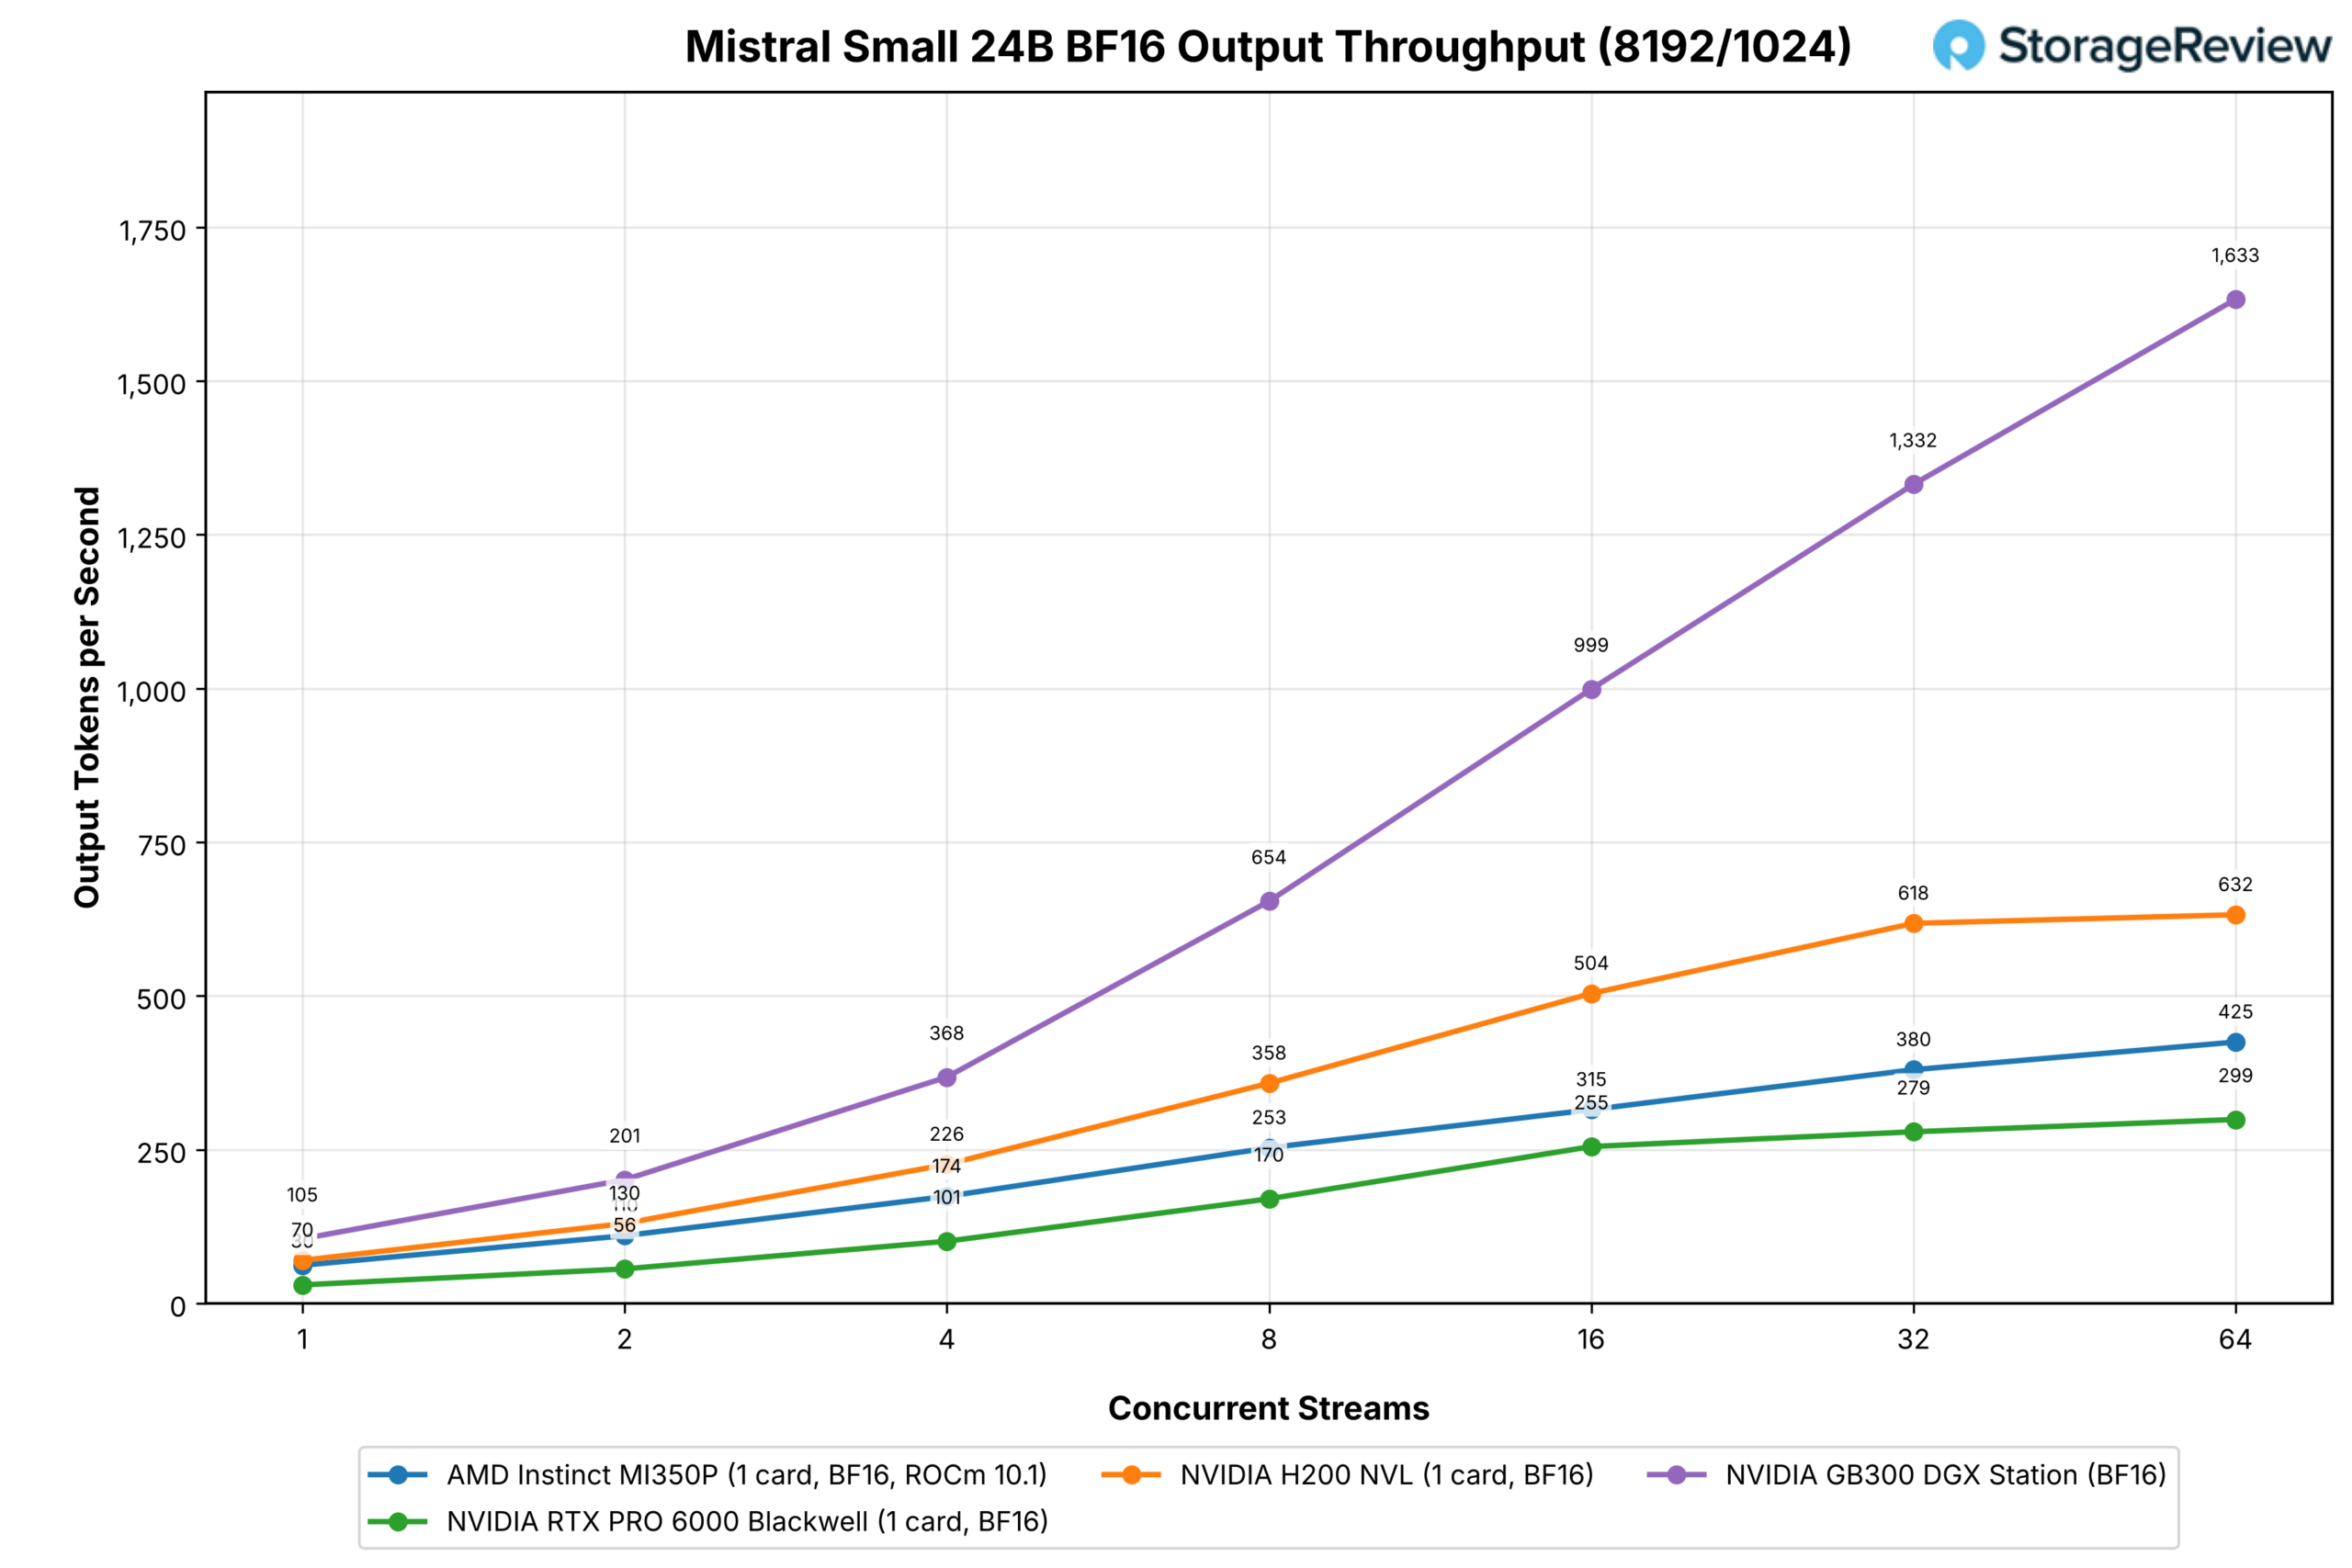
| Mistral Small 24B BF16 | 1 / 1 | ROCm 10.1 | 64 | 425 | 299 | 632 | 1,633 |
| Llama 3.1 8B (MXFP4 vs NVFP4) | 1 / 1 | ROCm 10.1 | 128 | 964 | 1,644 | Non correre | 6,737 |
| Llama 3.1 8B FP8 | 1 / 1 | ROCm 10.1 | 128 | 1,211 | 1,481 | 2,045 | 6,164 |
| Lama 3.1 8B BF16 | 1 / 1 | ROCm 10.1 | 128 | 686 | 716 | 1,358 | 3,498 |
Su prompt con precaricamento intensivo, il quadro è variegato: la MI350P supera la RTX PRO 6000 su entrambi i modelli GPT-OSS per ogni numero di stream e su Mistral Small, si posiziona a metà classifica su Qwen3-Coder a 128 stream (24% di vantaggio su BF16, 8% di svantaggio su FP8) e si appiattisce di 16 stream su Llama e MiniMax-M2.7, dove finisce dietro alla scheda NVIDIA. Contro la H200, è in vantaggio su GPT-OSS del 15% sul modello a 120B e del 5% su quello a 20B a 128 stream e in svantaggio dal 25 al 58% sui modelli densi.
Sui modelli più grandi, dove due MI350P si confrontano con quattro RTX PRO 6000, il set NVIDIA supera GLM-5.2 con 16 stream nel carico di lavoro della chat con 384 GB di GDDR7 contro 288 GB di HBM3E, mentre su MiniMax-M3 tutte e tre le configurazioni rimangono entro il 10% fino a otto stream prima che il quad RTX prenda il sopravvento a 16. La singola GB300 surclassa ogni configurazione PCIe con un ampio margine su qualsiasi cosa rientri nei suoi 252 GB.
Flash GLM-5.3
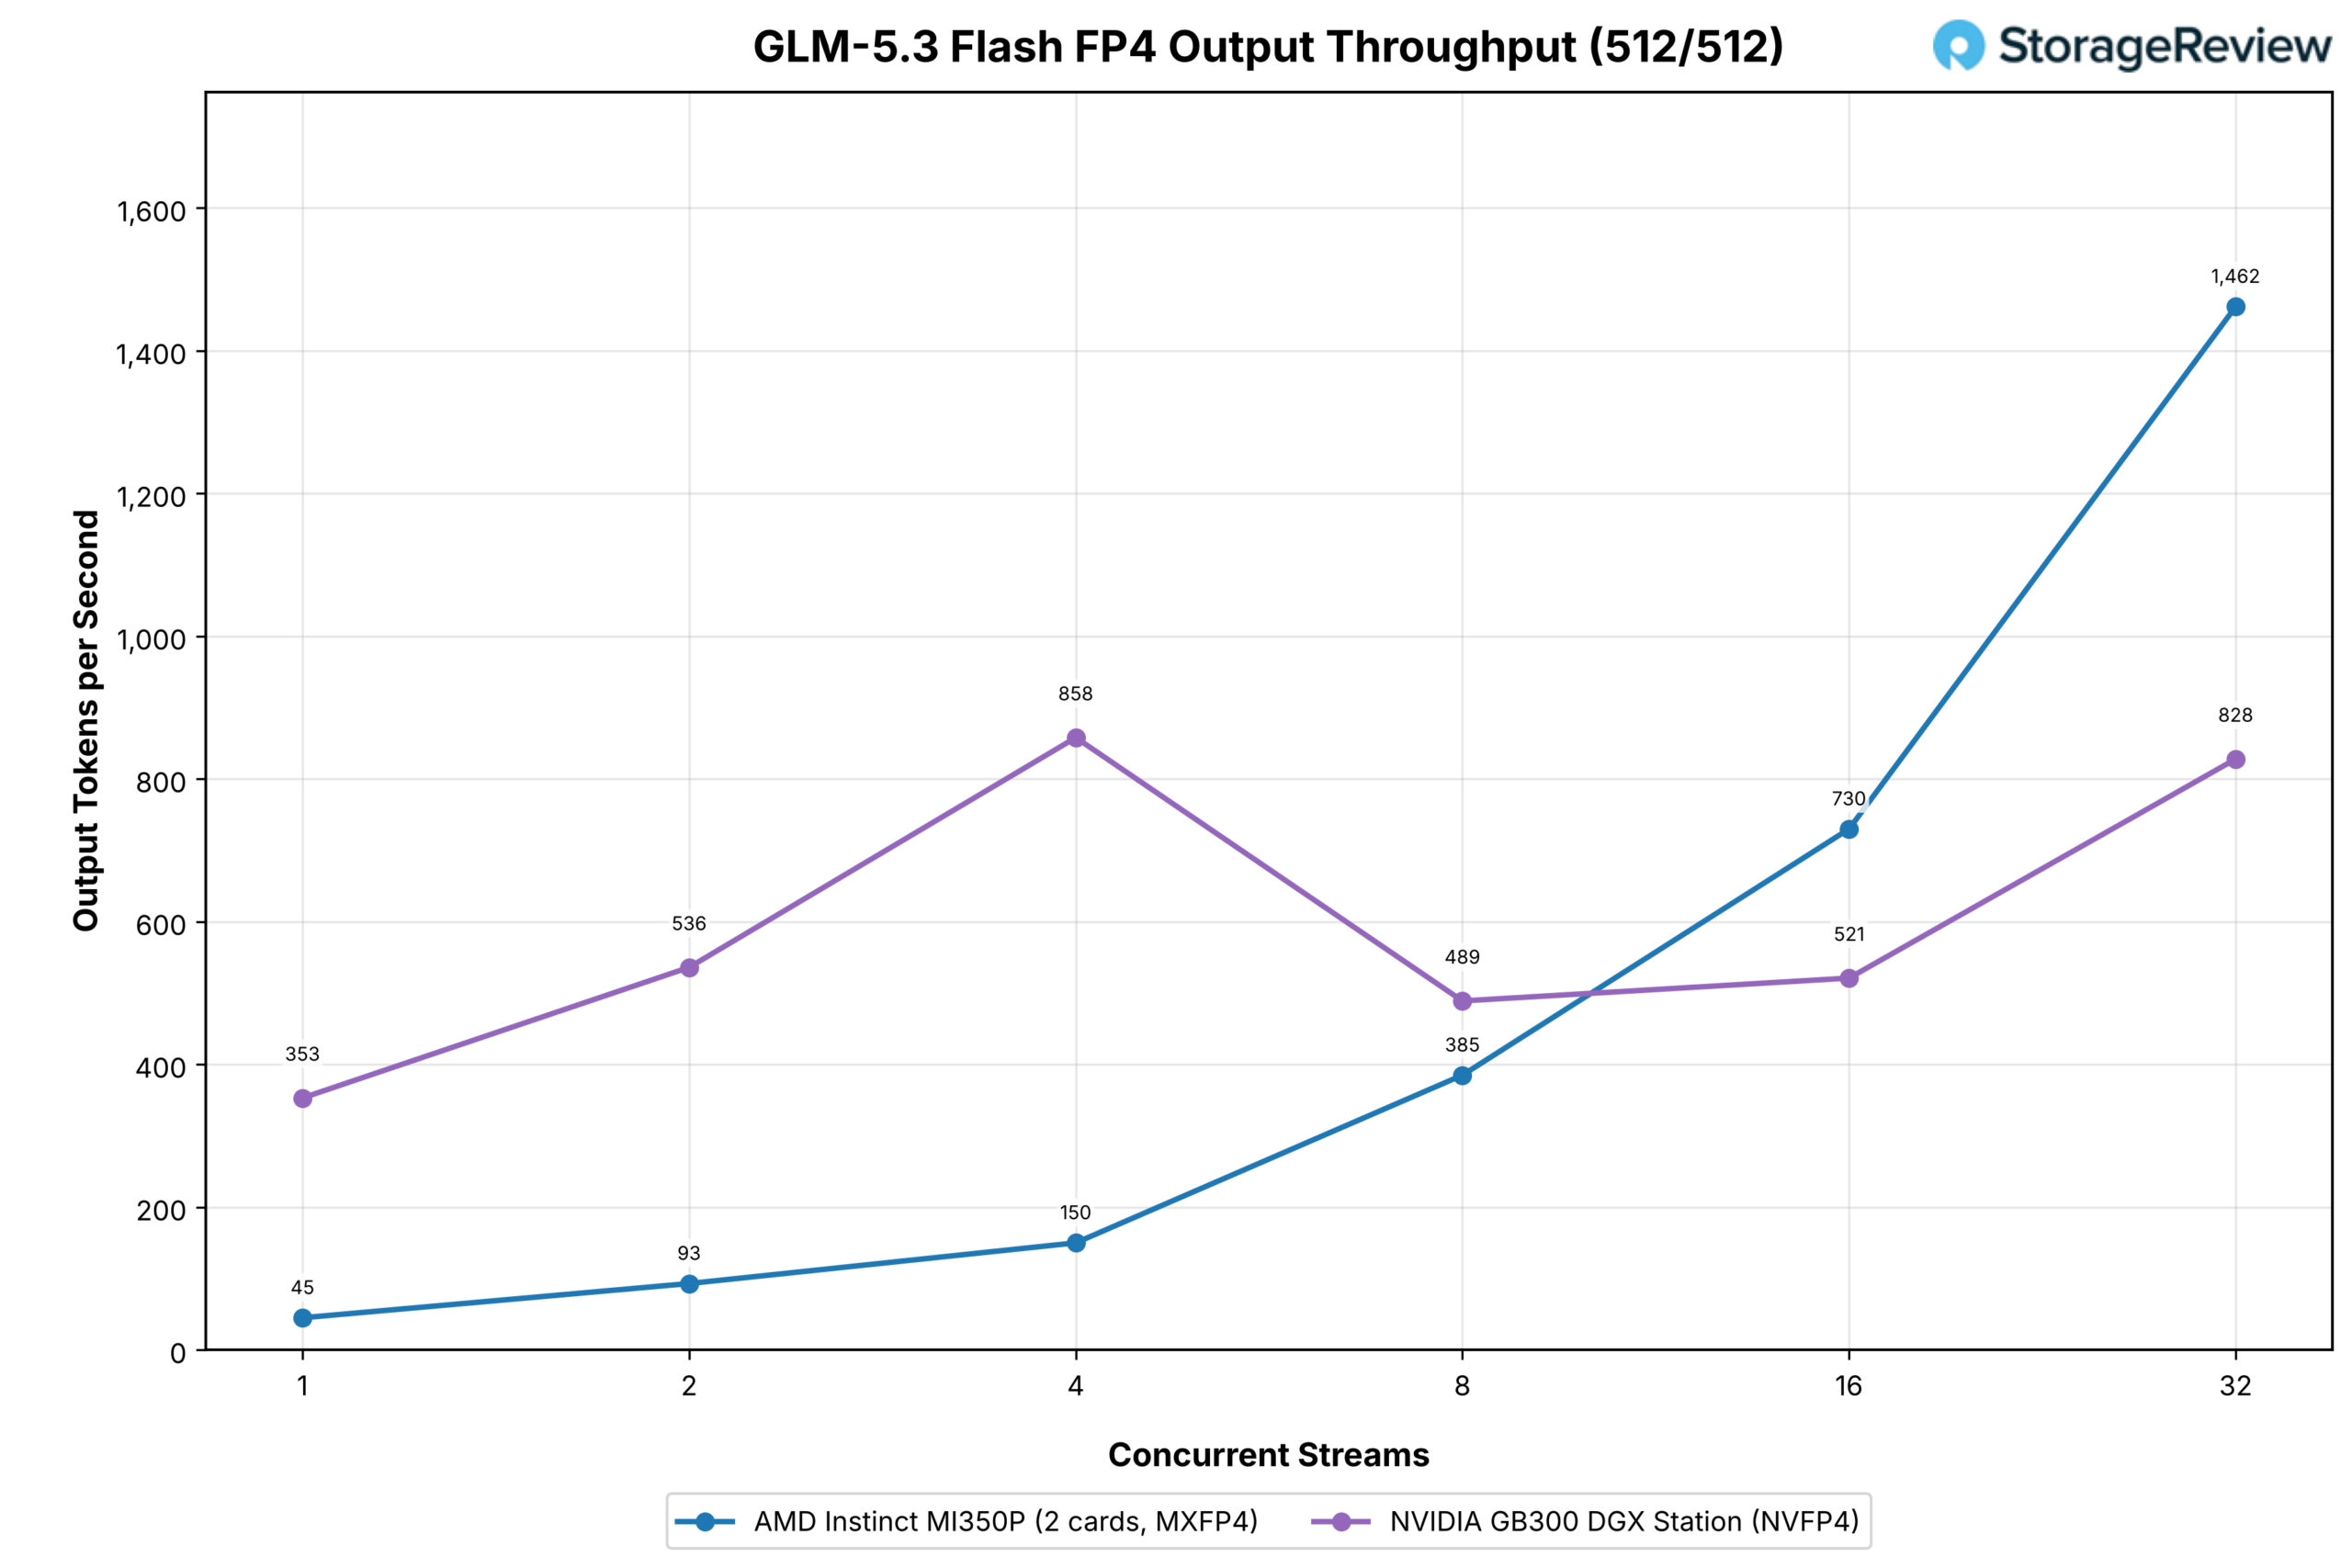
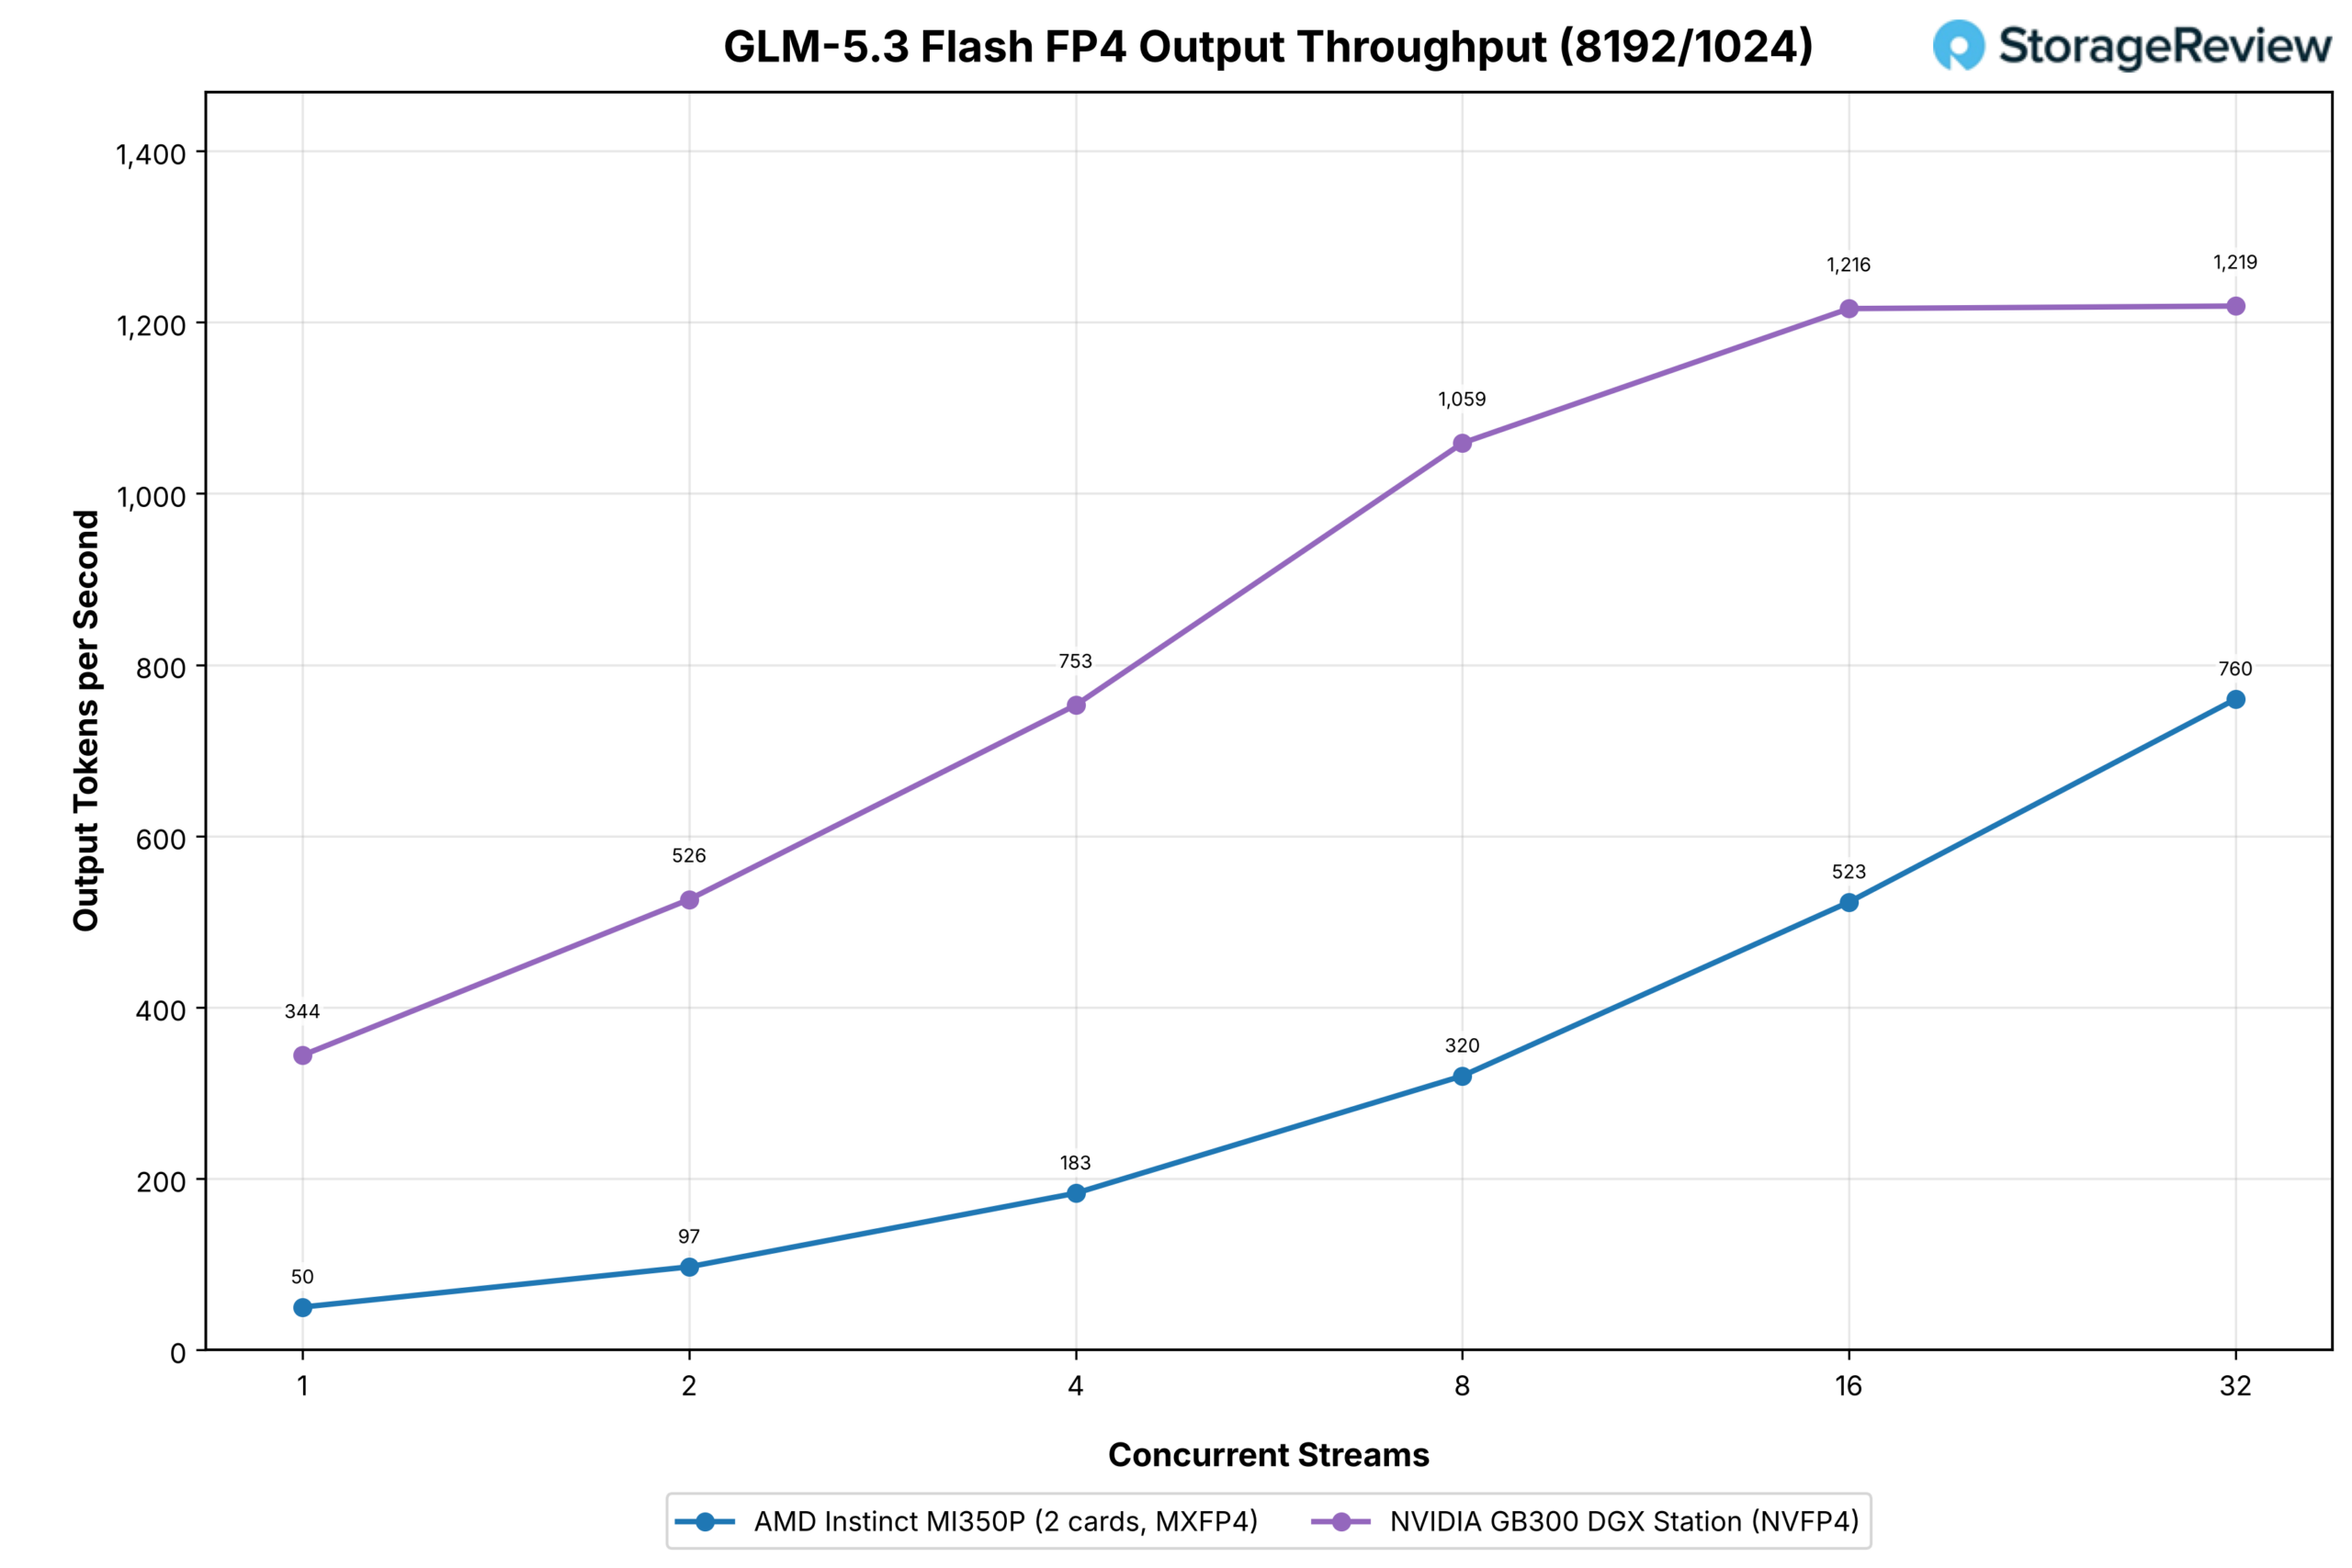
La memoria Flash GLM-5.3 non è stata eseguita sulla RTX PRO 6000, quindi il confronto è tra due schede MI350P e una singola GB300 Station con 32 stream. Nel carico di lavoro della chat, la coppia di MI350P parte in svantaggio, con 45 contro 353 token di output al secondo con un singolo stream, e supera la Station con otto stream, arrivando a 1,462 con 32 stream, contro gli 828 della Station. Nel carico di lavoro con pre-riempimento intensivo, la Station è in testa, con 1,219 contro 760 con 32 stream, dove il pre-riempimento della coppia deve attraversare il PCIe tra le due schede, mentre la B300 lo fa interamente in un unico blocco HBM.
GLM-5.2
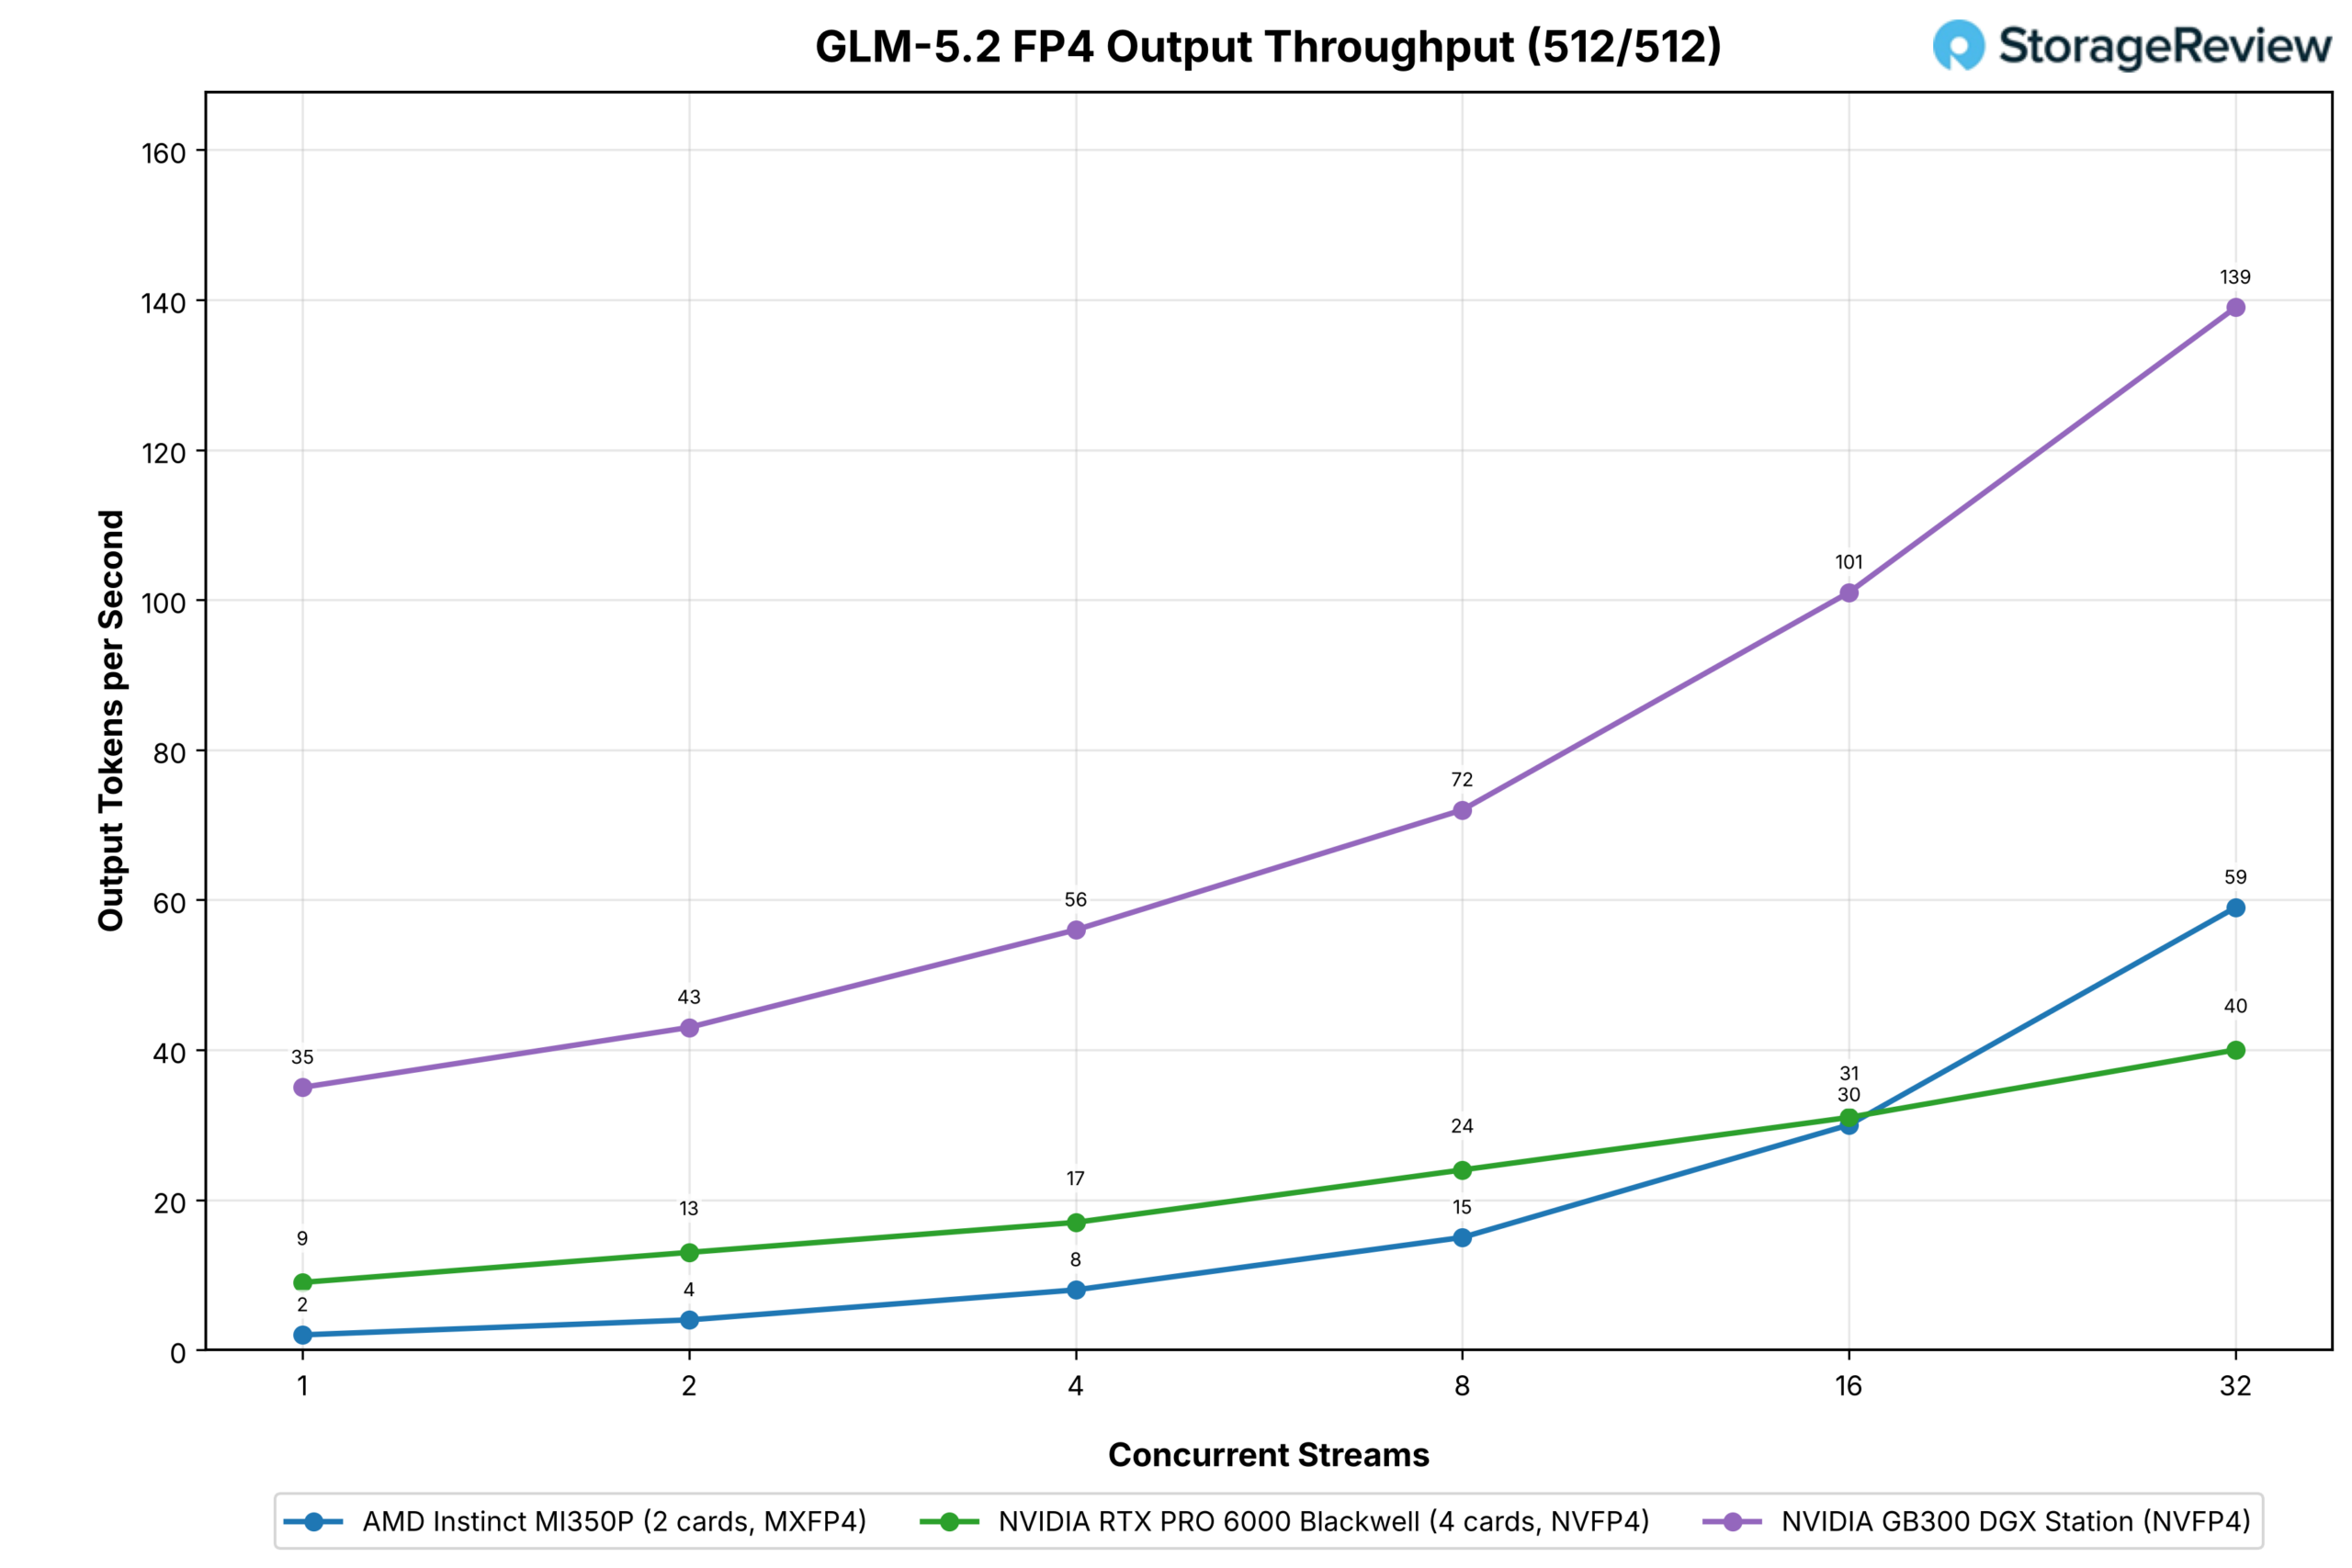
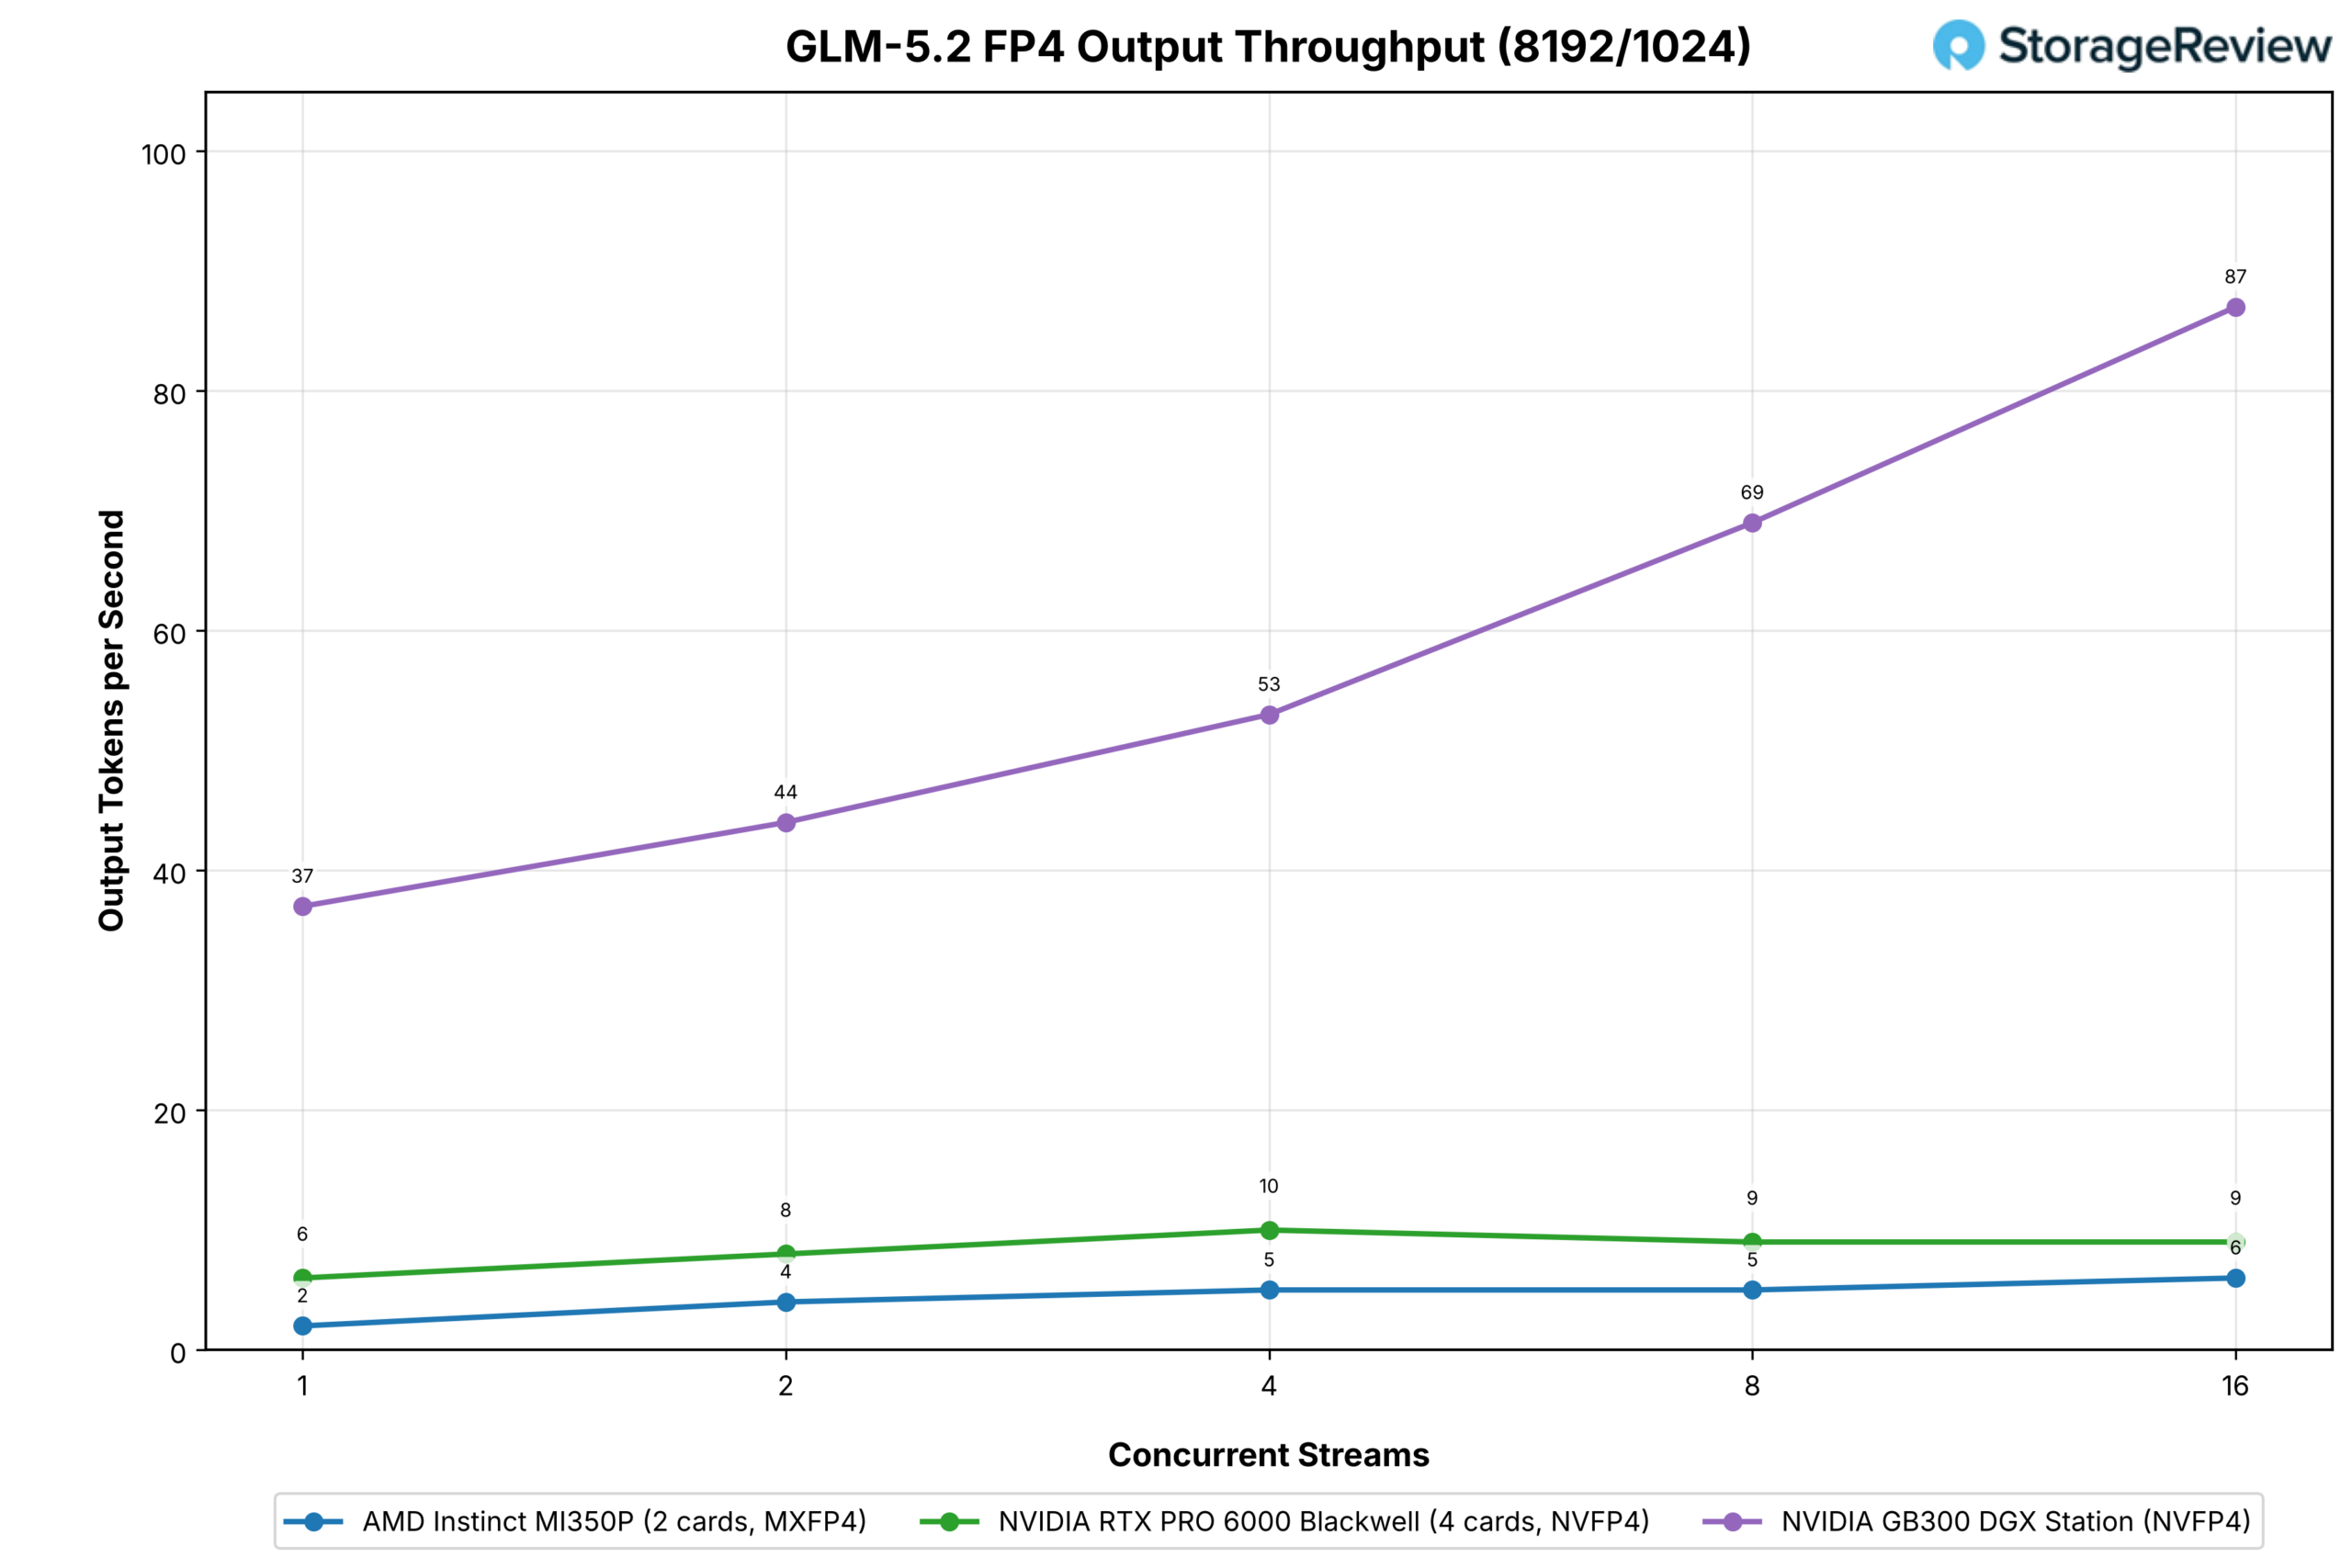
GLM-5.2 è il punto cruciale in questo set. Il checkpoint MXFP4 si estende oltre i 288 GB delle due schede MI350P nella memoria host, quindi il throughput single-stream è di 2 token di output al secondo sulla coppia contro i 9 delle quattro schede RTX PRO 6000 che ospitano la build NVFP4 in 384 GB di GDDR7 e 35 per la Station, che scarica circa 215 GB di pesi esperti sulla memoria Grace. Il quad RTX è in testa con 16 stream nel carico di lavoro della chat; con 32 la coppia MI350P raggiunge 59 contro 40 e la Station raggiunge 139. Nei prompt con precaricamento intensivo, nessuna delle due configurazioni PCIe supera le singole cifre con 16 stream, contro gli 87 della Station.
MiniMax-M3
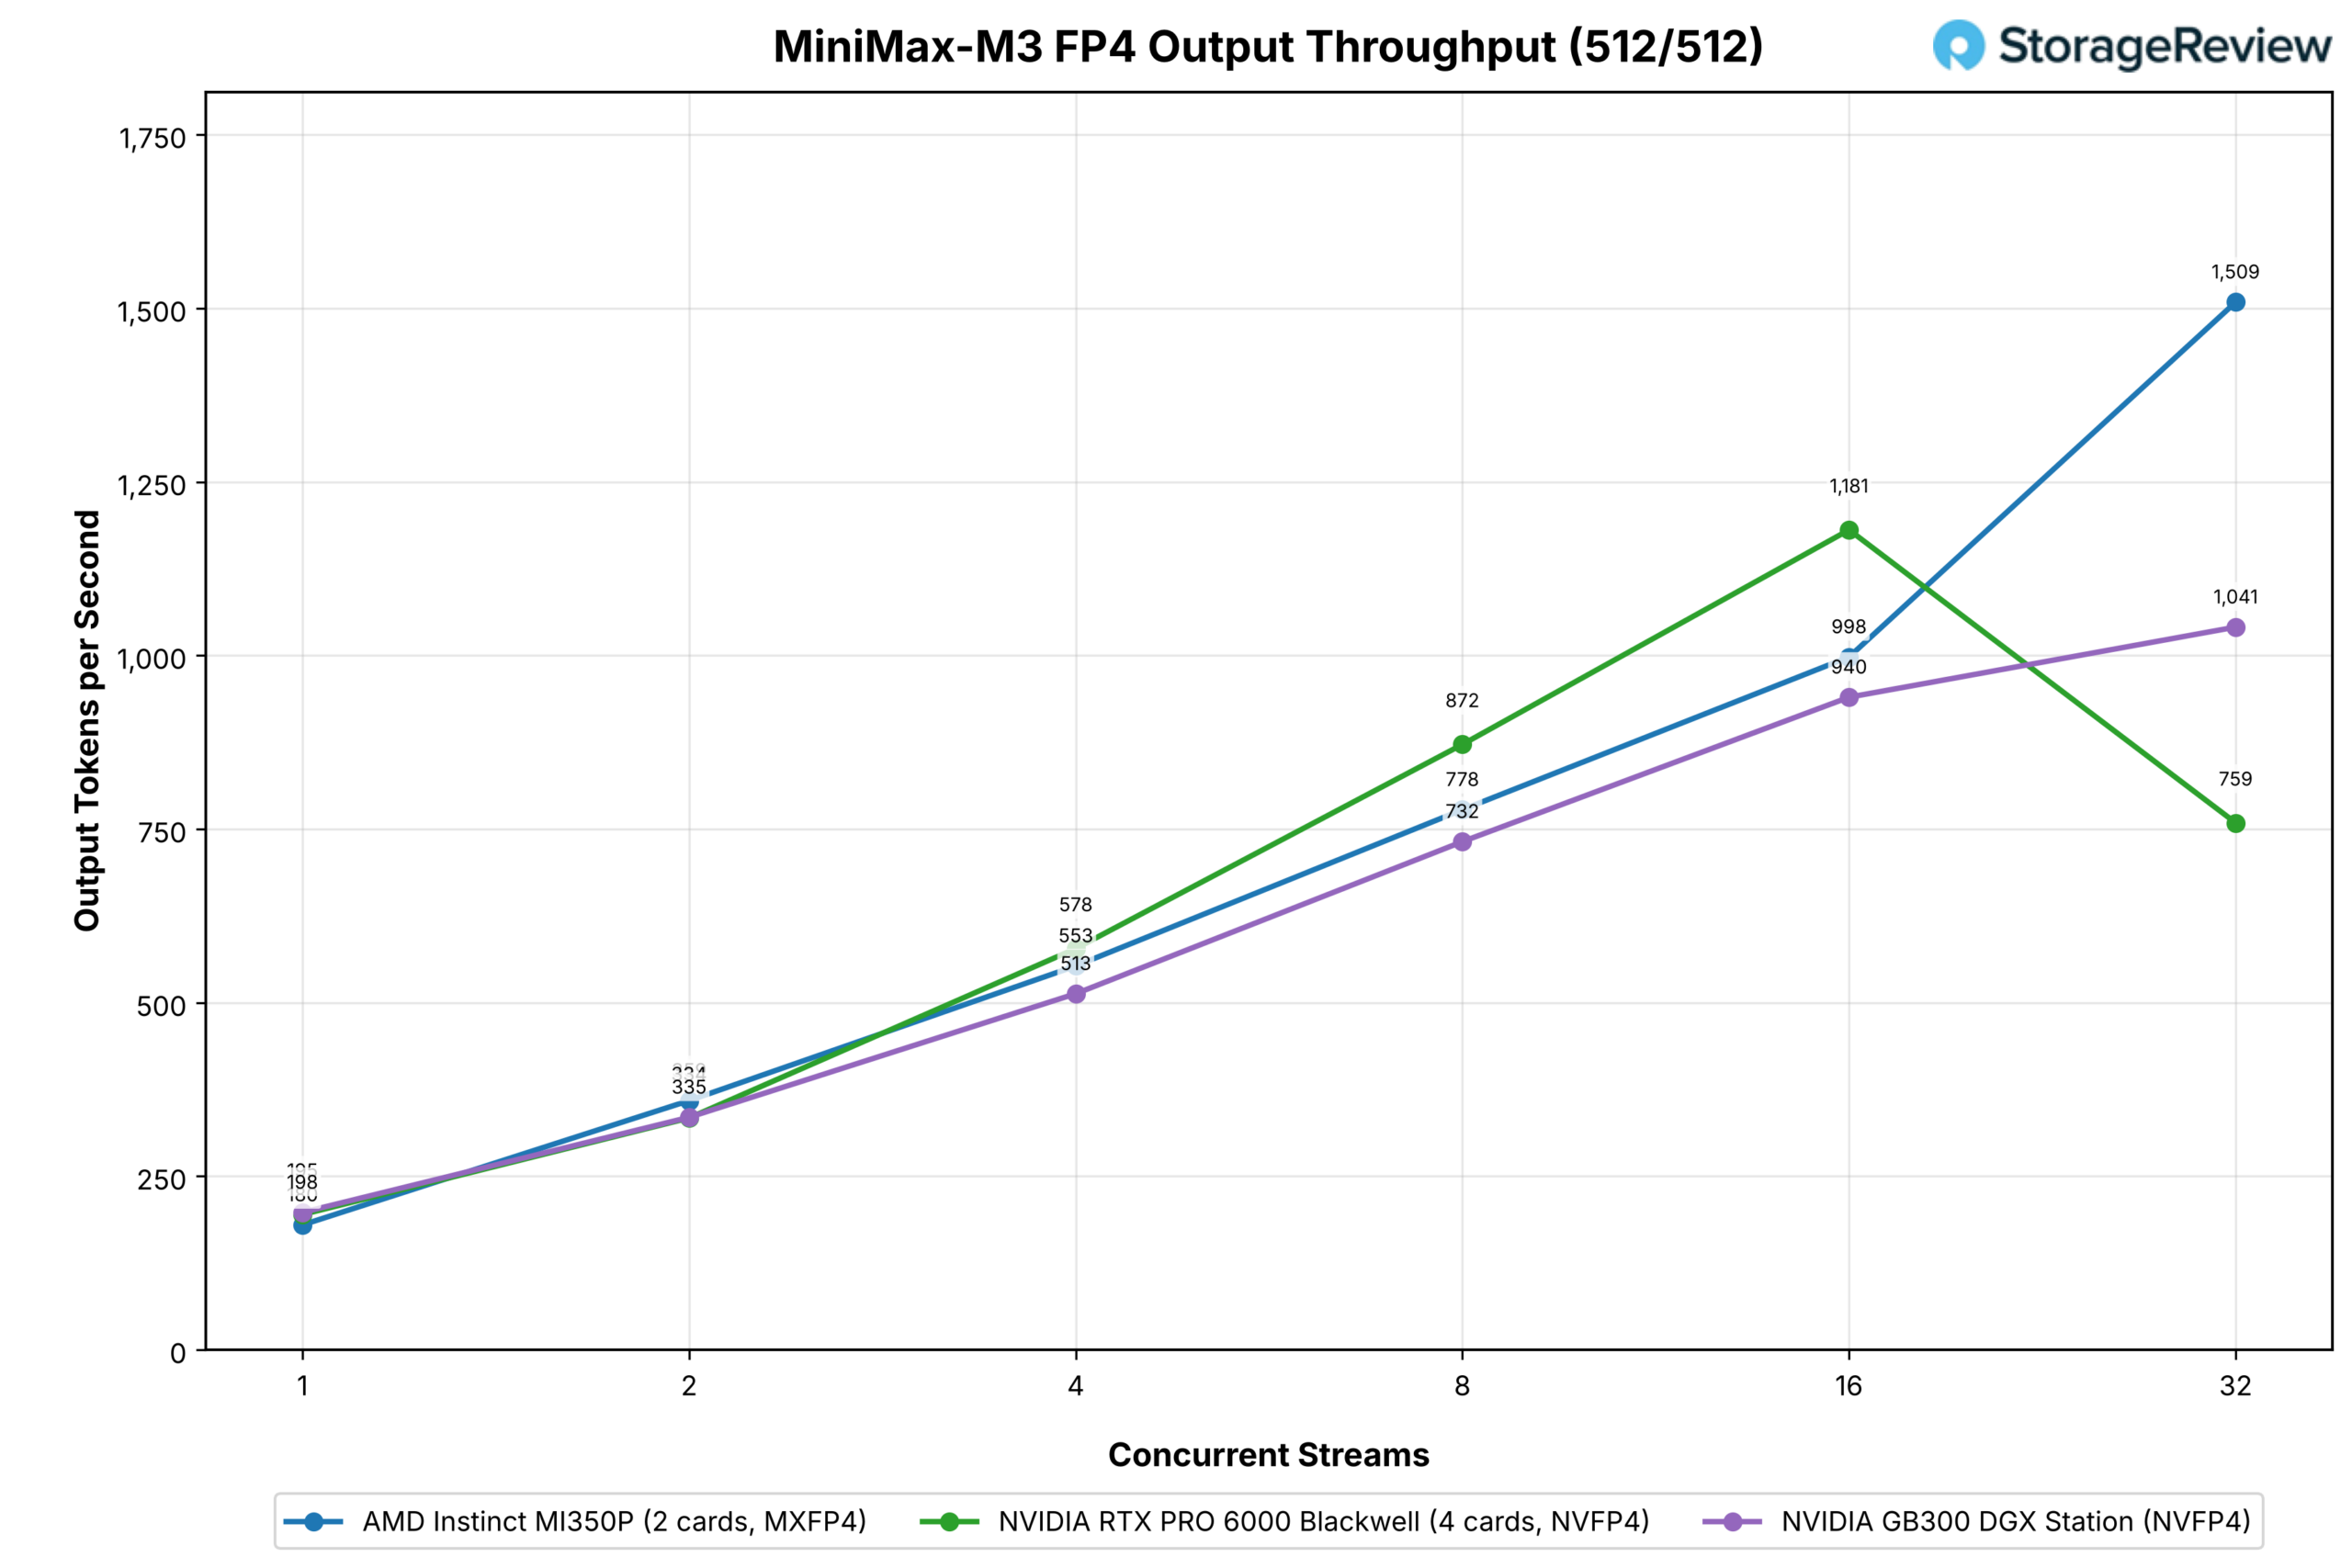
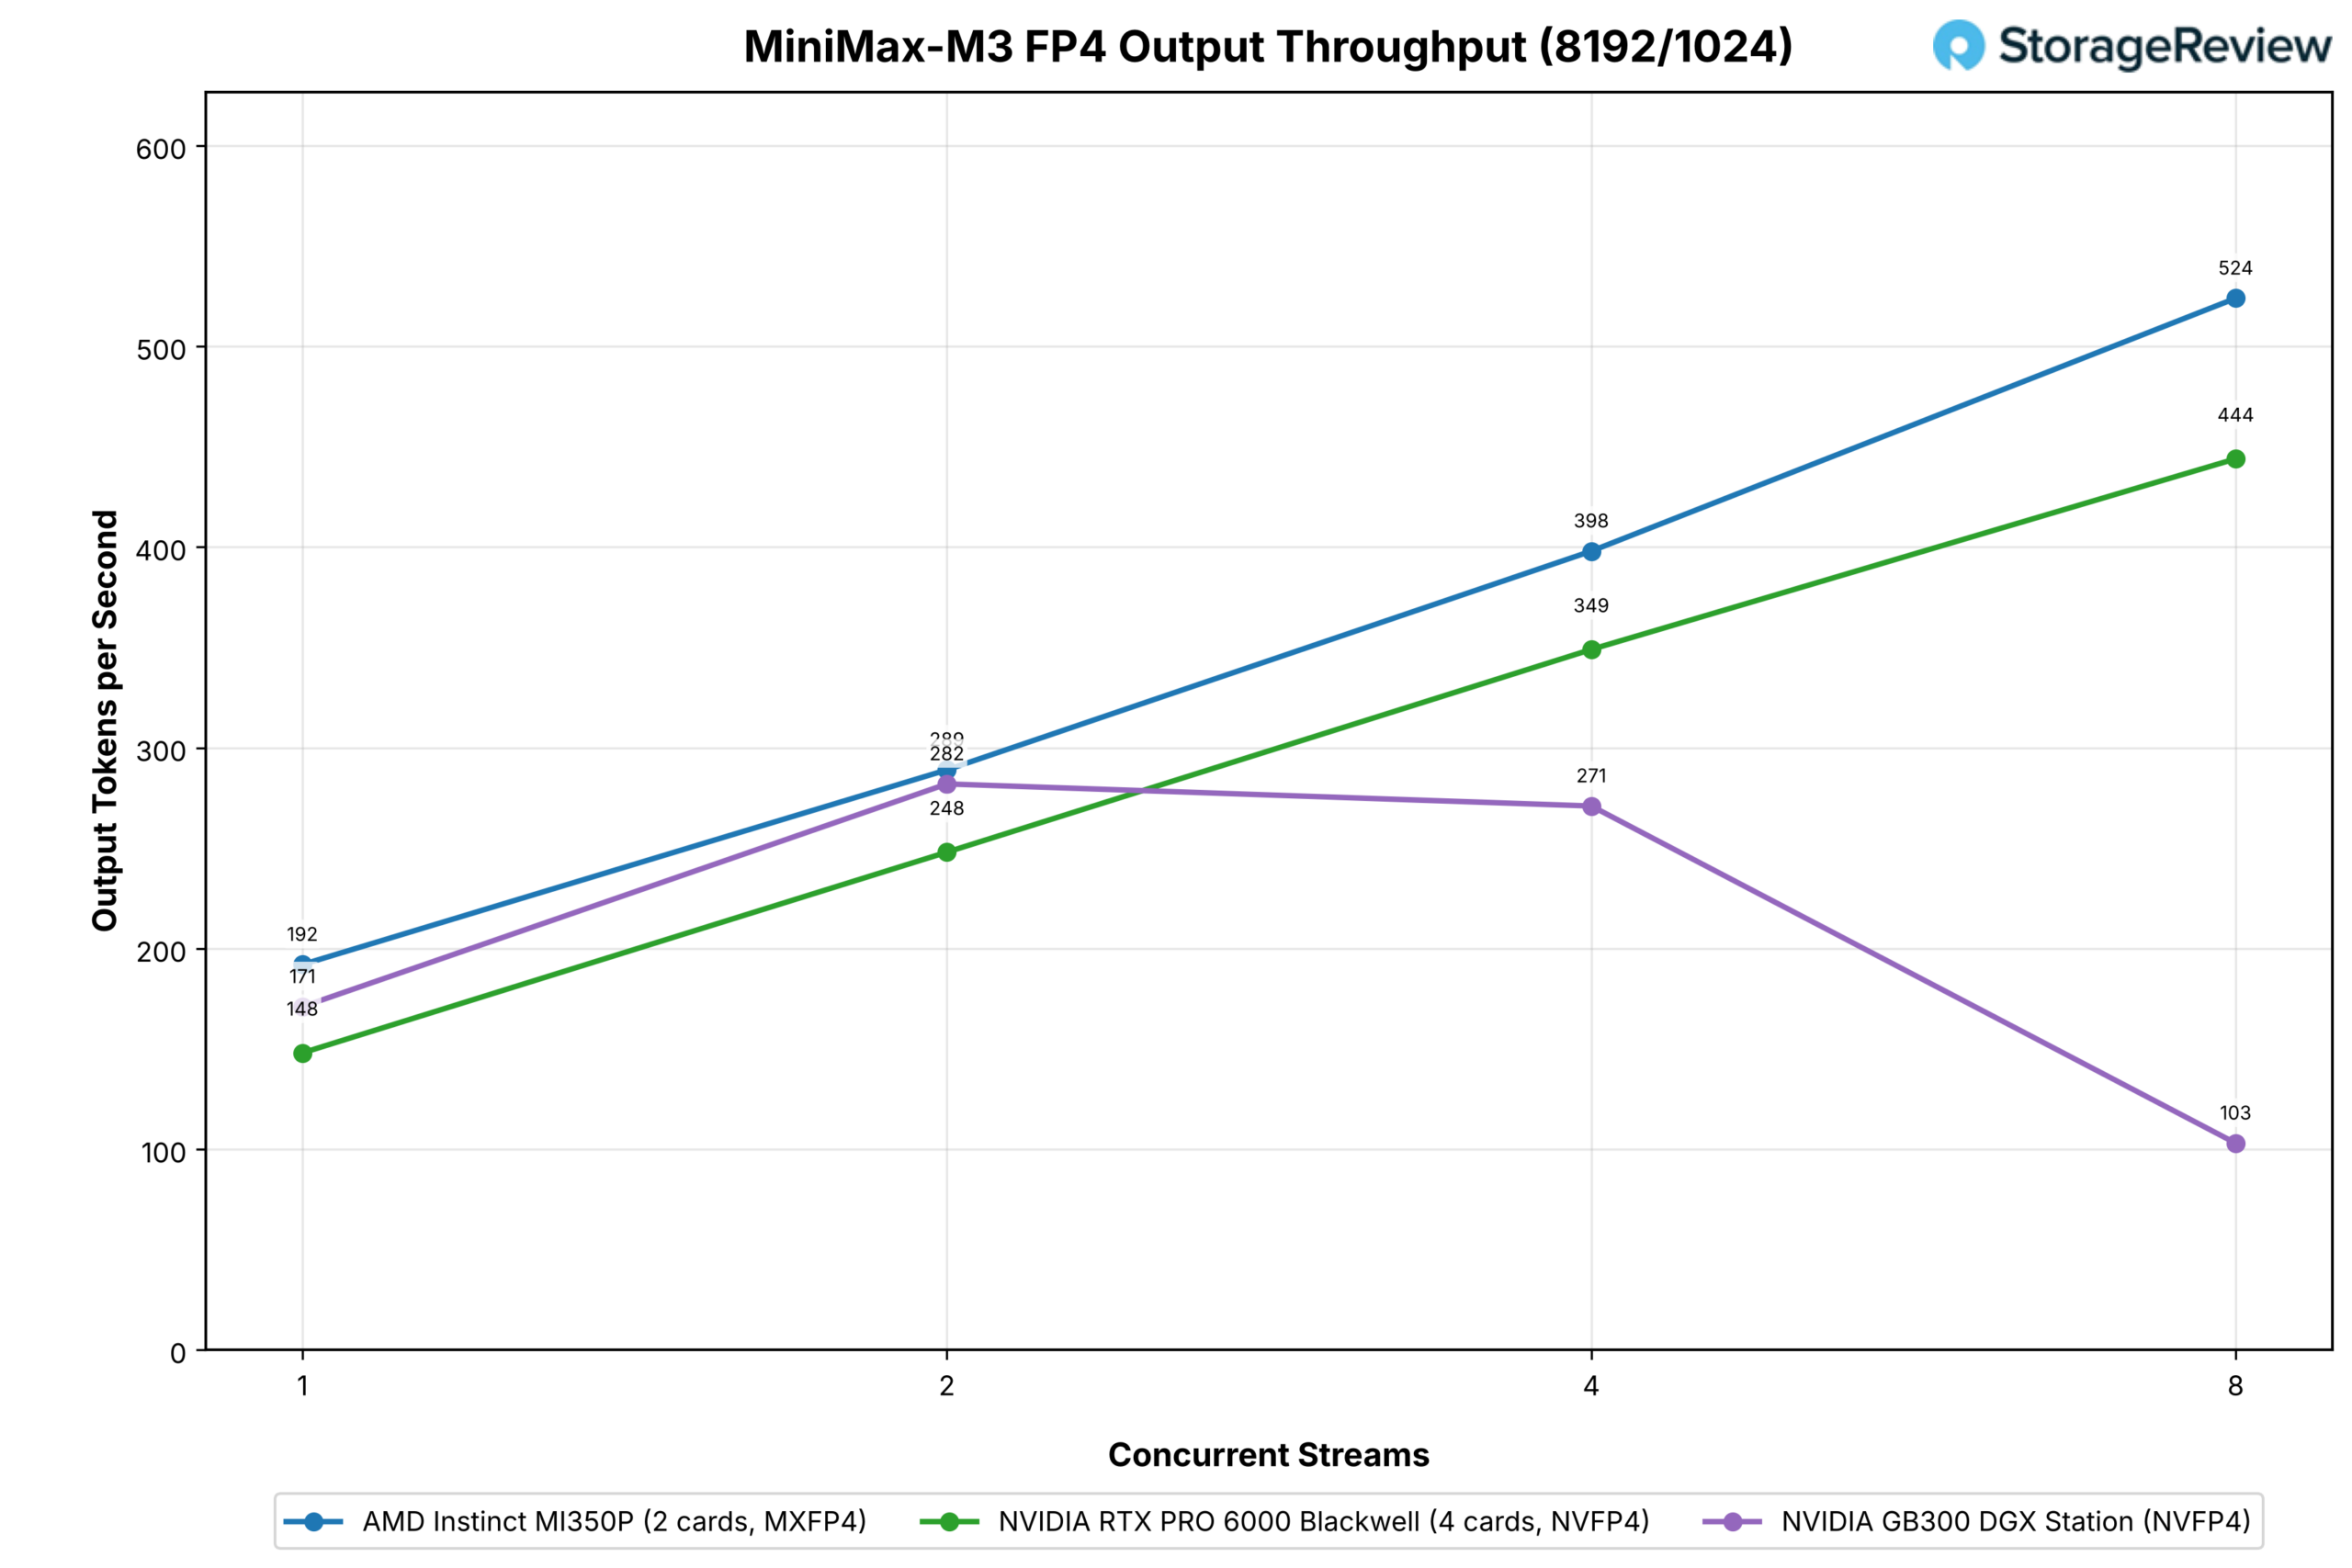
Due MI350P ospitano la build MXFP4 di MiniMax-M3 da 288 GB; la configurazione NVIDIA richiede quattro schede RTX PRO 6000. Le tre configurazioni presentano prestazioni simili, con una differenza inferiore al 10%, su otto flussi di lavoro nel test di chat; la configurazione con quattro RTX si impone a 16 (1,181 contro 998 per la coppia e 940 per la Station), mentre a 32 la coppia di MI350P raggiunge 1,509 contro 759 per la configurazione con quattro RTX e 1,041 per la Station.
Su prompt con precaricamento intensivo, la coppia MI350P è in testa in ogni punto attraverso otto flussi, 524 contro 444 per il quad, mentre la Station, che mantiene una parte degli esperti di questo modello nella memoria Grace, scende a 103.
DeepSeek-V4-Flash
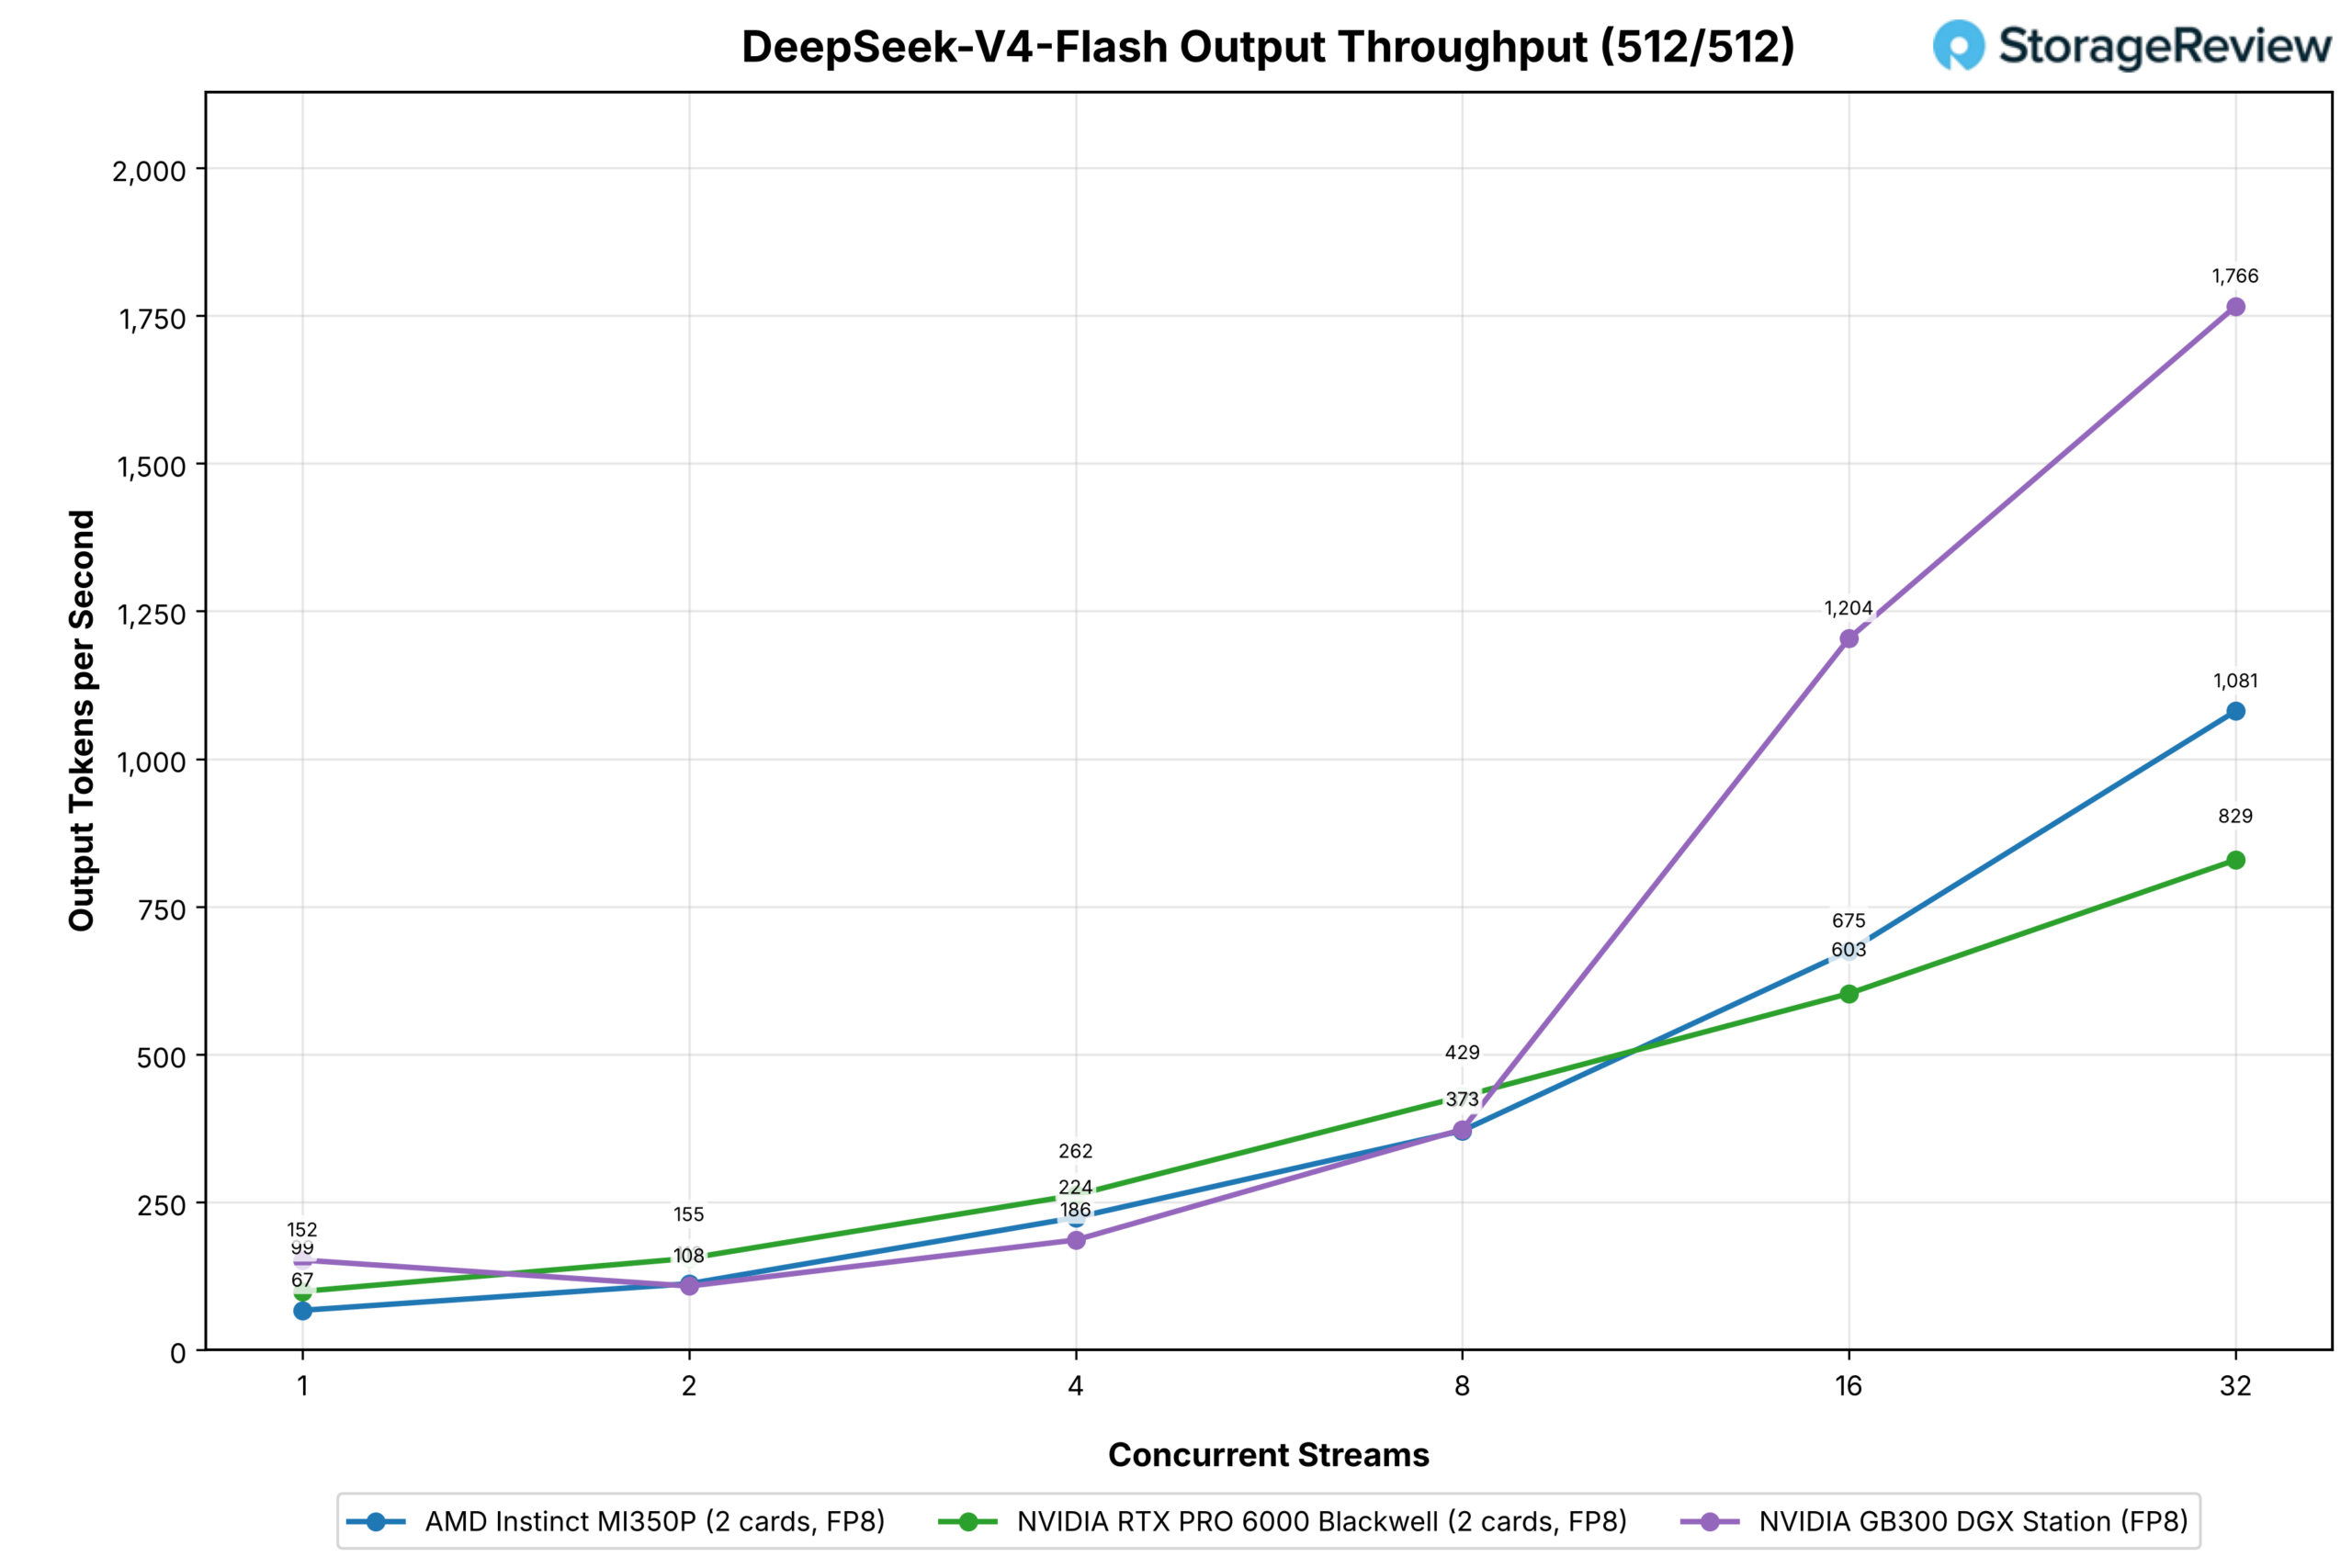
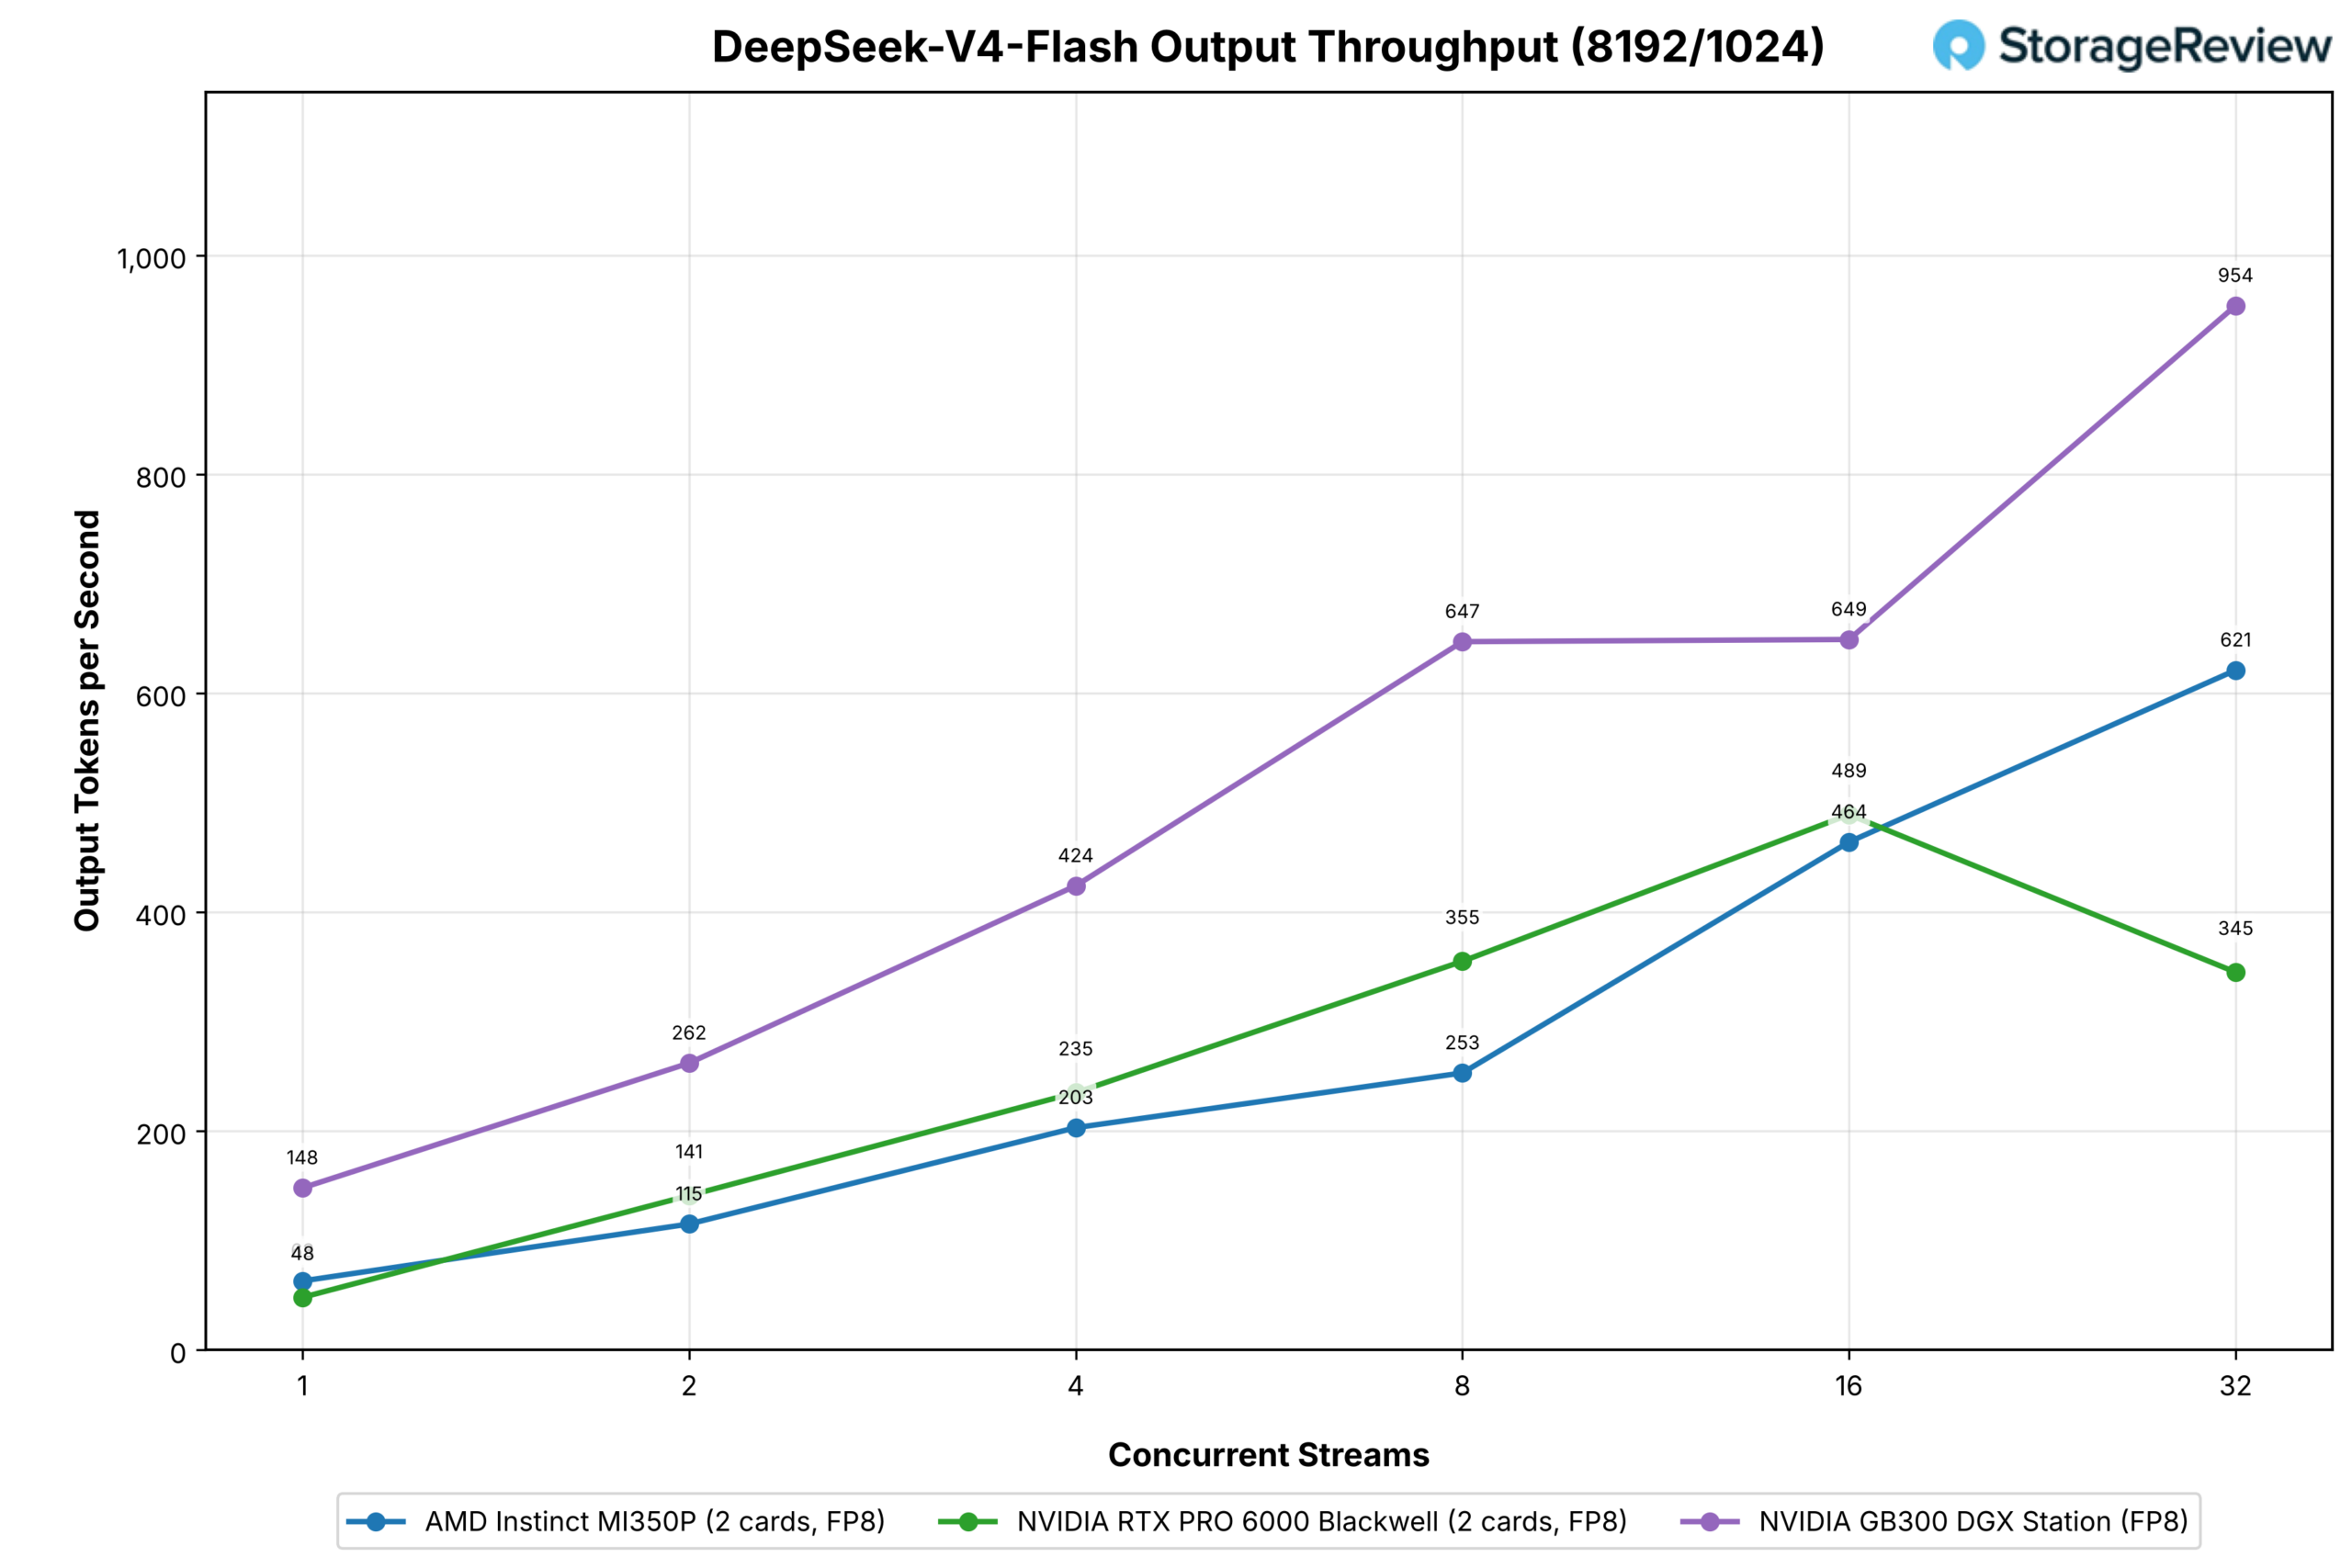
Con due schede per lato e il checkpoint nativo FP8, la coppia RTX PRO 6000 è in testa con otto stream nel carico di lavoro della chat e la coppia MI350P subentra da 16, terminando a 1,081 contro 829 con 32 stream; la singola Station raggiunge 1,766 allo stesso punto. La corsa con pre-riempimento segue lo stesso andamento, la coppia MI350P a 621 contro 345 per la coppia RTX con 32 stream e 954 per la Station.
MiniMax-M2.7
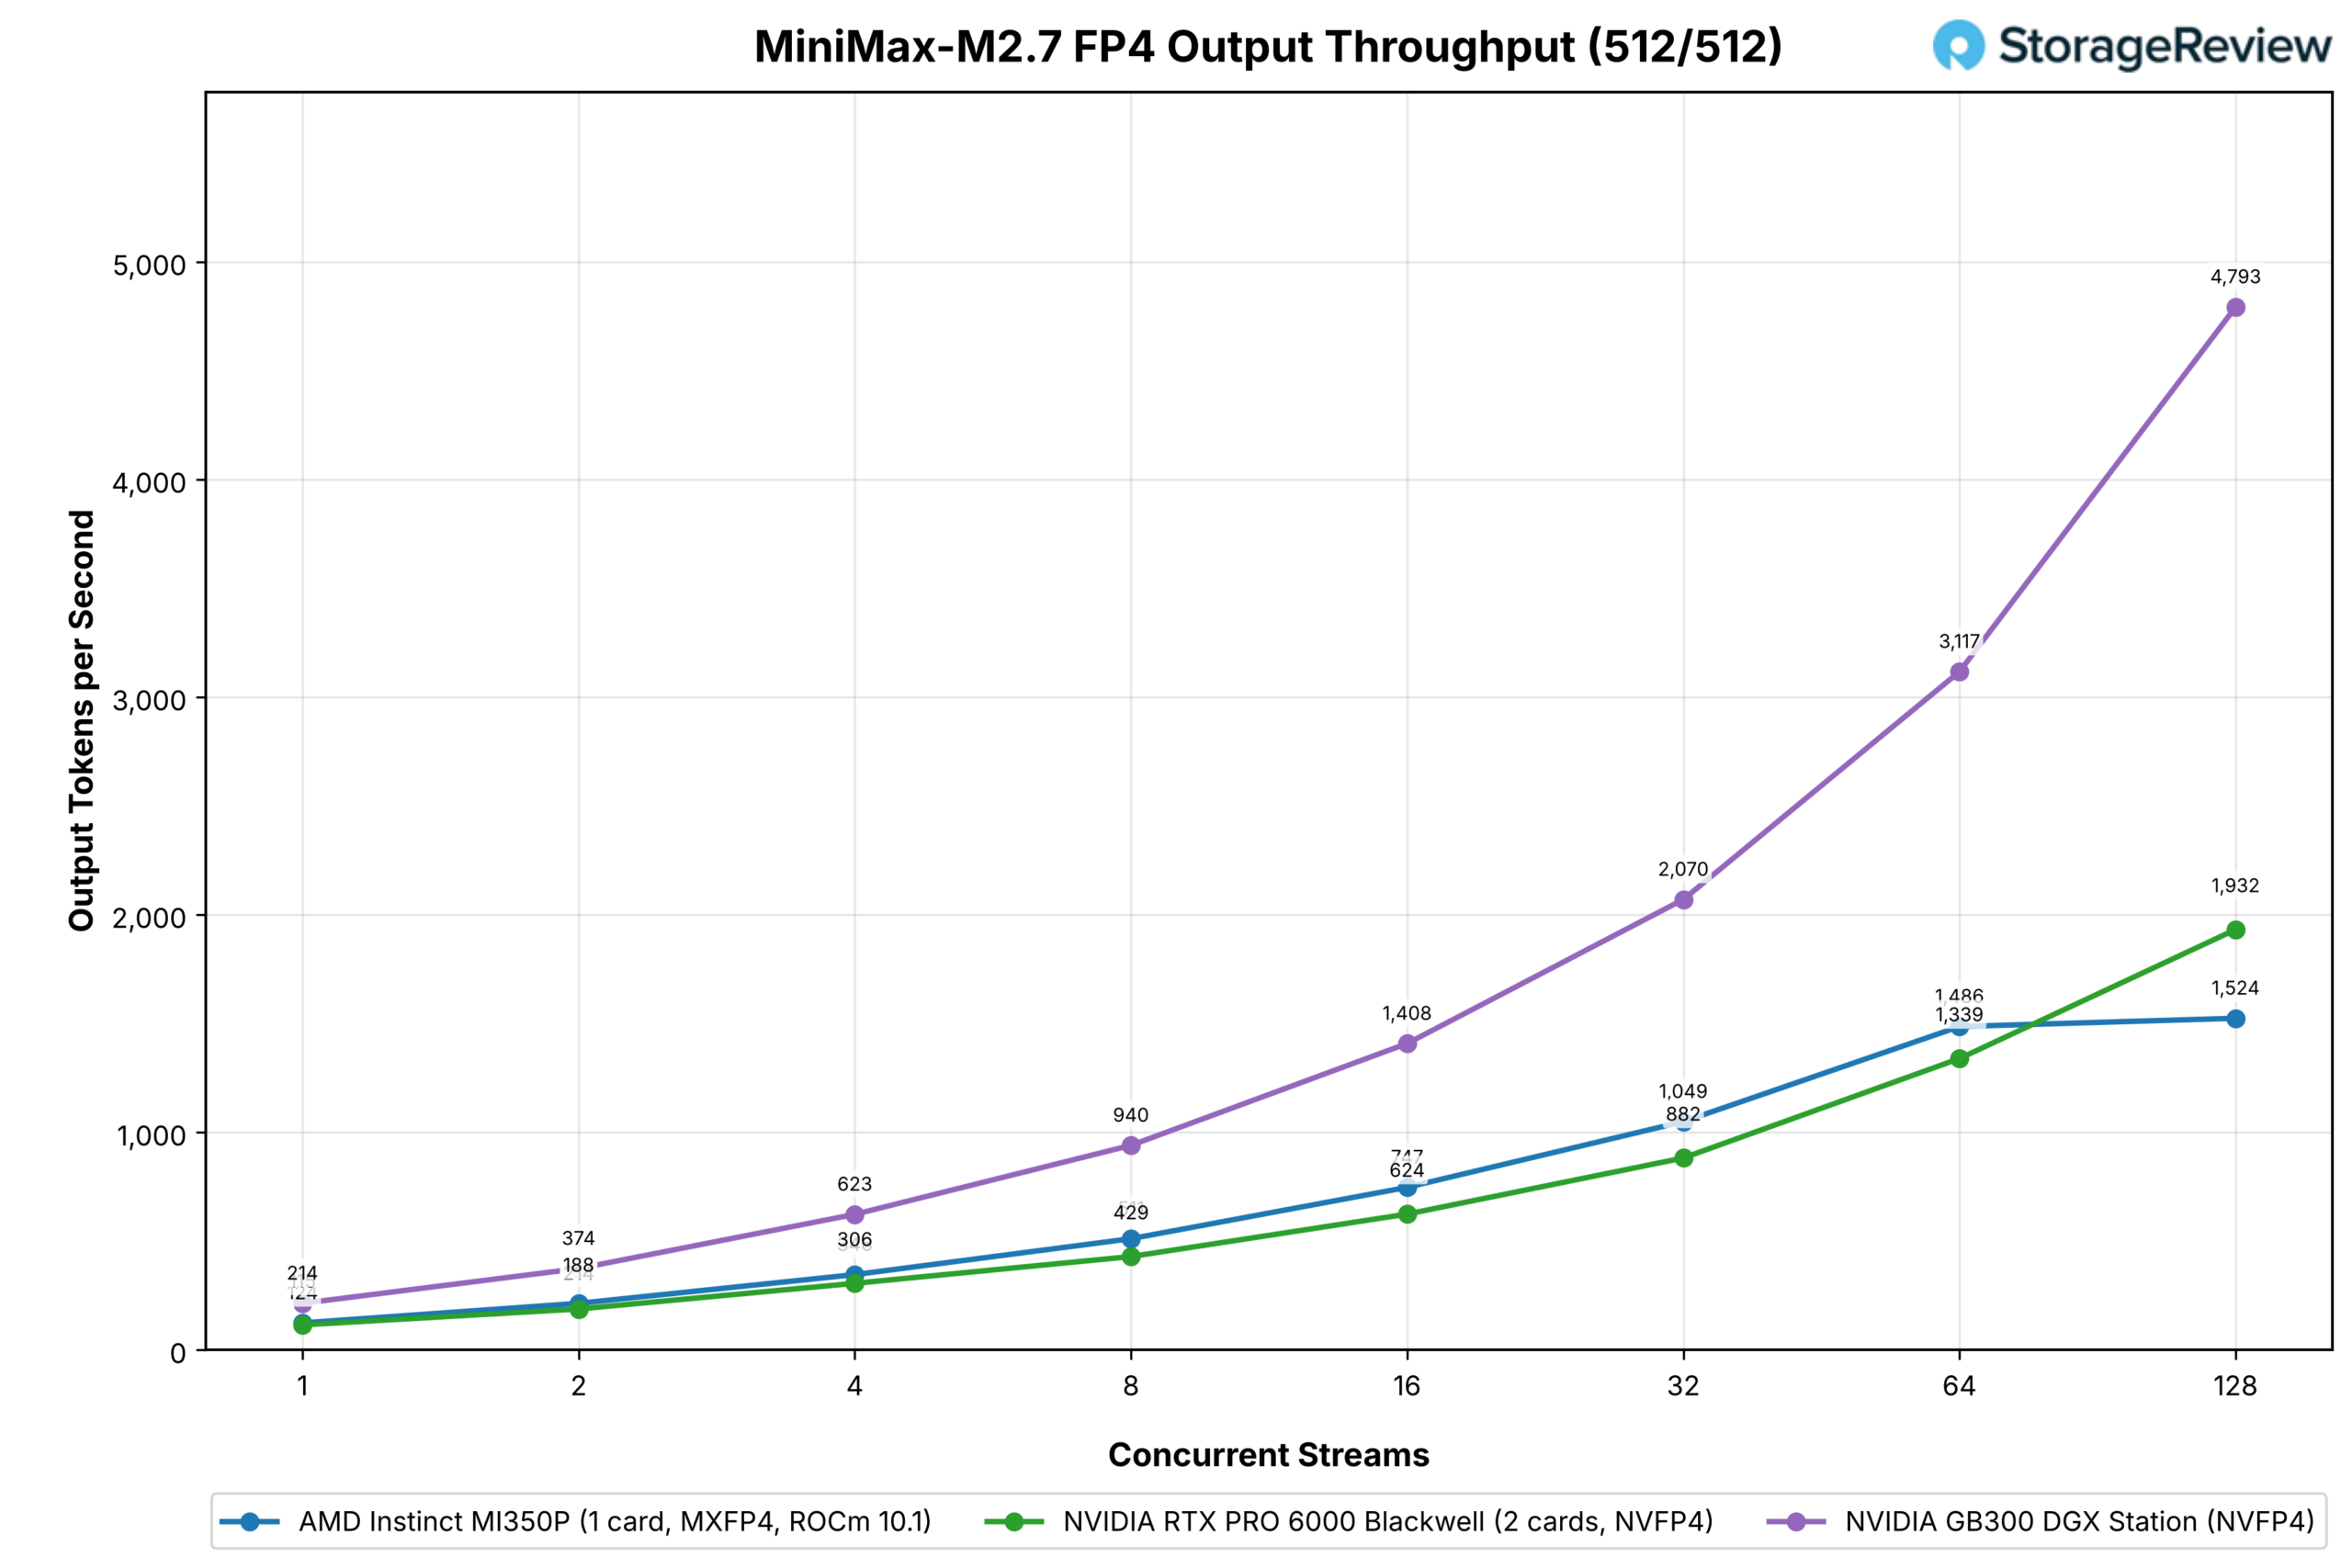
Un MI350P con la build MXFP4 di MiniMax-M2.7 viene messo a confronto con due schede RTX PRO 6000 su NVFP4. Il singolo MI350P è in vantaggio sulla coppia con un solo stream (124 contro 115), mantiene un vantaggio dall'8 al 20% fino a 64 stream (1,486 contro 1,339), per poi stabilizzarsi a 1,524 su 128 e 1,557 su 256, mentre la coppia di RTX continua a raggiungere 1,932 e 2,842; la Station arriva a 4,793.
Con un carico di lavoro che richiede un'elevata precarica, la MI350P mantiene una velocità di output compresa tra 304 e 331 token al secondo da otto a 64 flussi, contro i 501 della coppia RTX e i 1,744 della Station.
GPT-OSS-120B
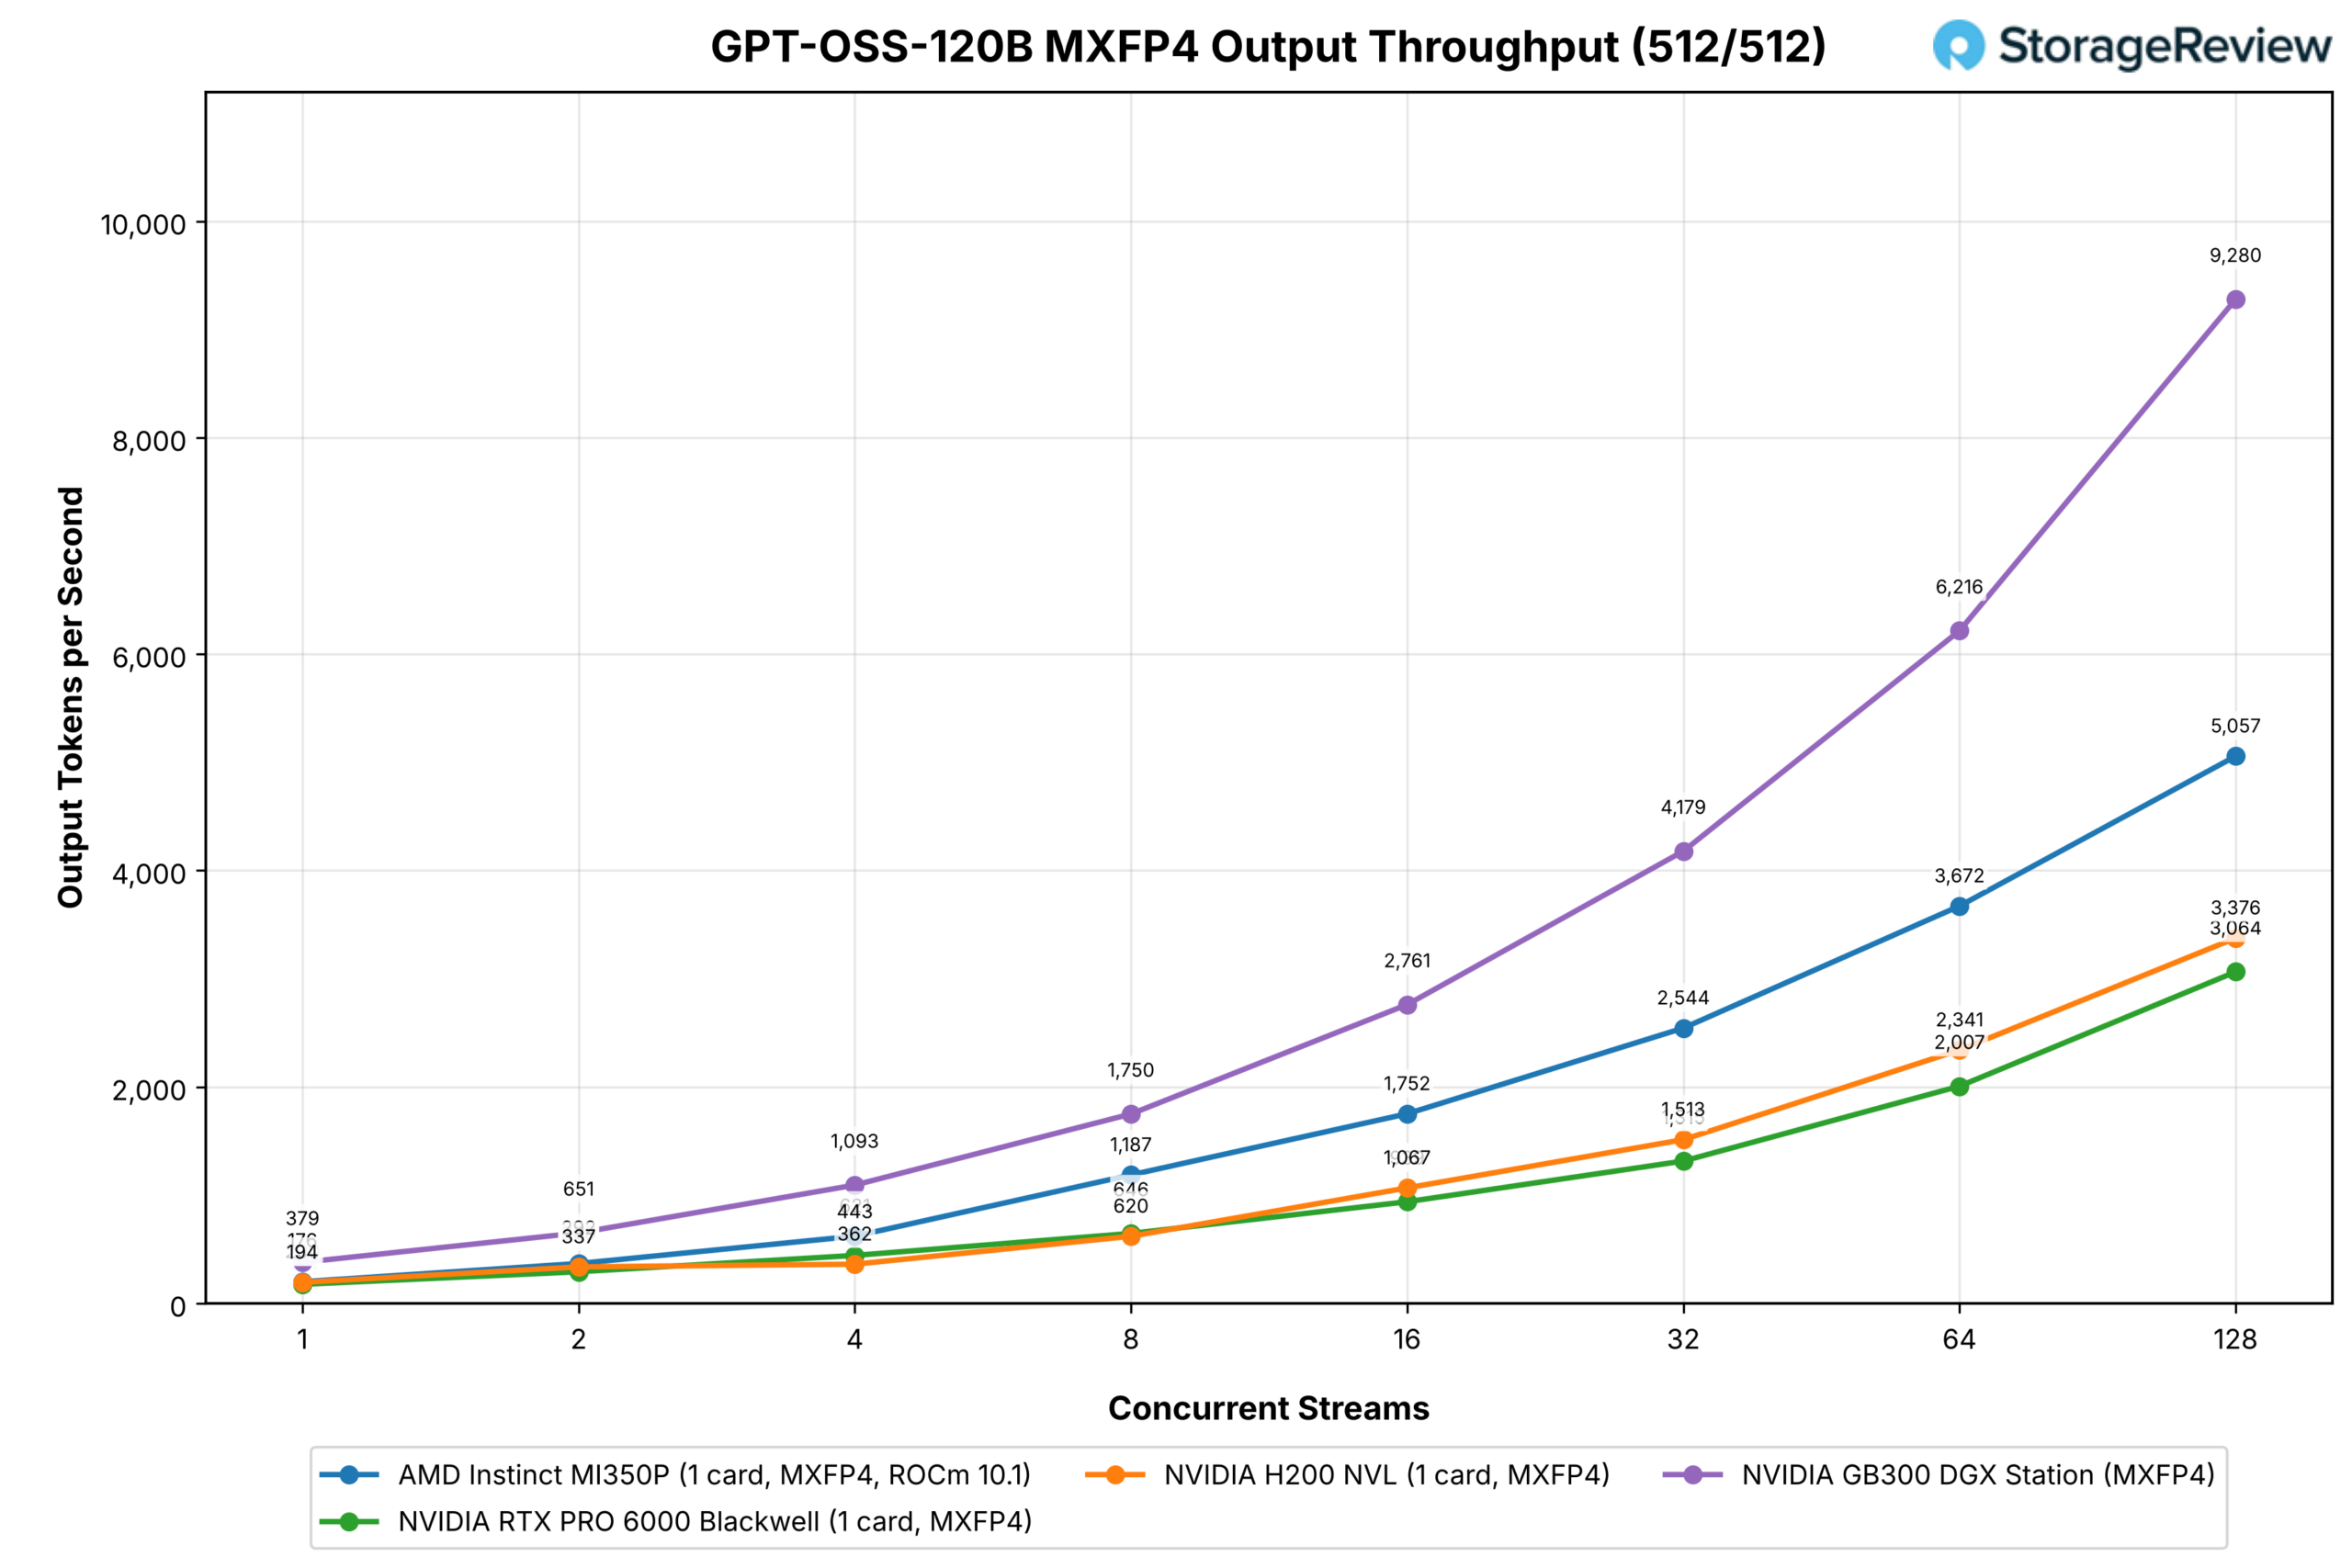
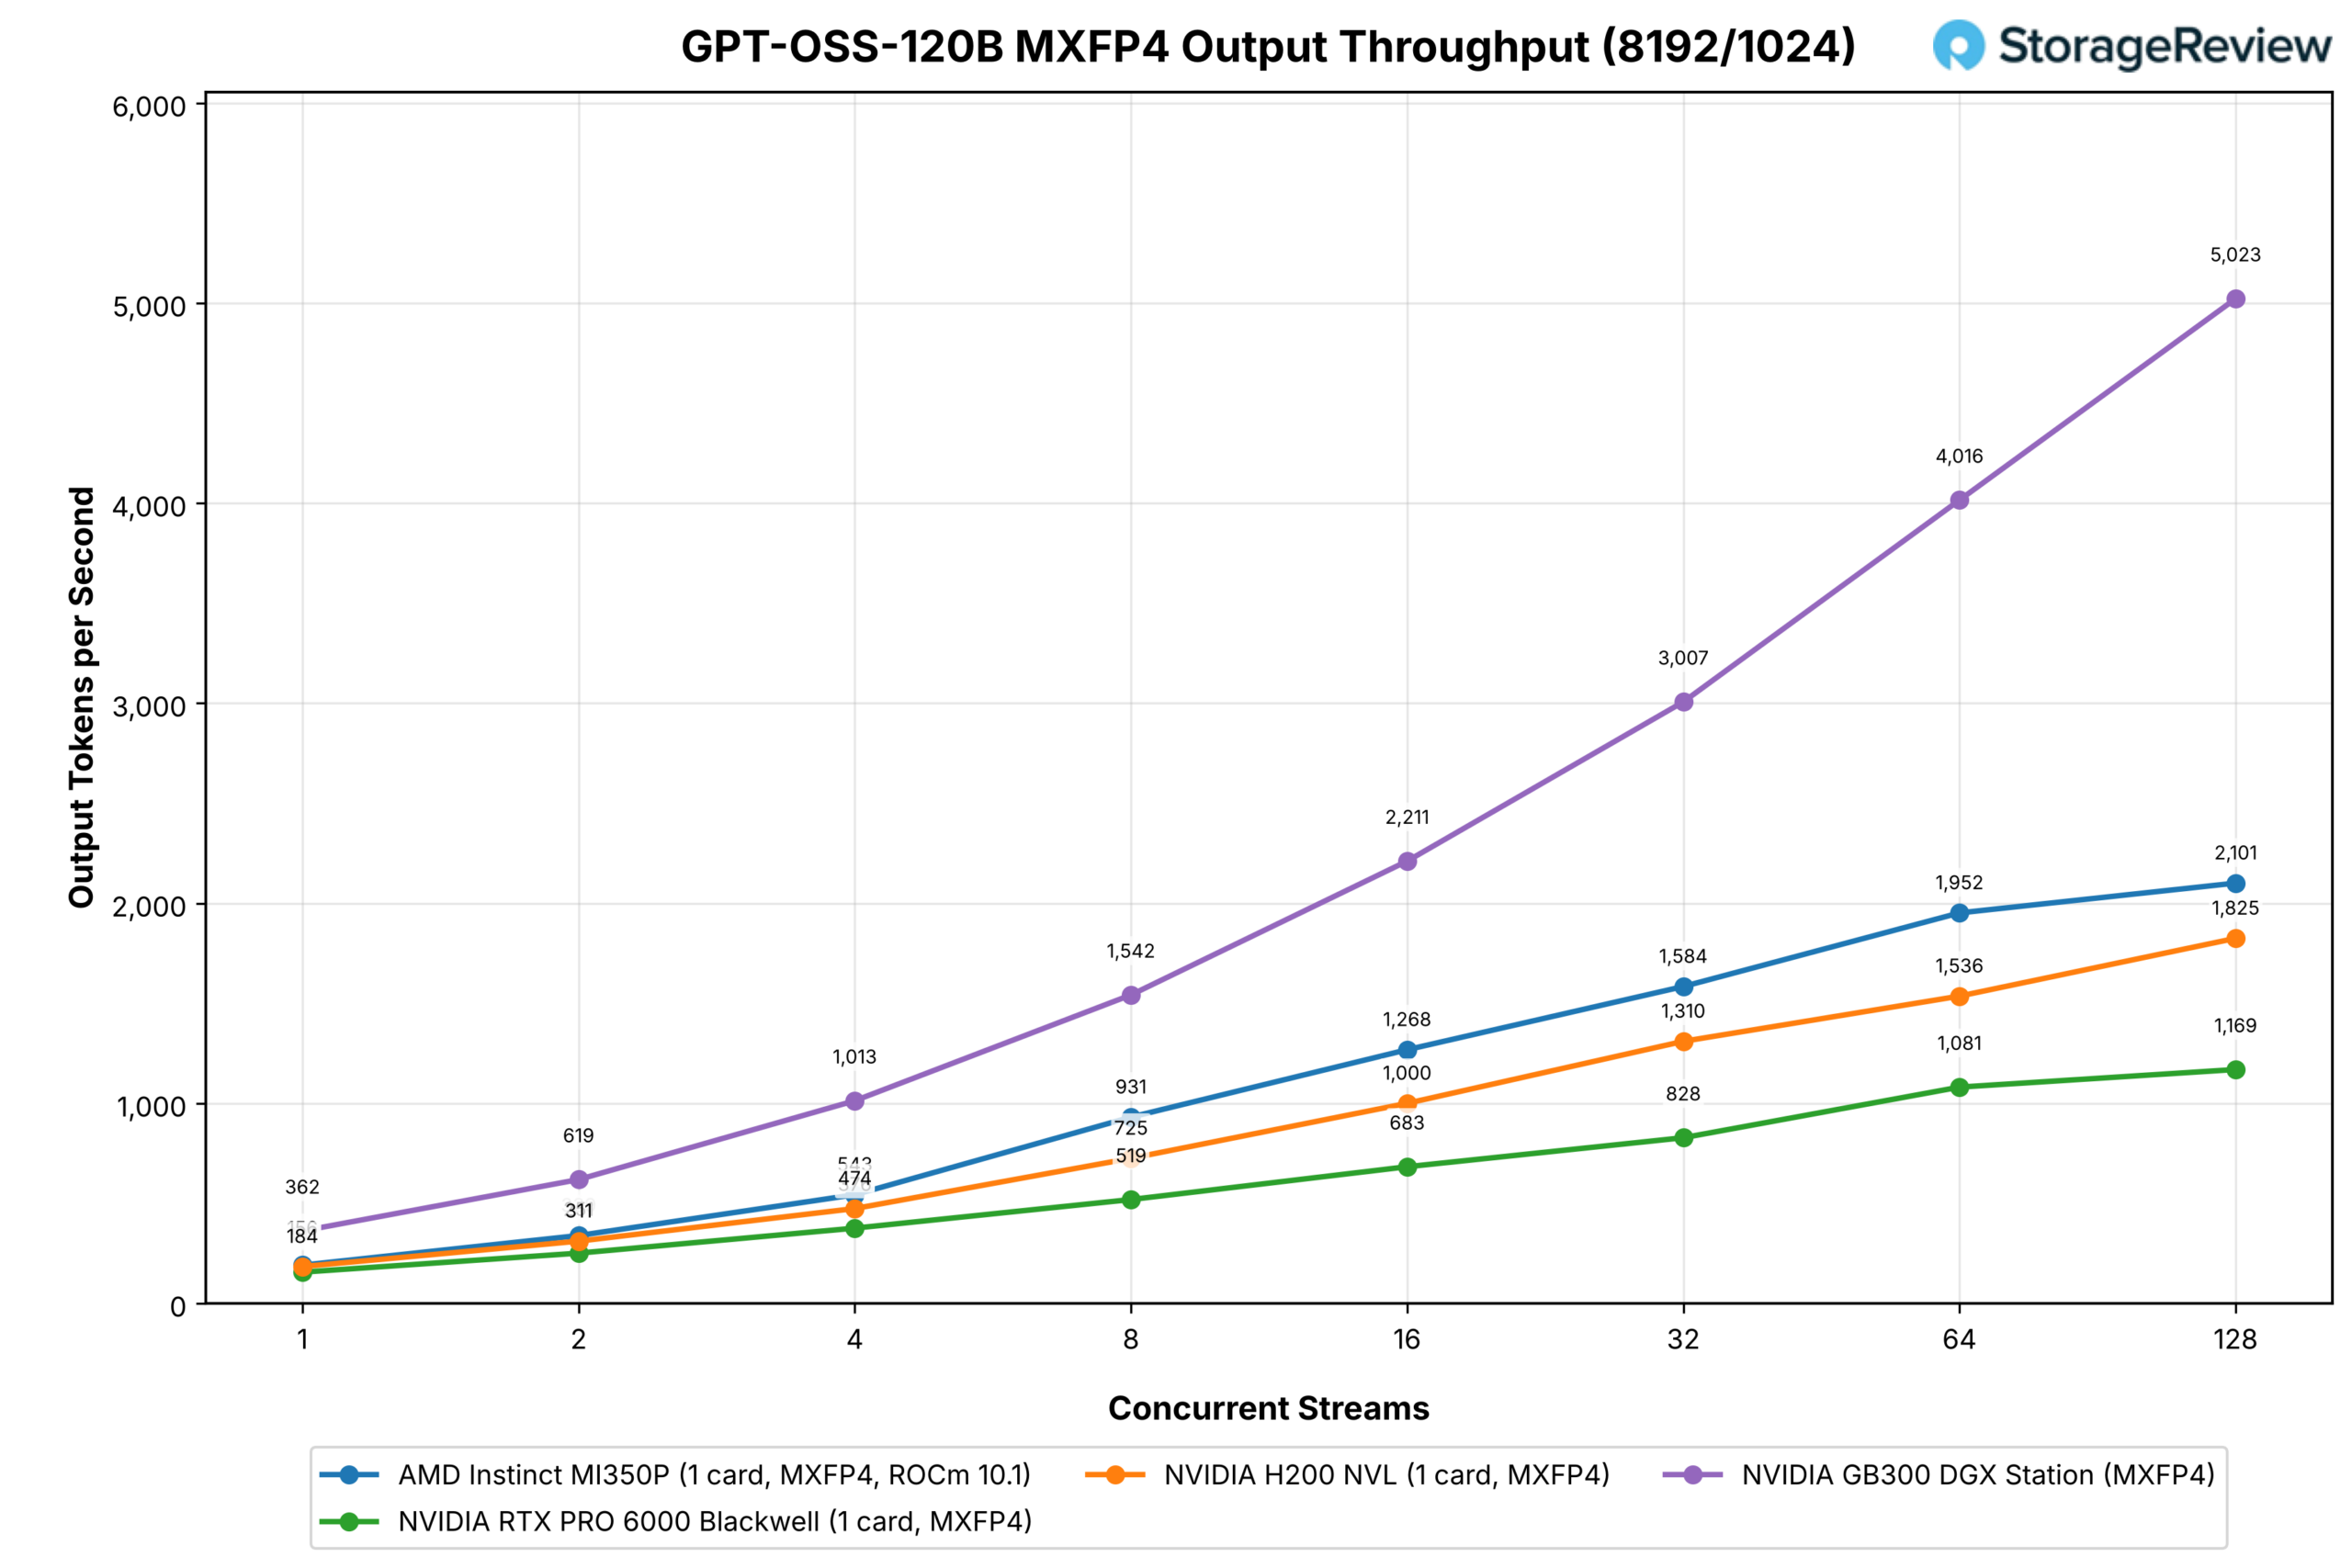
GPT-OSS viene distribuito come MXFP4, quindi ogni scheda esegue gli stessi pesi. Una MI350P supera una RTX PRO 6000 per ogni numero di stream su entrambi i carichi di lavoro, dal 40 al 93 percento a partire da quattro stream, e termina con 5,057 token di output al secondo sul carico di lavoro della chat e 2,101 sui prompt con precaricamento intensivo a 128 stream, contro 3,064 e 1,169 per la RTX PRO 6000 e 3,376 e 1,825 per la H200 NVL; la Station raggiunge 9,280 e 5,023.
Il test MLPerf Inference v6.1 di AMD e Dell, presentato il 16 settembre, pone un limite allo stesso modello: otto MI350P in un PowerEdge XE7745 hanno prodotto 48,971 token al secondo offline e 40,868 nello scenario server su GPT-OSS-120B, ovvero 6,121 e 5,108 per GPU, su uno stack di test ottimizzato. Questo test e il nostro non sono identici, ma i 5,057 che abbiamo misurato con 128 stream su vLLM standard si collocano nella parte inferiore di tale intervallo.
GPT-OSS-20B
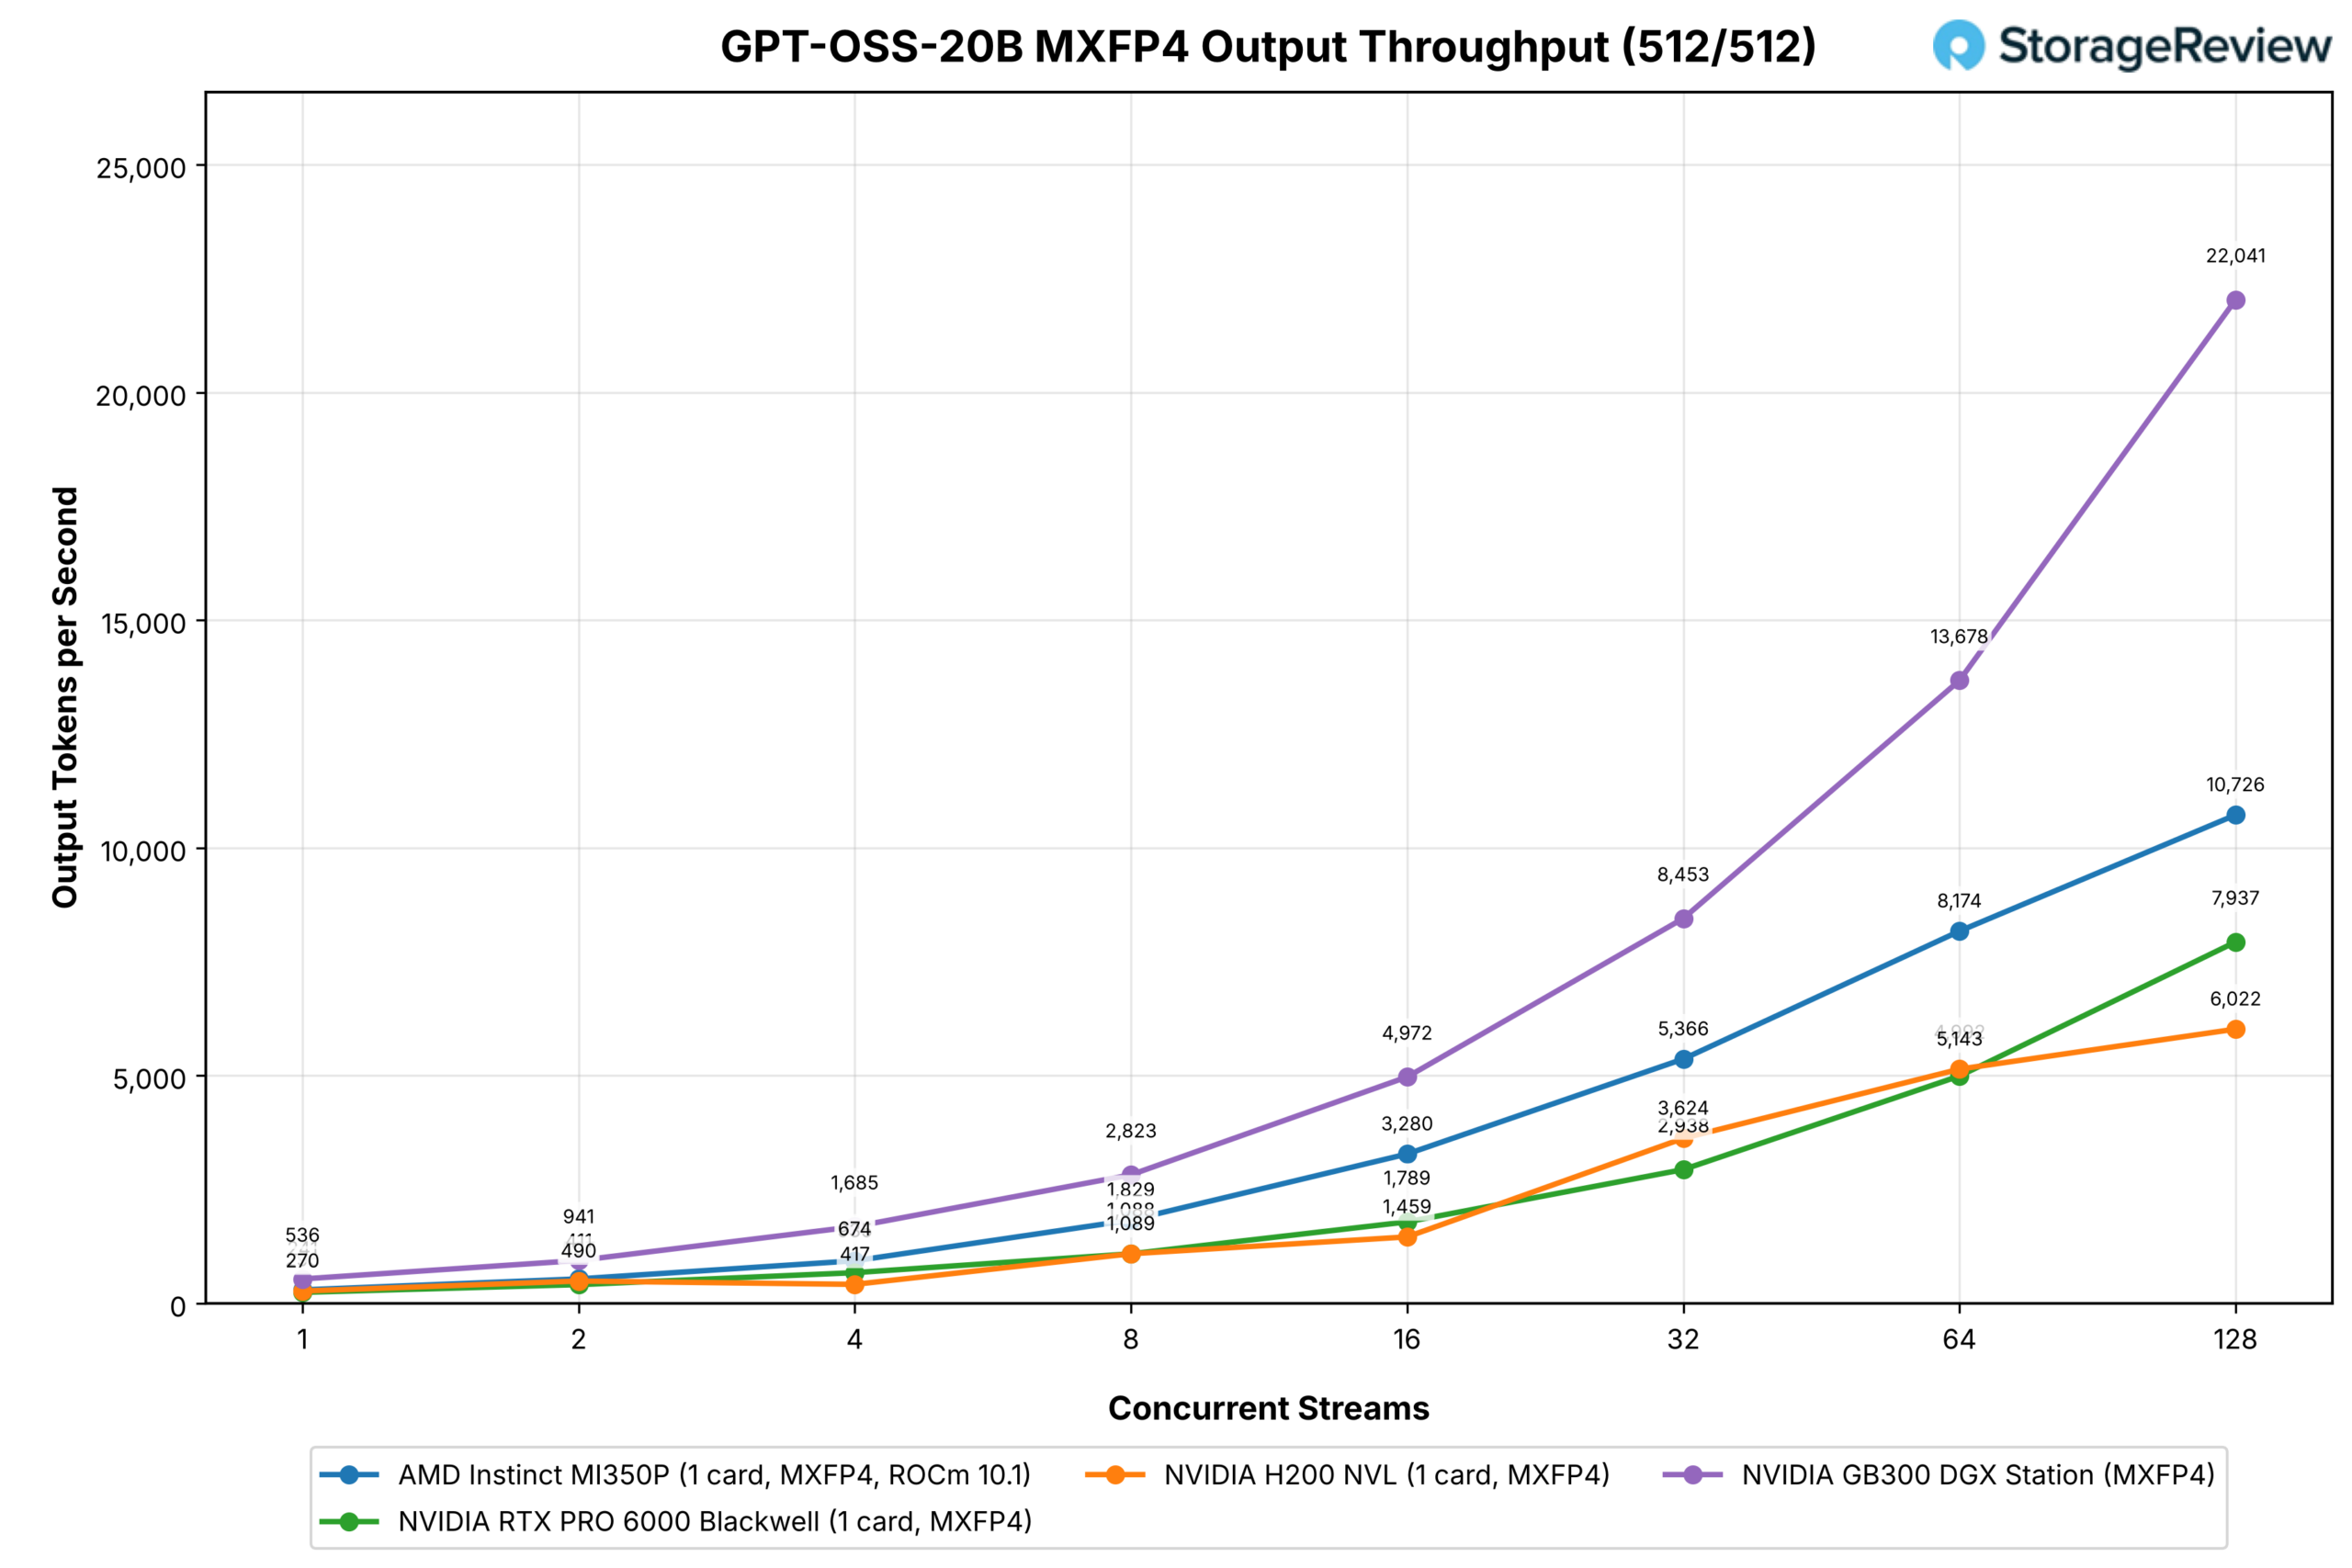
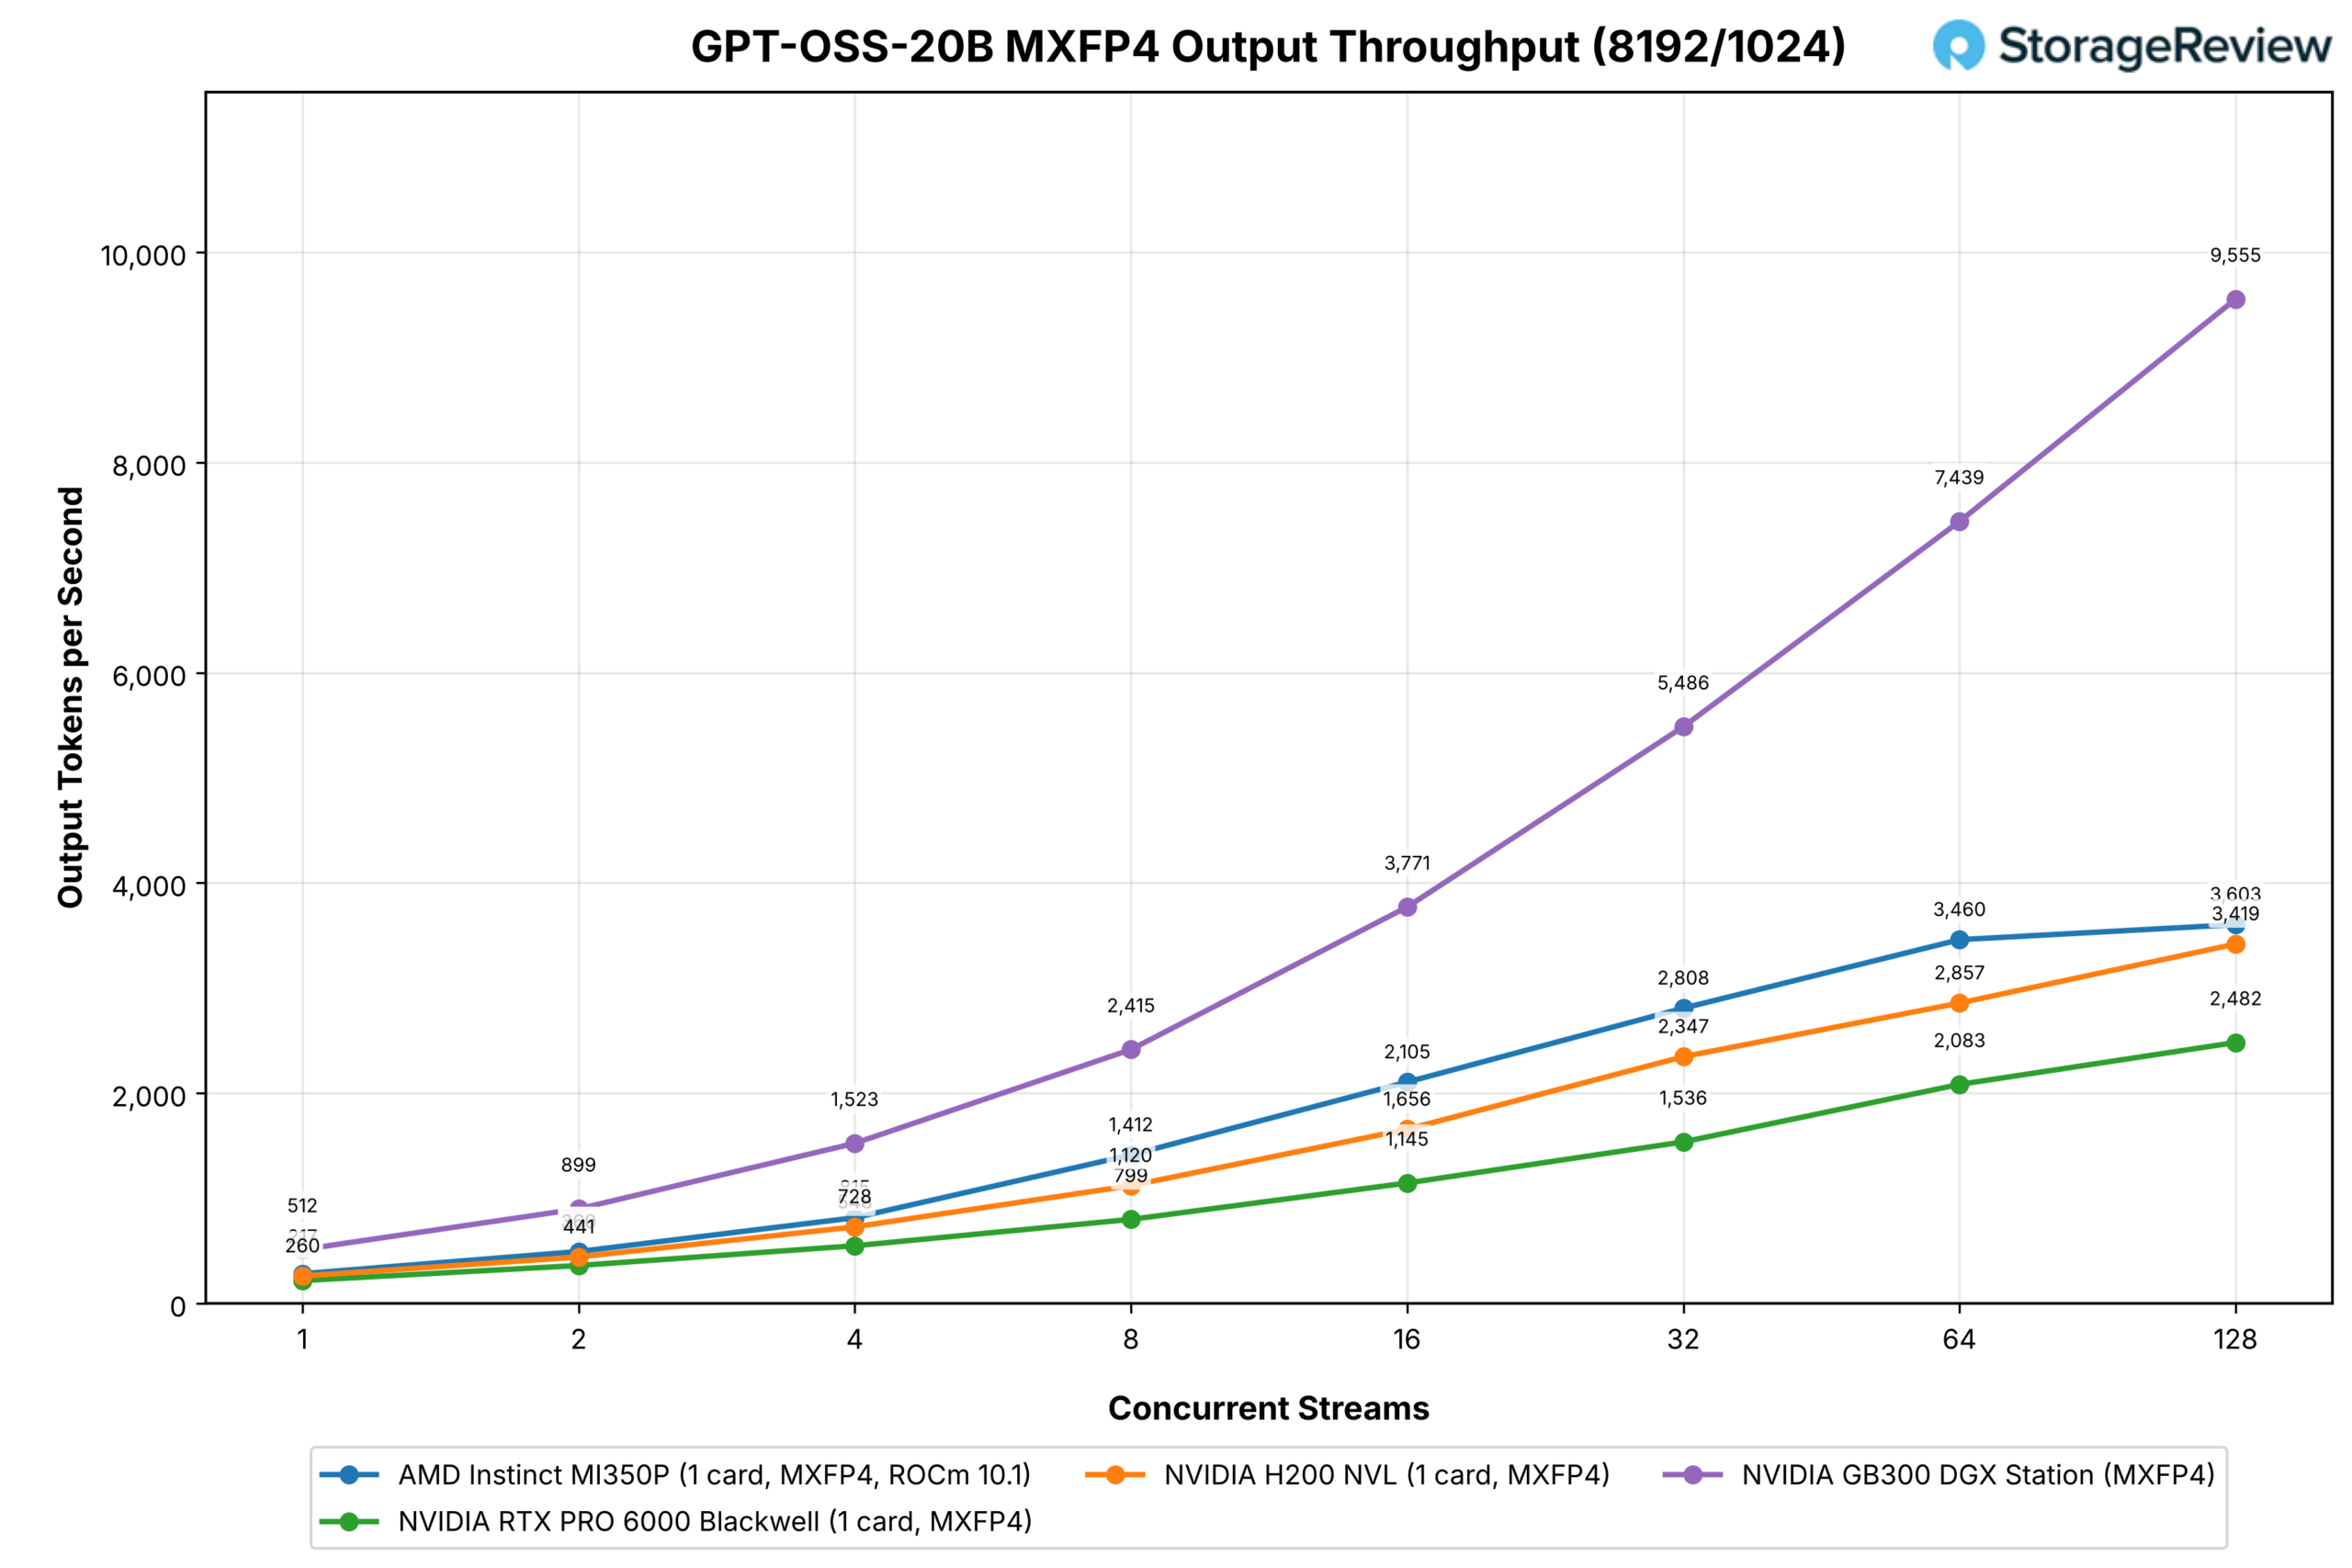
Il modello OpenAI più piccolo segue la stessa curva. La MI350P supera la RTX PRO 6000 in ogni punto, 8,174 contro 4,992 a 64 stream e 10,726 contro 7,937 a 128 sul carico di lavoro della chat, e 3,460 contro 2,083 e 3,603 contro 2,482 sui prompt con precompilazione intensa, e raggiunge 16,406 a 256 stream dove la RTX PRO 6000 legge 11,077. La H200 NVL è in svantaggio rispetto alla MI350P in entrambe le forme, a 6,022 e 3,419 a 128 stream, e la Station si attesta a 22,041 e 9,555.
Qwen3-Coder-30B-A3B
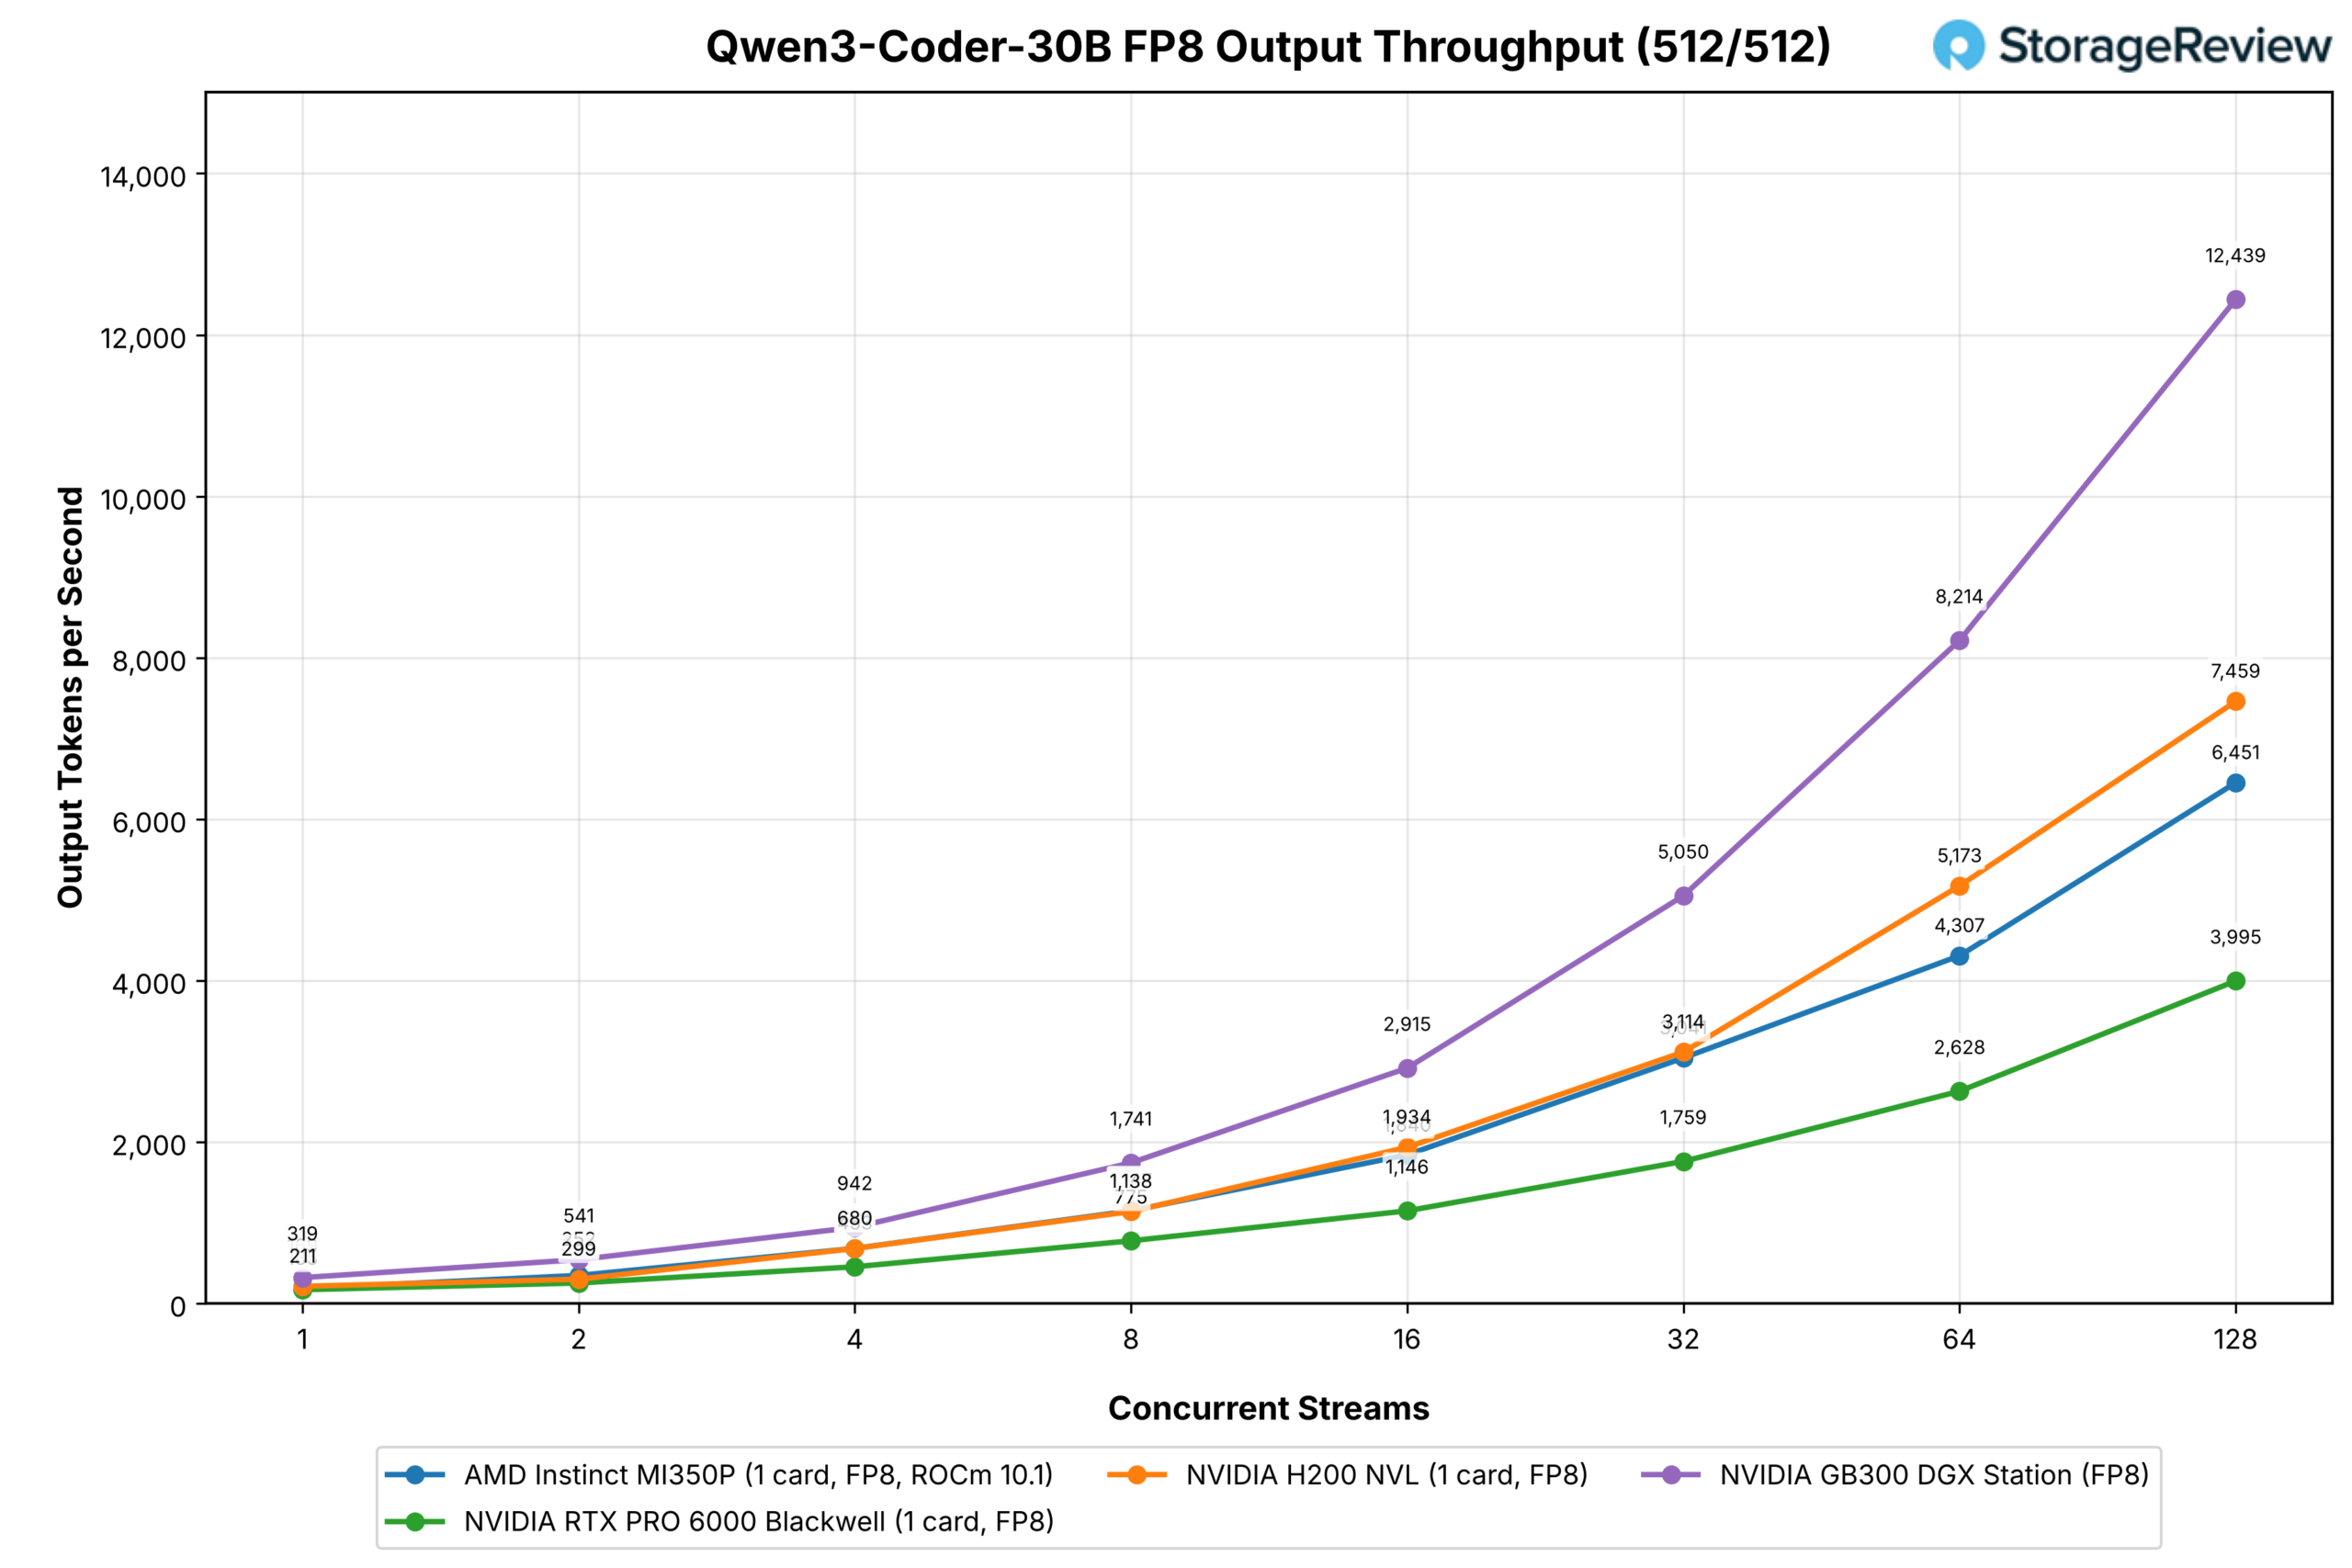
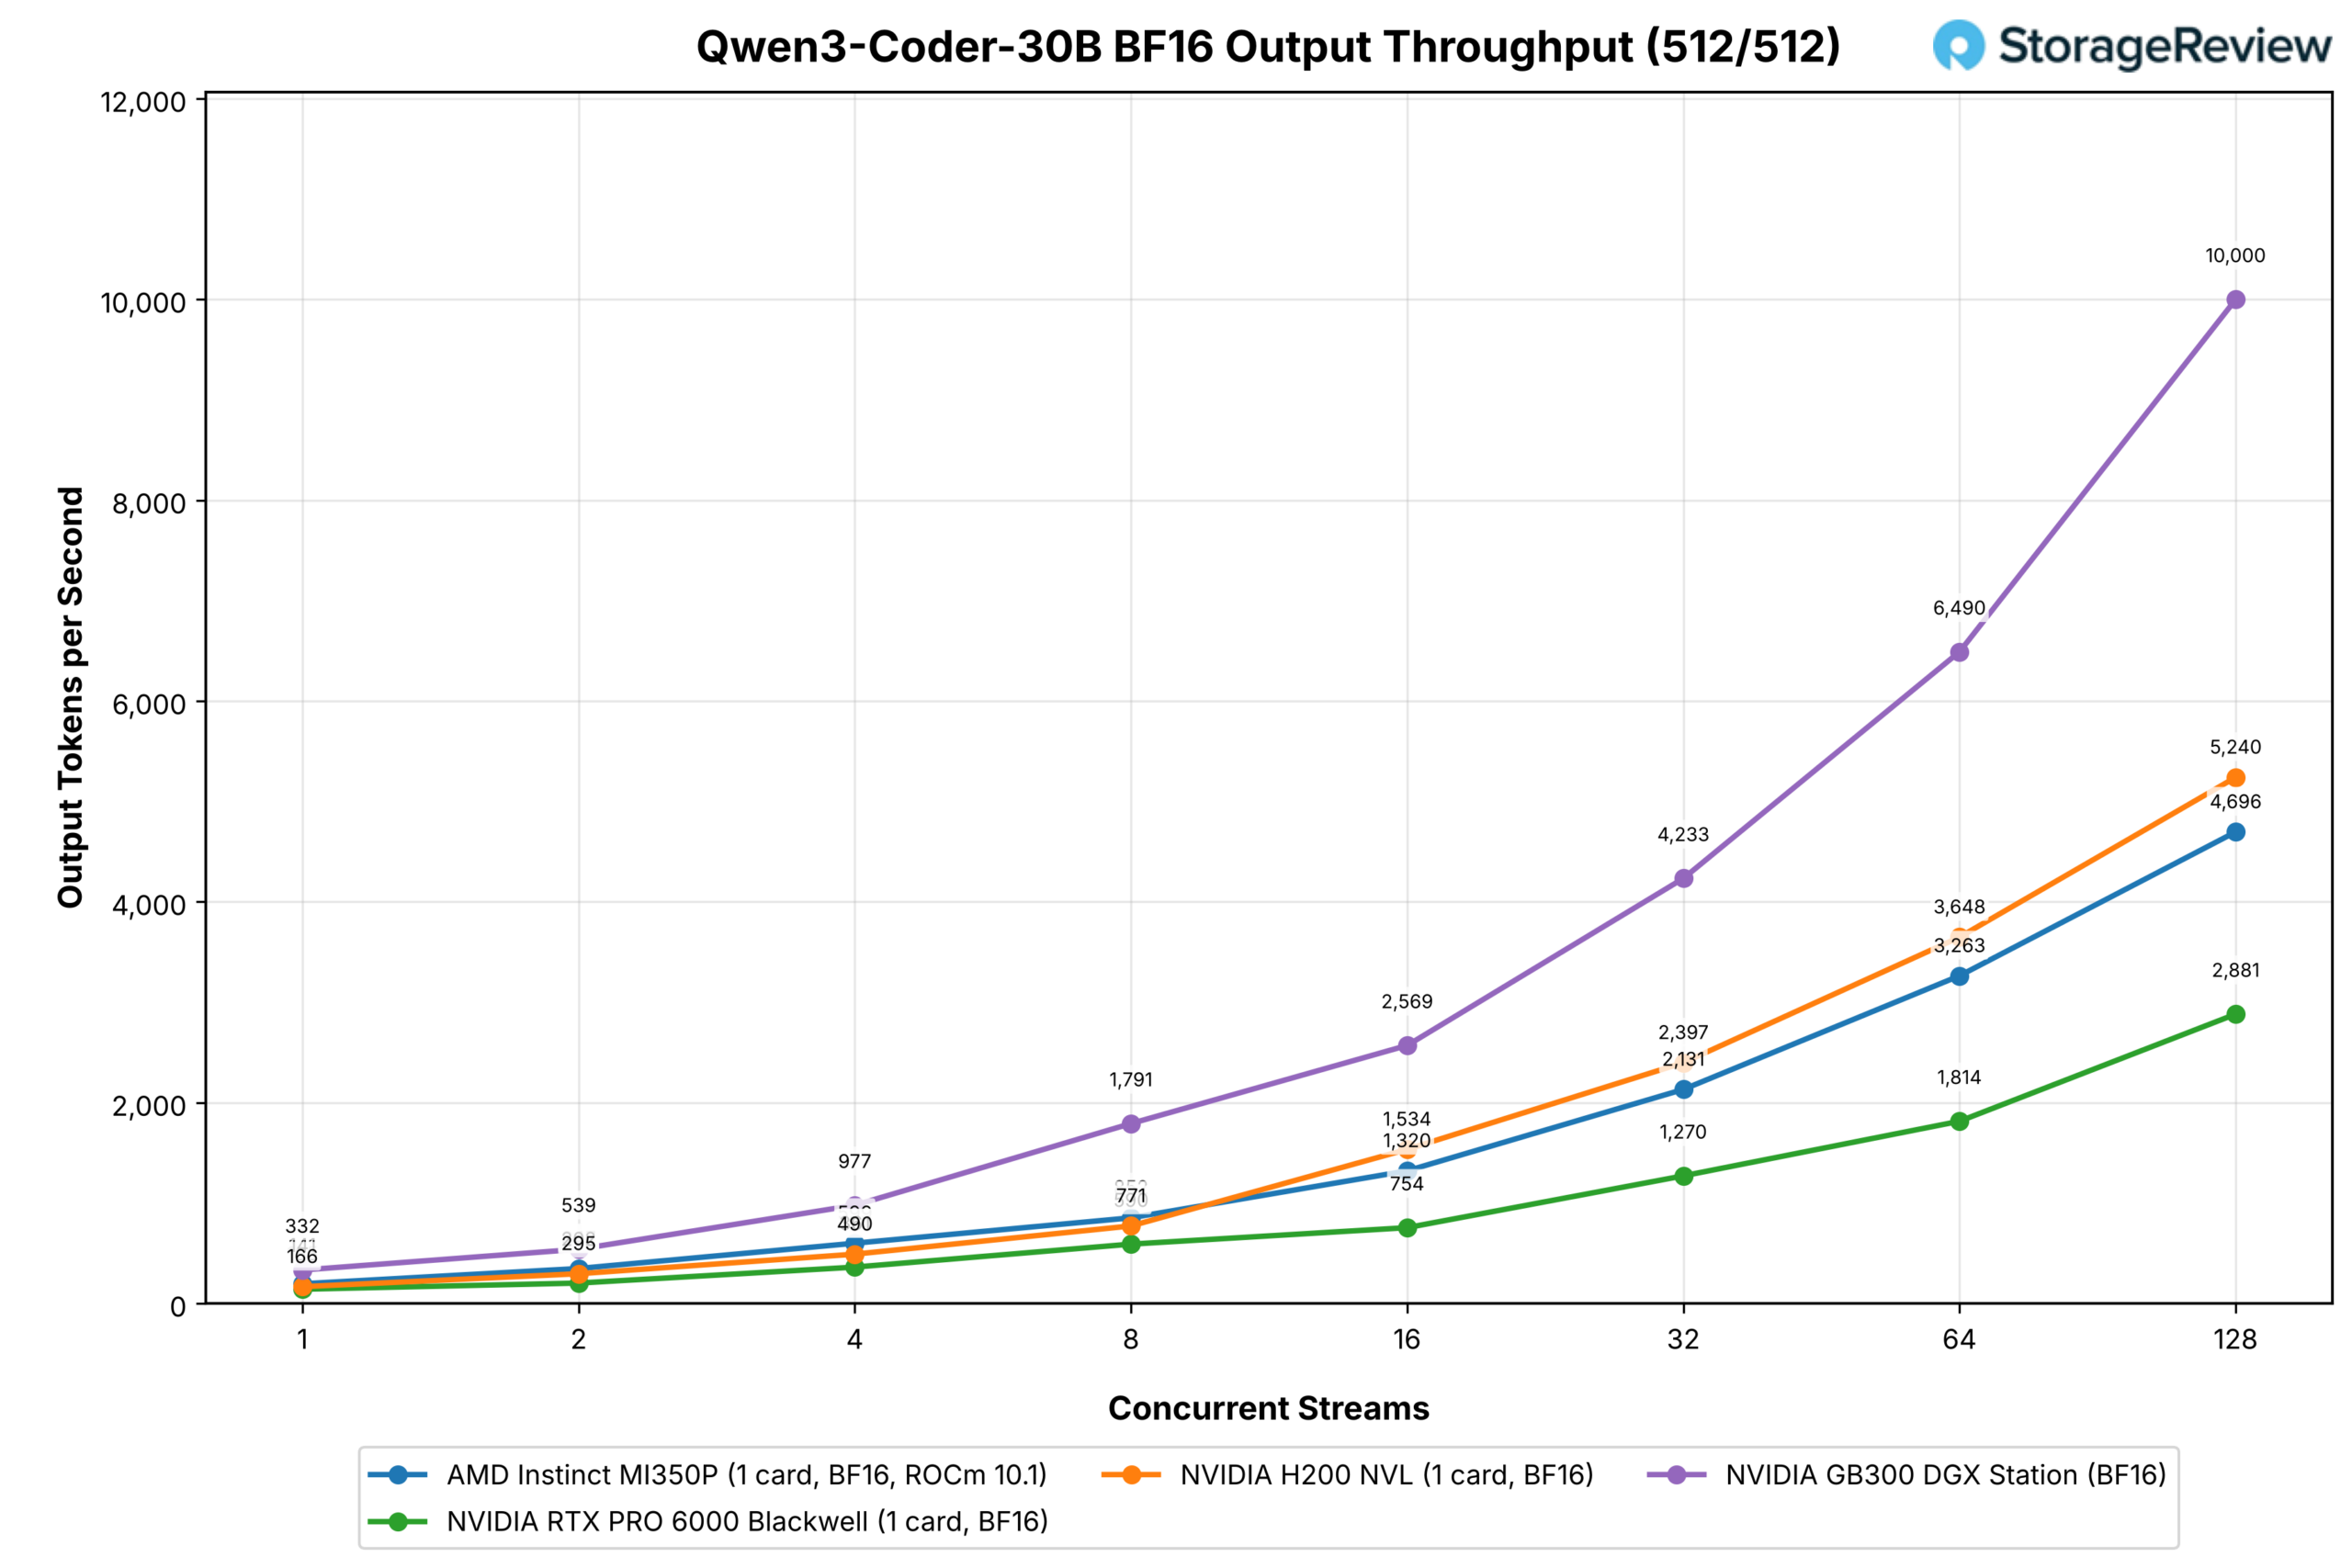
Il MoE da 30 miliardi con parametri attivi da 3 miliardi conferisce alla MI350P un vantaggio sulla RTX PRO 6000 in ogni condizione di concorrenza nel carico di lavoro della chat, terminando con 6,451 contro 3,995 su FP8 e 4,696 contro 2,881 su BF16 con 128 stream, con la H200 a 7,459 e 5,240.
Nei prompt con precaricamento intensivo, la run FP8 è in testa solo dopo quattro stream e poi è in svantaggio rispetto alla RTX PRO 6000 da otto a 128, 759 contro 823 in cima, con la H200 a 1,820; la run BF16 sale a 728 a 128 stream contro 588 e 1,592.
Mistral Piccolo 3.1 24B
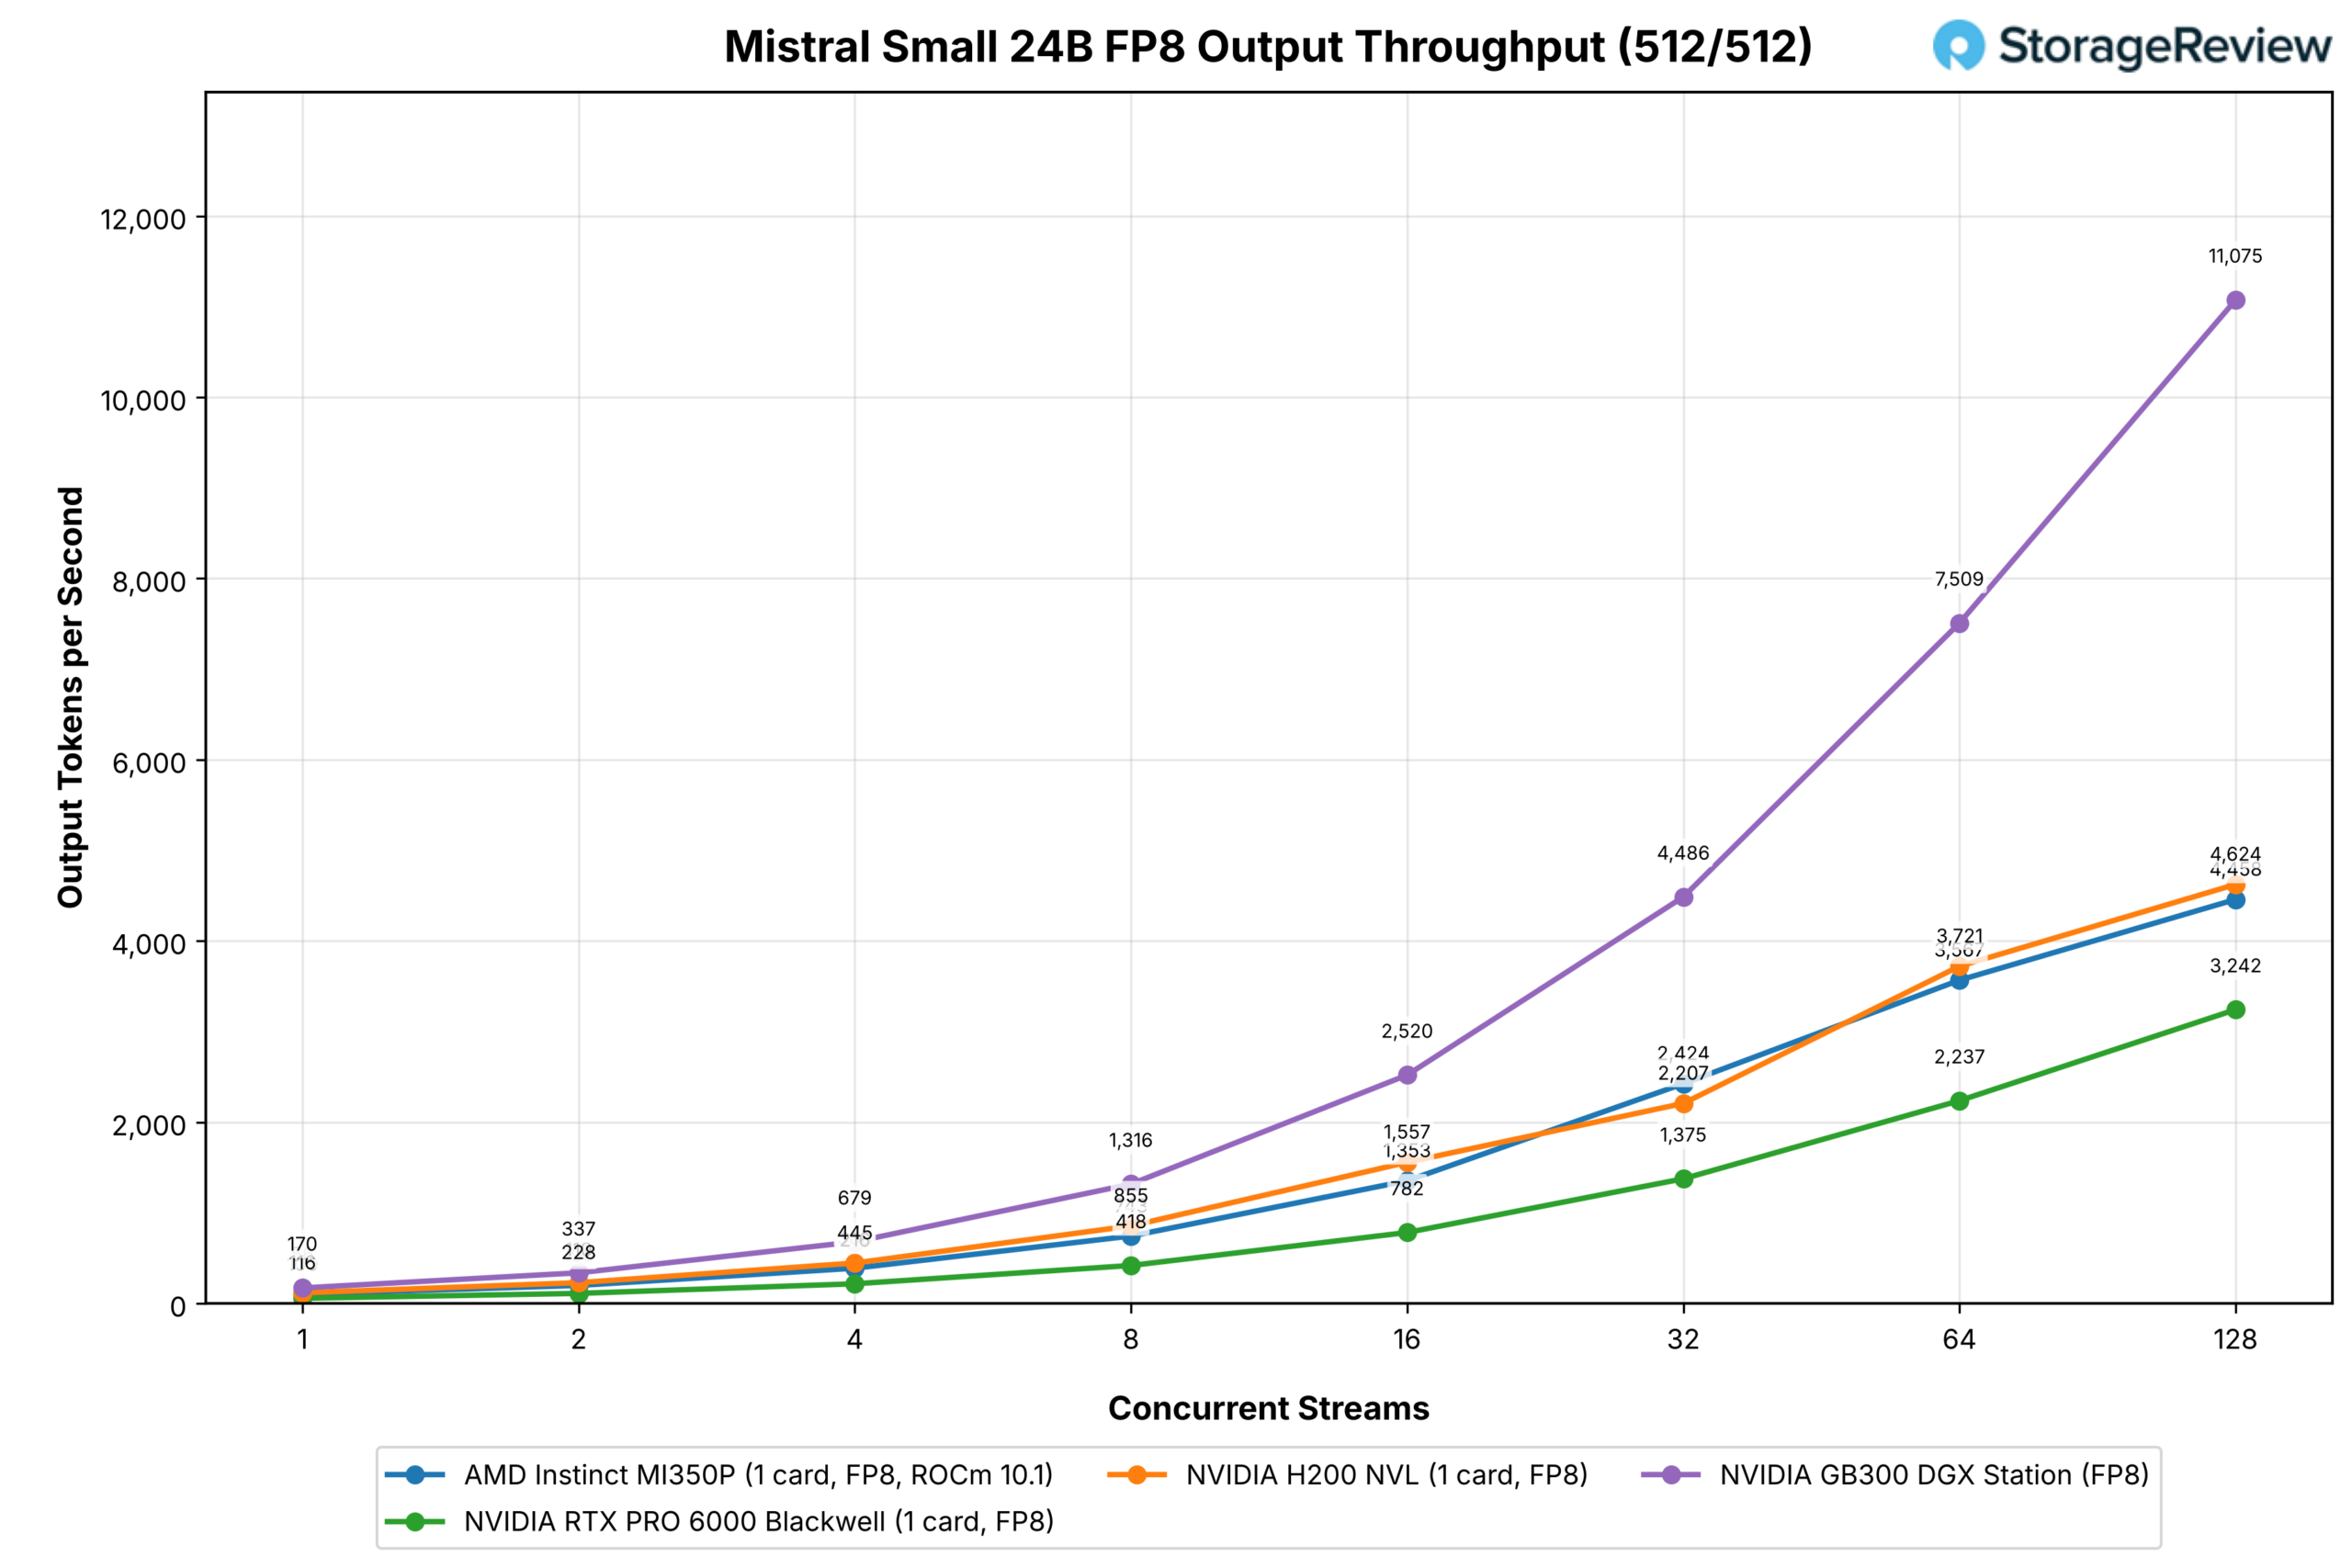
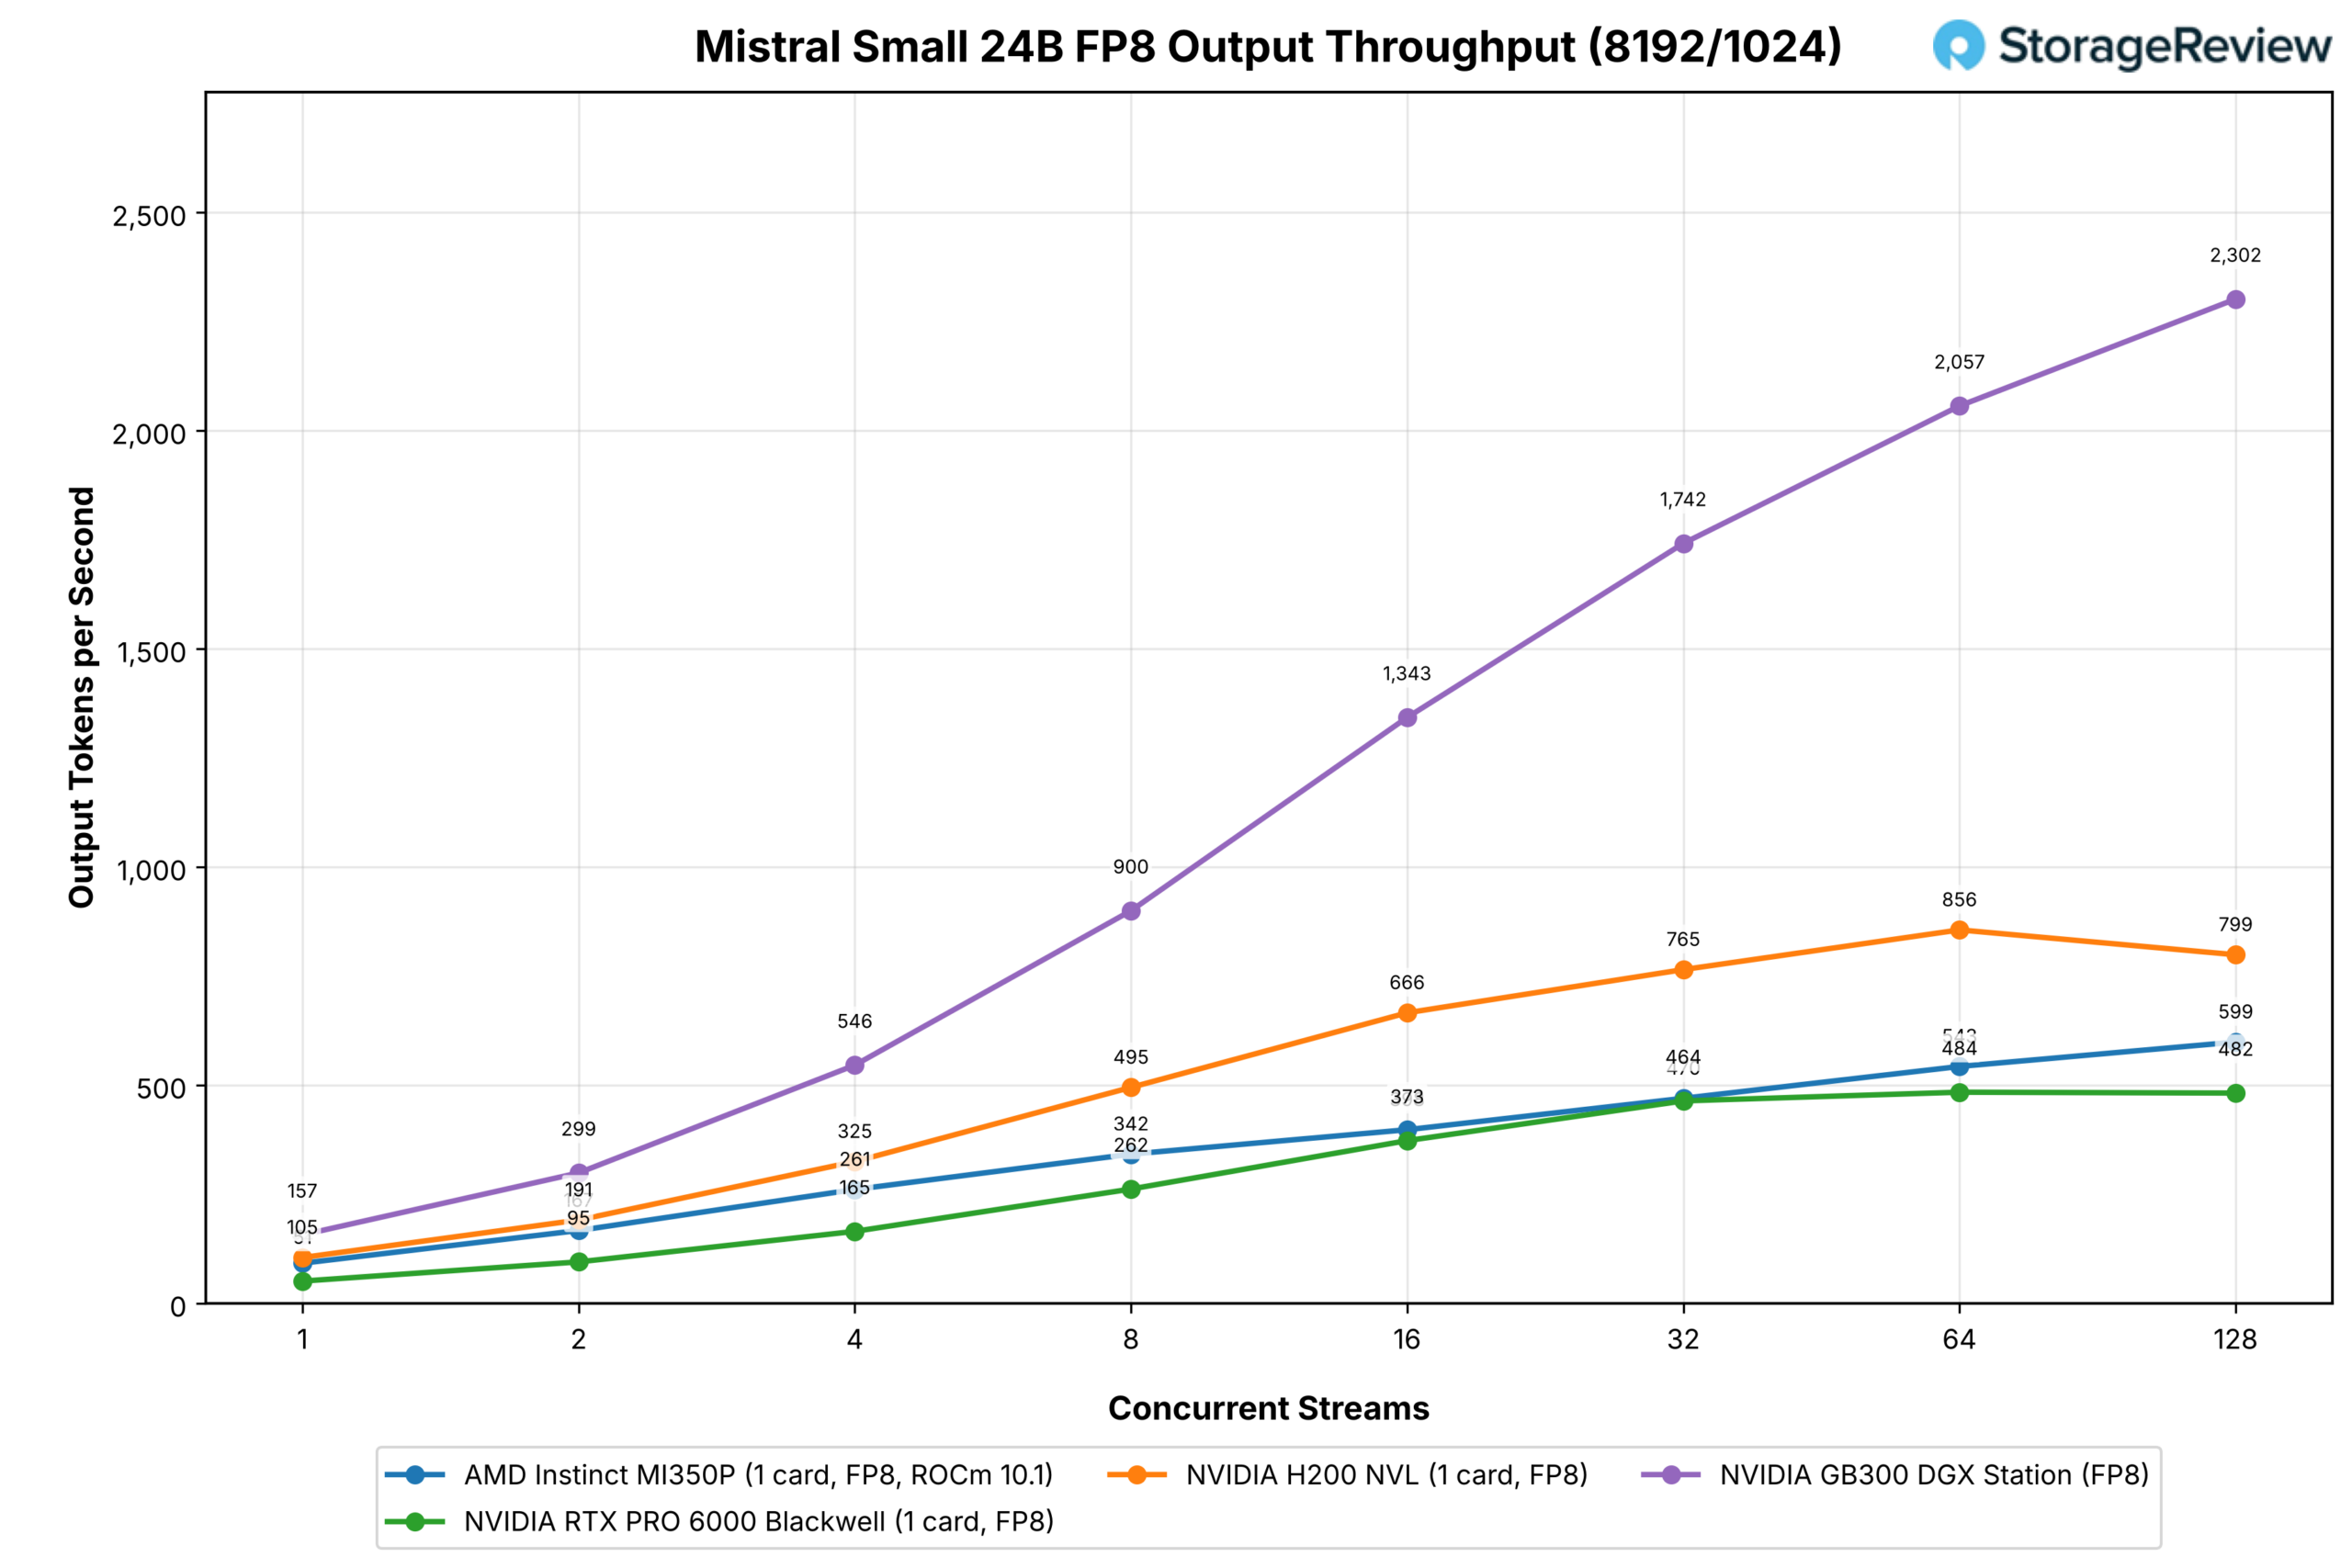
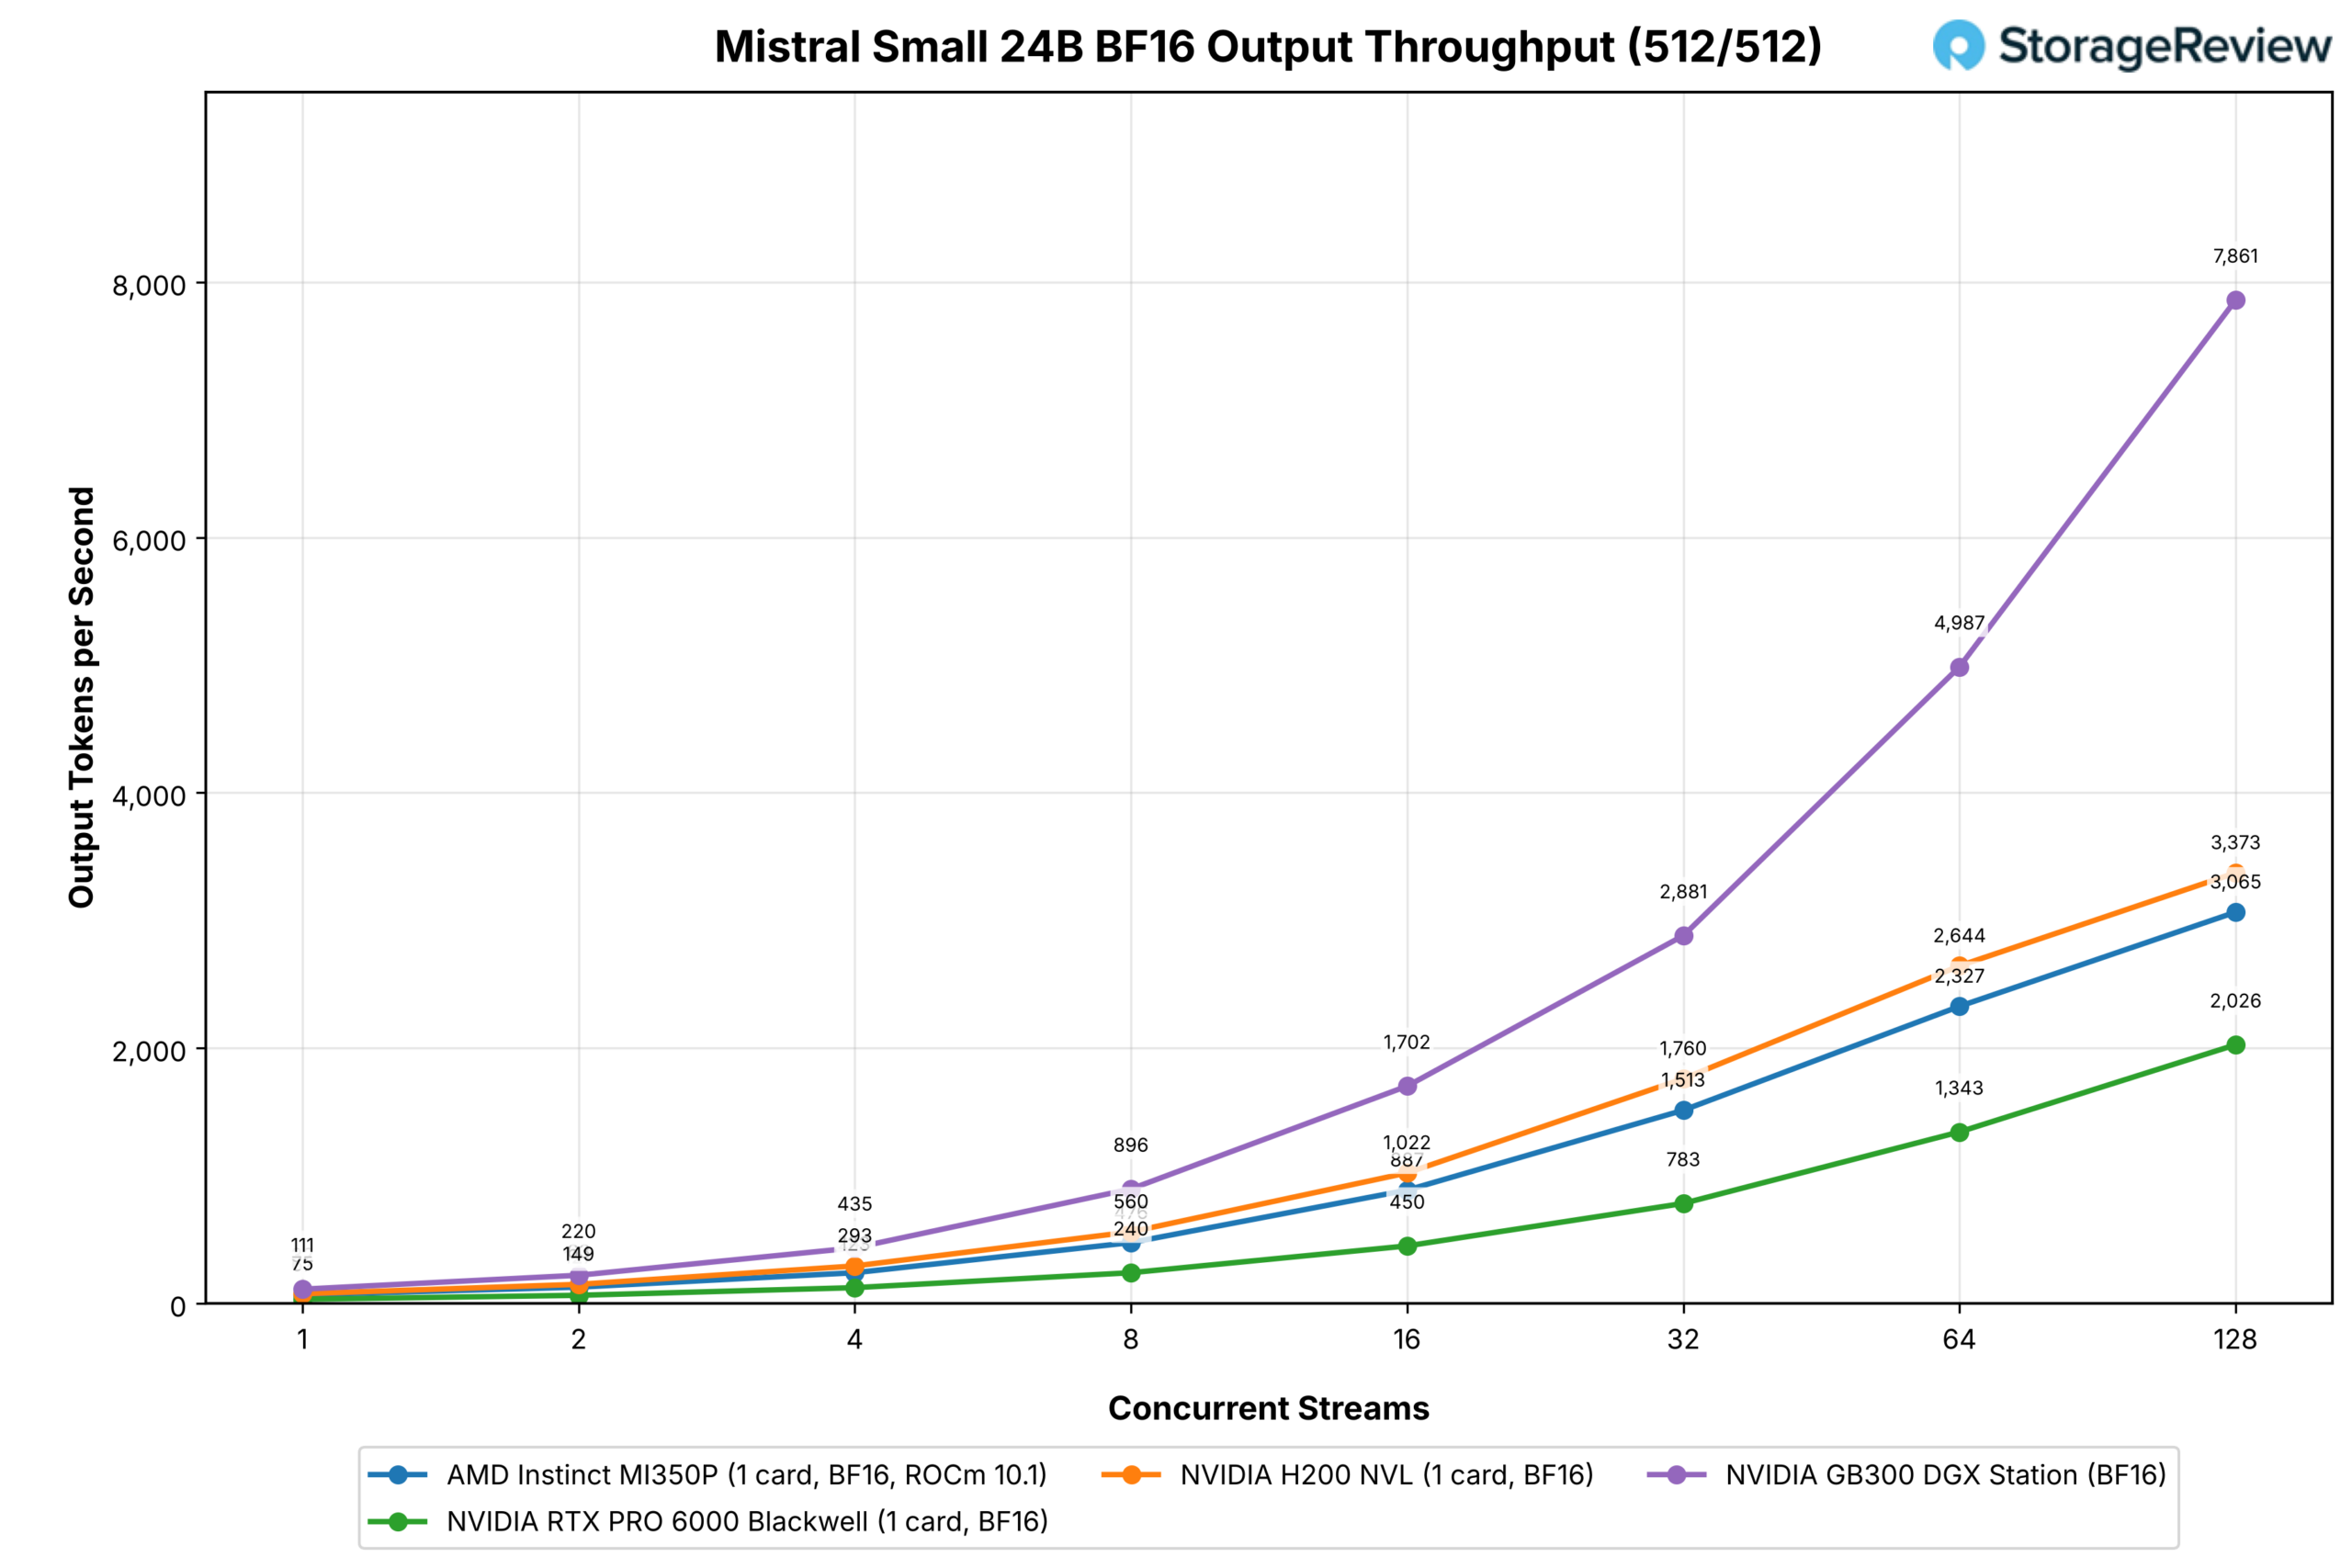
Mistral Small è il test più impegnativo per la MI350P contro la RTX PRO 6000: 4,458 contro 3,242 su FP8 e 3,065 contro 2,026 su BF16 con 128 stream nel carico di lavoro della chat, e con un singolo stream la MI350P raddoppia approssimativamente le prestazioni della scheda NVIDIA (100 contro 56 su FP8, 67 contro 32 su BF16).
È anche il modello denso in cui la MI350P è in vantaggio sui prompt con precaricamento intensivo, 599 contro 482 su FP8 a 128 flussi e 425 contro 299 su BF16 a 64, sebbene la H200 raggiunga 799 e 632 negli stessi punti.
Lama 3.1 8B
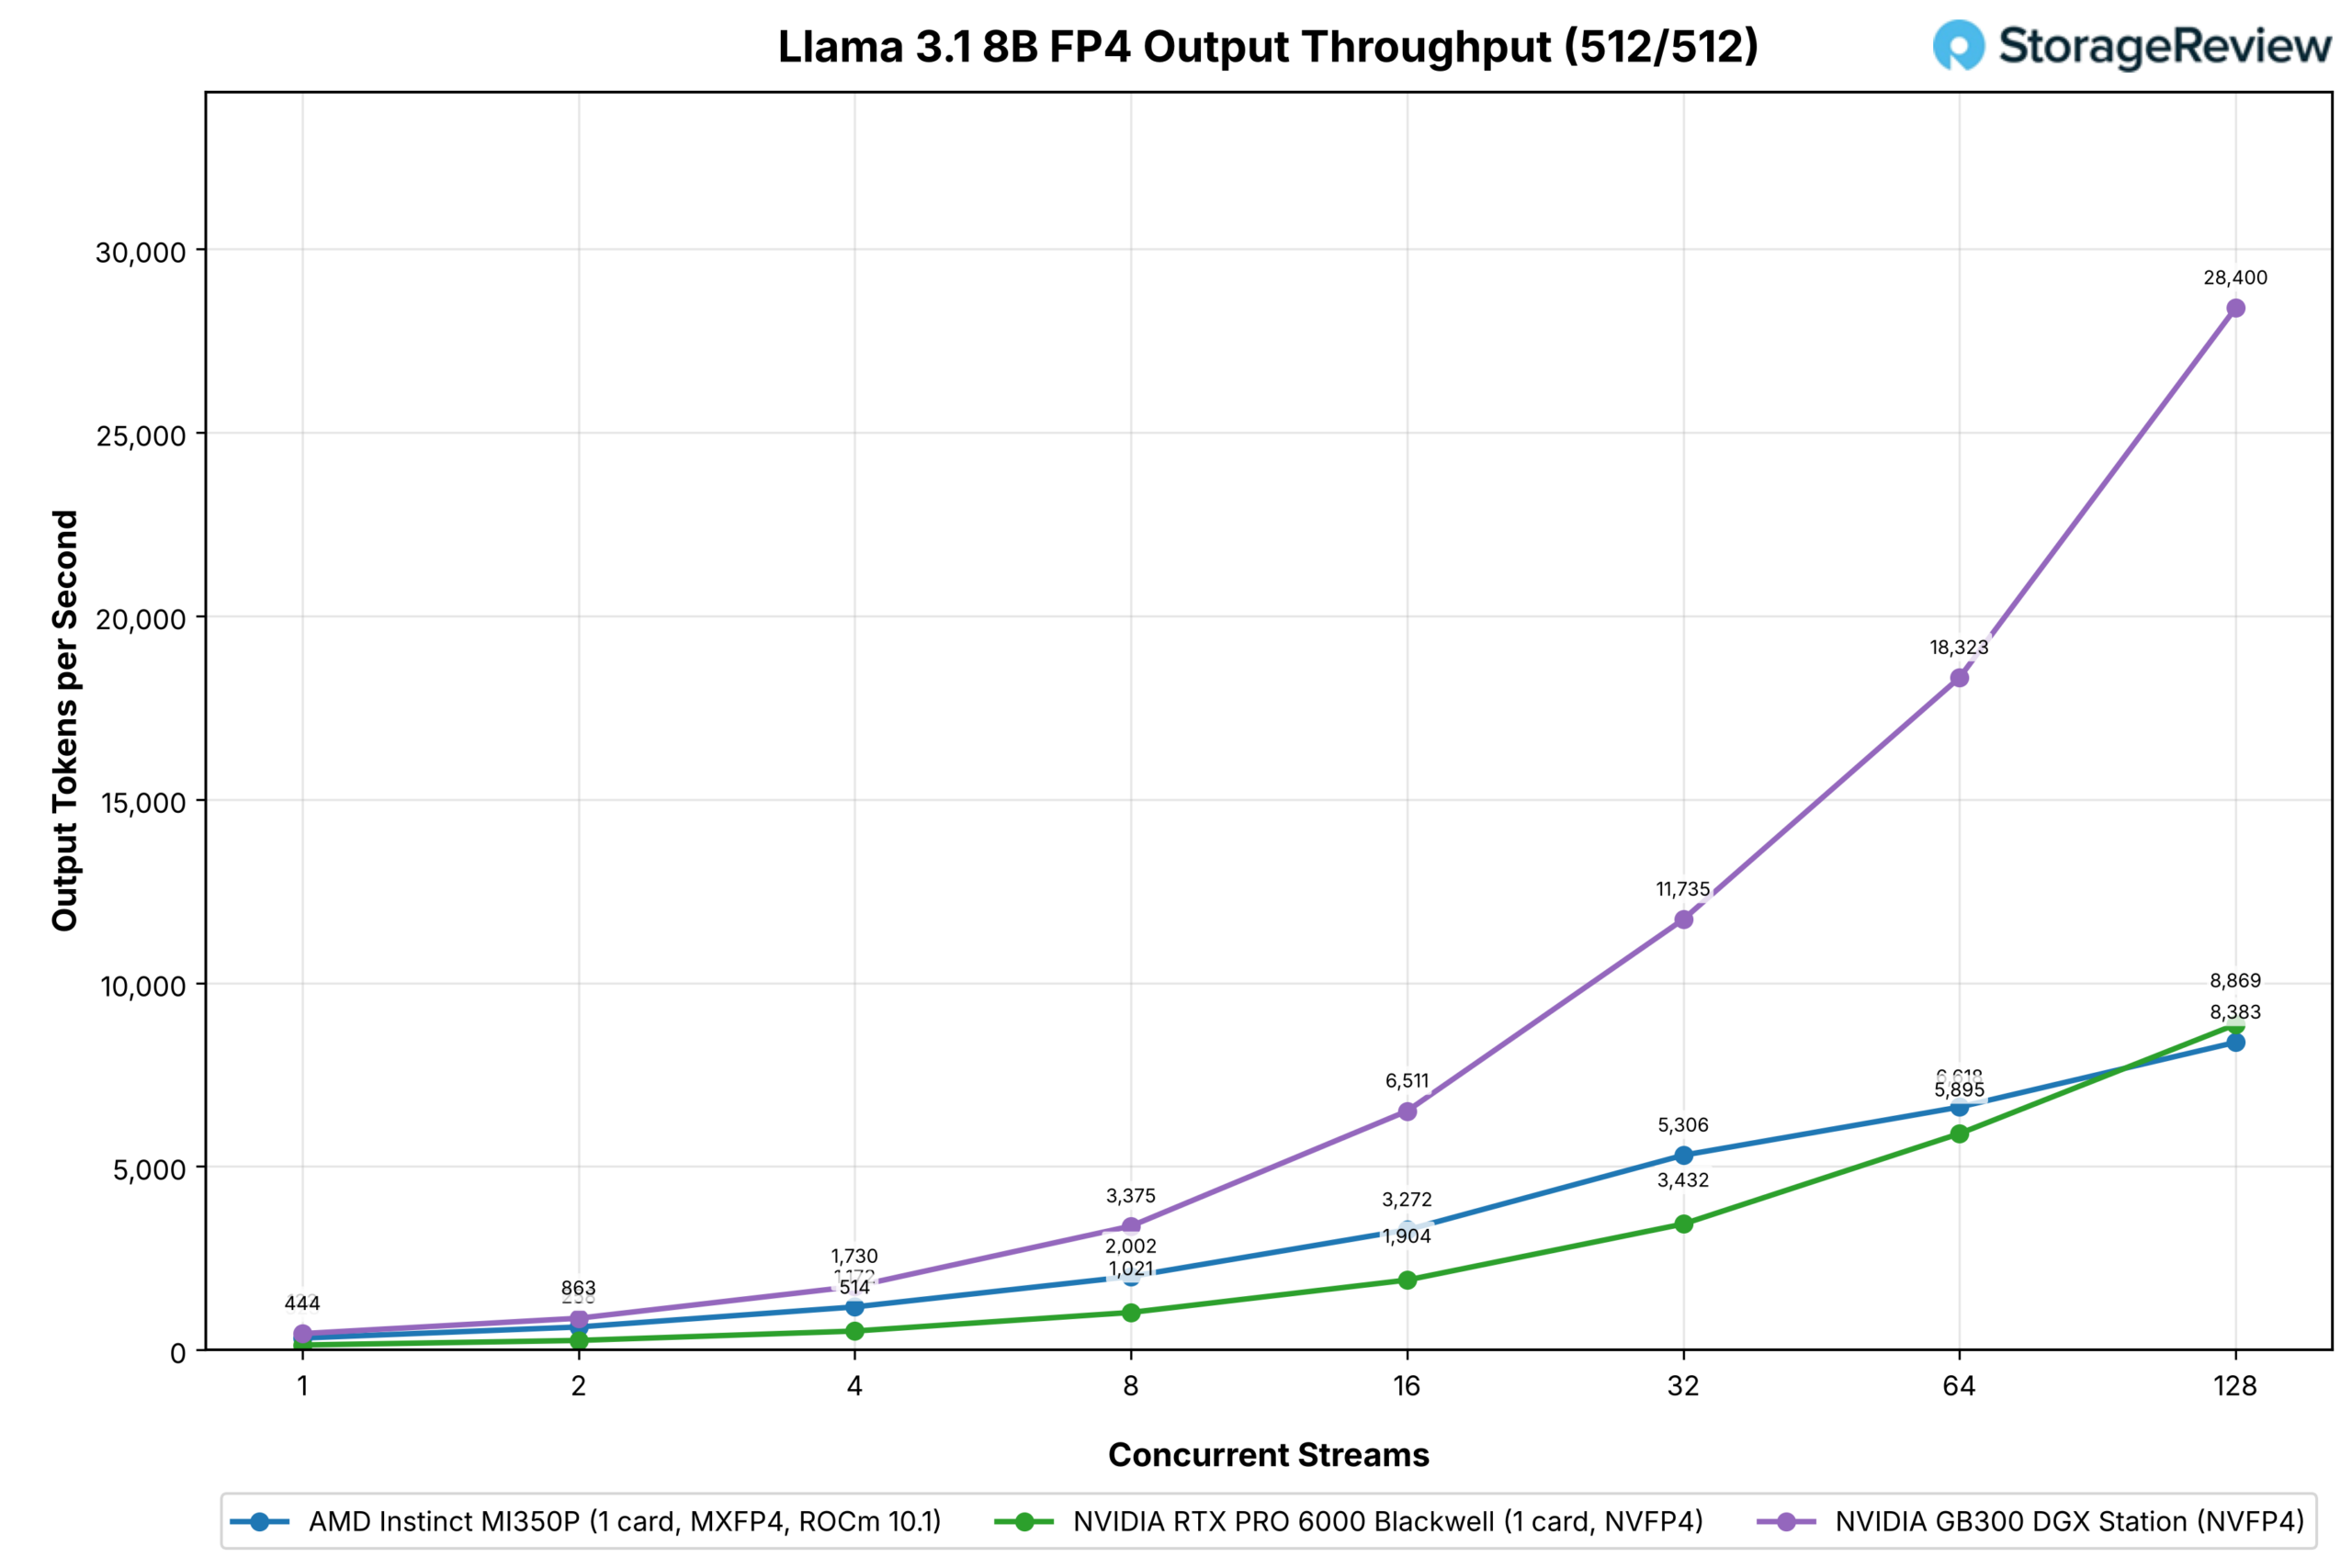
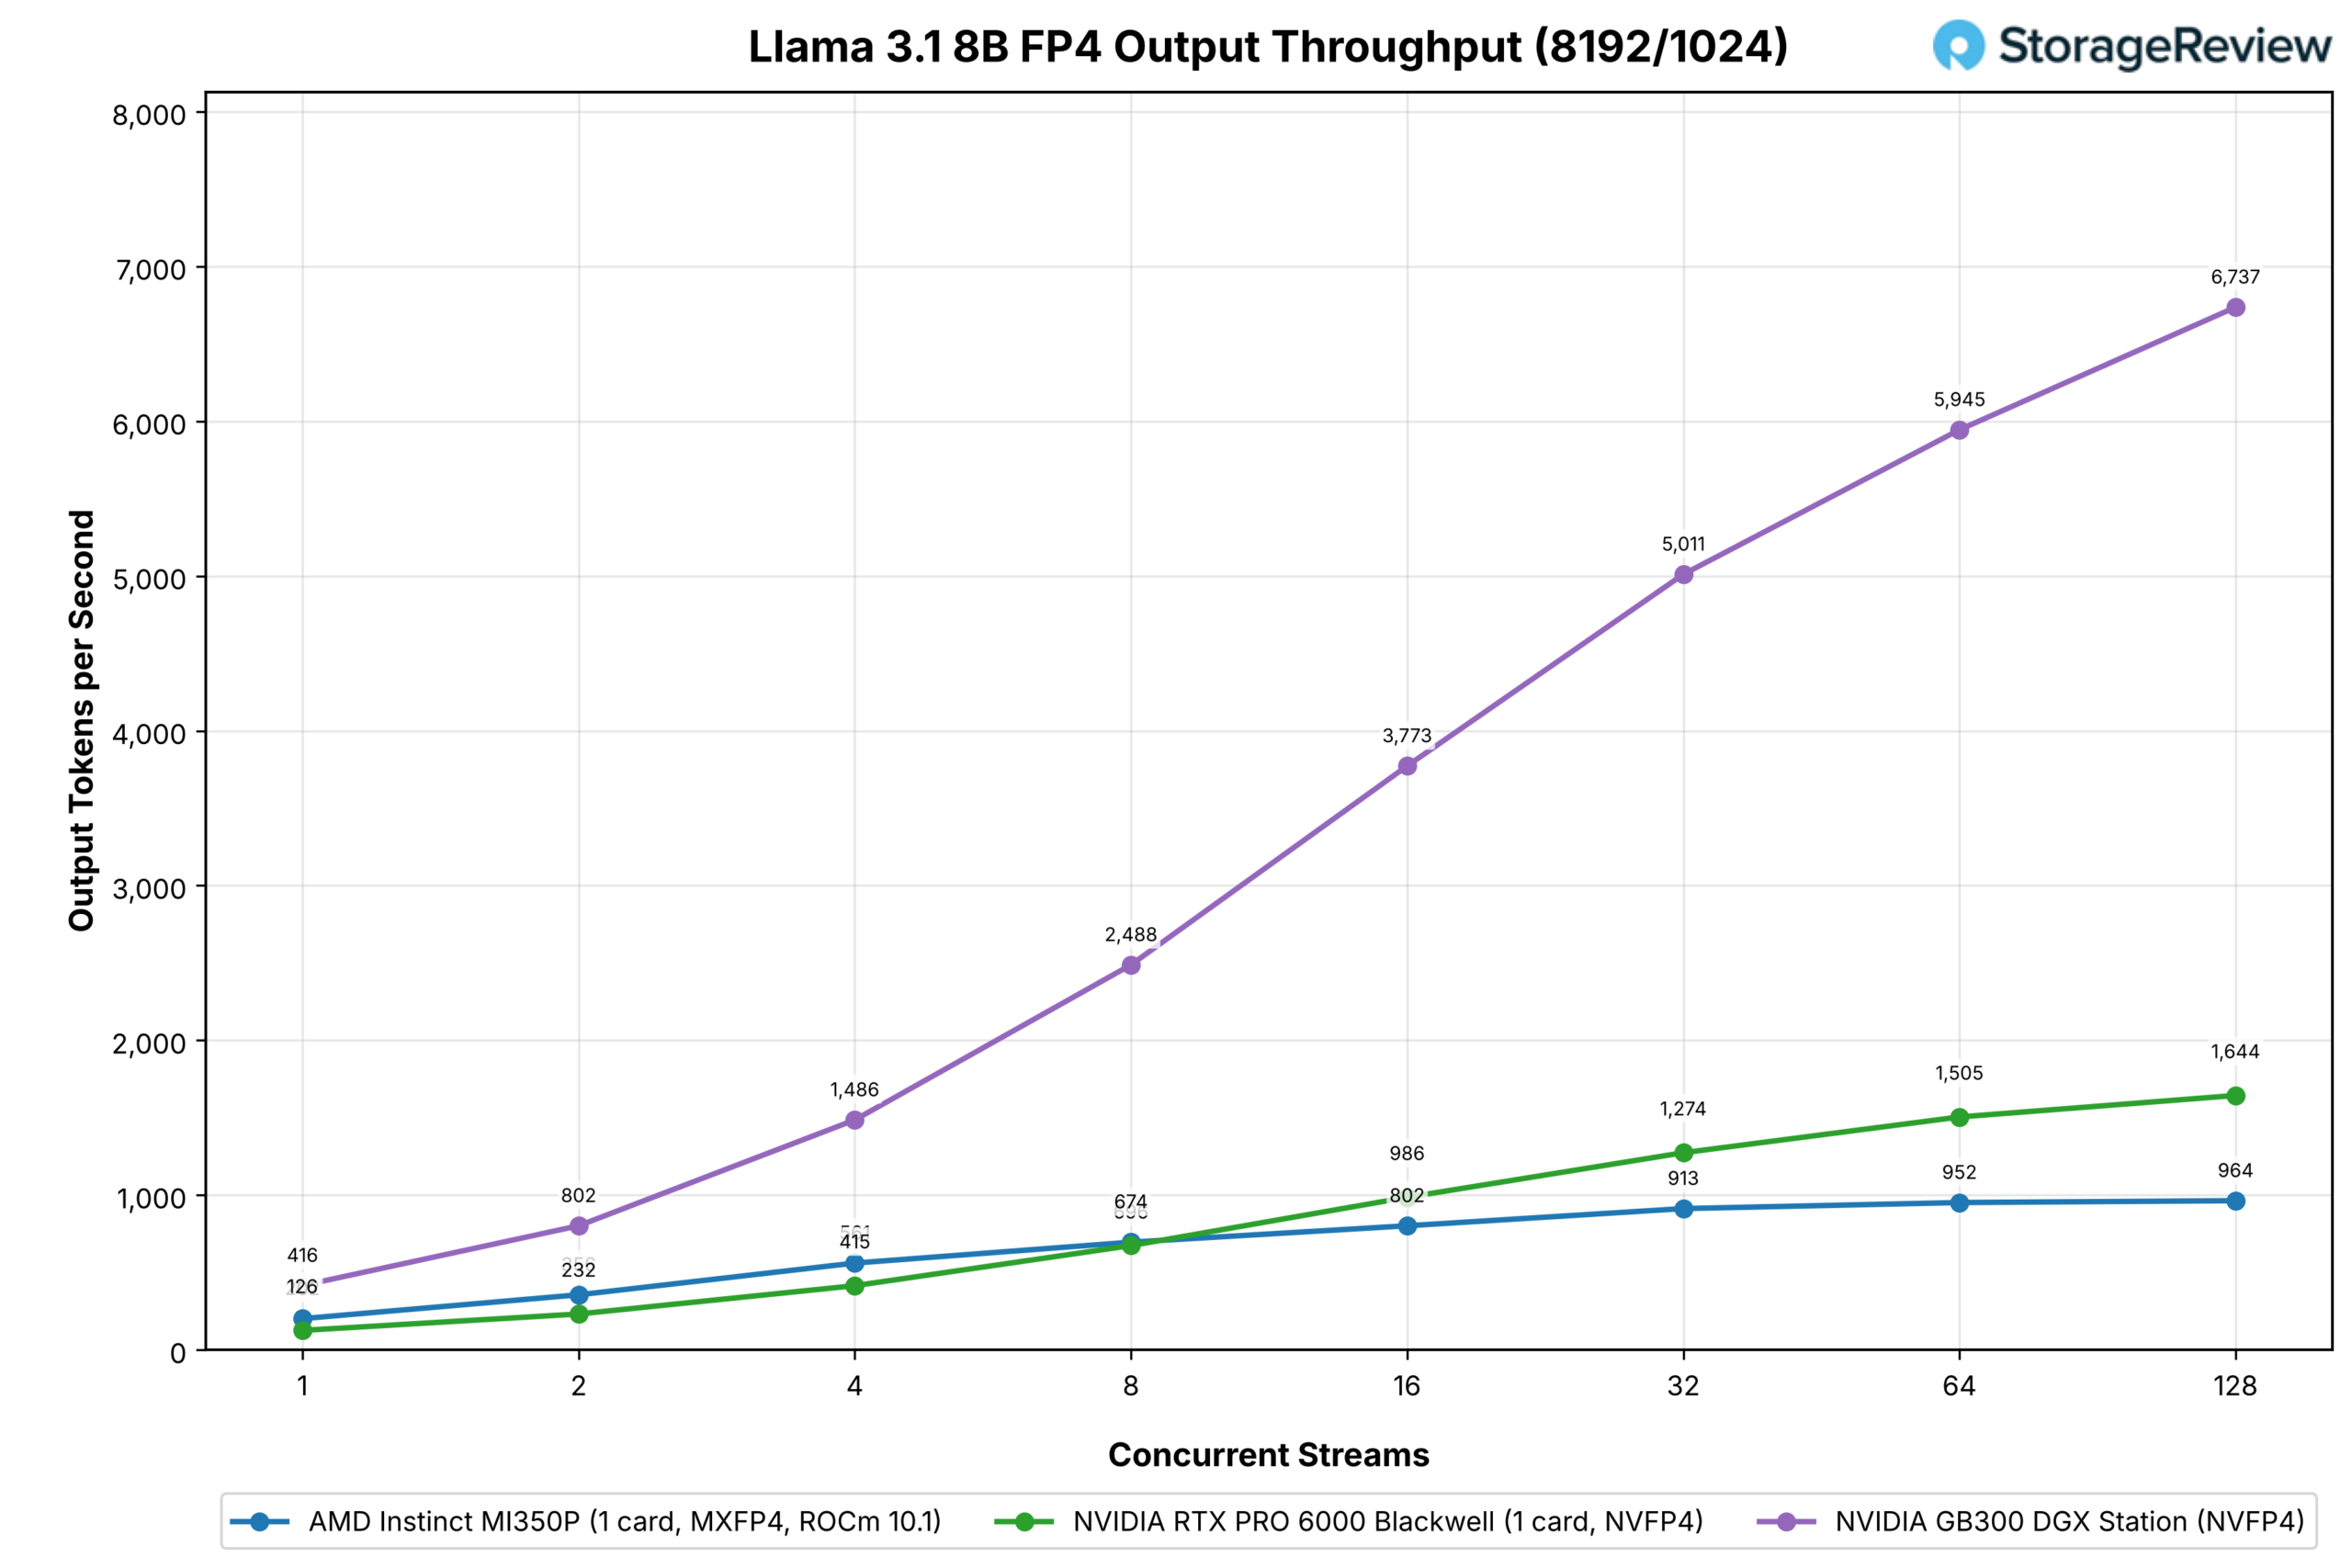
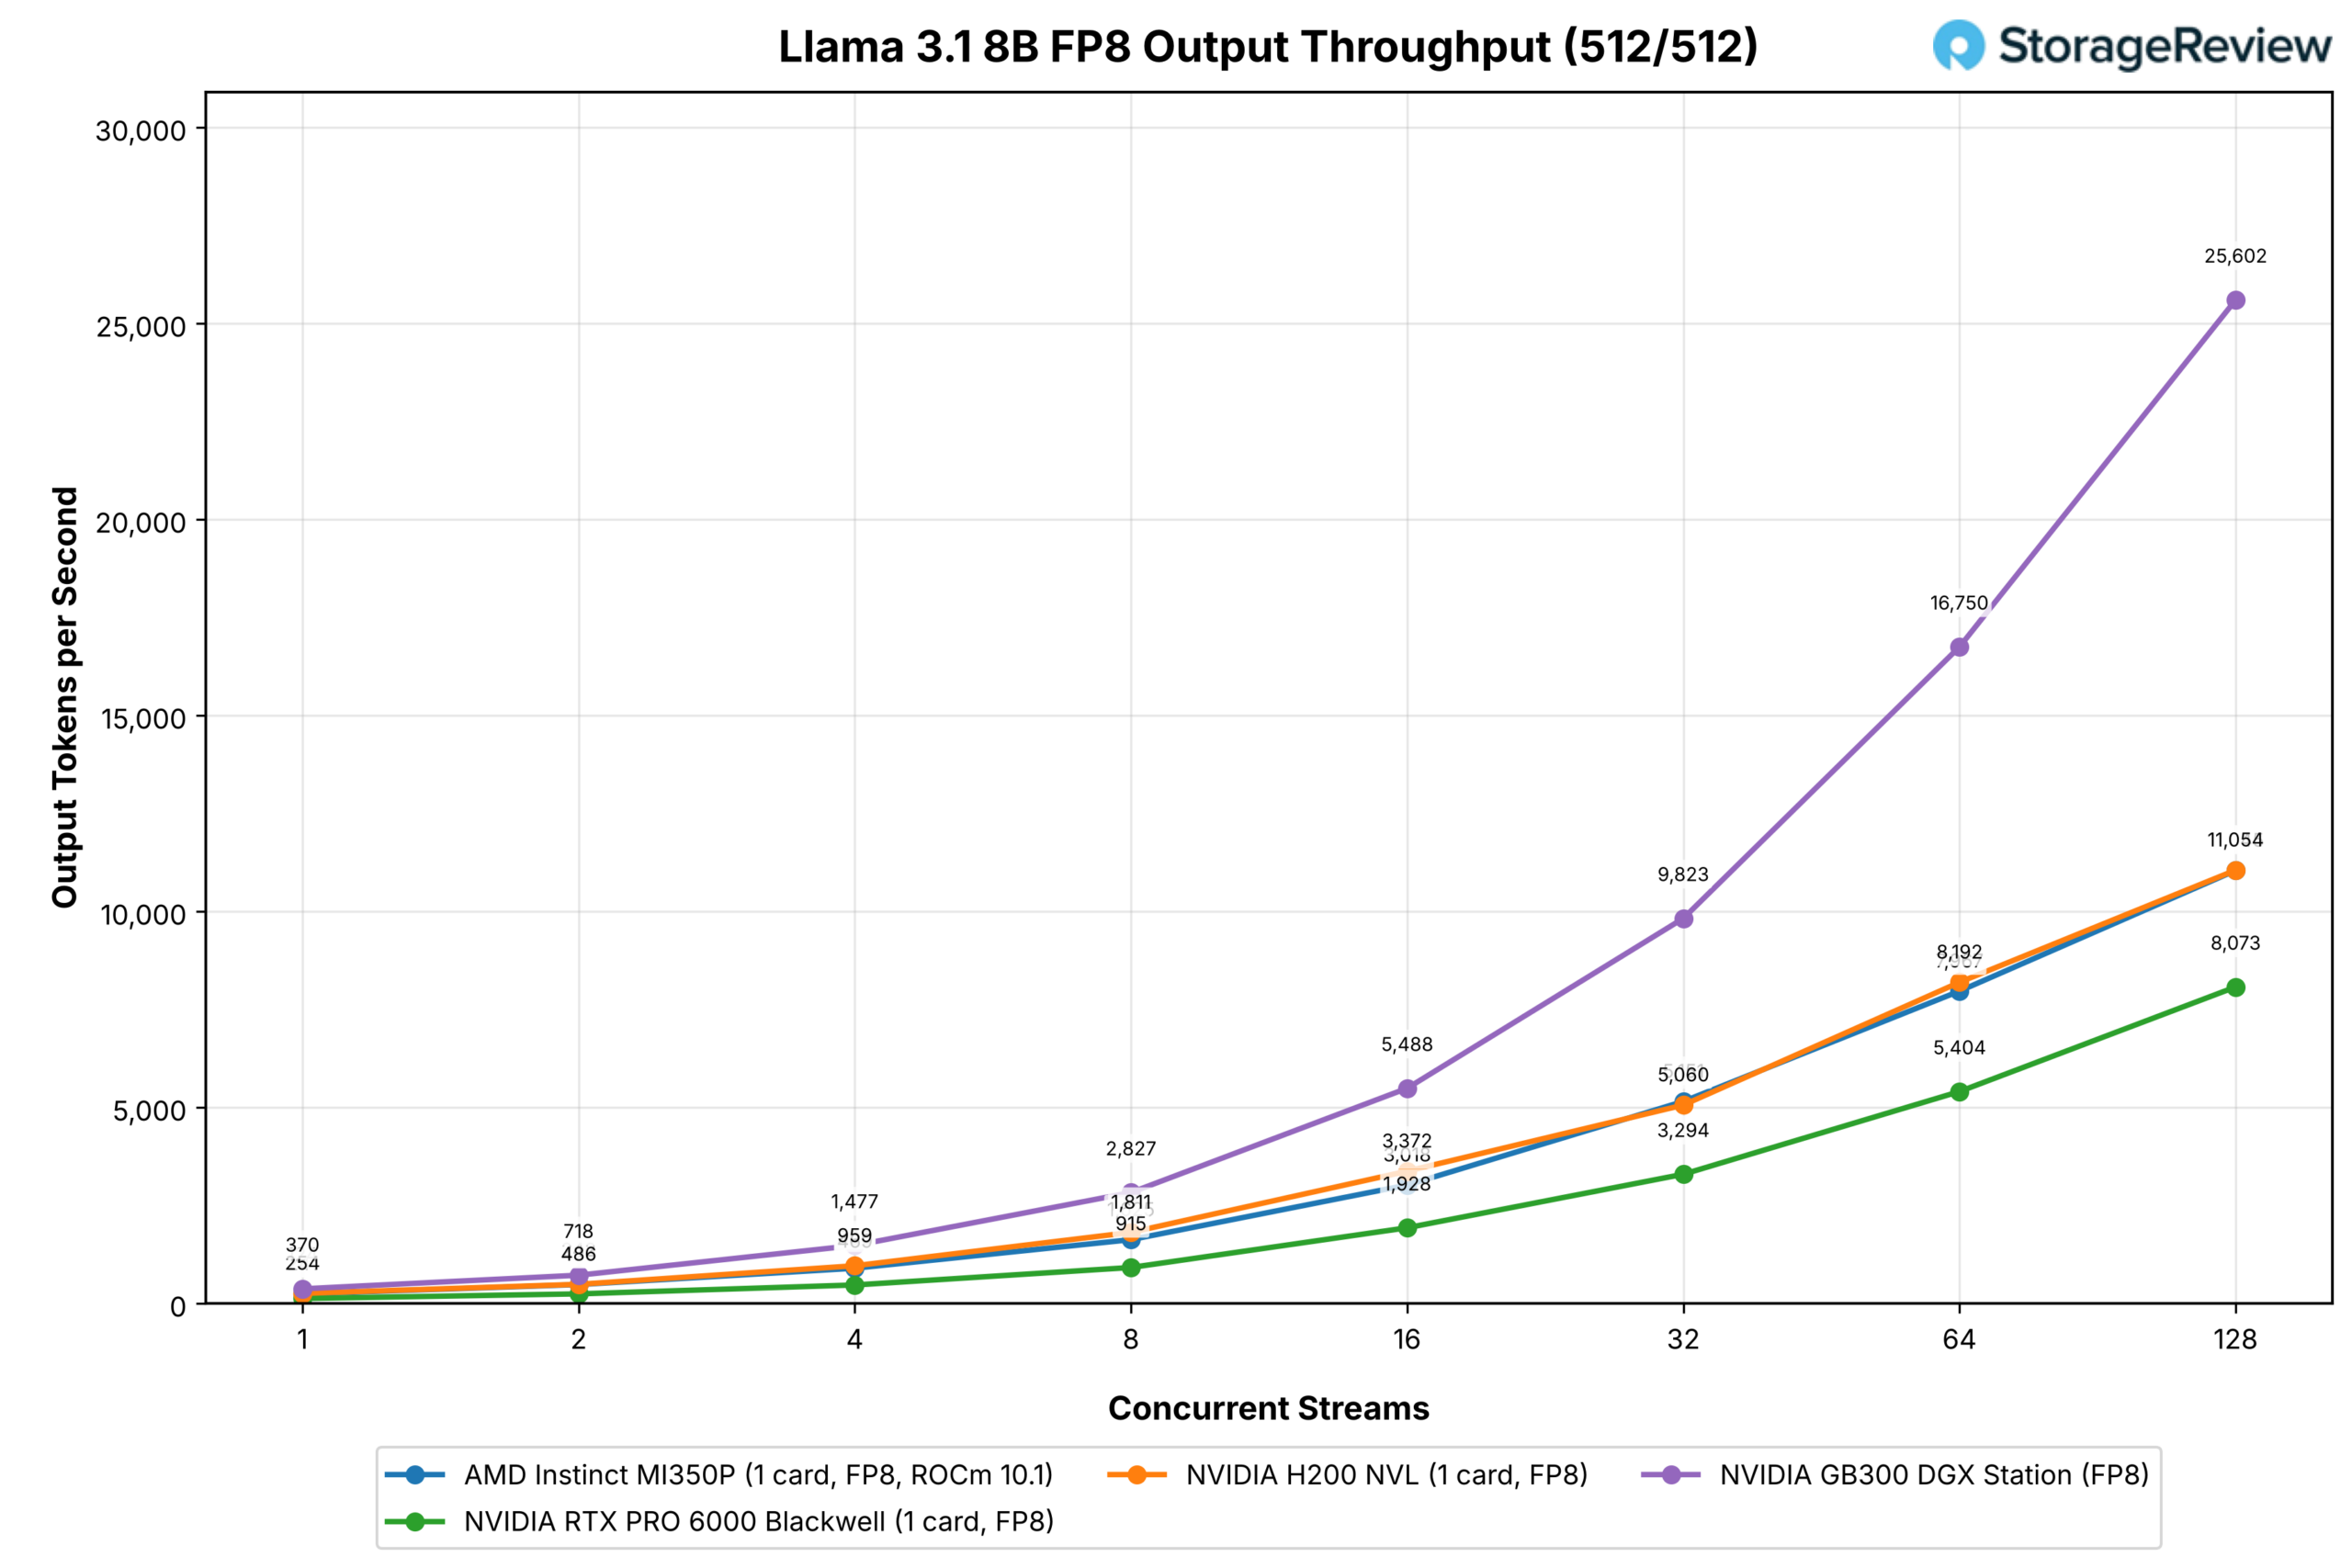
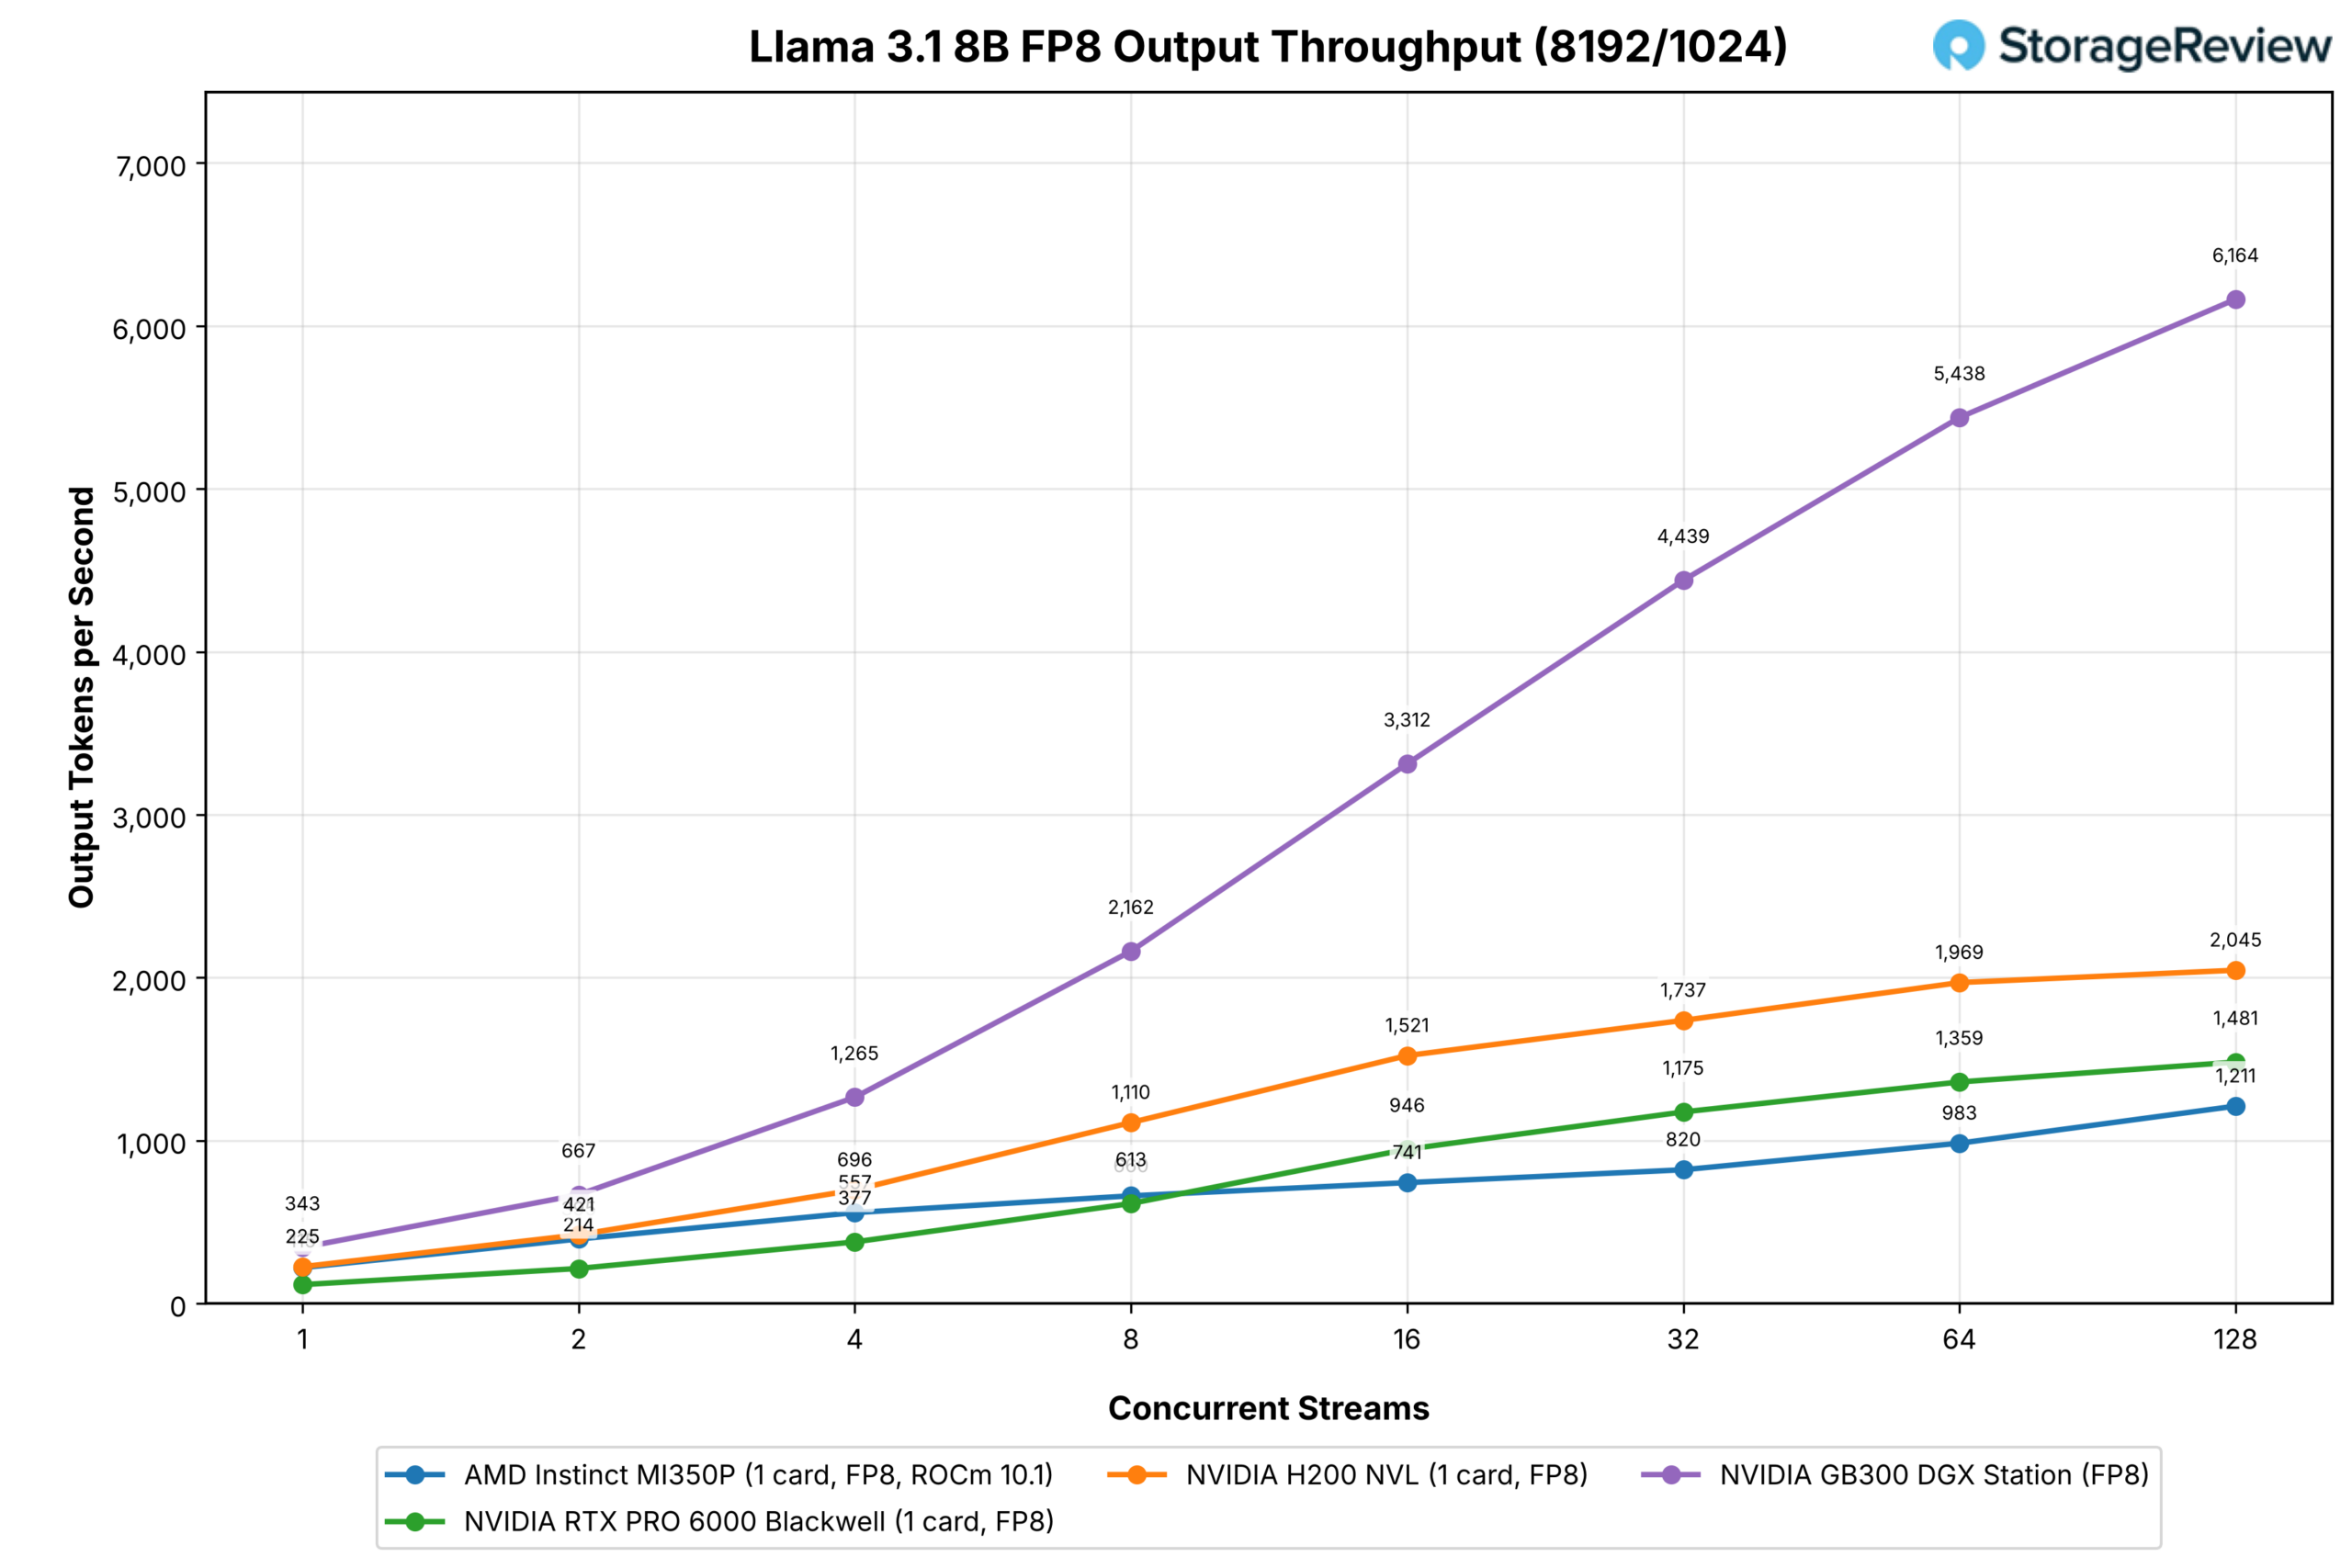
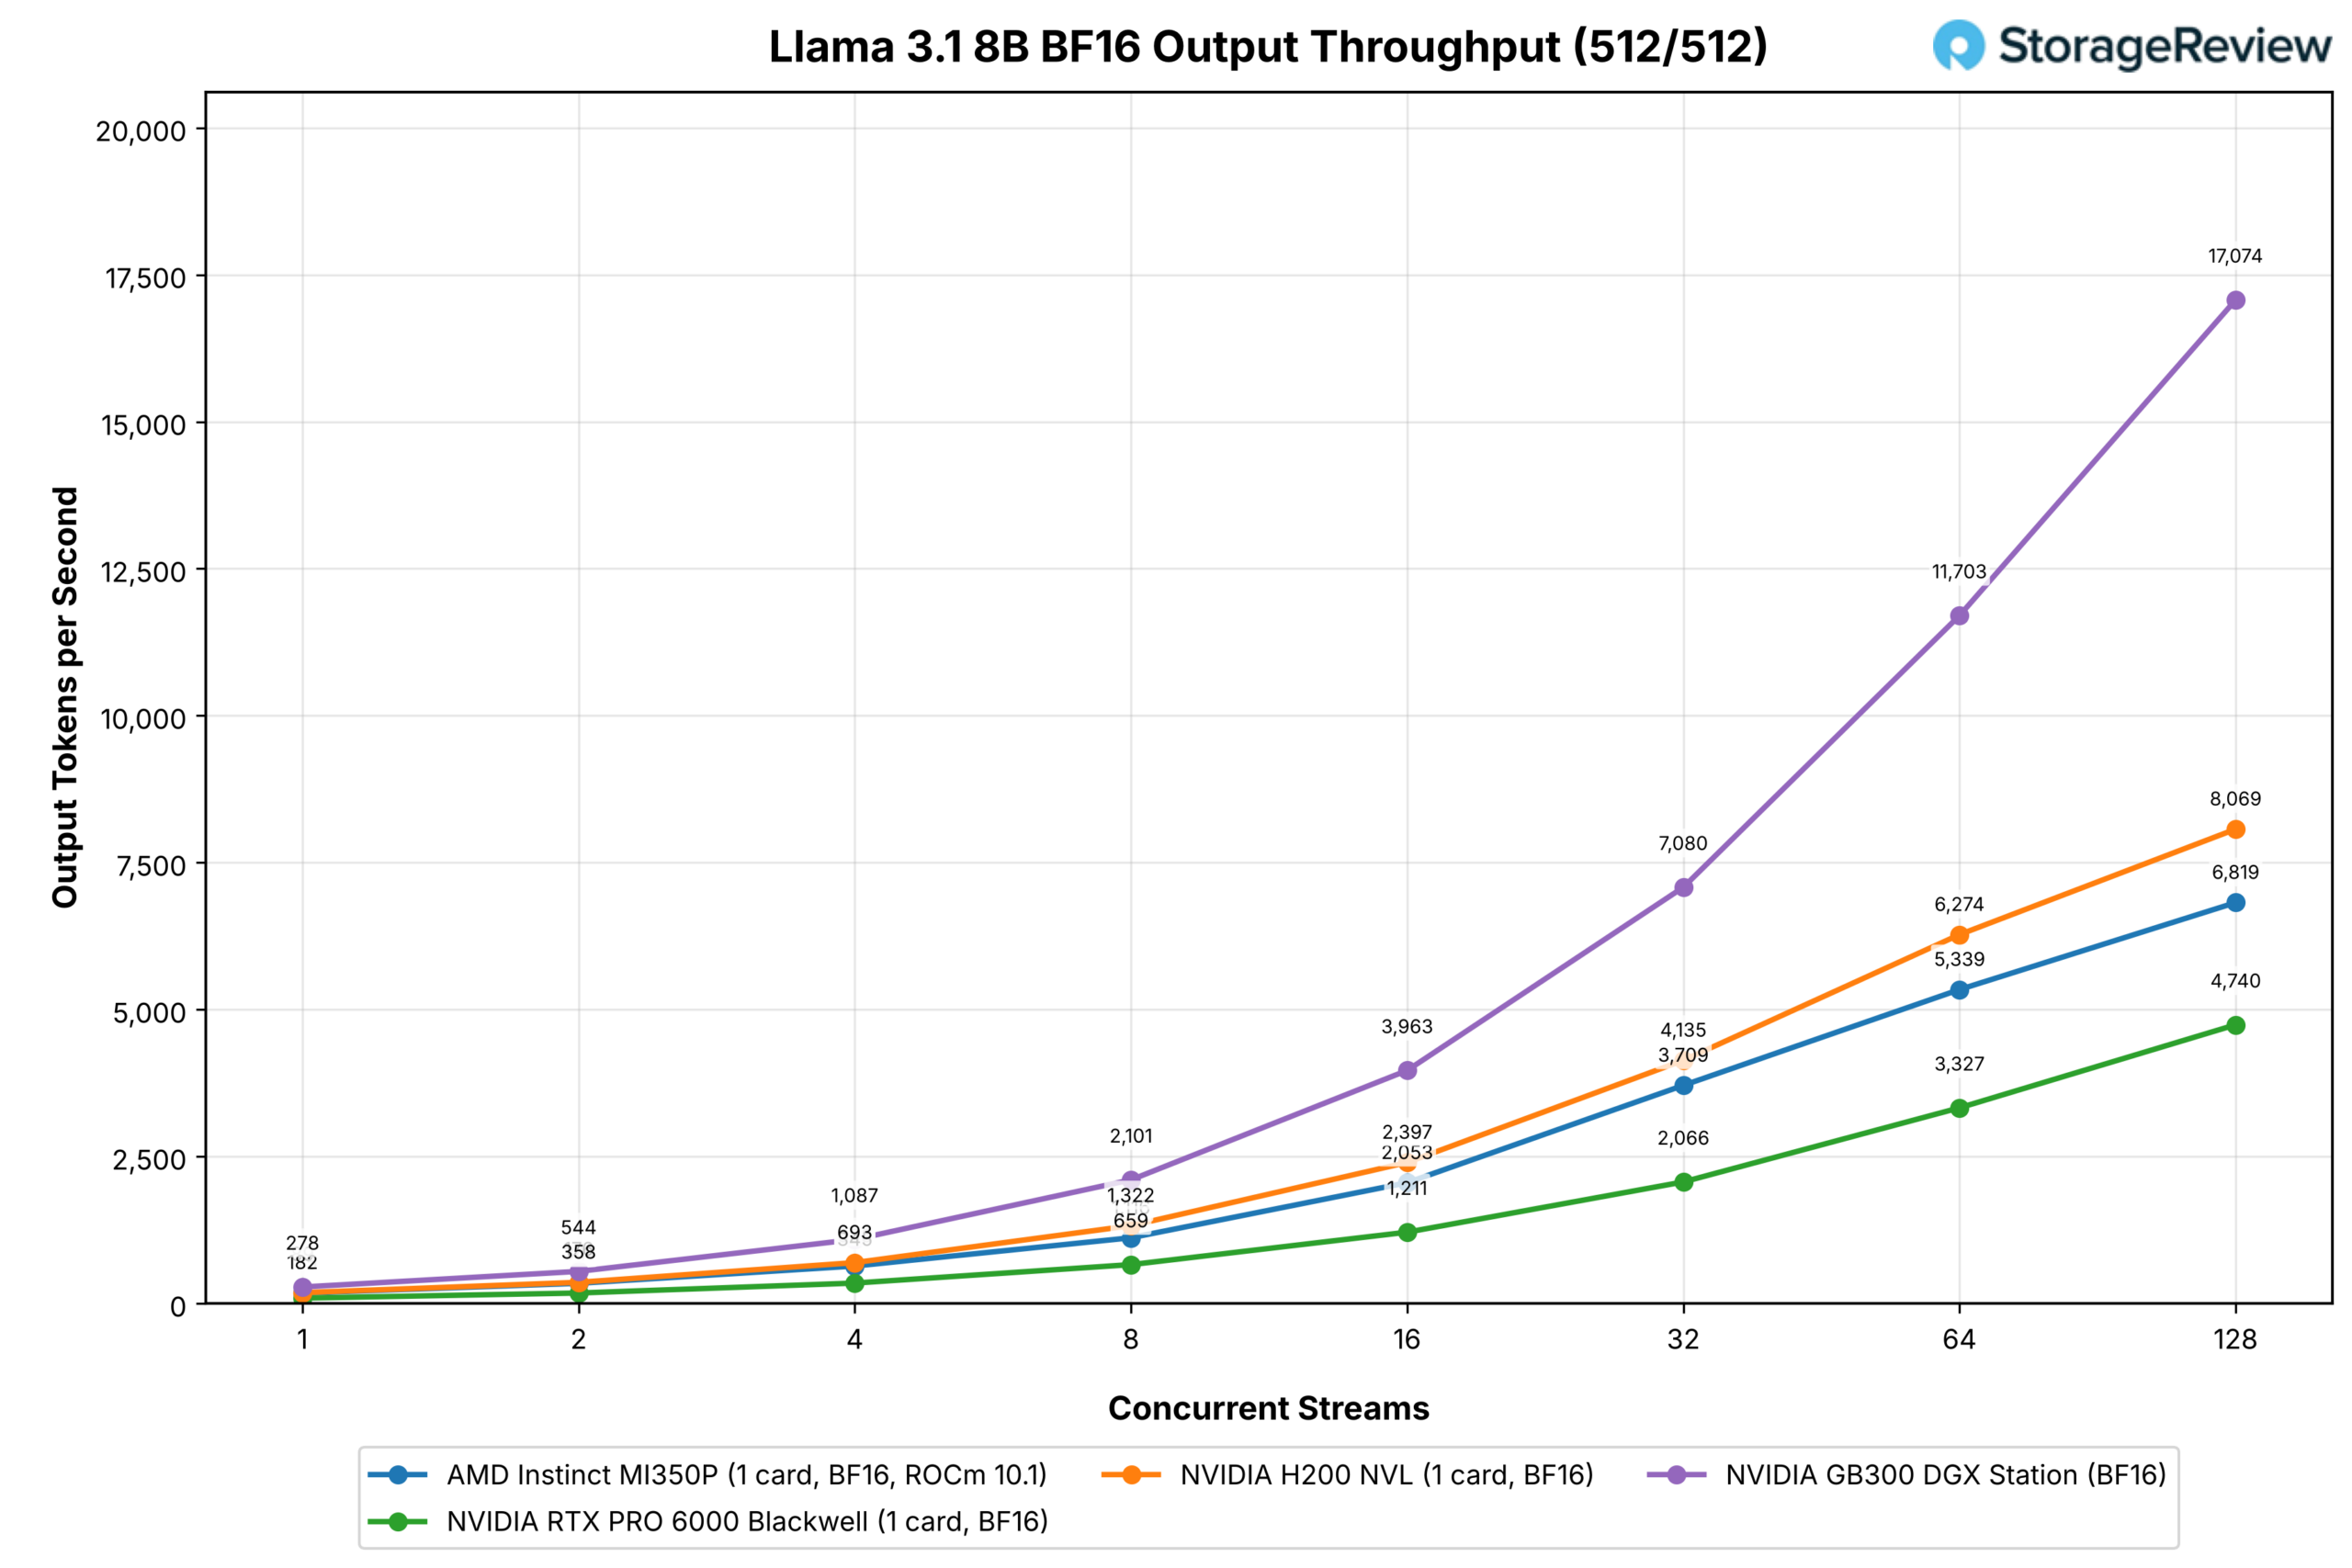
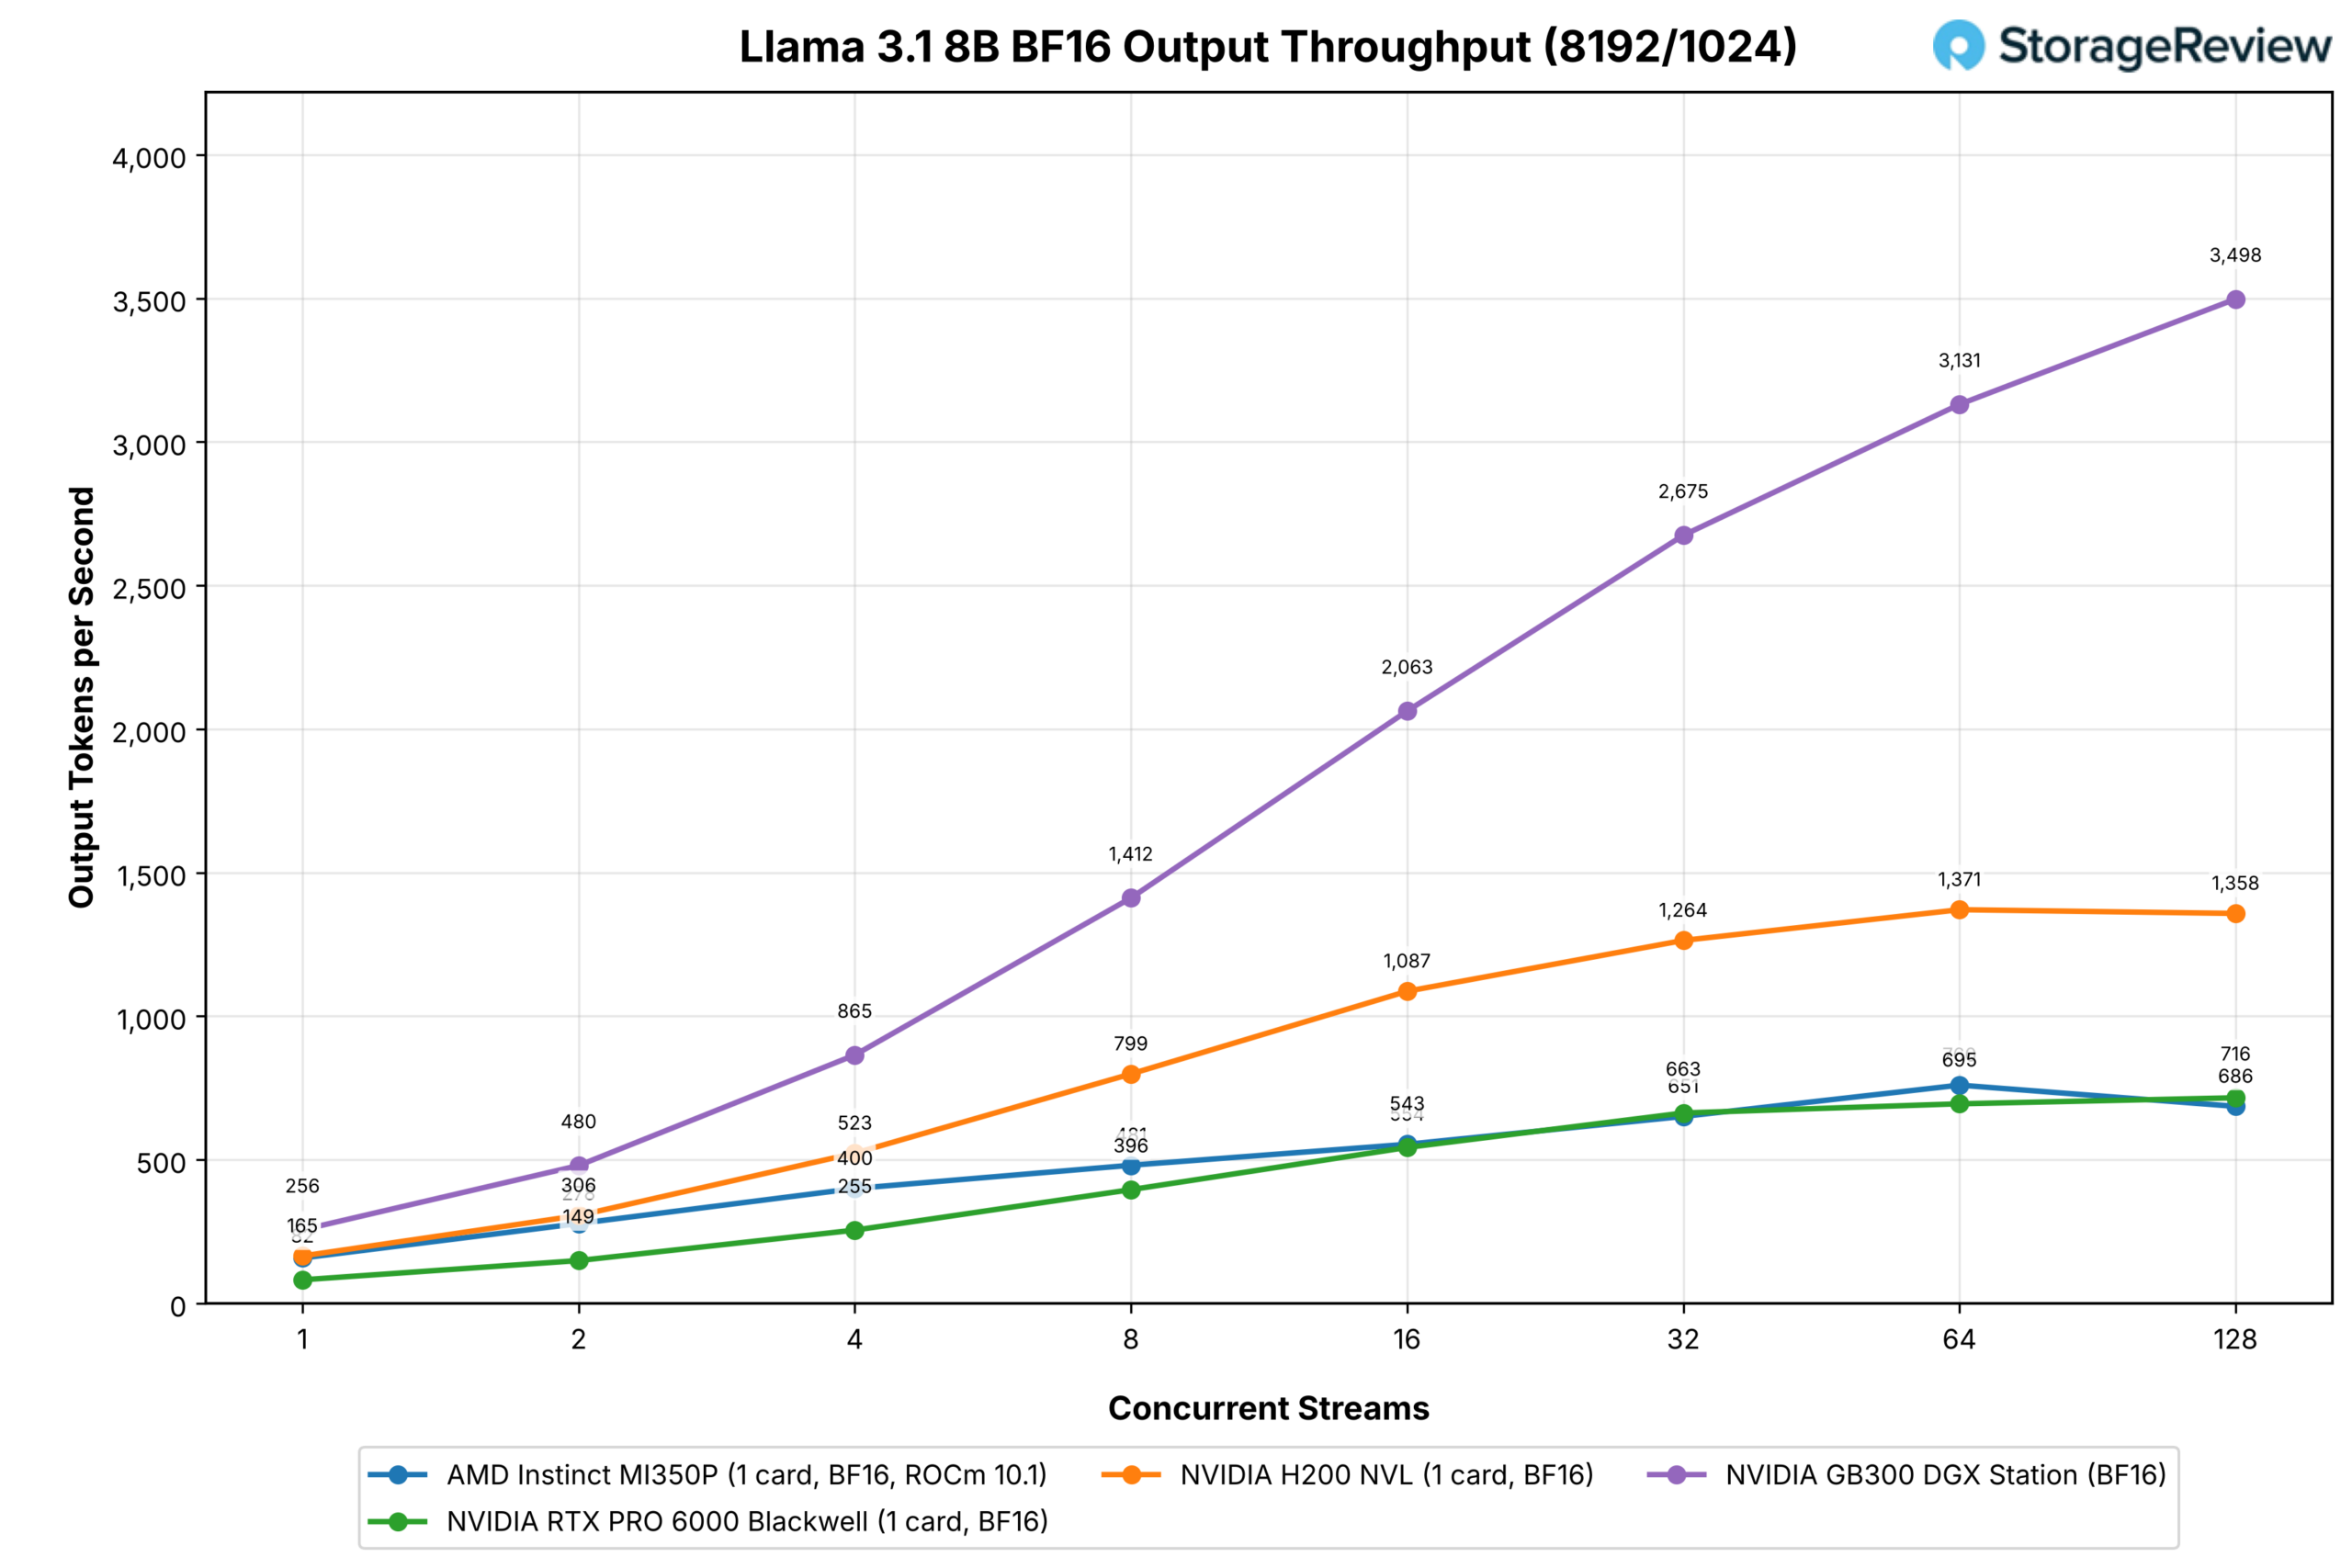
Llama 3.1 8B è qui per continuità con la nostra precedente copertura delle GPU. Con 128 stream nel carico di lavoro della chat, la MI350P fornisce 11,045 token di output al secondo su FP8 contro 8,073 per la RTX PRO 6000 e 11,054 per la H200, un pareggio con la scheda Hopper, e 6,819 su BF16 contro 4,740 e 8,069. La build MXFP4 di AMD raggiunge 8,383 con 128 stream, il 5% dietro la build NVFP4 di NVIDIA sulla RTX PRO 6000 (8,869), dopo averla superata dal 12 al 143% per ogni numero inferiore di stream; con un singolo stream la run MXFP4 legge 323 contro 133.
Le esecuzioni con pre-caricamento elevato invertono il risultato: MI350P FP8 si appiattisce di 16 stream e termina a 1,211 contro 1,481 per la RTX PRO 6000 e 2,045 per la H200, anche se MI350P parte con il 90% di vantaggio sulla RTX PRO 6000 con uno stream e la build MXFP4 è indietro del 41% rispetto a NVFP4 con 128 stream.
Conclusione
La MI350P è la prima scheda Instinct in quattro anni a essere integrata in un server standard e, con un consumo di 450 W in un box 2U, si dimostra un valido acceleratore PCIe: 144 GB di HBM3E a 4 TB/s, 1,120 TFLOPS di FP8 e 2,228 di FP4 scalato a blocchi in MAMF contro gli 820 e i 1,634 della RTX PRO 6000 Blackwell, e circa 2.1 volte la larghezza di banda di memoria utilizzabile della scheda NVIDIA.

Rispetto alla RTX PRO 6000, la MI350P è risultata più veloce sui prompt di dimensioni chat su ogni modello FP8, BF16 e GPT-OSS, dal 35 al 65 percento a 128 stream, dove la larghezza di banda e la capacità di HBM3E hanno superato una scheda GDDR7 da 96 GB, ed è in testa su entrambi i modelli GPT-OSS per ogni numero di stream su entrambe le forme di prompt.
La H200 NVL l'ha comunque superata nei test intensivi FP8 e BF16, dal 4 al 18% con 128 stream su prompt di chat e di più su prompt lunghi, con il 20% di larghezza di banda in più e senza percorso FP4; su GPT-OSS la MI350P ha concluso con il 50 e il 78% di vantaggio sulla scheda Hopper. I modelli più grandi sono meno definiti, dato che quattro RTX PRO 6000 superano la coppia MI350P su GLM-5.2 con 16 stream, con 384 GB contro 288 GB e una maggiore larghezza di banda e potenza di calcolo complessive da sfruttare.
MiniMax-M3 è più vicino: le tre configurazioni rimangono entro il 10% su otto flussi di messaggi di chat, il quad RTX si porta in vantaggio a 16 e la coppia MI350P è in testa sui messaggi lunghi su otto flussi. Per scheda, il tasso FP4 misurato della MI350P è superiore del 36% rispetto a quello della RTX PRO 6000, quindi il vantaggio è dato dal numero di schede. Questi risultati con due schede sono stati ottenuti con lo stack ROCm 7.2.3 e verranno eseguiti nuovamente con ROCm 10.1 insieme al test a 600W.
Non ci è ancora possibile esprimere un'opinione definitiva sul MI350P senza testarlo al massimo delle sue potenzialità a 600W, cosa che prevediamo di fare in un PowerEdge XE7745; Dell supporta otto MI350P a 600W in questo chassis. Ci risulta che AMD stimi un aumento delle prestazioni di circa il 10% con i 150W aggiuntivi.
AMD ha fatto molta strada e la linea MI350/5X dimostra quanto sia capace questa architettura. Nel nostro laboratorio utilizziamo un MI300X per lo sviluppo e la velocità dello stack software si è vista nella fluidità con cui gran parte della suite ha funzionato senza problemi con vLLM di serie.
Da quanto abbiamo visto in questa configurazione, il MI350P è pensato per gli acquirenti che cercano un'alternativa alle GPU NVIDIA, sia per via dei tempi di consegna, del prezzo o per evitare di dipendere da un unico produttore, e il supporto di Dell per questa tecnologia nella linea PowerEdge offre ai server mainstream la diversità di chip necessaria per soddisfare tali esigenze.
A dire il vero, il nostro lavoro qui è tutt'altro che concluso. Sebbene molti acquirenti possano installare queste schede in server 2U, si possono ottenere prestazioni migliori se utilizzate in chassis più grandi progettati per schede da 600 W. Indipendentemente dalla modalità di implementazione, questo rappresenta un ottimo primo assaggio del ritorno di AMD nel mercato delle schede aggiuntive per server e, con la continua maturazione dello stack software, la MI350P, e le sue future applicazioni, hanno un futuro promettente. Oggi, per un acquirente i cui modelli rientrano nella fascia tra 96 GB e 144 GB, la MI350P è una delle due schede PCIe che consentono di utilizzare una singola GPU, ed è l'unica a superare i 141 GB.
Classifica: The AMD Instinct MI350P appears under Also Tested on our Le migliori GPU aziendali leaderboard, with its two-card results under Scale-Out Configurations.



 Amazon