

Per gran parte del suo periodo nei data center, NVIDIA ha considerato la CPU poco più che il chip che alimentava la GPU. Grace, il suo primo processore per server, si adattava perfettamente a questo modello. Utilizzava i core Neoverse V2 standard di Arm ed era commercializzato principalmente come metà CPU dei superchip Grace Hopper e Grace Blackwell. Questi superchip introdussero tuttavia un elemento duraturo della piattaforma: NVLink-C2C, un collegamento che consente a CPU e GPU di accedere in modo coerente alla memoria l'una dell'altra con una larghezza di banda di gran lunga superiore a quella del PCIe.
Its successor, Vera, is far more ambitious. It is a clean-sheet design built around Olympus, NVIDIA’s custom Arm core. Olympus implements Armv9.2, and each Vera CPU features 88 cores and 176 threads. Alongside the new cores, the memory subsystem is the other highlight. Each CPU supports up to 1.5TB of LPDDR5X on SOCAMM modules, with an advertised peak bandwidth of 1.2TB/s per socket, which gives Vera the power efficiency of mobile-class DRAM while keeping the memory field-replaceable. Across the two sockets in our test server, that rating comes to 2.4TB/s, and we measured 2,073GB/s on STREAM Triad.
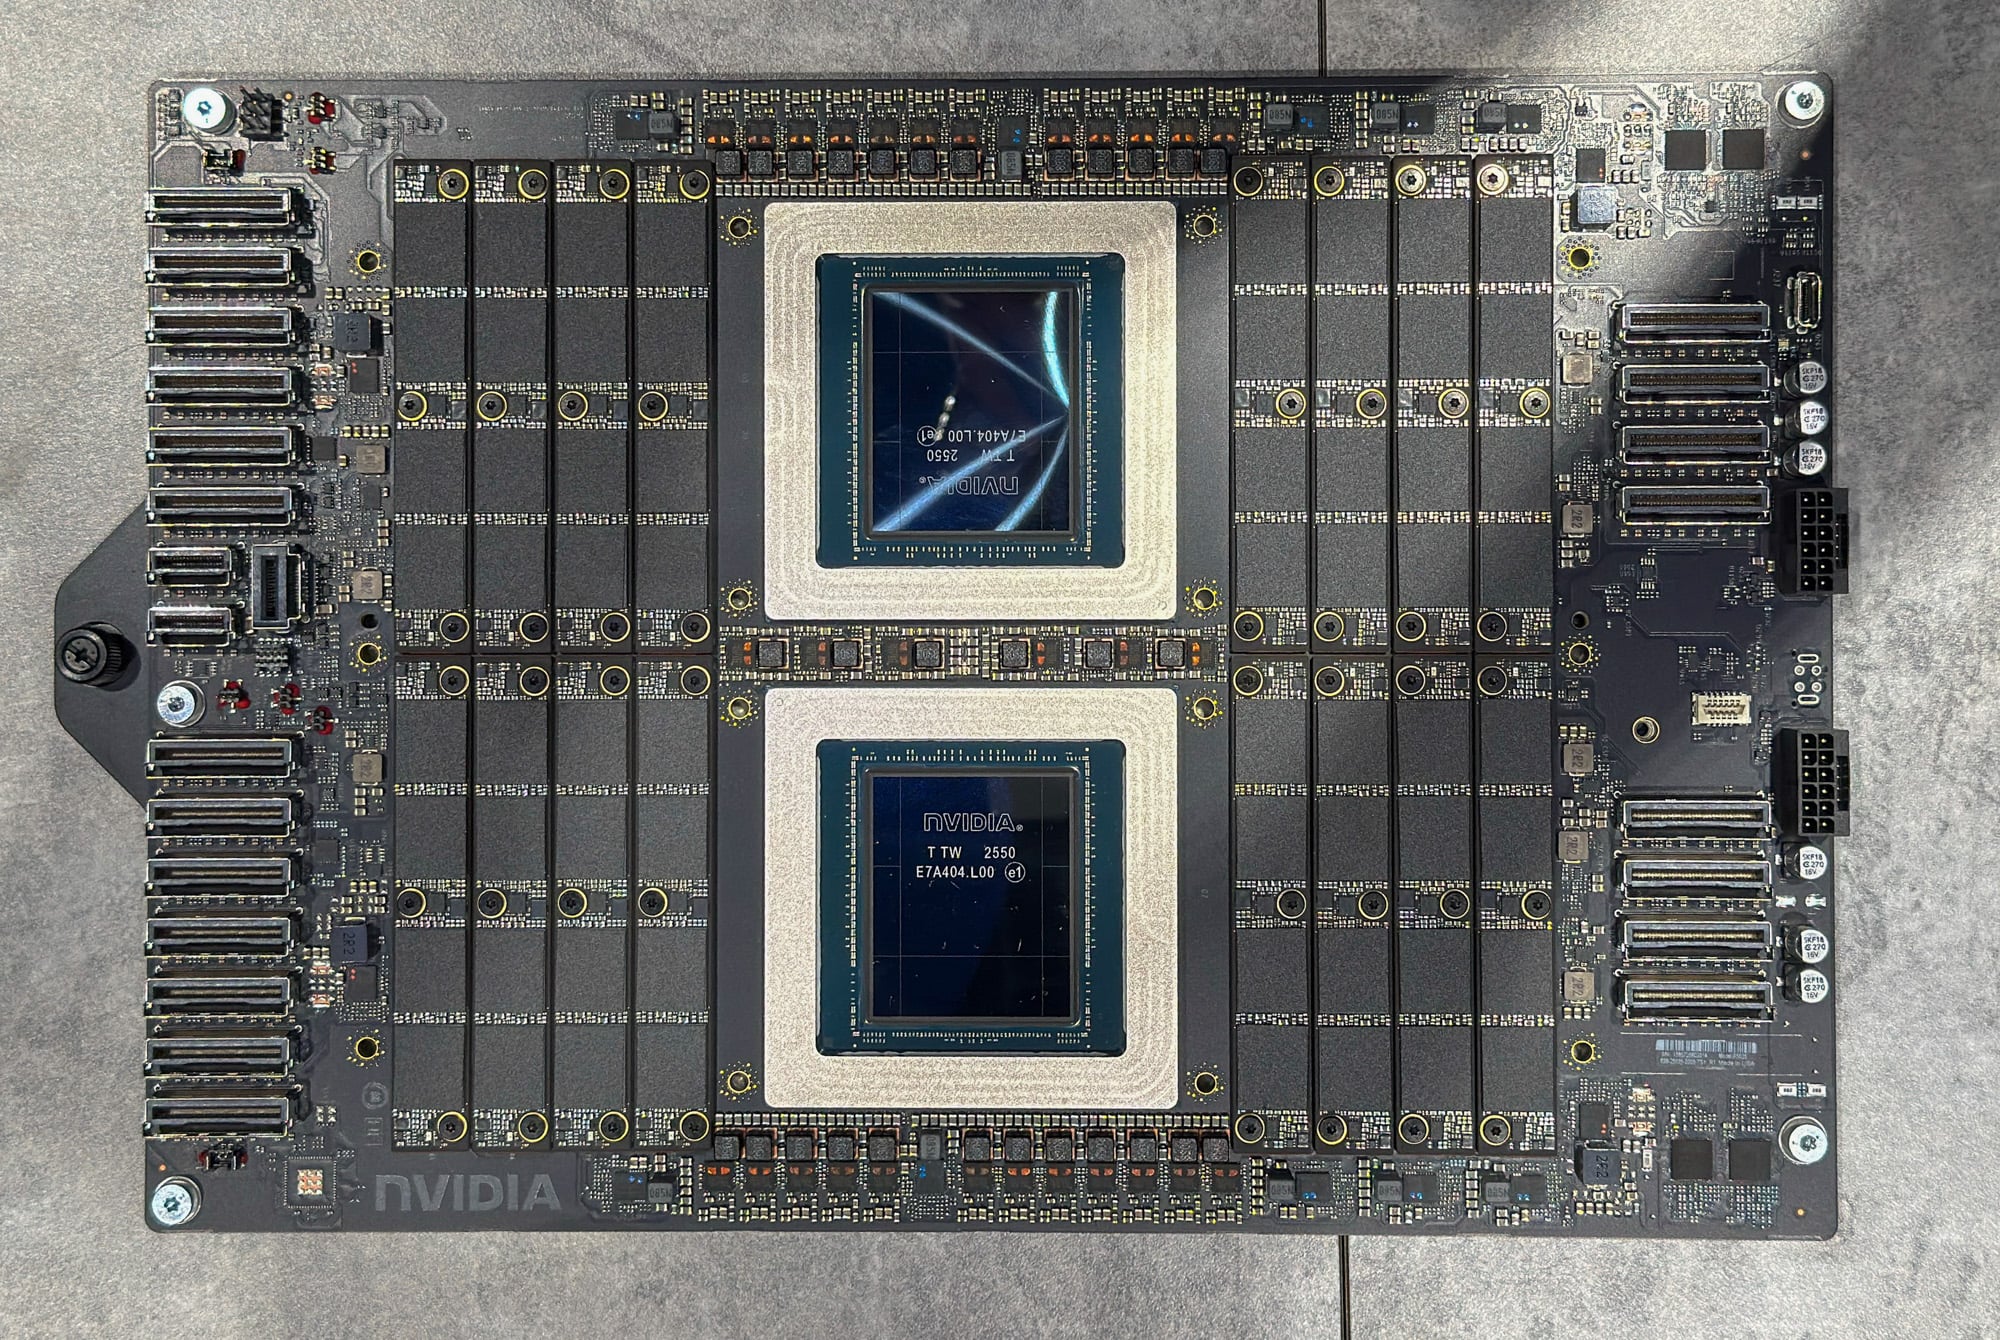
Quest'ambizione si estende anche al contesto di implementazione di Vera. È ancora integrato nel superchip dei sistemi Vera Rubin, ma NVIDIA lo ha esteso anche alla sua piattaforma di storage BlueField-4 STX e ai server CPU standalone per sandbox agentiche. Vera sta inoltre ottenendo un ampio supporto da parte di OEM, hyperscaler e NCP: Dell, HPE e Supermicro hanno aggiunto i server Vera alle loro gamme, e hyperscaler e NCP sono pronti a renderlo un'offerta standard. Questa ampia disponibilità è importante perché, come dimostreranno i nostri risultati, Vera è un serio concorrente per le sue controparti x86 e offre alle organizzazioni un terzo fornitore di CPU per contribuire a diversificare le loro catene di approvvigionamento.
Punti chiave
- La larghezza di banda della memoria raddoppia abbondantemente in ogni sistema x86. Due socket Vera hanno mantenuto oltre 2 TB/s su STREAM Triad, 2.3 volte il miglior server DDR5 che abbiamo testato. Anche durante la lettura della memoria dell'altro socket tramite NVLink-C2C, i core di Vera hanno sfruttato una larghezza di banda maggiore di quella che qualsiasi socket x86 ottiene dalla memoria locale, e la latenza locale con hugepages è risultata inferiore del 13% rispetto all'EPYC 9175F.
- Un chip ben bilanciato per l'ampia fascia media del mercato. Un singolo core Olympus da 3.4 GHz ha compresso i file con 7-Zip il 12% più velocemente rispetto all'EPYC 9175F da 5.0 GHz e ha vinto due dei tre test Python single-thread a cui è stato sottoposto. A pieno carico, Vera ha raggiunto dal 63% al 72% del throughput di 7-Zip dell'EPYC 9965 con meno della metà dei core, rimanendo vicina allo specialista di AMD per core in un singolo thread e al suo specialista di throughput sull'intero sistema.
- Il lavoro sui vettori e sulla crittografia è chiaramente il punto debole. Sei pipeline SVE2 a 128 bit non possono eguagliare AVX-512 a 512 bit su codice scritto per esso. Su 16 core corrispondenti, Vera ha eseguito GROMACS benchMEM alla metà della velocità dell'EPYC 9175F e a due terzi di quella dell'EPYC 9965, e un singolo core crittografato AES-256-GCM a circa un terzo della velocità del 9175F. Nell'intero sistema, l'EPYC 9965 a 384 core ha superato di circa 3 volte sia GROMACS benchPEP che AES.
- Il calcolo ad alte prestazioni (HPC) limitato dalla memoria trasforma la larghezza di banda in velocità. Sulla grande mesh OpenFOAM, Vera ha ottenuto un risultato 1.44 volte più veloce dell'EPYC 9965 a 384 core e 1.20 volte più veloce dello Xeon 6978P a 240 core. Sulla mesh più piccola, dove le cache L3 x86 più grandi rappresentano una parte maggiore del problema, Vera si è classificata seconda, con un distacco inferiore al 12% rispetto al 9965.
- I database e gli strumenti di analisi sono già altamente competitivi. Nel test HammerDB TPROC-C su un singolo socket, Vera con 88 core ha superato un socket EPYC 9965 con 192 core del 26% su PostgreSQL e dell'8% su MariaDB, mentre è rimasta indietro del 19% su MySQL e del 15% su VillageSQL; lo Xeon 6787P è risultato inferiore a Vera su tutti e cinque i motori di elaborazione. Vera ha inoltre completato il test ClickBench in un tempo inferiore del 23% rispetto all'EPYC 9965 e ha gestito il 34% di richieste in più su un working set Valkey da 256 GB.
Specifiche
| Specificazione | CPU NVIDIA Vera |
|---|---|
| Calcolo e potenza | |
| Nucleo | NVIDIA Olympus, Armv9.2 con SVE2 e FP8 |
| Nuclei e filettature per presa | 88 core, 176 thread (NVIDIA Spatial Multithreading) |
| Velocità di clock (misurata) | 3.41GHz |
| TDP | configurabile da 250W a 450W |
| Raffreddamento | Aria o liquido |
| Cache | |
| Istruzione L1 | 64 KB per core |
| Dati L1 | 96 KB per core, 6 vie |
| L2 | 2 MB per core, privato |
| Cache a livello di sistema (L3) | 164 MB per socket, partizionamento Arm MPAM |
| Tessuto | Tesseramento di coerenza scalabile di seconda generazione, bisezione a 3.4 TB/s |
| Memorie | |
| Tipo | LPDDR5X su 8 moduli SOCAMM2 per socket |
| Controller | 8x 128 bit (1,024 bit complessivi) |
| Velocità | Fino a 9,600 MT/s |
| Larghezza di banda | Fino a 1.2 TB/s per socket (valori dichiarati dal fornitore) |
| Ultra-Grande | Da 256 GB a 1.5 TB per socket |
| I / O | |
| PCIe | Sesta generazione, 88 linee per socket (piattaforma solo CPU) biforcazione x16, x8, x4, x2 |
| CXL | 3.1, Espansione e pooling della memoria di tipo 3 |
| NVLink-C2C | Crittografia bidirezionale, coerente e autenticata di seconda generazione, a 1.8 TB/s. |
| Sicurezza | |
| Informatica riservata | Realm Arm CCA, RME-DA e RME-CDA, TDISP, chiavi per VM |
Perché NVIDIA vuole entrare nel mercato delle CPU
Per capire perché Vera sia importante per NVIDIA, bisogna osservare la crescita dell'azienda. NVIDIA ha consolidato la sua posizione nel settore dei data center attorno alle GPU, per poi espandersi nell'infrastruttura necessaria al loro funzionamento. Sul fronte hardware, l'acquisizione di Mellanox nel 2020 ha portato la tecnologia di rete che connette i server e trasferisce i dati tra di essi. Sul fronte software, CUDA, DOCA e l'intero stack software hanno esteso la portata di NVIDIA nella programmazione e nella gestione dell'hardware. Insieme, questi elementi hanno conferito all'azienda il controllo su gran parte della piattaforma di calcolo accelerato.
Ma la piattaforma necessitava comunque di una CPU generica. Qualcosa doveva eseguire il sistema operativo, preparare i dati, gestire le applicazioni e coordinare il lavoro inviato agli acceleratori. Durante gran parte dell'espansione di NVIDIA, Intel e AMD hanno ricoperto questo ruolo. Ciò ha messo NVIDIA in una posizione scomoda: poteva fornire le GPU, la rete e gran parte del software, pur dipendendo dal processore di un'altra azienda al centro del server.
Grace ha rappresentato il primo passo importante verso questo cambiamento. Basato sui core Arm Neoverse V2, ha fornito a NVIDIA una CPU per data center e un modo per connetterla più strettamente alle sue GPU tramite NVLink-C2C. Ciononostante, Grace presentava un divario prestazionale da colmare. La sua larghezza di banda della memoria e la sua efficienza la rendevano competitiva come CPU host per l'intelligenza artificiale, ma i processori x86 di punta mantenevano vantaggi sostanziali nella maggior parte degli altri carichi di lavoro. Questa disomogeneità prestazionale limitava la possibilità di scegliere Grace come sostituto generico di un server EPYC o Xeon.
Vera colma gran parte di questo divario sostituendo i core Neoverse V2 di Grace con il design personalizzato Olympus di NVIDIA e aumentando sostanzialmente la larghezza di banda e la capacità della memoria. Fornendo una CPU competitiva insieme alle sue GPU, DPU e soluzioni di rete, NVIDIA può accaparrarsi una quota maggiore della spesa per ciascun server. Ciò offre inoltre all'azienda un maggiore controllo sul proprio ecosistema e sul modo in cui i componenti interagiscono: i core della CPU, il sottosistema di memoria, l'interconnessione e la GPU possono essere progettati in base agli stessi requisiti. Il collegamento coerente CPU-GPU di Vera, ora con una velocità nominale fino a 1.8 TB/s, è un esempio concreto di tale integrazione.
Catturare una quota maggiore della spesa di ciascun sistema è solo una parte del quadro. L'apprendimento per rinforzo (RL) e l'intelligenza artificiale agentica offrono a NVIDIA un ulteriore motivo per proporre un sistema CPU autonomo. Un agente fa molto di più che generare una risposta. Richiama strumenti, recupera informazioni, esegue codice e verifica i risultati prima di decidere cosa fare successivamente. Gran parte di questa esecuzione avviene sulle CPU e, quando il passo successivo del modello dipende dal risultato di un'attività della CPU, un'esecuzione lenta ritarda l'intera sequenza. Le prestazioni per core, la latenza della memoria e il comportamento prevedibile sotto carico diventano quindi fattori cruciali per la reattività dell'agente.
Il nucleo dell'Olimpo
Questi requisiti si allineano perfettamente con la progettazione degli 88 core Olympus di Vera, costruiti attorno a una chiara priorità: prestazioni elevate da ciascun core, mantenute anche quando l'intero socket è occupato. Olympus è l'implementazione di NVIDIA del set di istruzioni Armv9.2, che sostituisce i core Neoverse V2 utilizzati in Grace. Questa distinzione è importante: Arm definisce le istruzioni eseguite dal processore, mentre NVIDIA ha progettato il meccanismo che le recupera, le pianifica e le esegue. Questo controllo consente a NVIDIA di ottimizzare il core per il suo scopo: completare rapidamente le singole attività eseguendone molte contemporaneamente.
La prima parte di questo obiettivo inizia con le istruzioni per ciclo, o IPC: quante istruzioni un core completa, in media, in ogni ciclo di clock. La frequenza di clock determina la frequenza con cui si verificano questi cicli; la microarchitettura determina quanto lavoro utile può essere svolto in essi. NVIDIA dichiara un miglioramento dell'IPC di 1.5 volte rispetto alla generazione precedente. La frequenza di clock più elevata che abbiamo osservato è stata di 3.41 GHz, ma l'architettura di Vera si concentra sull'estrazione di più lavoro per ciclo e sul mantenimento di tale avanzamento sotto carico. Questa enfasi è importante perché, per un compilatore, un interprete o un'operazione di database con una lunga sequenza di passaggi dipendenti, il solo aumento dei core non è sufficiente a velocizzare il completamento di tale sequenza.
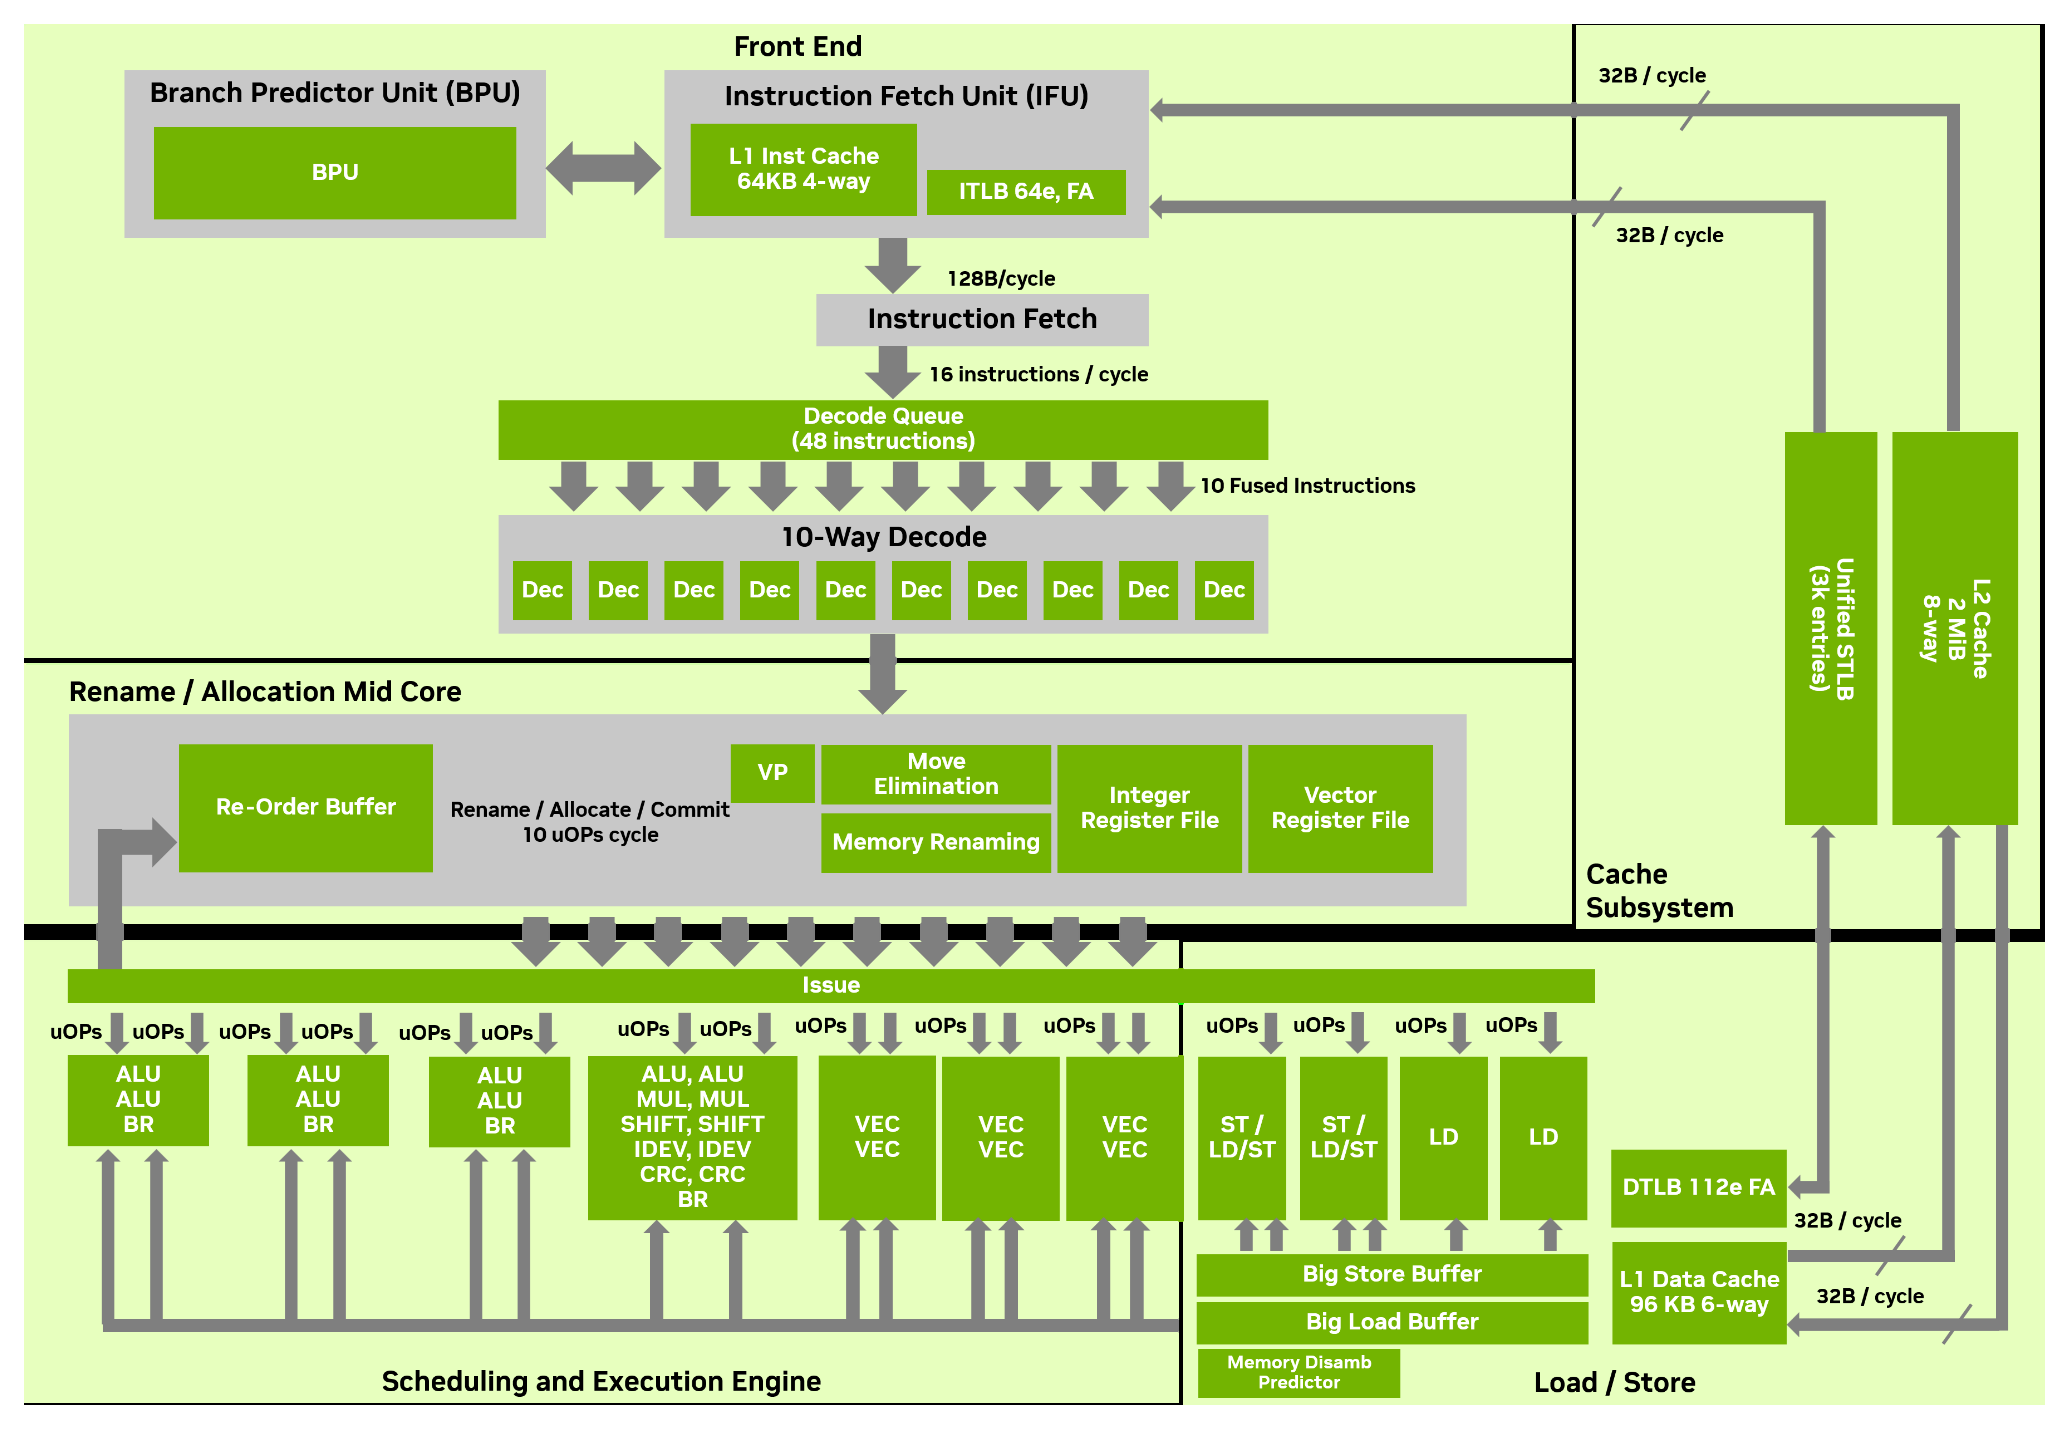
Raggiungere tale IPC inizia con un flusso costante di istruzioni utili. Il front-end di Olympus, la parte del core che preleva e decodifica le istruzioni del programma, può decodificare fino a dieci istruzioni per ciclo. Questa capacità è rilevante solo se il flusso di istruzioni viene mantenuto costante, il che diventa difficile quando il software effettua frequentemente salti condizionali tra i diversi percorsi di codice. Olympus combina quindi un predittore di salti neurale con altri predittori specializzati e supporta fino a due salti condizionali eseguiti per ciclo. Una migliore predizione aiuta il core a prelevare le istruzioni necessarie, riducendo il tempo impiegato nell'esecuzione di percorsi errati e i riavvii successivi a un errore.
Una volta recuperate e decodificate le istruzioni, Olympus utilizza l'esecuzione fuori ordine per individuare le operazioni che possono essere eseguite mentre le istruzioni precedenti sono in attesa. Ad esempio, se un'operazione è in attesa di memoria, un calcolo indipendente può essere eseguito prima di essa. Un'ampia finestra di istruzioni offre al processore maggiori opportunità di trovare tali operazioni indipendenti.
Ciononostante, alcune sequenze, come le catene dipendenti descritte in precedenza, resistono a questo approccio perché ogni passaggio richiede il risultato del passaggio precedente. In questi casi, Olympus utilizza anche la predizione del valore per consentire alle operazioni dipendenti di iniziare con un valore previsto, per poi verificare tale valore quando il risultato effettivo diventa disponibile. Le predizioni corrette possono ridurre i tempi di attesa effettivi lungo queste catene di dipendenza; le predizioni errate richiedono la correzione e il ricalcolo del lavoro speculativo.
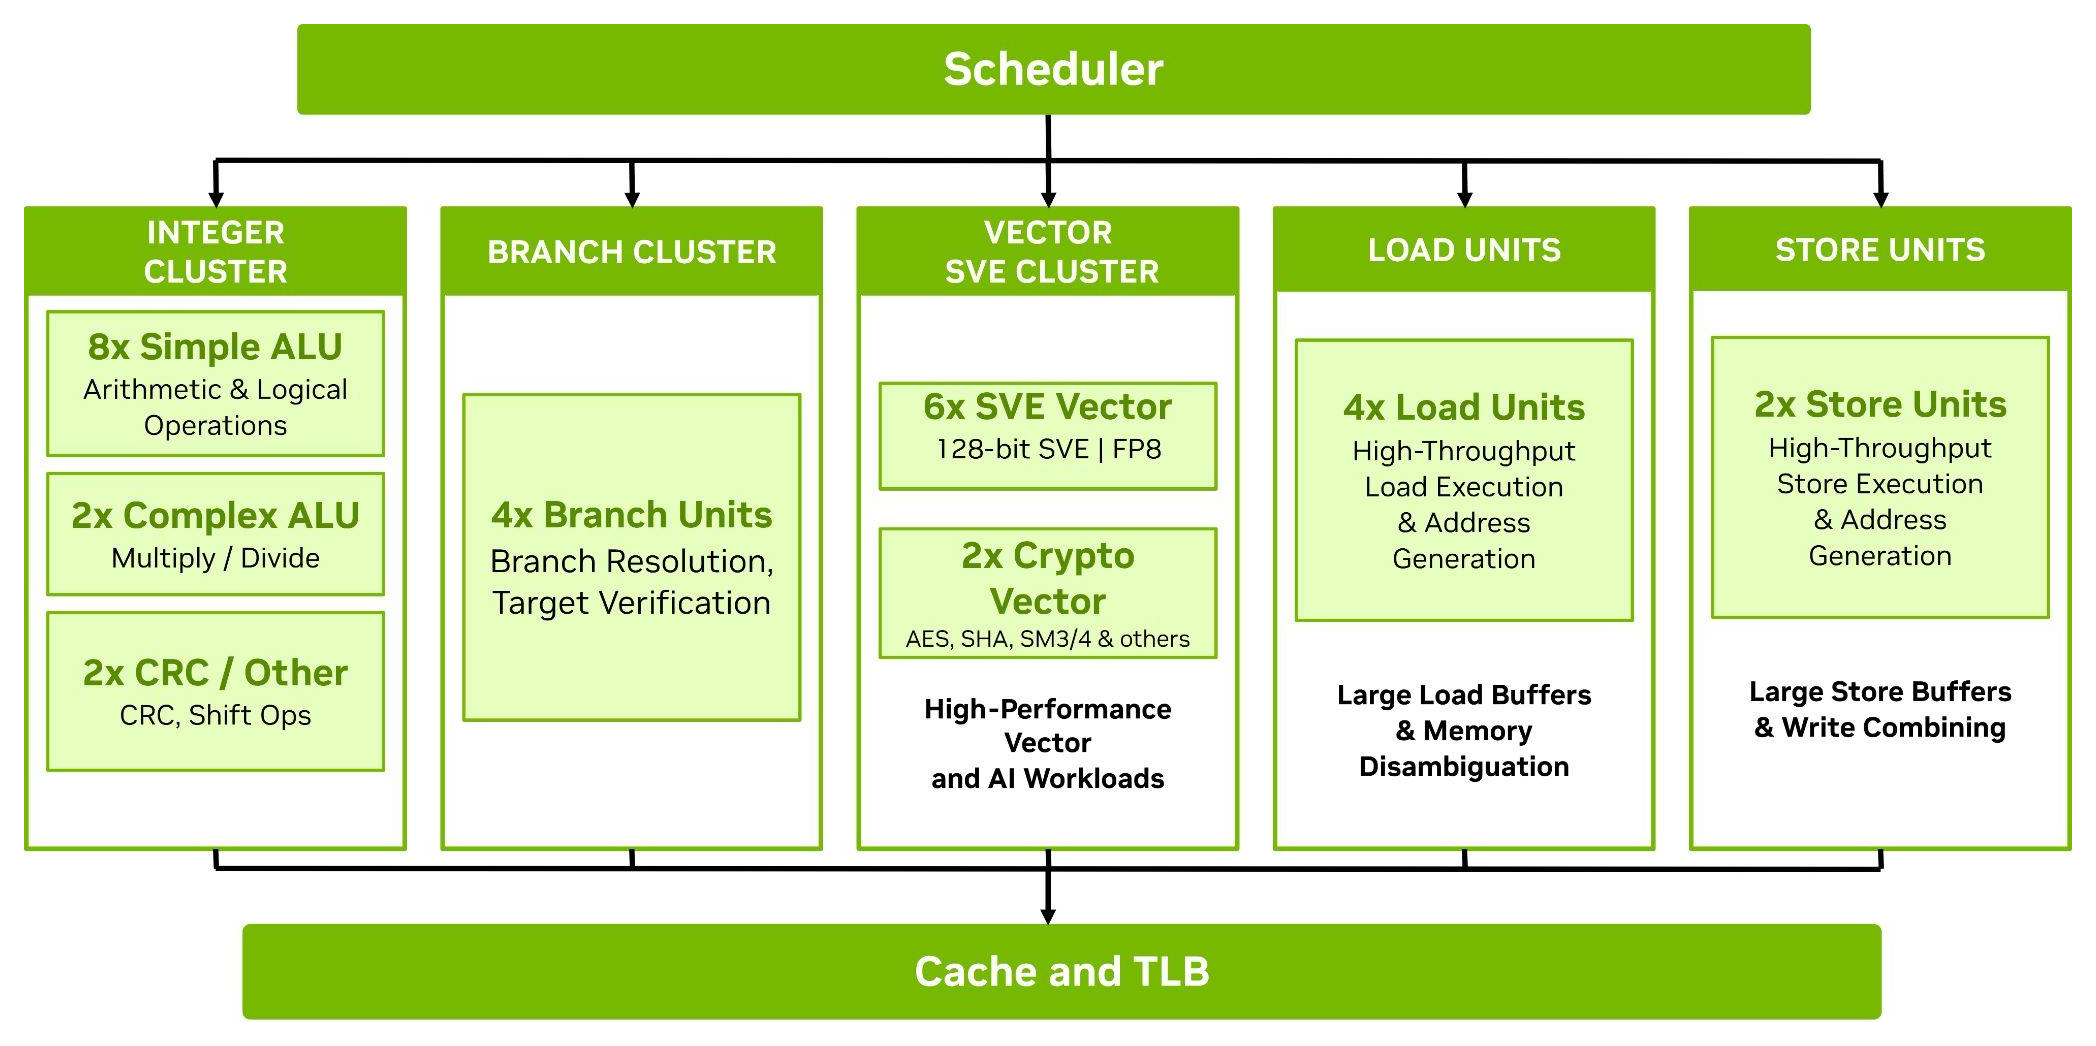
Il motore di esecuzione necessita quindi di una capacità sufficiente per trasformare le istruzioni in lavoro completato. Olympus combina ampie risorse di esecuzione per operazioni intere con unità di diramazione dedicate, quattro pipeline di caricamento e due pipeline di memorizzazione. Queste risorse soddisfano esigenze diverse: le unità per operazioni intere gestiscono aritmetica, confronti e logica; le unità di diramazione risolvono il flusso di controllo; e le pipeline di caricamento/memorizzazione trasferiscono i dati tra il core e le sue cache. L'equilibrio è fondamentale perché un decoder più ampio offrirebbe pochi vantaggi se le istruzioni si accumulassero semplicemente a causa di un collo di bottiglia nell'esecuzione o nella memoria.
Oltre a queste risorse scalari, Olympus dispone di sei pipeline vettoriali a 128 bit che supportano SVE2, con supporto FP8 e funzionalità crittografiche in due pipeline. Le istruzioni vettoriali applicano un'operazione a più elementi di dati, risultando utili per il lavoro numerico, la compressione e l'elaborazione dei dati.
Questo è un ambito in cui Olympus opera un chiaro compromesso: la sua larghezza vettoriale a 128 bit è inferiore alla larghezza a 512 bit disponibile tramite AVX-512 sui processori x86 della concorrenza. La differenza è rilevante per i kernel numerici ottimizzati e persino per i tokenizer, sebbene le prestazioni dell'applicazione dipendano anche dalla velocità di elaborazione delle singole istruzioni, dal codice generato e dalla quantità di dati disponibili. Le applicazioni scientifiche come GROMACS rimangono quindi un test a parte per valutare i punti di forza di questa architettura.
Ciascuna di queste risorse di esecuzione, scalare o vettoriale, dipende dall'arrivo tempestivo dei dati, quindi mantenere i dati utilizzati più frequentemente vicini al motore di esecuzione è altrettanto importante. Ogni core dispone di una cache istruzioni da 64 KB, una cache dati da 96 KB e una cache L2 privata da 2 MB. Le piccole cache di primo livello forniscono un accesso rapido alle istruzioni e ai dati più immediatamente utili; la cache L2, più grande, conserva una porzione maggiore del set di lavoro del core prima che un accesso debba percorrere ulteriori livelli del processore. Dotare ogni core di una cache L2 privata di dimensioni considerevoli supporta lo stesso obiettivo per core: una maggiore quantità di lavoro può essere gestita localmente, riducendo la pressione sulla cache condivisa e sulla memoria principale.
Il precaricamento integra queste cache caricando i dati prima che un'istruzione li richieda. Oltre ai precaricatori per i modelli di accesso regolari, Olympus include un precaricatore per grafi per accessi indiretti come A[B[i]], dove una ricerca fornisce l'indice per un'altra. Dopo aver appreso tale relazione, l'hardware può iniziare a recuperare il secondo dato prima che il programma lo richieda. Questo aiuta a risolvere un problema comune nell'elaborazione di grafi e in altri carichi di lavoro irregolari: il processore ha un'ampia capacità di esecuzione, ma il progresso dipende dal trovare il dato successivo.
L'ultimo componente di Olympus affronta l'altra metà del suo obiettivo: eseguire più attività contemporaneamente. Ogni core supporta due thread hardware, offrendo a Vera 176 thread per socket. NVIDIA chiama questo schema Spatial Multithreading. Il core può dedicare le proprie risorse a un singolo thread attivo oppure dividerle tra due thread attivi, offrendo la possibilità di concentrare la capacità di esecuzione su un flusso di istruzioni e supportare un maggior numero di operazioni simultanee.
L'obiettivo dichiarato di NVIDIA è ridurre l'interferenza tra i due thread, rendendo le prestazioni più prevedibili quando entrambi sono occupati, ovvero la stessa prevedibilità di cui hanno bisogno i carichi di lavoro agentici sotto carico. I due thread condividono comunque un core fisico e il sistema di memoria più ampio, quindi la partizione delle risorse non garantisce una latenza fissa dell'applicazione.
Tessuto, memoria e I/O
Oltre ai singoli core, mantenere produttivi 88 core richiede più di una semplice connessione veloce alla DRAM. I core devono anche scambiare dati, accedere alla cache condivisa e comunicare con i dispositivi collegati. Vera connette queste risorse tramite la seconda generazione di Scalable Coherency Fabric di NVIDIA, una rete interna che mantiene coerenti anche le copie in cache dei dati condivisi. I core, la fabric e la cache di sistema da 164 MB sono integrati in un unico die di calcolo, mentre i controller di memoria e l'I/O si trovano su chiplet adiacenti. NVIDIA valuta la fabric a 3.4 TB/s di larghezza di banda di bisezione, una misura della capacità di traffico attraverso la rete, separata dalla larghezza di banda della memoria principale.
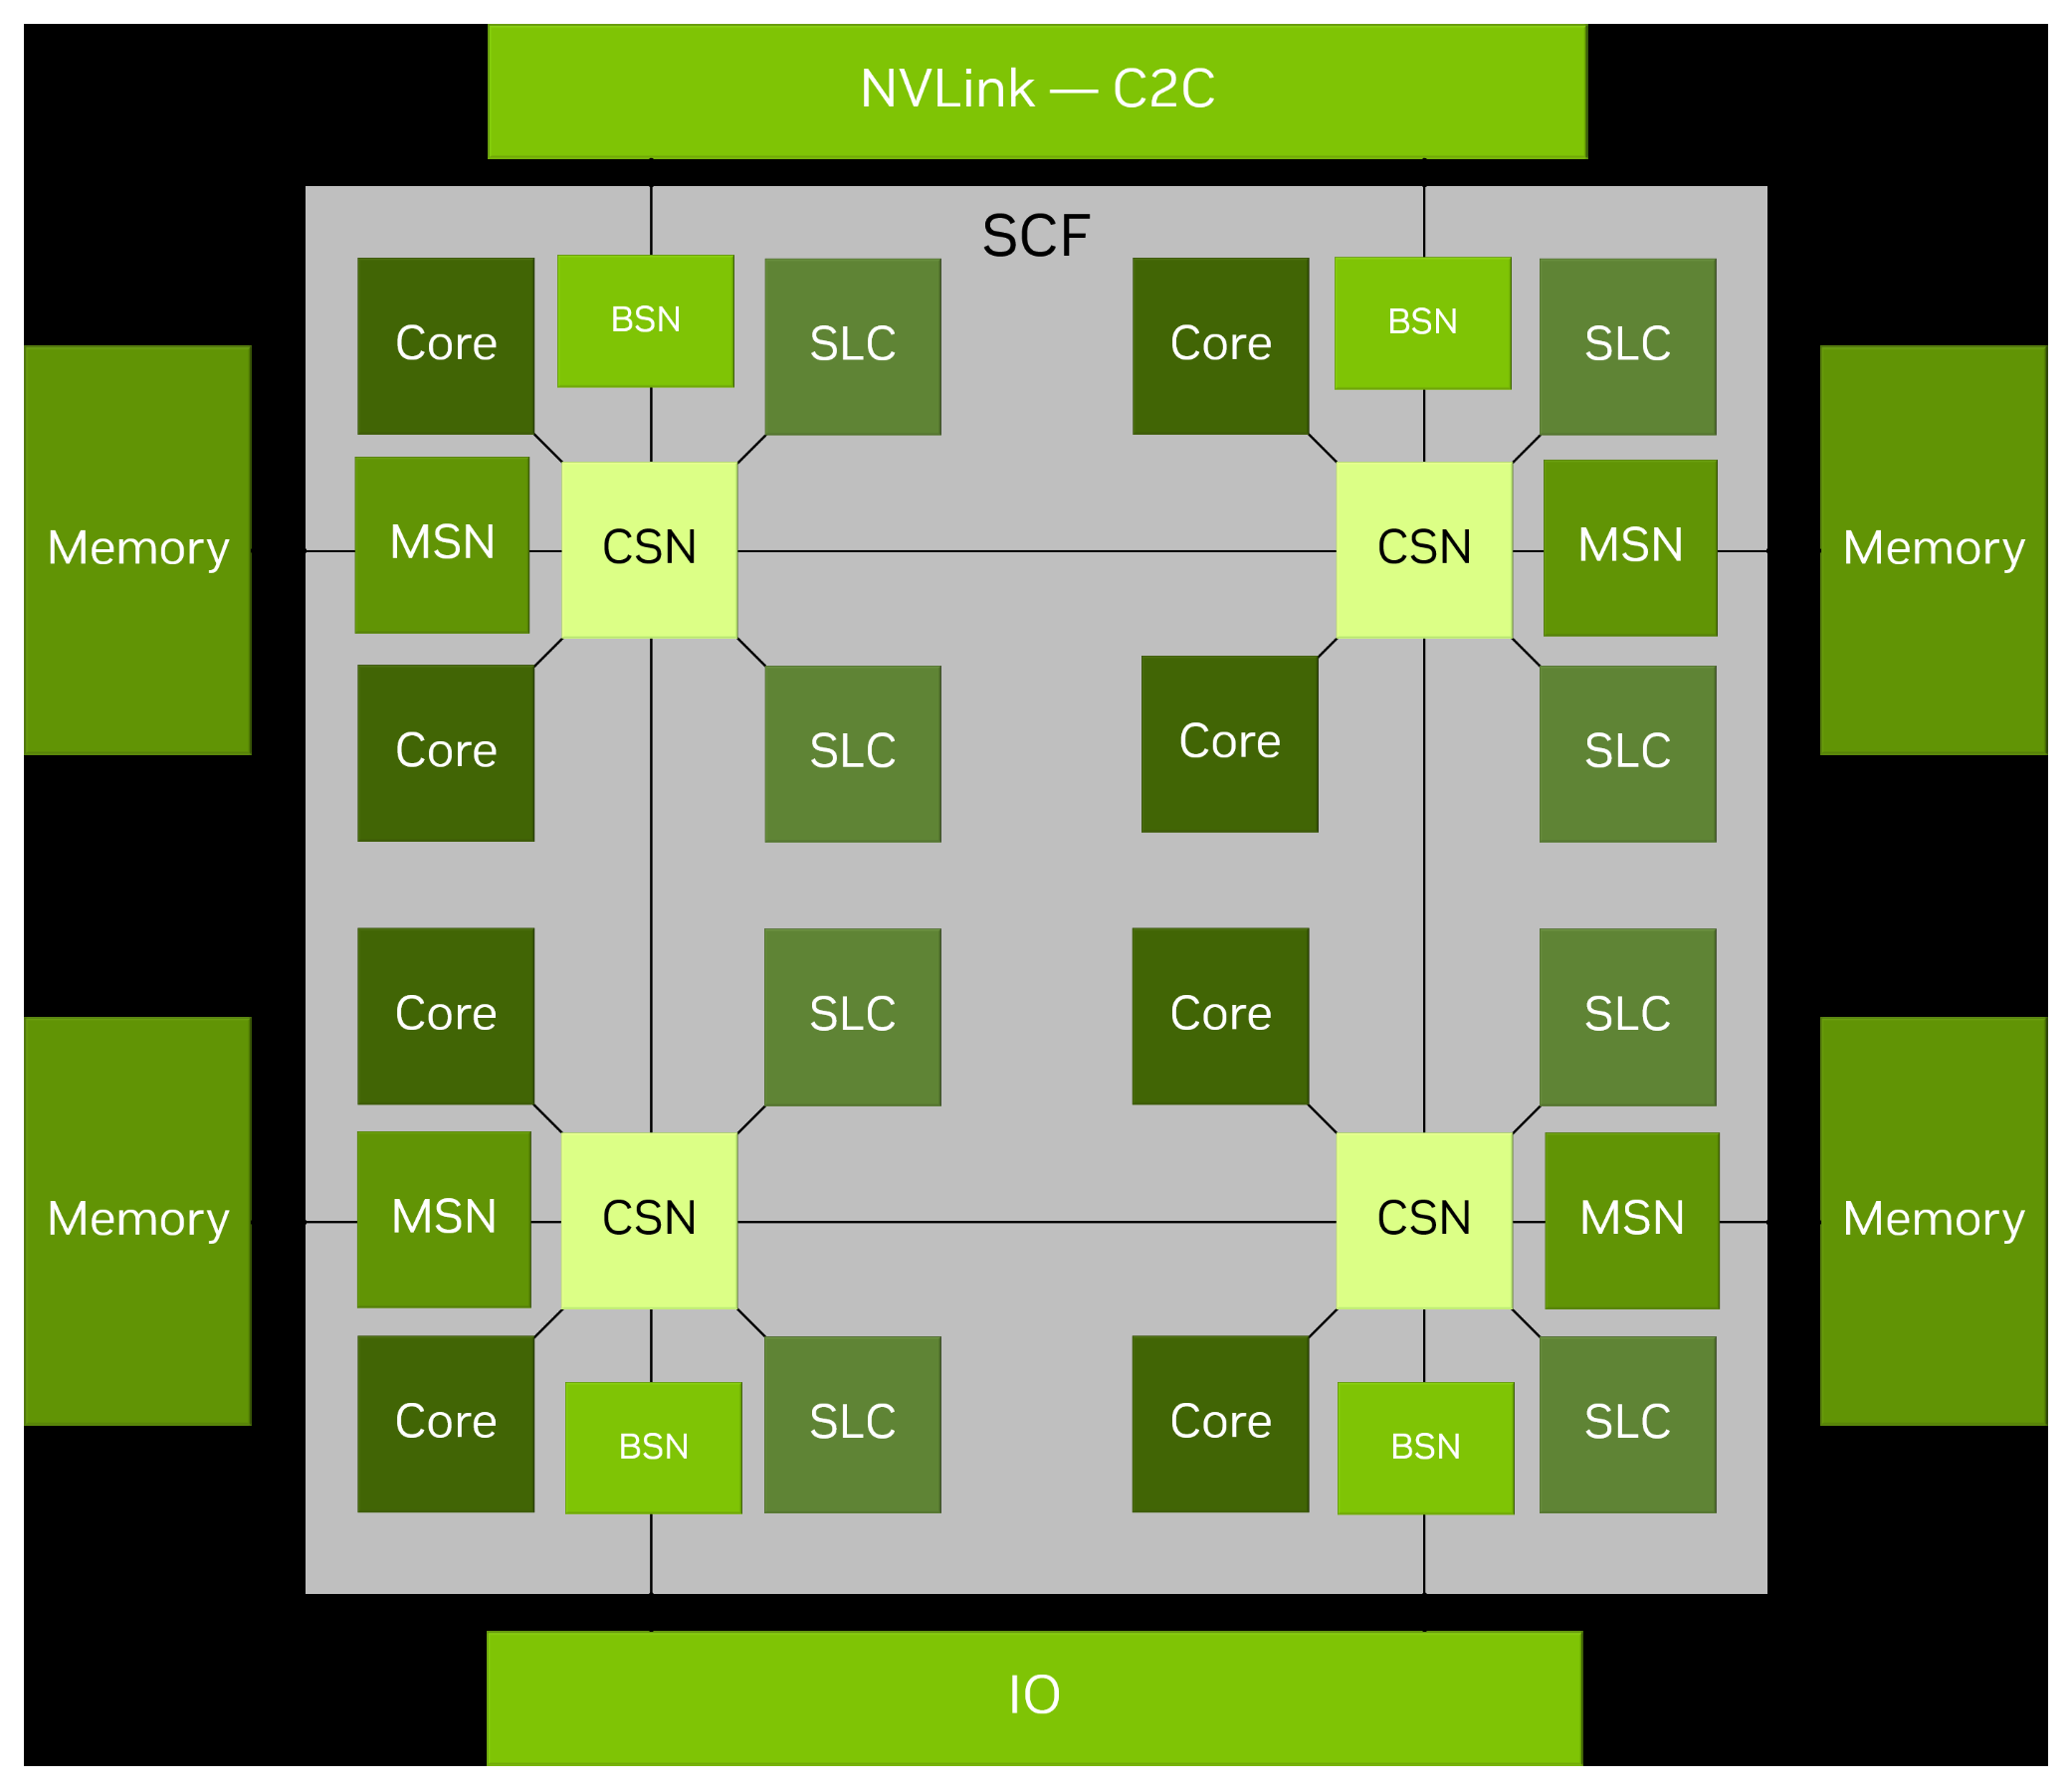
Questa configurazione a singolo die evita trasferimenti tra die di calcolo separati quando i core comunicano o accedono alla cache condivisa. Per quanto riguarda il software, Vera presenta anche un nodo NUMA per socket: il sistema operativo vede ogni socket come un gruppo di core e memoria collegata localmente. Ciò semplifica il posizionamento all'interno del socket, sebbene non significhi che ogni percorso attraverso la mesh abbia la stessa latenza. Un server a due socket ha comunque due nodi NUMA e l'accesso alla memoria dell'altro socket rimane diverso dall'accesso alla memoria locale.
All'interno di ciascun socket, la cache di sistema condivisa, o L3, si trova un livello oltre le cache L2 private descritte in precedenza. Offre ai core un'ulteriore possibilità di riutilizzare i dati senza dover accedere alla DRAM e fornisce una capacità condivisa accessibile a tutti i socket. I suoi 164 MB sono considerevoli, ma alcuni processori concorrenti offrono una L3 notevolmente superiore. Questo è importante quando un working set a cui si accede ripetutamente è troppo grande per la L2 di un core, ma può essere memorizzato in una cache condivisa più ampia. Un'elevata larghezza di banda della DRAM è utile quando i dati devono necessariamente provenire dalla memoria; non elimina però il vantaggio di evitare tale accesso fin dall'inizio.
Poiché tale capacità è condivisa, Vera supporta anche Arm MPAM, consentendo al software di sistema di partizionare la capacità della cache condivisa e di gestire le allocazioni di larghezza di banda della memoria tra i carichi di lavoro.
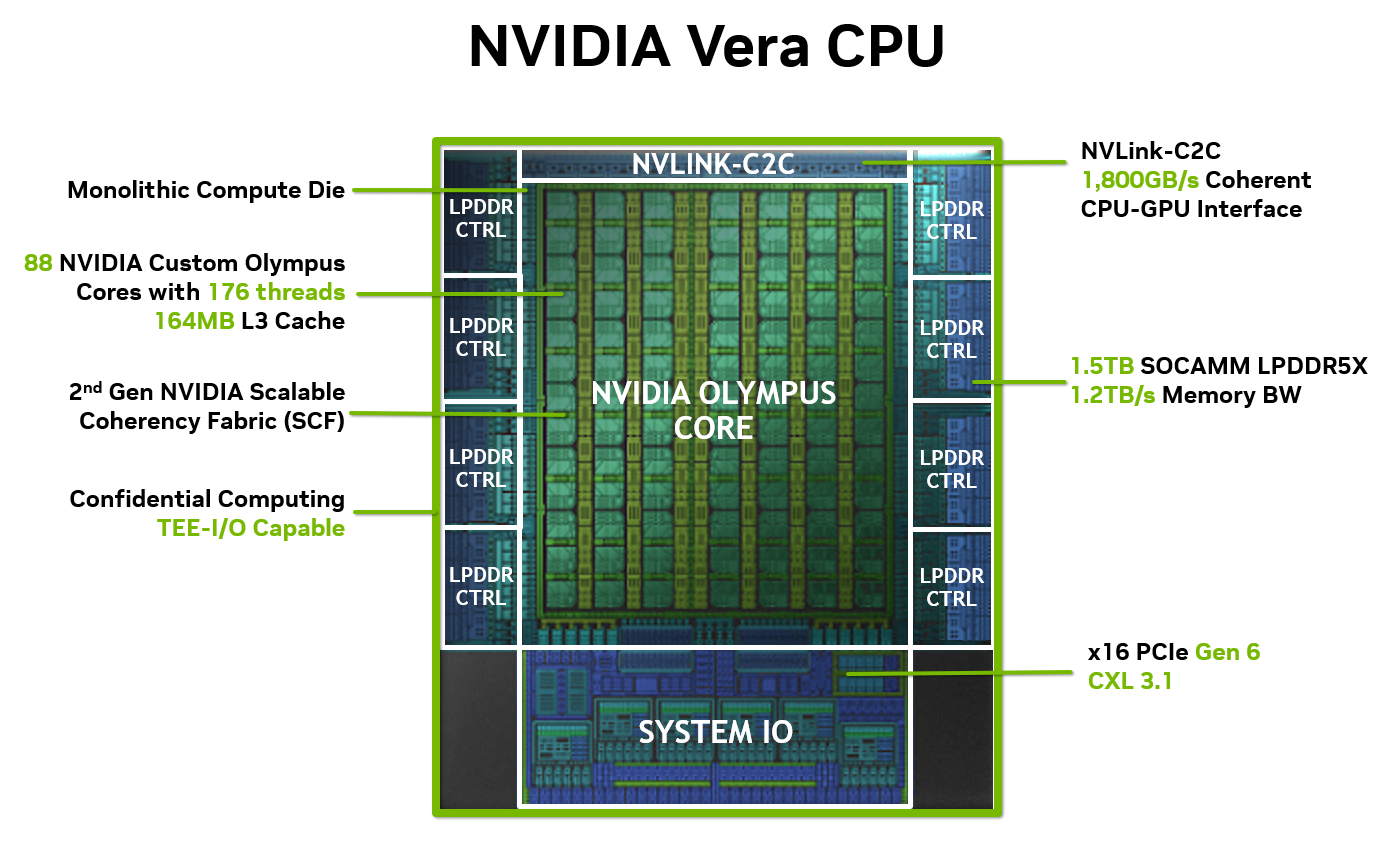
Quando si accede alla memoria principale, Vera dispone di una notevole larghezza di banda. Otto controller LPDDR5X a 128 bit forniscono un'interfaccia aggregata a 1,024 bit, con memoria che opera fino a 9,600 MT/s per una velocità nominale di 1.2 TB/s per socket. La memoria è installata su otto moduli rimovibili SOCAMM2, che combinano LPDDR5X con moduli sostituibili sul campo. Ciò conferisce a Vera un'interfaccia di memoria ampia e veloce senza la necessità di memoria saldata.
La larghezza di banda grezza è solo una parte del quadro. La relazione più utile è quella tra la larghezza di banda e il numero di core che la condividono. Dividendo i 1.2 TB/s nominali per 88 core si ottengono circa 13.6 GB/s per core fisico. Questo è un modo per descrivere il bilanciamento del processore, non un'allocazione dedicata o una garanzia di ciò che ogni thread riceve. Aumentare il numero di core senza un corrispondente aumento della larghezza di banda della memoria ridurrebbe questo rapporto.
Dividendo la larghezza di banda STREAM misurata per il numero di core fisici si ottengono 11.8 GB/s per core su Vera, rispetto ai 3.8 GB/s del sistema Xeon 6978P a 240 core. Questo è un esempio concreto di come Vera offra una velocità di trasmissione della memoria considerevole in rapporto alle sue risorse di calcolo.
L'efficienza energetica è parte integrante della stessa scelta progettuale. NVIDIA stima un consumo di circa 30-40 W per un sottosistema di memoria LPDDR5X completamente popolato, a seconda della capacità. Il vantaggio della LPDDR5X risiede nella capacità di fornire questa larghezza di banda mantenendo basso il contributo della memoria al consumo energetico totale del server, lasciando così una maggiore quantità di energia e risorse di raffreddamento disponibili per l'elaborazione.
La larghezza di banda e l'efficienza non dicono ancora nulla sulla quantità di dati che possono essere memorizzati, e la capacità rimane un fattore da considerare separatamente. NVIDIA specifica fino a 1.5 TB di LPDDR5X collegata direttamente per socket, o 3 TB su due socket. Per i carichi di lavoro che richiedono che il set di lavoro risieda in memoria, velocità di trasferimento più elevate non possono compensare una capacità insufficiente.
Laddove la capacità collegata direttamente non sia sufficiente, l'I/O di Vera offre un percorso per aumentarla, insieme alle connessioni per i dispositivi. La piattaforma CPU standalone fornisce 88 linee PCIe Gen6 per socket per rete, storage e acceleratori, mentre la configurazione Vera Rubin ne espone 96. Per quanto riguarda la memoria, il supporto CXL 3.1 include dispositivi di memoria di tipo 3 e pooling di memoria, consentendo di estendere la capacità oltre i moduli SOCAMM2. Questa memoria espansa utilizza un percorso di accesso diverso rispetto alla LPDDR5X collegata direttamente, quindi le sue prestazioni devono essere valutate separatamente.
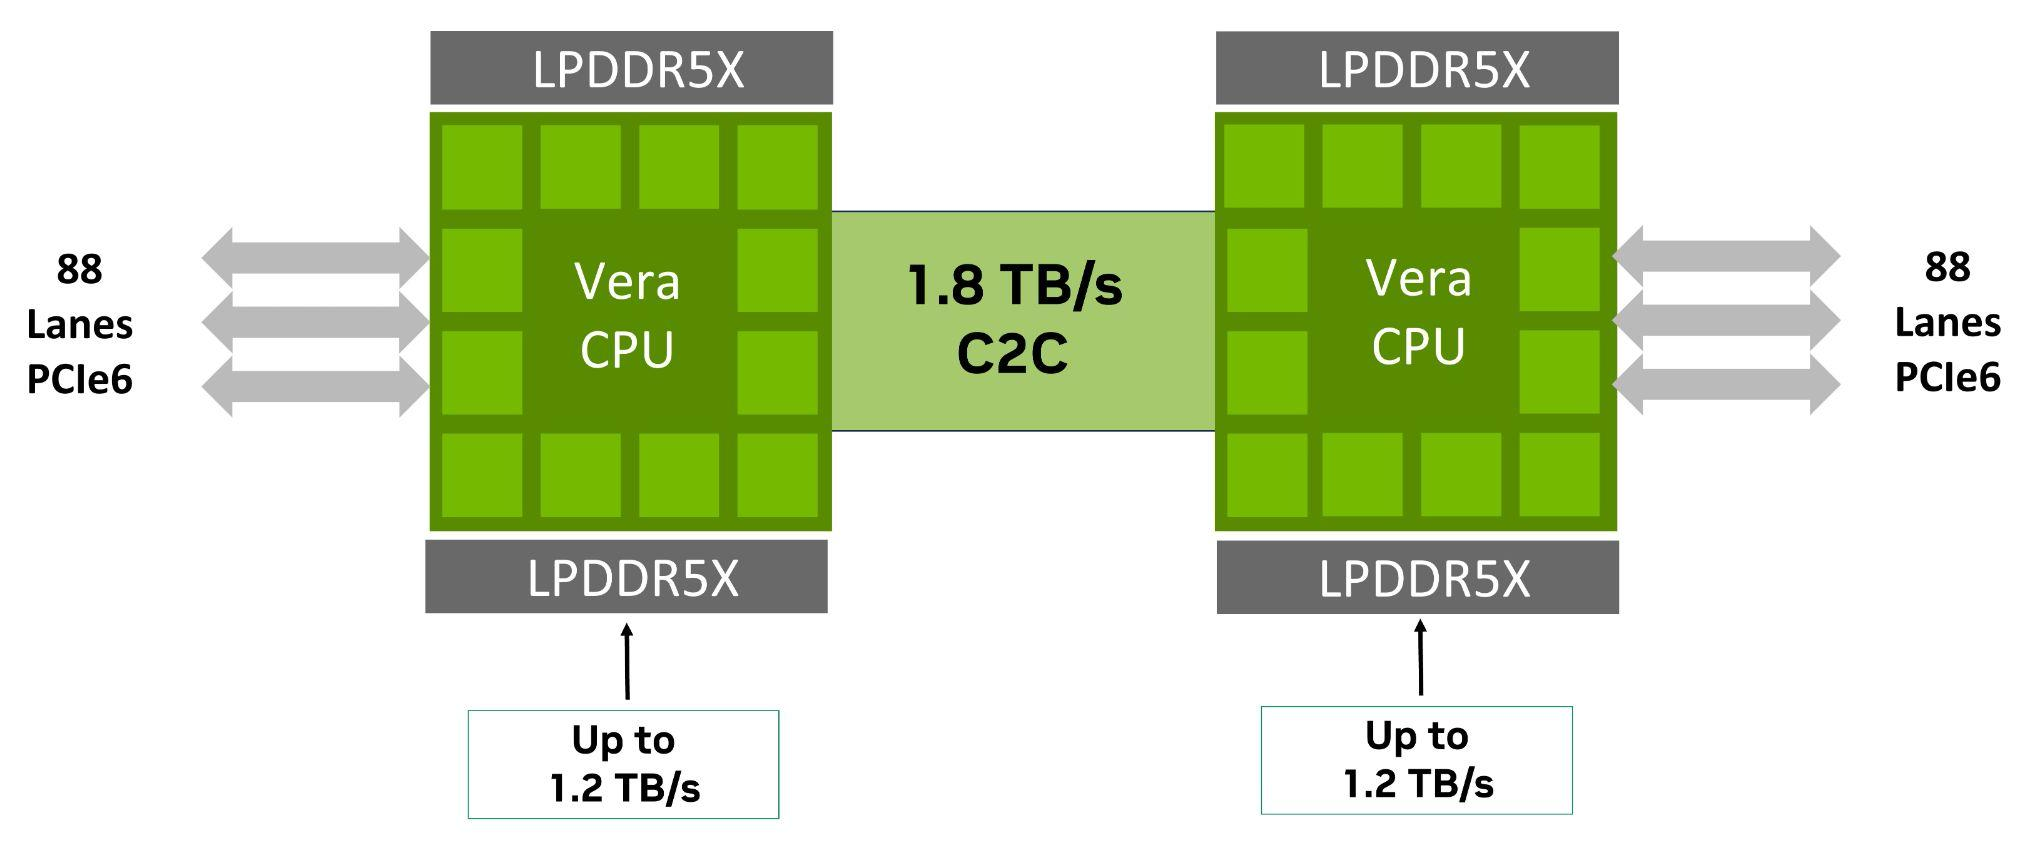
Infine, per la comunicazione tra i processori, Vera utilizza NVLink-C2C di seconda generazione, successore del collegamento introdotto con i superchip Grace. Questo collegamento connette due CPU Vera in un server dual-socket o collega Vera alle GPU Rubin in un superchip. Il collegamento offre una larghezza di banda bidirezionale aggregata fino a 1.8 TB/s, ovvero 900 GB/s in ciascuna direzione, e riflette la stessa stretta integrazione CPU-GPU che ha guidato l'ingresso di NVIDIA nel mercato delle CPU.
All'interno del server di riferimento MGX Vera C2
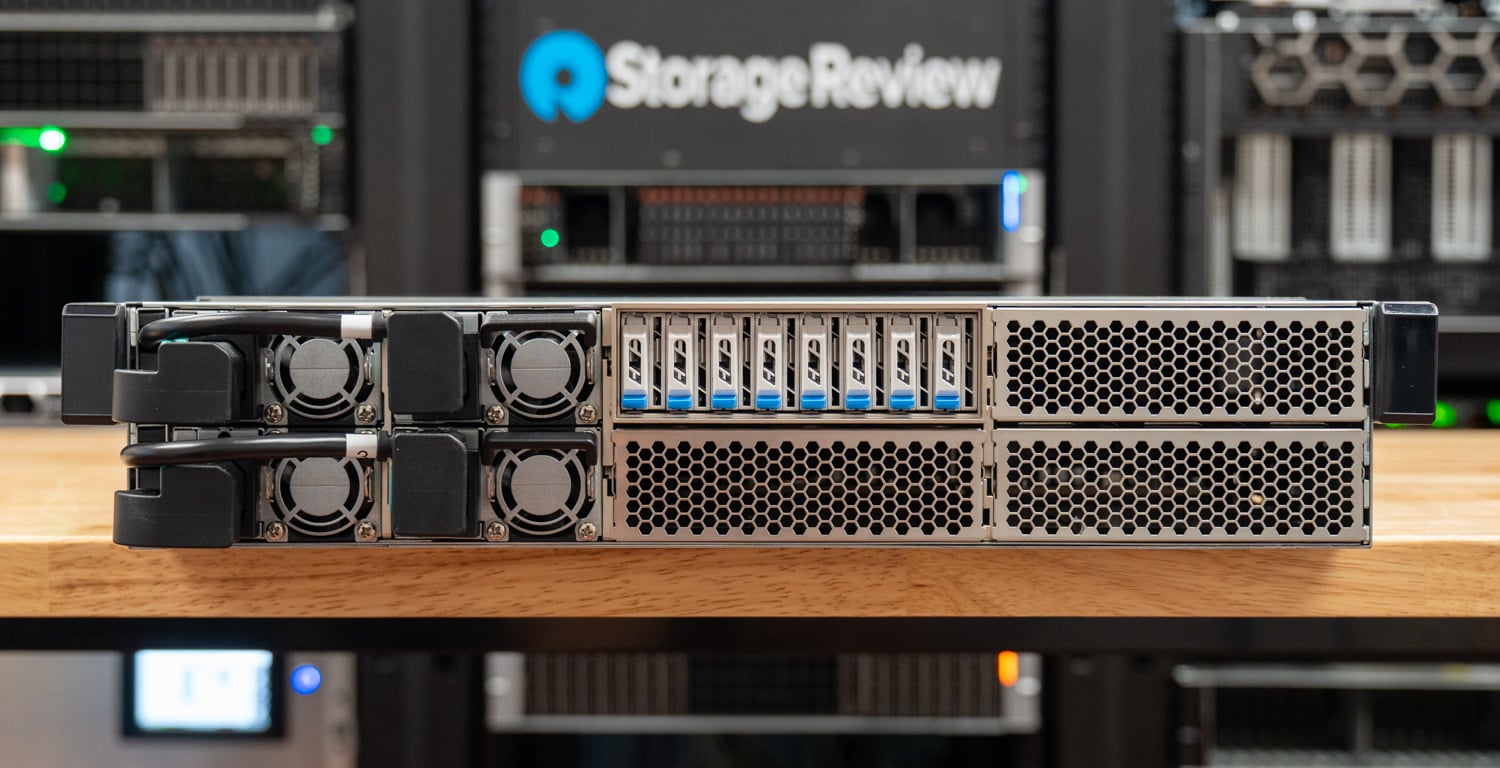
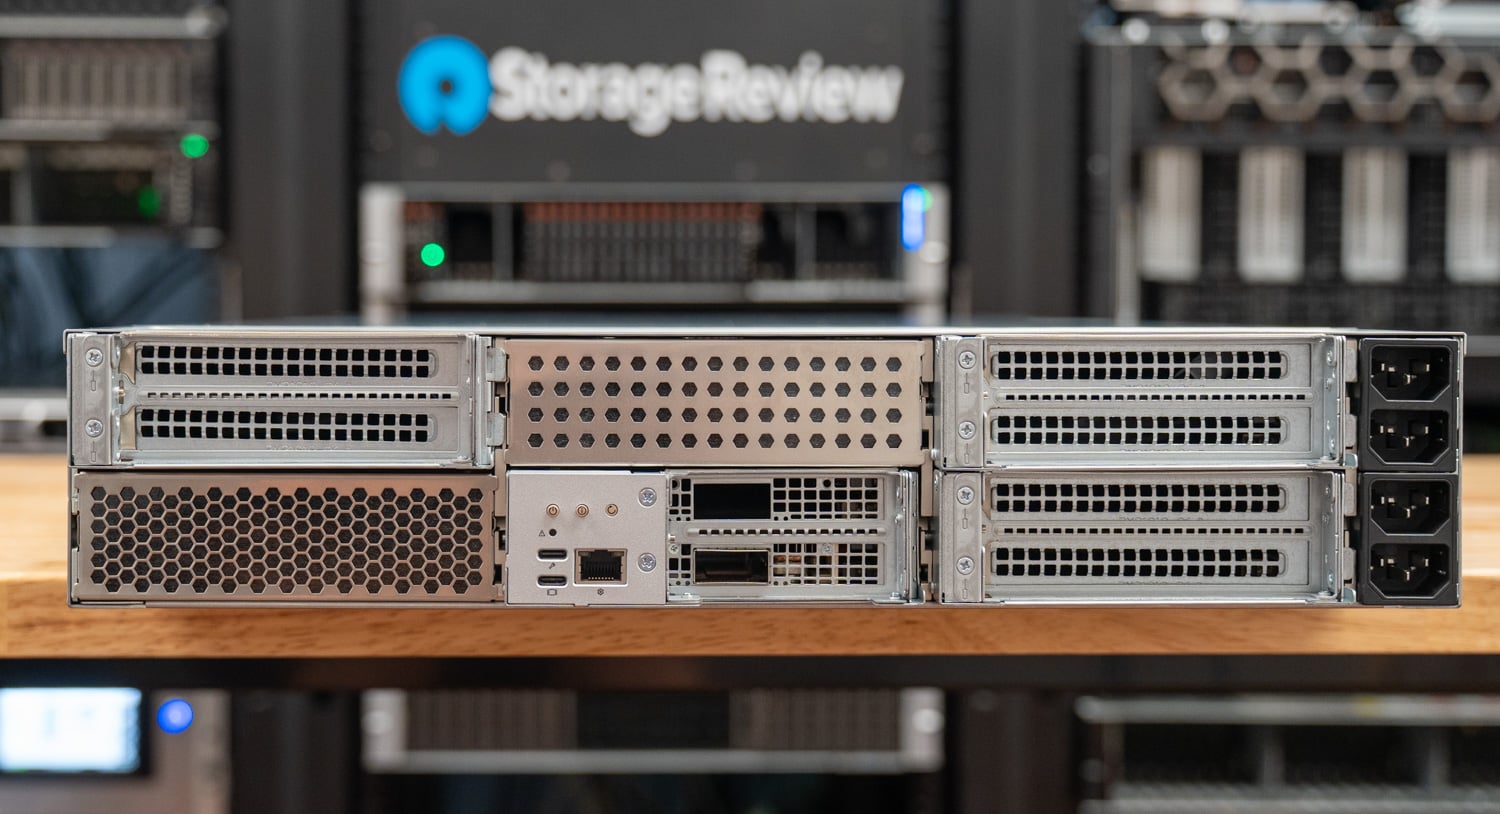
L'unità che abbiamo testato è l'NVIDIA MGX Vera C2, un server di riferimento 2U a doppio socket con raffreddamento ad aria, che i partner di NVIDIA utilizzano come base per i loro primi sistemi Vera. Otto alloggiamenti E1.S si estendono lungo la parte superiore del pannello frontale, accanto a quattro alimentatori Delta hot-swap, mentre il resto della superficie è occupato da prese d'aria a nido d'ape. Poiché gli alimentatori si installano frontalmente, la parte posteriore rimane libera per il cablaggio I/O nel rack ed è dedicata ai riser PCIe e agli I/O di gestione.
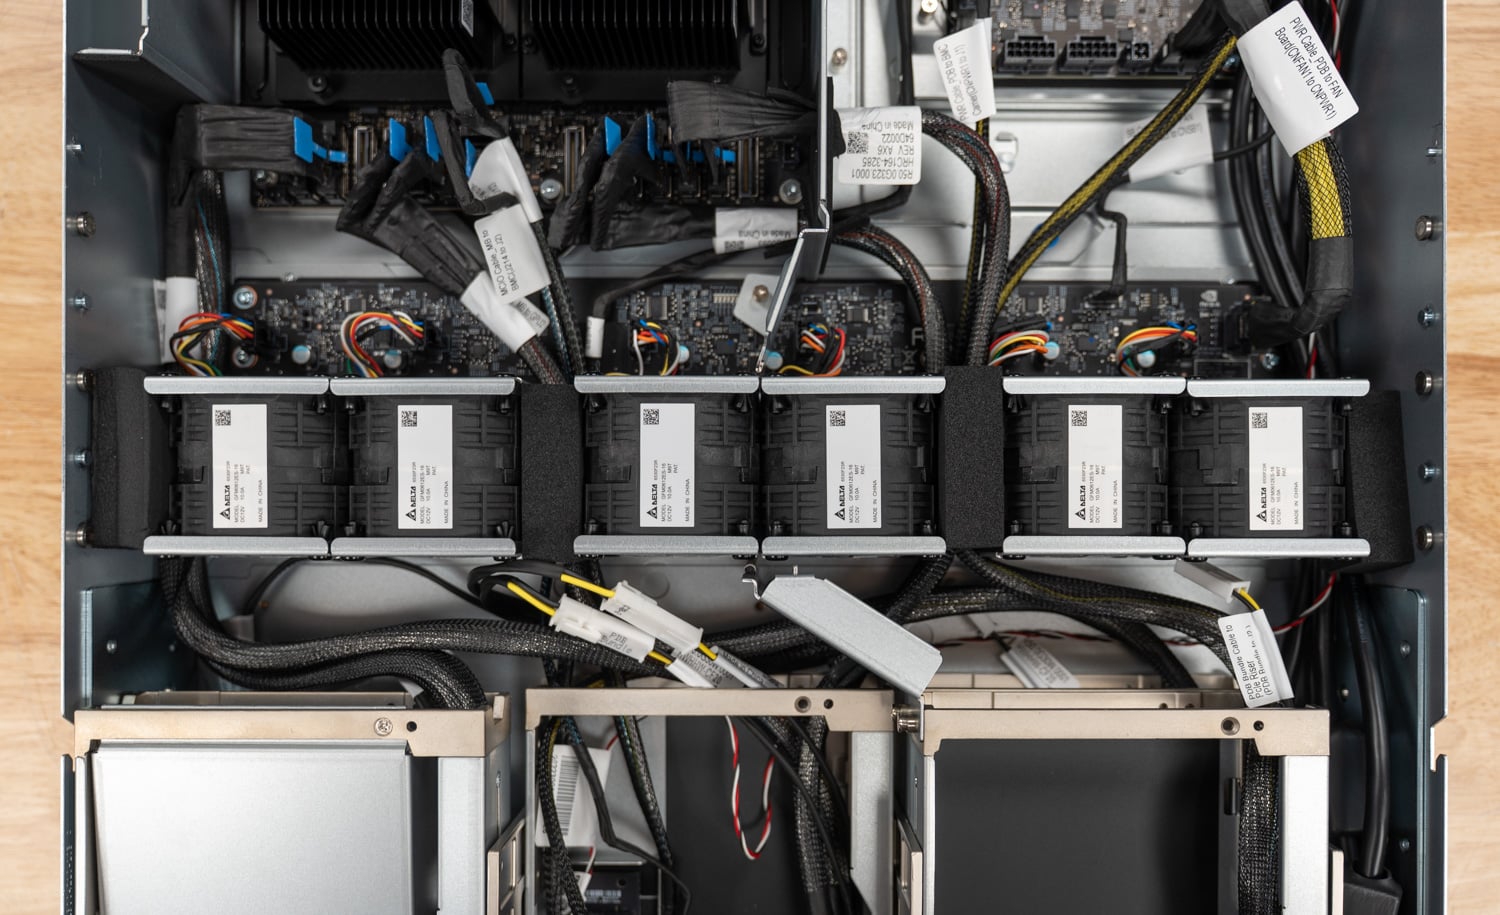
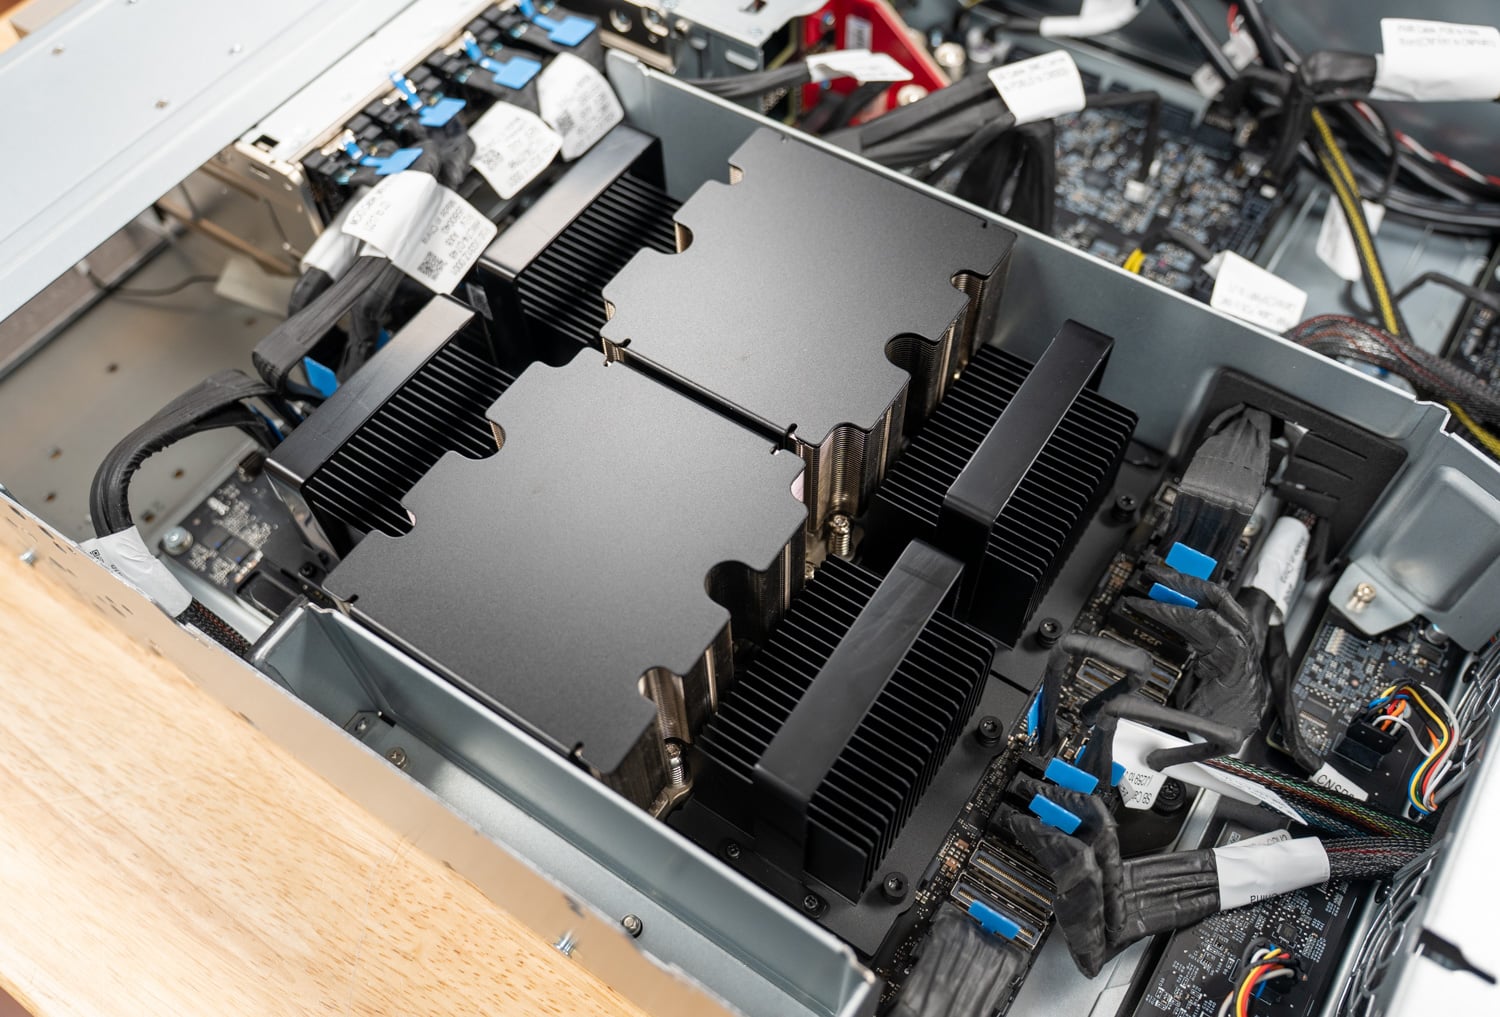
All'interno, le due CPU Vera sono posizionate una accanto all'altra sotto dissipatori passivi, con moduli SOCAMM2 lungo i lati. Una parete composta da sei ventole al centro del case, appena dietro gli alloggiamenti per le unità, convoglia l'aria su entrambi i socket, e blocchi di schiuma tra ogni coppia di ventole direzionano il flusso d'aria. Dal punto di vista del raffreddamento, la disposizione è ben studiata.
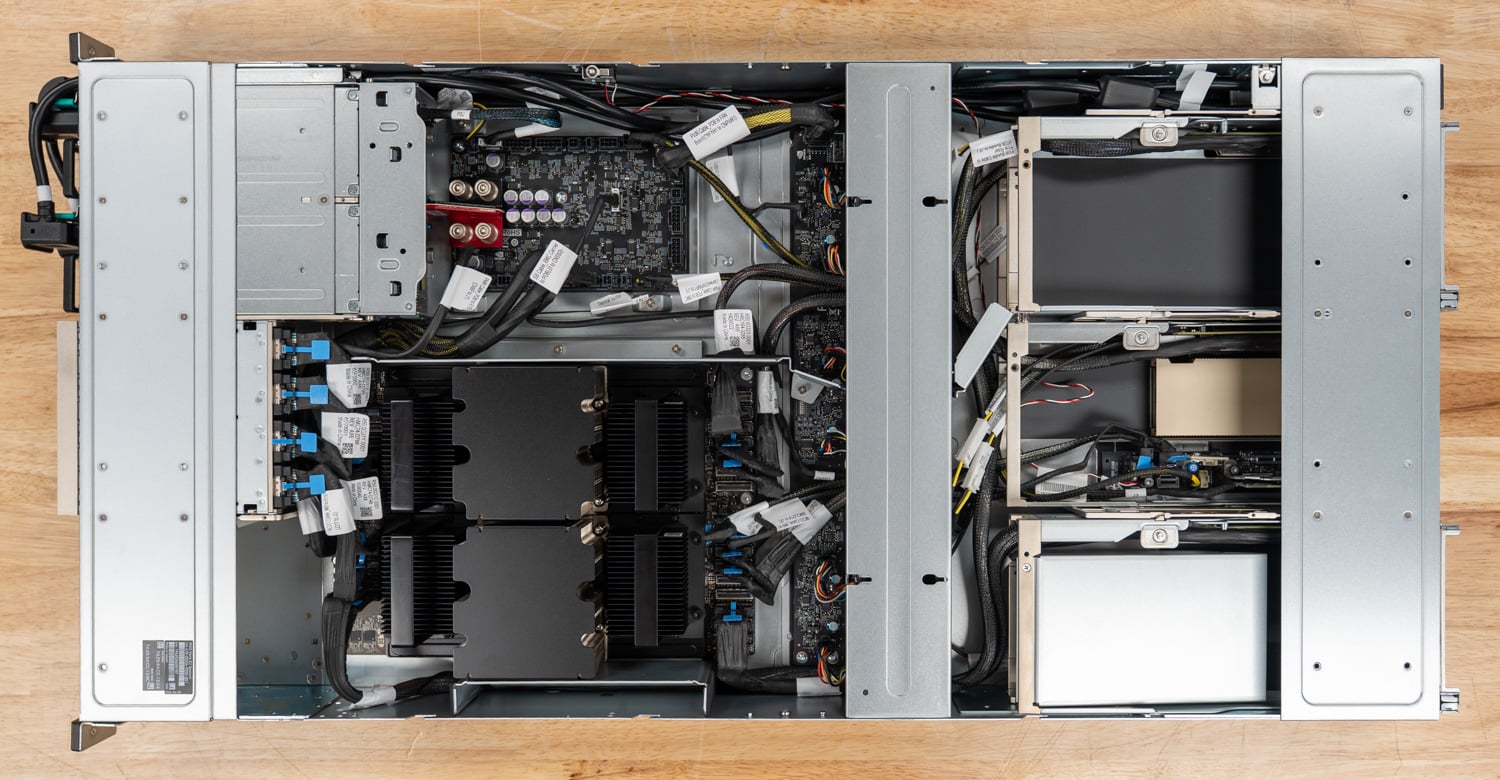
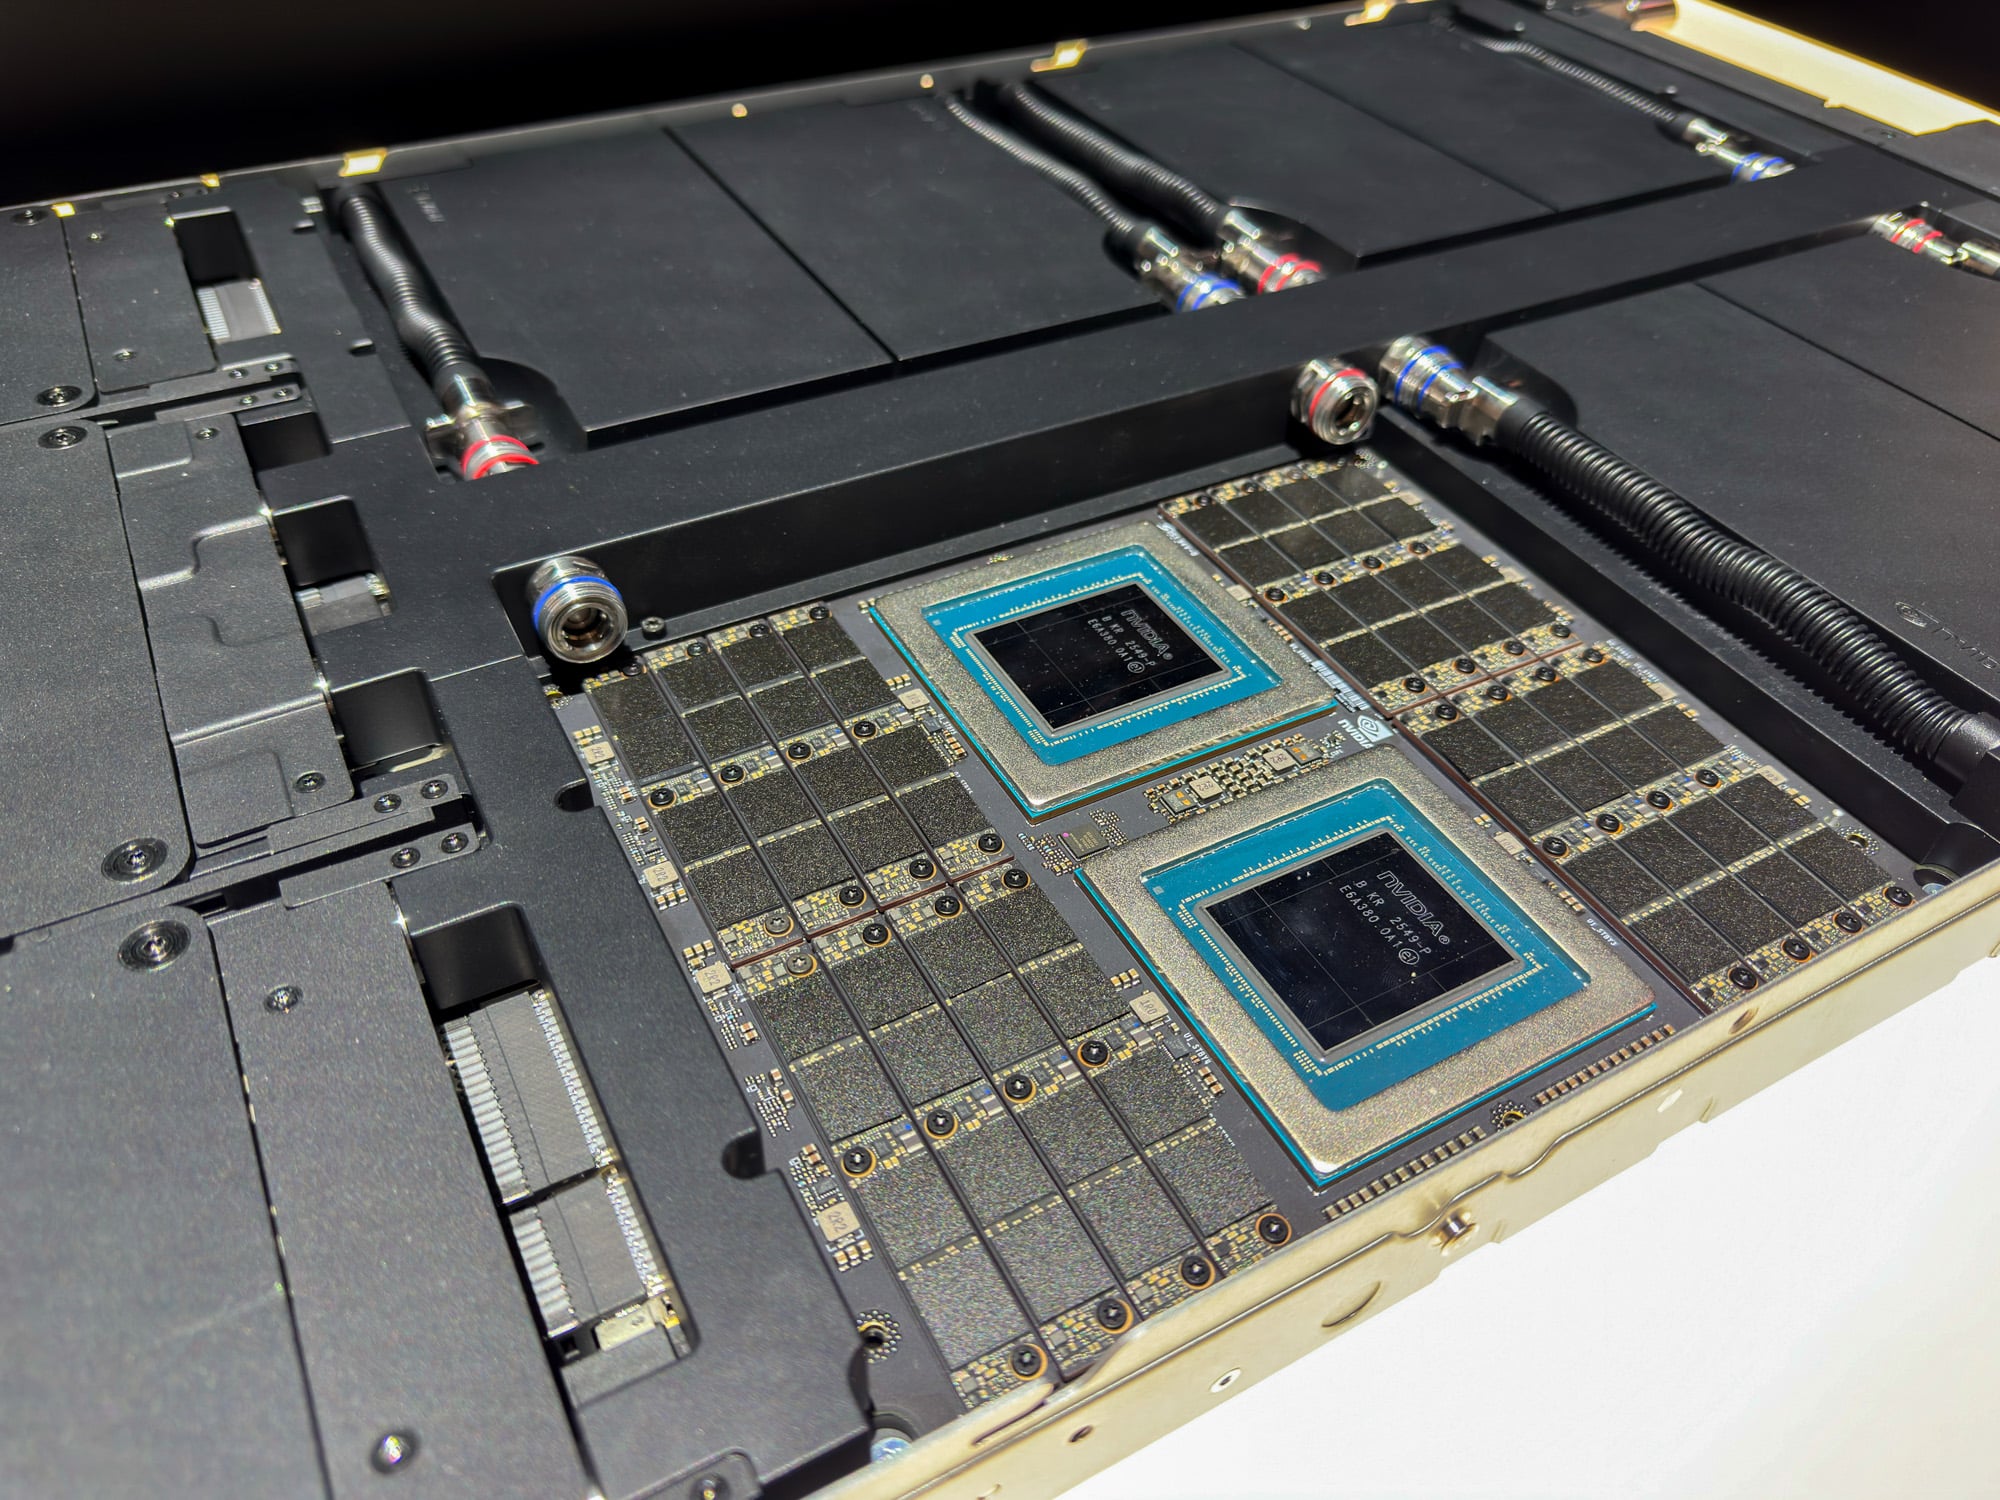
Entrambi i processori sono montati direttamente sul PCB senza zoccolo, nello stesso modo in cui NVIDIA integra Vera nei suoi superchip. I 16 slot SOCAMM2 circondano i due package, quindi la memoria rimane sostituibile sul campo anche se i processori non lo sono; la sostituzione di una CPU richiede la sostituzione dell'intera scheda. Durante l'estate, abbiamo anche esaminato la versione a raffreddamento a liquido della stessa scheda, che prevede tubi di raffreddamento a sgancio rapido che attraversano la parte superiore della scheda fino alle piastre di raffreddamento del processore, lasciando i moduli SOCAMM2 raffreddati ad aria.
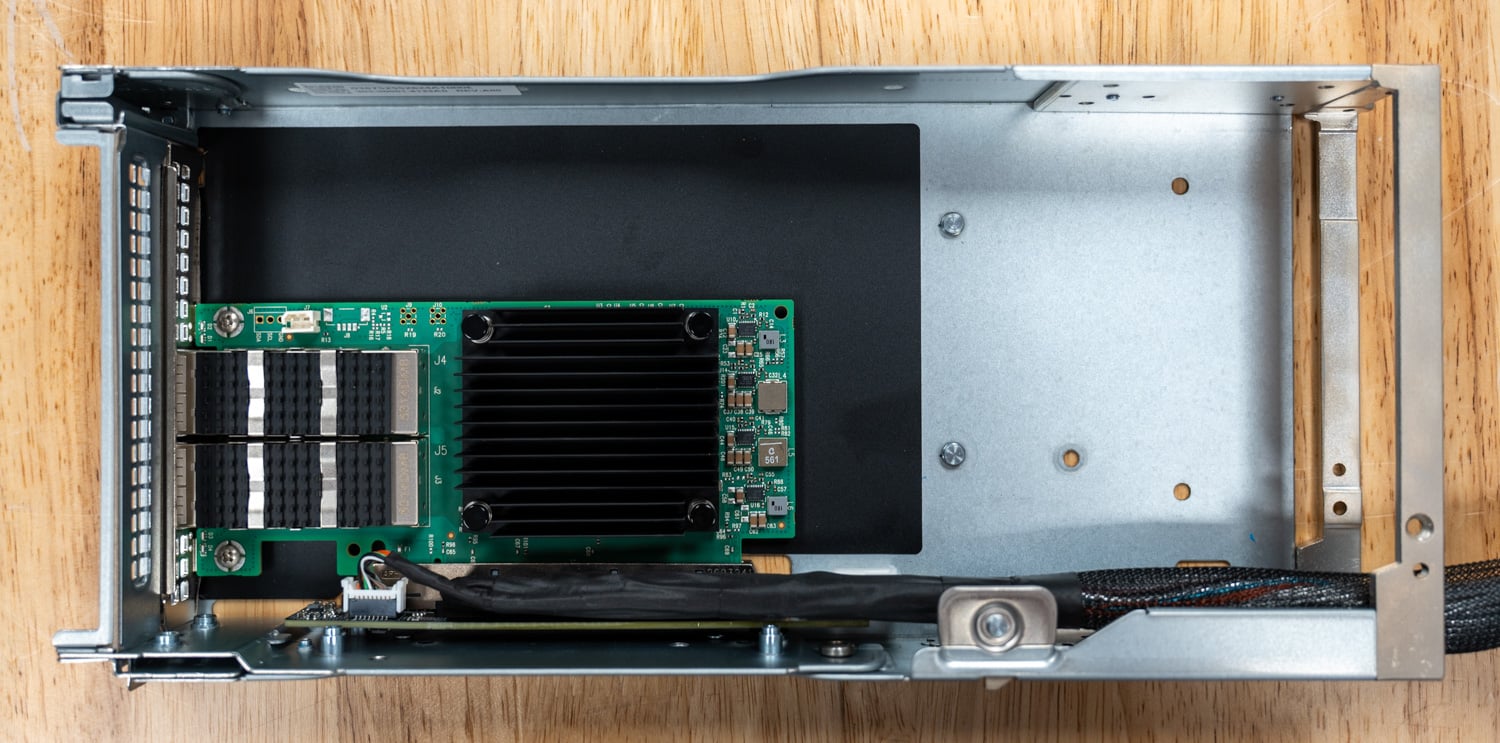
Il riser centrale ospita un adattatore NVIDIA ConnectX-8 per reti fino a 800G, mentre il pannello posteriore presenta porte USB, DisplayPort e una porta di rete dedicata per la gestione out-of-band.
La piattaforma è altamente modulare e supporta una vasta gamma di configurazioni di storage e PCIe posteriori, ma questa flessibilità ha un costo in termini di tempi di manutenzione. I suoi tre riser PCIe FHFL sembrano facili da riparare a prima vista. In un server tipico, la sostituzione di una scheda consiste nel rilasciare il riser, estrarre una linguetta di supporto o rimuovere una vite e sfilare la scheda.
Sul server Vera, per prima cosa bisogna rimuovere la copertura della ventola, togliere uno o più blocchi di schiuma e scollegare ed estrarre i cavi di alimentazione e PCIe del riser. Solo a questo punto l'intero gruppo riser può essere estratto dalla parte posteriore dello chassis. Una volta liberato, il gruppo deve essere smontato per raggiungere la scheda e poi rimontato dopo la sostituzione. Un'operazione che su un server convenzionale richiede pochi secondi, qui ne richiede dai 5 ai 10 per ogni gruppo.
In pratica, la manutenzione all'interno del rack è impossibile a meno che non siate disposti a spostarvi avanti e indietro, quindi la maggior parte delle sostituzioni di componenti richiede di spostare il server su un banco di lavoro per poterlo riparare.
Prestazioni e benchmark
I benchmark esaminano come l'architettura di Vera si traduca in prestazioni, dai singoli thread ai carichi di lavoro che utilizzano l'intero sistema. I nostri test coprono la larghezza di banda e la latenza della memoria, il calcolo scientifico, il software generico e i database, mostrando come il processore gestisce le diverse richieste sui suoi core e sul sistema di memoria.
Sistemi di test
| Sistema | NVIDIA MGX Vera C2 | Dell PowerEdge R7725 | Dell PowerEdge R7725 | Dell PowerEdge R770AP | Dell PowerEdge R770 | Dell PowerEdge R760 |
|---|---|---|---|---|---|---|
| Processori | ||||||
| CPU | NVIDIA Vera | AMD EPYC 9965 | AMD EPYC 9175F | Intel Xeon 6978P | Intel Xeon 6787P | Intel Xeon Platino 8592+ |
| Prese | 2 | |||||
| Core/Thread per CPU | 88 / 176 | 192 / 384 | 16 / 32 | 120 / 240 | 86 / 172 | 64 / 128 |
| Orologio base | 3.4 GHz | 2.25 GHz | 4.2 GHz | 2.1 GHz | 2.0 GHz | 1.9 GHz |
| Orologio massimo | 3.4 GHz | 3.7 GHz | 5.0 GHz | 3.9 GHz | 3.8 GHz | 3.9 GHz |
| Memorie | ||||||
| Configurazione | 16x 96GB Micron SOCAMM2 | 24x 128GB | 24x 64GB | 32x 64GB | 16x 64GB | |
| Tipo / Velocità | LPDDR5X-9600 | DDR5-6400 | DDR5-5200 | DDR5-4800 | ||
| Capacità totale | 1.5TB | 3TB | 1.5TB | 2TB | 1TB | |
| Archiviazione | ||||||
| SSD | Solidigm D7-PS1010 7.68 TB | Solidigm D7-PS1030 12.8 TB | Micron 9550 PRO 7.68 TB | Solidigm D7-PS1010 7.68 TB | Samsung PM1745 6.4 TB | Solidigm D7-P5520 3.84 TB |
| Collegamento SSD | PCIe Gen5x4 | PCIe Gen5x2 | PCIe Gen5x4 | PCIe Gen4x4 | ||
| Firmware | ||||||
| BIOS di sistema | NV_SBIOS 06.07.01.06 | 1.5.3 | 1.2.1 | 1.8.5 | 2.8.2 | |
| Profilo BIOS | Predefinito | Cookie di prestazione | ||||
| Pila di software | ||||||
| OS | Ubuntu LTS 26.04.1 | Ubuntu LTS 24.04.5 | ||||
| nocciolo | 7.0.0-2022-nvidia-bos | 6.8.0-142 / 6.8.0-146 | 6.8.0-147 | 6.8.0-138 | 6.8.0-142 / 6.8.0-146 | 6.8.0-142 / 6.8.0-146 |
| GCC | 15.2.0 | 13.3.0 | ||||
| glibc | 2.43 | 2.39 | ||||
| MPI aperto | 5.0.10 | 4.1.6 | ||||
| OpenJDK | 11.0.32 | |||||
Abbiamo confrontato Vera con cinque configurazioni Dell PowerEdge con una configurazione di memoria ideale e le abbiamo testate con la stessa suite di test, che comprendeva i processori EPYC di AMD con il maggior numero di core e la frequenza ottimizzata, oltre ai processori Xeon di generazione attuale e precedente.
Poiché il supporto per Olympus è stato introdotto con GCC 15, Vera utilizzava uno stack software più recente rispetto ai sistemi x86, come indicato sopra. Le versioni dei benchmark, gli input e i flag di compilazione erano altrimenti identici su tutti i sistemi.
Banda di memoria
La gestione della memoria è l'aspetto in cui Vera si discosta maggiormente dall'architettura x86, quindi iniziamo i nostri test da lì. Abbiamo testato STREAM Triad, eseguito con un thread OpenMP per core fisico su array da 16 GiB. Il test principale utilizza tutti i core del sistema, con i dati di ciascun thread posizionati sullo stesso socket. Abbiamo poi ripetuto il test con i core del socket 0 che leggono prima la propria memoria locale e poi la memoria del socket remoto, e con ogni core che legge le pagine in modo interleaved su entrambi i socket. Il grafico seguente mostra i risultati di Triad a livello di sistema per ciascun server con SMT disattivato.
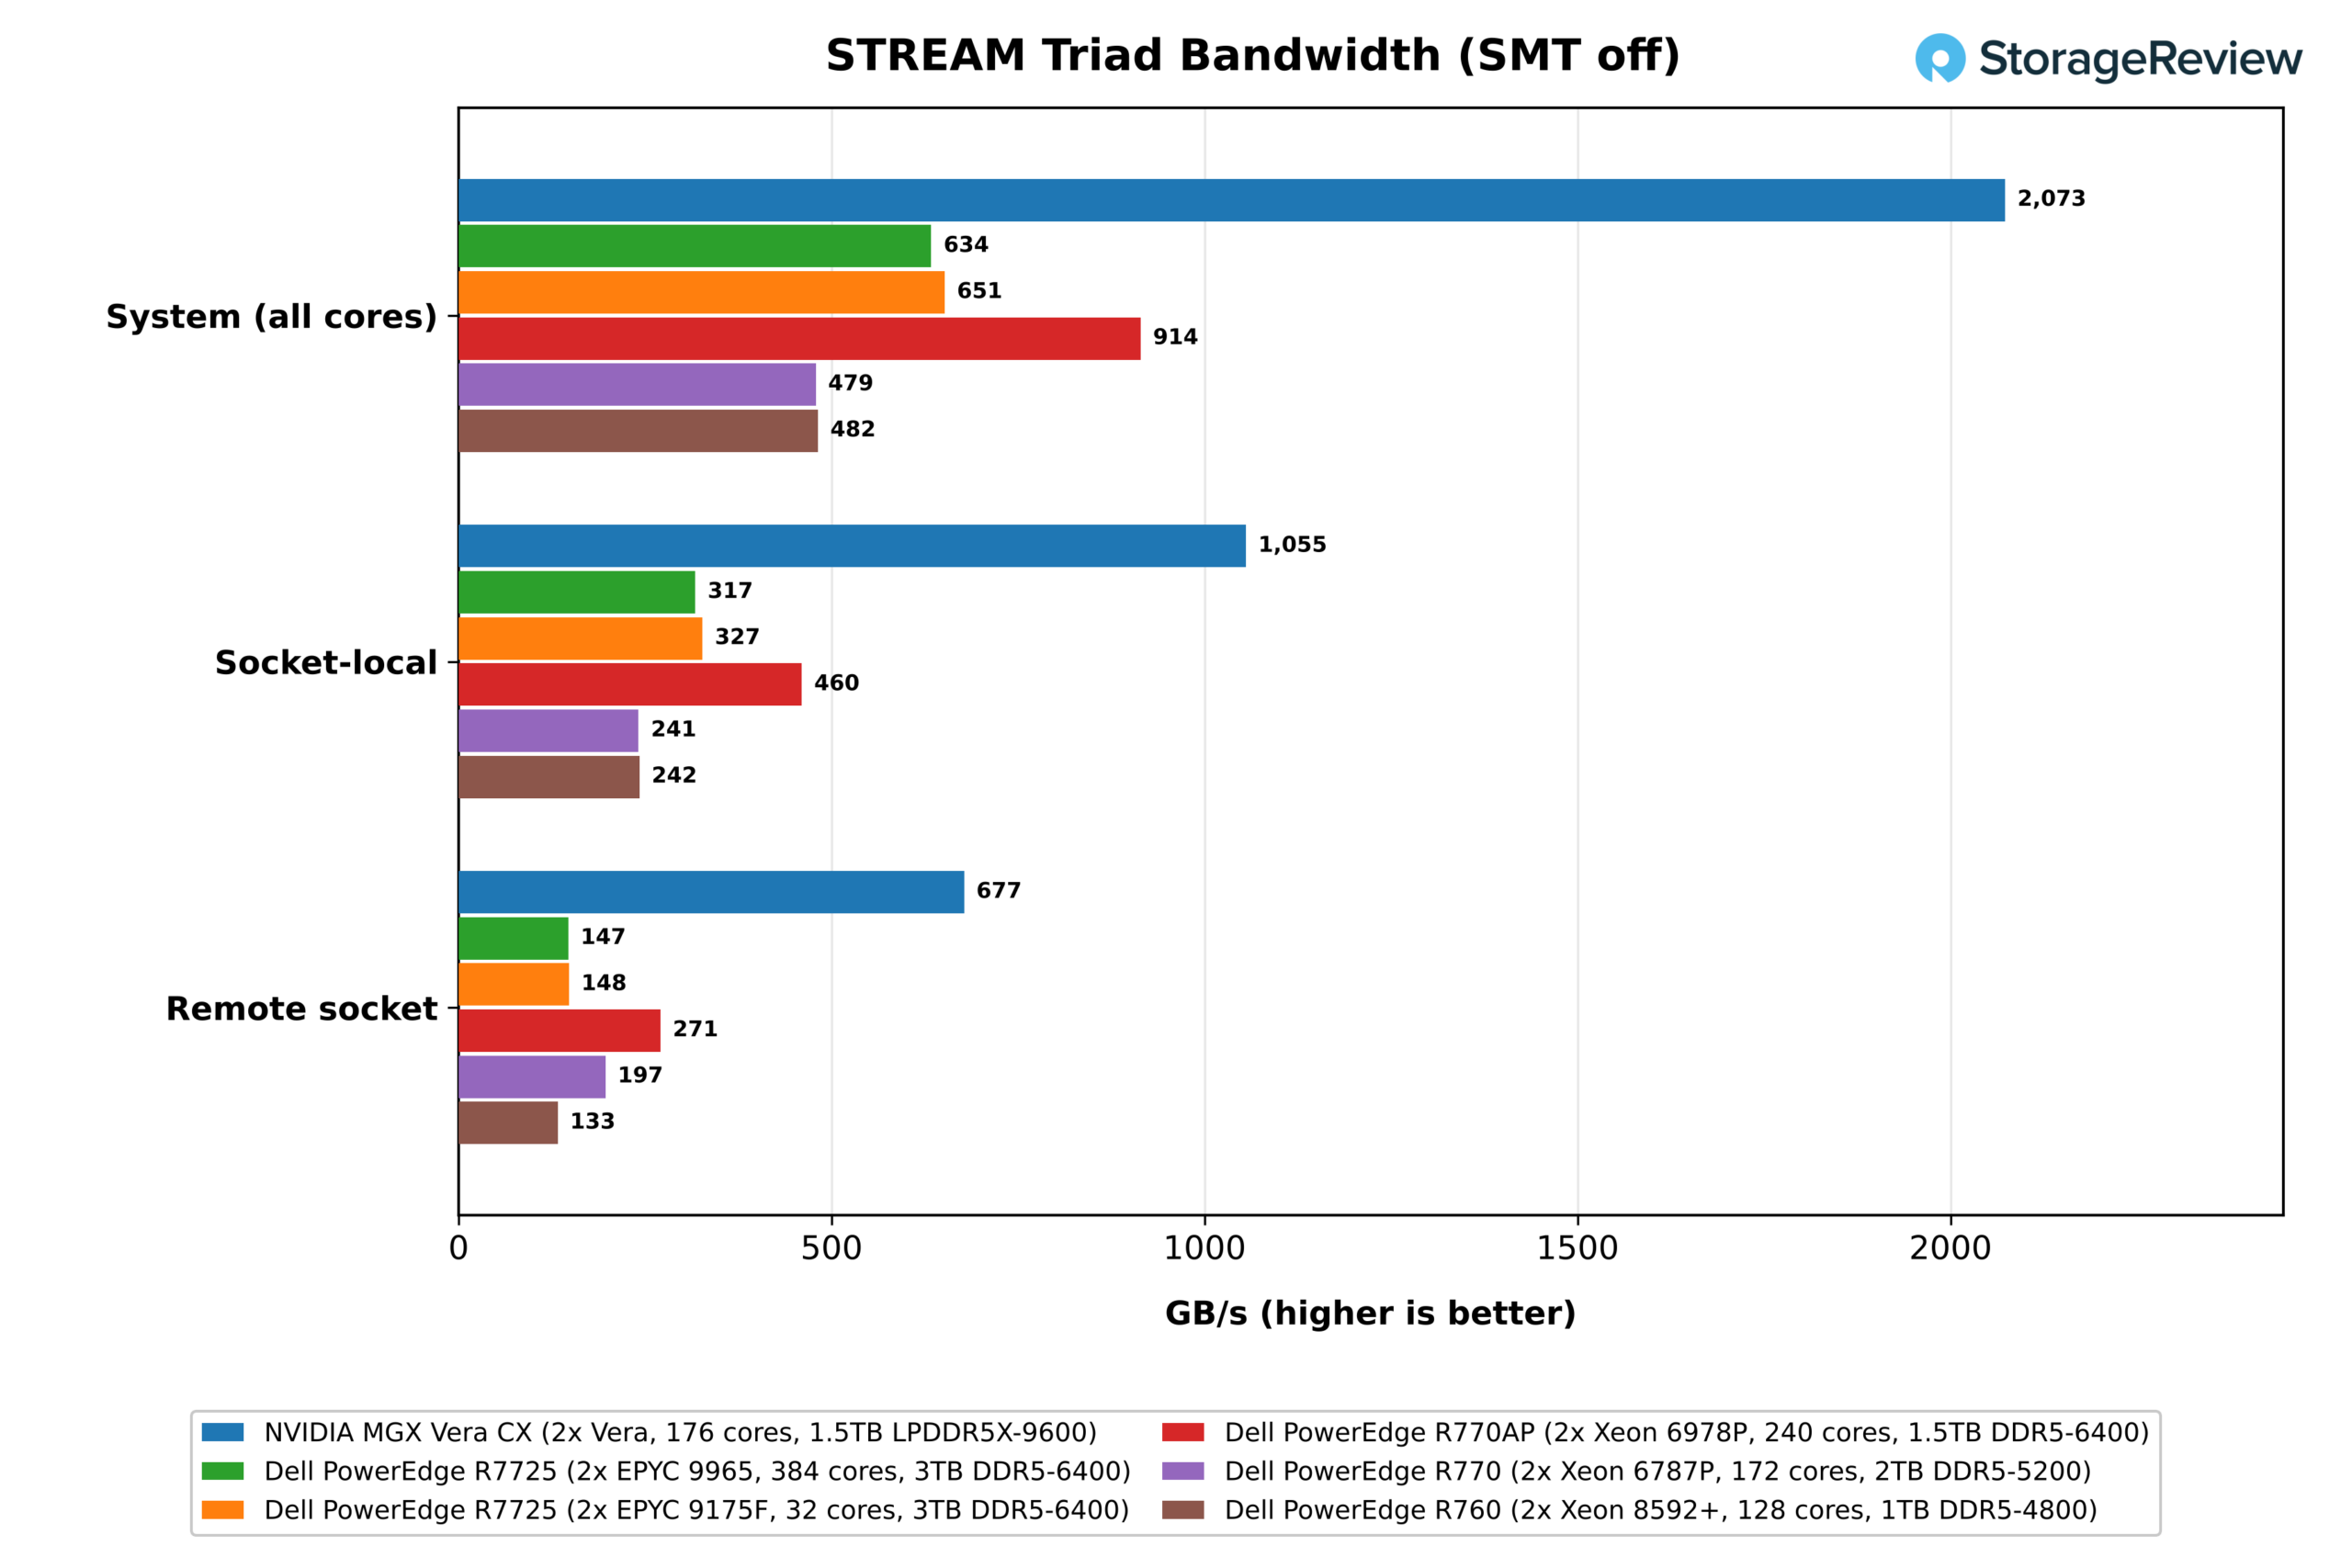
Vera ha mantenuto una velocità di 2,073 GB/s, pari all'86% della sua velocità nominale di 2.4 TB/s con due socket. Il sistema x86 più vicino è stato lo Xeon 6978P, i cui 24 canali di DDR5-6400 hanno erogato 914 GB/s, il 74% del suo picco teorico di 1,229 GB/s, con un vantaggio di 2.3 volte su Vera. I due sistemi EPYC utilizzano gli stessi 24 canali di DDR5-6400, ma si sono attestati ben al di sotto di tale valore: 651 GB/s per il 9175F a 32 core e 634 GB/s per il 9965 a 384 core, appena il 52% del picco e un vantaggio di 3.3 volte su Vera. Infine, gli Xeon 6787P e 8592+ restano indietro rispetto agli altri, operando con memorie DDR5-5200 e DDR5-4800 più lente, raggiungendo rispettivamente 479 GB/s e 482 GB/s.
Parte del deficit di EPYC deriva dal modo in cui STREAM calcola il traffico. La suite compila STREAM con il GCC standard, che non genera operazioni di scrittura in streaming, quindi un'operazione di scrittura che non trova un valore nella cache legge prima la sua riga di destinazione dalla memoria. STREAM non conteggia questa lettura, il che significa che Triad sottostima il traffico spostato di un quarto, ovunque avvenga. I core Zen di AMD lo conteggiano per ogni operazione di scrittura. I core Arm, come i precedenti Grace di NVIDIA, rilevano le scritture complete e saltano la lettura, e i recenti Xeon di Intel possono saltare la maggior parte di essa quando la memoria è fortemente carica.
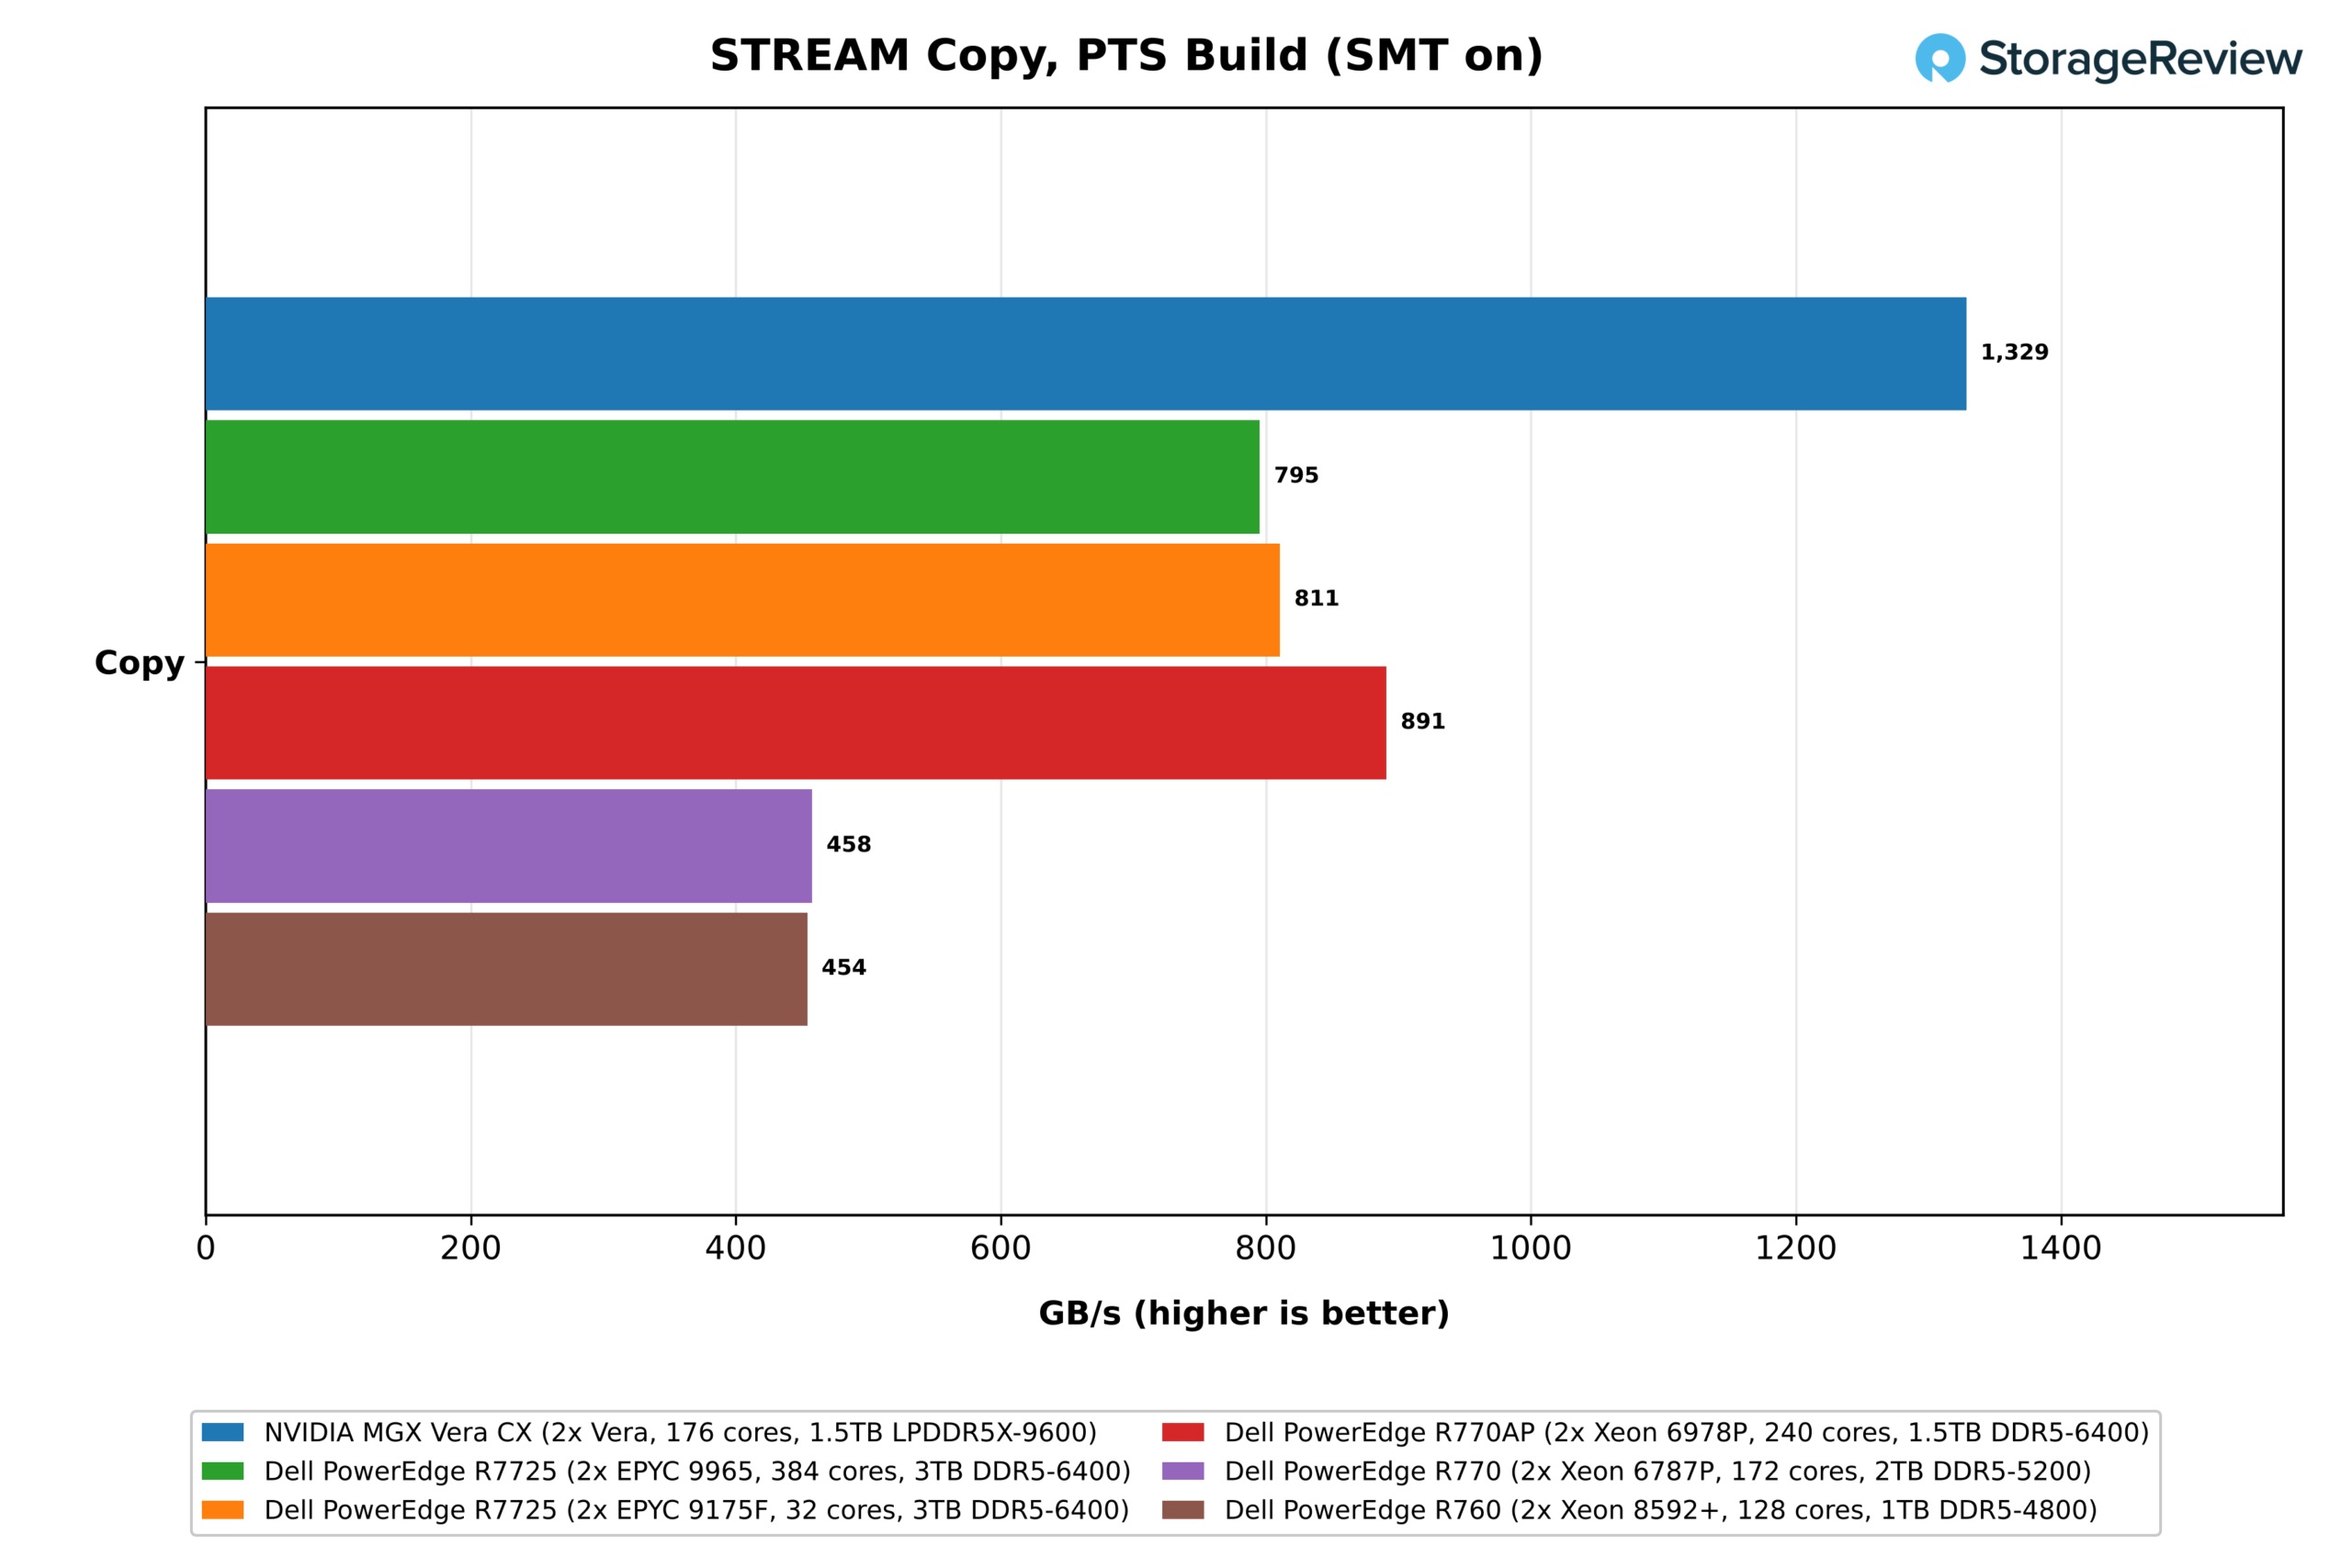
La versione separata di Phoronix Test Suite di STREAM indica la stessa direzione. Con SMT disattivato, il risultato di Copy ha raggiunto 832 GB/s sul 9965 e 873 GB/s sul 9175F, circa 1.5 volte i 551 GB/s e 570 GB/s della versione della suite, e in linea con il guadagno che Copy dovrebbe ottenere una volta eliminata la lettura aggiuntiva; sugli Xeon, le due versioni si sono discostate l'una dall'altra con una differenza inferiore al 9%.
Tenendo conto delle letture non conteggiate, il 9965 ha spostato circa 845 GB/s, circa il 69% del picco, e il vantaggio di Vera in termini di byte spostati si riduce a circa 2.5 volte. Il 6978P necessita di una correzione molto minore, il che rende il suo valore di 2.3 volte il confronto più prudente del set.
Suddividendo il test per socket, si può osservare come l'infrastruttura gestisce i dati non locali ai core. I core del Socket 0 che leggono la memoria locale hanno raggiunto 1,055 GB/s, l'88% del valore nominale di 1.2 TB/s per socket e più di qualsiasi server x86 completo del set. Leggendo la memoria dell'altro socket tramite NVLink-C2C, gli stessi core hanno mantenuto 677 GB/s, il 64% del valore locale, contro il 59% dello Xeon 6978P e il 45% dell'EPYC 9175F (148 GB/s remoti contro 327 GB/s locali). Anche un carico di lavoro posizionato sul socket sbagliato ottiene quindi una larghezza di banda maggiore di quella che qualsiasi socket x86 legge dalla memoria locale, che raggiunge un massimo di 460 GB/s sul 6978P.
Come test finale per Vera, abbiamo eseguito una prova con pagine interlacciate STREAM Triad su entrambi i socket, il caso che si presenta a un'applicazione non compatibile con NUMA, ottenendo una velocità di 1,372 GB/s, 1.5 volte superiore al risultato complessivo del sistema 6978P.
Latenza
La larghezza di banda è solo metà del problema della memoria. La latenza determina per quanto tempo un core attende ogni volta che non trova un valore nella cache, ed è fondamentale per il codice che accede ai puntatori nella memoria. La misuriamo con tinymembench, che cronometra le letture casuali su un buffer da 1 GiB da un singolo thread sul socket 0. L'EPYC 9175F è l'unico sistema x86 del nostro set con risultati di questo test, quindi è questo il termine di paragone.
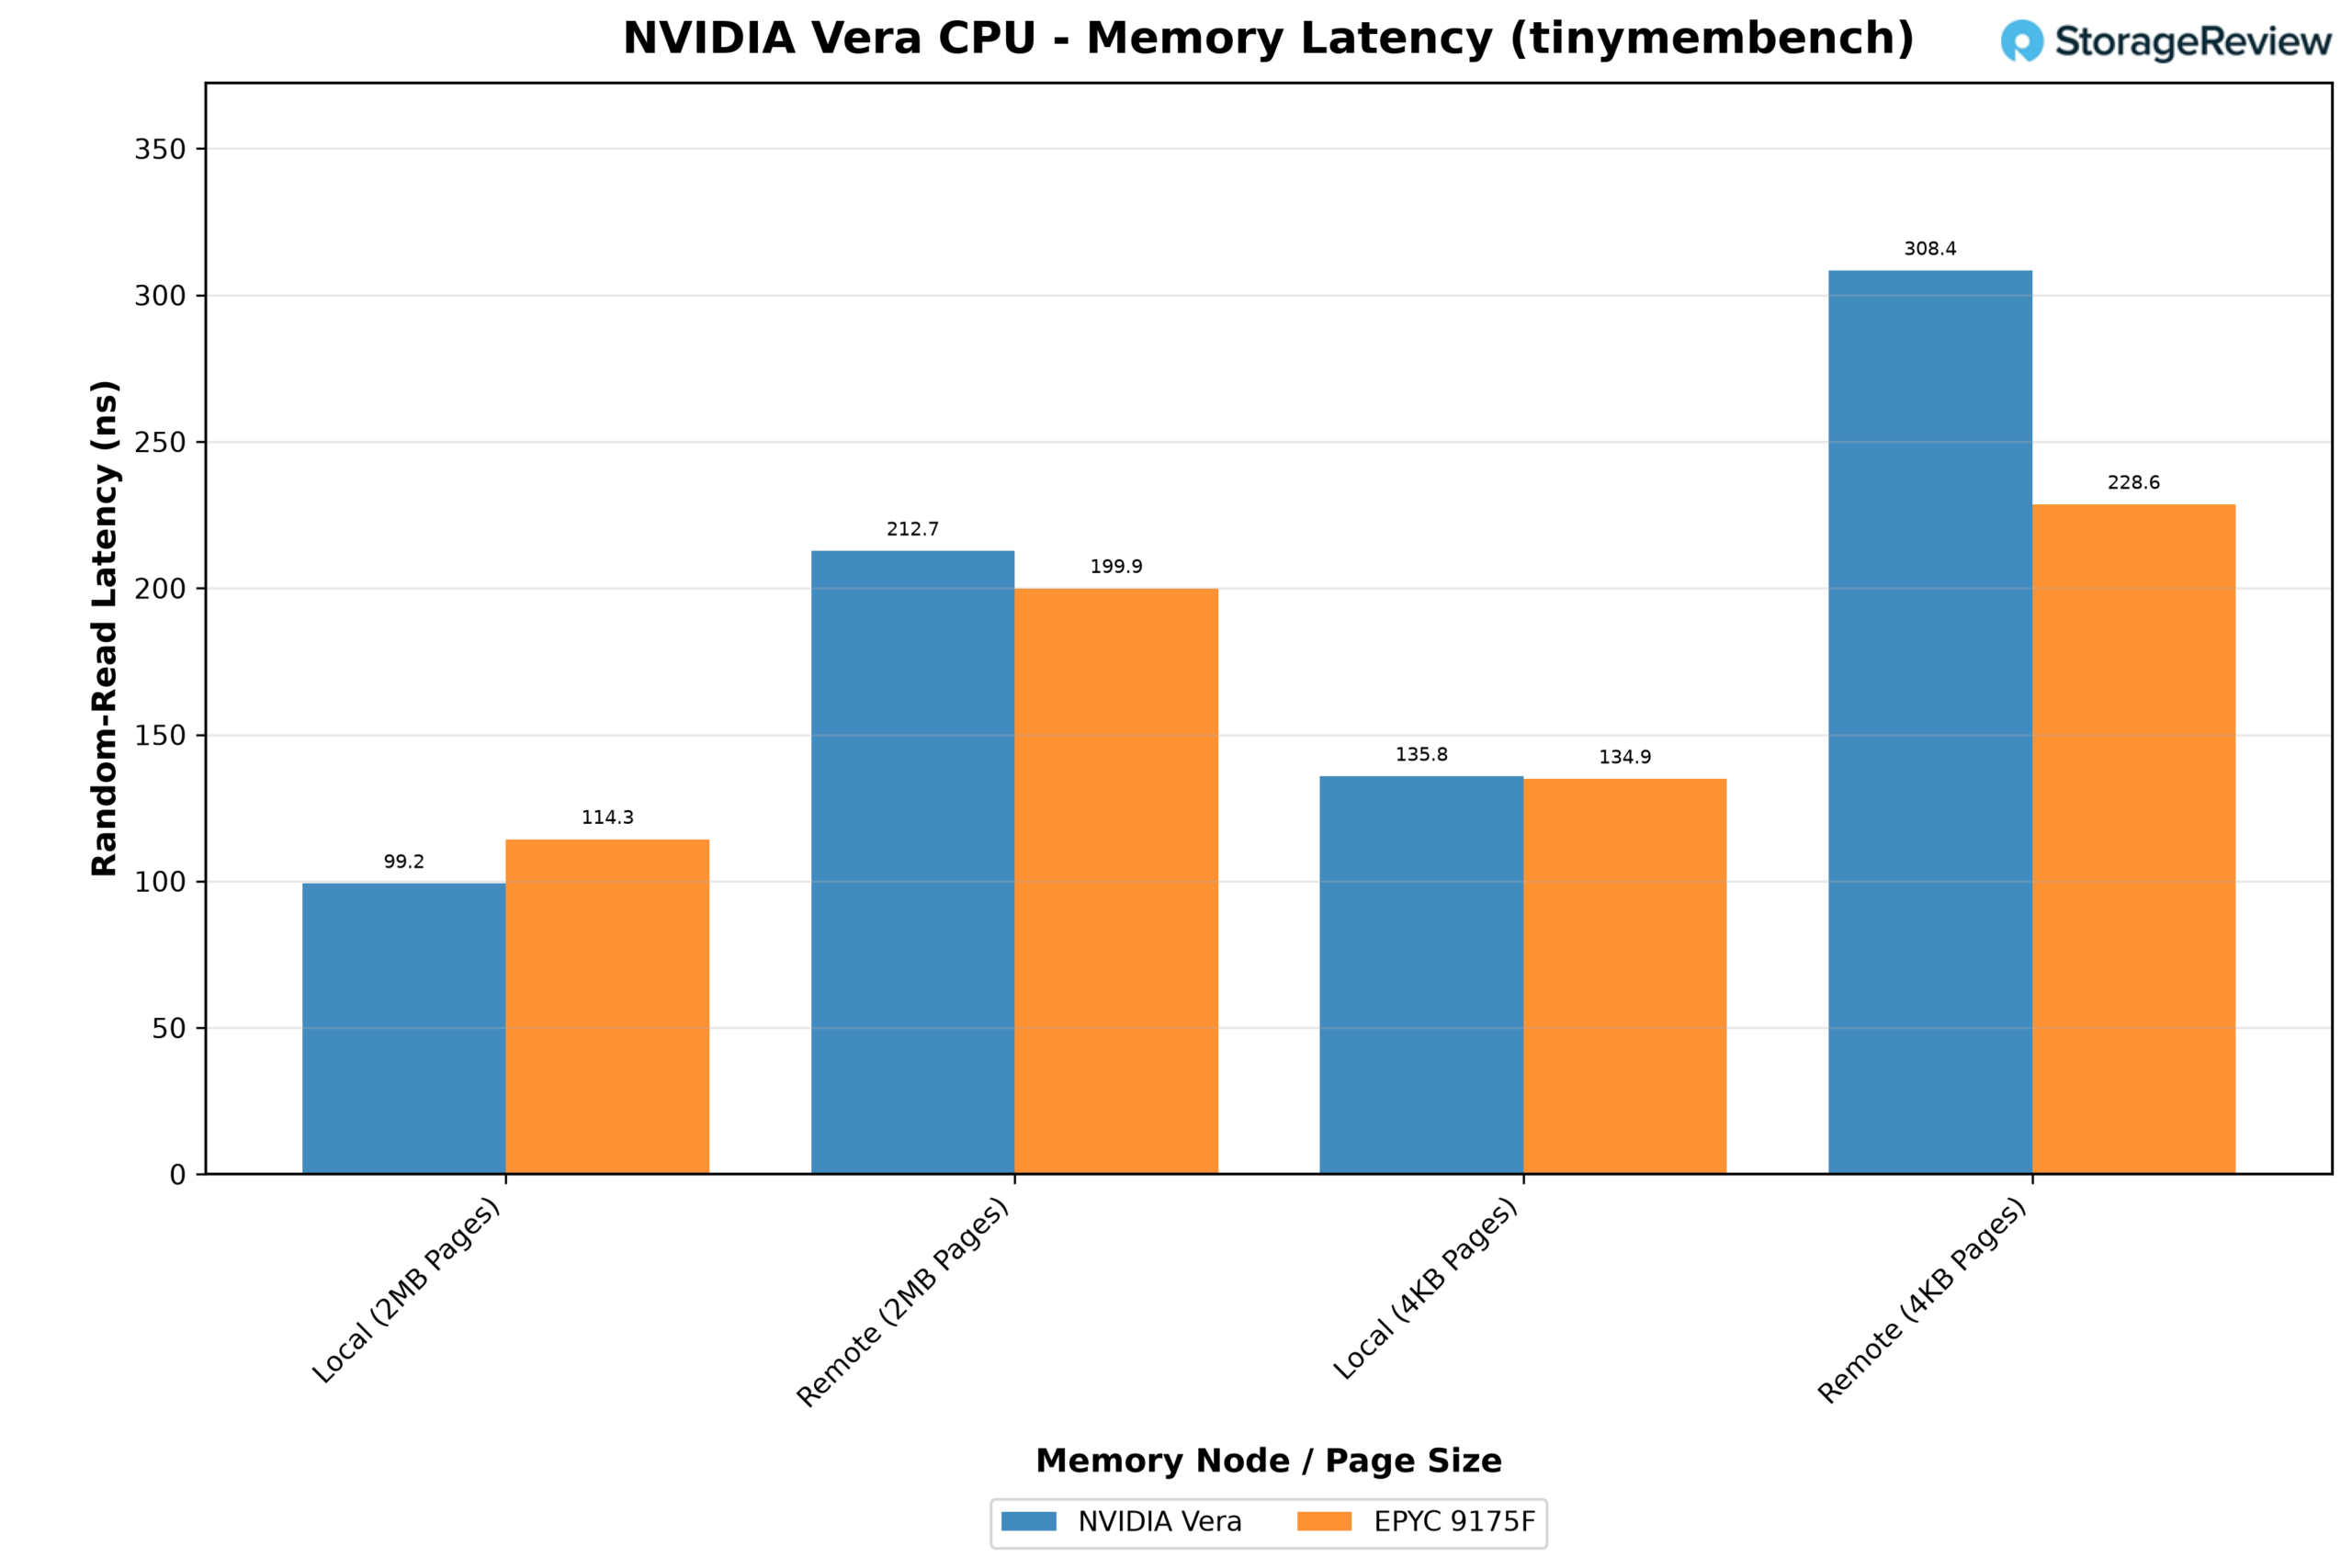
Nella lettura della memoria locale, Vera è più veloce dell'EPYC. Con pagine di memoria di grandi dimensioni da 2 MB, una lettura locale ha richiesto 99.2 ns su Vera contro i 114.3 ns del 9175F, il 13% in meno; con pagine standard da 4 KB, i tempi erano simili, circa 135 ns. È nel trasferimento dati all'altro socket che NVLink-C2C mostra il suo svantaggio. Una lettura remota ha richiesto 212.7 ns su Vera, circa 2.1 volte il tempo locale, mentre i 199.9 ns dell'EPYC erano solo 1.75 volte il tempo locale.
Vera è anche più sensibile alle dimensioni delle pagine. Con pagine da 4 KB, dove le mancate traduzioni degli indirizzi si aggiungono a ogni lettura, la sua latenza locale è aumentata del 37% e la sua latenza remota ha raggiunto i 308.4 ns, contro un aumento del 18% e 228.6 ns su EPYC. Su Vera, useremmo pagine enormi.
HPC
Larghezza di banda e latenza descrivono il sistema di memoria in isolamento. Le applicazioni scientifiche mostrano cosa accade quando il sistema di memoria e i core devono lavorare insieme, e i nostri due test HPC si basano su parti molto diverse della progettazione della CPU.
GROMACS, un codice di dinamica molecolare, impiega la maggior parte del tempo in operazioni aritmetiche vettoriali, con cicli critici scritti manualmente per ogni larghezza SIMD. Questo lo rende il test più diretto del compromesso descritto nella sezione Olympus: sei pipeline SVE2 a 128 bit contro le unità AVX-512 a 512 bit delle architetture x86. OpenFOAM, un risolutore di fluidodinamica computazionale, elabora grandi matrici sparse e impiega gran parte del tempo in attesa di memoria, dimostrando così se la larghezza di banda misurata in precedenza si traduce in un'applicazione reale.
GROMACS
Abbiamo testato GROMACS 2025.3 con benchPEP, un caso di 12 milioni di atomi eseguito su ogni core fisico del server. La build ha utilizzato ARM_SVE su Vera e AVX-512 su ogni sistema x86, e gli input bloccati della suite e la disabilitazione della regolazione PME hanno fatto sì che ogni piattaforma eseguisse lo stesso lavoro.
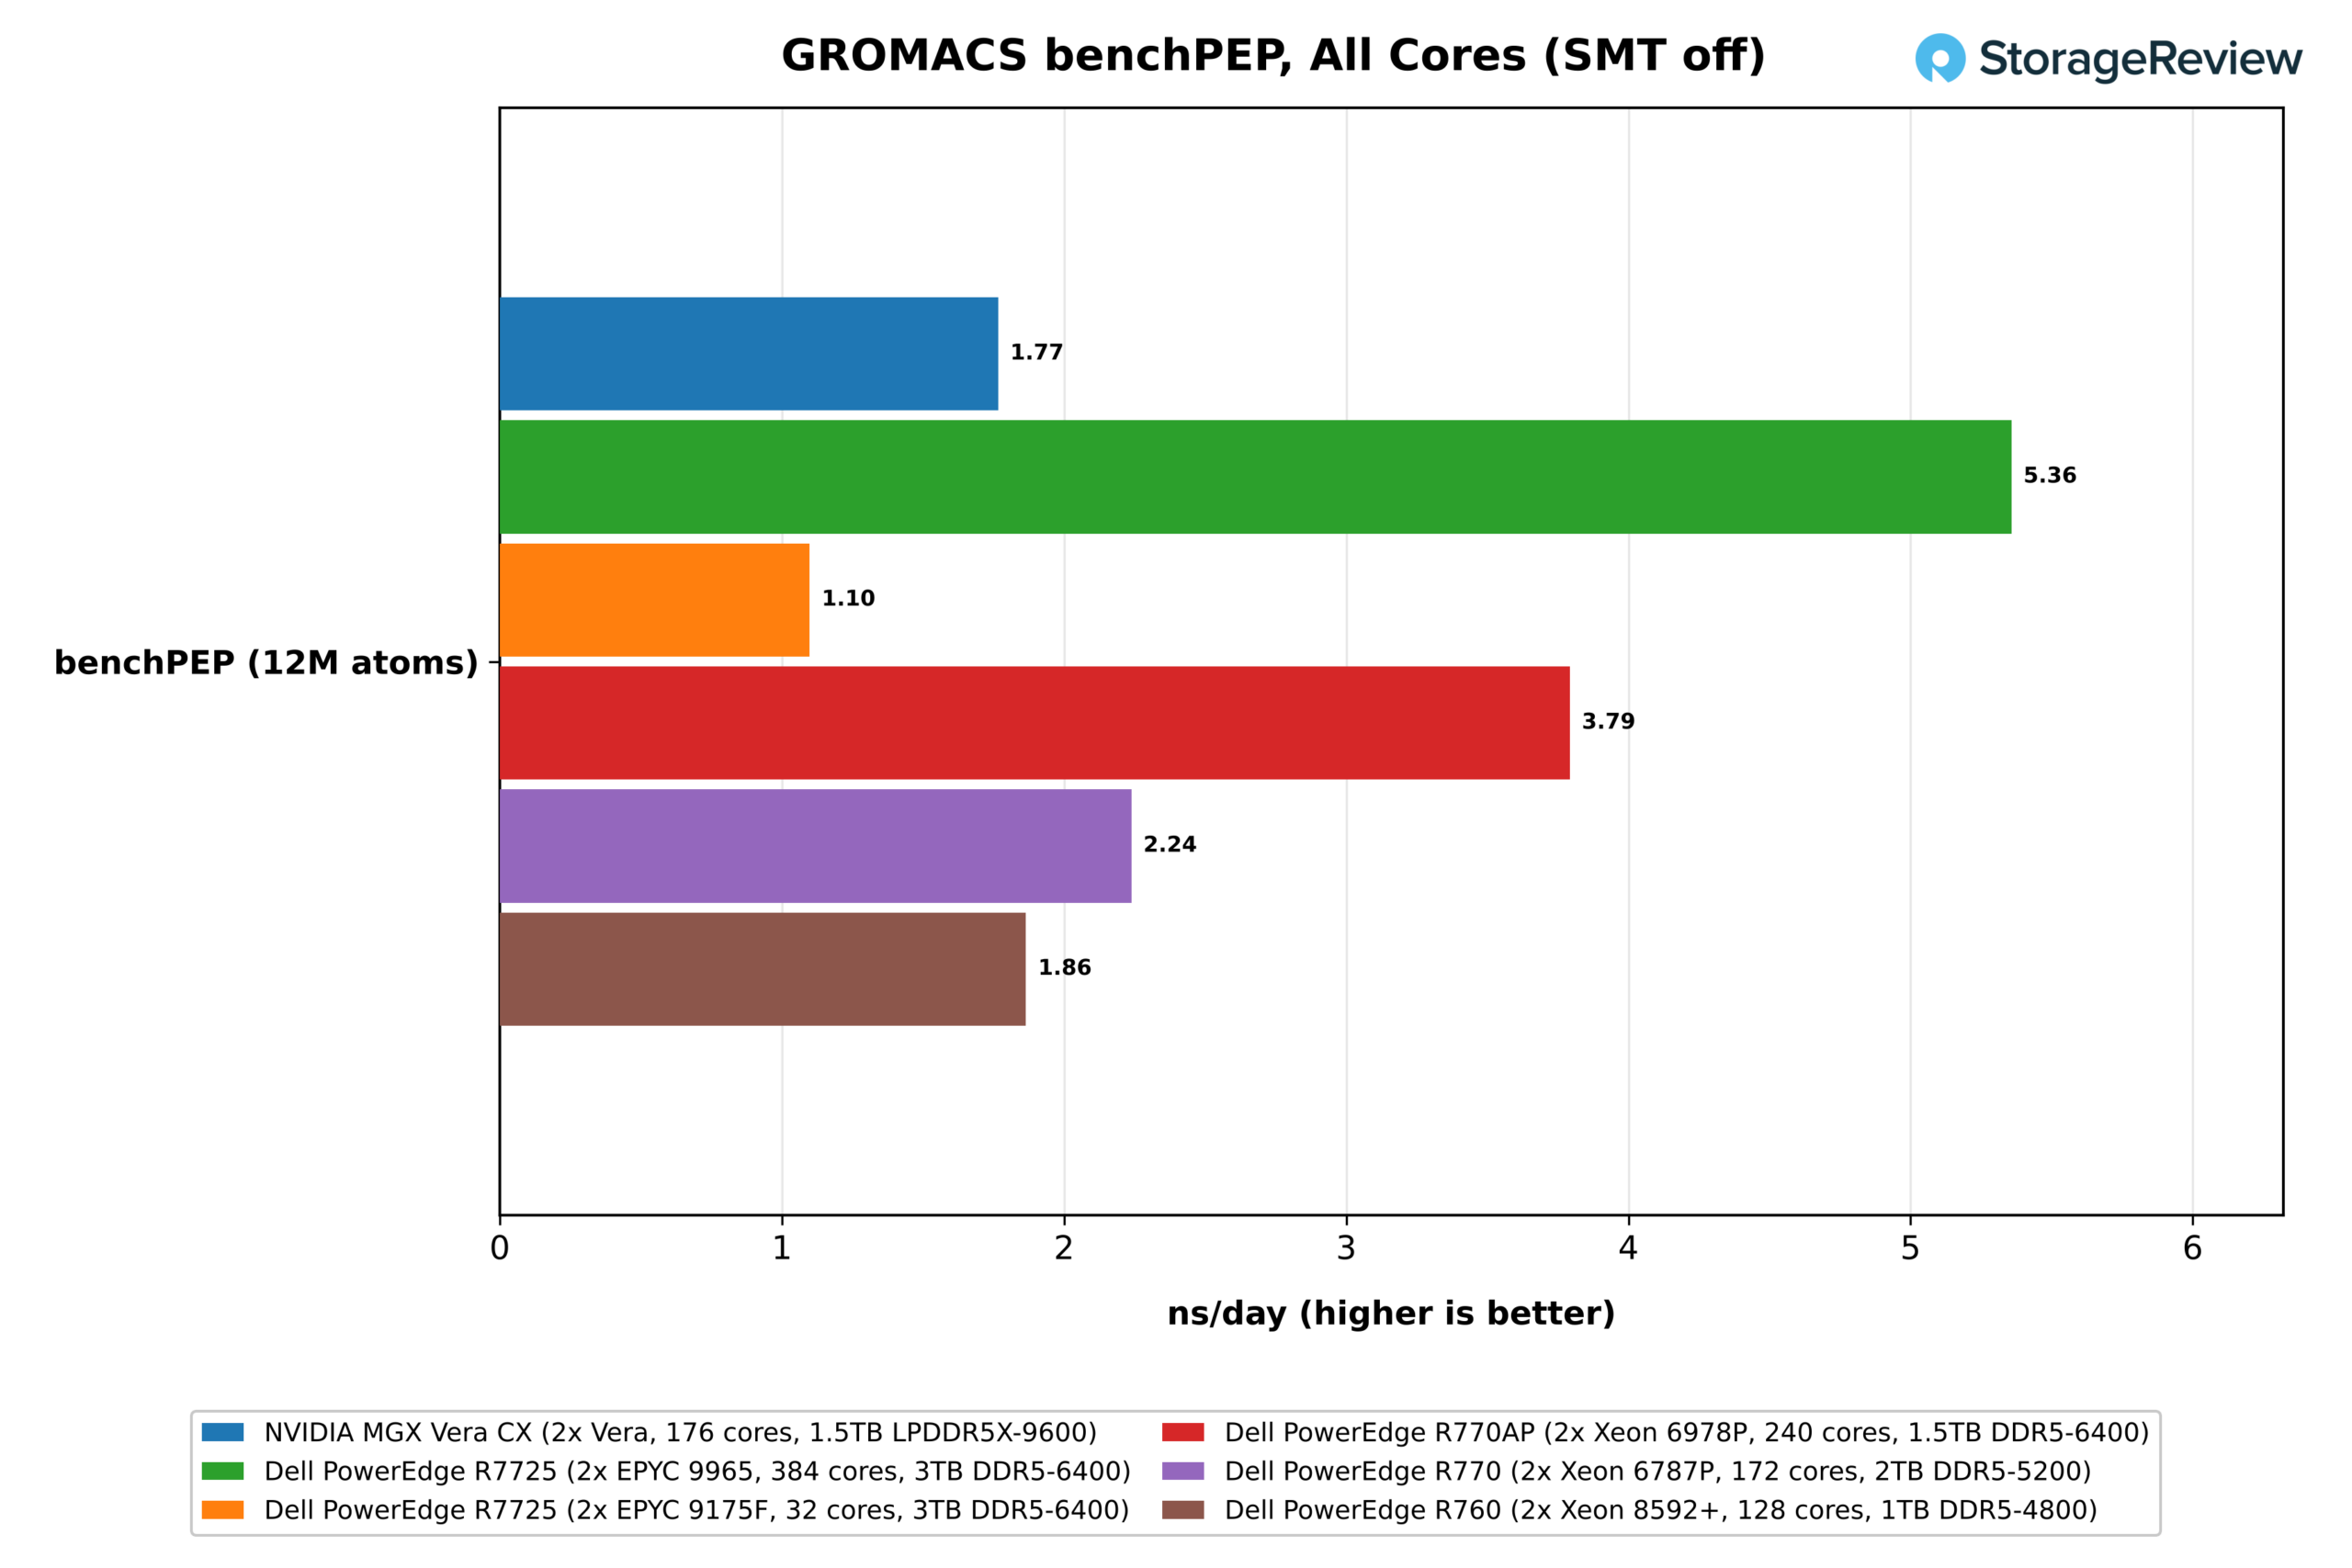
Con SMT disattivato, Vera ha completato benchPEP a 1.77 ns/giorno. L'EPYC 9965 a 384 core si è piazzato al primo posto con 5.36 ns/giorno, 3.0 volte più veloce di Vera, seguito dallo Xeon 6978P a 240 core a 3.79 (2.1 volte) e dallo Xeon 6787P a 172 core a 2.24 (1.27 volte). Anche lo Xeon 8592+ a 128 core si è piazzato davanti a Vera con 1.87, lasciando dietro di lei solo l'EPYC 9175F a 32 core, con 1.10. La normalizzazione per numero di core mostra quanto di questo divario sia dovuto all'architettura. Vera raggiunge 0.0100 ns/giorno per core, contro 0.0130 sul 6787P, 0.0140 sul 9965, 0.0146 sull'8592+ e 0.0158 sul 6978P, quindi il deficit rispetto ai processori x86 più potenti è dovuto in parte al numero di core e in parte alla velocità di elaborazione per core.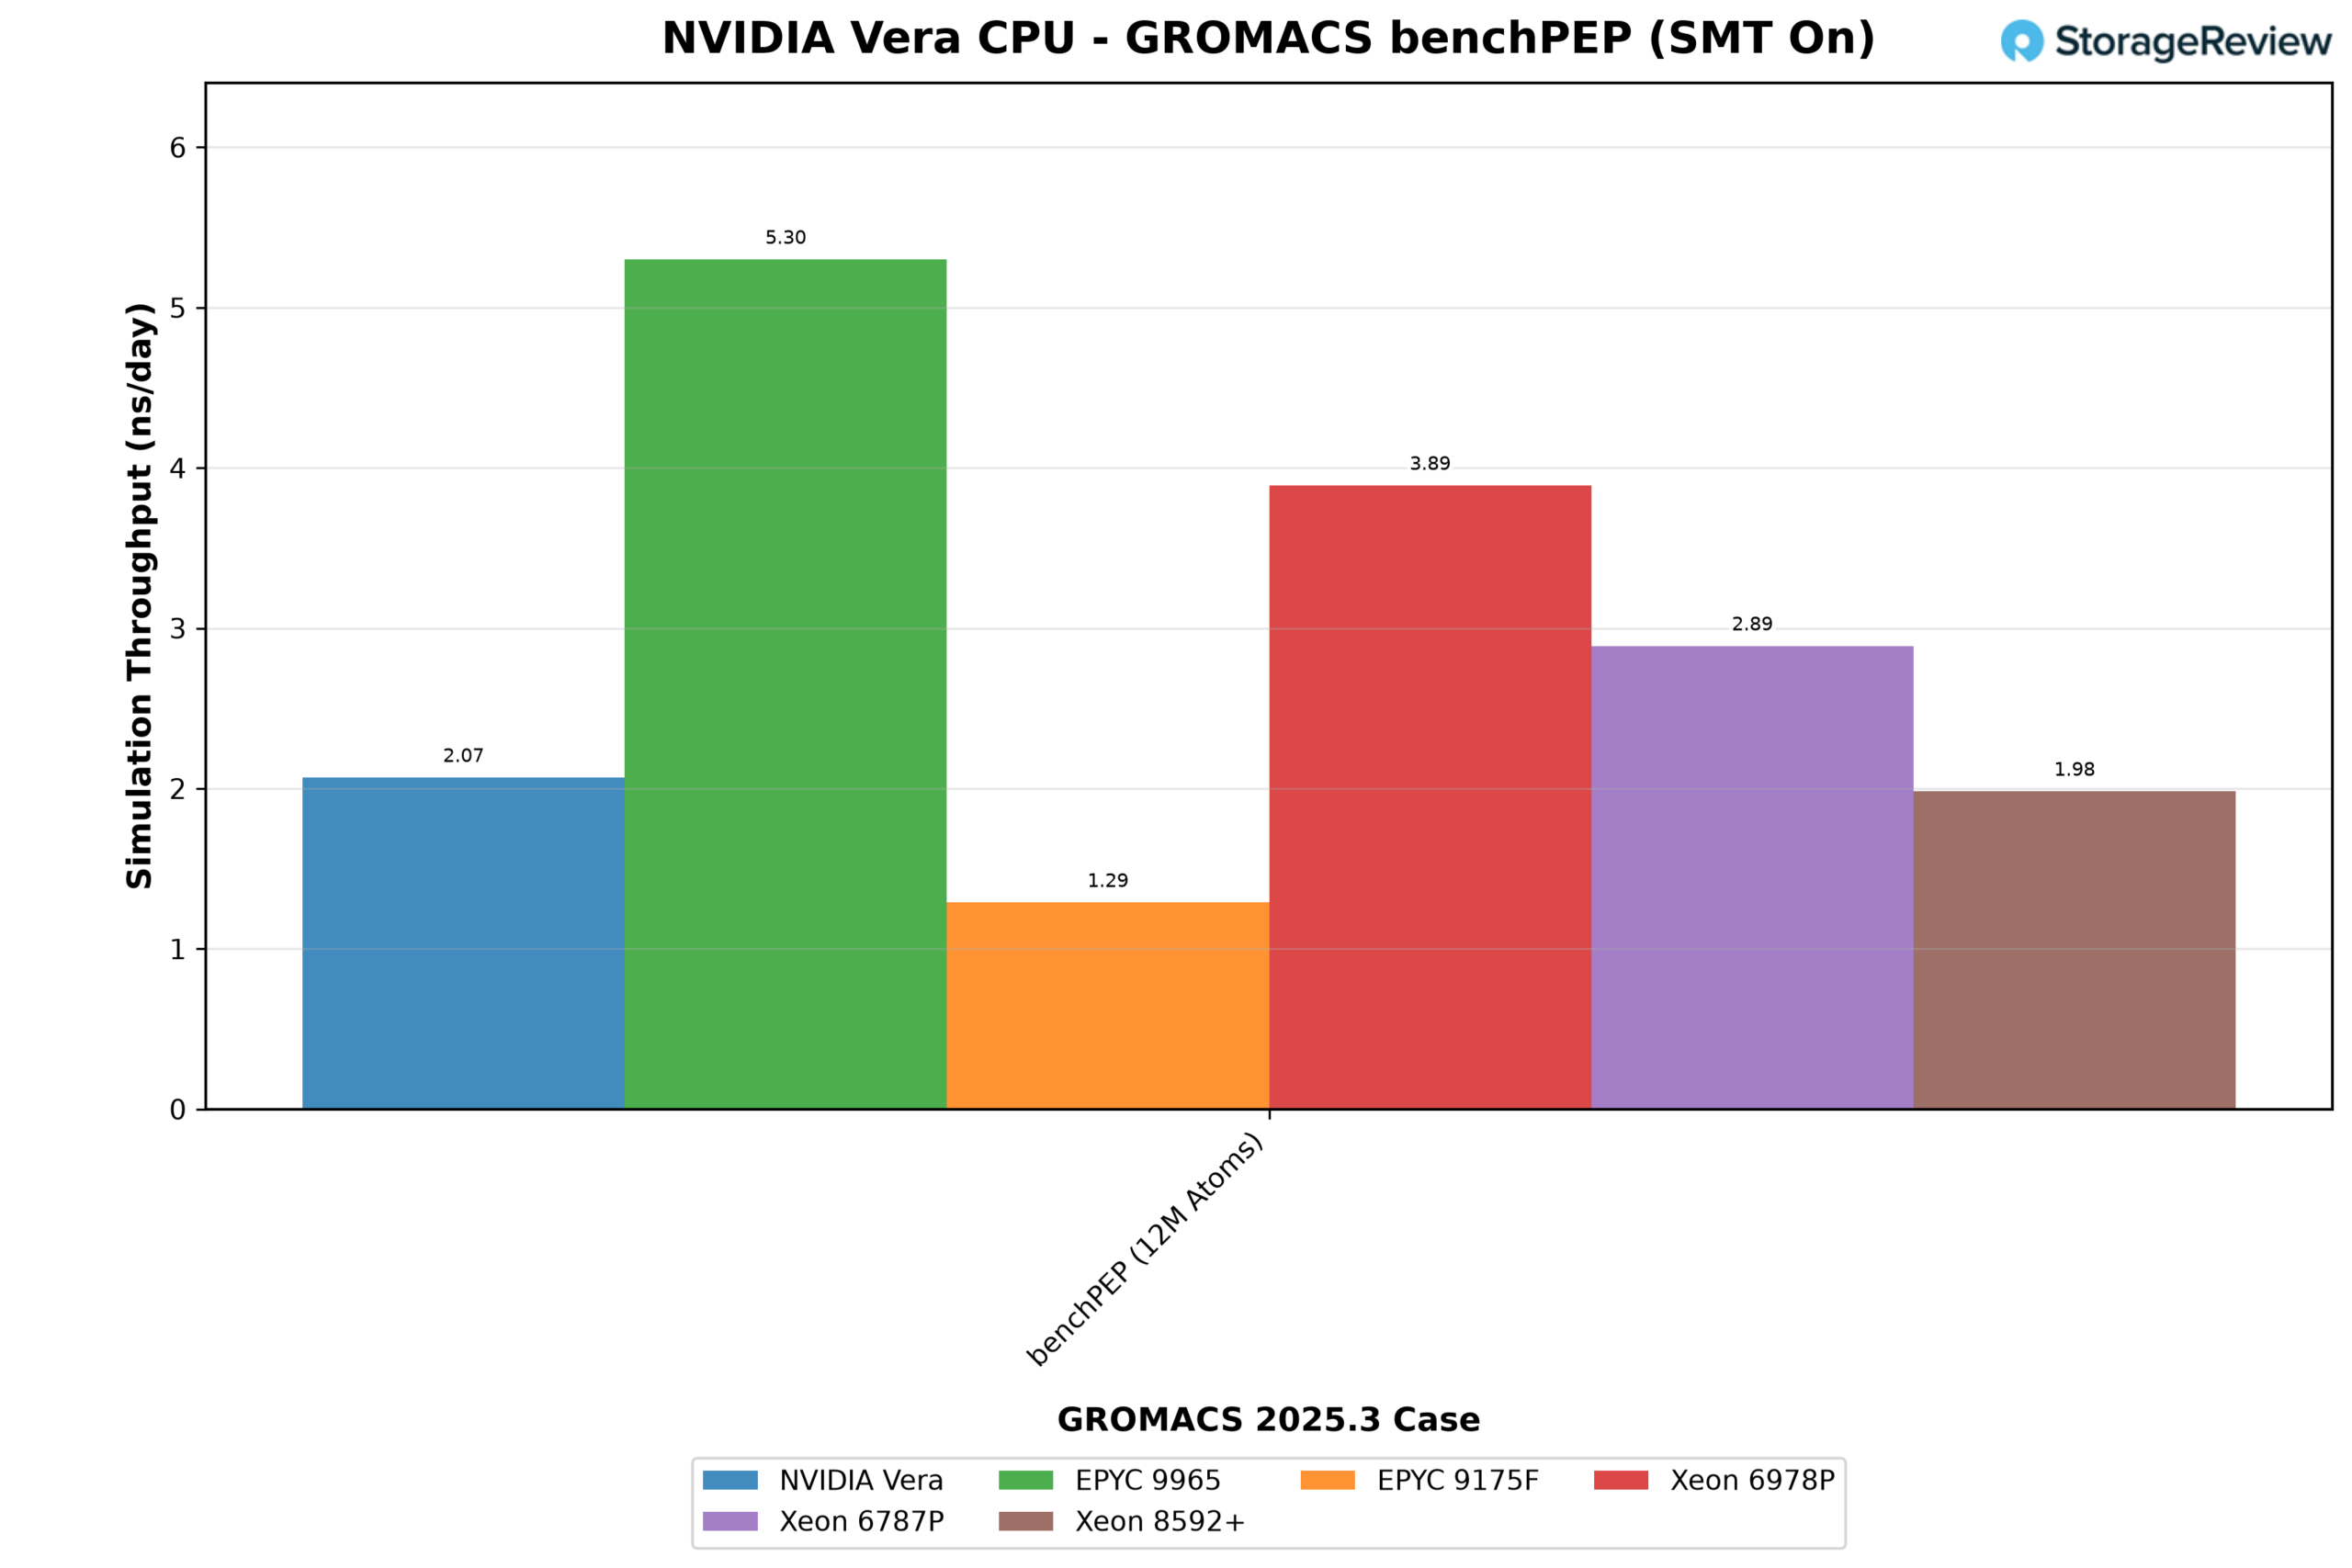
Il multithreading spaziale (SMT) recupera parte del terreno perduto, poiché la sua attivazione ha migliorato il risultato di Vera del 17%, portandolo a 2.07 ns/giorno, con la configurazione migliore che utilizza tutti i 352 thread hardware come rank thread-MPI. Si tratta di un guadagno maggiore rispetto a quello ottenuto con l'SMT sullo Xeon 6978P (3%) o sull'8592+ (11%) nei nostri test precedenti, mentre l'EPYC 9965 ha perso il 3.5% con l'SMT attivo. Con le risorse partizionate tra i due thread, ogni rank ottiene una porzione del core e la combinazione di calcoli vettoriali e blocchi di memoria del risolutore sembra riempire queste porzioni meglio di un singolo rank.
Il caso benchMEM isola il divario per core eseguendo il sistema da 82,000 atomi su 16 core fisici del socket 0 su ogni piattaforma, quindi il numero di core non è equato e il risultato riflette la velocità di elaborazione vettoriale, la cache e la memoria locale.
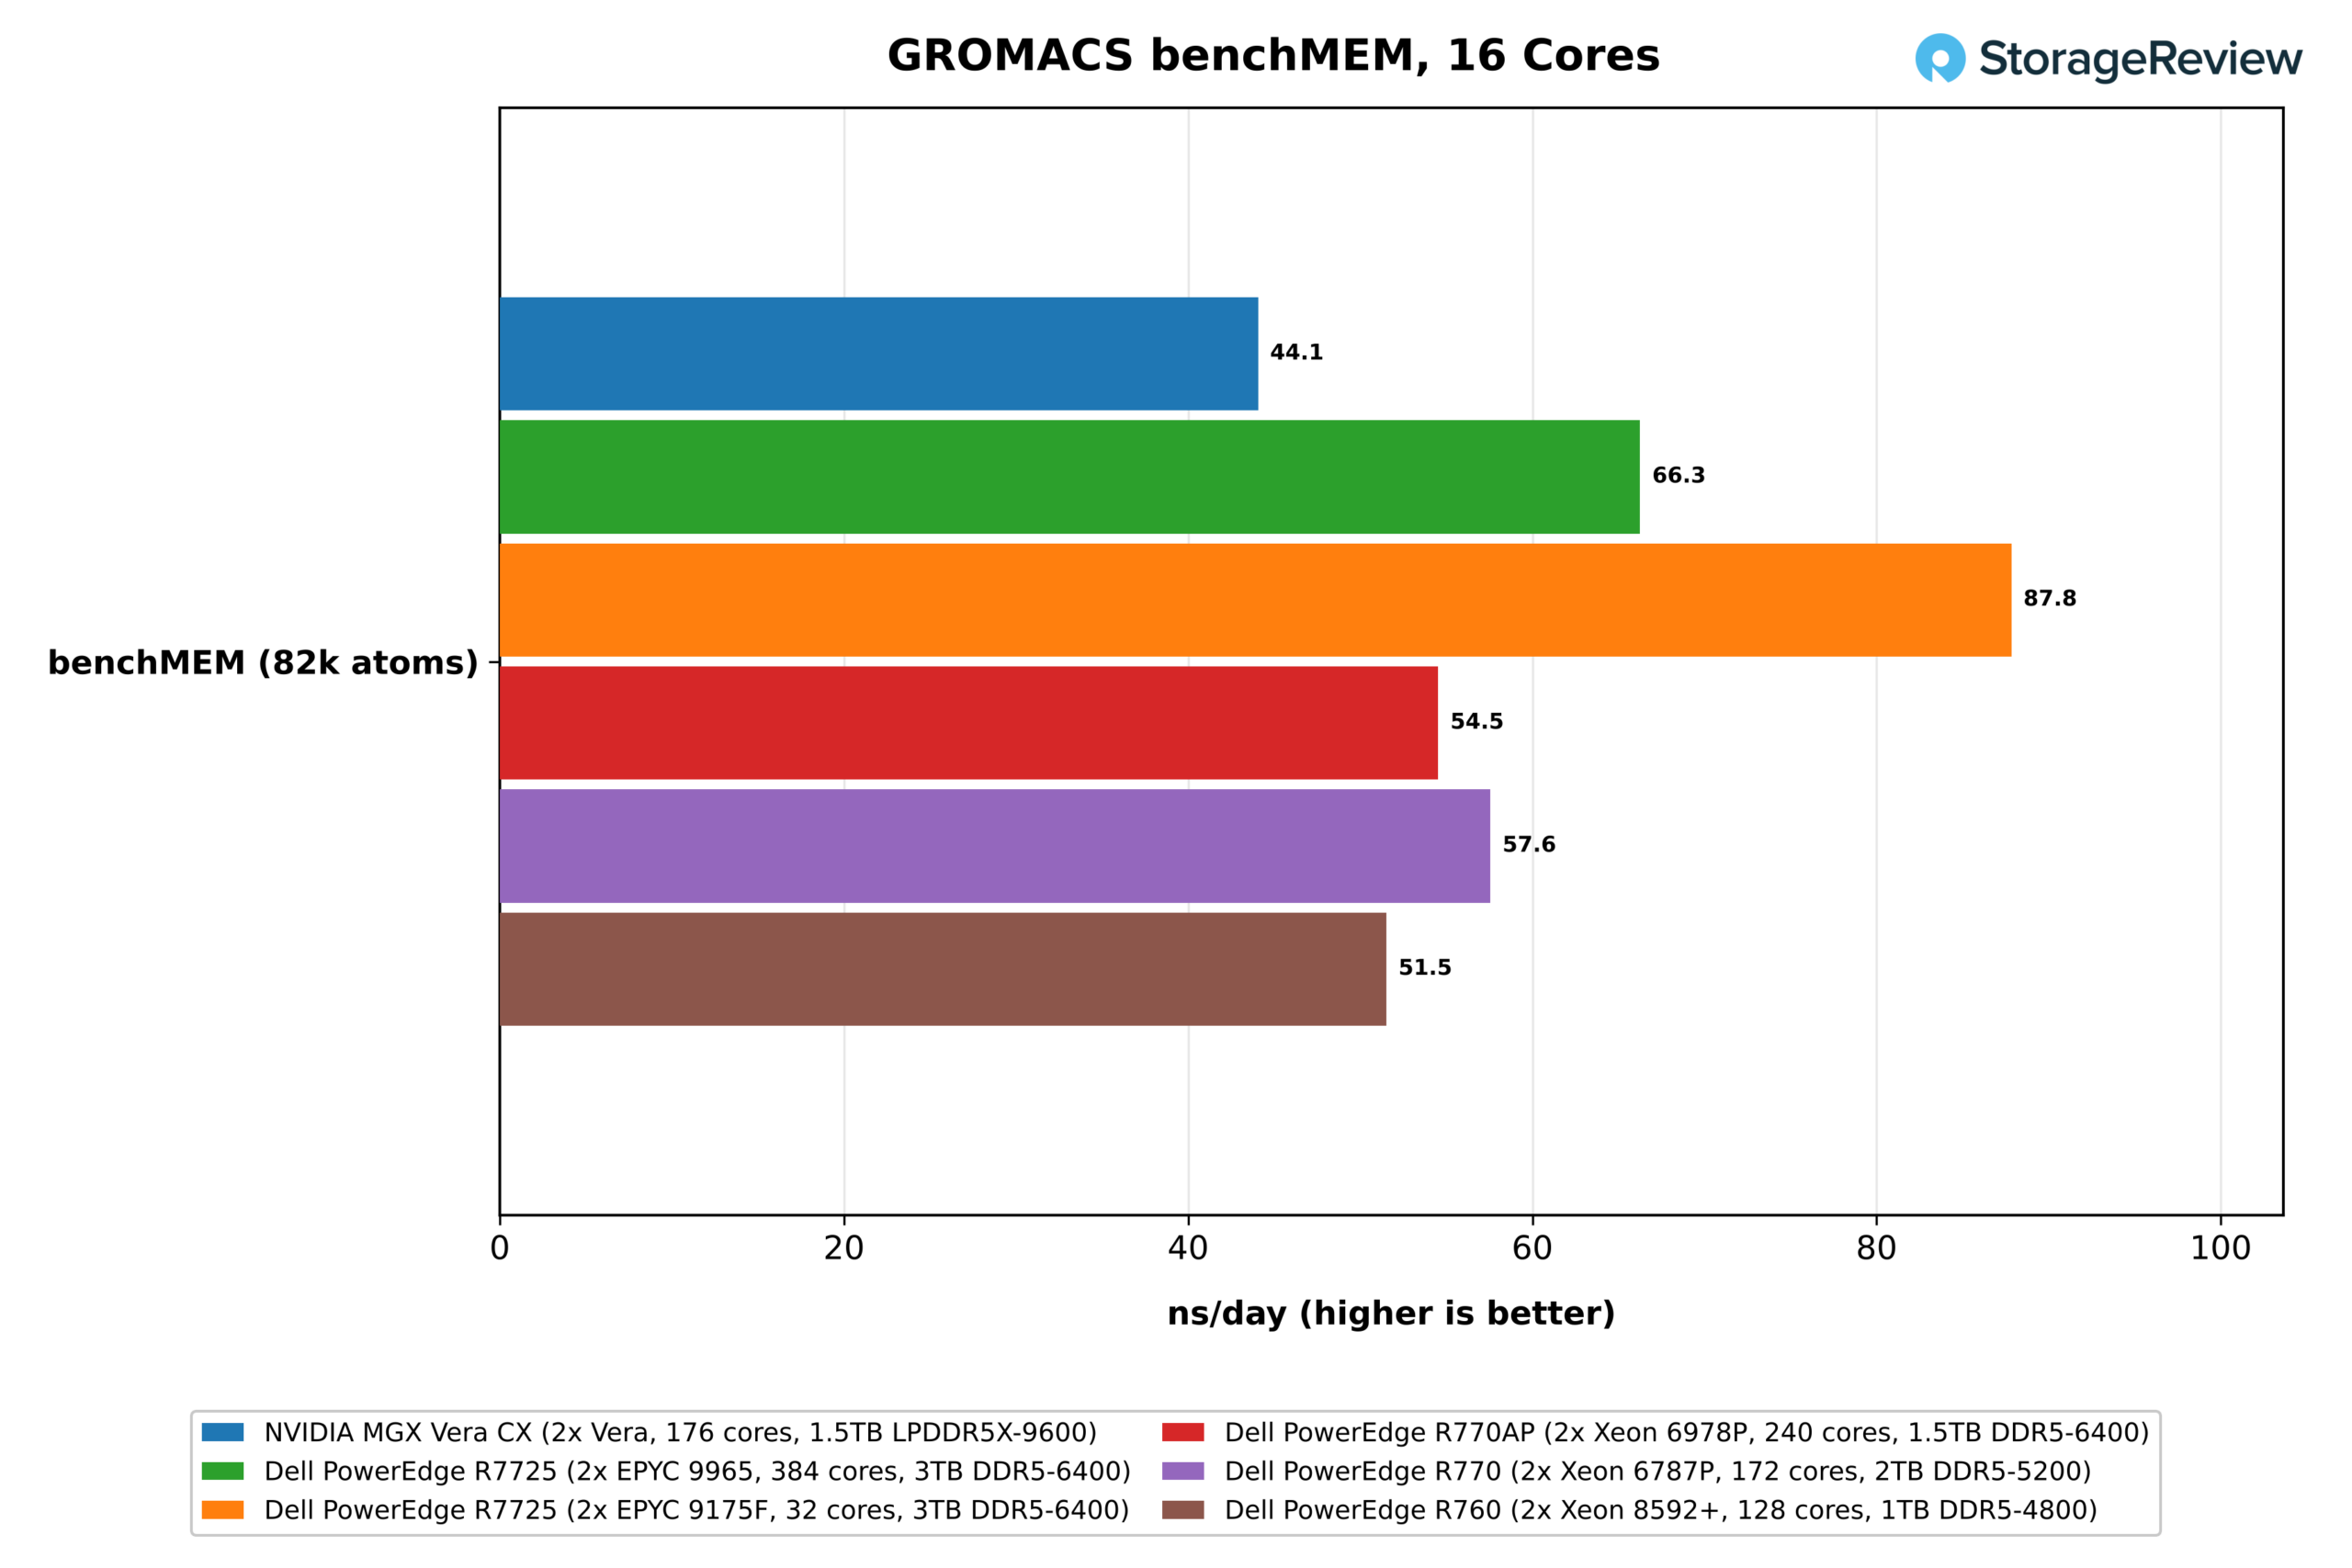
Qui Vera ha registrato 44.1 ns/giorno. L'EPYC 9175F da 5.0 GHz ha raddoppiato questo valore arrivando a 87.8, e l'EPYC 9965 ha raggiunto 66.3, 1.5 volte Vera, davanti allo Xeon 6787P a 57.6, al 6978P a 54.5 e all'8592+ a 51.5.
Una porzione a 16 core di Vera svolge quindi circa due terzi del lavoro di una porzione a 16 core di un processore Zen 5c, anche se i 16 core Zen 5c condividono una singola cache L3 da 32 MB, mentre Vera può attingere alla sua cache di sistema da 164 MB. Questo rappresenta la misurazione più chiara di cui disponiamo per valutare il costo dei vettori a 128 bit su codice scritto per vettori a 512 bit. L'ulteriore vantaggio del 9175F rispetto al 9965 è sostanzialmente in linea con il suo vantaggio di frequenza di clock, 5.0 GHz contro 3.7 GHz.
OpenFOAM
OpenFOAM sposta la pressione dalle unità vettoriali al sistema di memoria. Eseguiamo OpenFOAM 13 sul caso di aerodinamica automobilistica driverFastback, con un rank MPI per core fisico, con due dimensioni di mesh: una mesh media da 2.98 milioni di celle e una mesh grande da 22.6 milioni di celle.
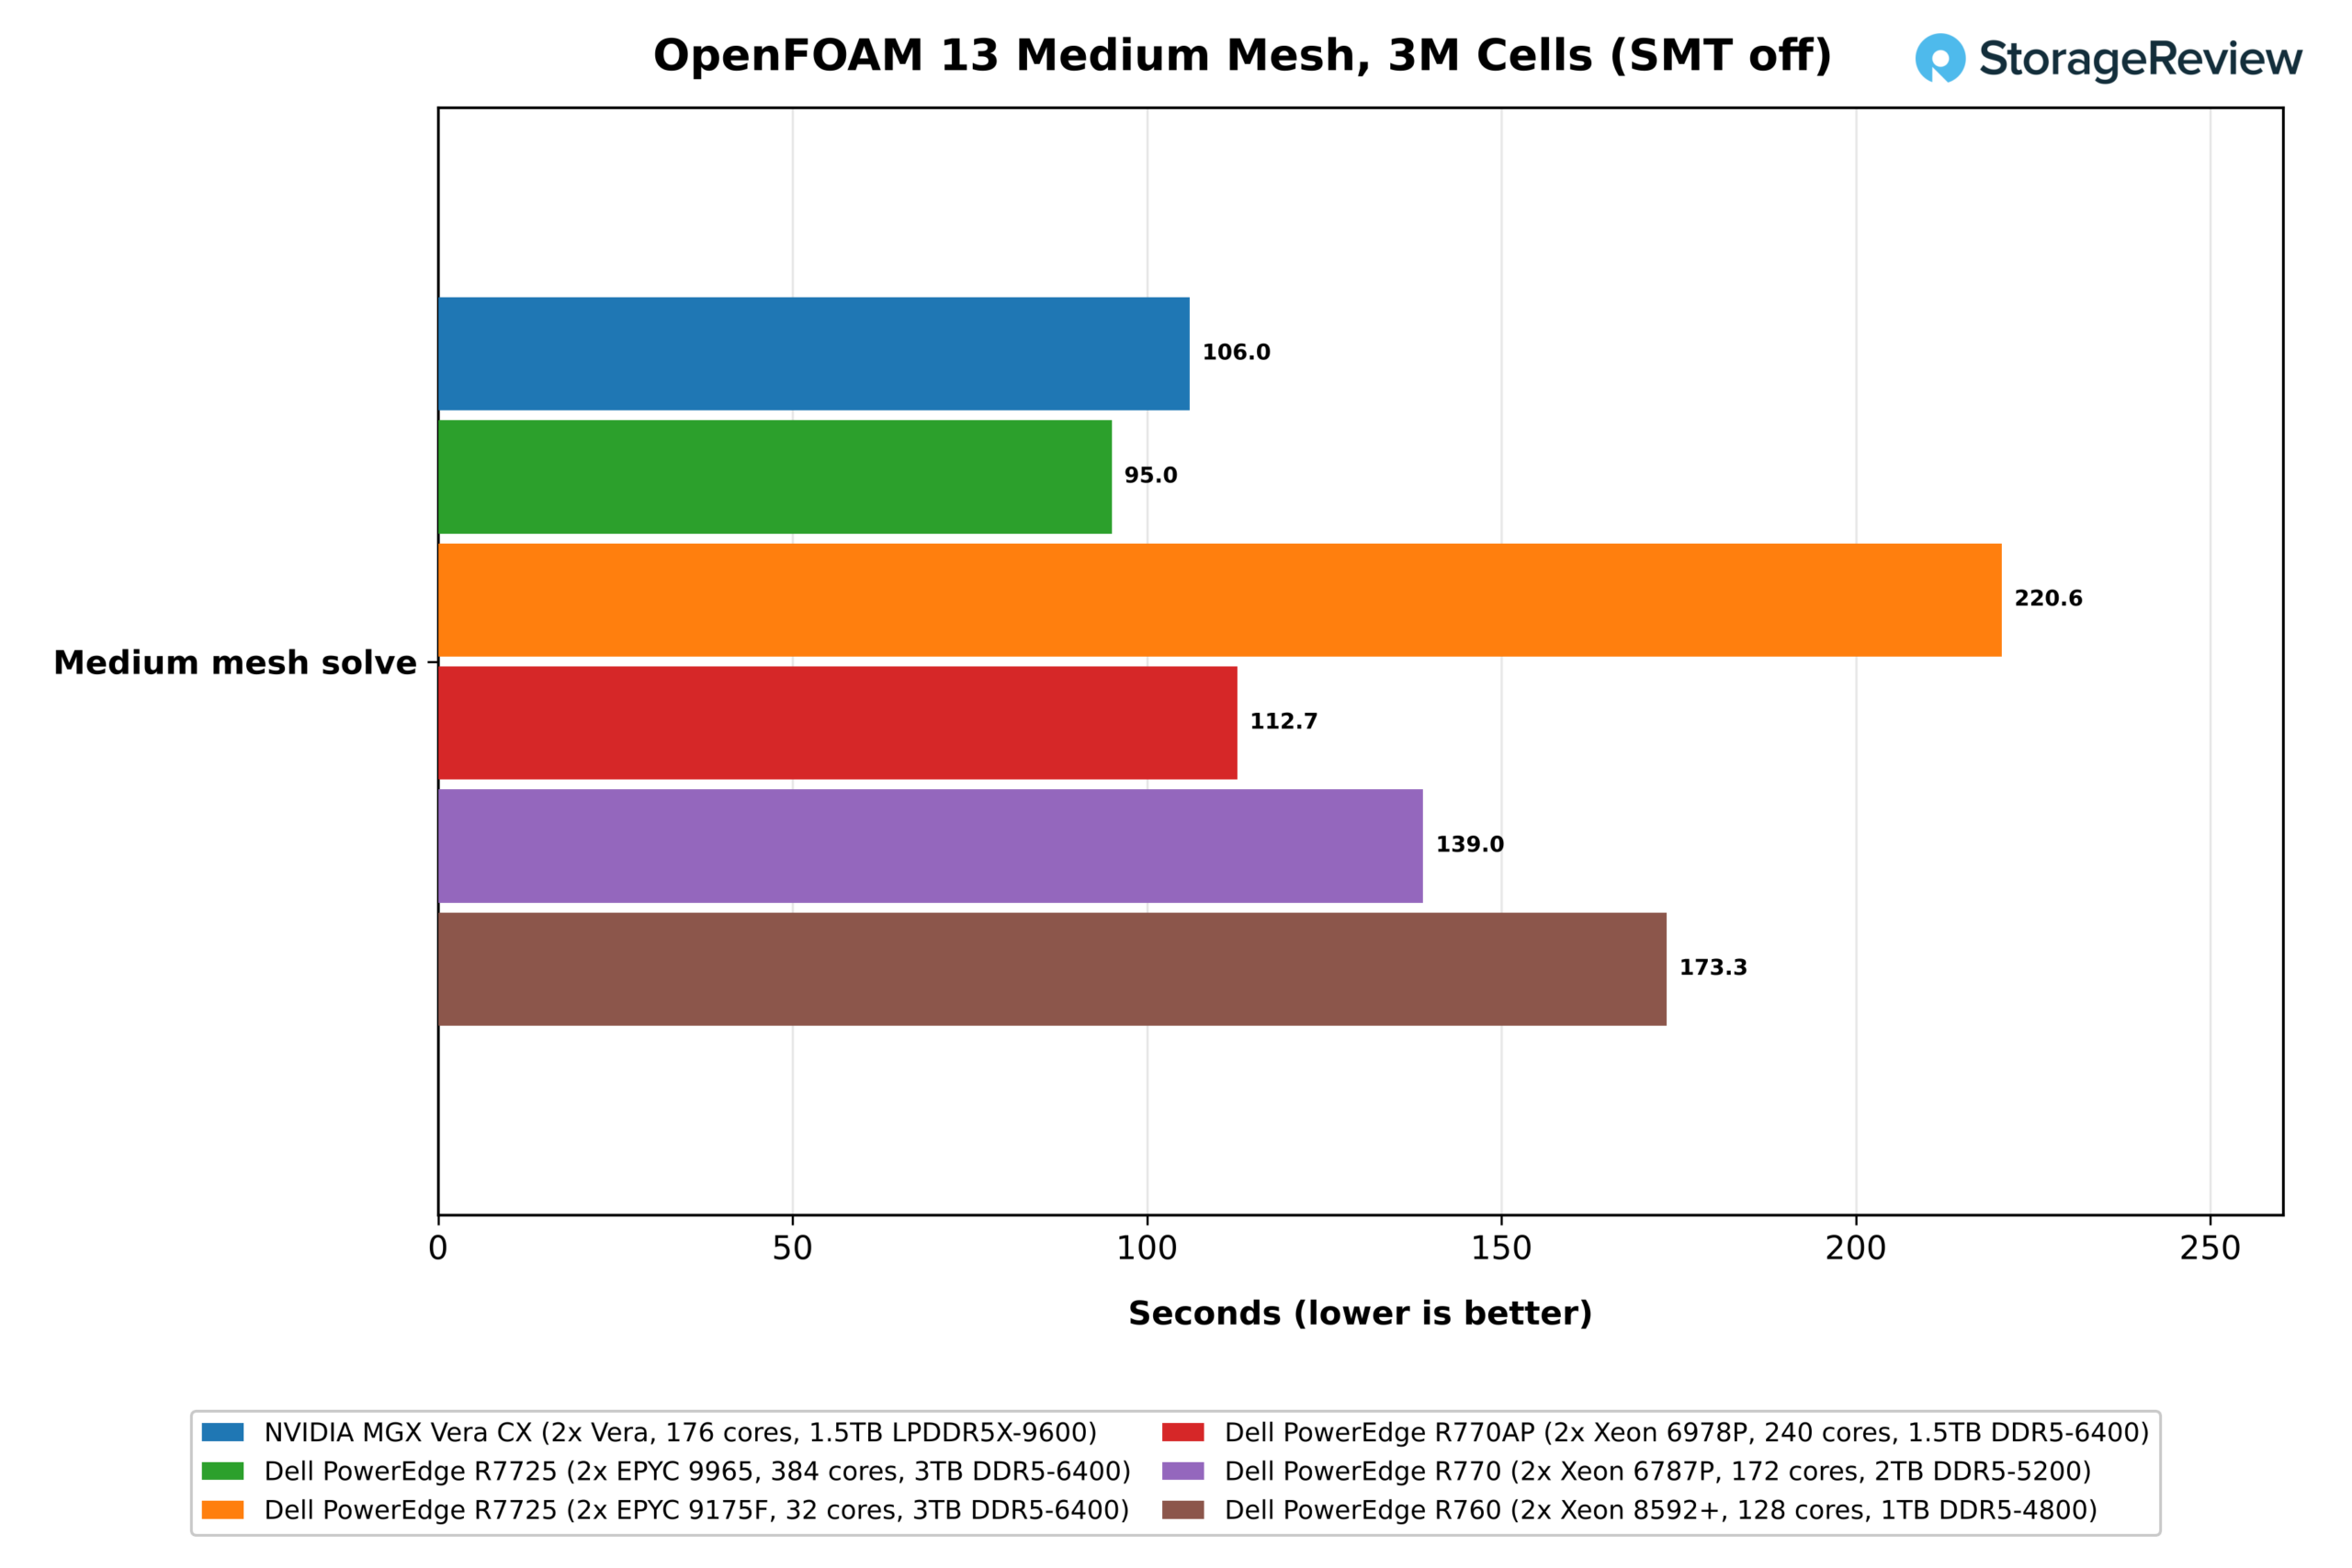
La mesh di medie dimensioni è stata risolta in 106.0 secondi su Vera, contro i 95.0 dell'EPYC 9965, i 112.7 dello Xeon 6978P, i 139.0 del 6787P, i 173.3 dell'8592+ e i 220.6 del 9175F a 32 core. A queste dimensioni, i 384 core del 9965 vincono, mentre Vera impiega il 12% in più ma si piazza al secondo posto, il 6% davanti allo Xeon a 240 core. Con soli 3 milioni di celle, le cache L3 più grandi dei processori x86 probabilmente contengono una parte maggiore del problema, il che mantiene il numero di core dominante.
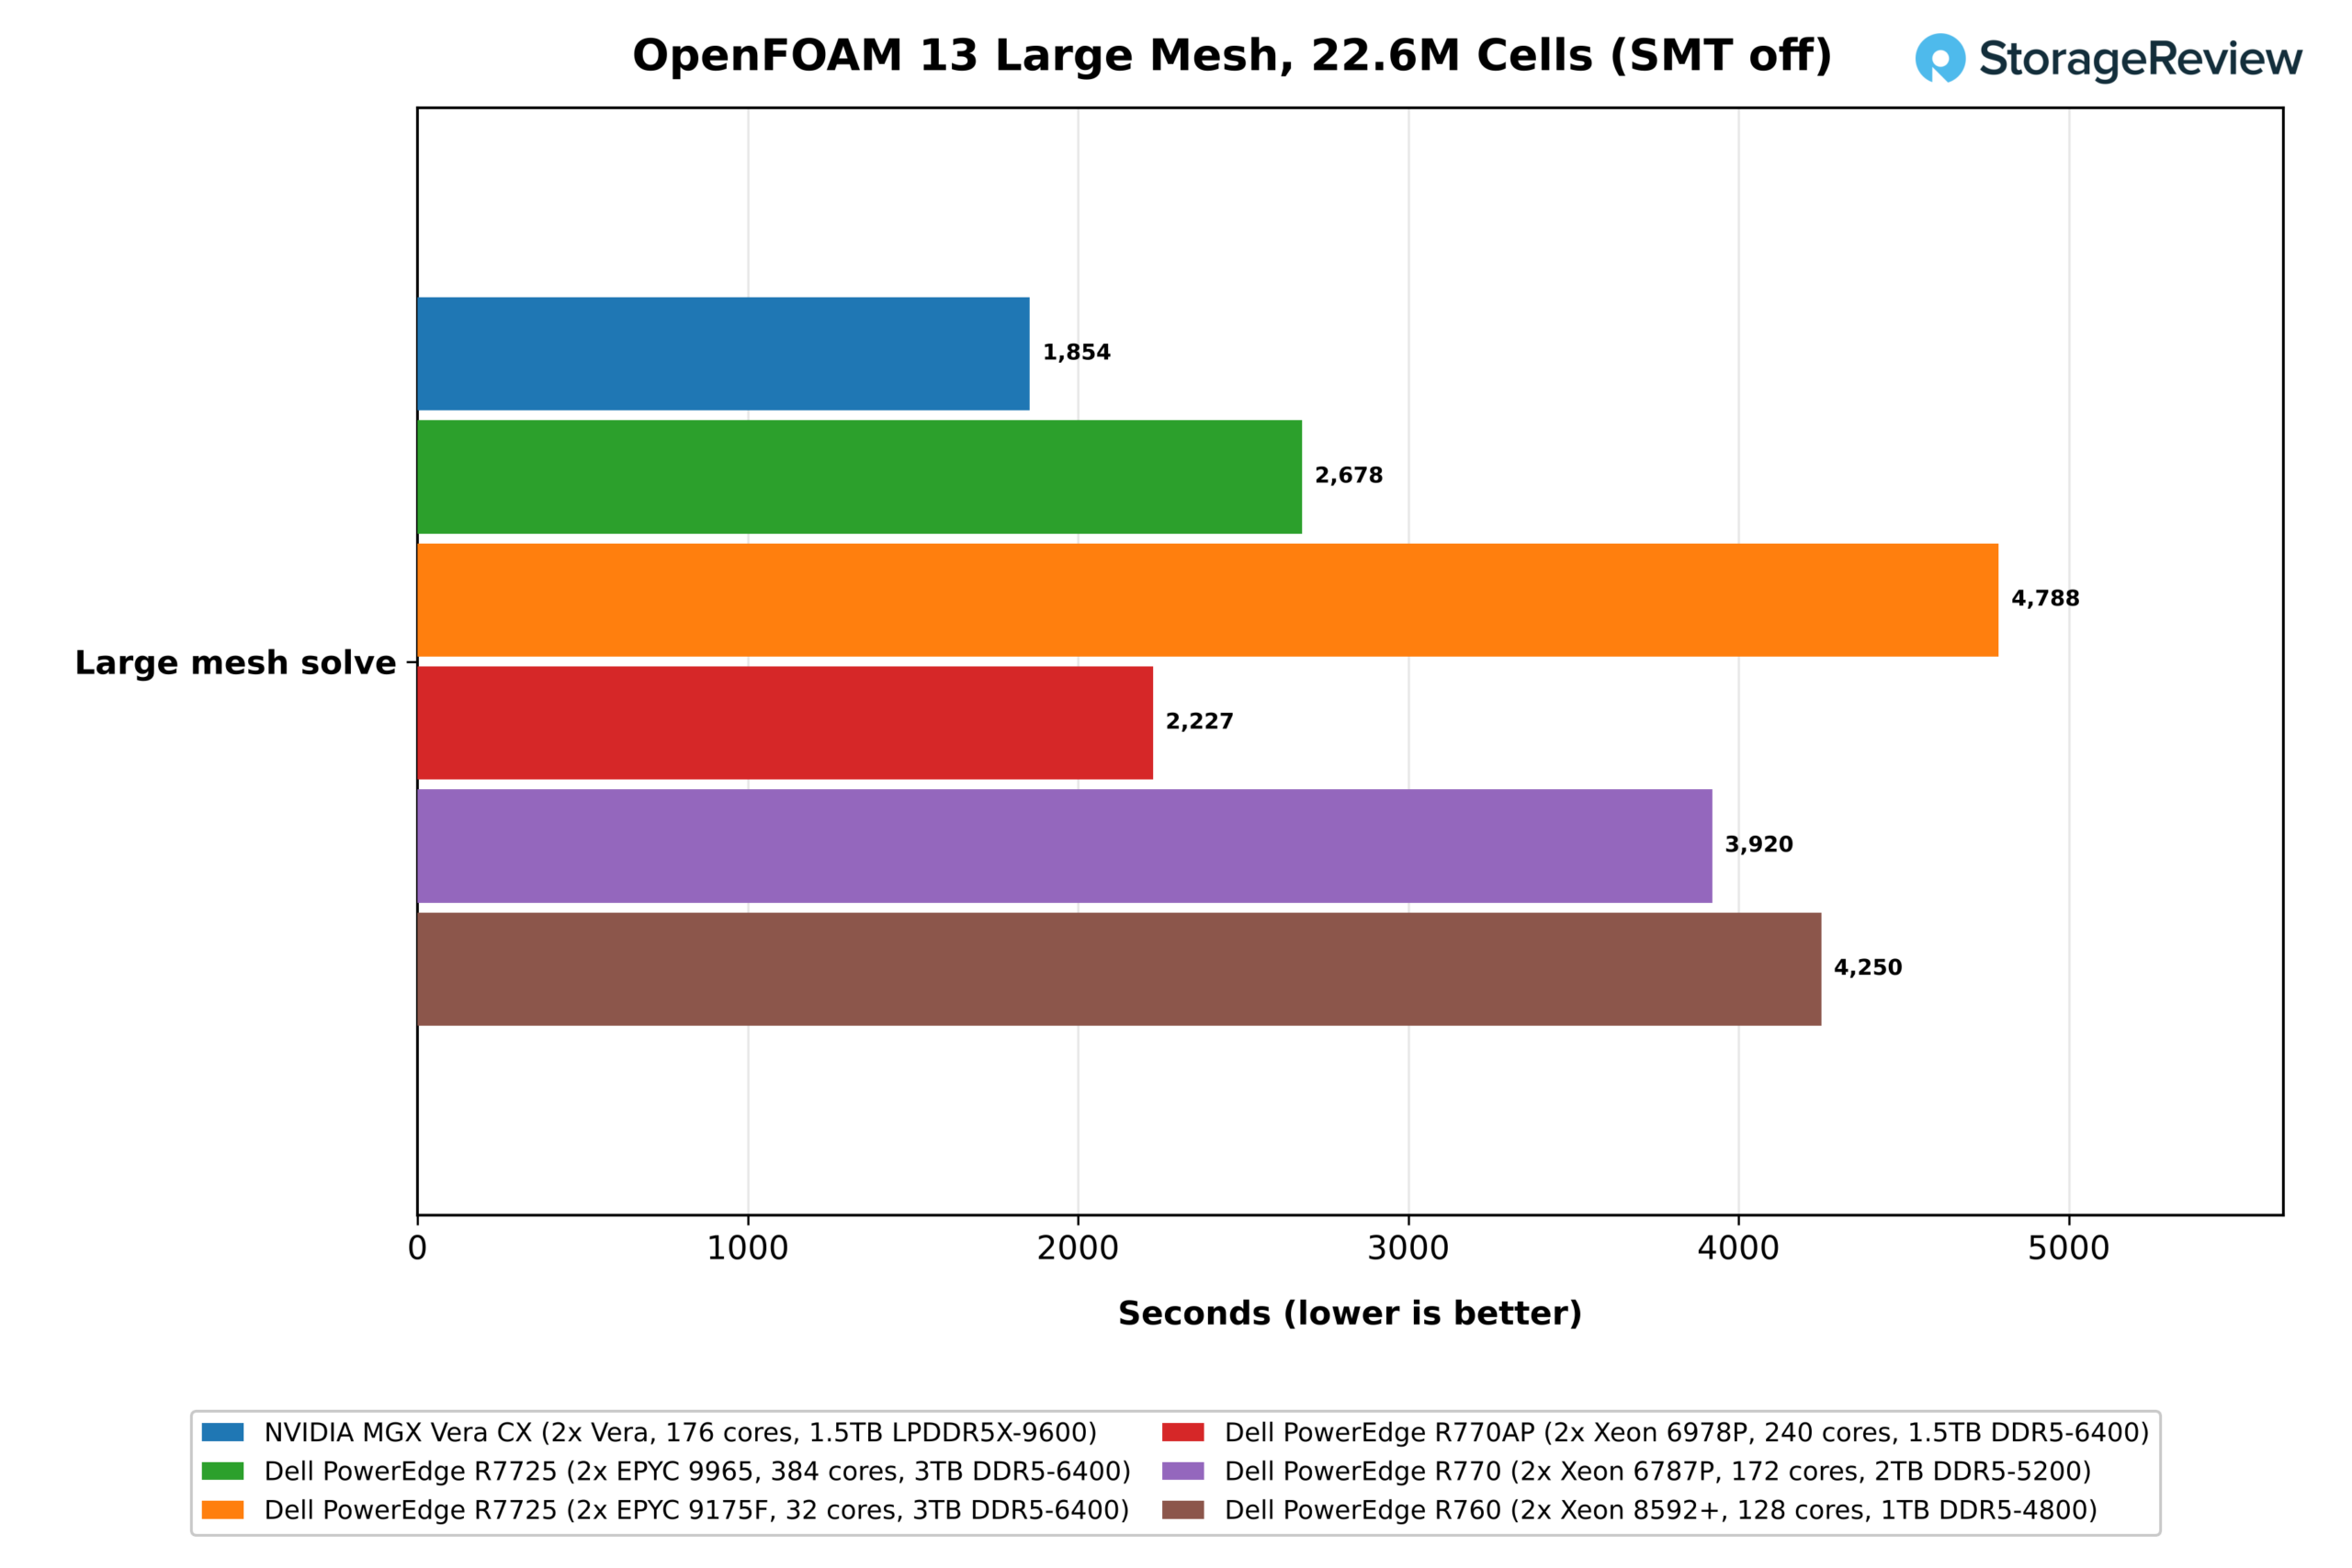
La grande mesh inverte l'ordine, con Vera che la risolve in 1,854 secondi, contro i 2,227 dello Xeon 6978P, i 2,678 dell'EPYC 9965, i 3,920 del 6787P, i 4,250 dell'8592+ e i 4,788 del 9175F, risultando 1.44 volte più veloce del server AMD a 384 core e 1.20 volte più veloce di quello Intel a 240 core. Vera inoltre rimane entro un consumo massimo nominale di 450 W per socket, rispetto ai 500 W del 9965.
Analisi e dati in memoria
I risultati dell'HPC hanno mostrato l'importanza della larghezza di banda di Vera per un risolutore scientifico. I servizi dati utilizzano lo stesso sistema di memoria in modi diversi e i nostri due test lo mettono alla prova da prospettive opposte. ClickBench esegue query analitiche che scansionano e aggregano grandi colonne di dati, distribuendo ogni query su ogni core, premiando quindi un sistema che abbina molti core con la larghezza di banda necessaria per gestirli. Valkey, un archivio chiave-valore in memoria, gestisce milioni di piccole richieste, ognuna delle quali legge o scrive un singolo valore, quindi dipende maggiormente dalla velocità con cui un singolo core elabora una richiesta e, una volta che i dati superano la capacità della cache, dalla latenza e dalla larghezza di banda della memoria.
ClickBench
Abbiamo testato ClickBench con 43 query su una tabella di analisi web da 100 milioni di righe su ClickHouse 26.8. La sua somma a caldo, in cui ogni query legge dalla cache di pagina, misura quanti core un sistema può dedicare alle scansioni colonnari e alle aggregazioni e quanto bene la sua memoria le gestisce. La somma a freddo aggiunge un riavvio del server e letture SSD prima della prima esecuzione di ogni query.
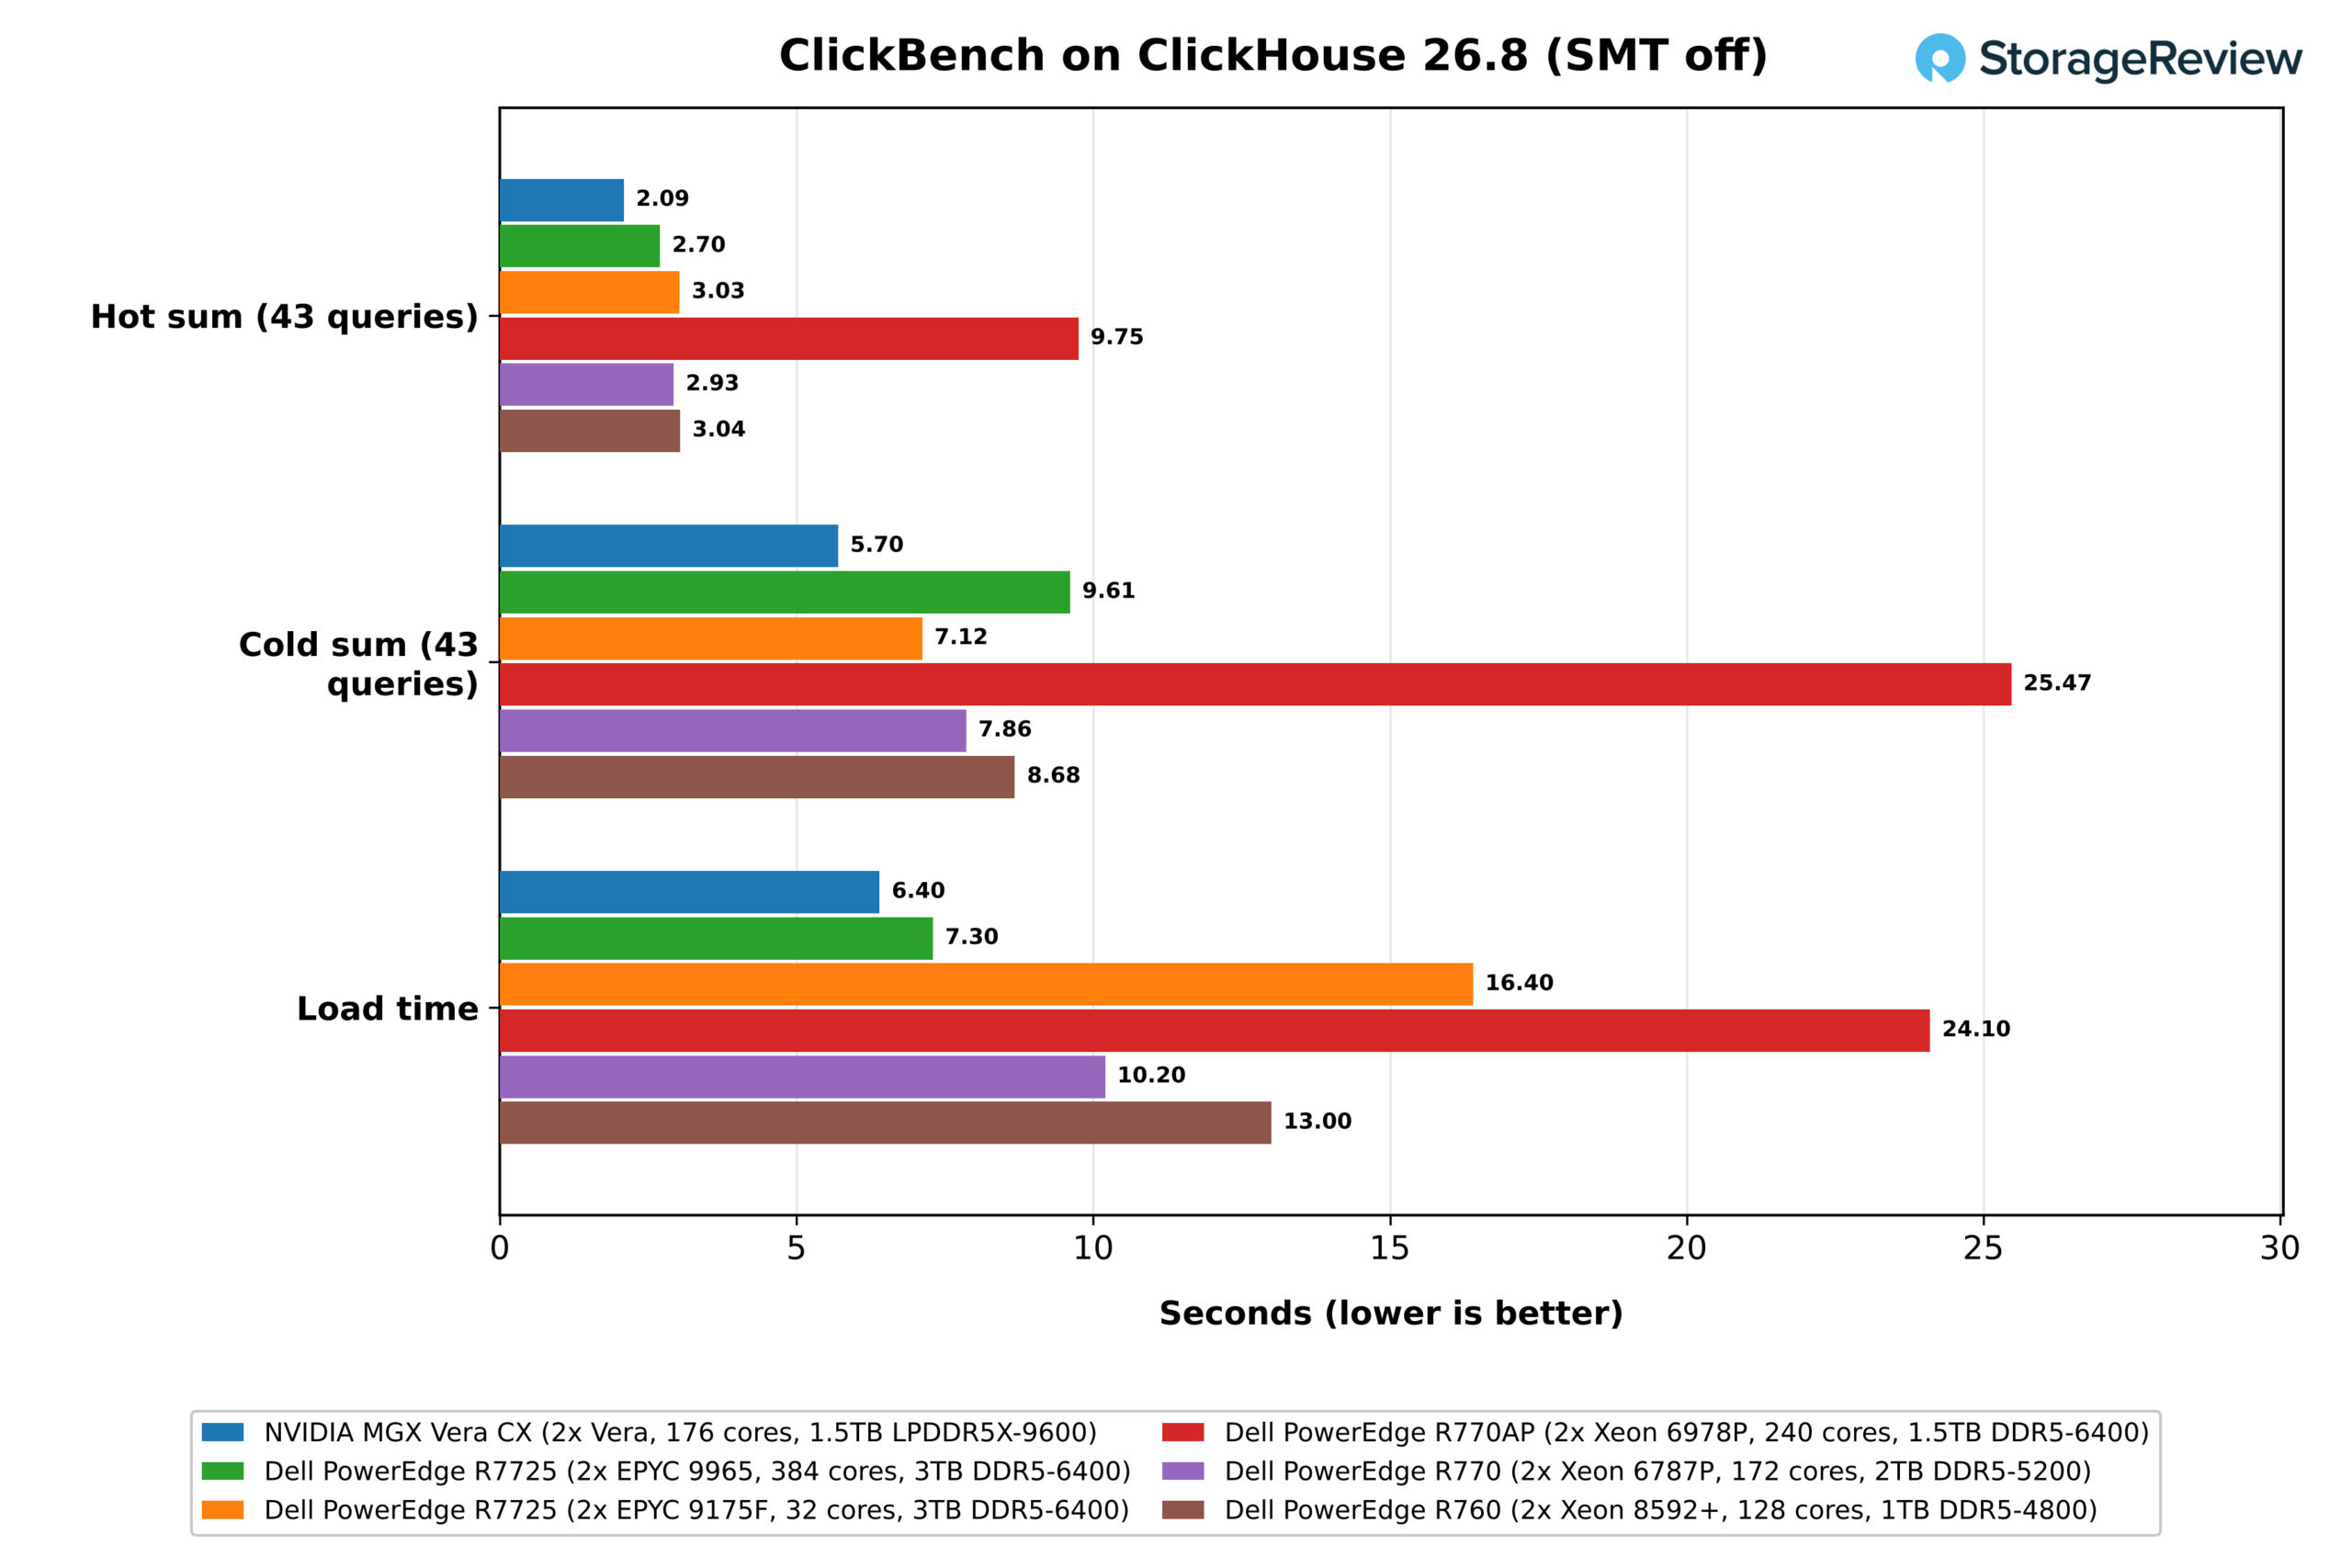
Con SMT disattivato, Vera ha completato il test a caldo in 2.09 secondi, il risultato più veloce del nostro set. L'EPYC 9965 si è piazzato subito dopo con 2.70 secondi, impiegando 1.29 volte più tempo, mentre Xeon 6787P, EPYC 9175F e Xeon 8592+ si sono attestati su tempi compresi tra 2.93 e 3.04 secondi. Questa differenza riflette l'equilibrio tra core e larghezza di banda. Il 9965 a 384 core ha core in abbondanza ma poca larghezza di banda per core; il 9175F a 32 core ha la situazione opposta; e Vera combina 176 core con una larghezza di banda più che tripla rispetto a entrambi.
Vera ha inoltre primeggiato nel test a freddo con un tempo di 5.70 secondi, davanti al 9175F con 7.12, al 6787P con 7.86, all'8592+ con 8.68 e al 9965 con 9.61. Il tempo a freddo è maggiormente influenzato dallo storage e i collegamenti delle unità sono diversi: Gen5 x4 su Vera e sul 6787P, x2 su entrambi i sistemi EPYC e Gen4 sull'8592+.
Vera ha anche caricato il dataset da 15 GB più velocemente, in 6.4 secondi, rispetto ai 7.3 secondi del 9965 e ai 10.2-16.4 secondi degli altri. Lo Xeon 6978P, con 9.75 secondi a caldo e 25.47 secondi a freddo, si è discostato molto dagli altri Xeon per ragioni che non abbiamo identificato, quindi lo abbiamo escluso dalla classifica.
L'attivazione del multithreading spaziale ha rallentato Vera a 2.31 secondi a caldo e 6.09 secondi a freddo, con una penalità del 10% sulla somma a caldo. La suddivisione delle risorse di ciascun core tra due thread ha comportato per le scansioni di ClickHouse un costo maggiore rispetto ai vantaggi ottenuti.
Valkey
Valkey esegue i comandi su un singolo thread principale, con i thread di I/O che intervengono solo fino a un certo punto, quindi le implementazioni si espandono aggiungendo shard, poiché aumentare il numero di core di una singola istanza non apporta grandi vantaggi. Analizziamo quindi Valkey in due modi: le prestazioni di un singolo shard su un numero di core corrispondente e le prestazioni di ciascuno shard quando un socket è occupato da tutti gli shard. In entrambi i test, i client vengono eseguiti sull'altro socket della stessa macchina, quindi non è coinvolta alcuna scheda di rete.
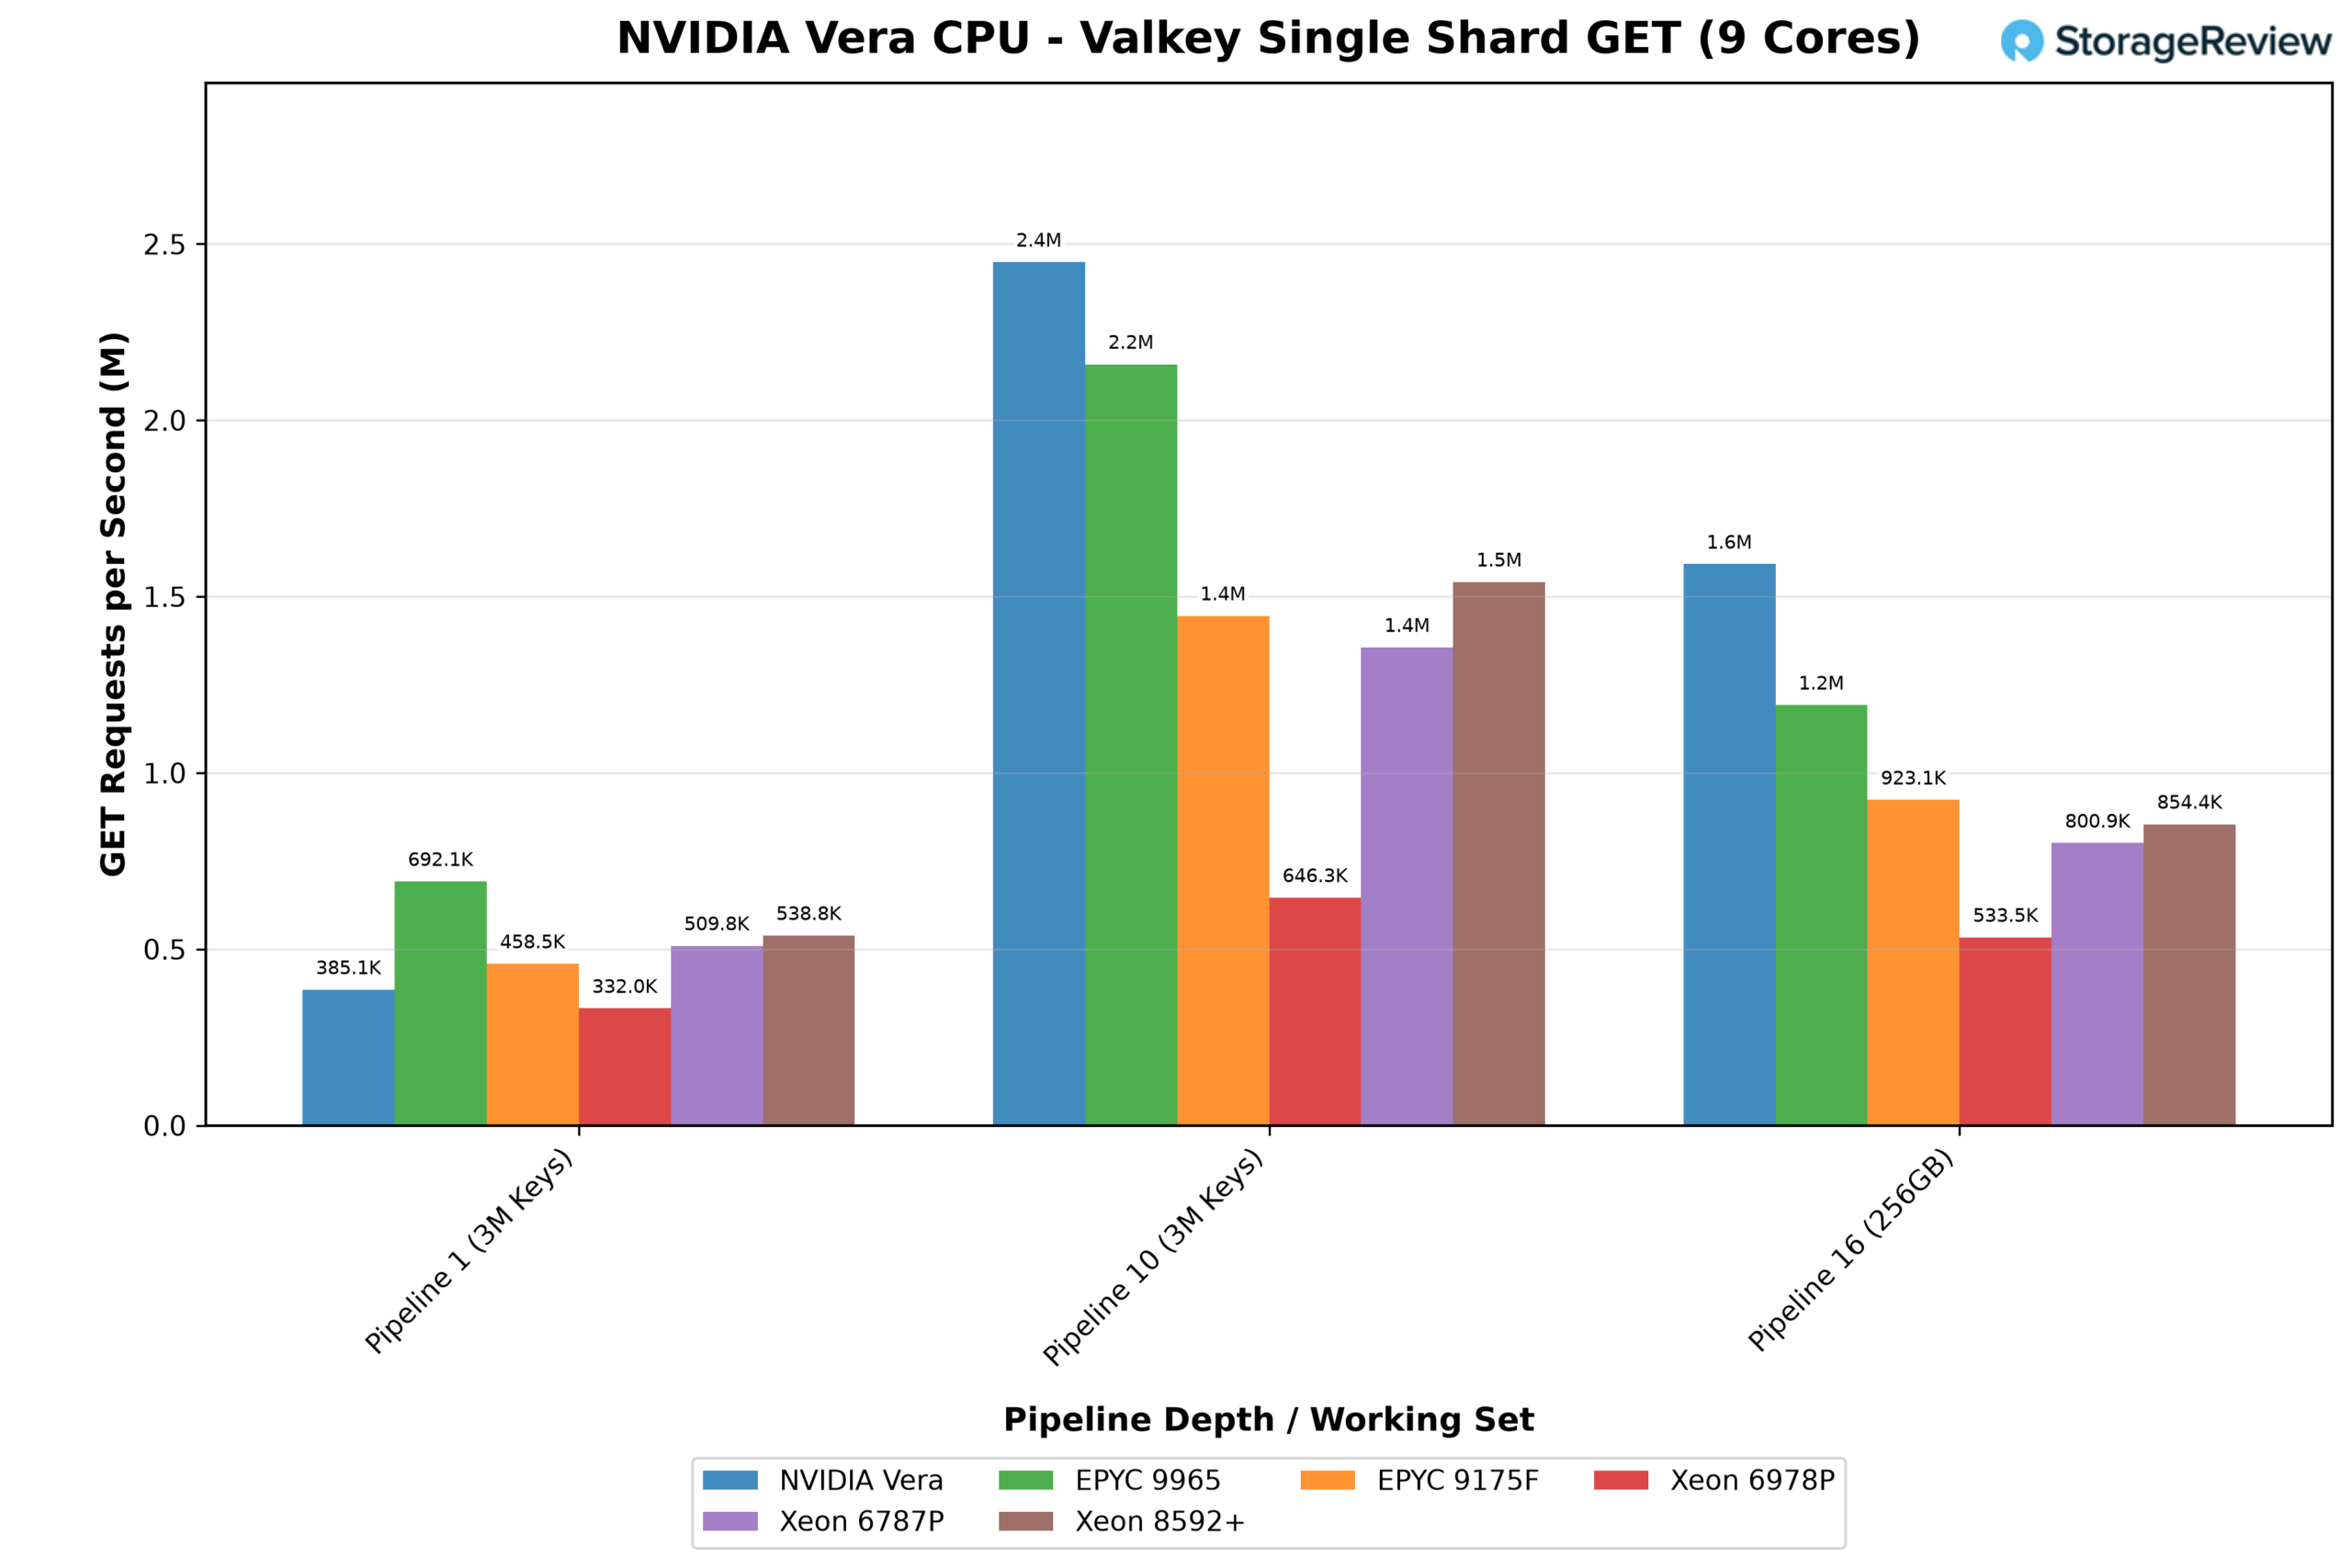
Il test a singolo shard assegna a un server Valkey nove core fisici su ogni piattaforma. Il server gestisce un dataset di 3 milioni di chiavi con richieste inviate una alla volta, poi in batch da 10, e infine gestisce un dataset di 256 GB, troppo grande per qualsiasi cache, in batch da 16. Ogni richiesta, inviata singolarmente, deve completare il suo round trip prima che la successiva venga inviata, ed è proprio in questo che Vera mostra le sue maggiori difficoltà. Il suo shard ha gestito 385,000 richieste GET al secondo, superando solo lo Xeon 6978P, mentre l'EPYC 9965 si è piazzato al primo posto con 692,000. Anche la latenza p99 di Vera è risultata superiore, pari a 1.76 ms contro 1.08 ms del 9965.
L'elaborazione in batch elimina gran parte del costo di andata e ritorno, e Vera si porta in testa. Con batch da 10, il suo shard ha gestito 2.45 milioni di richieste GET al secondo, il 13% in più rispetto al 9965 e ben al di sopra di ogni Xeon. Il set di dati da 256 GB ha ulteriormente ampliato il divario. Con quasi tutte le richieste indirizzate alla memoria, Vera ha gestito 1.59 milioni di richieste GET al secondo, il 34% in più rispetto al 9965, mentre il resto dei dispositivi si è attestato tra 0.53 milioni e 0.92 milioni. I risultati del test SET hanno seguito lo stesso andamento in entrambi i test.
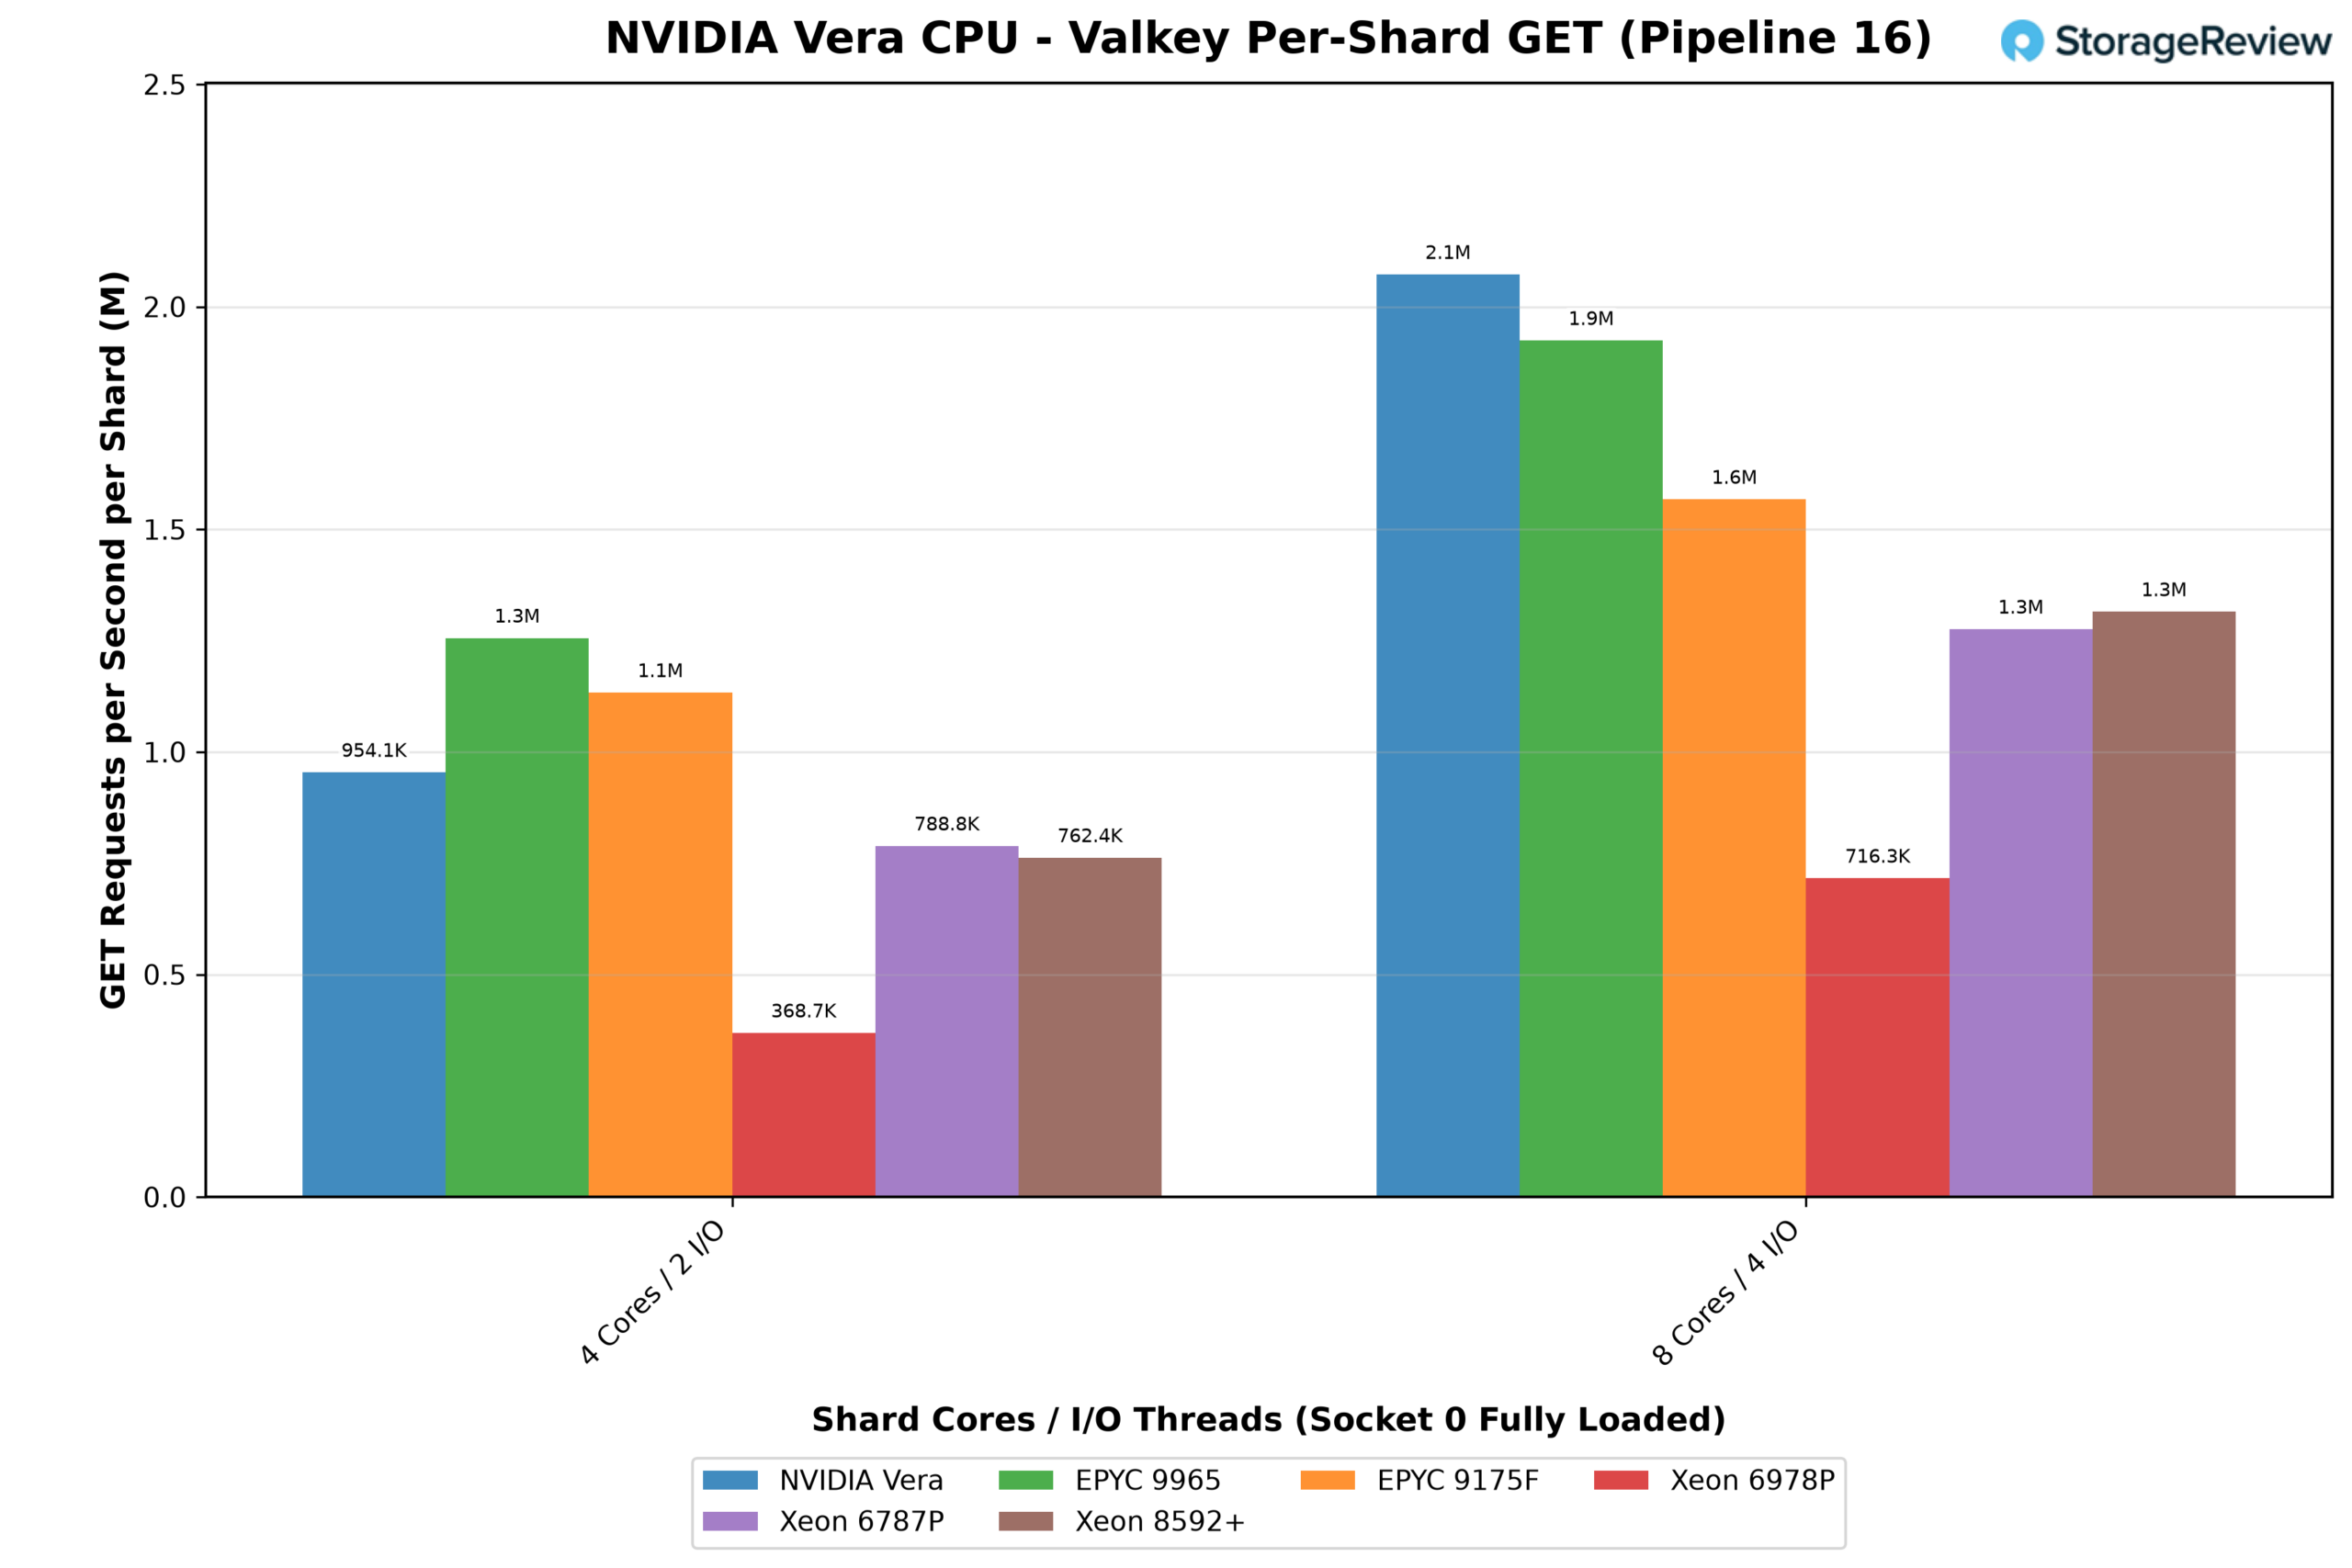
La modalità socket raggruppa il socket 0 in shard identici da quattro o otto core, che gestiscono il traffico simultaneamente, in modo più simile al funzionamento di un host Valkey dedicato. Con shard a 8 core e batch da 16, ogni shard Vera ha gestito 2.07 milioni di richieste GET al secondo, superando gli 1.92 milioni del 9965 e circa 1.6 volte le prestazioni dello Xeon 6787P e dell'8592+, sebbene la latenza p99 sia salita a 2.2 ms contro circa 0.5 ms del 9965.
Con shard più piccoli a 4 core, AMD ha avuto la meglio: il 9965 ha raggiunto 1.26 milioni di GET per shard contro gli 0.95 milioni di Vera, sebbene Vera fosse ancora in testa a tutti gli Xeon. Con le richieste inviate una alla volta, gli shard del 9965 sono risultati da 1.5 a 1.7 volte più veloci di quelli di Vera in entrambe le dimensioni, e anche il 6787P e l'8592+ hanno superato AMD con shard a 8 core.
La densità determina il numero totale di socket: un socket Vera ospita 11 shard da otto core e gestisce 22.8 milioni di richieste GET al secondo, mentre i 192 core del 9965 ospitano 48 shard da quattro core e ne gestiscono 60.3 milioni. Vera offre gli shard più veloci del nostro set quando ogni shard ha otto o più core e le richieste vengono raggruppate, ma il 9965 riesce a ospitare più del doppio degli shard in un singolo socket.
Single-Thread e Throughput
Valkey e ClickBench si basavano tanto sul sistema di memoria quanto sui core. Questa sezione si concentra sui core stessi e sui due obiettivi di Olympus descritti in precedenza: completare rapidamente le singole attività e mantenere tale velocità anche quando l'intero socket è occupato. 7-Zip, OpenSSL e Python vengono eseguiti ciascuno come un singolo thread assegnato a un core, mostrando cosa può fare un core Olympus da solo. 7-Zip e OpenSSL vengono quindi eseguiti nuovamente su tutti i thread del sistema, mostrando quanta di quella velocità per core si mantiene quando tutti i core competono per le stesse cache e la stessa memoria.
7-Zip
La compressione LZMA di 7-Zip è un codice intero con molte diramazioni e accessi alla memoria imprevedibili, il tipo di lavoro per cui sono stati progettati il front-end a 10 larghezze e il prefetcher grafico di Olympus.
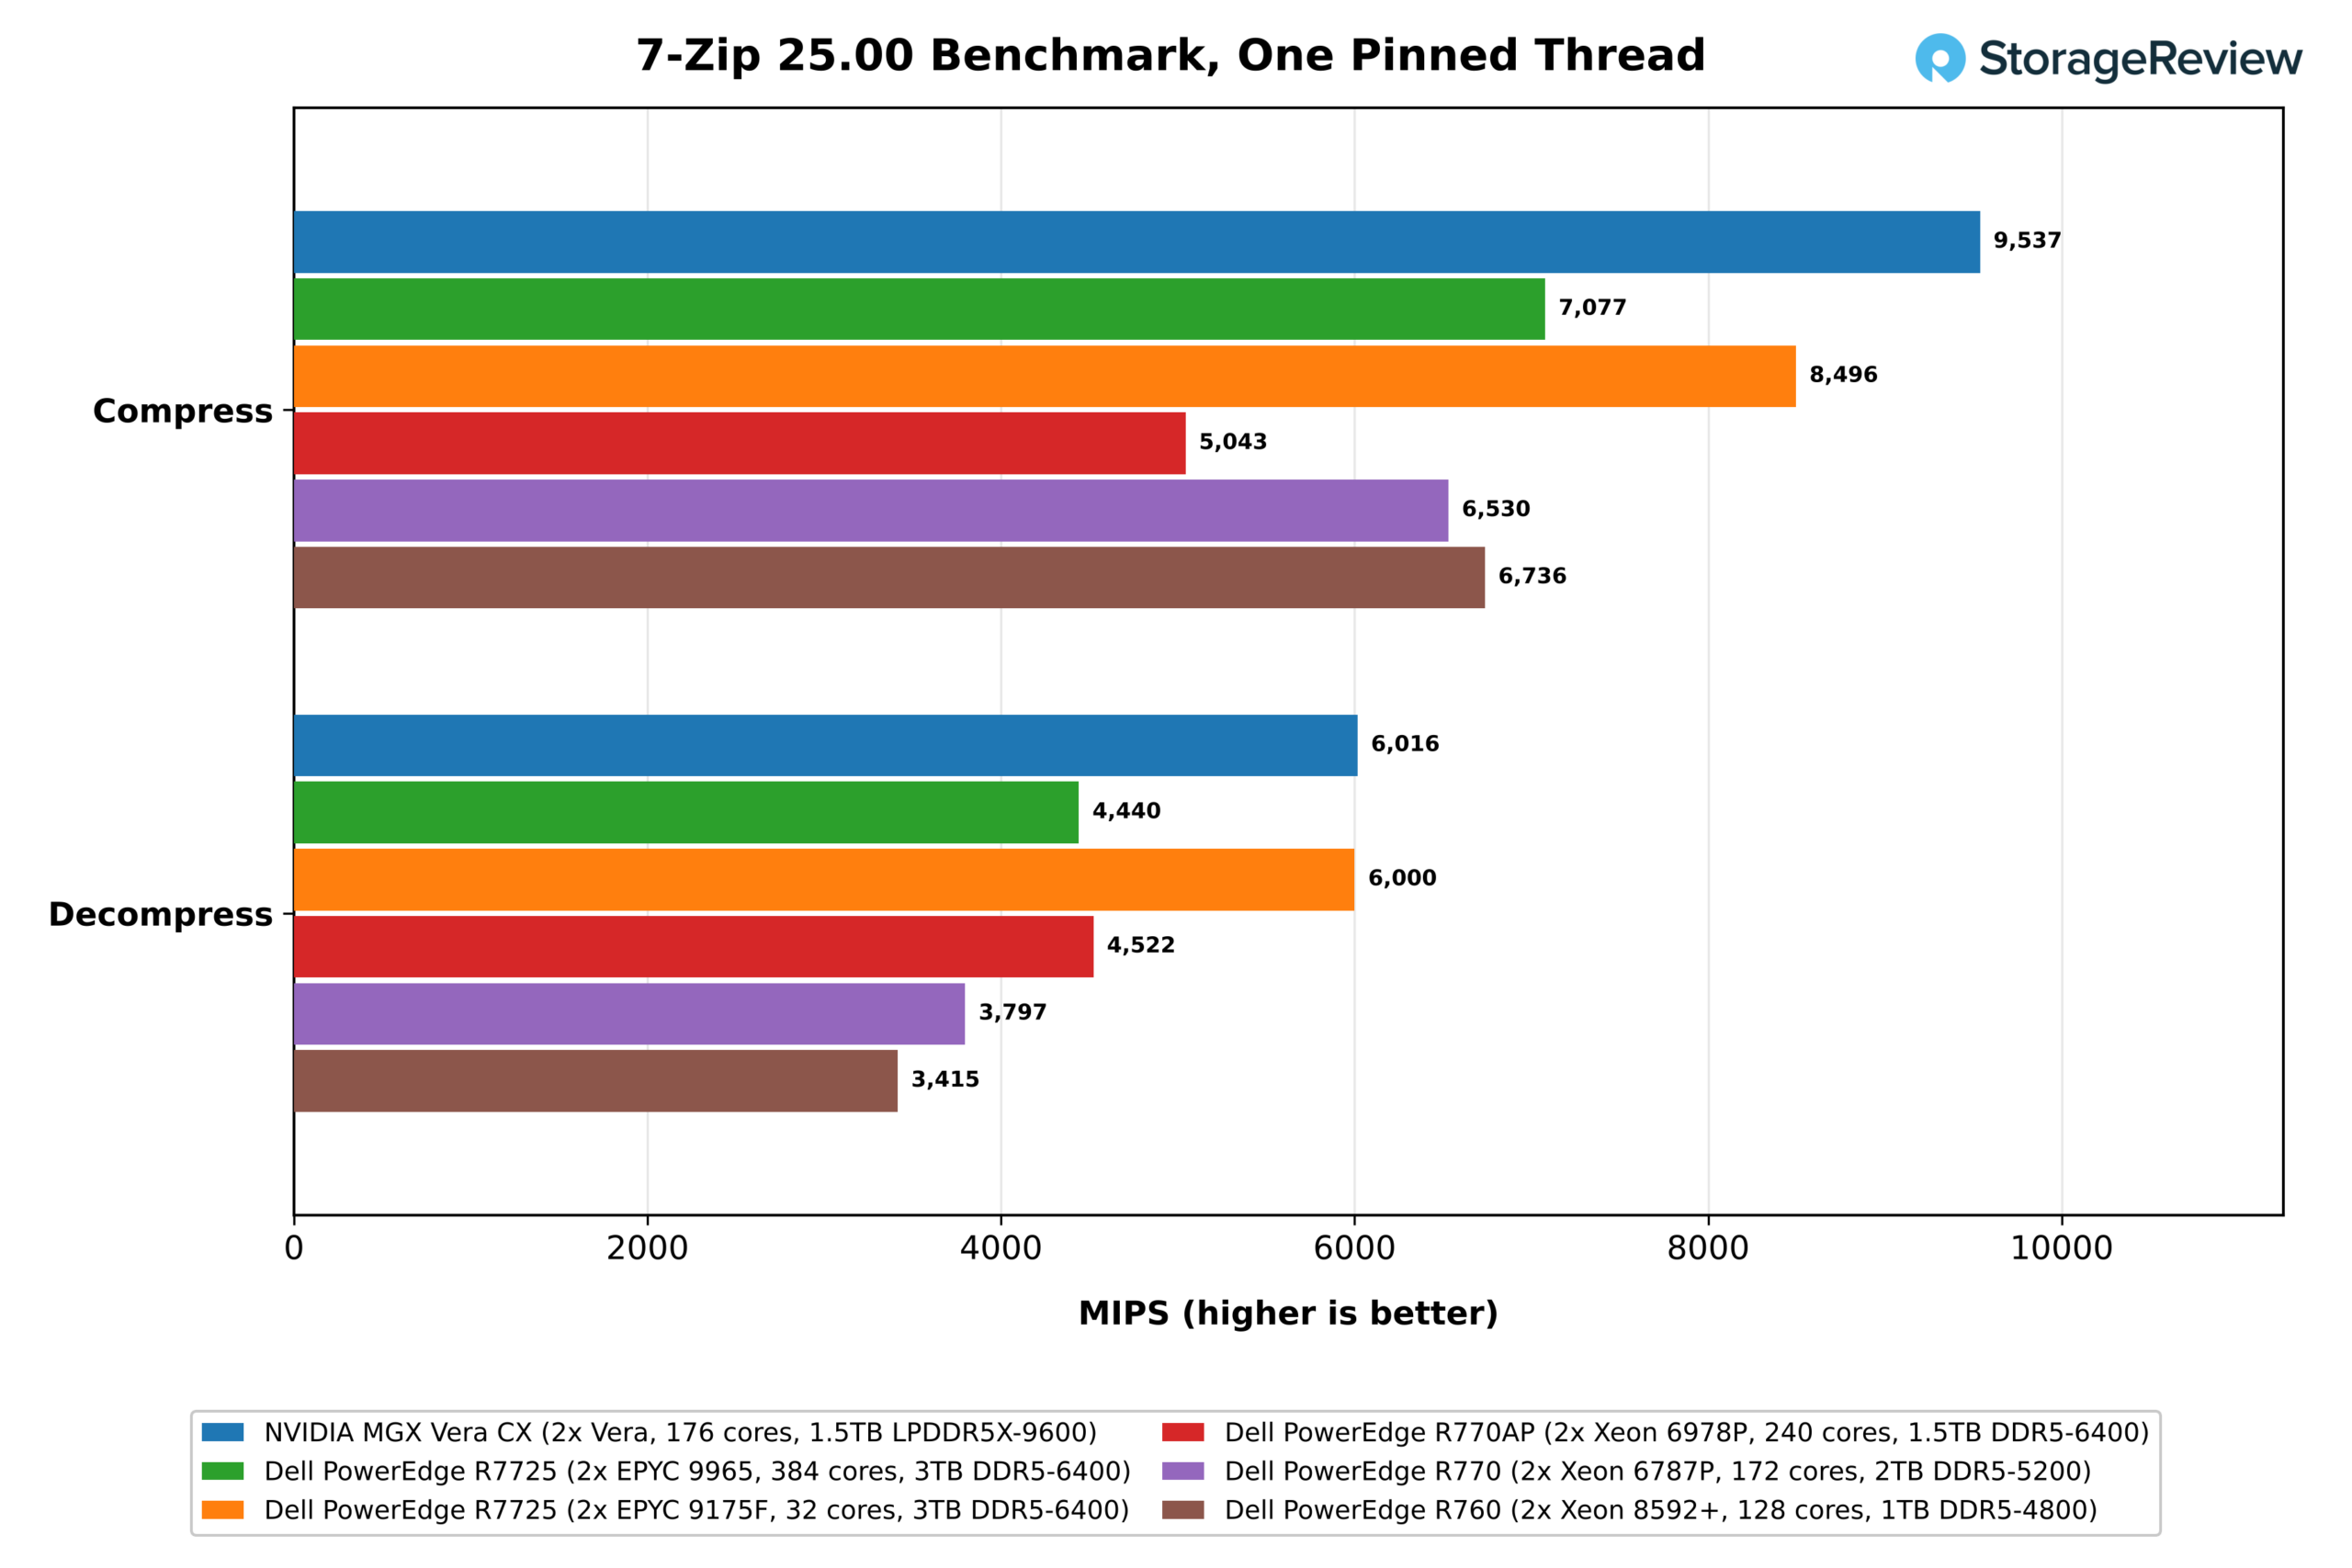
Su un singolo thread, Olympus è risultato il compressore più veloce del nostro set. Ha raggiunto 9,537 MIPS, il 12% in più rispetto all'EPYC 9175F a 5.0 GHz, il core x86 più veloce tra quelli testati, e nettamente superiore all'EPYC 9965 e a tutti i processori Xeon. La decompressione è stata praticamente identica per Vera: 6,016 MIPS per Vera e 6,000 per il 9175F, senza che nessun altro sistema si avvicinasse a meno del 20%.
Analizzando ogni singolo thread, si può osservare quanta parte di quel collegamento sopravvive quando l'intero sistema è occupato.
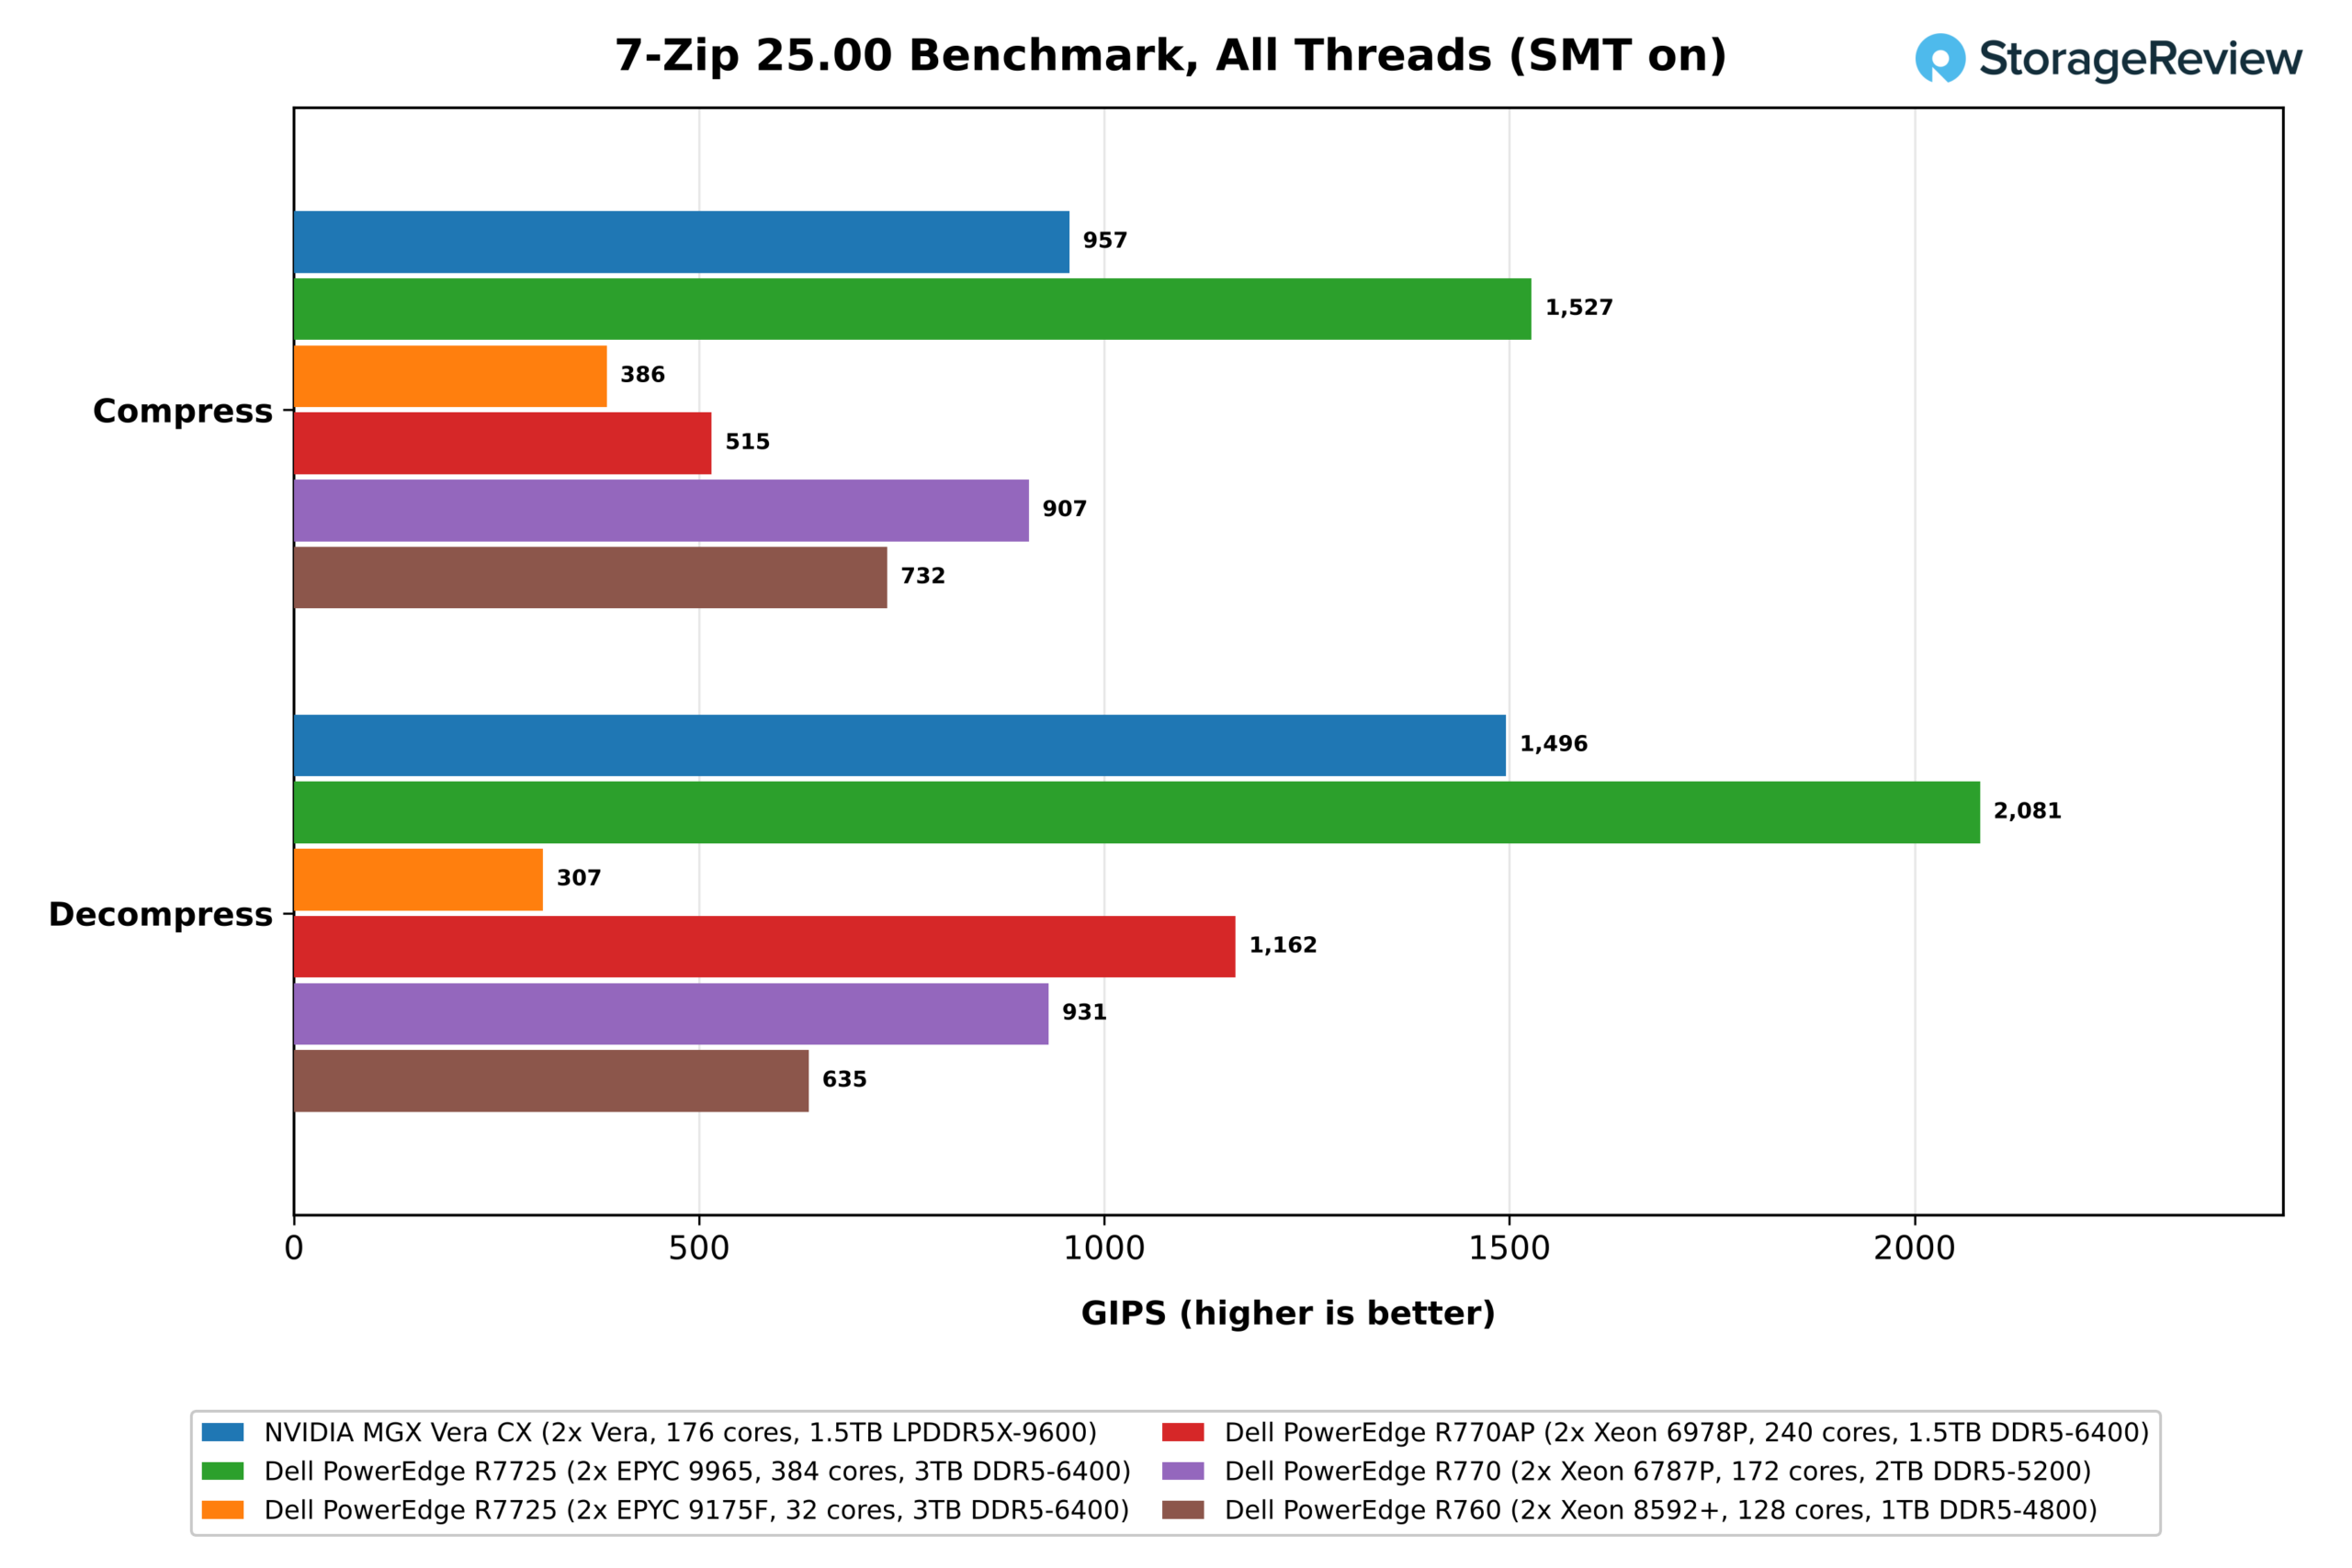
Con tutti i thread occupati, i 768 thread dell'EPYC 9965 si sono aggiudicati il primo posto con 1,527 GIPS in compressione e 2,081 GIPS in decompressione. I 352 thread di Vera si sono piazzati al secondo posto con 957 e 1,496 GIPS, davanti a tutti gli Xeon, con il 6787P più vicino a 907 e 931. Misurato per core fisico, Vera si comporta bene. I suoi 5.4 GIPS di compressione per core eguagliano il 6787P e l'8592+ e superano i 4.0 del 9965, e i suoi 8.5 GIPS di decompressione per core sono superiori del 57% rispetto al 9965 e superano tutti gli Xeon. Solo il 9175F a 32 core, con molti meno core che condividono cache e memoria di ciascun socket, ha fatto di più per core in entrambi i casi.
OpenSSL
Il test AES-256-GCM di OpenSSL è il punto debole di Vera. Solo due delle sei pipeline SVE2 a 128 bit di Olympus possono eseguire istruzioni crittografiche, mentre le architetture x86 possono eseguire AES su registri a 512 bit con VAES.
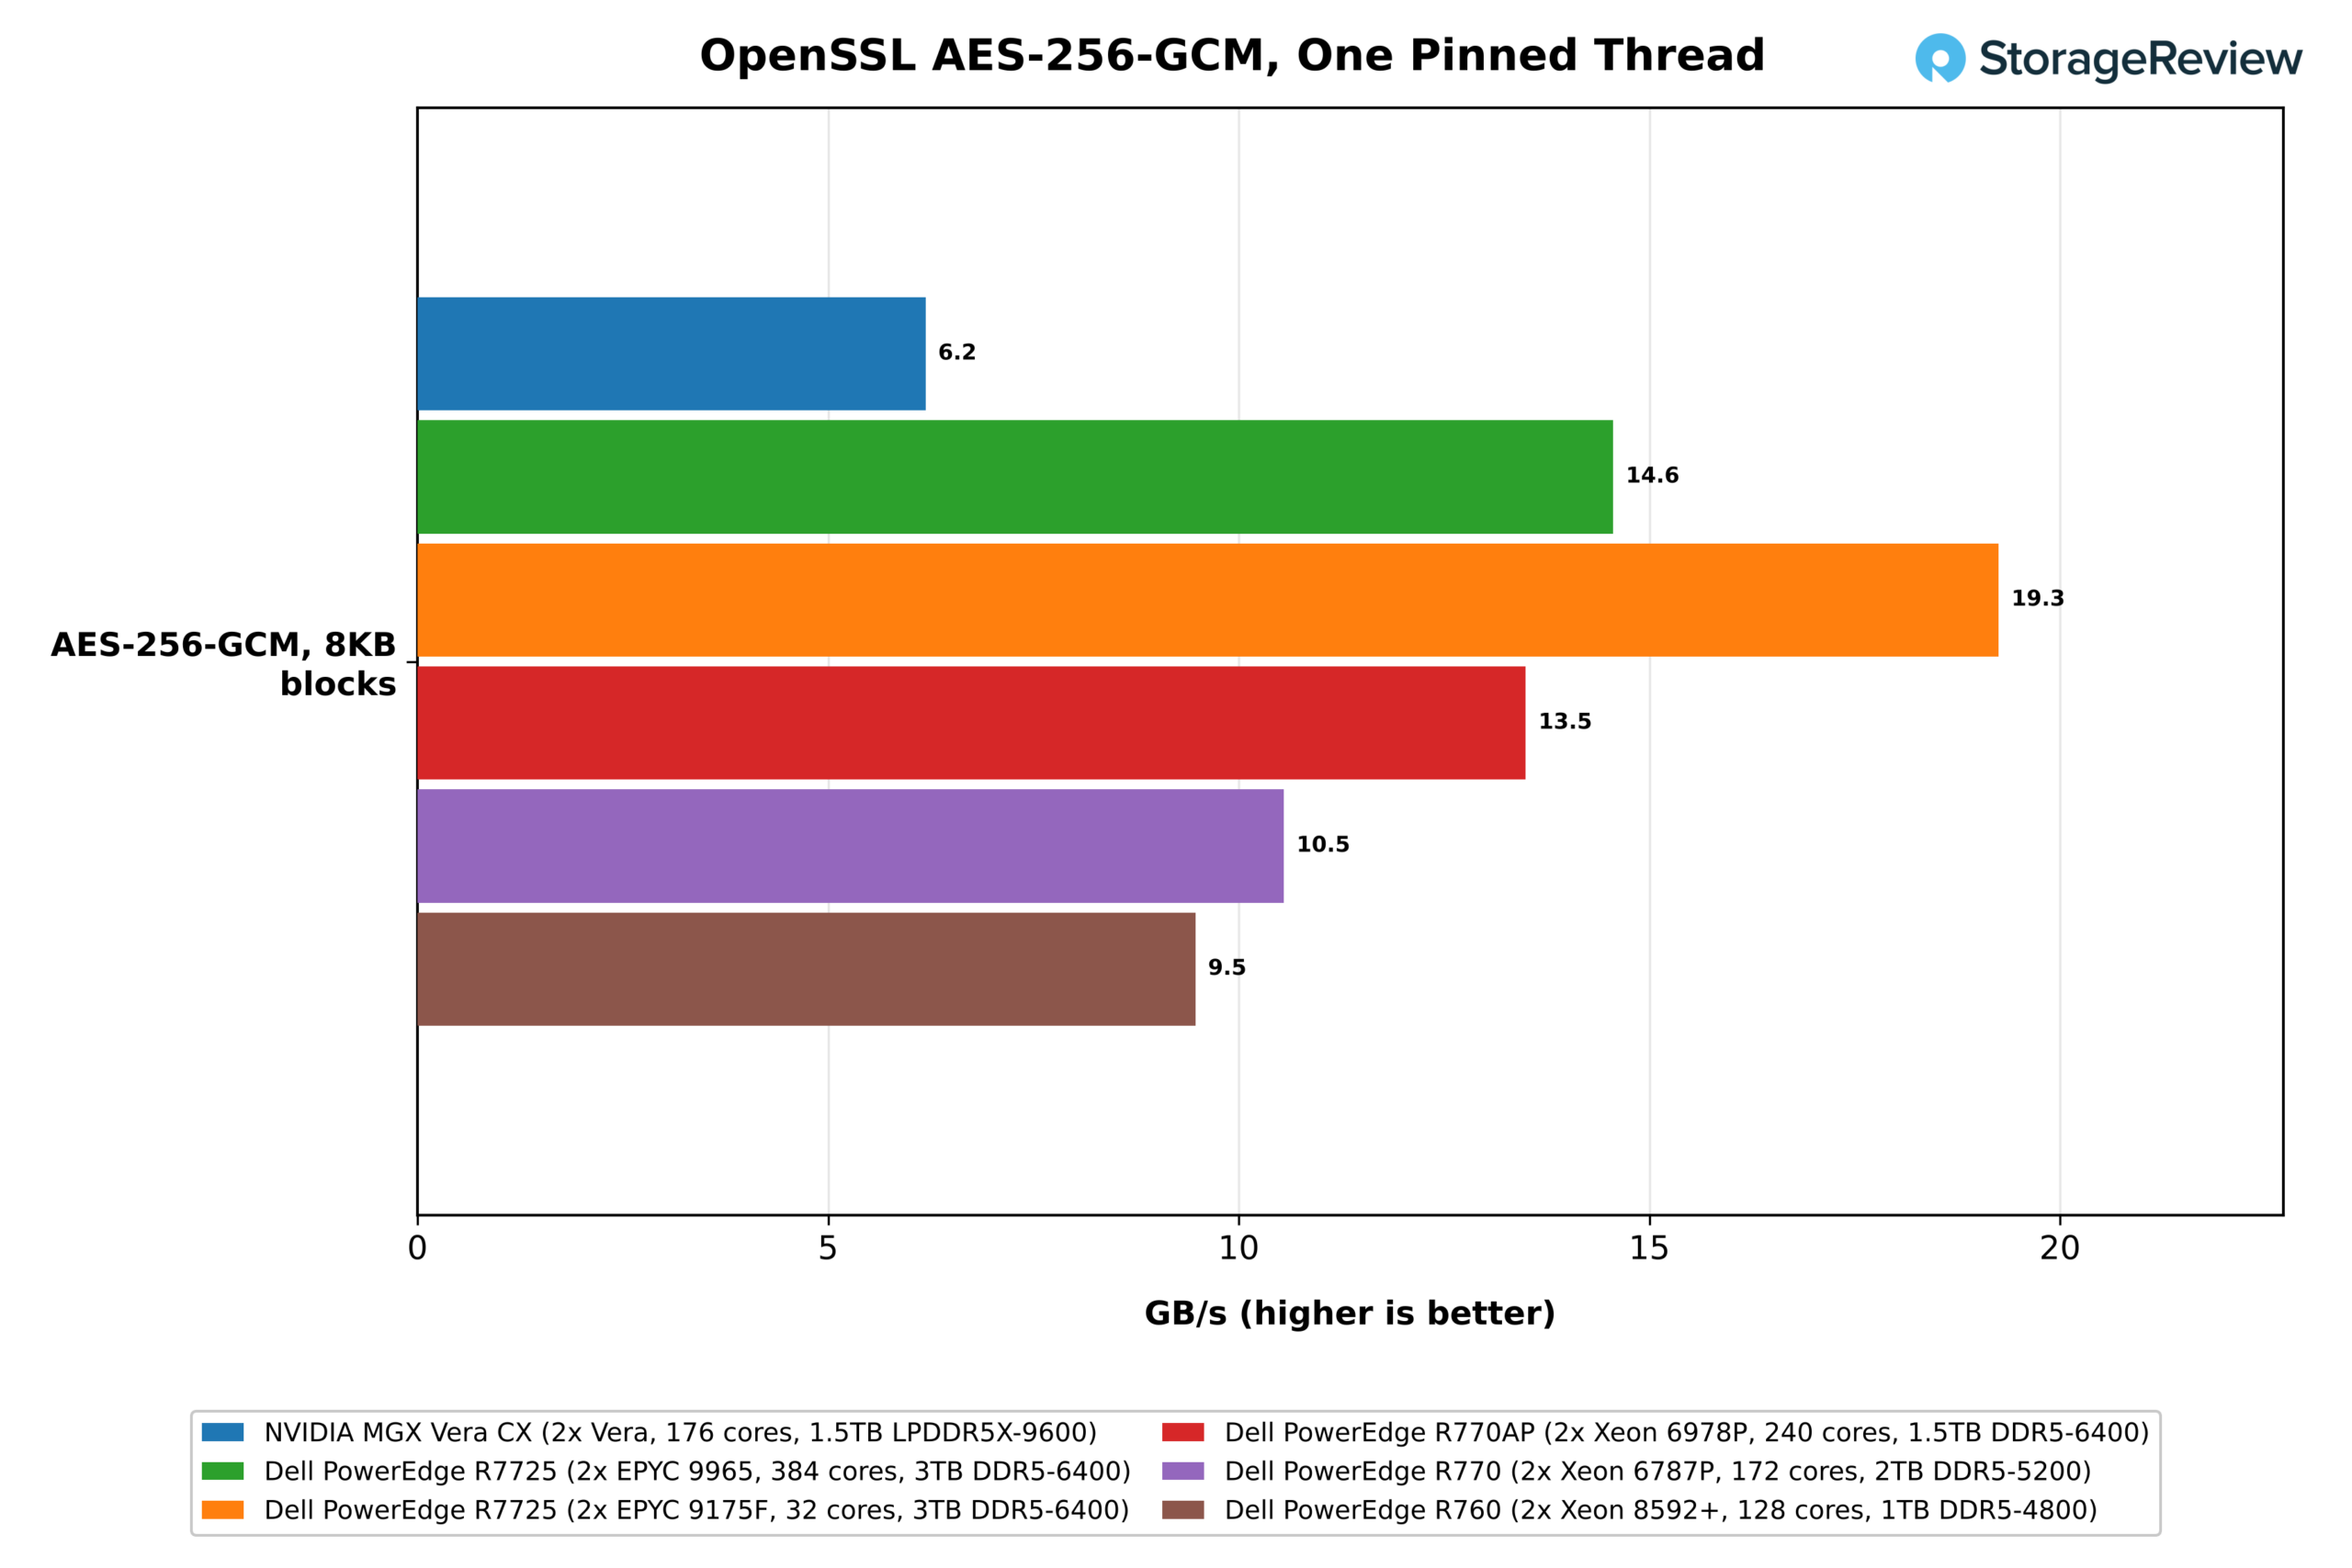
La differenza è più evidente su un singolo thread. Un core Olympus crittografa a 6.2 GB/s, circa un terzo dei 19.3 GB/s dell'EPYC 9175F, e ben al di sotto dell'EPYC 9965 a 14.6 GB/s e dello Xeon 6978P a 13.5 GB/s.
In ogni thread, i sistemi x86 si allineano in base al numero di core, il che mostra dove il deficit per core incide su Vera.
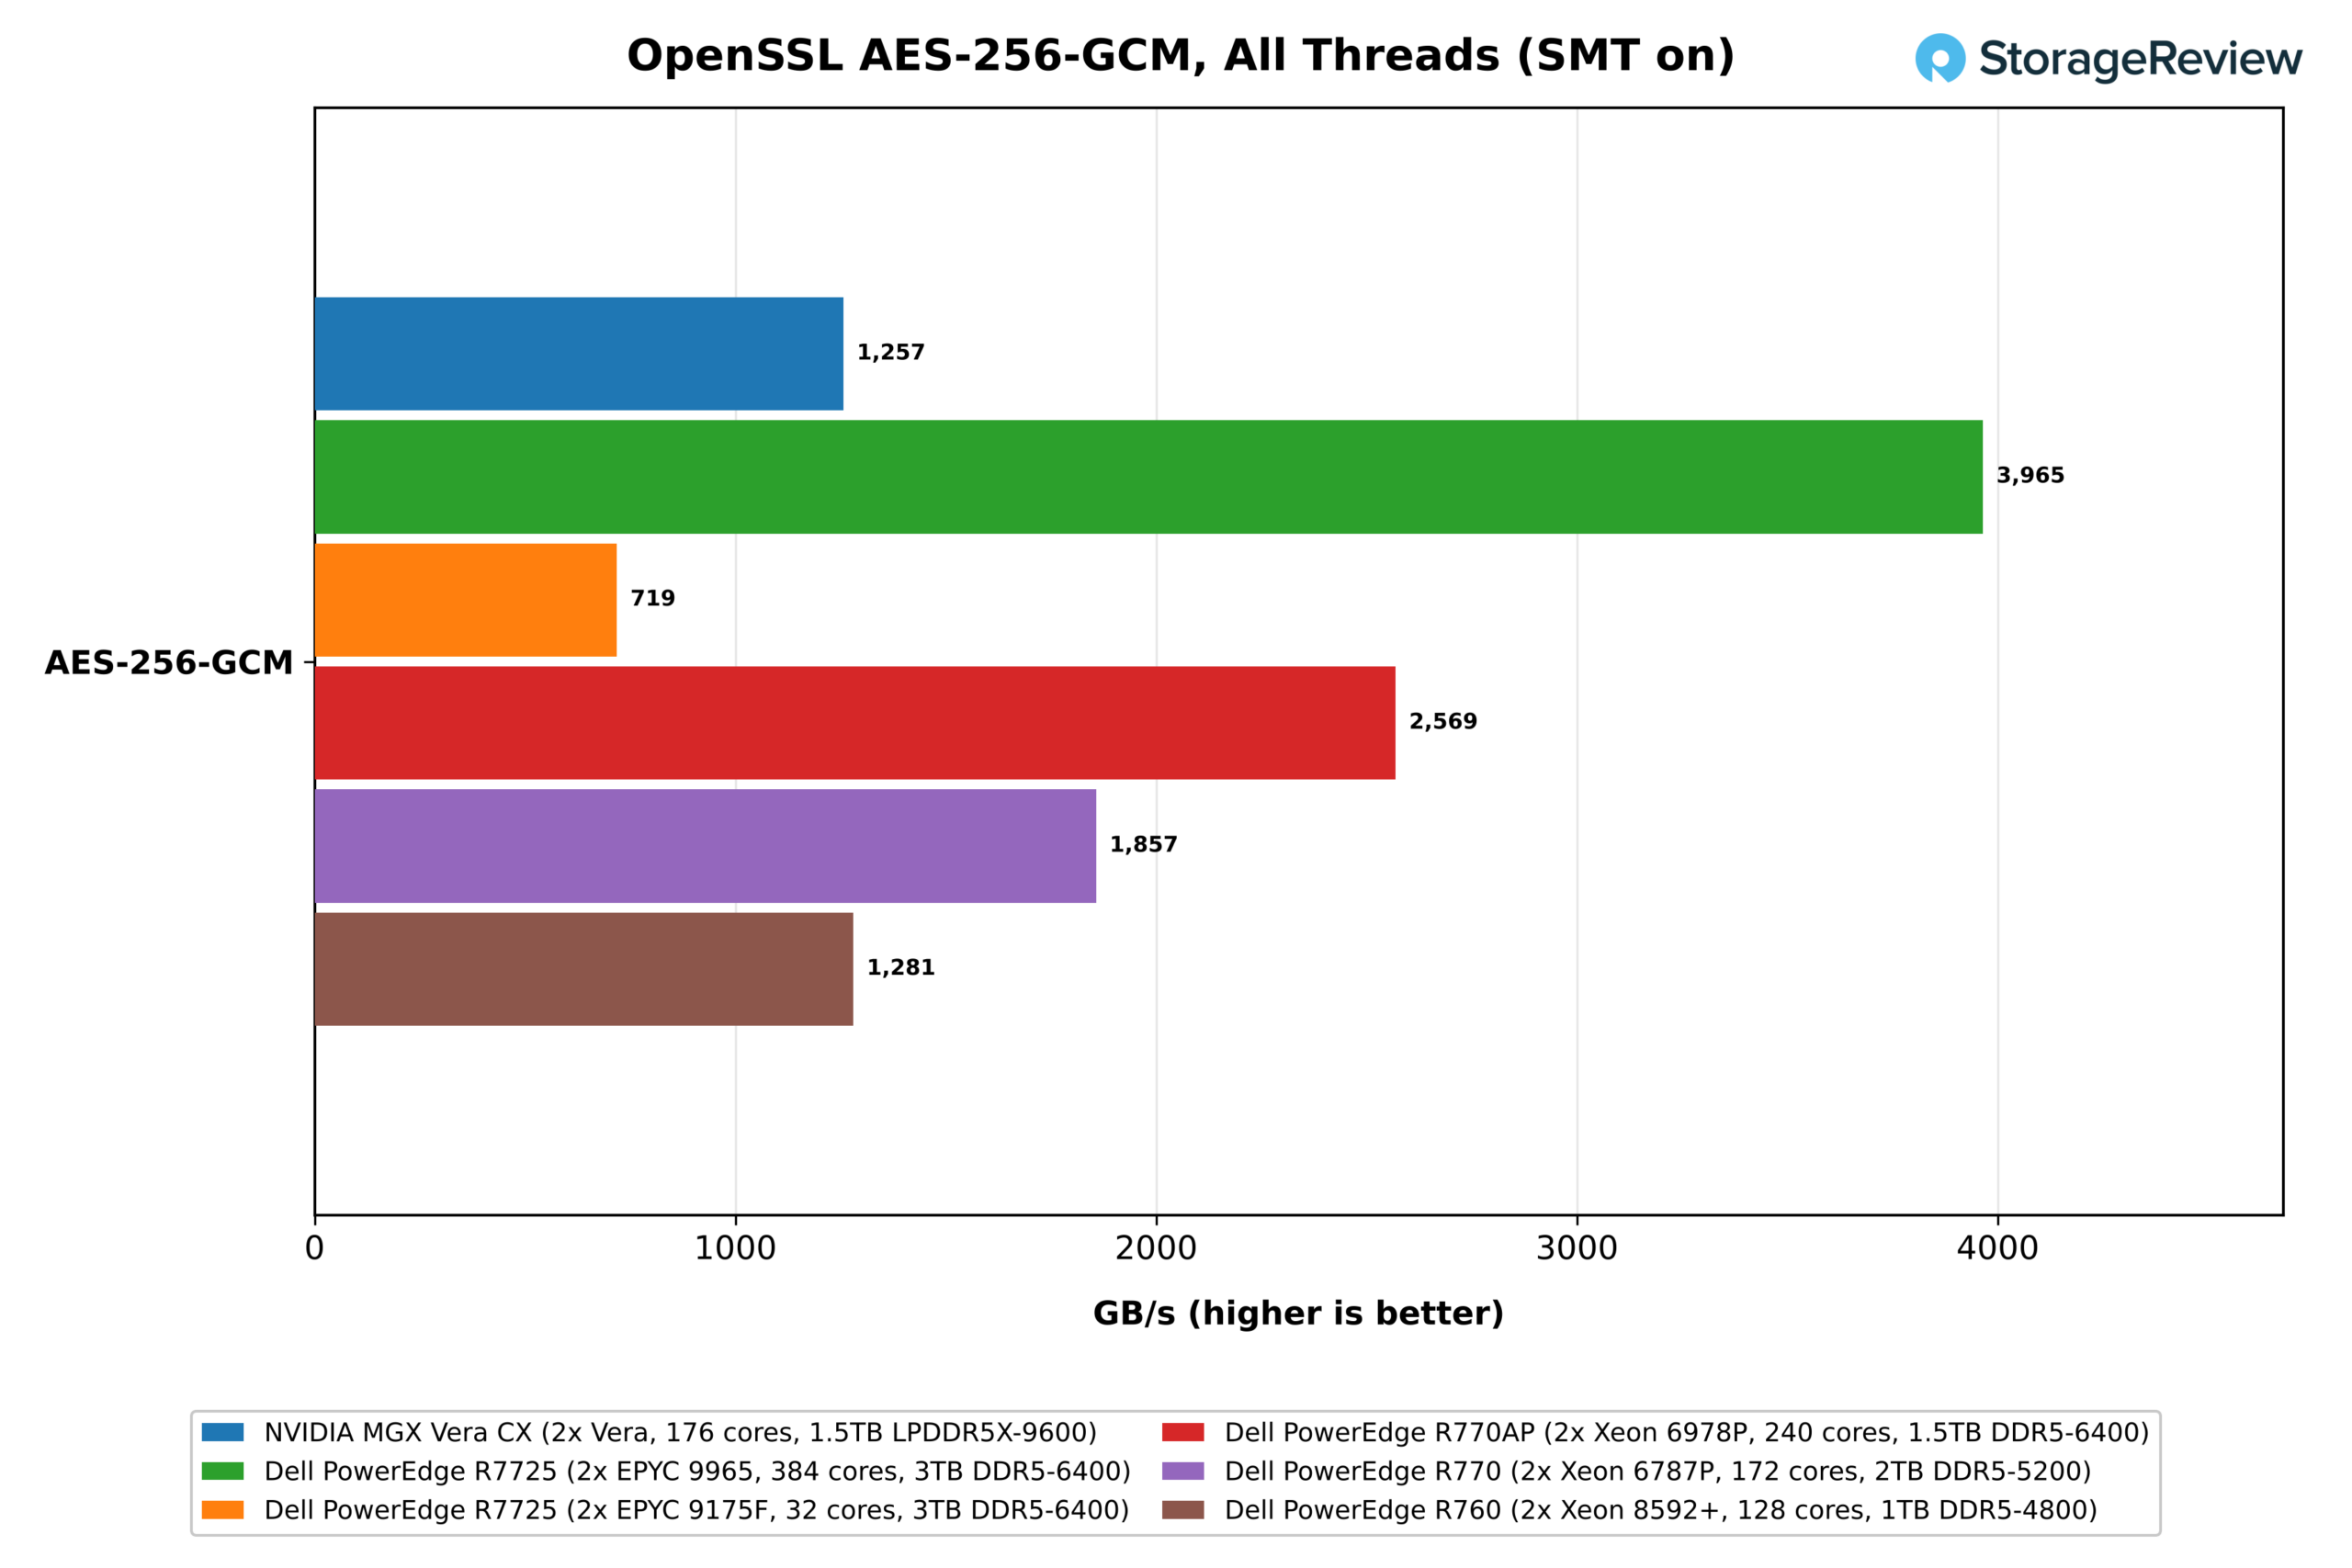
Con tutti i 352 thread occupati, Vera ha raggiunto 1.26 TB/s, pari a quello dello Xeon 8592+ a 128 core (1.28 TB/s) e superiore solo all'EPYC 9175F a 32 core. L'EPYC 9965 si è piazzato al primo posto con 3.96 TB/s, circa il triplo del risultato di Vera, seguito dallo Xeon 6978P a 2.57 TB/s e dal 6787P a 1.86 TB/s.
Python
Python è fondamentale per le sandbox degli agenti che NVIDIA sta prendendo di mira con Vera, e pyperformance ci fornisce tre test single-thread bloccati: go, una ricerca ad albero di gioco con un elevato utilizzo di oggetti; regex_compile, che compila espressioni regolari; e nbody, una simulazione fisica in virgola mobile. C'è una differenza a livello software: Vera utilizzava Python 3.14.4 di Ubuntu 26.04, mentre i sistemi x86 utilizzavano la versione 3.12.3 di Ubuntu 24.04, e quest'ultima versione offre miglioramenti in termini di velocità dell'interprete.
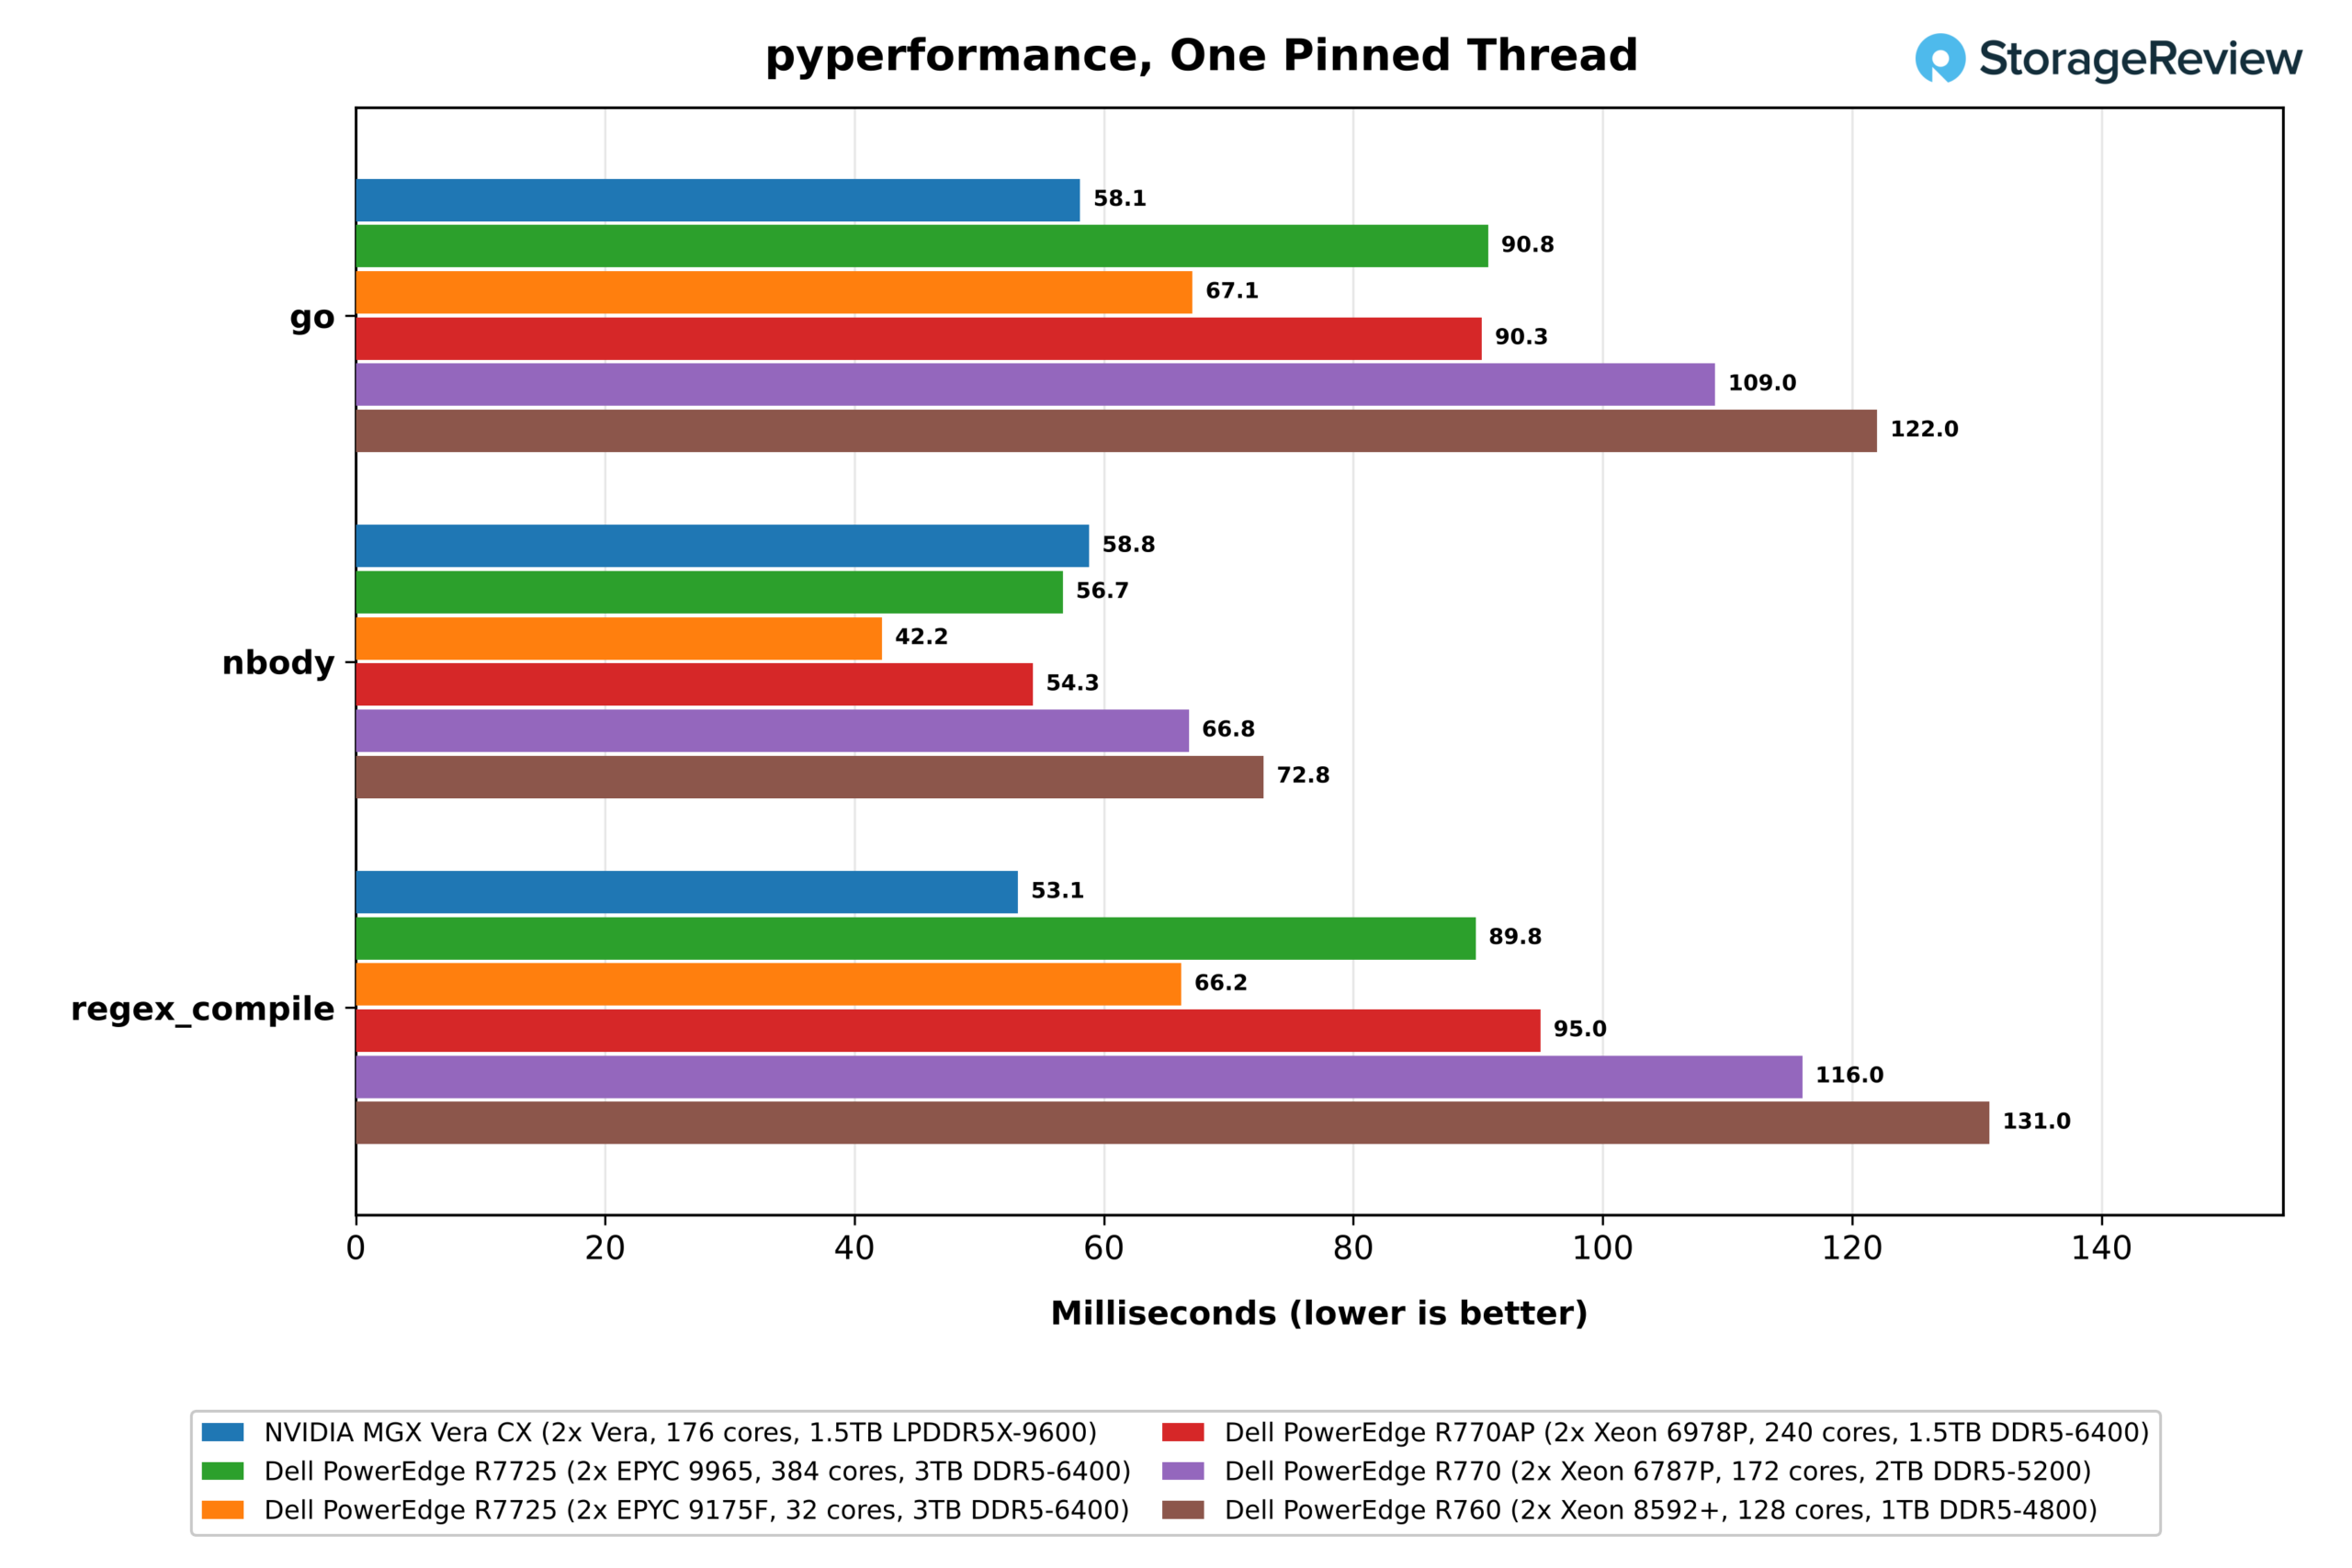
Vera ha vinto i due test basati su codice ramificato e ricco di oggetti. go ha completato l'esecuzione in 58.1 ms, il 15% più veloce dell'EPYC 9175F, il core x86 più veloce tra quelli testati, e da 1.6 a 2.1 volte più veloce rispetto agli altri. regex_compile ha mostrato un margine più ampio, terminando in 53.1 ms, il 25% più veloce del 9175F e 1.7 volte più veloce dell'EPYC 9965. Poiché Vera utilizzava anche la versione più recente di Python, entrambi i margini vanno interpretati come limiti superiori.
nbody ha preso la direzione opposta, poiché il suo breve ciclo in virgola mobile e il piccolo working set tendono a favorire le alte frequenze, e il 9175F a 5.0 GHz ha vinto con 42.2 ms, il 39% più veloce dei 58.8 ms di Vera. Anche lo Xeon 6978P e l'EPYC 9965 hanno superato Vera, con 54.3 ms e 56.7 ms, persino con il Python più recente di Vera.
Latenza di Web Server, JVM e Scheduler
L'ultimo gruppo di test di carico riguarda il software che circonda un'applicazione: lo stack web, la macchina virtuale Java, lo scheduler Linux e la toolchain del compilatore. Questi risultati dipendono tanto dal numero di thread in esecuzione in ciascun sistema quanto dalla velocità di ciascun core, quindi dicono meno su Olympus in sé rispetto alle sezioni precedenti, ma mostrano come si comporta un server Vera con il software server di uso comune.
Nginx
NGINX gestisce le richieste HTTPS indirizzandole al generatore di carico wrk in esecuzione sulla stessa macchina, in modo che client e server competano per gli stessi core, e il risultato riflette maggiormente lo stack TLS e HTTP piuttosto che il semplice conteggio dei core.
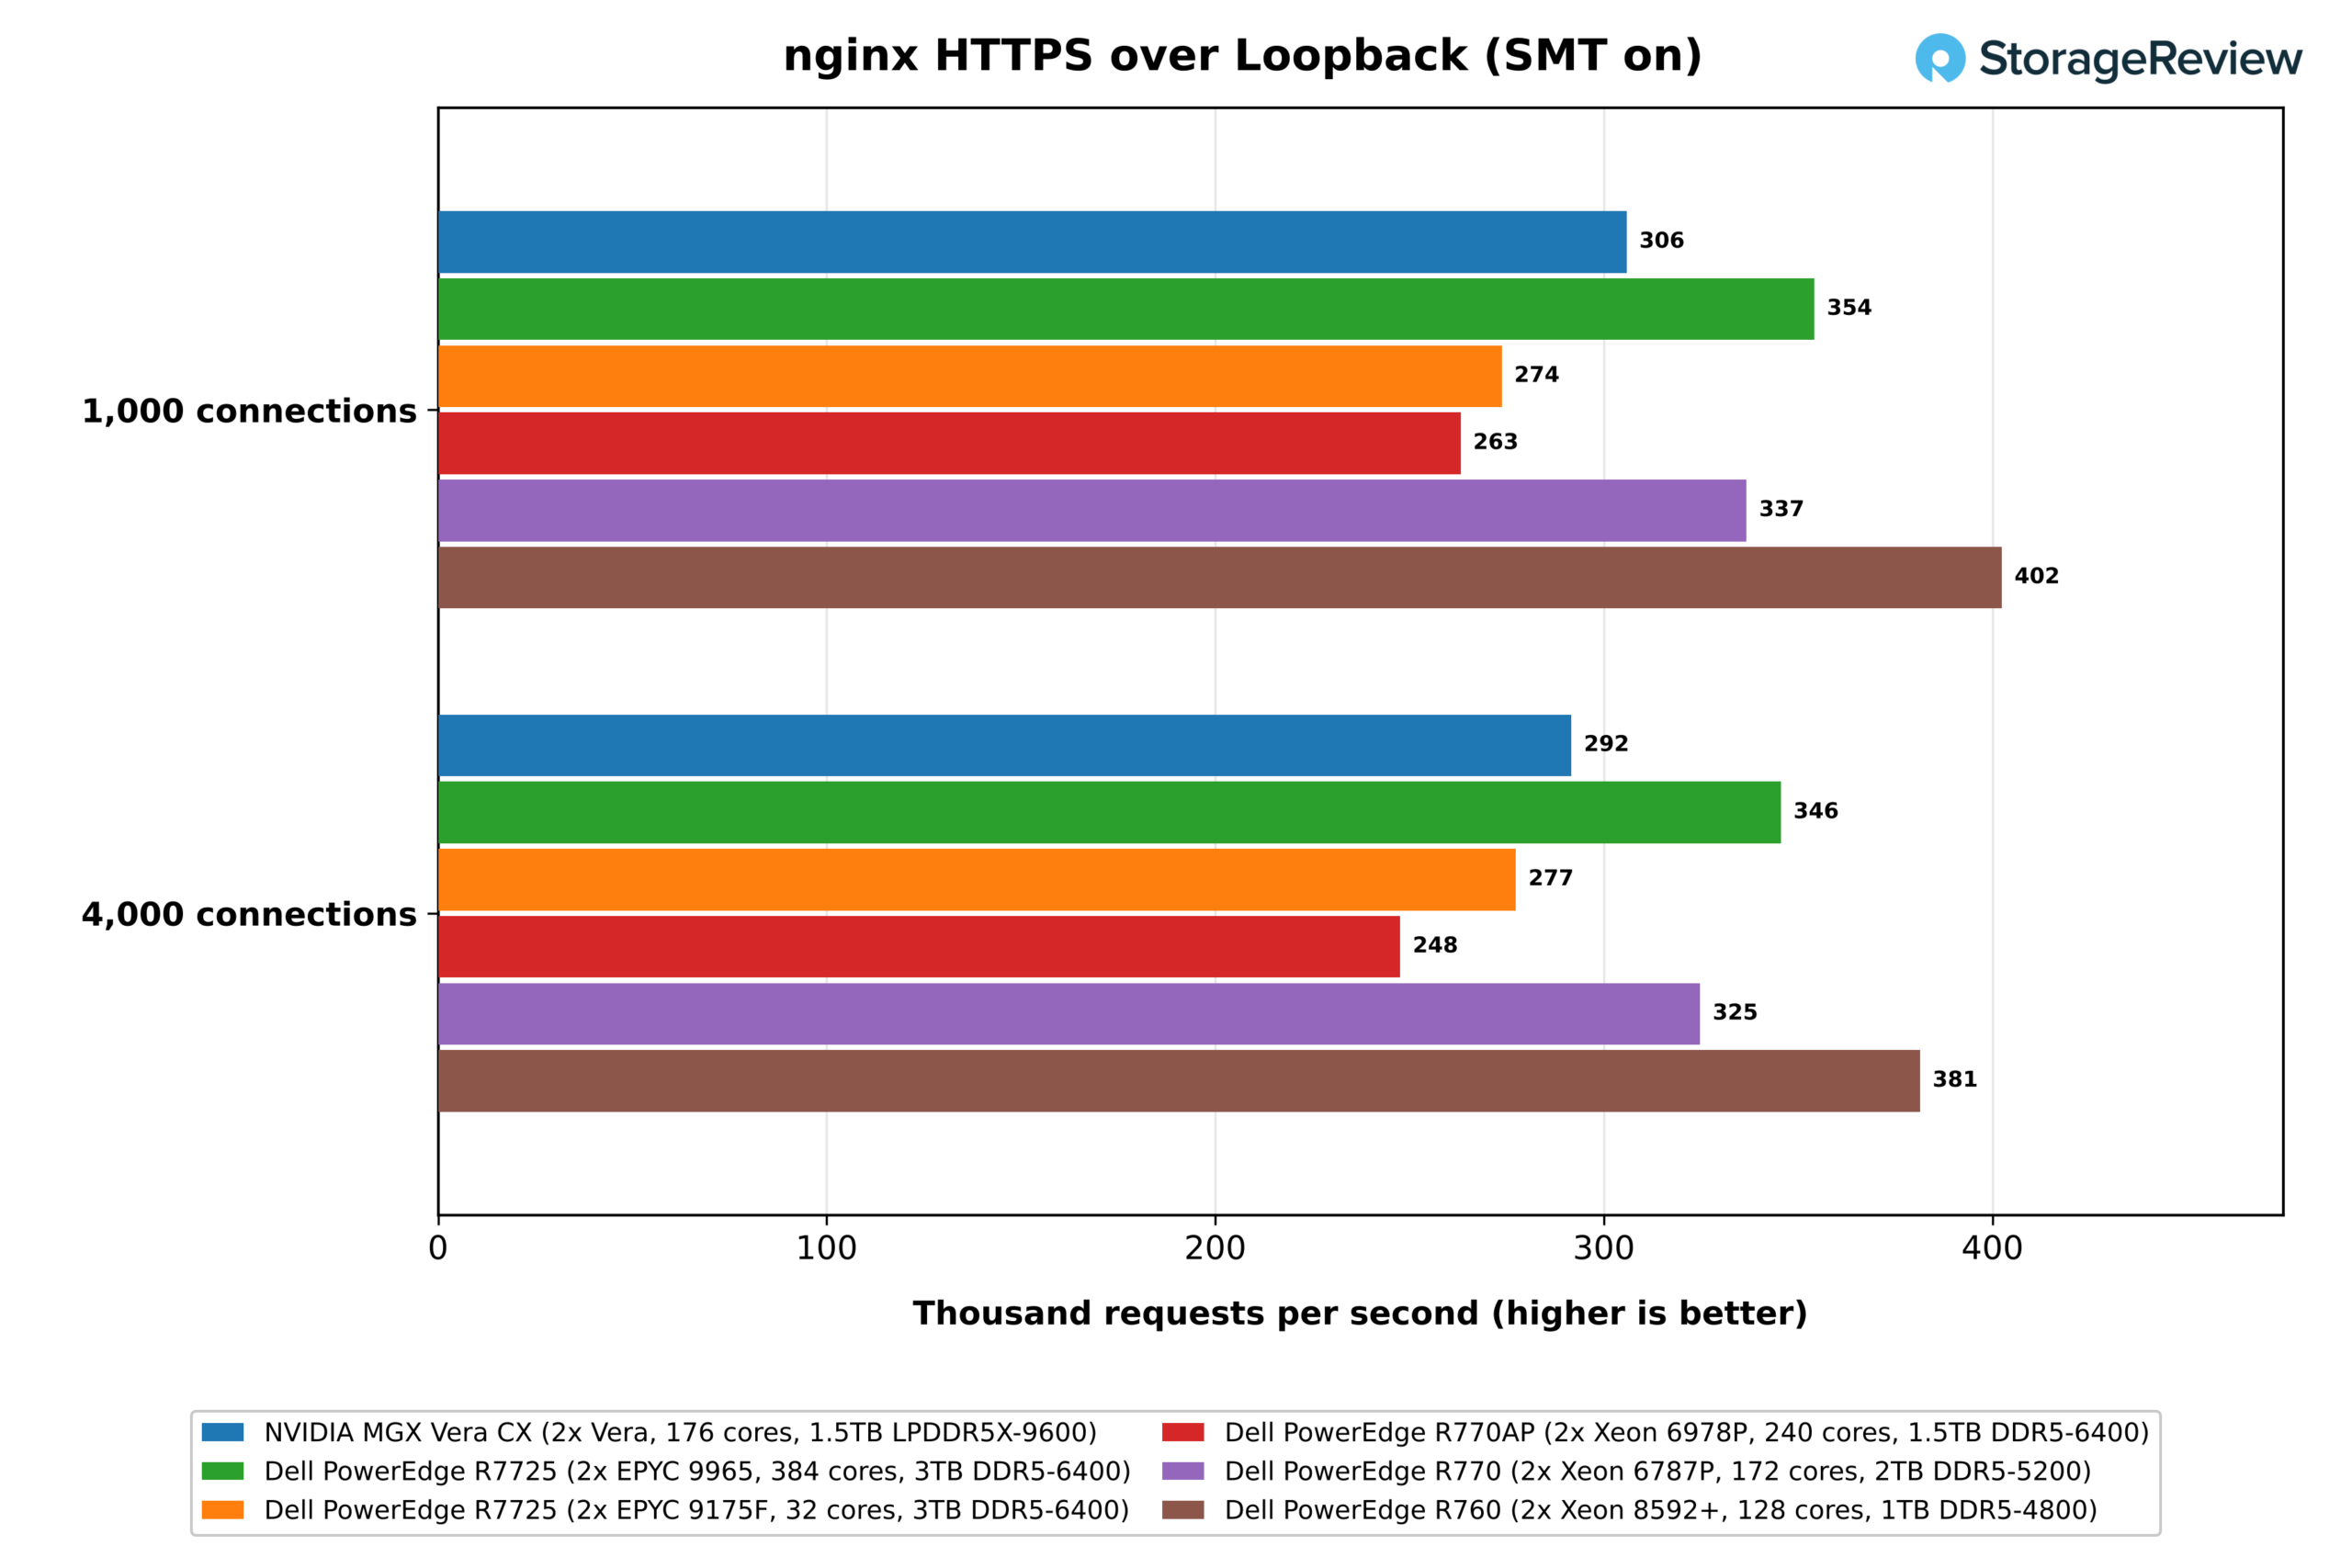
Con SMT attivo, Vera ha gestito 306,000 richieste al secondo con 1,000 connessioni e 292,000 con 4,000, posizionandosi a metà di un gruppo che andava da 263,000 sul Xeon 6978P a 402,000 sul Xeon 8592+. L'EPYC 9965 ha raggiunto 354,000 e lo Xeon 6787P 337,000, mentre disattivando SMT Vera è salita a 330,000. Lo stack di rete di Vera si colloca agevolmente accanto ai sistemi x86.
Rinascimento
Renaissance esegue carichi di lavoro Java su OpenJDK 11. Il suo test HTTP Finagle mette alla prova uno stack di rete Scala, mentre il suo test Akka un framework di concorrenza basato su modello ad attori. Entrambi distribuiscono il lavoro su ogni CPU logica visibile alla JVM, quindi li abbiamo eseguiti sia con SMT attivo che disattivo.
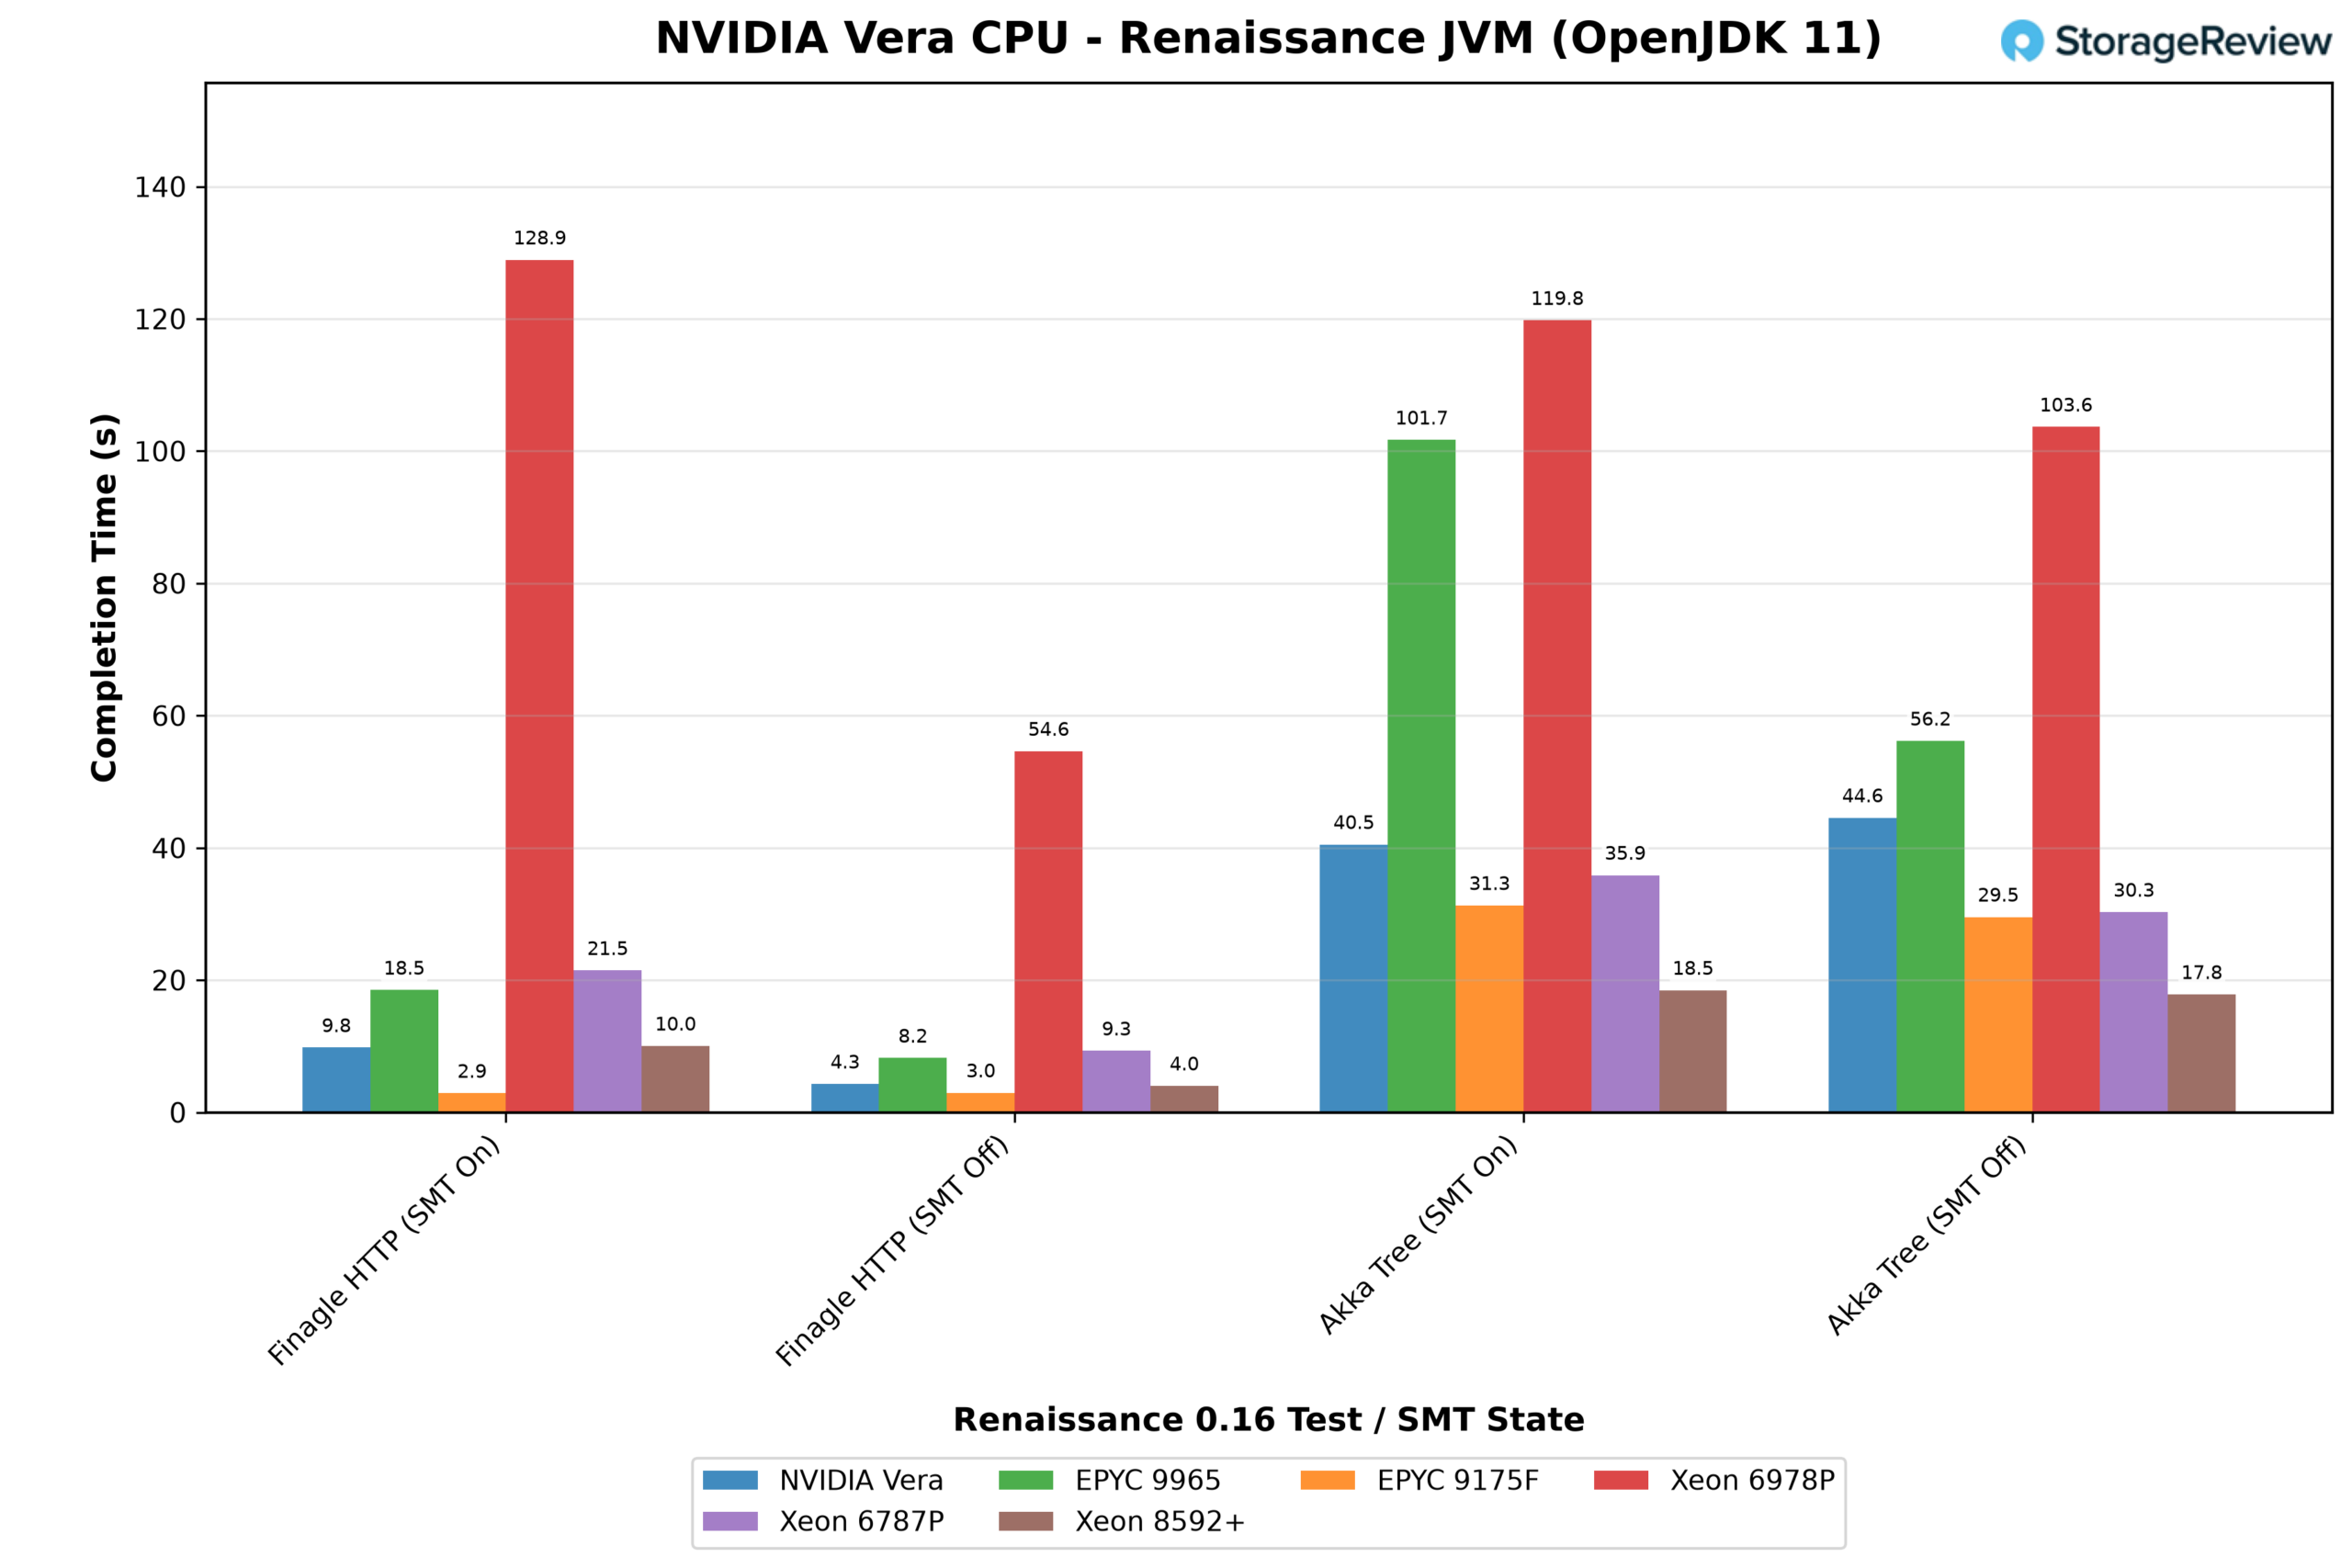
Finagle è più veloce con un numero inferiore di thread. Disattivando SMT, che dimezza il numero di thread, il tempo di Vera è sceso da 9.8 a 4.3 secondi, e i sistemi x86 più potenti hanno registrato un miglioramento simile, da 2.3 a 2.5 volte. L'EPYC 9175F a 32 core, con pochi thread già di per sé, ha comunque ottenuto un tempo di circa 3 secondi, risultando il migliore in entrambi i casi.
Akka ha favorito lo Xeon 8592+, che ha completato il test in circa 18 secondi con SMT attivo o disattivo, mentre Vera ha impiegato 40.5 secondi con SMT attivo e i due sistemi più potenti, l'EPYC 9965 e lo Xeon 6978P, sono risultati i più lenti con rispettivamente 101.7 e 119.8 secondi. Il terzo test di Renaissance, basato su un algoritmo genetico, ha completato il test in un intervallo di tempo compreso tra 1.6 e 2.6 secondi con SMT attivo su tutti i sistemi tranne il 6978P, con Vera a 2.6 secondi.
schbench
schbench misura la velocità con cui lo scheduler di Linux risveglia i thread di lavoro, eseguendo circa un worker per CPU logica con 4 thread di messaggi e circa otto per CPU con 32. Poiché il numero di worker aumenta con il sistema, i server più grandi svolgono più lavoro, quindi questi risultati descrivono la latenza a pieno carico su ciascuna macchina e non costituiscono un confronto diretto.
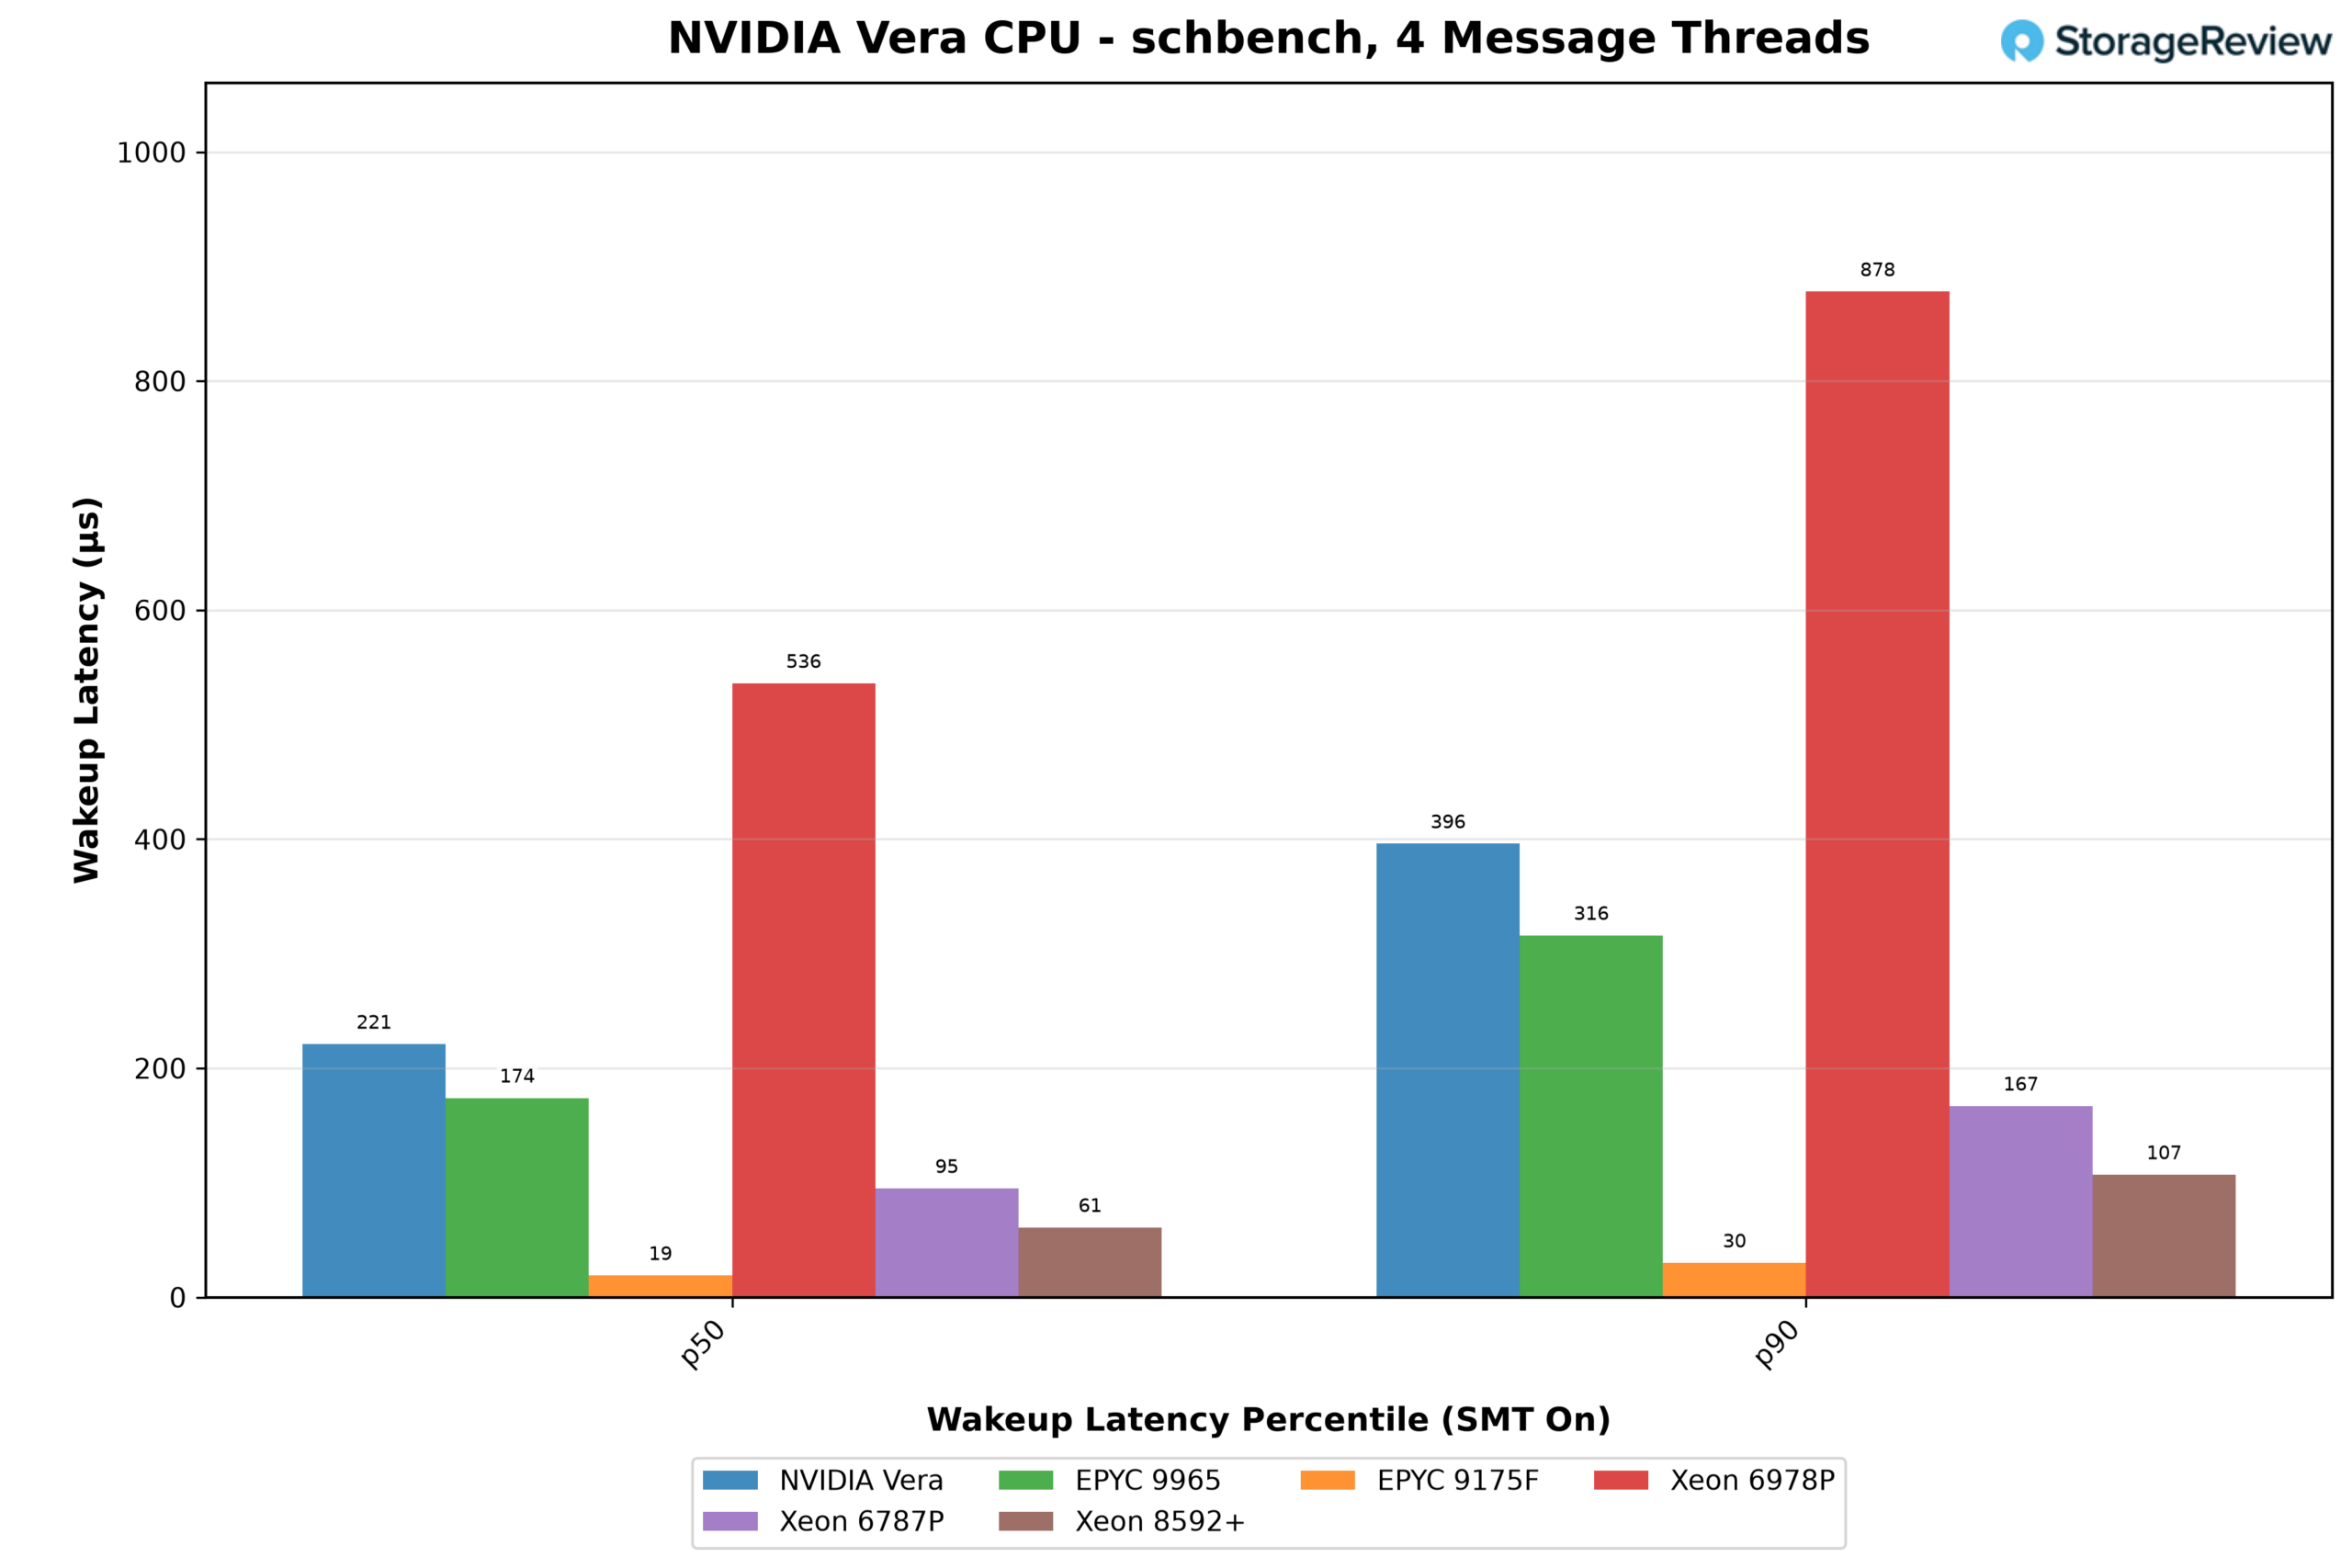
Con 4 thread di messaggi, la latenza di risveglio mediana di Vera era di 221 µs e il suo p90 di 396 µs, superiore a tutti i sistemi tranne lo Xeon 6978P con 536 µs e 878 µs. Le macchine più piccole hanno risvegliato i loro thread più velocemente, con l'EPYC 9175F a 32 core a 19 µs e lo Xeon 8592+ a 128 core a 61 µs.
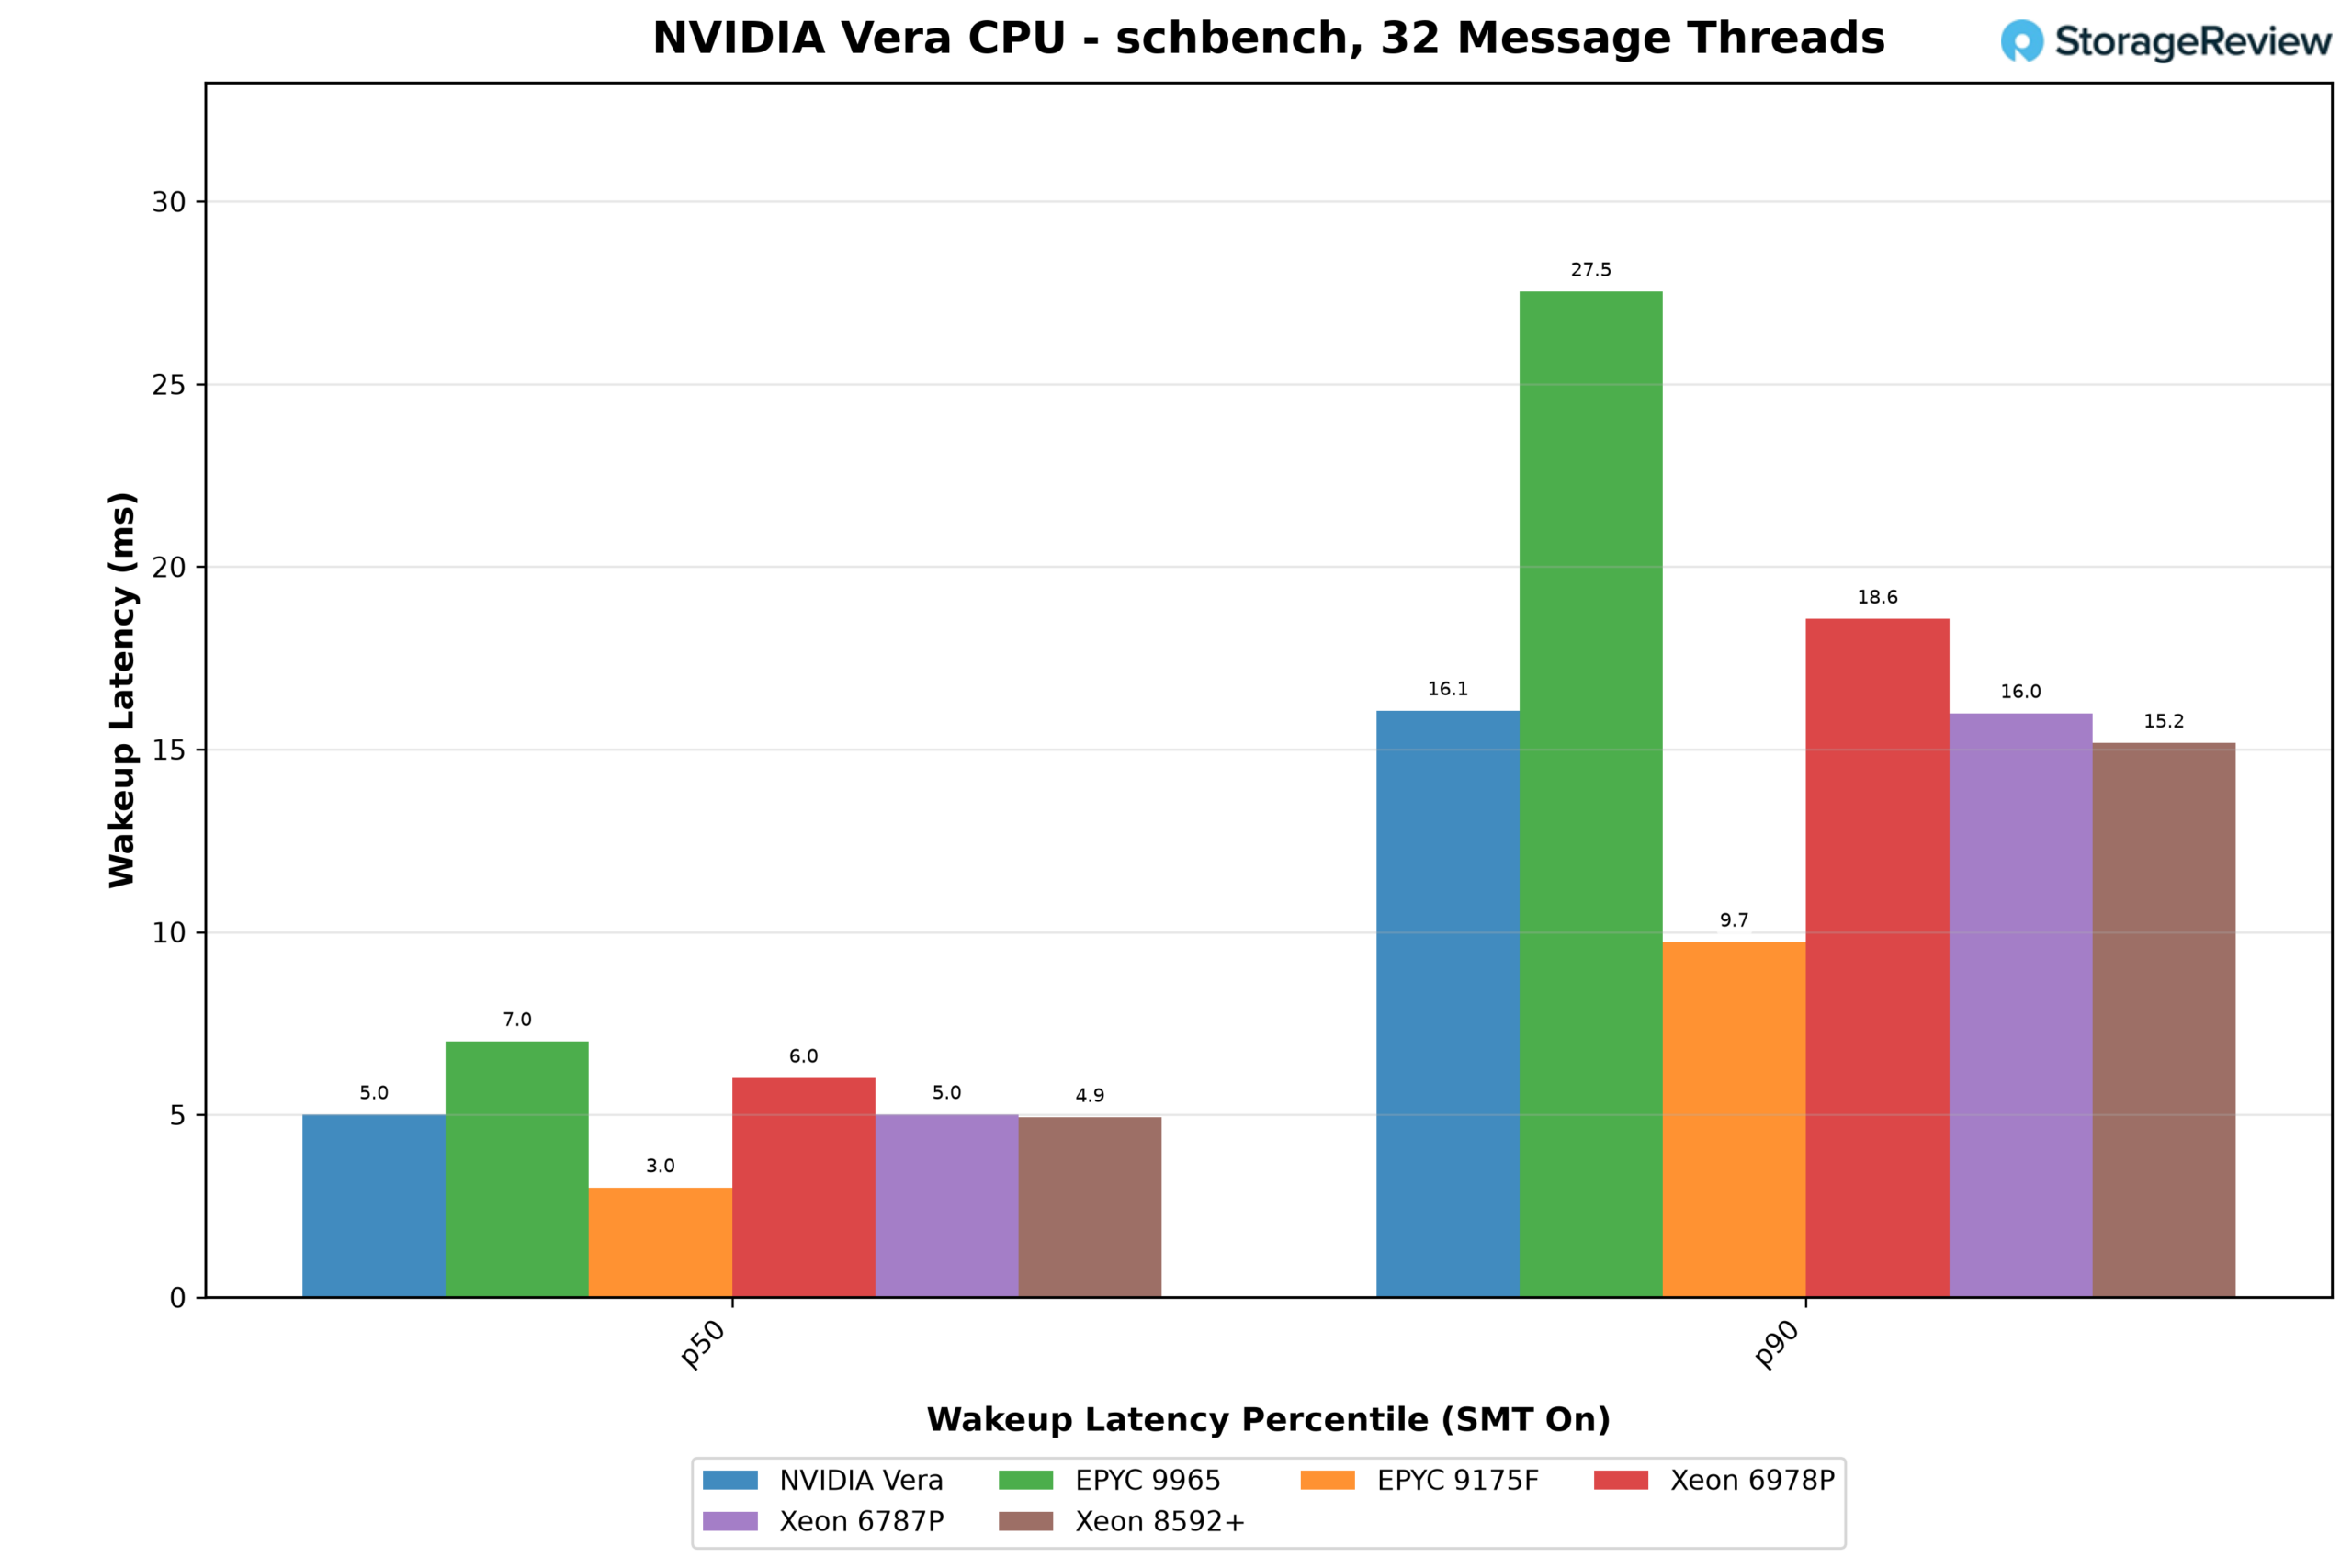
Con 32 thread di messaggi sovraccarichi, Vera si è posizionata a metà classifica. La sua mediana di 5.0 ms e il p90 di 16.1 ms erano pari a quelli dello Xeon 6787P e dell'8592+ e superiori sia allo Xeon 6978P che all'EPYC 9965, che ha raggiunto i 27.5 ms al p90. Solo il 9175F era nettamente più veloce, con 3.0 ms e 9.7 ms.
Compilazione del kernel Linux
La build del kernel Linux con allmodconfig è l'unico risultato in questa sezione che non abbiamo classificato. Vera compila l'albero del kernel arm64, che include un set diverso di moduli e driver rispetto all'albero x86-64 utilizzato dagli altri sistemi, e non abbiamo tentato una compilazione incrociata.
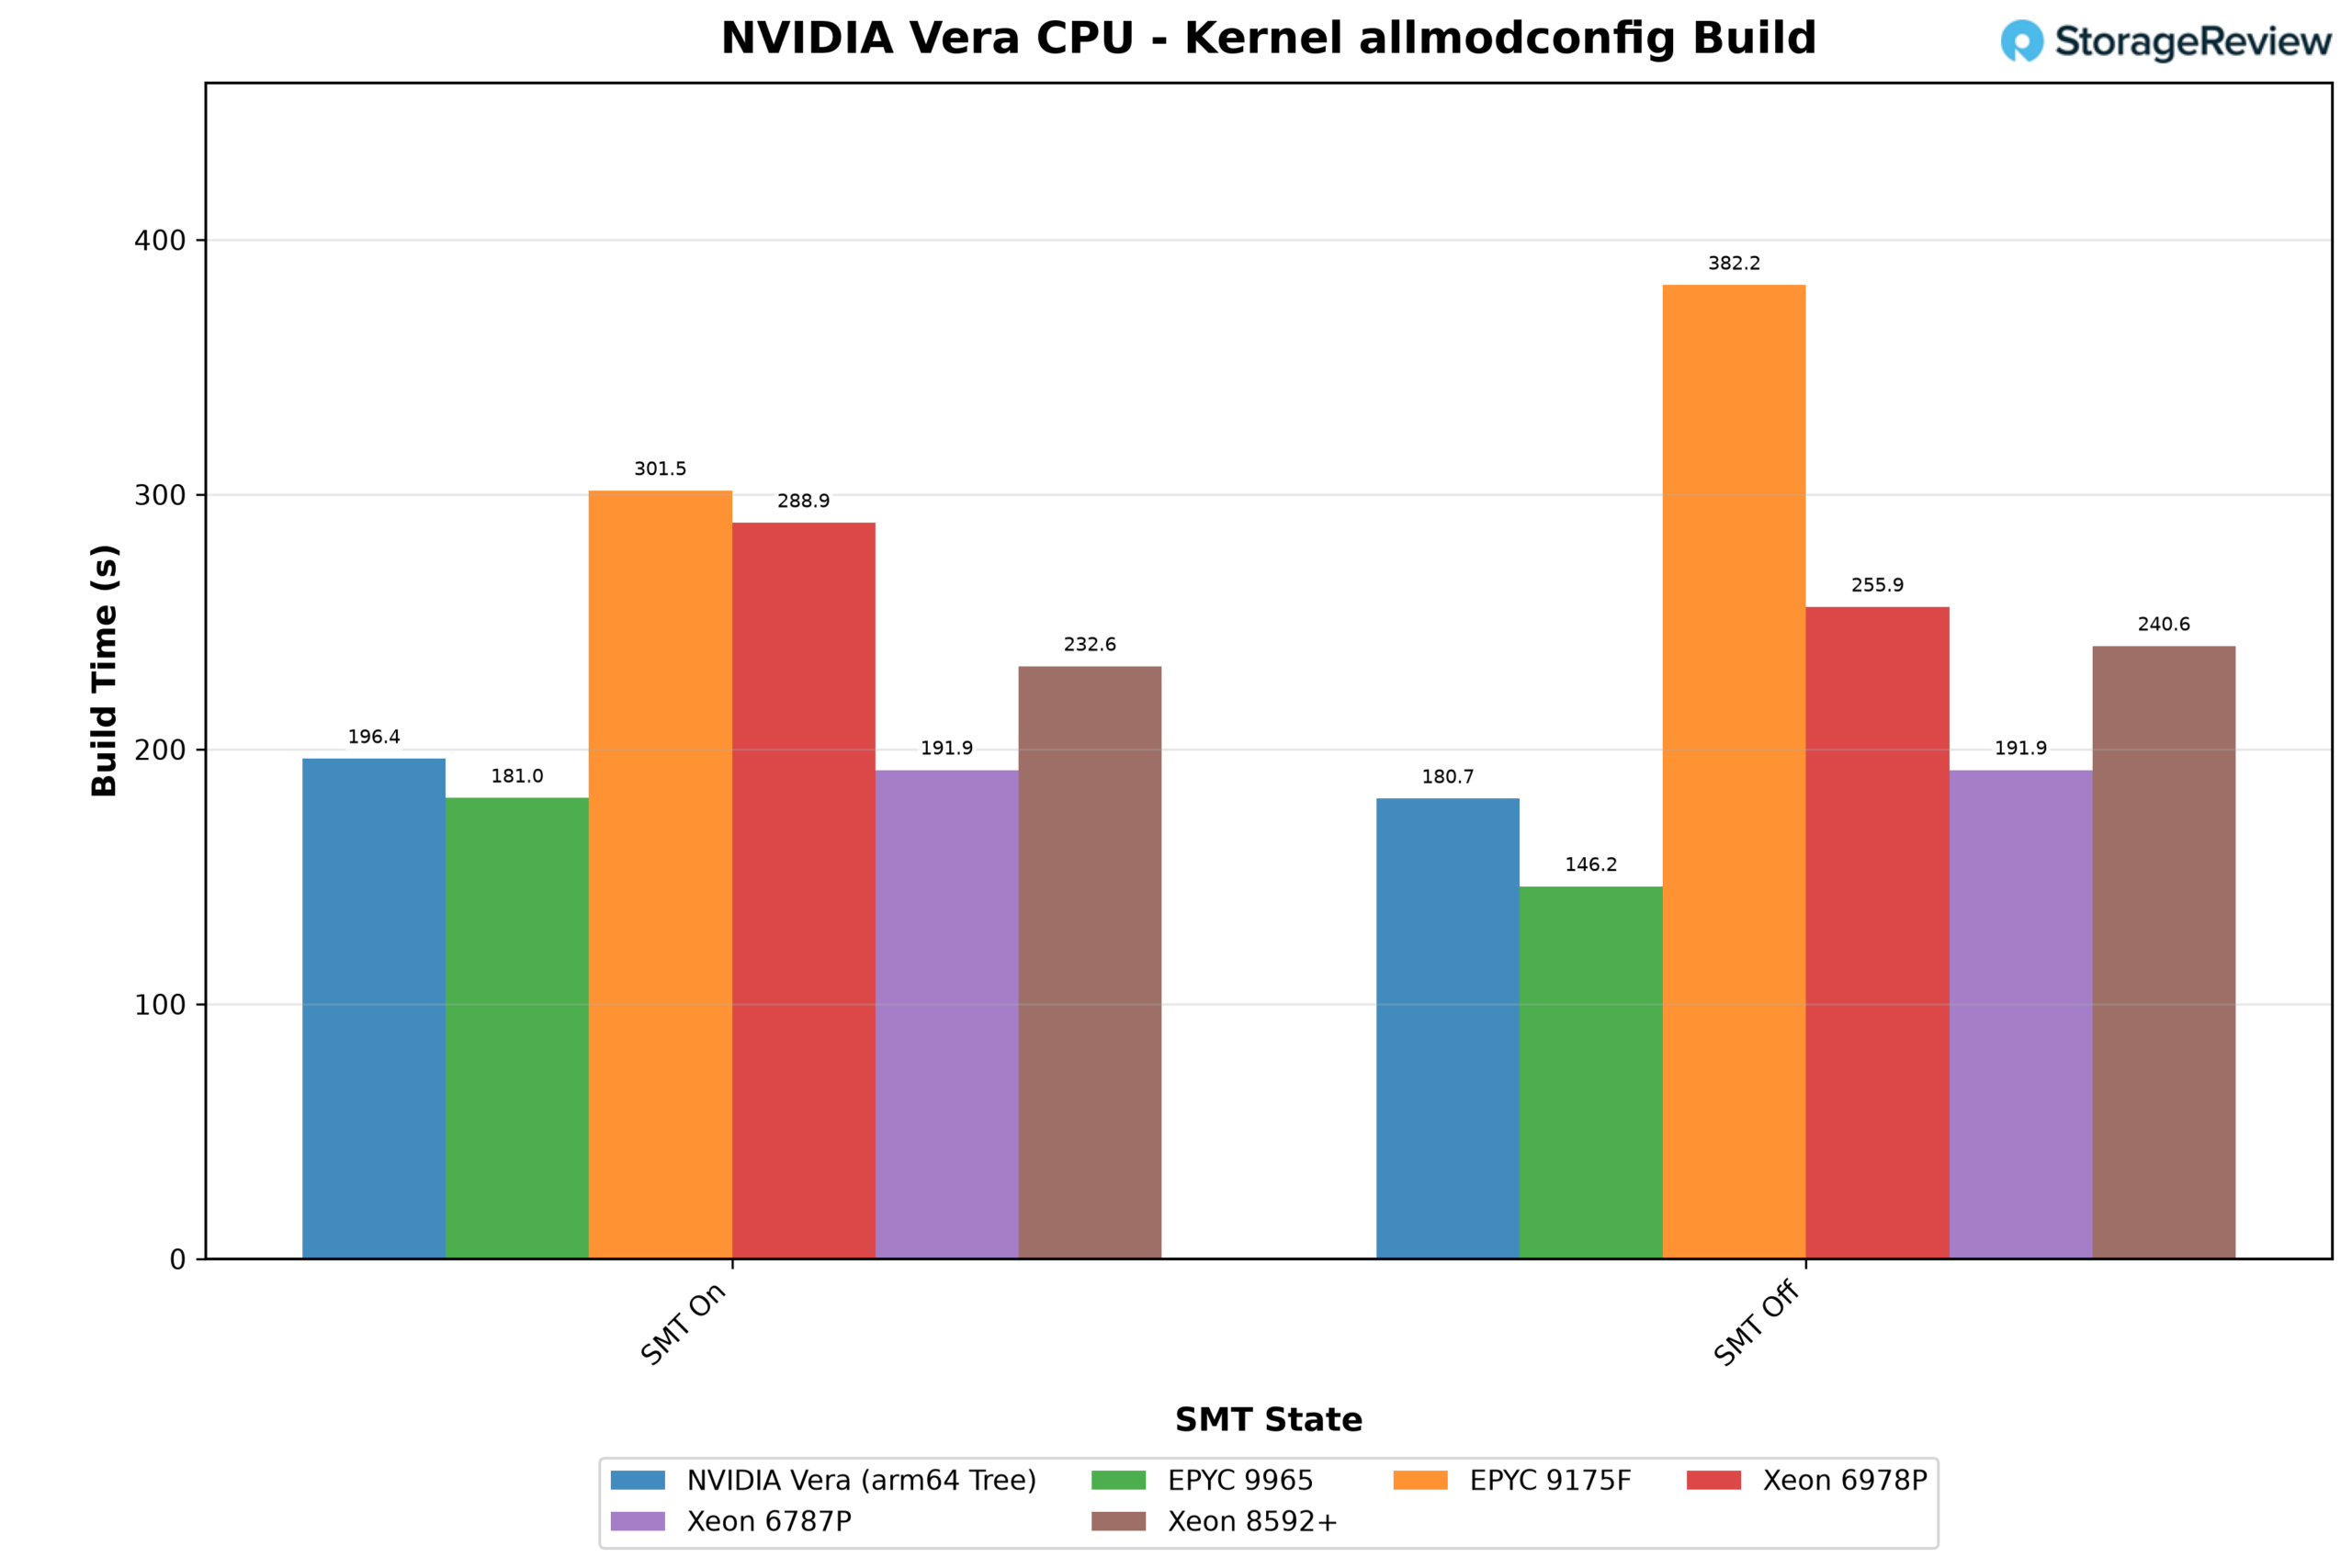
Vera ha costruito il suo albero in 180.7 secondi con SMT disattivato e in 196.4 secondi con SMT attivato, quindi i thread aggiuntivi hanno rallentato la compilazione. Sui sistemi x86, ognuno dei quali ha costruito un albero nativo, i tempi variavano da 146.2 secondi sull'EPYC 9965 con SMT disattivato a 382.2 secondi sull'EPYC 9175F a 32 core.
martello DB
Per i test del database, ci siamo avvalsi della collaborazione di Steve Shaw, creatore e manutentore di HammerDB. Shaw ha eseguito il carico di lavoro TPROC-C di HammerDB, un benchmark OLTP derivato da TPC-C ma non paragonabile ai risultati TPC pubblicati, sul server Vera, sul Dell PowerEdge R7725 con EPYC 9965 e sul PowerEdge R770 con Xeon 6787P. Su ciascuno di essi ha testato cinque motori open source: MariaDB 12.3.3 e 13.0.2, MySQL 26.7.0, VillageSQL 0.0.7 e PostgreSQL 18.6. La dimensione del database scalava con il numero di core a 16 data warehouse per core fisico, ovvero 1,408 per un singolo socket Vera.
Ogni motore è stato eseguito su un singolo socket e su due, con le CPU del secondo socket disattivate per le esecuzioni a singolo socket, e ogni sistema ha ottenuto risultati migliori su un singolo socket, come tipico per le prestazioni dei database. Su tutte le 15 coppie, l'aggiunta del secondo socket ha ridotto il throughput di picco dal 23% al 47%, e dal 29% al 45% su Vera. Shaw ha da tempo riscontrato che i database open source raggiungono un limite di scalabilità prima di esaurire i core. Oltre tale limite, mantenere la coerenza delle cache su due socket costa più dei core aggiuntivi. Pertanto, ci concentriamo sui risultati a singolo socket, mostrati nel grafico sottostante.
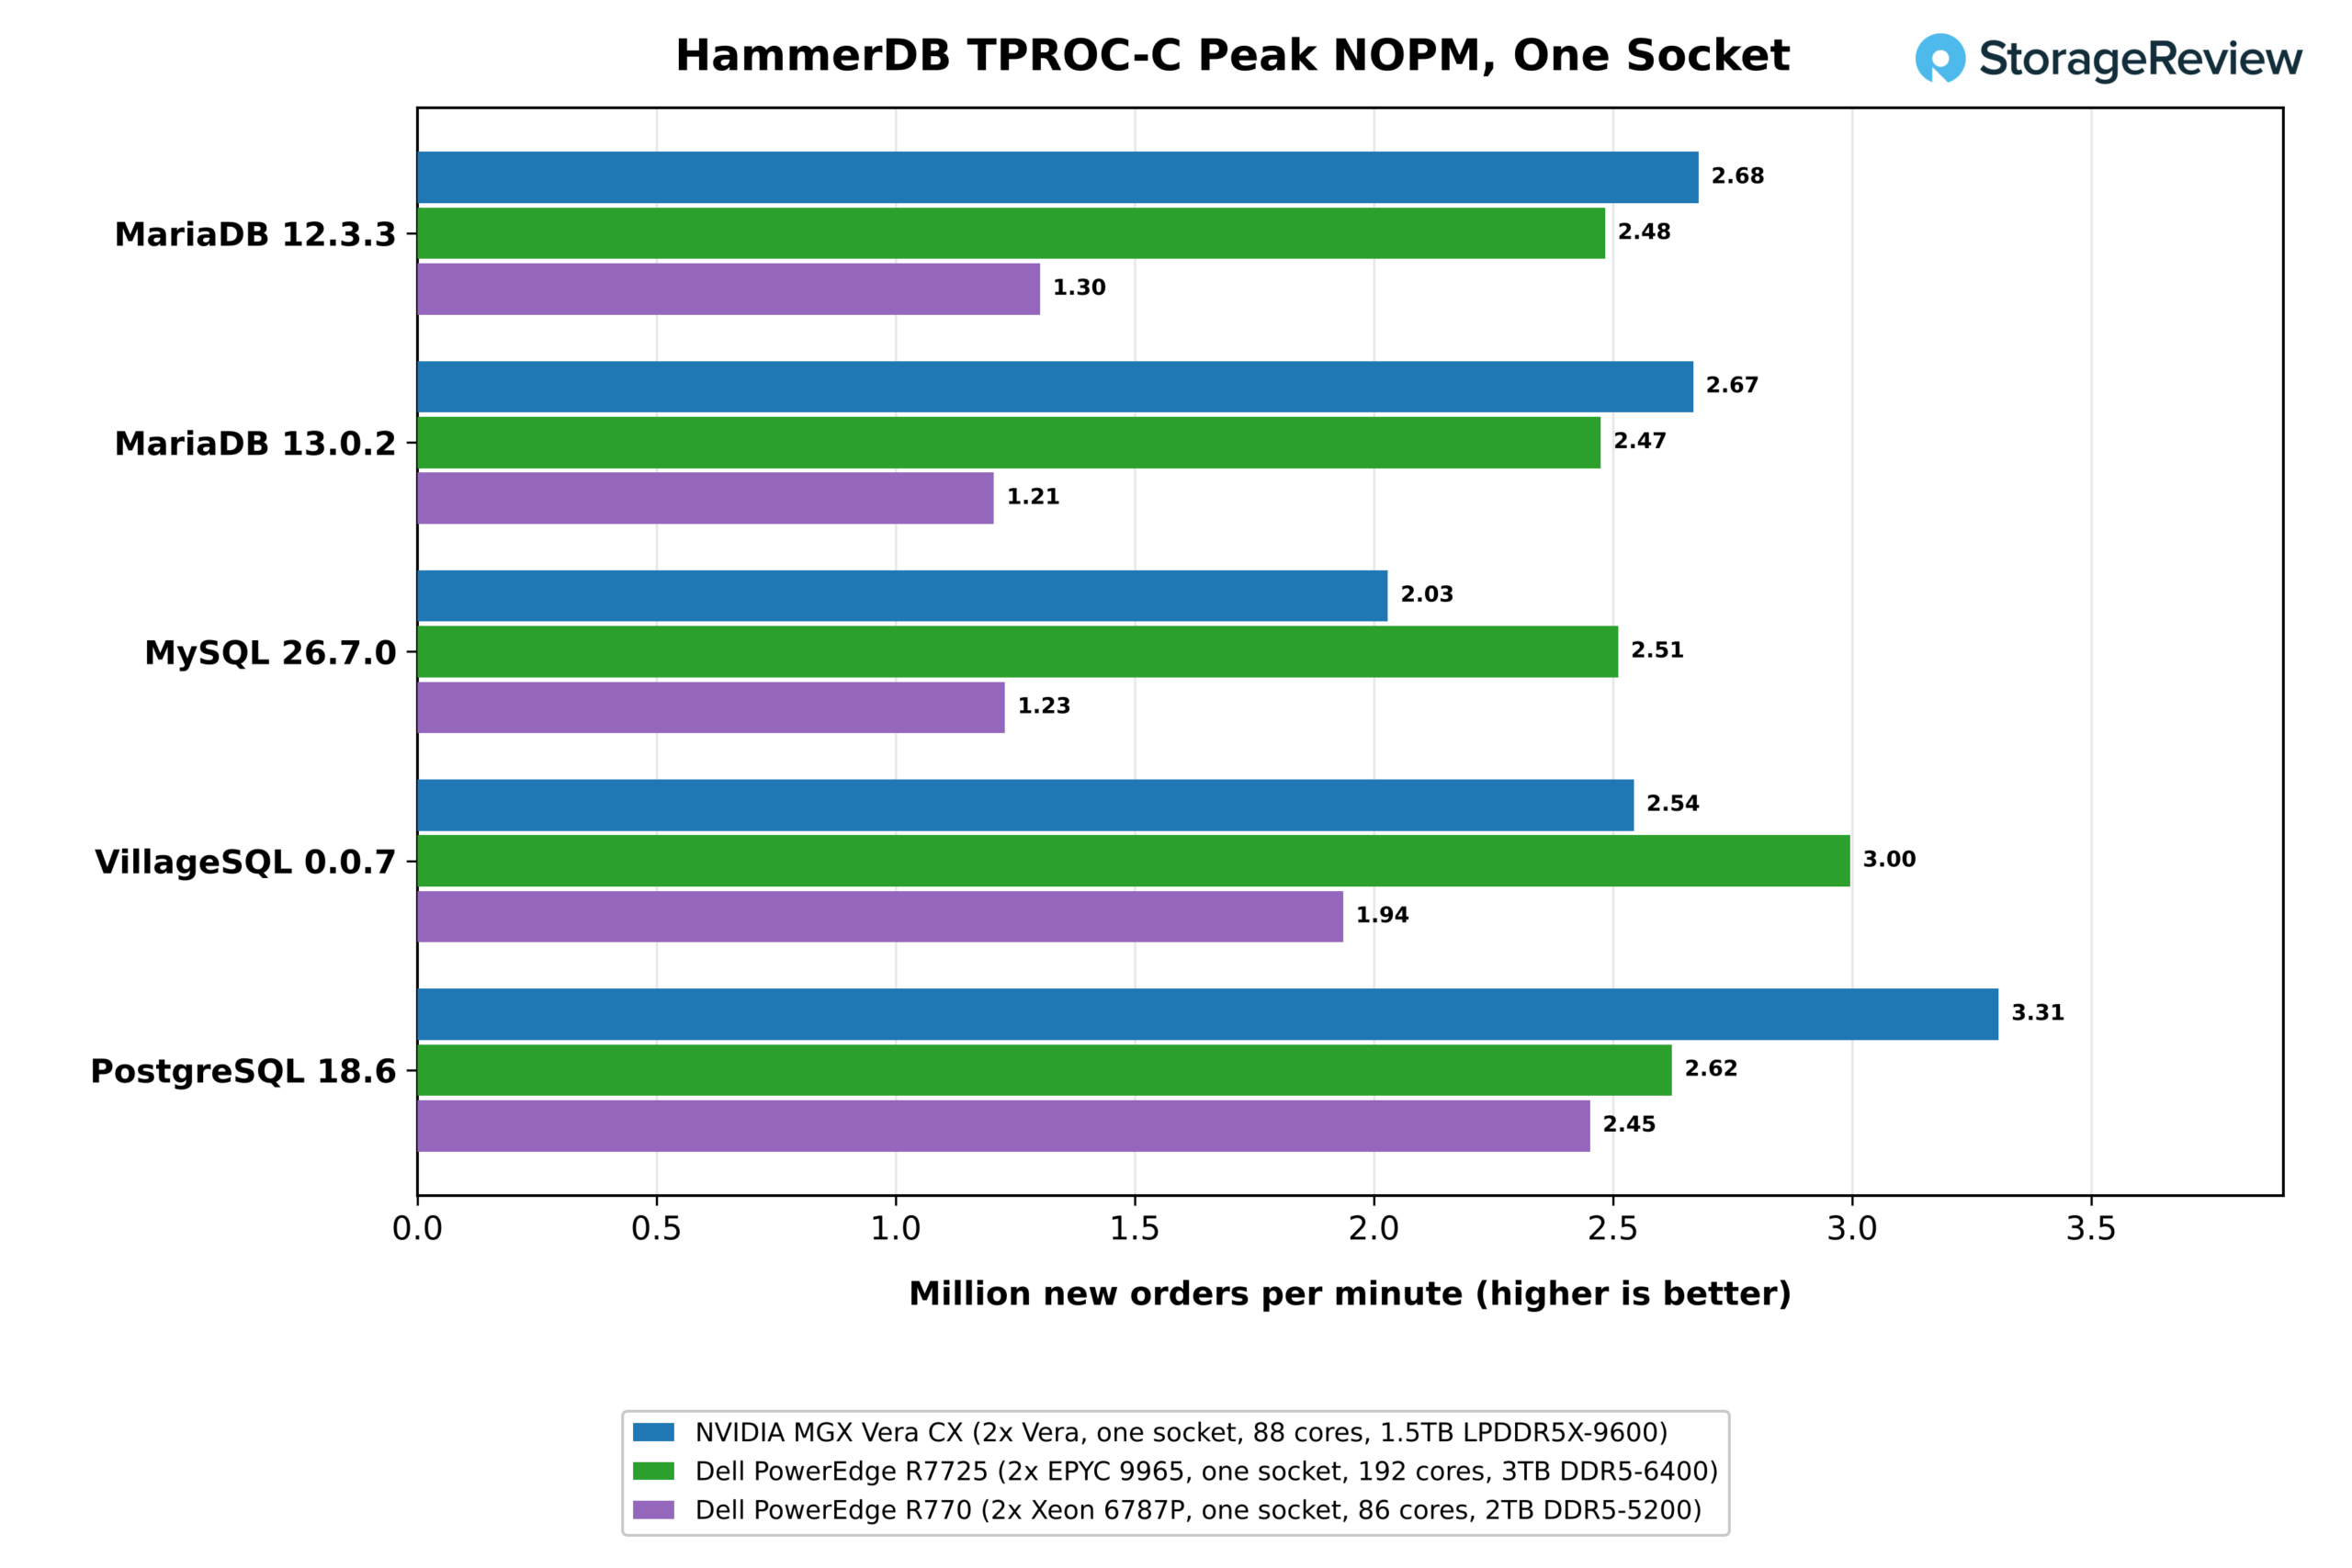
Su un singolo socket, Vera con 88 core ha primeggiato in tre dei cinque motori. PostgreSQL 18.6 ha dato a Vera il margine più ampio, con 3.31 milioni di nuovi ordini al minuto (NOPM) con 128 utenti virtuali, rispetto a 2.62 milioni sul socket EPYC 9965 a 192 core e 2.45 milioni sullo Xeon 6787P a 86 core. Anche entrambe le release di MariaDB sono andate a Vera, con 2.68 milioni e 2.67 milioni, rispetto a 2.48 milioni e 2.47 milioni sull'EPYC. AMD ha mantenuto MySQL 26.7.0 a 2.51 milioni contro i 2.03 milioni di Vera e VillageSQL a 3.00 milioni contro i 2.54 milioni. Lo Xeon è rimasto indietro in tutti e cinque i motori di 1.21 milioni contro 2.45 milioni, e i suoi risultati con MariaDB sono stati meno della metà di quelli di Vera.
La differenza probabilmente dipende da come ciascun motore si adatta alle prestazioni. Il modello "processo per connessione" di PostgreSQL e InnoDB di MariaDB distribuiscono il lavoro su molti core con un traffico intenso di memoria condivisa, il che si adatta perfettamente alla larghezza di banda locale di oltre 1 TB/s che ogni socket Vera ha supportato in STREAM. MySQL e VillageSQL raggiungono più rapidamente i limiti di blocco interni, quindi i loro risultati dipendono maggiormente dalla velocità con cui ogni core libera una sezione critica, ed è qui che il 9965 risulta superiore. Dopo il round di ottobre, Shaw ha giudicato Arm la piattaforma più veloce in assoluto, affermando che Arm "è definitivamente diventata un server di database competitivo", pur aggiungendo che un EPYC a 96 core a singolo socket che aveva testato in precedenza potrebbe superarla.
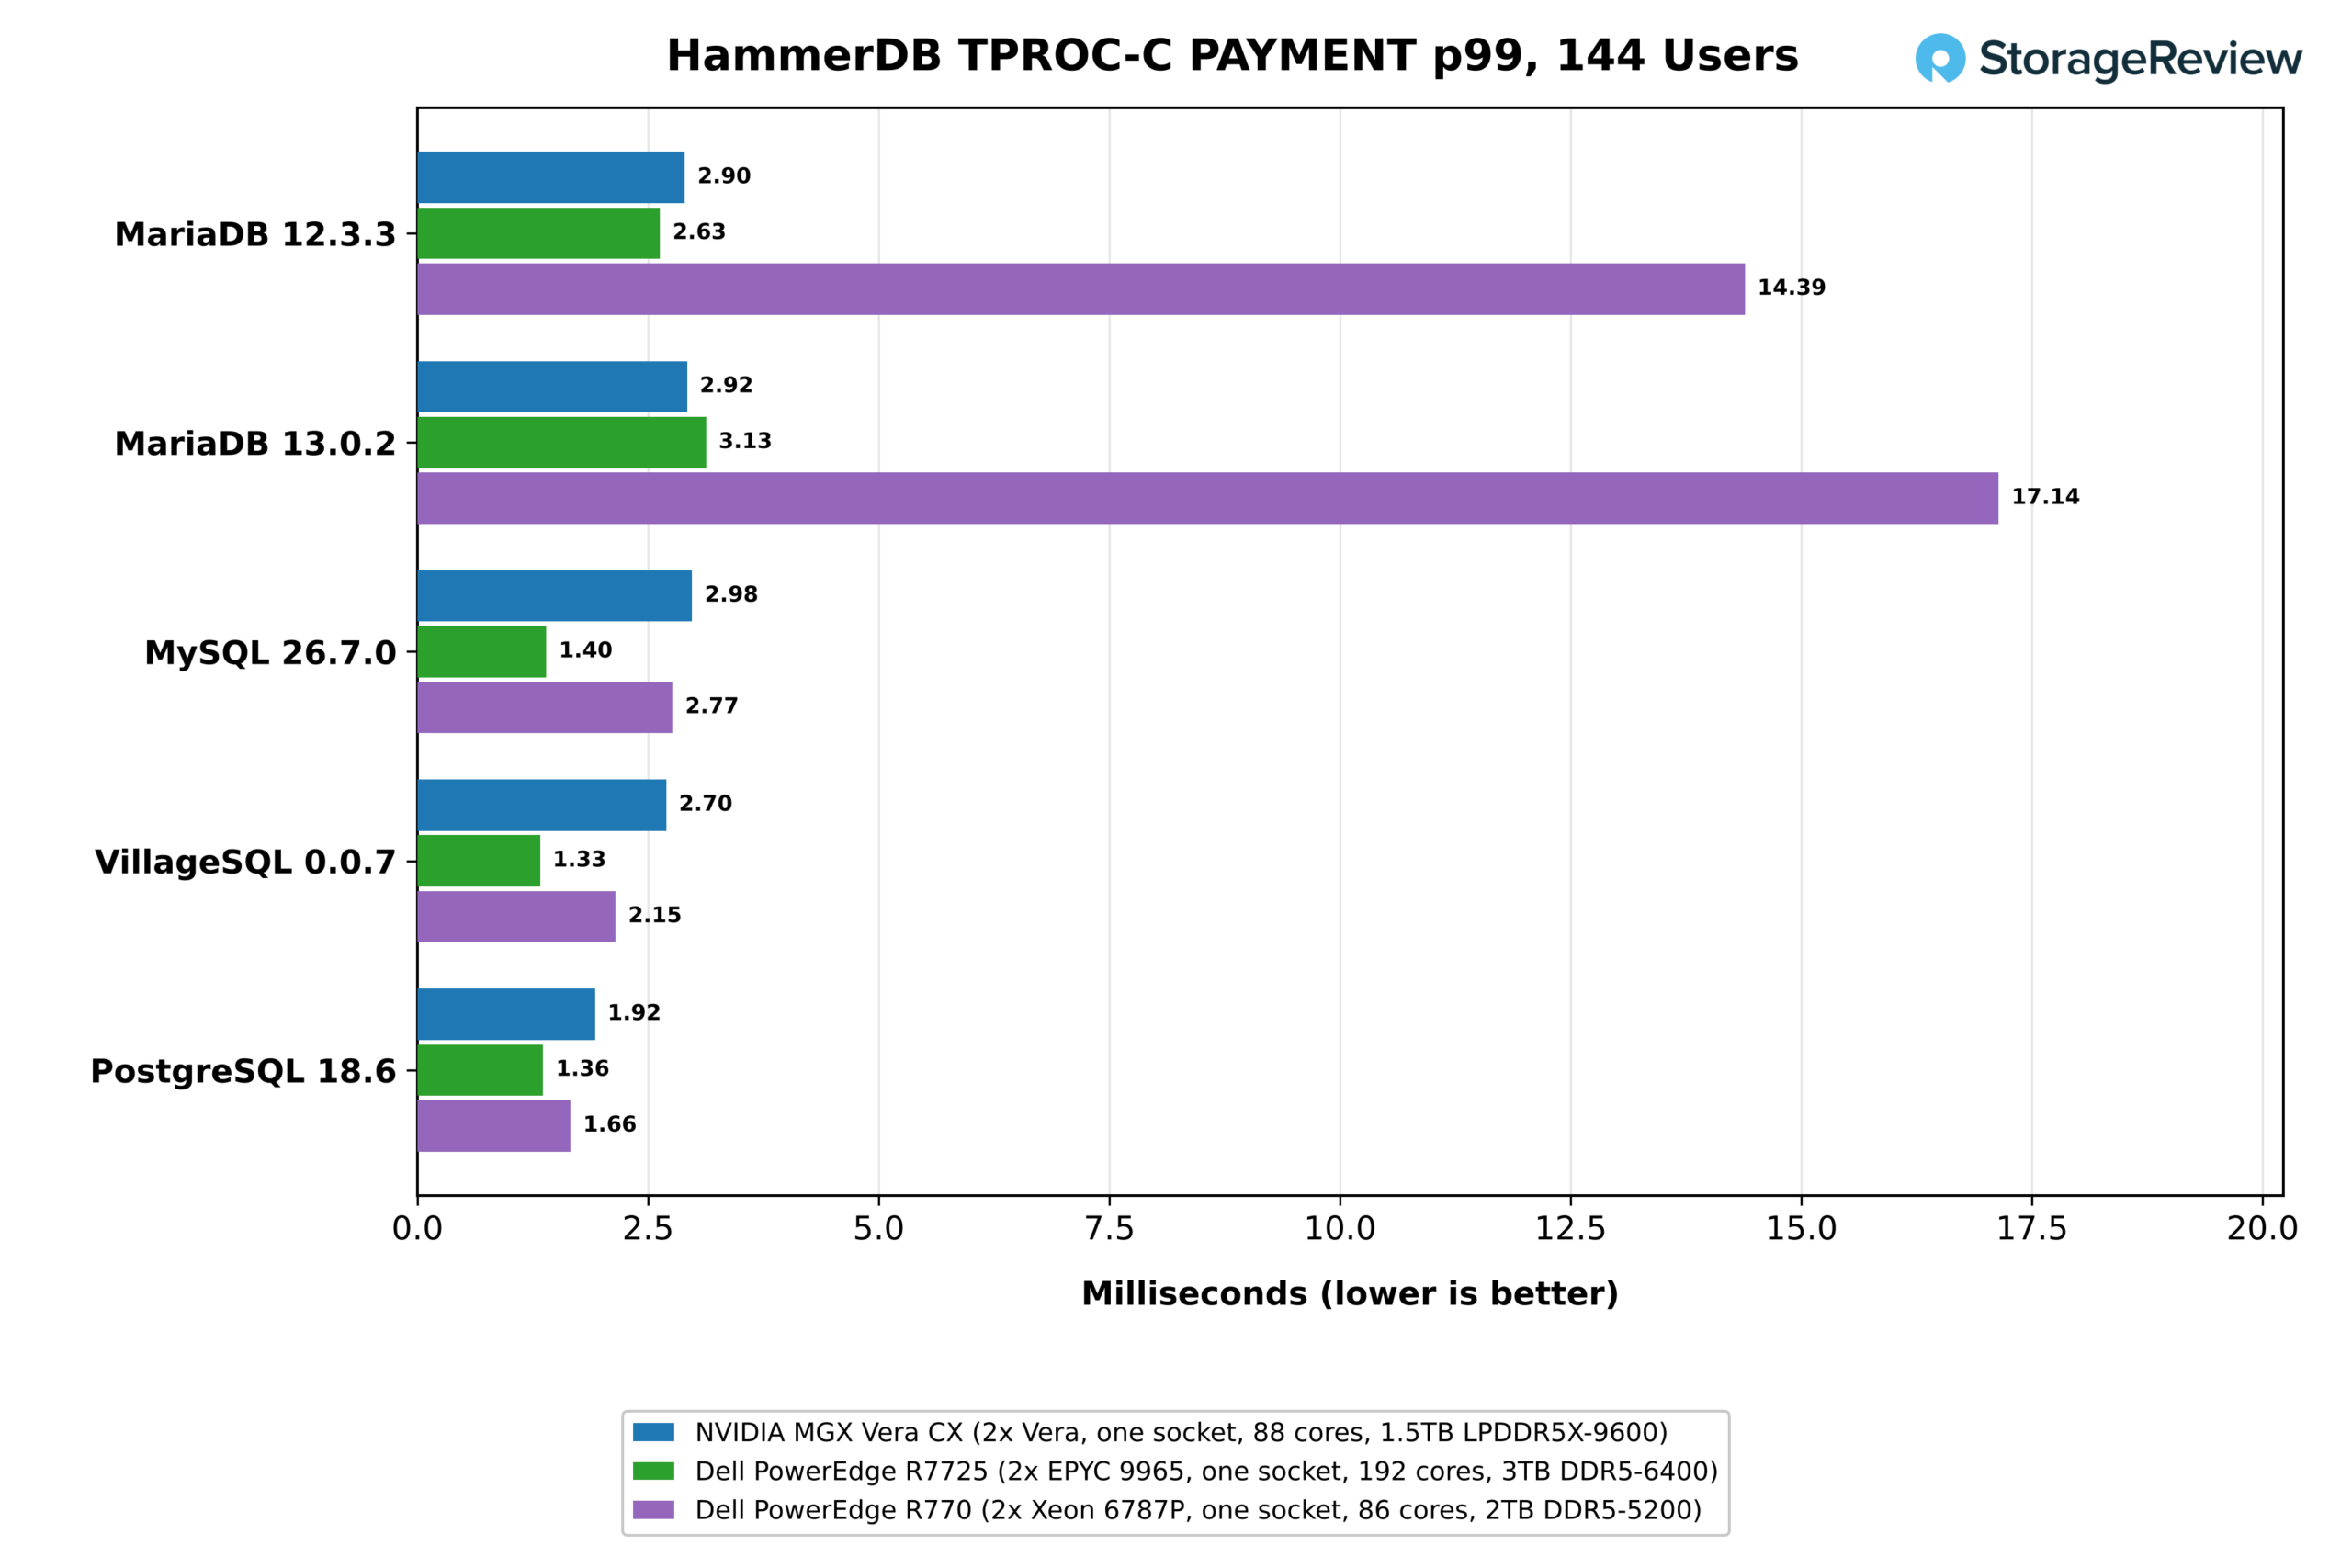
La latenza di coda con un carico equivalente di 144 utenti virtuali mostra la stessa suddivisione. La latenza PAYMENT p99 di Vera variava da 1.92 ms su PostgreSQL a 2.98 ms su MySQL. L'EPYC 9965 ha mantenuto MySQL, VillageSQL e PostgreSQL tra 1.33 ms e 1.40 ms, dal 29% al 53% in meno rispetto a Vera, ma i suoi 3.13 ms su MariaDB 13.0.2 erano inferiori ai 2.92 ms di Vera. Le latenze di coda di MariaDB dello Xeon 6787P, pari a 14.4 ms e 17.1 ms, erano diverse volte superiori a entrambe, in linea con il suo throughput molto inferiore allo stesso carico. Il passaggio di blocco all'interno dei motori probabilmente determina le latenze di coda più elevate di Vera, facendo eco ai risultati di Valkey, dove anche le richieste inviate una alla volta favorivano AMD.
Il round di novembre ha messo alla prova l'intuizione di Shaw. Ha eseguito lo stesso carico di lavoro su un socket del nuovo AMD EPYC 9996 a 256 core e su un EPYC 9686F a 96 core, utilizzando il socket di Vera per il confronto. Il 9996 e Vera si sono scambiati i motori di elaborazione, con Vera che ha mantenuto PostgreSQL e MariaDB e l'EPYC in vantaggio per quanto riguarda la latenza di coda, mentre il processore a 96 core ha superato Vera su PostgreSQL. I risultati completi sono disponibili nella nostra recensione di AMD EPYC Venice.
"Sono rimasto davvero impressionato dalle prestazioni dei database open source su NVIDIA Vera. È fantastico vedere Arm competere ai massimi livelli in termini di prestazioni dei database e offrire un'alternativa valida al mercato aziendale", ha dichiarato Steve Shaw, creatore e manutentore di HammerDB, al termine del round di finanziamento.
Conclusione
Vera non è il processore più veloce in ogni categoria perché AMD risponde a ciascuna fascia di mercato con un modello dedicato. L'EPYC 9175F, ottimizzato per la frequenza, è progettato per la velocità per core e si distingue comunque nei carichi di lavoro che premiano una frequenza di clock elevata, dalle operazioni nbody e AES single-thread di Python alle richieste Valkey una alla volta. L'EPYC 9965 è progettato per il throughput e si distingue nei carichi di lavoro che scalano con il numero di core, tra cui GROMACS, 7-Zip e AES multi-thread e il numero di shard Valkey che possono essere contenuti in un socket.
Il punto di forza di Vera risiede nella sua posizione intermedia e nella sua capacità di avvicinarsi a ciascuno di questi specialisti nel proprio campo. Su un singolo thread, ha eguagliato o superato il 9175F nelle operazioni con numeri interi e in due dei tre test Python, comprimendo il 12% più velocemente con 7-Zip ed eseguendo go e regex_compile rispettivamente il 15% e il 25% più velocemente, pur rimanendo indietro nelle operazioni con numeri in virgola mobile e crittografia.
Nell'intero sistema, ha raggiunto dal 63% al 72% delle prestazioni 7-Zip su tutti i thread del 9965 e ha completato il test OpenFOAM di medie dimensioni con una precisione inferiore del 12%, per poi superarlo una volta che la memoria ha preso il sopravvento, sia nel test di grandi dimensioni che in ClickBench. Rimanere così vicino al leader per core su un singolo thread e al leader per throughput sull'intero sistema è ciò che rende Vera un processore così valido per uso generale. Per gli acquirenti che desiderano un'unica piattaforma per la fascia media del mercato senza rinunciare a prestazioni elevate, rappresenta un'offerta estremamente interessante.
Vera offre una larghezza di banda di memoria di gran lunga superiore a qualsiasi sistema x86 che abbiamo testato. Due socket Vera hanno mantenuto una velocità di 2,073 GB/s su STREAM Triad, 2.3 volte superiore a quella del miglior server DDR5 testato, e NVLink-C2C mantiene tale larghezza di banda a portata di mano tra i socket: i core di Vera leggono la memoria dell'altro socket a 677 GB/s, una velocità superiore a quella di qualsiasi socket x86 che legge dalla memoria locale.
Sono seguiti i carichi di lavoro che dipendono dalla memoria: la grande mesh OpenFOAM è stata risolta 1.44 volte più velocemente rispetto all'EPYC 9965, l'esecuzione a caldo di ClickBench si è conclusa in 2.09 secondi contro 2.70, il working set Valkey da 256 GB è stato eseguito il 34% più velocemente e, su un singolo socket, Vera ha superato HammerDB su PostgreSQL e entrambe le versioni di MariaDB. Il costo del collegamento è la latenza: una lettura remota richiede circa 2.1 volte il tempo di una lettura locale, contro 1.75 volte sull'EPYC 9175F, quindi il posizionamento NUMA-aware e le hugepages sono ancora importanti su Vera.
Le debolezze sono sorprendentemente minime e derivano direttamente dalla progettazione. Sei pipeline SVE2 a 128 bit non corrispondono alle unità AVX-512 a 512 bit nel codice scritto per esse, quindi una versione a 16 core di Vera ha eseguito GROMACS benchMEM a metà della velocità del 9175F e a due terzi della velocità del 9965. Con solo due di queste pipeline dedicate alla crittografia, un singolo core Olympus ha crittografato AES-256-GCM a circa un terzo della velocità del 9175F.
L'evoluzione di Vera dipenderà in gran parte dai partner OEM. Il PowerEdge R8822 di Dell ha iniziato a essere spedito a ottobre, mentre il rack per CPU Vera M9882 è previsto per il primo trimestre del 2027. L'HPE ProLiant Compute DL394 Gen12 arriverà in autunno. Supermicro ha già disponibile il suo rack Vera da 256 CPU, con sistemi Vera raffreddati ad aria da 1U e 2U nella sua gamma. Anche ASUS, ASRock Rack, QCT, GIGABYTE, MSI, Compal, Foxconn, Pegatron, Wistron e Lenovo hanno presentato progetti basati su Vera. Oracle Cloud ha già reso disponibili le istanze Vera , a cui seguiranno CoreWeave, Nebius, Lambda e altri.
Vera è il primo processore server Arm che abbiamo testato in grado di competere con i top di gamma x86 per le applicazioni generiche, ed è anche il primo processore di qualsiasi produttore a offrire una larghezza di banda di memoria di 2 TB/s in un case a due socket con raffreddamento ad aria. Per la fascia media del mercato, rappresenta oggi un'opzione credibile, e NVIDIA entra nel mercato delle CPU con un sottosistema di memoria che nessun altro offre. Per l'HPC vettoriale e i servizi ad alta intensità crittografica, gli specialisti x86 mantengono la leadership. Sottoporremo i sistemi OEM alla stessa suite di test non appena arriveranno in laboratorio, iniziando dal ruolo di sandbox per cui NVIDIA ha progettato questo processore.
Dopo questa recensione, l'AMD EPYC Venice è arrivato nel nostro laboratorio e, nella nostra recensione dell'AMD EPYC Venice SP7 e nella recensione del Dell PowerEdge R9825, abbiamo sottoposto l'EPYC 9996 a 256 core agli stessi test della suite Vera, con Vera aggiornato al firmware più recente.
Classifica: NVIDIA Vera si aggiudica il primo posto nella nostra classifica dei migliori server con la migliore implementazione ARM.


 Amazon