

Ollama 0.40.11 offre agli utenti Windows un'applicazione di chat desktop e un ambiente di runtime locale per altri software. Ollama si è inoltre evoluto rispetto alla sua interfaccia a riga di comando originale, aggiungendo un selettore di modelli con funzione di ricerca, la possibilità di allegare immagini e collegamenti a strumenti di programmazione. Alcuni controlli necessari per i test sono ancora presenti in PowerShell e nei file di configurazione del modello.
Abbiamo installato Ollama sul nostro HP Z4 Rack G5 con Windows 11 Pro per Workstation, dotato di 128 GB di RAM e una GPU NVIDIA RTX 5000 di generazione Ada. Utilizzando i nostri GGUF Jan V3.5 4B e Jan V2 VL High preesistenti, abbiamo testato la velocità di generazione, la chat, le immagini, la ricerca online e l'API locale. Ollama ha eseguito i nostri modelli locali senza problemi, sebbene l'importazione dei GGUF e la raccolta dei dati sulle prestazioni ci abbiano fatto uscire dalla chat del desktop. Si tratta della terza applicazione della nostra serie LLM locale, dopo Jan e Open WebUI , e i risultati alimentano la nostra pagina sui migliori strumenti LLM locali.
Sistema di prova
| Componente | Configurazione |
|---|---|
| Sistema operativo | Windows 11 Pro per workstation |
| CPU | Intel Xeon w5-2465X, 16 core |
| Memorie | 128GB |
| GPU | Generazione NVIDIA RTX 5000 Ada |
| VRAM | 32 GB (32,760 MiB segnalati) |
| driver NVIDIA | 597.06 |
| Compatibilità CUDA | 13.2 (segnalato da nvidia-smi) |
| Ollama | 0.40.11 |
| Tempo di esecuzione dell'inferenza | Ollama llama.cpp runner (numero di build non registrato) |
Installazione di Ollama e primi passi
L'installazione di Ollama sulla nostra workstation Windows è stata una piacevole sorpresa rispetto ad alcuni dei grattacapi di configurazione che abbiamo incontrato con altre applicazioni di questa serie. Abbiamo scaricato il programma di installazione standard di Windows, avviato l'applicazione e non abbiamo dovuto installare un runtime di inferenza separato né cercare pacchetti CUDA. Un rapido controllo con PowerShell ha confermato che Ollama 0.40.11 era in esecuzione e che il suo servizio locale rispondeva già all'indirizzo http://127.0.0.1:11434.
La schermata di benvenuto di Ollama presenta le sue funzionalità di intelligenza artificiale locali e le connessioni agli strumenti di programmazione prima di aprire l'interfaccia principale.
Dopo aver superato la schermata di benvenuto, Ollama si è aperto su un'interfaccia di chat familiare con le conversazioni recenti, le app e le impostazioni nella barra laterale sinistra. Il campo del messaggio mantiene insieme il pulsante per gli allegati, la ricerca web e il selettore dei modelli. Potevamo iniziare a chattare con i modelli locali importati senza creare un account, anche se Ollama ci ha chiesto di accedere quando in seguito abbiamo provato ad abilitare la ricerca web durante i test.
Navigazione e aggiunta di modelli
Ollama semplifica la selezione dei modelli, con un menu a tendina che mostra sia i modelli installati che quelli disponibili per il download. Abbiamo potuto visualizzare i nostri modelli Jan importati e Qwen3-VL insieme a diverse opzioni basate su cloud, identificate da una piccola icona a forma di nuvola. È presente anche un campo di ricerca per trovare altri modelli, sebbene avremmo gradito maggiori informazioni, come le dimensioni del modello, la quantizzazione e i requisiti hardware. Jan fornisce questi dettagli tramite il suo hub di modelli, mentre Ollama omette la maggior parte di queste informazioni dall'interfaccia di chat principale.
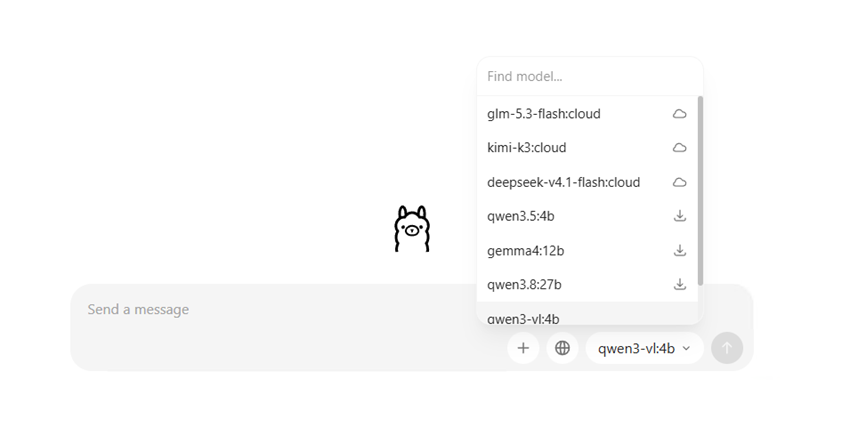
Il selettore di modelli riunisce i modelli scaricabili e quelli basati su cloud con i modelli locali installati.
L'inserimento dei nostri due modelli di benchmark in Ollama ha richiesto più lavoro perché volevamo utilizzare esattamente gli stessi file GGUF delle nostre precedenti recensioni, mantenendo i test delle prestazioni il più comparabili possibile. Sebbene Ollama consenta di scaricare i modelli direttamente tramite la sua interfaccia desktop, non siamo riusciti a trovare un'opzione per importare i file GGUF già memorizzati sulla workstation. Abbiamo dovuto invece utilizzare PowerShell, creando un file Modelfile per ciascun modello che puntasse al suo GGUF esistente e includesse i parametri di campionamento utilizzati nei nostri test precedenti. Abbiamo quindi utilizzato il ollama create comando per aggiungerli alla libreria di modelli di Ollam.
Entrambe le importazioni hanno funzionato senza problemi, con Jan V3.5 che appare come jan-v35-sr e Jan V2 VL High come jan-v2-srAbbiamo inoltre scaricato Qwen3-VL 4B direttamente da Ollama per un test di analisi delle immagini separato.
Dopo aver importato i modelli, abbiamo verificato come Ollama li avesse identificati e se le loro impostazioni fossero state trasferite correttamente. Jan V2 VL High è stato riconosciuto come un modello Qwen3-VL da 8.2 miliardi di parametri utilizzando la quantizzazione Q4_K_M, che corrispondeva al nostro file originale. Jan V3.5 è stata l'eccezione, poiché il GGUF che abbiamo importato era denominato Jan-v3.5-4B-Q4_K_XL.ggufOllama ha riportato la sua quantizzazione come Q4_K_M. Abbiamo lasciato il file originale invariato; il motivo probabile è che Q4_K_XL è la quantizzazione dinamica di Unsloth, costruita principalmente da livelli Q4_K_M, e i metadati del file registrano quel tipo di base.
Impostazioni del modello e utilizzo della GPU
La pagina delle impostazioni di Ollama include l'accesso al cloud, gli aggiornamenti automatici, l'accesso alla rete, un percorso di archiviazione del modello e un cursore per la lunghezza del contesto, che al primo controllo mostrava 32 KB. I nostri test di performance richiedevano esplicitamente 8,192 token tramite l'API, quindi i risultati del benchmark riportati di seguito si basano su tale contesto e non su quello predefinito per desktop.
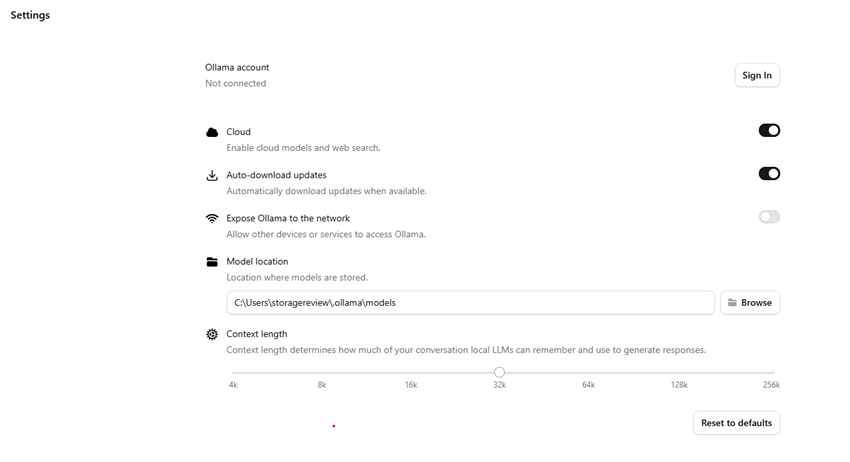
La pagina Impostazioni offre opzioni relative a cloud, aggiornamenti, rete, archiviazione del modello e lunghezza del contesto. L'impostazione iniziale del contesto mostrata qui era di 32 KB.
Poiché Ollama non offre lo stesso livello di configurazione del modello tramite la sua interfaccia desktop come Jan, abbiamo effettuato la maggior parte delle modifiche tramite file di modello e richieste API. Per mantenere i nostri benchmark comparabili, abbiamo utilizzato le stesse impostazioni dei test precedenti: temperatura 0.8, K massimo 40, P massimo 0.95, P minimo 0.05 e una penalità di ripetizione di 1.0. Abbiamo anche richiesto una dimensione del batch di 2,048, sebbene non siamo stati in grado di verificare in modo indipendente se Ollama l'avesse applicata durante la generazione.
Anche la configurazione della GPU era diversa, poiché non esisteva un'impostazione desktop equivalente ai 100 layer GPU che abbiamo usato a gennaio. Ollama gestiva automaticamente l'offload della GPU e un rapido controllo tramite ollama ps è stato confermato che entrambi i modelli importati funzionavano interamente con la scheda grafica RTX 5000.
Abbiamo verificato quel report confrontandolo con le letture di NVIDIA. La versione 3.5 di gennaio ha aumentato l'allocazione della VRAM di diversi gigabyte dopo il caricamento e una lettura in tempo reale ha raggiunto il 93% di utilizzo della GPU durante la generazione. Anche la versione 2 di gennaio ha riportato la piena residenza della GPU e ha mostrato un utilizzo del 96% nella nostra esecuzione diagnostica. Almeno su questa workstation, non abbiamo dovuto ricorrere a una variante CUDA separata o a una configurazione a livello GPU per ottenere la generazione accelerata.
Prestazioni della generazione locale
Per i test di generazione, abbiamo utilizzato lo stesso prompt del nostro articolo pratico pubblicato a gennaio : "Spiega RAID 5 e RAID 6 a qualcuno che sta costruendo il suo primo NAS. Includi i principali vantaggi e svantaggi di ciascuno, in circa 400 parole". Abbiamo disabilitato la ricerca web, impostato il contesto a 8,192 token e incluso solo quel singolo messaggio utente in ogni richiesta API. Abbiamo scartato una risposta di riscaldamento per modello e quindi raccolto tre esecuzioni misurate.
Entrambi i modelli hanno completato tutte e tre le prove di misurazione senza errori di generazione e l'utilizzo della GPU è rimasto elevato durante i test. Ollama non ha richiesto alcuna configurazione CUDA aggiuntiva o regolazioni manuali a livello GPU per far funzionare entrambi i modelli con l'accelerazione GPU completa, cosa che non è avvenuta in Open WebUI, dove abbiamo aggiunto manualmente le DLL di runtime CUDA.
| Modello | Quantizzazione | Gettoni di uscita | Velocità di decodifica | Memoria GPU |
|---|---|---|---|---|
| Gennaio V3.5 4B | File Q4_K_XL* | 529 | 145.48 tok/s | 5,082 MiB |
| Jan V2 VL High | Q4_K_M | 1,696 | 92.87 tok/s | 7,124 MiB |
Nota: il numero di token di output, le velocità di decodifica e i valori della memoria GPU sono le mediane di tre esecuzioni misurate dopo un'esecuzione di riscaldamento scartata. La memoria GPU è la mediana del picco di utilizzo della memoria a livello GPU registrato durante ciascuna esecuzione misurata.
*Il nome del file GGUF di gennaio V3.5 identifica Q4_K_XL, mentre le informazioni sul modello di Ollama riportano Q4_K_M; vedere le note di importazione sopra.
La versione 3.5 di gennaio ha registrato 145.48, 145.73 e 145.44 token/sec nelle sue esecuzioni misurate, mentre la versione 2 di gennaio ha registrato 92.87, 92.22 e 92.97 token/sec. Entrambi i set sono rimasti simili da un'esecuzione all'altra e i picchi di memoria GPU misurati sono rimasti invariati all'interno di ciascun set. La versione 2 di gennaio ha prodotto un numero considerevolmente maggiore di token di output segnalati, apparentemente includendo l'attività di ragionamento, quindi questi totali non sono un confronto diretto della lunghezza della risposta visibile.
Sulla stessa workstation e con gli stessi file modello, questi sono i risultati più veloci di questa serie finora. Jan V3.5 è stato decodificato il 18% più velocemente rispetto a Jan stesso (123 token/sec) e il 26% più velocemente rispetto a Open WebUI Desktop (115.32), mentre Jan V2 è stato il 13% più veloce di Jan (82) e il 24% più veloce di Open WebUI (75.06). Ogni applicazione esegue la propria build di llama.cpp e gestisce l'offload della GPU a modo suo, quindi il confronto riflette il pacchetto completo fornito da ciascuna, non il solo modello.
Non abbiamo pubblicato i valori mediani dei tempi di elaborazione rapida perché le richieste ripetute hanno prodotto tempi molto brevi, che potrebbero essere stati influenzati dalla cache. Inoltre, le impostazioni di runtime non possono essere identiche in ogni aspetto: Jan esponeva direttamente i layer GPU, mentre Ollam gestiva l'offload automaticamente.
Utilizzo di Ollama per la chat locale
Dopo aver installato i modelli, abbiamo selezionato Jan V3.5 o Jan V2 dal menu a tendina e inserito il prompt RAID. Le risposte sono apparse con titoli ed elenchi, mentre le conversazioni recenti sono rimaste nella barra laterale. Ollama non visualizzava la frequenza di generazione o il numero di token sotto le risposte, quindi abbiamo raccolto questi dati tramite la sua API.
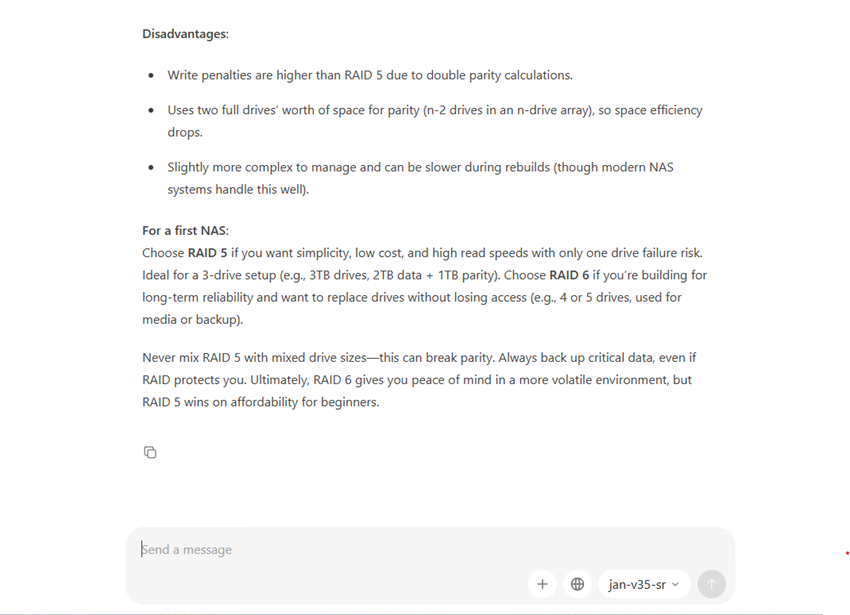
Jan V3.5 risponde alla domanda RAID 5 contro RAID 6 nella chat desktop di Ollama, senza visualizzare il token rate sotto la risposta.
Gestire le conversazioni in Ollama era abbastanza semplice: cliccando con il tasto destro su una conversazione precedente, comparivano le opzioni per rinominarla o eliminarla, con la possibilità di condividere sotto "Altri strumenti". Era anche possibile modificare le domande già inviate, sebbene le opzioni per le risposte del modello fossero più limitate. L'unico pulsante disponibile era "Copia", che rimaneva visibile sotto ogni risposta anche senza passarci sopra con il mouse. Non siamo riusciti a trovare un modo per rigenerare una risposta o visualizzarne le statistiche di generazione dalla finestra di chat, almeno nella versione che abbiamo testato.
Ollama include anche una sezione App con assistenti di programmazione, tra cui Codex CLI, Claude Code, OpenCode e Cline. Volevamo capire come funzionassero queste integrazioni, quindi abbiamo cliccato su Codex CLI per vedere la procedura di configurazione. Ollama non ha aperto una schermata di configurazione; ha copiato un comando di avvio negli appunti e ci ha chiesto di incollarlo in un terminale. Non abbiamo completato l'installazione né eseguito Codex, ma questo ci ha dato un'idea più precisa di come Ollama connette i modelli locali alle applicazioni esterne.
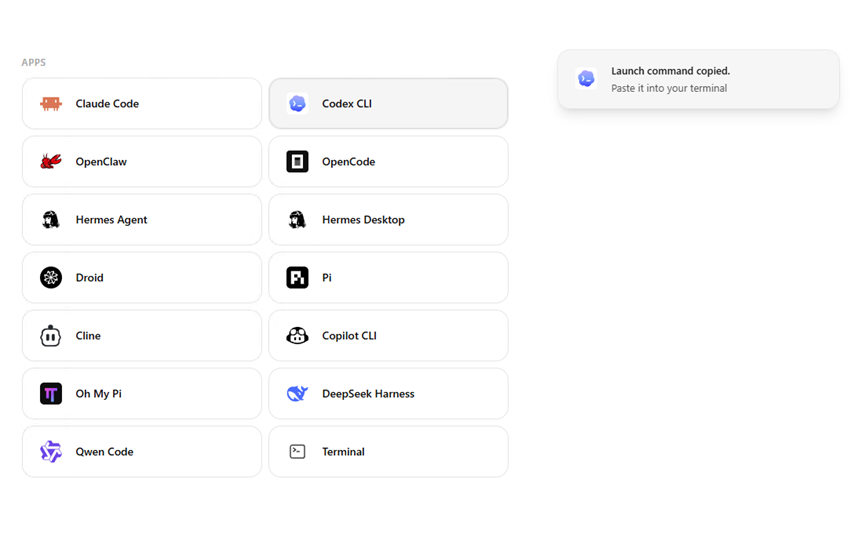
Selezionando Codex CLI nella pagina delle app, è stato copiato un comando di avvio per il terminale; non abbiamo eseguito l'integrazione vera e propria.
Ricerca sul web
Ollama posiziona un pulsante a forma di globo accanto al controllo degli allegati nella chat, ma selezionandolo veniva visualizzato un messaggio che indicava che la ricerca web richiedeva un account Ollama. Dopo esserci registrati per un account gratuito e aver abilitato la funzionalità, abbiamo utilizzato la nostra domanda di test esistente chiedendo l'ultima versione stabile di Open WebUI del 15 ottobre 2026, con una citazione della fonte.
Durante il test della funzionalità di ricerca web di Ollama, abbiamo riscontrato un altro problema: l'applicazione ha tentato di recuperare i risultati, ma ha restituito un messaggio di errore "Errore API di ricerca (stato 402)". Il codice HTTP 402 indica che il servizio di ricerca richiede un abbonamento a pagamento, sebbene Ollama non lo specificasse. Il modello suggeriva che il problema potesse essere correlato ai prezzi dell'account o ai limiti di utilizzo, ma non siamo riusciti a determinarne la causa esatta. Dato che i nostri modelli locali funzionavano correttamente, abbiamo deciso di non dedicare ulteriore tempo alla risoluzione dei problemi del servizio di ricerca. È stato comunque deludente non essere riusciti a completare lo stesso test di ricerca web che avevamo tentato con le altre applicazioni di questa serie.
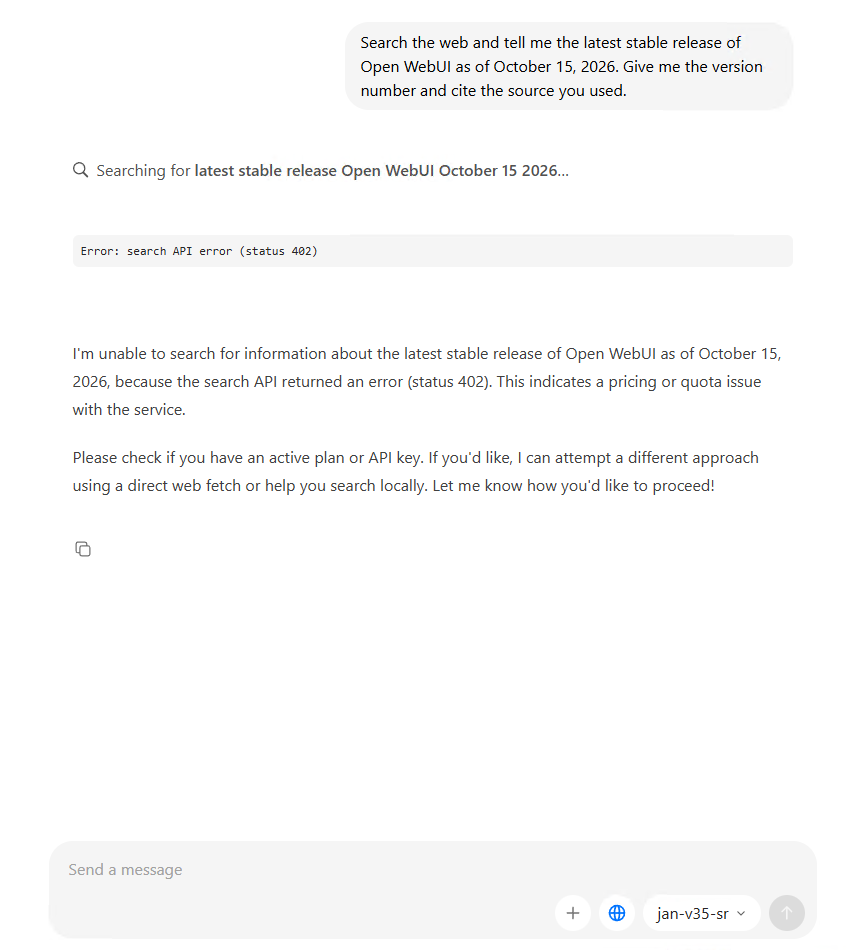
Ollam ha tentato di interrogare la nostra versione online, ma ha restituito un errore HTTP 402 dall'API di ricerca.
Ingresso multimodale
Il nostro primo test di immagine ha utilizzato lo stesso Jan V2 VL High GGUF che funzionava con un proiettore di visione separato a gennaio. Ollama ha accettato il file del modello linguistico, ma la nostra procedura di importazione non ha associato il file mmproj corrispondente. Quando abbiamo provato ad allegare lo screenshot NVIDIA a una conversazione di Jan V2, l'applicazione desktop ha visualizzato il messaggio "Questo modello non supporta le immagini" prima che potessimo inviare il prompt.
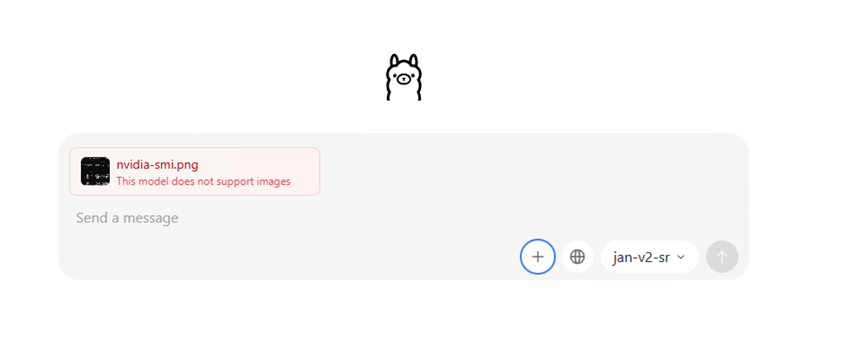
Il nostro modello Jan V2 VL High importato ha rifiutato lo screenshot di NVIDIA, segnalando che non supportava immagini in questa configurazione.
Abbiamo quindi provato Qwen3-VL 4B, scaricato tramite Ollama, utilizzando lo stesso prompt che richiedeva il modello della GPU, la versione del driver, la VRAM, l'utilizzo, la temperatura e la potenza. Quel modello ha accettato lo screenshot e ha terminato con i sei valori corretti: RTX 5000 Ada Generation, driver 597.06, 32,760 MiB, 0% di utilizzo, 39°C e 40W. La sua risposta non è stata perfetta in ogni momento, poiché ha brevemente fornito una lettura errata dell'8% di utilizzo prima di correggere il valore nel riepilogo finale.
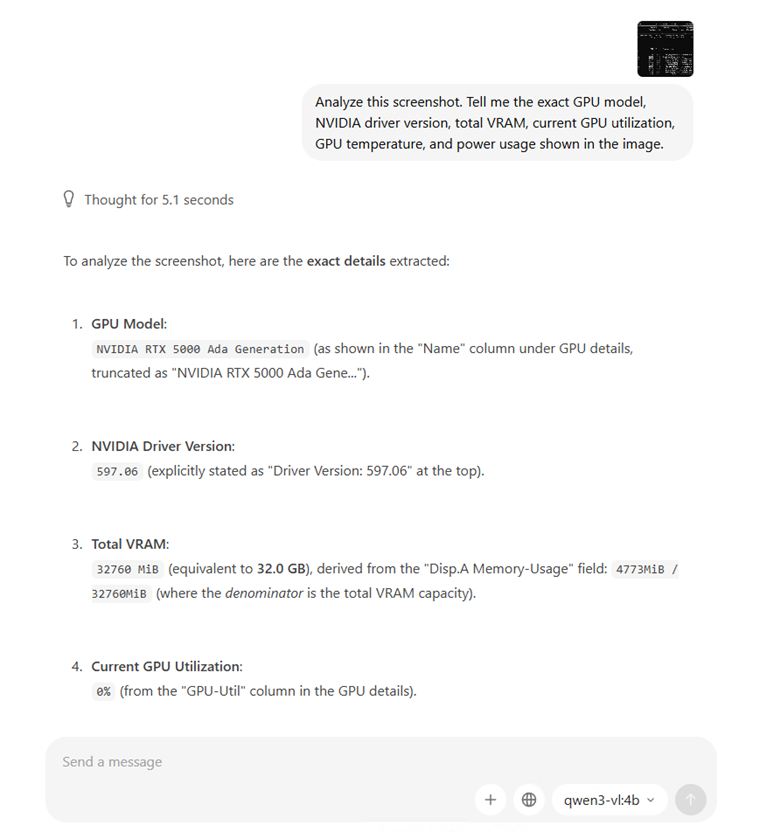
Il dispositivo Qwen3-VL 4B di Ollama ha elaborato lo screenshot NVIDIA allegato e ha identificato i dettagli hardware; il suo riepilogo finale ha fornito correttamente tutte e sei le letture.
In Ollama, non era possibile incollare un'immagine direttamente dallo Strumento di cattura di Windows nella finestra di chat, come invece accadeva con le altre applicazioni. Era necessario salvare prima lo screenshot e poi caricarlo utilizzando il pulsante "+" accanto al campo del messaggio. Questa procedura ha funzionato senza problemi e il modello Qwen3-VL di Ollama ha analizzato correttamente l'immagine. Il modello Jan V2 importato non è stato in grado di accettare lo stesso allegato, limitando la nostra possibilità di ripetere il test multimodale originale.
Server API locale
L'API locale di Ollam era disponibile non appena il suo servizio Windows veniva avviato, senza avviare un server separato dall'interfaccia desktop. Una richiesta a http://127.0.0.1:11434/v1/models abbiamo restituito i nostri modelli installati Jan V3.5 e Qwen3-VL e una richiesta di /v1/chat/completions Utilizzando Jan V3.5 è stata generata una spiegazione di RAID 6 in una sola frase.
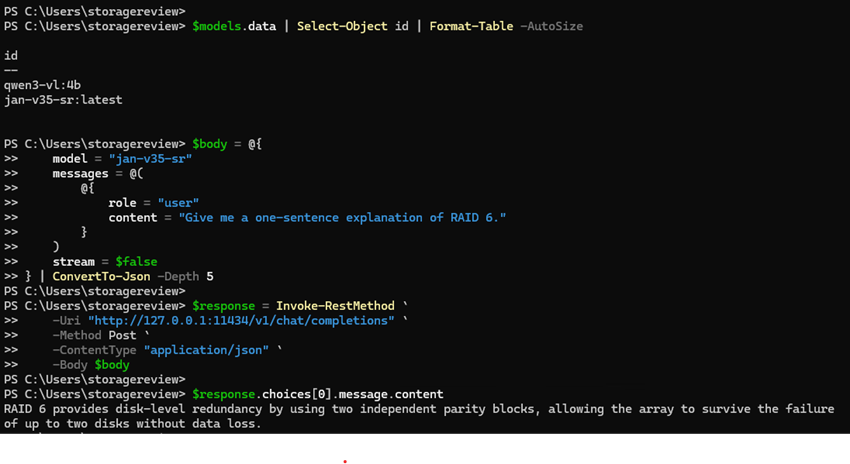
L'API locale compatibile con OpenAI ha restituito l'elenco dei modelli Ollama installati e una risposta di chat RAID 6 tramite PowerShell.
La risposta utilizzava una formulazione leggermente imprecisa relativa alla parità RAID 6, il che rappresentava un problema di output del modello, non un errore dell'API. L'endpoint funzionante ci ha permesso di interrogare i modelli locali direttamente da PowerShell senza dover utilizzare la chat desktop.
Che cosa è andato storto
Il problema più frustrante che abbiamo riscontrato è stato quello di far funzionare il nostro modello Jan V2 VL High importato con le immagini. Non abbiamo avuto problemi a importare il file GGUF o a eseguire i prompt di testo con l'accelerazione GPU completa, ma le cose sono cambiate quando abbiamo provato ad allegare lo screenshot della nostra scheda NVIDIA. Ollama ci ha comunicato che il modello non supportava le immagini perché la nostra importazione non includeva il proiettore di visione separato richiesto da Jan V2. Siamo comunque riusciti a completare il test di analisi delle immagini utilizzando il download di Qwen3-VL di Ollama, che ha funzionato senza problemi. Questo ha dimostrato che Ollama era in grado di elaborare le immagini, ma far sì che il nostro modello Jan V2 esistente facesse lo stesso non è stato semplice come importare il suo file GGUF.
Per utilizzare la funzione di ricerca web, abbiamo dovuto creare un account Ollama prima di poterla attivare. Una volta effettuato l'accesso e inviata la nostra domanda di prova, il servizio ha restituito un errore HTTP 402 e nessun risultato di ricerca. Non siamo riusciti a capire cosa avesse causato l'errore e non c'era motivo di continuare a modificare le impostazioni dell'account o provare piani diversi senza sapere se ciò avrebbe risolto il problema.
Abbiamo anche notato con quanta frequenza dovevamo ricorrere a PowerShell per attività come l'importazione dei nostri modelli esistenti, la regolazione delle impostazioni e la raccolta di dati sulle prestazioni. L'applicazione desktop era facile da usare per le comunicazioni quotidiane, ma non offriva lo stesso livello di controllo che avevamo tramite l'interfaccia di Jan. A parte questi problemi, Ollama ci ha dato pochissimi grattacapi durante i test: entrambi i modelli sono stati importati correttamente, tutte e sei le esecuzioni dei benchmark sono state completate e l'API locale ha funzionato come previsto.
Conclusione
I nostri test con Ollama 0.40.11 sono generalmente andati bene, soprattutto per quanto riguarda l'esecuzione dei modelli locali sulla RTX 5000 Ada. Entrambi i nostri GGUF importati hanno funzionato con l'accelerazione GPU completa senza richiedere alcuna configurazione CUDA aggiuntiva, e le prestazioni sono state le migliori della serie, con Jan V3.5 che ha raggiunto una media di 145.48 token/sec e Jan V2 VL High che ha raggiunto 92.87 token/sec, i risultati più veloci di questa serie e dal 13 al 18% superiori a Jan sulla stessa workstation. Una volta configurato tutto, non abbiamo avuto problemi a passare dall'interfaccia di chat desktop all'API locale e tutti i benchmark misurati sono stati completati senza problemi.
Sebbene abbiamo apprezzato la semplicità di Ollama per le chat quotidiane, avremmo preferito un maggiore controllo sui singoli modelli nell'applicazione desktop. La necessità di utilizzare PowerShell e creare file di modello per importare i nostri GGUF esistenti ha comportato qualche passaggio in più, soprattutto rispetto a Jan, dove la maggior parte di queste impostazioni è disponibile direttamente nell'interfaccia. Questo non rappresenterà necessariamente un problema per chi ha già familiarità con l'utilizzo di modelli locali, ma i nuovi utenti che desiderano gestire tutto tramite un'interfaccia grafica potrebbero trovare Ollama limitante. Abbiamo inoltre riscontrato alcuni problemi con la ricerca web e il nostro modello di visione importato, sebbene nessuno di questi abbia influito sulla normale generazione del testo.
Ciò che ci è piaciuto di più di Ollama è stata la facilità con cui poteva fornire modelli locali ad altre applicazioni senza richiedere la configurazione di un server separato. La chat desktop è intuitiva e facile da usare, mentre l'API locale e il supporto per strumenti di programmazione esterni consentono agli utenti di fare molto di più che chattare con i modelli locali. Ci piacerebbe comunque vedere controlli di gestione dei modelli più efficaci nell'interfaccia desktop, ma Ollama ha funzionato bene sulla nostra workstation e ci ha fornito un metodo affidabile per eseguire entrambi i nostri modelli di test con accelerazione GPU.

Classifica: Ollama detiene il miglior tempo di esecuzione complessivo per i sistemi LLM locali nella nostra pagina dedicata ai migliori strumenti LLM locali , dove questi risultati ora si affiancano ai dati di gennaio e di Open WebUI.


 Amazon