

La decisione più importante che molte aziende prenderanno nel prossimo anno in merito all'infrastruttura AI non sarà un investimento in GPU, bensì un aggiornamento del database. Oracle AI Database 26ai è la release con supporto a lungo termine verso cui Oracle sta orientando la sua base installata di 19c. 26ai integra la ricerca vettoriale nello stesso motore che gestisce le transazioni. Quando l'indice vettoriale risiede nel database, l'array di blocchi e la relativa infrastruttura SAN diventano infrastrutture AI, gestendo il traffico di recupero insieme alle transazioni che già gestiscono.
Il database è cambiato sotto l'IA
Oracle ha sviluppato 26ai attorno a quest'idea: un tipo di dati VECTOR nativo, funzioni di ricerca vettoriale SQL, esecuzione del modello nel database tramite ONNX e SELECT AI per query in linguaggio naturale, il tutto in una release LTS che l'azienda elenca con oltre 300 nuove funzionalità. In pratica, un DBA può generare embedding, memorizzarli accanto alle righe che descrivono ed eseguire una ricerca di similarità all'interno dello stesso ambito di transazione di una ricerca di ordine. Non è necessario eseguire un archivio vettoriale separato, né gestire una pipeline di sincronizzazione, né avere una seconda copia di dati regolamentati al di fuori del registro di controllo.
IBM cita IDC a proposito di questa tendenza: "I database vettoriali integrati rappresentano chiaramente la piattaforma di scelta per l'archiviazione e l'interrogazione di embedding vettoriali, poiché le organizzazioni prediligono ambienti unificati e governati per l'IA agentiva". I clienti di IBM e Broadcom desiderano estendere il database di cui già si fidano prima di crearne uno nuovo in parallelo.
Oracle non è l'unica azienda a seguire questa strada. La classifica di popolarità di DB-Engines dell'ottobre 2026 elenca i quattro principali motori relazionali e multi-modello: Oracle, MySQL, Microsoft SQL Server e PostgreSQL, e tutti e quattro hanno aggiunto tipi vettoriali o ricerca vettoriale, nativamente o tramite estensioni come pgvector. IBM ha scelto di iniziare il suo lavoro di validazione con Oracle principalmente per la sua leadership di mercato, sebbene la discussione sullo storage presentata in questo articolo sia valida anche per gli altri.

Le argomentazioni a favore del mantenimento dell'archiviazione a blocchi on-premise non sono cambiate con l'avvento dell'IA: i dati che rendono utile un'implementazione di IA, come cartelle cliniche, richieste di rimborso, ordini e transazioni, non possono essere spostati. Copiarli su una piattaforma IA dedicata significa pagare due volte per l'archiviazione, accettare che la copia si discosti dal cluster di produzione e perdere i controlli di governance che rendevano l'originale legalmente difendibile. Mantenere il recupero dei dati all'interno del database evita tutti e tre questi problemi. L'array che gestisce una ricerca di riga in meno di un millisecondo ora gestisce contemporaneamente anche una scansione di similarità vettoriale per un medico e un flusso di backup.
IBM Storage e il gruppo Fibre Channel (FC) di Broadcom si sono prefissati l'obiettivo di convalidare questo caso di carico di lavoro misto, creando un ambiente basato su Oracle AI Database 26ai su IBM FlashSystem con la rete SAN Brocade Gen 8 di Broadcom e gli HBA Secure Emulex 64G . Hanno quindi affrontato le domande poste da un team infrastrutturale: qual è l'impatto sulla latenza transazionale quando un carico di lavoro vettoriale viene avviato nelle vicinanze, l'effetto della velocità della rete sulla velocità effettiva della ricerca vettoriale, la capacità consumata dagli embedding, l'efficacia del rilevamento di ransomware quando si prende di mira un volume di backup RMAN e quali sono i requisiti per aggiungere un host alla SAN senza un ticket di zonizzazione?
I dati sono già memorizzati su storage a blocchi, e ora arriva l'intelligenza artificiale.
Nessuna di queste considerazioni implica che i carichi di lavoro di intelligenza artificiale in generale debbano essere gestiti tramite storage a blocchi. Le aziende continueranno a utilizzare array di file e oggetti per i dati non strutturati: documenti, immagini, video, set di dati di training e checkpoint dei modelli che non sono mai stati memorizzati in un database e probabilmente non lo saranno mai. Nella dimostrazione in ambito sanitario che segue, IBM conserva le immagini radiografiche grezze nello storage a oggetti, mentre memorizza in Oracle solo gli embedding e i metadati dei casi. Ciò che cambia è il carico sull'array, che ora gestisce contemporaneamente diversi carichi di lavoro con profili di I/O molto diversi.
Il livello relazionale è il più familiare: milioni di operazioni di I/O casuali da 4 KB a 16 KB al secondo, ricerche e commit di righe che devono essere completati in microsecondi, un'elevata concorrenza di scrittura dovuta al traffico di redo, undo e checkpoint, e una latenza di coda che rimane prevedibile perché un'applicazione rivolta all'utente è in attesa. RMAN, l'utility di backup di Oracle, è l'opposto: un flusso sequenziale che necessita di margine per terminare entro la sua finestra senza disturbare il primo carico di lavoro. Entrambi sono ben noti e gli array IBM sono ottimizzati per gestirli.
Il livello vettoriale è più difficile da caratterizzare perché le grandi tabelle di embedding vettoriali possono far apparire la ricerca vettoriale come un carico di lavoro ad alta intensità di banda: una grande scansione sequenziale. La caratterizzazione del percorso vettoriale di Oracle 26ai fornita da IBM è più vicina a un OLTP. Ogni passaggio attraverso l'indice corrisponde a una lettura casuale di circa 4 KB; il percorso di query è limitato dagli IOPS e sensibile alla latenza, e le letture sono predominanti perché le scritture avvengono in una fase di ingestione e di creazione dell'indice separata.
La larghezza di banda è importante nei picchi di traffico, ad esempio quando viene creato un indice o un corpus viene reinserito, e questi picchi tendono ad essere piuttosto elevati. Questa suddivisione è il fulcro del problema dell'I/O misto: nel percorso di interrogazione, il carico di lavoro vettoriale compete con le transazioni per le stesse code, rendendo l'isolamento un problema per la qualità del servizio. Ed è proprio durante le fasi di picco che la larghezza di banda della rete diventa il limite massimo, come dimostrano i risultati del confronto tra 32G e 64G presentati più avanti in questo articolo.
L'architettura validata
IBM e Broadcom hanno creato un ambiente per questa validazione nel laboratorio di intelligenza artificiale di Broadcom in Colorado. Lo storage è costituito da un array IBM FlashSystem serie 9000 con IBM Storage Virtualize 9.1.3 e 24 moduli FlashCore, che offrono porte Fibre Channel a 64G a una coppia di switch SAN Brocade Gen 8 G820. L'host del database è un server Intel Xeon 6767P a doppio socket con due SecureHBA Emulex LPe38102 a 2 porte da 64G, su cui è in esecuzione Oracle AI Database 26ai su ASM senza GPU nel percorso di storage; IBM Storage Insights monitora l'array.

Abbiamo eseguito i risultati relativi alla struttura e alla capacità, il confronto tra la ricerca vettoriale a 32G e quella a 64G e le misurazioni dell'ingombro utilizzando VectorDBBench sul dataset BioASQ da 1 milione di record su quel singolo host. La stessa configurazione supporta anche il carico di lavoro dell'applicazione. Un Supermicro 821GE-TNHR con due processori Xeon Platinum 8470 e otto GPU NVIDIA H100 da 80 GB ospita l'applicazione sanitaria e il relativo modello linguistico. Lo stack software include l'integrazione ONNX nel database di Oracle, Ollama che serve Llama 3 e NVIDIA cuVS. Uno switch Broadcom Tomahawk 5 e schede di rete Thor 2 da 400 GbE collegano i due server. Le dimostrazioni di QoS I/O, multi-tenancy, rilevamento ransomware e applicazioni sanitarie sono state eseguite in questo ambiente.

Secondo IBM, la famiglia FlashSystem ( 5300 e 5600, 7300 e 7600, e 9500 e 9600) utilizza lo stesso software Storage Virtualize e le funzioni qui illustrate, tra cui la limitazione I/O, AutoZoning, il rilevamento di ransomware, l'alta disponibilità basata su policy e la migrazione delle partizioni di storage, funzionano allo stesso modo con Oracle AI Database 26ai su qualsiasi di questi array allo stesso livello di codice. Prestazioni e densità variano a seconda del modello e della generazione del modulo FlashCore, pertanto ogni valore riportato in questo articolo si riferisce al sistema su cui è stato misurato.
Garantire prestazioni ottimali per i carichi di lavoro OLTP e vettoriali con QoS I/O
La prima domanda a cui IBM e Broadcom hanno cercato di rispondere è quella che ogni DBA si pone quando viene proposto un carico di lavoro vettoriale per l'array di produzione: cosa succede alle transazioni principali? IBM ha condotto due dimostrazioni sull'array FlashSystem serie 9000 utilizzando limitazioni I/O a livello di volume, il meccanismo alla base di ciò che IBM chiama I/O QoS. Il database era distribuito su 30 volumi: 15 per i tablespace OLTP (da ORCL16 a ORCL30) con Swingbench Order Entry e 192 utenti, e 15 per le tabelle vettoriali (da ORCL31 a ORCL45) con un generatore sintetico a 200 thread che eseguiva le prime k 500 query di similarità, con Storage Insights che tracciava i grafici per ciascun gruppo di volumi.
Con OLTP in esecuzione da solo, ogni volume OLTP manteneva una velocità costante di 20,500 operazioni/secondo. Quando il generatore di vettori è stato avviato, i volumi dei vettori sono saliti a circa 73,000 operazioni/secondo ciascuno in un minuto, mentre i volumi OLTP sono scesi a circa 13,000, con un calo del 37% senza alcuna modifica sul lato transazionale. Il percorso di ricerca dei vettori è costituito da letture casuali di 4 KB con la stessa dimensione del blocco delle transazioni, quindi accede alle stesse code e preleva tutto ciò che l'array gli fornisce.

Un limite di 45,000 IOPS su ciascun volume vettoriale, una riga di mkthrottle Tramite la CLI, i volumi vettoriali sono stati portati al limite e l'OLTP è tornato a circa 17,000 ops/s. La rimozione del limite ha invertito la situazione e, al termine dell'esecuzione del vettore, l'OLTP è tornato a 20,500. La dashboard ha registrato lo stesso risultato complessivo: 1.28 milioni di IOPS senza limitazioni e circa 950,000 al di sotto del limite, che, con una precisione di pochi punti percentuali, corrisponde alla velocità per volume moltiplicata per 30 volumi.

La seconda demo mostra la configurazione che IBM prevede di implementare in produzione: prima vengono impostati i limiti, 45,000 IOPS per volume vettoriale e 20,000 per volume OLTP, quindi entrambi i carichi di lavoro vengono avviati contemporaneamente. I volumi vettoriali hanno operato al loro limite massimo, i volumi OLTP si sono stabilizzati a circa 12,200 ops/s e sono rimasti costanti per tutta la durata dell'esecuzione, e l'array ha mantenuto 870,000 IOPS (800,000 in lettura, 70,000 in scrittura) a 377 microsecondi e 6.9 GB/s con un utilizzo della CPU del 25%. Il limite OLTP è rimasto al di sopra della richiesta del carico di lavoro e non è mai intervenuto; serve a impedire che un sovraccarico da una parte possa compromettere l'altra.
Swingbench ha mantenuto i suoi 192 utenti a circa 1.19 milioni di transazioni al minuto, ovvero circa 19,500 TPS, per tutta la durata del test. Il generatore è stato ottimizzato per saturare i volumi, quindi la sua latenza per query non rappresenta un benchmark dell'applicazione. Durante i 30 minuti di test, ha completato 35,672 query a una velocità di 19.8 al secondo, con una latenza mediana di circa 10 secondi e un p99 di 14.3 secondi a fronte di un timeout dell'applicazione di 15 secondi; 99 query (0.28%) hanno raggiunto il timeout, ma le transazioni non ne hanno risentito minimamente.


Il throttle di FlashSystem è un limite massimo di volume imposto a livello di array, indipendentemente dall'host o dal percorso, con un limite di larghezza di banda opzionale oltre al limite di IOPS; limita le risorse dei nodi vicini e non riserva nulla. Il limite è una questione di dimensionamento: 15 volumi vettoriali a 45,000 IOPS corrispondono a 675,000 IOPS di margine di capacità vettoriale, il che ha lasciato ai volumi OLTP di questo array la capacità necessaria. Un array o una configurazione diversi possono variare questo valore. Imposta il limite vettoriale in modo che le transazioni mantengano la loro latenza, e il carico di lavoro vettoriale riceverà tutto ciò che supera tale limite.
Rilevamento di ransomware su volumi Oracle attivi
Un'indagine condotta da Sophos nel 2024 su 2,974 organizzazioni colpite da ransomware ha rilevato che nel 94% dei casi gli aggressori hanno preso di mira i backup, che l'attacco è andato a buon fine nel 57% dei casi e che, in questi casi, i costi medi di ripristino sono risultati otto volte superiori. IBM ha impostato il test sulla stessa premessa, concentrandosi prima sui backup e poi sulla produzione, e ha indirizzato l'attacco al target di backup RMAN, lasciando intatti i volumi del database. RMAN ha scritto i suoi set di backup su volumi FlashSystem, è stato eseguito un simulatore di ransomware su di essi e l'array è stato lasciato indisturbato, senza alcun agente host interposto.
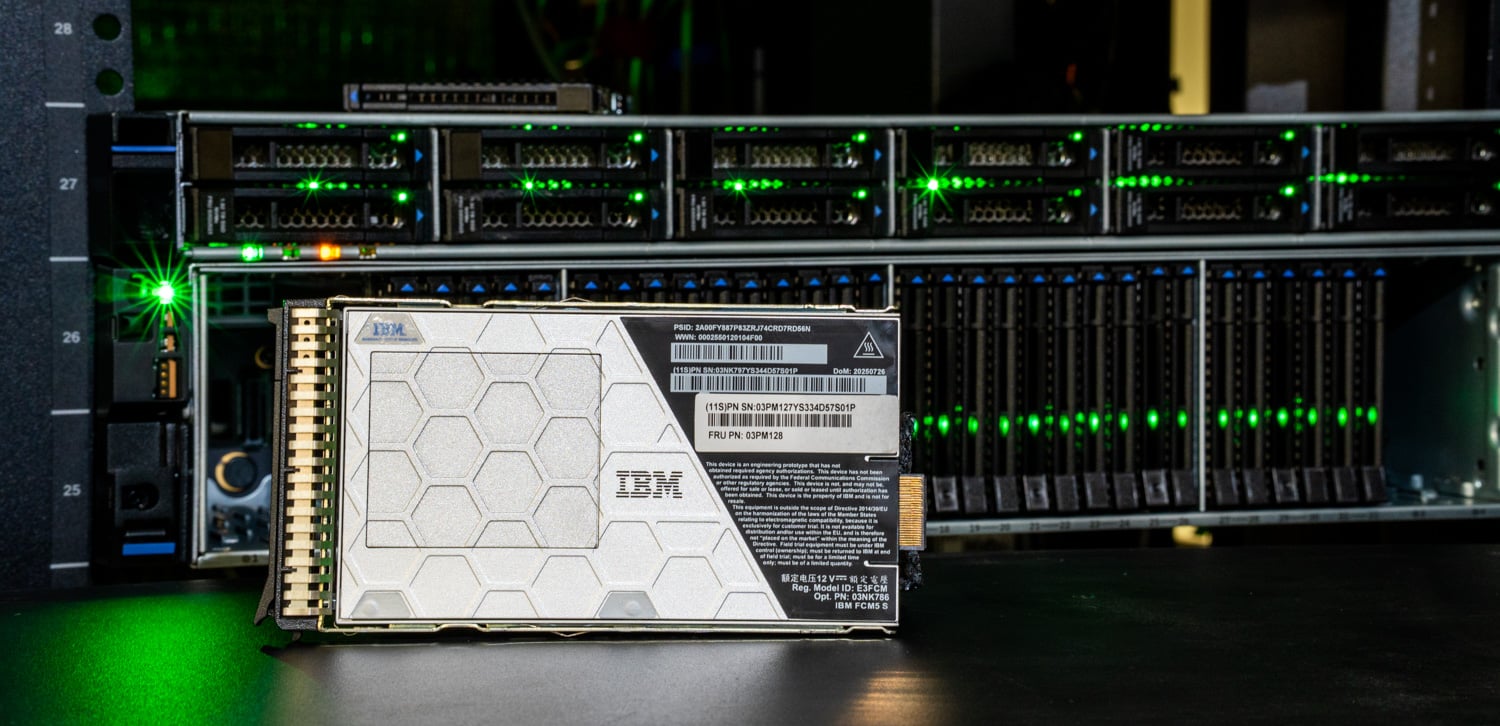
Il rilevamento avviene all'interno delle unità: i moduli FlashCore FCM4 e FCM5 calcolano l'entropia e la comprimibilità per ogni operazione di scrittura, insieme alla dimensione del blocco, all'indirizzo e ai pattern di riscrittura, e ogni due secondi inviano un riepilogo per volume a un motore di inferenza all'interno di Storage Virtualize (versione 8.6.3 o successiva con firmware FCM 4.1 o successivo). Il modello genera avvisi nell'interfaccia grafica di FlashSystem e in IBM Storage Insights Pro, li inoltra a Storage Defender o a un SIEM ed è aggiornabile autonomamente, pertanto un modello riaddestrato viene distribuito come un piccolo aggiornamento di sicurezza senza necessità di aggiornare il firmware.
Poiché l'analisi viene eseguita sul modulo, continua a funzionare anche quando è l'host a essere compromesso. L'output crittografato è ad alta entropia e smette di essere compresso, e questo si riflette nelle statistiche sia che l'attaccante modifichi le estensioni dei file, crittografi solo un blocco sì e uno no o rallenti la velocità per nascondersi da un agente di sicurezza dell'endpoint.
Durante la convalida, RMAN ha scritto il backup su 16 canali paralleli, con ogni set di backup limitato a 150 GB, e il database risiedeva su 15 dischi da 200 GB per gruppo di dischi ASM per i dati OLTP e vettoriali. IBM ha eseguito l'attacco contro tale destinazione di backup e l'avviso ha raggiunto Storage Insights in meno di 60 secondi, ovvero entro la finestra di rilevamento pubblicata da IBM per la funzionalità. Storage Insights ha segnalato tutti i 31 volumi del gruppo di volumi, poiché un avviso su un volume segnala l'intero gruppo come una minaccia.
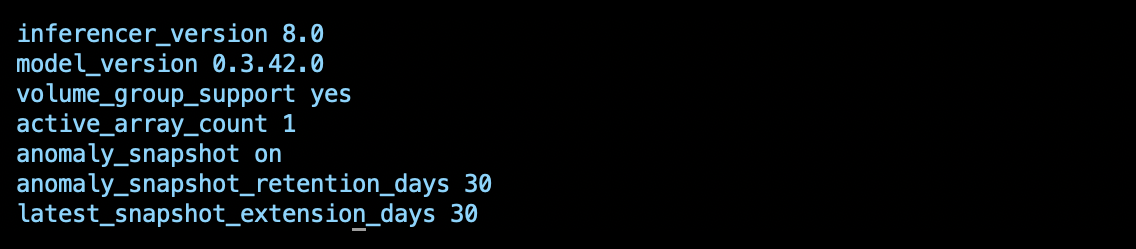
La risposta è Safeguarded Copy e l'array l'ha gestita senza un operatore: il FlashSystem ha acquisito un'istantanea immutabile del gruppo di volumi interessato nel momento in cui è stata rilevata la minaccia e ha esteso contemporaneamente la conservazione dell'ultima istantanea valida conosciuta. lsanomalydetection L'output dell'array mostra la configurazione sottostante: motore di inferenza 8.0 con modello 0.3.42.0, anomaly_snapshot attivo, 30 giorni di conservazione per il nuovo snapshot e 30 giorni aggiunti all'ultimo snapshot valido. Storage Virtualize contrassegna anche lo snapshot sospetto in modo che nessuno possa ripristinarlo, lasciando un punto di ripristino pulito precedente all'inizio della crittografia.
La struttura di rete include anche un livello di sicurezza. Broadcom integra la crittografia post-quantistica in Brocade Gen 8, gli Emulex SecureHBA crittografano i dati in transito tra host e rete, e il nuovo standard FC-SP-3 di FCIA definisce il livello di sicurezza di base per la tecnologia quantistica per Fibre Channel nel suo complesso.
Crescita SAN senza ticket di zonizzazione: AutoZoning di IBM FlashSystem tramite Broadcom Target-Driven Zoning
L'aggiunta di un host a una SAN Fibre Channel richiede in genere l'apertura di un ticket e l'intervento di due team: l'amministratore del server raccoglie i WWPN dell'HBA, l'amministratore della SAN crea manualmente le zone su entrambe le fabric e l'amministratore dello storage mappa l'host alle porte di destinazione corrette. Un singolo WWPN digitato in modo errato può lasciare un nuovo nodo Oracle RAC senza i percorsi di routing. AutoZoning sposta questo lavoro direttamente sull'array: FlashSystem comunica direttamente con la fabric, identifica i WWPN di inizio, seleziona le porte di destinazione e crea le zone autonomamente, senza che sia necessario l'accesso a uno switch.

Questa funzionalità si basa su Brocade Target Driven Zoning (TDZ) ed è stata introdotta nel software FlashSystem versione 9.1.2. Richiede switch Brocade con Fabric OS 9.1.1 o versioni successive, con TDZ abilitato dall'amministratore di fabric sulle porte dello switch rivolte verso le porte target di FlashSystem. Tale abilitazione è l'unico passaggio che rimane di competenza del team SAN e AutoZoning non interviene su una porta finché non viene completata. A quel punto, FlashSystem crea zone peer, consentendo agli host iniziatori di raggiungere la porta target ma non di comunicare tra loro, con un nome prevedibile IBM_SV_ che li identifica come gestiti dall'array.
La configurazione inizia nella vista delle porte Fibre Channel, che ora mostra lo switch a cui si connette ciascuna porta, se la porta è compatibile con AutoZone e se la sua connettività è simmetrica, ovvero se lo stesso ID di porta su ogni nodo si connette alla stessa rete. Una vista topologica visualizza queste informazioni a colori e solo le porte verdi attive, compatibili con AutoZone e simmetriche supportano AutoZoning. Le porte asimmetriche vengono escluse anche se altrimenti compatibili, poiché l'interfaccia grafica avverte che potrebbero compromettere la ridondanza e il failover.

La creazione degli host inizia da un elenco di host non configurati, compilato tramite FDMI, che comunica il nome host, il sistema operativo e le porte di ciascun HBA alla rete. Nella procedura guidata di IBM, la finestra di dialogo Aggiungi host si apriva con il nome del server, il sistema operativo e entrambe le porte HBA di un host che non aveva ancora zone configurate; l'amministratore selezionava un set di porte con AutoZone abilitato, che definisce le porte di destinazione raggiungibili dall'host, e faceva clic su Aggiungi. FlashSystem associava le porte di destinazione agli iniziatori host, inviava le zone a entrambi gli switch e l'host risultava online con quattro percorsi su due reti.

Per Oracle, IBM propone AutoZoning per l'aggiunta di nodi RAC e la sostituzione di HBA, poiché la funzionalità tiene traccia delle modifiche alla connettività degli host o dello storage e adatta le definizioni delle zone di conseguenza, in modo che un HBA sostituito non richieda una rizonizzazione manuale. La stessa automazione si applica quando gli host necessitano di percorsi verso un secondo array per la migrazione delle partizioni di storage o per l'alta disponibilità basata su policy (PBHA). Il team SAN continua a controllare quali porte di destinazione partecipano, poiché non accade nulla su una porta finché non viene abilitata la TDZ. Di conseguenza, l'aggiunta di un host non deve più attendere una modifica della zonizzazione.
Ambito operativo: PBHA, migrazione della griglia, multi-tenant e posizionamento.
La funzionalità Policy-Based HA (PBHA) replica in modo sincrono una partizione di storage tra due array FlashSystem distanti tra loro, con accesso host attivo-attivo in entrambi i siti. IBM afferma che questa funzionalità è progettata per un RPO pari a zero e per un failover dello storage che un'implementazione Oracle correttamente configurata in cluster può gestire senza perdita di dati. Quando il sito guasto torna operativo, i dati vengono risincronizzati e il carico di lavoro viene ripristinato senza interruzioni.
La funzionalità FlashSystem Grid federa fino a 32 array FlashSystem sotto un'unica vista di gestione e la migrazione delle partizioni di storage sposta una partizione, con i relativi volumi, gruppi di volumi e host, da un array all'altro senza tempi di inattività delle applicazioni. Per Oracle, IBM suggerisce l'aggiornamento hardware, svuotando un sistema prima di un aggiornamento del firmware e spostando una partizione vettoriale su un sistema con maggiore capacità man mano che il set di embedding cresce. Un sistema migra una partizione alla volta tramite Fibre Channel o Ethernet ad alta velocità; gli host possono connettersi tramite Fibre Channel, iSCSI o NVMe/TCP e una partizione già configurata per PBHA non è idonea alla migrazione.
Il sistema di pianificazione del posizionamento di Storage Insights gestisce la pianificazione per la stessa griglia. In base alla capacità del carico di lavoro, al tasso di crescita, al profilo I/O e al target di latenza, valuta ogni sistema nella griglia, classifica quello più adatto prima di qualsiasi provisioning e può anche consigliare una migrazione quando rileva uno squilibrio di CPU o IOPS. Sia la migrazione che il posizionamento utilizzano Storage Insights Pro, con ogni sistema della griglia registrato allo stesso tenant di Storage Insights.

La multi-tenancy consente a un team di DBA e a un team di IA di condividere la stessa griglia senza condividere l'amministrazione. Nella procedura guidata di IBM, un amministratore ha creato due tenant sullo stesso array (Tenant_Scale e Tenant_oracle_ai) e ha assegnato a ciascuno un sistema, un gruppo di utenti con un ruolo tenant e un primo utente. Ha quindi creato una partizione di storage per ciascuno con un gruppo di volumi, volumi e mappature host separati. L'interfaccia grafica offre la possibilità di configurare la replica non appena viene creata una nuova partizione. Accedendo come utente Tenant_Scale, l'interfaccia grafica mostrava solo la partizione e le risorse di quel tenant, senza nulla appartenente a Tenant_oracle_ai, e lo stesso controllo effettuato dal lato Tenant_oracle_ai ha restituito lo stesso risultato.
Il dividendo del tessuto: Fibre Channel 32G vs. 64G sotto ricerca vettoriale
L'unica variabile che IBM e Broadcom hanno modificato intenzionalmente in questi test è stata la rete Fibre Channel. Lo stesso array, host e SecureHBA Emulex LPe38102 hanno eseguito VectorDBBench sul dataset BioASQ 1M (un milione di vettori a 1,024 dimensioni dal corpus di domande e risposte biomediche) due volte: una volta con le due porte HBA a 32G e una volta a 64G, attraverso gli stessi switch Brocade G820. Tutto il resto, dai 16 volumi ASM alla SGA da 4 GB, è rimasto invariato, quindi la differenza tra le due esecuzioni è la generazione di Fibre Channel e nient'altro.

La fase di ricerca di questo benchmark è una scansione di sola lettura: l'indice IVF_FLAT di Oracle instrada ogni query a un cluster di partizioni e le legge per intero, e con vettori FLOAT32 a 1,024 dimensioni, questo rappresenta un carico di lavoro che richiede un'elevata larghezza di banda. Su due porte da 32G, le letture lato host si sono stabilizzate a 6.3 GB/s, la velocità di linea della coppia, e la curva di ricerca si è appiattita a 43.7 query al secondo con 20 thread. Su due porte da 64G, lo stesso host ha letto a 12.5 GB/s e ha continuato a scalare fino a 85.0 QPS con 80 thread, il 95% in più di throughput dallo stesso storage.

La latenza racconta l'altra parte della storia del 64G: con un solo thread, le due reti si discostano di meno dell'8%, ovvero 0.107 secondi contro 0.099, perché una singola query non satura mai nessuna delle due pipe. Da cinque thread in poi, tuttavia, il 32G mette in coda le query: la latenza media raddoppia il valore del 64G a ogni passaggio e, con 80 thread, p99 raggiunge i 4.08 secondi contro 1.14. Una rete FC satura non fallisce; mette in coda ogni query e questa attesa si manifesta come latenza di coda.

Anche la fase di caricamento si è spostata; l'acquisizione del milione di vettori ha richiesto 94.1 secondi su 32G e 84.5 su 64G, e la creazione dell'indice IVF_FLAT ha richiesto 139.6 secondi contro 108.4, il 28.8% in più sulla rete più lenta, per un caricamento totale di 233.7 secondi contro 193.0. Recall e NDCG sono rimasti entro lo 0.1% tra le due esecuzioni (83.81% e 84.42% su 32G, 83.95% e 84.56% su 64G), quindi la rete ha influenzato la velocità di risposta. Per un database che è stato su 32G sin dalla sua implementazione, l'aggiornamento dell'HBA e dello switch rappresenta un'ovvia opportunità per ottenere prestazioni migliori.
Pianificazione per la crescita della capacità di trasporto vettoriale
La ricerca vettoriale modifica i calcoli di capacità prima di influenzare le prestazioni. Un embedding è una copia numerica a larghezza fissa di un blocco di dati sorgente e, nel caso del testo, tale copia è solitamente più grande del blocco che descrive: un passaggio di 1,000 byte diventa un vettore FLOAT32 a 1,024 dimensioni di 4,096 byte prima che il database aggiunga una riga per contenerlo. Il team chiama questo processo amplificazione della memoria vettoriale e lo ha misurato sullo stesso dataset BioASQ 1M utilizzato nel confronto tra tessuti.
Il testo sorgente alla base del milione di vettori è di 0.90 GB. In Oracle 26ai, è diventato una tabella di vettori di 7.67 GB, inclusi circa 0.3 GB di overhead di riga, e l'indice IVF_FLAT ha aggiunto 8.57 GB in più perché mantiene una seconda copia clusterizzata di ogni vettore più circa 4 MB di centroidi. L'ingombro persistente sulla SAN è di 16.24 GB, 18 volte il testo sorgente, prima dello spazio operativo necessario a Oracle: da 15 a 23 GB di TEMP durante la creazione dell'indice e da 4 a 8 GB di UNDO e circa 15 GB di REDO durante l'acquisizione.

Il moltiplicatore varia in base al modello di embedding: Broadcom estrapola dallo stesso metodo, attribuendo a un modello Cohere v3 a 768 dimensioni (anch'esso misurato) un valore 4.8 volte superiore a quello della sorgente, a un MiniLM a 384 dimensioni un valore 9.6 volte superiore e a un modello Mistral a 4,096 dimensioni un valore 32.5 volte superiore. La dimensione del chunk è importante tanto quanto la larghezza, poiché un vettore ampio su un passaggio lungo amplifica meno dello stesso vettore su uno breve, e gli indici quantizzati riducono la quota dell'indice.
Nessuno di questi aspetti è specifico di FlashSystem o di Oracle. L'amplificazione avviene all'interno del database prima che l'array veda un byte, e ogni indice vettoriale su ogni piattaforma contiene una copia dei vettori, quindi deve essere incluso nel budget di capacità fin dal giorno in cui un progetto vettoriale viene approvato, insieme alle GPU. Ciò che l'array decide è quanta crescita può gestire: il modulo FlashCore di quinta generazione di IBM arriva fino a 105.6 TB per modulo, il che si traduce in 3.3 PB grezzi in un enclosure 2U sui modelli FlashSystem più grandi, 11.8 PB effettivi secondo i dati IBM, quindi un livello vettoriale può crescere in loco per anni prima che una partizione debba essere spostata.
Il modello di dimensionamento di IBM per l'applicazione sanitaria che segue funziona in modo opposto per le immagini: 100 GB di radiografie producono circa 2 GB all'interno del database, poiché lì risiedono solo gli embedding e i metadati dei casi. Il testo è il caso più oneroso: 100 GB di testo clinico suddiviso in blocchi occupano da 860 GB a 1.2 TB, la maggior parte dei quali indicizzati con HNSW. L'input per il dimensionamento è il numero di blocchi e la larghezza del modello; il corpus di origine non è un buon indicatore. Gli embedding, inoltre, vengono compressi meno delle righe, da 1.2 a 2 volte contro da 2 a 4 volte per i dati relazionali, secondo l'esperienza di IBM, quindi la riduzione dei dati del modulo FlashCore recupera una parte minore della crescita e ogni re-embed richiede nuovamente lo spazio TEMP.
La regola pratica di IBM è misurare prima di impegnarsi. Caricare dall'1 al 5% del corpus reale con il modello di embedding e le impostazioni di chunking di produzione, misurare i byte effettivi per vettore, quindi scalare linearmente e ripetere l'esercizio ogni volta che cambiano il modello, il numero di dimensioni o la politica di chunking.
Inferenza end-to-end basata sull'intelligenza artificiale: l'applicazione in ambito sanitario.
IBM ha sviluppato l'applicazione per questa validazione come assistente per radiologia e gastroenterologia, denominata RAD-AI. Si tratta di un'applicazione di esempio con requisiti di tipo produttivo, e in questo articolo viene illustrata una pipeline di inferenza completa sulla stessa matrice e struttura utilizzate nelle sezioni precedenti. Il medico inserisce l'età, il sesso e il sintomo principale del paziente, carica una radiografia del torace o un'immagine endoscopica e riceve un referto strutturato, creato a partire dai casi precedenti più simili presenti nell'archivio.
L'archivio contiene 112,120 radiografie del torace provenienti dal dataset NIH ChestX-ray14 e oltre 10,000 immagini di endoscopia gastrointestinale da HyperKvasir, inclusi vettori per fotogramma da 367 video endoscopici completi, per oltre 172,000 casi pre-incorporati. Ogni immagine viene trasformata in un vettore a 768 dimensioni da un modello CLIP ViT-L/14 in esecuzione all'interno di Oracle AI Database 26ai tramite il suo runtime ONNX, in modo che l'incorporamento avvenga nella stessa transazione della riga che lo contiene. Le immagini grezze rimangono nell'object storage; i vettori e i metadati dei casi risiedono in Oracle.

Al momento della query, Oracle esegue una ricerca approssimativa del vicino più prossimo tramite distanza coseno nell'archivio e restituisce i casi più simili, insieme ai relativi riscontri originali, diagnosi ed esiti. Questo insieme recuperato costituisce il contesto per Llama 3, gestito da Ollama su una delle GPU H100 del server Supermicro, che genera il report: una priorità clinica, un riepilogo dei risultati, una diagnosi differenziale classificata e le azioni raccomandate, con i casi corrispondenti elencati al di sotto. L'endoscopia segue lo stesso percorso e aggiunge una nota clinica; per i video, la pipeline incorpora i fotogrammi uno per uno in modo da poter tracciare una lesione lungo il tratto gastrointestinale.
L'applicazione esegue due carichi di lavoro sugli stessi volumi FlashSystem. Il carico di lavoro transazionale comprende accessi, archiviazione di report, registrazione di audit e sessioni; il carico di lavoro vettoriale esegue letture casuali ad alto fan-out sulle tabelle di embedding e sui metadati dei casi, in linea con il profilo del generatore nella dimostrazione di QoS I/O. L'implementazione di IBM imposta i limiti di velocità dei volumi descritti in precedenza, in modo che un'operazione di re-embedding batch non possa rallentare un medico che accede a un caso, e il rilevamento del ransomware e la migrazione delle partizioni mostrati sopra si applicano a questi volumi senza modifiche.

La fase che richiede maggiori risorse è la creazione dell'archivio, che IBM ha misurato incorporando due volte l'intero set di 112,120 immagini radiografiche del torace con lo stesso modello e lo stesso target VECTOR(768, FLOAT32). Con il modello ONNX in esecuzione all'interno del database sulle CPU host, la pipeline ha mantenuto una velocità di 3.41 immagini al secondo con un tempo di 0.272 secondi per incorporamento, e l'intero set ha richiesto 9.1 ore. Spostando il modello sul container Oracle Private AI Services sul secondo server, la velocità di elaborazione è aumentata a 8.55 immagini al secondo (0.097 secondi per immagine) e la stessa acquisizione è stata completata in 3.6 ore.

La preelaborazione (circa 0.019 secondi per immagine) e l'inserimento in Oracle (meno di un millisecondo) sono stati identici in entrambe le esecuzioni, quindi il guadagno di 2.5 volte deriva interamente dal punto in cui viene eseguito il modello. Il servizio di embedding di Private AI Services viene eseguito su un runtime ONNX con CPU, quindi le H100 presenti su quel server non sono state utilizzate in questo test; il guadagno è derivato dallo spostamento del modello dall'host del database, e la parte della pipeline che coinvolge la GPU è la creazione dell'indice, di cui parleremo in seguito.
IBM ha misurato questi valori nel laboratorio del Colorado; noi non abbiamo eseguito né verificato il test. In pratica, ciò che si può dedurre è che la prima incorporazione di un archivio, e ogni successiva incorporazione dopo una modifica del modello, è un'operazione batch che si misura in ore, mentre il recupero che ne consegue è un'operazione che richiede CPU e spazio di archiviazione e si misura in millisecondi.
Lo stesso container gestisce anche la creazione dell'indice. Oracle 26ai può inviare una build HNSW al Vector Index Service del container, che utilizza NVIDIA cuVS sulla GPU per costruire il grafo dei vicini prima di restituire l'indice completato al database. Le ricerche vengono quindi eseguite senza l'intervento della GPU. Nella registrazione di IBM, la build HNSW di base (32 vicini, efConstruction 200) ha richiesto 8.47 secondi nel database e 2.26 secondi con l'offload, una riduzione di 3.7 volte. Tale esecuzione ha utilizzato una piccola tabella dimostrativa, quindi conferma che il percorso funziona su questa configurazione; dobbiamo ancora misurare il numero su scala clinica.
L'applicazione dimostra la divisione del lavoro che è alla base di questo documento. Il server GPU ospita il modello linguistico e, durante la creazione o la ricostruzione degli archivi, i servizi di embedding e indicizzazione. Il database memorizza i vettori insieme ai record che descrivono, mentre l'array e la struttura gestiscono le operazioni di lettura e le transazioni di recupero. Nessun passaggio nel percorso di recupero utilizza un'API esterna e i dati dei pazienti non lasciano mai il data center.
IBM ha scelto il settore sanitario come ambito di applicazione per dimostrare la validità del concetto, e nessun elemento del modello è specifico di questo settore. Sostituendo l'archivio delle radiografie con lo storico delle richieste di rimborso, i registri di manutenzione o un catalogo prodotti, i tre elementi chiave rimangono gli stessi: vettori memorizzati accanto ai record che descrivono, generazione sul server GPU e recupero e transazioni su un unico array. Qualsiasi settore che esegua inferenze su dati già in suo possesso si basa sulla stessa architettura.
Quello che viene dopo
La validazione continua sullo stesso hardware: la Fase 2 sposta la cache KV del motore di inferenza dalla memoria GPU a FlashSystem sulla stessa infrastruttura Fibre Channel, in modo che un modello a contesto lungo mantenga a portata di mano una porzione maggiore del suo set di lavoro; il prossimo articolo di questa serie tratterà questo lavoro. IBM sta anche sviluppando una pipeline di aggiornamento consapevole del contenuto, con IBM Storage Scale AFM e Kafka che alimentano la vettorizzazione ONNX in-database con i nuovi documenti man mano che arrivano, in modo che l'indice vettoriale tenga traccia delle sue fonti senza un re-incorporamento batch. IBM prevede inoltre di estendere la stessa validazione dello storage agli altri database multi-modello che hanno aggiunto la ricerca vettoriale.
La Fase 2 mette in funzione anche il livello di sicurezza sui nuovi dati. Quando la cache KV viene spostata su FlashSystem, il contesto operativo di un modello sanitario (inclusa la cronologia del paziente) attraversa gli stessi collegamenti Fibre Channel dell'indice vettoriale e dei record transazionali. Gli Emulex SecureHBA crittografano i dati durante il transito tra host e fabric, mentre la crittografia post-quantistica di Brocade Gen 8 protegge il lato switch. Ogni fase aggiunge un carico di lavoro al fabric senza tuttavia introdurre un percorso in cui i dati viaggiano in chiaro.
Classifica: il profilo di IBM nella nostra pagina dedicata ai migliori array di storage ora include lo storage a blocchi FlashSystem oltre allo storage scalabile.
Questo rapporto è sponsorizzato da Broadcom. Tutte le opinioni e i punti di vista espressi in questo rapporto si basano sulla nostra visione imparziale del/i prodotto/i in esame.



 Amazon