

IBM은 AI 데이터 처리를 스토리지 계층에 직접 통합하는 콘텐츠 인식 스토리지(CAS) 아키텍처를 도입했습니다. 이 접근 방식은 스토리지 시스템 내에 문서 벡터화를 내장하여 외부 전처리 파이프라인의 필요성을 줄임으로써 검색 증강 생성(RAG) 워크플로우를 목표로 합니다.
CAS는 대규모 언어 모델 기반 기술을 활용한 문서 임베딩이라는 핵심 RAG 기능을 스토리지 인프라로 옮깁니다. 이를 통해 기업은 데이터를 제자리에서 처리하고 인덱싱하여 스토리지 시스템을 AI 기반 워크로드에 맞추고 인프라 계층 간 데이터 이동을 줄일 수 있습니다. IBM은 이를 통해 AI 애플리케이션의 배포를 간소화하고 성능 및 데이터 지역성을 향상시킬 수 있다고 설명합니다.
대규모 벡터 데이터베이스
IBM의 CAS 구현의 핵심은 의미 검색에 최적화된 벡터 데이터베이스입니다. 벡터 데이터베이스는 근사 최근접 이웃 검색을 지원하여 AI 시스템이 코사인 유사도 또는 L2 거리와 같은 유사도 측정 기준에 따라 관련 데이터 덩어리를 검색할 수 있도록 합니다. 이러한 기능은 RAG의 기반이 되며, RAG에서는 사용자 쿼리가 벡터로 변환되어 색인화된 기업 데이터와 비교되어 상황에 맞는 응답을 제공합니다.
출처 : IBM
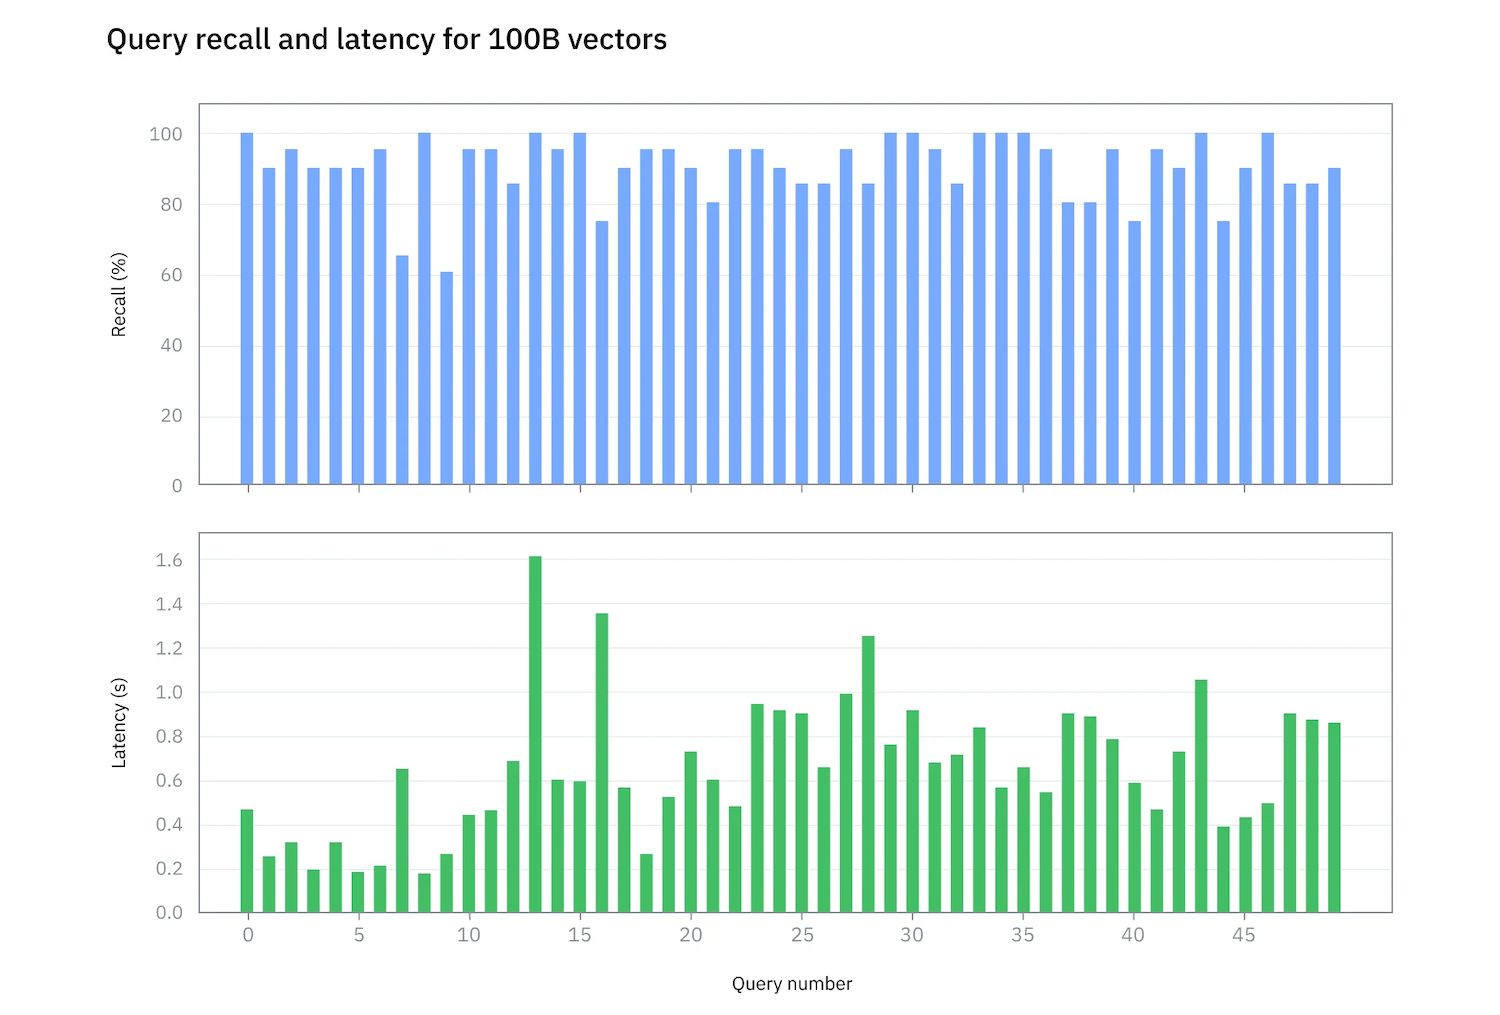
IBM 리서치는 삼성 및 NVIDIA와 협력하여 단일 서버에서 최대 100억 개의 벡터를 처리할 수 있는 프로토타입 시스템을 시연했습니다. 이 시스템은 90% 이상의 재현율과 정밀도를 달성했으며, 평균 쿼리 지연 시간은 700밀리초 미만이었습니다. 이러한 규모는 데이터 세트가 수십억 개의 파일로 구성되고, 완전히 인덱싱되면 수천억 개의 벡터에 달할 수 있는 엔터프라이즈 환경을 대상으로 합니다.
RAG 파이프라인 통합
RAG는 모델 재학습 없이 출력 정확도를 향상시키기 때문에 기업용 AI에서 선호되는 접근 방식으로 부상하고 있습니다. 이는 벡터 데이터베이스에서 가져온 기업별 데이터를 프롬프트에 추가하여 작동합니다.
이 파이프라인은 데이터 수집으로 시작되며, PDF 및 프레젠테이션과 같은 문서가 구문 분석되고, 청크화되고, 임베딩으로 변환됩니다. 이러한 임베딩은 효율적인 유사성 검색을 위해 데이터를 구성하는 벡터 데이터베이스에 저장됩니다. 쿼리 시 사용자 입력은 임베딩되어 저장된 벡터와 비교되고, 관련 콘텐츠는 컨텍스트로 언어 모델에 전달됩니다. 이러한 접지 메커니즘은 오류를 줄이고 AI 생성 결과에 대한 신뢰도를 높입니다.
IBM의 CAS는 이러한 파이프라인을 스토리지에 직접 통합하여 데이터 수집, 인덱싱 및 검색을 데이터에 더 가까운 곳에서 수행합니다.
규모 및 비용 문제 해결
엔터프라이즈 스토리지 시스템은 이미 페타바이트 규모로 운영되고 있습니다. CAS로 확장할 경우, 각 파일은 수백 개의 벡터를 생성할 수 있어 데이터셋 크기가 급격히 증가합니다. 기존 벡터 데이터베이스는 일반적으로 여러 서버에 걸쳐 확장되므로 비용과 운영 복잡성이 증가합니다. 또한 대규모 데이터셋의 인덱싱 및 재인덱싱 작업에도 많은 시간이 소요됩니다.
IBM의 접근 방식은 벡터 밀도를 향상시키고 인덱싱 오버헤드를 줄여 인프라 확산을 최소화하는 데 중점을 둡니다. 이 아키텍처는 벡터 및 인덱스 스토리지를 쿼리 컴퓨팅과 분리하여 스토리지 및 컴퓨팅 리소스를 독립적으로 확장할 수 있도록 합니다. 이는 IBM Storage Scale과 고성능 병렬 파일 시스템을 통해 구현됩니다.
스토리지 및 하드웨어 아키텍처
CAS 구현은 AI 및 고성능 워크로드에 맞게 설계된 올플래시 플랫폼인 IBM Storage Scale System 6000 (ESS 6000)을 활용합니다. 이 시스템은 4U 인클로저당 최대 48개의 NVMe 드라이브를 지원하며, 드라이브당 용량은 7TB에서 60TB까지 다양합니다. PCIe Gen5, 400Gb InfiniBand 또는 200Gb 이더넷 연결을 통합하고 노드당 최대 340GB/s의 읽기 및 175GB/s의 쓰기 처리량과 최대 7만 IOPS를 제공합니다.
이 플랫폼은 NVIDIA GPUDirect Storage를 지원하여 스토리지와 GPU 간의 직접적인 데이터 경로를 제공하며, 네트워크 및 데이터 처리를 오프로드하는 BlueField-3 DPU도 지원합니다.
삼성 PM9D3a PCIe Gen5 NVMe SSD는 높은 처리량과 고밀도의 스토리지를 제공합니다. 8세대 TLC V-NAND 기반의 이 드라이브는 장치당 최대 30.72TB의 용량을 제공하며, 순차 읽기 속도는 최대 12GB/s, 쓰기 속도는 최대 6.8GB/s입니다. 시중에서 구할 수 있는 엔터프라이즈급 SSD를 사용함으로써 표준 구성 요소를 활용하여 아키텍처를 확장할 수 있습니다.
계층적 인덱싱 및 GPU 가속
대규모 인덱싱 문제를 해결하기 위해 IBM은 독립적으로 최적화할 수 있는 여러 하위 인덱스로 구성된 계층적 인덱싱 모델을 개발했습니다. 이 구조를 통해 전체 데이터 세트를 중단하지 않고도 증분 업데이트 및 부분적인 재인덱싱이 가능해 가용성과 운영 효율성을 모두 향상시킬 수 있습니다.
GPU 가속을 사용하면 CPU만 사용하는 방식에 비해 인덱싱 시간이 크게 단축됩니다. CPU에서 몇 시간이 걸리는 작업도 NVIDIA GPU를 사용하면 몇 분 만에 완료할 수 있습니다. 테스트 결과, 100억 개의 벡터에 대한 인덱스를 구축하는 데 NVIDIA H200 GPU 6개를 사용했을 때는 4일밖에 걸리지 않았지만, 듀얼 소켓 CPU 시스템에서는 약 120일이 소요될 것으로 예상됩니다.
벡터와 인덱스를 포함한 전체 데이터 세트는 약 153TiB의 저장 공간을 사용했습니다. 초기 데이터 로딩 및 파티셔닝에는 9일이 소요되었습니다. 그 결과, 시스템은 무차별 대입 방식의 정답 데이터 계산을 통해 검증한 결과, 평균 쿼리 지연 시간 694ms, 재현율 90%를 달성했습니다.
로드맵 설정
IBM과 NVIDIA는 인덱싱 및 쿼리 지연 시간 단축에 중점을 두고 플랫폼 최적화를 지속하고 있습니다. 현재 목표는 하루 안에 1,000억 개 이상의 벡터를 인덱싱하고, 데이터 수집 시간을 9일에서 하루로 단축하며, 90%의 재현율을 유지하면서 쿼리 지연 시간을 50~100밀리초 범위로 낮추는 것입니다.
벡터 인덱싱을 표준 파일 시스템에 통합하는 것은 배포를 간소화하고 기업의 AI 도입 장벽을 낮추는 것을 목표로 합니다. IBM은 스토리지에 RAG 기능을 직접 내장함으로써 CAS를 AI 지원 인프라의 기반 계층으로 자리매김하고 있습니다.


 아마존