

NVIDIA는 SC26에서 과학 컴퓨팅용 신규 GPU인 Rubin HPC를 발표했습니다. Rubin HPC는 Vera Rubin 플랫폼의 구성원으로, 단일 GPU에 50,000만 개 이상의 CUDA 코어를 탑재했으며, NVIDIA는 2028년 출시를 목표로 하고 있습니다. NVIDIA는 SC26에서 이 외에도 2027년 초 출시 예정인 시뮬레이션 작업을 위한 192개 CPU로 구성된 Vera 랙, Nemotron for Science 오픈 모델 패키지, 새로운 CUDA-X 라이브러리, IBM 및 Fermilab과 공동 개발한 양자 공동 설계 플랫폼, 그리고 Lambda의 공동 패키징 광 스위치 배포 등을 발표했습니다.
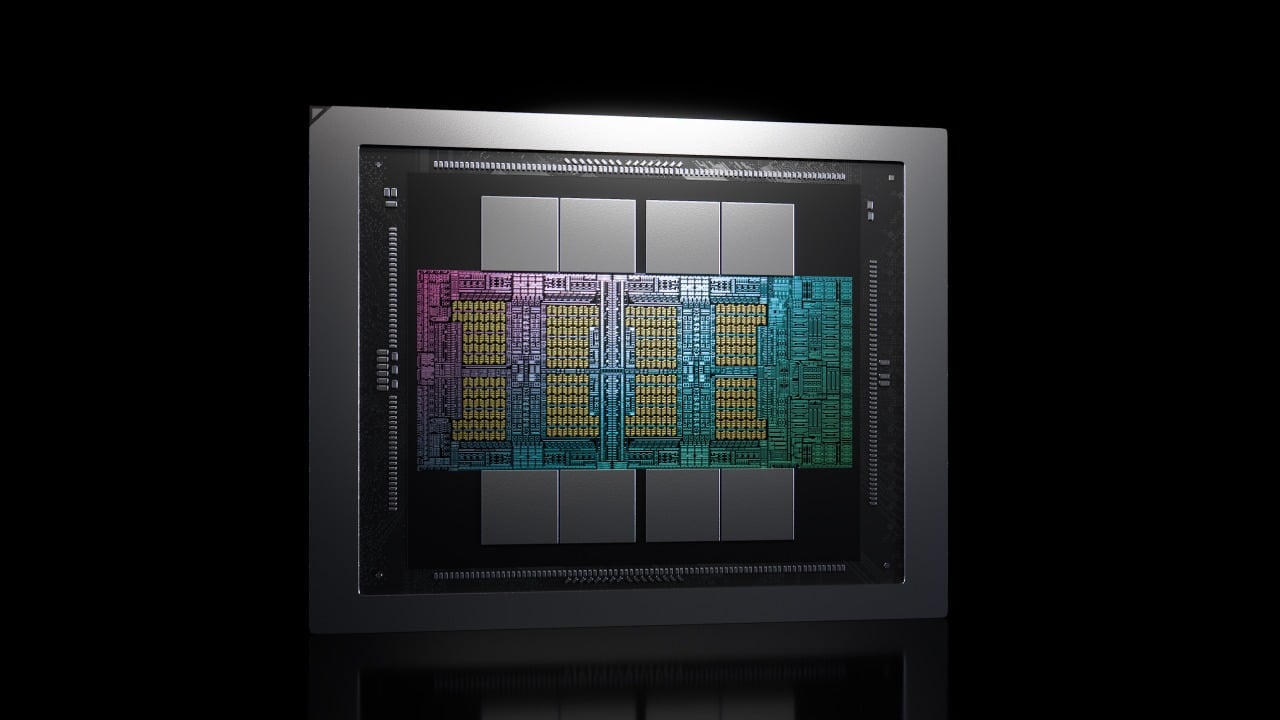
Rubin HPC GPU
NVIDIA는 Rubin HPC를 과학, 엔지니어링 및 분석 분야의 시뮬레이션 및 데이터 처리를 위한 GPU로, 컴퓨팅 성능과 함께 데이터 처리 속도를 확장하도록 설계되었다고 설명합니다. NVIDIA는 기록적인 코어 수 외에도, 7세대 NVLink를 통해 코어에 데이터를 지속적으로 공급하고 GPU 간 연결을 강화하는 희소 데이터 가속 기능을 강조합니다. 주요 작업 부하는 희소 행렬 연산, 스텐실 연산, 정렬 및 축소, 기후 모델, 엔지니어링 시뮬레이션, 유전체 분석 및 금융 위험 분석과 같은 패턴 분석입니다.

엔비디아는 SC26에서 Rubin HPC가 시뮬레이션 및 분석 성능을 3배 향상시키고 FP64부터 FP4까지 모든 정밀도를 지원한다고 발표했습니다. 하지만 3배 향상의 기준이 되는 수치는 밝히지 않았으며, 메모리 용량, FP64 처리량, 전력 소비량, 시스템 구성에 대한 정보도 공개하지 않았습니다. 엔비디아의 하이퍼스케일 및 고성능 컴퓨팅 부문 부사장인 이안 벅은 이 제품을 에이전트 기반 연구와 연관시키며, 과학 및 공학 문제를 해결하는 에이전트에게 "더 빠른 시뮬레이션은 더 빠른 발견을 의미한다"고 강조했습니다. 인텔 역시 이번 행사에서 동일한 시뮬레이션 워크로드에 적합한 FP64 지원 GPU D270을 선보였습니다.
HPC용 Vera CPU 랙
HPC용 Vera CPU 플랫폼은 액체 냉각 방식의 NVIDIA MGX 랙에 192개의 Vera CPU가 탑재되어 있으며, Quantum-X800 InfiniBand로 연결되어 약 300TB의 메모리, 1PB의 스토리지, 그리고 200TB/s 이상의 최대 메모리 대역폭을 제공합니다. 각 1U 트레이에는 8개의 CPU와 NVMe 스토리지 및 관리 모듈이 장착되며, 랙은 NVL72 시스템의 섀시, 전원 분배 장치 및 냉각 시스템을 재사용합니다. 각 CPU는 88개의 Olympus 코어, 176개의 스레드, 그리고 최대 1.2TB/s의 대역폭을 지원하는 SOCAMM2 LPDDR5X 메모리를 갖추고 있습니다.

이는 델과 슈퍼마이크로가 GTC 베를린에서 에이전트 샌드박스용으로 발표한 256 CPU 베라 랙 과는 다른 구성으로 , 긴밀하게 연결된 시뮬레이션을 위해 인피니밴드와 SHARP 네트워크 컴퓨팅이 추가되었습니다. NVIDIA는 델 테크놀로지스, HPE, 레노버, 슈퍼마이크로가 2027년 초부터 HPC 랙을 제공할 예정이라고 밝혔습니다. 독일 기후 컴퓨팅 센터(DKRZ)는 불(Bull)사가 구축하는 HLRE-5 슈퍼컴퓨터에 베라 CPU를 선정했으며, 이 슈퍼컴퓨터에는 GB200 시스템과 퀀텀-2 인피니밴드도 포함되어 있으며 2028년 초에 가동될 예정입니다.
NVIDIA는 Vera가 x86 CPU보다 두 배 높은 에너지 효율을 제공한다고 주장합니다. 자체 테스트 결과, Vera는 OpenFOAM motorBike Large 케이스에서 x86 시스템 대비 1.9배 높은 성능과 2.4배 높은 와트당 성능을 보여주었으며, 기상 연구 및 예측 모델에서는 1.6배 높은 성능과 2배 높은 효율을 예상한다고 밝혔습니다. 하지만 이는 NVIDIA에서 제공한 결과이며, 저희가 직접 실행하거나 검증한 것은 아닙니다. 또한 NVIDIA는 테스트에 사용된 x86 프로세서의 사양을 공개하지 않았습니다. 저희의 Vera CPU 리뷰 에서는 듀얼 소켓 Vera 시스템이 대규모 OpenFOAM 메시를 384코어 EPYC 9965 시스템보다 1.44배, 240코어 Xeon 6978P 시스템보다 1.20배 빠르게 완료하는 것을 확인했습니다.
소프트웨어 측면에서 NVIDIA HPC SDK 26.11이 현재 Vera에 최적화된 컴파일러와 라이브러리와 함께 제공되고 있으며, HPC 센터 및 국립 연구소와 협력하여 개발한 차세대 Fortran 컴파일러가 공개 베타 버전으로 제공되고 있습니다. NVIDIA는 이 컴파일러가 기존 Fortran 프로그램을 코드 수정 없이 자사 플랫폼에서 더 빠르게 실행할 수 있다고 밝혔습니다.
Nemotron for Science 및 CUDA-X 라이브러리
Nemotron for Science는 Nemotron 3.5 Super VL 오픈 모델과 과학적 평가, 학습 후 레시피, 그리고 약 50,000만 개의 화학 추론 문제로 구성된 오픈 데이터셋인 LitmusBench v0.2를 함께 제공합니다. 이 모델과 데이터셋은 현재 Hugging Face에서 이용 가능하며, NVIDIA는 이 모델이 128GB DGX Spark에서 로컬로 실행되도록 최적화되었다고 밝혔습니다. 아르곤 국립 연구소는 이 모델을 단백질 기반 치료제 개발을 위한 StructBioReasoner 다중 에이전트 시스템에 통합하고 있으며, 이켄 연구소는 RIKYU AI 슈퍼컴퓨팅 플랫폼에서 이 모델을 사용할 수 있도록 제공하고 있습니다.
모델을 사후 학습시킨 고객사 중 Lila Sciences는 양자점 합성 정확도를 거의 두 배로 높여 61%에 도달했는데, NVIDIA에 따르면 이는 GPT-6 Astra의 54% 정확도를 10~20배 낮은 추론 비용으로 능가하는 수치입니다. Terray Therapeutics는 화학 반응 다이어그램 판독을 위한 RxnScribe 테스트에서 주석이 달린 반응의 약 76%를 복구했습니다. KTH 왕립 공과대학의 에이전트는 단일 DGX Spark에서 하룻밤 만에 GROMACS 분자 동역학 설정의 손상된 부분을 81% 복구했습니다.
CUDA-X에 추가된 기능 중 cuPhoton 툴킷은 사건의 지평선 망원경(Event Horizon Telescope) 관측 결과를 8분 만에 상관 분석할 수 있도록 해줍니다. 이전에는 이 분석에 한 달 이상이 걸렸습니다. cuPotential은 기존 분자 시뮬레이션 소프트웨어의 속도를 최대 3배까지 향상시키고, Daviator는 비엔나 Ab initio 시뮬레이션 패키지(VASP)용 배치 처리 GPU 커널 세트로, 양자 역학 계산을 최대 22배 빠른 속도로 최대 75% 낮은 비용으로 실행할 수 있습니다. NVIDIA는 cuPotential과 Daviator의 성능 기준치를 공개하지 않았습니다.
cuSpa와 GPU 가속 HMMER 라이브러리가 오픈 소스로 공개되었습니다. cuSpa는 메모리얼 슬론 케터링 암 센터에서 세포 다각형 계산 시 CPU 대비 900배의 속도 향상을 보여주었고, HMMER 라이브러리는 베이스캠프 리서치에서 표준 HMMER보다 최대 84배 빠른 벤치마크 검색 속도를 달성했습니다. scverse와 공동 개발한 rapids-singlecell 라이브러리는 에이전트용으로 구축된 단일 컨테이너에 포함되어 제공되며, 10x Genomics는 이를 자사의 Sentira 플랫폼에 통합했습니다.
IBM 및 페르미랩과 함께하는 양자 공동설계
양자 컴퓨팅 분야에서 NVIDIA와 IBM은 페르미랩과 공동 개발한 모듈형 양자 공동설계 플랫폼을 지원하기 위해 IBM Quantum Nighthawk 프로세서를 탑재한 시스템을 포함한 IBM 양자 컴퓨터와 NVIDIA DGX B200 시스템을 함께 배치하고 있습니다. 연구원들은 이 플랫폼을 사용하여 오류 정정 코드, 디코딩 알고리즘, 고에너지 및 핵물리학 분야의 양자-고전 응용 프로그램을 평가할 예정입니다. IBM은 AMD 및 오크리지 국립 연구소와도 유사한 협력 관계를 구축하여 Nighthawk 프로세서를 Instinct MI355X 클러스터와 함께 사용하고 있습니다. NVIDIA는 시스템 배치 수량, 위치 또는 일정에 대해서는 밝히지 않았습니다.
한편, NVIDIA는 CUDA-Q QEC 0.9.0 라이브러리에 포함된 디코딩 알고리즘인 TCBP-JOBS를 공개했습니다. NVIDIA에 따르면 이 알고리즘은 기존 주요 알고리즘보다 최대 13,000배 빠른 속도로 디코딩하며, 새로운 양자 컴퓨터 설계에 필요한 계산 시간을 12주에서 45분으로 단축합니다. CUDA-Q 플랫폼에는 디코더 서버, 확장된 내결함성 기본 요소 세트, 재사용 가능한 애플리케이션 구성 요소로 이루어진 CUDA-Q 알고리즘 라이브러리, 그리고 큐비트를 구동하는 제어 펄스를 생성하는 CUDA-Q Pulse도 추가되었습니다.
NVIDIA는 슈퍼컴퓨팅 센터의 양자 프로세서 도입이 5년 만에 거의 7배 증가했으며, 현재 약 30개 센터에서 50개 이상의 프로세서를 사용하고 있다고 밝혔습니다. 11월 말 출시 예정인 Slurm 26.11에는 양자 인터페이스가 추가되어 QPU 개발자가 하드웨어를 단일 파일로 한 번만 정의하고 모든 센터에서 해당 통합을 재사용할 수 있습니다. 이 버전은 QRMI 및 QDMI 양자 HPC 인터페이스를 지원하며, IBM은 양자 리소스 관리 인터페이스(QRM)를 통해 이를 지원하고 있어 센터에서 CPU 및 GPU와 함께 양자 프로세서를 스케줄링할 수 있습니다. Alice & Bob, IBM, IQM, Pasqal, Quantinuum, MQSC 등이 이 버전을 채택하고 있으며, NVIDIA는 2025년 말 Slurm 개발사인 SchedMD를 인수했습니다 .
NVIDIA는 또한 2026년 ACM 고든 벨 상 최종 후보였던 IBM과 RIKEN의 양자-고전 화학 연구를 언급했는데, 이 연구에서는 최대 12,635개의 원자로 구성된 단백질-리간드 복합체의 결합 에너지를 계산했습니다. 이는 기존의 303개 원자 양자-고전 벤치마크보다 40배 이상 큰 수치입니다. 고전적 측면 계산은 NVIDIA GB200 시스템과 Quantum-X800 InfiniBand를 기반으로 구축된 RIKEN의 ROQUO 슈퍼컴퓨터에서 수행되었습니다.
플랫폼의 생태계 프로젝트 중 Altera와 Oxford Quantum Circuits는 NVQLink를 통해 큐비트 제어 및 판독을 GPU에 연결하는 FPGA 기반 양자 컨트롤러 를 개발했으며 , Quantum Motion은 QUICHE 화학 프레임워크를 CUDA-Q와 통합했습니다. QunaSys는 cuQuantum과 1,024개의 NVIDIA Hopper 세대 GPU를 ABCI-Q에서 사용하여 3억 개 이상의 양자 연산을 시뮬레이션하고 4개의 수소 원자 모델에 대해 화학적 정확도를 달성했습니다. NVIDIA 연구원들은 JUPITER 슈퍼컴퓨터를 사용하여 실제 노이즈 환경에서 10⁴개의 큐비트를 시뮬레이션했습니다.
Lambda는 공동 패키징된 광학 장치를 배포합니다.
Lambda는 10,000개 이상의 GPU를 배포하는 환경에서 NVIDIA Photonics의 코패키지드 옵틱(CPO) 스위치를 사용하여 GB300 NVL72 랙을 연결하고 있습니다. 각 스위치는 800Gb/s 속도의 144개 포트와 현장에서 기술자가 교체할 수 있는 18개의 외부 광원을 갖추고 있습니다. 반면 플러그형 옵틱의 경우 레이저에 문제가 발생하면 전체 모듈을 교체해야 합니다. NVIDIA에서 제시한 테스트 결과에 따르면, 랙 규모에서는 네트워크 지연 시간이 약 4% 감소하고, 포드 규모에서는 최대 약 10%까지 감소하면서 플러그형 옵틱과 동일한 처리량을 유지하는 것으로 나타났습니다.

배포 환경에서 광학 부품의 평균 온도는 36°C였으며, 기존 플러그형 광학 부품의 평균 온도는 51°C였습니다. NVIDIA는 자사의 포토닉스 스위치가 플러그형 설계 대비 최대 5배의 전력 효율, 최대 15배의 신뢰성, 그리고 4배 적은 레이저를 제공한다고 밝혔습니다. 또한 NVIDIA는 이번 행사를 통해 CUDA 출시 20주년을 기념했으며, 현재 11만 명 이상의 개발자와 1,000개 이상의 CUDA-X 라이브러리를 보유하고 있다고 발표했습니다.


 아마존