

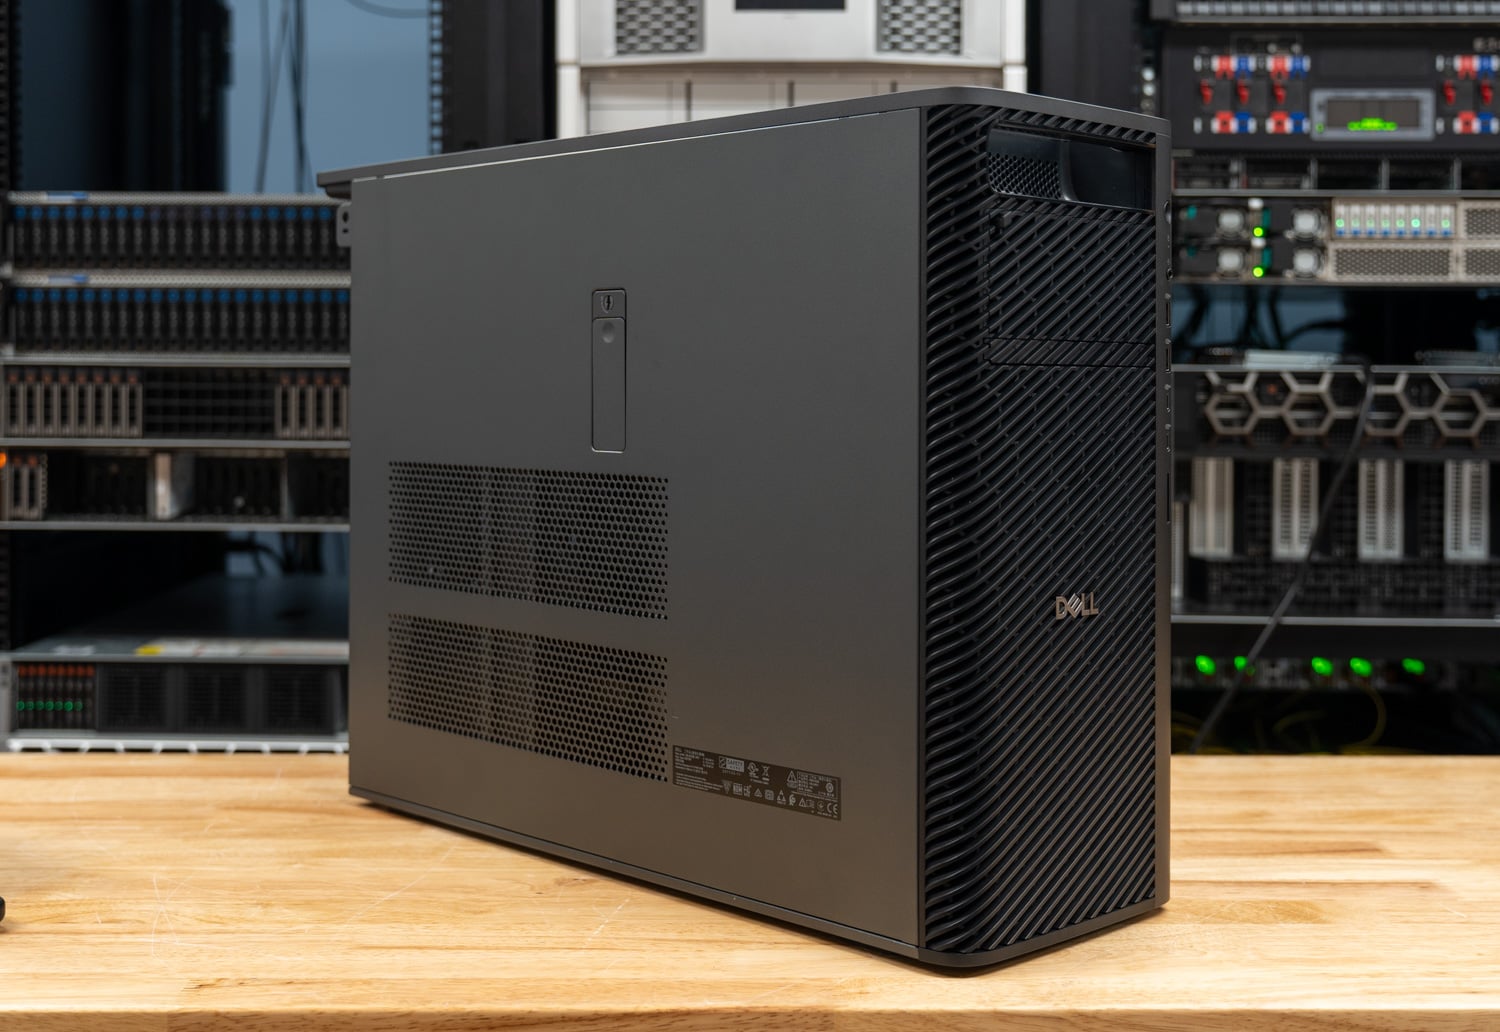
델 프로 프리시전 9 T4는 델 프로 프리시전 라인업의 최상위 싱글 소켓 타워형 워크스테이션입니다. 저희 리뷰 제품은 일반 워크스테이션에서는 구현하기 어려운 규모의 로컬 AI 환경을 구축할 수 있도록 구성되었습니다. 인텔 86코어 제온 698X 프로세서, 256GB DDR5-6400 ECC 메모리, 96GB GDDR7 메모리를 탑재한 300W NVIDIA RTX PRO 6000 블랙웰 맥스-Q 그래픽 카드 두 장, 2TB Gen5 SSD 두 개, 그리고 2400W 파워 서플라이를 사용하는 듀얼 포트 25GbE 어댑터가 장착되어 있습니다. 델 공식 웹사이트에서 동일한 구성으로 구매할 경우 가격은 약 66,600달러입니다.
주요 요점
- 두 개의 GPU를 사용하면 하나의 그래픽 카드에 담을 수 없는 모델도 사용 가능한 모델로 만들 수 있습니다. 129.3GB 용량의 MiniMax M2.7은 두 개의 RTX PRO 6000 카드를 모두 사용할 경우 한 사용자에게 초당 83.7개의 토큰을 생성했는데, 이는 카드 하나만 사용하고 나머지 메모리는 시스템 메모리에 있을 때보다 초당 30.3개의 토큰이 2.8배 높은 수치입니다.
- 두 번째 GPU는 서버 성능을 1.85배에서 2.02배까지, 임베딩 성능을 1.92배 향상시켰습니다. Ministral 3 3B에서 llama.cpp의 최대 출력은 초당 582.5개에서 1,176.1개 토큰으로, gpt-oss 120B에서는 GPU당 서버 1개를 사용했을 때 초당 424.8개에서 787.9개 토큰으로 증가했으며, 위키피디아 구절 백만 개를 임베드하는 데 걸리는 시간은 890초에서 464초로 단축되었습니다.
- 두 번째 GPU를 사용하니 LoRA 에포크 처리 시간이 37% 단축되었습니다. Ministral 3 8B에서 LoRA의 한 에포크를 수행하는 데 단일 GPU에서는 31.5분, 두 GPU에서는 19.7분이 걸렸으며, 최종 홀드아웃 손실은 각각 1.169와 1.167이었습니다.
- 메모리 대역폭은 T4의 제온 프로세서가 우위를 점하는 부분입니다. STREAM Triad는 328GB/s의 속도를 기록했는데, 이는 Precision 7875에 탑재된 Threadripper PRO 9995WX보다 53% 높은 수치입니다. 또한 T4는 OpenFOAM drivAer 솔브를 293초 만에 완료했는데, 이는 기존 제품의 556초보다 빠른 기록입니다. 10억 자리 y-cruncher 실행은 53.9초 만에 완료했는데, 기존 제품의 83.7초보다 빠른 기록입니다.
- Precision 7875는 코어 활용도가 높은 CPU 작업에서 우위를 점합니다. 96코어 스레드리퍼는 7-Zip에서 37%, Blender Monster에서 30% 더 빠른 성능을 보였으며, LLVM 빌드는 58.4초에서 43.7초로 단축되었습니다.
Pro Precision 9 T4의 위치
델은 T4를 AI 개발, 엔지니어링 시뮬레이션, 과학 컴퓨팅 등 최고 수준의 컴퓨팅 밀도와 확장성을 필요로 하는 기업을 위한 플래그십 싱글 소켓 타워 워크스테이션으로 포지셔닝하고 있습니다. T4는 동일한 Granite Rapids-WS Xeon 6 워크스테이션 플랫폼을 사용하는 소형 섀시의 Dell Pro Precision 9 T2( GPU 1개 탑재)보다 상위 모델입니다. T4는 최상위급 8채널 프로세서(최대 86코어)와 모델에 따라 최대 4개의 그래픽 카드 장착 공간을 제공합니다.
Dell.com에서 제공하는 프로세서 옵션은 12코어 Xeon 634부터 시작하여 64코어 Xeon 696X를 거쳐, 저희 테스트 차량에 탑재된 86코어 Xeon 698X까지 다양합니다. Xeon 698X는 336MB 캐시, 2.0GHz 기본 클럭, 4.8GHz 최대 클럭, 350W 정격 전력을 갖추고 있습니다. 메모리는 16개의 슬롯에 걸쳐 최대 4TB의 DDR5 RDIMM을 지원하며, 저희 테스트 차량에는 6400MT/s 속도의 32GB 모듈이 8개 슬롯에 장착되어 있습니다. 그래픽 카드는 RTX A400 1개부터 시작하며, 카드 개수는 모델에 따라 다릅니다. Dell의 구성 도구에서는 RTX A1000 4개, RTX PRO 4000 Blackwell 3개, 300W RTX PRO 6000 Max-Q 2개 또는 600W RTX PRO 6000 1개를 선택할 수 있습니다.
델 공식 웹사이트(Dell.com)에서 기본 구성 가격은 5,925달러입니다. 저희가 구성한 사양에는 Xeon 698X 프로세서(8,300달러), 256GB 메모리(15,000달러), 그리고 RTX PRO 6000 Max-Q 그래픽 카드 두 개(30,820달러)가 추가되었으며, 여기에 스토리지, 네트워크 구성, 그리고 델에서 이 가격대에 자동으로 제공하는 36개월 ProSupport 업그레이드 비용이 포함되어 있습니다.
빌드 및 디자인
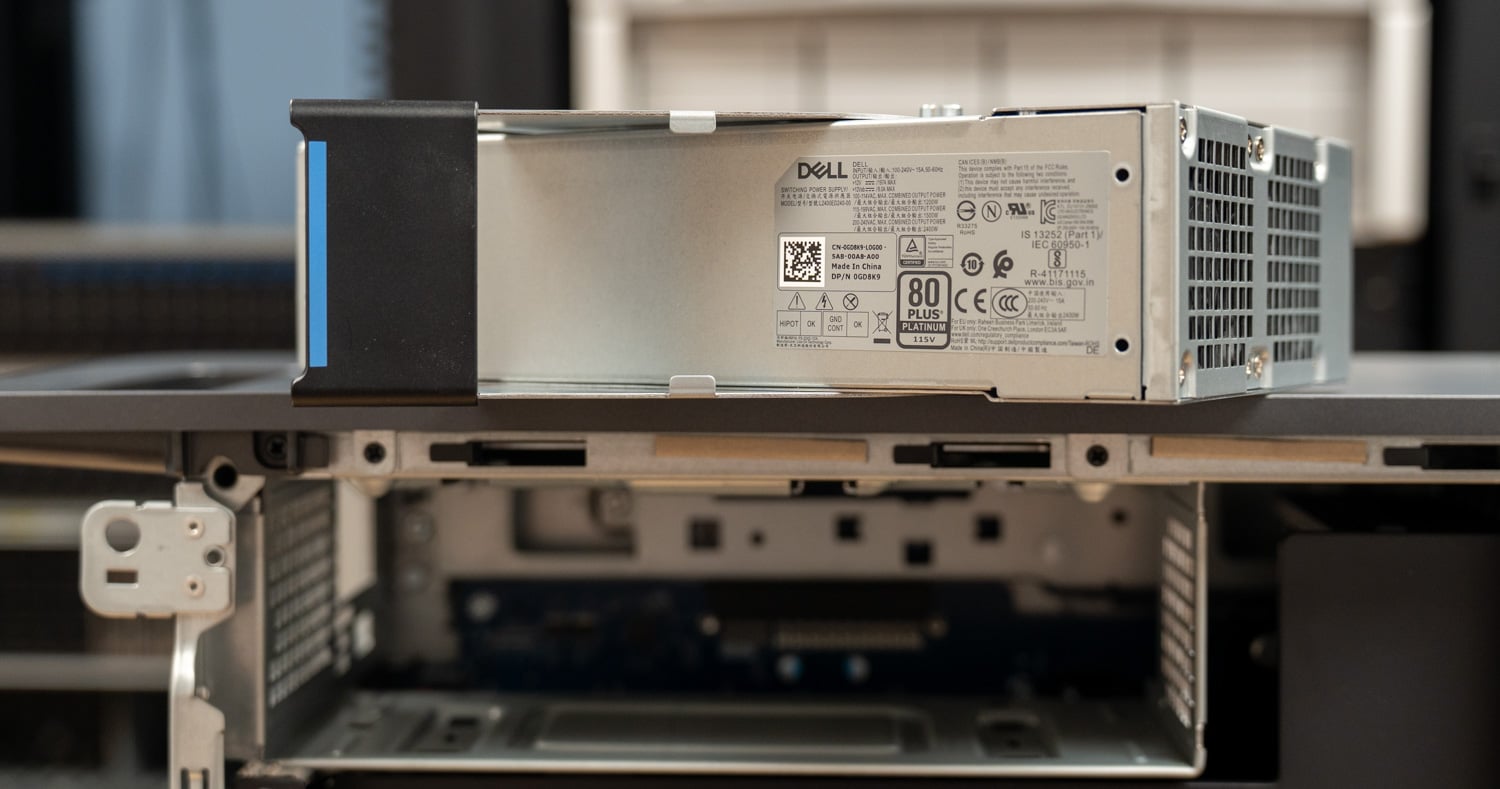
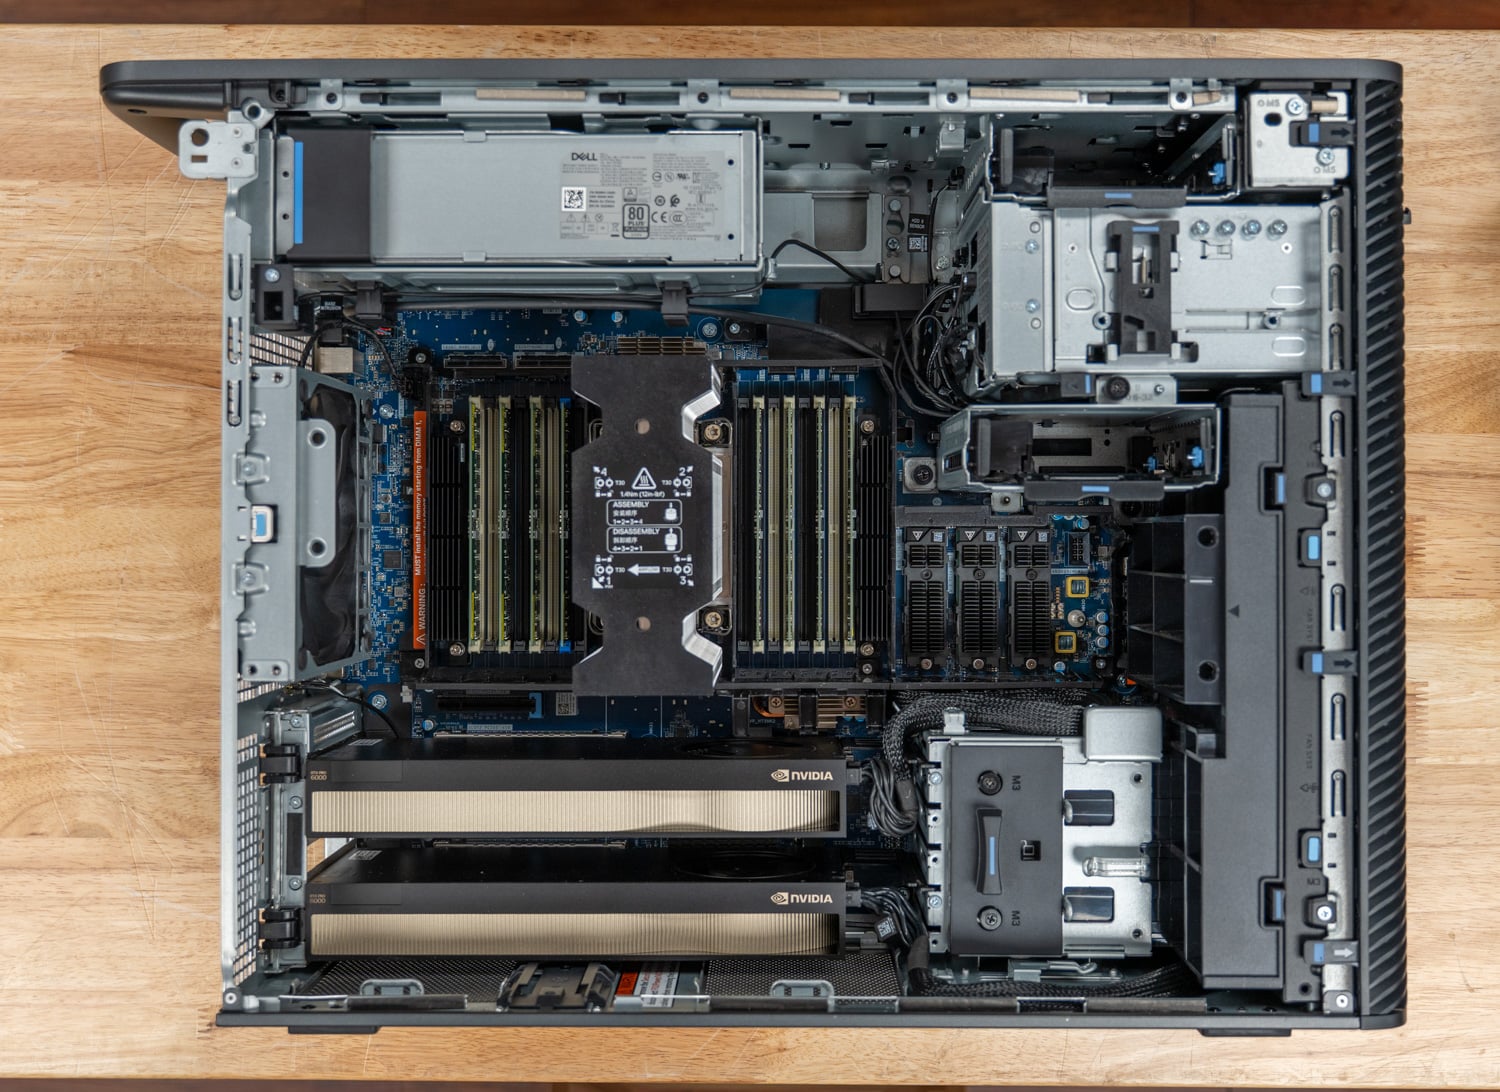
T4는 높이 449.8mm, 너비 203.7mm, 깊이 617.5mm의 풀타워 케이스이며, 델은 구성에 따라 최소 24.1kg에서 최대 33.6kg까지의 무게를 명시하고 있습니다. 저희 테스트 장치는 2400W 플래티넘 파워 서플라이를 사용하는데, 이는 델의 구성 도구에서 듀얼 RTX PRO 6000 구성에 기본적으로 선택되는 사양이며, 더 가벼운 구성에서는 1500W 파워 서플라이가 기본으로 제공됩니다.
T4의 가장 큰 장점 중 하나는 뛰어난 유지보수성입니다. 측면 패널의 래치를 통해 공구 없이 접근할 수 있고, 2400W 파워 서플라이는 섀시 상단 후면에서 손으로 밀어서 분리할 수 있습니다. 그래픽 카드와 SSD를 포함한 나머지 부품들은 모두 십자 드라이버로 분리할 수 있으며, 델 특유의 파란색 터치 포인트가 손으로 분리해야 하는 부품들을 표시해 줍니다. 연구실에서는 사용자가 현장에서 쉽게 수리할 수 있다는 점을 확인했는데, 이는 이 가격대의 워크스테이션에 있어 매우 중요한 요소입니다.
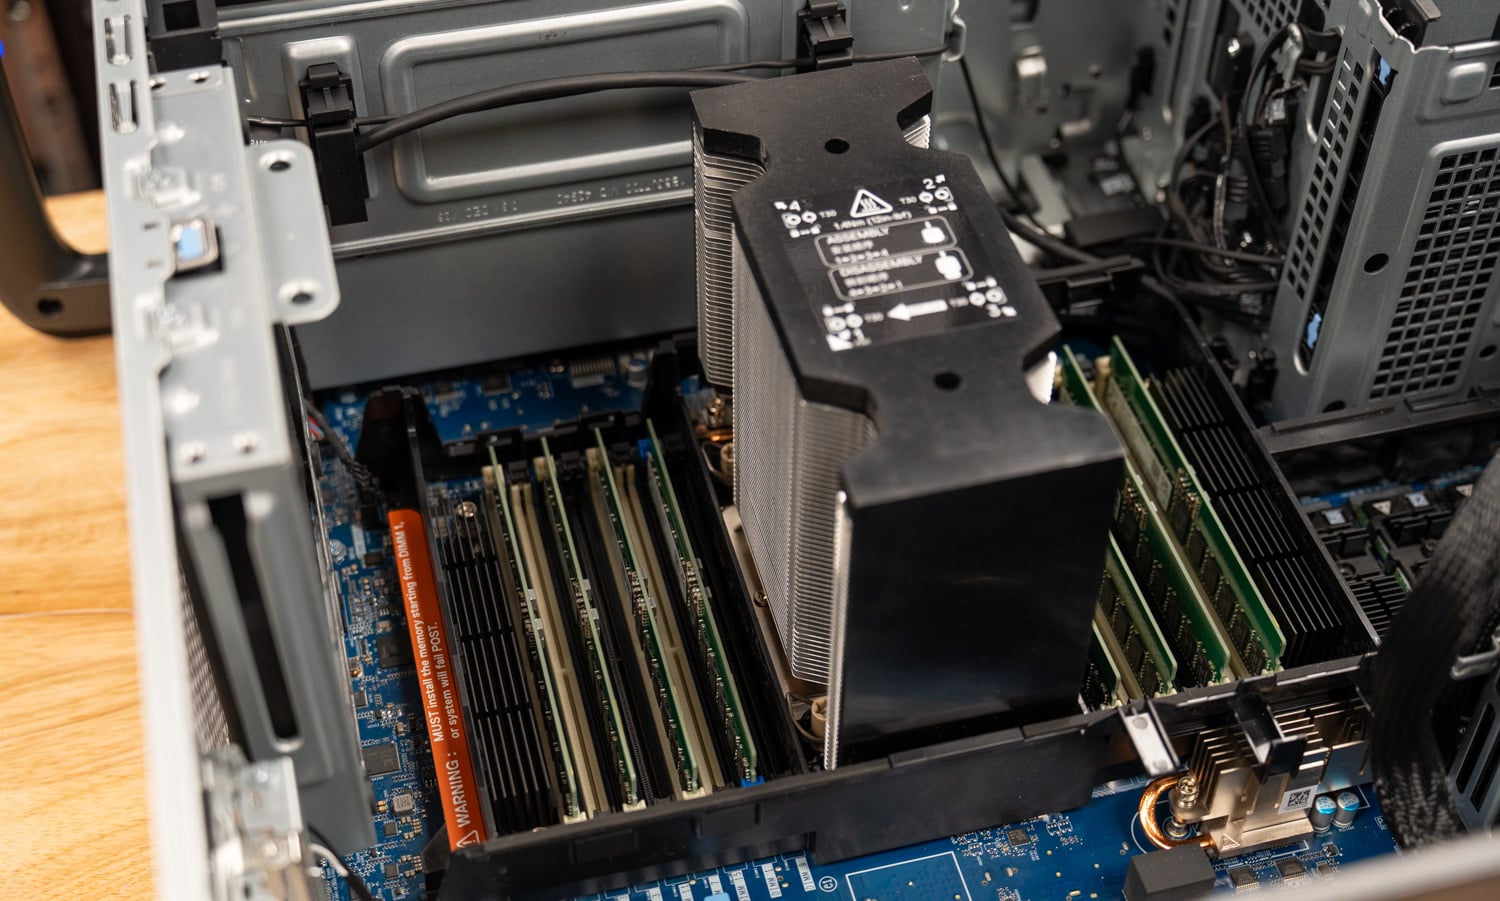
냉각 성능은 동급 타워 케이스 중 델에서 가장 뛰어난 수준입니다. 공기는 전면에서 후면으로 흐르며, 크기에 꼭 맞는 대형 커버가 프로세서와 메모리 쪽으로 공기를 불어넣어 냉각하는 동시에 PCIe 영역과 메모리 영역을 분리합니다. 따라서 두 개의 300W 그래픽 카드는 별도의 공기 흐름을 이용하므로 350W 제온 프로세서의 열을 흡수하지 않습니다. 커버를 장착한 상태에서 프로세서 영역과 그래픽 카드 베이 사이에는 두 개의 팬이 위치하며, 본체는 동일한 파란색 터치 포인트를 유지하고 분리하여 메모리에 쉽게 접근할 수 있습니다.
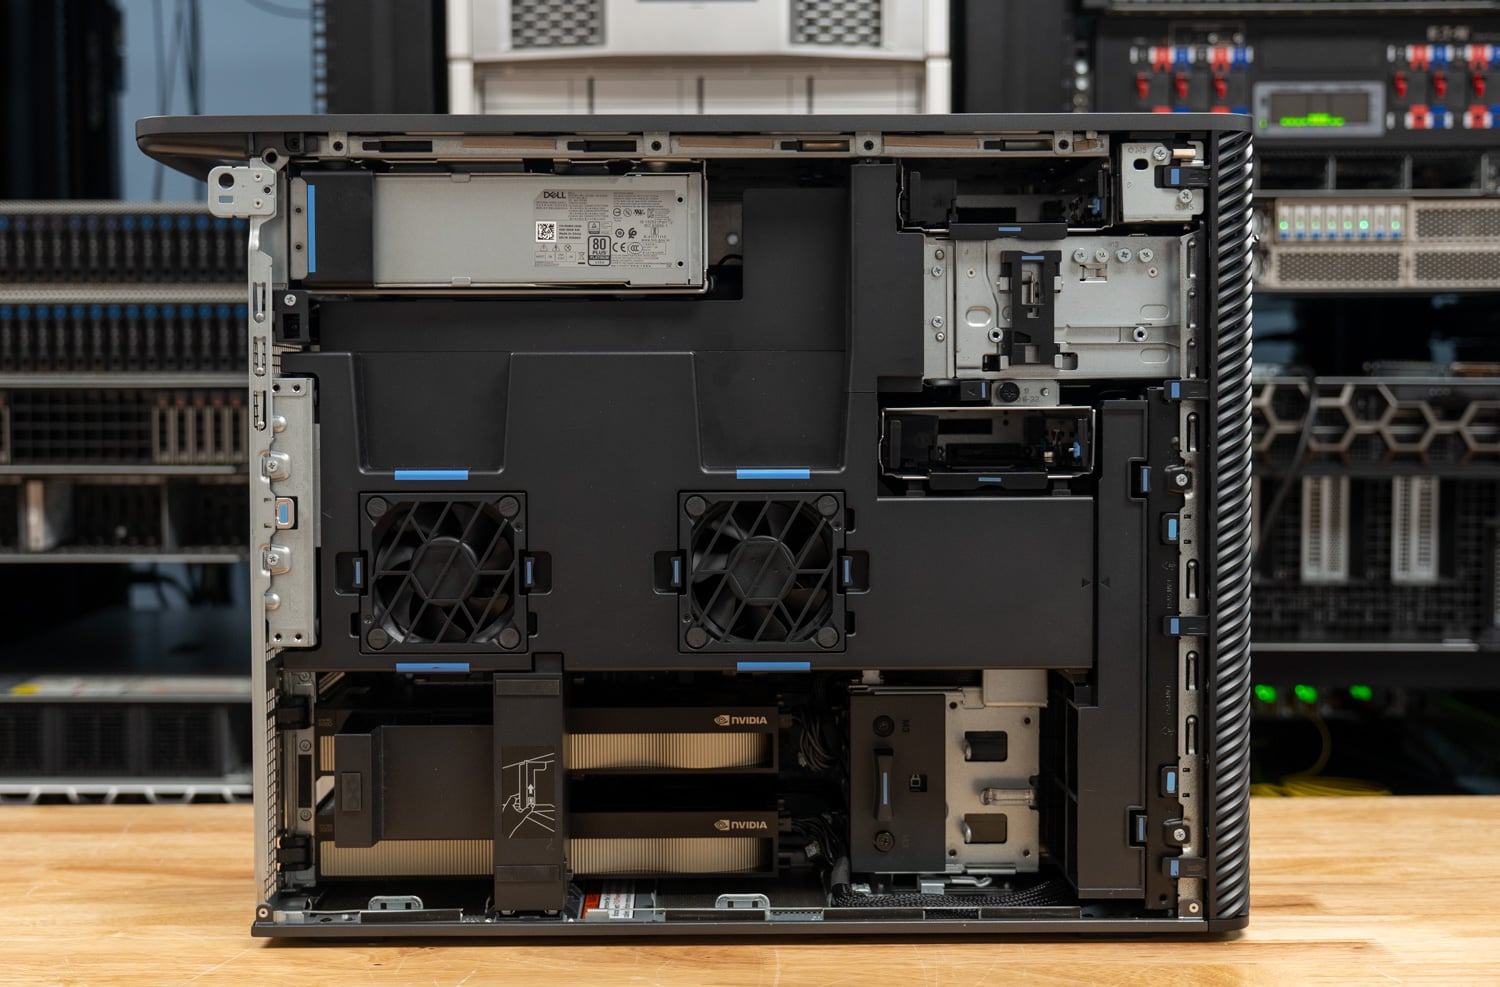
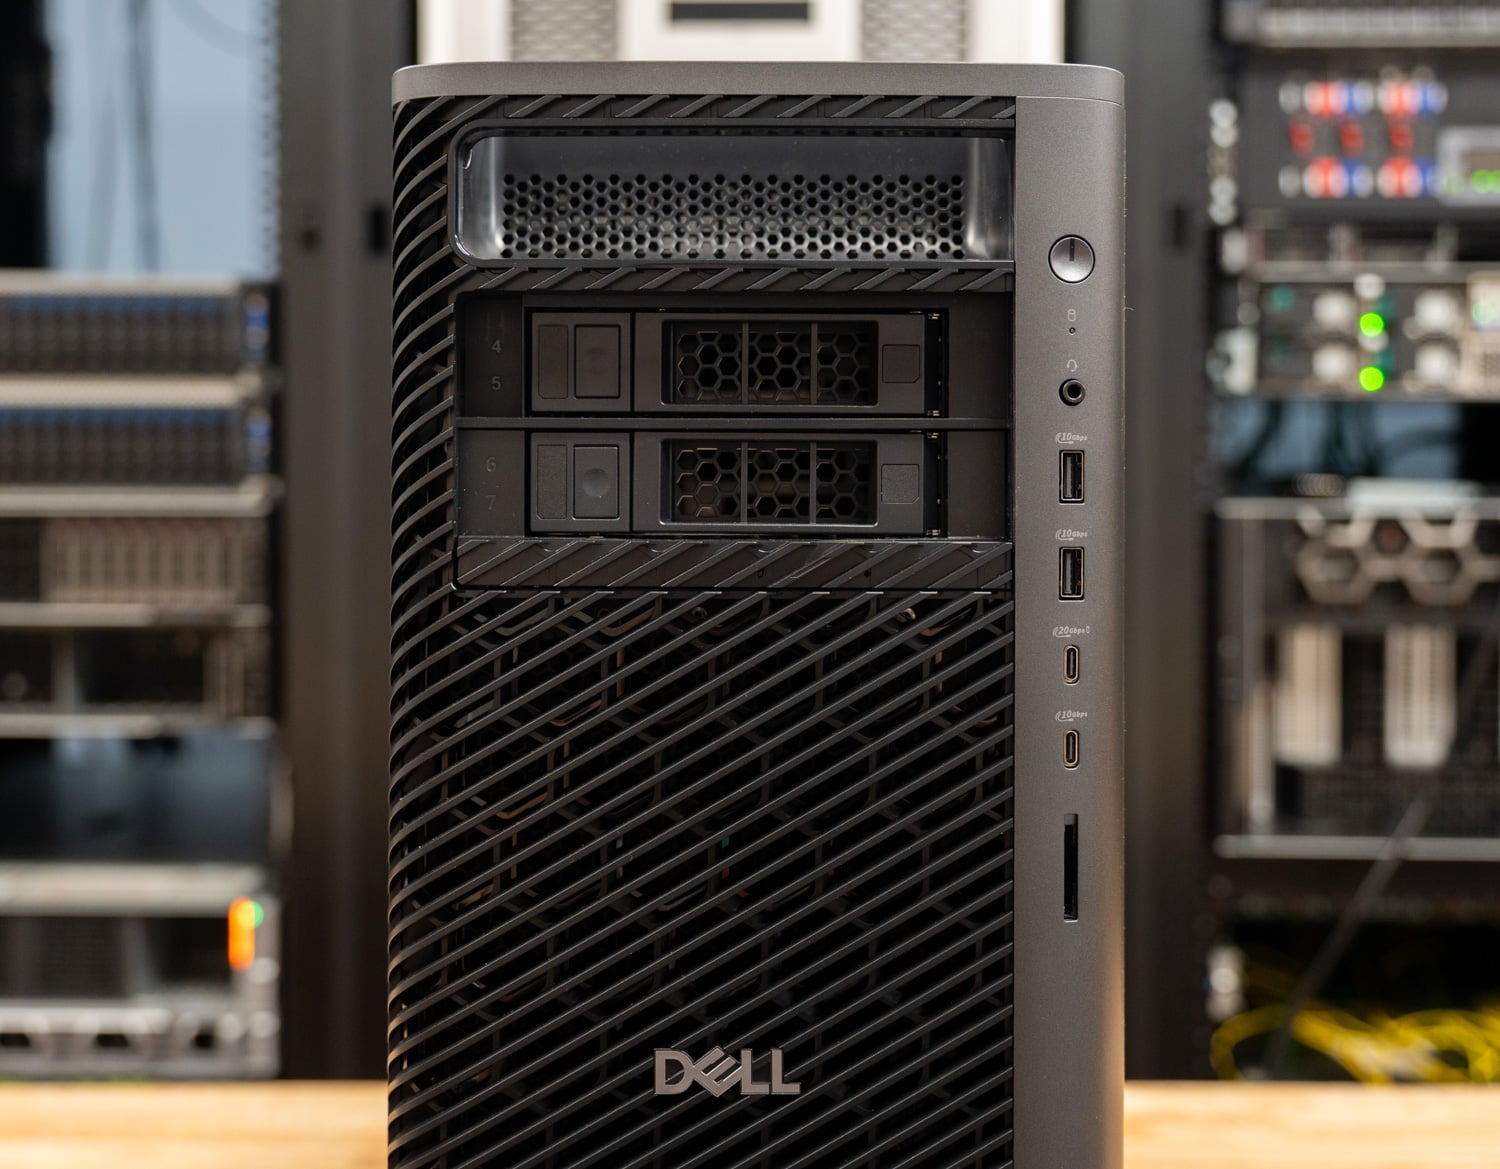
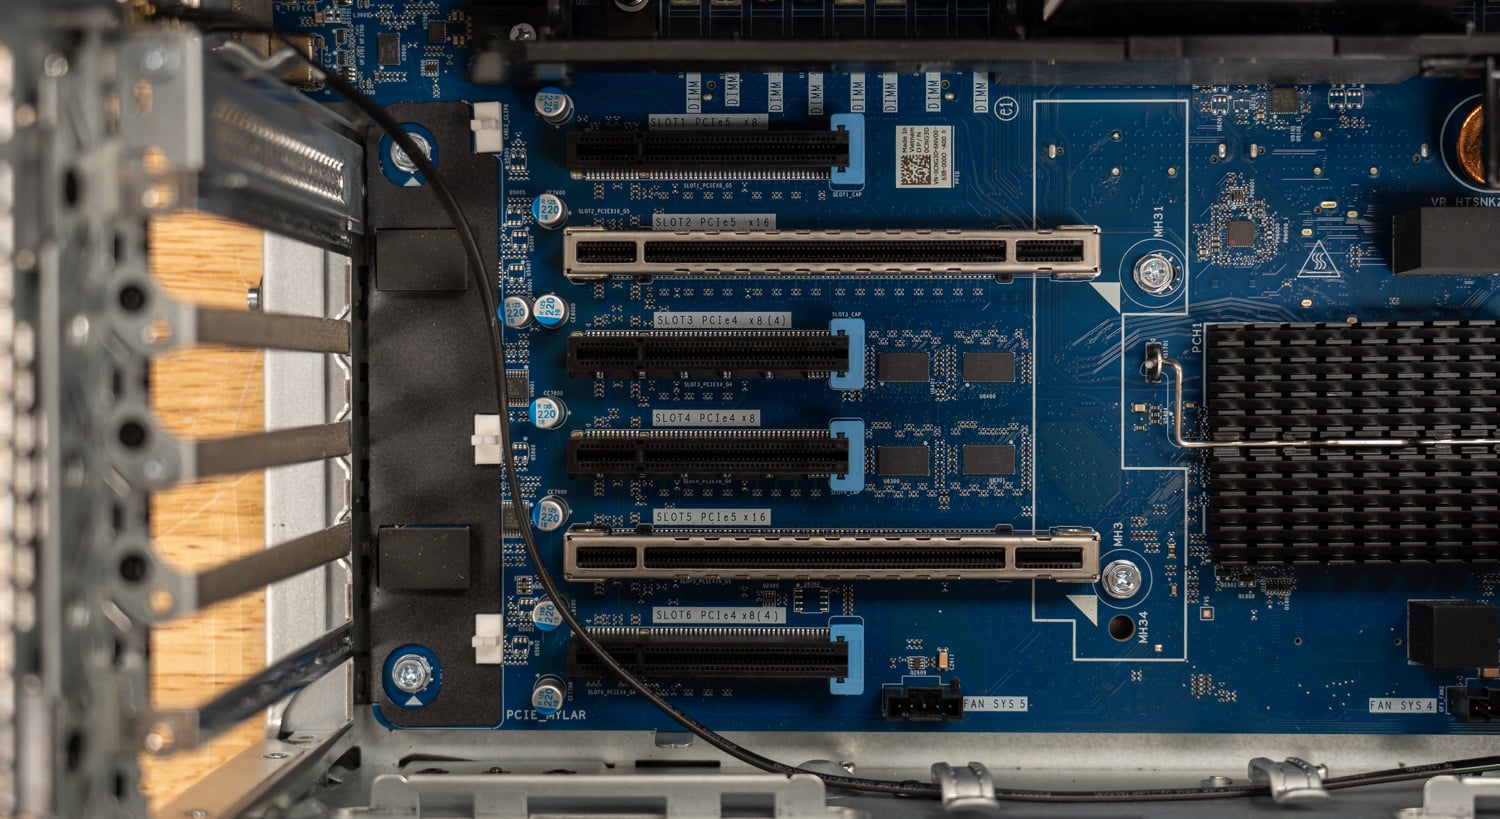
확장성은 6개의 풀 사이즈 PCIe 슬롯을 통해 제공됩니다. GPU를 장착하는 Gen5 x16 슬롯 2개, Gen5 x8 슬롯 1개, Gen4 x8 슬롯 1개, 그리고 x8 커넥터와 x4 배선을 갖춘 Gen4 슬롯 2개가 있습니다. 저장 장치는 내부 M.2 Gen5 슬롯 3개와 Gen4 슬롯 1개, 내부 3.5인치 SATA 베이 2개, 그리고 최대 4개의 NVMe 드라이브 또는 2개의 3.5인치 드라이브를 장착할 수 있는 전면 FlexBay를 지원하며, 슬림형 광학 드라이브는 옵션으로 제공됩니다. 저희 테스트 장치는 내부 2TB Gen5 드라이브에서 부팅하며, 내부 M.2 슬롯에 2TB Gen5 드라이브가 하나 더 장착되어 있습니다.
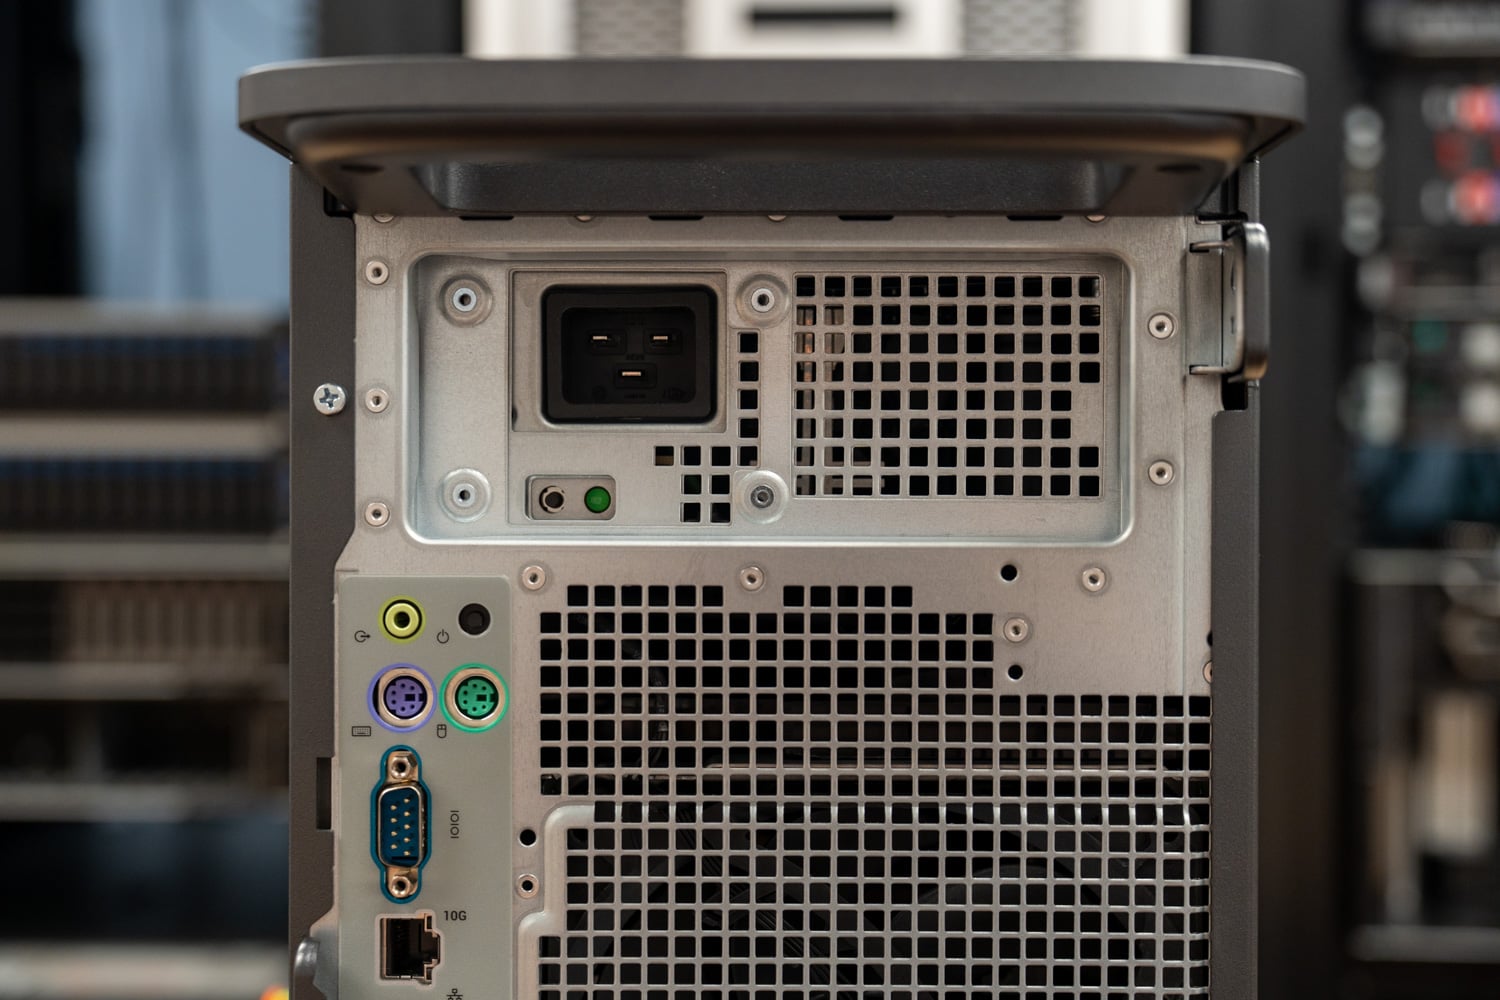
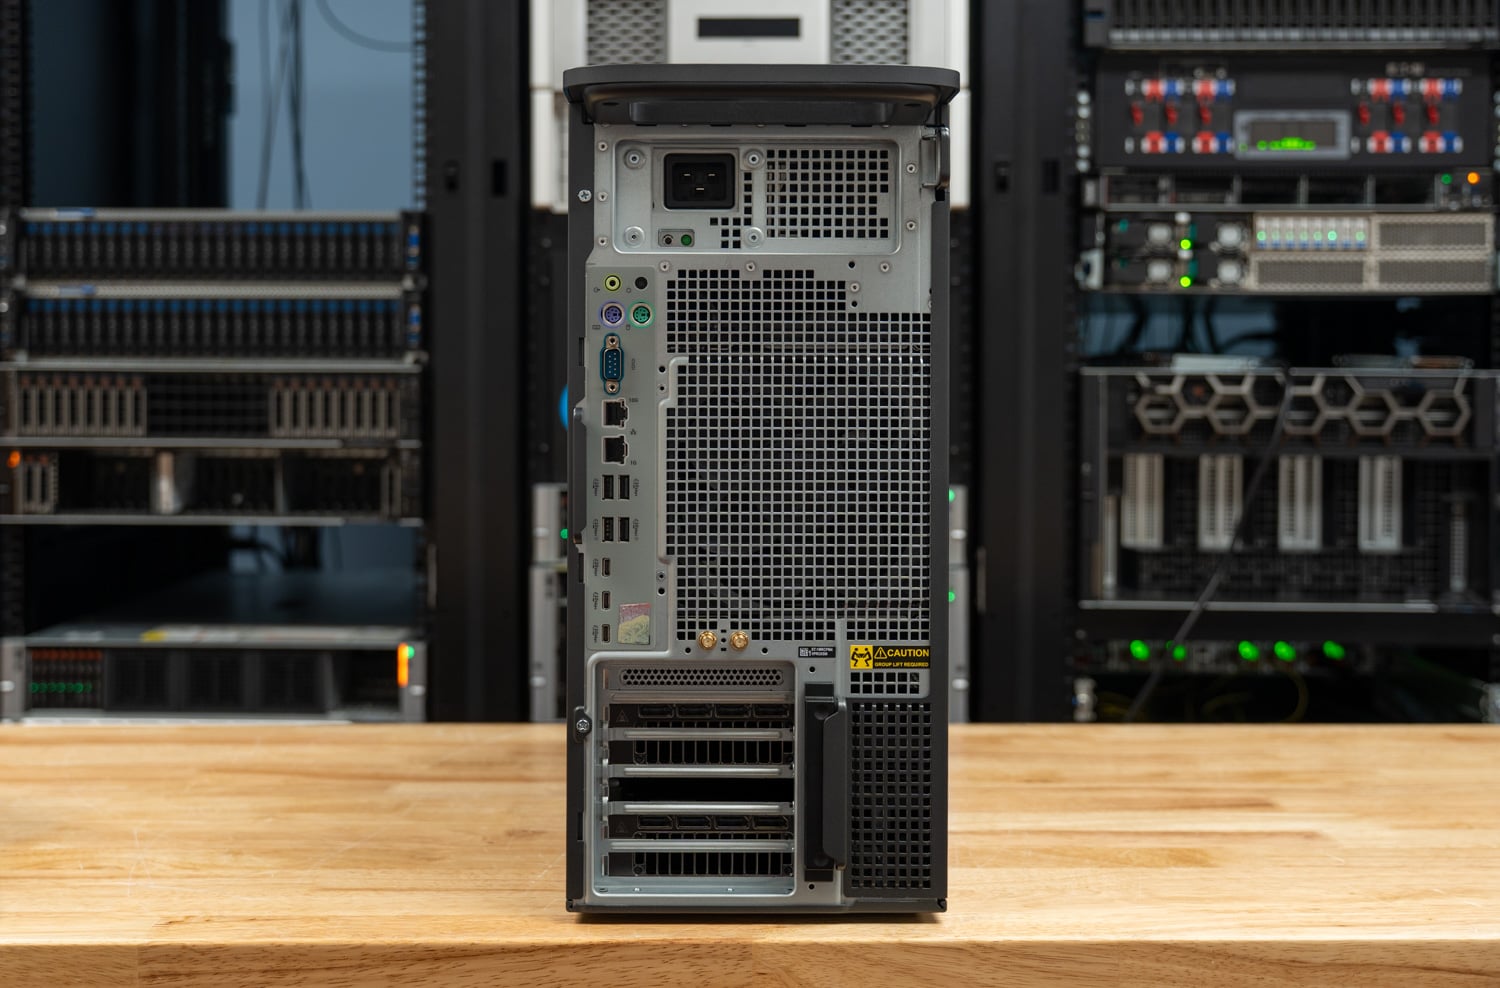
전면 패널에는 헤드셋 잭, 10Gbps USB-A 포트 2개, PowerShare 기능이 있는 20Gbps USB-C 포트 1개, 10Gbps USB-C 포트 1개, 그리고 옵션으로 SD 카드 슬롯이 있습니다. 후면에는 10GbE 및 1GbE RJ-45 포트, 10Gbps USB-A 포트 4개, 10Gbps USB-C 포트 2개, 20Gbps USB-C 포트 1개, 시리얼 포트, PS/2 포트 2개, 그리고 라인 출력 단자가 있습니다. 저희 테스트 장치에는 Intel E810-XXV 듀얼 포트 25GbE SFP28 어댑터, MediaTek Wi-Fi 7 MT7925(Bluetooth 5.4 지원), 미디어 카드 리더기, 그리고 Dell의 듀얼 USB-C 확장 카드가 추가되어 있습니다.
보안 및 관리 기능에는 TPM 2.0, Dell SafeBIOS, 섀시 침입 감지, 자체 암호화 드라이브 지원, BIOS 보안 삭제 및 Intel vPro Enterprise가 포함됩니다. Dell은 T4의 주요 구성 요소에 최대 85%의 재활용 플라스틱, 손잡이에 90%의 재활용 알루미늄, 섀시에 11%의 재활용 강철을 사용했으며, 에너지 스타(ENERGY STAR) 인증을 획득했다고 밝혔습니다.
델 프로 프리시전 9 T4 사양
| 스펙 | 델 프로 프리시전 9 T4 (테스트 결과) |
|---|---|
| 플랫폼 | |
| 모델 | 델 프로 프리시전 9 T4 (PW9T4260) |
| 프로세서 | 인텔 제온 698X, 86코어, 172스레드, 336MB 캐시, 기본 클럭 2.0GHz, 최대 클럭 4.8GHz, 350W |
| 프로세서 옵션 | Xeon 634(12코어)부터 Xeon 698X(86코어)까지 |
| 메모리 | 256GB(8x 32GB) DDR5-6400 RDIMM ECC 16개 슬롯, 최대 4TB |
| 그래픽 업로드 | NVIDIA RTX PRO 6000 블랙웰 맥스-Q 워크스테이션 에디션 2개, 각 96GB GDDR7 메모리, 각 300W 소비전력 |
| 운영체제 | Windows 11 Pro 워크스테이션용 (Ubuntu 26.04.1 LTS에서 테스트됨) |
| 스토리지 | |
| 설정된 대로 | 2개의 2TB M.2 2280 Gen5 x4 TLC SED (모두 내부 M.2 슬롯에 장착) |
| 내부 슬롯 | 3x M.2 2230/2280 Gen5 NVMe 1x M.2 2230/2280 Gen4 NVMe 2x 3.5인치 SATA |
| 플렉스베이 | 최대 4개의 NVMe 드라이브와 옵션으로 제공되는 슬림형 ODD 또는 2개의 3.5인치 SATA 드라이브를 지원합니다. |
| 확장 및 연결성 | |
| PCIe 슬롯 | 2x Gen5 x16 1x Gen5 x8 1x Gen4 x8 2x Gen4 x8 (x4 전기식) |
| 네트워킹 | Intel E810-XXV 듀얼 포트 25GbE SFP28 (애드인) 온보드 10GbE 및 1GbE RJ-45 미디어텍 Wi-Fi 7 MT7925, 블루투스 5.4 |
| 전면 포트 | PowerShare 기능이 있는 USB-C 20Gbps 포트 1개 1개의 USB-C 10Gbps 포트 2x USB-A 10Gbps 헤드셋 잭 SD 카드 슬롯(선택 사항) |
| 후면 포트 | 1개의 USB-C 20Gbps 포트 2개의 USB-C 10Gbps 포트 4x USB-A 10Gbps 시리얼 포트, PS/2 포트 2개, 라인 출력 |
| 힘과 신체 | |
| 전원 공급 장치 | 2400W 플래티넘 (1500W 옵션) |
| 크기 | 449.8 x 203.7 x 617.5mm (17.70 x 8.01 x 24.31in) |
| 중량(평량) | 구성에 따라 24.1kg~33.6kg(53.1~74.1lb) |
| 품질 보증 | 원격 진단 후 현장 방문 서비스를 포함한 ProSupport, 36개월 보증 |
| 가격 | 5,925만 달러 기본 구성에 따라 약 66,600달러입니다(Dell.com). |
테스트 설정 및 방법론
본 리뷰에서는 고성능 워크스테이션을 Linux 환경에서 테스트했으며, 모든 시스템은 Ubuntu 26.04.1 LTS(커널 7.0.0-43), NVIDIA 드라이버 595.99.02, CUDA 13, llama.cpp 빌드 b11716, Ollama 0.40.3을 설치하고 Linux 성능 향상 프로파일에서 실행했습니다. 테스트 결과는 세 가지 도구를 사용하여 얻었습니다. 로컬 AI 및 클라이언트 워크로드에는 sr-client, 컴파일, 압축, 암호화, 웹 서버 및 y-cruncher에는 sr-harness, GROMACS, OpenFOAM, ClickHouse, Valkey 및 메모리 대역폭에는 sr-suite r5.28을 사용했습니다. 각 결과는 반복 테스트의 중앙값입니다.
네 시스템 모두 BIOS 열 모드를 울트라 퍼포먼스로 설정한 상태에서 실행되었으며, T4는 BIOS 1.2.0 버전을 사용했습니다. T4 하네스는 sr-harness 3.3을, Precision 7875는 3.5를, 두 대의 T2는 3.6을 사용했으며, 모든 버전에서 동일한 테스트 구성을 적용했습니다.
모든 비교 시스템은 RTX PRO 6000 Blackwell 그래픽 카드가 탑재된 Dell 타워형 PC입니다. Dell Precision 7875는 96코어 Threadripper PRO 9995WX 프로세서에 동일한 RTX PRO 6000 Max-Q 카드 두 개와 512GB DDR5-5600 메모리를 조합하여 가장 유사한 구성을 보여줍니다. Dell Pro Precision 9 T2 는 24코어 Xeon 658X 프로세서와 Max-Q 카드 한 개를, Dell Pro Max Tower T2는 24코어 Core Ultra 9 285K 프로세서와 600W RTX PRO 6000 그래픽 카드를 탑재하여, 더 높은 전력 제한이 GPU당 성능에 미치는 영향을 보여줍니다.
| 구성 | CPU | 메모리 | GPU | 테스트 드라이브 | BIOS 열 모드 |
|---|---|---|---|---|---|
| 델 프로 프리시전 9 T4 | 제온 698X, 86코어 | 256GB DDR5-6400 (8채널) | 2x RTX PRO 6000 Max-Q (300W) | 2TB SK 하이닉스 PCB01 Gen5 | 울트라 성능 |
| Dell Precision 7875 | 스레드리퍼 프로 9995WX, 96코어 | 512GB DDR5-5600 (8채널) | 2x RTX PRO 6000 Max-Q (300W) | 2TB 삼성 Gen4 | 울트라 성능 |
| 델 프로 프리시전 9 T2 | 제온 658X, 24코어 | 128GB DDR5-6400 (4채널) | 1x RTX PRO 6000 Max-Q (300W) | 삼성 PM9E1 Gen5 2TB 드라이브 스트라이핑 어레이 | 울트라 성능 |
| 델 프로 맥스 타워 T2 | 코어 울트라 9 285K, 24코어 | 128GB DDR5-4400 (2채널) | 1x RTX PRO 6000 (600W) | 2TB 삼성 PM9F1 4세대 | 울트라 성능 |
로컬 AI 성능
여기 있는 모든 시스템에는 최소 하나 이상의 RTX PRO 6000 Blackwell 그래픽 카드와 96GB의 GDDR7 메모리가 탑재되어 있으므로, 단일 GPU 테스트 결과는 카드 자체의 성능, 전력 한계, 그리고 플랫폼이 카드에 데이터를 얼마나 빠르게 제공하는지를 측정합니다. T4의 차별점은 두 개의 그래픽 카드이며, 두 개의 GPU를 사용하는 테스트는 각 모델에 대해 가능한 경우 세 가지 방식으로 진행됩니다. 첫째, 처리량 측정을 위해 GPU당 하나의 서버를 사용하는 두 개의 독립적인 서버 구성, 둘째, 레이어별로 두 카드에 데이터를 분산하여 사용하는 모델 구성, 셋째, MiniMax M2.7의 경우 하나의 카드에 데이터를 입력하고 나머지 데이터는 시스템 메모리에 저장하는 구성입니다.
하나의 GPU에서 LLM 서비스 제공
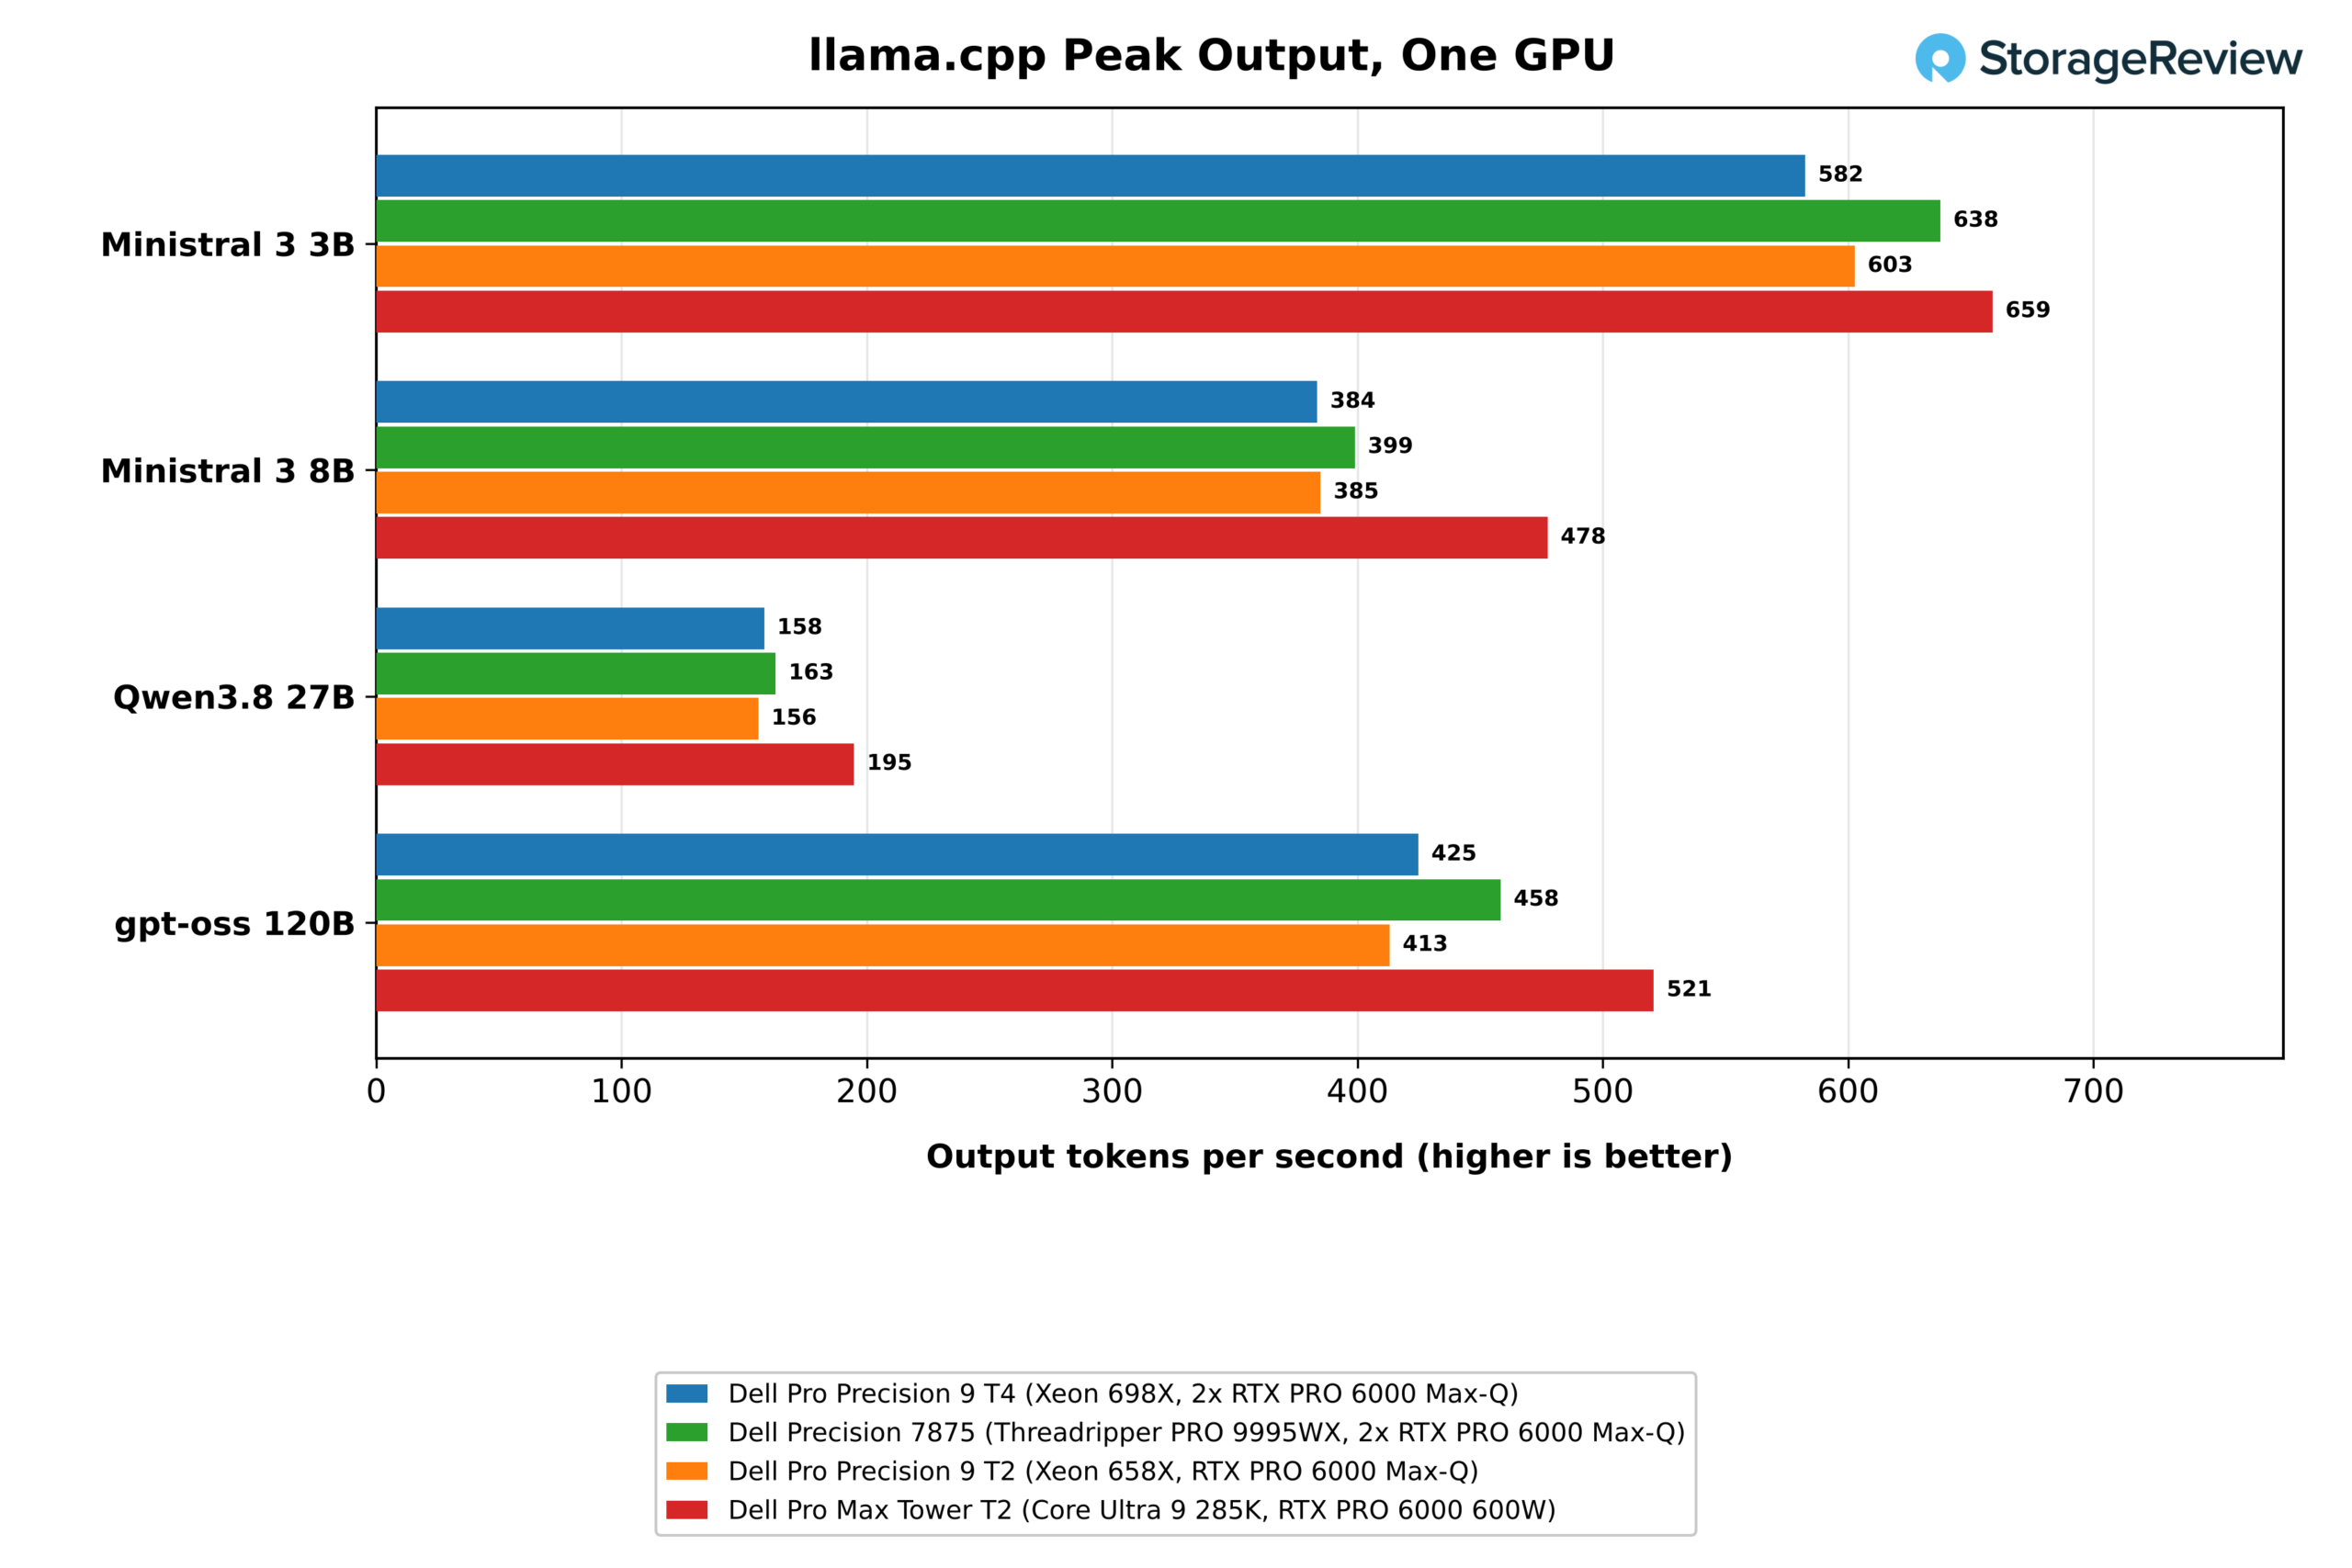
| llama.cpp 서버, GPU 1개 (초당 토큰 출력량, 높을수록 좋음) | 델 프로 프리시전 9 T4 | Dell Precision 7875 | 델 프로 프리시전 9 T2 | 델 프로 맥스 타워 T2 |
|---|---|---|---|---|
| 미니스트랄 3 3B, 요청 1건 | 240.5 | 252.6 | 243.8 | 261.6 |
| 미니스트랄 3 3B, 피크 | 582.5 | 637.6 | 602.6 | 658.8 |
| 미니스트랄 3 8B, 요청 1건 | 166.8 | 171.1 | 167.3 | 194.5 |
| 미니스트랄 3 8B, 피크 | 383.6 | 398.9 | 384.9 | 477.5 |
| Qwen3.8 27B, 요청 1건 | 54.9 | 55.4 | 53.8 | 64.5 |
| Qwen3.8 27B, 피크 | 158.1 | 162.8 | 155.8 | 194.7 |
| gpt-oss 120B, 요청 1건 | 166.9 | 171.2 | 164.5 | 193.0 |
| gpt-oss 120B, 피크 | 424.8 | 458.4 | 413.1 | 520.7 |
| gpt-oss 120B, 요청 1건, 첫 번째 토큰 생성 시간(밀리초, 낮을수록 좋음) | 1,189 | 1,181 | 1,213 | 844 |
한 GPU에서 T4는 카드의 300W 한계에 근접한 성능을 보였습니다. gpt-oss 120B에서 한 명의 사용자를 대상으로 초당 166.9개의 토큰을 생성했고, 64개의 동시 요청에서는 최대 424.8개의 토큰을 생성했습니다. 이는 모든 4개 모델에서 Precision 7875의 동일한 Max-Q 카드와 1~9% 이내의 성능 차이이며, Pro Precision 9 T2와 비슷한 수준입니다. Pro Max Tower T2에 탑재된 600W 카드는 모든 모델에서 최대 성능이 13~25% 더 빠르며, gpt-oss 120B에서 초당 520.7개의 토큰을 생성합니다.
두 개의 GPU: 복제본 및 분할 모델
| llama.cpp 서버, GPU 2개 (초당 토큰 출력량, 높을수록 좋음) | 델 프로 프리시전 9 T4 | Dell Precision 7875 |
|---|---|---|
| 미니스트랄 3 3B, 최대치, GPU당 서버 1대 | 1,176.1 | 1,260.2 |
| 미니스트랄 3 8B, 최대치, GPU당 서버 1대 | 765.7 | 796.4 |
| Qwen3.8 27B, 최대치, GPU당 서버 1대 | 310.8 | 323.2 |
| gpt-oss 120B, 최대치, GPU당 서버 1대 | 787.9 | 905.8 |
| gpt-oss 120B, 단일 요청, 레이어별 분할 | 170.6 | 182.4 |
| gpt-oss 120B, 피크, 레이어별 분할 | 539.2 | 619.4 |
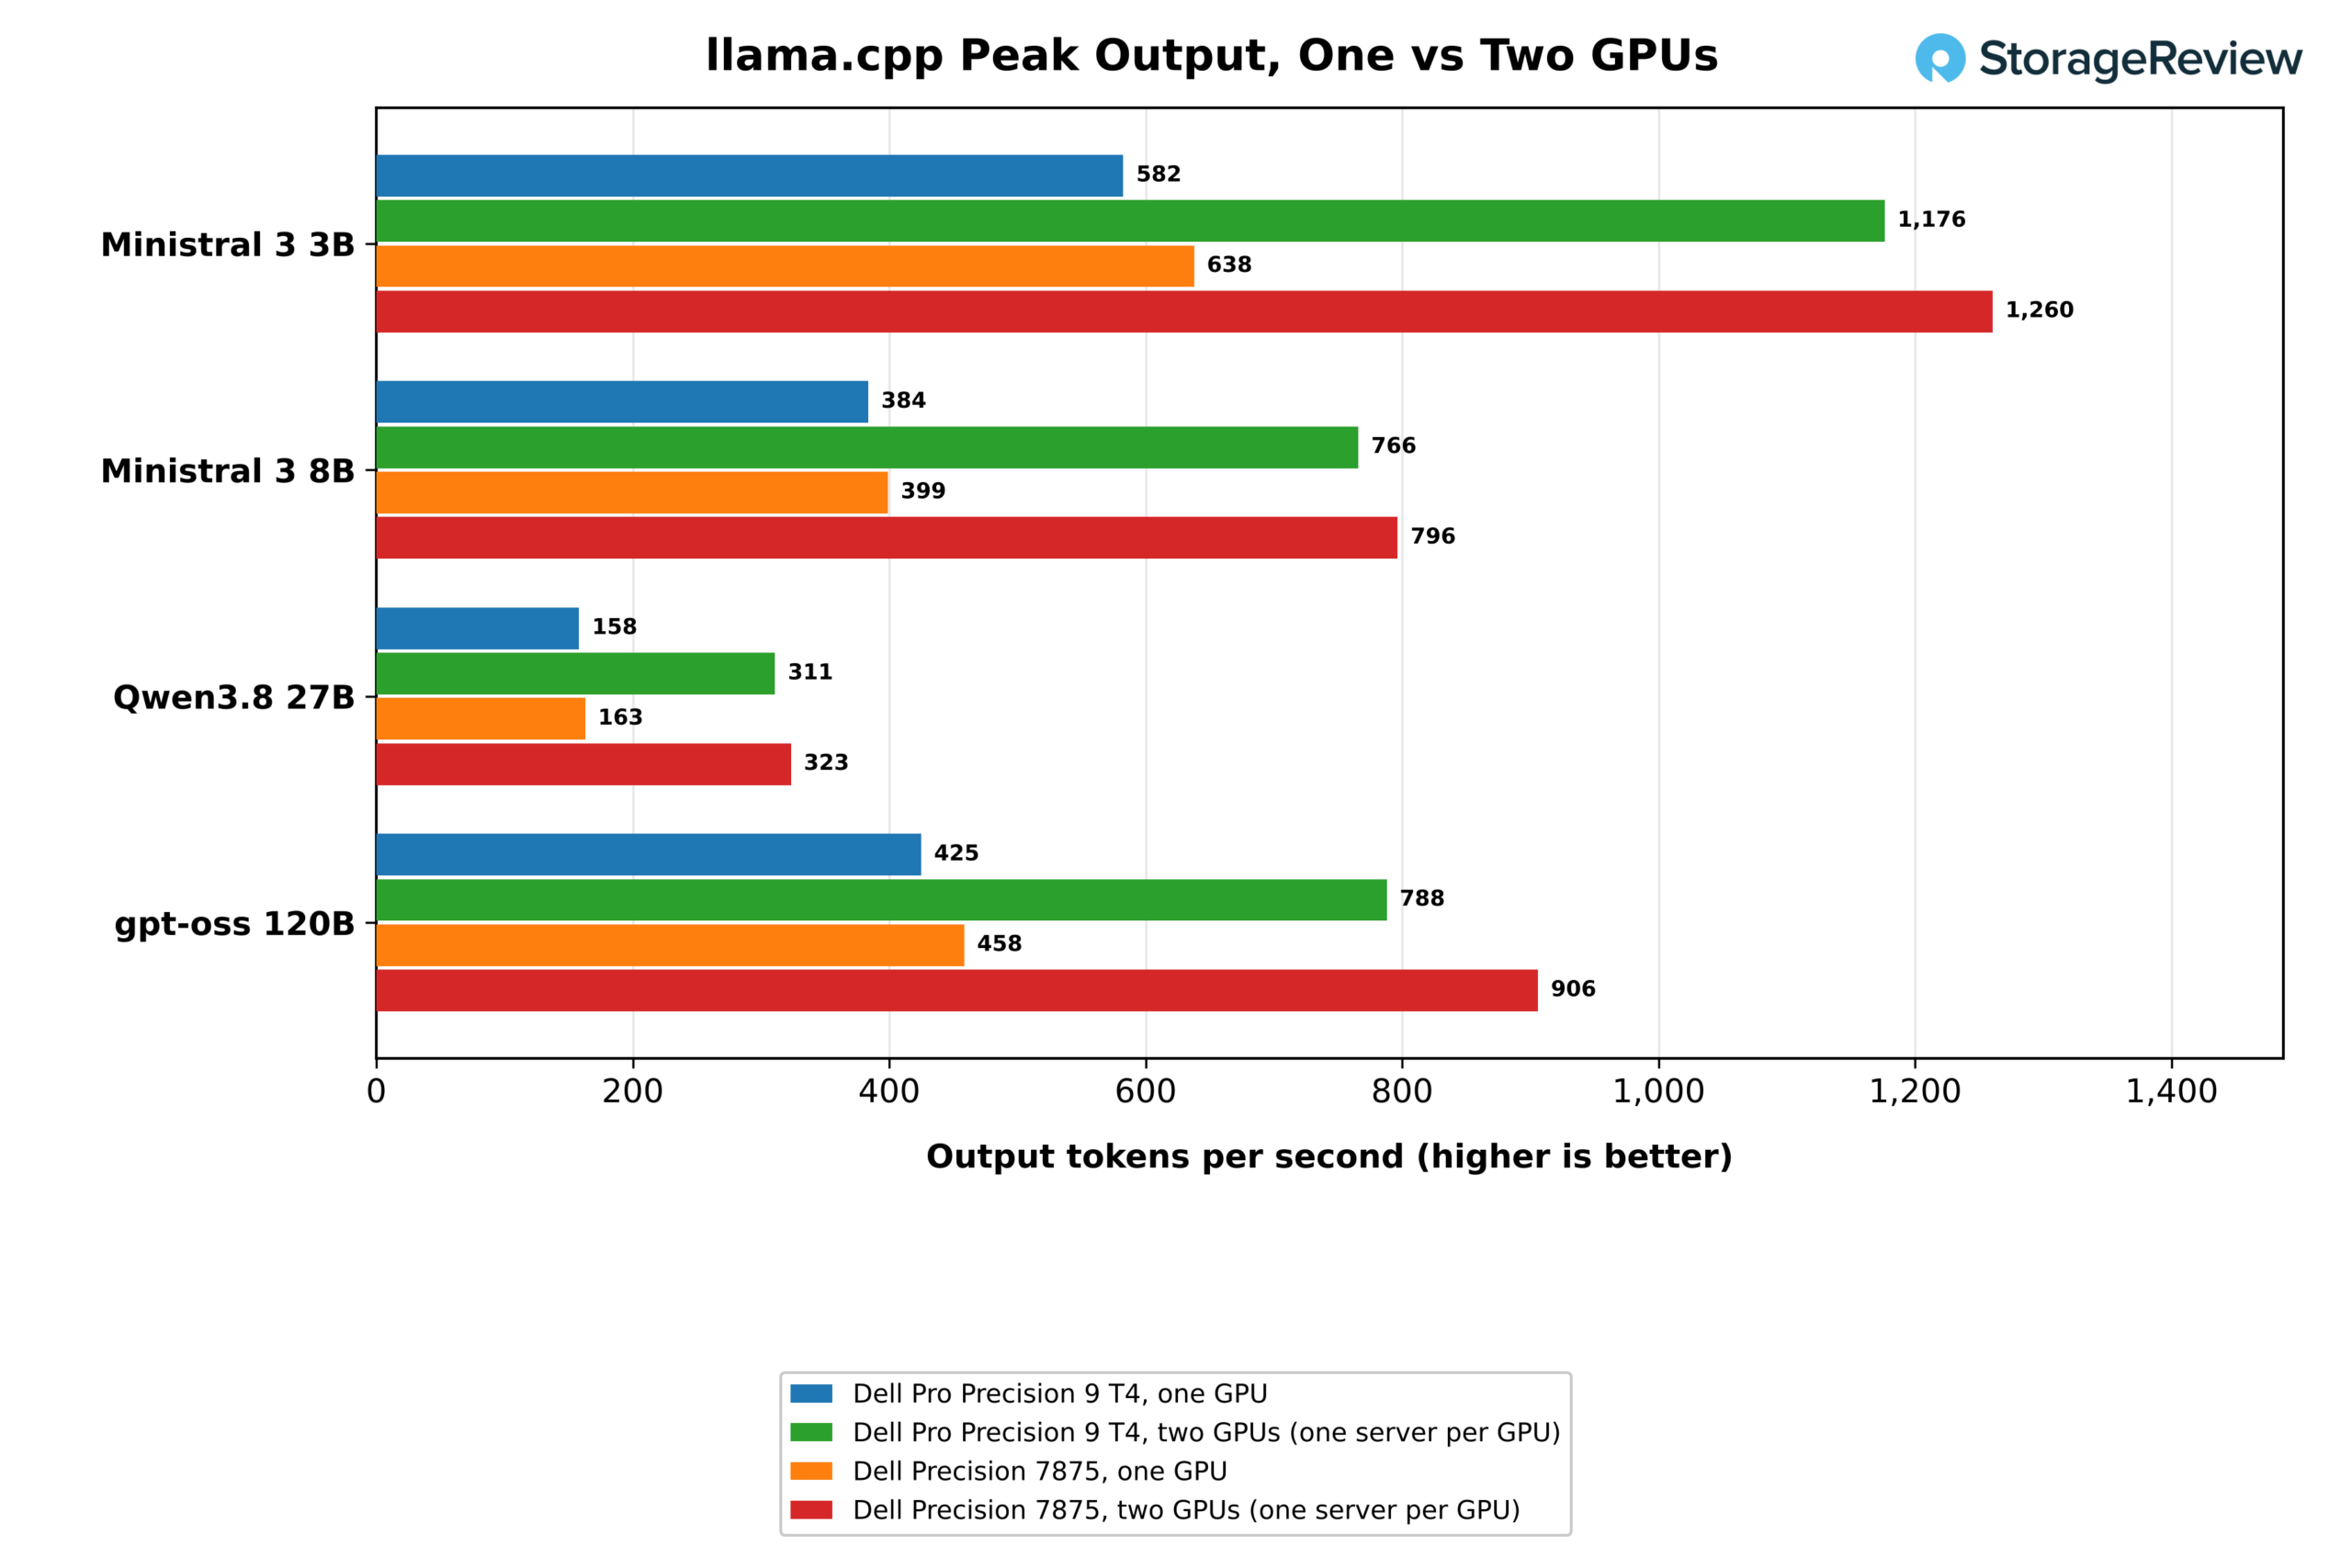
GPU당 하나의 서버를 실행함으로써 T4의 최대 출력은 네 가지 모델 모두에서 1.85배에서 2.02배까지 증가했습니다. 최대 출력은 Ministral 3 3B에서 초당 582.5개에서 1,176.1개 토큰으로, 8B 모델에서 383.6개에서 765.7개로, Qwen3.8 27B에서 158.1개에서 310.8개로 증가하여 1.97배에서 2.02배까지 확장되었습니다. gpt-oss 120B는 T4에서 초당 787.9개 토큰으로 1.85배, Precision 7875에서 초당 905.8개 토큰으로 확장되었으며, Precision 1.98는 최대 동시 요청 수 128개에 도달한 반면 T4는 64개에서 최고치를 기록했습니다.
GPT-OSS 120B를 레이어별로 두 카드에 분산하여 사용하는 방식은 모델이 이미 하나의 카드에 들어갈 때 두 번째 GPU를 활용하는 가장 느린 방법입니다. 한 명의 사용자를 대상으로 테스트한 결과 초당 170.6 토큰을 처리했는데, 이는 단일 카드 대비 3% 이내의 속도이며, 최고 속도는 539.2로 단일 카드 대비 27% 높지만 두 개의 복제본을 사용했을 때의 787.9에는 훨씬 못 미칩니다. 이러한 분산 레이아웃은 하나의 카드에 들어가지 않는 모델, 예를 들어 MiniMax M2.7과 같은 경우에 유용합니다.
| llama.cpp 서버, gpt-oss 120B, 8,192개 토큰 프롬프트, 1,024개 토큰 출력 | T4, GPU 1개 | T4, GPU 2개, GPU당 서버 1개 | T4, GPU 2개, 레이어별로 분할 | Precision 7875, GPU 2개, GPU당 서버 1개 |
|---|---|---|---|---|
| 동시 접속자 1명: 총 처리량(토큰/초) | 1,502 | 1,504 | 1,536 | 1,530 |
| 동시 접속자 1명: 첫 번째 토큰이 생성될 때까지의 시간(중앙값, 밀리초, 낮을수록 좋음) | 1,189 | 1,180 | 719 | 1,189 |
| 동시 접속자 8명: 총 처리량(토큰/초) | 2,760 | 4,820 | 3,300 | 4,949 |
| 동시 접속자 8명: 사용자당 출력량(토큰/초) | 38.3 | 66.9 | 45.8 | 68.7 |
| 동시 접속자 8명: 첫 번째 토큰이 생성될 때까지의 시간(중앙값, 밀리초, 낮을수록 좋음) | 2,654 | 2,523 | 1,622 | 2,472 |
| 동시 접속자 64명: 총 처리량(토큰/초) | 3,823 | 7,091 | 4,853 | 7,557 |
| 동시 접속자 64명: 사용자당 출력량(토큰/초) | 6.6 | 12.3 | 8.4 | 13.1 |
| 동시 접속자 64명: 첫 번째 토큰이 생성될 때까지의 시간(중앙값, 밀리초, 낮을수록 좋음) | 3,874 | 3,226 | 2,852 | 2,867 |
gpt-oss 120B에 대한 전체 테스트 결과는 두 번째 그래픽 카드가 처리량 곡선에 어떤 변화를 가져오는지 보여줍니다. 총 처리량은 프롬프트 토큰과 출력 토큰을 모두 합산한 값입니다. 단일 GPU를 사용했을 때는 단일 요청 시 초당 1,502개의 토큰을 처리했지만, 8개 요청 시에는 2,760개, 64개 요청 시에는 3,823개로 증가했으며, 각 사용자는 초당 6.6개의 출력 토큰을 받았습니다. GPU당 서버 하나씩을 사용했을 때는 8개 요청 시 4,820개, 64개 요청 시 7,091개의 토큰을 처리했는데, 이는 단일 GPU 사용 시의 1.85배에 해당하며 사용자당 초당 12.3개의 토큰을 처리한 것입니다. 모델을 분할했을 때는 최고 처리량이 4,853개로 낮아졌지만, 단일 사용자의 첫 번째 토큰 반환 시간이 1,189ms에서 719ms로 단축되었습니다.

MiniMax M2.7: 하나의 메모리 카드에 담기엔 너무 큰 모델
| MiniMax M2.7 Q4_K_M, 129.3GB (별도 표기가 없는 한 용량이 클수록 좋습니다) | 델 프로 프리시전 9 T4 | Dell Precision 7875 | 델 프로 프리시전 9 T2 | 델 프로 맥스 타워 T2 |
|---|---|---|---|---|
| GPU 1개와 시스템 RAM, 요청 1개(토큰/초) | 30.3 | 32.8 | 22.6 | 15.8 |
| GPU 1개와 시스템 RAM을 합산했을 때 최대 처리량(토큰/초) | 35.5 | 39.1 | 27.7 | 18.0 |
| GPU 1개와 시스템 RAM을 합산했을 때, 첫 번째 토큰 생성 시간(밀리초, 낮을수록 좋음) | 16,224 | 16,143 | 16,216 | 18,522 |
| 레이어별로 분할된 두 개의 GPU, 하나의 요청(토큰/초) | 83.7 | 85.0 | 단일 GPU | 단일 GPU |
| 레이어별로 분할된 두 개의 GPU, 최대 처리량(토큰/초) | 127.3 | 129.5 | 단일 GPU | 단일 GPU |
| 레이어별로 나뉜 두 개의 GPU에서 첫 번째 토큰까지의 시간(밀리초, 낮을수록 좋음) | 3,138 | 3,162 | 단일 GPU | 단일 GPU |
| 콜드 로딩, GPU 1개 + RAM (s, 낮을수록 좋음) | 40.5 | 65.8 | 37.6 | 81.1 |
| 콜드 로드, 두 개의 GPU 분할(s, 낮을수록 좋음) | 27.6 | 50.7 | 단일 GPU | 단일 GPU |
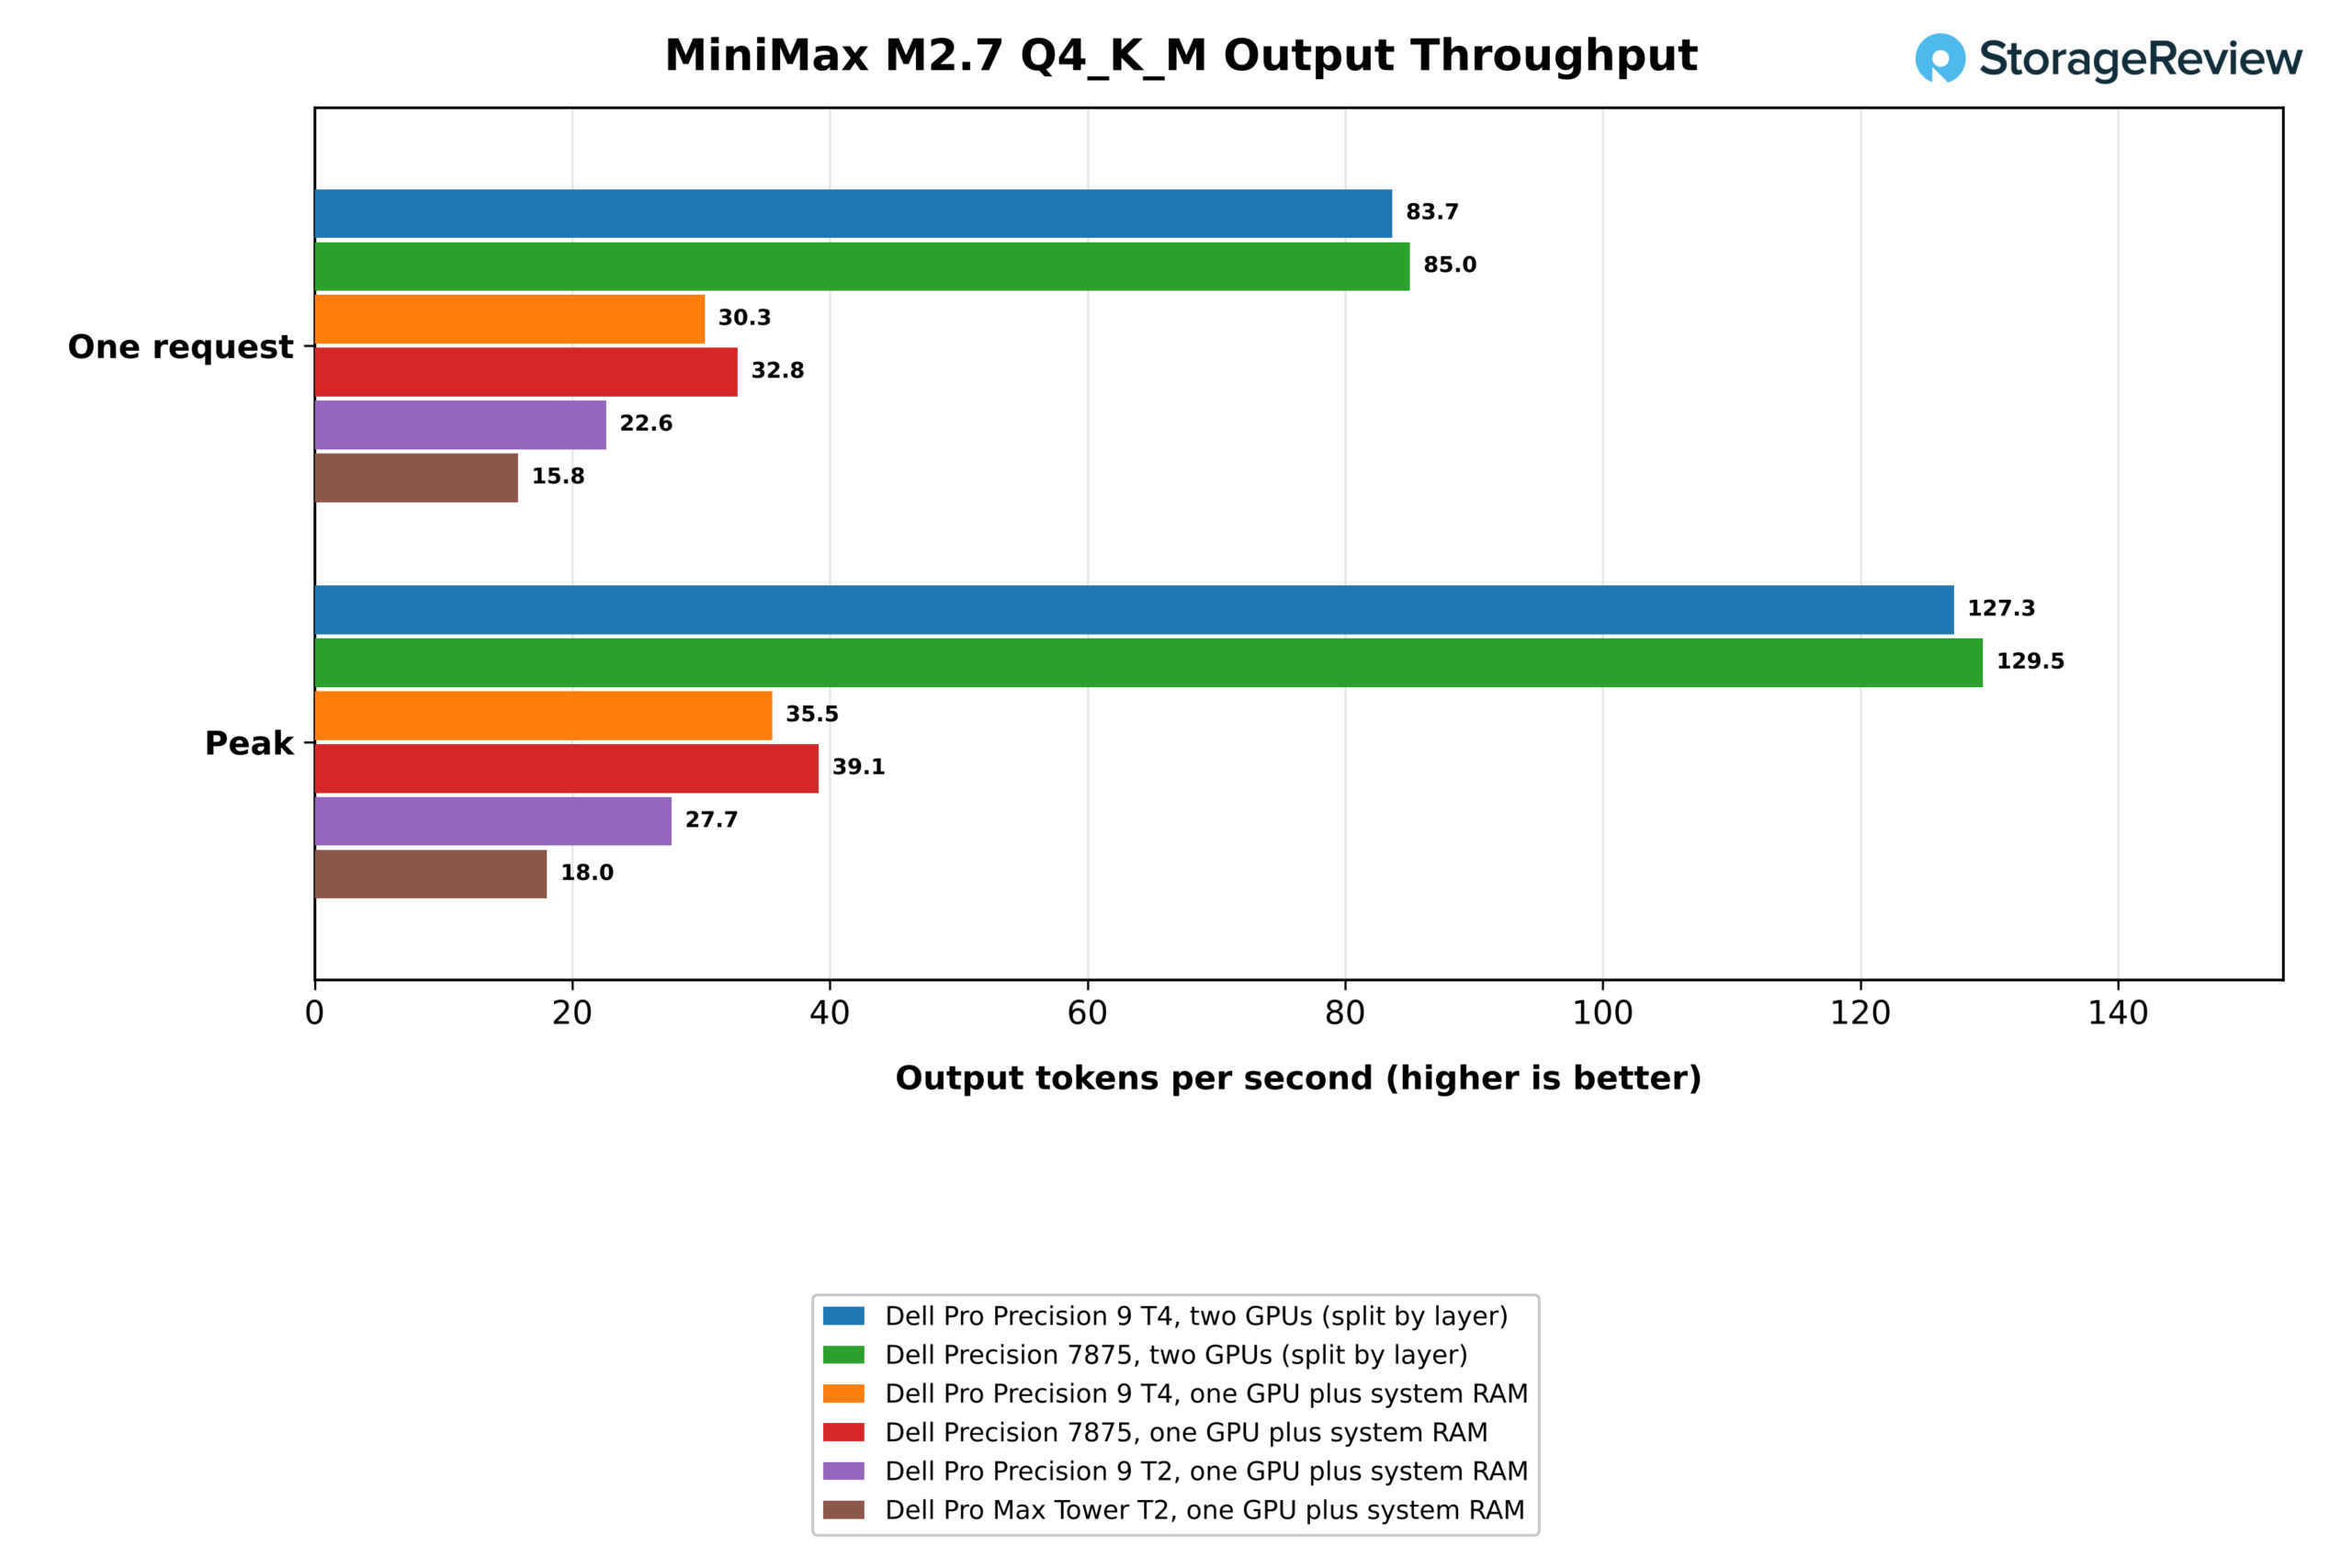
MiniMax M2.7은 230억 개의 매개변수를 가진 혼합형 전문가 모델이며, 4비트 양자화에 129.3GB의 메모리가 필요합니다. 이는 RTX PRO 6000 한 장에 탑재되는 96GB보다 더 많은 용량입니다. 한 장의 카드만 사용하고 나머지 메모리는 시스템 메모리에 저장했을 때, T4는 한 명의 사용자에게 초당 30.3개의 토큰을 생성했고 첫 번째 토큰을 반환하는 데 16.2초가 걸렸습니다. 두 장의 카드를 모두 사용했을 때는 초당 83.7개의 토큰을 생성하여 2.8배 더 빠른 속도를 보였고, 첫 번째 토큰을 반환하는 데 3.1초밖에 걸리지 않았으며, 최대 토큰 생성 속도는 초당 127.3개로 기존의 35.5개보다 훨씬 빨랐습니다.
단일 GPU 테스트 결과는 모델이 시스템 메모리에 영향을 미치기 시작하면 호스트 플랫폼이 얼마나 중요한지 보여줍니다. T4는 8채널 DDR5-6400 메모리를 사용하여 4채널 Pro Precision 9 T2보다 34% 빠른 초당 22.6 토큰, 듀얼채널 Pro Max Tower T2보다 1.9배 빠른 초당 15.8 토큰을 처리했습니다. Pro Max Tower T2의 600W 소비 전력이 모든 호환 모델에서 더 빠른 성능을 보였음에도 불구하고 이러한 결과가 나왔습니다. Precision 7875는 메모리 대역폭이 35% 낮음에도 불구하고 T4보다 빠른 초당 32.8 토큰을 처리했습니다. 따라서 대역폭만으로는 이 결과를 결정할 수 없습니다. 7875의 우위는 측정된 값이며, 그 원인은 아직 밝혀내지 못했습니다.
모델 로딩
| Ollama 0.40.3 및 llama.cpp 모델 로드(초, 낮을수록 좋음) | 델 프로 프리시전 9 T4 | Dell Precision 7875 | 델 프로 프리시전 9 T2 | 델 프로 맥스 타워 T2 |
|---|---|---|---|---|
| gpt-oss:20b (12.8GB), 콜드 | 5.79 | 7.61 | 5.57 | 7.95 |
| gpt-oss:20b, 따뜻함 | 3.45 | 2.50 | 3.47 | 3.05 |
| gpt-oss:120b (60.9GB), 콜드 | 15.16 | 25.80 | 15.16 | 28.18 |
| gpt-oss:120b, 따뜻함 | 7.49 | 5.01 | 7.87 | 6.81 |
| gpt-oss:120b, 콜드, 각 GPU에 하나씩 복사본 있음 | 26.47 | 35.55 | 단일 GPU | 단일 GPU |
| MiniMax M2.7 (129.3GB), 냉각 상태, GPU 1개 및 RAM | 40.5 | 65.8 | 37.6 | 81.1 |
| MiniMax M2.7, 발열 문제 있음, GPU 1개 및 RAM 포함 | 28.6 | 15.2 | 36.7 | 80.5 |
콜드 모델 로드에서는 Gen5 드라이브가 우세합니다. T4는 SK 하이닉스 Gen5 SSD에서 gpt-oss:120b를 15.2초 만에 로드하여 Pro Precision 9 T2와 동일한 속도를 보였으며, Gen4가 장착된 Precision 7875 및 Pro Max Tower T2의 25.8초 및 28.2초보다 훨씬 빠릅니다. 페이지 캐시에서 웜 로드를 수행할 때는 순서가 반대로 바뀌어 7875가 5.0초, T4가 7.5초를 기록했으며, 각 GPU에 동시에 복사본을 로드하는 데는 T4에서 26.5초가 걸렸습니다.
대규모 검색 증강 생성
| RAG는 1,002,067개 이상의 위키피디아 구절을 분석합니다. | 델 프로 프리시전 9 T4 | Dell Precision 7875 | 델 프로 프리시전 9 T2 | 델 프로 맥스 타워 T2 |
|---|---|---|---|---|
| 임베딩, GPU 1개 (초당 패시지 수) | 1,126 | 1,196 | 1,141 | 1,388 |
| 내장된 벽 시간, GPU 1개 (초, 낮을수록 좋음) | 890 | 838 | 878 | 722 |
| 임베딩, GPU 2개 (초당 패시지 수) | 2,162 | 2,371 | 단일 GPU | 단일 GPU |
| 내장된 벽 시간, 두 개의 GPU (초, 낮을수록 좋음) | 464 | 423 | 단일 GPU | 단일 GPU |
| HNSW 지수 빌드(s, 낮을수록 좋음) | 27.3 | 34.8 | 46.3 | 118.6 |
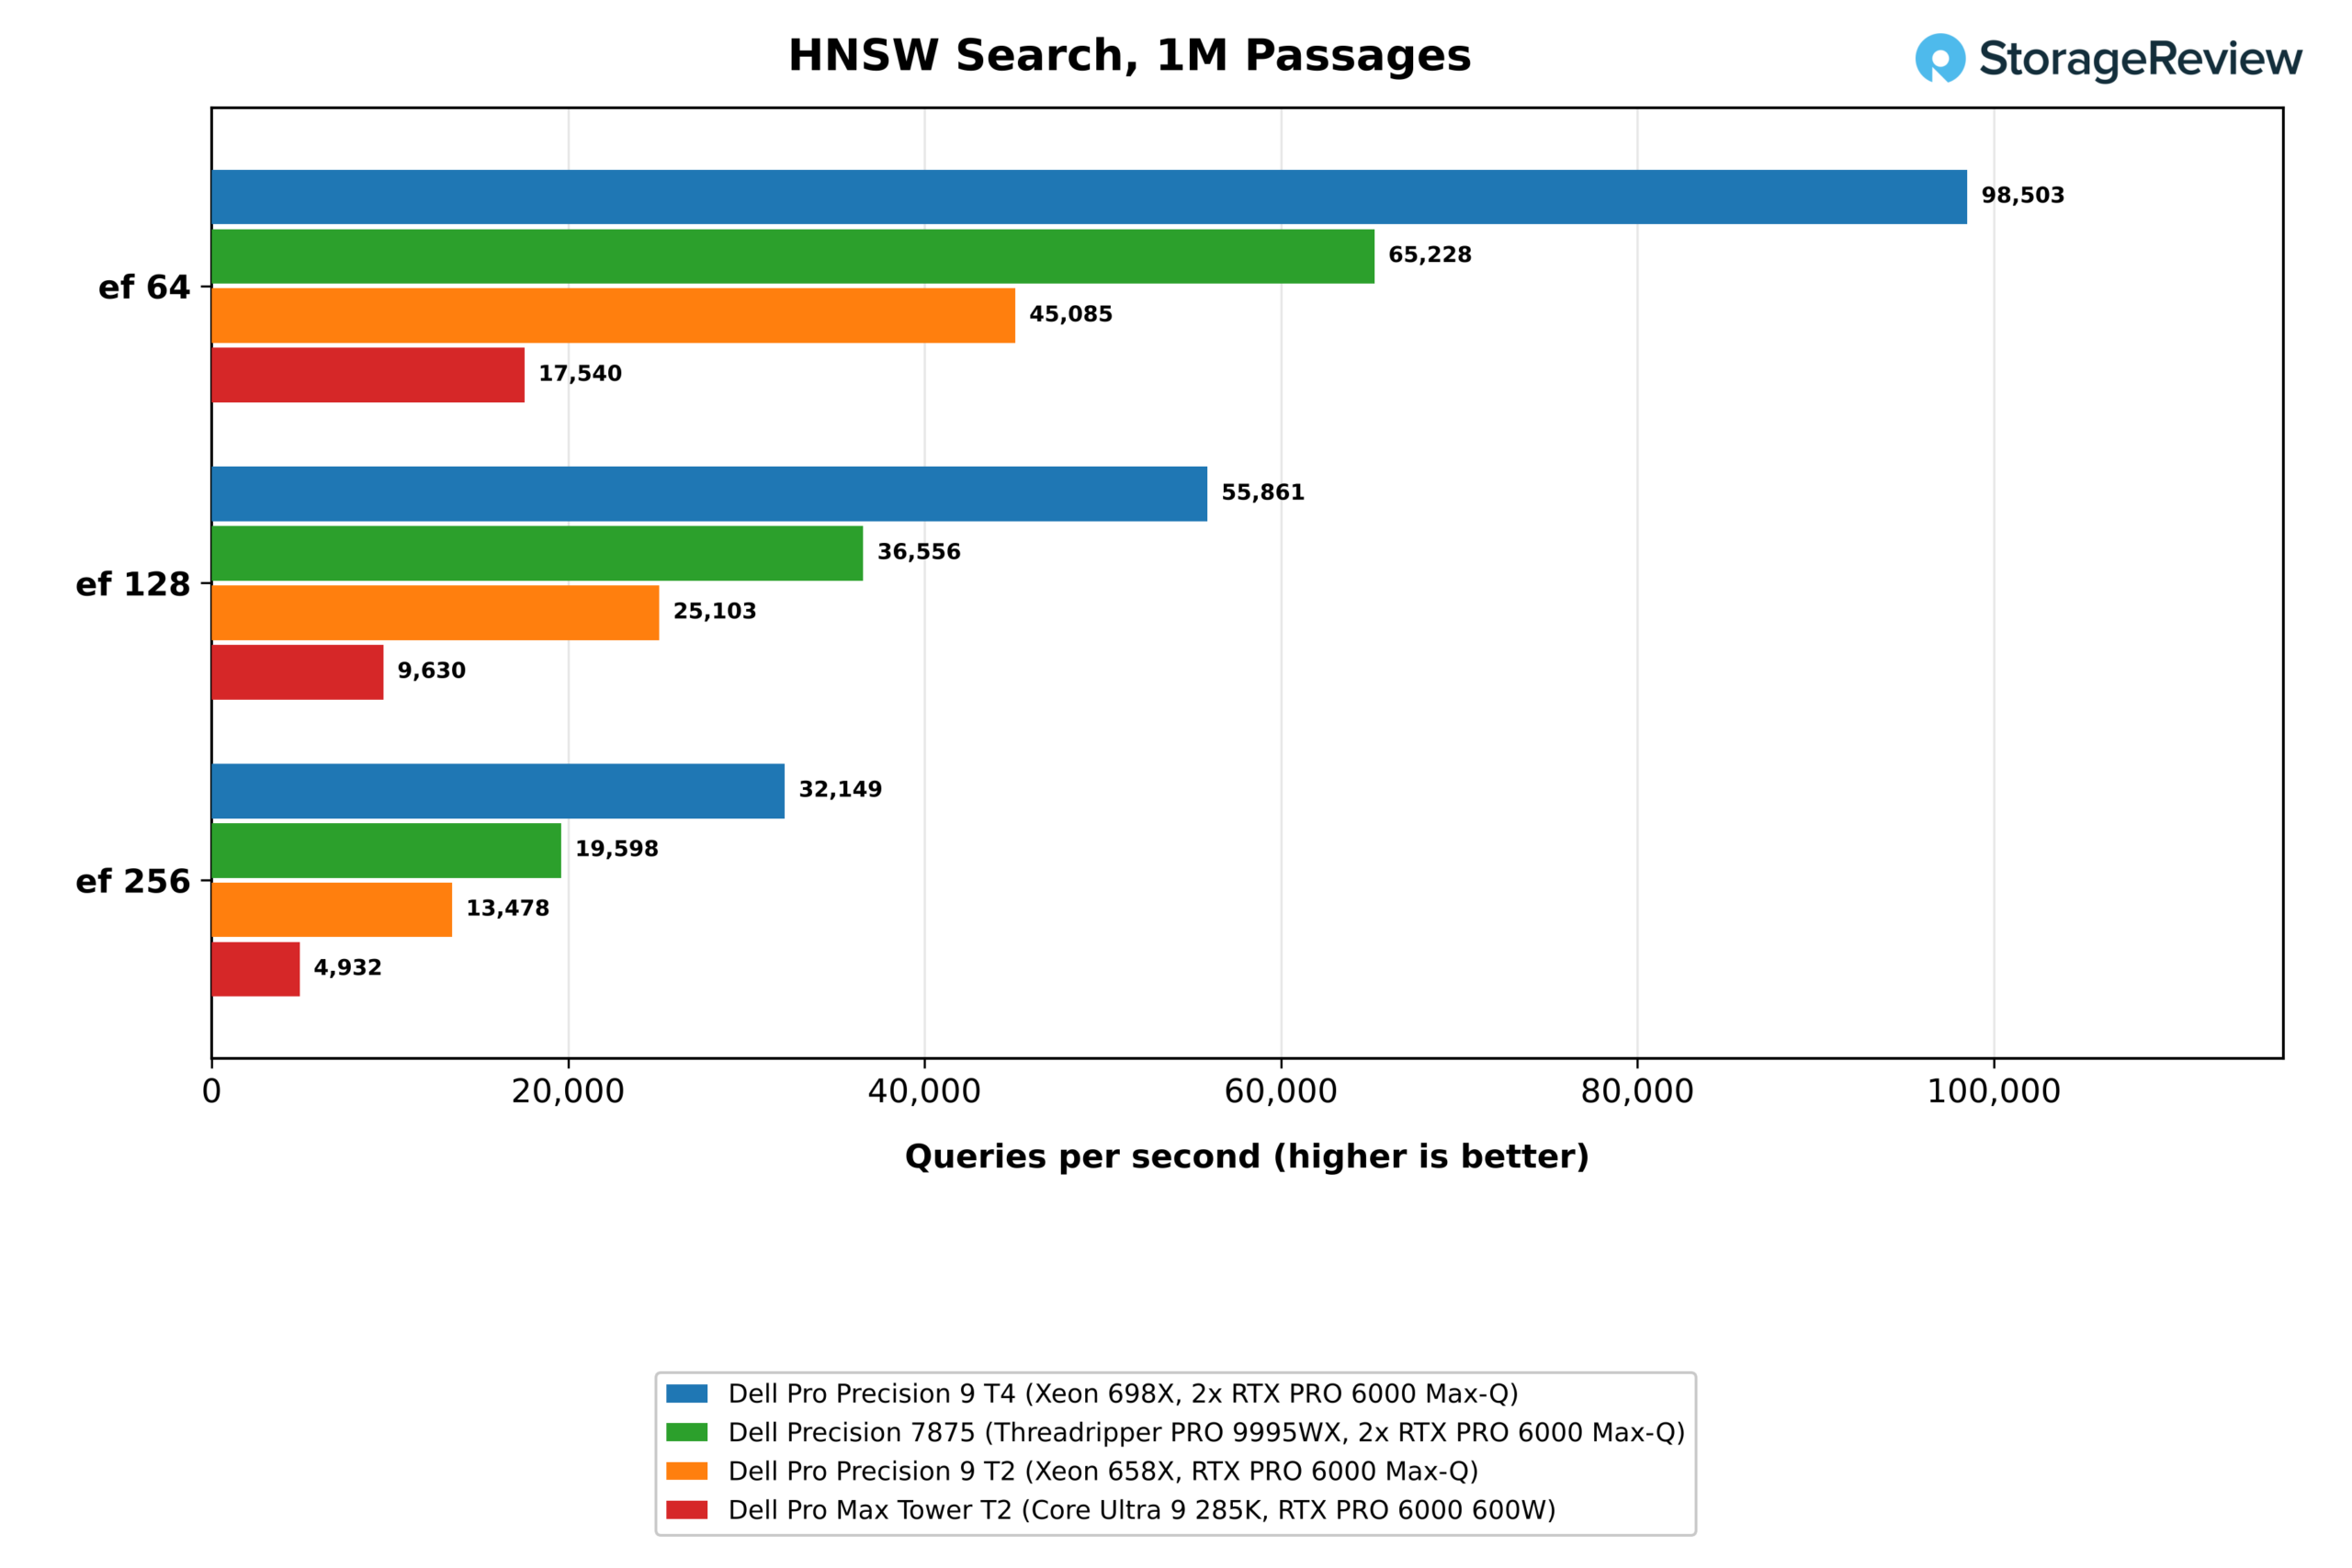
| HNSW 검색, ef 64 (쿼리/초) | 98,503 | 65,228 | 45,085 | 17,540 |
| HNSW 검색, ef 256 (쿼리/초) | 32,149 | 19,598 | 13,478 | 4,932 |
| Recall@5 대 정확한 검색, ef 256 (%) | 97.59 | 97.67 | 97.26 | 97.70 |
| 50페이지에 있는 질문에 답해주세요 (s, 낮을수록 좋습니다) | 0.123 | 0.082 | 0.117 | 0.095 |
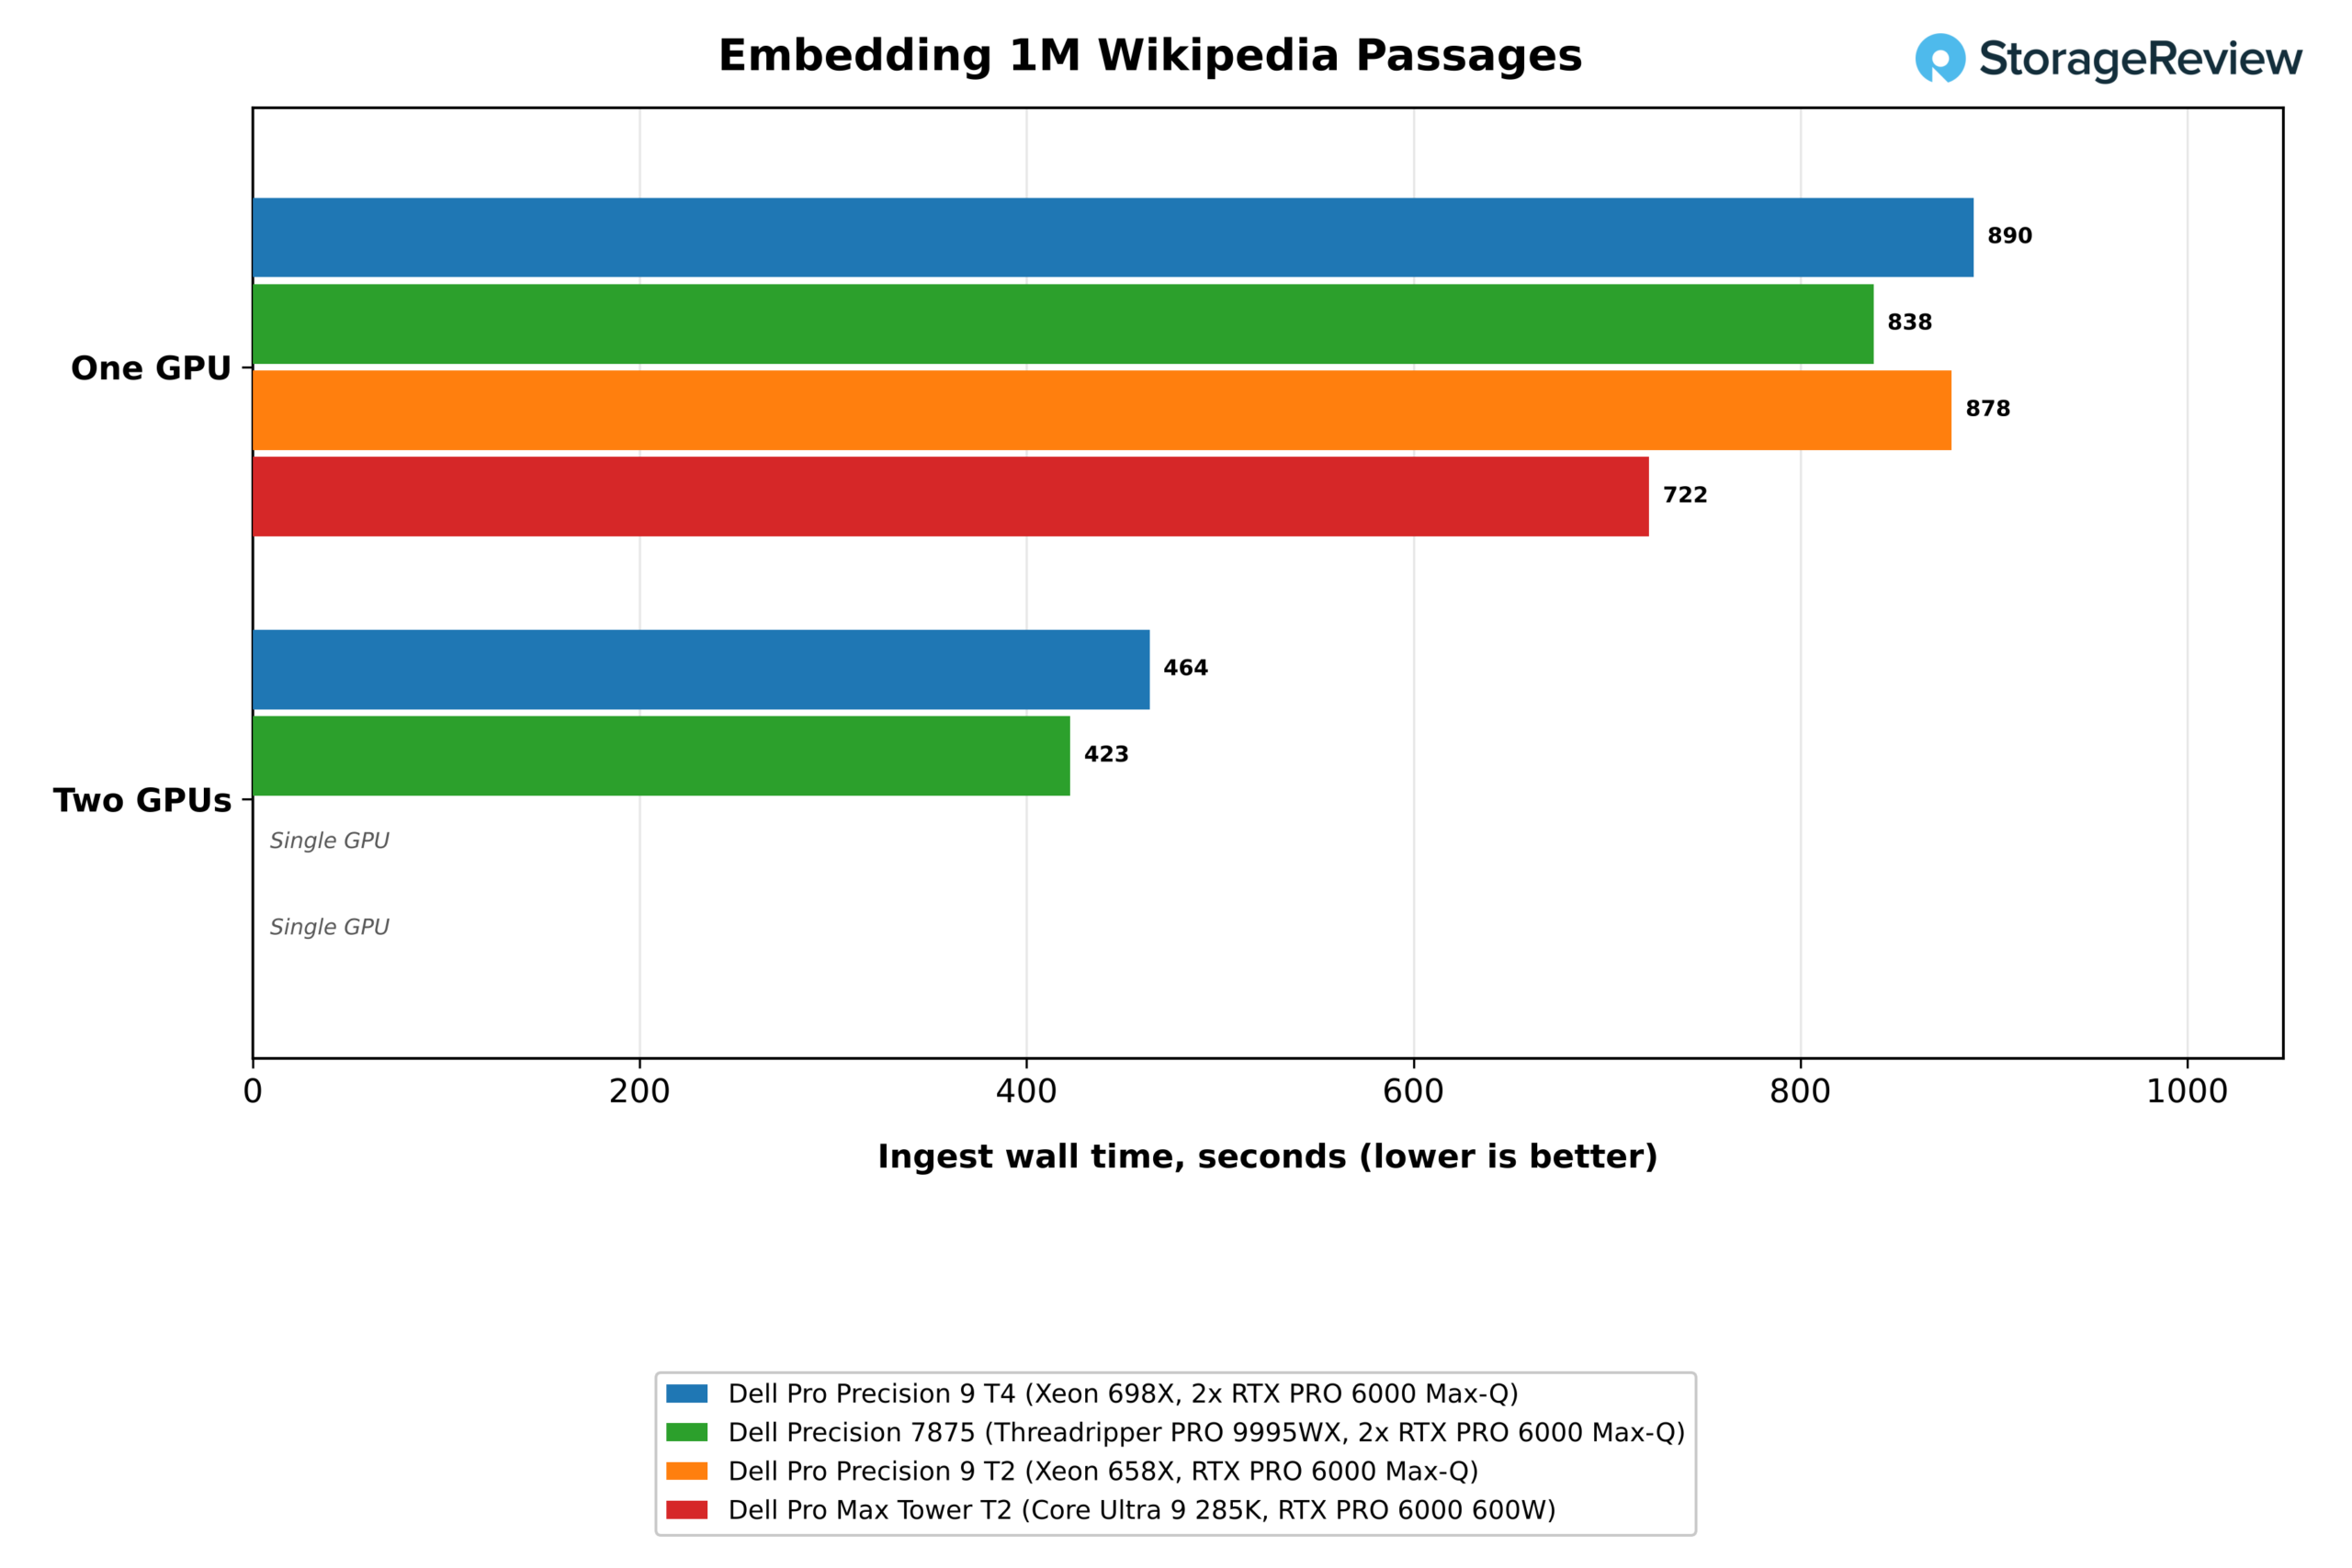
RAG 대규모 테스트는 백만 개의 위키피디아 구절 사이에 SQuAD 질문을 숨기고, nomic-embed-text를 사용하여 질문을 삽입한 다음, HNSW 색인을 구축하고, Phi-4-mini를 사용하여 답변을 생성합니다. 삽입 작업은 T4 GPU 하나에서 890초, 두 개에서 464초가 소요되어 1.92배의 속도 향상을 보였습니다. Precision 7875는 두 개의 카드를 사용하여 423초 만에 완료되었습니다. Pro Max Tower T2에 탑재된 600W 카드는 722초로 가장 빠른 단일 GPU 성능을 보였습니다.
인덱스 구축과 벡터 검색은 CPU에서 실행되며, 바로 이 부분에서 T4가 우위를 점합니다. T4는 HNSW 인덱스 구축에 27.3초를 소요했는데, 이는 Precision 7875의 34.8초, Pro Max Tower T2의 118.6초보다 빠른 기록입니다. 또한, ef 64에서 초당 98,503개의 쿼리를 처리했는데, 이는 7875보다 1.51배, Core Ultra 시스템보다 5.6배 빠른 속도입니다. ef 256에서는 초당 32,149개의 쿼리를 처리하며 정확한 검색에 대한 재현율 97.6%를 달성했고, 응답 시간은 중앙값 0.12초였습니다.
미세 조정
| 미니스트랄 3 8B LoRA, BF16, 돌리 15k의 한 시대 | 델 프로 프리시전 9 T4 | Dell Precision 7875 | 델 프로 프리시전 9 T2 | 델 프로 맥스 타워 T2 |
|---|---|---|---|---|
| 에포크 학습 시간(GPU 1개 기준, 분 단위, 낮을수록 좋음) | 31.5 | 27.2 | 30.6 | 22.3 |
| 처리량, GPU 1개 기준 (토큰/초) | 1,584 | 1,834 | 1,631 | 2,236 |
| 훈련 전후의 홀드아웃 손실, GPU 1개 사용 | 1.534 ~ 1.169 | 1.534 ~ 1.172 | 1.534 ~ 1.167 | 1.534 ~ 1.167 |
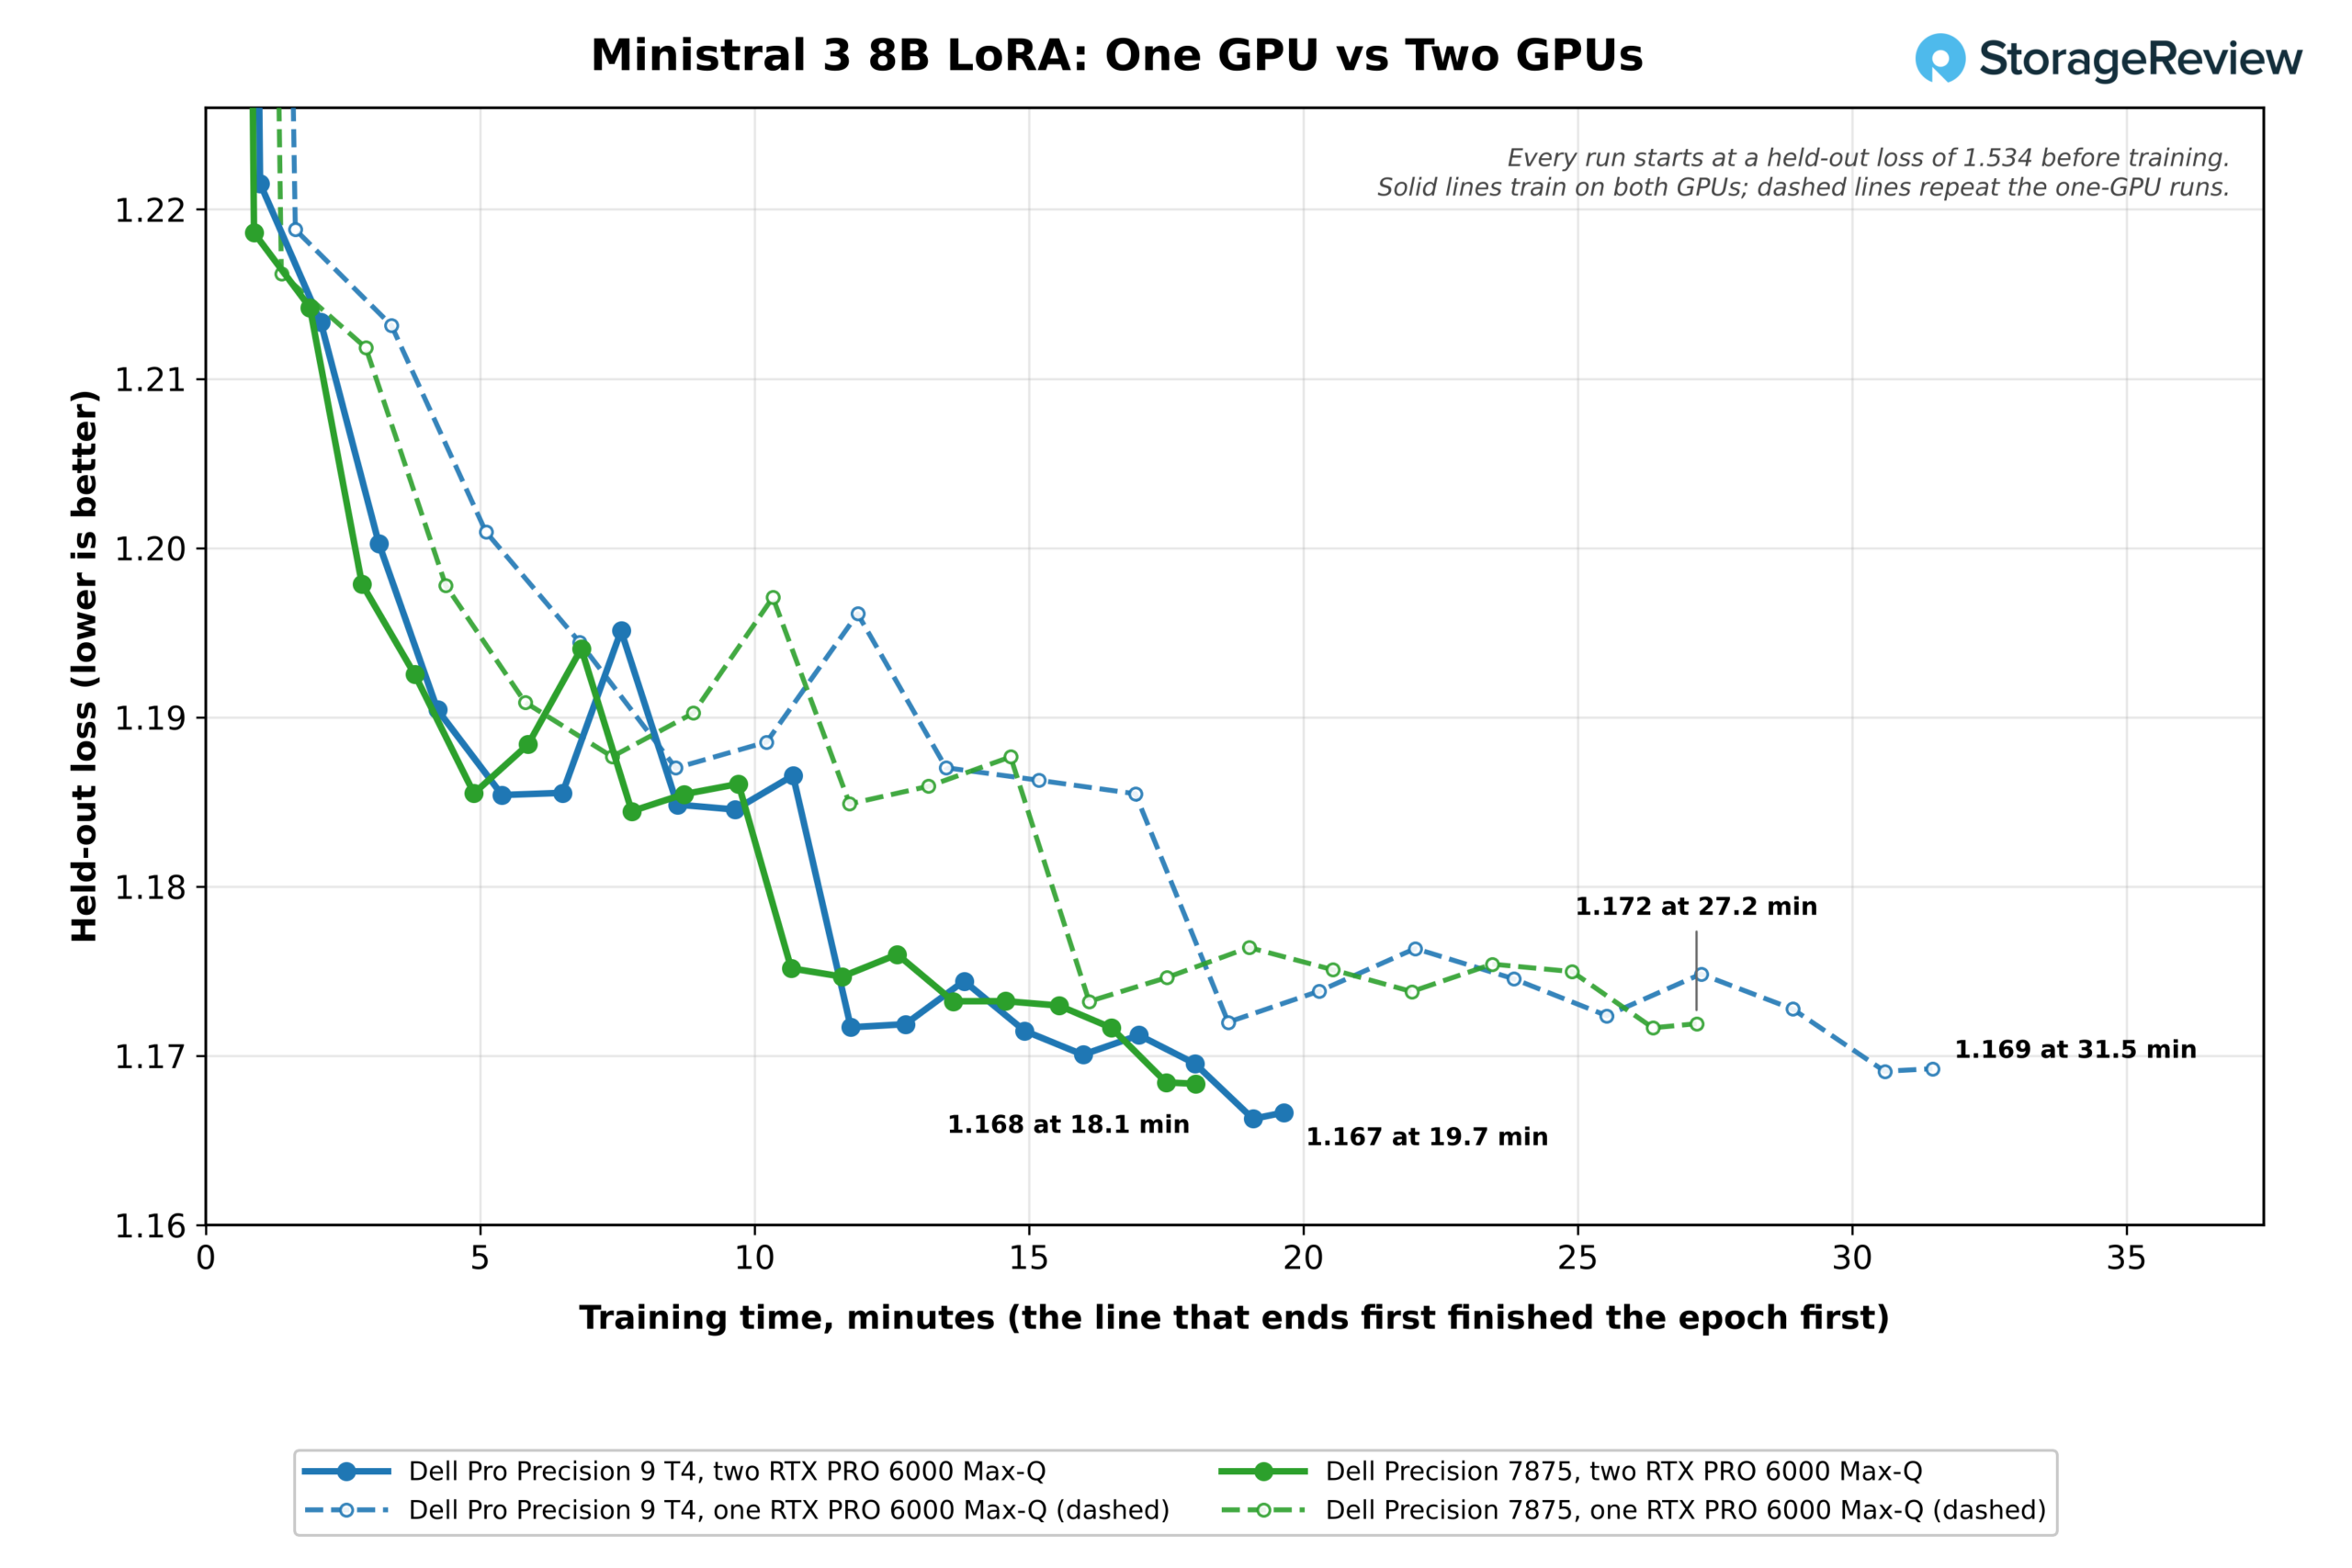
| 에포크 학습 시간(GPU 2개 사용 시, 분 단위, 낮을수록 좋음) | 19.7 | 18.1 | 단일 GPU | 단일 GPU |
| 처리량, GPU 2개 기준 (토큰/초) | 2,528 | 2,754 | 단일 GPU | 단일 GPU |
| 두 번째 GPU를 통한 속도 향상 | SR 1.60x | SR 1.50x | 단일 GPU | 단일 GPU |
| 훈련 후 손실 보정, GPU 2개 사용 | 1.167 | 1.168 | 단일 GPU | 단일 GPU |
LoRA 테스트는 1,849단계에 걸쳐 Dolly 15k 데이터셋의 BF16 맵에서 Ministral 3 8B GPU를 미세 조정하고, 100단계마다 200개의 홀드아웃 예제에 대한 점수를 계산합니다. 모든 시스템은 1.534의 홀드아웃 손실로 시작하여 1.167에서 1.172 사이의 값으로 마무리되었으므로, 시스템 간의 차이를 결정하는 요소는 에포크에 소요된 시간입니다. 한 T4 GPU는 초당 1,584 토큰의 속도로 31.5분 만에 테스트를 완료했으며, 동일한 Max-Q 카드에 탑재된 Pro Precision 9 T2와 3% 이내의 차이를 보였습니다. Precision 7875는 27.2분, Pro Max Tower T2에 탑재된 600W 카드는 22.3분이 소요되었습니다.
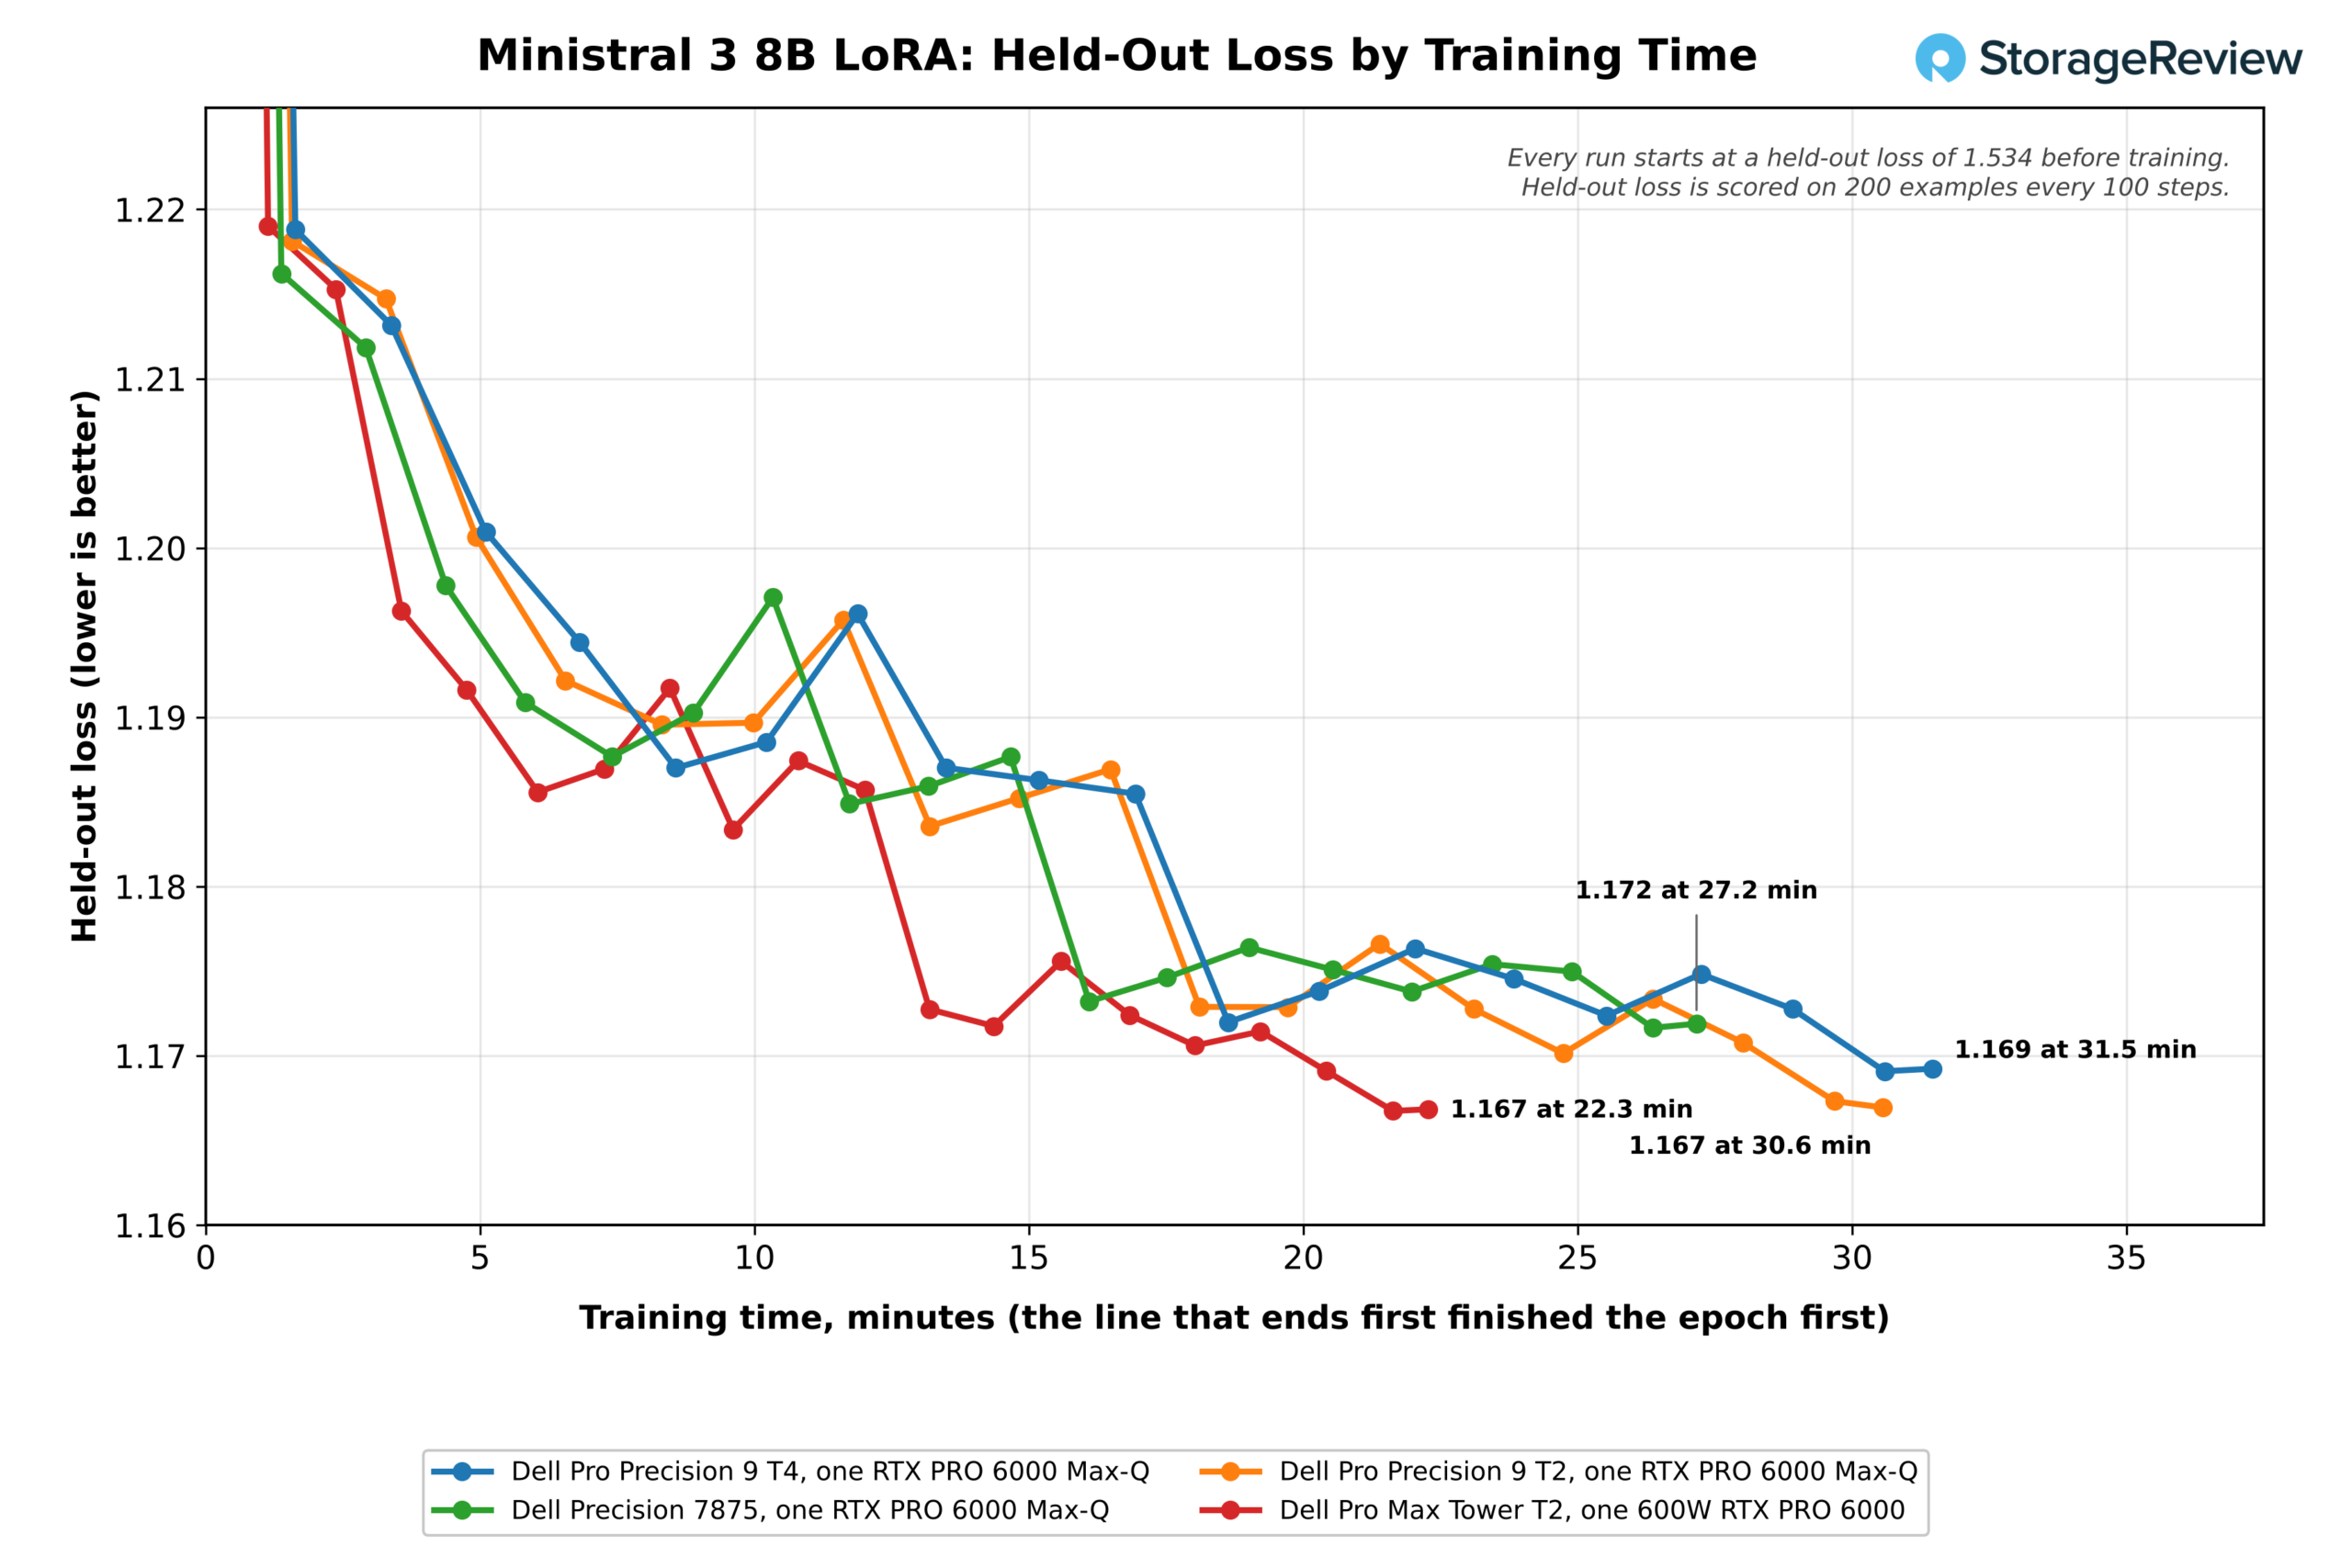
T4의 홀드아웃 손실은 학습 시작 후 1.6분, 즉 첫 100단계 동안 1.534에서 1.219로 떨어졌고, 이후 에포크가 끝날 때까지 1.169로 완만하게 감소했습니다. 두 번째 GPU를 추가함으로써 T4의 에포크는 초당 2,528개의 토큰 처리 속도로 19.7분으로 단축되었으며, 이는 1.60배의 속도 향상으로, 단일 600W 카드의 22.3분보다 빠른 결과입니다. Precision 7875는 두 개의 GPU를 사용하여 18.1분 만에 에포크를 완료하여 1.50배의 속도 향상을 보였으며, 두 GPU 실행에서 홀드아웃 손실은 각각 1.167과 1.168이었습니다.
두 그래픽 카드는 각각 두 개의 예제를 사용하여 데이터를 병렬로 처리하고, 하나의 GPU에서는 4번의 패스, 두 개의 GPU를 사용하는 경우 2번의 패스를 통해 동일한 8개의 전역 배치에 그래디언트를 누적합니다. 따라서 두 개의 GPU를 사용하는 실행은 각 단계에서 동일한 예제를 사용하고 동일한 손실 함수를 적용합니다. 각 패스에서 GPU당 두 개의 짧은 예제를 처리하므로 두 번째 카드가 처리해야 할 작업량이 적고 그래디언트 교환이 각 단계에서 더 큰 비중을 차지합니다. 에포크 동안 한 카드에서는 최대 19.5GiB, 두 카드에서는 카드당 최대 19.7GiB의 GPU 메모리를 사용했는데, 이는 각 RTX PRO 6000의 96GB 용량에 비하면 극히 일부에 불과합니다.
코딩 에이전트, 소규모 RAG 및 이미지 생성
| 코딩 에이전트, RAG 및 이미지 생성 (별도로 명시되지 않은 경우 높을수록 좋습니다) | 델 프로 프리시전 9 T4 | Dell Precision 7875 | 델 프로 프리시전 9 T2 | 델 프로 맥스 타워 T2 |
|---|---|---|---|---|
| 코딩 에이전트, gpt-oss:20b 64K, 성공적으로 실행됨 (3회 중) | 3 | 2* | 2* | 2* |
| 코딩 에이전트, gpt-oss:120b 128K, 성공적으로 실행됨 (3회 중) | 3 | 3 | 3 | 3 |
| 코딩 에이전트, gpt-oss:120b, 생성 속도(토큰/초) | 161.5 | 167.9 | 166.7 | 183.2 |
| RAG, 20,963개 구절, 섭취(구절/초) | 304.6 | 433.8 | 392.1 | 371.6 |
| RAG 답변 생성, Phi-4-mini(토큰/초) | 372.5 | 410.0 | 402.8 | 415.8 |
| FLUX.2 클라인 4B BF16, 1024×1024(이미지/분) | 40.96 | 43.03 | 41.32 | 54.25 |
| Z-Image Turbo 6B BF16 (이미지/분) | 17.29 | 17.67 | 17.27 | 23.83 |
| Qwen-Image 20B BF16 (이미지/분) | 2.43 | 2.45 | 2.39 | 3.20 |
*검증 도구 모음에서 플래그가 지정됨: 이 시스템에서 실행된 세 번의 에이전트 중 하나가 11가지 테스트를 모두 통과하지 못했습니다.
T4는 모든 모델 계층에서 모든 코딩 에이전트 실행을 통과했으며, 특히 다른 세 시스템이 3개 중 2개만 통과한 64K 컨텍스트에서의 gpt-oss:20b 실행 3개를 모두 통과했습니다. 또한 gpt-oss:120b에서는 초당 161.5개의 토큰을 생성했습니다. 이미지 생성은 하나의 GPU에서 실행되므로 BF16의 FLUX.2 klein에서 T4의 분당 40.96개 이미지 생성 속도는 다른 Max-Q 시스템과 비슷한 수준이며 600W 카드(분당 54.25개)보다는 낮습니다.
CPU 성능
CPU 성능 비교에서 T4의 86개 제온 코어와 Precision 7875의 96개 스레드리퍼 코어를 비교했으며, 24개 코어를 가진 두 대의 T2를 기준점으로 삼았습니다. 스레드리퍼는 코어 수가 10개 더 많고 스레드 수도 192개로 제온의 172개보다 많습니다. 메모리 대역폭이 승패를 좌우하는 부분에서는 T4가 우위를 점했고, 코어 수와 클럭 속도가 중요한 부분에서는 7875가 우위를 점했습니다.
압축, 렌더링 및 컴파일
| Test | 델 프로 프리시전 9 T4 | Dell Precision 7875 | 델 프로 프리시전 9 T2 | 델 프로 맥스 타워 T2 |
|---|---|---|---|---|
| 7-Zip, 모든 스레드(GIPS) | 619.8 | 850.0 | 285.1 | 172.7 |
| 7-Zip, 단일 스레드(GIPS) | 8.85 | 10.58 | 9.27 | 11.04 |
| 블렌더 4.5 몬스터(샘플/분) | 961.8 | 1,253.8 | 400.7 | 303.0 |
| Blender 4.5 정크샵(샘플/분) | 641.9 | 849.7 | 266.9 | 191.9 |
| Blender 4.5 강의실용 (샘플/분) | 442.8 | 612.2 | 187.2 | 147.1 |
| 핸드브레이크 x265 (fps) | 31.4 | 41.7 | 41.5 | 40.0 |
| 핸드브레이크 SVT-AV1 (fps) | 159.4 | 255.8 | 198.5 | 122.6 |
| LLVM 21 빌드 (s, 숫자가 낮을수록 좋음) | 58.4 | 43.7 | 106.4 | 155.9 |
| Linux 커널 allmodconfig (s, 값이 낮을수록 좋음) | 312 | 264 | 537 | 843 |
| OpenSSL AES-256-GCM, 모든 스레드 (GB/s) | 882.6 | 1,139.1 | 371.2 | 137.0 |
| nginx, 1,000 연결(요청/초) | 414,468 | 467,128 | 323,567 | 153,732 |
T4는 7-Zip에서 619.8 GIPS, Blender Monster에서 분당 961.8 샘플을 기록했는데, 이는 2.4코어 Pro Precision 9 T2보다 각각 2.2배와 24배 빠른 속도입니다. Precision 7875는 7-Zip에서 37%, Blender에서 30% 더 빠른 성능을 보였으며, LLVM 빌드는 43.7초(T4는 58.4초), Linux 커널 allmodconfig 빌드는 264초(T4는 312초) 만에 완료했습니다. 코어당 속도는 T4의 약점으로, 단일 스레드 7-Zip 테스트에서 이 그룹 중 가장 낮은 8.85 GIPS를 기록했습니다.
HandBrake의 x265 인코딩은 이 표에서 예외적인 결과이며, 그 원인은 프로세서보다는 인코더 자체에 있습니다. 나머지 세 시스템은 24코어 또는 96코어에서 모두 40.0~41.7fps 사이의 성능을 보였으므로, 이 프리셋에서 x265는 코어 수에 비례하여 성능이 향상되지 않으며, T4의 31.4fps는 x265에 사용되는 스레드에서 코어당 속도가 낮다는 점과 일치합니다. 인코딩 과정에서 T4는 172개 스레드에서 평균 약 1GHz의 클럭 속도를 보였고, 온도는 51~64°C였습니다. 이는 칩 대부분이 유휴 상태임을 나타냅니다. SVT-AV1은 T4에서 159.4fps, 7875에서 255.8fps를 기록하며 더 나은 성능 향상을 보였습니다.


메모리 대역폭, 시뮬레이션 및 수학
| Test | 델 프로 프리시전 9 T4 | Dell Precision 7875 | 델 프로 프리시전 9 T2 | 델 프로 맥스 타워 T2 |
|---|---|---|---|---|
| 스트림 트라이어드(MB/s) | 328,329 | 215,177 | 141,832 | 45,102 |
| OpenFOAM 13 드라이버, 3M 셀, 해결(초, 값이 낮을수록 좋음) | 293 | 556 | 826 | 끝나지 않았다 |
| GROMACS benchPEP, 모든 코어(ns/일) | 1.243 | 1.034 | 실행되지 않음 | 실행되지 않음 |
| GROMACS benchMEM, 16개 코어 (ns/일) | 68.09 | 84.94 | 78.03 | 54.26 |
| OpenBLAS DGEMM, 모든 코어(GFLOPS) | 3,664 | 4,745 | 2,319 | 1,063 |
| OpenBLAS LU는 N=20000(GFLOPS)을 해결합니다. | 1,660 | 1,172 | 1,616 | 858 |
| y-cruncher Pi, 1억 자리 (초, 숫자가 낮을수록 좋음) | 4.01 | 7.45 | 8.51 | 24.61 |
| y-cruncher Pi, 10억 자리 (초, 숫자가 낮을수록 좋음) | 53.9 | 83.7 | 119.2 | 347.9 |
| y-cruncher Pi, 25억 자리 (초, 숫자가 낮을수록 좋음) | 155.6 | 259.6 | 실행되지 않음 | 실행되지 않음 |
8개의 DDR5-6400 채널을 탑재한 T4는 STREAM Triad에서 328GB/s의 대역폭을 제공하며, 이는 Precision 7875의 DDR5-5600보다 53% 높고, 4채널 Pro Precision 9 T2보다 2.3배 빠른 성능입니다. 대역폭 성능 테스트 결과, T4는 300만 셀 규모의 OpenFOAM drivAer 케이스를 293초 만에 완료했는데, 이는 Precision 7875의 556초, Pro Precision 9 T2의 826초보다 빠른 기록입니다. 반면 Pro Max Tower T2는 테스트 제한 시간인 150분 내에 완료하지 못했습니다. 또한 T4는 2260만 셀 규모의 케이스를 6,851초 만에 처리했습니다.

대규모 전 코어 분자 동역학 테스트인 GROMACS benchPEP는 T4에서 1.243ns/일, 7875에서 1.034ns/일의 처리 시간을 기록했으며, LU 분해능은 T4에서 1,660GFLOPS, 7875에서 1,172GFLOPS를 달성했습니다. y-cruncher 테스트에서는 원주율 100억 자리 계산에 T4가 53.9초, 7875가 83.7초를 기록했고, 250억 자리 계산에는 T4가 155.6초, 7875가 259.6초를 기록했습니다. 캐시에 유지되는 고밀도 연산에서는 Threadripper가 우위를 점했으며, OpenBLAS DGEMM 테스트에서는 T4가 4,745GFLOPS, 7875가 3,664GFLOPS를 기록했습니다.


데이터베이스 및 서비스
| Test | 델 프로 프리시전 9 T4 | Dell Precision 7875 | 델 프로 프리시전 9 T2 | 델 프로 맥스 타워 T2 |
|---|---|---|---|---|
| ClickBench 핫런, 43개 쿼리 (초, 낮을수록 좋음) | 3.21 | 2.88 | 4.80 | 10.44 |
| ClickBench 콜드런, 43개 쿼리 (초, 수치가 낮을수록 좋음) | 6.45 | 7.09 | 6.92 | 14.22 |
| Valkey 캐시, SET(요청/초) | 666,714 | 1,138,696 | 914,832 | 1,719,108 |
| Valkey 캐시, GET (초당 요청 수) | 865,353 | 1,279,429 | 991,576 | 1,648,278 |
| 스톡피쉬, 모든 스레드(Mnps) | 68.21 | 168.27 | 45.44 | 37.42 |
| PyPerformance go (ms, 낮을수록 좋음) | 74.3 | 66.0 | 72.1 | 56.7 |
ClickHouse는 T4에서 43개의 ClickBench 쿼리를 핫 테스트 시 3.21초, 콜드 테스트 시 6.45초 만에 실행했습니다. 이는 핫 테스트에서는 7875보다 0.33초 느리고, 콜드 테스트에서는 0.64초 빠른 결과입니다. Valkey는 코어 수보다 빠른 코어를 선호하는데, T4의 초당 666,714개의 SET 요청 처리량은 비교 대상 시스템 세 곳 모두에 뒤처지며, Pro Max Tower T2에 탑재된 Core Ultra 9 285K가 1.72만 개로 가장 빠른 처리량을 기록했습니다. 이러한 패턴은 T4의 단일 스레드 테스트 결과와 일치하며, 지연 시간에 민감한 서비스의 경우 고려해야 할 사항입니다.
172개의 스레드가 모두 로드되고 프로세서 평균 온도가 87°C인 상태에서 T4는 Stockfish에서 초당 68.21만 개의 노드를 검색했습니다. 이는 48개의 스레드를 사용하는 Pro Precision 9 T2의 1.5배에 해당하며, 192개의 스레드를 사용하는 7875의 1억 6,827만 개에는 훨씬 못 미치는 수치입니다. 또한, T4의 첫 번째 전체 실행 테스트는 시간 초과로 실패했으며, 이후 별도로 재테스트한 결과 이 수치가 나왔습니다. 본 보고서는 측정된 결과를 있는 그대로 제시하며, 성능 저하의 원인은 아직 규명하지 못했습니다.
스토리지 성능
| fio, 25GiB 용량 (용량이 클수록 좋음) | 델 프로 프리시전 9 T4 | Dell Precision 7875 | 델 프로 프리시전 9 T2 | 델 프로 맥스 타워 T2 |
|---|---|---|---|---|
| 순차 읽기 속도 128K(MB/s) | 14,152 | 7,089 | 20,914 * | 7,234 |
| 순차 쓰기 속도 128K(MB/s) | 10,078 | 5,265 | 12,564 | 6,772 |
| 랜덤 읽기 4K, 최대 (IOPS) | 2,306,346 | 993,569 | 3,214,066 | 1,538,387 |
| 랜덤 쓰기 4K, 최대 (IOPS) | 1,830,776 | 787,388 | 2,353,766 | 1,326,030 |
*재실행 후 실행 간 편차가 발생하여 해당 검사 도구에서 플래그가 지정되었습니다.
T4의 2TB SK 하이닉스 Gen5 부팅 드라이브는 읽기 속도 14,152MB/s, 쓰기 속도 10,078MB/s를 기록했는데, 이는 Precision 7875와 Pro Max Tower T2에 탑재된 Gen4 드라이브의 순차 읽기 속도보다 약 두 배 빠른 속도입니다. 또한, 랜덤 읽기 IOPS는 최대 2.31만, 랜덤 쓰기 IOPS는 최대 1.83만까지 도달했습니다. Pro Precision 9 T2의 순차 읽기 속도는 20,914MB/s로, Gen5 x4 링크 하나가 처리할 수 있는 속도를 초과합니다. 이는 해당 시스템의 테스트 볼륨(삼성 PM9E1 Gen5 드라이브 스트라이프 어레이)에 적합한 속도입니다. 본 테스트에서는 T4의 부팅 드라이브만 사용했으며, 두 번째 2TB 드라이브는 테스트에 포함하지 않았습니다.

부하 시 발열 및 클럭 속도
| 델 프로 프리시전 9 T4 | CPU 최대치(섭씨) | CPU 평균(C) | 평균 CPU 클럭(MHz) |
|---|---|---|---|
| 7 - 우편 번호 | 93 | 80.6 | 1,967 |
| 믹서기 | 91 | 85.7 | 2,587 |
| GROMACS | 96 | 81.3 | 1,313 |
| LLVM 빌드 | 83 | 74.5 | 2,127 |
| 오픈블라스 | 80 | 62.9 | 1,325 |
| LLM 과정 제공 | 84 | 65.0 | 924 |
| 미세 조정 | 71 | 61.2 | 854 |
| 대규모 RAG | 74 | 64.4 | 987 |
| 스토리지 | 64 | 55.4 | 942 |
BIOS를 울트라 퍼포먼스 모드로 설정했을 때, Xeon 698X는 7-Zip 실행 시 최고 93°C, GROMACS 실행 시 최고 96°C를 기록했으며, 표에 표시된 클럭 수치는 172개의 논리 CPU 전체의 평균값입니다. Blender와 Stockfish는 모든 스레드를 로드하여 칩의 기본 클럭인 2.0GHz보다 높은 2.5GHz~2.6GHz를 유지했습니다. GROMACS와 OpenBLAS는 각각 64개와 86개의 물리적 코어를 로드하고 나머지 스레드는 약 0.8GHz로 유휴 상태를 유지하므로 평균 클럭이 약 1.3GHz로 나타납니다. GPU 중심 작업(LLM Serving, Fine Tuning, RAG)은 GPU에 부하가 걸리기 때문에 프로세서 온도를 61°C~65°C로 낮게 유지했습니다.

맺음말
Dell Pro Precision 9 T4는 로컬 AI 작업에 최적화되어 있으며, 두 번째 RTX PRO 6000 그래픽 카드의 성능이 이를 입증합니다. 두 개의 Max-Q 카드를 사용함으로써 4개 모델에서 최대 서비스 처리량이 1.85배에서 2.02배로 향상되었고, 임베딩 처리량은 1.92배 증가했습니다. 또한 Ministral 3 8B에서 LoRA 에포크 처리 시간이 31.5분에서 19.7분으로 단축되었으며, 단일 카드로는 처리하기 어려운 MiniMax M2.7 모델의 경우 단일 사용자 기준 초당 토큰 처리량이 30.3개에서 83.7개로 증가했습니다. gpt-oss 120B에서는 GPU당 하나의 서버를 사용했을 때 64개 요청에서 초당 총 7,091개의 토큰을 처리했지만, 모델을 두 카드에 분산했을 때는 단일 사용자의 첫 번째 토큰 반환 시간이 1,189ms에서 719ms로 단축되었습니다.

8개의 DDR5-6400 채널을 탑재한 Xeon 698X는 Threadripper PRO 9995WX보다 53% 높은 메모리 대역폭을 제공했습니다. 이러한 대역폭 덕분에 T4는 Precision 7875보다 OpenFOAM, GROMACS benchPEP, y-cruncher, HNSW 검색 결과에서 더 빠른 속도를 보여주었고, T4의 Gen5 스토리지는 대용량 모델을 더 빠르게 로드했습니다. 섀시 또한 칭찬할 만한데, 동급에서 Dell이 선보인 최고의 냉각 시스템과 도구 없이 전원 공급 장치에 접근할 수 있는 편리함을 갖추고 있습니다.
7875는 코어 집약적인 렌더링, 압축 및 컴파일 작업에서 18~38%, SVT-AV1에서는 60% 더 우수한 성능을 보였습니다. Xeon의 코어당 속도는 이 그룹의 모든 시스템에 비해 떨어졌으며, 이는 Valkey 및 기타 스레드 사용량이 적은 서비스에서 확연히 드러났습니다. 단일 GPU에서의 미세 조정 또한 T4에서 더 느렸는데, LoRA 에포크는 T4에서 31.5분이 소요된 반면 7875는 27.2분, Pro Max Tower T2에 탑재된 600W 카드는 22.3분이 소요되었습니다. 모든 시스템은 동일한 기준치와의 0.005초 이내의 차이를 보였습니다.
Dell.com에서 구성 기준으로 약 66,600달러인 T4는 96GB 이상의 GPU 메모리가 필요한 모델을 포함하여 온프레미스에서 모델을 서비스, 임베딩 및 미세 조정하려는 팀에 적합하며, 동일한 머신에서 메모리 집약적인 시뮬레이션 및 분석 작업도 수행할 수 있습니다. 주로 렌더링 및 컴파일 작업을 하는 사용자는 스레드리퍼 플랫폼의 빠른 속도를 경험할 수 있으며, GPU가 하나만 필요한 사용자는 더 작은 Pro Precision 9 T2에서 동일한 카드를 사용할 수 있습니다.

순위표: Dell Pro Precision 9 T4는 로컬 AI 용 최고의 데스크톱 순위표에서 최고의 Xeon 타워로 선정되었습니다.


 아마존