

저희는 지금까지 몇 가지 GB300 DGX 스테이션을 살펴보았고, 최근에는 ASUS ExpertCenter Pro ET900N G3 와 HP ZGX Fury AI Station 두 대를 동시에 연구실에 들여놓았습니다 . 두 대의 타워를 나란히 놓고 연결하여 두 번째 GB300이 단일 시스템의 성능을 어떻게 향상시켜 데스크톱 AI 워크로드를 더욱 효율적으로 처리할 수 있는지 확인하고자 했습니다.
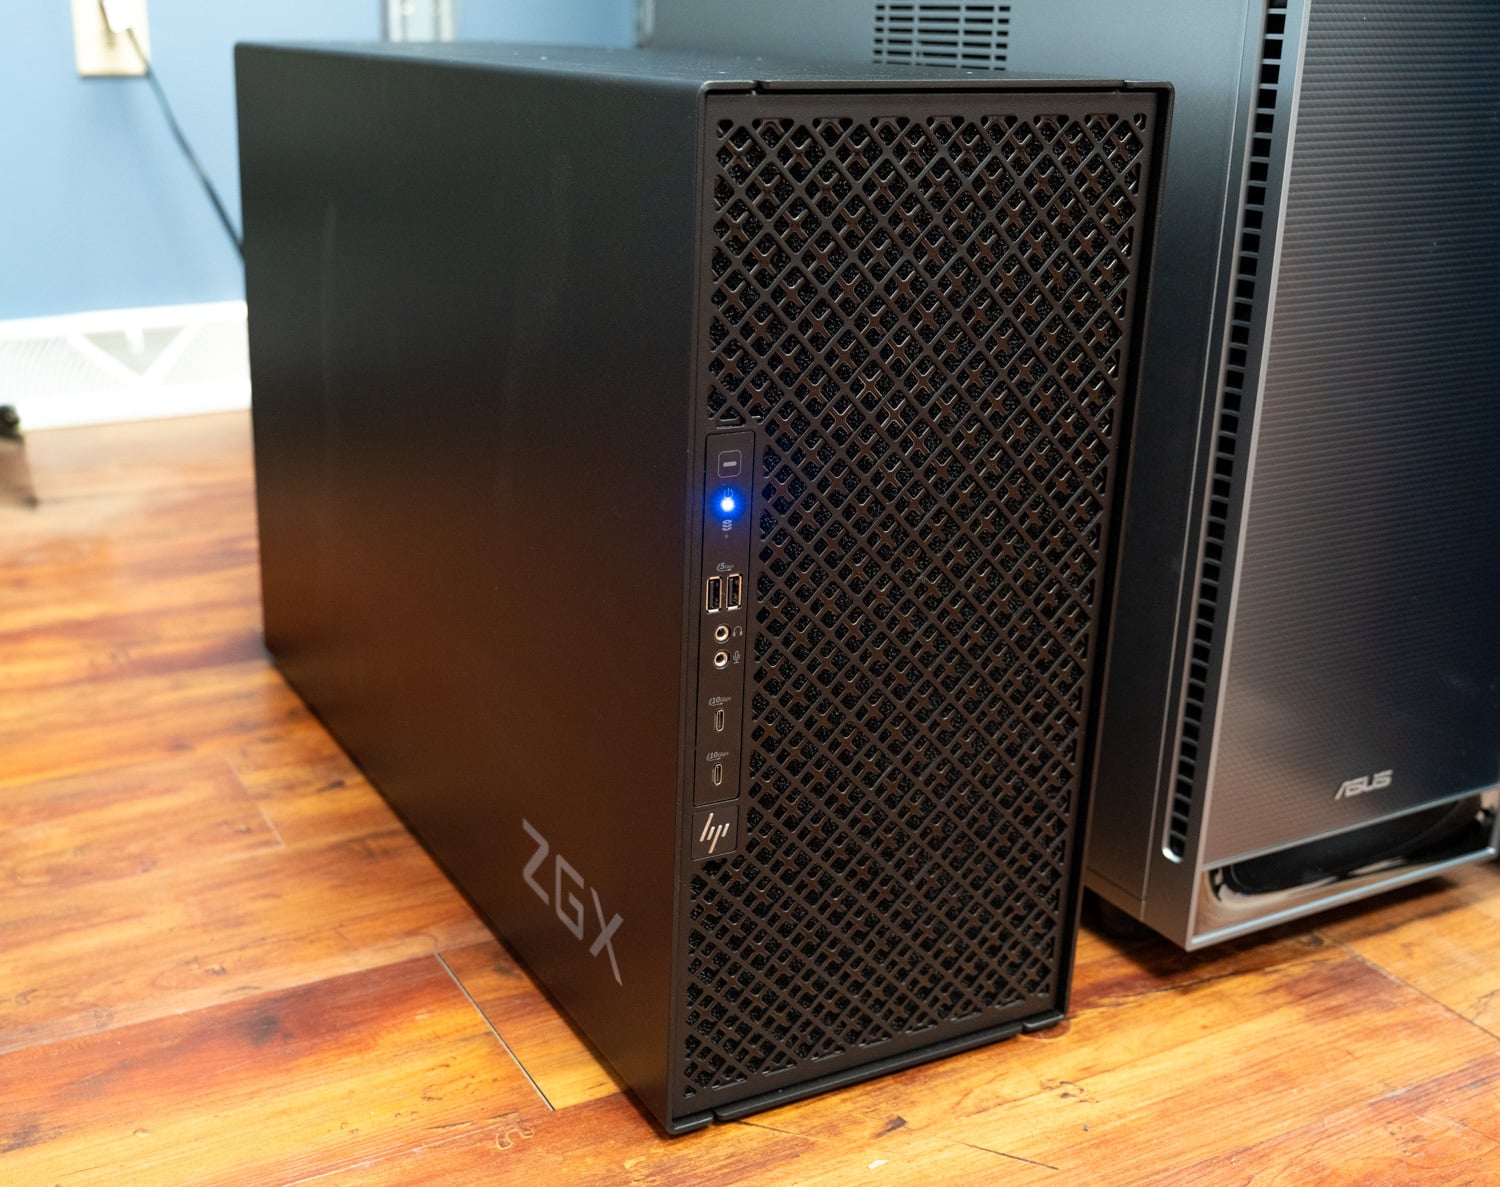
데스크톱 환경을 한 번에 한 대씩 확장하는 것은 새로운 아이디어가 아닙니다. NVIDIA는 GB10 플랫폼에서 이를 명확히 제시했습니다. DGX Spark의 가장 큰 장점 중 하나는 시스템 한 대로 시작하여 워크로드가 증가함에 따라 더 많은 시스템을 연결할 수 있다는 점이었습니다. GB300은 훨씬 뛰어난 성능으로 시작하지만, 더 큰 모델을 실행하거나 더 많은 사용자를 지원해야 하는 경우, 우리가 테스트한 가장 빠른 데스크톱 시스템조차도 버거워질 수 있습니다. 이것이 바로 우리가 이전 MSI 리뷰 에서 언급했던 내용입니다 . 워크로드에 따라 이러한 워크스테이션 한 대가 필요하다면, 결국 여러 대를 구매해야 할 필요성이 생길 수 있다는 것을 쉽게 알 수 있습니다.
많은 구매자에게 있어 비용은 확장이 실현 가능한 시점을 결정하는 중요한 요소입니다. 현재 두 스테이션이 얼마나 잘 연동되는지 이해하면, 스테이션 하나로 시작하는 사람이 나중에 확장을 통해 얻을 수 있는 이점을 더욱 명확하게 파악할 수 있습니다.
주요 요점
- 케이블 두 개, 회선 속도의 98%: ASUS ET900N G3와 HP ZGX Fury의 ConnectX-8 포트 사이에 두 개의 400G DAC를 연결하여 NCCL 테스트 결과, 브로드캐스트, 리듀스, 송수신 속도에서 각각 98GB/s를 기록했으며, 이는 DAC 쌍이 지원할 수 있는 최대 속도인 100GB/s를 상회하는 수치입니다. GPUDirect RDMA 테스트에서는 각 레일에서 392Gb/s의 속도를 달성했고, 8바이트 RDMA 쓰기 평균 시간은 1.46µs였습니다. NVIDIA의 테스트 매뉴얼이 이 설정을 원활하게 처리했습니다.
- GLM-5.2는 동일한 동시 실행 환경에서 11배의 성능 향상을 보였습니다. 433GB NVFP4 체크포인트는 약 215GB의 전문가 가중치를 하나의 스테이션에 있는 Grace 메모리에 저장하는데, 이 스테이션은 32개의 스트림에서 초당 139개의 출력 토큰을 처리했습니다. 텐서 병렬로 두 개의 B300에 분산했을 때는 32개의 스트림에서 1,525개, 256개의 스트림에서 3,141개의 토큰을 처리했습니다.
- GLM-5.3은 초당 188개 토큰에서 5,018개 토큰으로 증가합니다. 이 세트에서 가장 큰 성능 향상(27배)은 252GB의 HBM3e를 사용하는 다른 모델에서 나타났으며, 두 모델을 함께 사용하면 동일한 작업 부하에서 256개의 스트림을 처리하고 8,192개의 토큰 프롬프트에서 초당 약 600개의 출력 토큰을 유지하여 단일 타워보다 약 5배 빠른 성능을 보여줍니다.
- MiniMax-M3의 긴 프롬프트는 한 스테이션에서 최대 8개의 스트림까지만 표시됩니다. KV 캐시가 소진되면서 단일 타워는 8개 스트림에서 초당 103개의 출력 토큰으로 떨어졌지만, 두 타워를 함께 사용했을 때는 같은 시점에서 736개(7.1배)를 처리했고, 256개 스트림에서는 1,801개까지 처리량을 유지했습니다.
- 적합한 모델은 두 번째 복사본을 얻고 사전 채우기/디코딩 분할을 수행합니다. 한 스테이션은 프리필, 다른 스테이션은 디코딩으로 설정했을 때, GLM-5.3 Flash는 32개 스트림에서 짧은 프롬프트 처리량을 3배(828에서 2,721로) 늘리고 긴 프롬프트 처리량을 2배(1,219에서 2,448로) 늘렸으며, DeepSeek V4.1 Flash는 테스트된 모든 모델 중 가장 높은 출력 처리량인 256개 스트림에서 초당 5,248개의 토큰을 기록했습니다.
DGX 스테이션에서의 네트워킹
클러스터 구성에 대해 자세히 알아보기 전에, MSI 리뷰에서 다뤘던 네트워킹 기능을 다시 한번 살펴보겠습니다. ConnectX-8 SuperNIC는 단순한 네트워크 연결 이상의 기능을 제공합니다. 내장된 PCIe 스위치 는 스테이션의 내부 I/O 일부를 처리하며, Grace 보드와 2개의 PCIe Gen 6 x4 스토리지 슬롯에 연결됩니다.
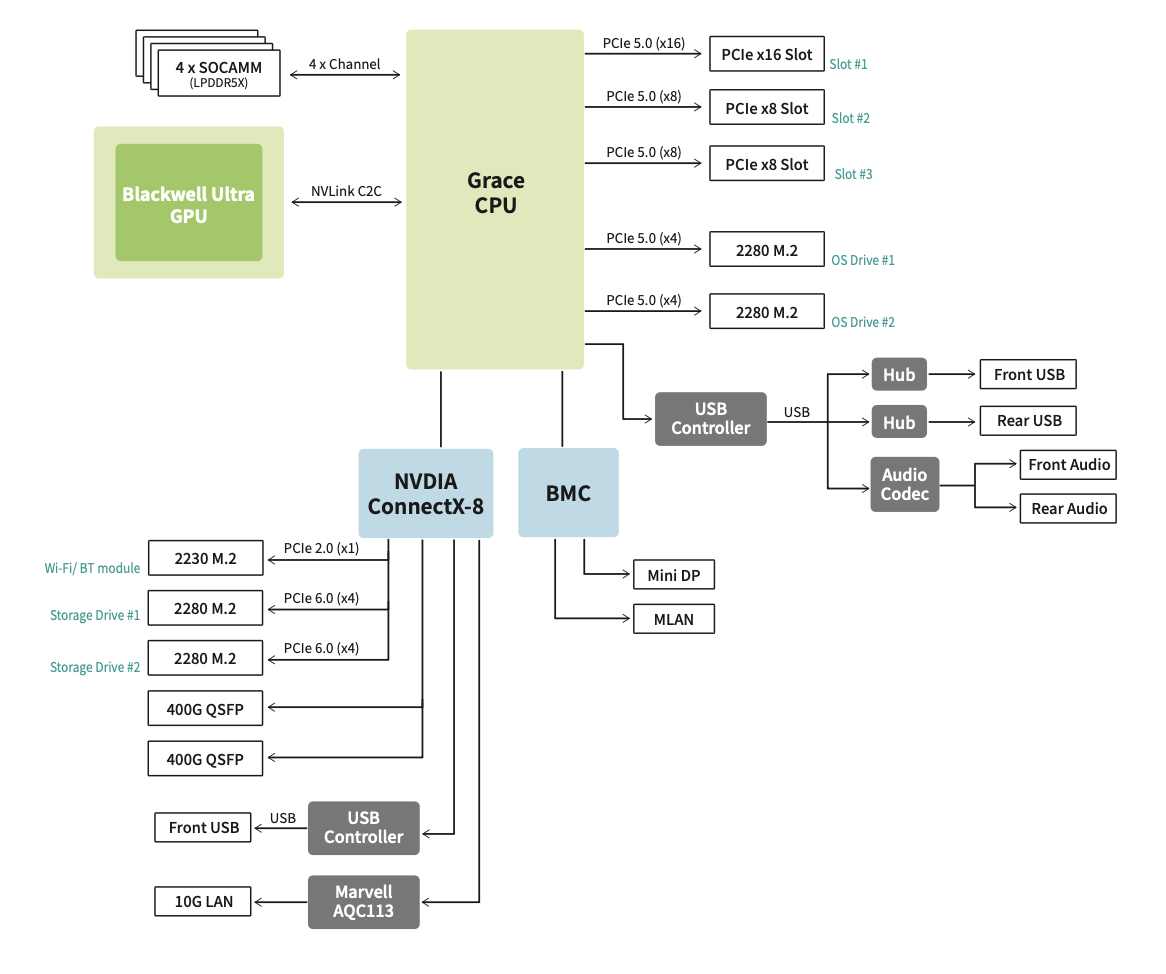
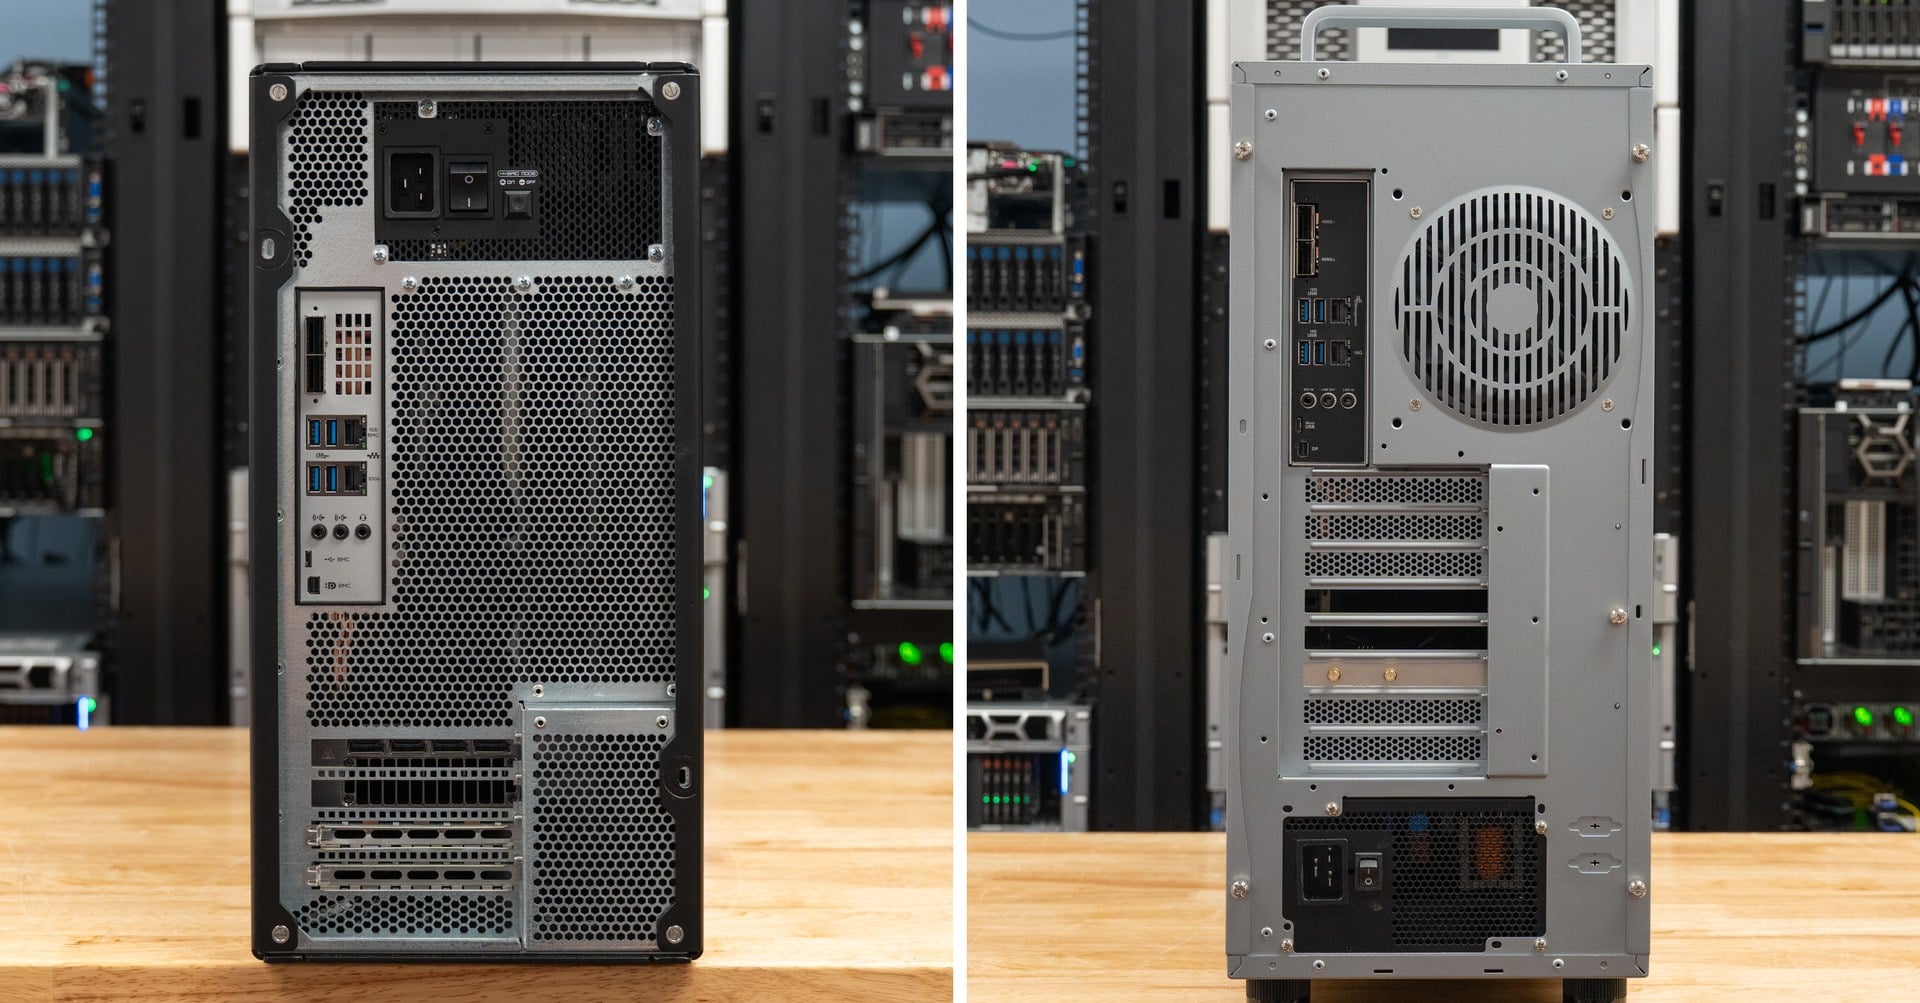
실제 네트워킹을 위해 시스템은 각각 400Gb/s 등급의 QSFP112 포트 2개를 제공하여 스테이션 간 연결 또는 더 큰 네트워크에 연결하기 위한 총 800Gb/s의 대역폭을 제공합니다.
이전에 DGX Spark 리뷰 에서 다뤘던 DGX Spark의 구현 방식과 비교해 보면 , Spark의 400Gb/s급 ConnectX-7은 GB10의 PCIe 연결 대역폭을 완전히 활용할 수 있는 수준보다 더 뛰어난 성능을 제공했습니다. 컨트롤러는 두 개의 별도 PCIe 5.0 x4 링크 뒤에 위치하여, 실질적인 네트워크 처리량은 약 200Gb/s로 제한되었습니다. 또한, 두 개의 물리적 포트는 Linux 환경에서 네 개의 논리적 이더넷 인터페이스로 인식되었습니다. 최대 대역폭을 확보하려면 이러한 인터페이스를 연결된 케이지에 매핑하고, 케이지 뒤에 있는 두 개의 논리적 인터페이스를 모두 구성하고 , RDMA 트래픽이 두 개의 PCIe 경로를 모두 사용할 수 있도록 설정해야 했습니다.
스테이션은 각각 독립적인 네트워크 레일 역할을 할 수 있는 400Gb/s 포트 두 개를 제공하여 더욱 간편한 구성을 가능하게 합니다.
Spark의 유효 대역폭을 4배로 늘려 QSFP 케이지 두 개를 통해 데이터를 전송하면 냉각 부하가 증가하지만, 테스트 결과 모든 장치가 이를 문제없이 처리했습니다. ConnectX-8 자체는 액체 냉각 방식을 사용하며, MSI처럼 QSFP 케이지까지 냉각 기능을 확장한 제조사도 있고, ASUS 리뷰에서처럼 방열판과 전용 팬을 케이지 위에 장착한 제조사도 있습니다. 이러한 냉각 방식은 수동 DAC보다 열을 더 많이 발생시키는 광 모듈에 특히 유용합니다. 두 방식 모두 테스트에서 좋은 결과를 보여주었으며, 네트워크 작동 중 냉각 관련 문제는 발생하지 않았습니다.
두 역 연결
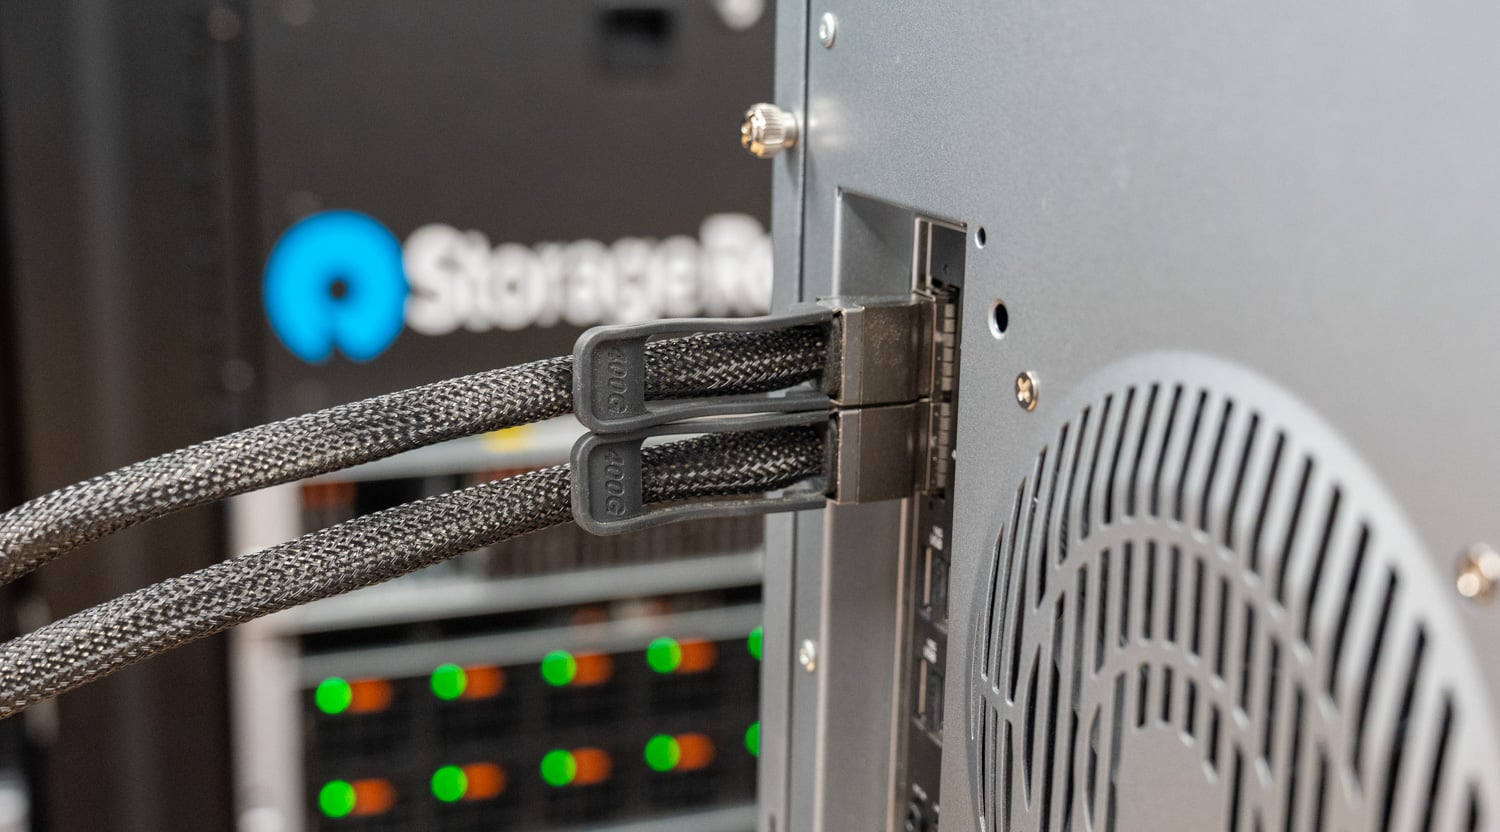
두 개의 DGX 스테이션을 클러스터링하는 것은 간단했습니다. ASUS와 HP 스테이션을 각각 해당 QSFP112 포트 사이에 400G DAC(Direct Attach Copper) 케이블 두 개를 사용하여 직접 연결함으로써 두 개의 독립적인 400Gb/s 연결을 확보했습니다.
소프트웨어 측면에서 NVIDIA는 시스템 클러스터링을 위한 단계별 가이드를 제공하며 , 설명이 매우 명확하여 Claude Code에 링크만 제공하고 나머지는 Claude Code가 처리하도록 했습니다. Claude Code는 두 스테이션 간의 네트워크를 구성하고 NCCL 대역폭 테스트를 실행한 후 결과 보고서를 제공했습니다.
이 가이드는 SSH를 통해 두 스테이션 모두에 접속하는 제0의 머신에서 실행되는 번호가 매겨진 플레이북입니다. 포트는 QSFP0과 QSFP1에 각각 QSFP1과 같은 일치하는 레일로 케이블링되어 있으며, 각 레일은 자체적인 포인트 투 포인트 RoCEv2 링크가 됩니다. 스크립트는 두 개의 ConnectX-8 인터페이스를 9,000바이트 MTU로 활성화하고, 각 레일에 자체적인 /24 프라이빗 영역을 할당하며, RoCE 및 GPUDirect 런타임 설정을 적용합니다.
검증 과정을 통해 두 링크 모두 400G로 학습되었는지, 점보 핑이 각 레일을 통과하는지, 두 개의 RDMA 장치(mlx5_0 및 mlx5_1)가 활성 상태인지 확인합니다. 또한 각 레일에서 ib_write_bw를 실행하여 패브릭이 핑뿐만 아니라 RDMA 트래픽도 전송하는지 검증합니다. 그 후 NCCL_IB_HCA=mlx5_0,mlx5_1로 NCCL을 두 레일 모두에 지정하고 다른 2노드 실행과 마찬가지로 작업을 시작합니다. 아래 결과는 이러한 과정을 거쳐 얻은 것입니다.
첫 번째 표는 nccl-tests에서 가져온 것으로, 두 대의 B300 서버에서 두 개의 레일을 모두 사용하여 분산 추론 또는 학습 작업의 집합 연산 결과를 보여줍니다. 스테이션당 하나의 GPU가 사용되므로 모든 집합 연산 결과는 두 개의 GPU가 400G 링크 쌍을 통해 데이터를 교환하는 것에 달려 있습니다. 따라서 버스 대역폭 열은 두 케이블이 제공하는 100GB/s(800Gb/s) 대역폭을 직접적으로 나타냅니다. 피크 값은 메시지 크기에 관계없이 가장 좋은 결과이며, 16GiB 열은 대역폭이 안정화된 가장 큰 메시지 테스트 결과입니다.
| 조작 | 피크 크기 | 최대 버스 대역폭 | 버스 대역폭 16GiB |
|---|---|---|---|
| 전체 감소 | 1 GiB | 92.242 GB / 초 | 91.346 GB / 초 |
| 모두 모이다 | 16 GiB | 87.893 GB / 초 | 87.893 GB / 초 |
| 산포 감소 | 2 GiB | 93.930 GB / 초 | 92.905 GB / 초 |
| 방송 | 16 GiB | 97.975 GB / 초 | 97.975 GB / 초 |
| 줄입니다 | 16 GiB | 97.978 GB / 초 | 97.978 GB / 초 |
| 모두 대 모두 | 8 GiB | 80.522 GB / 초 | 80.512 GB / 초 |
| 송수신, 단방향 | 16 GiB | 97.953 GB / 초 | 97.953 GB / 초 |
| 송수신, 양방향 | 16 GiB | 방향당 83.748GB/s | 167.496 GB/s 총합 |
브로드캐스트, 리듀스, 단방향 송수신 모두 98GB/s에 도달하여 두 케이블 최대 전송 용량의 98%를 기록했습니다. 양방향으로 데이터가 동시에 전송되는 패턴은 리듀스 방식의 경우 92GB/s, 양방향 송수신 방식의 경우 80GB/s로 다소 낮은 속도를 보였습니다. 양방향 송수신 결과는 이러한 패턴들의 기준점이 되는데, 두 GPU가 동시에 데이터를 전송할 때 각 방향은 84GB/s, 전체 링크 속도는 167GB/s를 기록했습니다.
두 번째 표는 NCCL보다 낮은 RDMA 경로를 사용하여 ib_write_bw를 한 번에 하나의 레일에 적용합니다. GPUDirect 행은 한 B300의 HBM에서 다른 B300의 HBM으로 1MiB 전송을 기록하며, NIC가 GPU 메모리를 직접 읽고 씁니다. 두 레일 모두 392Gb/s, 즉 회선 속도의 98%에 도달했습니다. 호스트 메모리 행은 가이드의 기본 스모크 테스트로, NVIDIA 플레이북에서 400G 레일에서 220~230Gb/s로 평가하는 Grace 메모리에서 소싱하는 단일 큐 쌍을 사용합니다. 우리는 228Gb/s를 확인했습니다. 지연 시간 행은 8바이트 쓰기로 평균 1.46µs입니다.
| Test | 대역폭 | 링크 활용 |
|---|---|---|
| GPUDirect RDMA, GPU 메모리, ib_write_bw, 1 MiB 전송 | ||
| 레일 0 | 392.15 Gb / s | 98.04% |
| 레일 1 | 392.15 Gb / s | 98.04% |
| 호스트 메모리 RDMA, 양쪽 레일 모두 | ||
| RDMA 쓰기, 단방향 | 228.15 Gb / s | |
| RDMA 읽기, 단방향 | 228.23 Gb / s | |
| RDMA 전송, 단방향 | 228.16 Gb / s | |
| RDMA 쓰기, 양방향 | 총 447.10Gb/s | |
| RDMA 쓰기 지연 시간, 8바이트 | 평균 1.46µs, 레일별 99번째 백분위수 1.63µs 및 1.66µs | |
클러스터 테스트 방법
두 시스템을 함께 사용할 수 있는 시간이 제한적이었기 때문에 현재 가장 인기 있는 AI 워크로드인 추론에 집중했습니다. 향후 더 큰 클러스터로 연구를 확장할 계획입니다. 이 논문에서는 더 큰 모델에 초점을 맞추고 텐서 병렬 처리(TP)와 사전 채우기/디코딩(PD) 분산을 사용하여 단일 스테이션과 두 개의 스테이션을 비교했습니다.
텐서 병렬 처리는 모델 내의 가중치 텐서와 계산을 여러 GPU에 분산시킵니다. 저희의 2스테이션 구성(TP2)에서는 각 B300 GPU가 모델의 일부를 담당하고, 두 GPU가 각 요청을 처리합니다. 이를 통해 가중치를 저장할 수 있는 고대역폭 메모리(HBM) 공간을 늘리고, 가중치 계산에 필요한 연산 능력도 향상시킵니다. 또한, 추론 과정 전반에 걸쳐 GPU 간 중간 결과를 교환하고 NCCL을 통해 동기화해야 하므로, 통신 오버헤드가 모델 실행 비용에 포함됩니다.
분산형 추론은 요청의 사전 입력(prefill) 및 디코딩(decode) 단계를 서로 다른 워커에 할당합니다. 사전 입력 단계에서는 입력 프롬프트를 처리하고 키/값(KV) 캐시, 즉 모델이 생성 과정에서 재사용하는 어텐션 상태를 구축합니다. 디코딩 단계에서는 이 상태를 사용하여 출력 토큰을 하나씩 생성합니다. 두 단계는 처리 요구 사항이 다릅니다. 사전 입력 단계는 연산 집약적인 반면, 디코딩 단계는 메모리 대역폭 집약적입니다. 대규모 환경에서 이처럼 추론을 분산하면 운영자는 수요에 따라 각 워커를 독립적으로 확장할 수 있습니다. 이는 저희의 KV 캐시 오프로드 관련 논문 에서 이미 설명했습니다.
단일 노드 구성에서 두 단계가 워커를 공유하는 경우, vLLM은 들어오는 프롬프트에 대한 사전 채우기 작업과 이미 진행 중인 요청의 디코딩 작업을 인터리빙할 수 있습니다. 이러한 프롬프트 처리로 인해 출력 토큰 간 시간이 늘어날 수 있습니다. 저희 PD 구성에서는 한 스테이션이 사전 채우기를 처리하고 요청의 키-값 캐시를 다른 스테이션으로 전송하며, 다른 스테이션은 디코딩을 처리합니다. 각 워커는 Grace 메모리에 저장된 데이터를 포함하여 모델의 자체 복사본에 접근할 수 있습니다. 디코딩 워커는 더 이상 토큰 생성과 함께 새로운 프롬프트 처리를 예약할 필요가 없으므로 추론 처리량이 향상됩니다.
테스트에서 어떤 접근 방식을 사용할지는 모델의 메모리 요구 사항에 따라 결정되었습니다. 단일 스테이션에서 상당량의 모델 가중치를 Grace 메모리로 오프로드해야 하는 가장 큰 체크포인트의 경우 TP 방식이 가장 좋은 성능을 보였습니다. 가중치를 두 개의 GPU에 분산함으로써 모델의 더 많은 부분을 HBM에 유지할 수 있었고 오프로드로 인한 성능 저하를 줄일 수 있었습니다. HBM에 전체를 저장하거나 Grace 메모리로의 오프로드가 제한적인 모델이 단일 스테이션에 비교적 잘 맞는 경우에는 PD 분해 방식을 사용했습니다. 여기에는 Engram 조회 테이블이 Grace DRAM에 배치된 DeepSeek V4.1 Flash가 포함됩니다.
기존 데이터와의 비교 가능성을 유지하기 위해 입력 시퀀스 길이(ISL)와 출력 시퀀스 길이(OSL)를 고정한 기존 방식을 그대로 사용했습니다. 동일한 작업 부하 조건에서는 입력 토큰 512개와 출력 토큰 512개를 사용하고, 사전 입력량이 많은 작업 부하 조건에서는 입력 토큰 8,192개와 출력 토큰 1,024개를 사용합니다. 시퀀스 길이는 고정한 상태에서 동시 요청 수를 변화시켰습니다.
각 차트의 단일 스테이션 기준선은 저희 리뷰에 포함된 ASUS ET900N G3이며, 32개 스트림까지 스캔했습니다. 2개 스테이션 테스트는 최대 256개 스트림까지 진행되었습니다. 각 지점은 단일 패스를 나타내므로, 특정 동시 접속 수준에서의 데이터 감소는 데이터 수집으로 간주됩니다.
추론 구성
| 모델 | 클러스터 모드 | 소프트웨어 | 추측적 디코딩 | 그레이스 메모리 |
|---|---|---|---|---|
| DeepSeek V4.1 플래시(FP8) | 사전 입력/디코딩 분해, 스테이션별 전체 사본 | vllm/vllm-openai:deepseekv41-flash-0909 | 모델 본인의 초안 작성자가 5개의 토큰을 고정했습니다. | 각 스테이션에는 Grace 메모리에 고정된 FP8 엔그램 테이블 2개(188.84GiB)와 전문가 가중치 131.97GB가 별도로 저장되어 있습니다. |
| GLM-5.3 NVFP4 | 텐서 병렬(TP2) | NVIDIA vLLM 26.08 NGC 컨테이너(vLLM 0.27.1) | MTP, 고정 5토큰 드래프트 | 클러스터에는 아무것도 없으며, 215GB의 전문가 가중치 데이터가 단일 스테이션으로 오프로드되었습니다. |
| GLM-5.3 플래시 NVFP4 | 사전 입력/디코딩 분해, ASUS 사전 입력, HP 디코딩 | vLLM 0.28.1 RC1 | MTP, 고정 5토큰 드래프트 | 없음 |
| GLM-5.2 NVFP4 | 텐서 병렬(TP2) | NVIDIA vLLM 26.08 NGC 컨테이너(vLLM 0.27.1) | MTP, 고정 3토큰 드래프트 | 클러스터에는 아무것도 없으며, 약 215GB의 전문가 가중치 데이터가 단일 스테이션으로 오프로드되었습니다. |
| 미니맥스-M3 NVFP4 | 텐서 병렬(TP2) | NVIDIA vLLM 26.08 NGC 컨테이너(vLLM 0.27.1) | EAGLE3, 고정 3토큰 드래프트 | 클러스터에는 아무도 없고, 전문가들의 일부가 단일 스테이션에 집중되어 있습니다. |
추론 성능
DeepSeek V4.1 플래시
DeepSeek V4.1 플래시는 분리된 스테이션에서 실행되었으며, 한 스테이션은 프리필을, 다른 스테이션은 디코딩을 담당했습니다. 각 스테이션에는 모델의 전체 복사본이 저장되었는데, 두 개의 FP8 엔그램 테이블(총 188.84GiB)은 Grace 메모리에 고정되어 있었고, 추가로 131.97GB의 전문가 가중치 데이터가 Grace 메모리로 오프로드되었습니다. 따라서 이 구성은 두 장비 모두에서 Grace 메모리가 사용되는 유일한 구성입니다. 또한, ASUS 리뷰에서는 이전 버전인 V4 플래시 체크포인트를 사용했기 때문에 두 버전을 직접 비교할 수 없어 단일 스테이션 라인이 없는 유일한 모델이기도 합니다.
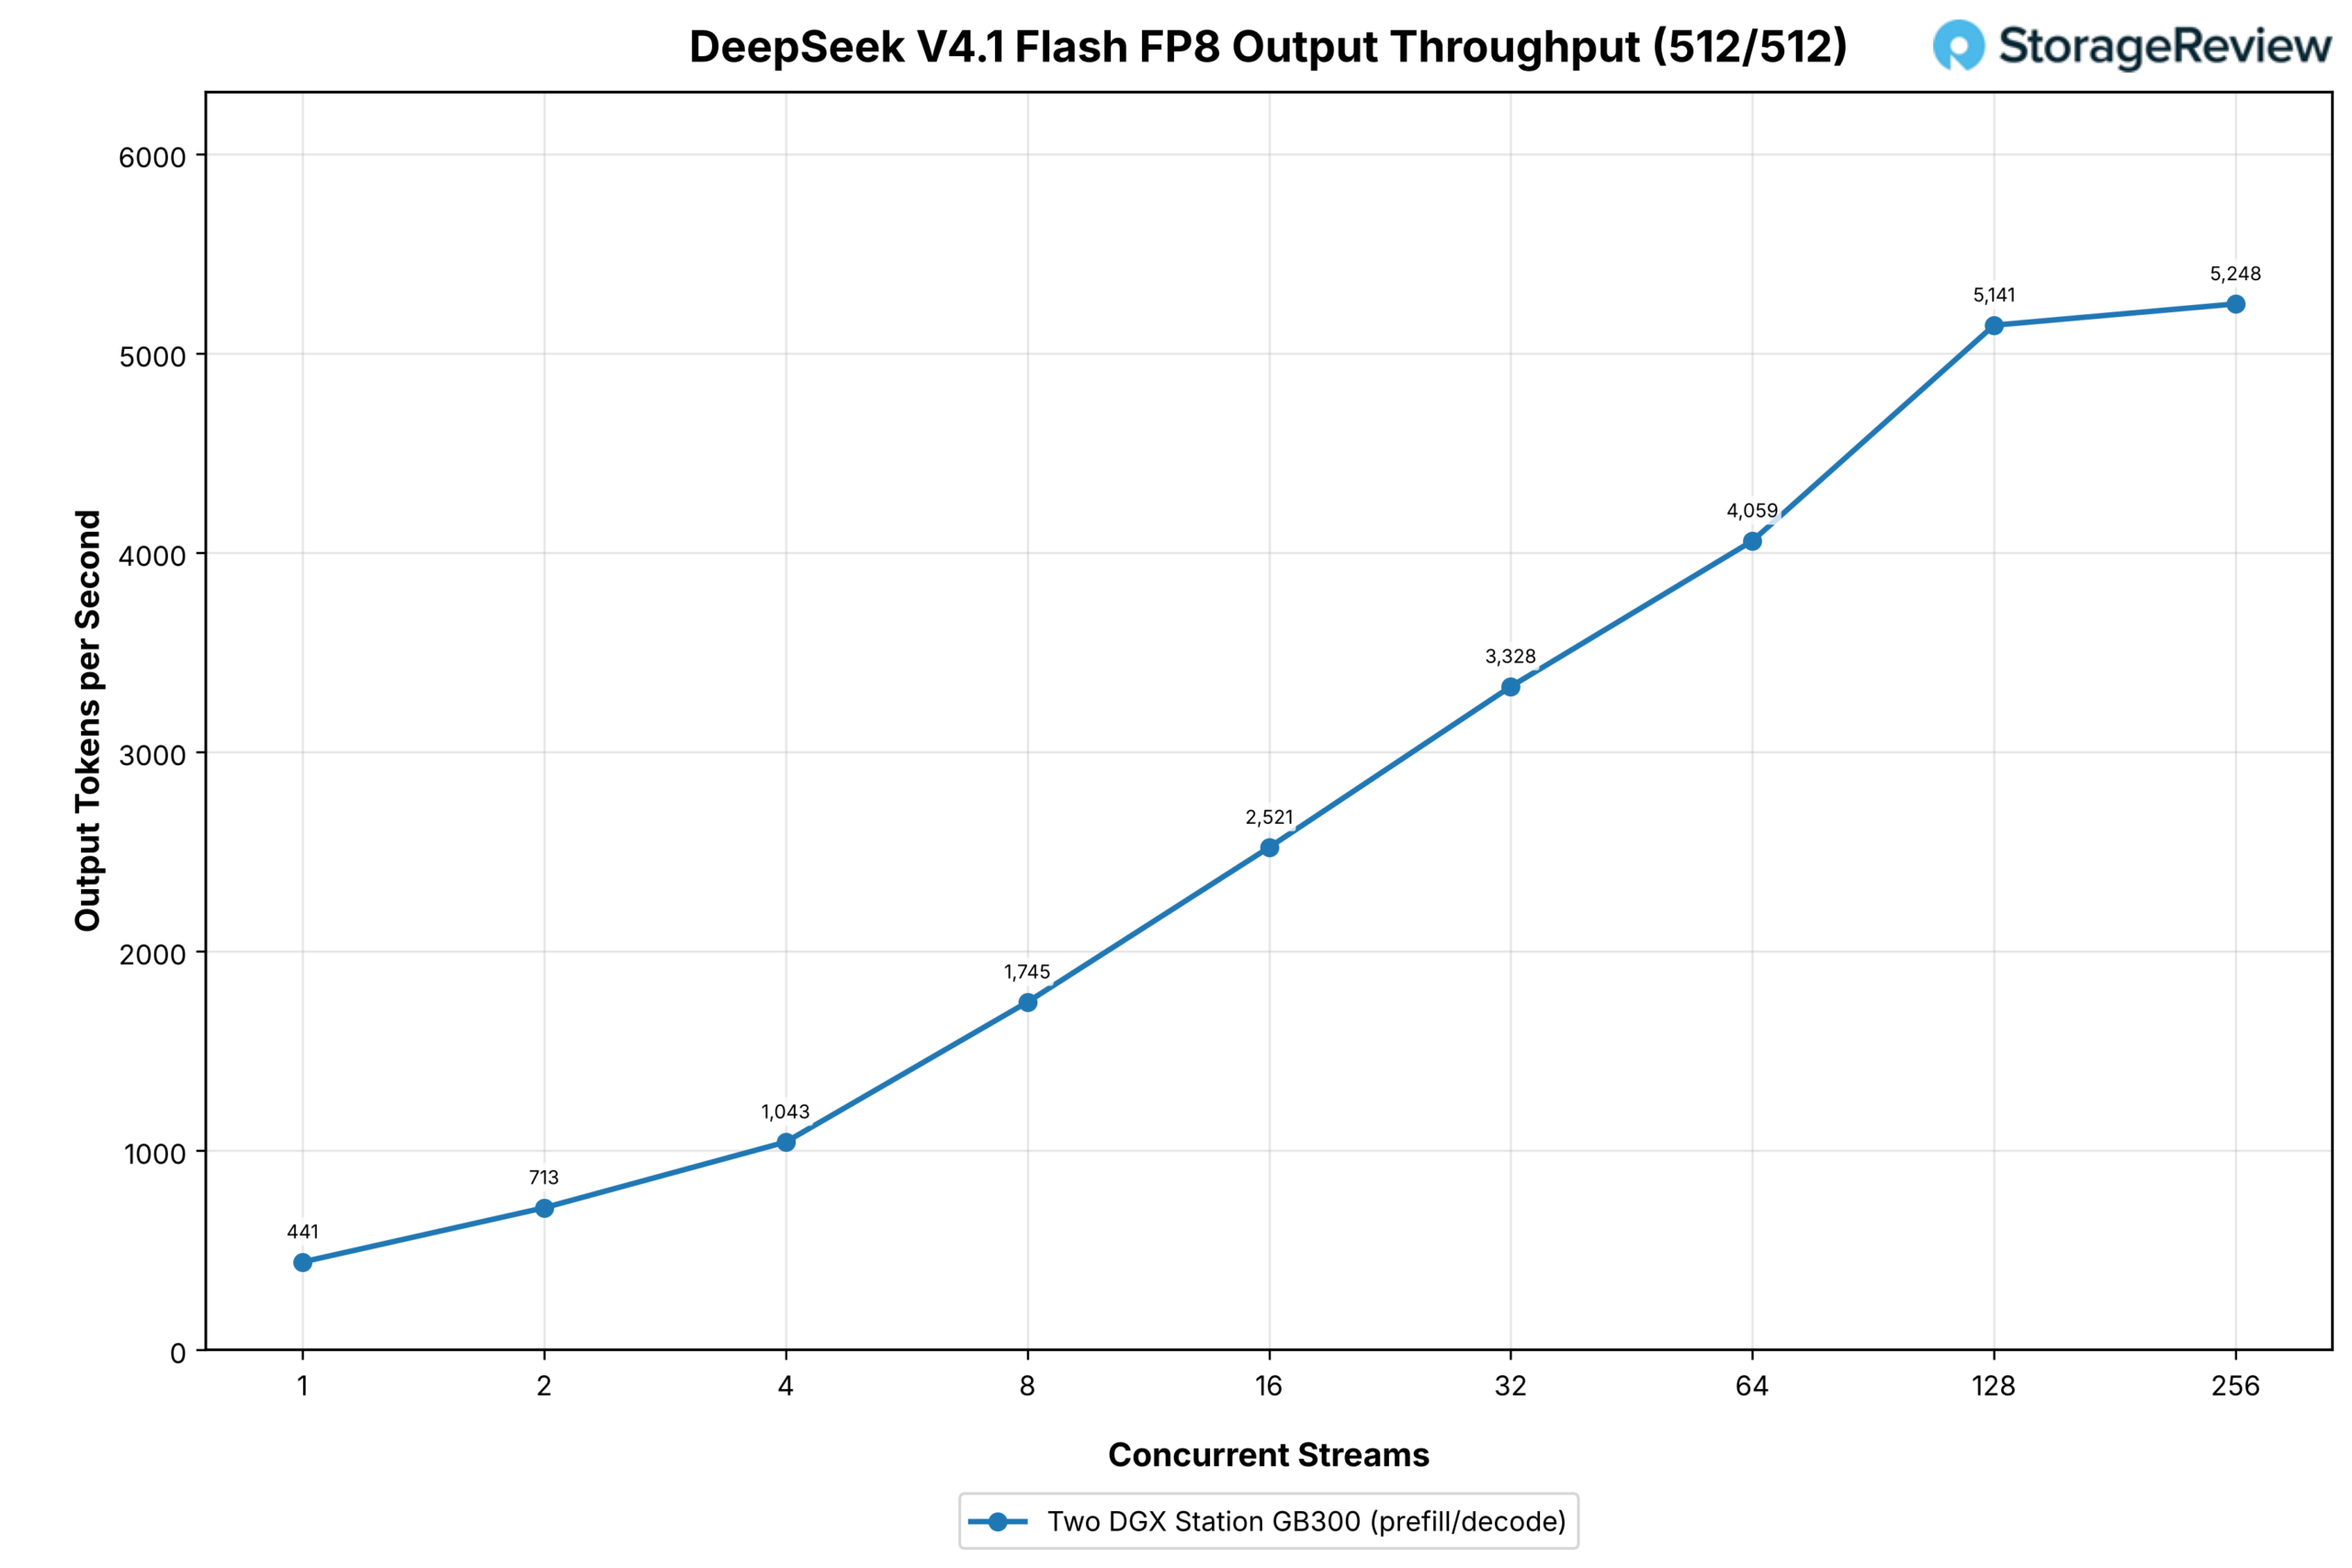
2개의 스테이션으로 구성된 클러스터에서 네이티브 FP8 모델은 단일 스트림에서 초당 441개의 출력 토큰을 처리했으며, 32개 스트림에서는 3,328개, 128개 스트림에서는 5,141개, 256개 스트림에서는 5,248개의 출력 토큰을 처리했습니다. 이는 이번 테스트 세트에 포함된 모든 모델 중 가장 높은 출력 처리량이며, 처리량 곡선은 최고치에서만 완만해졌습니다. 참고로, 저희 리뷰에서 단일 ASUS 스테이션은 V4 플래시 메모리를 32개 스트림에서 초당 1,766개의 출력 토큰으로 처리했습니다.
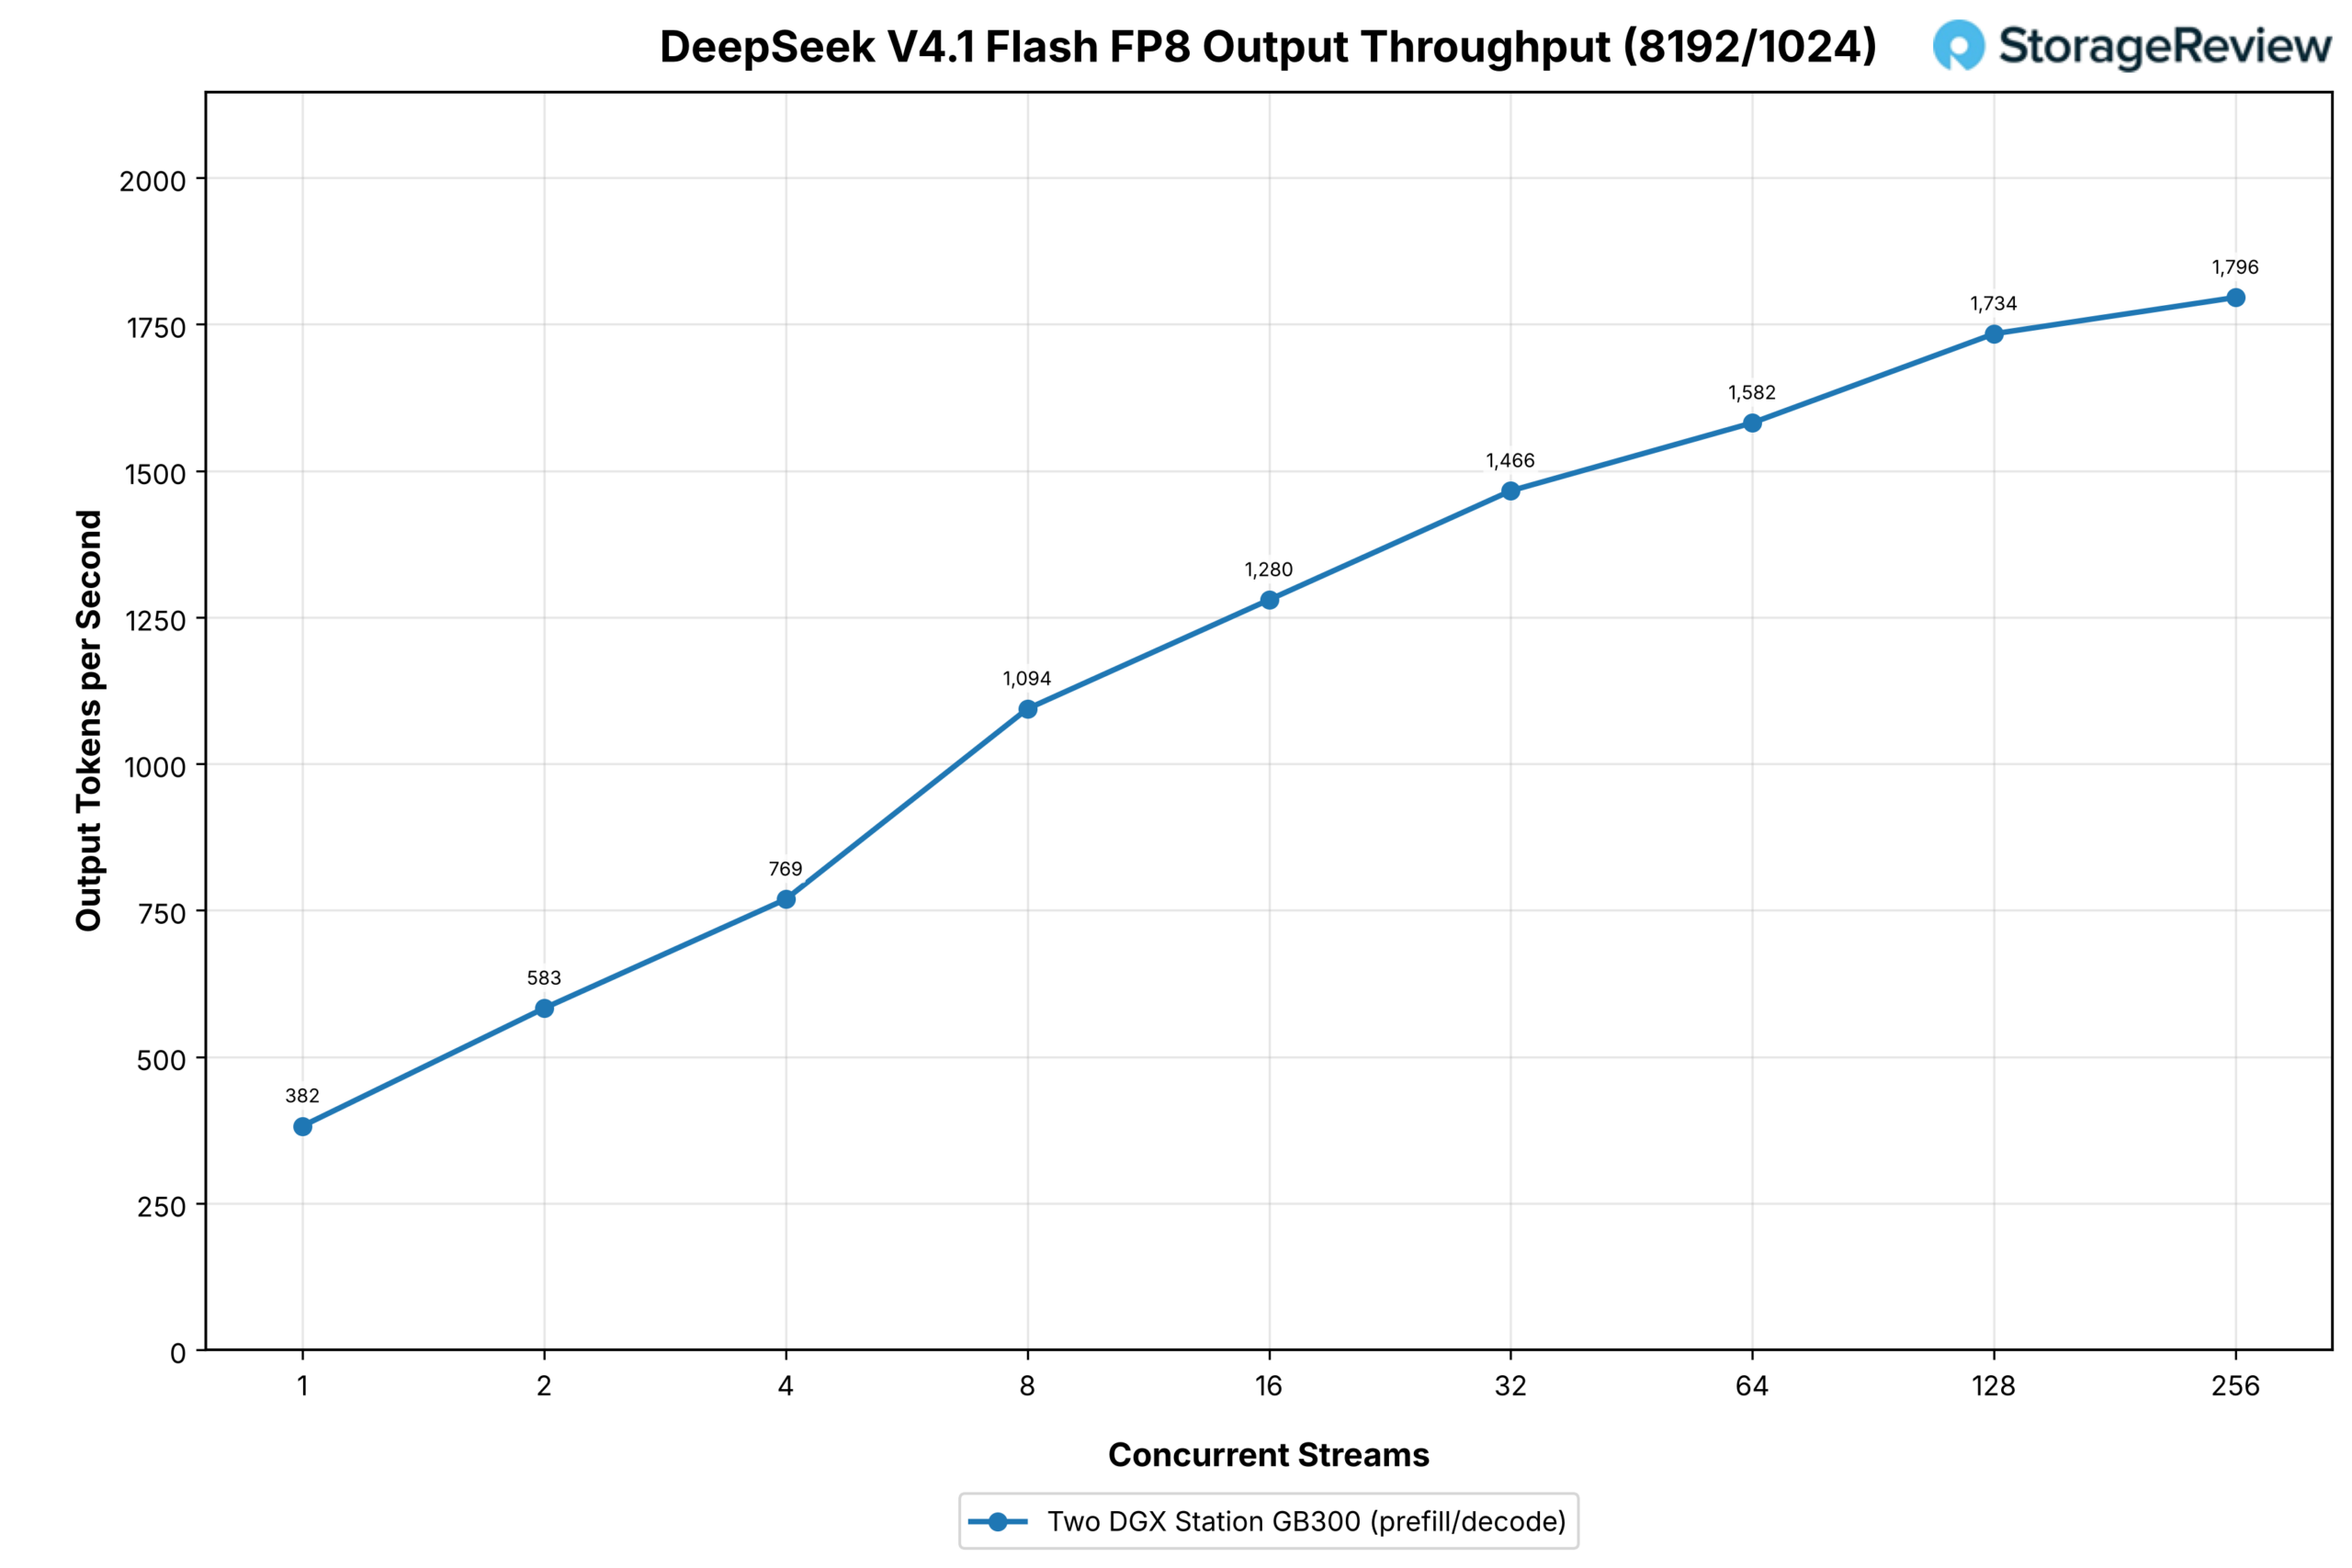
사전 입력량이 많은 프로파일에서 클러스터는 단일 스트림에서 초당 382개의 출력 토큰으로 시작하여 32개 스트림에서는 1,466개, 256개 스트림에서는 1,796개까지 증가했습니다. 각 요청에는 8,192개의 입력 토큰이 포함되므로 전체 처리량은 스윕 최고점에서 초당 16,163개의 토큰에 도달했습니다. 각 스테이션의 Grace 메모리에 엔그램 테이블과 131.97GB의 전문가 가중치가 저장되어 있기 때문에 스윕 전체에 걸쳐 곡선이 매끄럽게 유지됩니다.
GLM-5.3
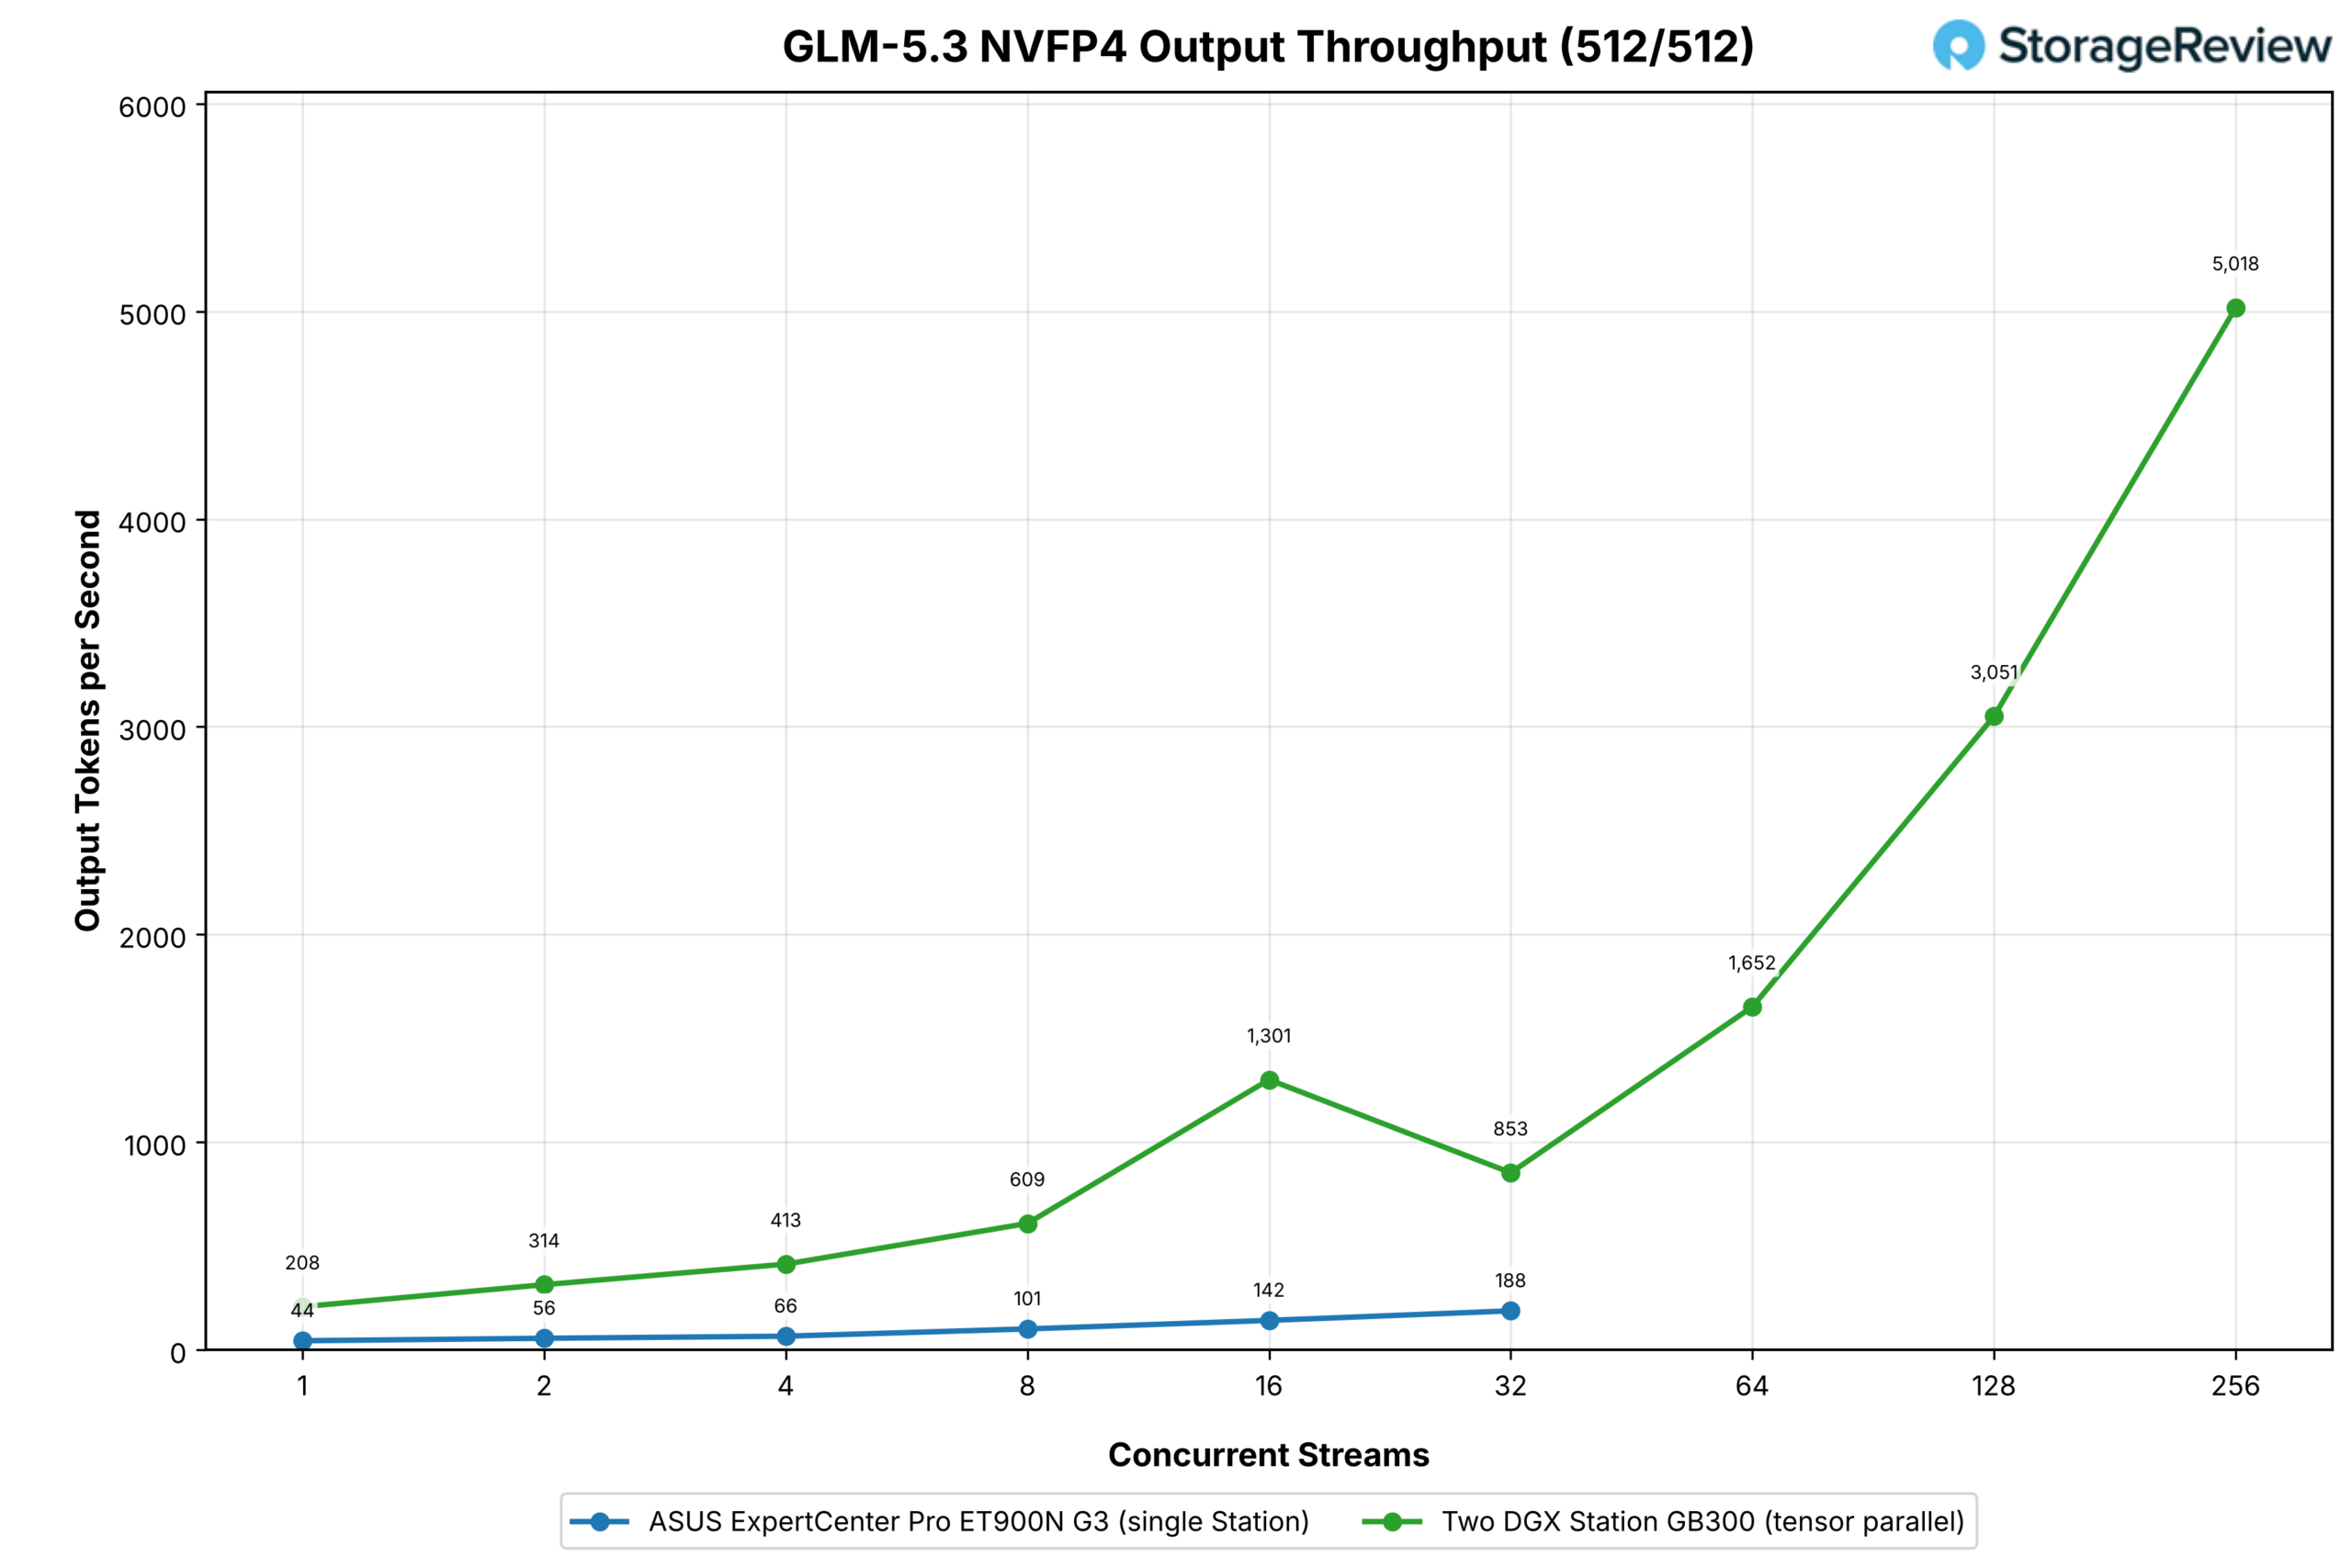
GLM-5.3은 Grace 오프로드 없이 TP2에서 실행되었습니다. 단일 스테이션에서 215GB의 전문가 가중치를 Grace 메모리로 오프로드했으며, 클러스터 결과는 대부분의 스윕 동안 GLM-5.2와 유사한 흐름을 보이다가 이후부터는 불안정해졌습니다. 동일한 작업 부하에서 한 스테이션은 단일 스트림에서 초당 44개의 출력 토큰에서 32개의 스트림에서 188개의 출력 토큰까지 처리했습니다.
두 개의 스테이션으로 구성된 클러스터는 단일 스트림에서 208개, 16개 스트림에서 1,301개로 증가했는데, 이는 단일 타워 대비 4.7배에서 9.2배에 해당하는 수치입니다. 이후 32개 스트림에서는 853개로 감소했다가 다시 증가하여 64개 스트림에서 1,652개, 128개 스트림에서 3,051개, 그리고 256개 스트림에서 5,018개에 도달했습니다. 32개 스트림 지점은 수집된 데이터에 나타난 값입니다. 배치 처리 결정과 커널 선택은 동시 처리량이 증가함에 따라 모두 변경되며, 텐서 병렬 배포는 각 계층마다 다음 단계로 넘어가기 전에 완료해야 하는 집합 연산을 추가하므로 그래프가 직선은 아니지만, 256개 스트림에서의 최대치는 단일 스테이션이 32개 스트림에서 도달한 값의 27배에 해당합니다.
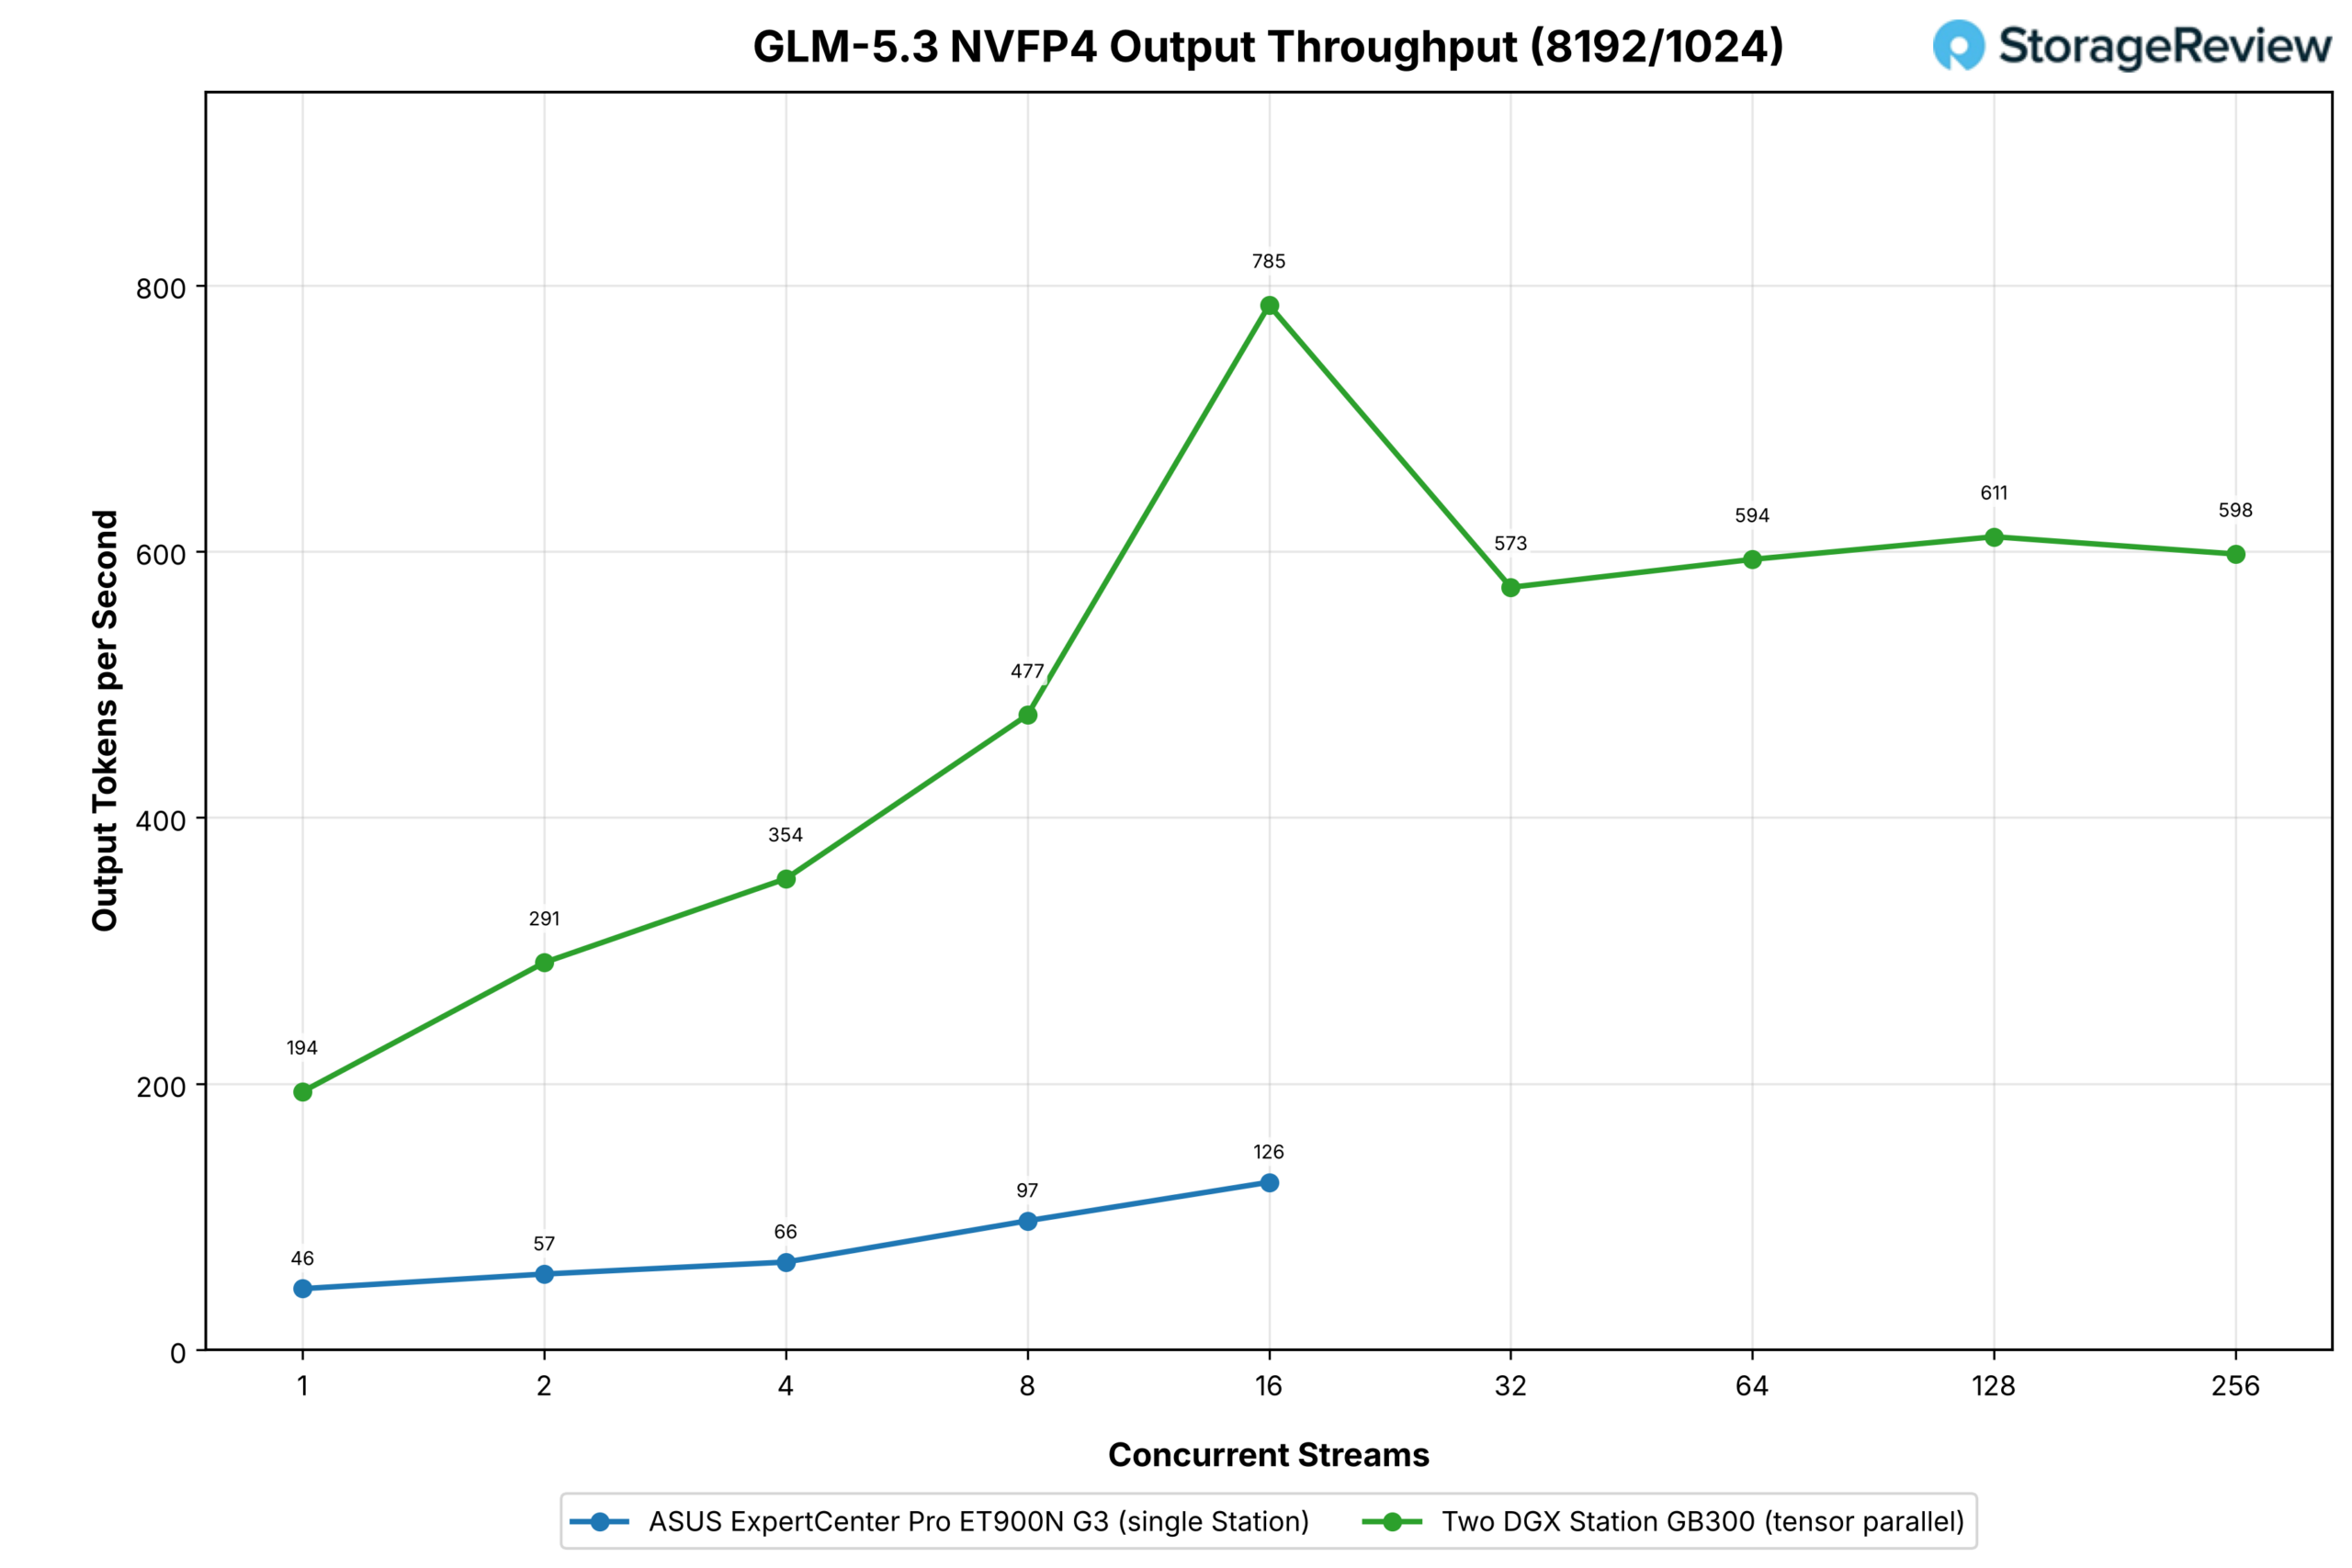
사전 입력량이 많은 프로파일에서 단일 스테이션은 설계상 16개 스트림에서 멈췄습니다. 오프로드 모델은 초기에 성능이 저하되고, 동시성을 더 높여도 얻을 수 있는 이점이 거의 없기 때문입니다. 단일 스테이션은 스트림이 하나일 때 초당 46개의 출력 토큰을 처리했지만, 16개 스트림에서는 126개로 증가했습니다. 클러스터는 같은 범위에서 초당 194개에서 785개로 증가하여 최고치에서는 6.2배 증가했고, 32개 스트림에서 256개 스트림까지는 573개에서 611개 사이에서 안정화되었습니다. 이는 장시간 프롬프트 처리 시에도 초당 약 600개의 출력 토큰이라는 최대치를 기록하며, 단일 스테이션의 최고 성능보다 약 5배 높은 수치입니다.
GLM-5.3 플래시
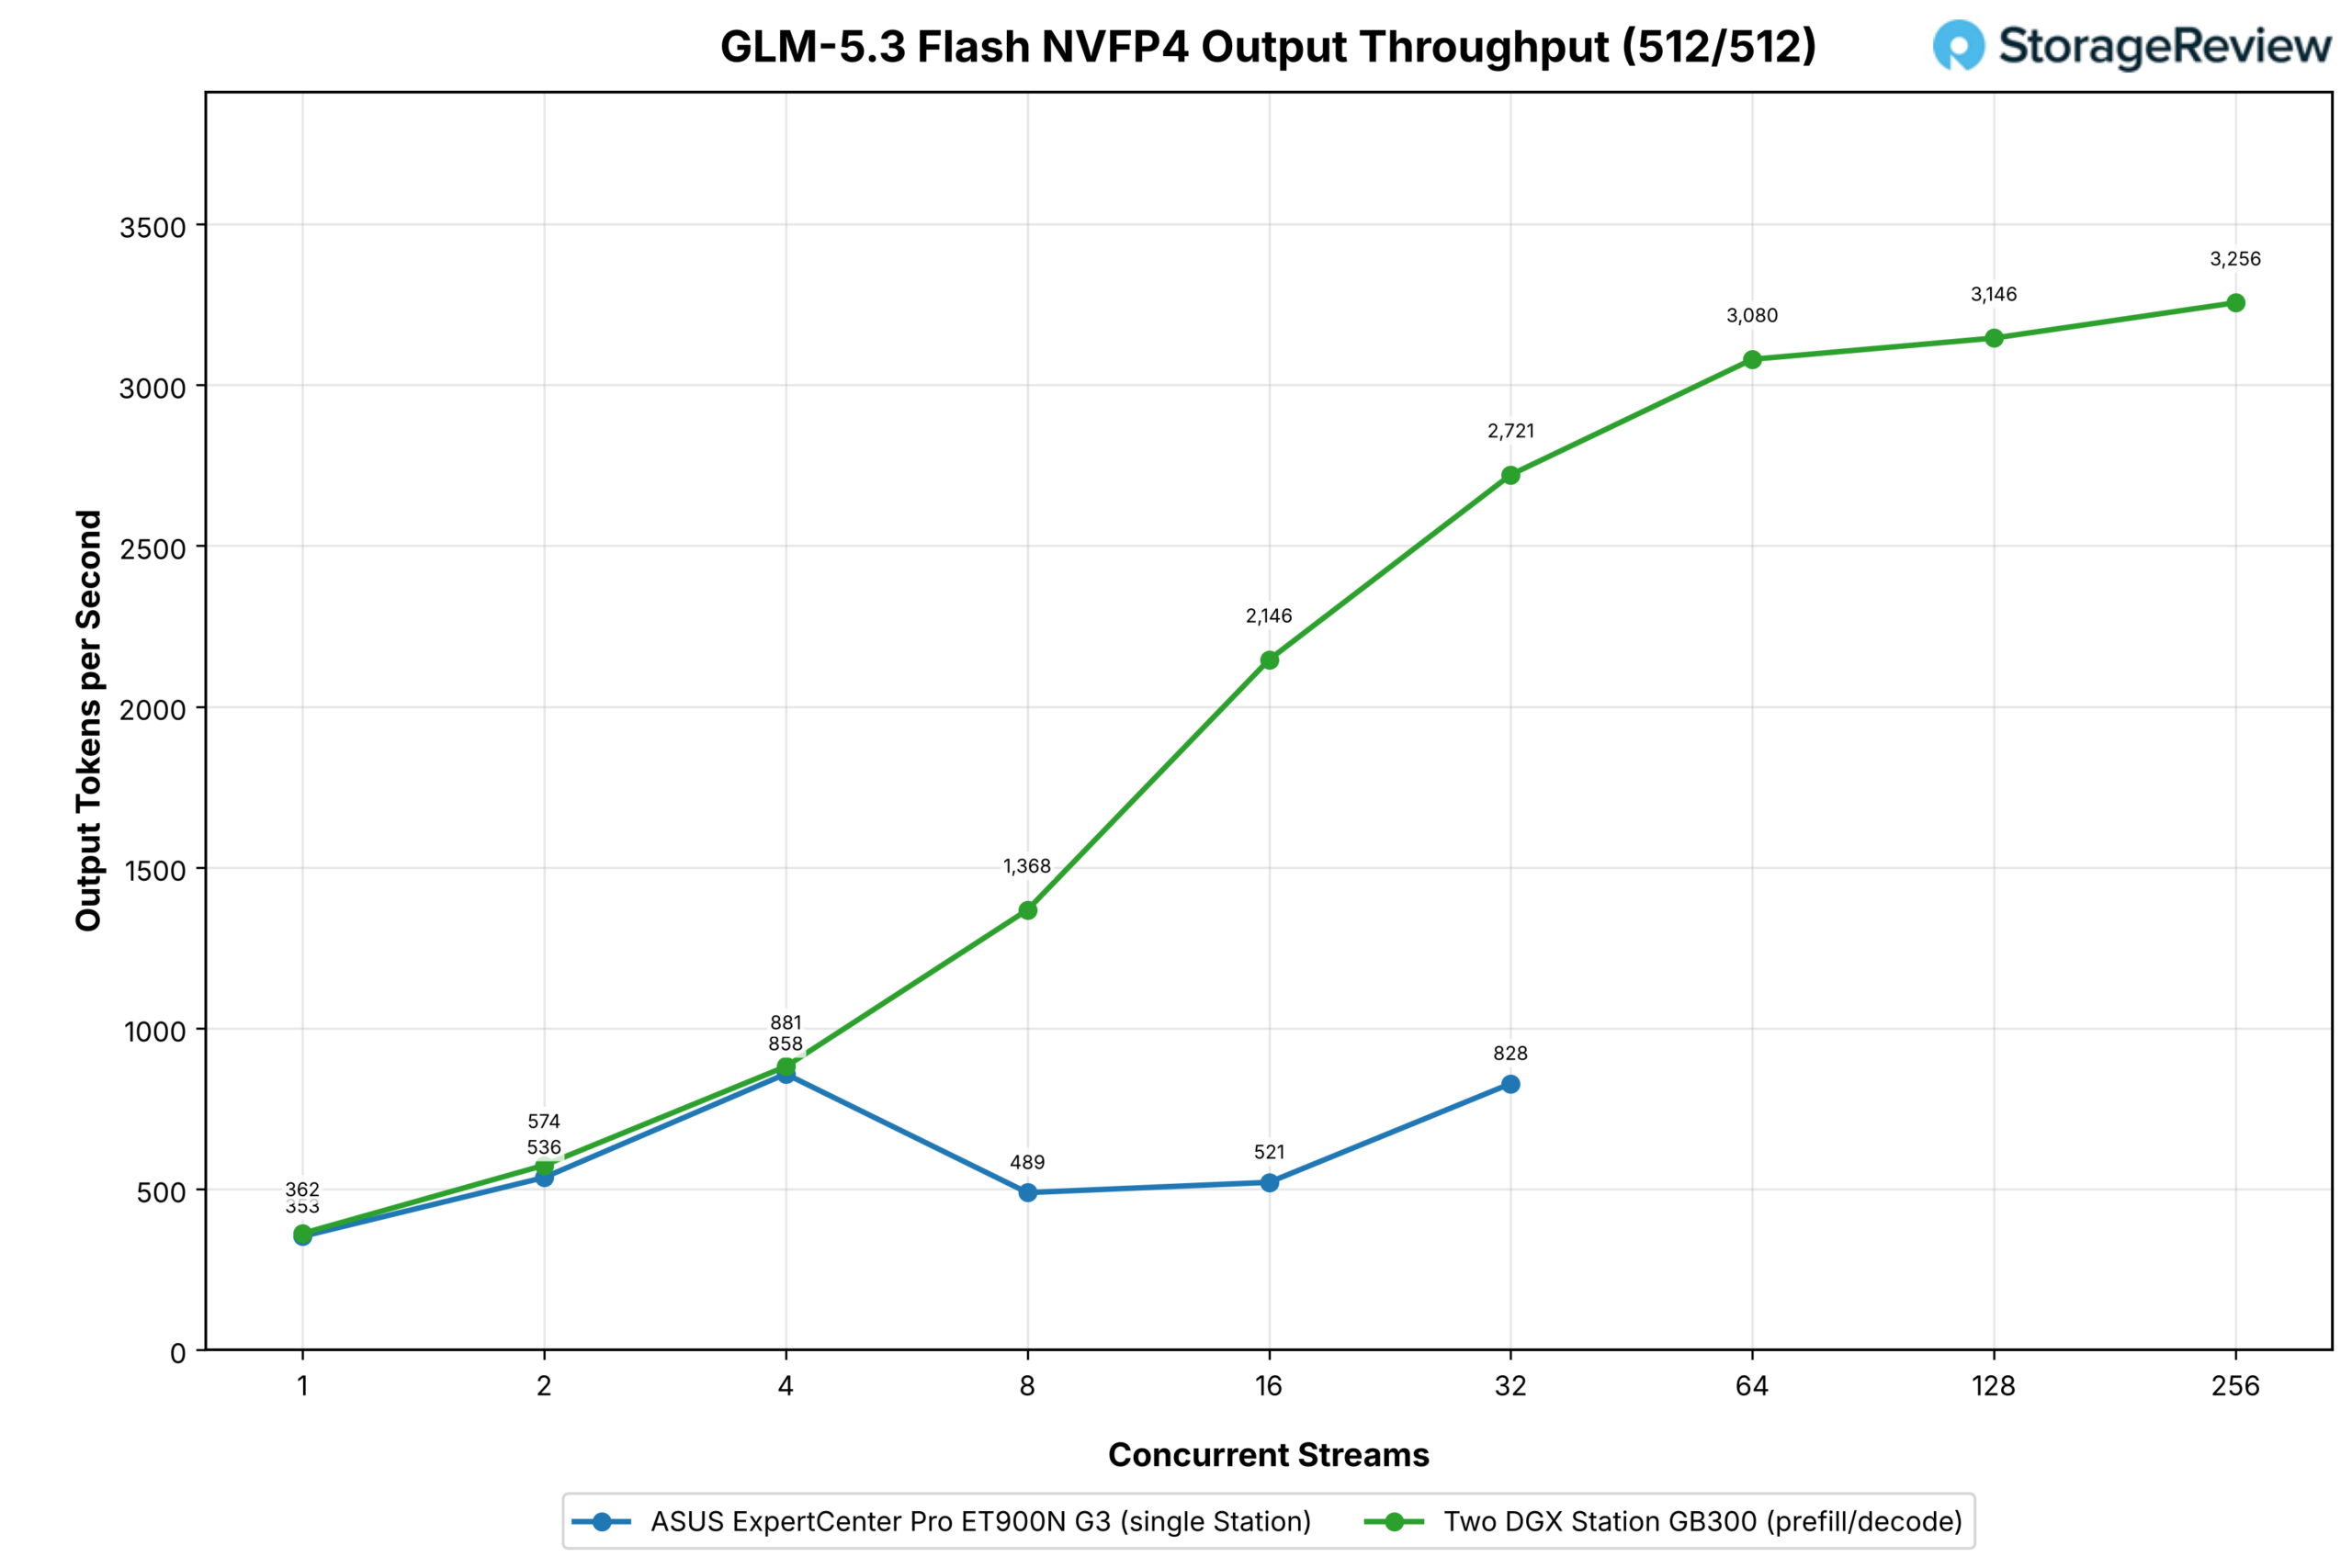
GLM-5.3 플래시는 각 스테이션에 전체 복사본을 저장할 수 있을 만큼 크기가 작아서 ASUS가 프리필을 처리하고 HP가 디코딩을 처리하는 분산 방식으로 작동했습니다. 플래시는 활성 파라미터 수가 적어 단일 스테이션에서도 이미 빠른 속도로 작동합니다. 동일한 작업 부하에서 스트림 하나당 초당 353개의 출력 토큰을 처리하고, 스트림 32개일 때는 828개를 처리하며, 중간값(스트림 4개일 때 858개, 8개일 때 489개)에서도 일정한 속도를 보였지만, 이 또한 수집된 것으로 보고합니다.
분리된 쌍에서 동일한 작업 부하는 단일 스트림에서 초당 362개의 출력 토큰에서 32개 스트림에서 2,721개(단일 타워의 3.3배)로 증가했으며, 256개 스트림에서는 3,256개까지 증가했습니다.
스트림이 하나 또는 두 개인 경우, 두 스테이션의 성능은 단일 스테이션과 거의 정확히 일치하는데, 이는 디코딩 스테이션이 단독으로 동일한 작업을 수행할 때 예상되는 결과입니다. 성능 향상은 프리필 스테이션이 계속 바쁘게 작동하고 디코딩 스테이션이 프리필을 위해 일시 중지하지 않고도 이점을 누릴 수 있을 만큼 충분한 요청이 있을 때 나타납니다.
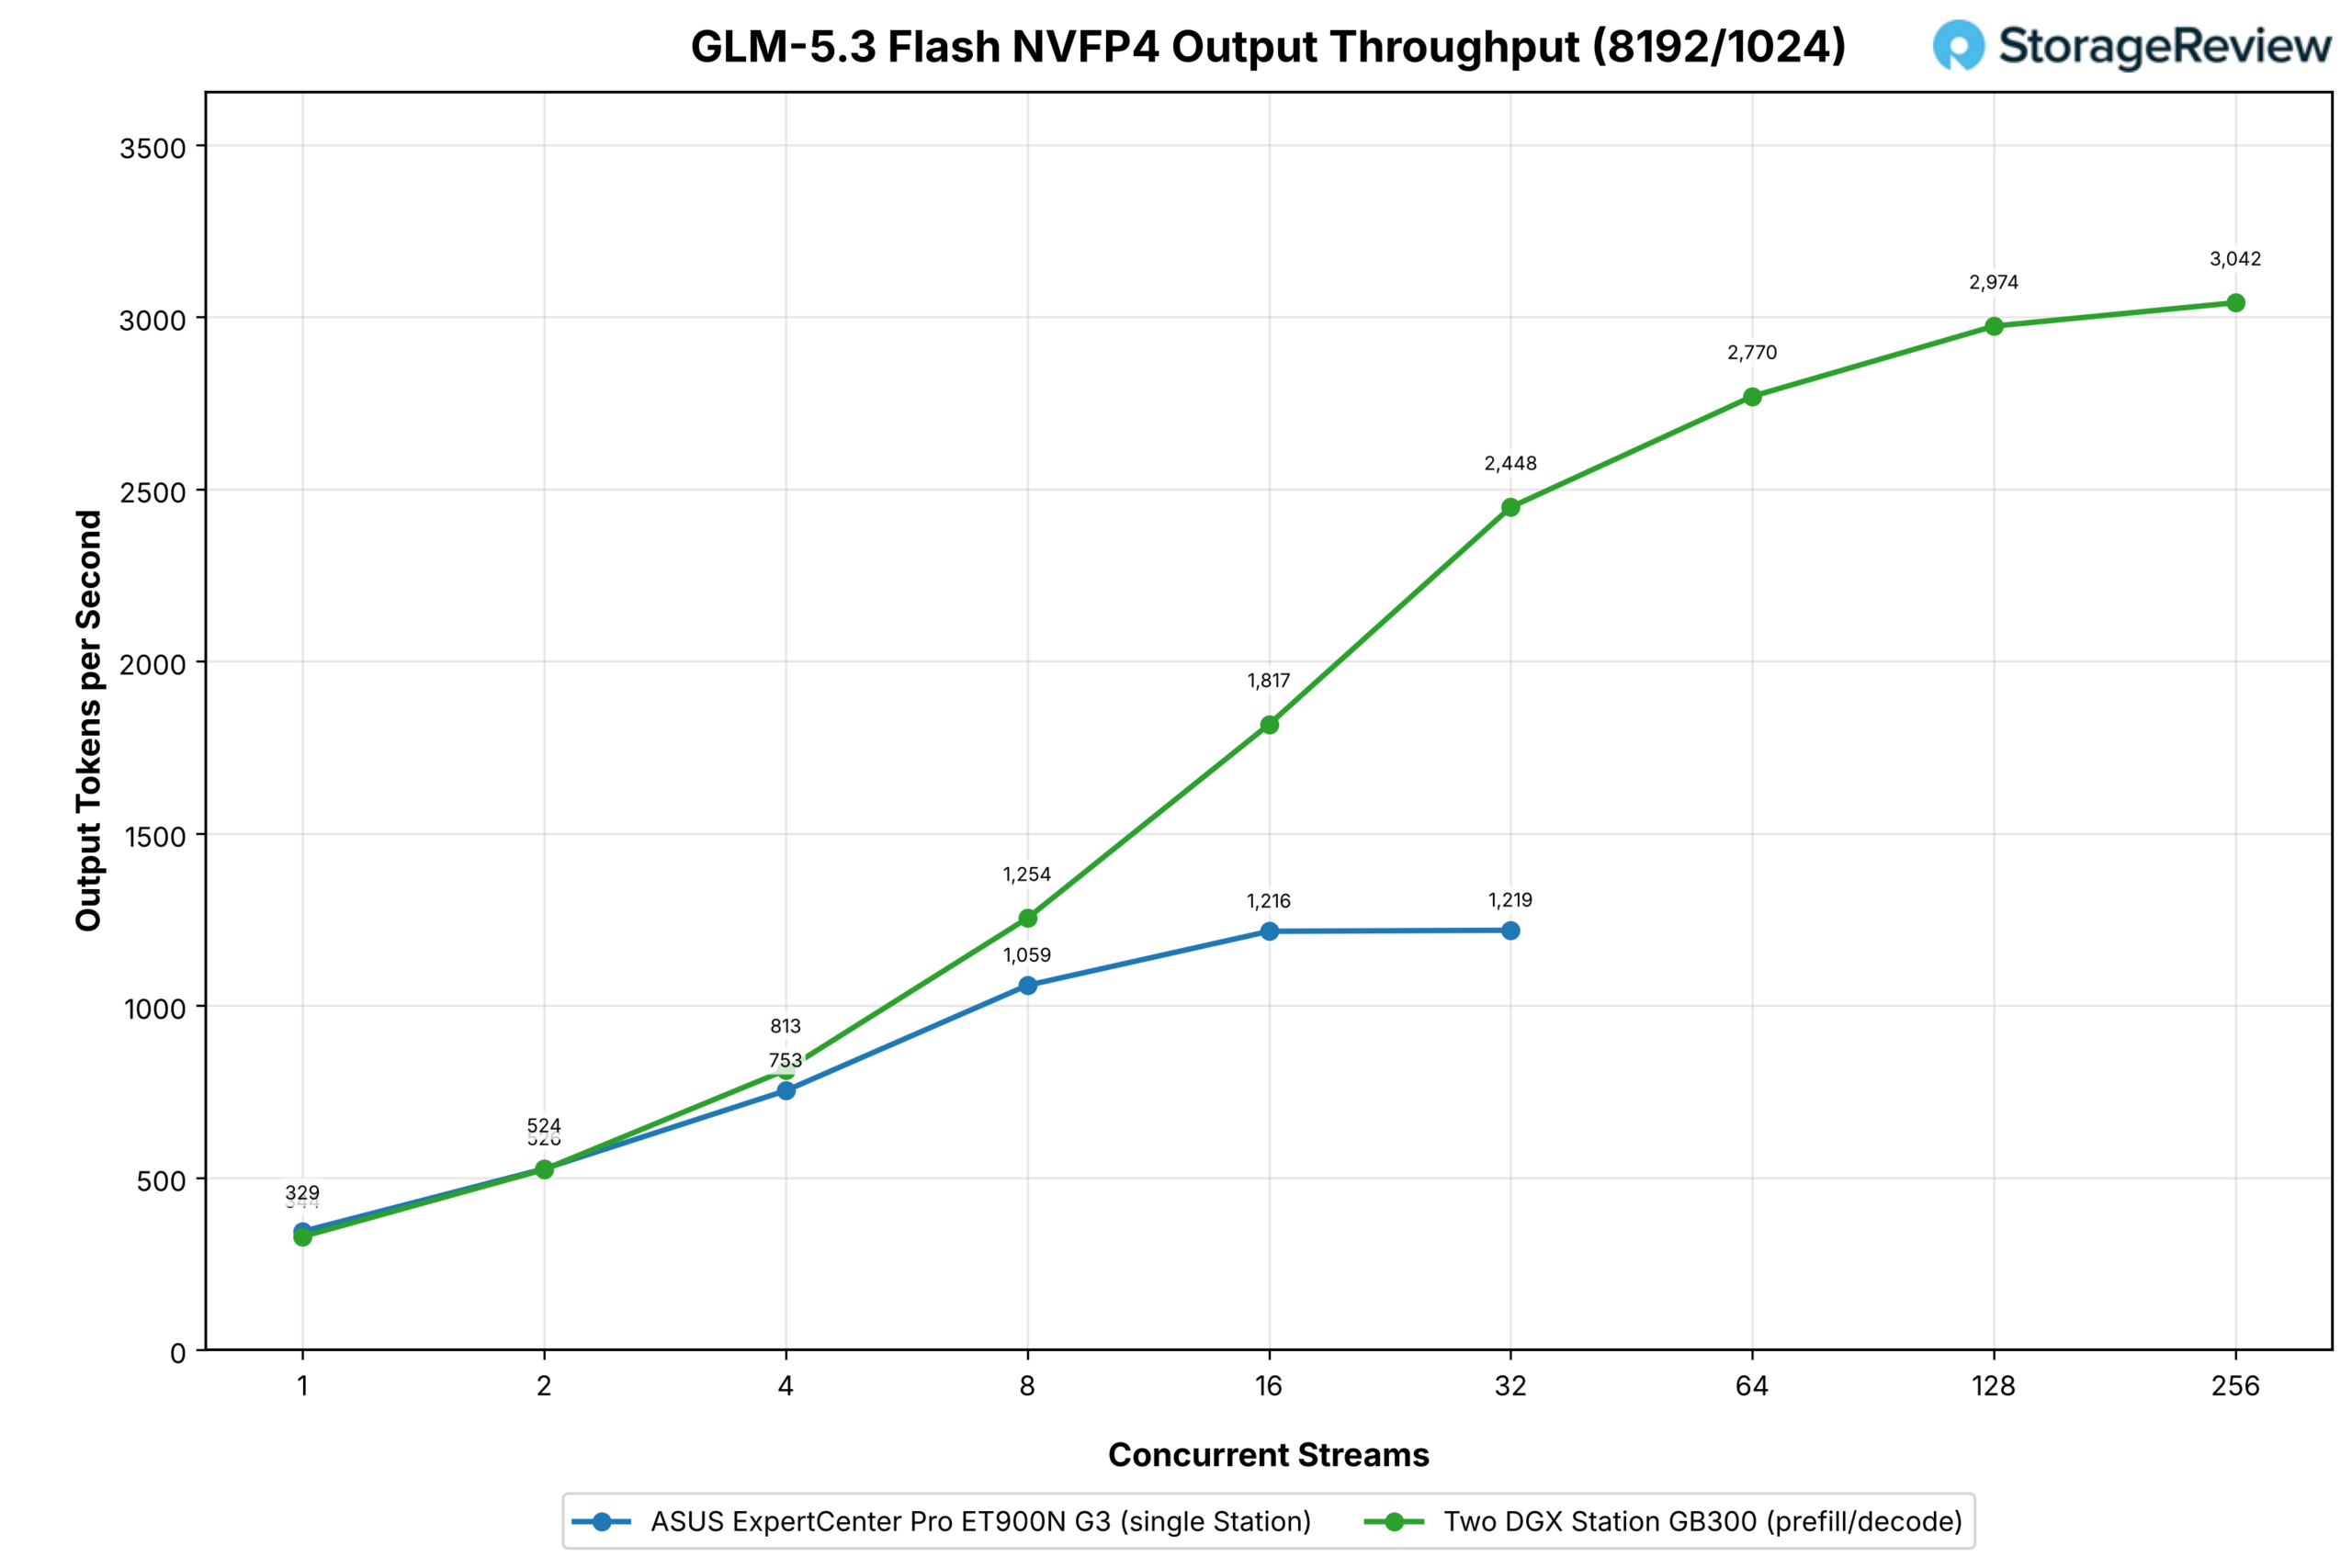
프리필 작업이 많은 프로파일에서 단일 스테이션은 스트림 하나에서 초당 344개의 출력 토큰을 처리하다가 16개 스트림에서는 1,216개로 증가했고, 32개 스트림에서는 1,219개를 유지하다가 16개 스트림 이후로는 일정한 수준을 보였습니다. 프리필/디코딩 쌍은 스트림 하나에서 329개에서 32개 스트림에서는 2,448개로 계속 증가하여, 단일 스테이션의 두 배에 달하는 수치를 기록했고, 256개 스트림에서는 3,042개까지 증가했습니다. 이러한 분할 구성은 긴 프롬프트 처리에 최적화되어 있는데, 프리필 스테이션이 8,192개의 토큰으로 구성된 프롬프트를 처리하는 동안 디코딩 스테이션은 KV 캐시와 연산 능력을 활용하여 지속적으로 토큰을 생성하기 때문입니다.
GLM-5.2
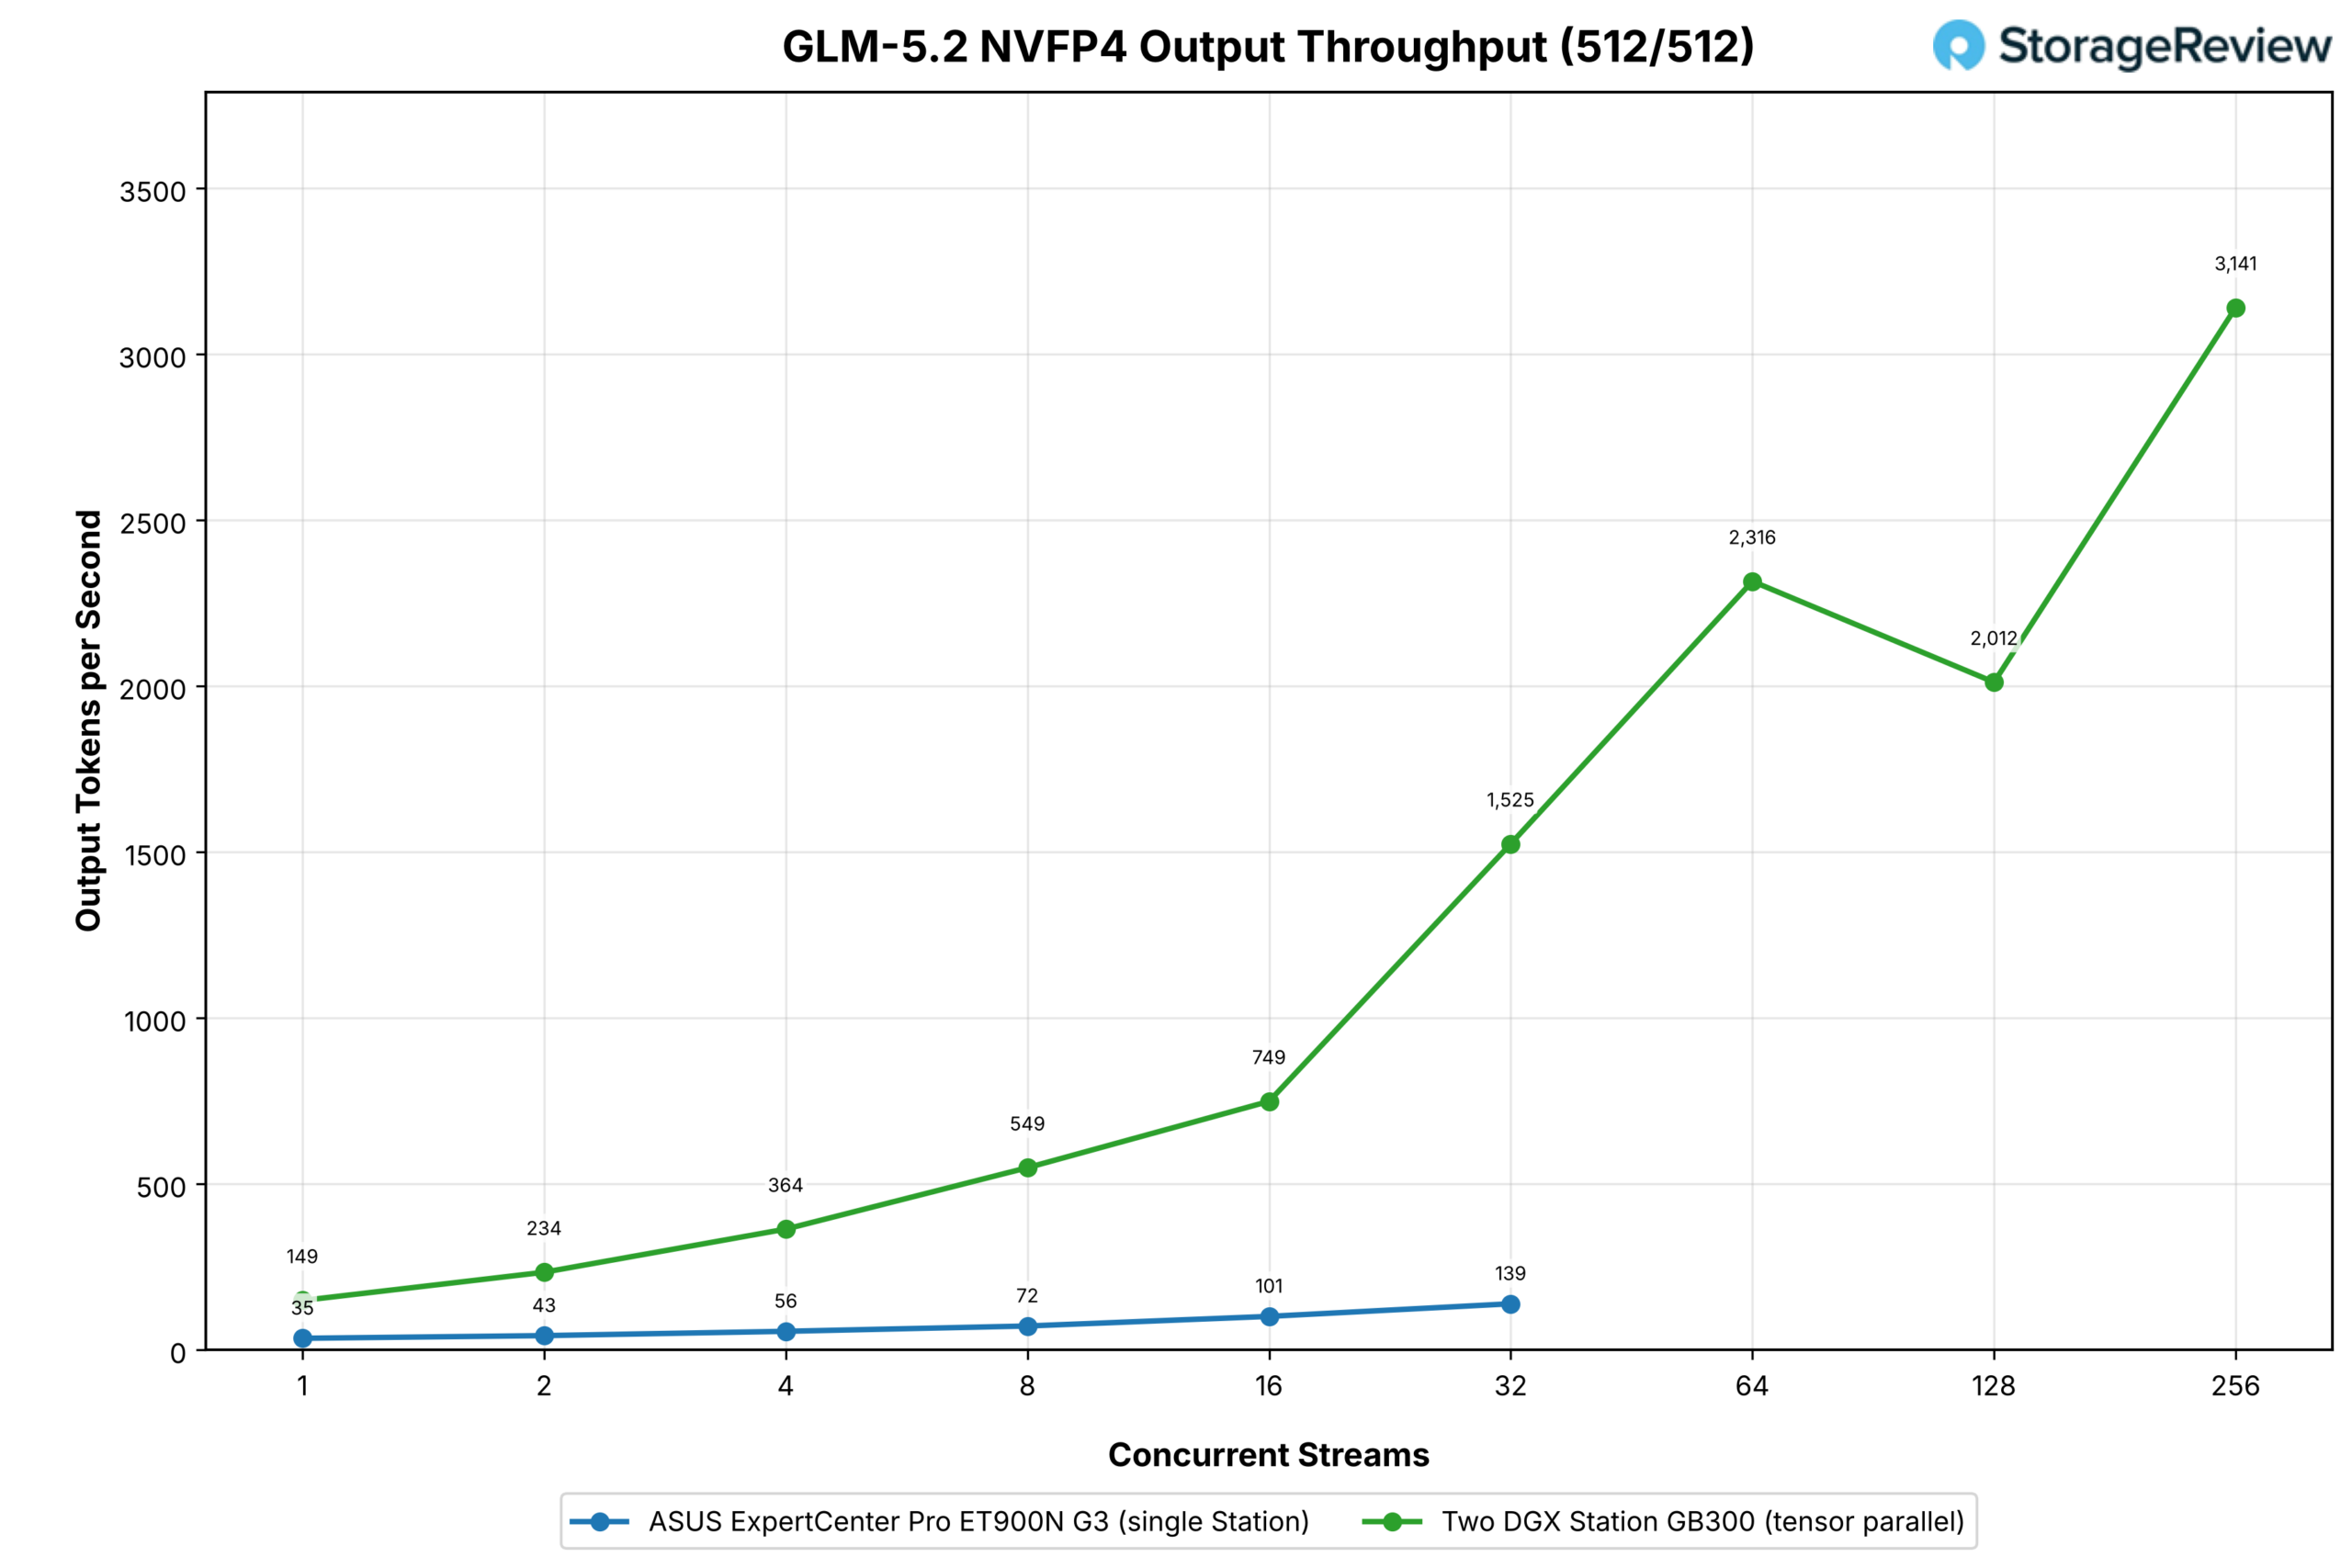
GLM-5.2는 클러스터에서 Grace 오프로드 없이 TP2에서 실행되었으며, 두 번째 스테이션의 필요성을 가장 강력하게 뒷받침하는 모델입니다. NVFP4 체크포인트는 약 433GB이므로, 하나의 GB300에는 약 215GB의 전문가 가중치가 Grace 메모리에 저장되고, 이를 사용하는 모든 디코딩 단계는 NVLink-C2C를 통해 396GB/s의 속도로 LPDDR5X에 전송됩니다. 두 개의 스테이션으로 분산될 경우, 각 B300에는 모델의 절반 정도가 HBM3e에 저장됩니다.
동일한 작업 부하에서 단일 ET900N G3는 단일 스트림에서 초당 35개의 출력 토큰을, 32개 스트림에서 139개를 처리했습니다. 두 대의 스테이션으로 구성된 클러스터는 단일 스트림에서 초당 149개의 토큰으로 시작하여 단일 스테이션보다 4.3배 빠른 속도를 보였고, 32개 스트림에서는 1,525개(11배)에 도달했으며, 64개 스트림에서는 2,316개, 256개 스트림에서는 3,141개까지 단일 스테이션의 처리 속도를 뛰어넘었고, 128개 스트림에서는 2,012개로 잠시 감소했습니다. 소수의 사용자를 위해 대화 속도로 서비스를 제공하는 단일 스테이션 모델이 두 대의 스테이션을 통해 부서 전체에 서비스를 제공할 수 있는 모델로 확장된 것입니다.
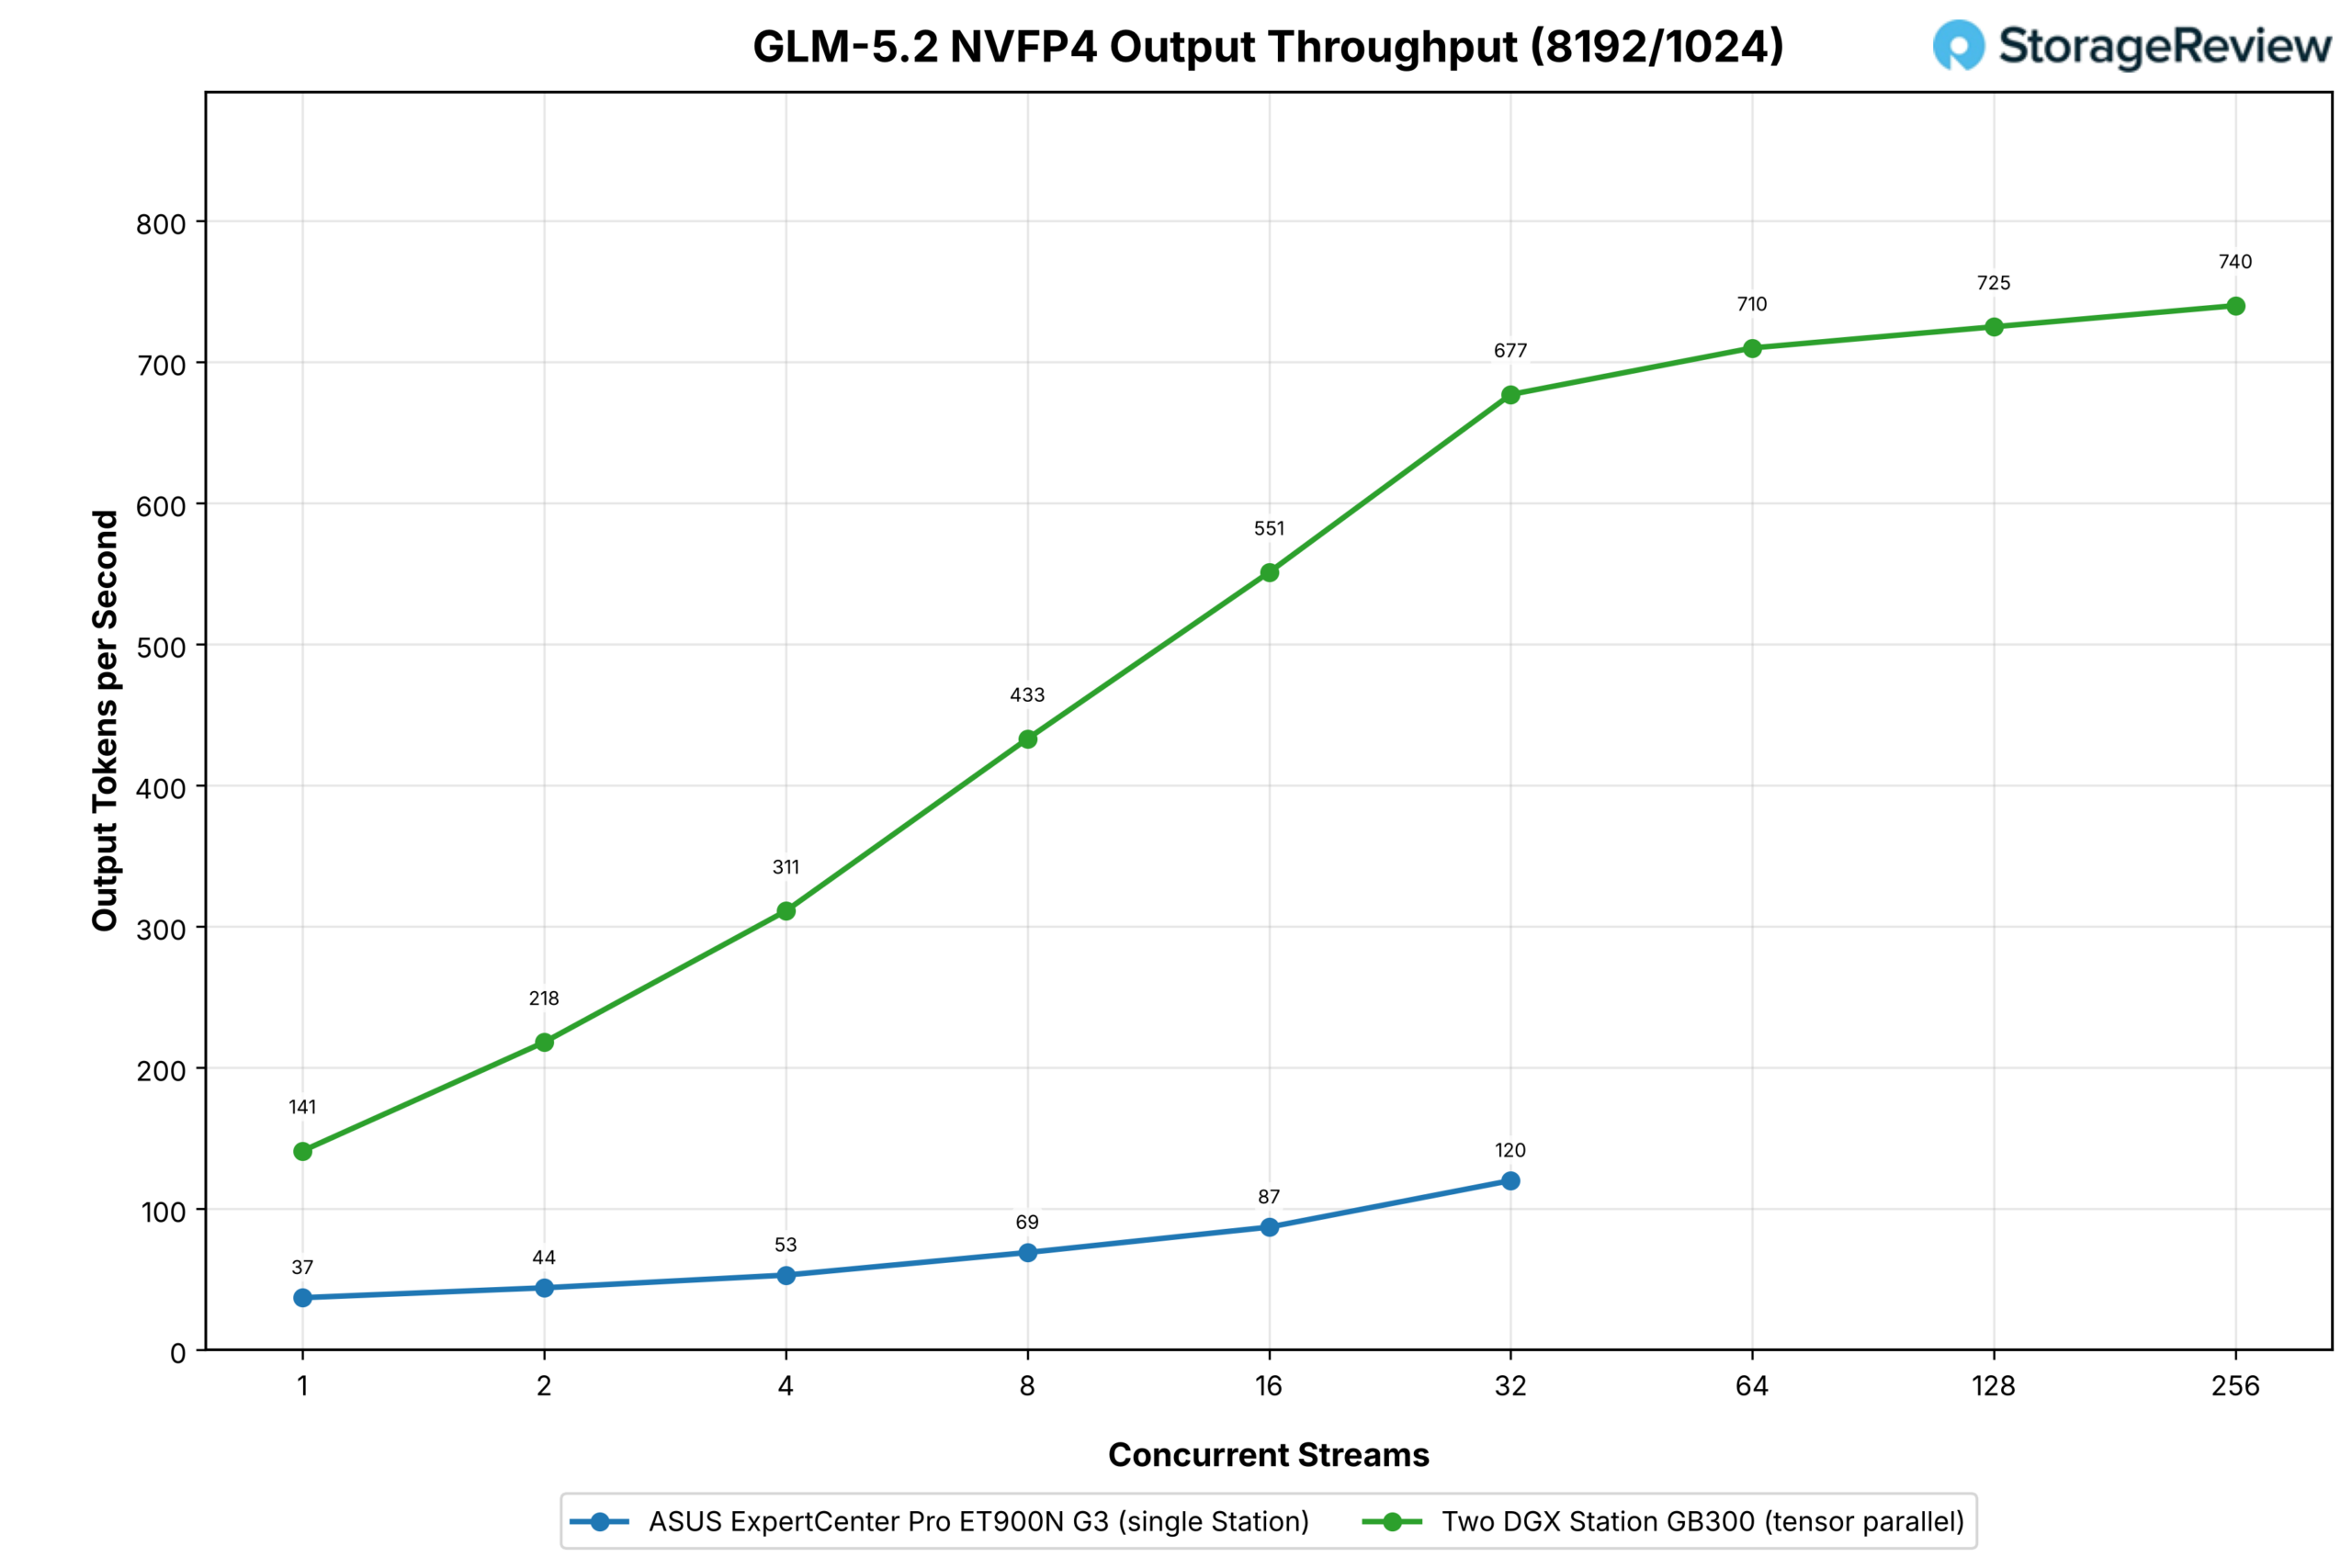
사전 채우기가 많은 프로필은 더 낮은 높이에서 동일한 이야기를 보여줍니다. 한 스테이션은 한 스트림에서 초당 37개의 출력 토큰에서 32개 스트림에서 120개로 이동하고, 클러스터는 동일한 범위에서 141개에서 677개로 이동하며, 스윕 하단에서 3.8배, 상단에서 5.6배 증가한 후 256개 스트림을 거쳐 710, 725, 740에서 평탄해집니다.
긴 프롬프트는 사전 채우기 작업에 더 많은 시간을 소모하게 되는데, 두 구성 모두 연산 집약적이므로 두 번째 스테이션이 제거하는 오프로드 페널티가 짧은 프롬프트에서보다 전체에서 차지하는 비중이 더 작습니다. 두 프로파일 모두에서 성능 향상이 2배를 훨씬 넘는 이유는 두 번째 스테이션이 433GB 모델을 LPDDR5X에서 HBM으로 모두 교체하기 때문이며, 이는 두 번째 B300의 연산 능력보다 더 중요한 요소입니다.
미니맥스-M3
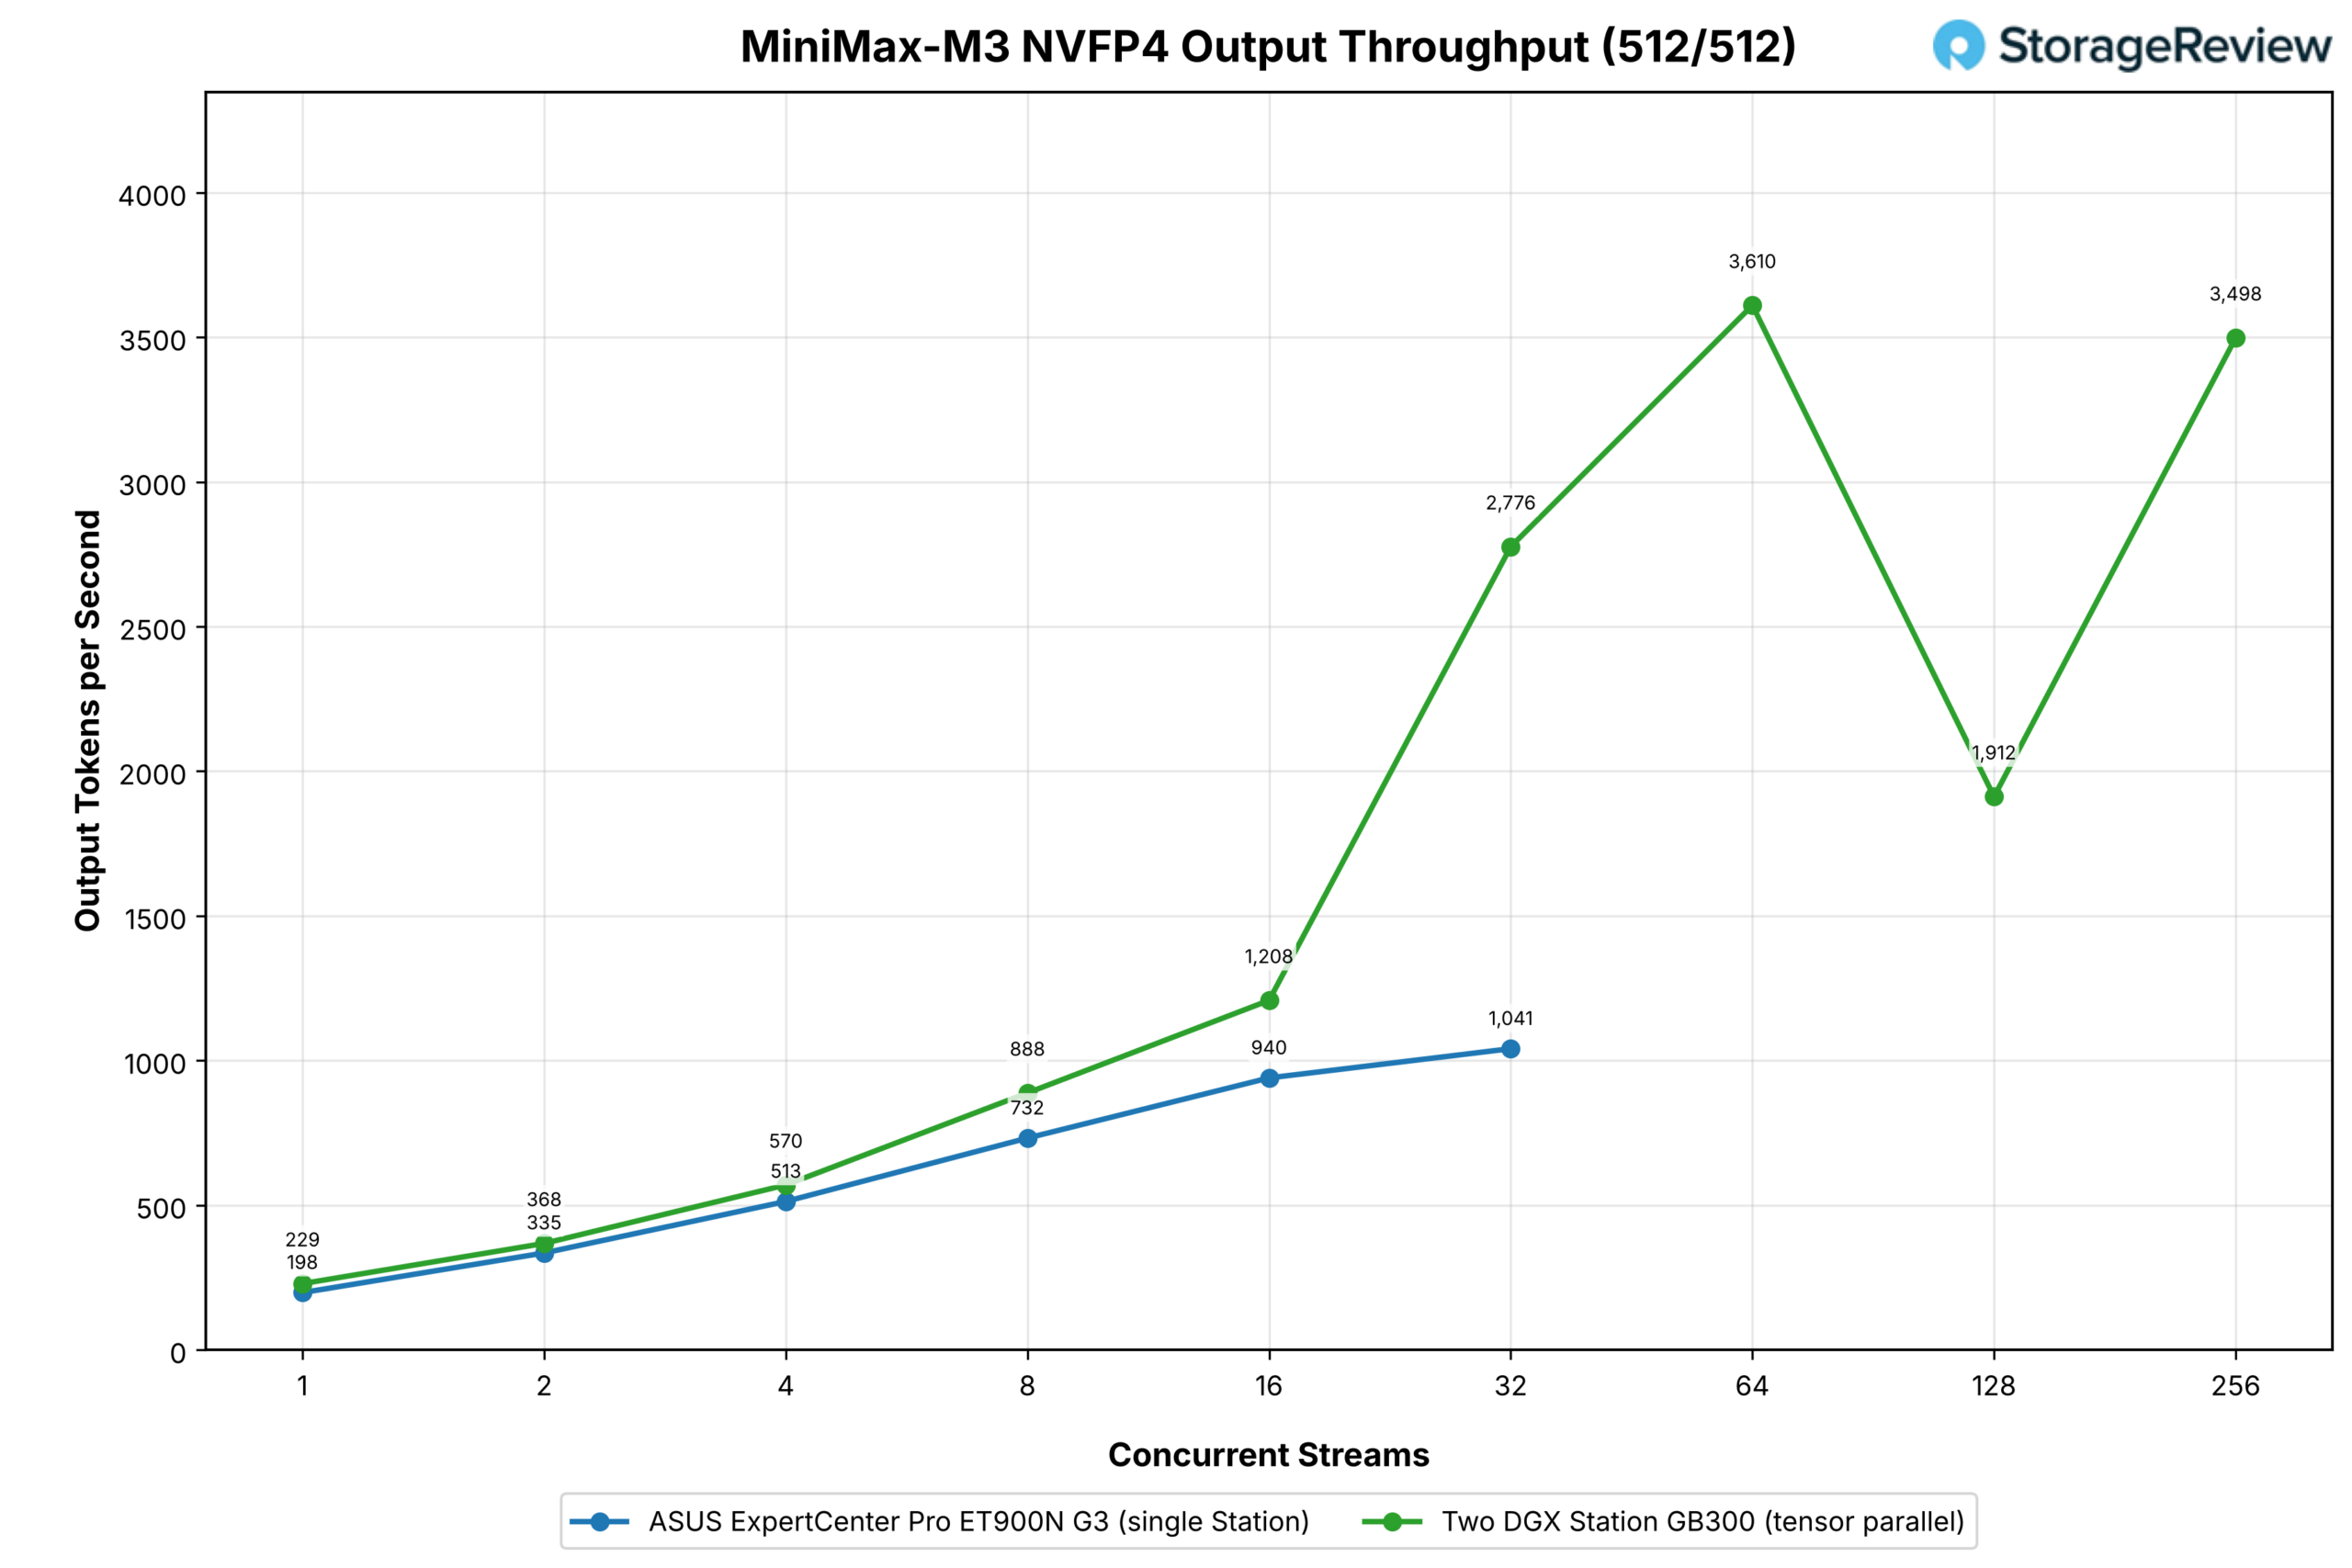
MiniMax-M3는 Grace 오프로드 없이 TP2에서 작동했습니다. 한 스테이션에서는 HBM 경계에 위치하며, 일부 전문가가 Grace 메모리에 참여했습니다. ASUS 리뷰에서는 EAGLE3를 사용한 동일한 작업 부하에서 32개 스트림으로 초당 1,041개의 출력 토큰을 처리했습니다.
클러스터는 16개의 스트림(1,208 대 940) 동안 단일 스테이션과 매우 유사한 성능을 보이다가 이후 격차를 벌립니다. 32에서 2,776으로 단일 타워의 2.7배, 64에서 3,610, 128에서 1,912로 다소 감소했다가 256에서 3,498을 기록합니다. 두 개의 스테이션이 GLM-5.2에서보다 성능 향상에 기여하는 정도가 적은 이유는 하나의 스테이션이 이미 이 모델의 대부분을 HBM에 저장하고 있기 때문에 두 번째 GPU의 기여도가 KV 캐시 여유 공간을 활용한 순수 컴퓨팅 성능 확장에 더 가깝기 때문입니다.
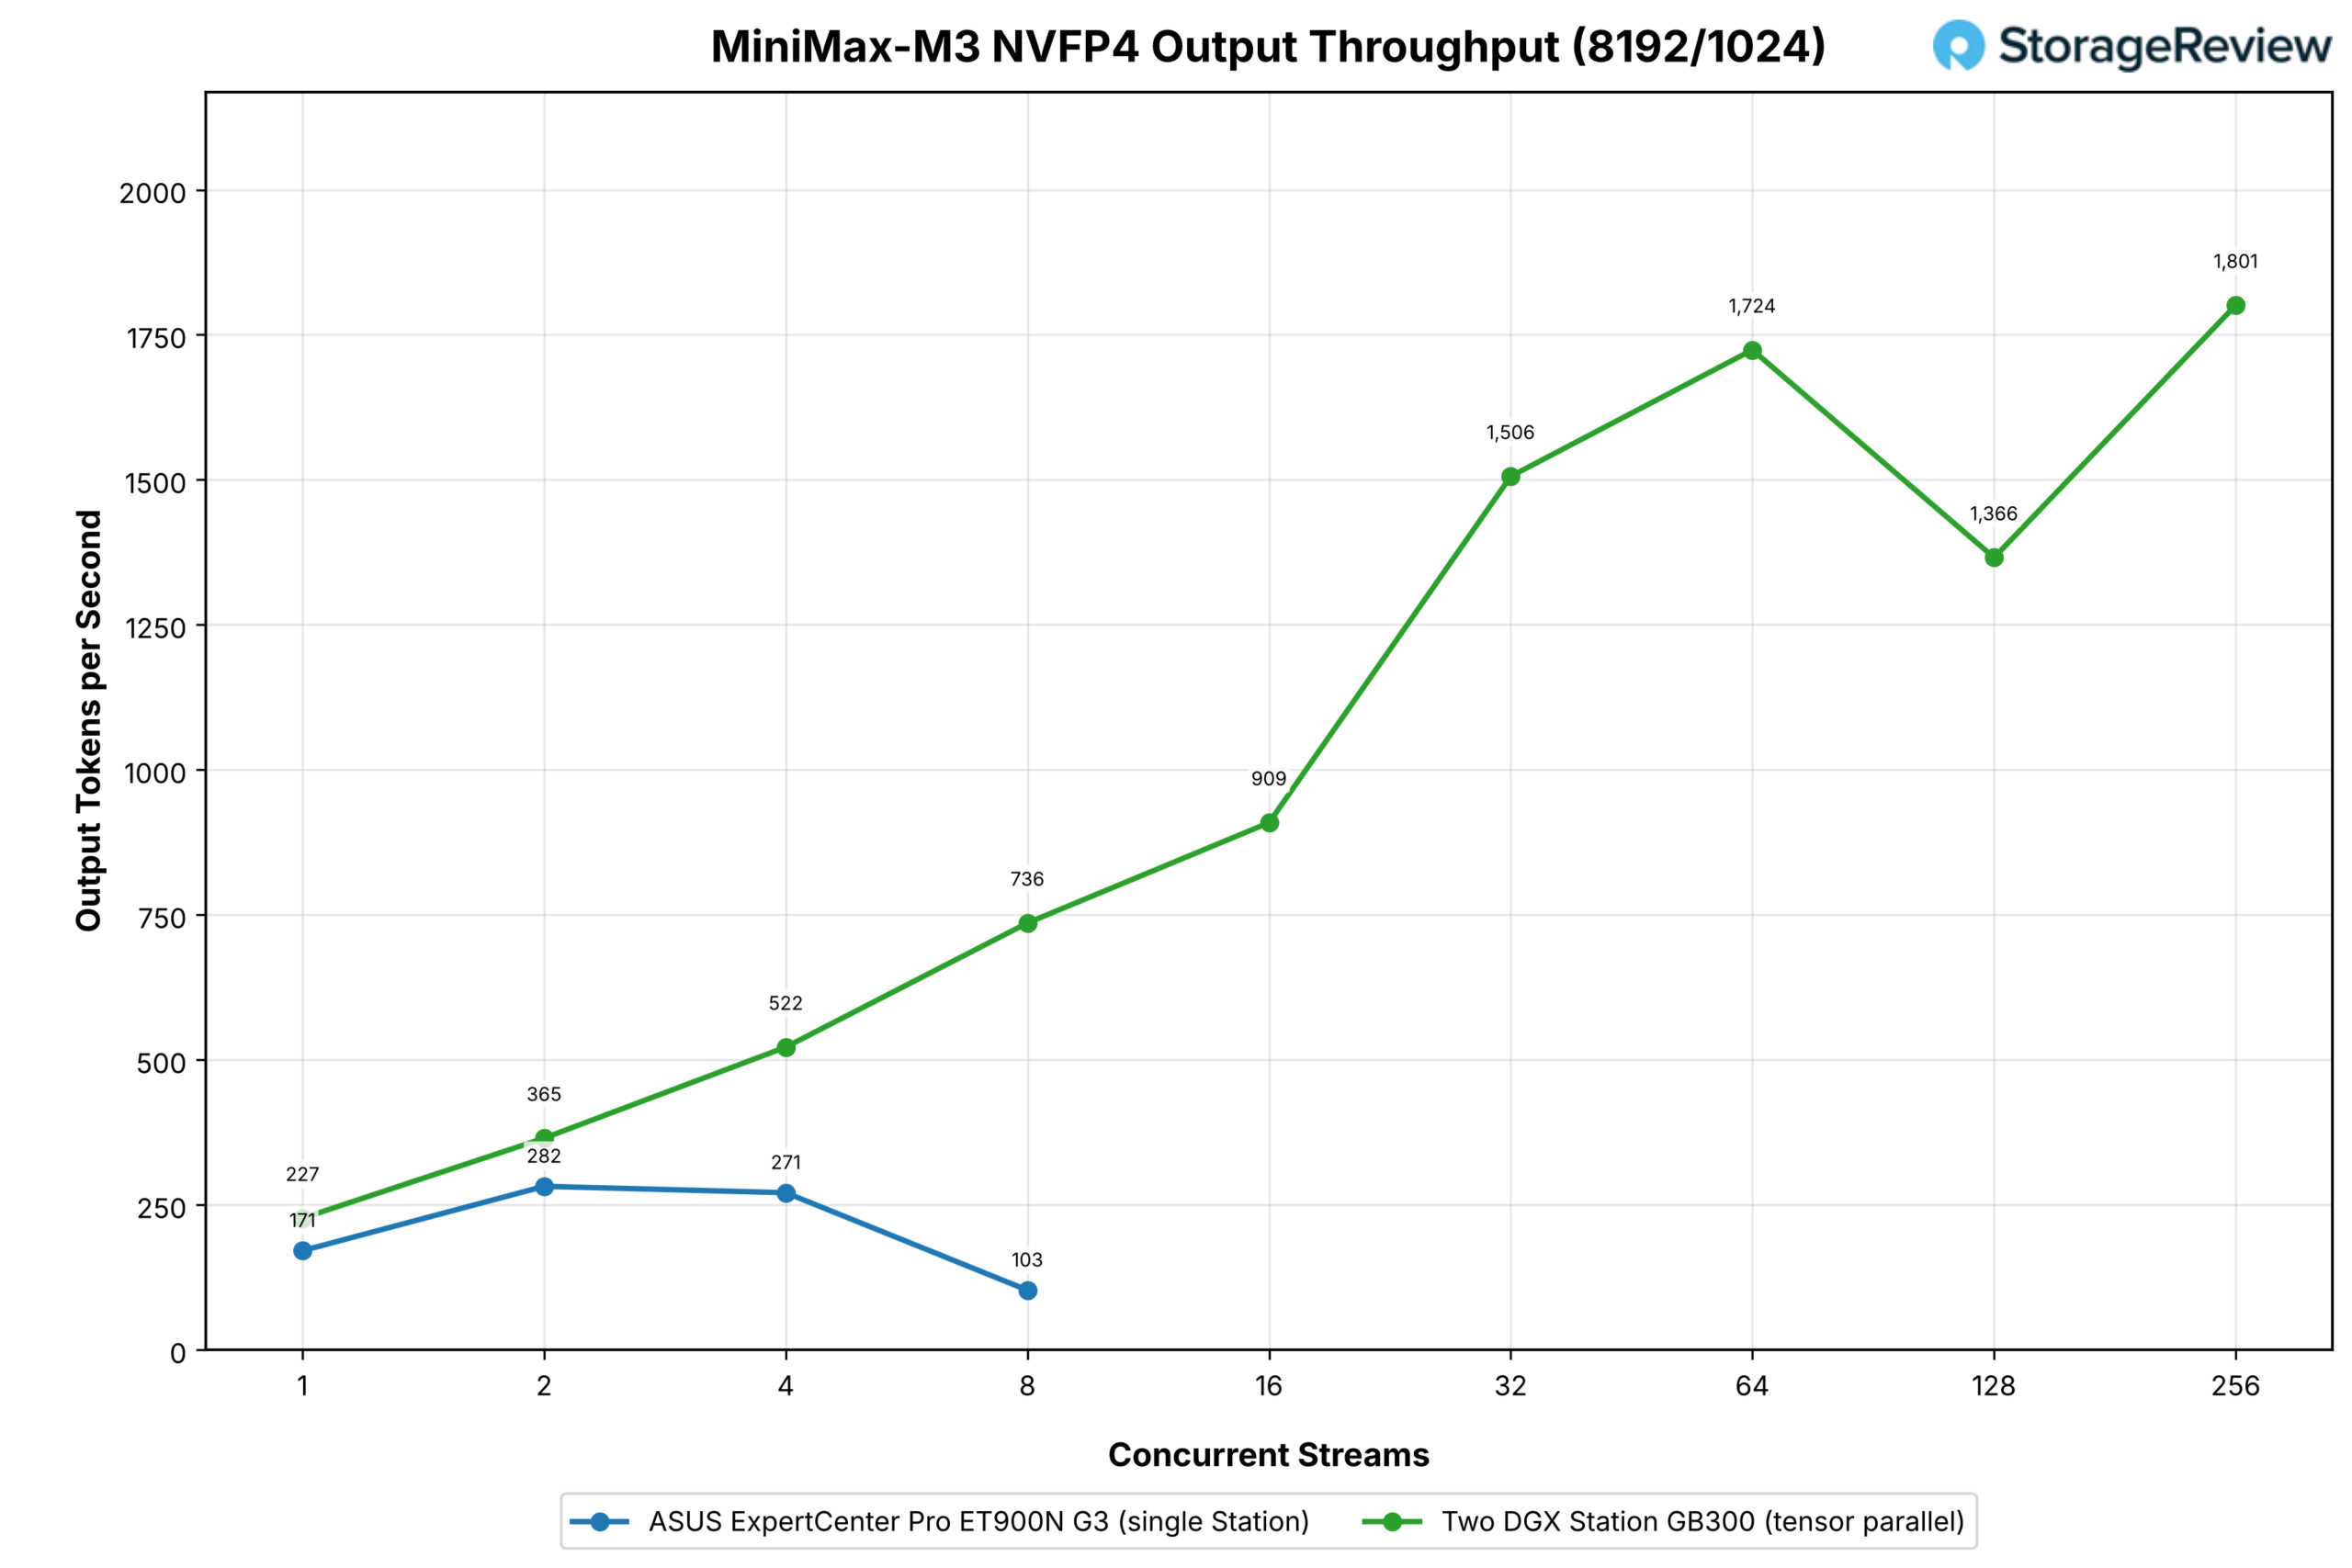
사전 입력량이 많은 프로파일에서 MiniMax-M3는 한 스테이션에서 캐시 공간이 부족해졌습니다. 8,192개의 토큰을 처리하는 프롬프트는 남은 KV 캐시를 빠르게 소모하여 단일 타워는 두 개의 스트림에서 초당 최대 282개의 출력 토큰을 처리했고, 네 개에서는 271개를 유지했으며, 여덟 개에서는 103개로 떨어졌습니다. 더 이상 측정할 데이터가 없었기 때문에 스윕이 종료되었습니다.
모델을 두 개의 스테이션으로 분할했을 때, 동일한 지점에서 365, 522, 736이라는 결과가 나왔습니다. 이는 두 스트림 모두 캐시 여유가 있는 구성에서 30%의 성능 향상을, 하나의 스트림이 캐시 부족으로 작동이 멈춘 8개 스트림 구성에서는 7.1배의 성능 향상을 의미합니다. 이후 클러스터는 16에서 909, 32에서 1,506, 64에서 1,724, 128에서 1,366, 256에서 1,801까지 성능을 끌어올렸는데, 이는 단일 스테이션으로는 이 프로파일에서 도달할 수 없는 범위입니다.
맺음말
두 대의 GB300 DGX 스테이션을 각각의 ConnectX-8 포트로 연결했을 때 NVIDIA 문서에 명시된 대로 작동했습니다. 설정 과정은 간단했으며, 이번 데이터는 이러한 듀얼 시스템 구성에 대한 최초의 처리량 데이터입니다.
두 번째 스테이션은 252GB의 HBM3e 메모리를 초과하는 모델에서 제 역할을 톡톡히 해냅니다. GLM-5.2는 단일 스테이션에서 32개 스트림으로 초당 139개의 출력 토큰을 처리하던 것이 두 스테이션에서는 1,525개, 256개 스트림에서는 3,141개까지 증가하는데, 이는 분할 과정에서 433GB 용량의 LPDDR5X 메모리를 사용하기 때문입니다. GLM-5.3은 단일 스테이션에서 최대 188개였던 출력이 256개 스트림에서는 5,018개까지 증가합니다. MiniMax-M3는 긴 프롬프트 처리 시 8개 스트림에서 속도가 느려지던 것이 256개 스트림에서도 여전히 속도가 증가하는 두 개의 스테이션으로 확장됩니다.
하나의 스테이션에 장착 가능한 두 모델인 GLM-5.3 Flash와 DeepSeek V4.1 Flash의 경우, 두 번째 박스를 더 효율적으로 사용하는 방법은 각 스테이션에 전체 복사본을 제공하고, 프리필과 디코딩을 분리한 후, 디코딩 워커가 일시 정지 없이 생성하도록 하는 것입니다. GLM-5.3 Flash의 경우, 이 방법을 통해 32개 스트림에서 롱 프롬프트 처리량이 두 배로 증가했고, 숏 프롬프트 처리량은 세 배로 증가했습니다. 또한 DeepSeek V4.1 Flash는 초당 5,248 토큰으로 가장 높은 출력 처리량을 기록했습니다.
MSI XpertStation WS300 리뷰 이후 제품에 대한 우리의 견해는 변함이 없습니다 . 이 제품은 특정 시장을 위한 흥미로운 장비이며, 만약 당신이 이 제품이 필요하다고 느낀다면, 또 다른 제품이 필요하다고 느낄 수도 있을 것입니다.
이러한 시스템을 운영하는 가장 좋은 방법은 교체 가능한 인프라로 활용하는 것입니다. 즉, 팀이 작업 일정을 잡고 프로젝트 변경에 따라 재구성할 수 있는 풀을 구축하는 것이죠. NVIDIA는 이를 구현하는 데 필요한 구성 요소를 모두 보유하고 있습니다. NVIDIA는 작업 일정 관리를 위한 Run:ai, 개발자 환경을 위한 Brev, 컴퓨팅 마켓플레이스를 위한 Lepton을 인수했으며, 이 세 가지 중 하나라도 NVIDIA Station 랙과 함께 사용한다면 제품의 경쟁력을 크게 높일 수 있을 것입니다.
두 개의 스테이션으로 구성된 시스템은 확장성이 뛰어났습니다. 측정된 최대 성능 향상은 GLM-5.3에서 나타났는데, 단일 스테이션에서 초당 188개의 출력 토큰을 처리하던 것이 두 스테이션을 함께 사용했을 때는 5,018개로 증가하여 27배의 성능 향상을 보였습니다. 또한, 동일한 동시 실행 환경에서 GLM-5.2는 32개의 스트림에서 11배의 성능 향상을 기록했는데, 이는 단일 스테이션으로는 그레이스 메모리에 가중치를 분산시켜야만 처리할 수 있는 모델에서 달성한 결과입니다. 이러한 결과는 2개의 400G 스테이션에서 GB300 수준의 성능을 보여주는 것으로, NVIDIA가 차세대 HBM과 NVLink-C2C를 탑재한 베라 루빈 스테이션을 출시할 때 어떤 성능을 보여줄지 기대하게 만듭니다.
이러한 변화가 적용되는 위치는 변함이 없습니다. 랙이나 데이터 센터 없이 책상 위에 두 개의 워크스테이션만으로도 이전에는 GPU 서버와 관련 설비가 필요했던 모델들을 구현할 수 있습니다. 따라서 데이터 센터 슬롯을 확보할 수 없거나 기다리고 싶지 않은 팀도 바로 옆에서 최첨단 추론 성능을 활용할 수 있게 되었습니다. NVIDIA는 가격을 제외하고도 이 분야의 기준을 높였습니다. GB300 시리즈는 당사의 로컬 AI용 최고 데스크톱 순위에서 상위권을 차지하고 있으며, 이번 클러스터 데이터는 이러한 선택을 뒷받침합니다.



 아마존