

Fio ဆိုတာ IO workload generator တစ်ခုဖြစ်တဲ့ Flexible IO ရဲ့ အတိုကောက်ပါ။ ၂၀၀၅ ခုနှစ်မှာ Linux kernel မှာ IO stack ရဲ့ နောက်ခံနဲ့ ရေးသားသူ Jens Axboe ဟာ Linux IO subsystem ရဲ့ ပြောင်းလဲမှုတွေကို benchmark လုပ်ဖို့အတွက် ဒါမှမဟုတ် အတည်ပြုဖို့အတွက် တစ်ကြိမ်တည်းသော test program တွေကို အဆက်မပြတ်ရေးသားရတာကို ငြီးငွေ့နေခဲ့ပါတယ်။ ရလဒ်အနေနဲ့ fio ဟာ အလုပ်ကို ပိုမိုလွယ်ကူစေဖို့ မွေးဖွားလာခဲ့ပါတယ်။ အသေးစိတ် workload setup တွေကို ခွင့်ပြုဖို့ လုံလောက်တဲ့ ပြောင်းလွယ်ပြင်လွယ်ရှိခဲ့ပြီး ပြီးစီးတဲ့အခါ data တွေကို နားလည်နိုင်ဖို့ လိုအပ်တဲ့ reporting တွေ ပါဝင်ခဲ့ပါတယ်။ Jens ဟာ Oracle နဲ့ နောက်ပိုင်းမှာ Fusion-io မှာ ပါဝင်လာတဲ့အခါ fio မှာ ဆက်လက်လုပ်ဆောင်ခဲ့ပါတယ်။ ဒီနေ့ခေတ်မှာ fio user အသိုင်းအဝိုင်းဟာ development မှာ တက်ကြွစွာ ပါဝင်လှုပ်ရှားနေပြီး ရလဒ်အနေနဲ့ fio ကို အဆက်မပြတ် တီထွင်ပြီး feature အသစ်တွေကို အကောင်အထည်ဖော်နေကြပါတယ်။ လူ ၁၀၀ ကျော်ဟာ fio မှာ ပါဝင်ခဲ့ကြပြီး အများအပြားလည်း အကြိမ်ပေါင်းများစွာ ပါဝင်ခဲ့ကြပါတယ်။ ဒီကတိကဝတ်ကြောင့် fio ရဲ့ version အသစ်ကို ၄-၆ ပတ်တစ်ကြိမ်လောက် ထုတ်ဝေလေ့ရှိပြီး fio ကို industry standard benchmark၊ stress testing tool နဲ့ IO verification ရည်ရွယ်ချက်တွေအတွက် ကျယ်ကျယ်ပြန့်ပြန့် အသုံးပြုကြပါတယ်။
အဓိကအင်္ဂါရပ်အစုံနှင့် စွမ်းရည်များ
ကောင်းမွန်တဲ့ benchmark တစ်ခုမှာ အဓိကအင်္ဂါရပ်နှစ်ခုကတော့ သင်လိုချင်တဲ့ workload ကို လုပ်ဆောင်နိုင်ခြင်းနဲ့ လိုချင်တဲ့ output ယူနစ်တွေကို ရရှိနိုင်ခြင်းပဲ ဖြစ်ပါတယ်။ ပြောင်းလွယ်ပြင်လွယ်ရှိခြင်းဟာ fio ရဲ့ အဓိကအာရုံစိုက်မှုပဲ ဖြစ်ပါတယ်။ တခြား benchmark တွေမှာ မတွေ့ရတဲ့ workload option တွေနဲ့အတူ အသေးစိတ် IO စာရင်းအင်းတွေကို ပံ့ပိုးပေးပါတယ်။ ဘယ်လို random နဲ့ sequential IO mix ဒါမှမဟုတ် read/write mix မျိုးမဆို သတ်မှတ်ရလွယ်ကူပါတယ်။ fio ရဲ့ internal design ကလည်း ပြောင်းလွယ်ပြင်လွယ်ရှိပါတယ်။ workload တစ်ခုကို သတ်မှတ်တာဟာ IO engine နဲ့ လုံးဝကွဲပြားပါတယ် (fio က IO ကို kernel ကို ဘယ်လိုပို့ဆောင်ပေးတယ်ဆိုတာကို ဖော်ပြဖို့ အသုံးပြုတဲ့ အသုံးအနှုန်းပါ)။ ဥပမာ Linux မှာ native async နဲ့ workload တစ်ခုကို run ပြီး Windows မှာ တူညီတဲ့ workload ကို နှိုင်းယှဉ်ချင်ရင် single IO engine line ကို Windows မှာ native version ကို ပြောင်းလိုက်ပါ။ ဒါမှမဟုတ် distribution ရဲ့ အဆုံးမှာ ပိုပြီးအသေးစိတ်ကျတဲ့ latency percentile statistics တွေကို လိုချင်ရင် အဲဒါလည်း လွယ်ပါတယ်။ သင်စိတ်ဝင်စားတဲ့ percentile အတိအကျကို သတ်မှတ်ပေးလိုက်ရင် fio က သင့်အတွက် ခြေရာခံပေးပါလိမ့်မယ်။
Linux မှာ အစပိုင်းမှာ တီထွင်ခဲ့ပေမယ့် OS-specific features တွေနဲ့ မချိတ်ဆက်ထားတဲ့ fio ရဲ့ နယ်ပယ်တွေဟာ Windows ကနေ HP-UX၊ Android အထိ မည်သည့် platform မှာမဆို အလုပ်လုပ်ပါတယ်။ Linux၊ Windows၊ Solaris စတဲ့ platform တွေမှာ native IO engines တွေလည်း ရှိပါတယ်။ ဒါက မတူညီတဲ့ operating environment တွေမှာ တူညီတဲ့ workloads တွေကို (အနီးစပ်ဆုံး) run နိုင်ချင်တဲ့ mixed environment တွေအတွက် အဓိက feature တစ်ခုပါ။ ထို့အပြင်၊ fio ကို target machine မှာ တိုက်ရိုက် run လေ့ရှိပေမယ့် network connection တွေကိုလည်း support လုပ်ပါတယ်။ target machine(s) မှာ server backend ကို run နိုင်ပြီး client machine မှာ data collection frontend ကို run နိုင်ပါတယ်။ ဒါက စီမံခန့်ခွဲရတာ ပိုလွယ်ကူစေပါတယ်၊ အထူးသဖြင့် fio ကို စက်များစွာမှာ မကြာခဏအသုံးပြုလေ့ရှိရင်ပေါ့။
Fio သည် အဓိကအားဖြင့် စာသားအခြေခံ CLI အပလီကေးရှင်းတစ်ခုဖြစ်သော်လည်း၊ cross-platform gtk-based GUI frontend (gfio) အတွက် ကနဦးပံ့ပိုးမှုရှိပါသည်။ ဤထုတ်ဝေချိန်တွင် gfio ကို နောက်ဆုံးထွက် fio ဗားရှင်း v2.1 တွင် ထည့်သွင်းထားပြီး တည်ငြိမ်မှုအတော်လေးရှိသင့်သည်။ ၎င်းသည် CLI client မှ ပံ့ပိုးပေးသော မည်သည့် workload အတွက်မဆို GUI frontend အဖြစ် ဆောင်ရွက်နိုင်သည်။ ၎င်းသည် GUI တည်းဖြတ်ခြင်း အလုပ်ရွေးချယ်မှုများနှင့် workloads များအတွက် အခြေခံပံ့ပိုးမှုကိုလည်း ပေးစွမ်းသော်လည်း၊ gfio သည် လုပ်ဆောင်ဆဲလုပ်ငန်းတစ်ခုဖြစ်သောကြောင့် အပြည့်အဝပံ့ပိုးမှုကို တီထွင်နေဆဲဖြစ်သည်။
Fio သည် output format အမျိုးအစားသုံးမျိုးကို ပံ့ပိုးပေးပါသည်။ “classic” output သည် workload ၏အဆုံးတွင် workload statistics များကို dump လုပ်သည့် default ဖြစ်သည်။ CSV format အတွက်လည်း ပံ့ပိုးမှုရှိသော်လည်း ၎င်းသည် JSON-based output format ဖြင့် တဖြည်းဖြည်း လျော့နည်းလာပါသည်။ နောက်ဆုံးတစ်ခုသည် ပိုမိုပြောင်းလွယ်ပြင်လွယ်ရှိပြီး လူများနှင့် ကွန်ပျူတာများအတွက် parse လုပ်ရန် ရိုးရှင်းခြင်း၏ အားသာချက်ရှိသည်။
Fio ဟာ ၎င်းရဲ့ တက်ကြွတဲ့ အသုံးပြုသူနဲ့ ဖွံ့ဖြိုးတိုးတက်ရေး အသိုင်းအဝိုင်းရဲ့ ပေါင်းစပ်မှုကြောင့် အလျင်အမြန် တိုးတက်နေပါတယ်။ ယှဉ်ပြိုင်နေတဲ့ ပရောဂျက်တွေထက် လုပ်ဆောင်ရတာ ပိုမိုလွယ်ကူပြီး အသုံးပြုသူတွေရဲ့ တာဝန်တွေကို ပြီးမြောက်အောင် လိုက်လျောညီထွေဖြစ်အောင် လုပ်ဆောင်နိုင်သလို၊ မည်သည့် သိုလှောင်မှုစနစ်ကိုမဆို အပြည့်အဝ မြန်နှုန်းနဲ့ မောင်းနှင်နိုင်ဖို့ overhead နည်းပါးပါတယ်။ တခြားဘယ်ဟာထက်မဆို ပိုမိုကြွယ်ဝတဲ့ ရွေးချယ်စရာတွေနဲ့ အစီရင်ခံမှုတွေနဲ့ ပေါင်းစပ်လိုက်တဲ့အခါ fio ဟာ အလွန်ကောင်းမွန်တဲ့ ကိရိယာတစ်ခု ဖြစ်ပါတယ်။
StorageReview.com မှာ FIO ကို ဘာကြောင့် အသုံးပြုတာလဲ
ကျွန်ုပ်တို့၏ enterprise storage review များ၏ ပမာဏနှင့် အတိမ်အနက် နှစ်မျိုးလုံးကို တိုးမြှင့်လာသည်နှင့်အမျှ operating system အများအပြားတွင် မတူညီသော storage product များ၏ စွမ်းဆောင်ရည်ကို တိကျစွာ တိုင်းတာရန် ပိုမိုကောင်းမွန်သော benchmarking tool တစ်ခု လိုအပ်လာပါသည်။ Iometer သို့မဟုတ် Vdbench ကဲ့သို့သော ရိုးရာ workload generator software များသည် ၎င်းတို့၏ non-native OS နှင့် လိုက်လျောညီထွေဖြစ်မှု အကန့်အသတ်ရှိခြင်း သို့မဟုတ် PCIe application accelerator များ သို့မဟုတ် high-performance networked storage ကဲ့သို့သော high-performance storage device များအတွက် load များကို scaling လုပ်ရာတွင် အခက်အခဲရှိခဲ့ပါသည်။ FIO ကို အကောင်အထည်ဖော်မှု စတင်ကတည်းက ၎င်းသည် ဤပြဿနာများစွာကို ဖြေရှင်းပေးခဲ့ပြီး ရှည်လျားသော စမ်းသပ်ကာလများအတွက် scripting ကို ပံ့ပိုးပေးခြင်းဖြင့် နောက်တစ်ဆင့်တက်လှမ်းခဲ့ပါသည်။ ဤအလုံးစုံလုပ်ဆောင်ချက်သည် enterprise review အားလုံးအတွက် ရွေးချယ်ထားသော synthetic benchmark ဖြစ်စေပါသည်။
ကျွန်ုပ်တို့၏ သုံးသပ်ချက်များအတွက်၊ သတ်မှတ်ထားသော ကာလအတွင်း သိုလှောင်မှုကိရိယာတစ်ခု၏ စွမ်းဆောင်ရည်ကို တိုင်းတာရန် FIO ကို အသုံးပြုပါသည်။ ထုတ်ကုန်အများစုအတွက်၊ ကျွန်ုပ်တို့၏ အဓိကစမ်းသပ်မှုများထဲသို့ မ၀င်မီ ကြိုတင်ပြင်ဆင်မှု ၆ နာရီ ပါဝင်သည်။ စမ်းသပ်မှုတွင် နာရီပေါင်းများစွာ steady-state ထဲသို့ မ၀င်နိုင်သော ပိုကြီးသော PCIe သိုလှောင်မှုကိရိယာများအတွက်၊ ကျွန်ုပ်တို့၏ အဓိကစမ်းသပ်မှုများ မစတင်မီ ၁၂ နာရီတွင် နှစ်ဆကြာ ကြိုတင်ပြင်ဆင်မှု ပြုလုပ်ပါသည်။ ကျွန်ုပ်တို့၏ ပေါင်းစပ် enterprise storage benchmark လုပ်ငန်းစဉ်သည် ပြီးပြည့်စုံသော ကြိုတင်ပြင်ဆင်မှုအဆင့်အတွင်း drive ၏ စွမ်းဆောင်ရည်ကို ခွဲခြမ်းစိတ်ဖြာခြင်းဖြင့် စတင်ပါသည်။ နှိုင်းယှဉ်နိုင်သော ထုတ်ကုန်တစ်ခုစီကို ရောင်းချသူ၏ကိရိယာများကို အသုံးပြု၍ ဦးစွာ လုံခြုံစွာ ဖျက်ပစ်ပြီးနောက် device ကို thread တစ်ခုလျှင် ၁၆ ခုပါသော queue ဖြင့် thread ၁၆ ခု၏ လေးလံသောဝန်အောက်တွင် စမ်းသပ်မည့် workload တူညီသော steady-state သို့ ကြိုတင်ပြင်ဆင်မှု ပြုလုပ်ပါသည်။ လုပ်ငန်းစဉ်ကို အပြီးသတ်ပြီးနောက်၊ အသုံးပြုမှုအနည်းငယ်နှင့် လေးလံသောအသုံးပြုမှုအောက်တွင် စွမ်းဆောင်ရည်ကို ပြသရန် thread/queue depth profile များစွာတွင် သတ်မှတ်ထားသော အကွာအဝေးများတွင် စမ်းသပ်ပါသည်။
ကြိုတင်အခြေအနေပြင်ဆင်ခြင်းနှင့် မူလတည်ငြိမ်အခြေအနေစမ်းသပ်မှုများ-
- ပမာဏ (ဖတ်+ရေး IOPS စုစည်းမှု)
- ပျမ်းမျှ နှောင့်နှေးမှု (ဖတ်+ရေး နှောင့်နှေးမှု အတူတကွ ပျမ်းမျှ)
- အများဆုံး နှောင့်နှေးမှု (အမြင့်ဆုံး ဖတ်ရန် သို့မဟုတ် ရေးရန် နှောင့်နှေးမှု)
- နှောင့်နှေးမှု စံသွေဖည်မှု (ဖတ်+ရေး စံသွေဖည်မှုကို ပျမ်းမျှပေါင်းစပ်ထားသည်)
ကျွန်ုပ်တို့၏ Enterprise Synthetic Workload Analysis တွင် လက်တွေ့လုပ်ငန်းဆောင်တာအချို့ကို ထင်ဟပ်စေရန်အတွက် မတူညီသောပရိုဖိုင်များ ပါဝင်သည်။ ဤပရိုဖိုင်များကို ကျွန်ုပ်တို့၏ ယခင်စံနှုန်းများအပြင် enterprise hardware အတွက် အသုံးများသော အမြင့်ဆုံး 4k read/write speed နှင့် 8k 70/30 ကဲ့သို့သော ကျယ်ကျယ်ပြန့်ပြန့်ထုတ်ဝေထားသော တန်ဖိုးများနှင့် နှိုင်းယှဉ်ရလွယ်ကူစေရန် တီထွင်ထားပါသည်။
- 4k
- ၁၀၀% ဖတ်ရန် သို့မဟုတ် ၁၀၀% ရေးသားရန်
- ၁၀၀% ၁၂၈k
- fio –filename=/dev/sdx –direct=1 –rw=randrw –refill_buffers –norandommap –randrepeat=0 –ioengine=libaio –bs=4k –rwmixread=100 –iodepth=16 –numjobs=16 –runtime=60 –group_reporting –name=4ktest
- ၈၀၀၀၇၀/၃၀
- ၇၀% ဖတ်၊ ၃၀% ရေးသား
- ၁၀၀% ၁၂၈k
- fio –filename=/dev/sdx –direct=1 –rw=randrw –refill_buffers –norandommap –randrepeat=0 –ioengine=libaio –bs=8k –rwmixread=70 –iodepth=16 –numjobs=16 –runtime=60 –group_reporting –name=8k7030test
လက်ရှိတွင် ကျွန်ုပ်တို့၏ Linux စွမ်းဆောင်ရည်စမ်းသပ်မှုများအတွက် CentOS 6.3 ရှိ FIO ဗားရှင်း 2.0.7 (x64) နှင့် Windows စွမ်းဆောင်ရည်အတွက် Windows Server 2008 R2 SP1 ရှိ FIO ဗားရှင်း 2.0.12.2 (x64) ကို အသုံးပြုပါသည် ။
StorageReview Enterprise Testing Platforms
Storage solution များကို StorageReview Enterprise Test Lab တွင် FIO synthetic benchmark ဖြင့် stand-alone server များကို အသုံးပြု၍ စမ်းသပ်ထားပါသည်။ ကျွန်ုပ်တို့သည် HP ProLiant DL380/DL360 Gen9 ကို အသုံးပြု၍ လက်တွေ့ကျသော စွမ်းဆောင်ရည်ကို ပြသပြီး ကျွန်ုပ်တို့၏ DL380/DL360 ကို မတူညီသော storage ထုတ်ကုန်များနှင့် ချိတ်ဆက်ရန် storage adapter သို့မဟုတ် network interface ကိုသာ ပြောင်းလဲအသုံးပြုပါသည်။ DL380/DL360 သည် third-party devices များနှင့် ကောင်းမွန်သော တွဲဖက်အသုံးပြုနိုင်မှုကို သက်သေပြခဲ့ပြီး ဤကွဲပြားသော testing environment အတွက် အကောင်းဆုံး go-to platform တစ်ခု ဖြစ်စေပါသည်။
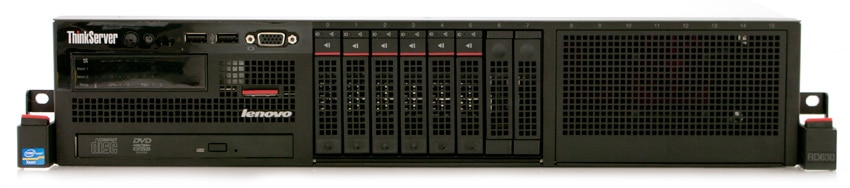
(မျိုးဆက် ၂) Lenovo ThinkServer RD240
- ၂ x Intel Xeon X5650 (2.66GHz, 12MB Cache)
- Intel 5500+ ICH10R ချစ်ပ်ဆက်
- မှတ်ဉာဏ် - 8GB (2 x 4GB) 1333Mhz DDR3 မှတ်ပုံတင်ထားသော RDIMM များ
- Windows Server 2008 Standard Edition R2 SP1 64-Bit နှင့် CentOS 6.2 64-Bit
- LSI 9211 SAS/SATA 6.0Gb/s HBA
(မျိုးဆက် ၂) Lenovo ThinkServer RD630
- ၂ x Intel Xeon E5-2620 (2.0GHz, 15MB Cache, 6-cores)
- Intel C602 ချစ်ပ်ဆက်
- မှတ်ဉာဏ် - 16GB (2 x 8GB) 1333Mhz DDR3 မှတ်ပုံတင်ထားသော RDIMM များ
- Windows Server 2008 R2 SP1 64-bit၊ Windows Server 2012 Standard၊ CentOS 6.3 64-bit
- 100GB မိုက်ခရွန် RealSSD P400e SSD ကို စတင်ပါ
- LSI 9207-8i SAS/SATA 6.0Gb/s HBA (SSD သို့မဟုတ် HDD များကို benchmarking လုပ်ရန်အတွက်)
(Gen3) HP ProLiant DL380 / DL360 Gen9
- Intel E5-2667 v3 CPU နှစ်လုံး (3.2GHz၊ 8-cores၊ 20MB Cache)
- 256GB RAM (16GB x 16 DDR4၊ CPU တစ်ခုလျှင် 128GB)
- ဝင်းဒိုးဆာဗာ ၂၀၁၂ R၂၊ စင်အိုအက်စ် ၇.၀
- ၄၀၀GB Boot SSD – ဝင်းဒိုး
- 300GB Boot HDD – Linux
- LSI 9300-8e SAS/SATA 12.0Gb/s HBA (SSD သို့မဟုတ် HDD များကို benchmarking လုပ်ရန်အတွက်)
- စူပါမိုက်ခရို စူပါကိုယ်ထည် 846BE1C-R1K28B SAS3 JBOD (SSD သို့မဟုတ် HDD များ ချိတ်ဆက်ရန်အတွက်)


 အမေဇုံ