StorageReview.com

Enterprise AI သုံးသပ်ချက်များ

ကျွန်ုပ်တို့ရဲ့ လက်ရှိ AI စနစ် ပြန်လည်သုံးသပ်ချက်တွေဟာ ဓာတ်ခွဲခန်းမှာ ဆောင်ရွက်ပေးနေတဲ့ inference ကို အဓိကထားပြီး Llama၊ Qwen၊ DeepSeek နဲ့ gpt-oss မိသားစုတွေက open-weight မော်ဒယ်တွေဟာ vLLM ဒါမှမဟုတ် SGLang တွေကနေတစ်ဆင့် လည်ပတ်နေပြီး output throughput နဲ့ first-token latency တို့ကို တိုင်းတာထားပါတယ်။ Coverage ဟာ edge ကနေ full GPU node အထိ လည်ပတ်ပါတယ်- NVIDIA RTX PRO 4500 Server Edition ဟာ HPE ProLiant DL145 Gen11 အတွင်းမှာ အစားထိုးဖို့ တည်ဆောက်ထားတဲ့ L4 ရဲ့ တစ်စက္ကန့်ကို output token ထက် 2.7x ပျမ်းမျှ ပို့ဆောင်ပေးနိုင်ခဲ့ပြီး wall မှာ 105W လောက် ပိုပေးစွမ်းနိုင်ခဲ့ပါတယ်။ Dell၊ GIGABYTE နဲ့ HP ဗားရှင်းတွေဖြစ်တဲ့ DGX Spark တွေဟာ 200 Gb fabric ပေါ်မှာ two-node cluster အနေနဲ့ distributed inference ကို လည်ပတ်ခဲ့ပြီး Supermicro JumpStart က NVIDIA HGX B200 နဲ့ AMD Instinct MI350X system တို့နဲ့ လက်တွေ့လုပ်ဆောင်ချိန် ပေးခဲ့ပါတယ်။ ဒေတာလမ်းကြောင်းက ထို GPU များ မည်မျှအလုပ်များနေမည်ကို ဆုံးဖြတ်ပေးသောကြောင့် သိုလှောင်မှုသည်လည်း အလားတူဆက်ဆံမှုကို ရရှိပါသည်၊ ထို့ကြောင့် ကျွန်ုပ်တို့သည် GDSIO ဖြင့် GPUDirect Storage throughput ကို တိုင်းတာပြီး long-context နှင့် agentic workloads အတွက် flash လုပ်ရန် KV cache offload ကို စမ်းသပ်ပါသည်။

AI အတွက် hardware အရွယ်အစားကို ခွဲခြားသတ်မှတ်နေတယ်ဆိုရင် Best Servers စာမျက်နှာက ကျွန်ုပ်တို့ရဲ့ လက်ရှိ AI ကောက်ချက်နဲ့ ဒီသုံးသပ်ချက်တွေကနေ ရရှိတဲ့ အချက်အလက်တွေအပေါ် edge picks တွေကို ဖော်ပြပေးပါတယ်။ Best Enterprise SSDs ကတော့ GPU တွေကို ထောက်ပံ့ပေးတဲ့ drives တွေကို ဖော်ပြထားပြီး Best Storage Arrays ကတော့ training clusters နဲ့ neoclouds တွေရဲ့ နောက်ကွယ်က AI storage platforms တွေကို ဖော်ပြပေးထားပါတယ်။


Dell PowerEdge R7725 တွင် တပ်ဆင်ထားသော AMD Instinct MI350P ကတ်နှစ်ခု၊ အဖုံးပိတ်ထားပြီး အပေါ်မှမြင်ရသော ကတ်တစ်ခု၊ riser ပေါ်တွင် ကတ်တစ်ခုနှင့် ဘေးတွင်ရှိသော ဒုတိယ riser bay
AI  ◇  စီးပွားရေးလုပ်ငန်း

AMD Instinct MI350P ပထမဆုံးအကြည့်- 600W PCIe ကတ်တွင် 144GB HBM3E ပါဝင်သည်

AMD Instinct MI350P သည် ၂၀၂၂ ခုနှစ်တွင် MI210 ထွက်ရှိပြီးနောက် လေးနှစ်အတွင်း AMD ၏ ပထမဆုံး PCIe Instinct GPU အသစ်ဖြစ်သည်။ ၎င်းသည် ကုမ္ပဏီ၏ CDNA 4 ဗိသုကာကို ရိုးရာ add-in card တစ်ခုသို့ ယူဆောင်လာပြီး MXFP4 စွမ်းဆောင်ရည် 4.6 PFLOPS အထိ၊ HBM3E 144GB နှင့် မန်မိုရီ bandwidth 4TB/s အထိ ရှိသည်။ ၎င်းအားလုံးသည် dual-slot၊ 600W တွင် ကိုက်ညီသည်။

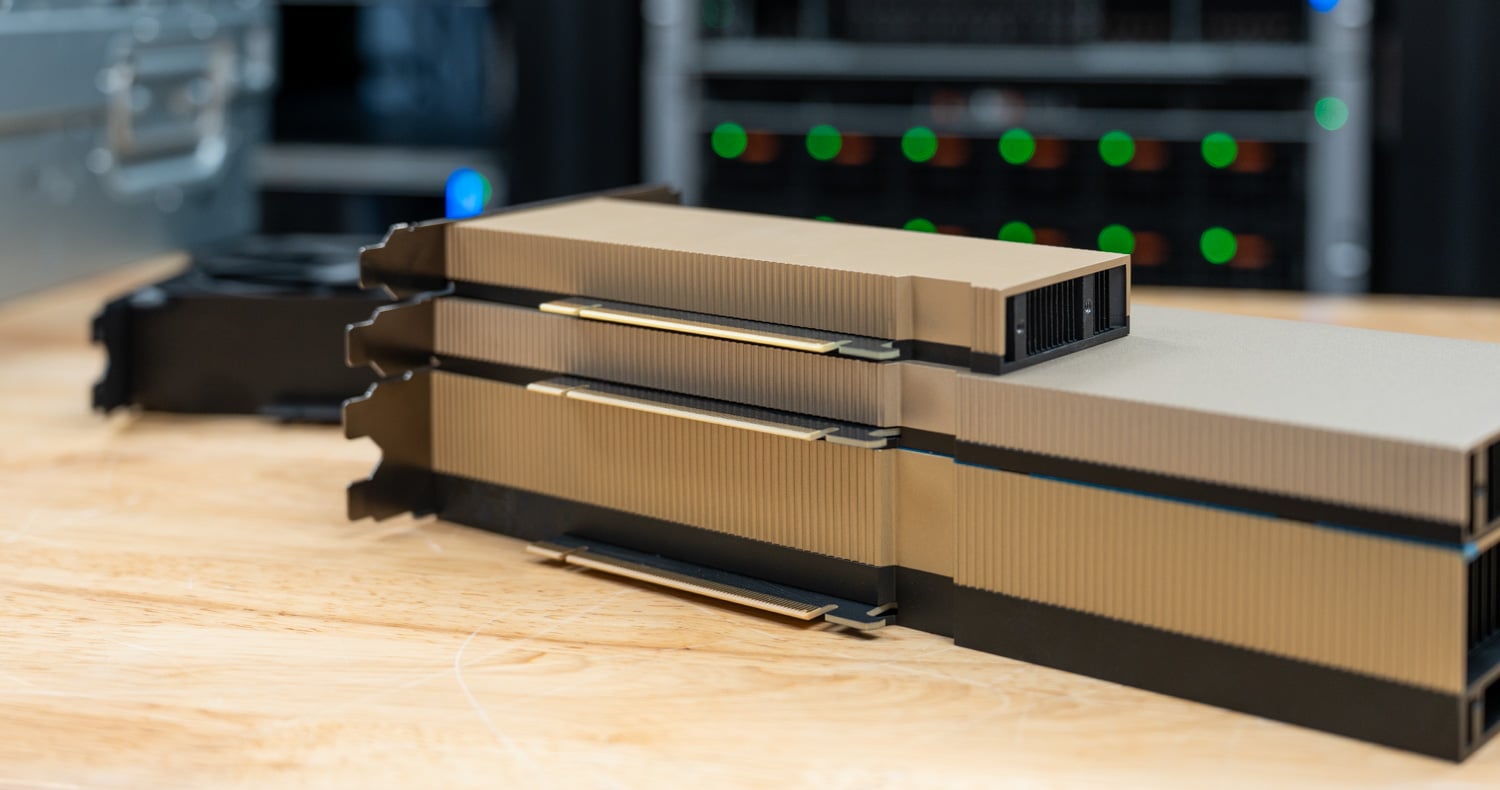
NVIDIA L4၊ RTX PRO 4500 Blackwell Server Edition နှင့် L40S တို့ကို slot အထူနှင့် အရှည်ကို နှိုင်းယှဉ်ရန် အပေါ်မှအောက်သို့ အနားသတ်များကို စီထားပြီး RTX PRO 6000 Workstation Edition သည် နောက်တွင်ရှိသည်။
AI  ◇  စီးပွားရေးလုပ်ငန်း

NVIDIA RTX PRO 4500 Blackwell Server Edition သုံးသပ်ချက်- Single Slot တွင် 165W ဖြင့် L40S Throughput

NVIDIA RTX PRO 4500 Blackwell Server Edition သည် လုပ်ငန်းအများစုပိုင်ဆိုင်ပြီးသား ဆာဗာများအတွက် NVIDIA တည်ဆောက်ထားသော ကတ်ဖြစ်သည်။ ၎င်းသည် single-slot၊ passively cooled၊ 165W board တစ်ခုဖြစ်ပြီး 32GB GDDR7 နှင့် Blackwell feature အစုံအလင်ပါဝင်သည်- FP4 ပါရှိသော ပဉ္စမမျိုးဆက် Tensor Cores၊ စတုတ္ထမျိုးဆက် RT cores၊ encoder သုံးခုနှင့် decoder သုံးခုနှင့် Multi-Instance GPU ပံ့ပိုးမှုတို့ဖြစ်သည်။

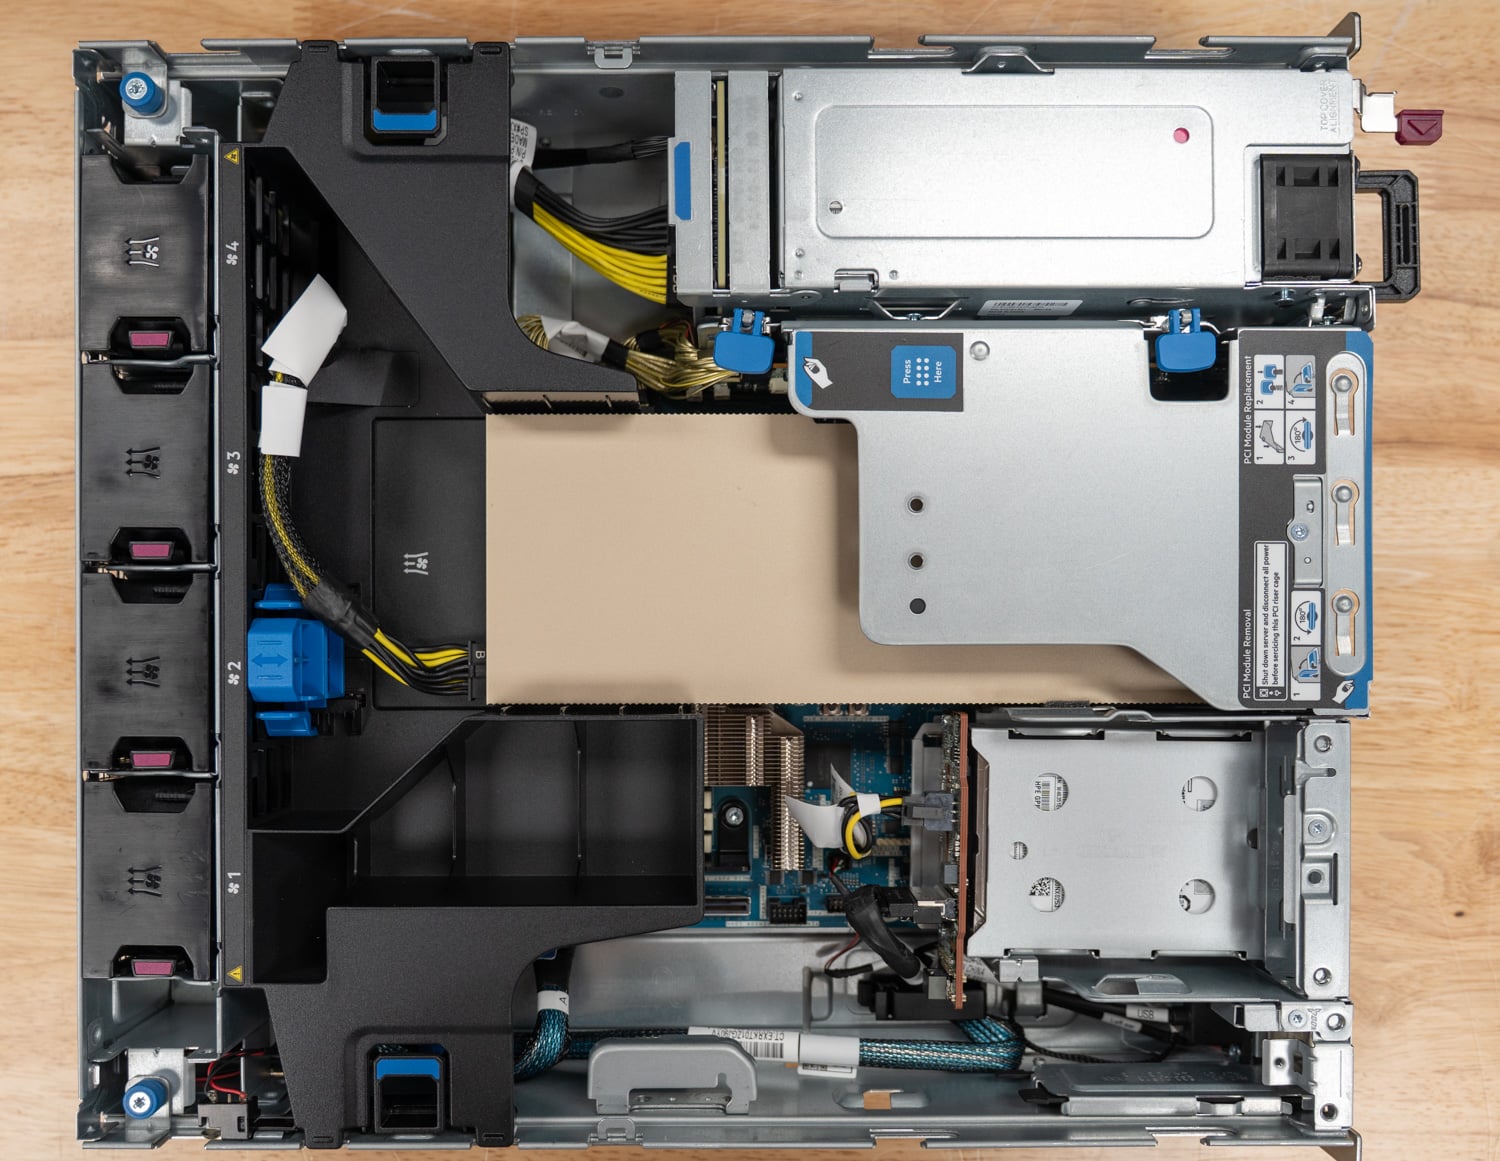
RTX PRO 4500 edge သုံးသပ်ချက်- RTX PRO 4500 Server Edition ကို full-height riser တွင်တပ်ဆင်ထားပြီး ၎င်း၏ 16-pin power cable ချိတ်ဆက်ထားသော HPE ProLiant DL145 Gen11 အတွင်းပိုင်းအပေါ်မှအောက်သို့ မြင်ကွင်း
AI  ◇  စီးပွားရေးလုပ်ငန်း

NVIDIA RTX PRO 4500 Edge သုံးသပ်ချက်- HPE ProLiant DL145 Gen11 အတွင်းရှိ L4 ၏ ၂.၇ ဆ

NVIDIA RTX PRO 4500 Blackwell Server Edition သည် ဒေတာစင်တာပြင်ပရှိ ဆာဗာများတွင် L4 ကို အစားထိုးရန် NVIDIA မှ အဓိကတည်ဆောက်ထားသော ကတ်ဖြစ်သည်- single-slot၊ PCIe Gen5၊ passively cooled၊ 165W၊ 32GB GDDR7 နှင့် FP4 Tensor Cores နှင့် Multi-Instance GPU အပါအဝင် Blackwell feature set အပြည့်အစုံပါဝင်သည်။ HPE သည် ကျွန်ုပ်တို့ထံ ProLiant DL145 ပေးပို့ခဲ့သည်။

AI  ◇  စီးပွားရေးလုပ်ငန်း

ရှည်လျားသော အခြေအနေဆိုင်ရာ ကောက်ချက်ချမှုအတွက် တိုကင်ထိရောက်သော လမ်းကြောင်း- KV Cache ကို Flash သို့ လျှော့ချခြင်း

Enterprise AI အခြေခံအဆောက်အအုံသည် လေ့ကျင့်ရေးပုံစံများကို အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းမှ ၎င်းတို့ကို ဝန်ဆောင်မှုပေးခြင်းသို့ ပြောင်းလဲခဲ့ပြီး ၎င်းသည် စီးပွားရေးကို ပြောင်းလဲစေခဲ့သည်။ လေ့ကျင့်ရေးသည် endpoint ပါရှိသော အရင်းအနှီးစီမံကိန်းတစ်ခုဖြစ်သည်။ Inference သည် ဝန်ဆောင်မှုအသက်ဝင်နေသရွေ့ လည်ပတ်နေသော ထုတ်လုပ်မှုအလုပ်ပမာဏတစ်ခုဖြစ်ပြီး output ကို tokens များဖြင့် တိုင်းတာသည်။ ဤသည်မှာ AI အော်ပရေတာများ ရင်ဆိုင်နေရသော tokenomics ပြဿနာဖြစ်သည်- တစ်ချိန်က

AI  ◇  စီးပွားရေးလုပ်ငန်း

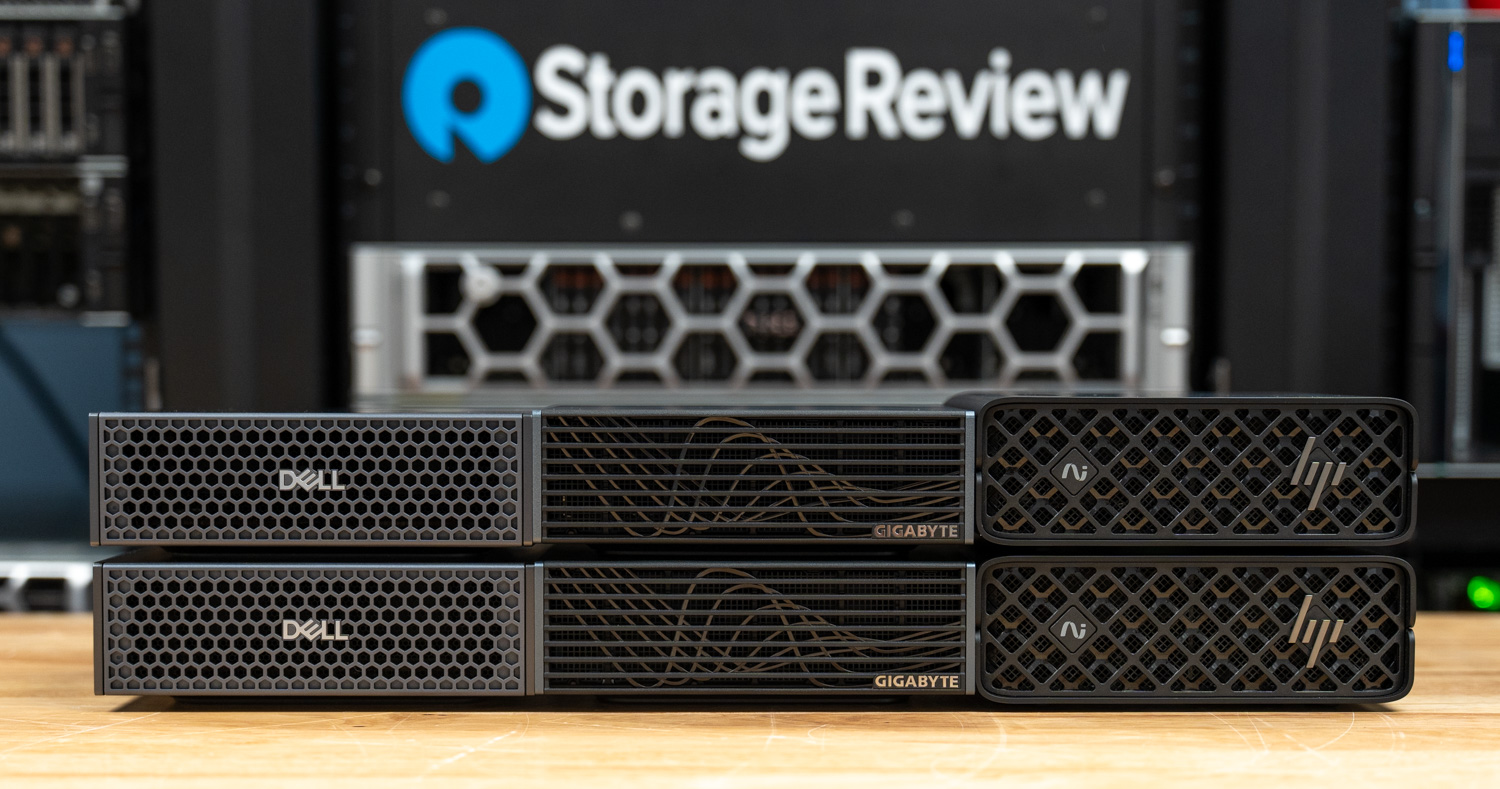
NVIDIA DGX Spark Cluster ပြန်လည်သုံးသပ်ချက်- Dell၊ GIGABYTE နှင့် HP တို့အပေါ် ဖြန့်ဝေထားသော ကောက်ချက်

NVIDIA DGX Spark အကြောင်းပြောတဲ့အခါတိုင်း အချက်နှစ်ချက်က အဓိကအချက်ပါ။ ပထမအချက်ကတော့ ဒေါ်လာ ၄၀၀၀ လောက်တန် desktop box ထဲမှာ 128 GB unified memory ပါဝင်တာပါ။ လွန်ခဲ့တဲ့ နှစ်နှစ်ကတောင် အင်ဂျင်နီယာတစ်ယောက်ရဲ့စားပွဲပေါ်မှာ တင်ထားဖို့ မဖြစ်နိုင်ဘူးလို့ ထင်ခဲ့မိတယ်။ ဒုတိယအချက်ကတော့ 200 ပါ။

AI  ◇  စီးပွားရေးလုပ်ငန်း

Metrum AI နှင့် Oregon State University တို့သည် ပညာရေးဆိုင်ရာ အကဲဖြတ်မှုအတွက် စံနှုန်းသစ်တစ်ခုကို မည်သို့တည်ဆောက်နေကြသည်

ပြီးခဲ့တဲ့ နိုဝင်ဘာလက Oregon State University ရဲ့ plankton imaging သုတေသနအကြောင်း ကျွန်တော်တို့ရဲ့ ဇာတ်လမ်းကို ထုတ်ဝေခဲ့တုန်းက ခေါင်းစဉ်က သိပ္ပံပညာပါ- AI-accelerated infrastructure တွေက သုတေသနသင်္ဘောတွေပေါ်က အခြေခံအဆောက်အအုံတွေကို အရှိန်မြှင့်ပေးပြီး သင်္ဘောဆိပ်ကမ်းကို မရောက်ခင်မှာ terabytes ပမာဏရှိတဲ့ သမုဒ္ဒရာဒေတာတွေကို အချိန်နဲ့တပြေးညီ စီမံဆောင်ရွက်ပေးပါတယ်။ ဒါပေမယ့် နောက်ရက်သတ္တပတ်တွေအတွင်းမှာ တိတ်တဆိတ်ဖြစ်ပျက်ခဲ့တဲ့ တခြားအရာတစ်ခုရှိပါတယ်။ ကျောင်းဝင်းတစ်ခုလုံးမှာ ဘယ်လို... ဆိုတဲ့ သတင်းက ပျံ့နှံ့သွားခဲ့ပါတယ်...

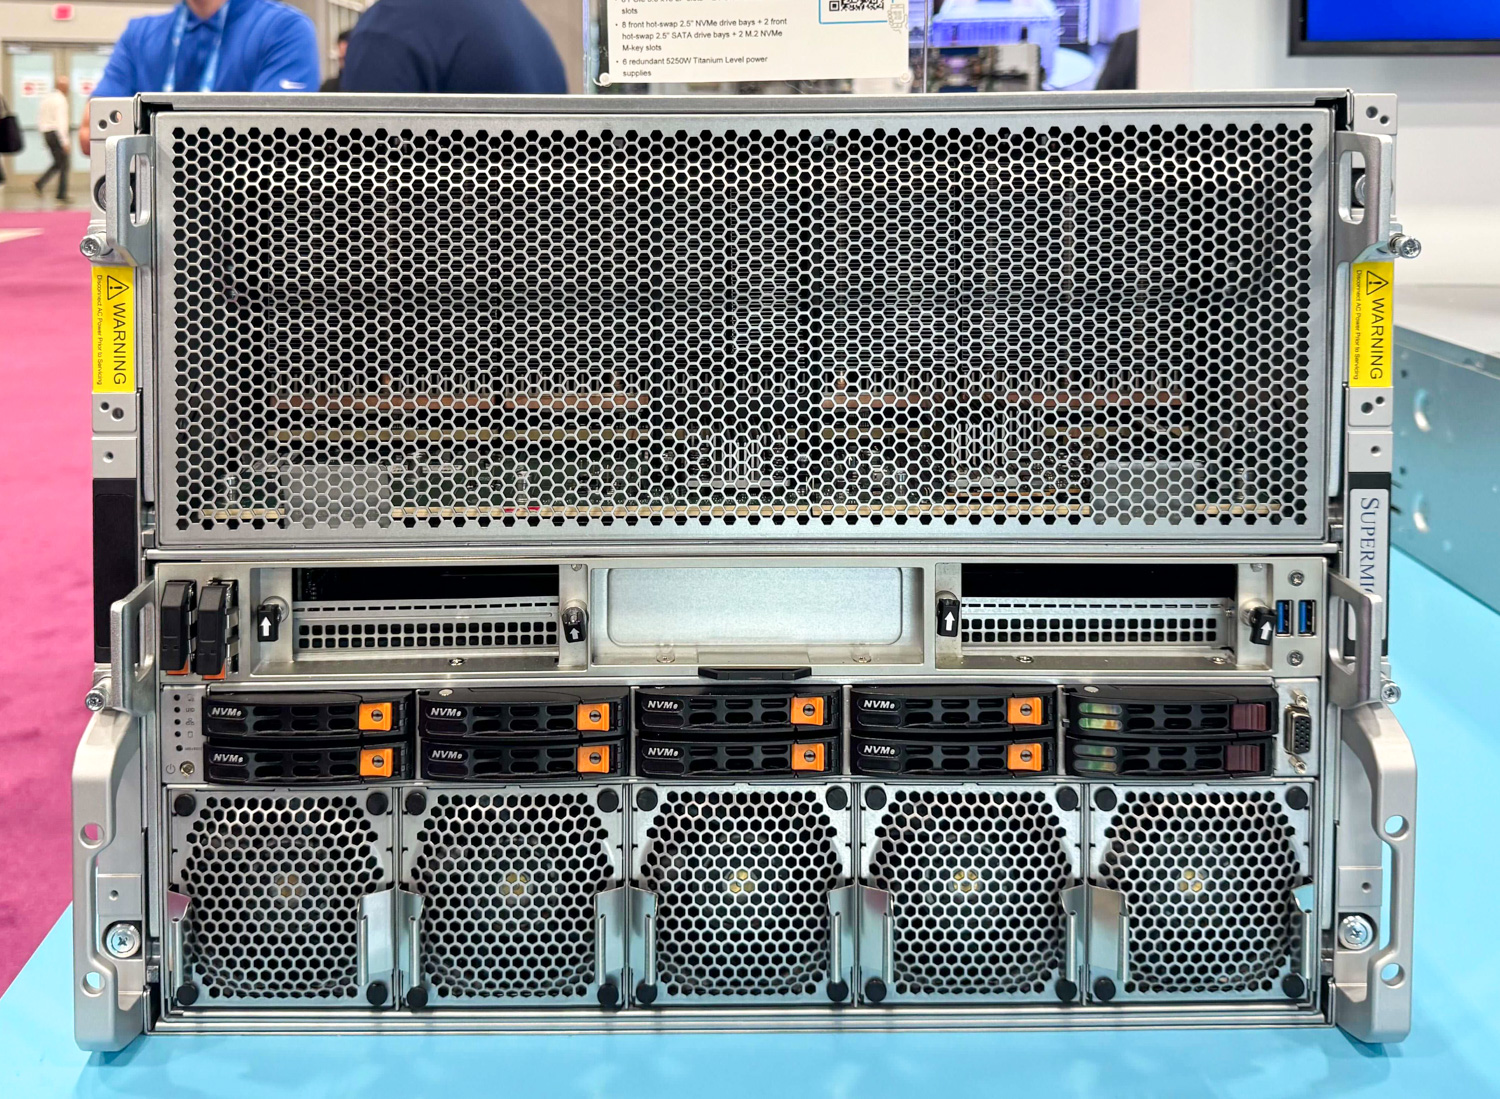
AMD Instinct MI350X GPU များပါရှိသော Supermicro H14 ဆာဗာ၊ ပန်ကာနံရံနှင့် NVMe drive bay များကိုပြသထားသော ရှေ့မြင်ကွင်း
AI  ◇  စီးပွားရေးလုပ်ငန်း

Supermicro JumpStart သုံးသပ်ချက်- AMD Instinct MI350X ပါရှိသော H14

Supermicro ရဲ့ JumpStart ပရိုဂရမ်ဟာ AI အခြေခံအဆောက်အအုံအတွက် ဝယ်ယူမှုမတိုင်မီ အကဲဖြတ်ကိရိယာတန်ဆာပလာတွေမှာ အသုံးဝင်ဆုံးကိရိယာတွေထဲက တစ်ခုအဖြစ် ထင်ရှားလာခဲ့ပါတယ်။ မျှဝေအသုံးပြုတဲ့ပတ်ဝန်းကျင်မှာ scripted demo အစား JumpStart ဟာ အရည်အချင်းပြည့်မီတဲ့အသုံးပြုသူတွေကို SSH၊ IPMI နဲ့ VNC မှတစ်ဆင့် အစစ်အမှန်ထုတ်လုပ်မှုဆာဗာတွေကို အခမဲ့၊ အချိန်အကန့်အသတ်နဲ့ bare-metal access ပေးတာကြောင့် တကယ့် hardware ပေါ်မှာ workload တွေကို လုပ်ဆောင်နိုင်စေပါတယ်။

Supermicro JumpStart X14 B200 စနစ်
AI  ◇  စီးပွားရေးလုပ်ငန်း

Supermicro JumpStart ပြန်လည်သုံးသပ်ခြင်း- NVIDIA HGX B200 ဖြင့် တစ်ပတ်

ကျွန်ုပ်တို့သည် AI ပလပ်ဖောင်းဆုံးဖြတ်ချက်များကို မည်မျှအမြန်နှုန်းဖြင့် အဝေးမှသတ္တုဗလာဖြင့်ဝင်ရောက်ကြည့်ရှုနိုင်သည်ကိုကြည့်ရှုရန် Supermicro JumpStart မှတစ်ဆင့် HGX B200 ကို တစ်ပတ်ကြာစမ်းသပ်ခဲ့သည်။

AI  ◇  စီးပွားရေးလုပ်ငန်း

ပင်လယ်ရှိ AI - အော်ရီဂွန်ပြည်နယ်သည် သမုဒ္ဒရာကို အချိန်နှင့်တပြေးညီ လေ့လာရန် ရွက်လွှင့်ခဲ့သည်။

Oregon State သည် ပင်လယ်ပြင်တွင် plankton အချက်အလက်များကို အချိန်နှင့်တပြေးညီ ခွဲခြမ်းစိတ်ဖြာရန်အတွက် GPU၊ compute နှင့် dense NVMe တို့ဖြင့် AI သမုဒ္ဒရာသုတေသနကို မြှင့်တင်နေပါသည်။

AI  ◇  စီးပွားရေးလုပ်ငန်း

Omniverse အတွက် NVIDIA L40S: OpenUSD မြင်ကွင်းများမှ ရူပဗေဒ-အသိပညာရှိသော ကမ္ဘာ့မော်ဒယ်များအထိ

L40S သည် အထူးသဖြင့် synthetic data generation၊ multimodal AI ဖွံ့ဖြိုးတိုးတက်မှုနှင့် computing နှင့် graphics စွမ်းဆောင်ရည် နှစ်မျိုးလုံး လိုအပ်သော Omniverse application များအတွက် အဖိုးတန်ပါသည်။