

၂၀၂၆ ခုနှစ်၊ အောက်တိုဘာလ ၂၉ ရက်နေ့တွင် အပ်ဒိတ်လုပ်ခဲ့သည်- Dell XPS 16 Creator Edition သည် RTX Spark အပိုင်းတွင် ၎င်း၏ new-suite ရလဒ်များနှင့်အတူ Also Tested နှင့် ပူးပေါင်းခဲ့သည်။ ရွေးချယ်မှုများ မပြောင်းလဲပါ။ အောက်တိုဘာလ ၂၆ ရက်နေ့တွင် Lenovo ThinkPad P1 Gen 9 သည် ၎င်း၏ new-suite MLPerf Client ရလဒ်များနှင့်အတူ Also Tested နှင့် ပူးပေါင်းခဲ့သည်။
ဤနေရာတွင် အဆင့်သတ်မှတ်ထားသော လက်တော့ပ်တိုင်းသည် StorageReview ဓာတ်ခွဲခန်းမှတစ်ဆင့် ရရှိခဲ့ခြင်းဖြစ်သည်။ ကျွန်ုပ်တို့သည် ဒေသတွင်း AI စွမ်းဆောင်ရည်ကို တိုက်ရိုက်တိုင်းတာသည်- UL Procyon AI Text Generation သည် ၎င်းတို့ကို သိမ်းဆည်းထားနိုင်သော စနစ်တိုင်းတွင် တူညီသော မော်ဒယ်များကို အသုံးပြုပြီး ဟာ့ဒ်ဝဲက သင့်လျော်သည့်နေရာတွင် LM Studio နှင့် Ollama တို့ဖြင့် ပိုမိုနက်ရှိုင်းစွာ လုပ်ဆောင်ပါသည်။ ဤစာမျက်နှာရှိ မည်သည့်အရာမျှ spec sheet မှ အဆင့်သတ်မှတ်ထားခြင်းမရှိဘဲ ရွေးချယ်မှုတိုင်းသည် ဒေတာသိမ်းဆည်းထားသော သုံးသပ်ချက်နှင့် ချိတ်ဆက်ထားသည်။
၂၀၂၆ ခုနှစ်တွင် လက်ပ်တော့တွင် AI မော်ဒယ်များကို လည်ပတ်ရန် နည်းလမ်းနှစ်ခုရှိပါသည်။ သီးခြား NVIDIA RTX PRO GPU များသည် တစ်စက္ကန့်လျှင် အမြန်ဆုံးတိုကင်များကို ပေးစွမ်းနိုင်သော်လည်း မော်ဒယ်သည် ကတ်၏ VRAM အတွင်း၊ ဤနယ်ပယ်တစ်လျှောက်တွင် 8GB မှ 24GB အထိ တပ်ဆင်နိုင်ရမည်။ AMD ၏ Ryzen AI Max+ (Strix Halo) နှင့် Intel ၏ Core Ultra shared LPCAMM2 ပလက်ဖောင်းများမှ ဦးဆောင်သော ပေါင်းစည်းထားသော နှင့် မျှဝေထားသော မှတ်ဉာဏ်ဒီဇိုင်းများသည် စွမ်းရည်အတွက် အရင်းအနှီးအမြန်နှုန်းကို လဲလှယ်ကြသည်- GPU သည် စနစ်မှတ်ဉာဏ်အများစုကို ငှားရမ်းနိုင်ပြီး၊ ယခုအချိန်အထိ ပိုကြီးသော မော်ဒယ်များသည် load လုပ်နိုင်သည်။ အောက်ဖော်ပြပါ ရွေးချယ်မှုများသည် လမ်းနှစ်လမ်းလုံးအပြင် NPU-first စွမ်းဆောင်ရည်အတန်းအစားကိုလည်း လွှမ်းခြုံထားသည်။
တစ်တစ်ချက်မှာ
| အမျိုးအစား | စံနစ် | AI အအင်ဂျင် | အဓိကရလဒ် | အပြည့်အဝပြန်လည်ဆန်းစစ်ခြင်း |
|---|---|---|---|---|
| ဒေသတွင်း AI အတွက် အကောင်းဆုံး Laptop | Dell Pro Max 18 Plus | RTX PRO 5000 Blackwell 24GB / 128GB CAMM2 | 185 tok/s (Phi, Procyon)၊ ကျွန်ုပ်တို့စမ်းသပ်ဖူးသမျှတွင် အမြန်ဆုံးလက်တော့ပ် | Pro Max 18 Plus သုံးသပ်ချက် |
| မော်ဒယ်ကြီးများအတွက် အကောင်းဆုံး | HP ZBook Ultra G1a 14 | Ryzen AI Max+ PRO 395၊ 96GB အထိ သတ်မှတ်နိုင်သော ပေါင်းစည်းမှတ်ဉာဏ် | DeepSeek-R1 70B ကို တင်ပြီးပါပြီ။ Gemma 3 27B ကို 9 tok/s ဖြင့် တင်ထားပါသည်။ | ZBook Ultra G1a သုံးသပ်ချက် |
| အကောင်းဆုံး ၁၆ လက်မ ချိန်ခွင်လျှာညှိခြင်း | Dell Pro Max 16 Plus | RTX PRO 5000 Blackwell 24GB / 128GB CAMM2 | ဘက်ထရီ ၆ နာရီ ၂၁ မိနစ်ဖြင့် ၁၇၉ tok/s (Phi) | Pro Max 16 Plus သုံးသပ်ချက် |
| အကောင်းဆုံး Ultraportable | Lenovo ThinkPad P14s မျိုးဆက် ၄ | RTX PRO 1000 Blackwell 8GB / 64GB LPCAMM2 | ၃.၅၉ ပေါင်တွင် ၅၅ tok/s (Phi) | P14s Gen 7 သုံးသပ်ချက် |
| Discrete GPU မပါဝင်တာ အကောင်းဆုံးပါပဲ | Dell Pro Precision 5 14s Intel | Intel Arc Pro B390 iGPU၊ 64GB မျှဝေထားသော LPCAMM2 | 8GB VRAM ထက်ကျော်လွန်သော မော်ဒယ်များကို အသုံးပြုခဲ့ပြီး ဘက်ထရီ ၂၃ နာရီ ၅၀ မိနစ် အသုံးပြုခဲ့သည်။ | Pro Precision 5 14s သုံးသပ်ချက် |
| အကောင်းဆုံး ပါးလွှာပေါ့ပါးသော NPU စနစ် | HP EliteBook 6 G1q | Snapdragon X Plus၊ ၄၅ TOPS Hexagon NPU၊ ၃၂GB | LM Studio မှာ ၃၇ tok/s နှုန်းနဲ့ Llama 3.2 3B | EliteBook 6 G1q သုံးသပ်ချက် |
| အကောင်းဆုံး RTX Spark လက်တော့ပ် | HP OmniBook Ultra 16 | RTX Spark N1X၊ 20-core CPU / 6,144-core Blackwell GPU၊ 128GB (GPU အတွက် 64GB) | 35B coding agent လုပ်ငန်းကို 72.0 s အတွင်း 89.5 tok/s ဖြင့် လုပ်ဆောင်ခဲ့ပြီး၊ 3 ကြိမ်တွင် 3 ကြိမ် အောင်မြင်ခဲ့သည်။ | OmniBook Ultra 16 သုံးသပ်ချက် |
| အကောင်းဆုံးလည်ပတ်နေတဲ့ RTX Spark Laptop | Lenovo Yoga 9n 2-in-1 16 | RTX Spark N1X၊ 20-core CPU / 6,144-core Blackwell GPU၊ 64GB (GPU အတွက် 32GB) | မိနစ် ၃၀ ကြာ ကြာရှည်ခံ ဝန်အားအတွင်း အမြင့်ဆုံးအပူချိန် ၇၂ ဒီဂရီစင်တီဂရိတ်ရှိပြီး HP OmniBook Ultra 16 တွင် ၉၈ ဒီဂရီစင်တီဂရိတ်ရှိသည်။ | Yoga 9n 2-in-1 16 ခု သုံးသပ်ချက် |
ရွေးချယ်မှုများ
ဒေသတွင်း AI အတွက် အကောင်းဆုံး Laptop: Dell Pro Max 18 Plus
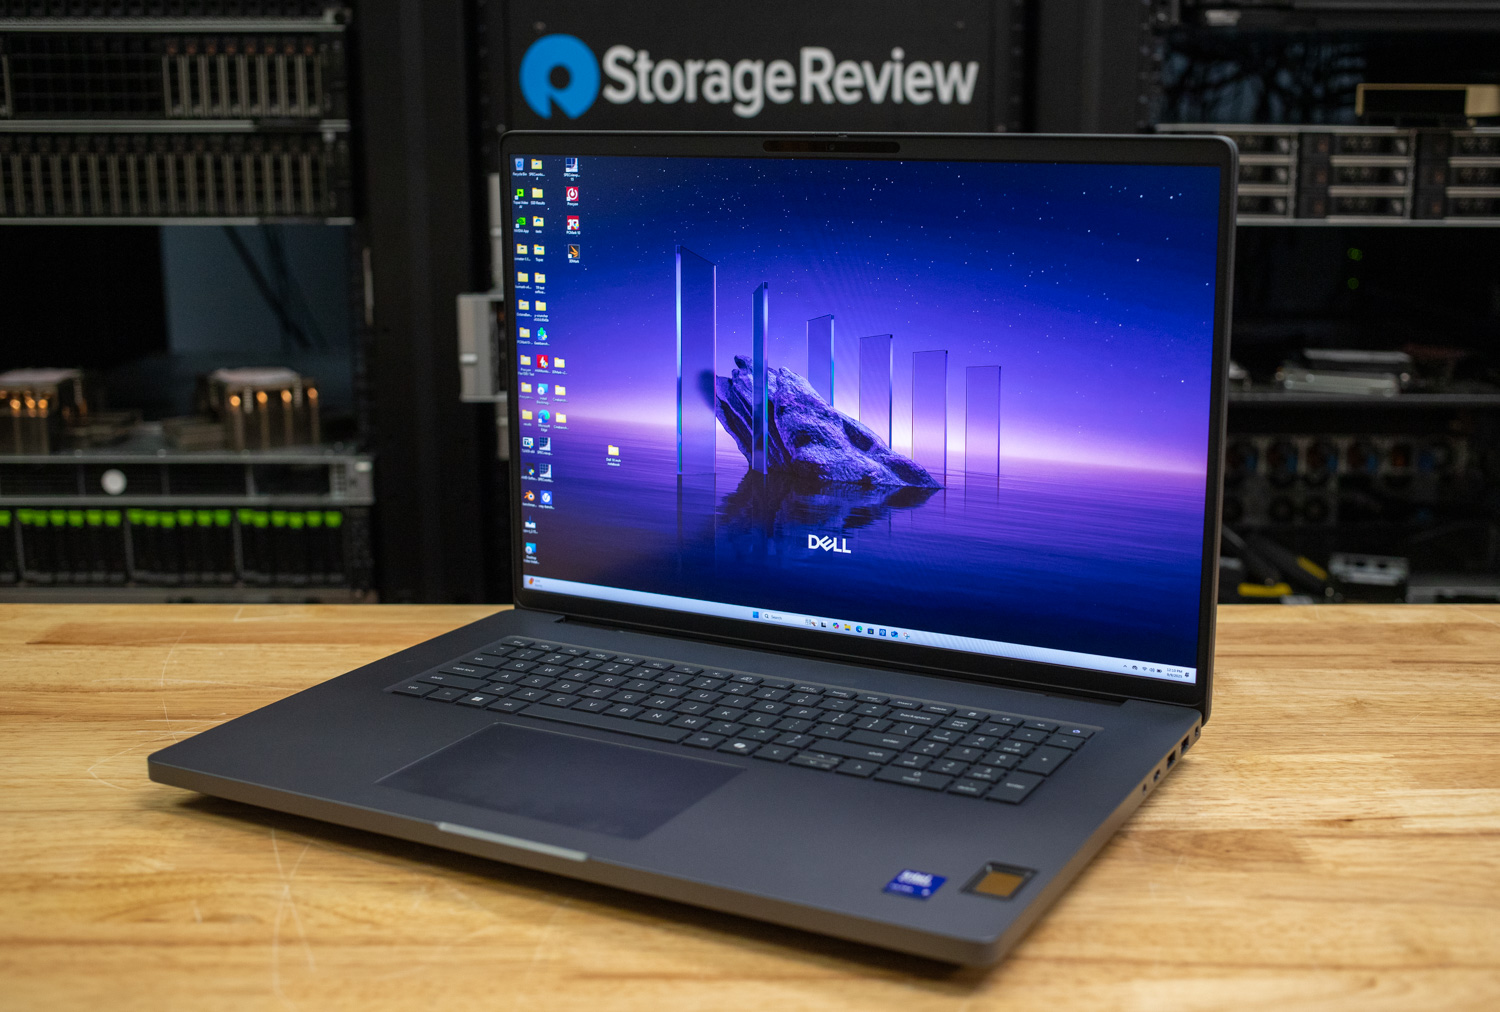
Pro Max 18 Plus သည် StorageReview ဓာတ်ခွဲခန်းမှတစ်ဆင့် မည်သည့်လက်တော့ပ်တွင်မဆို အမြန်ဆုံး ဒေသတွင်း AI နံပါတ်များကို တင်ခဲ့သည်။ UL Procyon AI Text Generation တွင် ၎င်း၏ RTX PRO 5000 Blackwell (24GB GDDR7) သည် Phi ကို တစ်စက္ကန့်လျှင် 185.1 တိုကင်၊ Mistral ကို 140.5 နှင့် Llama 3 ကို 119.7 အထိ တွန်းပို့ခဲ့ပြီး ပထမဆုံးတိုကင်ရရှိရန် အချိန်က မော်ဒယ်တိုင်းတွင် 0.35 စက္ကန့်အောက်သာရှိသည်။ Core Ultra 9 285HX နှင့် 128GB CAMM2 မှတ်ဉာဏ်သည် ကျန်ရှိသော pipeline ကို လမ်းမှဖယ်ထားပြီး 24GB VRAM သည် 20B-class quantized မော်ဒယ်များကို အဆင်ပြေစွာ သိမ်းဆည်းထားသည်။
အပေးအယူလုပ်ရမယ့်အချက်တွေကတော့ ကိုယ်ထည်က ညွှန်ပြထားတဲ့အတိုင်းပါပဲ။ ပေါင် ၇.၁၇ အလေးချိန်နဲ့ ဘက်ထရီသက်တမ်း ၃ နာရီ ၃၉ မိနစ်ရှိပြီး ကျွန်တော်တို့ရဲ့ လက်တော့ပ်ဒေတာစုထဲမှာ အတိုဆုံး လည်ပတ်ချိန်ပါ။ ဒါက ခေါက်လို့ရတဲ့ စားပွဲဘေးစက်တစ်လုံးပါ။ ပြန်လည်သုံးသပ်ချိန်မှာ စမ်းသပ်ထားတဲ့အတိုင်း ဒေါ်လာ ၉,၂၄၅ နဲ့ စာရင်းသွင်းထားပါတယ်။ ဒေသတွင်း ကောက်ချက်ချမှုအမြန်နှုန်းက မေးခွန်းတစ်ခုလုံးဆိုရင် ဒါက အဖြေပါပဲ။
သုံးသပ်ချက်- Dell Pro Max 18 Plus: Blackwell RTX PRO 5000 စွမ်းဆောင်ရည် ကုန်ဆုံးသွားပါပြီ
မော်ဒယ်ကြီးတွေအတွက် အကောင်းဆုံး- HP ZBook Ultra G1a 14
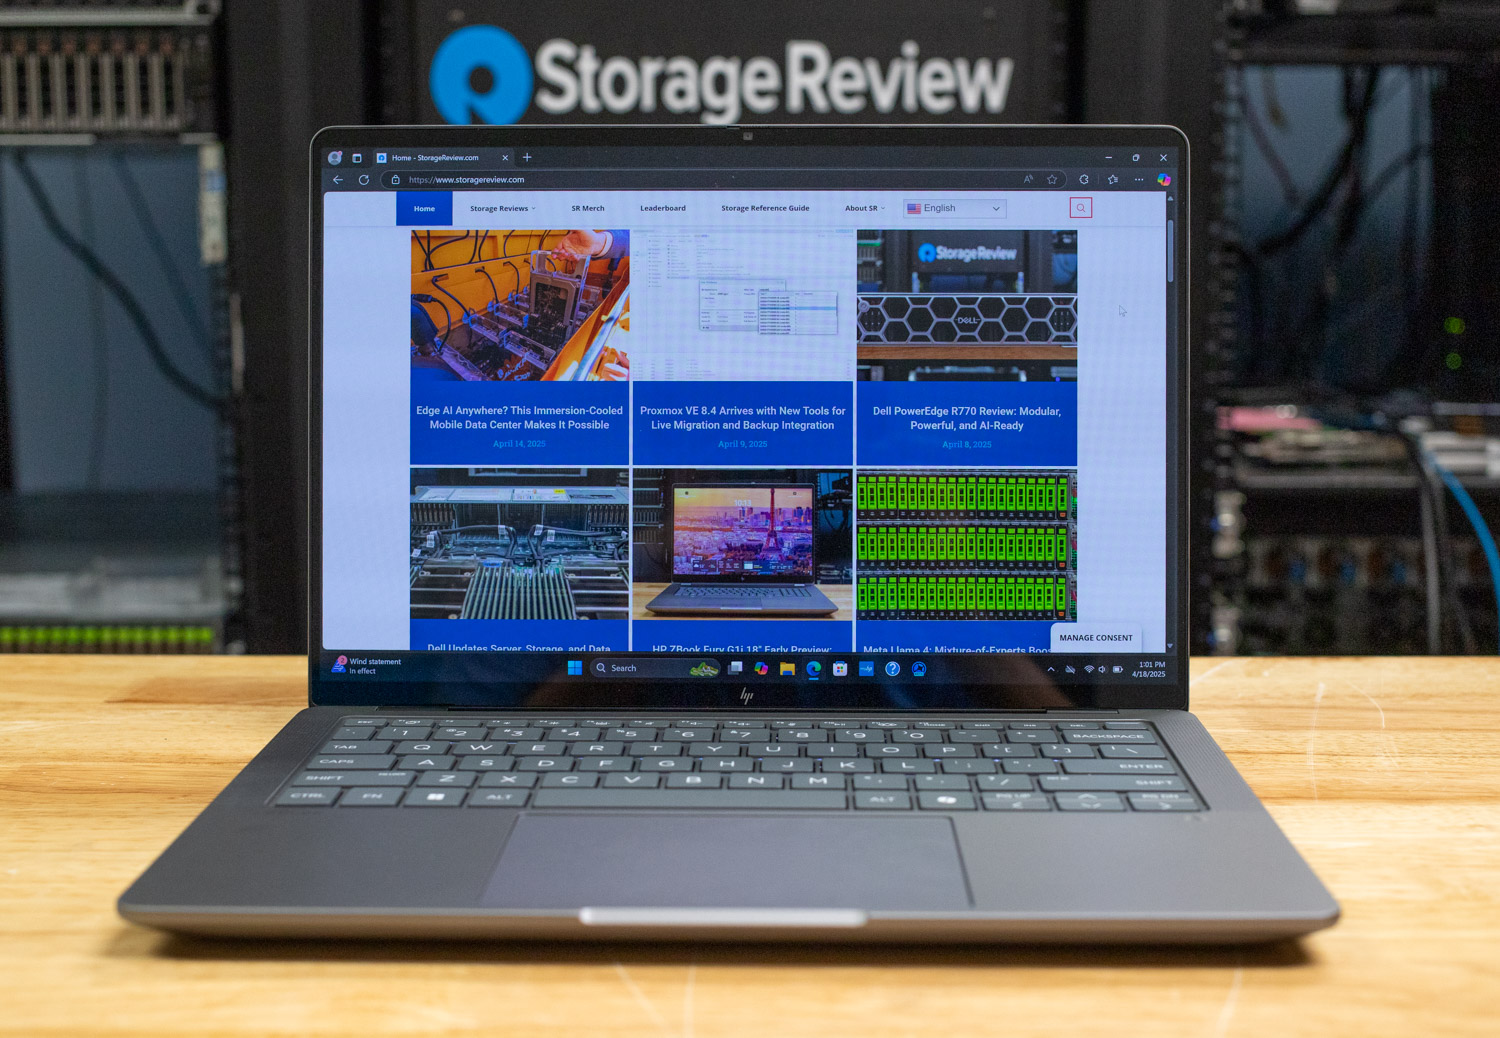
မြန်နှုန်းက ဝင်ရိုးတစ်ခုဖြစ်ပြီး စွမ်းရည်က အခြားဝင်ရိုးတစ်ခုပါ။ ZBook Ultra G1a သည် AMD ၏ Ryzen AI Max+ PRO 395 ကို 128GB LPDDR5X unified memory နှင့် တွဲဖက်ထားပြီး 96GB အထိကို Radeon 8060S GPU သို့ သတ်မှတ်ပေးနိုင်သည်။ ထို pool သည် discrete-GPU လက်ပ်တော့များ မထိတွေ့နိုင်သော မော်ဒယ်များကို load လုပ်ခွင့်ပြုသည်- DeepSeek-R1 70B နှင့် QwQ 32B နှစ်ခုစလုံးသည် LM Studio နှင့် Ollama တွင် ဒေသတွင်းတွင် run ထားပြီး Gemma 3 27B ကို တစ်စက္ကန့်လျှင် တိုကင် ၈.၉၆ ဖြင့် တစ်စက္ကန့်လျှင် တိုကင် ၇၃ ဖြင့် prompt processing ပြုလုပ်ပေးသည်။
၎င်း၏ Procyon နံပါတ်များသည် ဤနေရာတွင် RTX PRO စက်တိုင်းတွင် ရှိနေပြီး (တစ်စက္ကန့်လျှင် တိုကင် ၆၅ ဖြင့် Phi)၊ ထို့ကြောင့် ၎င်းသည် မော်ဒယ်ငယ်များတွင် မြန်ဆန်သော စကားပြောဆိုမှုအတွက် ရွေးချယ်မှုမဟုတ်ပါ။ မော်ဒယ်ကိုယ်တိုင်က အဓိကအချက်ဖြစ်သည့်အခါ ၎င်းသည် ရွေးချယ်မှုဖြစ်ပြီး ဘက်ထရီ ၁၀ နာရီ ၃၅ မိနစ်ဖြင့် ပေါင် ၃.၃ ဖြင့် လုပ်ဆောင်သည်။ ၎င်းသည် AMD ၏ Strix Halo သည် ကျွန်ုပ်တို့၏ desktop ဘက်ခြမ်းတွင် ၁၄ လက်မ ကိုယ်ထည်ထဲသို့ ခေါက်ထားသော unified-memory ဇာတ်လမ်းနှင့် အတူတူပင်ဖြစ်သည်။
သုံးသပ်ချက်- HP ZBook Ultra G1a 14 သုံးသပ်ချက်
မိုးကုပ်စက်ဝိုင်းပေါ်တွင်- HP ZBook Ultra G3a 16
အထက်ဖော်ပြပါ အကောင်းဆုံး မော်ဒယ်ကြီးများအတွက် ရွေးချယ်မှုသည် ယင်းကဏ္ဍကို ၎င်း၏ဆက်ခံသူထံ လွှဲပြောင်းပေးရန် နီးကပ်လာနိုင်သည်။ ZBook Ultra G3a 16 တွင် 192GB LPDDR5X-8533 unified memory ပါဝင်ပြီး GPU သို့ 160GB အထိ သတ်မှတ်နိုင်သည် (G1a 14 သည် အမြင့်ဆုံး 128GB နှင့် 96GB)၊ Ryzen AI Max+ PRO 495 နှင့် G1a တွင် 55W ရှိသည့် 100W ကို ထောက်ပံ့ပေးသည့် thermal ဒီဇိုင်းတို့ ပါဝင်ပါသည်။ ပါဝါဘတ်ဂျက်က ၎င်း၏အရှိန်ကို ကန့်သတ်ထားသော်လည်း စွမ်းရည်က G1a ကို ၎င်း၏ slot တွင် အနိုင်ယူခဲ့သည်။ G3a သည် နံပါတ်နှစ်ခုလုံးကို တစ်ပြိုင်နက်တည်း အနိုင်ယူခဲ့သည်။
HP က အောက်တိုဘာလမှာ အမေရိကန်မှာ မှာယူမှုတွေကို ဒေါ်လာ ၃၁၄၉ ကနေစပြီး configuration တွေနဲ့ ဖွင့်လှစ်ခဲ့ပြီး Procyon နဲ့ LM Studio အပြည့်အဝ လည်ပတ်နေချိန်မှာ G3a က အဆင့်သတ်မှတ်ချက်ထဲ ပါဝင်လာပါတယ်။ ကျွန်ုပ်တို့ရဲ့ လက်တွေ့စမ်းသပ်ချက် မှာ စွမ်းဆောင်ရည်စမ်းသပ်မှုကို ခွင့်မပြုထားတဲ့ pre-production unit ရဲ့ hardware ကို ပြသခဲ့ပြီး သင်္ဘောတင်ပို့တဲ့ unit ဓာတ်ခွဲခန်းကို ရောက်ရှိတဲ့အခါ အပြည့်အစုံ သုံးသပ်ချက်ကို ဖော်ပြပေးသွားမှာပါ။
အကောင်းဆုံး ၁၆ လက်မ ချိန်ခွင်လျှာညှိမှု- Dell Pro Max 16 Plus
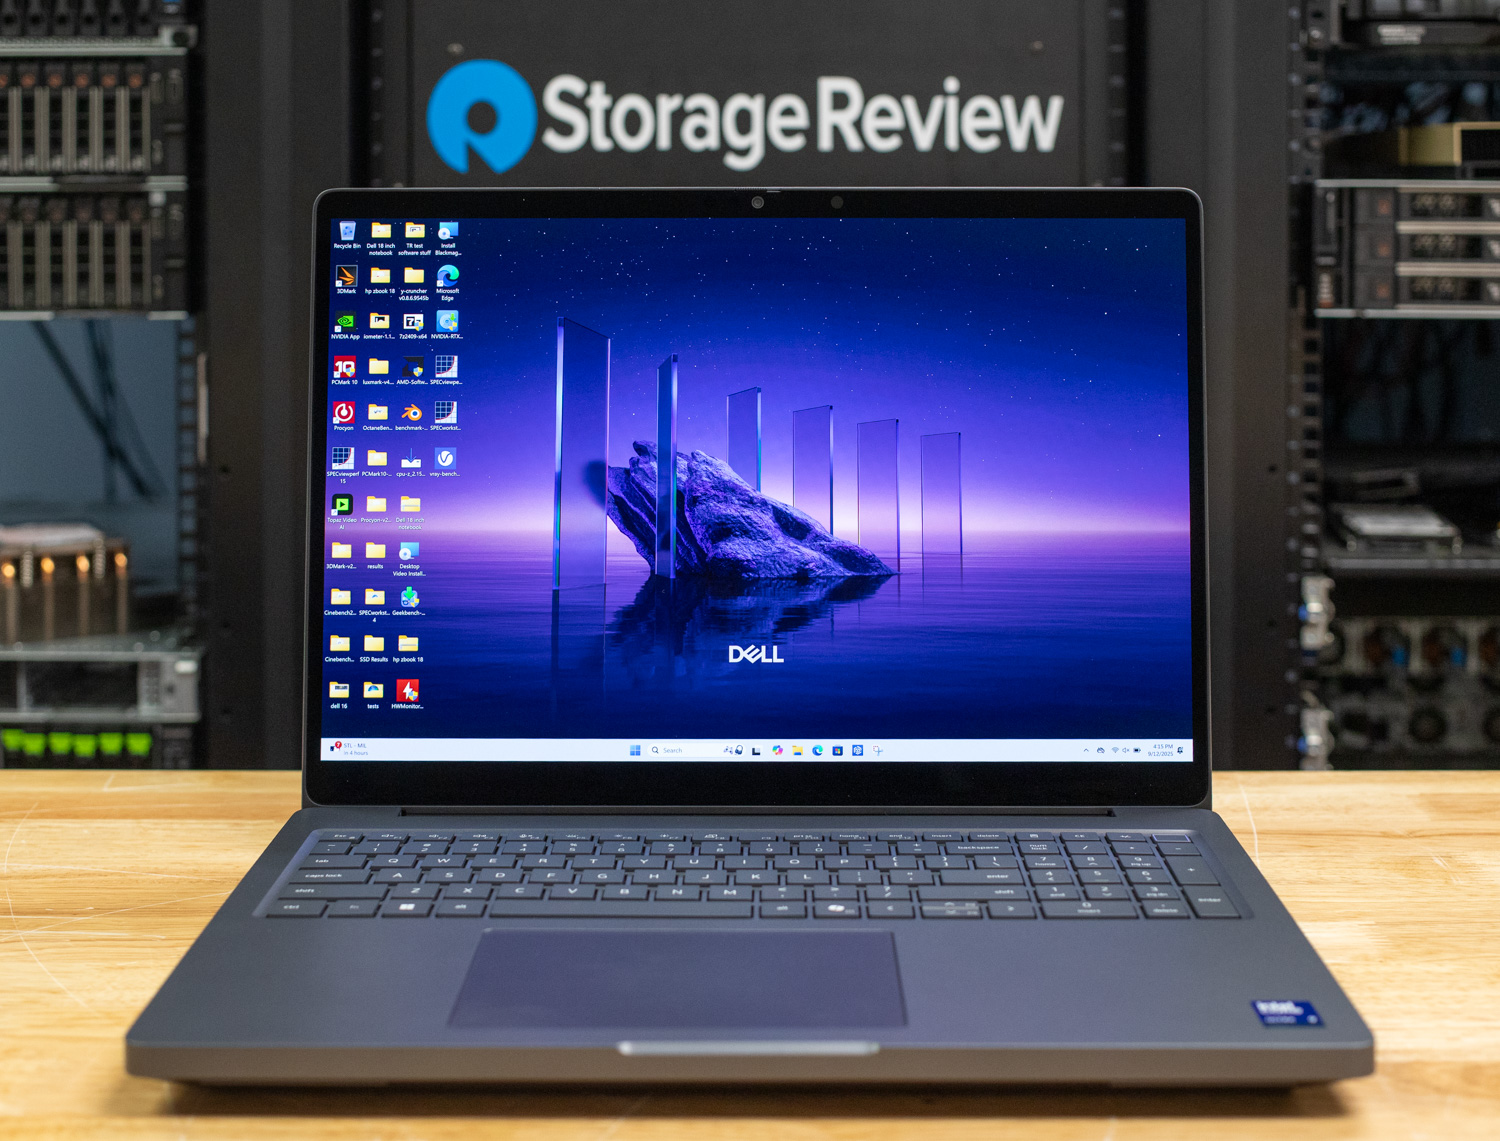
Pro Max 16 Plus မှာ 18 Plus လိုပဲ RTX PRO 5000 Blackwell 24GB ကို အသုံးပြုထားပြီး ဘာမှ မပေးသလောက်ပါပဲ- Phi က တစ်စက္ကန့်ကို 178.6 tokens၊ Mistral က 134.2 tokens၊ Llama 3 က 114.7 tokens ဖြစ်ပြီး flagship ရဲ့ throughput ရဲ့ ၉၆ ရာခိုင်နှုန်းလောက် ရှိပါတယ်။ လဲလှယ်မှုအရ 5.63 ပေါင်ကနေ စတင်ပြီး 7.17 ပေါင်နဲ့ စတင်ကာ ဘက်ထရီရဲ့ ၆ နာရီ ၂၁ မိနစ်မှာ ရလဒ်ကို နှစ်ဆနီးပါး မြင့်တက်စေပါတယ်။
ဒေသတွင်း ကောက်ချက်ချမှုကို အလေးအနက်ထားလိုသူအများစုအတွက် ဒါက နှစ်ခုထဲက ပိုကောင်းတဲ့ ဝယ်ယူမှုပါ။ ၎င်းသည် ကျွန်ုပ်တို့၏ အကောင်းဆုံး မိုဘိုင်း Workstations ဦးဆောင်သူစာရင်းတွင် အကောင်းဆုံး အလုံးစုံ မိုဘိုင်း Workstation နေရာကိုလည်း ရရှိထားသောကြောင့် AI အမြန်နှုန်းသည် အတည်ပြုပြီးသား အပြည့်အဝ ပရော်ဖက်ရှင်နယ် application stack နှင့်အတူ ပါလာပါသည်။
သုံးသပ်ချက်- Dell Pro Max 16 Plus သုံးသပ်ချက်- ရှည်လျားသောနေ့ရက်များနှင့် ကြီးမားသောအလုပ်များအတွက် တည်ဆောက်ထားသည်
အကောင်းဆုံး Ultraportable: Lenovo ThinkPad P14s Gen 7
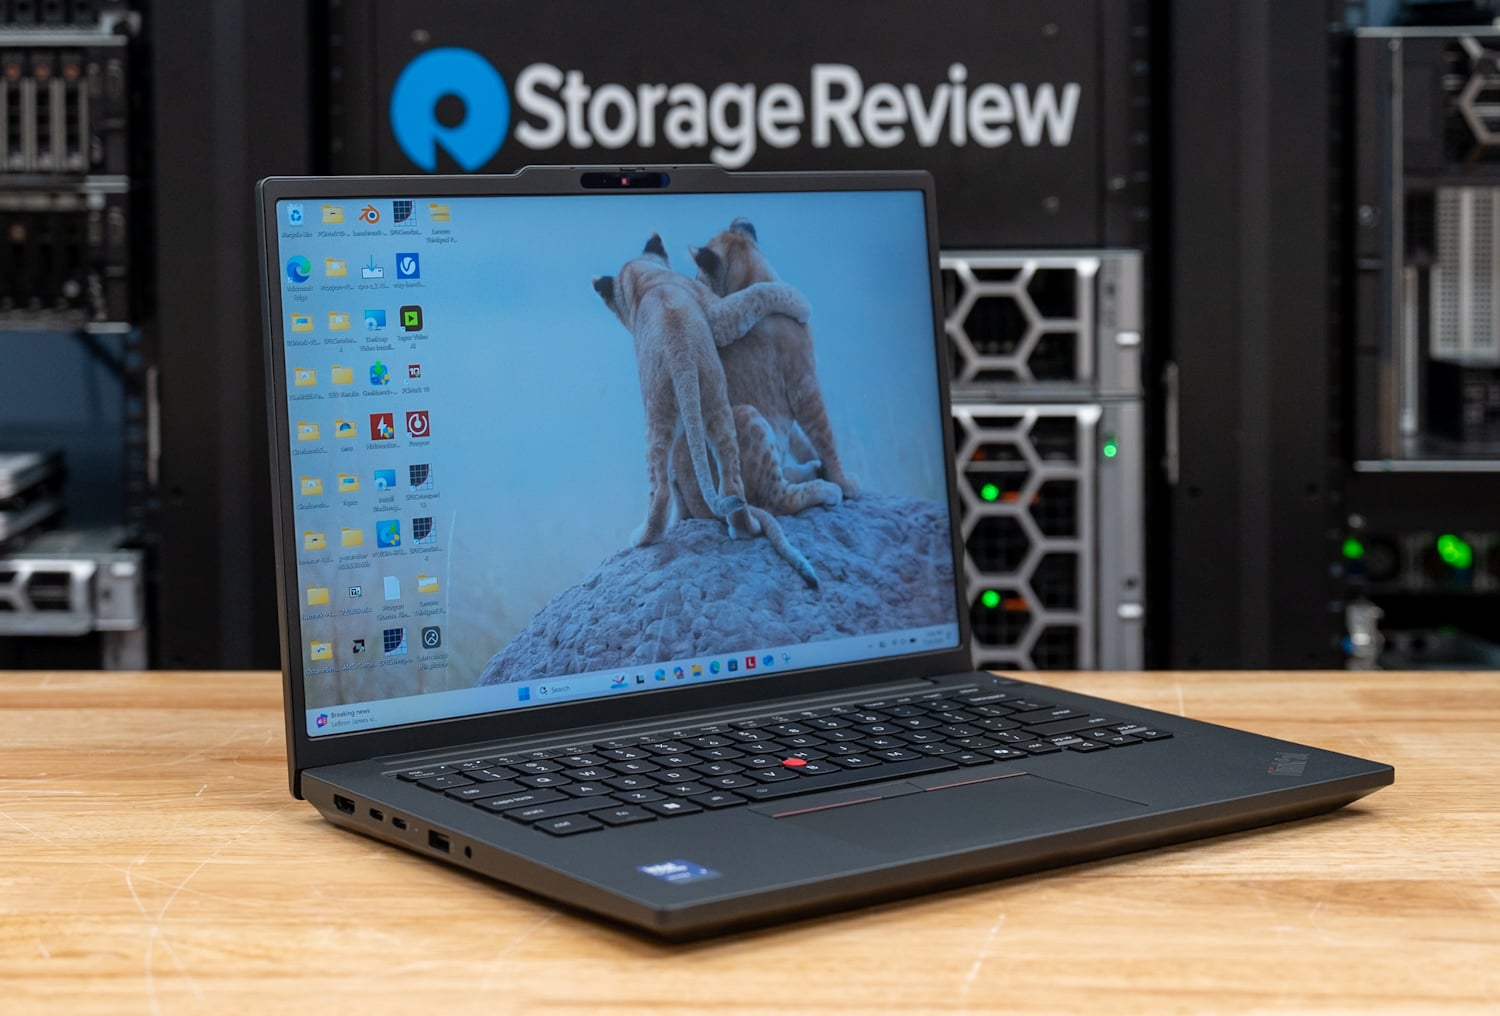
ပေါင် ၃.၅၉ ရှိတဲ့ P14s Gen 7 ဟာ discrete Blackwell GPU ပါဝင်တဲ့ အပေါ့ပါးဆုံး laptop ပါ။ RTX PRO 1000 (8GB GDDR7) က တစ်စက္ကန့်ကို 55.1 tokens နဲ့ Mistral က တစ်စက္ကန့်ကို 40.3 tokens နဲ့ Phi ကို turn လုပ်နိုင်ပြီး 7B-class မော်ဒယ်တွေအတွက် တကယ့် interactive speed တွေအပြင် Panther Lake ရဲ့ 50 TOPS NPU ကြောင့် Copilot+ စက်တစ်လုံး ဖြစ်လာပါတယ်။ ဘက်ထရီ ၁၅ နာရီ ၅၂ မိနစ် ခံတာကြောင့် AI စွမ်းရည်က တစ်နေ့လုံး အလုပ်ချိန် မကုန်ပါဘူး။
ဝယ်ယူခင်မှာ အမြင့်ဆုံးပမာဏကို သိထားပါ- ကျွန်တော်တို့ရဲ့ Llama 2 13B မော်ဒယ်က Procyon လမ်းကြောင်းကနေ ဂရပ်ဖစ်မှတ်ဉာဏ် 12GB လောက် လိုချင်ပြီး GPU မှာ 8GB ပါတဲ့အတွက် မအောင်မြင်ခဲ့ပါဘူး။ 7B နဲ့အောက် ပမာဏသတ်မှတ်ထားတဲ့ မော်ဒယ်တွေအတွက်ကတော့ ဒါက အရမ်းကောင်းတဲ့ ရွေးချယ်မှုပါပဲ။ ပိုကြီးတဲ့ မော်ဒယ်တွေအတွက်တော့ စာမျက်နှာကို ရှာကြည့်ပါ။
သုံးသပ်ချက်- Lenovo ThinkPad P14s Gen 7 သုံးသပ်ချက်
Discrete GPU မပါဘဲ အကောင်းဆုံး- Dell Pro Precision 5 14s Intel
discrete GPU မရှိတာက ပြဿနာမရှိပါဘူး၊ ကျိုးကြောင်းဆီလျော်ပါတယ်- Pro Precision 5 14s Intel က Core Ultra X9 388H (50 TOPS NPU) ကို Intel Arc Pro B390 integrated graphics နဲ့ 64GB LPCAMM2 shared memory pool ပေါ်မှာ တွဲဖက်အသုံးပြုပါတယ်။ ကျွန်ုပ်တို့ရဲ့ စမ်းသပ်မှုမှာ အဲဒီ pool ဟာ 8GB discrete card တွေထက် local AI workloads ပိုများတာကို လုပ်ဆောင်ခဲ့ပြီး VRAM ကန့်သတ်ချက်ရှိတဲ့ စနစ်တွေမှာ DNF တွေ တင်ထားတဲ့ Procyon AI Text Generation suite အပြည့်အစုံ (Phi မှာ ရမှတ် ၈၈၇ နဲ့ Llama 2 မှာ ရမှတ် ၇၈၆) ကို ပြီးမြောက်စေခဲ့ပါတယ်။
ထုတ်လုပ်မှုအမြန်နှုန်းက RTX PRO ဆီလီကွန်နဲ့ယှဉ်ရင် အသင့်အတင့်ပဲရှိတာကြောင့် နောက်ခံလက်ထောက်အလုပ်တွေမှာ အပြန်အလှန်တုံ့ပြန်မှုများတဲ့ session တွေနဲ့ ကိုက်ညီပါတယ်။ ကျန်တဲ့ package ရဲ့ ကျန်အပိုင်းကတော့ အံ့သြစရာပါပဲ- ပေါင် ၃.၁၂ နဲ့ ဘက်ထရီ ၂၃ နာရီ ၅၀ မိနစ် ခံပြီး ကျွန်ုပ်တို့ရဲ့ dataset တစ်ခုလုံးမှာ ဒုတိယအကြာဆုံးဖြစ်ပါတယ်။ ဒါ့အပြင် ကျွန်ုပ်တို့ရဲ့ အကောင်းဆုံး မိုဘိုင်း Workstations ဘုတ်အဖွဲ့မှာ အကောင်းဆုံး Ultraportable Workstation နေရာကိုလည်း ရရှိထားပါတယ်။
ပြန်လည်သုံးသပ်ချက်- Dell Pro Precision 5 14s Intel ပြန်လည်သုံးသပ်ချက်
အကောင်းဆုံး ပါးလွှာပေါ့ပါးသော NPU စနစ်- HP EliteBook 6 G1q
EliteBook 6 G1q က မေးခွန်းတစ်ခုကို ဖြေဆိုပေးပါတယ်- အသုံးဝင်တဲ့ on-device AI အတွက် စက်သေးသေးလေး ဘယ်လောက်လိုအပ်လဲ။ ၄၅ TOPS Hexagon NPU ပါတဲ့ Snapdragon X Plus မှာ Llama 3.2 3B ကို တစ်စက္ကန့် ၃၆.၇ တိုကင်နဲ့ LM Studio မှာ Gemma 3 4B ကို ၂၉.၃ တိုကင်နဲ့ လည်ပတ်ပြီး 1B မော်ဒယ်တွေက တစ်စက္ကန့်ကို ၆၂ တိုကင်နဲ့ အများဆုံးရခဲ့ပါတယ်။ ဒါတွေက ဘက်ထရီ ၁၉ နာရီ ၃၅ မိနစ် ခံတဲ့ ပေါင် ၃.၁၇ အလေးချိန်ရှိတဲ့ စက်ကနေ အသုံးပြုနိုင်တဲ့အချိန် chat speed တွေပါ။
ကန့်သတ်ချက်က နည်းပြီး ကျွန်တော်တို့ စမ်းသပ်ခဲ့တဲ့ အကြီးဆုံး မော်ဒယ်က 4B parameters ဖြစ်တာကြောင့် ဒါက local chat၊ summarization နဲ့ offline assistant တွေအတွက်ဖြစ်ပြီး လေးလံတဲ့ မော်ဒယ်တွေကိုတော့ မသုံးနိုင်ပါဘူး။ ပြန်လည်သုံးသပ်ချက်မှာ configure လုပ်ထားတဲ့အတိုင်း $3,100 ဝန်းကျင်နဲ့ ဒီစာမျက်နှာမှာ အသက်သာဆုံး စနစ်လည်း ဖြစ်ပါတယ်။
ပြန်လည်သုံးသပ်ချက်- ပေါ့ပါးသော Laptop တွင် တစ်နေကုန် စွမ်းဆောင်ရည်
RTX Spark Laptop များ- ကျွန်ုပ်တို့၏ Client Suite အသစ်တွင် စမ်းသပ်ပြီးပါပြီ
NVIDIA ရဲ့ RTX Spark N1X ဟာ DGX Spark ကနေ GB10 superchip ကို Windows လက်တော့ပ်တွေဆီ ယူဆောင်လာပြီး Grace CPU နဲ့ Blackwell GPU ကြားမှာ LPDDR5X တစ်ခုကို မျှဝေထားပါတယ်။ လက်တော့ပ်တွေမှာ 45 မှ 80W TDP ရှိတဲ့ မျိုးကွဲနှစ်ခု ရရှိနိုင်ပါတယ်- 6,144-core GPU ပါတဲ့ 20-core CPU နဲ့ 5,120-core GPU ပါတဲ့ 18-core CPU တို့ ဖြစ်ပါတယ်။ ဒီစနစ်တွေကို ကျွန်ုပ်တို့ရဲ့ Arm64-native client suite အသစ်ဖြစ်တဲ့ sr-client 1.2 မှာ စမ်းသပ်ပါတယ်၊ ဒါကြောင့် သူတို့ရဲ့ ရလဒ်တွေဟာ အထက်က ရွေးချယ်မှုတွေနောက်ကွယ်က Procyon နံပါတ်တွေနဲ့ တစ်တန်းတည်း တူညီမှု မရှိပါဘူး။ ကျွန်ုပ်တို့ရဲ့ RTX Spark မိတ်ဆက်ပွဲမှာ platform အသေးစိတ် အချက်အလက် အပြည့်အစုံ ပါဝင်ပါတယ်။
မှတ်ဉာဏ်က configuration တစ်ခုစီမှာ ဘယ်မော်ဒယ်တွေ run နိုင်မလဲဆိုတာ ဆုံးဖြတ်ပေးပါတယ်။ firmware setting က Windows နဲ့ GPU ကြားမှာ pool ကို ပိုင်းခြားပေးပြီး ကျွန်ုပ်တို့ရဲ့ အသေးဆုံး local AI model tier က GPU အသုံးပြုနိုင်တဲ့ memory အနည်းဆုံး 16GB လိုအပ်တာကြောင့် GPU အတွက် 12GB လို့ သတ်မှတ်ထားတဲ့ 32GB system က 12.8GB gpt-oss:20b ကို load လုပ်လို့မရပါဘူး။
အကောင်းဆုံး RTX Spark လက်ပ်တော့- HP OmniBook Ultra 16
128GB OmniBook Ultra 16 ဟာ ကျွန်တော်တို့ စမ်းသပ်ဖူးသမျှထဲမှာ အပြည့်စုံဆုံး RTX Spark notebook ပါ။ GPU-usable memory 62.5GB ပါရှိတာကြောင့် ကျွန်တော်တို့ရဲ့ local AI model tiers နှစ်ခုလုံးကို run နိုင်ပြီး gpt-oss:20b ကို တစ်စက္ကန့်ကို 58.0 tokens နဲ့ Qwen3.6-35B-A3B ကို 89.5 မှာ generate လုပ်နိုင်ပါတယ်။ coding agent ကိုးခုလုံးကို အောင်မြင်ခဲ့ပြီး Qwen3.6 task ကို 72.0 စက္ကန့်အတွင်း အပြီးသတ်နိုင်ခဲ့ပြီး ၎င်းဟာ ၎င်းအုပ်စုထဲမှာ အမြန်ဆုံးဖြစ်ပါတယ်။ ဒါ့အပြင် Surface Laptop Ultra unit နှစ်ခုကို power ပေးခဲ့တဲ့ all-core OpenBLAS solve ကို 98 C မှာ အပြီးသတ်နိုင်ခဲ့ပါတယ်။
Cinebench 2026 multi-core မှာ 7,004 မှတ်ရခဲ့ပြီး အဲဒီနှိုင်းယှဉ်မှုမှာ ထိပ်တန်း CPU ရလဒ်ဖြစ်ပြီး Razer Blade 16 ထက် ၃၅ ရာခိုင်နှုန်း ပိုများပါတယ်။ Blade ရဲ့ RTX 5090 ဟာ 24GB မော်ဒယ်တွေမှာ token တွေကို ၂.၃ ဆ ပိုမြန်အောင် ထုတ်လုပ်ပေးနိုင်ပြီး coding agent က shared GPU မှာ လည်ပတ်နေချိန်မှာ OmniBook ရဲ့ browser က ၁.၇၃ ဆ နှေးကွေးသွားပါတယ်။ ကျွန်ုပ်တို့ စမ်းသပ်ထားတဲ့ 128GB, 2TB build ကို HP.com မှာပဲ ရောင်းချပြီး အောက်တိုဘာလ ၁၄ ရက်နေ့အထိ HP က ဒေါ်လာ ၆,၂၂၉.၉၉ နဲ့ ရောင်းချခဲ့ပါတယ်။ ဒေါ်လာ ၃,၁၉၉.၉၉ 32GB မော်ဒယ်ကတော့ CPU မြန်နှုန်းကို ထိန်းသိမ်းထားပေမယ့် ကျွန်တော်တို့ရဲ့ မော်ဒယ်အဆင့်တွေကို load မလုပ်နိုင်ပါဘူး။ ဘက်ထရီရလဒ်တွေကိုလည်း စောင့်ဆိုင်းနေဆဲပါ။
အကောင်းဆုံး RTX Spark Laptop: Lenovo Yoga 9n 2-in-1 16
Yoga 9n 2-in-1 16 ဟာ ကျွန်တော်တို့စမ်းသပ်ဖူးသမျှ RTX Spark notebook တွေထက် N1X ကို ပိုအေးအောင် မောင်းနှင်နိုင်ခဲ့ပါတယ်။ မိနစ် ၃၀ ကြာ ကြာရှည်ခံတဲ့ loop အတွင်းမှာ CPU ဟာ 72°C မှာ အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး 3,015MHz နှုန်းနဲ့ ထိန်းထားနိုင်ခဲ့ပြီး ပထမဆုံးဖြတ်သန်းမှုရဲ့ 100.1 ရာခိုင်နှုန်းနဲ့ ပြီးဆုံးခဲ့ပါတယ်။ HP OmniBook Ultra 16 နဲ့ Surface Laptop Ultra တို့ဟာ 98°C မှာ ရှိနေပြီး Lenovo Pro 9n 15 ကတော့ 92°C မှာ အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး ဒီစနစ်တွေက ဖော်ထုတ်ပေးတဲ့ CPU sensor တစ်ခုတည်းသာ ဖြစ်ပါတယ်။ Lenovo က ကျယ်ဝန်းတဲ့ vents တွေ၊ မြင့်မားတဲ့ thermal bump နဲ့ လေဝင်ပေါက်တွေနောက်မှာ လေဝင်ပေါက်တွေ ရွေ့လျားနိုင်အောင် နေရာချန်ထားတဲ့ convertible hinge တို့ကို ထည့်သွင်းထားပါတယ်။
အအေးပေးစနစ် ချိန်ညှိမှုကြောင့် Yoga ဟာ HP နဲ့ ယှဉ်ရင် all-core မြန်နှုန်းကို လျော့ကျစေပါတယ်။ Multi-threaded ရလဒ်တွေက စမ်းသပ်မှုအများစုမှာ OmniBook ထက် ၄ ရာခိုင်နှုန်းကနေ ၁၀ ရာခိုင်နှုန်းအထိ နောက်ကျနေပြီး coding agent က browser ကို Yoga မှာ ၂.၄၄ ဆ နှေးကွေးစေပြီး HP မှာ ၁.၇၃ ဆ နှေးကွေးစေပါတယ်။ ၎င်းရဲ့ 64GB build က GPU 32GB ကို ပေးစွမ်းပြီး gpt-oss:20b အတွက် တစ်စက္ကန့်ကို ၅၈.၀ tokens နဲ့ လုံလောက်ပေမယ့် ကျွန်ုပ်တို့ရဲ့ 35B အဆင့်ထက် နည်းပါတယ်။ တက်ဘလက်အဖြစ် ဒါမှမဟုတ် ပေါင်ပေါ်မှာ တင်ဆောင်နိုင်တဲ့ ၁၆ လက်မ convertible အတွက်ကတော့ အဲဒီအရောင်းအဝယ်က ကျိုးကြောင်းဆီလျော်ပါတယ်။ စမ်းသပ်ထားတဲ့အတိုင်း $3,749.99 နဲ့ စာရင်းသွင်းထားပြီး ဘက်ထရီရလဒ်တွေကို စောင့်ဆိုင်းနေပါတယ်။
Lenovo Yoga 9n 2-in-1 16 ပြန်လည်သုံးသပ်ချက် - အကောင်းဆုံး RTX Spark Notebook
အသစ်ထွက် suite မှာလည်း စမ်းသပ်ပြီးပါပြီ-
- Dell XPS 16 Creator Edition64GB မန်မိုရီနှင့် 32GB GPU မျှဝေမှုပါရှိသော 20-core N1X။ ၎င်းသည် MLPerf Client တွင် တစ်စက္ကန့်လျှင် 55.7 တိုကင်နှုန်းဖြင့် Llama 3.1 8B ကို ထုတ်ပေးခဲ့ပြီး gpt-oss:20b coding agent ကို 58.5 ဖြင့် လုပ်ဆောင်ခဲ့ပြီး Qwen3.8 ကို 27B ဖြင့် အသုံးပြုသူရှစ်ဦးအား 31.9 ဖြင့် ပေးအပ်ခဲ့ပြီး local AI တွင် 128GB OmniBook ၏ 2 မှ 8 ရာခိုင်နှုန်းအတွင်း ပေးအပ်ခဲ့သည်။ ၎င်းသည် throttling မရှိဘဲ 98 C တွင် အပြည့်အဝ clocks များကို ထိန်းသိမ်းထားနိုင်ခဲ့ပြီး RTX Spark အုပ်စုတွင် အကောင်းဆုံး single-core နှင့် memory bandwidth ရလဒ်များကို တင်ခဲ့ပြီး ၎င်းတို့ထဲတွင် ဝန်ဆောင်မှုပေးရန် အလွယ်ကူဆုံးဖြစ်သည်။ ၎င်း၏ 30.5GB GPU ဘတ်ဂျက်သည် 35B agent အဆင့်မှ လွတ်မြောက်စေသည်။ Dell သည် ဤတည်ဆောက်မှုကို $4,799.99 ဖြင့် စာရင်းပြုစုထားသည်။
- လီနိုဗို ပရို ၉န် ၁၅: ပေါင် ၃.၆၄ အလေးချိန်ရှိတဲ့ ကိုယ်ထည်မှာ 32GB မန်မိုရီပါတဲ့ 18-core N1X။ Llama 3.1 8B ဟာ MLPerf Client မှာ တစ်စက္ကန့်ကို 55.1 တိုကင်နှုန်းနဲ့ လည်ပတ်ပြီး 12GB GPU ခွဲထုတ်မှုမှာပဲ 20-core N1X ရဲ့ ၂ ရာခိုင်နှုန်းအတွင်းမှာပဲ လည်ပတ်ပါတယ်။ ၎င်းရဲ့ မြင့်မားတဲ့ all-core clock တွေကြောင့် rendering နဲ့ compile လုပ်မှုမှာ 20-core အပိုင်းရဲ့ ၈ ရာခိုင်နှုန်းကနေ ၁၁ ရာခိုင်နှုန်းအတွင်း ရှိနေပြီး 93 C မှာ အမြင့်ဆုံးရောက်ရှိနေပါတယ်။ GPU အတွက် 12GB မှာ ကျွန်တော်တို့ရဲ့ model-load နဲ့ coding agent စမ်းသပ်မှုတွေမှာ မပါဝင်တာကြောင့် ဒေသခံ AI ဝယ်ယူသူတွေက မန်မိုရီ ပိုမို configure လုပ်သင့်ပါတယ်။ Lenovo က 18-core, 32GB, 512GB မော်ဒယ်အတွက် ဒေါ်လာ ၂,၉၉၉.၉၉ ကနေ စတင်ရောင်းချပါတယ်။
- စီးပွားရေးလုပ်ငန်းသုံး Microsoft Surface Laptop Ultra (စမ်းသပ်ပြီးသည့်အတိုင်း): 128GB ယူနစ်သည် gpt-oss:20b နှင့် Qwen3.6-35B-A3B ကို တစ်စက္ကန့်လျှင် တိုကင် ၅၈ မှ ၈၉ အထိ ထုတ်ပေးပြီး Cinebench 2026 multi-core တွင် ၆,၉၆၃ ရရှိခဲ့သည်။ ကျွန်ုပ်တို့၏ all-core OpenBLAS ဝန်အောက်တွင် ယူနစ်နှစ်ခု ပါဝါပိတ်ထားသောကြောင့် ၎င်းသည် စမ်းသပ်ပြီးသာ ပေါ်လာပါသည်။
RTX Spark စနစ်တိုင်းအတွက် ဘက်ထရီရလဒ်များသည် ကျွန်ုပ်တို့၏ cross-platform ဘက်ထရီစမ်းသပ်မှုအသစ်အပေါ်တွင် စောင့်မျှော်နေပါသည်။
စမ်းသပ်ပြီးပါပြီ
ဤစနစ်များသည် တူညီသောဓာတ်ခွဲခန်းလုပ်ငန်းစဉ်ကို ဖြတ်သန်းခဲ့ပြီး ယနေ့ခေတ်တွင် အမျိုးအစားတစ်ခုတွင် မရှိသော်လည်း မှန်ကန်သောဝယ်သူကို ရှာဖွေသင့်သည်။
- Lenovo ThinkPad P16 မျိုးဆက် ၂: အစုအဖွဲ့တွင် တတိယမြောက် RTX PRO 5000 စက် (Phi 141.2 tok/s)၊ ကျွန်ုပ်တို့၏ယူနစ်တွင် 32GB RAM ပါရှိပြီး ၎င်းသည် workflow ဇာတ်လမ်း၏ ကျန်အပိုင်းများကို တားဆီးထားသည်။
- HP ZBook Fury G1i 18Pro Max 18 Plus ကဲ့သို့ 24GB Blackwell GPU အမျိုးအစား အတူတူပင်ဖြစ်ပြီး၊ throughput (Phi တွင် 157.4 tok/s) တွင် နောက်တစ်ဆင့် နောက်ကျနေပြီး သုံးသပ်ချက်တွင် စမ်းသပ်ထားသည့်အတိုင်း $11,687 ဖြစ်သည်။
- Dell Pro Precision 7 16 Intel: ဤနယ်ပယ်တွင် အားအကောင်းဆုံး midrange GPU ရလဒ်ဖြစ်သည့် 12GB VRAM ပါသည့် RTX PRO 3000 Blackwell (DirectML မှတစ်ဆင့် Phi တွင် Procyon text generation ရမှတ် 2,244)၊ ၎င်း၏ 12GB သည် 8GB ကတ်များ မဆံ့သော 14B အတန်းကို ဖွင့်ပေးသည်။
- Lenovo ThinkPad P1 မျိုးဆက် ၂: RTX PRO 2000 8GB သည် ၄.၀၆ ပေါင်အလေးချိန်ရှိသော ကိုယ်ထည်တွင် ပါဝင်ပြီး ၁၂ နာရီ ၅၉ မိနစ် ဘက်ထရီ ခံသည်။ ၇၇.၃ tok/s ဖြင့် Phi ရှိသည်။
- Lenovo ThinkPad P1 မျိုးဆက် ၂: ကျွန်ုပ်တို့၏ client suite အသစ်တွင် စမ်းသပ်ထားပြီး၊ ၎င်း၏ 50W RTX PRO 2000 သည် MLPerf Client တွင် တစ်စက္ကန့်လျှင် 64.8 tokens ဖြင့် Llama 3.1 8B ကို ထုတ်ပေးပြီး၊ ကျွန်ုပ်တို့ စမ်းသပ်ဖူးသမျှတွင် အမြန်ဆုံး RTX PRO 2000 ဖြစ်ပြီး ထိုမော်ဒယ်တွင် RTX Spark HP OmniBook Ultra 16 ထက် သာလွန်ကာ 56.5 ဖြင့် ရှိသည်။ ၎င်း၏ 8GB ကတ်သည် ကျွန်ုပ်တို့၏ 20B နှင့်အထက် မော်ဒယ်အဆင့်များကို မတင်နိုင်ပါ။
- Dell Pro Max 14 ပရီမီယံRTX PRO 2000 8GB ကို ပေါင် ၃.၅၅ ဖြင့် ရောင်းချပြီး Phi မှာ ၅၄.၁ tok/s ဖြစ်သည်။
- Dell Pro Max 16 (Ryzen): ၁၆ နာရီ ၂ မိနစ် ဘက်ထရီရလဒ်ဖြင့် RTX PRO 1000 8GB; 61.9 tok/s ဖြင့် Phi။
- Lenovo ThinkPad P14s မျိုးဆက် ၄RTX PRO 500 6GB; Phi မှာ ၄၅.၇ tok/s နဲ့ Blackwell AI ကို entry လုပ်နိုင်ပါတယ်။
- Dell Pro Precision 5 16s Intel: တူညီသော shared-memory platform ပေါ်ရှိ ကျွန်ုပ်တို့၏ no-dGPU pick ၏ ၁၆ လက်မညီအစ်မဖြစ်ပြီး ကျွန်ုပ်တို့တိုင်းတာခဲ့သော အရှည်ကြာဆုံး workstation ဘက်ထရီမှာ ၂၄ နာရီ ၄၃ မိနစ်ဖြစ်သည်။
- Dell Pro Precision 5 14s AMD: 60 TOPS NPU နှင့် 64GB shared pool; AMD ၏ Procyon INT8 image path ကို စမ်းသပ်ချိန်တွင် မရရှိနိုင်သေးသောကြောင့် နှိုင်းယှဉ်မှုကို ကန့်သတ်ထားသည်။ Dell Pro Precision 5 16s AMD တူညီတဲ့ Ryzen AI 9 HX PRO 475 နဲ့ 60 TOPS NPU တို့ကို ၁၆ လက်မ ကိုယ်ထည်ထဲ ယူဆောင်လာပြီး ကျွန်ုပ်တို့ရဲ့ စမ်းသပ်မှုမှာ Pro Precision လိုင်းရဲ့ အားအကောင်းဆုံး ဒေသတွင်း LLM throughput ကို တင်ခဲ့ပြီး Llama3 နဲ့ Llama2 နှစ်ခုလုံးမှာရှိတဲ့ Intel ညီအစ်ကိုတွေထက် အများကြီး သာလွန်တာကြောင့် ဒေသတွင်း ကောက်ချက်ချမှုအလုပ်အတွက် ဒီမိသားစုရဲ့ ရွေးချယ်မှုဖြစ်စေပါတယ်။
- HP EliteBook X G1a55 TOPS NPU ပါရှိသော Ryzen AI 9 HX 375; ကျွန်ုပ်တို့၏ LLM suite ကို ၎င်းတွင် မလည်ပတ်ရသေးပါ။
ကျွန်ုပ်တို့ အဆင့်သတ်မှတ်ပုံ
UL Procyon AI Text Generation သည် ကျွန်ုပ်တို့၏ cross-fleet စံနှုန်းဖြစ်သည်- ၎င်းတို့ကို သိမ်းဆည်းထားနိုင်သော လက်ပ်တော့တိုင်းတွင် မော်ဒယ်လေးခု (Phi၊ Mistral၊ Llama 3 နှင့် Llama 2) တူညီသောကြောင့် ဤနေရာတွင် တိုကင်-တစ်စက္ကန့် ကိန်းဂဏန်းများသည် တိုက်ရိုက်နှိုင်းယှဉ်နိုင်သည်။ ဟာ့ဒ်ဝဲက ၎င်းကို စိတ်ဝင်စားစရာကောင်းစေသည့်နေရာတွင်၊ ကျွန်ုပ်တို့သည် LM Studio ဖြင့် ပိုမိုနက်ရှိုင်းစွာ လေ့လာပြီး Ollama သည် ပိုကြီးသော မော်ဒယ်များတွင် အလုပ်လုပ်သည်။ လက်ပ်တော့တစ်ခုစီကို တိုင်းတာမှုတစ်ခုလျှင် တစ်ကြိမ်သာ အဆင့်သတ်မှတ်ထားပြီး စနစ်တစ်ခုသည် ကျွန်ုပ်တို့၏ဓာတ်ခွဲခန်းတွင် အသုံးပြုနိုင်သော ဒေသတွင်း AI ရလဒ်များကို ထုတ်လုပ်ပါကသာ ဤစာမျက်နှာတွင် ပေါ်လာသည်။
RTX Spark စနစ်များသည် ကျွန်ုပ်တို့၏ client suite အသစ်ဖြစ်သော sr-client 1.2 ကို အသုံးပြုထားသောကြောင့် ၎င်းတို့ကို ဤစာမျက်နှာတွင် တစ်ခုနှင့်တစ်ခု နှိုင်းယှဉ်ထားပြီး အခြားရွေးချယ်မှုများ၏နောက်ကွယ်ရှိ Procyon ရလဒ်များနှင့် နှိုင်းယှဉ်ခြင်းမဟုတ်ပါ။
ဤဈေးကွက်တွင် ဈေးနှုန်းများ လျင်မြန်စွာ ပြောင်းလဲနေသောကြောင့် ဤစာမျက်နှာရှိ မည်သည့်ဒေါ်လာကိန်းဂဏန်းမဆို သုံးသပ်ချက်ထုတ်ဝေချိန်တွင် စမ်းသပ်ထားသည့်အတိုင်း ဈေးနှုန်းဖြစ်သည်။ လက်ရှိရောင်းချသူ ပြင်ဆင်သတ်မှတ်သည့် ဈေးနှုန်းကို စစ်ဆေးခြင်းမရှိဘဲ ကျွန်ုပ်တို့သည် တန်ဖိုးတောင်းဆိုမှုများ မပြုလုပ်ပါ၊ ထိုသို့ပြုလုပ်သည့်အခါတွင် ချက်လက်မှတ်ကို ရက်စွဲတပ်ပါသည်။
Laptop ဒေသတွင်း AI မေးလေ့ရှိသောမေးခွန်းများ
လက်တော့ပ်ပေါ်က ဒေသတွင်း AI၊ VRAM ဒါမှမဟုတ် စုစုပေါင်းမှတ်ဉာဏ်အတွက် ဘာက ပိုအရေးကြီးလဲ။
နှစ်ခုစလုံးမှာ အကြောင်းပြချက်အမျိုးမျိုးကြောင့်ပါ- မော်ဒယ်တစ်ခုဟာ GPU ရောက်ရှိနိုင်တဲ့ မှတ်ဉာဏ်ထဲမှာ အံဝင်ခွင်ကျဖြစ်ရပါမယ်- VRAM ဖြစ်တဲ့ discrete card တွေမှာ (ဒီ field မှာ 8GB မှ 24GB အထိ)၊ ပြီးတော့ ကျွန်ုပ်တို့ရဲ့ Llama 2 13B ဟာ 8GB card တွေမှာ 12GB လောက်လိုချင်လို့ DNF'd run ခဲ့ပါတယ်။ Unified နဲ့ shared memory design တွေက ညီမျှခြင်းကို ပြောင်းလဲစေပါတယ်- AMD ရဲ့ Ryzen AI Max+ ဟာ GPU ကို system RAM 96GB အထိ သတ်မှတ်ပေးနိုင်ပြီး Intel ရဲ့ shared LPCAMM2 pool တွေက 64GB အထိ ရောက်ရှိပါတယ်၊ အခုချိန်ထိ ပိုကြီးတဲ့ မော်ဒယ်တွေက အမြန်နှုန်းနိမ့်နဲ့သာ load လုပ်နိုင်ပါတယ်။ Fit က မော်ဒယ်တစ်ခု run မလုပ်ကို ဆုံးဖြတ်ပေးပြီး silicon က ဘယ်လောက်မြန်မြန် run မလဲဆိုတာကို ဆုံးဖြတ်ပေးပါတယ်။
StorageReview ရဲ့ လက်တော့ပ်မှာ ပါဝင်တဲ့ အကြီးဆုံး မော်ဒယ်က ဘာလဲ။
DeepSeek-R1 70B ကို HP ZBook Ultra G1a 14 တွင် ၎င်း၏ 96GB assignable unified memory pool မှတစ်ဆင့် ဒေသတွင်းတွင် load လုပ်ထားသည်။ ရေရှည်ထုတ်လုပ်မှုအတွက် ကျွန်ုပ်တို့သည် Gemma 3 27B ကို တူညီသောစက်တွင် တစ်စက္ကန့်လျှင် 8.96 tokens ဖြင့် တိုင်းတာခဲ့သည်။ ကျွန်ုပ်တို့၏ desktop ဘက်တွင် ဘားသည် ပိုမိုမြင့်မားသည်။ ဒေသတွင်း AI အတွက် အကောင်းဆုံး Desktops leaderboard တွင် ပိုမိုကြီးမားသော မော်ဒယ်များကို ဝန်ဆောင်မှုပေးသည့် စနစ်များကို လွှမ်းခြုံထားသည်။
LLM များ လည်ပတ်ရန်အတွက် NPU TOPS အဆင့်သတ်မှတ်ချက်များ အရေးကြီးပါသလား။
ယနေ့ခေတ် ဈေးကွက်ရှာဖွေရေးက အကြံပြုထားတာထက် နည်းပါတယ်၊ ဘာလို့လဲဆိုတော့ ဒေသတွင်း LLM runtime အများစုဟာ GPU ပေါ်မှာ မှီခိုနေရပြီး ဒီစာမျက်နှာမှာရှိတဲ့ tokens-per-second နံပါတ်တိုင်းဟာ GPU ကောက်ချက်ကနေ လာတာဖြစ်ပြီး Snapdragon EliteBook ကလွဲလို့ပေါ့။ NPU တွေဟာ လက်ရှိမှာ စွမ်းဆောင်ရည်နဲ့ INT8 image generation paths တွေမှာ ထိန်းသိမ်းထားနိုင်ပြီး ဒီစက်တွေထဲက အတော်များများဟာ Copilot+ PC တွေအဖြစ် အရည်အချင်းပြည့်မီရတဲ့ အကြောင်းရင်းတွေဖြစ်လို့ GPU နဲ့ memory ကို အရင်ဝယ်ပါ။
မော်ဒယ်တွေကို ဒေသတွင်းမှာ လည်ပတ်တဲ့အခါ ဘက်ထရီသက်တမ်း ဘာဖြစ်သွားမလဲ။
လက်တော့ပ်တစ်လုံး လည်ပတ်နိုင်တဲ့ အလေးဆုံး ဝန်အားတွေထဲက တစ်ခုဖြစ်တဲ့ Inference ဟာ အစစ်အမှန် session တွေအတွက် နံရံပါဝါကို အသုံးပြုဖို့ စီစဉ်ပါ။ ဒီစာမျက်နှာမှာရှိတဲ့ ဘက်ထရီနံပါတ်တွေက PCMark 10 Modern Office ရလဒ်တွေဖြစ်ပြီး ထုတ်လုပ်နိုင်စွမ်းကို တိုင်းတာတဲ့ တိုင်းတာမှုတစ်ခုဖြစ်ပြီး ပျံ့နှံ့မှုက အလွန်ကြီးမားပါတယ်- ကျွန်ုပ်တို့ရဲ့ အမြန်ဆုံး AI လက်တော့ပ်မှာ ၃ နာရီ ၃၉ မိနစ်နဲ့ shared-memory Dell မှာ ၂၄ နာရီနီးပါး ကြာမြင့်ပါတယ်။ ကျွန်ုပ်တို့ရဲ့ လက်တော့ပ် ဘက်ထရီသက်တမ်း Leaderboard က အဆင့်သတ်မှတ်ချက်အပြည့်နဲ့ အဆင့်သတ်မှတ်ထားပါတယ်။
RTX Spark လက်ပ်တော့တွေက ဒီမှာ အဆင့်သတ်မှတ်ထားတဲ့ လက်ပ်တော့တွေနဲ့ ဘယ်လိုနှိုင်းယှဉ်လို့ရလဲ။
RTX Spark လက်ပ်တော့များတွင် NVIDIA ၏ N1X ကို အသုံးပြုထားပြီး Grace CPU နှင့် Blackwell GPU အကြား LPDDR5X pool တစ်ခုကို မျှဝေအသုံးပြုထားသည်။ ကျွန်ုပ်တို့သည် ၎င်းတို့ကို ၎င်းတို့၏ client suite အသစ်ဖြစ်သော sr-client 1.2 တွင် စမ်းသပ်ထားသောကြောင့် ၎င်းတို့၏ နံပါတ်များသည် ဤစာမျက်နှာရှိ ရွေးချယ်မှုများနောက်ကွယ်ရှိ Procyon ရလဒ်များနှင့် အဆက်မပြတ် ကိုက်ညီမှုမရှိပါ။ 128GB HP OmniBook Ultra 16 တွင် gpt-oss:20b နှင့် Qwen3.6-35B-A3B များကို တစ်စက္ကန့်လျှင် 58.0 နှင့် 89.5 တိုကင်များဖြင့် ထုတ်လုပ်ပြီး 35B coding task သည် 72.0 စက္ကန့်အတွင်း သုံးကြိမ်လုပ်ဆောင်ပြီး သုံးကြိမ်အောင်မြင်ခဲ့သည်။
မန်မိုရီခွဲခြမ်းမှုက ဘယ်မော်ဒယ်တွေကို load လုပ်မလဲဆိုတာကို ဆုံးဖြတ်ပေးပါတယ်- GPU အတွက် 12GB လို့ သတ်မှတ်ထားတဲ့ 32GB Lenovo Pro 9n 15 က 12.8GB gpt-oss:20b ကို load မလုပ်နိုင်ပါဘူး။ Lenovo Yoga 9n 2-in-1 16 က အအေးဆုံးဖြစ်ပြီး မိနစ် ၃၀ ကြာ load လုပ်တဲ့အခါ အပူချိန် 72°C မှာ အမြင့်ဆုံးရောက်ခဲ့ပါတယ်။ Surface က စမ်းသပ်ပြီးသားလို့ပဲ ထင်ပါတယ်၊ ဘာလို့လဲဆိုတော့ ယူနစ်နှစ်ခုက ကျွန်တော်တို့ရဲ့ all-core OpenBLAS load အောက်မှာ ပါဝါပိတ်သွားလို့ပါ။
ဒေသတွင်း AI အတွက် desktop တစ်လုံးပဲ ဝယ်သင့်လား။
စက်ကို စားပွဲပေါ်မှာ ထားမယ်ဆိုရင်လည်း ဖြစ်နိုင်ပါတယ်။ စားပွဲဘေးစနစ်တွေက တစ်ဒေါ်လာကို မန်မိုရီပိုများတယ်၊ အပူချိန်ကို ပိုမိုကောင်းမွန်စွာ ထိန်းထားနိုင်ပြီး ဘက်ထရီထိခိုက်မှုလည်း မရှိပါဘူး။ ဒေသတွင်း AI အတွက် အကောင်းဆုံး ဒက်စ ်တော့တွေရဲ့ ဈေးနှုန်းက အလယ်အလတ်တန်းစား လက်တော့ပ်တွေရဲ့ ဈေးနှုန်းလောက်နဲ့ စတင်ပါတယ်။ ဒီစာမျက်နှာမှာရှိတဲ့ လက်တော့ပ်တွေက AI အလုပ်ဝန်ထုပ်ဝန်ပိုးကို ခရီးသွားရတဲ့သူတွေအတွက်ပါ။
RTX Spark vs DGX Spark: what is the difference?
They are the same silicon tuned for different platforms. RTX Spark N1X laptops carry the GB10 superchip from DGX Spark, a Grace CPU and Blackwell GPU sharing one pool of LPDDR5X, at a 45 to 80W TDP against the 140W NVIDIA publishes for the GB10 in DGX Spark. DGX Spark runs NVIDIA’s Linux stack with unified memory; RTX Spark laptops run Windows 11 on Arm, where a firmware setting splits the pool in advance, and the 128GB HP OmniBook Ultra 16 gives its GPU 62.5GB. We test the two on different suites, so we do not rank them against each other; DGX Spark systems are ranked on ဒေသတွင်း AI အတွက် အကောင်းဆုံး Desktop များ.


 အမေဇုံ