

၂၀၂၆ ခုနှစ်၊ အောက်တိုဘာလ ၂၄ ရက်နေ့တွင် အပ်ဒိတ်လုပ်ခဲ့သည်- Mac Studio အဖြေသည် Apple မှ စက်တင်ဘာလတွင် စတင်တင်ပို့ခဲ့သော M5 Max နှင့် M5 Ultra မော်ဒယ်များကို ယခုအခါ ထင်ဟပ်စေပြီး 64GB DGX Spark မှတ်စုသည် အောက်တိုဘာ ၂၃ ရက်တွင် မိတ်ဆက်ခြင်းကို ထင်ဟပ်စေပါသည်။ ရွေးချယ်မှုများ မပြောင်းလဲပါ။ အောက်တိုဘာ ၂၀ ရက်တွင် entry bar သည် Linux အောက်ရှိ vLLM တွင် GPU နှစ်ခု သို့မဟုတ် နှစ်ခုထက်ပိုသော GPU များ သို့မဟုတ် မော်ဒယ်များအတွက် အနည်းဆုံး 96GB ရရှိနိုင်သော shared memory pool တစ်ခု ဖြစ်လာခဲ့သည်။
ဤစာမျက်နှာတွင် အဆင့်သတ်မှတ်ထားသော စနစ်တိုင်းကို StorageReview ဓာတ်ခွဲခန်းမှတစ်ဆင့် ပြုလုပ်ထားပါသည်။ ကျွန်ုပ်တို့သည် ဒေသတွင်း AI စွမ်းဆောင်ရည်ကို တိုက်ရိုက် benchmark လုပ်ပါသည်- GPT-OSS-120B၊ Llama 3.1 8B၊ Mistral Small 3.1 24B နှင့် Qwen3 Coder 30B အပါအဝင် မော်ဒယ်များတွင် vLLM အွန်လိုင်းဝန်ဆောင်မှု throughput၊ time-to-first-token နှင့် time-per-output-token တို့အပြင် MAMF compute efficiency နှင့် GDSIO storage testing တို့ပါဝင်သည်။ မည်သည့်စနစ်ကိုမျှ spec sheet မှ အဆင့်သတ်မှတ်ထားခြင်း မရှိပါ။
၂၀၂၆ ခုနှစ်တွင် ဒေသတွင်း AI ဒက်စ်တော့အတွက် အဓိပ္ပာယ်ဖွင့်ဆိုချက်မှာ ပေါင်းစည်းထားသော မှတ်ဉာဏ်နှင့် discrete VRAM ဖြစ်သည် ။ NVIDIA ၏ GB10-based DGX Spark နှင့် AMD ၏ Ryzen AI Max (Strix Halo) စနစ်များကဲ့သို့သော စားပွဲဘေးသုံးပစ္စည်းများသည် ပစ္စည်းဈေးနှုန်းများတွင် ချစ်ပ်တစ်ခုတည်း၏နောက်တွင် ပေါင်းစည်းထားသော မှတ်ဉာဏ် 128GB ထားရှိသောကြောင့် discrete GPU များစွာ လိုအပ်မည့် မော်ဒယ်များကို ထိန်းသိမ်းထားနိုင်သည်။
Workstation tower များသည် raw throughput ဖြင့် တုံ့ပြန်သည်- RTX PRO 6000 Blackwell ကတ်များသည် တစ်စက္ကန့်လျှင် တိုကင်များ ပိုမိုမြင့်မားစွာ ပေးစွမ်းပြီး ကုန်ကျစရိတ်နှင့် ပါဝါသုံးစွဲမှုထက် အဆပေါင်းများစွာ ပိုမိုမြင့်မားသည်။ ဤစာမျက်နှာသည် တစ်ခုတည်းသော စမ်းသပ်မှုအစုံမှ သီးခြားအဆင့်များတွင် အဆင့်သတ်မှတ်ထားသည်၊ အဘယ်ကြောင့်ဆိုသော် မှန်ကန်သောအဖြေသည် သင်လည်ပတ်ရန် ရည်ရွယ်ထားသော အကြီးဆုံးမော်ဒယ်နှင့် ၎င်းကို မည်မျှမြန်မြန် တုံ့ပြန်ရန် လိုအပ်သည်ပေါ် မူတည်သောကြောင့်ဖြစ်သည်။
တစ်တစ်ချက်မှာ
| အမျိုးအစား | စံနစ် | မှတ်ဉာဏ် | GPU များ (စမ်းသပ်ပြီး / အများဆုံး) | အပြည့်အဝပြန်လည်ဆန်းစစ်ခြင်း |
|---|---|---|---|---|
| အကောင်းဆုံး အလုံးစုံ Deskside AI စနစ် | NVIDIA DGX Spark | ပေါင်းစည်းထားသော 128GB LPDDR5X | GB10 ပေါင်းစပ်ထားသည် (ပြုပြင်ပြီး) | DGX Spark သုံးသပ်ချက် |
| အကောင်းဆုံး GB10 အကောင်အထည်ဖော်မှု | Acer Veriton GN100 | ပေါင်းစည်းထားသော 128GB LPDDR5X | GB10 ပေါင်းစပ်ထားသည် (ပြုပြင်ပြီး) | Veriton GN100 သုံးသပ်ချက် |
| အကောင်းဆုံး x86 အစားထိုး | AMD Ryzen AI Halo (Strix Halo) | ပေါင်းစည်းထားသော LPDDR5X 128GB အထိ | Radeon 8060S ပေါင်းစပ်ထားသည် (ပြင်ဆင်ပြီး) | Ryzen AI Halo သုံးသပ်ချက် |
| Discrete GPU မပါဝင်တာ အကောင်းဆုံးပါပဲ | HP Z2 Mini G1a | ပေါင်းစည်းထားသော LPDDR5X (GPT-OSS 120B ကို လည်ပတ်ခဲ့သည်) | ပေါင်းစပ်ထားပြီး၊ dGPU မပါဝင်ပါ (ပုံသေ) | Z2 Mini G1a သုံးသပ်ချက် |
| အကောင်းဆုံး GB300 စနစ် | MSI XpertStation WS300 (အခြားရွေးချယ်စရာ- ASUS ET900N G3) | 748GB coherent (252GB HBM3e + 496GB LPDDR5X) | GB300 ပေါင်းစပ်ထားသည် (ပြုပြင်ပြီး) | XpertStation WS300 သုံးသပ်ချက် |
| ဒေသခံ AI အတွက် အကောင်းဆုံး Tower | Dell က Precision 7875 | 192GB GDDR7 (၈ × ၉၆GB) | ၈× RTX PRO 6000 / ၈ မက်စ် | Precision 7875 ပြန်လည်သုံးသပ်ချက် |
| အကောင်းဆုံး Multi-GPU ပလက်ဖောင်း | HP Z8 Fury G6i | စမ်းသပ်ပြီး 192GB GDDR7 / 384GB အထိ | ၂× RTX PRO 6000 စမ်းသပ်ပြီး / အများဆုံး ၄ ခု | Z8 Fury G6i သုံးသပ်ချက် |
| အစွန်းရောက်ရွေးချယ်မှု | Comino Grando RTX PRO 6000 | 768GB GDDR7 (၈ × ၉၆GB) | ၈× RTX PRO 6000 / ၈ မက်စ် | Comino Grando သုံးသပ်ချက် |
စားပွဲဘေး AI ပစ္စည်းများ
Dell က deskside AI လို့ခေါ်ပြီး NVIDIA က personal AI supercomputer လို့ခေါ်တဲ့ appliance tier ဟာ မော်ဒယ်စွမ်းရည်၊ ပါဝါထိရောက်မှုနဲ့ ဈေးနှုန်းတွေနဲ့ အမြင့်ဆုံး throughput ကို လဲလှယ်ပါတယ်။ 128GB unified memory နဲ့ ဒီစနစ်တွေက 70B-class မော်ဒယ်တွေကို quantization မြင့်မားတဲ့နေရာမှာ အဆင်ပြေပြေ သိမ်းဆည်းထားနိုင်ပြီး 120B-class အထိ ဆန့်ထုတ်နိုင်ပြီး tower တစ်ခုမှာ discrete GPU များစွာ လိုအပ်မယ့် workloads တွေ ဖြစ်ပါတယ်။
ဤအဆင့်အတွက် မရှိမဖြစ်ဓာတ်ခွဲခန်းဖတ်ရှုခြင်း- ကျွန်ုပ်တို့၏ DGX Spark အပူချိန်စမ်းသပ်မှုသည် အောက်ဖော်ပြပါ GB10 စနစ်များတစ်လျှောက် OEM အအေးပေးဒီဇိုင်းများကို နှိုင်းယှဉ်ပြီး ဤပလက်ဖောင်းများ ပြင်ဆင်မှုမပြုလုပ်မချင်း ဤအတန်းရှိ ယူနစ်တိုင်းနှင့် သက်ဆိုင်ပါသည်။
အကောင်းဆုံး Deskside AI စနစ်- NVIDIA DGX Spark
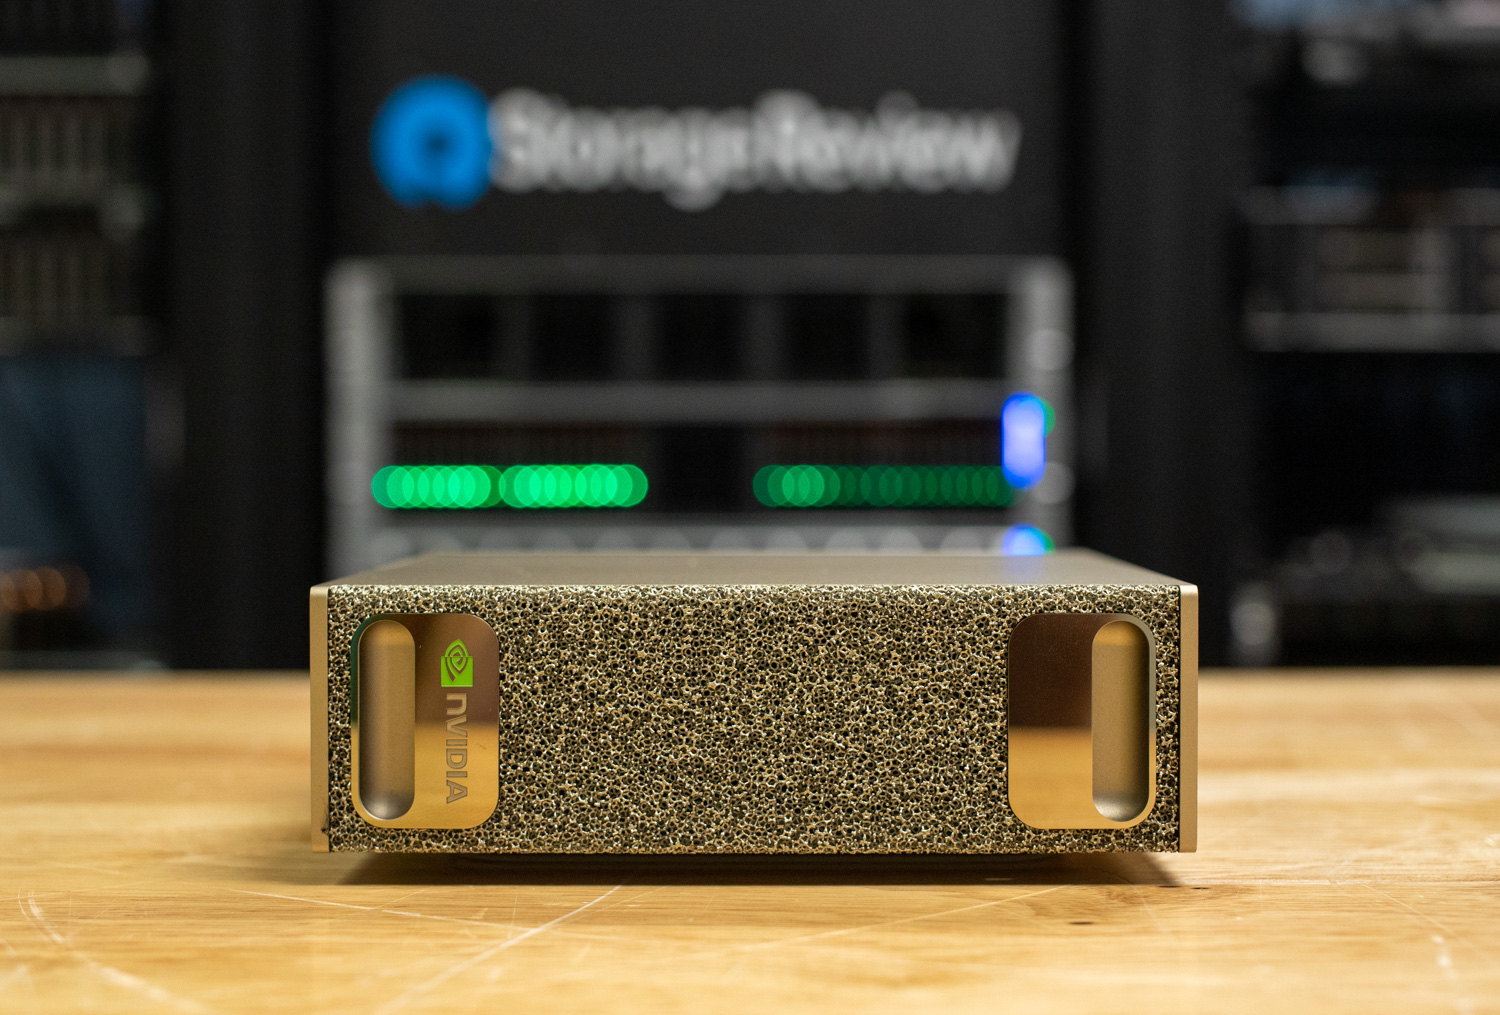
DGX Spark ဟာ အခြား deskside AI box တိုင်းနဲ့ တိုင်းတာတဲ့ reference point ပါ။ GB10 Grace Blackwell superchip က 20-core Arm CPU နဲ့ 128GB unified LPDDR5X တို့ တွဲဖက်အသုံးပြုထားပြီး dual ConnectX-7 200GbE ports တွေက ကျွန်တော်တို့ စမ်းသပ်ဖူးသမျှ appliance class တွေထဲမှာ တစ်ခုတည်းသော cluster ဖြစ်တာကြောင့် box ထဲကနေ cluster လုပ်လို့ရတဲ့ appliance class တစ်ခုဖြစ်စေပါတယ်- ကျွန်တော်တို့ရဲ့ two-node distributed inference testing က Dell, GIGABYTE နဲ့ HP node တွေမှာ 200GbE ကျော် pipeline-parallel workloads တွေကို run လုပ်ခဲ့ပါတယ်။
အဲဒီ clustering ဇာတ်လမ်းက အခုဆိုရင် ဈေးသက်သာတဲ့ လမ်းကြောင်းပေါ် ရောက်လာပါပြီ။ NVIDIA ဟာ အောက်တိုဘာ ၂၃ ရက်နေ့မှာ 64GB DGX Spark SKU ကို ဒေါ်လာ ၄,၉၉၉ နဲ့ စတင်ရောင်းချခဲ့ပြီး အဲဒီ OEM ခြောက်ခုကနေတစ်ဆင့် ရောင်းချခဲ့ပါတယ်။ အဲဒီထဲက နှစ်ခုက 200GbE ကြိုးတစ်ချောင်းနဲ့ 128GB ပေါင်းထည့်ဖို့ တွဲဖက်အသုံးပြုပါတယ်။ NVIDIA ဟာ Qwen3.8 27B မှာ clustered pair ကို 1.7xa single 128GB unit အထိ တပ်ဆင်ပေးထားပြီး၊ ဒါကိုတော့ ကျွန်တော်တို့ မစမ်းသပ်ရသေးပါဘူး။ CUDA software stack က ဒီကဏ္ဍမှာ အနက်ရှိုင်းဆုံးအဖြစ် ရှိနေဆဲပါ။
ပလက်ဖောင်းရဲ့ hard limit တစ်ခုကတော့ storage ပါ။ GB10 system တိုင်းဟာ single short M.2 slot တစ်ခုတည်းမှာ 4TB လောက်အထိ အမြင့်ဆုံးရရှိမှာပါ။ ကျွန်ုပ်တို့ရဲ့ ရှစ်ခုပါ Spark shared storage build က fleet ရဲ့ အဖြေပါပဲ။ Spark တိုင်းမှာ ရှိပြီးသား 100GbE ports တွေပေါ်မှာ serve လုပ်ထားတဲ့ single governed QLC array တစ်ခုဖြစ်ပြီး client တစ်ခုက 10.8GiB/s မှာ read လုပ်ပါတယ်။ GB10 system မှာ ကျွန်ုပ်တို့ တိုင်းတာခဲ့တဲ့ အမြန်ဆုံး internal M.2 နဲ့ ကိုက်ညီပါတယ်။ ပြီးတော့ local NVMe ရဲ့ 13% အတွင်း centralized load လုပ်ထားတဲ့ 78GB model လည်း ရှိပါတယ်။
DGX Spark သုံးသပ်ချက်အပြည့်အစုံကို ဖတ်ရှုပါ။
အကောင်းဆုံး GB10 အကောင်အထည်ဖော်မှု- Acer Veriton GN100
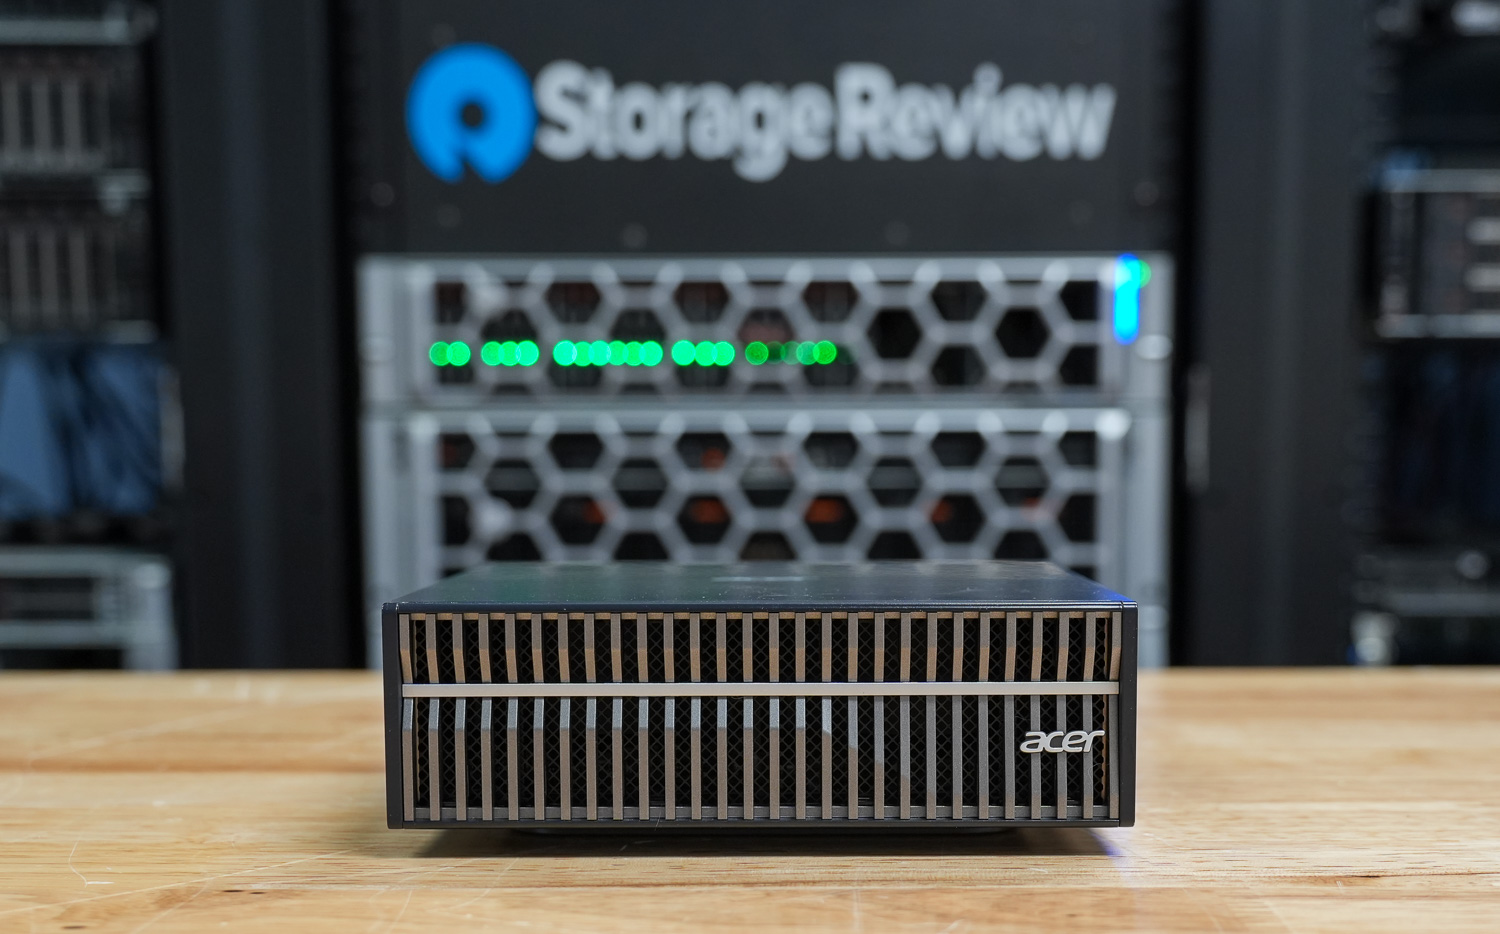
GB10 OEM စနစ်တွေထဲမှာ အပူဒီဇိုင်းက တကယ့်ကွာခြားချက်ဖြစ်ပြီး Veriton GN100 က ကျွန်ုပ်တို့ရဲ့ စမ်းသပ်မှုမှာ ထင်ရှားပါတယ်။ GB10 သေတ္တာအားလုံးမှာ ဆီလီကွန်နဲ့ မှတ်ဉာဏ်ဖွဲ့စည်းပုံ အတူတူပဲ ရှိတာကြောင့် စွမ်းဆောင်ရည် တည်ငြိမ်ဖို့က အအေးပေးစနစ်ပေါ်မှာ မူတည်ပါတယ်။ ကျွန်ုပ်တို့ရဲ့ multi-OEM အပူနှိုင်းယှဉ်ချက်ဟာ ကျွန်ုပ်တို့ သိရှိသလောက် ဒီလိုထုတ်ဝေခဲ့တဲ့ တစ်ခုတည်းသော နှိုင်းယှဉ်ချက် ဖြစ်ပါတယ်။
Veriton GN100 သုံးသပ်ချက်အပြည့်အစုံကို ဖတ်ရှုပါ။
အကောင်းဆုံး x86 အစားထိုး- AMD Ryzen AI Halo
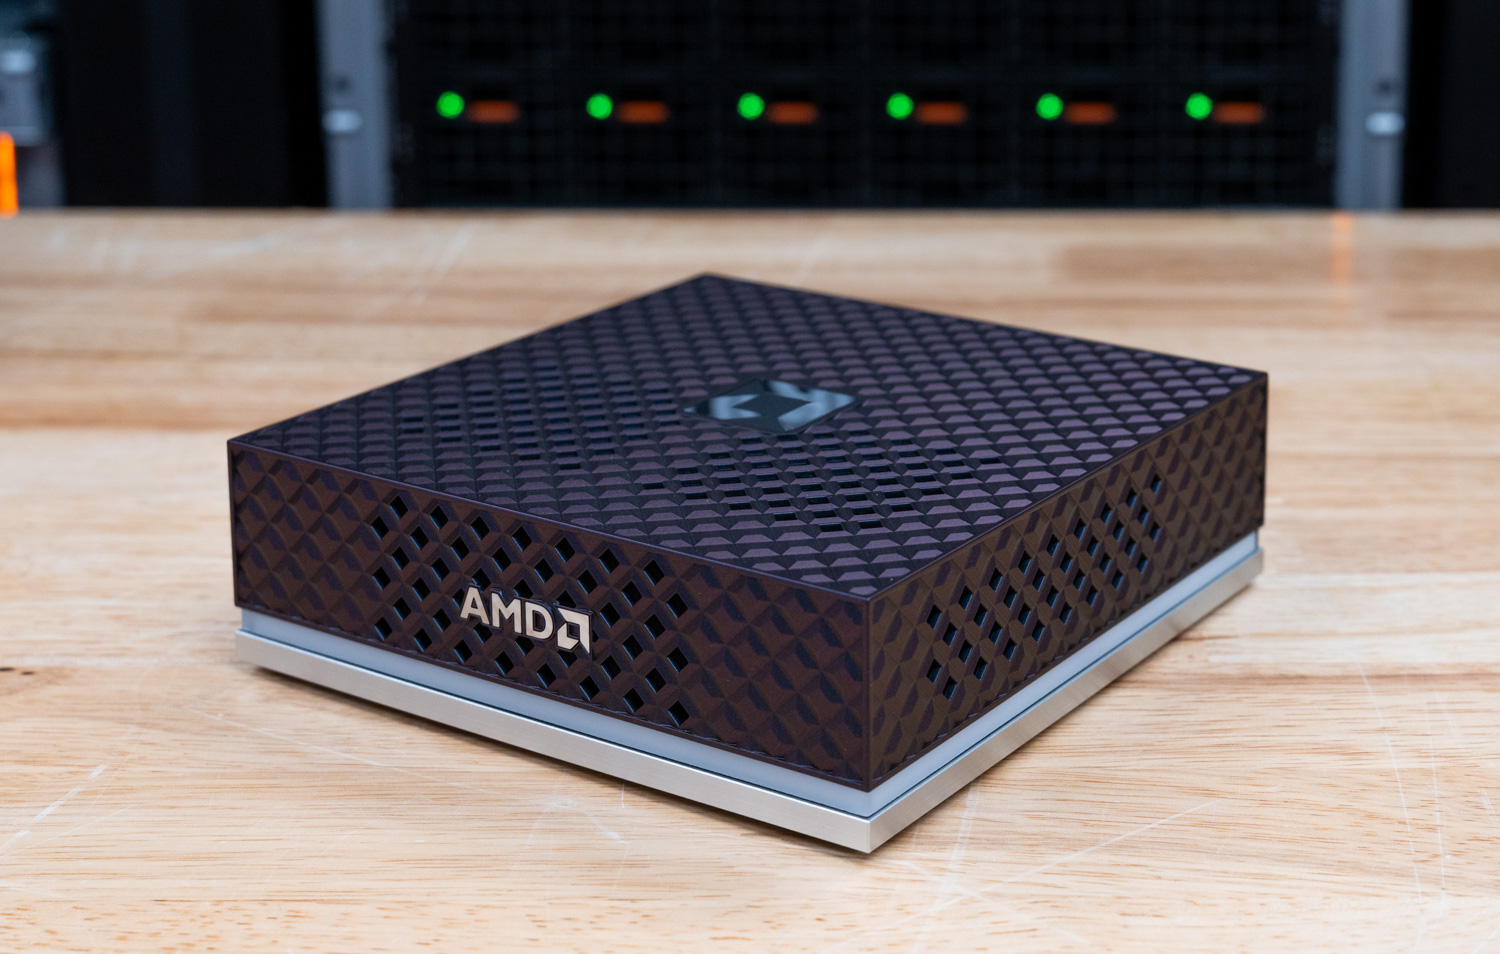
Windows ဒါမှမဟုတ် standard x86 software stack လိုအပ်ရင် Strix Halo က စားပွဲဘေးထွက်အဖြေပါ။ AMD ရဲ့ Ryzen AI Max+ 395 platform က 128GB unified memory နဲ့ dual-OS setup ကို တွဲဖက်အသုံးပြုထားပြီး ကျွန်တော်တို့ရဲ့ စမ်းသပ်မှုမှာ 200B-parameter-class model တွေကို ကိုင်တွယ်နိုင်ပါတယ်။ Arm/DGX OS မပါဘဲ DGX Spark ကို တိုက်ရိုက်ကိုင်တွယ်သလိုပါပဲ။
Ryzen AI Halo သုံးသပ်ချက်အပြည့်အစုံကို ဖတ်ရှုပါ။
Discrete GPU မပါတဲ့ အကောင်းဆုံး - HP Z2 Mini G1a
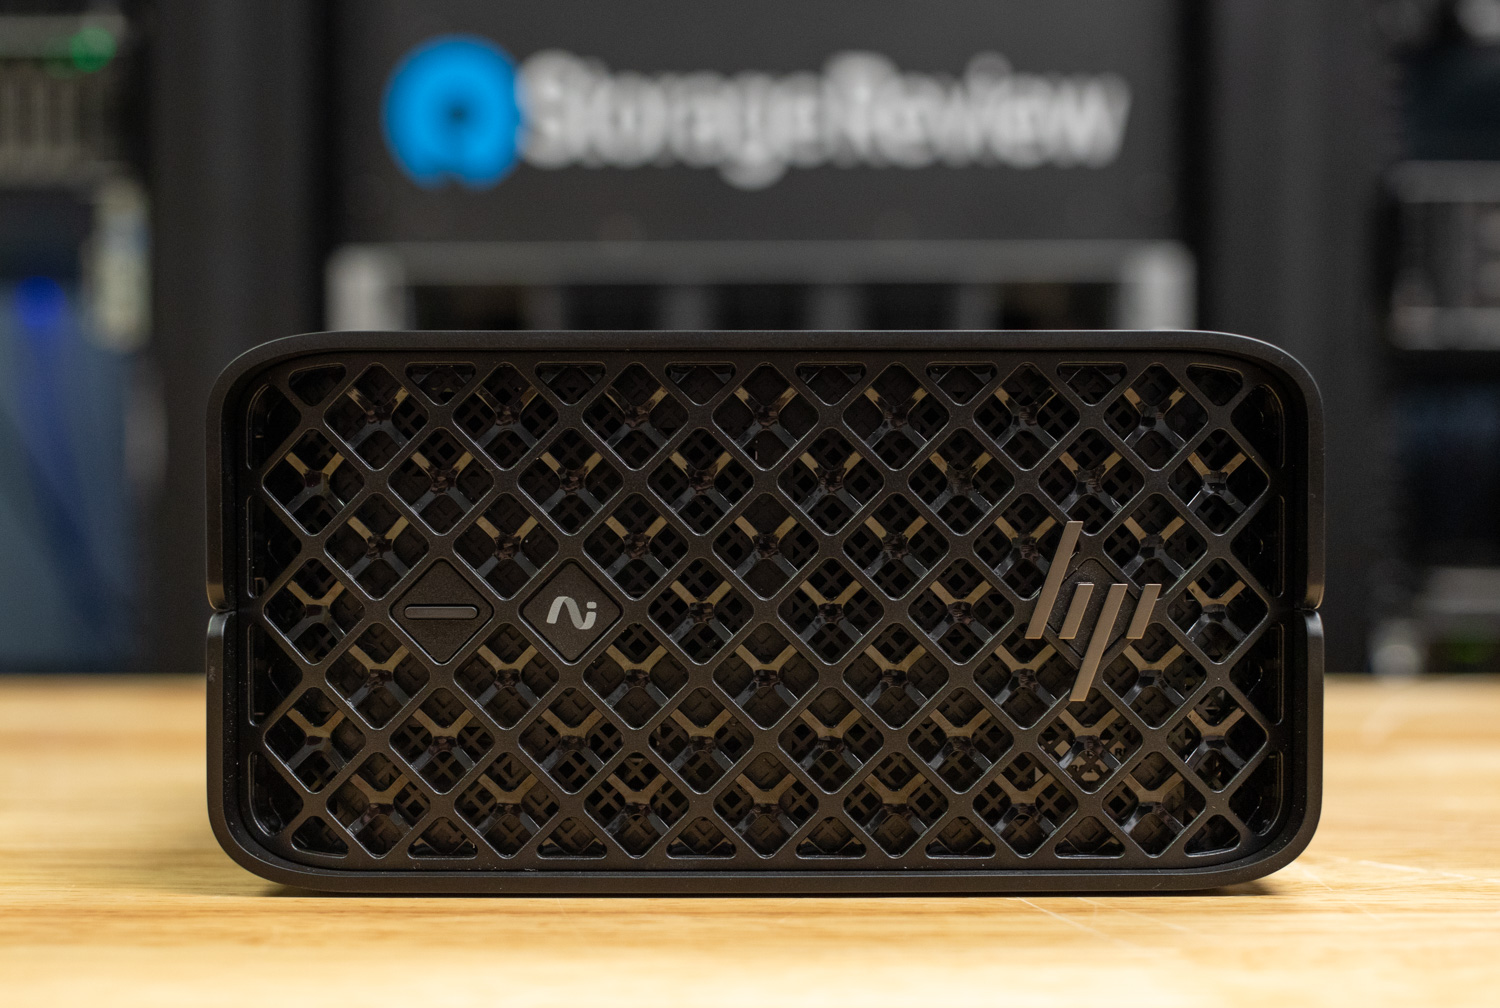
Z2 Mini G1a မှာ discrete GPU လုံးဝမပါဝင်ဘဲ GPT-OSS 120B ကို အသုံးပြုထားပါတယ်။ HP ရဲ့ mini workstation မှာ AMD ရဲ့ Ryzen AI Max+ PRO silicon ကို ကျစ်လျစ်ပြီး တိတ်ဆိတ်ငြိမ်သက်တဲ့ IT နဲ့ လိုက်ဖက်တဲ့ chassis ထဲမှာ ထည့်သွင်းထားပြီး unified-memory x86 စနစ်တွေက ရုံးခန်းငယ်လေးတစ်ခုရဲ့ ကြီးမားတဲ့ မော်ဒယ်တွေကို ပြောင်းလဲပေးနိုင်တယ်ဆိုတာကို အရှင်းလင်းဆုံး သရုပ်ပြမှုတစ်ခုအဖြစ် ဆက်လက်တည်ရှိနေပါတယ်။
Z2 Mini G1a သုံးသပ်ချက်အပြည့်အစုံကို ဖတ်ရှုပါ။
အကောင်းဆုံး GB300 စနစ်- MSI XpertStation WS300
WS300 ဟာ ကျွန်ုပ်တို့ရဲ့ ဓာတ်ခွဲခန်းကနေတစ်ဆင့် ပထမဆုံး GB300 DGX Station ဖြစ်ပြီး appliance tier အတွက် အမြင့်ဆုံးအဆင့်ကို reset လုပ်ပါတယ်။ Grace Blackwell Ultra superchip မှာ coherent memory 748GB၊ HBM3e 252GB နဲ့ LPDDR5X 496GB ပါဝင်ပြီး FP4 compute ရဲ့ 20 petaFLOPS နောက်မှာ ပေါင်းစပ်ထားပါတယ်။ ကျွန်ုပ်တို့ရဲ့ စမ်းသပ်မှုမှာ Grace memory မှာ expert weights 216GB ပါဝင်တဲ့ 433GB GLM-5.2 checkpoint ကို ဆောင်ရွက်ပေးခဲ့ပြီး စားပွဲဘေးမှာ လုပ်ငန်းလည်ပတ်နေတဲ့ မော်ဒယ်တစ်ခု မဟုတ်ပါဘူး။ DGX-class system တိုင်းလိုပဲ Windows အစား DGX OS ကို လည်ပတ်ပါတယ်။ ဒါက memory အများစုက တောင်းဆိုတဲ့ ကတိကဝတ်ပါ။
ဈေးနှုန်းနှင့် ပါဝါကြောင့် အထက်ဖော်ပြပါ GB10 box များထက် tower tier ၏ အစွန်းဆုံးအဆင့်နှင့် ပိုမိုနီးကပ်သော်လည်း၊ appliance အမျိုးအစားတွင် အခြားမည်သည့်အရာမှ ဤအရွယ်အစားကြီးမားသော မော်ဒယ်ကို မပိုင်ဆိုင်နိုင်ပါ။ ထင်ရှားသောမေးခွန်းဖြစ်သည့် 1,300W part throttles သည် tower တွင် ထိန်းညှိပေးမည်လားဆိုသည့် မေးခွန်းသည် ယခုအခါ တိုင်းတာထားသောအဖြေတစ်ခုရှိလာပါပြီ- ကျွန်ုပ်တို့၏ WS300 thermals deep dive သည် Blackwell Ultra die ကို 60C တွင်ထိန်းထားပြီး၊ 2.07GHz clock သည် dips မရှိဘဲ 2.8 နာရီကြာ လည်ပတ်မှုကို မှတ်တမ်းတင်ထားပြီး၊ full load တွင် thermal margin 20C ခန့်ကျန်ရှိနေပါသည်။
GB300 အစားထိုးကိရိယာ- ASUS ExpertCenter Pro ET900N G3 သည် ကျွန်ုပ်တို့၏ စမ်းသပ်မှုတစ်လျှောက် ဒုတိယမြောက် GB300 DGX Station ဖြစ်ပြီး ၎င်းသည် platform ကို အတည်ပြုသည်- မော်ဒယ် ၁၄ ခုနှင့် workloads နှစ်ခုတွင် peak-throughput နှိုင်းယှဉ်မှု ၂၈ ခုအနက် ၂၄ ခုသည် WS300 ၏ ၂% အတွင်း ရောက်ရှိခဲ့ပြီး coherent-pool မော်ဒယ်များသည် parity သို့မဟုတ် ပိုမိုကောင်းမွန်သော စွမ်းဆောင်ရည်တွင် လည်ပတ်ခဲ့သည်။ ASUS သည် ၂၇ ကီလိုဂရမ် တာဝါတွင် သယ်ဆောင်နိုင်သော လက်ကိုင်များ၊ 400G optics cages များပေါ်ရှိ သီးသန့်ပန်ကာတစ်ခုနှင့် 80 PLUS Titanium ထောက်ပံ့မှုကို ထည့်သွင်းထားသည်။ တာဝါတိုင်းသည် platform ကို ပေးစွမ်းနိုင်သည်။ တာဝါနှစ်ခု နှိုင်းယှဉ်မှုအတွက် ကျွန်ုပ်တို့၏ ET900N G3 သုံးသပ်ချက်ကို ဖတ်ရှုပါ။
Cluster scaling: ဤတာဝါနှစ်ခုကို ၎င်းတို့၏ကိုယ်ပိုင် 400G port များပေါ်တွင် အတူတကွချိတ်ဆက်ထားသည်ကို ယခုအခါ တိုင်းတာပြီးဖြစ်သော်လည်း ကတိမပေးရသေးပါ- ကျွန်ုပ်တို့၏ GB300 cluster စမ်းသပ်မှုသည် ASUS နှင့် HP Station များကို DAC နှစ်ခုနှင့် တွဲဖက်ပေးခဲ့ပြီး NCCL collective များတွင် line rate ၏ 98% သို့ ရောက်ရှိခဲ့ပြီး GLM-5.2၊ 433GB မော်ဒယ်ကို Station တစ်ခုတည်းသည် Grace memory ထဲသို့ weight 215GB ကို spill လုပ်ခြင်းဖြင့်သာ ဝန်ဆောင်မှုပေးနိုင်သည်၊ stream ၃၂ ခုတွင် တစ်စက္ကန့်လျှင် output token ၁၃၉ ခုမှ 1,525 ခုအထိ၊ 256 တွင် 3,141 ခုအထိ ရောက်ရှိခဲ့သည်။
Station scale တစ်ခုနှင့် ကွဲပြားစွာ ကိုက်ညီသော မော်ဒယ်များ- prefill/decode disaggregation သည် GLM-5.3 Flash short-prompt throughput ကို သုံးဆတိုးစေပြီး DeepSeek V4.1 Flash သည် တစ်စက္ကန့်လျှင် တိုကင် ၅,၂၄၈ ခု ရရှိခဲ့ပြီး အစုံတွင် အမြင့်ဆုံး output ဖြစ်သည်။
XpertStation WS300 သုံးသပ်ချက်အပြည့်အစုံကို ဖတ်ရှုပါ။
ဓာတ်ခွဲခန်းတွင်- HP ZGX Fury AI Station
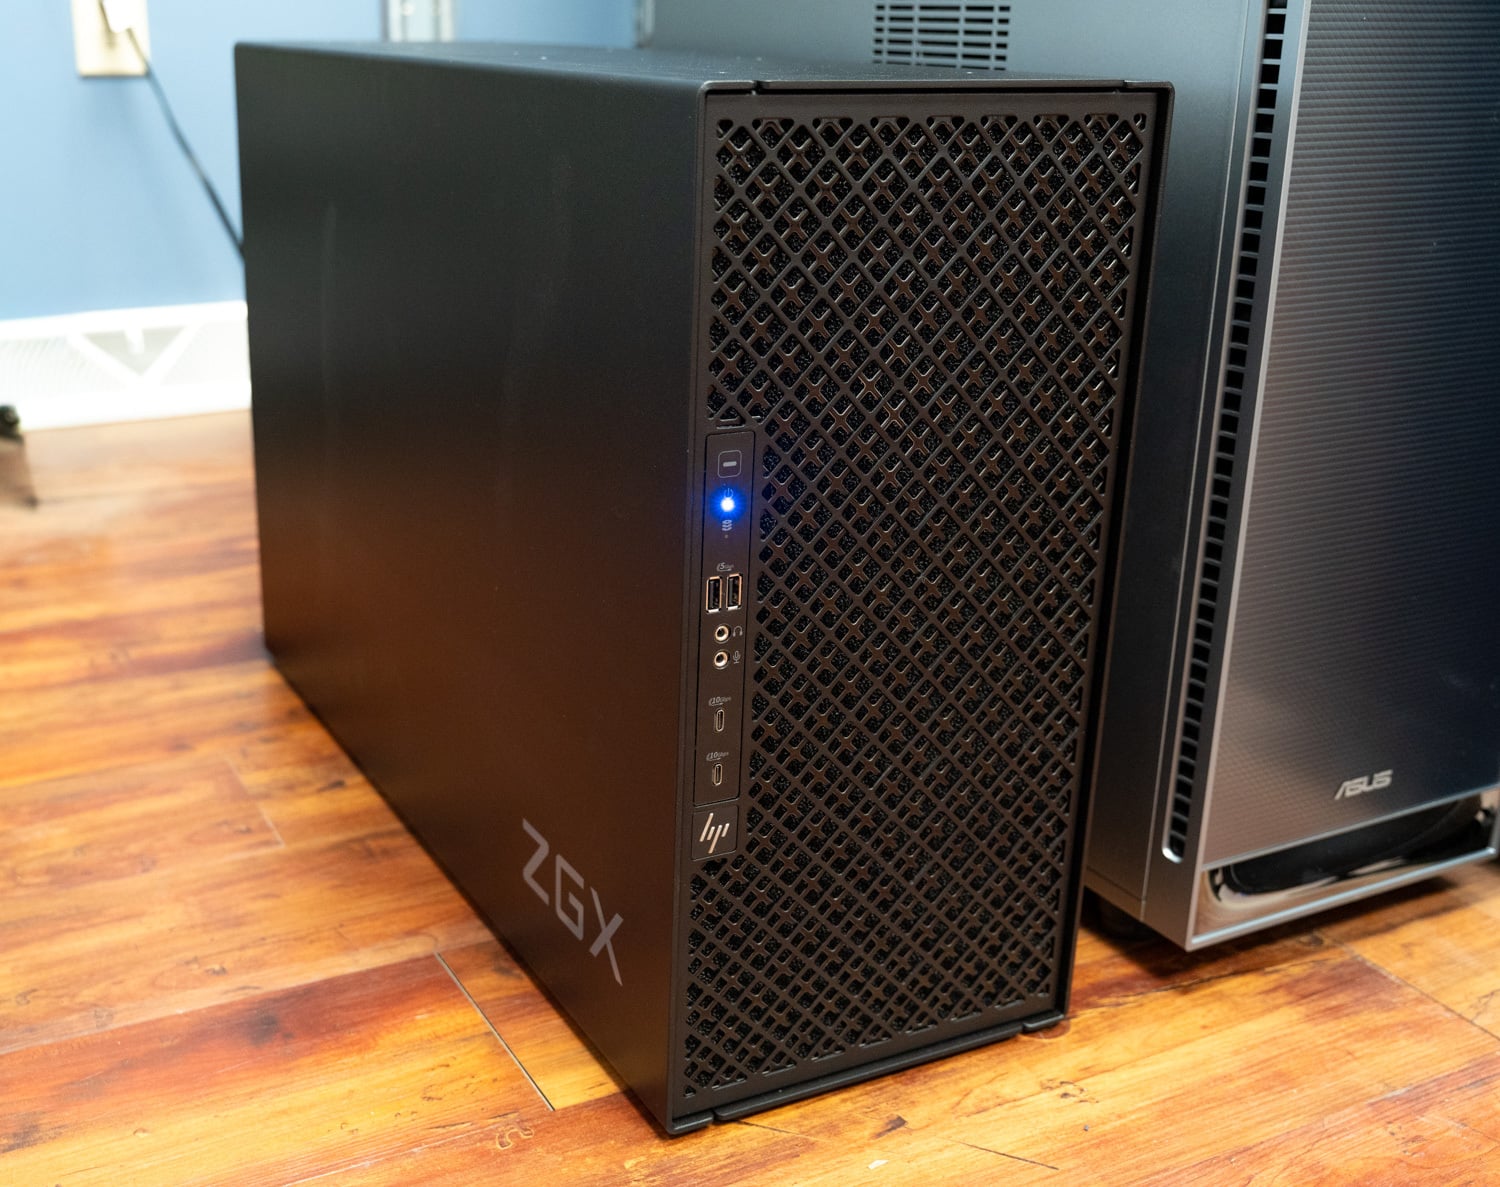
MSI WS300 နှင့် ASUS ET900N G3 တို့၏ two-tower ရလဒ်များသည် တစ်ခုနှင့်တစ်ခု ၂% အတွင်း ကျဆင်းပြီးနောက် ကျွန်ုပ်တို့၏ဓာတ်ခွဲခန်းသို့ ရောက်ရှိခဲ့သော တတိယမြောက် GB300-class စနစ်ဖြစ်သည့် HP ZGX Fury AI Station
HP ရဲ့ ZGX Fury AI Station ကို အခု ကျွန်တော်တို့ရဲ့ ဓာတ်ခွဲခန်းမှာ ရှာတွေ့နိုင်ပါပြီ။ အထက်ဖော်ပြပါ MSI XpertStation WS300 လိုပဲ NVIDIA GB300 Grace Blackwell Ultra platform ပေါ်မှာ တည်ဆောက်ထားတာဖြစ်လို့ DGX Station architecture ရဲ့ vendor နှစ်ယောက်ရဲ့ အကောင်အထည်ဖော်မှုတွေက တူညီတဲ့ bench ပေါ်မှာ ဘယ်လိုနှိုင်းယှဉ်ထားလဲဆိုတာကို မြင်တွေ့ခွင့်ရမှာပါ- thermals, acoustics, sustained clocks နဲ့ စက်နဲ့အတူ လက်တွေ့နေထိုင်မှုအတွေ့အကြုံတွေပါပဲ။
၎င်း၏ ပထမဆုံး အများပြည်သူသုံး နံပါတ်များ ထွက်ရှိပြီးသားဖြစ်သည်- ZGX Fury သည် ကျွန်ုပ်တို့၏ two-Station GB300 cluster စမ်းသပ်မှု တွင် ဒုတိယ tower အဖြစ် ဆောင်ရွက်ခဲ့ပြီး ၊ disaggregated GLM-5.3 Flash configuration အတွက် decode လုပ်ခြင်းနှင့် tensor-parallel လုပ်ဆောင်မှုတိုင်း၏ ထက်ဝက်ကို လုပ်ဆောင်ခဲ့သည်။ solo review ကို လုပ်ဆောင်နေပြီး ZGX Fury သည် ၎င်း၏ကိုယ်ပိုင် bench နံပါတ်များ ဝင်လာသောအခါ အဆင့်သတ်မှတ်ချက်များသို့ ဝင်ရောက်လာခဲ့သည်။
ZGX Fury သည် Microsoft မှ DGX Station for Windows အမည်ဖြင့် အမည်ပေးထားသော ပထမဆုံးစနစ်နှစ်ခုထဲမှ တစ်ခုဖြစ်ပြီး GB300 ပါ Dell Pro Precision နှင့်အတူ NVIDIA မှ စတုတ္ထသုံးလပတ်အတွက် Windows ဗားရှင်းကို စာရင်းပြုစုထားသည်။ ဟာ့ဒ်ဝဲသည် Ubuntu တွင် ကျွန်ုပ်တို့စမ်းသပ်ထားသော GB300 towers များနှင့် ကိုက်ညီပြီး serving stacks များသည် Windows တွင် natively သို့မဟုတ် WSL အောက်တွင် run ခြင်းရှိမရှိသည် ဤဗားရှင်းအတွက် ပွင့်လင်းသောမေးခွန်းဖြစ်သည်။
မိုးကုပ်စက်ဝိုင်းပေါ်တွင်- AMD Threadripper Halo Station
IFA 2026 မှာ ကြေညာခဲ့ပြီး ဘယ်ဓာတ်ခွဲခန်းမှာမှ မပါဝင်သေးတဲ့ AMD ရဲ့ Threadripper Halo Station ဟာ အထက်ဖော်ပြပါ GB300 အတန်းအစားအတွက် ပထမဆုံး တိုက်ရိုက်အဖြေပါပဲ။ ဒီ pitch က NVIDIA ရဲ့ အလောင်းအစားကို ပြောင်းပြန်လှန်ပစ်လိုက်ပါတယ်- coherent memory pool ကြီးတစ်ခုအစား AMD ဟာ 96-core Threadripper PRO ကို 2TB အထိ eight-channel DDR5 နဲ့ 128 PCIe 5.0 lanes ပါဝင်တဲ့ platform ပေါ်မှာ 144GB HBM3E ပါတဲ့ 600W Instinct MI350P accelerator နှစ်ခုနဲ့ တွဲဖက်ထားပြီး ကတ်လေးခုနဲ့ 576GB HBM အတွက် သတ်မှတ်ထားတဲ့ လမ်းကြောင်းတစ်ခု ပါဝင်ပါတယ်။ စနစ်တစ်ခုလုံးကို liquid-cooled နဲ့ ပြုလုပ်ထားပြီး x86 host က WS300 review မှာ ကျွန်တော်တို့ flag လုပ်ထားတဲ့ Arm toolchain friction ကို ရှောင်လွှဲထားပါတယ်။
မေးခွန်းထုတ်စရာကတော့ PCIe-attached card တွေကို NVLink-C2C နဲ့ ဘယ်လောက်ထိ ကိုက်ညီအောင် မော်ဒယ်တွေက တပ်ဆင်အသုံးပြုထားလဲဆိုတာပါပဲ။ AMD ကတော့ benchmark၊ ဈေးနှုန်း ဒါမှမဟုတ် ရရှိနိုင်မှုကို မပြသထားပါဘူး။ ဒါကြောင့် ဒါက စောင့်ကြည့်ရမယ့်အရာပါ။ အသေးစိတ်အချက်အလက်တွေကို ကျွန်တော်တို့ရဲ့ ကြေငြာချက်မှာ ဖော်ပြထားပါတယ် ။ hardware က ဓာတ်ခွဲခန်းကို ရောက်တဲ့အခါ အဆင့်သတ်မှတ်ချက်တွေထဲ ထည့်သွင်းသွားမှာပါ။
စမ်းသပ်ပြီးပါပြီ- Deskside AI Appliances
ဤစနစ်များသည် တူညီသော ဓာတ်ခွဲခန်းလုပ်ငန်းစဉ်ကို ဖြတ်သန်းခဲ့ပြီး အမျိုးအစားအလိုက် မပါဝင်သည့် ခိုင်မာသော ရွေးချယ်မှုများဖြစ်သည်- GB10 ပါ Dell Pro Max ၊ ASUS Ascent GX10 ၊ GIGABYTE AI TOP ATOM ၊ HP ZGX Nano G1n နှင့် HP EliteDesk 8 Mini G1a ။
ဒေသတွင်း AI အတွက် Workstation Towers များ
ရယူမှုကုန်ကျစရိတ် (အပြန်အလှန်တုံ့ပြန်နိုင်သော coding assistant များ၊ multi-user serving၊ tool-call chain ရှည်လျားသော agentic pipelines များ) ထက် response time က ပိုအရေးကြီးသည့်အခါ discrete VRAM က ဆက်လက်အုပ်ချုပ်နေဆဲဖြစ်သည်။ ဤ tower များကို inference throughput နှင့် memory ceiling အလိုက် အဆင့်သတ်မှတ်ထားပြီး တစ်ခုချင်းစီအတွက် ကျွန်ုပ်တို့စမ်းသပ်ထားသော GPU configuration ကို chassis အမြင့်ဆုံးနှင့်အတူ စာရင်းပြုစုထားပါသည်။ အဘယ်ကြောင့်ဆိုသော် chassis တစ်ခုက ကျွန်ုပ်တို့၏ build တွင် ပို့ဆောင်ပေးသည့်အရာကဲ့သို့ပင် အရေးကြီးသောကြောင့်ဖြစ်သည်။ ဤအပိုင်းတွင် အဆင့်သတ်မှတ်ရန် tower တစ်ခုသည် GPU နှစ်ခု သို့မဟုတ် နှစ်ခုထက်ပို၍ လိုအပ်ပါသည်။ 96GB RTX PRO 6000 ပါသည့် tower များအပါအဝင် single-GPU tower များကို ကျွန်ုပ်တို့၏ Windows client suite ရှိ အကောင်းဆုံး Desktop Workstations စာမျက်နှာတွင် အဆင့်သတ်မှတ်ထားပါသည်၊ အဘယ်ကြောင့်ဆိုသော် ၎င်းတို့သည် မတူညီသောမေးခွန်းတစ်ခုကို ဖြေဆိုပေးသောကြောင့်ဖြစ်သည်။
ဒေသတွင်း AI အတွက် အကောင်းဆုံး Tower: Dell Precision 7875
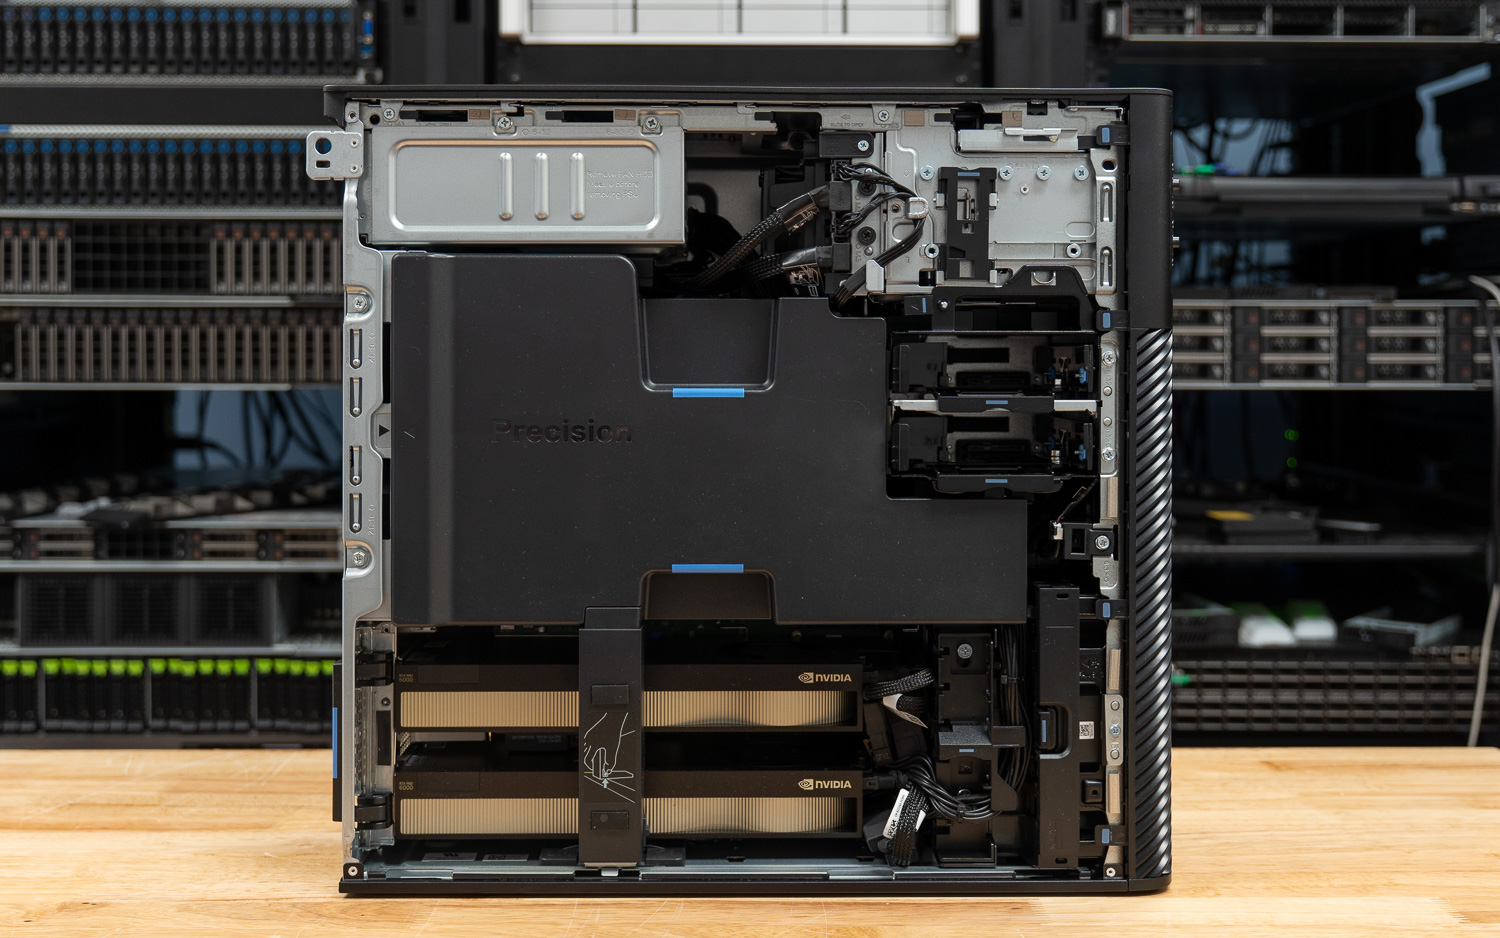
Dual RTX PRO 6000 Blackwell GPU များကြောင့် Precision 7875 ကို ကျွန်ုပ်တို့ local inference အတွက် စမ်းသပ်ဖူးသမျှ အမြန်ဆုံး standard-form-factor system ဖြစ်စေသည်။ Threadripper PRO 9995WX နှင့် ကတ်နှစ်ခုတွင် ပေါင်းစပ် VRAM 192GB ဖြင့် 100B-class မော်ဒယ်များကို GPU memory တွင် အပြည့်အဝ သိမ်းဆည်းထားပြီး မည်သည့် unified-memory appliance မှ မချဉ်းကပ်နိုင်သော interactive-grade time-to-first-token ကို ပေးဆောင်သည်။ သို့သော် အမြင့်ဆုံးကန့်သတ်ချက်ကို သိထားပါ- 7875 chassis သည် dual-width ကတ်နှစ်ခုအထိ အများဆုံး ပံ့ပိုးပေးသောကြောင့် ကျွန်ုပ်တို့၏ dual-GPU တည်ဆောက်မှုသည် maxed-out configuration ဖြစ်သည်။ နောက်ပိုင်းတွင် တတိယကတ်ကို ထည့်သွင်းရန် မလိုအပ်ပါ။
Precision 7875 သုံးသပ်ချက်အပြည့်အစုံကို ဖတ်ရှုပါ။
အကောင်းဆုံး Multi-GPU ပလက်ဖောင်း- HP Z8 Fury G6i
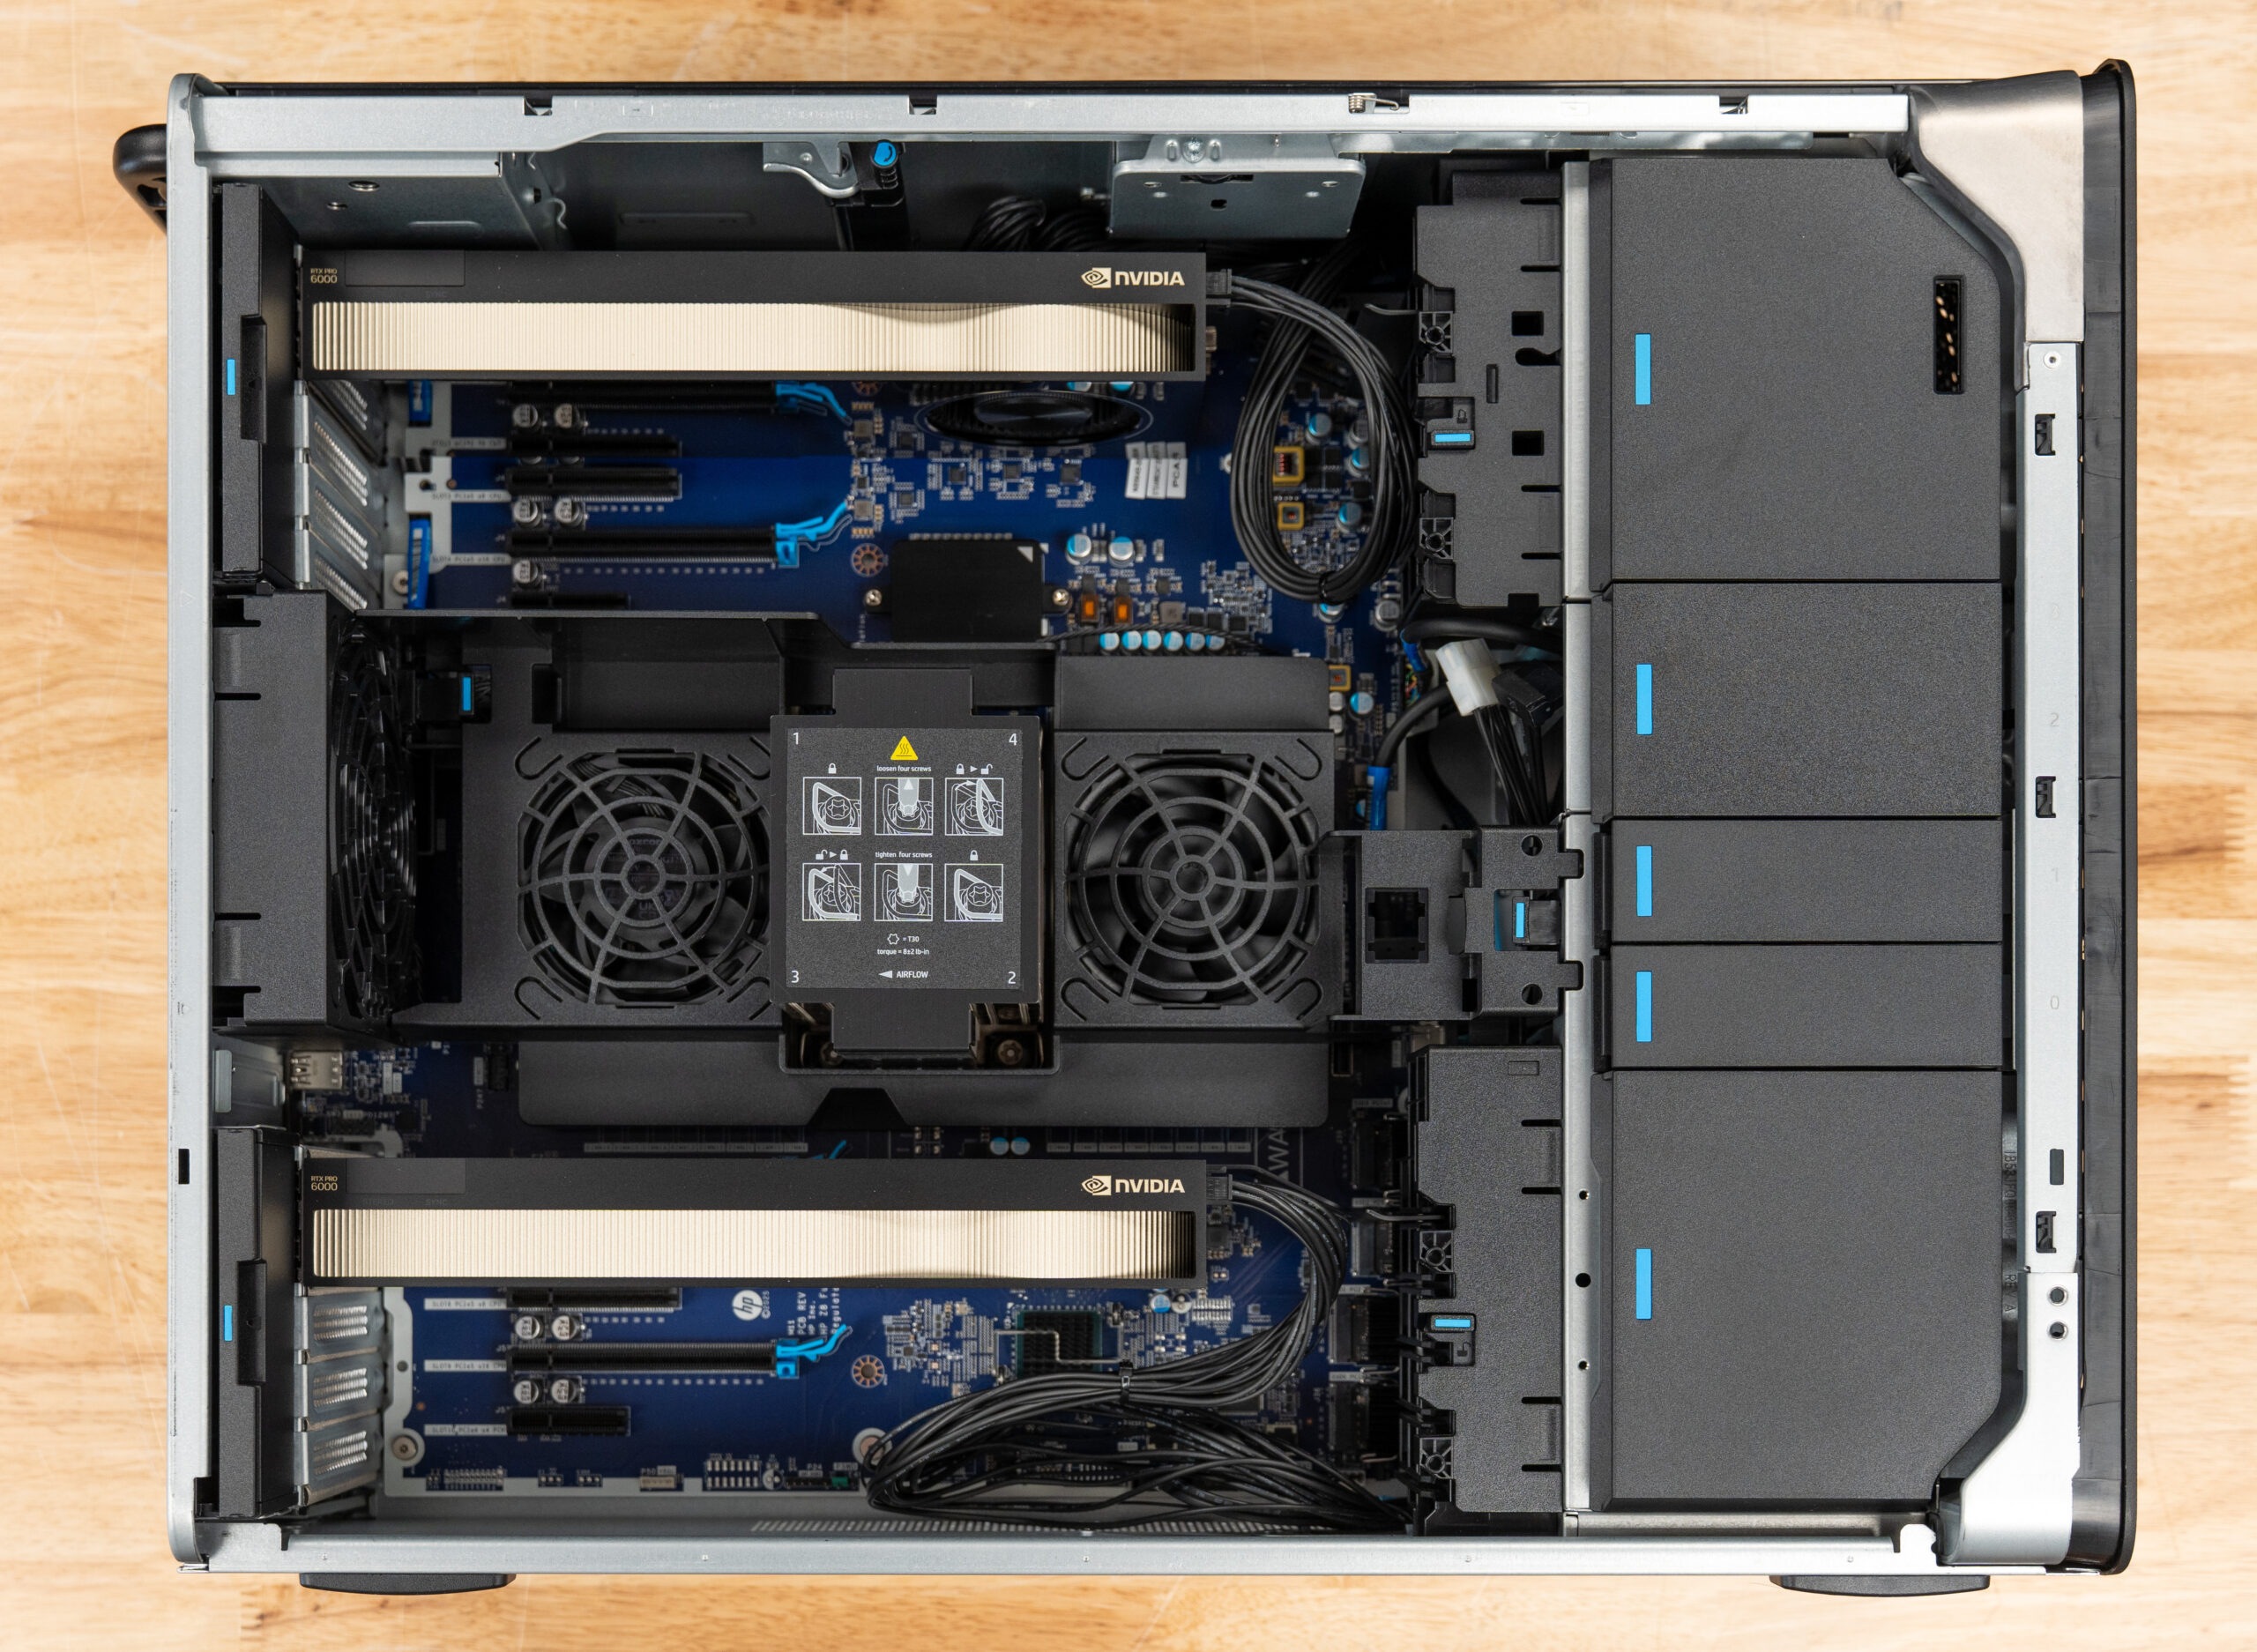
Z8 Fury G6i ဟာ GPU တွေ ပိုမိုထုတ်လုပ်ဖို့ စီစဉ်ထားတဲ့အခါ ဝယ်ယူသင့်တဲ့ tower ပါ။ ကျွန်ုပ်တို့ရဲ့ review build မှာ RTX PRO 6000 Max-Q ကတ်နှစ်ခုကို ပေါင်းစပ်ထားတဲ့ 192GB VRAM အတွက် အသုံးပြုထားပေမယ့်၊ စုစုပေါင်း 2700W အထိရှိတဲ့ dual power supply တွေနဲ့ ထောက်ပံ့ပေးထားတဲ့ chassis ဟာ Blackwell ကတ်လေးကတ်နဲ့ 384GB VRAM အထိ ထောက်ပံ့ပေးပါတယ်။ စမ်းသပ်ပြီးသားနဲ့ အမြင့်ဆုံးကြားက ကွာဟချက်က အဓိကအချက်ပါပဲ။ ကျွန်ုပ်တို့ စမ်းသပ်ထားတဲ့ standard OEM tower တွေမှာ GPU ပိုများတဲ့ နေရာလွတ် မပေးနိုင်ဘဲ၊ ကတ်နှစ်ခုကနေ လေးကတ်အထိ သွားဖို့ chassis ပြောင်းလဲဖို့ မလိုအပ်ပါဘူး။
Z8 Fury G6i သုံးသပ်ချက်အပြည့်အစုံကို ဖတ်ရှုပါ။
လွန်ကဲရွေးချယ်မှု- Comino Grando RTX PRO 6000
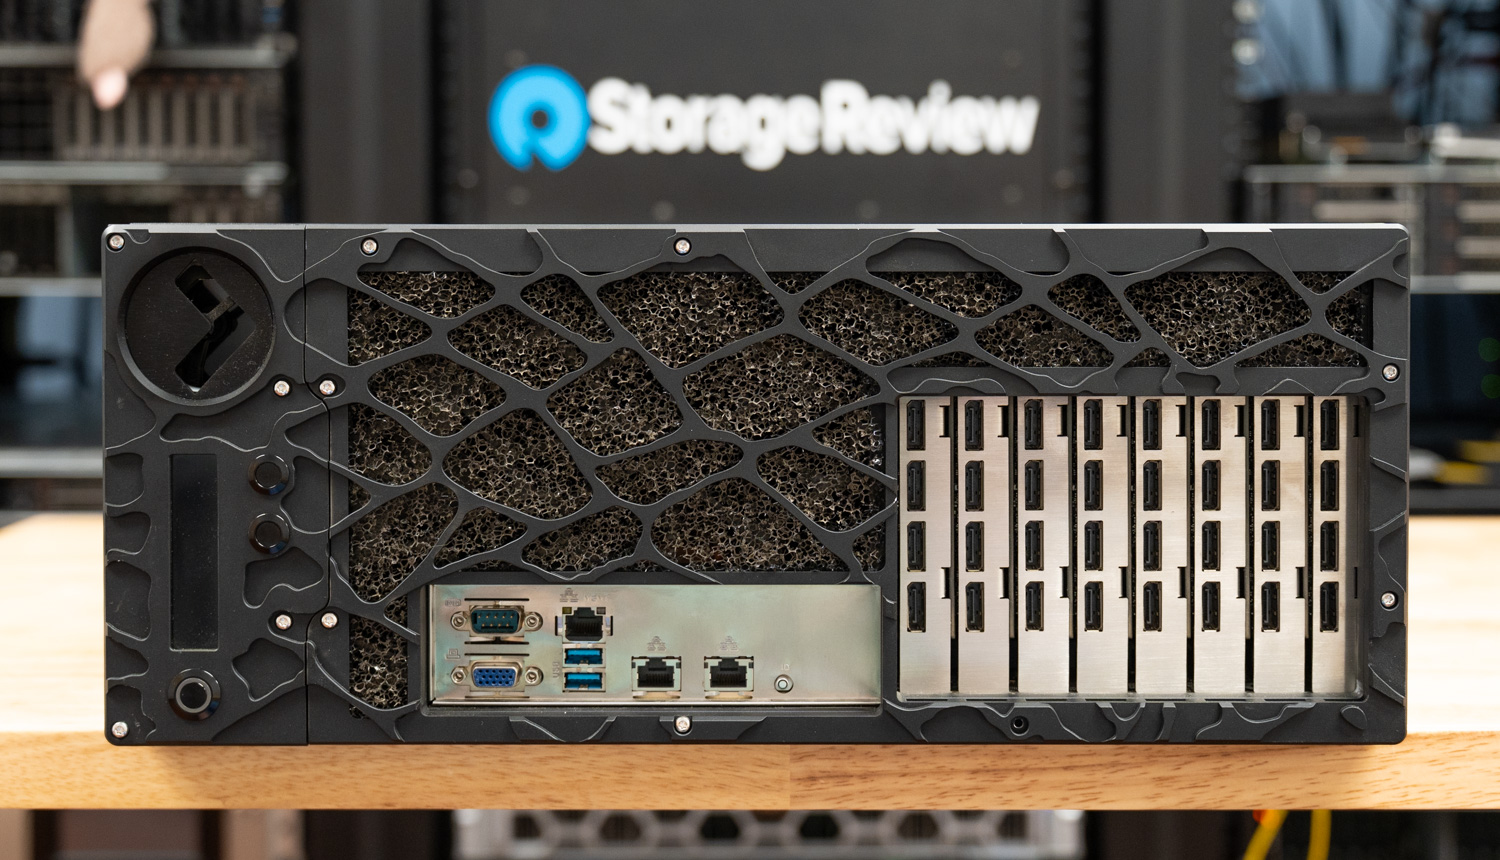
အရည်အအေးပေးစနစ် 4U ကိုယ်ထည်မှာ 768GB VRAM ပါဝင်ပါတယ်- Grando ဟာ တခြားဘယ်နေရာမှာမှ မတပ်ဆင်နိုင်တဲ့ ဝယ်ယူသူတွေအတွက် ရှိနေပါတယ်။ ကျွန်ုပ်တို့ရဲ့ သုံးသပ်ချက်ယူနစ်မှာ RTX PRO 6000 Blackwell ကတ် ရှစ်ကတ်ပါဝင်ပြီး တစ်လုံးကို 96GB (အများဆုံး ကိုယ်ထည်) နဲ့ ပါရှိပြီး Comino ရဲ့ အရည်အအေးပေးစနစ်က ရှစ်ကတ်လုံးကို အပြည့်အဝ TDP မှာ ၂၄ နာရီ ထိန်းထားပေးပါတယ်။ အဲဒါက စားပွဲဘေးမှာ ရှိနေနိုင်တဲ့ rack server အများစုထက် GPU မှတ်ဉာဏ်ပိုများပါတယ်။ အသံပိုင်းမှာမဟုတ်ဘဲ ဈေးနှုန်းအရ ကျယ်ပြီး ဒီစာရင်းမှာ တမင်တကာ ထူးခြားနေတာပါ- စားပွဲဘေးမှာ ရှိတဲ့ အမြင့်ဆုံးပမာဏရဲ့ သက်သေပါပဲ။
Comino Grando သုံးသပ်ချက်အပြည့်အစုံကို ဖတ်ရှုပါ။
ကျွန်ုပ်တို့ အဆင့်သတ်မှတ်ပုံ
StorageReview leaderboard တိုင်းကို စည်းမျဉ်းသုံးခုက အုပ်ချုပ်ပြီး ပထမအချက်ကတော့ ဓာတ်ခွဲခန်းစမ်းသပ်ပြီးသား စနစ်တွေကိုသာ အဆင့်သတ်မှတ်ပါတယ် - ကျွန်ုပ်တို့ benchmark မလုပ်ထားဘူးဆိုရင် ဖော်ပြနိုင်ပေမယ့် အမျိုးအစားတစ်ခုကိုတော့ ထိန်းသိမ်းထားလို့မရပါဘူး။ ဒုတိယအချက်အနေနဲ့ စနစ်တွေကို တိုင်းတာမှုတစ်ခုအတွက် တစ်ကြိမ်သာ အဆင့်သတ်မှတ်ပါတယ်။ အထက်ဖော်ပြပါ tower တွေဟာ SPECworkstation အရ ကျွန်ုပ်တို့ရဲ့ desktop workstation leaderboard မှာလည်း အဆင့်သတ်မှတ်ခံရပြီး ၂၀၂၆ ခုနှစ် အောက်တိုဘာလအထိ စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ပြီး အဲဒီစာမျက်နှာက single-GPU စနစ်တွေဆီ ပြောင်းလဲသွားတဲ့အထိပါပဲ။ သူတို့ရဲ့ရလဒ်တွေက သူတို့ရဲ့ review တွေမှာ ရှိနေဦးမှာဖြစ်ပြီး ဒီမှာ inference throughput နဲ့ memory ceiling အလိုက် အဆင့်သတ်မှတ်ခံရပါတယ်။
တတိယအချက်အနေနဲ့ entry bar တစ်ခုရှိပါတယ်- စနစ်တစ်ခုဟာ Linux အောက်မှာ vLLM နဲ့ စမ်းသပ်ထားတဲ့ GPU နှစ်ခု ဒါမှမဟုတ် နှစ်ခုထက်ပိုတဲ့ GPU တွေ လိုအပ်ပါတယ်၊ ဒါမှမဟုတ် မော်ဒယ်တွေအတွက် အနည်းဆုံး 96GB ရရှိနိုင်တဲ့ shared memory pool တစ်ခု လိုအပ်ပါတယ်။ 96GB card ပါရင်တောင် single-GPU tower တွေကို Windows client suite မှာရှိတဲ့ Best Desktop Workstations စာမျက်နှာမှာ အဆင့်သတ်မှတ်ထားပါတယ်။
အဆင့်သတ်မှတ်ချက်များကို vLLM အွန်လိုင်းဝန်ဆောင်မှု throughput၊ ပထမဆုံးတိုကင်သို့အချိန်၊ အထွက်တိုကင်တစ်ခုလျှင်အချိန်၊ MAMF တွက်ချက်မှုထိရောက်မှု၊ GDSIO သိုလှောင်မှုစွမ်းဆောင်ရည်နှင့် လမ်းဘေးဈေးနှုန်းတို့ ပေါင်းစပ်ထားခြင်းဖြစ်သည်။ အယ်ဒီတာ့အာဘော်ဆုံးဖြတ်ချက်သည် အမှတ်ပေးအဆင့်များအတွင်း ဆက်စပ်မှုများကို ဖြတ်တောက်ပေးသည်။ ရောင်းချသူများသည် ထုတ်ဝေခြင်းမပြုမီ အဆင့်သတ်မှတ်ချက်များကို မမြင်တွေ့ရဘဲ ဤစာမျက်နှာတွင် မည်သည့်နေရာမှ ငွေပေးချေခြင်းမရှိပါ။
ဒေသတွင်း AI Desktop FAQ
အေးဂျင့် AI အတွက် အကောင်းဆုံး desktop က ဘာလဲ။
coding agent များ၊ tool-calling pipelines များနှင့် multi-step autonomous task များကဲ့သို့သော Agentic workloads များသည် single-chat အသုံးပြုမှုကဲ့သို့ throughput နှင့် latency-sensitive ဖြစ်ပြီး၊ အဘယ်ကြောင့်ဆိုသော် agent များသည် model call အများအပြားကို context ကြီးမားသော context ဖြင့် chain လုပ်သောကြောင့်ဖြစ်သည်။ ၎င်းသည် tower tier ကို အကျိုးပြုသည်- Dell Precision 7875 ၏ discrete VRAM သည် agent chain ရှည်များကို တုံ့ပြန်မှုရှိစေသည့် ရေရှည်တည်တံ့သော time-to-first-token ကို ပေးဆောင်သည်။ ဘတ်ဂျက်ကို သတိထားသော agentic စမ်းသပ်မှုအတွက်၊ GB10-class appliance သည် တူညီသော stack များကို အမြန်နှုန်းနိမ့်ဖြင့် လည်ပတ်သည်။ ကျွန်ုပ်တို့၏ အပြည့်အဝ sizing လမ်းညွှန်ချက်သည် Agentic AI အတွက် RAM၊ GPU နှင့် Storage တွင် ရှိသည် ။
70B မော်ဒယ်ကို ဒေသတွင်းမှာ run ဖို့ မှတ်ဉာဏ် ဘယ်လောက်လိုအပ်လဲ။
အလုပ်လုပ်တဲ့စည်းမျဉ်းအရ 4-bit quantization မှာရှိတဲ့ 70B မော်ဒယ်ဟာ context မတိုင်ခင် model-accessible memory 40-48GB လောက် လိုအပ်ပါတယ်။ context ရှည်လျားတဲ့ context နဲ့ အဆင်ပြေတဲ့ interactive use အတွက်ဆိုရင် ပိုပြီးလိုအပ်ပါတယ်။ ဒါကြောင့် 128GB unified-memory appliances တွေဟာ 70B-class မော်ဒယ်တွေကို ကောင်းကောင်းကိုင်တွယ်နိုင်ပြီး single-GPU towers တွေကို ကျွန်ုပ်တို့ရဲ့ Best Desktop Workstations စာမျက်နှာမှာ အဆင့်သတ်မှတ်ခံရတာ ဖြစ်ပါတယ်။
ဒီစနစ်တွေကို လည်ပတ်ဖို့ အထူးစွမ်းအား လိုအပ်ပါသလား။
ပစ္စည်းအဆင့်အတွက်၊ GB10-အတန်းအစား သေတ္တာများနှင့် Strix Halo စနစ်များသည် စံရုံးပလပ်တွင် အဆင်ပြေစွာ လည်ပတ်နိုင်သည်။ တာဝါများသည် အဆောက်အအုံပိုင်ရှင်နှင့် အမှန်တကယ် စကားပြောဆိုရန် ထိုက်တန်ပါသည်။ အပြည့်အဝ ပြင်ဆင်ထားသော HP Z8 Fury G6i သည် စုစုပေါင်း 2700W အထိရှိသော dual power supplies များကို သယ်ဆောင်နိုင်ပြီး၊ စံ 15-amp၊ 120V ဆားကစ်ထက် ပိုမိုများပြားပြီး Comino Grando သည် 180-264V input လိုအပ်သည့် 2000W hot-swap supplies ကို သတ်မှတ်ထားပြီး 110V ဝန်ဆောင်မှုတွင် 1000W ယူနစ်များသို့ ကျဆင်းသွားသည်။
ဤစာမျက်နှာ၏ထိပ်မှဝယ်ယူခြင်းမပြုမီ နံရံက မည်သည့်အရာကို ထောက်ပံ့ပေးနိုင်သည်ကို စစ်ဆေးပါ။ သီးသန့်ဆားကစ် သို့မဟုတ် 208/240V ဝန်ဆောင်မှုသည် GPU အပြည့်အဝ loadout ၏ တကယ့်ကုန်ကျစရိတ်၏ တစ်စိတ်တစ်ပိုင်းဖြစ်နိုင်သည်။ အသုံးပြုသောဝပ်တိုင်းသည် အခန်းထဲသို့ အဆုံးသတ်သွားသောကြောင့် အပူသည်လည်း တွက်ချက်မှုတူညီသည်။
Mac Studio ကရော ဘယ်လိုလဲ။
ကျွန်တော်တို့ ဓာတ်ခွဲခန်းမှာ စမ်းသပ်မထားသေးလို့ပါ။ Apple က Mac Studio ကို M5 Max နဲ့ M5 Ultra ပါတဲ့ စက်တင်ဘာ ၂၂ ရက်နေ့မှာ စတင်ရောင်းချခဲ့ပြီး M5 Max ကို 128GB အထိ unified memory နဲ့ $2,499 ကနေစတင်ပြီး M5 Ultra ကို 512GB အထိ $5,499 ကနေစတင်ရောင်းချပါတယ်။ အရွယ်အစားကြီးတဲ့ မော်ဒယ်တွေအတွက် အရေးအကြီးဆုံးဖြစ်တဲ့ 512GB configuration ကို Apple က မကြေညာထားတဲ့ ဈေးနှုန်းနဲ့ အောက်တိုဘာလကုန်မှာ ရောင်းချပေးသွားမှာပါ။ ကျွန်တော်တို့ စမ်းသပ်ကြည့်မယ်ဆိုရင် ဒီစာမျက်နှာမှာရှိတဲ့ စနစ်တိုင်းလိုပဲ တိုင်းတာထားတဲ့ ရလဒ်တွေအရ အဆင့်သတ်မှတ်ပေးပါတယ်။


 အမေဇုံ