

၂၀၂၆ ခုနှစ်၊ နိုဝင်ဘာလ ၃ ရက်နေ့တွင် အပ်ဒိတ်လုပ်ခဲ့သည်- AMD Instinct MI350P သည် ကျွန်ုပ်တို့၏ 450W ကို ပထမဆုံးကြည့်ရှုမှုမှစ၍ Also Tested နှင့် ပူးပေါင်းခဲ့ပြီး ၎င်း၏ ကတ်နှစ်ခုပါ ရလဒ်များသည် Scale-Out Configurations နှင့် ပူးပေါင်းခဲ့သည်။ ၎င်းသည် Ministral 3 ladder ကို 600W တွင် ပြီးမြောက်သည်နှင့် အဆင့်သတ်မှတ်ခံရသည်။ ၂၀၂၆ ခုနှစ်၊ အောက်တိုဘာလ ၁၄ ရက်နေ့တွင် ထုတ်ဝေခဲ့သည်။ PCIe accelerator ငါးခုကို vLLM container တစ်ခုနှင့် model set တစ်ခုတွင် အဆင့်သတ်မှတ်ခဲ့ပြီး H100 NVL နှင့် MI350P တို့ကို Also Tested တွင် ထည့်သွင်းထားသည်။ H200 NVL တွင် အောက်တွင်ရှင်းပြထားသော power note ပါရှိသည်။
ဤစာမျက်နှာတွင် အဆင့်သတ်မှတ်ထားသော accelerator တိုင်းကို StorageReview lab မှတစ်ဆင့် PCIe ကတ်တစ်ခုတည်းအဖြစ် ဖြတ်သန်းခဲ့သည်။ enterprise GPU ဈေးကွက်ကို AI စက်ရုံများကို ဖြည့်သွင်းသည့် HGX နှင့် OAM မော်ဂျူးများနှင့် ဒေတာစင်တာအများစုတွင် လည်ပတ်နေပြီးဖြစ်သော 2U နှင့် 4U ဆာဗာများထဲသို့ ဝင်သွားသည့် add-in ကတ်များအဖြစ် ပိုင်းခြားထားပြီး ဤစာမျက်နှာတွင် ဒုတိယအုပ်စုကိုသာ ဖော်ပြထားသည်- mainstream server configurator တွင် မှာယူနိုင်ပြီး သင်ရှိပြီးသား rack ထဲသို့ slot လုပ်နိုင်သည့် ဒေတာစင်တာ GPU။
အဲဒါက enterprise inference ဈေးကွက်ဖြစ်ပြီး enterprise inference ဆိုတာ ဒီမှာရှိတဲ့ ကတ်တိုင်းရဲ့ အဆင့်သတ်မှတ်ချက်ပါ။ ရွေးချယ်မှုတိုင်းဟာ ဒေတာတွေကို သိမ်းဆည်းထားတဲ့ သုံးသပ်ချက်နဲ့ ချိတ်ဆက်ထားပြီး အဆင့်သတ်မှတ်ချက်က ကတ်တိုင်းရဲ့ တူညီတဲ့ စမ်းသပ်မှုကနေ ရရှိတာပါ။
အဲဒီစမ်းသပ်မှုက vLLM အွန်လိုင်းဝန်ဆောင်မှုဖြစ်ပြီး၊ enterprise inference အများစု run တဲ့ stack ပေါ်မှာ run ပါတယ်၊ card တိုင်းမှာ concurrent stream ၁ ခုကနေ ၃၂ ခုအထိ၊ Hopper card နှစ်ခုမှာ ၁၂၈ ခုအထိ၊ NGC vLLM 26.08 container (CUDA 13.4.1 မှာ vLLM 0.27.1) နဲ့ တူညီတဲ့ 595.71.05 driver ထဲမှာရှိတဲ့ model လေးခုမှာ ဖြစ်ပါတယ်။
ကတ်ခြောက်ကတ်အနက် ငါးကတ်ကို ကျွန်ုပ်တို့၏ Dell PowerEdge R770 တွင် server မှ GPU slot သို့ ပေးပို့သော ပါဝါဖြင့် လည်ပတ်ခဲ့ပြီး RTX PRO 6000 သည် ကျွန်ုပ်တို့၏ Dell Pro Max Tower T2 တွင် တူညီသော container နှင့် driver ဖြင့် လည်ပတ်ခဲ့သည်။ အောက်တွင် သင်မြင်ရသော အစီအစဉ်သည် ကျွန်ုပ်တို့ လည်ပတ်သော မော်ဒယ်တိုင်းနှင့် နှစ်မျိုးလုံးတွင် ရှိနေသောကြောင့် အဆင့်သတ်မှတ်ချက်သည် အမြင့်ဆုံးရလဒ်တစ်ခုတည်းအတွက် မဟုတ်ပါ။
ဒီအတန်းအစားမှာ ကွန်ပျူတာထက် မှတ်ဉာဏ်က ပိုပြီးဆုံးဖြတ်ပေးပါတယ်။ 24GB ဒါမှမဟုတ် 32GB ကတ်တစ်ခုဟာ chat length မှာ အသေးစားနဲ့ အလတ်စား မော်ဒယ်တွေကို ပံ့ပိုးပေးပြီး prompts ရှည်တွေစုပုံလာတာနဲ့ KV cache ကုန်သွားပါတယ်။ 48GB ဒါမှမဟုတ် 96GB ကတ်တစ်ခုမှာ multi-tenant concurrency အတွက် နေရာရှိတဲ့ အလတ်စား မော်ဒယ်တွေကို သယ်ဆောင်ထားပြီး 94GB နဲ့ 141GB HBM ကတ်တွေကတော့ 70B ကနေ 120B band မှာရှိတဲ့ မော်ဒယ်တစ်ခုဟာ GPU တစ်ခုတည်းမှာ ရှိနေတဲ့နေရာပါ။ ရွေးချယ်မှုတွေကို အဲဒီ split ပေါ်မှာ စီစဉ်ထားပြီး အောက်ခြေမှာရှိတဲ့ FAQ က ဝယ်သူတွေ အများဆုံးမေးလေ့ရှိတဲ့ နှိုင်းယှဉ်မေးခွန်းတွေကို ဖြေကြားပေးပါတယ်။ RTX PRO 6000 နဲ့ H100 ကနေ 2U မှာ 450W နဲ့ 600W ဘယ်လောက်တန်ဖိုးရှိလဲအထိပါ။
တစ်တစ်ချက်မှာ
တစ်စက္ကန့်လျှင် output token များသည် Ministral 3 14B Instruct FP8 မှဖြစ်ပြီး၊ 512-in, 512-out chat shape နှင့် 8,192-in, 1,024-out document shape ပေါ်တွင် ပြီးစီးသော ကတ်တိုင်း၏ အလေးဆုံးအချက်ဖြစ်သည့် တစ်ပြိုင်နက်တည်း stream ၃၂ ခုတွင် ရရှိသည်။ FP8 သည် TFLOPS တွင် MAMF အများဆုံးရရှိနိုင်သော matmul ရလဒ်ဖြစ်ပြီး၊ ရောင်းချသူ၏ အထွတ်အထိပ်မဟုတ်ဘဲ ရေရှည်တည်တံ့သော dense GEMM တိုင်းတာမှုတစ်ခုဖြစ်သည်။
| အမျိုးအစား | တိုး။ မြန်စေသောအရာ | မှတ်ဉာဏ် / လှိုင်းအလျား | စမ်းသပ်ပြီးသော slot များ / ပါဝါ | ချတ် ၅၁၂/၅၁၂ (tok/s) | စာရွက်စာတမ်း ၈၀၀၀/၁၀၀၀ (တိုခ်/စက္ကန့်) | MAMF FP8 (TFLOPS) | အပြည့်အဝပြန်လည်ဆန်းစစ်ခြင်း |
|---|---|---|---|---|---|---|---|
| အကောင်းဆုံး PCIe AI Accelerator | NVIDIA H200 NVL* | 141GB HBM3e / 4.8TB/s | နှစ်ခုတွဲ slot / 450W* | 3,435 | 1,038 | 1,262 | ET900N G3 သုံးသပ်ချက် (H200 NVL ဒေတာ) |
| အကောင်းဆုံး Enterprise Inference GPU | NVIDIA RTX PRO 6000 Blackwell Server Edition | 96GB GDDR7 / 1.6TB/s | နှစ်ခုတွဲ slot / 600W (450W ဦးထုပ်ကိုလည်း စမ်းသပ်ပြီး) | 2,283 | 608 | 774 | RTX PRO 6000 သုံးသပ်ချက် |
| အကောင်းဆုံး Single-Slot GPU | NVIDIA RTX PRO 4500 Blackwell Server Edition | 32GB GDDR7 / 800GB/s | တစ်ပေါက်/၁၆၅ ဝပ် | 1,107 | 190 | 280 | RTX PRO 4500 SE သုံးသပ်ချက် |
| အကောင်းဆုံး Mainstream Inference GPU ကို ဆက်လက်တင်ပို့နေဆဲပါ။ | NVIDIA L40S | 48GB GDDR6 / 864GB/s | နှစ်ခုတွဲ slot / 350W | 995 | 230 | 369 | RTX PRO 4500 SE ပြန်လည်သုံးသပ်ခြင်း (L40S ဒေတာ) |
| 1U နှင့် Edge အတွက် အကောင်းဆုံး Slot-Powered Card | NVIDIA L4 | 24GB GDDR6 / 300GB/s | တစ်ပေါက်တည်းသုံး HHHL / 72W | 364 | 42 | 116 | L4 သုံးသပ်ချက် |
*H200 NVL ကို 450W မှာ စမ်းသပ်ခဲ့ပြီး Dell PowerEdge R770 GPU slot က အများဆုံး ပေးစွမ်းနိုင်ပါတယ်။ ကတ်ကို 600W အဆင့်သတ်မှတ်ထားပြီး ကျွန်တော်တို့ အဲဒီမှာ မလည်ပတ်ရသေးတာကြောင့် ဒီစာမျက်နှာမှာရှိတဲ့ ကိန်းဂဏန်းတွေက ကြမ်းပြင်အဆင့်ပဲ ရှိပါတယ်။ RTX PRO 6000 ကိန်းဂဏန်းတွေက Workstation Edition ကနေ လာတာပါ။ NVIDIA က edition နှစ်ခုလုံးကို 600W အဆင့်သတ်မှတ်ထားပြီး ကျွန်တော်တို့ရဲ့ စမ်းသပ်မှုမှာ တူညီတဲ့ profile ရှိပြီး Server Edition ကတော့ GPU နဲ့ memory တူညီတဲ့ passive, headless board ဖြစ်ပါတယ်။
ရွေးချယ်မှုများ
အကောင်းဆုံး PCIe AI Accelerator: NVIDIA H200 NVL
H200 NVL ဟာ ကျွန်တော်တို့တိုင်းတာဖူးသမျှထဲမှာ အမြန်ဆုံး add-in ကတ်ဖြစ်ပြီး ဒီစာမျက်နှာမှာ stream ၃၂ ခုကို ကျော်လွန်နေတဲ့ တစ်ခုတည်းသော ကတ်လည်း ဖြစ်ပါတယ်။ Ministral 3 14B FP8 မှာ concurrent stream ၃၂ ခုမှာ တစ်စက္ကန့်ကို output token ၃၄၃၅ ခု ပေးစွမ်းနိုင်ပြီး H100 NVL မှာ ၃၀၉၆ ခုနဲ့ RTX PRO 6000 မှာ ၂၂၈၃ ခု ပေးစွမ်းနိုင်ခဲ့ပါတယ်။ concurrency မြင့်တက်လာတာနဲ့အမျှ ကွာဟချက်က ပိုကျယ်လာပါတယ်။ RTX ကတ်တွေ ရပ်တန့်သွားတဲ့အချိန်မှာ stream ၁၂၈ ခုမှာ တစ်စက္ကန့်ကို ၇၃၃၆ ခု ရရှိခဲ့ပါတယ်။ 8,192-token document shape မှာ HBM3e ရဲ့ 141GB ဟာ ဘယ်တော့မှ တိုတောင်းမသွားခဲ့ပါဘူး။ ကတ်ဟာ matched concurrency မှာ model တိုင်းမှာ H100 NVL ထက် ၂၁ ရာခိုင်နှုန်းကနေ ၂၃ ရာခိုင်နှုန်းအထိ သာလွန်နေပါတယ်။
Blackwell ကတ်နဲ့ ယှဉ်ရင် ဦးဆောင်မှုက spec sheet တွေက အကြံပြုထားတာထက် ပိုကျယ်ပါတယ်။ stream ၃၂ ခုမှာ H200 ဟာ FP8 နဲ့ BF16 မော်ဒယ်သုံးမျိုးမှာ RTX PRO 6000 ထက် ၅၀ ရာခိုင်နှုန်းကနေ ၈၁ ရာခိုင်နှုန်းအထိ သာလွန်ကောင်းမွန်ပြီး 8K input မှာ 14B မော်ဒယ်မှာ RTX ကတ်ရဲ့ 608 ထက် တစ်စက္ကန့်ကို token ၁၀၃၈ ခု ပိုများပါတယ်။ ဘာလို့လဲဆိုတော့ 4.8TB/s HBM feed တွေက GDDR7 ရဲ့ 1.6TB/s က decode မလုပ်ပေးနိုင်လို့ပါ။
ကတ်နှစ်ခု သို့မဟုတ် လေးကတ်သည် NVLink ကို 900GB/s ဖြင့် ဖြတ်ကျော်နိုင်ပြီး ဤနေရာတွင် အခြားကတ်များ မပေးနိုင်ပါ။ ကျွန်ုပ်တို့၏ H200 NVL နံပါတ်များသည် ET900N G3 သုံးသပ်ချက်တွင် RTX PRO 6000 နှင့် GB300 DGX Station ဘေးတွင် ပါရှိပြီး Station သည် GPT-OSS-20B တွင် 128 streams တွင် တစ်စက္ကန့်လျှင် output tokens 22,041 ရောက်ရှိခဲ့ပြီး ဤကတ်အတွက် 6,022 ရရှိခဲ့ပါသည်။
2U ဝယ်ယူသူတစ်ယောက်အတွက် power note က အရေးကြီးပါတယ်။ ဒီကတ်က PowerEdge R770 slot က ခွင့်ပြုတဲ့ 450W မှာ run နိုင်ပြီး 600W rating ကတော့ ကျွန်တော်တို့ရဲ့ lab မှာ မစမ်းသပ်ရသေးပါဘူး။ အားသာချက်မပြတဲ့ workload တစ်ခုက Qwen3.8-27B ရဲ့ NVFP4 build ပါ။ ကတ်မှာ FP4 hardware မပါပါဘူး။ vLLM က on the fly dequantize လုပ်ပါတယ်။ RTX PRO 6000 မှာတော့ တစ်စက္ကန့်ကို 467 tokens နဲ့ 616 tokens ပဲ ရှိပါတယ်။ memory နဲ့ bandwidth အတွက် ဝယ်ပါ။ အဲဒါက 70B ကနေ 120B အထိ deployment အတွက် လိုအပ်တဲ့အရာပါ။
ကျွန်ုပ်တို့၏ H200 NVL ရလဒ်များကို ပေးဆောင်သည့် ASUS ET900N G3 သုံးသပ်ချက်ကို ဖတ်ရှုပါ။
အကောင်းဆုံး Enterprise Inference GPU: NVIDIA RTX PRO 6000 Blackwell Server Edition
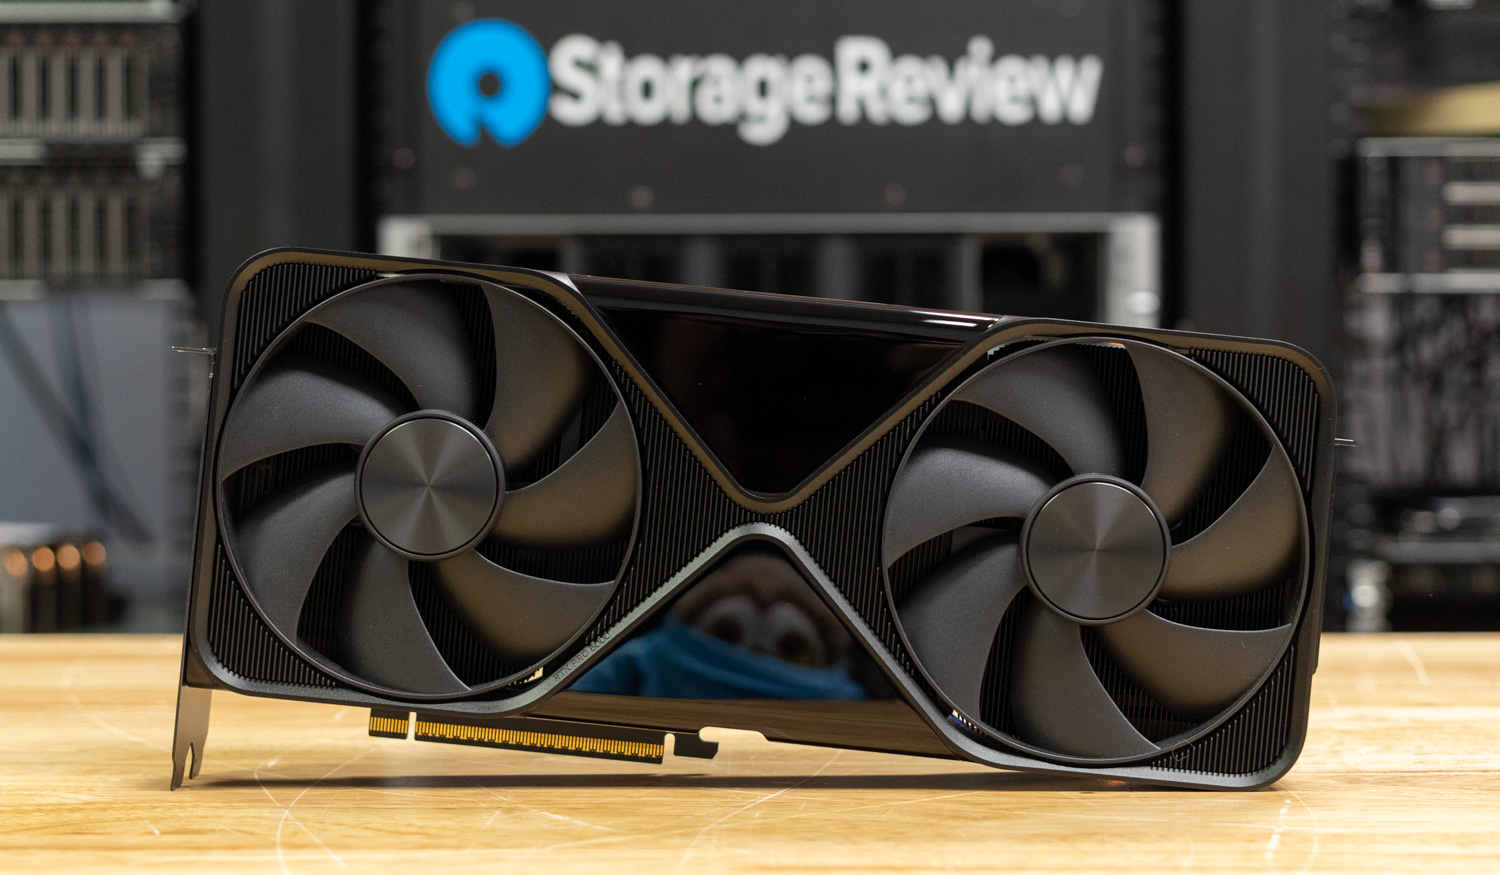
RTX PRO 6000 သည် ဤစာမျက်နှာရှိ enterprise inference GPU ဖြစ်သည်- enterprise များ ယခုဝယ်ယူနေသော 2U နှင့် 4U inference server များအတွက် တည်ဆောက်ထားသော Blackwell ကတ်ဖြစ်ပြီး HBM tier အောက်ရှိ အကြီးဆုံး frame buffer နှင့် ဤနေရာတွင်ရှိသော မည်သည့်ကတ်ထက်မဆို အကျယ်ပြန့်ဆုံး feature set ရှိသည်။ 600W မှာ Ministral 3 14B FP8 မှာ stream ၃၂ ခုမှာ တစ်စက္ကန့်ကို output token ၂,၂၈၃ ခု၊ 8B မော်ဒယ်မှာ ၂,၁၃၉ ခု နဲ့ 3B မှာ ၄,၁၅၅ ခု ပေးစွမ်းနိုင်ပြီး၊ အတိုချုပ်အားဖြင့် RTX PRO 4500 ထက် ၂ ဆခန့်နဲ့ 8K input မှာ ၂.၇x မှ ၃.၅x အထိ ပေးစွမ်းနိုင်ပြီး၊ 32GB နဲ့ 48GB ကတ်တွေကတော့ ပြတ်တောက်နေချိန်မှာ 96GB ကတော့ stream ၃၂ ခုအထိ မြင့်တက်နေပါတယ်။
MAMF တွင် FP8 တွင် 774 TFLOPS နှင့် NVFP4 တွင် 1,481 သို့ ရောက်ရှိခဲ့ပြီး စာမျက်နှာပေါ်ရှိ အမြင့်ဆုံး FP4 ကိန်းဂဏန်းဖြစ်သည်။
450W ကန့်သတ်ချက်က 2U ဝယ်ယူသူတစ်ဦးအား နောက်ဆုံး 150W ၏တန်ဖိုးကို ပြောပြသည်။ PowerEdge R770 slot တွင် အများဆုံးပေးစွမ်းနိုင်သည့် 450W တွင် သိမ်းဆည်းထားသော်လည်း ကတ်သည် ရေတိုအခြေအနေတွင် ၂ ရာခိုင်နှုန်းမှ ၅ ရာခိုင်နှုန်းနှင့် ရေရှည်အခြေအနေတွင် ၄ ရာခိုင်နှုန်းမှ ၉ ရာခိုင်နှုန်းအထိ ပေးစွမ်းနိုင်ပြီး ၎င်း၏ FP8 MAMF ရလဒ်သည် မပြောင်းလဲပါ။ ကန့်သတ်ချက်တွင် 14B မော်ဒယ်တွင် rated watt တစ်ခုလျှင် တစ်စက္ကန့်လျှင် 4.8 output tokens ပေးစွမ်းနိုင်ပြီး 600W တွင် 3.8 watt သာ ပေးစွမ်းနိုင်သောကြောင့် 2U ဝယ်ယူသူတစ်ဦးသည် ထိုနေရာတွင် လည်ပတ်ခြင်းဖြင့် ဆုံးရှုံးမှုနည်းပါးသည်။
၎င်းသည် ဤစာမျက်နှာတွင် RT cores၊ encoder နှင့် decoder လေးခုနှင့် display output များပါရှိသော တစ်ခုတည်းသော ကတ်လည်းဖြစ်သောကြောင့် rendering၊ transcoding သို့မဟုတ် vGPU အောက်ရှိ virtual workstation များကို ရောနှောထားသော server သည် ၎င်းအားလုံးအတွက် ကတ်တစ်ခုရရှိမည်ဖြစ်သည်။ ကျွန်ုပ်တို့၏ နံပါတ်များသည် Dell Pro Max Tower T2 ရှိ Workstation Edition မှ ဆင်းသက်လာခြင်းဖြစ်သည်။ NVIDIA သည် edition နှစ်ခုလုံးကို 600W ဖြင့် အဆင့်သတ်မှတ်ပြီး ကျွန်ုပ်တို့၏ စမ်းသပ်မှုတွင် ၎င်းတို့သည် profile တူညီပြီး Server Edition သည် GB202 GPU နှင့် ECC ပါသော 96GB GDDR7 ပါရှိသော passive၊ headless ဗားရှင်းဖြစ်သည်။
ကျွန်ုပ်တို့၏ဓာတ်ခွဲခန်းတွင်လည်း- HPE ProLiant DL380a Gen12 ရှိ Server Edition ကတ်လေးကတ် ၊ ET900N G3 သုံးသပ်ချက် အတွင်းရှိ Dell PowerEdge XE7740 ရှိ ကတ်နှစ်ခုနှင့် လေးကတ် ၊ အထက်ဖော်ပြပါနံပါတ်များကိုထုတ်လုပ်ပေးသော Dell Pro Max Tower T2 ရှိ ကတ်တစ်ခုတည်း ၊ Dell Pro Precision 9 T2 ရှိ 300W Max-Q နှင့် 600W ကတ်နှစ်ခုစလုံး ၊ 600W ကတ်သည် Xeon ကို all-core CPU အလုပ်တွင် ၄ မှ ၅ ရာခိုင်နှုန်းအထိ ကုန်ကျစေသည်၊ Comino Grando ရှိ ကတ်ရှစ်ကတ်နှင့် 768GB နှင့် Dell Precision 7875 နှင့် HP Z8 Fury G6i ရှိ dual Max-Q ကတ်များ ။
NVIDIA RTX PRO 6000 သုံးသပ်ချက်အပြည့်အစုံကို ဖတ်ရှုပါ။
အကောင်းဆုံး Single-Slot GPU: NVIDIA RTX PRO 4500 Blackwell Server Edition

RTX PRO 4500 Server Edition သည် single-slot၊ 165W ကတ်မှ L40S throughput ကို ပေးစွမ်းနိုင်ပြီး ၎င်းသည် mainstream server အများစု စောင့်မျှော်နေသည့် ကုန်သွယ်မှုဖြစ်သည်။ chat shape မှာ stream ၃၂ ခုနဲ့ဆိုရင် FP8 နဲ့ BF16 မော်ဒယ်တိုင်းမှာ L40S နဲ့ တူညီတယ် ဒါမှမဟုတ် သာလွန်တယ်- Ministral 3 14B FP8 မှာ တစ်စက္ကန့်ကို token ၉၉၅ ခုနဲ့ 1,107 ခု၊ 3B မော်ဒယ်မှာ တစ်စက္ကန့်ကို token ၉၉၅ ခုနဲ့ 2,006 ခု၊ L40S ရဲ့ power ရဲ့ ၄၇ ရာခိုင်နှုန်းနဲ့ slot တစ်ဝက်ရှိတဲ့ card ကနေ ရရှိပြီး 1,988 ခု ရရှိခဲ့ပါတယ်။ အစားထိုးလိုက်တဲ့ L4 နဲ့ ယှဉ်ရင် board power ရဲ့ ၂.၃ ဆ မှာ ၂.၈ ဆ မှ ၃.၆ ဆ ပိုမြန်ပြီး dual-slot card လေးခု ပါဝင်တဲ့ 2U chassis မှာ ဒီ card ရှစ်ခု ပါဝင်ပါတယ်။
ကန့်သတ်ချက်က 32GB ပါ- 8,192-token input မှာ ကတ်ဟာ L40S ထက် ၁၇ ရာခိုင်နှုန်းကနေ ၃၃ ရာခိုင်နှုန်းအထိ နောက်ကျကျန်ခဲ့ပြီး 48GB ကတ်ဟာ stream ရှစ်ခုမှာ ၁၆ အထိ မြင့်တက်နေခဲ့ပါတယ်။ အဘယ်ကြောင့်ဆိုသော် compute မဟုတ်ဘဲ KV cache ကုန်သွားလို့ပါ။ ၎င်းသည် 16-pin connector ပါရှိသော full-height၊ full-length board တစ်ခုလည်းဖြစ်သောကြောင့် L4 ၏ 1U နှင့် half-height အိမ်များသည် FHFL ကတ်များအတွက် တည်ဆောက်ထားသော chassis မပါဘဲ ၎င်းကို လက်ခံနိုင်မည်မဟုတ်ပါ။
NVFP4 ကတော့ ဒီ vLLM build မှာ ကျွန်တော်တို့ စမ်းသပ်ထားတဲ့ card တိုင်းနဲ့ တူညီတဲ့ နောက်ထပ်သတိပေးချက်တစ်ခုပါ- Qwen3.8-27B မှာ 4500 ဟာ stream ၃၂ ခုမှာ တစ်စက္ကန့်ကို token ၃၂၀ ထုတ်လုပ်ခဲ့ပြီး FP4 hardware ကတော့ MAMF မှာ 569 TFLOPS အထိ ရောက်ရှိခဲ့တာကြောင့် FP4 ရဲ့ အားသာချက်က GEMM အဆင့်မှာ ရှိနေပြီး serving stack ကို မရောက်သေးပါဘူး။ 16GB MIG partition နှစ်ခု၊ confidential computing နဲ့ vGPU 20 တို့က Workstation Edition မှာ မပါဝင်တဲ့ data center feature set ကို ပြီးပြည့်စုံစေပါတယ်။
ကျွန်ုပ်တို့၏ဓာတ်ခွဲခန်းတွင်လည်း- HPE ProLiant DL145 Gen11 အတွင်းရှိ L4 နှင့် ဆန့်ကျင်ဘက်ဖြစ်သော ကတ်တစ်ခုတည်း ၊ ဤတစ်ခုမတိုင်မီက edge server သုံးသပ်ချက်။
NVIDIA RTX PRO 4500 Blackwell Server Edition သုံးသပ်ချက်အပြည့်အစုံကို ဖတ်ရှုပါ။
အကောင်းဆုံး Mainstream Inference GPU ကို ဆက်လက်တင်ပို့နေဆဲဖြစ်သည်- NVIDIA L40S

L40S သည် နှစ်နှစ်ကြာ မူရင်း mainstream inference card တစ်ခုဖြစ်ခဲ့ပြီး 48GB ကြောင့် Blackwell ခေတ် စာမျက်နှာတွင် နေရာတစ်ခု ရရှိနေဆဲဖြစ်သည်။ chat shape မှာ Ministral 3 14B FP8 မှာ stream ၃၂ ခုမှာ တစ်စက္ကန့်ကို output token ၉၉၅ ခု၊ 8B model မှာ ၁၀၀၅ ခု နဲ့ 3B မှာ ၁၉၈၈ ခု ဝန်ဆောင်မှုပေးခဲ့ပါတယ်။
အဲဒါက RTX PRO 4500 ရဲ့ ၁၂ ရာခိုင်နှုန်းအတွင်းမှာပဲ ရှိပြီး 8K စာရွက်စာတမ်းပုံစံမှာ 14B မော်ဒယ်မှာ ၂၃၀ နဲ့ ၁၉၀၊ 8B မော်ဒယ်မှာ ၂၇၇ နဲ့ ၁၈၅ နဲ့ 3B မော်ဒယ်မှာ ၄၇၅ နဲ့ ၃၈၄ တို့မှာ သူ့ထက် သာလွန်နေပါတယ်။ 32GB ကတ်ကတော့ ရှစ်မှာ ရပ်တန့်သွားပေမယ့် ရှည်လျားတဲ့အခြေအနေမှာ stream ၁၆ ခုအထိ မြင့်တက်နေပါတယ်။
အဲဒီ memory ရဲ့ ဈေးနှုန်းက PCIe 4.0 မှာ 350W၊ dual-slot board တစ်ခုဖြစ်ပြီး FP4 hardware မပါဝင်ပါဘူး။ Qwen3.8-27B ရဲ့ NVFP4 build မှာ dequantizing လုပ်ခြင်းအားဖြင့် တစ်စက္ကန့်ကို 480 tokens ရရှိခဲ့ပြီး ဒီ software build မှာ 4500 ထက် 1.5x သာလွန်ခဲ့ပါတယ်။ သူ့ရဲ့ MAMF ceilings ကတော့ BF16 မှာ 220 TFLOPS နဲ့ FP8 မှာ 369 TFLOPS ဖြစ်ပြီး RTX PRO 6000 ရဲ့ ထက်ဝက်အောက် အနည်းငယ်သာရှိပါတယ်။ L40S မှာ run ပြီးသားဖြစ်ပြီး workloads တွေက long context မှာရှိနေတဲ့ fleet တစ်ခုအတွက် အစားထိုးဖို့ ကတ်တစ်ခု မဟုတ်သေးပါဘူး။ 2U အသစ်အတွက် single-slot 4500 က slot နဲ့ power ရဲ့ ထက်ဝက်မှာ chat-length work ကို လုပ်ဆောင်ပါတယ်။
ကျွန်တော်တို့ရဲ့ ဓာတ်ခွဲခန်းမှာလည်း- Lenovo ThinkSystem SR650 V4 မှာ L40S တစ်လုံး နဲ့ Omniverse အပိုင်း အတွက် ကျွန်တော်တို့ရဲ့ L40S မှာ ကတ်ရဲ့ ဂရပ်ဖစ်ဘက်ခြမ်း ။
RTX PRO 4500 Server Edition သုံးသပ်ချက်တွင် ကျွန်ုပ်တို့၏ L40S ရလဒ်များကို ဖတ်ရှုပါ။
1U နှင့် Edge အတွက် အကောင်းဆုံး Slot-Powered Card: NVIDIA L4
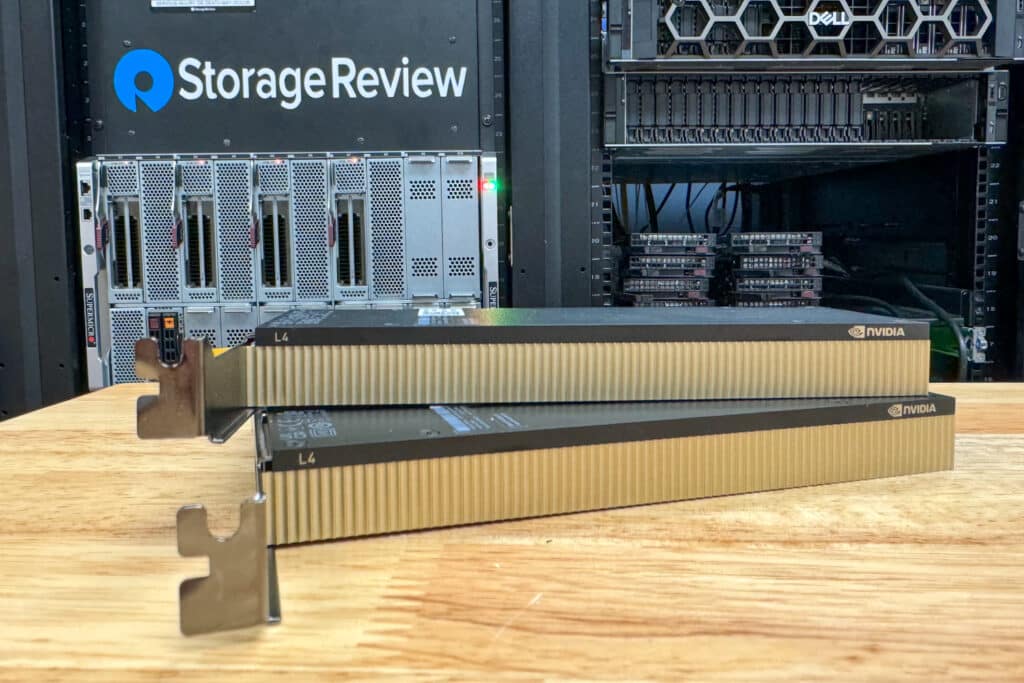
L4 သည် ဤစာမျက်နှာရှိ တစ်ခုတည်းသော ကတ်ဖြစ်ပြီး slot မှ ၎င်း၏ပါဝါကို ရယူပြီး half-height bay တပ်ဆင်နိုင်သောကြောင့် 1U server များနှင့် edge box များတွင် ထားရှိသည်။ အသစ်ထည့်သွင်း၍မရပါ။ 72W မှာ Ministral 3 14B FP8 မှာ stream ၃၂ ခုမှာ တစ်စက္ကန့်ကို output token ၃၆၄ ခု၊ 8B မော်ဒယ်မှာ ၂၇၉ ခု နဲ့ 3B မော်ဒယ်မှာ ၇၀၄ ခု ပေးစွမ်းနိုင်ပြီး 14B မော်ဒယ်မှာ တစ်စက္ကန့်ကို rated watt တစ်ခုအတွက် 5.1 output tokens ဟာ L40S ကို 2.8 watt နဲ့ RTX PRO 6000 ကို 3.8 watt နဲ့ ကျော်လွန်ပါတယ်။
BF16 မှာ 50 TFLOPS နဲ့ FP8 မှာ 116 MAMF ceilings တွေက ဒီမှာ အနိမ့်ဆုံးဖြစ်ပြီး FP4 path မရှိတဲ့အတွက် 27B NVFP4 မော်ဒယ်က သူ့ရဲ့ 24GB နဲ့ မကိုက်ညီပါဘူး။
ရှည်လျားသောအခြေအနေသည် ၎င်းရပ်တန့်သွားသည့်နေရာဖြစ်သည်- 8,192-token ပုံသဏ္ဍာန်တွင်၊ L4 သည် မော်ဒယ်တိုင်းတွင် တစ်စက္ကန့်လျှင် 34 မှ 130 tokens ဖြင့် stream လေးခုမှ ပြားချပ်ချပ်ဖြစ်နေသည်၊ အဘယ်ကြောင့်ဆိုသော် 24GB နှင့် 300GB/s သည် 8K context အနည်းငယ်ကိုသာ တစ်ပြိုင်နက်တည်း သိမ်းဆည်းထားနိုင်သောကြောင့်ဖြစ်သည်။ RTX PRO 4500 Server Edition သည် 2.8x မှ 3.6x အထိ ပိုမိုမြန်ဆန်စွာ လည်ပတ်နိုင်သော်လည်း FHFL slot နှင့် 16-pin cable လိုအပ်သောကြောင့် 1U သို့မဟုတ် half-height chassis ရှိ L4 fleet သည် drop-in အစားထိုးမှု မရရှိနိုင်ပါ။ ကျွန်ုပ်တို့၏ RTX PRO 4500 edge သုံးသပ်ချက်သည် HPE ProLiant DL145 Gen11 အတွင်းရှိ ကတ်နှစ်ခုလုံးကို တိုင်းတာခဲ့ပြီး 4500 သည် L4 ထက် 2.7x ပိုမိုပေးစွမ်းနိုင်ခဲ့သည်။
ကျွန်ုပ်တို့၏ဓာတ်ခွဲခန်းတွင်လည်း- Dell PowerEdge XR7620 ရှိ အစွန်းရှိ L4 ၊ Dell PowerEdge T560 ရှိ L4 လေးခု နှင့် HPE ProLiant DL145 Gen11 ရှိ RTX PRO 4500 နှင့် ယှဉ်နိုင်သော ကတ် ။
NVIDIA L4 သုံးသပ်ချက်အပြည့်အစုံကို ဖတ်ရှုပါ။
စမ်းသပ်ပြီးပါပြီ
NVIDIA H100 NVL
H100 NVL သည် တူညီသော R770 တွင် တူညီသော ladder ကို run ခဲ့ပြီး ဤစာမျက်နှာတွင် category တစ်ခုကို ယှဉ်တွဲရန် Hopper peer မရှိသောကြောင့် Also Tested တွင် ရှိနေသည်။ မျိုးဆက်တစ်ခုအကြာက ကျွန်ုပ်တို့အသုံးပြုခဲ့တဲ့ FP8 နဲ့ BF16 မော်ဒယ်တွေမှာ တစ်ပြိုင်နက်တည်းအသုံးပြုတဲ့အခါ RTX PRO 6000 ထက် ၃၆ ရာခိုင်နှုန်းကနေ ၆၁ ရာခိုင်နှုန်းအထိ ပိုမြန်ခဲ့ပါတယ်။
တူညီတဲ့ R770 မှာ၊ တူညီတဲ့ container ပေါ်မှာ၊ Ministral 3 14B FP8 မှာ stream ၃၂ ခုမှာ တစ်စက္ကန့်ကို output token ၃,၀၉၆ ခု၊ 8B reasoning model မှာ ၃,၄၄၉ ခု နဲ့ 3B မှာ ၅,၈၇၃ ခု ပေးခဲ့ပြီး သူ့ရဲ့ဆက်ခံသူလိုပဲ stream ၁၂၈ ခုအထိ တိုးချဲ့ခဲ့ပြီး 14B model မှာ ၆,၀၃၈ ခုအထိ ရောက်ရှိခဲ့ပါတယ်။ FP8 မှာ 1,047 TFLOPS ရဲ့ MAMF ရလဒ်ဟာ RTX PRO 6000 ရဲ့ 774 ထက် ၃၅ ရာခိုင်နှုန်း ပိုများပါတယ်။
3.9TB/s မှာ 94GB HBM3 ပါရှိတာကြောင့်ပါ။ စာရွက်စာတမ်းပုံစံအရ 14B မော်ဒယ်မှာ 32 streams မှာ တစ်စက္ကန့်ကို tokens 859 ခု သိမ်းဆည်းထားပြီး 600W မှာ RTX PRO 6000 ထက် ၄၁ ရာခိုင်နှုန်း ပိုများပြီး H200 ရဲ့ အမြင့် ၂၁ မှ ၂၃ ရာခိုင်နှုန်း နိမ့်တဲ့နေရာမှာ ပြသထားတဲ့ curve ပုံစံနဲ့ အတူတူပါပဲ။ ကတ်နှစ်ကတ်ဟာ NVLink ကို 600GB/s မှာ ပေါင်းကူးပေးထားပြီး Comino Grando H100 သုံးသပ်ချက်မှာ ပါဝင်တဲ့ configuration အတိုင်းဖြစ်ပြီး ကတ်က 350 မှ 400W အထိ ထုတ်ယူနိုင်ပြီး L40S လိုပဲ risers တွေနဲ့ ကိုက်ညီတဲ့ dual-slot passive package မှာ configure လုပ်နိုင်ပါတယ်။
၎င်းလိုအပ်ချက်မှာ H200 တွင်ရှိသည့်နေရာနှင့် အတူတူပင်ဖြစ်သည်။ NVFP4 စစ်ဆေးရေးဂိတ်များတွင် ၎င်းတွင် hardware မရှိပါ။ HBM စွမ်းရည်လိုအပ်ပြီး H100 NVL ဈေးနှုန်းကို လက်ထဲတွင်ရှိသော ဝယ်ယူသူတစ်ဦးအတွက်၊ အချက်အလက်များအရ ၎င်းသည် အထက်ဖော်ပြပါ H200 NVL ပြီးရင် ကျွန်ုပ်တို့စမ်းသပ်ခဲ့သမျှတွင် ဒုတိယအမြန်ဆုံး add-in ကတ်ဖြစ်ကြောင်း သိရသည်။
ကျွန်ုပ်တို့၏ဓာတ်ခွဲခန်းတွင်လည်း- ကျွန်ုပ်တို့၏ R770 ရှိ H100 NVL တစ်စုံသည် Graid SupremeRAID AE GPU Direct Storage စမ်းသပ်မှုကို ထောက်ပံ့ပေးခဲ့သည်။
Comino Grando H100 သုံးသပ်ချက်အပြည့်အစုံကို ဖတ်ရှုပါ။
AMD Instinct MI350P

MI350P သည် လေးနှစ်အတွင်း AMD ၏ ပထမဆုံး PCIe Instinct ကတ်အသစ်ဖြစ်ပြီး အထက်ဖော်ပြပါ အဆင့်သတ်မှတ်ချက်ကို မရသေးသောကြောင့် Also Tested တွင် ပါဝင်သည်။ အဲဒီ ladder မှာ NGC container နဲ့ Ministral 3 model set ကို အသုံးပြုထားပါတယ်။ ကျွန်တော်တို့ရဲ့ ပထမဆုံး look မှာ 2U PowerEdge R7725 မှာ 450W ရှိတဲ့ ROCm အတွက် stock vLLM ပေါ်မှာ card ကို run ခဲ့ပြီး 600W rating နဲ့ ယှဉ်ရင် run ခဲ့ပါတယ်။ 4TB/s မှာ 144GB HBM3E ပါဝင်ပြီး ကျွန်တော်တို့ စမ်းသပ်ဖူးသမျှ PCIe accelerator တွေထဲမှာ memory အများဆုံးဖြစ်ပြီး H200 NVL ထက် 3GB ပိုများပါတယ်။
ထပ်နေတဲ့ စမ်းသပ်မှုတွေမှာ NVIDIA ကတ်နှစ်ခုကြားမှာ ရှိနေပါတယ်။ MAMF ဟာ FP8 မှာ 1,120 TFLOPS နဲ့ block-scaled FP4 မှာ 450W မှာ 2,228 ရရှိခဲ့ပြီး အဲဒီသုံးသပ်ချက်ရဲ့ လုပ်ဆောင်ချက်တိုင်းမှာ 600W RTX PRO 6000 ထက် ၃၆ ရာခိုင်နှုန်းကနေ ၃၈ ရာခိုင်နှုန်းအထိ ပိုများပြီး BF16 နဲ့ FP8 မှာ H200 NVL ထက် နောက်ကျနေပါတယ်။ GPT-OSS-120B မှာ chat shape မှာ 128 streams မှာ ကတ်တစ်ခုဟာ တစ်စက္ကန့်ကို output tokens 5,057 ခု ပေးစွမ်းနိုင်ပြီး RTX PRO 6000 အတွက် 3,064 ခုနဲ့ H200 NVL အတွက် 3,376 ခု ရရှိခဲ့ပြီး 512-token prompts မှာ RTX PRO 6000 ကို FP8၊ BF16 နဲ့ GPT-OSS မော်ဒယ်တိုင်းမှာ 35 ရာခိုင်နှုန်းကနေ ၆၅ ရာခိုင်နှုန်းအထိ ကျော်လွန်ခဲ့ပါတယ်။
H200 NVL သည် dense FP8 နှင့် BF16 မော်ဒယ်များတွင် chat prompts တွင် stream ၁၂၈ ခုဖြင့် ၄ ရာခိုင်နှုန်းမှ ၁၈ ရာခိုင်နှုန်းအထိ ဦးဆောင်နေပြီး 8,192-token prompts တွင် MI350P သည် တူညီသော မော်ဒယ်များတွင် ၂၅ ရာခိုင်နှုန်းမှ ၅၈ ရာခိုင်နှုန်းအထိ နောက်ကျကျန်နေပြီး Llama 3.1 8B နှင့် MiniMax M2.7 တွင် stream ၁၆ ခုဖြင့် ပြားချပ်နေပါသည်။ ၎င်း၏ two-card ရလဒ်များတွင် တစ်စုံသည် RTX PRO 6000s လေးခုယူသည့် MiniMax M3 နှင့် GLM-5.2 ၏ MXFP4 builds များကို ကိုင်ဆောင်ထားပြီး ROCm 7.2.3 တွင် run ထားပြီး Scale-Out Configurations အောက်တွင် ပေါ်လာပါသည်။
Dell က MI350P ရှစ်ခုနဲ့ ထောက်ပံ့ပေးတဲ့ PowerEdge XE7745 မှာ Ministral 3 ladder ကို 600W နဲ့ ပြီးမြောက်တာနဲ့ အဆင့်သတ်မှတ်ပါတယ်။ အဲဒီအချိန်အထိ 96GB နဲ့ 144GB အကြား မော်ဒယ်တွေရှိတဲ့ ဝယ်ယူသူတစ်ယောက်အတွက် GPU တစ်ခုတည်းမှာပဲ ထားရှိတဲ့ PCIe ကတ်နှစ်ခုထဲက တစ်ခုဖြစ်ပြီး 141GB ကျော်တဲ့ တစ်ခုတည်းသော ကတ်လည်း ဖြစ်ပါတယ်။
AMD Instinct MI350P ကို ပထမဆုံးဖတ်ကြည့်ပါ။
စကေး-အောက် ဖွဲ့စည်းပုံများ
ကတ်တစ်ခုသည် ဤစာမျက်နှာတွင် ကတ်တစ်ခုတည်းအနေဖြင့် ၎င်း၏အဆင့်ကို ရရှိသည်။ ကတ်များစွာပါသောရလဒ်များကို ဤနေရာတွင် configuration အဖြစ် တင်ပြထားပြီး၊ အဆင့်မသတ်မှတ်ထားပါ၊ အဘယ်ကြောင့်ဆိုသော် ၎င်းတို့သည် မတူညီသော မော်ဒယ်အစုံများနှင့် software stack များကို လုပ်ဆောင်ပြီး တစ်ခုနှင့်တစ်ခု သို့မဟုတ် အထက်ဖော်ပြပါ ကတ်တစ်ခုတည်းပါသော လှေကားထစ်နှင့် နှိုင်းယှဉ်၍မရသောကြောင့်ဖြစ်သည်။ အတန်းတစ်ခုစီတွင် တိုင်းတာထားသောရလဒ်နှင့် ၎င်းမှရရှိသော သုံးသပ်ချက်ကို သယ်ဆောင်ထားသည်။
| configuration | host က | တိုင်းတာသောရလဒ် | စုပုံထား | အရင်းအမြစ် |
|---|---|---|---|---|
| NVIDIA RTX PRO 6000 Blackwell Server Edition (384GB) ၂ ခု | ဒဲလ် ပါဝါအိုက်ဒ် XE7740 | MiniMax M3 NVFP4: stream ၁၆ ခုတွင် output tokens/s ၁,၁၈၁ ခု၊ stream ၃၂ ခုတွင် ၇၅၉ ခု (၅၁၂/၅၁၂) | NGC vLLM 26.08၊ MTP မှန်းဆချက် ဒီကုဒ်လုပ်ခြင်း | ET900N G3 သုံးသပ်ချက် |
| NVIDIA RTX PRO 6000 Blackwell Server Edition (384GB) ၂ ခု | HPE ProLiant DL380a Gen12 | GPT-OSS-120B NVFP4၊ TP4: အသုတ် ၆၄ တွင် စုစုပေါင်း တိုကင်/s ၄,၀၁၆ ခု၊ အသုတ် ၃၂ တွင် ၃,၉၅၆ ခု၊ Llama 32 90B Vision: အသုတ် ၁၂၈ တွင် စုစုပေါင်း တိုကင်/s ၁,၃၇၂ ခု | vLLM အွန်လိုင်းဝန်ဆောင်မှု | DL380a Gen12 သုံးသပ်ချက် |
| NVIDIA RTX PRO 6000 Blackwell Server Edition (192GB) ၂ ခု | ဒဲလ် ပါဝါအိုက်ဒ် XE7740 | MiniMax M2.7 NVFP4: 128 streams (512/512) တွင် output tokens/s ၁,၉၃၂ ခု၊ 8K/1K တွင် ၅၁၁ ခု | NGC vLLM ၂၆.၀၈ | ET900N G3 သုံးသပ်ချက် |
| ၄x Intel Gaudi 3 PCIe (512GB HBM) | ဒဲလ် ပါဝါအိုက်ဒ် XE7740 | Llama 3.1 70B၊ TP4: တစ်ပြိုင်နက်တည်း တောင်းဆိုမှု ၁၂၈ ခု (1,024/1,024) တွင် စုစုပေါင်း တိုကင်/စက္ကန့် ၃၆၀၀ ခန့်။ ဤတည်ဆောက်မှုတွင် FP8 လမ်းကြောင်းများသည် BF16 ထက် နှေးကွေးသည်။ | Gaudi Docker 1.22.2 မှာ Intel vLLM fork 2.7.1 ကို အသုံးပြုထားပါတယ်။ | XE7740 သုံးသပ်ချက် (Dell မှ စပွန်ဆာပေးသည်) |
| AMD Instinct MI350P (288GB) ၂ ခု၊ ကတ်တစ်ခုလျှင် 450W | Dell PowerEdge R7725 | MiniMax M3 MXFP4: stream ၁၆ ခုတွင် output tokens/s ၉၉၈ ခု၊ stream ၃၂ ခုတွင် ၁၅၀၉ ခု (၅၁၂/၅၁၂)၊ DeepSeek-V4-Flash FP8: stream ၃၂ ခုတွင် output tokens/s ၁,၀၈၁ ခု (၅၁၂/၅၁၂)၊ 8K/1K တွင် ၆၂၁ ခု | ROCm 7.2.3 မှာ vLLM ကို ထည့်သွင်းပါ | MI350P ကို ပထမဆုံးကြည့်ရှုခြင်း |
Intel vLLM fork သည် စမ်းသပ်ချိန်တွင် ၎င်း၏ FP8 လမ်းကြောင်းများကို အကောင်းဆုံးဖြစ်အောင် မလုပ်ရသေးဘဲ FP8 သည် BF16 ထက် နှေးကွေးစွာ လည်ပတ်ခဲ့သည်။ MiniMax M3 ရလဒ်သည် 384GB တွင်သာ ဆန့်သော မော်ဒယ်တွင် PCIe scale-out ၏ အမြင့်ဆုံးအဆင့်ကို ပြသနေပြီး ကတ်လေးခုသည် stream ၁၆ ခုတွင် GB300 DGX Station တစ်ခုထက် ရှေ့ရောက်နေပြီး prompts ရှည်များသည် cache ကို စားသုံးသောကြောင့် 32 တွင် ပြန်လည်ကျဆင်းသွားခဲ့သည်။
အပေါက်ထက်ကျော်လွန်၍
ကတ်တစ်ခုတည်းတွင် 141GB ထက်ကျော်လွန်သော မော်ဒယ် သို့မဟုတ် 400B-class checkpoint တွင် stream များစွာလိုအပ်သော serving load တစ်ခုသည် add-in ကတ်ဈေးကွက်မှ ထွက်ခွာသွားပါပြီ။ GB300 DGX Station အတန်းအစားသည် ကျွန်ုပ်တို့၏ Best Desktops for Local AI board တွင် အဆင့်သတ်မှတ်ထားပြီး 252GB HBM3e ပါသည့် Blackwell Ultra GPU တစ်ခုတည်းသည် H200 NVL ၏ တူညီသောဇယားတွင် ရှိနေပြီး ကျွန်ုပ်တို့၏ Supermicro JumpStart သုံးသပ်ချက်များမှ HGX B200 နှင့် AMD Instinct MI350X စနစ်များသည် အကောင်းဆုံးဆာဗာ များတွင် ပါဝင်သည် ။ ထိုစနစ်များကို ကတ်များအဖြစ် မဟုတ်ဘဲ စနစ်များအဖြစ် တိုင်းတာပြီး ဤနေရာတွင် အဆင့်မသတ်မှတ်ပါ။
ကျွန်ုပ်တို့ အဆင့်သတ်မှတ်ပုံ
StorageReview leaderboard တိုင်းကို စည်းမျဉ်းသုံးခုက အုပ်ချုပ်ပြီး ပထမအချက်ကတော့ ဓာတ်ခွဲခန်းမှာ စမ်းသပ်ထားတဲ့ ကတ်တွေကိုပဲ အဆင့်သတ်မှတ်တာ ဖြစ်ပါတယ်။ ကျွန်တော်တို့ benchmark မလုပ်ရသေးတဲ့ မည်သည့်ကတ်ကိုမဆို ဖော်ပြနိုင်ပေမယ့် အမျိုးအစားတစ်ခုကိုတော့ ထိန်းသိမ်းထားလို့ မရပါဘူး။ ဒုတိယအချက်အနေနဲ့ ကတ်တွေကို host က ထုတ်ပေးတဲ့ ပါဝါနဲ့ ပံ့ပိုးပေးတဲ့ host တစ်ခုမှာ single card တွေအနေနဲ့ စမ်းသပ်ပြီး အဲဒီပါဝါကို entry တိုင်းမှာ ဖော်ပြထားပါတယ်။ အထက်ဖော်ပြပါ H200 NVL မှတ်စုက rating နဲ့ စမ်းသပ်ထားတဲ့ ပါဝါ ကွဲပြားတဲ့ တစ်ခုတည်းသော ဖြစ်ရပ်ပါ။
တတိယအချက်အနေနဲ့ workstation ကတ်တွေကို ဒီစာမျက်နှာကနေ ချန်လှပ်ထားပြီး၊ ဖော်ပြထားတဲ့ ခြွင်းချက်တစ်ခုကတော့ NVIDIA က server အစိတ်အပိုင်းတစ်ခုအဖြစ် silicon တူညီစွာ ရောင်းချပြီး profile နှစ်ခုကို အတူတူရောင်းချတဲ့အခါ workstation ကတ်က နေရာမှာ ရှိနေပြီး entry မှာ အဲဒီလို ဖော်ပြထားပါတယ်။
အဆင့်သတ်မှတ်ချက်များသည် vLLM အွန်လိုင်းဝန်ဆောင်မှု output throughput၊ enterprise inference workload မှရရှိပြီး၊ 8,192-token document shape နှင့် MAMF compute ရလဒ်များသည် ချည်နှောင်မှုများကို ဖြတ်တောက်ပေးပြီး မှတ်ဉာဏ်စွမ်းရည်သည် အသက်ရှင်နိုင်မှုအဆင့်ကို သတ်မှတ်ပေးသည်။ ရောင်းချသူများသည် ထုတ်ဝေခြင်းမပြုမီ အဆင့်သတ်မှတ်ချက်များကို မမြင်ရပါ၊ ဤစာမျက်နှာတွင် မည်သည့်နေရာမှ ငွေပေးချေခြင်းမရှိပါ၊ ထို့အပြင် စပွန်ဆာပေးထားသော အပိုင်းကို ကိုးကားထားပါက ၎င်းကို ထိုအတိုင်း သတ်မှတ်သည်။ ကတ်အသစ်များသည် တူညီသော container တွင် တူညီသောစမ်းသပ်မှုကို ပြီးမြောက်သည်နှင့် ဝင်ရောက်လာပြီး အပေါ်ဆုံးရှိ changelog သည် ပြောင်းလဲမှုတိုင်းကို မှတ်တမ်းတင်သည်။
ဆော့ဖ်ဝဲလ် stack များသည် ရက်သတ္တပတ်အနည်းငယ်တိုင်း ပြောင်းလဲနေသောကြောင့် ဤစာမျက်နှာရှိ ကိန်းဂဏန်းတစ်ခုစီသည် အဆင့်သတ်မှတ်ချက်ကို သတ်မှတ်ပေးသည့် လုပ်ဆောင်မှုမှ လာခြင်းဖြစ်ပြီး နောက်ပိုင်းသုံးသပ်ချက်များသည် ကတ်တူ၏ လုပ်ဆောင်မှုအသစ်များကို အစီရင်ခံနိုင်ပါသည်။ နံပါတ်တစ်ခု ရွေ့လျားသွားသောအခါ မဟုတ်ဘဲ လုပ်ဆောင်မှုအသစ်တစ်ခုက အစီအစဉ်ကို ပြောင်းလဲသောအခါတွင် ကျွန်ုပ်တို့သည် အဆင့်ကို ပြန်လည်သတ်မှတ်ပါသည်။
Enterprise GPU FAQ များ
Enterprise Inference အတွက် အကောင်းဆုံး GPU က ဘာလဲ။
လုပ်ငန်းအများစုဝယ်ယူသော 2U နှင့် 4U inference server များအတွက် RTX PRO 6000 Blackwell Server Edition သည် 96GB ပေါင်းစပ်ထားသောကြောင့် ၎င်းသည် PCIe ကတ်၊ MIG၊ vGPU နှင့် ဂရပ်ဖစ်နှင့် ဗီဒီယိုအင်ဂျင်များတွင် ကျွန်ုပ်တို့တိုင်းတာဖူးသမျှ အမြင့်ဆုံး FP4 compute ဖြစ်ပြီး mainstream slot မှ ပေးစွမ်းသော 450W တွင် ၎င်း၏ throughput ၏ 2 မှ 9 ရာခိုင်နှုန်းအထိသာ ဆုံးရှုံးသည်။
H200 NVL က workload ကို ဆုံးဖြတ်ပေးတဲ့အခါ ပိုမြန်တဲ့ကတ်ဖြစ်ပြီး ကျွန်တော်တို့ run တဲ့ မော်ဒယ်တိုင်းကို ဦးဆောင်ခဲ့တာကြောင့် 70B မှ 120B အထိ မော်ဒယ်တွေကို တစ်ပြိုင်နက်တည်း မြင့်မားစွာ တည်ဆောက်ထားတဲ့ ဖြန့်ကျက်မှုဟာ အဲဒီကနေ စတင်သင့်ပါတယ်။ slot က single-width ဖြစ်တဲ့အခါ ဒါမှမဟုတ် power budget က 165W ဖြစ်တဲ့အခါ RTX PRO 4500 Server Edition က ရွေးချယ်မှုပါပဲ။
RTX PRO 6000 vs H100 NVL: ဘယ်ဟာက ကောက်ချက်ချဖို့ ပိုမြန်လဲ။
H100 NVL ဟာ တူညီတဲ့ vLLM container ထဲမှာ run ထားတဲ့ FP8 နဲ့ BF16 မော်ဒယ်တွေမှာ တစ်ပြိုင်နက်တည်း အလုပ်လုပ်တဲ့အခါ ၃၆ ရာခိုင်နှုန်းကနေ ၆၁ ရာခိုင်နှုန်းအထိ ပိုမြန်ပြီး 8,192-token document shape မှာတော့ ၄၁ ရာခိုင်နှုန်းကနေ ၅၂ ရာခိုင်နှုန်းအထိ ပိုမြန်ပါတယ်။ ဘာကြောင့်လဲဆိုတော့ 3.9TB/s feeds မှာ 94GB HBM3 ဟာ 1.6TB/s feeds မှာ 96GB GDDR7 ထက် decode ပိုမြန်လို့ပါ။ RTX PRO 6000 ဟာ NVFP4 checkpoints တွေမှာ အနိုင်ရပါတယ်။ H100 မှာ FP4 hardware မပါဝင်ပါဘူး။ ပြီးတော့ graphics, video နဲ့ display capabilities ရှိတဲ့ တစ်ခုတည်းသော မော်ဒယ်လည်း ဖြစ်ပါတယ်။ FP8 နဲ့ BF16 မော်ဒယ်တွေမှာ throughput အတွက် H100 NVL ကို ဝယ်ယူပါ။ ရောနှော workload ဒါမှမဟုတ် FP4 roadmap အတွက် RTX PRO 6000 ကို ဝယ်ယူပါ။
H100 NVL vs H200 NVL: အဆင့်မြှင့်တင်မှုက တန်ပါသလား။
H200 NVL ဟာ chat shape မှာ stream ၃၂ ခုနဲ့ H100 NVL ထက် ၁၀ ရာခိုင်နှုန်းကနေ ၁၂ ရာခိုင်နှုန်းအထိ သာလွန်ပြီး stream ၁၂၈ ခုနဲ့ 8,192-token document shape မှာ ၂၁ ရာခိုင်နှုန်းကနေ ၂၃ ရာခိုင်နှုန်းအထိ သာလွန်ပါတယ်။ memory 94GB နဲ့ ယှဉ်ရင် 141GB နဲ့ 4.8TB/s နဲ့ ယှဉ်ရင် 3.9TB/s ရှိပါတယ်။ အဲဒီကိန်းဂဏန်းတွေက H200 ရဲ့ 450W မှာ ရှိပြီး 2U R770 slot က အများဆုံးပေးစွမ်းနိုင်ပြီး သူ့ရဲ့ 600W rating ကို ကျွန်တော်တို့ရဲ့ lab မှာ မစမ်းသပ်ရသေးတဲ့အတွက် ကွာဟချက်က ကြမ်းပြင်တစ်ခုပါပဲ။ capacity ကွာခြားချက်က ဝယ်သူအများစုအတွက် ဆုံးဖြတ်ချက်ချရမယ့်အချက်ပါ။ FP8 မှာရှိတဲ့ 120B-class မော်ဒယ်မှာ 141GB နဲ့ ကိုက်ညီတဲ့ H100 NVL နှစ်ခု လိုအပ်ပါတယ်။
L40S vs RTX PRO 6000: ပိုကြီးတဲ့ကတ်က ဘာတွေကို ဝယ်ယူနိုင်မလဲ။
အကျဉ်းချုပ်ပြောရရင် RTX PRO 6000 ဟာ Ministral set မှာရှိတဲ့ 32 streams မှာ L40S ရဲ့ output throughput ထက် 2.1x မှ 2.3x အထိ စွမ်းဆောင်ပေးနိုင်ခဲ့ပြီး 8,192-token input မှာတော့ 48GB card က 16 streams မှာ KV cache ကုန်သွားတာကြောင့် ratio 2.2x မှ 2.6x အထိ မြင့်တက်လာခဲ့ပါတယ်။ 6000 မှာ FP4 hardware၊ PCIe 5.0 နဲ့ 24GB partitions လေးခုပါဝင်တဲ့ MIG တို့ပါဝင်ပြီး 350W နဲ့ 600W မှာ အသုံးပြုနိုင်ပါတယ်။ long-context ဒါမှမဟုတ် multi-tenant work အတွက် ဝယ်ယူဖို့ ပိုကောင်းပါတယ်။ L40S ရဲ့ power မှာ chat-length ကောင်းကောင်းသုံးချင်ရင် single-slot RTX PRO 4500 က အနီးစပ်ဆုံးပါပဲ။
L4 vs RTX PRO 4500: L4 fleet ကို အဆင့်မြှင့်တင်သင့်ပါသလား။
RTX PRO 4500 Server Edition ဟာ ကျွန်တော်တို့ရဲ့ R770 မှာ L4 ရဲ့ output throughput ထက် ၂.၈ ဆ မှ ၃.၆ ဆ အထိ မြန်ဆန်ပြီး HPE ProLiant DL145 Gen11 ထဲမှာ 2.7 ဆ မြန်ဆန်ပါတယ်။ 72W နဲ့ ယှဉ်ရင် 165W နဲ့ 24GB နဲ့ ယှဉ်ရင် 32GB ပဲ ရှိပါတယ်။ အဓိကအချက်ကတော့ ရုပ်ပိုင်းဆိုင်ရာပါ။ 4500 က 16-pin connector ပါတဲ့ full-height, full-length card ဖြစ်ပြီး L4 က half-height, slot-powered card ဖြစ်တာကြောင့် L4 ပတ်လည်မှာ တည်ဆောက်ထားတဲ့ 1U server တွေနဲ့ small edge box တွေက 4500 ကို အသုံးမပြုနိုင်ပါဘူး။ chassis မှာ FHFL slot ပါတဲ့နေရာကို upgrade လုပ်ပါ။ L4 ကို မရှိတဲ့နေရာမှာပဲ ထားပါ။
RTX PRO 6000 Server Edition နဲ့ Workstation Edition: ဘာကွာခြားချက်ရှိလဲ။
GB202 GPU တူညီ၊ ECC ပါ GDDR7 96GB နှင့် 600W အဆင့်သတ်မှတ်ချက်၊ NVIDIA သည် ၎င်းတို့ကို တူညီသောအဆင့်သတ်မှတ်ချက်ပေးထားပြီး ကျွန်ုပ်တို့၏စမ်းသပ်မှုတွင် ၎င်းတို့သည် တူညီသောပရိုဖိုင်ကို ပေးဆောင်သောကြောင့် Workstation Edition ၏ဒေတာသည် ဤစာမျက်နှာရှိ Server Edition အတွက် ရပ်တည်ခြင်းဖြစ်သည်။ Server Edition သည် passive နှင့် headless ဖြစ်ပြီး chassis airflow အတွက် တည်ဆောက်ထားပြီး data center feature set ဖြစ်သော MIG၊ confidential computing နှင့် vGPU တို့ပါရှိသည်။ Workstation Edition တွင် DisplayPort output လေးခုဖြင့် actively cooled လုပ်ထားသည်။ server ဝယ်ယူသူသည် Server Edition ကို လိုချင်ပြီး နံပါတ်များသည် မည်သည့်နည်းနှင့်မဆို အတူတူပင်ဖြစ်သည်။
PCIe GPU နဲ့ SXM ဒါမှမဟုတ် HGX module ဘာကွာခြားချက်ရှိလဲ။
PCIe accelerator ဆိုသည်မှာ standard slot ထဲသို့ ပလပ်ထိုးပြီး 72W မှ 600W အထိ ဆွဲယူသည့် add-in card တစ်ခုဖြစ်ပြီး၊ rack တွင်ရှိပြီးသား 2U နှင့် 4U server များနှင့် ကိုက်ညီပြီး multi-card ဆက်သွယ်ရေးသည် PCIe သို့မဟုတ် NVLink bridge မှတစ်ဆင့် လည်ပတ်သည်။ SXM နှင့် OAM မော်ဂျူးများကို HGX B200 သို့မဟုတ် MI350X platform များကဲ့သို့သော ရည်ရွယ်ချက်ရှိရှိတည်ဆောက်ထားသော စနစ်များအတွင်းရှိ baseboard တစ်ခုနှင့် ဂဟေဆက်ထားပြီး GPU တစ်ခုလျှင် 700W မှ 1,400W အထိ လည်ပတ်ကာ full NVLink သို့မဟုတ် Infinity Fabric mesh မှတစ်ဆင့် ချိတ်ဆက်ထားသည်။ ဤစာမျက်နှာသည် ပထမအမျိုးအစားတွင် အဆင့်သတ်မှတ်ထားပြီး ဒုတိယအမျိုးအစားကို ကျွန်ုပ်တို့၏ server နှင့် local AI desktop board များတွင် ဖော်ပြထားသည်။
inference server တစ်ခုတွင် GPU memory မည်မျှလိုအပ်သနည်း။
မော်ဒယ်နှင့် အကြောင်းအရာပေါ် မူတည်ပါသည်။ ဤစာမျက်နှာတွင် 24GB နှင့် 32GB ကတ်များသည် chat length တွင် 3B မှ 14B မော်ဒယ်များကို အဆင်ပြေစွာ ပံ့ပိုးပေးပြီး 8,192-token input တွင် stream လေးခုမှ ရှစ်ခုအထိ ပြားချပ်အောင် ပြုလုပ်ပေးပါသည်။ 48GB သည် stream ၁၆ ခုအထိ ဆက်လက်မြင့်တက်ခဲ့ပြီး 96GB သည် တူညီသော မော်ဒယ်များတွင် ဘယ်သောအခါမှ ပြတ်လပ်မှု မရှိခဲ့ပါ။ 141GB H200 NVL သည် ကျွန်ုပ်တို့၏ ET900N G3 စမ်းသပ်မှုတွင် ကတ်တစ်ခုတည်းတွင် GPT-OSS-120B ကို ထိန်းထားနိုင်ခဲ့သည်။ သင်မျှော်လင့်ထားသည့် concurrency အတွက် အလေးချိန်များကို ဦးစွာဘတ်ဂျက်ချပြီးနောက် KV cache ကို ချပြီး long-context သို့မဟုတ် multi-tenant work ကို 48GB နှင့်အထက် လိုအပ်ချက်အဖြစ် သတ်မှတ်ပါသည်။
2U server မှာ 450W နဲ့ 600W က အရေးကြီးလား။
အဆင့်သတ်မှတ်ချက်ကွာဟချက်ထက်နည်းပြီး ကတ်တစ်ခုတည်းမှာ ကျွန်တော်တို့ နှစ်ဖက်စလုံးတိုင်းတာထားပါတယ်။ PowerEdge R770 slot က အများဆုံးပေးစွမ်းနိုင်တဲ့ 450W အထိကန့်သတ်ထားတဲ့ RTX PRO 6000 ဟာ ရေတိုအခြေအနေမှာ output throughput ရဲ့ ၂ ရာခိုင်နှုန်းကနေ ၅ ရာခိုင်နှုန်းအထိနဲ့ ရေရှည်အခြေအနေမှာ ၄ ရာခိုင်နှုန်းကနေ ၉ ရာခိုင်နှုန်းအထိ ပေးစွမ်းခဲ့ပြီး သူ့ရဲ့ FP8 MAMF ရလဒ်ကလည်း မပြောင်းလဲဘဲ သူ့ရဲ့ power budget ရဲ့ ၂၅ ရာခိုင်နှုန်းကို ၂ ရာခိုင်နှုန်းကနေ ၉ ရာခိုင်နှုန်းအထိ ကုန်ကျစရိတ်ပြန်ပေးခဲ့ပါတယ်။ ဒီစာမျက်နှာမှာရှိတဲ့ H200 NVL ကို အကြောင်းပြချက်တစ်ခုတည်းအတွက် 450W မှာ စမ်းသပ်ခဲ့ပြီး သူ့ရဲ့ 600W ရလဒ်အပြည့်အစုံကို မတိုင်းတာရသေးပါဘူး။ AMD Instinct MI350P ကိုလည်း ကျွန်တော်တို့ရဲ့ ပထမဆုံးကြည့်ရှုမှုမှာ 2U PowerEdge R7725 မှာ 600W အဆင့်သတ်မှတ်ချက်နဲ့ ယှဉ်ရင် 450W မှာ လည်ပတ်ခဲ့ပြီး PowerEdge XE7745 ရဲ့ ကွာခြားချက်ကို ကျွန်တော်တို့ တိုင်းတာသွားပါမယ်။


 အမေဇုံ