

Advancing AI 2026 သည် AMD ၏ အကြီးမားဆုံး မိတ်ဆက်ပွဲဖြစ်ပြီး ကျွန်ုပ်တို့၏ လွှမ်းခြုံမှုကို နှစ်ပိုင်းခွဲရလောက်အောင် ကြီးမားပါသည်။ ကျွန်ုပ်တို့၏ ပထမဆုံးဆောင်းပါးတွင် Instinct MI455X နှင့် 72-GPU Helios rack အကြောင်း ဖော်ပြထားပြီး၊ ဤညီအစ်မဆောင်းပါးတွင် ၎င်းတို့နှင့်အတူ သက်တောင့်သက်သာ မတပ်ဆင်နိုင်သော အရာများဖြစ်သည့် Venice ဟု ကုဒ်နံပါတ်ပေးထားသော 6th Gen EPYC server CPU များနှင့် Verano host processor တို့ ပါဝင်ပါသည်။ CPU သည် ၎င်း၏ကိုယ်ပိုင်ခေါင်းစဉ်ကို ထိုက်တန်ပါသည်။ Venice တွင် socket တစ်ခုလျှင် 256 cores နှင့် threads 512 အထိ၊ 1.6TB/s memory bandwidth၊ server CPU တွင် ပထမဆုံး PCIe Gen 6 နှင့် 2017 ခုနှစ်မှ ပထမမျိုးဆက် EPYC ၏ 18x throughput ကို ယူဆောင်လာပါသည်။
Venice ကလည်း ချစ်ပ်တစ်ခု မဟုတ်ပါဘူး။ portfolio တစ်ခုဖြစ်ပြီး AMD က session တိုင်းမှာ ထပ်ခါတလဲလဲ ပြောလေ့ရှိတဲ့ အချက်ကတော့ CPU profile တစ်ခုတည်းနဲ့ အားလုံးနဲ့ ကိုက်ညီမှာ မဟုတ်ပါဘူး။ Zen 6 မျိုးဆက်တစ်ခုတည်းဟာ density အပိုင်း၊ enterprise အပိုင်း၊ stacked-cache HPC အပိုင်း နဲ့ low-power LPDDR host အဖြစ် ပြောင်းလဲသွားတာပါ။ ဒါကြောင့် speed နဲ့ feeds တွေအကြောင်း မပြောခင်မှာ lineup ကို ကြည့်ကြရအောင်။
ဗင်းနစ်နှင့် ဗီရာနိုအသင်းတို့၏ ပွဲထွက်လူစာရင်း
AMD သည် ခေတ်မီဒေတာစင်တာကို server အမျိုးအစားသုံးမျိုးခွဲခြားထားပြီး ၎င်းတို့အားလုံးကို ဖြည့်တင်းရန် တည်ဆောက်ထားသည်။ အထွေထွေရည်ရွယ်ချက် CPU server များသည် web gateways၊ caches၊ application tiers၊ databases နှင့် storage တို့ကို လုပ်ဆောင်ပြီး ကျန်အရာအားလုံး မှီခိုအားထားရသည်။ GPU server များသည် accelerators များကို ထောက်ပံ့ပေးသည့် host CPU တစ်ခု လိုအပ်ပြီး single-threaded speed နှင့် I/O bandwidth သည် core အရေအတွက်ထက် သာလွန်သော အလုပ်တစ်ခုဖြစ်သည်။ တတိယအမျိုးအစားမှာ AI ဝန်ဆောင်မှုများတွင် ကြီးထွားလာသော orchestration နှင့် tool-execution code အတွက် dense CPU server များဖြစ်သည်။ ထို code သည် branch-heavy ဖြစ်ပြီး stall-pheej yig ဖြစ်ပြီး အဓိကအားဖြင့် threads များကို လိုချင်သည်။
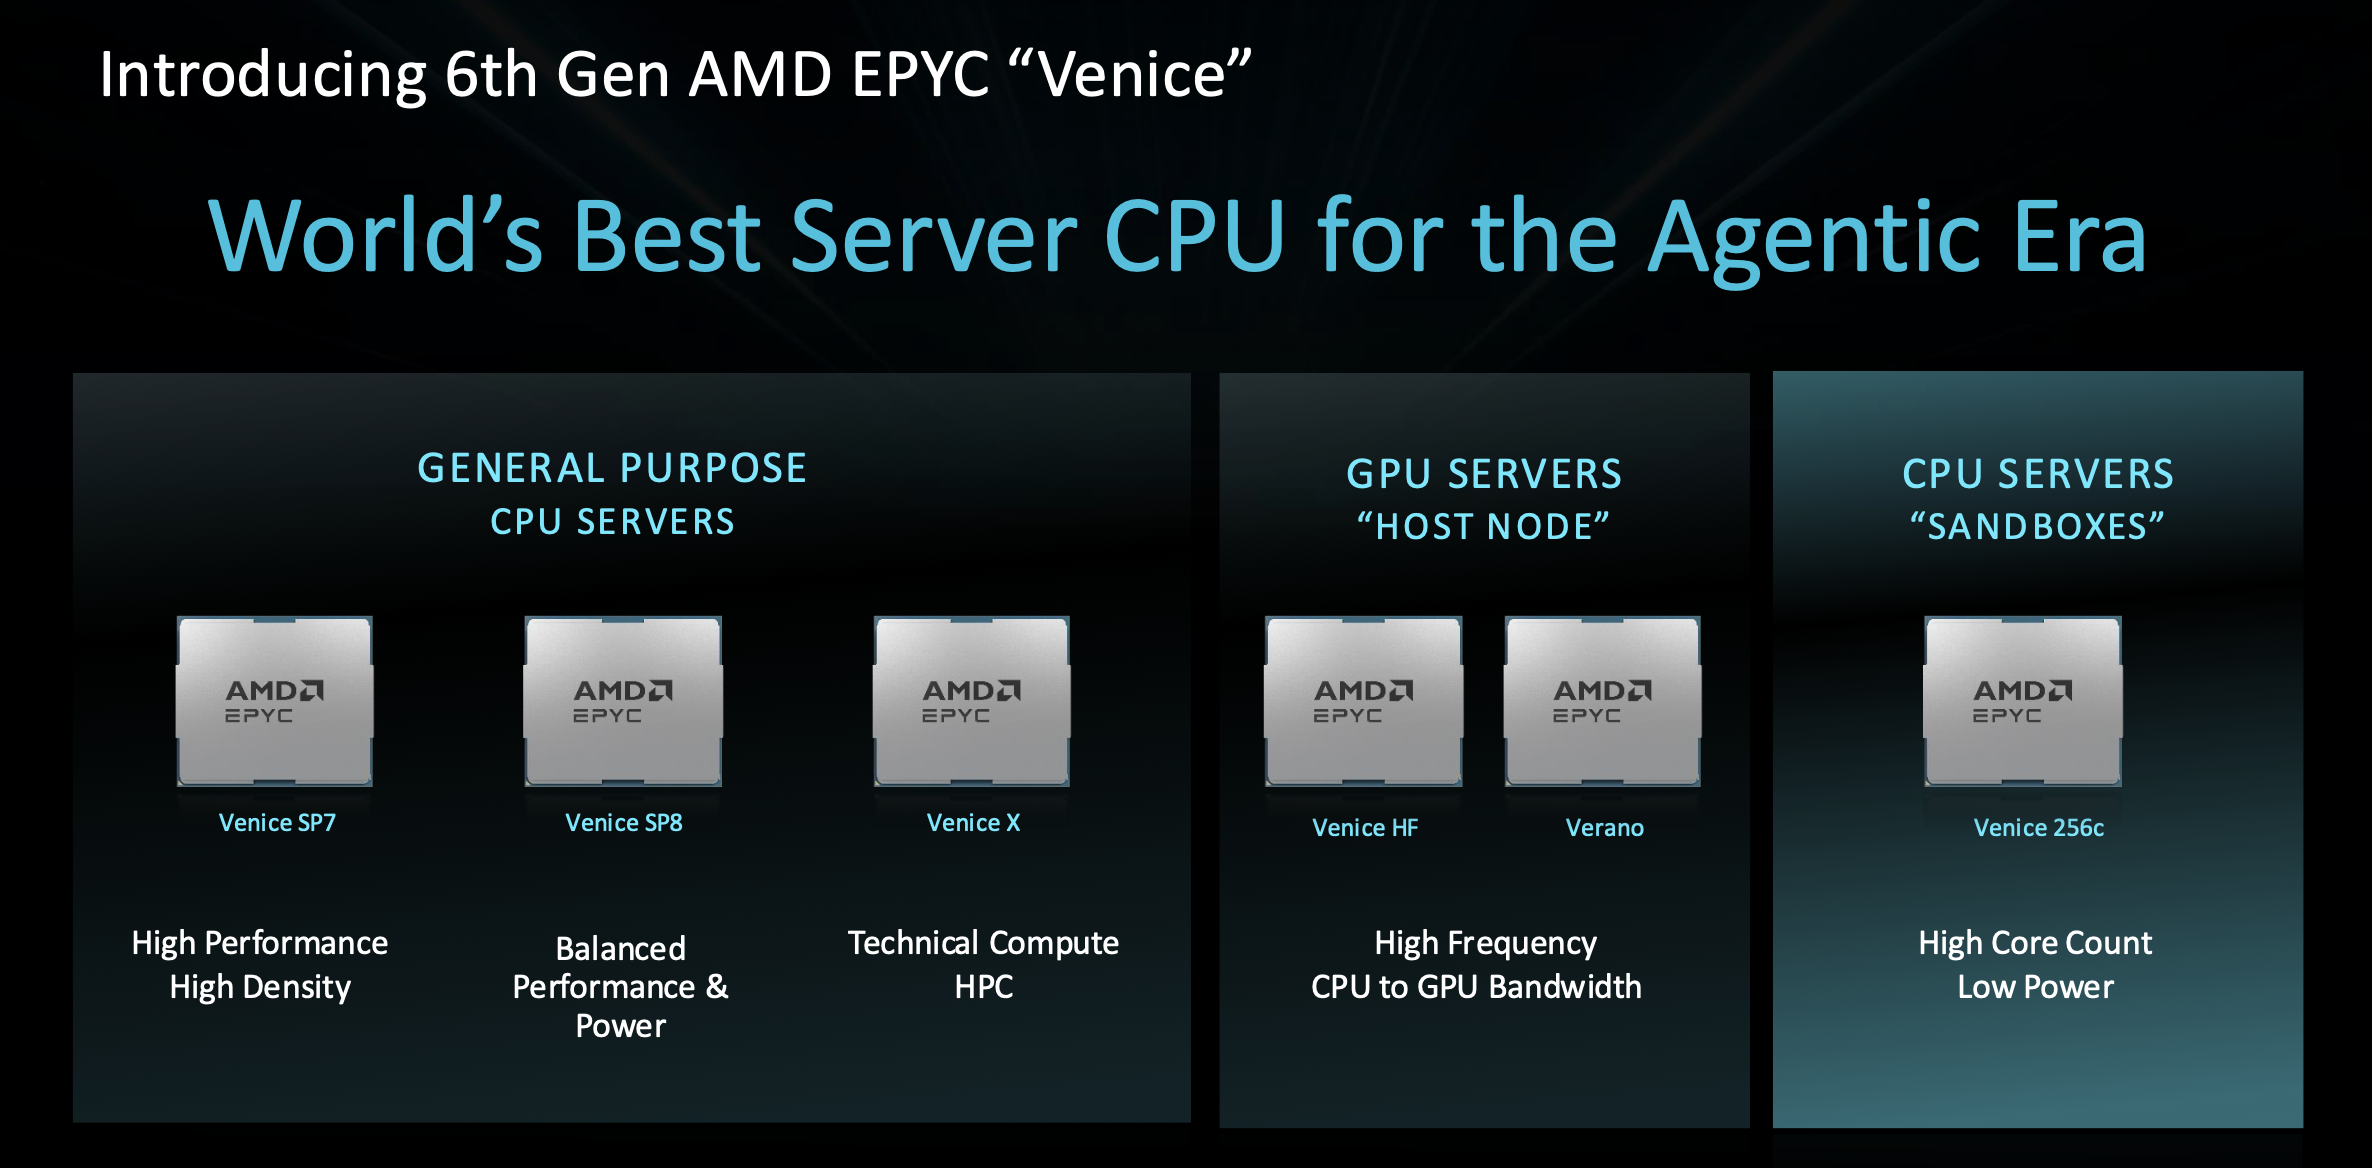
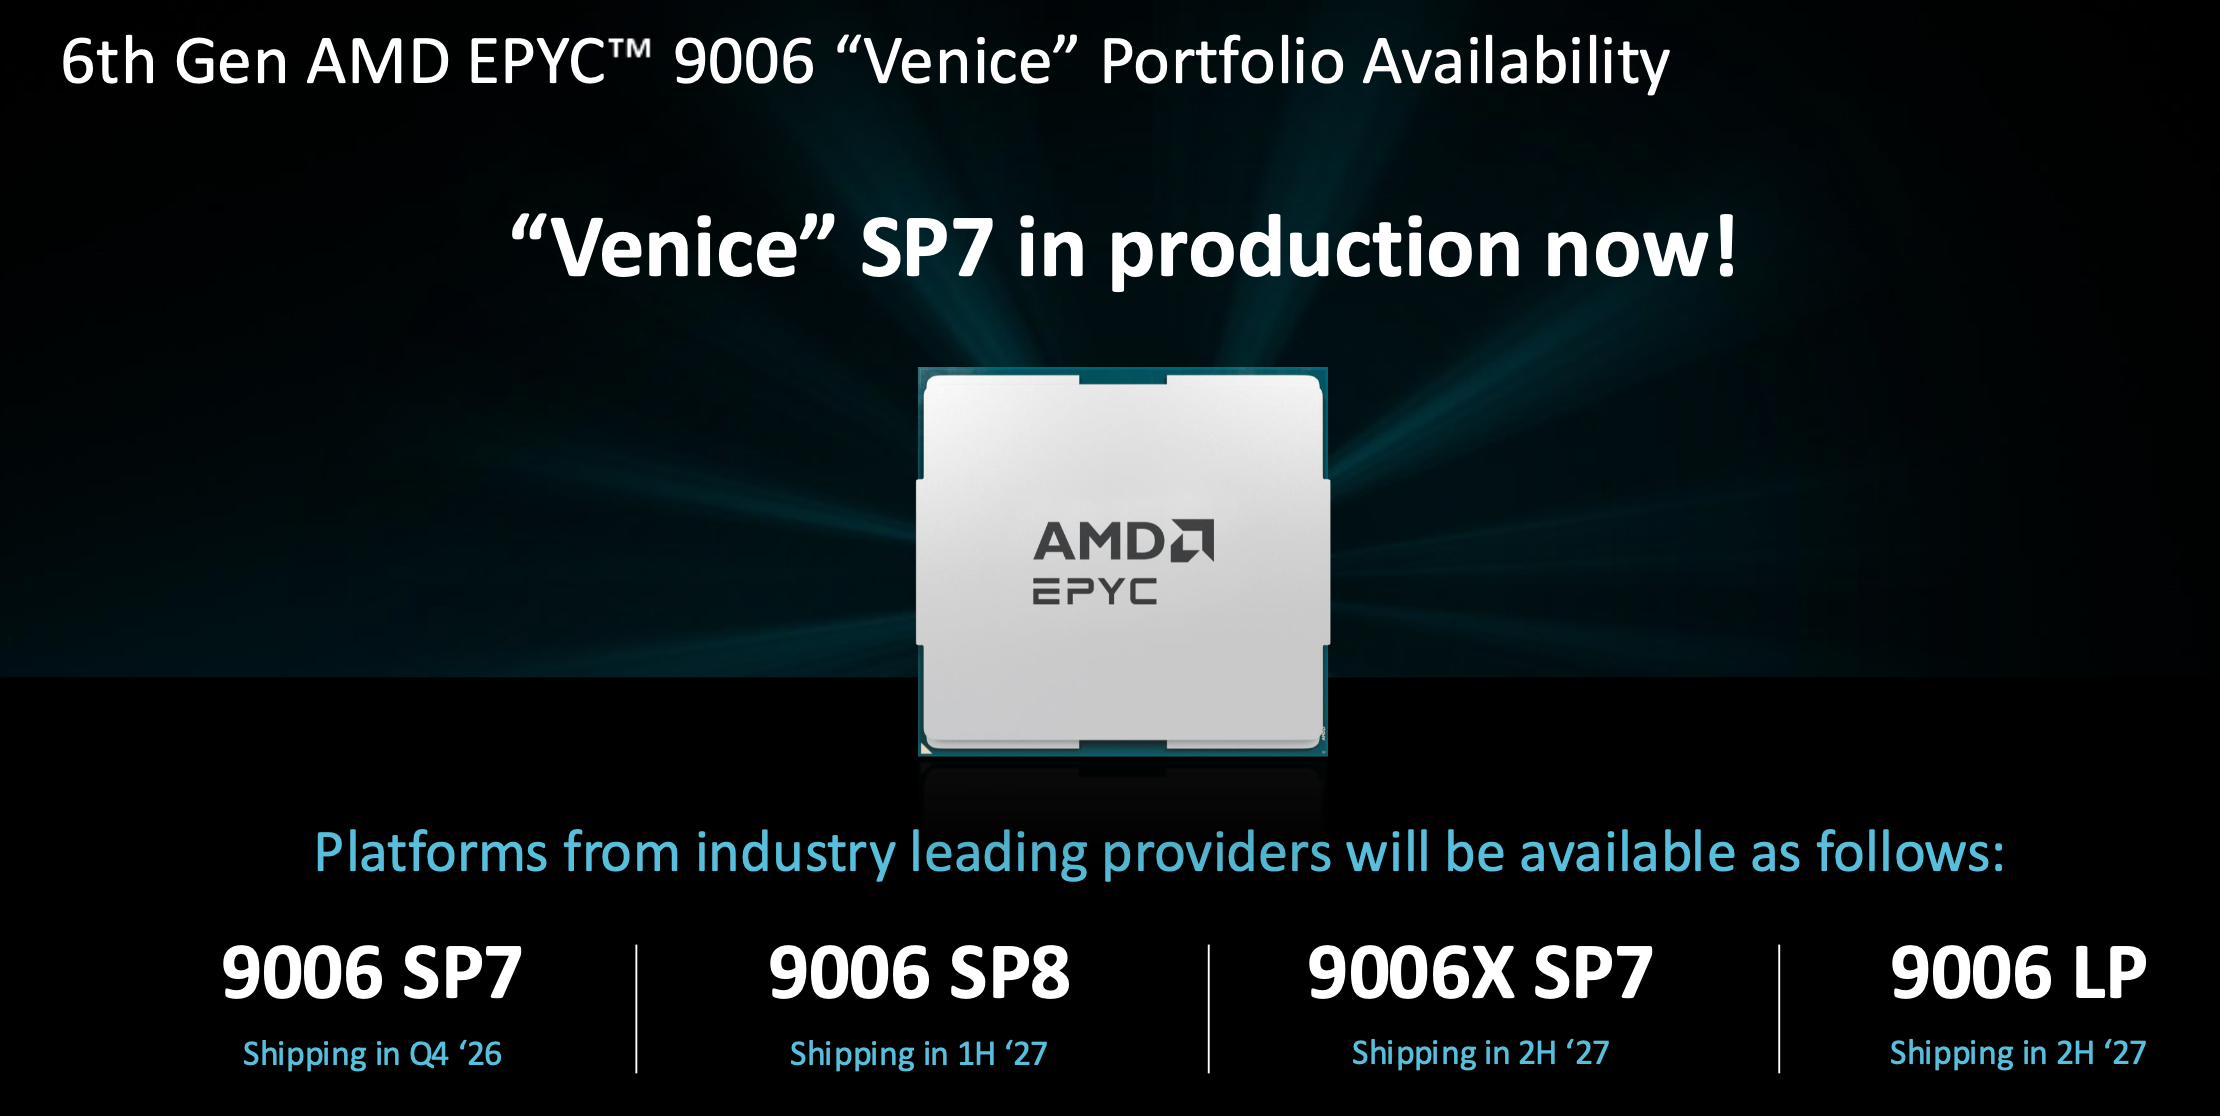
ထုတ်ကုန်စာရင်းတွင် ထုတ်ကုန်လေးမျိုးပါဝင်ပြီး ပလက်ဖောင်းများသည် လှိုင်းလုံးကြီးများ ရောက်ရှိလာသည်- ၂၀၂၆ ခုနှစ် စတုတ္ထသုံးလပတ်တွင် Venice SP7၊ ၂၀၂၇ ခုနှစ် ပထမနှစ်ဝက်တွင် Venice SP8 နှင့် ဒုတိယနှစ်ဝက်တွင် Venice-X နှင့် Verano။ AMD သည် တူညီသော ဆီလီကွန်ကို ခြောက်လမ်းခွဲပြီး ပိုမိုအသေးစိတ်ကျသော ဖြတ်တောက်မှုသည် အလွှာသုံးလွှာသို့ တိုက်ရိုက်ချိတ်ဆက်ထားသည်။ General purpose တွင် Venice SP7၊ SP8 နှင့် Venice-X တို့ကို ရရှိသည်။ host bucket သည် မြင့်မားသော ကြိမ်နှုန်း Venice bin ကို Verano နှင့် ၎င်း၏ LPDDR မှတ်ဉာဏ်နှင့် တွဲဖက်ပေးသည်။ Dense compute သည် deck တွင် Venice 256c ဟု အမည်ပေးထားသည့်အတိုင်း ရရှိသည်- ပါဝါနည်းသော ပါဝါဘတ်ဂျက်က ခွင့်ပြုသလောက် rack ထဲသို့ thread များကို များများထည့်သွင်းရန် တည်ဆောက်ထားသည်။ Verano သည်လည်း လရောင်အောက်တွင်ရှိသည်- ရွေးချယ်ထားသော ဖောက်သည်များသည် system watt တစ်ခုလျှင် စွမ်းဆောင်ရည်သည် ချည်နှောင်ထားသော ကန့်သတ်ချက်ရှိသည့်နေရာတိုင်းတွင် အထွေထွေရည်ရွယ်ချက် ပရိုဆက်ဆာအဖြစ် ဖြန့်ကျက်မည်ဟု AMD က ပြောကြားခဲ့သည်။
အောက်ခြေမှတ်စုတွေကြောင့် SKU တွေကို sneak peek လုပ်နိုင်ပါတယ်။ 256-core EPYC 9996 က stack မှာ ဦးဆောင်နေပြီး 9956 က 400W မှာ တူညီတဲ့ core တွေကို သယ်ဆောင်ထားပြီး 96-core 9686F က high-frequency host အပိုင်းဖြစ်ပါတယ်။ Helios မှာ compute tray တိုင်းမှာ အဲဒီ host silicon ရဲ့ ကိုယ်ပိုင်ဗားရှင်းဖြစ်တဲ့ EPYC 9G76 ရှိပါတယ်။
ညှိနှိုင်းမှုမပြုလုပ်သောအဆင့်
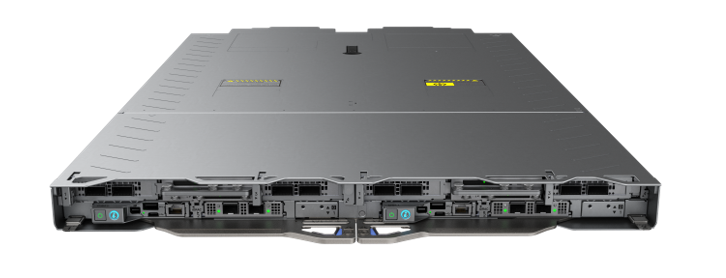
spec ဇယားတွေမတိုင်ခင်မှာ socket ကြီးတွေရဲ့ အားသာချက်အကြောင်း ပြောပါရစေ။ Venice SP7 ကို AMD ရဲ့ အမြင့်ဆုံး၊ အလျှော့အတင်းမရှိတဲ့ စွမ်းဆောင်ရည်အဆင့်တွေအတွက် သီးသန့်ထားရှိပါတယ်- datacenter၊ hyperscaler နဲ့ HPC compute deployments တွေဖြစ်ပြီး၊ rack တစ်ခုရဲ့ throughput က ကုန်ကျစရိတ်မရှိဘဲ ဆုံးဖြတ်ချက်ချတဲ့အချက်ပါ။ server ရောင်းချသူတွေက ဒီအပေါ်မှာ ပြန်လည်အဆင့်သတ်မှတ်နေကြပါပြီ။ Dell က နေရာလွတ်ပေးဖို့ သူ့ရဲ့ ကြာမြင့်စွာကတည်းက တည်ရှိခဲ့တဲ့ PowerEdge naming schema ကို ပိုင်းခြားထားပြီး၊ ဒီ compute အမျိုးအစားဟာ အခုဆိုရင် PowerEdge R9825 နဲ့ Rack Scale M9825 တို့ ဦးဆောင်တဲ့ 9000 series အသစ်မှာ ပါဝင်လာပါပြီ။ 3U chassis မှာ Venice ချစ်ပ် ၂ ခု ပါဝင်တဲ့ flagship တွေပါ။
ခေါင်းစဉ်သတ်မှတ်ချက်များ
မိသားစုတစ်ခုလုံးဟာ ပလက်ဖောင်းတစ်ခုတည်းမှာ တည်ဆောက်ထားပြီး တူရင်နောက်ပိုင်း ထောင့်တိုင်းလိုလိုက အသစ်စက်စက်တွေပါ။
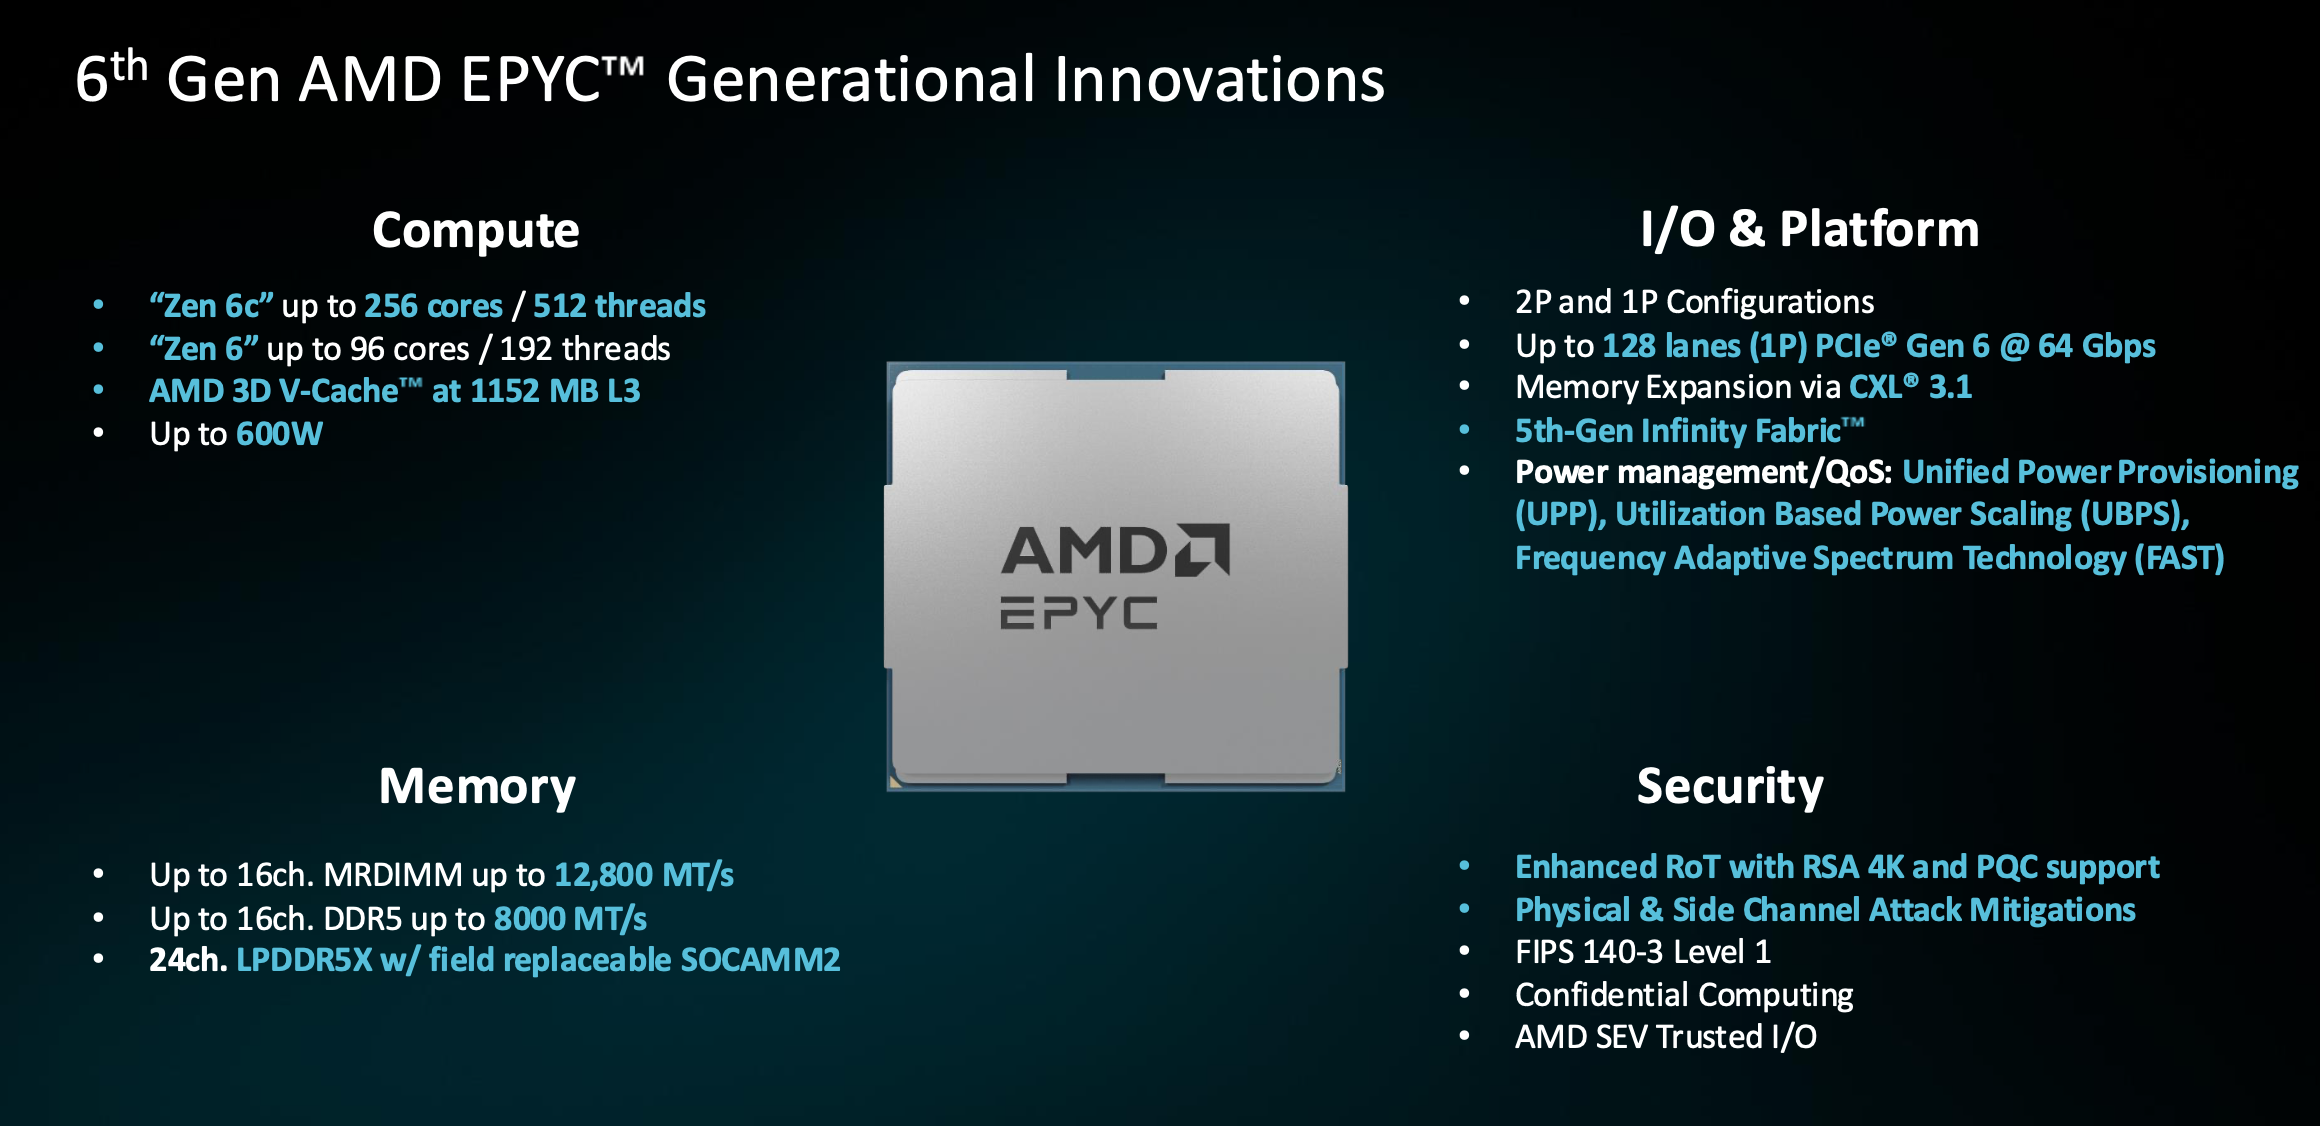
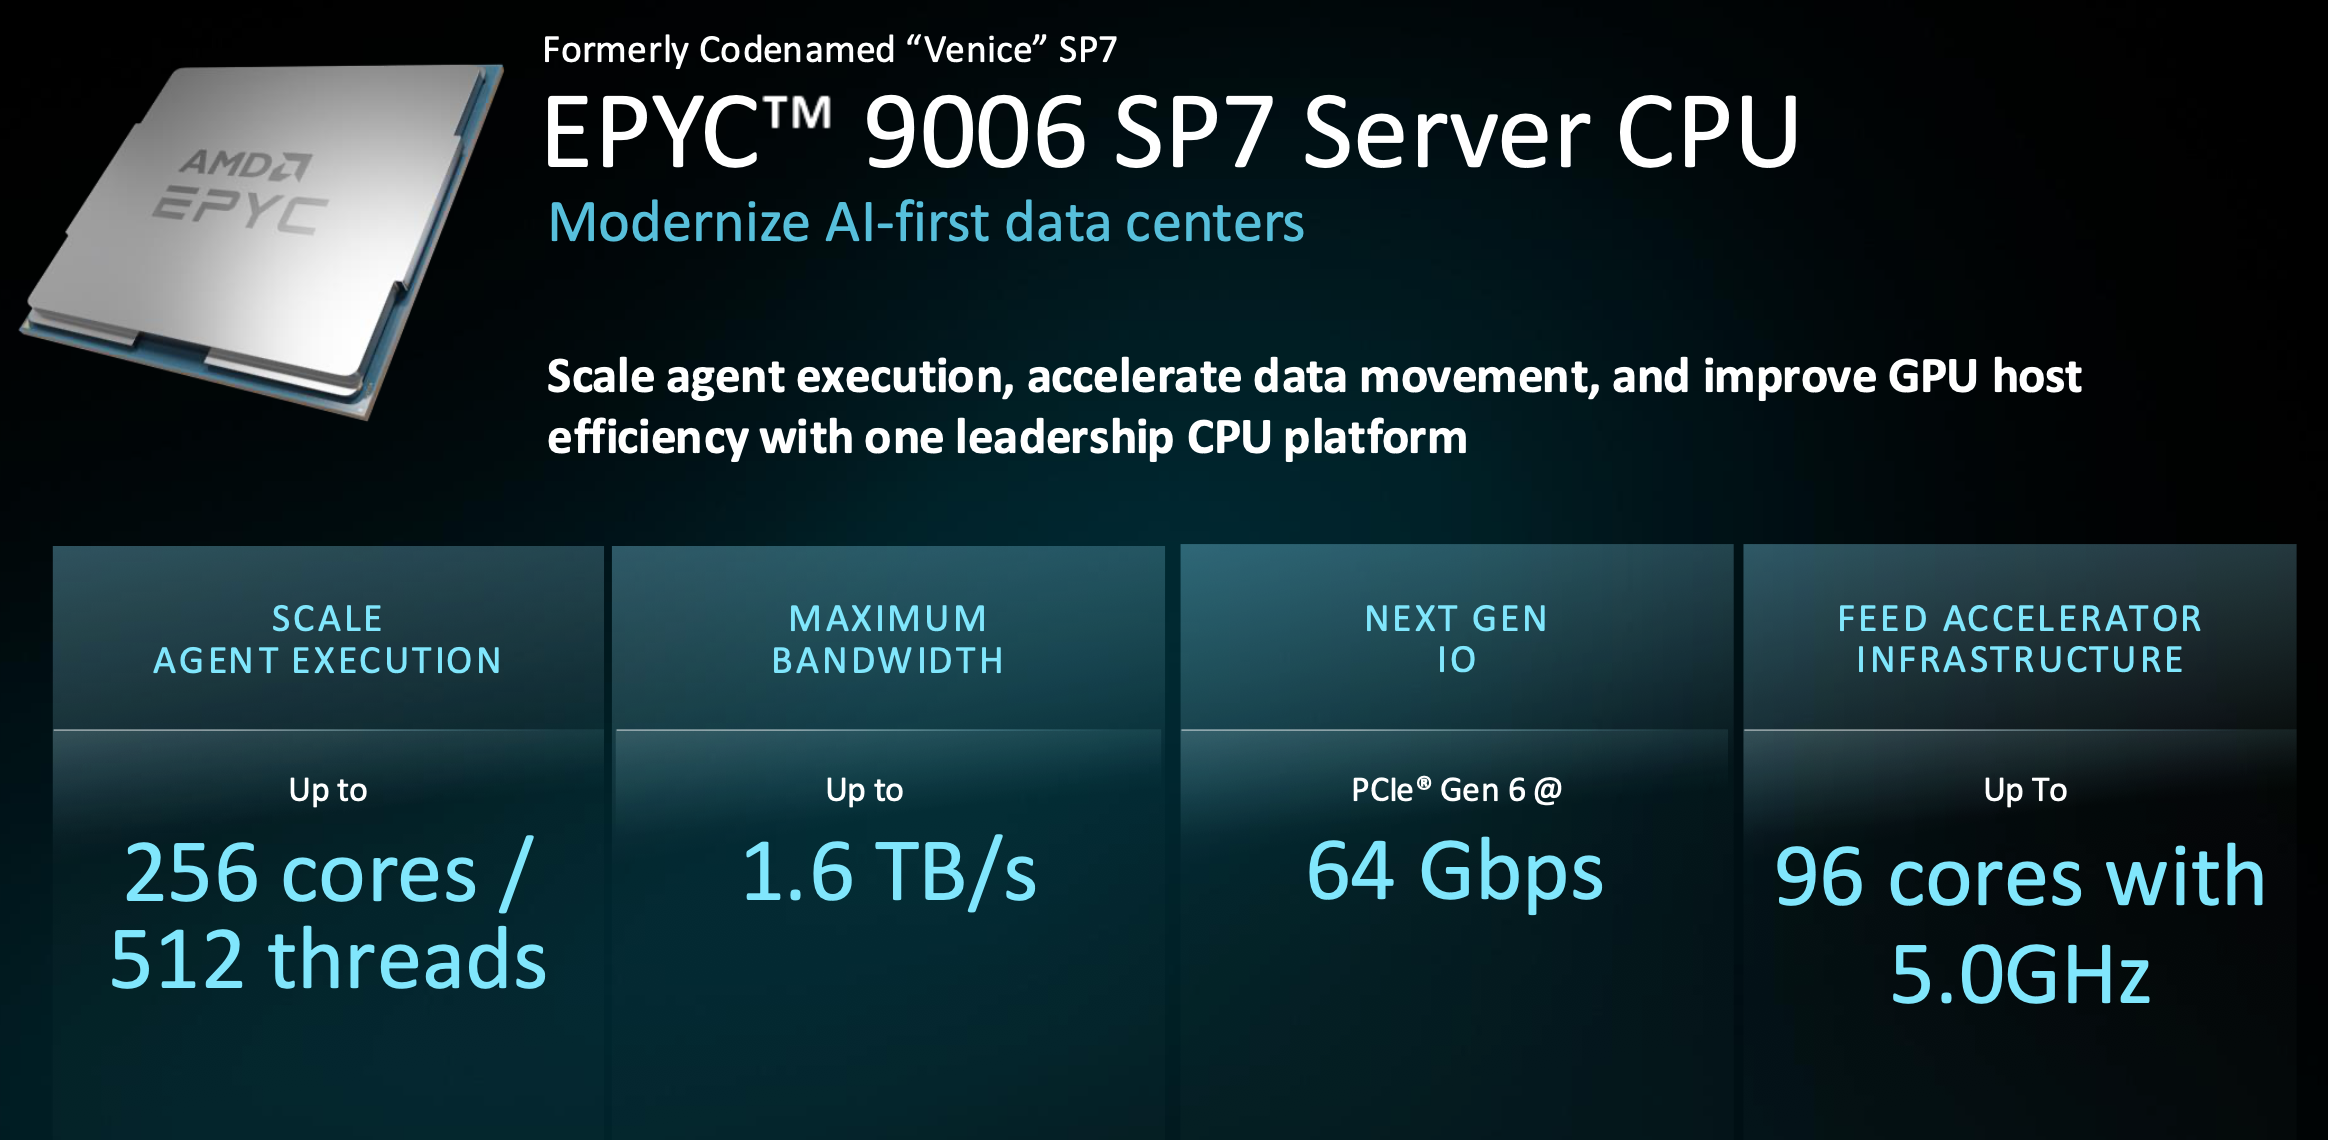
core တွေနဲ့စလိုက်ပါ။ Zen 6 မှာ အရသာနှစ်မျိုးရှိပါတယ်။ compact Zen 6c မှာ core ၂၅၆ ခုနဲ့ thread ၅၁၂ ခုကို socket ထဲမှာ 600W အထိထည့်သွင်းထားပြီး standard core ကတော့ 96 မှာရပ်တန့်နေပေမယ့် 5GHz အထိ clock လုပ်နိုင်ပါတယ်။ AMD က ကိုက်ညီတဲ့ core အရေအတွက်တွေမှာ ပြိုင်ဘက်အစိတ်အပိုင်းတွေထက် per-core စွမ်းဆောင်ရည် ၂၀% ကျော်ပိုများတယ်လို့ ဆိုထားပြီး density က cache ကို မပါးလွှာစေပါဘူး။ 256-core die တောင် flagship မှာ full gigabyte ရှိတဲ့ core တစ်ခုစီမှာ L3 4MB လောက်ကို သိမ်းဆည်းထားပါတယ်။ AVX-512 က CPU မှာ ပိုမိုလည်ပတ်နေတဲ့ tokenizer တွေနဲ့ 3-to-8-billion-parameter မော်ဒယ်တွေကို ကိုင်တွယ်ပါတယ်။
ထို core များကို ထောက်ပံ့ပေးရန်အတွက် မှတ်ဉာဏ်စနစ် ပိုမိုကြီးမားသော လိုအပ်သည်- 8,000MT/s ဖြင့် DDR5 channel ၁၆ ခု သို့မဟုတ် 12,800 ဖြင့် MRDIMM၊ socket တစ်ခုလျှင် 16TB/s အတွက် ကောင်းမွန်ပြီး Turin သည် channel ၁၂ ခုမှ 614GB/s ရရှိခဲ့သည်။ I/O သည်လည်း အလားတူ ခုန်ပျံကျော်လွှားမှုကို ပြုလုပ်သည်။ Venice သည် PCIe Gen 6 ပါရှိသော ပထမဆုံး server CPU ဖြစ်ပြီး 128 lanes သည် 64 GT/s ဖြင့် ရှိပြီး ယနေ့ခေတ် accelerator များနှင့် ချိတ်ဆက်ထားသော အခြားမည်သည့်အရာထက်မဆို per-lane bandwidth ၏ နှစ်ဆဖြစ်ပြီး host-node claim ၏ အခြေခံအုတ်မြစ်လည်း ဖြစ်သည်။ CXL 3.1 သည် မှတ်ဉာဏ်တိုးချဲ့မှုအတွက် ထို lanes များပေါ်တွင် မောင်းနှင်ပြီး ရွေးချယ်ထားသော two-socket AI host platform များသည် အသုံးပြုနိုင်သော lanes ၁၆၀ သို့ရောက်ရှိရန် I/O အတွက် inter-socket xGMI width ကို လဲလှယ်သည်။ ပိုမိုတိတ်ဆိတ်သော ထပ်လောင်းနှစ်ခုသည် cores များကို မလောင်ကျွမ်းစေဘဲ data များကို ရွှေ့ပြောင်းသည်- SDXI သည် မှတ်ဉာဏ်မိတ္တူများနှင့် 30 မှ 50 cores တန်ဖိုးရှိသော crypto ကို offload လုပ်သည်၊ Smart Data Cache Injection သည် network packets များကို DRAM မှတစ်ဆင့် routing မလုပ်ဘဲ cache ထဲသို့ တိုက်ရိုက်ချပေးသည်။
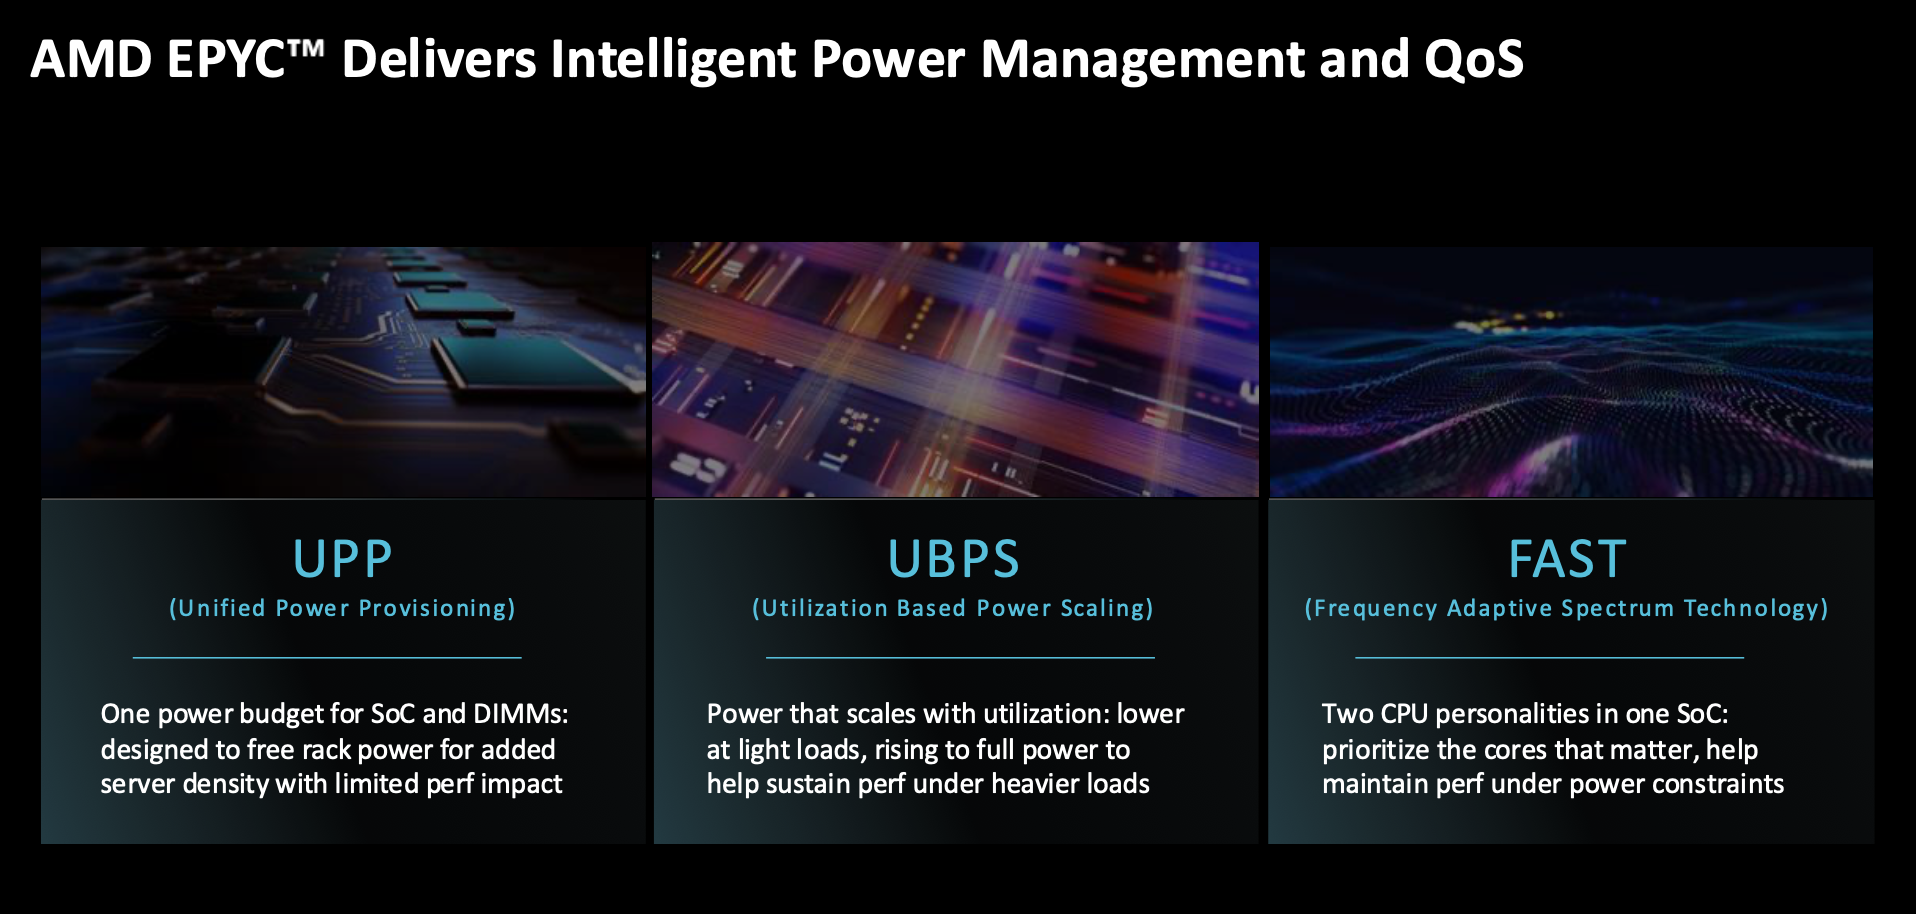
ပါဝါစီမံခန့်ခွဲမှုမှာ ခလုတ်အသစ်သုံးခုပါလာပြီး AMD က နောက်ပိုင်းလုပ်တဲ့ rack နှိုင်းယှဉ်မှုတိုင်းဟာ power budget အတွင်းမှာ ဖြစ်ပေါ်တာကြောင့် အရေးကြီးပါတယ်။ UPP က SoC နဲ့ DIMM budget တွေကို တစ်ခုတည်းအဖြစ် ပေါင်းစပ်ပေးတာကြောင့် memory-bound workload က watt တွေကို DIMM တွေဆီ ရွှေ့ပေးပြီး compute-bound တစ်ခုက ပြန်ဆွဲထုတ်ပေးပါတယ်။ အဲဒါက fixed budget အတွင်းမှာ စွမ်းဆောင်ရည်ကို မြှင့်တင်ပေးတာ ဒါမှမဟုတ် node ပိုများတဲ့ rack ပါဝါကို လွတ်လပ်စေပါတယ်။ UBPS က အသုံးပြုမှုနည်းတဲ့အခါ power ကို ကန့်သတ်ပေးပြီး ပုံမှန် light-load performance bump ကို flat, predictable load line နဲ့ လဲလှယ်ပေးပါတယ်။ bump ကို ပိုနှစ်သက်တဲ့ operator တွေက ပိတ်နိုင်ပါတယ်။ FAST က SoC တစ်ခုကို personality နှစ်ခုအဖြစ် ပိုင်းခြားပေးပြီး priority core တွေကို high frequency မှာ ထားရှိပြီး background core တွေက ပိုနှေးအောင် လည်ပတ်တာကြောင့် latency-critical work တွေကို batch jobs တွေနဲ့ socket မျှဝေတဲ့အခါ ထိခိုက်မှုမရှိစေပါဘူး။
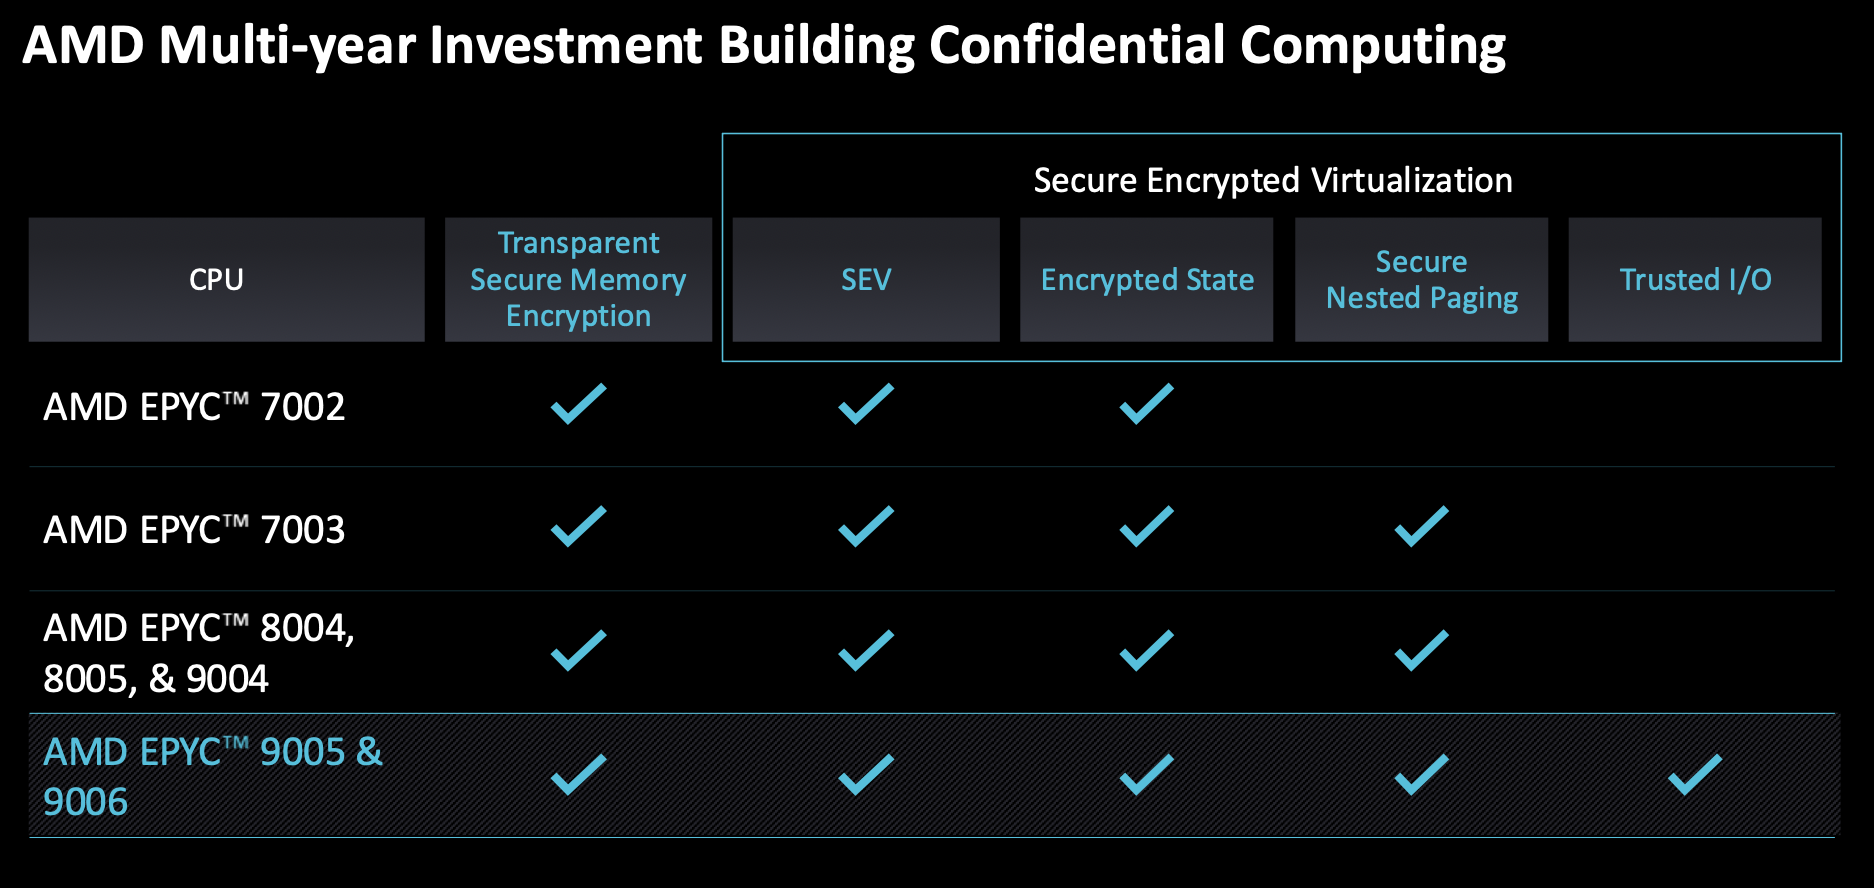
လုံခြုံရေးအတွက်၊ Venice သည် encrypted state၊ secure nested paging နှင့် Turin နှင့်အတူ ရောက်ရှိလာသော Trusted I/O တို့မှတစ်ဆင့် EPYC 7002 ပေါ်ရှိ SEV မှ လည်ပတ်သော confidential-computing မျိုးရိုးကို တိုးချဲ့ထားသည်။ ယခုမျိုးဆက်အသစ်- RSA-4K နှင့် post-quantum algorithms၊ physical နှင့် side-channel attack mitigations၊ FIPS 140-3 Level 1 အသိအမှတ်ပြုလက်မှတ်နှင့် Device Provenance တို့ဖြင့် မြှင့်တင်ထားသော ယုံကြည်မှုအမြစ်၊ Venice သည် ပထမဆုံး AMD ထုတ်ကုန်များထဲတွင် ပါဝင်မည့် သက်သေပြနိုင်သော ထုတ်လုပ်မှုသမိုင်း။
Portfolio အတွင်းပိုင်း
အပိုင်းလေးပိုင်းသည် မျှဝေထားသောအမည်ထက် ပိုမိုကွဲပြားသည်။
| specification | ၉.၁ SP9006 | ၉.၁ SP9006 | ၉၀၀၆X SP၇ | ၉၀၀၆ LP “ဗီရာနို” |
|---|---|---|---|---|
| အရောင်များ | ၂၅၆ အထိ (၅၁၂ thread) | 8 မှ 128 | 96 အထိ | 72 အထိ |
| အမြင့်ဆုံးကြိမ်နှုန်း | 5.0GHz ဖြင့် 96 cores (HF) | HF ရွေးချယ်စရာများ ပေးဆောင်ထားသည် | ~၅.၁၅ GHz | 5.0GHz အထိ |
| မှတ်ဉာဏ် | ၁၆ch၊ ၁.၆TB/s အထိ | ချန်နယ်တစ်ခုလျှင် DIMM ၂ ခုပါ 8ch | 16ch MRDIMM သည် 12,800 MT/s တွင် ရှိသည်။ | ၂၄ch LPDDR5X၊ SOCAMM2 |
| L3 cache ကို | 1024MB အထိ | Core အရေအတွက်ပေါ်မူတည်သည် | ၁၁၅၂MB (3D V-Cache) | Core အရေအတွက်ပေါ်မူတည်သည် |
| I / O | PCIe Gen 6၊ ၉၆ လမ်းကြောင်း | PCIe လမ်းကြောင်း ၁၂၈ ခု၊ 1P နှင့် 2P | PCIe ဗိုလ်ချုပ်ကြီး 6 | 112 GT/s တွင် မြှင့်တင်ထားသော xGMI |
| ရည်ရွယ် | Hyperscale သိပ်သည်းဆ၊ AI လက်ခံသူ | Enterprise၊ edge၊ NEBS နှင့် လိုက်ဖက်သော | HPC၊ AI ကြိုတင်လုပ်ဆောင်ခြင်း | Rack-scale AI host |
EPYC ၉၀၀၆ SP၈
SP7 သည် flagship socket ဖြစ်ပြီး ယခုထုတ်လုပ်နေသော socket တစ်ခုဖြစ်သည်။ မိတ်ဖက်ပလပ်ဖောင်းများသည် စတုတ္ထသုံးလပတ်တွင် လိုက်လံလုပ်ဆောင်သည်။ ၎င်း၏ high-frequency bins များသည် AMD က ၎င်း၏အမြန်ဆုံး ramping SKU များထဲတွင် ပါဝင်သည်ဟု ပြောကြားခဲ့ပြီး ၎င်းတို့၏ အကြီးမားဆုံးဖြန့်ကျက်မှုမှာ Helios ဖြစ်ပြီး compute tray တိုင်းရှိ host CPU သည် Infinity Fabric မှတစ်ဆင့် rack ၏ coherent memory domain နှင့် ချိတ်ဆက်ကာ 1TB DDR5 ပါရှိသည်။ socket သည် စံသတ်မှတ်ချက်ဖြစ်သောကြောင့် 256-core flagship အထိ မည်သည့် SP7 SKU မဆို ထည့်သွင်းထားပြီး ညီအစ်မဆောင်းပါးတွင် ဖော်ပြခဲ့သည့်အချက်ကို ကျွန်ုပ်တို့ ဖော်ပြခဲ့သည်။
EPYC ၉၀၀၆ SP၈
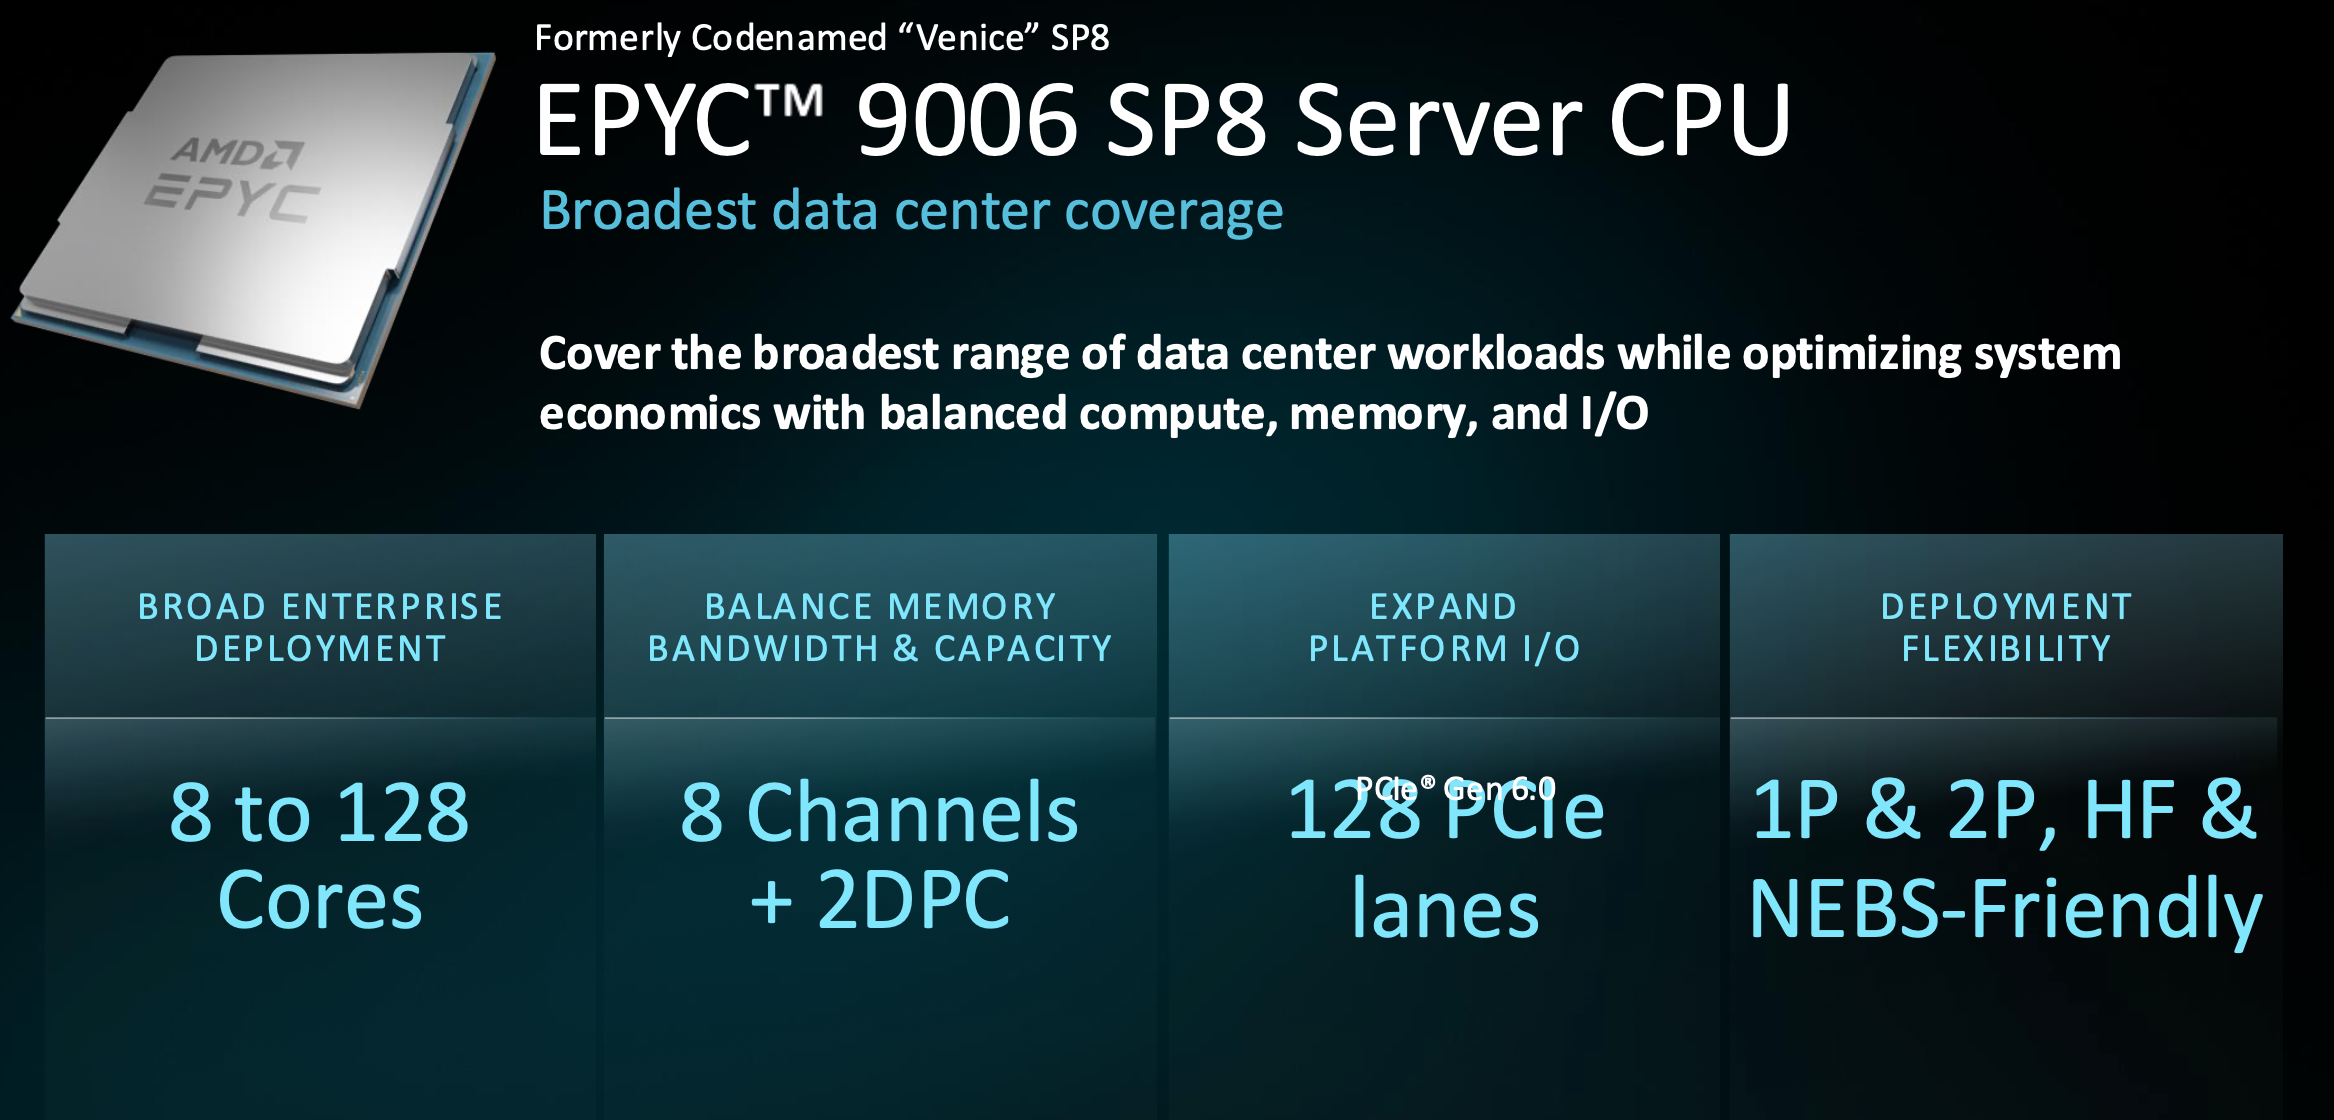
SP8 သည် စနစ်စီးပွားရေးအတွက် ဧရာမ socket ကို ရောင်းဝယ်ဖောက်ကားသည်။ ၎င်းသည် core ၈ ခုမှ ၁၂၈ ခုအထိ ပါဝင်ပြီး channel တစ်ခုလျှင် DIMM ၂ ခုပါသည့် မှတ်ဉာဏ် channel ၈ ခုကို လည်ပတ်ကာ PCIe လမ်းကြောင်း ၁၂၈ ခုကို ထိန်းသိမ်းထားပြီး telco နှင့် edge ဖြန့်ကျက်မှုများအတွက် မြင့်မားသောကြိမ်နှုန်းနှင့် NEBS-friendly ရွေးချယ်စရာများပါရှိသော 1P နှင့် 2P ဖြင့် ထွက်ပေါ်လာသည်။ AMD ၏ ရည်ရွယ်ချက်မှာ လုပ်ငန်းအတွက် သင့်တော်သော စွမ်းဆောင်ရည်ဖြစ်ပြီး အရောင်းအဝယ်များ အောင်မြင်စေသည့် စံနှုန်းမှာ rack တစ်ခုစီထက် system တစ်ဒေါ်လာလျှင် စွမ်းဆောင်ရည်ဖြစ်သည်။
EPYC 9006X “ဗင်းနစ်-X”
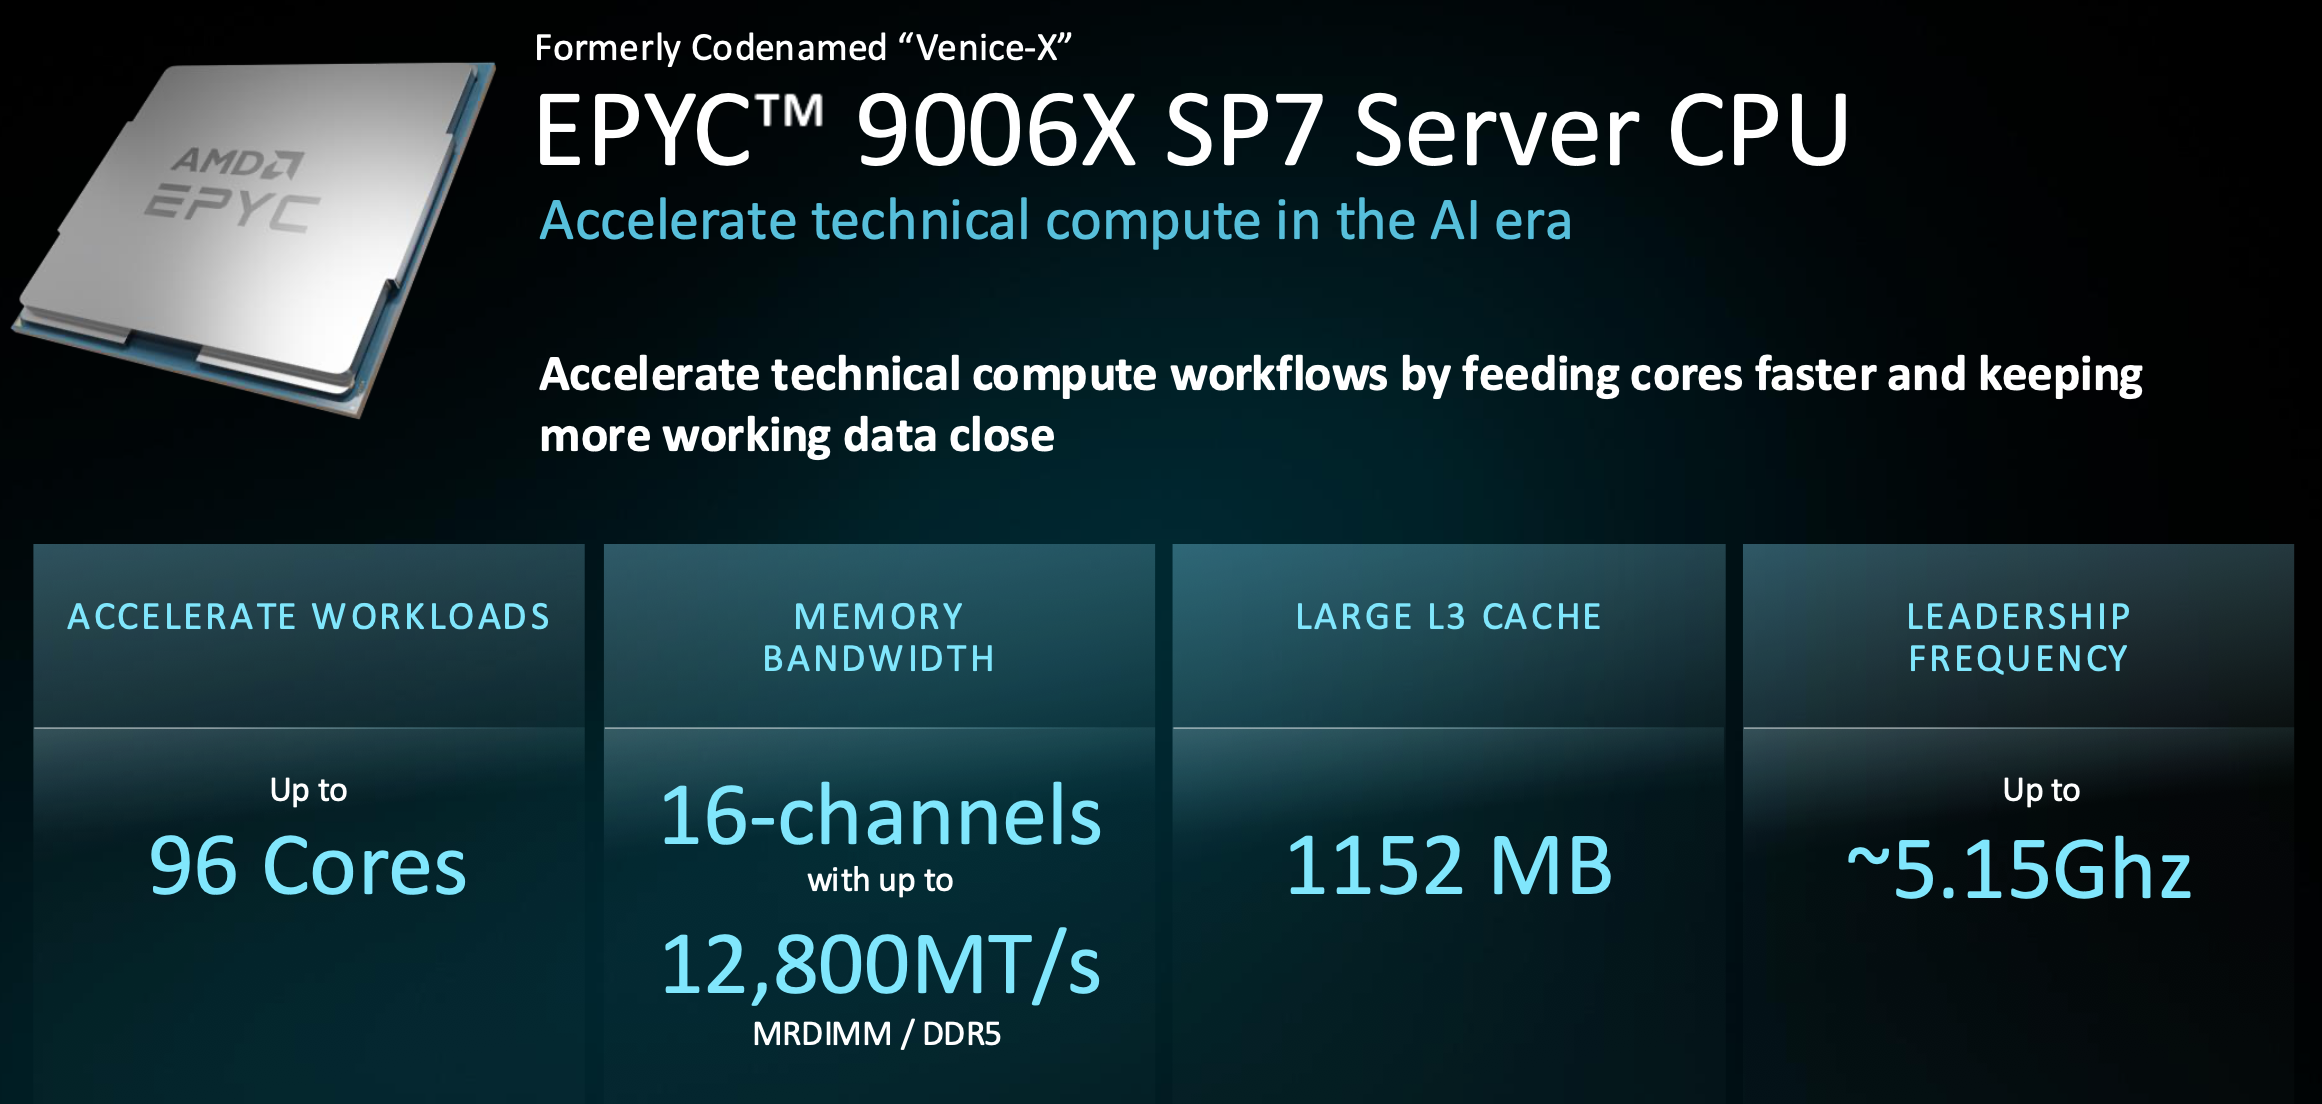
Venice-X သည် 3D V-Cache ကို 96-core high-frequency configuration ပေါ်တွင် စီထားပြီး L3 ကို 1152MB အထိ ယူဆောင်သွားပြီး စံ SP7 အစိတ်အပိုင်းများ၏ core တစ်ခုလျှင် cache ၏ ၃ ဆခန့်ရှိသည်။ clocks များသည် 5.15GHz ခန့်သို့ ရောက်ရှိပြီး 16-channel အပြည့်အစုံ၊ 12,800 MT/s memory system သည် ဆက်လက်လုပ်ဆောင်သည်။ ပစ်မှတ်များမှာ simulation နှင့် modeling၊ large-scale analytics၊ in-memory databases နှင့် training pipelines များကို feed လုပ်သည့် AI pre-processing—အပို core များထက် cache တွင် သိမ်းဆည်းထားသော working set သည် ပိုအရေးကြီးသည့် workloads များဖြစ်သည်။
EPYC 9006 LP “Verano”
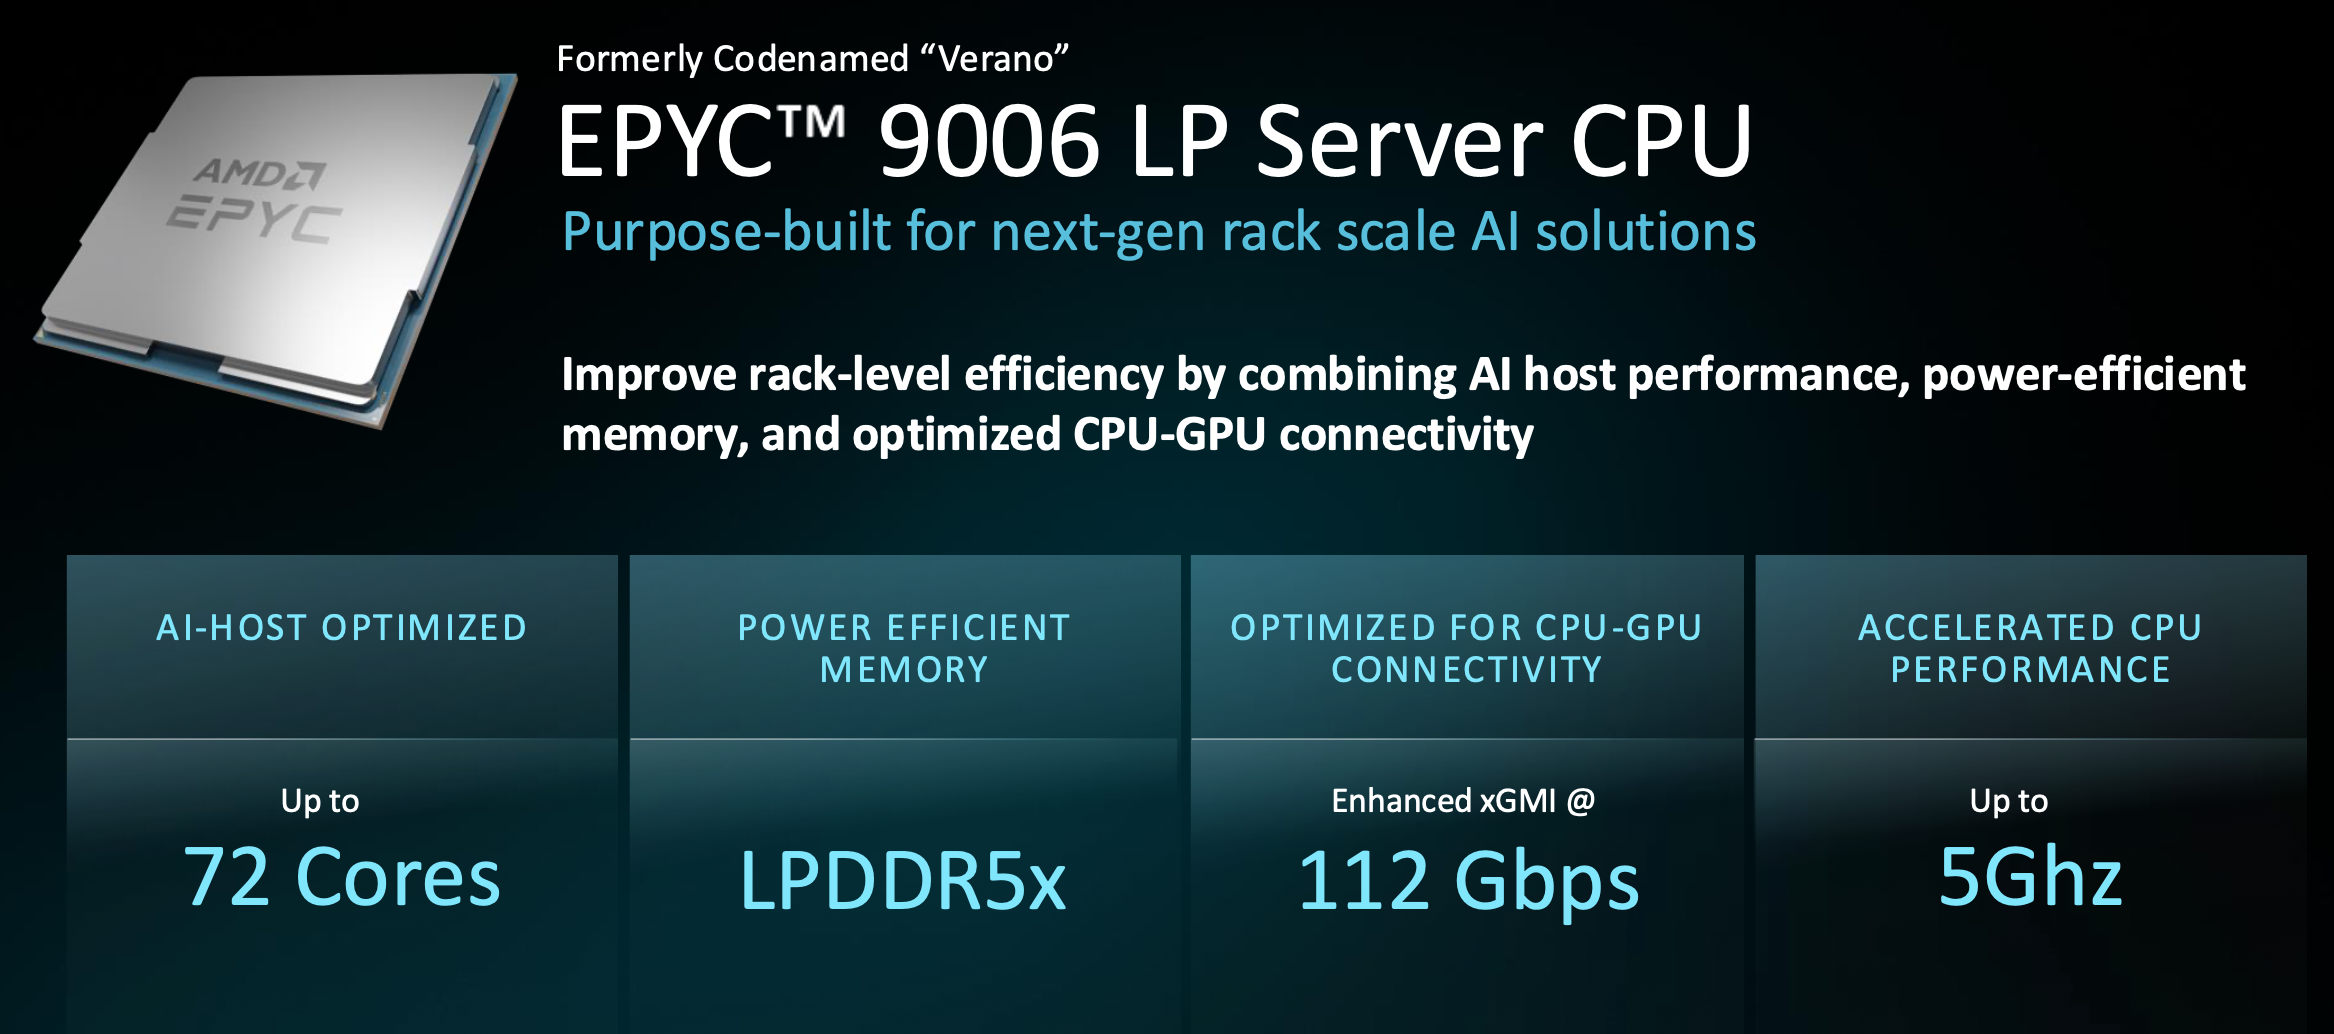
Verano က မိသားစုထဲမှာ အာရုံစိုက်မှုအရှိဆုံးအပိုင်းပါ- AI host node first ဖြစ်ပြီး 5GHz မှာ core ၇၂ ခုအထိ၊ LPDDR5X ရဲ့ channel ၂၄ ခုနဲ့ CPU-to-GPU traffic အတွက် မြှင့်တင်ထားတဲ့ 112 GT/s xGMI link ပါဝင်ပါတယ်။ LPDDR ဟာ field မှာ အစားထိုးနိုင်တဲ့ SOCAMM2 modules တွေပေါ်မှာ တပ်ဆင်ထားပြီး soldered-down memory failure ဖြစ်သွားရင် board တစ်ခုလုံး ပျက်စီးသွားနိုင်တဲ့ fleet တစ်ခုမှာ အရေးကြီးပါတယ်။ ဒါဟာ NVIDIA ရဲ့ Vera အတွက် AMD ရဲ့ တိုက်ရိုက်အဖြေလည်း ဖြစ်ပါတယ်။ AMD ကလည်း အဲဒီလိုပဲ လုပ်ခဲ့တာကြောင့် ကျွန်တော်တို့ ပြန်ဆုံကြဦးမှာပါ။
ဗင်းနစ်မြို့ ဘယ်လိုပုံစံနဲ့ စည်ကားနေလဲ
AMD သည် ၎င်း၏အခြေအနေကို နှစ်ကြိမ်တိုင်တိုင် တင်ပြခဲ့ပြီး Turin သည် ၎င်းရရှိထားပြီးသော ဦးဆောင်မှုကို ပြသခဲ့ပြီး ထို့နောက် Venice သည် ၎င်းမည်မျှအထိ ဝေးကွာနေပြီကို ပြသခဲ့သည်။
တူရင်ရဲ့ ဒီနေ့ ဦးဆောင်မှု
AMD သည် ၎င်း၏နှိုင်းယှဉ်မှုအများစုကို NVIDIA ၏ Vera၊ Vera Rubin ပလက်ဖောင်းရှိ Arm CPU ကို ရည်ရွယ်ခဲ့ပြီး ၎င်းထုတ်လုပ်ပြီးသော မျိုးဆက်ဖြင့် စတင်ခဲ့သည်။ AMD ၏ rack-level modeling အရ Turin ၏ rack သည် Vera ၏ 2.4x general-purpose throughput နှင့် watt တစ်ခုလျှင် agents ၏ နှစ်ဆကို ပေးစွမ်းသည်။ မော်ဒယ်သည် rack နှစ်ခုလုံးကို 100kW power budget ဖြင့် ပြုပြင်ပေးပြီး 384 cores ပါသည့် 2P EPYC 9965 ကို 176 cores ပါသည့် 2P Vera board နှင့် ကိုက်ညီစေပြီး ရလဒ်များကို workload ခြောက်ခုတွင် ပျမ်းမျှထားသည်- estimated SPECrate 2017၊ server-side Java၊ NGINX၊ Redis၊ Memcached နှင့် TPC-C derivative တို့ဖြစ်သည်။
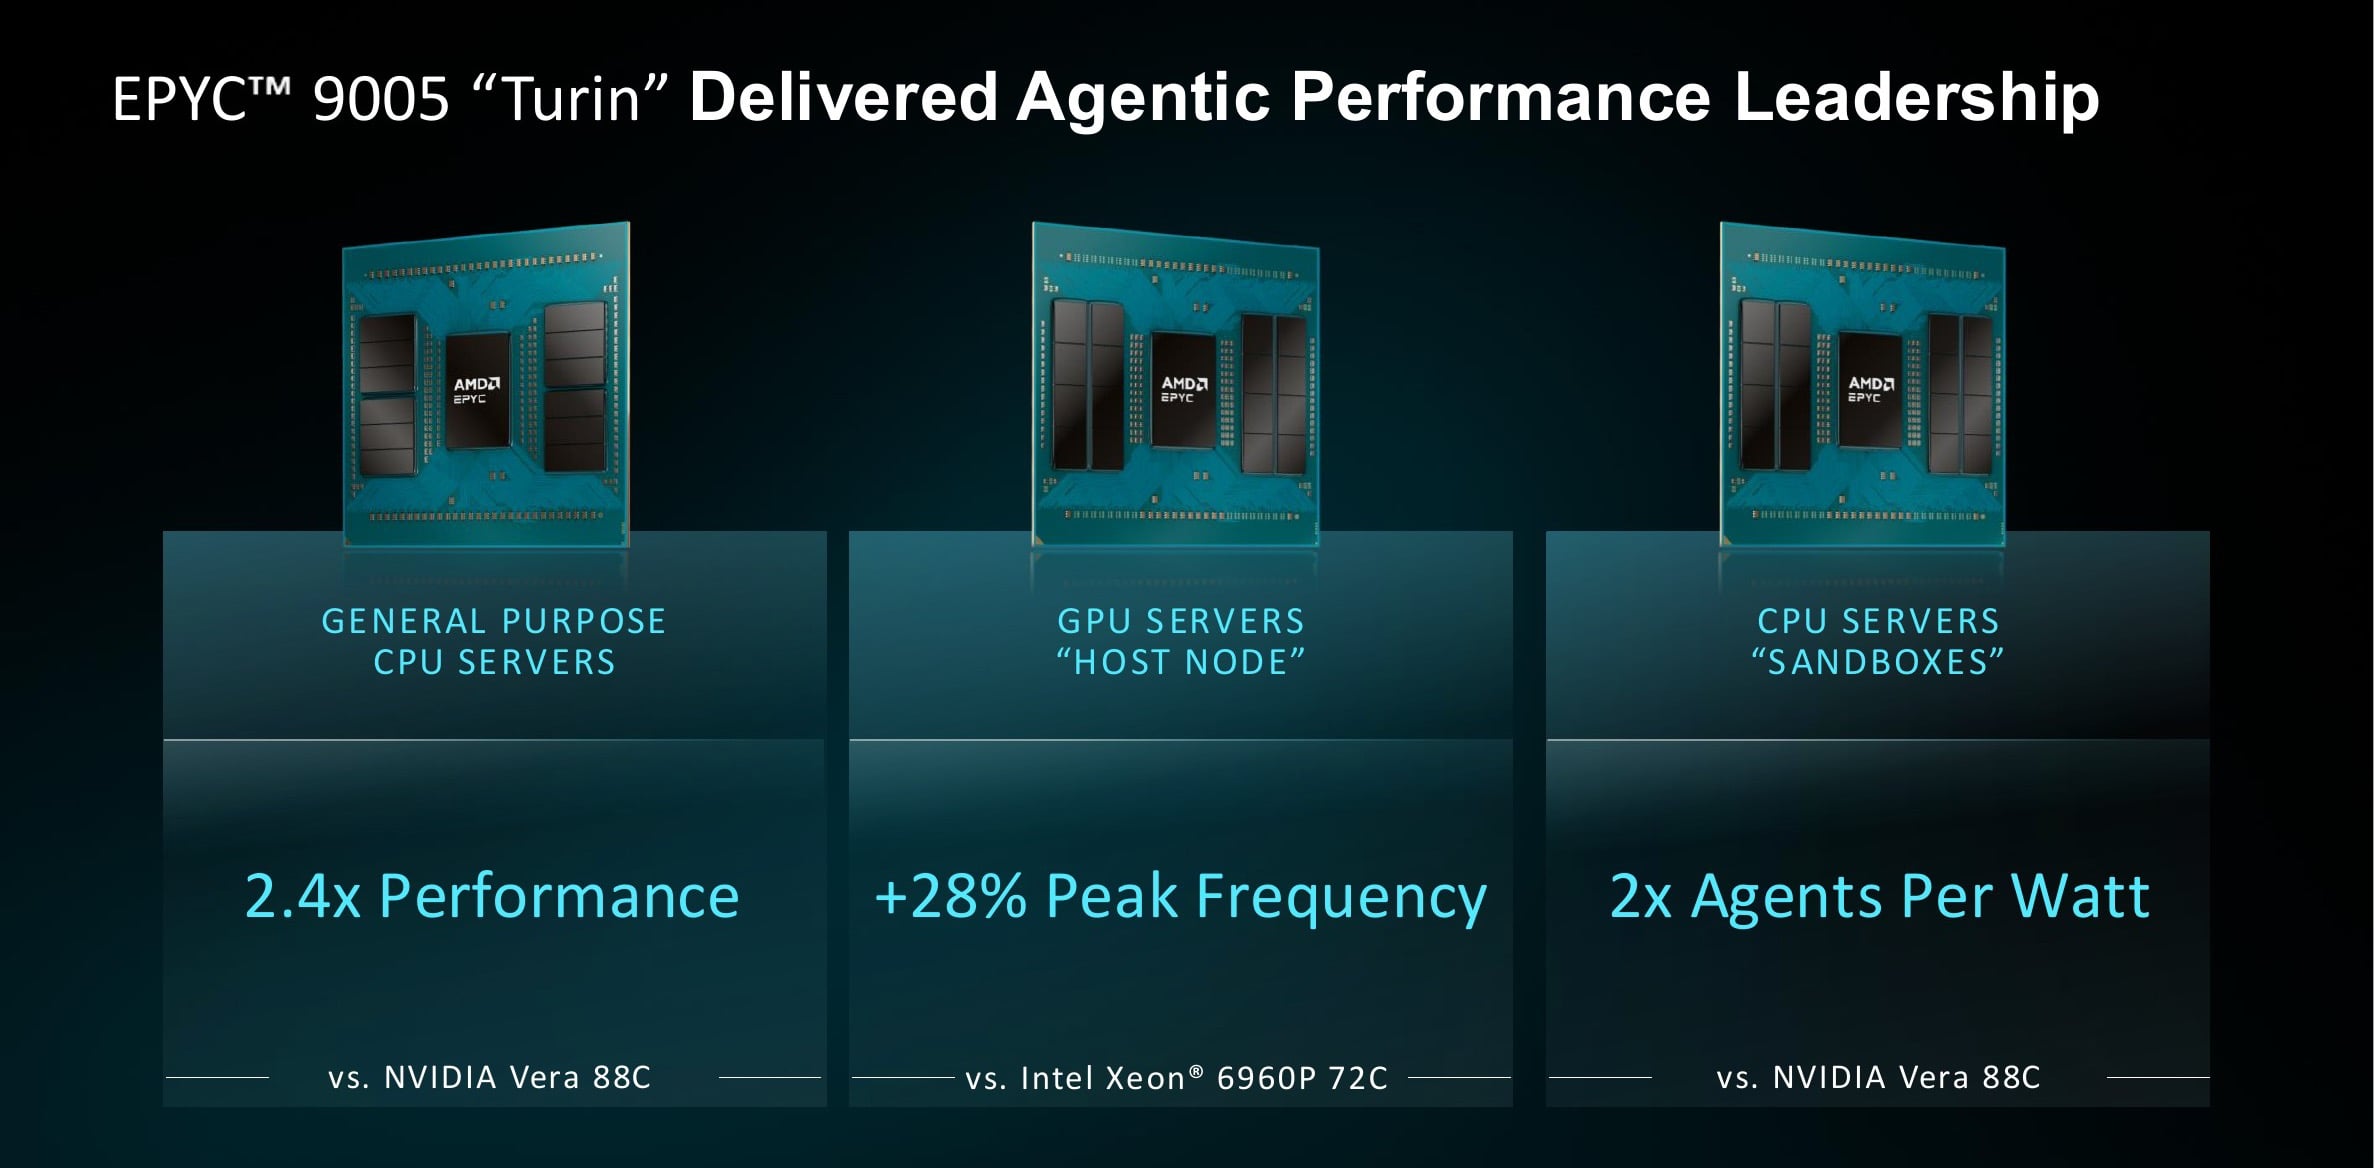
ဤနေရာတွင်နှင့် ဤဆောင်းပါး၏ ကျန်အပိုင်းအတွက် သတိပေးချက်နှစ်ခု အကျုံးဝင်ပါသည်။ Vera ကို မပို့ရသေးသောကြောင့် Vera ကိန်းဂဏန်းတိုင်းသည် NVIDIA မှ ၎င်း၏ အများပြည်သူဆိုင်ရာ ပစ္စည်းများတွင် ဖော်ပြထားသော 88-core၊ 450W အစိတ်အပိုင်း၏ AMD ခန့်မှန်းချက်ဖြစ်သည်။ agentic workloads အတွက် စံ benchmark မရှိသောကြောင့် AMD သည် ၎င်း၏ agents-per-watt သင်္ချာတွင် agent များအတွက် proxy အဖြစ် hardware thread များကို ရေတွက်သည်။
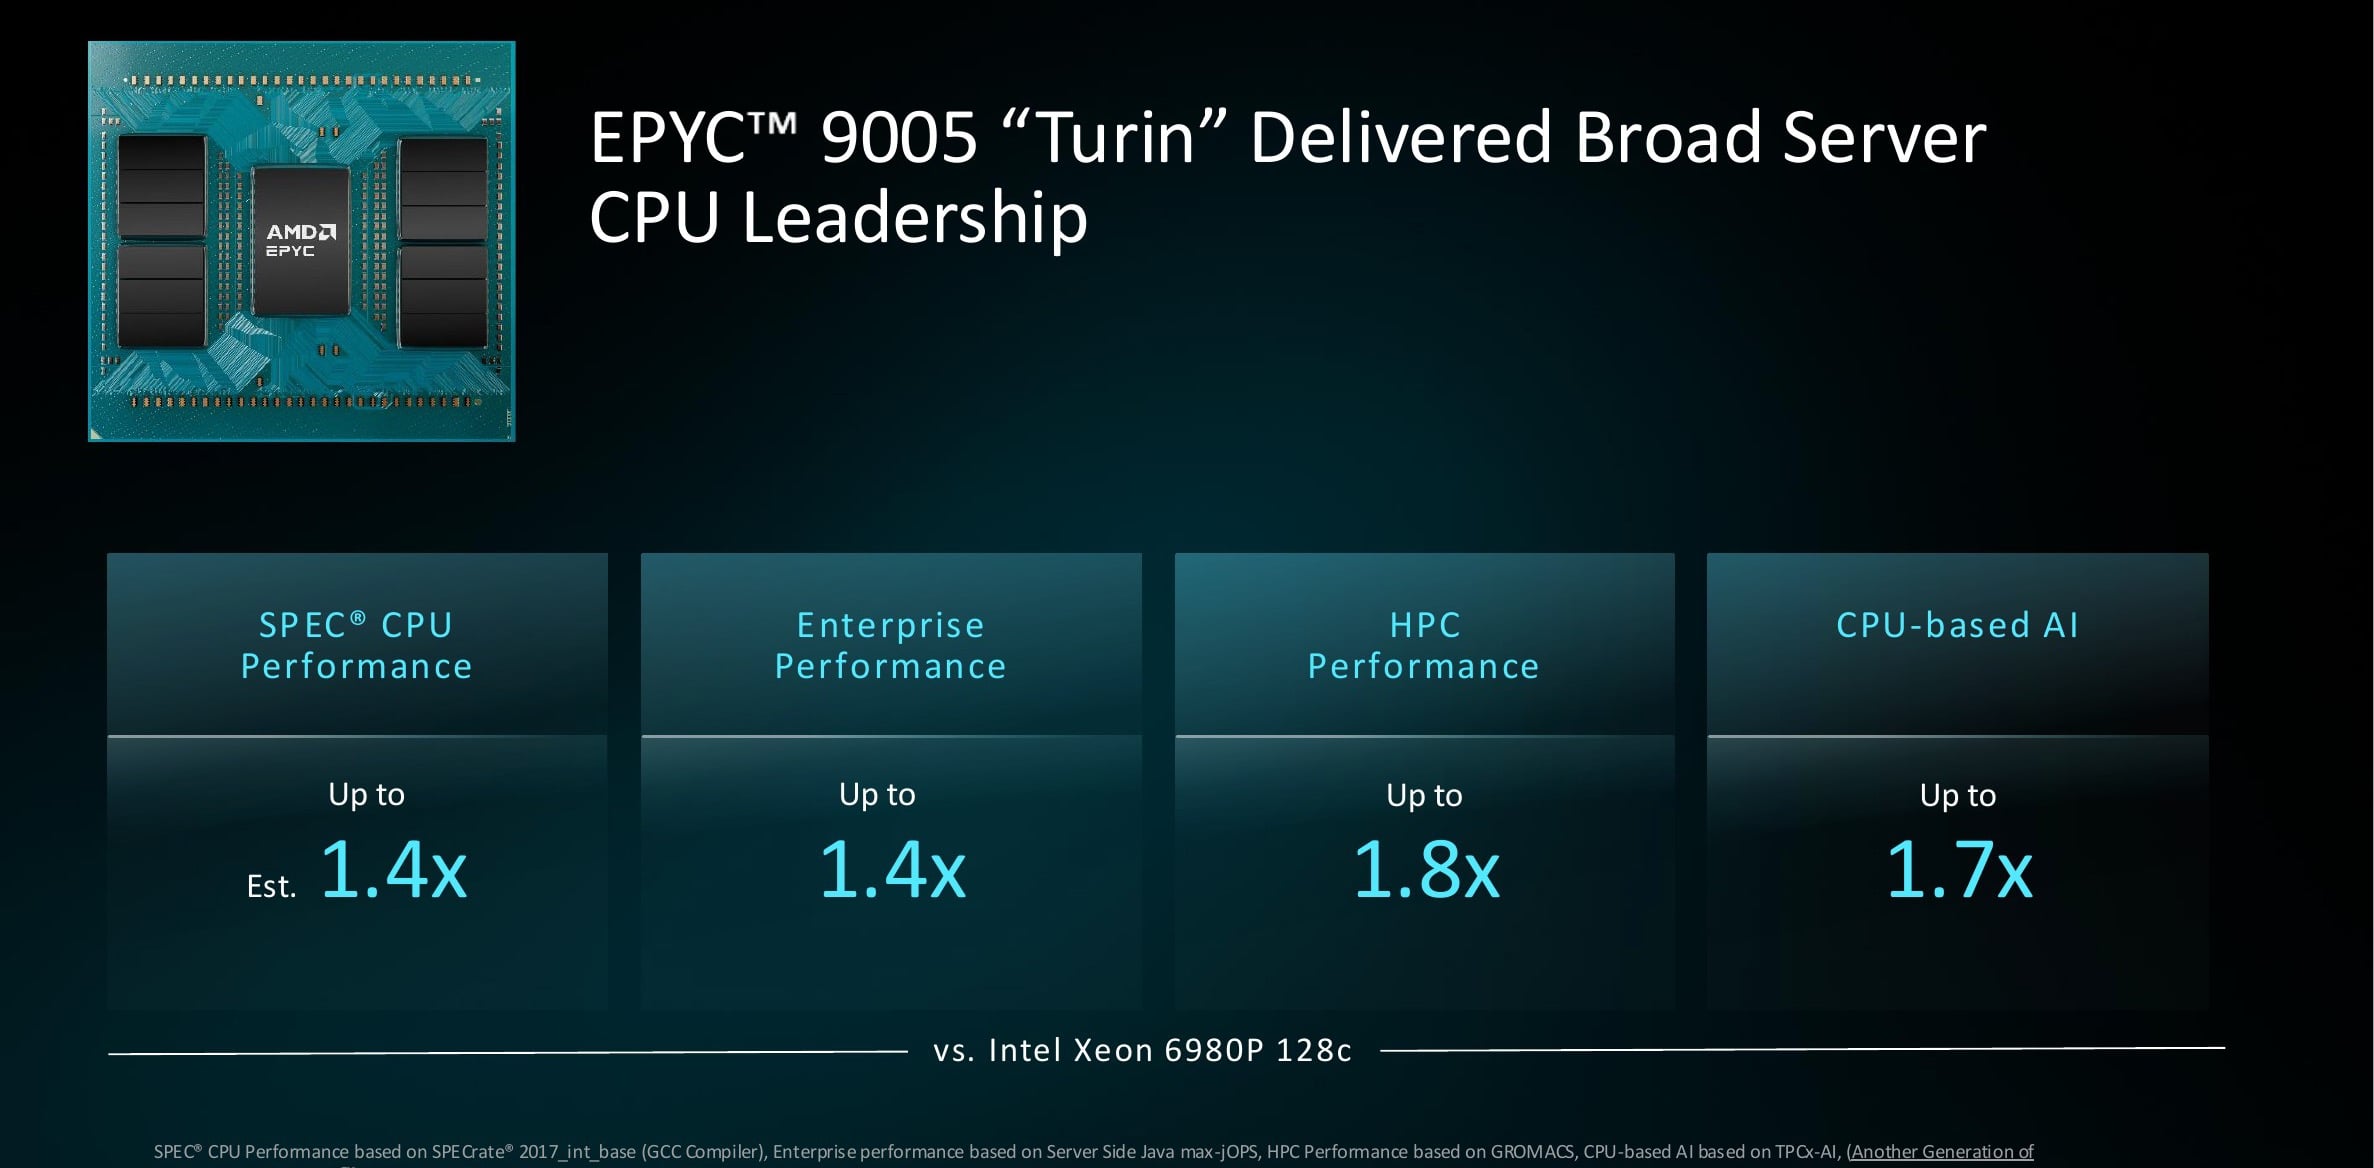
Intel နှိုင်းယှဉ်မှုဟာ ပိုမိုခိုင်မာတဲ့ အနေအထားမှာ ရှိပါတယ်၊ ဘာလို့လဲဆိုတော့ နှစ်ဖက်စလုံးက AMD ကို တိုက်ရိုက် benchmark လုပ်နိုင်တဲ့ အစိတ်အပိုင်းတွေ ဖြစ်နေလို့ပါ။ Turin ရဲ့ host CPU တွေက 5.0GHz အထိ ရောက်ရှိပြီး နှိုင်းယှဉ်လို့ရတဲ့ Xeon ကတော့ 3.9GHz အထိ အမြင့်ဆုံး ရောက်ရှိပြီး single thread တွေက GPU တွေကို feed လုပ်တဲ့အခါ အရေးပါသော 28% frequency အားသာချက် ရှိပါတယ်။ 128-core Xeon 6980P နဲ့ နှိုင်းယှဉ်ရင် Socket-for-socket မှာ AMD က Turin ကို SPEC CPU မှာ 1.4X၊ enterprise Java မှာ 1.4X၊ HPC မှာ 1.8X နဲ့ CPU-based AI မှာ 1.7X အထိ တိုင်းတာပါတယ်။
ဗင်းနစ်မြို့ဟာ ကွာဟချက်တိုင်းကို ချဲ့ထွင်လိုက်သလိုပါပဲ
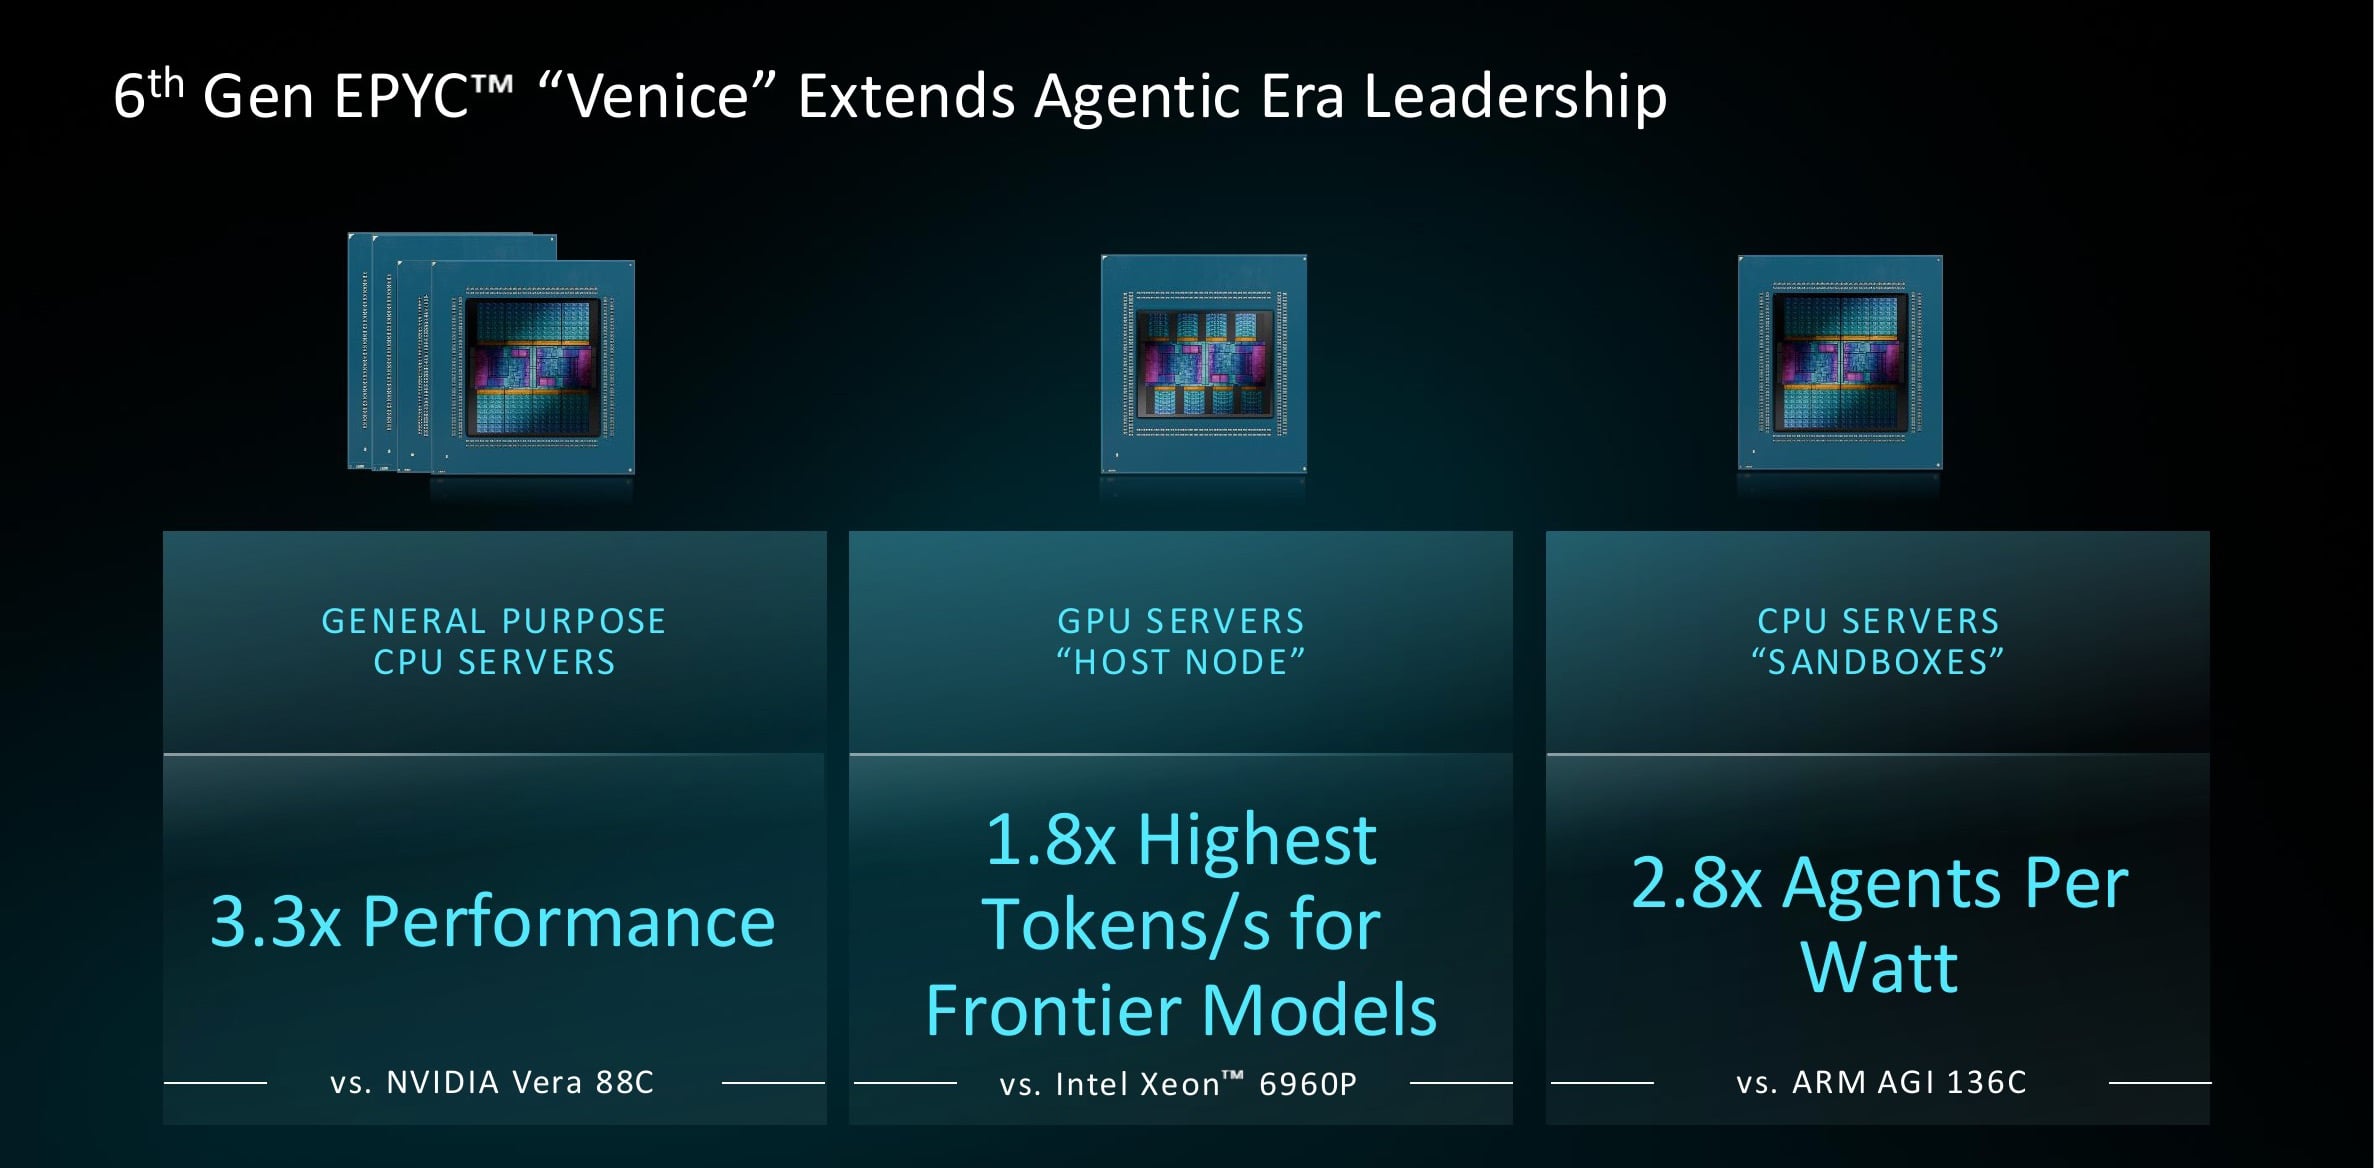
Venice သည် ထိုဦးဆောင်မှုတစ်ခုချင်းစီကို တိုးချဲ့ထားသည်။ တူညီသော 100kW rack မော်ဒယ်အောက်တွင်၊ ယခုအခါ Vera ၏ 176 တွင် Venice cores 512 ခုပါရှိပြီး AMD သည် Vera ၏ အထွေထွေအသုံးပြုမှုစွမ်းဆောင်ရည်ကို 3.3X ရှိသည်ဟု ဆိုသည်။ Venice သည် 136-core Arm AGI ၏ watt တစ်ခုလျှင် agents 2.8x နှင့် Venice တွင် GPU များကို host လုပ်သည့်အခါ frontier မော်ဒယ်များတွင် တစ်စက္ကန့်လျှင် tokens 1.8x ရရှိသည်။ ထို 1.8× ကိန်းဂဏန်းသည် ခေါင်းစဉ်က အကြံပြုထားသည်ထက် ပိုမိုကျဉ်းမြောင်းသော အခြေအနေကို တိုင်းတာပြီး အောက်ဖော်ပြပါ host-node အပိုင်းတွင် ကျွန်ုပ်တို့ ပြန်သွားပါမည်။
ဗီရာနှင့် ထိပ်တိုက်တွေ့ဆုံခြင်း
SPECrate 2026 မှာ AMD က Vera အတွက် 2P Venice 9996 ကို 2070 မှာ 925 နဲ့ ယှဉ်ပြီး ခန့်မှန်းထားပြီး 2.2X throughput အားသာချက်ရှိကာ 96-core high-frequency အပိုင်းဟာ Vera per core ထက် 1.2× ခန့် သာလွန်ပါတယ်။ ရလဒ်နှစ်ခုစလုံးကို NVIDIA က ၎င်းရဲ့ Vera နံပါတ်တွေအတွက် အသုံးပြုတဲ့ toolchain တစ်ခုတည်းနဲ့ GCC 15.2 နဲ့ စုစည်းထားပါတယ်။
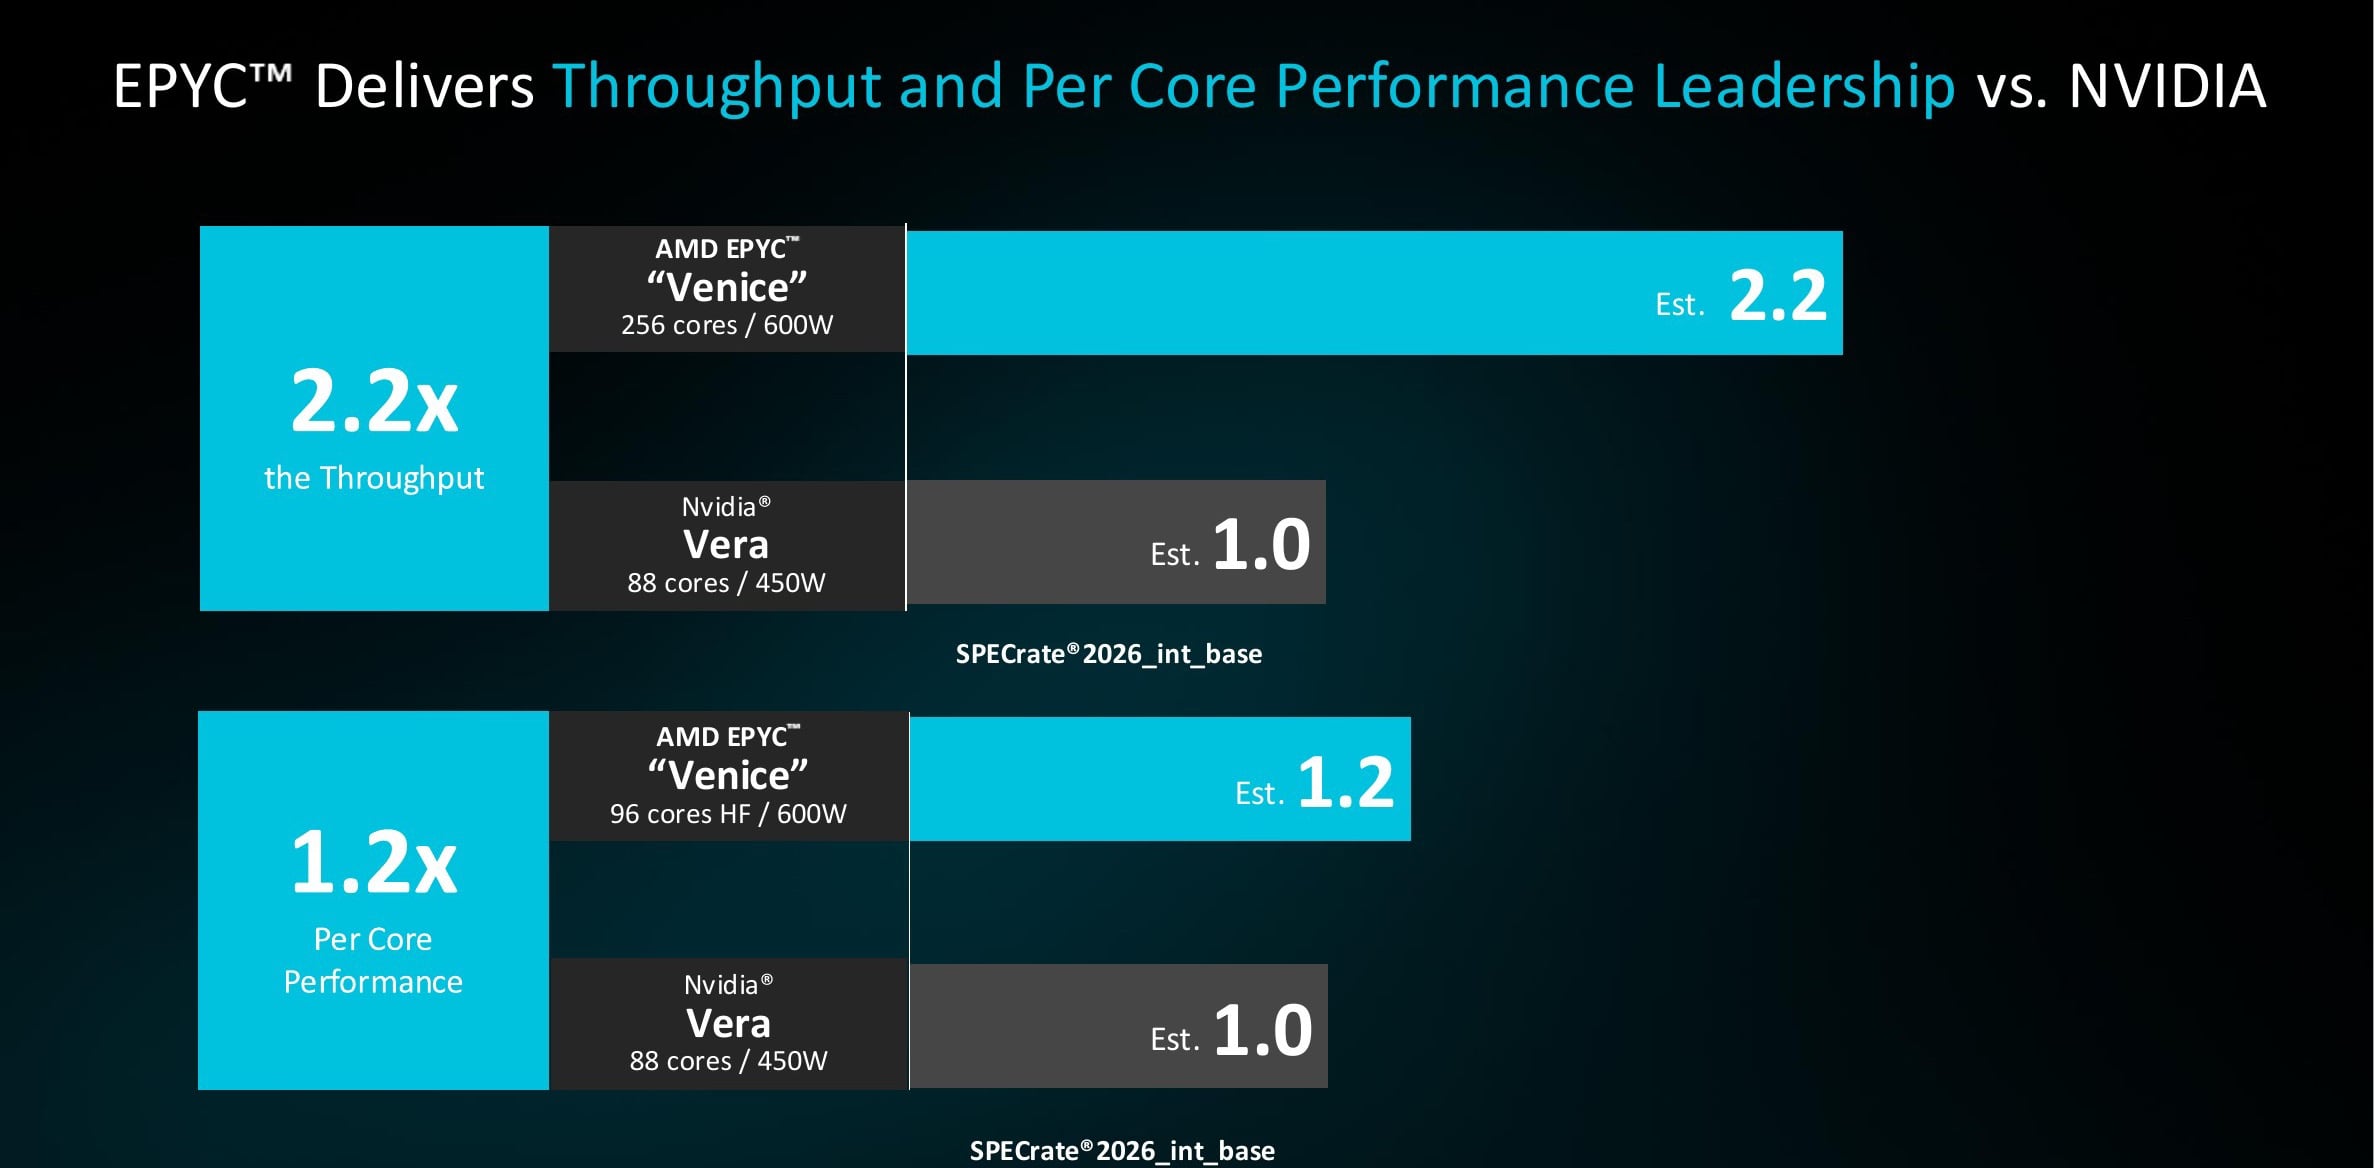
core တစ်ခုလျှင် core တစ်ခုချင်းစီ၏ တောင်းဆိုမှုသည် စတင်ရောင်းချသည့်အပတ်အတွင်း အမှန်တကယ် မြင့်တက်လာခဲ့သည်။ AMD ၏ CPU အင်ဂျင်နီယာကို ဦးဆောင်သူ Ravi Kuppuswamy က AMD သည် မူလက core တစ်ခုလျှင် 10% အားသာချက်ရှိသည်ဟု အခိုင်အမာပြောဆိုခဲ့ကြောင်း သတင်းစာရှင်းလင်းပွဲတွင် ပြောကြားခဲ့သည်။ NVIDIA သည် ၎င်း၏ကိုယ်ပိုင် Vera နံပါတ်များကို အပတ်အစောပိုင်းတွင် ထုတ်ပြန်ပြီးနောက်၊ ၎င်း၏အဖွဲ့သည် တူညီသော compiler နှင့် setting များကို အသုံးပြု၍ နှိုင်းယှဉ်မှုကို ပြန်လည်လုပ်ဆောင်ခဲ့ပြီး ချိန်ညှိမှု မပြီးဆုံးသေးဘဲ 20% ဦးဆောင်မှုကို တိုင်းတာခဲ့သည်။ 2.2× throughput gap သည် AMD ၏ အတွင်းပိုင်း ခန့်မှန်းချက်များနှင့် တစ်ချိန်လုံး ကိုက်ညီကြောင်း ၎င်းက ပြောကြားခဲ့သည်။ သီးခြား endnote တစ်ခုတွင် AMD ၏ကိုယ်ပိုင် AOCC compiler ကို အသုံးပြု၍ SPECrate 2017 ရှိ per-core နှိုင်းယှဉ်မှုကို ပြန်လည်တွက်ချက်ထားပြီး 1.7× သို့ ရောက်ရှိခဲ့ပြီး တွက်ချက်မှုနှစ်ခုတွင် 20% သည် ပိုမိုကွန်ဆာဗေးတစ်ဖြစ်စေသည်။
Intel နှင့် Arm
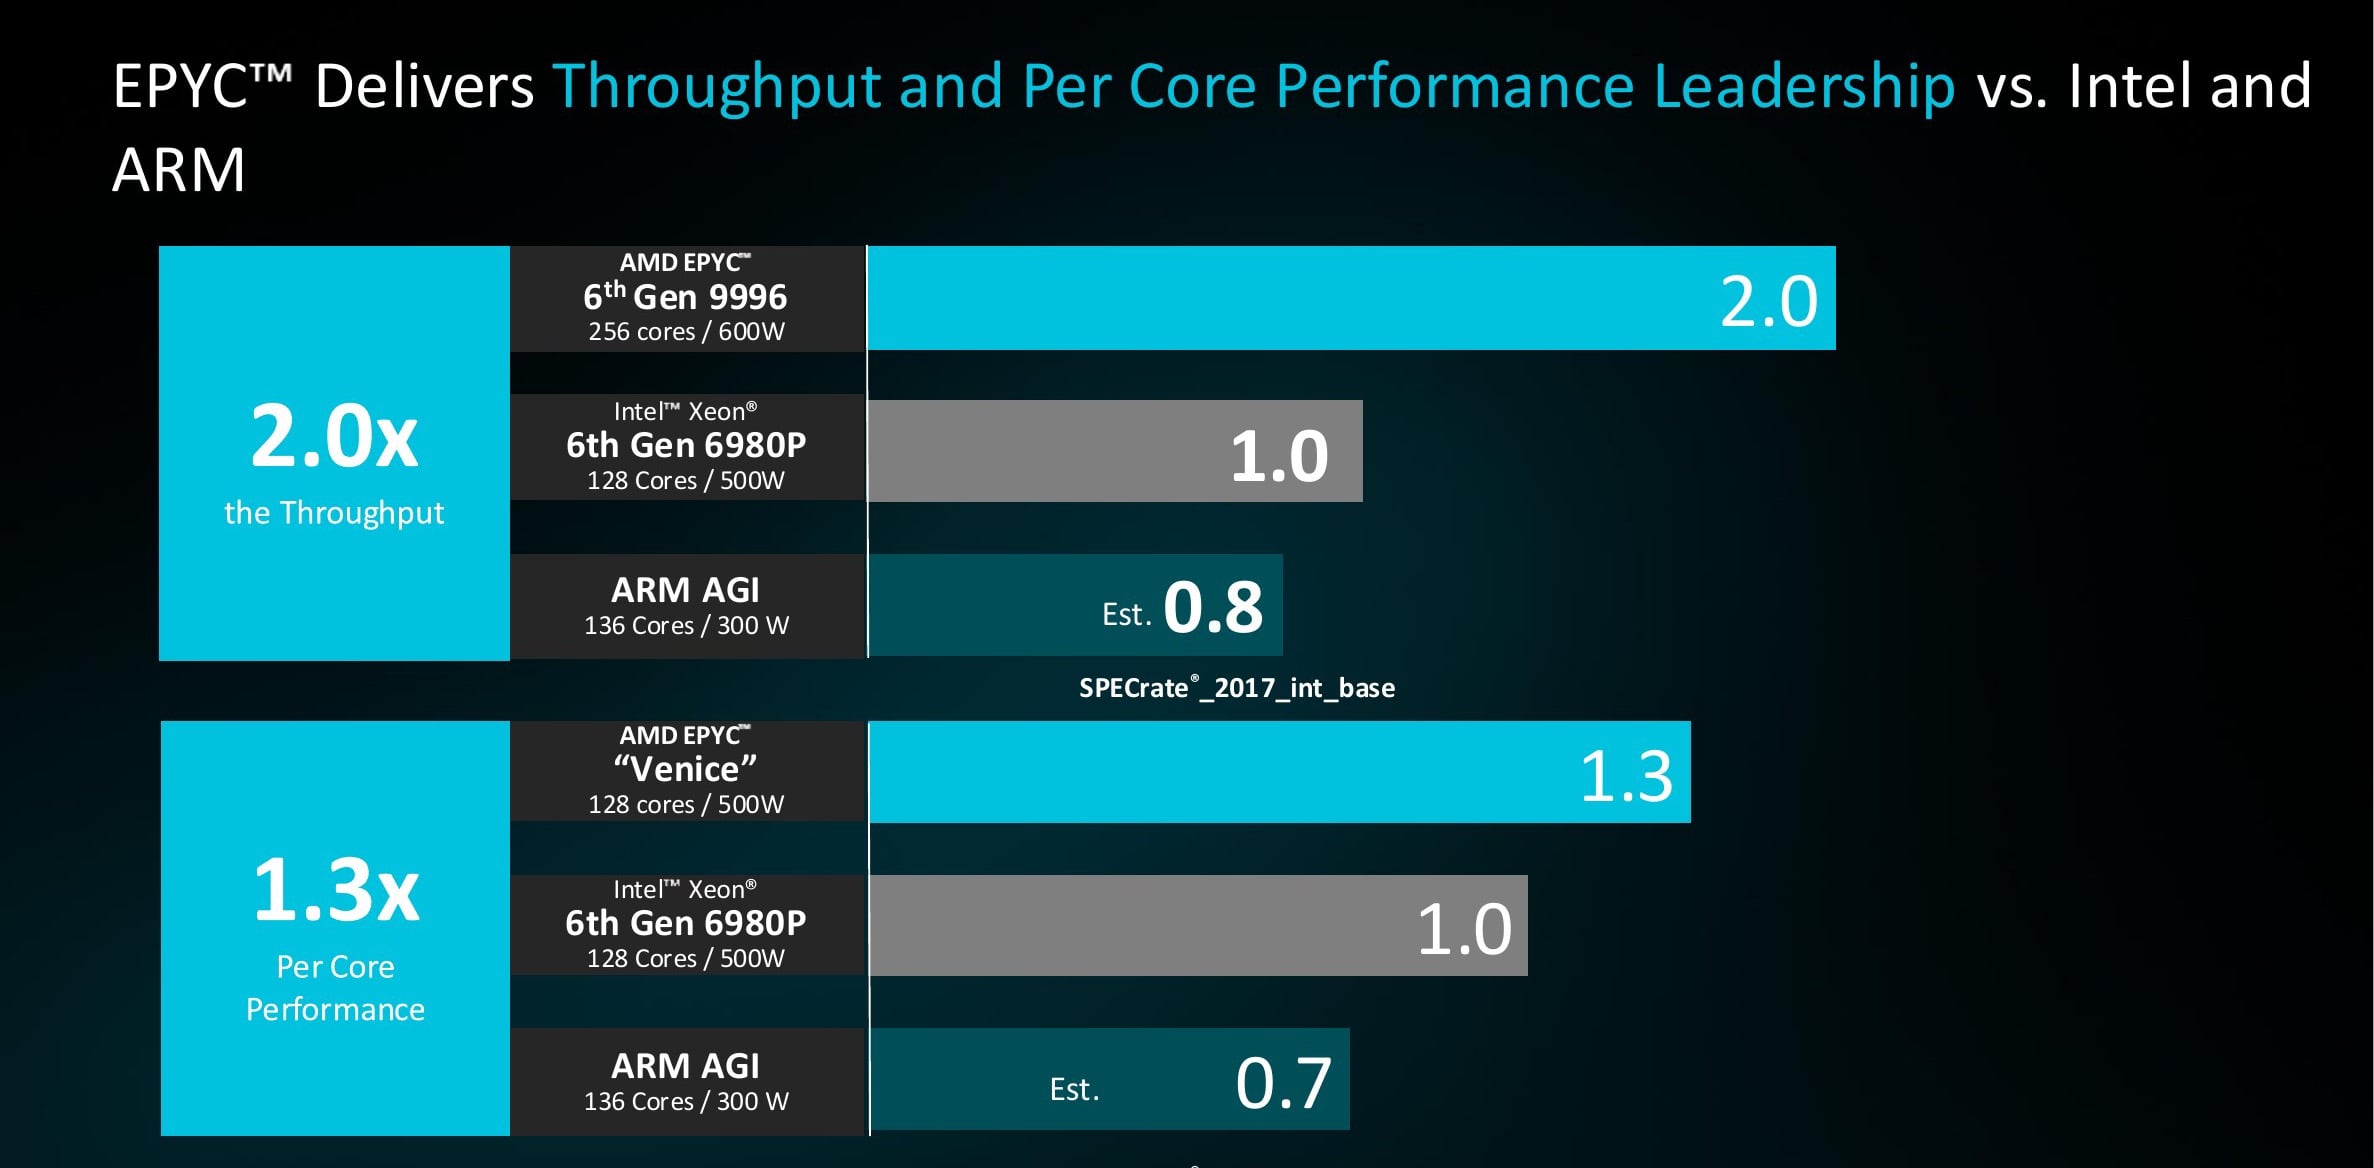
AMD သည် ပိုမိုကျယ်ပြန့်သော SPECrate 2017 အဆင့်သတ်မှတ်ချက်ကိုလည်း ပြသခဲ့သည်။ Venice 9996 သည် 4900 (256 cores, 600W, $14,904 at 1Ku) ဖြင့် ဦးဆောင်နေပြီး Turin 9965 သည် 3240 ဖြင့် ဒုတိယနေရာတွင် ရပ်တည်လျက်ရှိပြီး Intel ၏ Xeon 6980P သည် 2510 (128 cores, 500W, $13,955) ဖြင့် ဒုတိယနေရာတွင် ရပ်တည်လျက်ရှိကာ Arm AGI သည် 1944 (136 cores, 300W) နှင့် Vera သည် 1459 ဖြင့် ဒုတိယနေရာတွင် ရပ်တည်လျက်ရှိသည်။ 9996၊ AGI နှင့် Vera ကိန်းဂဏန်းများသည် AMD ၏ ခန့်မှန်းချက်များဖြစ်သည်။ Turin နှင့် Intel ရမှတ်များသည် ထုတ်ဝေထားသော ရလဒ်များဖြစ်သည်။ Intel နှင့် နှိုင်းယှဉ်ပါက ၎င်းသည် နှိုင်းယှဉ်နိုင်သော စာရင်းဈေးနှုန်းတွင် throughput နှစ်ဆခန့် သို့မဟုတ် တစ်ဒေါ်လာလျှင် စွမ်းဆောင်ရည် နှစ်ဆခန့် မြင့်တက်စေသည်။ core တစ်ခုလျှင် 128-core, 500W Venice configuration သည် 6980P ထက် 1.3x ရမှတ်ရရှိပြီး Arm AGI သည် 0.7x ရမှတ်ရရှိထားသည်။ အထက်ဖော်ပြပါ Vera နှိုင်းယှဉ်မှုနှင့်မတူဘဲ၊ ဤနေရာတွင် ရောင်းချသူတစ်ဦးချင်းစီ၏ ရမှတ်ကို ၎င်း၏ကိုယ်ပိုင် အကောင်းဆုံး toolchain ဖြင့် ထုတ်လုပ်ထားသည်- AMD အတွက် AOCC၊ Intel အတွက် OneAPI နှင့် Arm အတွက် GCC 13။
Cloud native နှင့် HPC
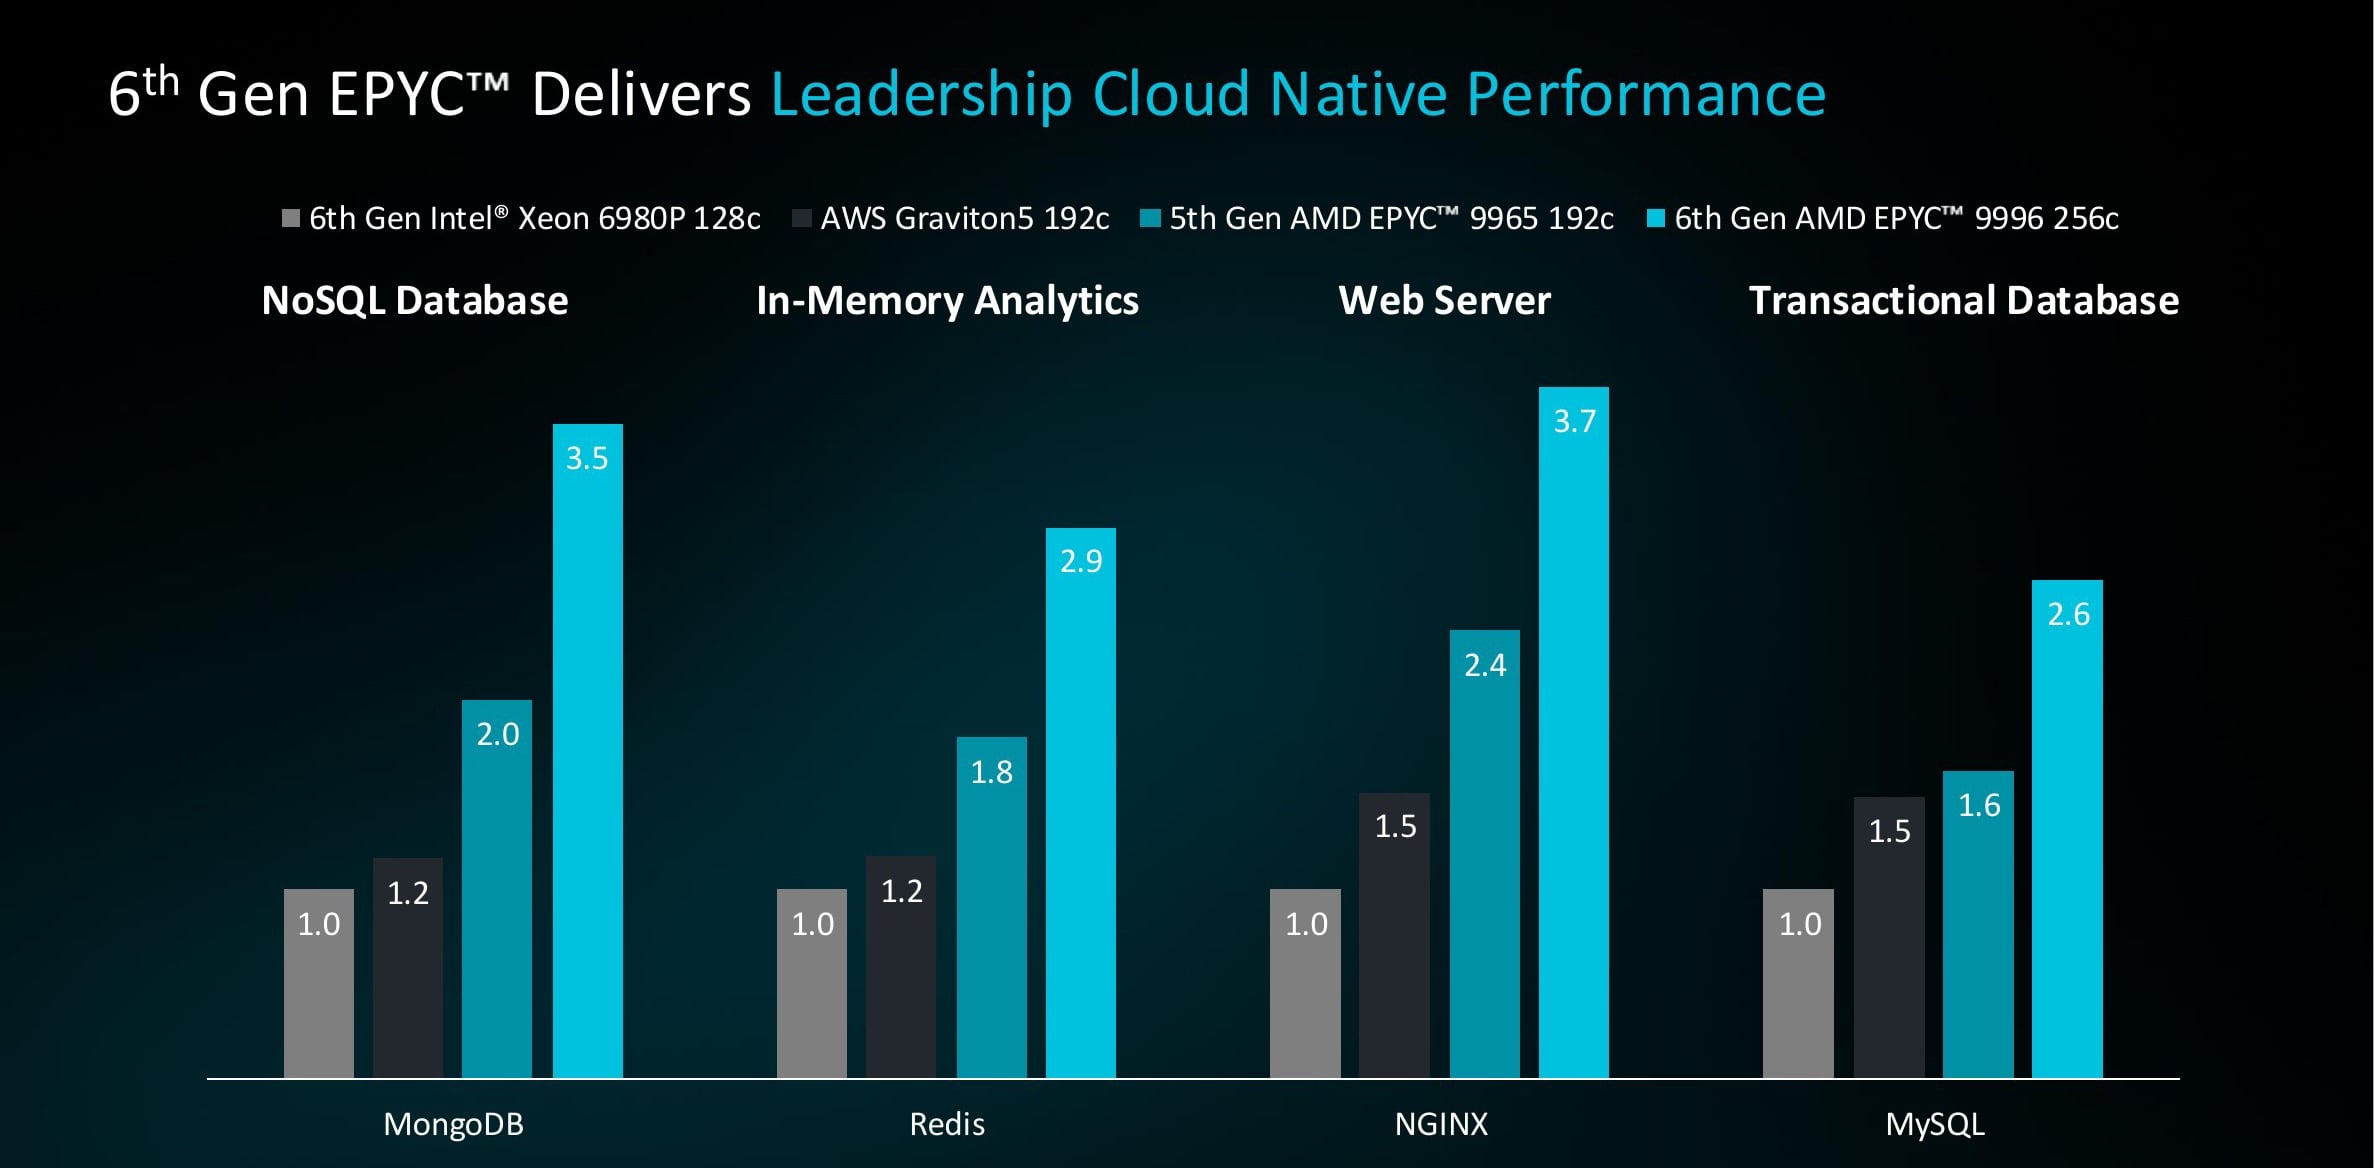
AMD သည် workload အလိုက် နှိုင်းယှဉ်မှုကိုလည်း ခွဲခြမ်းစိတ်ဖြာခဲ့ပြီး ရလဒ်တိုင်းကို Intel ၏ 6980P သို့ 1.0 တွင် index လုပ်ထားသည်။ cloud-native ဘက်တွင် 256-core Venice 9996 သည် MongoDB တွင် 3.5×၊ Redis တွင် 2.9X၊ NGINX တွင် 3.7X နှင့် MySQL တွင် 2.6X ရရှိခဲ့သည်။ Turin သည် တူညီသောစမ်းသပ်မှုများတွင် 1.6X နှင့် 2.4X အကြားတွင် ရပ်တည်ခဲ့ပြီး Graviton5 သည် 1.2X နှင့် 1.5X အကြားတွင် ရပ်တည်ခဲ့သည်။
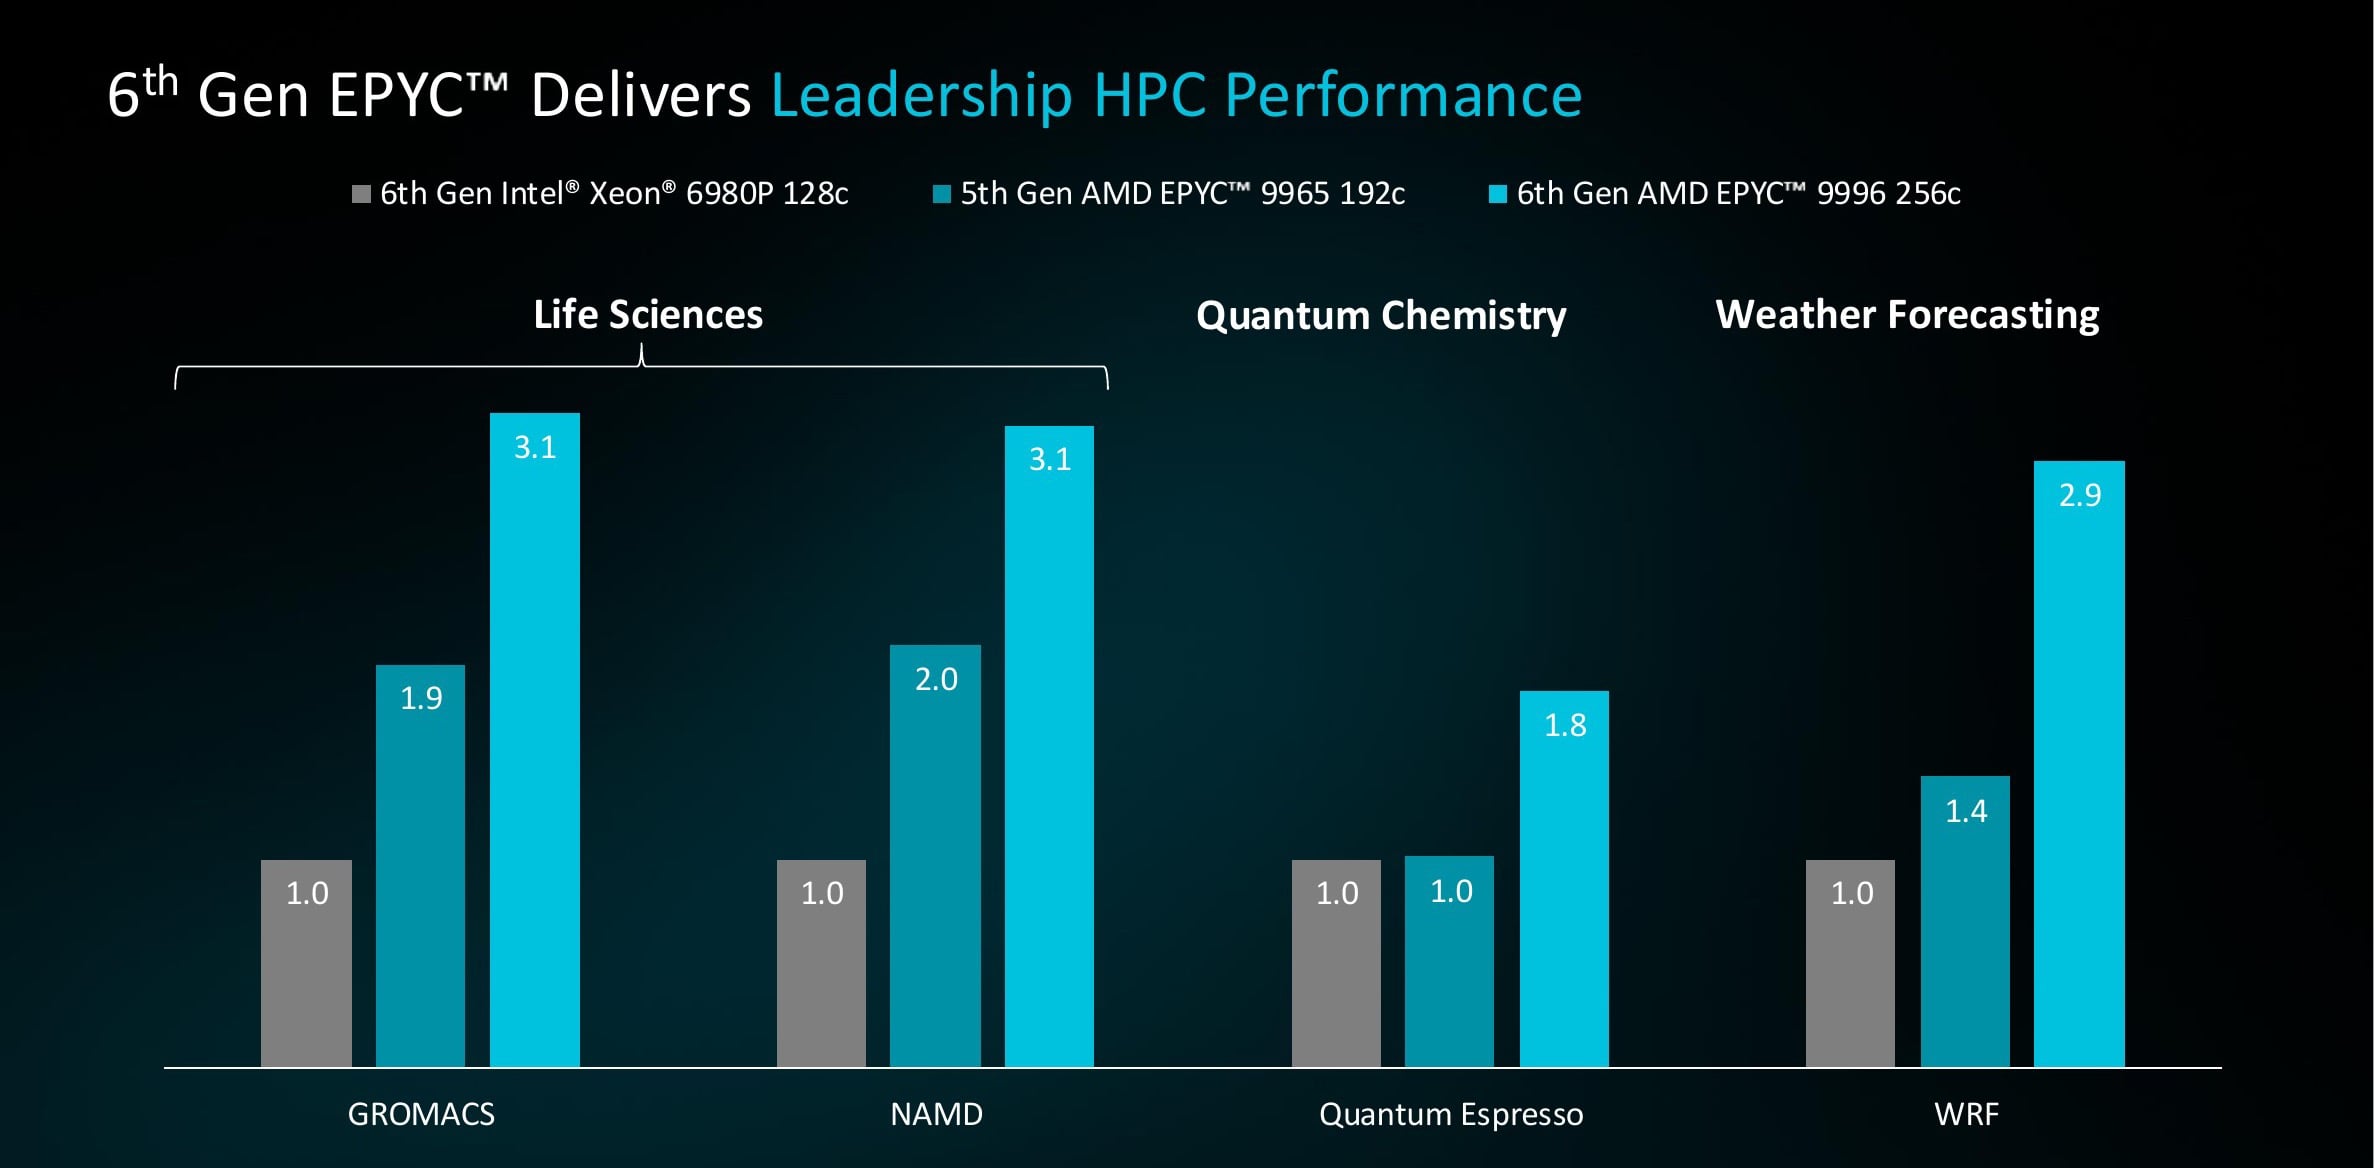
HPC မှာ Venice ဟာ GROMACS နဲ့ NAMD မှာ 3.1X၊ WRF မှာ 2.9X နဲ့ Quantum Espresso မှာ 1.8X ရရှိထားပါတယ်။ Memory configuration က ဒီကိန်းဂဏန်းတွေကို သိသိသာသာ တိုးတက်စေပါတယ်။ စံ 8,000 MT/s RDIMM တွေနဲ့ Venice ဟာ GROMACS မှာ Xeon baseline ထက် 2.81X ရရှိပါတယ်။ 12,800 MT/s MRDIMM တွေက အဲဒါကို 3.13X အထိ မြှင့်တင်ပေးပြီး အဲဒီ upgrade က WRF ကို 2.25X ကနေ 2.90X အထိ ရောက်စေပါတယ်။ AMD က သူ့ရဲ့ HPC lead ကို workload နဲ့ memory ပေါ်မူတည်ပြီး 1.8X ကနေ 3.5X အထိ ရရှိတယ်လို့ အကျဉ်းချုပ်ဖော်ပြထားပါတယ်။ Intel baseline က 8,800 MT/s MRDIMM တွေကို run ခဲ့တာကြောင့် ဒီကွာဟချက်ဟာ upgrade လုပ်ထားတဲ့ AMD memory ကို Intel configuration နှေးကွေးတာနဲ့ တွဲသုံးလို့ မရပါဘူး။
host node နှင့် 1.8× claim
ဒါက 1.8X tokens-per-second ဆိုတဲ့ ပြောဆိုချက်ဆီ ပြန်ရောက်စေပါတယ်။ ၎င်းရဲ့နောက်ကွယ်က hardware တိုးတက်မှုတွေကို စာရင်းပြုစုဖို့ လွယ်ကူပါတယ်- 5GHz host အပိုင်းမှာ အခုဆိုရင် 64 cores အစား 96 cores ပါဝင်ပြီး host memory bandwidth ဟာ 614GB/s ကနေ 1.6TB/s အထိ မြင့်တက်လာပြီး PCIe Gen 6 က CPU-to-GPU link ရဲ့ bandwidth ကို နှစ်ဆတိုးစေပါတယ်။
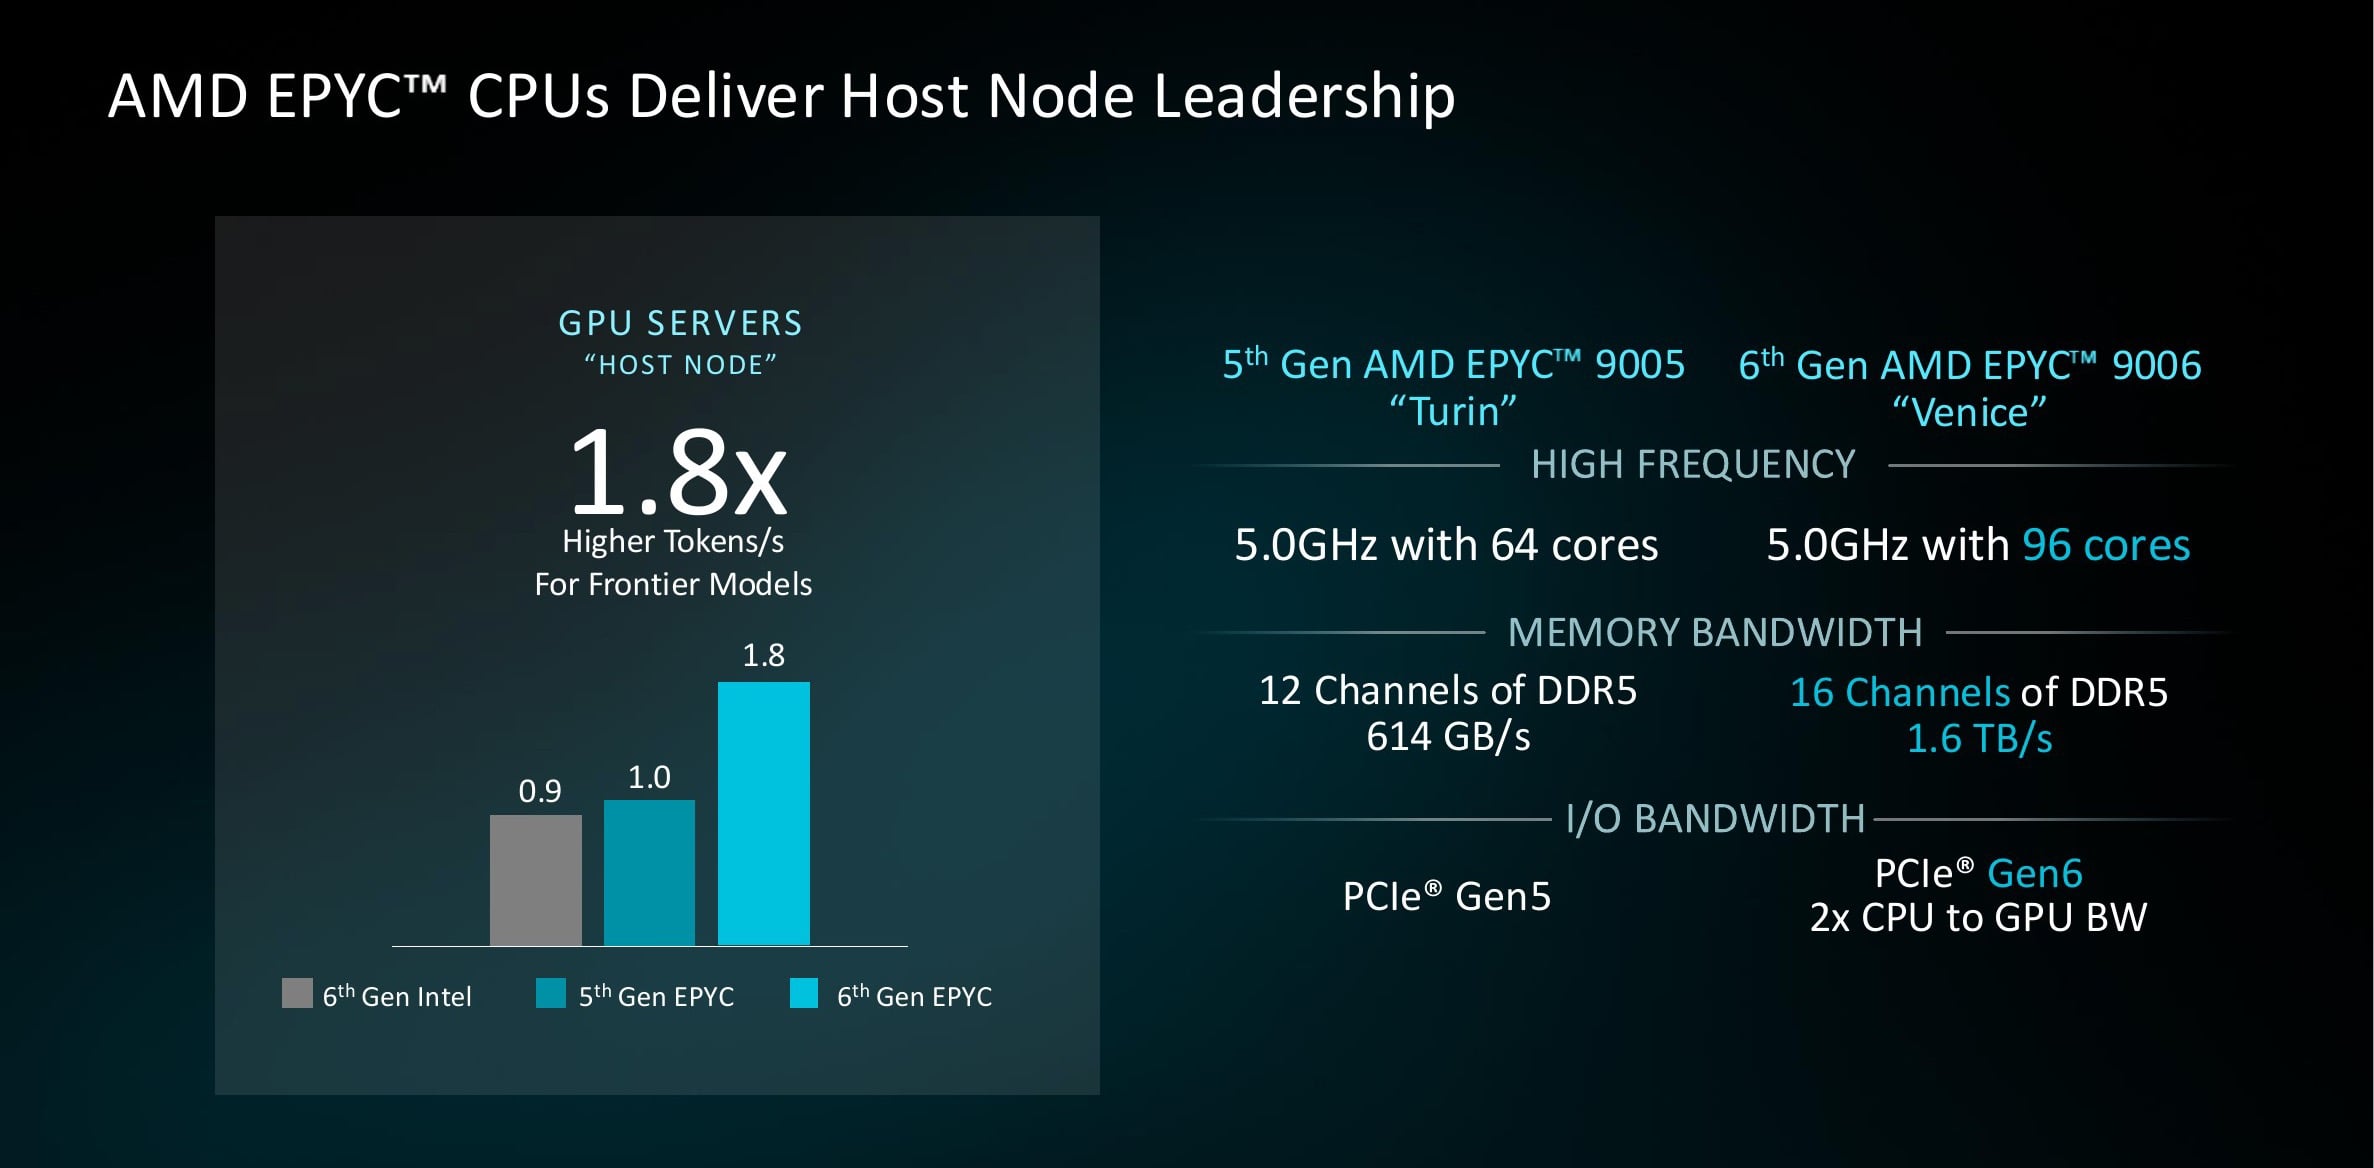
ပထမဆုံးစစ်ဆေးရမယ့်အရာက baseline ပါ။ AMD က ဒီဇယားကို Intel အစား Turin ကို index လုပ်ခဲ့ပြီး 6th Gen Xeon ကို 0.9 မှာထားခဲ့တာကြောင့် Xeon 6960P နဲ့ပြန်ယှဉ်ရင် အဲဒီအချက်က 2x နီးပါးဖြစ်နေပါတယ်။ ခန့်မှန်းထားတဲ့ gain ဟာ I/O bandwidth ကနေ အများစုနီးပါးရလာတာပါ။ AMD က CPU-offload စမ်းသပ်မှုတစ်ခုကို လုပ်ဆောင်ခဲ့ပြီး Qwen3-30B ရဲ့ BF16 weight တွေကို host memory ကနေ GPU ကို stream လုပ်ခဲ့ပြီး PCIe Gen 5 x16 receive path ဟာ theoretical ceiling ရဲ့ 89% မှ 95% မှာ run နေတာကိုတွေ့ရှိခဲ့ပြီး host DRAM read တွေကတော့ theoretical ceiling ရဲ့ 1.0% အောက်မှာပဲရှိနေခဲ့ပါတယ်။ Decode speed ကို transfer ကကန့်သတ်ထားတာကြောင့် PCIe Gen 6 နဲ့ link ကိုနှစ်ဆတိုးလိုက်ခြင်းအားဖြင့် ဒီစမ်းသပ်မှုမှာ 1.8X မှ 1.9X အထိတိုးတက်မှုကိုရရှိစေပါတယ်။ Venice ဟာ လက်ရှိမှာ accelerator တွေကို PCIe Gen 6 ပေးစွမ်းနိုင်တဲ့ တစ်ခုတည်းသော server CPU ဖြစ်တာကြောင့် အားသာချက်က အမှန်တကယ်ဖြစ်ပြီး လောလောဆယ်မှာတော့ exclusive ဖြစ်ပါတယ်။ ၎င်း၏ နယ်ပယ်မှာ ကျဉ်းမြောင်းသော်လည်း- 1.8X သည် bandwidth-bound offload pattern တစ်ခုကို ဖော်ပြထားပြီး၊ Venice host များတွင် GPU များသည် မော်ဒယ်တိုင်းကို 1.8X ပိုမြန်စွာ ဝန်ဆောင်မှုပေးသည်ဟူသော ကတိအဖြစ် မဖတ်ရှုသင့်ပါ။ ယနေ့ခေတ် hardware တင်ပို့မှုတွင် Turin host သည် Xeon 6960P ကို တူညီသော 8X B200 system ရှိ vLLM နှင့် NIM workloads များတွင် time-to-first-token တွင် geometric ပျမ်းမျှ 13% ဖြင့် ကျော်လွန်ပြီး အကောင်းဆုံးအခြေအနေတွင် 36% တိုးတက်မှုရှိခဲ့သည်။
တစ်ပွဲသိပ်သည်းမှု
နောက်ဆုံးအခိုင်အမာပြောဆိုချက်ကတော့ သိပ်သည်းဆပါ- rack တစ်ခုမှာ Venice core ၄၉,၁၅၂ ခုရှိပြီး Turin မှာ ၃၆,၈၆၄ ခုနဲ့ Vera မှာ ၂၂,၅၂၈ ခုရှိပြီး အစိတ်အပိုင်းတစ်ခုစီမှာ core တွေထက် thread နှစ်ဆပိုများပါတယ်။ deck ထဲက claim အားလုံးထဲမှာ ဒီတစ်ခုက endnote တွေကို အသုံးပြုလိုက်တာနဲ့ အများဆုံးပြောင်းလဲသွားပါတယ်။
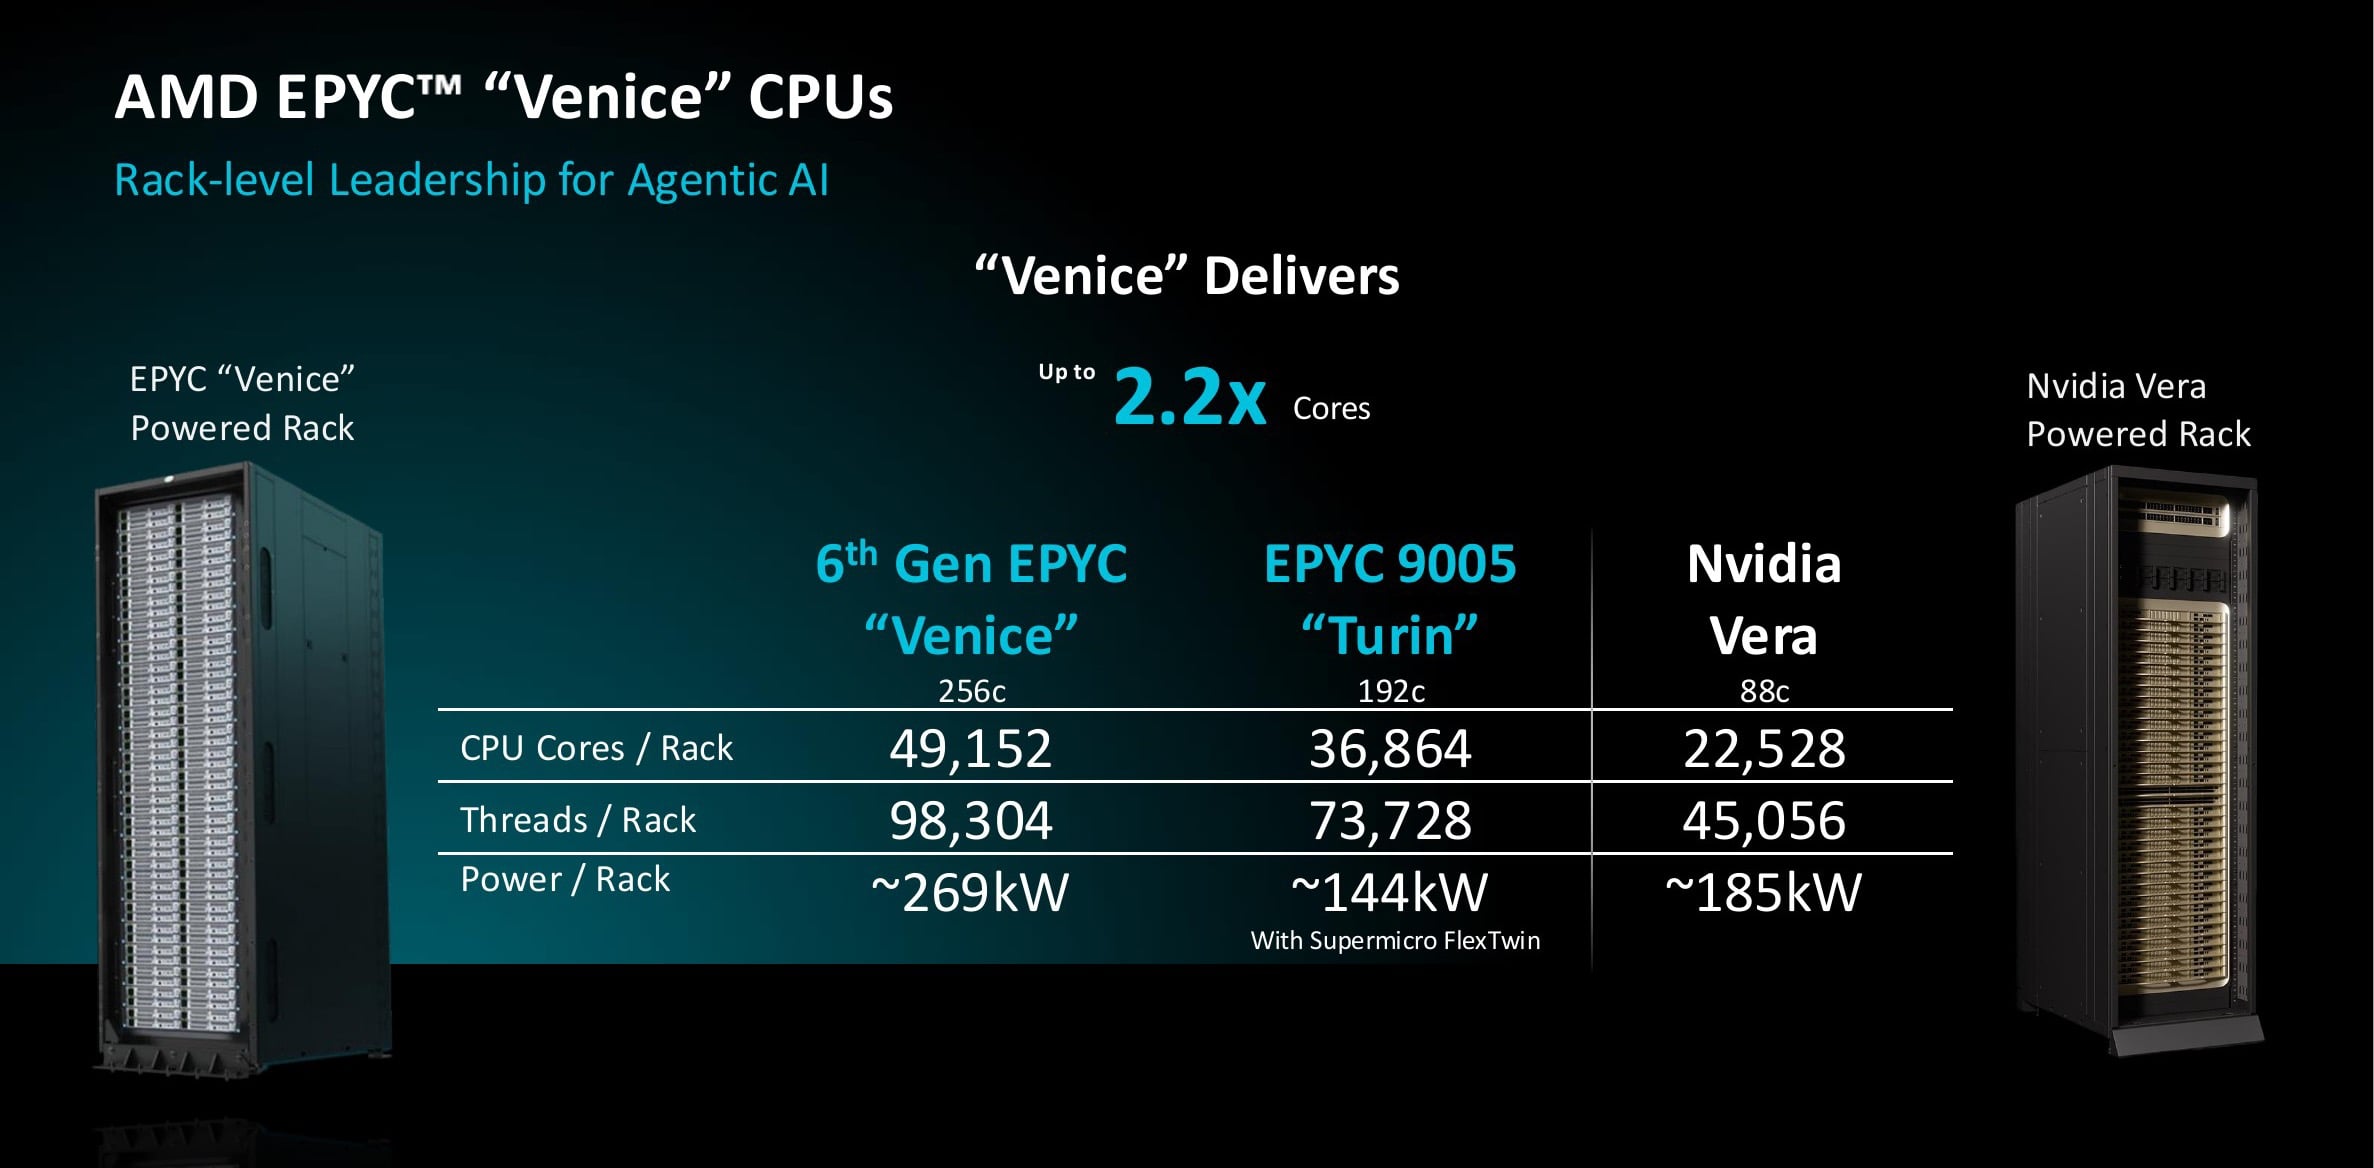
ခေါင်းစဉ်က 2.2X Vera ရဲ့ core တွေဖြစ်ပေမယ့် Venice rack က Vera ရဲ့ 185kW နဲ့ ယှဉ်ရင် 269kW ဆွဲယူနေချိန်မှာ ရောက်ရှိတာကြောင့် rack နှစ်ခုကို တူညီတဲ့ power မှာ မနှိုင်းယှဉ်ပါဘူး။ AMD ရဲ့ endnote တွေက normalized version တွေကို ထောက်ပံ့ပေးပါတယ်။ rack နှစ်ခုလုံးကို 100kW envelope မှာ တပ်ဆင်ထားတဲ့အခါ 9996 က 2.08X Vera ရဲ့ core တွေ၊ 1.86X Turin နဲ့ 1.24X Intel ရဲ့ 6980P တွေကို ပေးစွမ်းပါတယ်။ flagship အတွက် 400W EPYC 9956 ကို အစားထိုးတဲ့အခါ AMD က Vera ရဲ့ core 1.91X ဟာ power 26% လျော့နည်းတယ်လို့ ခန့်မှန်းထားပြီး rack watt တစ်ခုလျှင် 2.57X cores ရရှိပါတယ်။ ဘယ် power budget ကို ပုံသေထားလဲပေါ်မူတည်ပြီး lead က 1.9X နဲ့ 2.2X ကြားမှာ ရှိပြီး ဒီဆောင်းပါးထဲက Vera figure တိုင်းလိုပဲ NVIDIA rack ကို hardware တိုင်းတာတာထက် ထုတ်ဝေထားတဲ့ specifications တွေကနေ ပုံစံထုတ်ထားပါတယ်။ density advantage က normalization မှာ ရှင်သန်နေပါတယ်။ ၎င်းသည် 2.2X ခေါင်းစဉ်ထက် ရိုးရိုးလေး သေးငယ်သည်။
အကြီးစားအနိုင်ကျင့်သူ
တစ်ဦးချင်းပြောဆိုချက်များကို ဘေးဖယ်ထားပါ- server CPU ဈေးကွက်၏ ထိပ်တန်းအဆင့်တွင် AMD သည် လက်ရှိတွင် တိုက်ရိုက်ပြိုင်ဘက်မရှိပါ။ Intel ၏ အကောင်းဆုံးအပိုင်းမှာ Turin ထက် နောက်ကျနေပြီး AMD မျိုးဆက်က အစားထိုးနေပြီဖြစ်သည်။ Arm ပြိုင်ဘက်များသည် AMD ပြသခဲ့သော ဇယားတိုင်းတွင် Turin အောက်တွင် ရှိနေသည်။ Vera ကို မတင်ပို့ရသေးဘဲ AMD ၏ ခန့်မှန်းချက်အရ ၎င်း၏ throughput သည် တစ်နှစ်ခွဲကြာ ဈေးကွက်တွင် ရှိနေသော Turin 9965 ၏ ထက်ဝက်အောက်သာ ရှိသည်ဟု ခန့်မှန်းထားပြီး Venice သည် Turin ၏ throughput ကို နှစ်ဆခန့် ထပ်မံမြင့်တက်စေခဲ့သည်။ Mercury Research ၏ အဆိုအရ ထိုအနေအထားသည် AMD ကို server CPU ဝင်ငွေ၏ ၄၆% အထိ ရရှိစေခဲ့သည်။ ဈေးကွက်အထောက်အထားများက အလားတူပင် ညွှန်ပြနေသည်။ ထိပ်တန်း EPYC အစိတ်အပိုင်းများအတွက် ၀ယ်လိုအားသည် လက်ရှိတွင် ထောက်ပံ့မှုထက် ကျော်လွန်နေပြီး ရလဒ်အနေဖြင့် ပို့ဆောင်ချိန်များ ရှည်လျားလာခဲ့သည်။
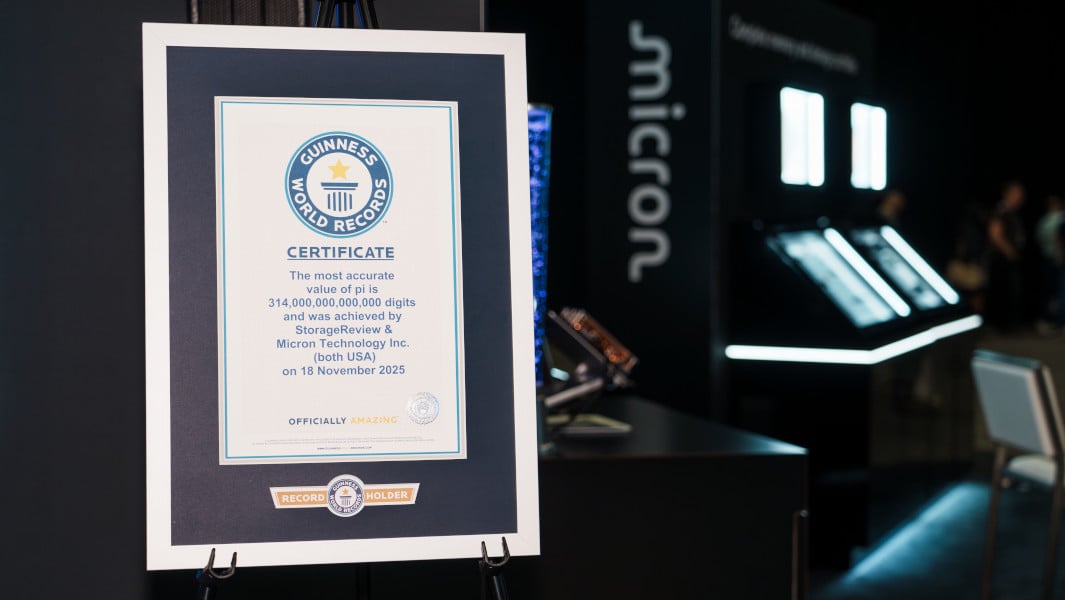
ကျွန်တော်တို့ရဲ့ကိုယ်ပိုင်ဒေတာအချက်ကို ဒီမှာထည့်နိုင်ပါတယ်။ ကျွန်တော်တို့ရဲ့ 314-trillion-digit Pi ကမ္ဘာ့စံချိန်ကို Dell PowerEdge R7725 မှာ 192-core EPYC 9965 နှစ်ခုနဲ့ 1.5TB DDR5 ပါဝင်တဲ့ 384-core 2P configuration နဲ့ run ခဲ့ပြီး AMD ရဲ့ Turin မော်ဒယ်မှာ တပ်ဆင်ထားတဲ့ 110-core 225P configuration အတိုင်း လုပ်ဆောင်ခဲ့ပါတယ်။ တွက်ချက်မှုက core တိုင်းကို ရက်ပေါင်း ၁၁၀ ကြာ load လုပ်ထားပြီး တစ်စက္ကန့်မှ downtime မရှိဘဲ ပြီးဆုံးခဲ့ပါတယ်။ memory error ဒါမှမဟုတ် crash တစ်ခုခုဖြစ်ရုံနဲ့တင် ဒီကြိုးပမ်းမှုကို ရပ်တန့်သွားနိုင်ပါတယ်။ ပျမ်းမျှပါဝါသုံးစွဲမှုက 1,600W လောက်ရှိပြီး run တစ်ခုလုံးက 4,305 kWh ဒါမှမဟုတ် ထရီလီယံဂဏန်းတစ်ခုကို 13.7 kWh သုံးစွဲခဲ့ပြီး၊ ယခင် 300-trillion-digit စံချိန်အတွက် ရက်ပေါင်း ၂၂၅ ရက်ခန့်အတွင်း ခန့်မှန်းခြေ 33,600 kWh သုံးစွဲခဲ့ပါတယ်။
ကောက်ချက်
AMD မှ ထုတ်လုပ်ခဲ့ဖူးသမျှ server CPU များတွင် Venice သည် အခိုင်မာဆုံးဖြစ်ပြီး ၎င်း၏ အဓိကအကြောင်းအရာမှာ ကျယ်ပြန့်မှုဖြစ်သည်။ Zen 6 မျိုးဆက်တစ်ခုသည် 256-core-density အပိုင်းမှ enterprise socket နှင့် 1152MB stacked-cache HPC chip မှတစ်ဆင့် LPDDR host node အထိ ကျယ်ပြန့်သောကြောင့် ဖောက်သည်တစ်ဦးသည် တူညီသော architecture နှင့် software base တွင် data center ၏ tier တိုင်းကို တည်ဆောက်နိုင်သည်။ endnote များကို ဖတ်ပြီးသည်နှင့် launch ကို ခိုင်မာစေသော ကိန်းဂဏန်းများသည် အကျုံးဝင်သည်- Intel ၏ throughput သည် စာရင်းဈေးနှုန်းနှင့် နှိုင်းယှဉ်နိုင်သော နှစ်ဆခန့်၊ ကိုက်ညီသော compiler တွင် Vera ထက် 20% per-core ဦးဆောင်မှုနှင့် NVIDIA ၏ host CPU ၏ rack density သည် power envelope ပေါ် မူတည်၍ 1.9X မှ 2.2X အကြားရှိသည်။
ဇာတ်လမ်းရဲ့ စီးပွားဖြစ်တစ်ဝက်ကို ခန့်မှန်းစရာမလိုပါဘူး။ SP7 ကို အခုထုတ်လုပ်နေပြီး မိတ်ဖက်ပလက်ဖောင်းတွေနဲ့ စတုတ္ထသုံးလပတ်မှာ ထုတ်လုပ်မှာဖြစ်ပြီး SP8 ကိုတော့ ၂၀၂၇ ခုနှစ် ပထမနှစ်ဝက်မှာ ထုတ်လုပ်မှာဖြစ်ပြီး Venice-X နဲ့ Verano တို့နောက်မှာ ရှိနေပါတယ်။ ကုမ္ပဏီက ရောင်းချတဲ့ ကုမ္ပဏီဟာ server CPU ဝင်ငွေရဲ့ ၄၆% ကို ရရှိနေပြီး လက်ရှိ အစိတ်အပိုင်းတွေအတွက် ဝယ်လိုအားက ထောက်ပံ့မှုထက် အများကြီးပိုများတာကြောင့် ဝယ်သူတွေက ချို့ယွင်းချက်အစား တန်းစီစောင့်ဆိုင်းနေရပါတယ်။ Venice ဟာ တစ်နှစ်လောက် နောက်ကျသွားနိုင်ပြီး ဒီဆောင်းပါးထဲက နှိုင်းယှဉ်ချက်တွေကို ဦးဆောင်မှုအဖြစ် ဖတ်ရှုနိုင်ဆဲပါ။ ဘာလို့လဲဆိုတော့ Turin ဟာ တင်ပို့ရောင်းချတာပဲဖြစ်ဖြစ်၊ မတင်ပို့ရောင်းချတာပဲဖြစ်ဖြစ် ဇယားပေါ်က ကျန်တာအားလုံးထက် သာလွန်နေလို့ပါ။ AMD ဟာ အရမ်းဦးဆောင်နေတာကြောင့် အနီးဆုံးပြိုင်ဘက်ကတော့ လက်ရှိမှာ သူ့ရဲ့ နောက်ဆုံးမျိုးဆက်ပါပဲ။


 အမေဇုံ