

AMD၊ Spectro Cloud နှင့် Supermicro တို့သည် AI coding workloads များအတွက် ရည်ရွယ်သည့် အတည်ပြုထားသော enterprise inference platform တစ်ခုဖြစ်သည့် AMD Instinct Coder ကို ကြေညာခဲ့သည်။ ၎င်းဖြေရှင်းချက်တွင် AMD Instinct GPU accelerators များ၊ Supermicro AI infrastructure နှင့် Spectro Cloud ၏ PaletteAI Inference Launchpad တို့ကို ပေါင်းစပ်ထားပြီး private နှင့် hybrid AI inference environments များကို ဖြန့်ကျက်ရန်အတွက် packaged option တစ်ခုကို ပေးစွမ်းသည်။
ဗိသုကာပုံစံကို ဒေသတွင်းလုပ်ဆောင်မှု၊ နယ်စပ်ပုံစံများသို့ ဝင်ရောက်ခွင့်၊ လုပ်ငန်းလည်ပတ်မှုအုပ်ချုပ်မှုနှင့် တိုကင်သုံးစွဲမှုတို့ကို ဟန်ချက်ညီအောင်လုပ်ဆောင်ရန် လိုအပ်သော လုပ်ငန်းများ၊ cloud provider များနှင့် အချုပ်အခြာအာဏာပိုင် AI အော်ပရေတာများအတွက် ဒီဇိုင်းထုတ်ထားသည်။ coding-agent တောင်းဆိုမှုအားလုံးကို ပြင်ပကြီးမားသောဘာသာစကားပုံစံများသို့ ညွှန်ကြားမည့်အစား AMD Instinct Coder သည် တောင်းဆိုမှုကို ဒေသတွင်းဖြန့်ကျက်ထားသောပုံစံမှ ဝန်ဆောင်မှုပေးသည် သို့မဟုတ် ပြင်ပနယ်စပ်ပုံစံအဆုံးမှတ်သို့ ပေးပို့သည်ဖြစ်စေ ဆုံးဖြတ်ရန် မူဝါဒအခြေပြု routing ကိုအသုံးပြုသည်။
ဤချဉ်းကပ်မှုသည် ပုံမှန်ကုဒ်ရေးခြင်း၊ ကုဒ်ထုတ်လုပ်ခြင်း၊ အကျဉ်းချုပ်ခြင်းနှင့် အလားတူအလုပ်များကို ဒေသတွင်းတွင် ကိုင်တွယ်နိုင်သည့် အလုပ်ပမာဏကို ပစ်မှတ်ထားပြီး၊ ပြင်ပမော်ဒယ်များမှတစ်ဆင့် ပိုမိုရှုပ်ထွေးသော ကျိုးကြောင်းဆင်ခြင်ခြင်း သို့မဟုတ် အထူးပြုစွမ်းရည်များ ရရှိနိုင်ပါသည်။ ဤပလက်ဖောင်းသည် သင့်လျော်သည့်နေရာတွင် ထိန်းချုပ်ထားသော အခြေခံအဆောက်အအုံအတွင်း အရေးကြီးသောကုဒ်၊ prompts များနှင့် contextual data များကို ထိန်းသိမ်းထားစဉ်တွင် မော်ဒယ်ပံ့ပိုးပေးသူတစ်ခုတည်းအပေါ် မှီခိုမှုကို လျှော့ချရန် ရည်ရွယ်ပါသည်။ မိတ်ဖက်များက ဤအစီအစဉ်သည် AI ကုဒ်ရေးခြင်းတိုကင်ကုန်ကျစရိတ်ကို ၇၀% အထိ လျှော့ချပေးနိုင်ကြောင်း ပြောဆိုကြပြီး AMD ၏ကိုယ်ပိုင်ပစ္စည်းများသည် စုစုပေါင်းပိုင်ဆိုင်မှုကုန်ကျစရိတ်နှင့် တူညီသောကိန်းဂဏန်းကို ပုံဖော်ထားပြီး ခြောက်လအတွင်း ပြန်ဆပ်ရမည်ဟု ကိုးကားဖော်ပြကြသည်။ မည်သည့်ကိန်းဂဏန်းကိုမျှ လွတ်လပ်စွာ အတည်ပြုနိုင်ခြင်း မရှိသေးပါ။
အဖွဲ့အစည်းများသည် ဖွံ့ဖြိုးတိုးတက်ရေးအဖွဲ့များနှင့် အလိုအလျောက်လုပ်ငန်းစဉ်များတွင် AI coding tools များကို တိုးချဲ့လာသည်နှင့်အမျှ ကြေငြာချက်ထွက်ပေါ်လာခြင်းဖြစ်သည်။ Gartner သည် ၂၀၂၆ ခုနှစ် ဇွန်လ ၂၄ ရက်နေ့တွင် ၎င်း၏အစီရင်ခံစာတွင် Gartner သည် Token သုံးစွဲမှုမြင့်တက်လာသောကြောင့် ၂၀၂၈ ခုနှစ်တွင် AI Coding ကုန်ကျစရိတ်များသည် ပျမ်းမျှ Developer ၏လစာထက် ကျော်လွန်သွားမည်ဟု ခန့်မှန်းထားပြီး ဖွဲ့စည်းတည်ဆောက်ထားသော operating model မပါဘဲ token ကုန်ကျစရိတ်များသည် ထုတ်လုပ်မှုတိုးတက်မှုများကို ကျော်လွန်သွားနိုင်ကြောင်း ဖော်ပြခဲ့သည်။ AMD Instinct Coder သည် model routing၊ metering၊ quotas နှင့် workload မူဝါဒများမှတစ်ဆင့် ထိုစိုးရိမ်မှုကို ဖြေရှင်းပေးသည်။
ကနဦးဖွဲ့စည်းပုံတွင် AMD Instinct MI325X GPU များကို အသုံးပြုရန် မျှော်လင့်ရသည်။ MI325X accelerator တစ်ခုစီတွင် 256GB HBM3E memory နှင့် 6TB/s အထိ အမြင့်ဆုံး memory bandwidth ပါဝင်ပြီး memory-intensive generative AI inference workloads များကို ပစ်မှတ်ထားသည်။ AMD သည် ၎င်း၏ Instinct accelerator portfolio နှင့် ROCm software ecosystem ပေါ်တွင် အခြေခံ၍ platform ကို နေရာချထားပြီး အဖွဲ့အစည်းများအနေဖြင့် hardware နှင့် software stack အပြည့်အစုံကို သီးခြားစီ စုစည်းပြီး အတည်ပြုရန် မလိုအပ်ဘဲ ဒေသတွင်းတွင် လည်ပတ်နေသော inference ကို ပံ့ပိုးရန် ရည်ရွယ်သည်။ Local inference သည် AMD Inference Microservices မှတစ်ဆင့် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသော GLM-5.2 မော်ဒယ်ကို လည်ပတ်ပြီး platform သည် Grafana နှင့် Prometheus dashboards များမှတစ်ဆင့် token quotas၊ audit trails နှင့် cost visibility တို့ကို ဖော်ထုတ်သည်။
အသေးစိတ်ဖော်ပြချက်
| specification | AMD Instinct Coder ရည်ညွှန်းဖွဲ့စည်းပုံ |
|---|---|
| hardware | |
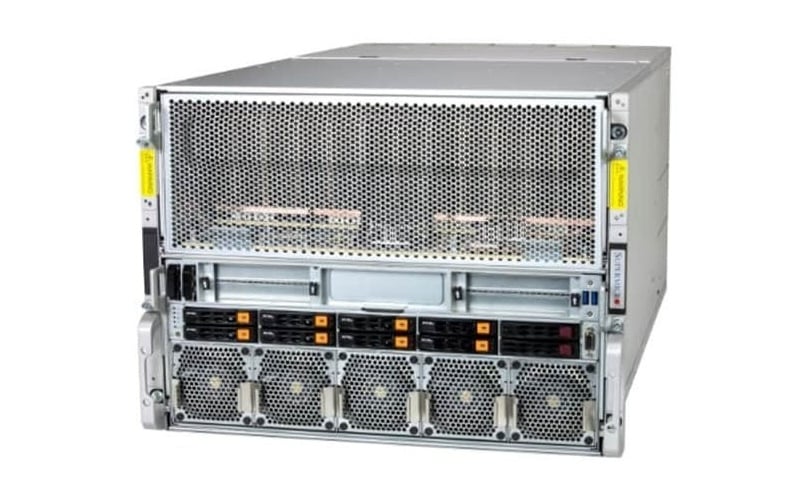
| ဆာဗာ | စူပါမိုက်ခရို AS-8126GS-TNMR |
| CPU များ | AMD EPYC 9575F ၂ ခု၊ 64 cores၊ 3.3GHz |
| အဆင့်မြင့်ထိပ်တန်း | AMD Instinct MI325X ၈ လုံး |
| မှတ်ဉာဏ် | 3TB (24 x 128GB) DDR5 RDIMM 6400 ECC |
| ဘွတ်တင်သိုလှောင်မှု | 2 x 960GB NVMe PCIe Gen4 V6 M.2 |
| ဒေတာများသိုလှောင် | 8 x 7.68TB PCIe Gen5 TLC U.2 SSD |
| Network | ၂ x AMD Pensando Pollara 400 HHHL PCIe NIC, 400GbE |
| စွမ်းအား | ၆ x 5250W အပို (၃+၃ ပုံစံ) တိုက်တေနီယမ်အဆင့် မြင့်မားသော စွမ်းဆောင်ရည်ရှိသော ပါဝါထောက်ပံ့မှုများ |
| Software များ | |
| ပလက်ဖောင်း | Spectro Cloud Palette AI Inference Launchpad |
| စွမ်းရည်များ | Full-stack AI lifecycle စီမံခန့်ခွဲမှု အတိုင်းအတာတစ်ခုအထိ စီးပွားရေးလုပ်ငန်းအုပ်ချုပ်မှု ဉာဏ်ရည်ထက်မြက်သော ဒေသတွင်း-ပထမဆုံး မော်ဒယ်လမ်းကြောင်းရှာဖွေခြင်း၊ တရားမျှတသည့်အခါ နယ်နိမိတ် AI အသုံးပြုမှုနှင့် ကုန်ကျစရိတ်ကို အပြည့်အဝ မြင်နိုင်မှုနှင့် ထိန်းချုပ်နိုင်မှု |
| AI မော်ဒယ်များ | |
| ဒေသဆိုင်ရာ | AMD Inference Microservices မော်ဒယ် GLM-5.2 |
| နယ်နိမိတ် (တရားမျှတသောအခါ) | မနုဿ လော့ဒ် OpenAI GPT Google Gemini |
| ရေးသားသူ Tools များ | |
| ပံ့ပိုးပေးထားသော IDE များ / ကိရိယာများ | Claude Code cursor Visual Studio က Code ကို |
| ထောက်ပံ့ | |
| Software များ | Spectro Cloud မှ ပြည့်စုံသော full-stack software ပံ့ပိုးမှု |
| hardware | Supermicro မှ နောက်လာမည့်လုပ်ငန်းရက်တွင် လုပ်ငန်းခွင်၌ ၃ နှစ် |
| စကေး | |
| စွမ်းဆောင်ရည်မြှင့် | node တစ်ခုလျှင် developer ၅၀ အထိ၊ တစ်ပြိုင်နက်တည်း ၃၀ အထိ |
Supermicro ၏ အခြေခံ enterprise AI အခြေခံအဆောက်အအုံကို ပံ့ပိုးပေးပါသည်။ ၎င်း၏ ပံ့ပိုးပေးထားသော စနစ်များတွင် AMD Instinct MI325X နှင့် MI350 Series accelerators များ နှင့် တွဲဖက်အသုံးပြုနိုင်သော လေနှင့် အရည်အအေးပေး ရှစ်ခုပါ GPU ပလက်ဖောင်းများ ပါဝင်သည် ။ Supermicro ၏ ပံ့ပိုးကူညီမှုတွင် pre-validation၊ rack integration နှင့် system qualification တို့ ပါဝင်ပြီး ဖြန့်ကျက်မှု ရှုပ်ထွေးမှုကို လျှော့ချရန်နှင့် ပေးပို့ထားသော အခြေခံအဆောက်အအုံမှ ထုတ်လုပ်မှုဆိုင်ရာ ကောက်ချက်သို့ အကူးအပြောင်းကို တိုတောင်းစေရန် ရည်ရွယ်ပါသည်။
Spectro Cloud PaletteAI Inference Launchpad သည် လုပ်ငန်းလည်ပတ်မှုဆော့ဖ်ဝဲအလွှာကို ပံ့ပိုးပေးသည်။ ဤပလက်ဖောင်းသည် ဒေသတွင်းနှင့် နယ်စပ်မော်ဒယ်များတစ်လျှောက် routing၊ workload-specific policy enforcement၊ token metering၊ consumption quotas နှင့် အဖွဲ့များနှင့် အသုံးပြုသူများအတွက် multi-tenant separation တို့ကို ပံ့ပိုးပေးသည်။ ဆော့ဖ်ဝဲကို ပြင်ပ hosted frontier မော်ဒယ်များသို့ fallback ချိတ်ဆက်မှုကို ထိန်းသိမ်းထားစဉ် သင့်လျော်သော workloads အတွက် local execution ကို ထိန်းသိမ်းရန် ဒီဇိုင်းထုတ်ထားသည်။
ရလဒ်အနေဖြင့် ဗိသုကာပုံစံသည် အဆင့်ဆင့် ကောက်ချက်ချခြင်းကို အသုံးပြုပြီး လိုအပ်သော စွမ်းဆောင်ရည်၊ အာရုံခံနိုင်စွမ်း၊ မော်ဒယ်စွမ်းရည်များ၊ ကုန်ကျစရိတ်ရည်မှန်းချက်များနှင့် ရရှိနိုင်သော အခြေခံအဆောက်အအုံစွမ်းရည်တို့အပေါ် အခြေခံ၍ မော်ဒယ်အဆုံးမှတ်များကို သတ်မှတ်ပေးသည်။ ပလက်ဖောင်းအဖွဲ့များအတွက်၊ ၎င်းသည် အတွင်းပိုင်းအသုံးပြုသူများနှင့် အပလီကေးရှင်းများတစ်လျှောက် AI ကုဒ်ရေးသွင်းခြင်းဝယ်လိုအားကို မည်သို့ပံ့ပိုးပေးပြီး အုပ်ချုပ်သည်ကို စံသတ်မှတ်ရန် နည်းလမ်းတစ်ခုကို ဖန်တီးပေးသည်။ AMD ၏ Compute နှင့် Enterprise AI ၏ အကြီးတန်းဒုတိယဥက္ကဋ္ဌနှင့် အထွေထွေမန်နေဂျာ Dan McNamara က AI ကုဒ်ရေးသွင်းခြင်းသည် တစ်ဦးချင်း developer tool မှ enterprise platform ဆုံးဖြတ်ချက်သို့ ရွေ့လျားခြင်းအဖြစ် ပြောင်းလဲမှုကို ပုံဖော်ခဲ့သည်။ BMC သည် အစောပိုင်းအသုံးပြုသူများထဲတွင် ပါဝင်ခဲ့ပြီး SaaS လုပ်ငန်းလည်ပတ်မှုဆိုင်ရာ ဒုတိယဥက္ကဋ္ဌ Tom Davies က AMD Instinct Coder ကို ကုမ္ပဏီ၏ Helix Agentic Engineering လုပ်ငန်းအတွက် ကုန်ကျစရိတ်သက်သာပြီး မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော ကောက်ချက်ချမှုအလွှာတစ်ခုအဖြစ် ဖော်ပြခဲ့သည်။
AMD Instinct Coder ၏ ကနဦးဖွဲ့စည်းပုံကို AMD Instinct MI325X GPU များကို အသုံးပြုသည့် Supermicro စနစ်များတွင် ပေးပို့ရန် မျှော်လင့်ရပြီး မိတ်ဖက်များသည် ယခုအပတ် လာ့စ်ဗီးဂတ်စ်ရှိ Ai4 တွင် ပလက်ဖောင်းကို သရုပ်ပြမည်ဖြစ်သည်။ နောက်ဆုံးထုတ်ကုန်ဖွဲ့စည်းပုံများ၊ ရရှိနိုင်မှု၊ ဒေသဆိုင်ရာပံ့ပိုးမှုနှင့် ဈေးနှုန်းများသည် မိတ်ဖက်အတည်ပြုချက်နှင့် ခွင့်ပြုချက်အပေါ် မူတည်နေဆဲဖြစ်သောကြောင့် အထက်ဖော်ပြပါ သတ်မှတ်ချက်များသည် ထုတ်ဝေထားသော ဈေးနှုန်းပါရှိသော ပို့ဆောင်ရေး SKU ထက် ရည်ညွှန်းတည်ဆောက်ပုံကို ဖော်ပြထားသည်။ အကဲဖြတ်ခြင်းကို စိတ်ဝင်စားသော အဖွဲ့အစည်းများသည် Spectro Cloud ကို ၎င်း၏ Get Started စာမျက်နှာ မှတစ်ဆင့် ဆက်သွယ်နိုင်ပါသည် ။


 အမေဇုံ