

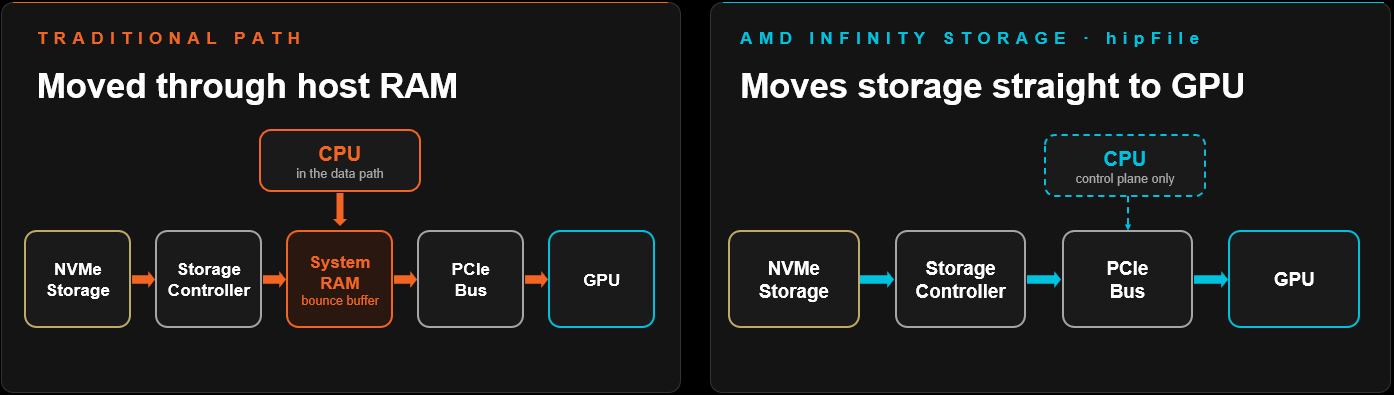
အောက်တိုဘာလ ၅ ရက်နေ့တွင် ထွက်ရှိခဲ့သော AMD ROCm 10.1 သည် storage နှင့် GPU ကြားရှိလမ်းကြောင်းပေါ်တွင် ၎င်း၏အလေးချိန်ကို ထားရှိသည်။ Checkpoint ဖိုင်များ၊ key-value cache များနှင့် model weight များသည် ယခုအခါ accelerator memory ထက် ပုံမှန်ကျော်လွန်နေပြီး ၎င်းတို့ပြုလုပ်သောအခါ data ရွှေ့ပြောင်းချိန်သည် သင်္ချာထက် iteration အချိန်ကို ပိုမိုထိန်းချုပ်လာသည်။ ဤထုတ်ဝေမှုသည် ROCm 7.14 တွင် ရောက်ရှိလာသော direct-storage stack ဖြစ်သော AMD Infinity Storage ကို storage access ကို HIP runtime ထဲသို့ ချိတ်ဆက်ခြင်းနှင့် NUMA-aware host memory ကို ထည့်သွင်းခြင်းဖြင့် တည်ဆောက်ပေးသောကြောင့် data သည် CPU memory မှတစ်ဆင့် လမ်းကြောင်းလွဲခြင်းမရှိဘဲ GPU သို့ ရောက်ရှိသည်။
တိုက်ရိုက် GPU သိုလှောင်မှုပိုက်လိုင်းများနှင့် NUMA-Aware မှတ်ဉာဏ်
AMD Infinity Storage အတွင်းရှိ hipFILE library သည် asynchronous fast-path backend ကို ရရှိသည်။ read နှင့် write request များသည် HIP stream ပေါ်တွင် တိုက်ရိုက်အလုပ်လုပ်ပြီး ရိုးရာလမ်းကြောင်းလိုအပ်သော host-memory staging အဆင့်ကို ကျော်သွားကာ ရလဒ်အနေဖြင့် checkpoint engine များနှင့် KV-cache offload အတွက် latency နည်းပါးပြီး bandwidth တည်ငြိမ်နေကြောင်း AMD က ပြောကြားခဲ့သည်။ ထုတ်ဝေမှုမှတ်စုများတွင် hipFileReadAsync() နှင့် hipFileWriteAsync() တို့သည် fast path ကို ယခု ပံ့ပိုးပေးပါသည်။
batch I/O API သည် ဖိုင်တောင်းဆိုမှုများစွာကို တစ်ပြိုင်နက်တင်သွင်းပြီး worker thread များ၏ internal pool တစ်လျှောက် ဖြန့်ဝေပေးသောကြောင့် လေ့ကျင့်ရေးအလုပ်တစ်ခုသည် dataset ကြီးတစ်ခုကို ဆွဲယူနေချိန်တွင် storage queue များကို ပြည့်နေစေပါသည်။ Telemetry သည် ၎င်းနှင့်အတူ ကြီးထွားလာသည်- hipFileGetStatsL1၊ L2 နှင့် L3 တို့သည် ပိုမိုအသေးစိတ်ကျသော I/O စာရင်းအင်းများကို ပြန်ပေးသည်၊ ထို counters များသည် ROCm profilers များကို feed လုပ်သောကြောင့် operator သည် pipeline တစ်ခုကို compute၊ memory သို့မဟုတ် data delivery ဖြင့် ကန့်သတ်ထားခြင်းရှိမရှိ ပြောပြနိုင်သည်။
socket နှစ်ခုပါ host များတွင်၊ မှားယွင်းသော socket တွင် ခွဲဝေထားသော buffer သည် transfer တိုင်းတွင် inter-socket ပြစ်ဒဏ်ကို ပေးဆောင်သည်။ ROCm 10.1 သည် HIP virtual memory management API များကို hipMemLocationTypeHostNuma နှင့် hipMemLocationTypeHostNumaCurrent တို့ဖြင့် တိုးချဲ့ထားသောကြောင့် host memory ကို create၊ reserve၊ map နှင့် teardown lifecycle တစ်ခုလုံးမှတစ်ဆင့် သတ်မှတ်ထားသော NUMA node တွင် ထားရှိနိုင်သည်။ RCCL ကဲ့သို့သော libraries များသည် NUMA-local၊ zero-copy communication buffers များကို ၎င်းအပေါ်တွင် တည်ဆောက်နိုင်ပြီး host-to-device traffic ကို socket interconnect မှ ဝေးဝေးထားနိုင်သည်။
ROCm CLI v1.0.0 နှင့် AI Agent Workflow များ
ROCm CLI သည် Linux၊ Windows နှင့် WSL2 အတွက် v1.0.0 သို့ ရောက်ရှိပြီး AMD GPU များပေါ်တွင် local AI workloads များကို install လုပ်ခြင်း၊ configure လုပ်ခြင်းနှင့် run ခြင်းတို့ကို ပြုလုပ်ပေးပါသည်။ ၎င်းသည် vLLM လိုအပ်သော flash-attn နှင့် amd-aiter wheels များကို ထောက်လှမ်းပြီး update လုပ်ထားသော ROCm 10 package layout ကို support လုပ်ကာ scripted သို့မဟုတ် CI environments များတွင် အပြည့်အဝ non-interactive install များအတွက် flag တစ်ခုထည့်သွင်းပေးပါသည်။ full-screen TUI dashboard တွင် model serving ဘေးတွင် live GPU telemetry နှင့် endpoint တစ်ခုက ဖြေကြားခြင်းရှိမရှိ စစ်ဆေးရန်အတွက် local chat window တစ်ခုကို ပြသထားသည်။
Claude Code နှင့် Codex ကဲ့သို့သော coding agent များအတွက် packaged integration များဖြစ်သည့် AMD Skills သည် နောက်ထပ်နှစ်ခုကို ရွေးချယ်ပါသည်။ quark-install သည် AMD Quark ကို ကိုက်ညီသော PyTorch build ဖြင့် setup လုပ်ပြီး၊ quark-torch-llm-ptq သည် PyTorch နှင့် Hugging Face LLM များတွင် FP8 နှင့် INT4 ကဲ့သို့သော schemes များဖြင့် post-training quantization ကို လုပ်ဆောင်သည်။
ပရိုဖိုင်နှင့် တယ်လီမက်ထရီ ခေတ်မီအောင်ပြုလုပ်ခြင်း
ROCprofiler-SDK သည် beta တွင် kernel replay ကို ထည့်သွင်းထားသည်။ GPU hardware သည် dispatch တစ်ခုလျှင် performance counter အရေအတွက် အကန့်အသတ်ဖြင့်သာ ဖော်ထုတ်ပေးသောကြောင့် counter set အပြည့်အစုံကို စုဆောင်းခြင်းသည် counter group တစ်ခုလျှင် application တစ်ခုလုံးကို တစ်ကြိမ်ပြန်လည်လည်ပတ်ခြင်းဟု ဆိုလိုသည်။ Kernel replay သည် dispatch တစ်ခုစီကို ပြန်လည်လုပ်ဆောင်ပြီး pass များကြားတွင် GPU memory ကို reset လုပ်ကာ set အပြည့်အစုံကို single run တွင် စုဆောင်းပေးသည်။ SDK သည် PyTorch Kineto နှင့် Triton Proton အတွက် run တစ်ခု၏ မည်သည့်အချိန်တွင်မဆို profiling စတင်ရပ်တန့်နိုင်စေပြီး compute stalls များကိုရှာဖွေရန် coding assistant အား rocprofv3 PC sampling မှတစ်ဆင့် လမ်းညွှန်ပေးသည့် PC sampling agent skill တစ်ခုကို ပို့ဆောင်ပေးသည်။
ROCm Compute Profiler ရဲ့ roofline report ဟာ အခုဆိုရင် interactive HTML page တစ်ခုဖြစ်လာပါပြီ။ ဒါကြောင့် engineer တစ်ယောက်ဟာ kernel တစ်ခုတည်းကို isolate လုပ်ပြီး cache level တွေကြားမှာ arithmetic-intensity axis ကို ပြောင်းပေးနိုင်ပါတယ်။ kernel တစ်ခုချင်းစီရဲ့ PC sampling report တွေက sample နဲ့ stall count တွေအထိ အသီးသီး instruction တွေမှာ ပါဝင်ပြီး profiling vLLM ကို guide အသစ်မှာ ဖော်ပြထားပါတယ်။ ROCm Systems Profiler က Gorgon Point 1, 2, and 3 APUs (gfx1150, gfx1152, and gfx1153) အတွက် Linux tracing ကို ထည့်သွင်းပေးထားပြီး ROCm Optiq က Systems Profiler traces နဲ့ Compute Profiler analysis တွေနဲ့အတူ rocprofv3 profile တွေကို visualize လုပ်ပါတယ်။
AMD SMI (amd-smi) သည် ROCm SMI မှ လွှဲပြောင်းယူထားပြီး ယခုထုတ်ဝေမှုတွင် standard build မှ ဖယ်ရှားထားသည်။ ၎င်းတွင် CLI၊ C library (amd_smi_lib) နှင့် Python၊ Go နှင့် Rust bindings များပါဝင်သည့် Linux နှင့် Windows ရှိ AMD GPU များ၊ CPU များနှင့် APU များကို လွှမ်းခြုံထားသည်။ Container awareness သည် Kubernetes pods များအပါအဝင် containerd၊ CRI-O၊ Podman၊ LXC နှင့် LXD အထိ ကျယ်ပြန့်သောကြောင့် cluster administrator သည် GPU လုပ်ငန်းစဉ်များနှင့် ၎င်းတို့ကို လည်ပတ်နေသော container နှင့် အသုံးချမှုကို ကိုက်ညီစေနိုင်သည်။
Core Compiler အပ်ဒိတ်များ၊ Libraries များနှင့် Runtime ပံ့ပိုးမှု
toolchain သည် LLVM 23 မှ LLVM 24 သို့ ရွေ့လျားပြီး clang_major macro သည် ယခုအခါ 24 ကို report လုပ်သောကြောင့် compiler version များကို pin လုပ်သူများ သို့မဟုတ် libLLVM နှင့် link လုပ်သူများသည် upgrade မလုပ်မီ စစ်ဆေးသင့်ပါသည်။ Incremental build များသည် device-code link-time optimization မှ ဖန်တီးသော partition များ၏ caching မှတစ်ဆင့် ပိုမိုမြန်ဆန်လာသောကြောင့် မပြောင်းလဲသော partition များကို နောက် build တွင် ပြန်လည်အသုံးပြုပါသည်။
Composable Kernel သည် Radeon GPU များအပေါ် အာရုံစိုက်မှုကို အရှိန်မြှင့်ပေးပြီး ၎င်း၏ dispatcher တွင် quantized matrix-multiply အမျိုးအစားများကို ပိုမိုထည့်သွင်းပေးသည်။ MIGraphX သည် ၎င်း၏ backend compiler ကို rocMLIR မှ rocMLIRTriton သို့ လဲလှယ်ပေးပြီး AMD က inference စွမ်းဆောင်ရည်ကို တိုးတက်စေပြီး compiler ကို upstream Triton နှင့် တစ်ပြေးညီဖြစ်စေသည်ဟု ဆိုကာ model compile အချိန်များကို မကြာခဏ တိုတောင်းစေပါသည်။ rocSPARSE သည် ELLPACK (ELL) format တွင်သိမ်းဆည်းထားသော matrices များပေါ်တွင် conversion step ဦးစွာမပါဘဲ triangular solves များကို တိုက်ရိုက်လုပ်ဆောင်သည်။
ROCm Core SDK threading libraries များအောက်ရှိ အသစ်ထွက်ရှိလာသော hipThreads သည် Linux နှင့် Windows ရှိ AMD GPU များသို့ စံ C++ threading သဘောတရားများကို ယူဆောင်လာပါသည်။ အဓိကအချက်မှာ HIP kernel များနှင့် synchronization primitives များထဲသို့ အပြည့်အဝပြန်လည်ရေးသားခြင်းမရှိဘဲ GPU ပေါ်ရှိ CPU-threaded code ကို အရှိန်မြှင့်တင်ရန်ဖြစ်သည်။
Windows Subsystem for Linux 2 သည် tech preview သို့ ဝင်ရောက်လာပြီဖြစ်ပြီး၊ standard Linux package များကို guest တွင် ထည့်သွင်းပြီး GPU paravirtualization သည် Windows host driver သို့ အလုပ်လွှဲပြောင်းပေးပါသည်။ preview တွင် .deb package များနှင့် Python wheel များကို ဖော်ပြထားသော်လည်း RPM များကိုမူ မဖော်ပြထားပါ။ ထို့အပြင် profiling၊ debugging နှင့် KFD-dependent tooling များသည် WSL2 တွင် အလုပ်မလုပ်သေးပါ။ virtualization ဘက်တွင်၊ KVM SR-IOV ကို Ubuntu 26.04 LTS တွင် host နှင့် guest နှစ်မျိုးလုံးအဖြစ် ပံ့ပိုးပေးထားပြီး AMD ၏ GIM virtualization driver ၏ version 9.3.0.K နှင့် တွဲဖက်အသုံးပြုထားပါသည်။
ထောက်ပံ့ပေးထားသော ဟာ့ဒ်ဝဲစာရင်းတွင် Radeon AI PRO R9600 ကို Instinct MI355X၊ MI350X နှင့် MI350P၊ MI300 နှင့် MI200 စီးရီးများ၊ Radeon AI PRO R9700 မိသားစု၏ ကျန်အစိတ်အပိုင်းများနှင့် Ryzen AI ပရိုဆက်ဆာများနှင့်အတူ ထည့်သွင်းထားသည်။


 အမေဇုံ