

Broadcom သည် မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော computing (HPC) နှင့် artificial intelligence (AI) networking ကို ပြန်လည်သတ်မှတ်ရန် သတ်မှတ်ထားသော ထုတ်ကုန်တစ်ခုဖြစ်သည့် Tomahawk Ultra Ethernet Switch ကို တင်ပို့ရောင်းချကြောင်း တရားဝင်ကြေငြာခဲ့သည် ။ အလွန်နိမ့်သော latency၊ မြင့်မားသော throughput နှင့် lossless operation အတွက် ဒီဇိုင်းထုတ်ထားသော Tomahawk Ultra သည် တောင်းဆိုမှုများသော နည်းပညာပတ်ဝန်းကျင်များတွင် Ethernet switching အတွက် စံနှုန်းအသစ်တစ်ခုကို ချမှတ်ပေးပါသည်။
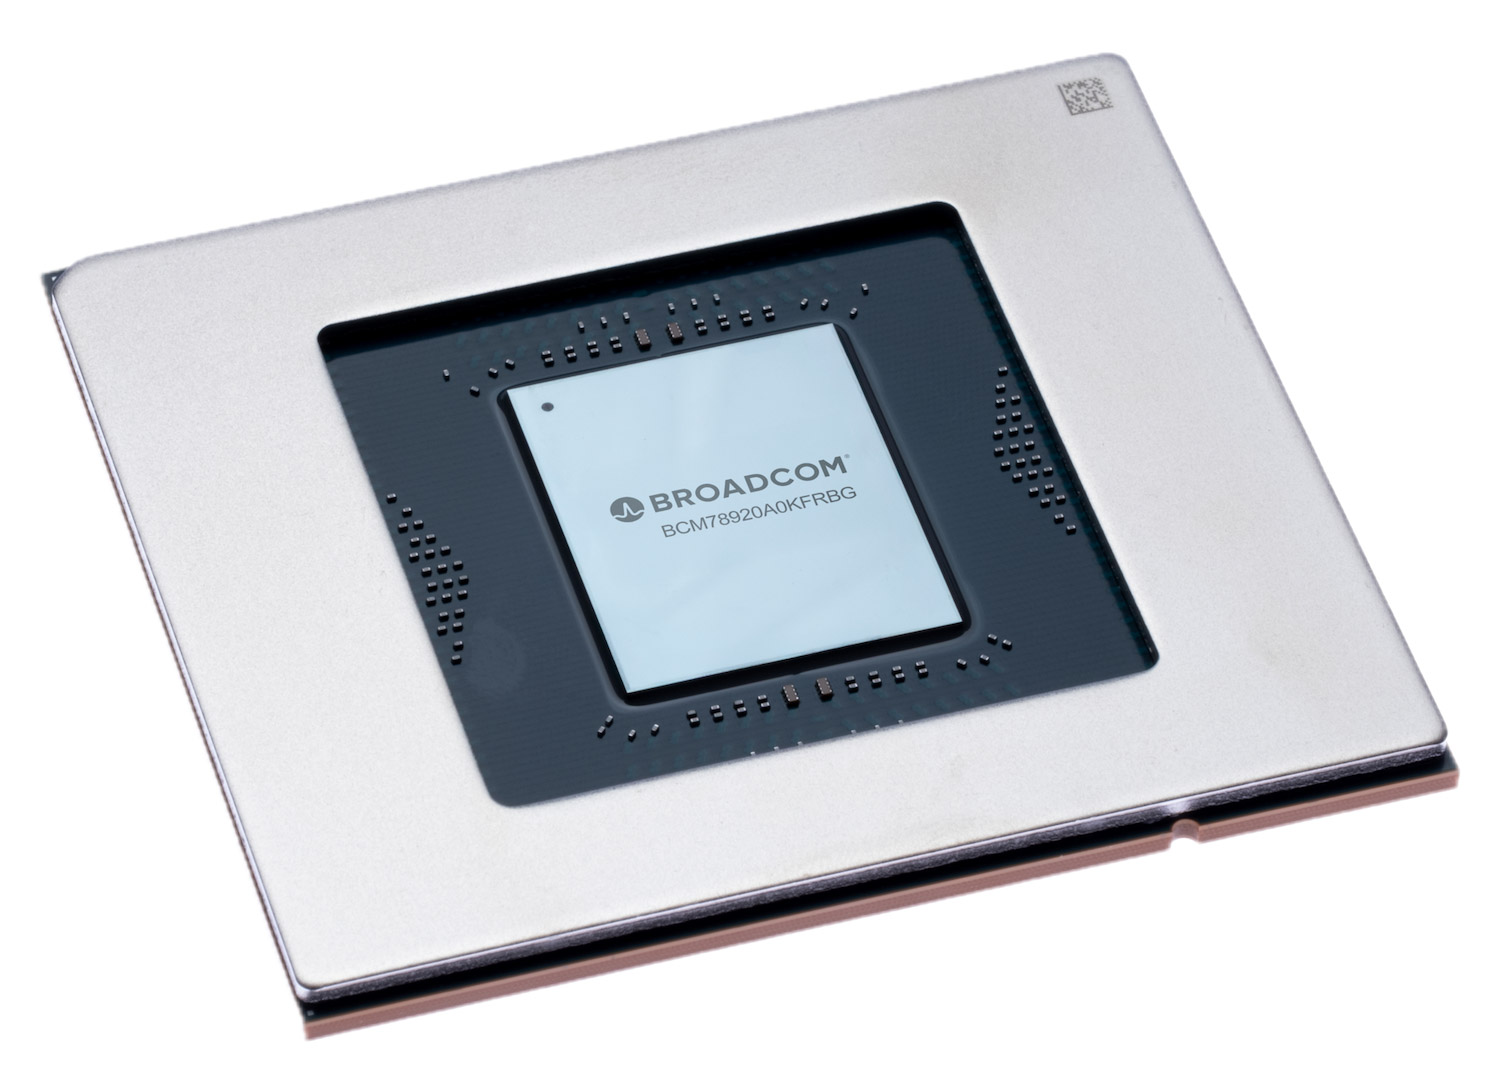
Broadcom ၏ Core Switching Group ၏ အကြီးတန်းဒုတိယဥက္ကဋ္ဌနှင့် အထွေထွေမန်နေဂျာ Ram Velaga က Tomahawk Ultra သည် ကျွမ်းကျင်သူရာပေါင်းများစွာပါဝင်သည့် နှစ်ပေါင်းများစွာ အင်ဂျင်နီယာကြိုးပမ်းမှု၏ရလဒ်ဖြစ်ကြောင်း အလေးပေးပြောကြားခဲ့သည်။ ယခုမိတ်ဆက်မှုသည် မြင့်မားသောစွမ်းဆောင်ရည်နှင့် AI-driven workloads များ၏ နောက်မျိုးဆက်အတွက် Ethernet နည်းပညာကို မြှင့်တင်ရန် Broadcom ၏ စဉ်ဆက်မပြတ်ကတိကဝတ်ကို ပေါ်လွင်စေသည်။
ဖျက်ဆီးပစ်သော ဒဏ္ဍာရီများ၊ Ethernet ကို ပြန်လည်အဓိပ္ပာယ်ဖွင့်ဆိုခြင်း
သမိုင်းကြောင်းအရ Ethernet ကို latency မြင့်မားပြီး lossy နည်းပညာတစ်ခုအဖြစ် ရှုမြင်ခဲ့ကြပြီး အလိုအပ်ဆုံး compute cluster များအတွက် မသင့်တော်ပါ။ Tomahawk Ultra သည် ဤအမြင်ကို အောက်ပါအတိုင်း ပေးအပ်ခြင်းဖြင့် စိန်ခေါ်သည်-
- အလွန်နိမ့်သော latency: 51.2 Tbps throughput အပြည့်ဖြင့် 250ns switch latency ကို ရရှိပြီး တင်းကျပ်စွာ ချိတ်ဆက်ထားသော compute environment များအတွက် အချိန်နှင့်တပြေးညီ data movement ကို ပြုလုပ်နိုင်စေပါသည်။
- မြင့်မားသောစွမ်းဆောင်ရည်- အသေးဆုံး 64-byte packets များအတွက်ပင် line-rate switching ကို ပံ့ပိုးပေးပြီး တစ်စက္ကန့်လျှင် packets ၇၇ ဘီလီယံအထိ ကိုင်တွယ်နိုင်သည်။
- အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ထားသော Ethernet headers များ- Ethernet လိုက်နာမှုအပြည့်အဝကို ထိန်းသိမ်းထားပြီး၊ ကွန်ရက်စွမ်းဆောင်ရည်ကို မြှင့်တင်ပေးကာ application-specific မြှင့်တင်မှုများကို ခွင့်ပြုပေးနေစဉ်တွင် header အရွယ်အစားကို 46 bytes မှ 10 bytes အထိ လျှော့ချပေးပါသည်။
- Lossless fabric: packet ဆုံးရှုံးမှုကို ဖယ်ရှားပြီး ယုံကြည်စိတ်ချရသော data ပေးပို့မှုကို သေချာစေရန် Link Layer Retry (LLR) နှင့် Credit-Based Flow Control (CBFC) ကို အကောင်အထည်ဖော်သည်။
HPC နှင့် AI Scale-Up အတွက် ရည်ရွယ်ချက်ရှိရှိ တည်ဆောက်ထားသည်
Tomahawk Ultra ကို HPC စနစ်များနှင့် AI cluster များတွင်တွေ့ရှိရသော latency နည်းပါးပြီး bandwidth မြင့်မားသော ဆက်သွယ်ရေးပုံစံများအတွက် အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ထားသည်။ ၎င်း၏ဗိသုကာလက်ရာကို ကြီးမားသော simulation များ၊ သိပ္ပံနည်းကျကွန်ပျူတာနှင့် တစ်ပြိုင်တည်းလုပ်ဆောင်နိုင်သော AI မော်ဒယ်လေ့ကျင့်မှုနှင့် ကောက်ချက်ချမှုများအတွက် ခန့်မှန်းနိုင်သော၊ မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ရန် ဒီဇိုင်းထုတ်ထားသည်။
Scale-Up Ethernet (SUE) ဖြင့် ဖြန့်ကျက်လိုက်သောအခါ Tomahawk Ultra သည် switch transit time အပါအဝင် sub-400ns XPU-to-XPU ဆက်သွယ်ရေး latency ကို ရရှိပြီး စကေးအလိုက် တင်းကျပ်စွာ ထပ်တူပြုထားသော AI compute အတွက် စံနှုန်းသစ်တစ်ခုကို သတ်မှတ်ပေးပါသည်။
Ethernet header overhead ကို 46 bytes မှ 10 bytes အထိ လျှော့ချခြင်းဖြင့် လိုက်နာမှုကို ထိန်းသိမ်းထားခြင်းဖြင့် ကွန်ရက်စွမ်းဆောင်ရည်ကို သိသိသာသာ မြှင့်တင်ပေးပါသည်။ ဤချောမွေ့ပြီး လိုက်လျောညီထွေဖြစ်အောင် ပြုလုပ်နိုင်သော header သည် HPC နှင့် AI workloads အမျိုးမျိုးတွင် ပြောင်းလွယ်ပြင်လွယ်ရှိမှုနှင့် စွမ်းဆောင်ရည်တိုးတက်မှု နှစ်မျိုးလုံးကို ပေးစွမ်းသည်။
ဒေတာများစွာအသုံးပြုသော အလုပ်ဝန်များအတွက် Lossless Fabric
Tomahawk Ultra ရဲ့ lossless fabric နည်းပညာကို မြင့်မားတဲ့ data transfer တွေအတွင်း packet drop တွေကို ကာကွယ်ဖို့ ဒီဇိုင်းထုတ်ထားပါတယ်။ LLR ကို အသုံးပြုခြင်းအားဖြင့် switch ဟာ Forward Error Correction (FEC) နဲ့ link error တွေကို ထောက်လှမ်းပြီး physical-level drop တွေကို ရှောင်ရှားကာ packet တွေကို အလိုအလျောက် ပြန်လည်ပေးပို့ပါတယ်။ CBFC ဟာ packet loss ရဲ့ အဖြစ်များတဲ့ အကြောင်းရင်းတစ်ခုဖြစ်တဲ့ buffer overflow တွေကို ထပ်မံကာကွယ်ပေးပါတယ်။ ဒီ mechanism တွေ ပေါင်းစပ်လိုက်တဲ့အခါ အမှန်တကယ် lossless Ethernet fabric တစ်ခုကို ဖန်တီးပေးပြီး ဒီနေ့ခေတ် data-intensive application တွေအတွက် လိုအပ်တဲ့ reliability ကို ပေးစွမ်းနိုင်ပါတယ်။
AI နှင့် machine learning workloads များတွင် သိသာထင်ရှားသော အတားအဆီးတစ်ခုမှာ AllReduce၊ Broadcast နှင့် AllGather ကဲ့သို့သော collective operations များနှင့် ဆက်စပ်နေသော overhead ဖြစ်သည်။ Tomahawk Ultra သည် ဤလုပ်ဆောင်ချက်များကို switch chip အတွင်း တိုက်ရိုက်လုပ်ဆောင်ခြင်းဖြင့် ဤပြဿနာကို ဖြေရှင်းပေးပြီး အလုပ်ပြီးမြောက်ချိန်များကို လျှော့ချပေးပြီး စျေးကြီးသော compute resources များကို အများဆုံးအသုံးချနိုင်စေပါသည်။ မှတ်သားစရာကောင်းသည်မှာ ဤ feature သည် endpoints များနှင့် သီးခြားစီလည်ပတ်ပြီး မတူညီသော system architectures များနှင့် vendor ecosystems များတွင် လျင်မြန်စွာပေါင်းစပ်နိုင်စေပါသည်။
Topology-Aware Routing နှင့် Ecosystem Openness
Tomahawk Ultra ကို Dragonfly၊ Mesh နှင့် Torus ကဲ့သို့သော HPC topology များကို ပံ့ပိုးပေးရန်အတွက် အဆင့်မြင့် topology-aware routing ဖြင့် ဒီဇိုင်းထုတ်ထားသည်။ ဤ switch သည် UEC စံနှုန်းနှင့် ကိုက်ညီပြီး Ethernet ကွန်ရက်၏ ပွင့်လင်းမှုနှင့် ကြွယ်ဝသော ဂေဟစနစ်ကို အသုံးချကာ ပြောင်းလဲနေသော data center ဗိသုကာပုံစံများအတွက် ကျယ်ပြန့်သော တွဲဖက်အသုံးပြုနိုင်မှုနှင့် အနာဂတ်အတွက် အာမခံချက်ရှိကြောင်း သေချာစေသည်။
Broadcom ရဲ့ AI scaling အတွက် Ethernet-forward ဗျူဟာရဲ့ တစ်စိတ်တစ်ပိုင်းအနေနဲ့ ကုမ္ပဏီဟာ SUE သတ်မှတ်ချက်ရဲ့ အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားတဲ့ ဗားရှင်းဖြစ်တဲ့ SUE-Lite ကို မိတ်ဆက်ခဲ့ပါတယ်။ SUE-Lite ကို ပါဝါနဲ့ ဧရိယာအလိုက် အာရုံခံနိုင်တဲ့ accelerator application တွေအတွက် ဖန်တီးထားပြီး full SUE ရဲ့ core low-latency နဲ့ lossless feature တွေကို ထိန်းသိမ်းထားစဉ်မှာပဲ AI XPU တွေနဲ့ CPU တွေပေါ်က Ethernet interface တွေရဲ့ silicon footprint နဲ့ ပါဝါသုံးစွဲမှုကို ပိုမိုလျှော့ချပေးပါတယ်။ ဒီပေါ့ပါးတဲ့ ချဉ်းကပ်မှုက စံနှုန်းနဲ့ ကိုက်ညီတဲ့ Ethernet fabric တွေကို AI platform တွေထဲ ပေါင်းစပ်မှုကို ရိုးရှင်းစေပြီး scale-up architectures တွေအတွက် ဦးစားပေး interconnect အဖြစ် Ethernet ကို ပိုမိုကျယ်ပြန့်စွာ အသုံးပြုမှုကို မြှင့်တင်ပေးပါတယ်။
102.4 Tb/s Tomahawk 6 နှင့်အတူ Tomahawk Ultra သည် ပေါင်းစည်းထားသော Ethernet ဗိသုကာ၏ အဓိကကျောရိုးဖြစ်ပြီး တိုးချဲ့နိုင်သော AI လေ့ကျင့်ရေး clusters များနှင့် ကျယ်ပြန့်သော HPC နှင့် ဖြန့်ဝေထားသော workloads နှစ်မျိုးလုံးကို လုပ်ဆောင်နိုင်စေပါသည်။
အသုံးပြုနိုင်မှု
လက်ရှိတွင် switch ကို rack-scale AI training clusters များနှင့် supercomputing environments များတွင်အသုံးပြုရန် တင်ပို့နေပါသည်။


 အမေဇုံ