

ပါရီတွင်ကျင်းပသော RAISE ထိပ်သီးအစည်းအဝေးတွင် DDN သည် ဥရောပအချုပ်အခြာအာဏာပိုင်-hybrid cloud ပံ့ပိုးပေးသူ Nebul နှင့် ၎င်း၏ လက်ရှိပူးပေါင်းဆောင်ရွက်မှုကို မီးမောင်းထိုးပြခဲ့ပြီး၊ ကြီးမားသော AI inference ဖြန့်ကျက်မှုများ၏ ထိရောက်မှုကို မြှင့်တင်ရန် အာရုံစိုက်ခဲ့သည်။ ပြီးခဲ့သည့်အပတ်က ကြေညာခဲ့သော ဤကြိုးပမ်းအားထုတ်မှုသည် Nebul ၏ inference platform၊ DDN ၏ Infinia data intelligence architecture နှင့် NVIDIA accelerated computing တို့ကို ပေါင်းစပ်ထားပြီး ကြီးထွားလာနေသော ထုတ်လုပ်မှု AI ကန့်သတ်ချက်ဖြစ်သည့် inference အတွင်း data ရွှေ့ပြောင်းခြင်း၏ ကုန်ကျစရိတ်နှင့် စွမ်းဆောင်ရည်ဆိုင်ရာ သက်ရောက်မှုများကို ဖြေရှင်းရန်ဖြစ်သည်။
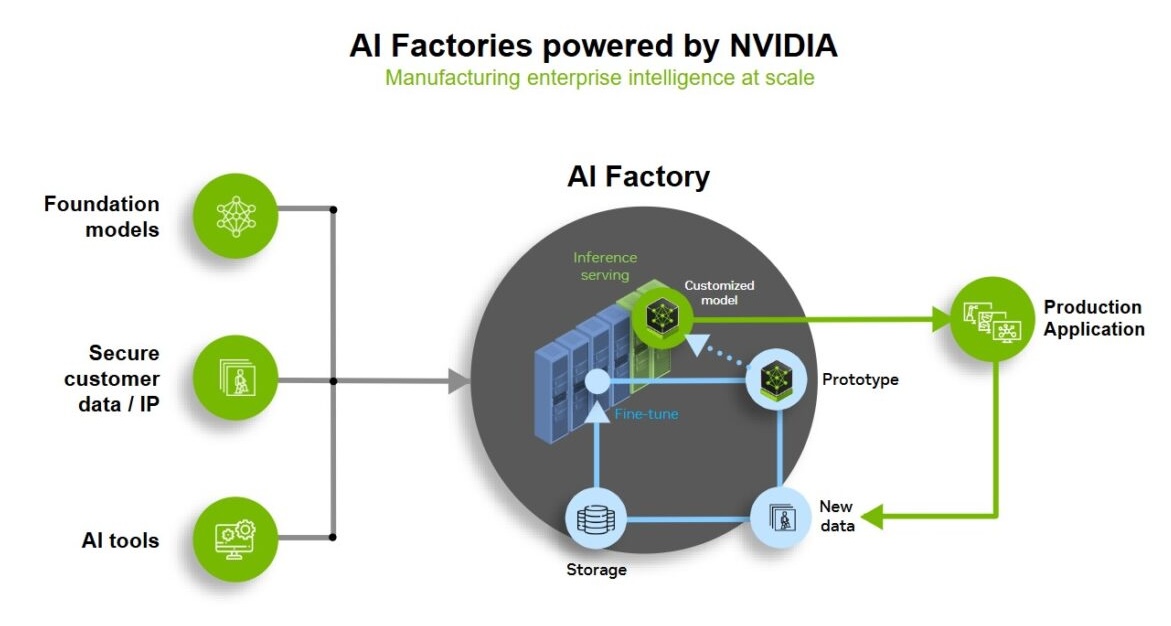
DDN သည် GPU အသုံးပြုမှု၊ token throughput၊ token တစ်ခုလျှင် ကုန်ကျစရိတ်နှင့် latency အပါအဝင် အဓိကထုတ်လုပ်မှုမက်ထရစ်များကို အခြေခံ၍ အလုပ်ကို နေရာချထားပေးသည်။ မော်ဒယ်လေ့ကျင့်မှုသည် AI ပိုင်ဆိုင်မှု၏တန်ဖိုးကို သတ်မှတ်ပေးပြီး inference သည် ၎င်း၏လည်ပတ်မှုနှင့် စီးပွားဖြစ်ပြန်ရမှုကို ဆုံးဖြတ်ပေးသည်ဟူသော အခြေခံအယူအဆဖြစ်သည်။ agentic AI၊ retrieval-augmented generation နှင့် high-concurrency inference တို့သည် ပိုမိုအသုံးများလာသည်နှင့်အမျှ သိုလှောင်မှုနှင့် အချက်အလက်အခြေခံအဆောက်အအုံသည် accelerator အသုံးပြုမှုနှင့် တုံ့ပြန်မှုအချိန်ကို တိုက်ရိုက်အကျိုးသက်ရောက်နိုင်သည်။
ဒီလုပ်ငန်းဟာ ဆက်လက်လုပ်ဆောင်နေတဲ့ proof-of-concept ထိတွေ့ဆက်ဆံမှုတစ်ခုဖြစ်ပြီး DDN က ရလဒ်တွေကို အလားအလာကောင်းတဲ့ အစောပိုင်းဒေတာတွေအဖြစ် ဖော်ပြပါတယ်။ ကုမ္ပဏီတွေဟာ KV cache ကိုဖွင့်ထားတဲ့ ပထမဆုံးတိုကင်အတွက် အချိန်မီ တိုင်းတာနိုင်တဲ့ တိုးတက်မှုတွေကို အစီရင်ခံပြီး RoCE-based infrastructure validation ကို ပြီးမြောက်အောင် လုပ်ဆောင်ခဲ့ပြီး Infinia platform အတွင်း နောက်ထပ် optimization အခွင့်အလမ်းတွေကို ဖော်ထုတ်လာတာနဲ့အမျှ inference sequence length ပိုများတဲ့ benchmarking ကို ဆက်လက်လုပ်ဆောင်နေပါတယ်။ ဒီစီမံကိန်းဟာ NVIDIA နဲ့ benchmarking နည်းလမ်းတွေ၊ scalability validation နဲ့ အနာဂတ်နည်းပညာဆိုင်ရာထုတ်ဝေမှုတွေမှာ ပူးပေါင်းဆောင်ရွက်မှုကို ထည့်သွင်းဖို့လည်း တိုးချဲ့ခဲ့ပါတယ်။
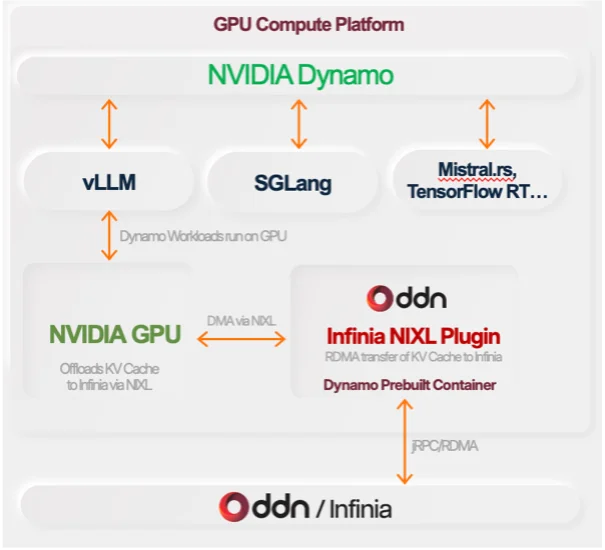
ဤပလက်ဖောင်းသည် ဖြန့်ဝေထားသော KV cache ဝန်ဆောင်မှုများ၊ GPU-native data movement၊ data orchestration နှင့် high-performance storage architectures များကို အသုံးပြုသည်။ KV cache acceleration သည် ယခင်က တွက်ချက်ထားသော attention state ကို ထိန်းသိမ်းပြီး လျင်မြန်စွာ ပြန်လည်ရယူပေးသောကြောင့် inference အတွက် အထူးသက်ဆိုင်သည်၊ အဘယ်ကြောင့်ဆိုသော် ၎င်းသည် ထပ်ခါတလဲလဲ တွက်ချက်မှုကို လျှော့ချပေးပြီး GPU များကို အလုပ်မလုပ်စေသည့် data ပေးပို့မှု နှောင့်နှေးမှုများကို ကန့်သတ်ပေးသောကြောင့်ဖြစ်သည်။
DDN၊ Nebul နှင့် NVIDIA တို့၏ ဦးဆောင်မှုသည် GPU ရယူခြင်းမှ လုပ်ငန်းလည်ပတ်မှု ထိရောက်မှုသို့ အခြေခံအားဖြင့် စက်မှုလုပ်ငန်း ပြောင်းလဲမှုတစ်ခုကို ညွှန်ပြခဲ့ပြီး၊ ဖြန့်ကျက်ထားသော accelerator များမှ တန်ဖိုးကို အမြင့်ဆုံးဖြစ်အောင် အာရုံစိုက်ခဲ့သည်။ DDN CEO Alex Bouzari နှင့် Nebul CEO Arnold Juffer နှစ်ဦးစလုံးက မော်ဒယ်စကေးသည် သမိုင်းဝင်ဦးစားပေးဖြစ်သော်လည်း၊ လက်ရှိစိန်ခေါ်မှုမှာ inference economics နှင့် token ကုန်ကျစရိတ်နည်းပါးခြင်းဖြင့် production AI ကို စီးပွားဖြစ်အသုံးပြုနိုင်အောင် လုပ်ဆောင်ခြင်းတွင် ရှိကြောင်း အလေးပေးပြောကြားခဲ့သည်။ NVIDIA ၏ Cloud Infrastructure ၏ ဒုတိယဥက္ကဋ္ဌ Rod Evans က အဖွဲ့အစည်းများသည် ကြီးမားသော agent workloads များဆီသို့ ရွေ့လျားလာသည်နှင့်အမျှ၊ အခြေခံအဆောက်အအုံအောင်မြင်မှုကို raw compute capacity ထက် GPU utilization နှင့် latency ဖြင့် ပိုမိုတိုင်းတာလာကြောင်း ထပ်လောင်းပြောကြားခဲ့သည်။
DDN က AI အခြေခံအဆောက်အအုံသည် ရိုးရာသိုလှောင်မှုလုပ်ငန်းများထက် ကျော်လွန်၍ တိုးတက်ပြောင်းလဲရမည်ဖြစ်ပြီး AI အကောင်အထည်ဖော်မှုတွင် တက်ကြွစွာပါဝင်သူဖြစ်လာရမည်ဟု ငြင်းခုံသည်။ ကုမ္ပဏီက ၎င်း၏ပလက်ဖောင်းများသည် ကမ္ဘာတစ်ဝှမ်းရှိ GPU တစ်သန်းကျော်ကို ပံ့ပိုးပေးပြီး hyperscaler များ၊ cloud builder များ၊ လုပ်ငန်းများ၊ အစိုးရများနှင့် သုတေသနအဖွဲ့အစည်းများ ပါဝင်သည်။
အခြေခံအဆောက်အအုံအဖွဲ့များအတွက် သက်ဆိုင်ရာ ထုတ်လုပ်မှု မက်ထရစ်များတွင် အောက်ပါတို့ ပိုမိုပါဝင်လာသည်-
- GPU အသုံးပြုမှုကောက်ချက်ချစဉ်အတွင်း ဈေးကြီးသော အရှိန်မြှင့်စက်များသည် မည်မျှထိရောက်စွာ တက်ကြွနေမည်ကို တိုင်းတာခြင်း။
- တိုကင်တစ်ခုလျှင် ကုန်ကျစရိတ်အခြေခံအဆောက်အအုံ ထိရောက်မှုကို မော်ဒယ်ထုတ်လုပ်မှု၏ ကုန်ကျစရိတ်နှင့် ချိတ်ဆက်ခြင်း။
- ဝပ်အလိုက် တိုကင်များ၊ ပါဝါသုံးစွဲမှုနှင့် နှိုင်းယှဉ်၍ အထွက်ထိရောက်မှုကို တိုင်းတာခြင်း။
- ပထမဆုံး တိုကင်အတွက် အချိန်၊ ၎င်းသည် အပြန်အလှန်တုံ့ပြန်နိုင်သော AI အပလီကေးရှင်းများအတွက် တုံ့ပြန်မှုကို ထိခိုက်စေပါသည်။
- ထုတ်လုပ်မှုအထိ ကြာမြင့်ချိန်သည် AI ဝန်ဆောင်မှုများကို စမ်းသပ်ခြင်းမှ ရွှေ့ပြောင်းရန် လိုအပ်သော လုပ်ငန်းလည်ပတ်မှု အားထုတ်မှုကို ထင်ဟပ်စေသည် တိုးချဲ့နိုင်သော ဖြန့်ကျက်မှု။
ကောက်ချက်ချခြင်းသည် အဓိက AI လည်ပတ်မှုအလုပ်ပမာဏဖြစ်လာသည်နှင့်အမျှ၊ ခန့်မှန်းနိုင်သော latency နည်းပါးသော GPU များထံ cached context နှင့် enterprise data ပေးပို့နိုင်စွမ်းသည် အသုံးပြုမှုကို ထိန်းသိမ်းရန်နှင့် ကုန်ကျစရိတ်များကို ထိန်းချုပ်ရန်အတွက် ပိုမိုအရေးကြီးလာမည်ဖြစ်သည်။


 အမေဇုံ