

Google Cloud Next မှာ Google က သူ့ရဲ့ နောက်မျိုးဆက် AI accelerator တွေကို ကြေညာခဲ့ပါတယ်- လေ့ကျင့်ရေးအတွက် TPU 8t “Sunfish” နဲ့ ကောက်ချက်ချဖို့အတွက် TPU 8i “Zebrafish” တို့နဲ့အတူ Virgo data center fabric အသစ်ပါ။ Google ရဲ့ blog post တွေအရ ဒီ chip တွေဟာ “agentic era” အတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားတာ ထင်ရှားပါတယ်- frontier mixture-of-experts model တွေကို chip ရာပေါင်းများစွာနဲ့ လေ့ကျင့်ပေးပြီး အဲဒီ model တွေကို latency နည်းပါးပြီး aggressive price-per-token target တွေမှာ ဝန်ဆောင်မှုပေးပါတယ်။ 8t နဲ့ 8i တို့ဟာ host platform နဲ့ fabric တစ်ခုကို မျှဝေပေမယ့် memory capacity၊ on-chip SRAM၊ interconnect topology နဲ့ on-die specialization တွေမှာ ကွဲပြားတဲ့ architecture အရ ကွဲပြားတဲ့ chip နှစ်ခု ဖြစ်ပါတယ်။ 8t ကို dense matrix multiplication (matmul) အတွက် တည်ဆောက်ထားပြီး 8i ကိုတော့ silicon ပေါ်က KV cache နဲ့ per-token collective latency ပေါ်မှာ အခြေခံပြီး တည်ဆောက်ထားပါတယ်။
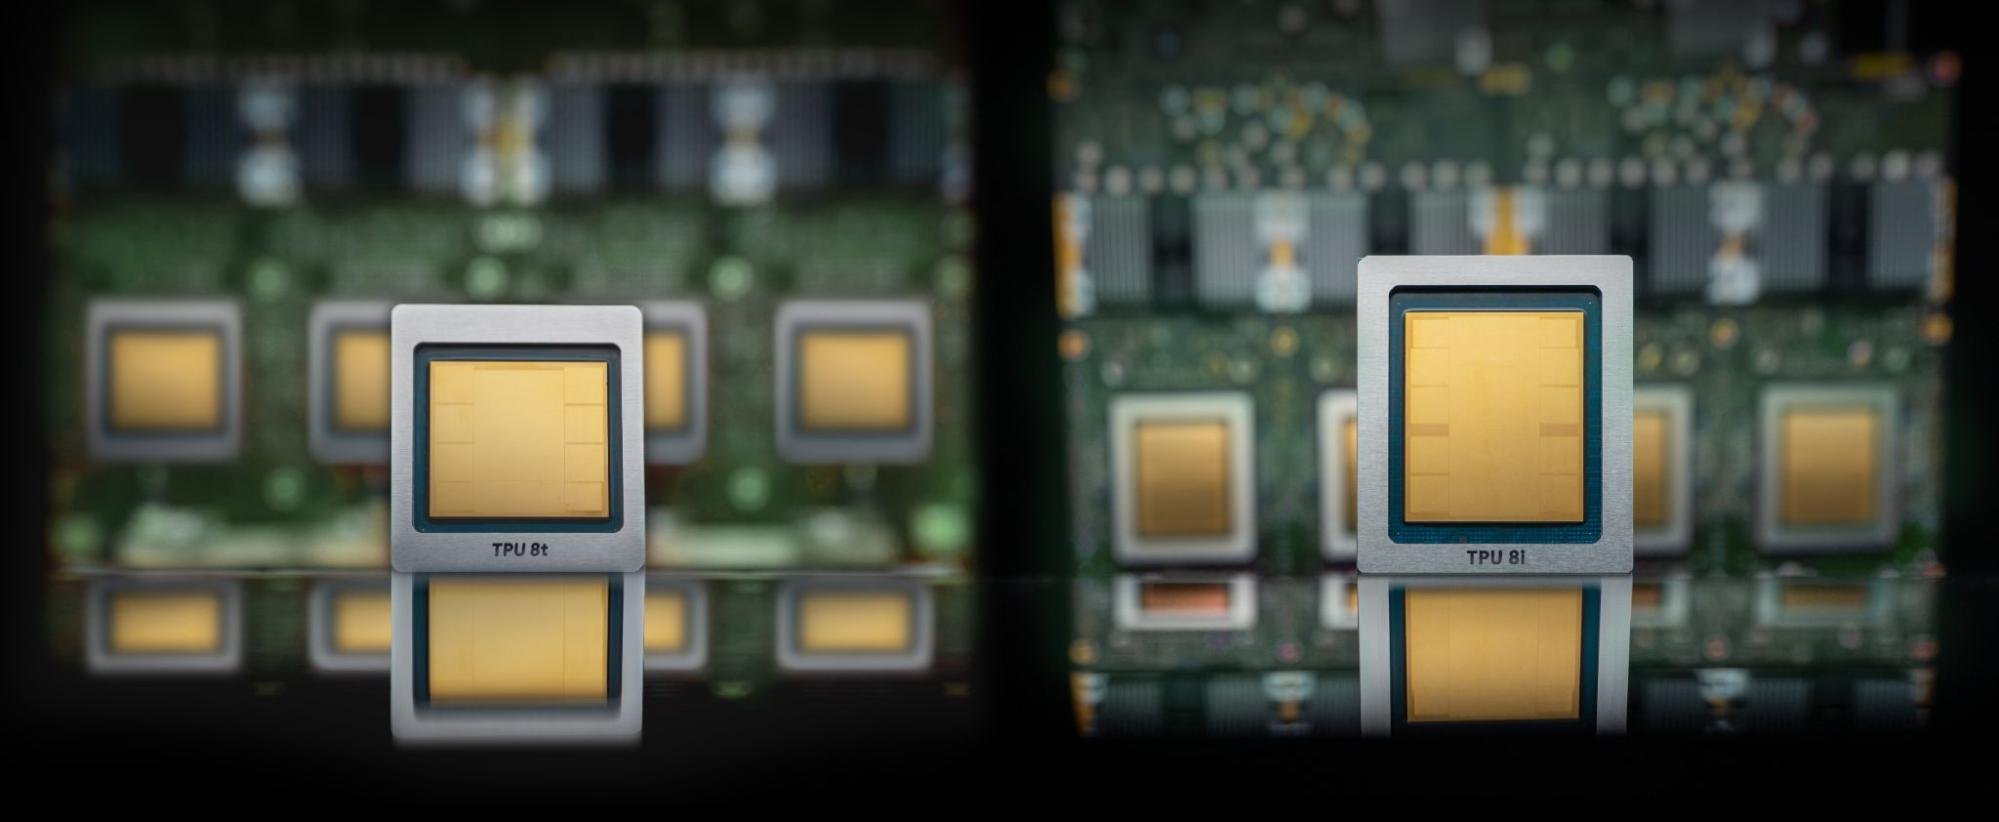
8t superpod တစ်ခုတည်းသည် ချစ်ပ် ၉,၆၀၀ အထိ တိုးချဲ့နိုင်ပြီး HBM ၂ PB သိမ်းဆည်းထားနိုင်ပြီး FP4 compute ၏ EFLOPS ၁၂၁ ကို ပေးစွမ်းနိုင်ပြီး Ironwood superpod ၏ pod တစ်ခုလျှင် compute ထက် ၃ ဆ နီးပါး ပိုများသည်။ 8i သည် HBM ၂၈၈ GB နှင့် on-chip SRAM (Ironwood ၃x) ၃၈၄ MB ကို ချစ်ပ် ၁,၁၅၂ ခု scale-up domain အတွင်း တွဲဖက်ထားပြီး LLM တွက်ချက်မှုအတွက် Ironwood ထက် တစ်ဒေါ်လာလျှင် ၈၀% ပိုမိုကောင်းမွန်သော စွမ်းဆောင်ရည်ကို ပေးစွမ်းသည်ဟု ဆိုထားသည်။ Virgo သည် ချစ်ပ်မိသားစုနှစ်ခုလုံးကို တစ်ခုတည်းသော data center fabric အဖြစ် ချည်နှောင်ထားပြီး non-blocking bisection bandwidth ၄၇ Pb/s ဖြင့် 8t ချစ်ပ် ၁၃၄,၀၀၀ ကျော်ကို ချိတ်ဆက်ပေးကာ၊ per-accelerator bandwidth ၄ ဆ အထိ ရှိပြီး unloaded latency ၄၀% လျော့နည်းသည်။
TPU ဆိုတာ တကယ်တော့ ဘာလဲ
8 silicon အကြောင်းမပြောခင်မှာ TPU ဆိုတာဘာလဲ၊ GPU နဲ့ ဘယ်လိုကွာခြားလဲဆိုတာကို နောက်ခံအချက်အလက်တချို့ ပြောပြပါမယ်၊ ဘာလို့လဲဆိုတော့ 8 ဒီဇိုင်းဆုံးဖြတ်ချက်တွေက အဲဒီအခြေအနေပေါ်မှာပဲ မူတည်နေလို့ပါ။
Tensor Processing Unit ဆိုတာ Google က ၂၀၁၅ ခုနှစ်ကတည်းက ထပ်ခါတလဲလဲ လုပ်ဆောင်နေတဲ့ custom ASIC တစ်ခုပါ။ မျိုးဆက်တိုင်းကို တူညီတဲ့ core idea ပေါ်မှာ အခြေခံပြီး တည်ဆောက်ထားပါတယ်။ GPU လိုမျိုး core အသေးစားထောင်ပေါင်းများစွာကို dynamically scheduling လုပ်မယ့်အစား TPU ဟာ အလွန်ကြီးမားတဲ့ MXU (matrix multiply units) အနည်းငယ်ပေါ်မှာ အခြေခံထားပြီး on-chip၊ software-managed SRAM scratchpad ကနေ ထောက်ပံ့ပေးပြီး advanced compiler ကနေ မောင်းနှင်ပါတယ်။ chip တစ်ခုစီမှာ TensorCores အနည်းငယ်ပါဝင်ပြီး တစ်ခုချင်းစီကို systolic-array MXU အကြီးကြီးတစ်ခုနဲ့ တည်ဆောက်ထားပြီး recommendation embedding တွေကို လွှမ်းမိုးထားတဲ့ irregular gather-scatter lookups တွေအတွက် ရည်ရွယ်ထားတဲ့ SparseCores အသေးစားတစ်ခု ပါဝင်ပါတယ်။ HBM ကနေ scratchpad ကနေတစ်ဆင့်၊ MXU ကနေတစ်ဆင့် scratchpad ကို ပြန်သွားပြီး activation၊ normalization နဲ့ reduction တွေကို Vector Processing Unit က ကိုင်တွယ်ပေးပါလိမ့်မယ်။ hardware warp scheduler မရှိပါဘူး၊ GPU မှာ L1 ဒါမှမဟုတ် L2 cache hierarchy မရှိပါဘူး၊ dynamic dispatch လည်း မရှိပါဘူး။
ဒီဒီဇိုင်းရဲ့ အားသာချက်ကတော့ dense linear algebra မှာ ထိရောက်မှုပါပဲ။ tensor တိုင်းရဲ့ တည်နေရာနဲ့ collective တိုင်းရဲ့ fire တွေကို ဆုံးဖြတ်ပေးတဲ့ precedent compiler ပါရှိတာကြောင့် cache-miss jitter နဲ့ warp-scheduler tax မရှိပါဘူး။ ဒါက chip ထောင်ပေါင်းများစွာကို collective တစ်ခုတည်းကနေ synchronize လုပ်နေရတဲ့အခါ ပိုအရေးကြီးပါတယ်။ well-tuned training workloads တွေအတွက် TPU တွေပေါ်မှာ real-world model FLOP utilization က ရိုးရာ GPU တွေထက် ပိုများပါတယ်။ အားနည်းချက်ကတော့ large dense matmuls၊ အထူးသဖြင့် dynamic shapes၊ irregular sparsity patterns၊ uneven token distribution ပါတဲ့ MoE routing ဒါမှမဟုတ် graph neural networks တွေကို cleanly map မလုပ်တဲ့ ဘယ်အရာမဆို ထိရောက်စွာ ဖော်ပြဖို့ ပိုခက်ပါတယ်။ TPU တွေဟာ သူတို့ရဲ့ GPU counterparts တွေထက် chip တစ်ခုအတွက် HBM နည်းတဲ့ သမိုင်းကြောင်းရှိပြီး framework support ကလည်း ကျဉ်းမြောင်းပါတယ်။ XLA နဲ့ JAX တွေက ပထမတန်းစားပါ။ PyTorch က မကြာသေးခင်အထိ translation layer လိုအပ်ခဲ့ပါတယ်။ ထို့အပြင် compiler၊ runtime၊ networking libraries နဲ့ multi-pod software stack တွေဟာ Google အတွင်းမှာ closed-source အဖြစ် ရှိနေပါသေးတယ်။
Sparsity သည် GPU များနှင့် TPU များကြားရှိ ဒဿနိကဗေဒဆိုင်ရာကွာဟချက်၏ အရှင်းလင်းဆုံးဥပမာဖြစ်ပြီး အကြောင်းရင်းမှာ စျေးကွက်ရှာဖွေရေးထက် ဖွဲ့စည်းပုံဆိုင်ရာကြောင့်ဖြစ်သည်။ NVIDIA သည် Ampere မှစ၍ Tensor Cores များတွင် 2:4 ဖွဲ့စည်းပုံဆိုင်ရာ sparsity ကို ပံ့ပိုးပေးခဲ့ပြီး၊ စာရွက်ပေါ်တွင် sparse workloads များအတွက် စွမ်းဆောင်ရည်သည် dense workloads ထက် နှစ်ဆဖြစ်သည်။ Tensor Core သည် အခြေခံအားဖြင့် dispatch unit တစ်ခုဖြစ်သည်- ၎င်းသည် MMA instruction တစ်ခုချင်းစီအတွက် explicit operand loads များကို ယူသောကြောင့် compressed 2-out-of-4 block plus index metadata ကို လက်ခံသည့် sparse MMA variant ကို ထည့်သွင်းခြင်းသည် ရှိပြီးသား instruction set ၏ ရိုးရှင်းသော extension တစ်ခုဖြစ်သည်။ cycle တစ်ခုစီတွင်၊ hardware သည် သုညမဟုတ်သောတန်ဖိုးများနှင့် ၎င်းတို့၏ index များကိုသာ multiplier array ထဲသို့ ဆွဲယူကာ သုညများကို သွယ်ဝိုက်၍ ကျော်သွားသည်။
systolic array သည် ဆန့်ကျင်ဘက်နည်းလမ်းဖြင့် အလုပ်လုပ်သည်။ PE (processing element) တိုင်းသည် cycle တိုင်းကို တွက်ချက်ပြီး operand များသည် array မှတစ်ဆင့် lockstep ဖြင့် တစ်ခုမှ နောက်တစ်ခုသို့ တိုက်ရိုက် register-to-register လမ်းကြောင်းများမှတစ်ဆင့် streaming လုပ်သည်။ ထို deterministic dataflow သည် SIMT ထက် power-efficiency အားသာချက် ပေါ်ပေါက်လာသည့်နေရာ အတိအကျဖြစ်သည်- ထပ်ခါတလဲလဲ SRAM ဖတ်ရှုခြင်းမရှိ၊ instruction dispatch overhead မရှိ၊ operand အများဆုံး ပြန်လည်အသုံးပြုခြင်း။ သို့သော် ၎င်းသည် pipeline ကို မဖြတ်တောက်ဘဲ cycle တိုင်းတွင် zero-value element တစ်ခုကို ကျော်သွား၍မရဟုလည်း ဆိုလိုသည်။

ရင်းမြစ်: Google က
TPU များသည် tile အဆင့်တွင် sparsity ကို အသုံးချနိုင်ဆဲဖြစ်သည်။ MXU အရွယ် tile တစ်ခုလုံးသည် သုညအားလုံးဖြစ်ပါက compiler သည် ၎င်းတွင် အလုပ်ကို အချိန်ဇယားဆွဲမည်မဟုတ်ပါ။ သို့သော်၊ structured sparsity အတွက် hardware acceleration ကို မထည့်ရန် Google ၏ရွေးချယ်မှုသည် ရည်ရွယ်ချက်ရှိရှိလုပ်ဆောင်ခြင်းဖြစ်သည်။ M:N structured sparsity ကို systolic array တွင်ထည့်သွင်းခြင်းကို နည်းပညာများစွာကို အသုံးပြု၍ ရရှိနိုင်ပြီး တစ်ခုချင်းစီတွင် မတူညီသော trade-off များရှိသည်။ ထိုကဲ့သို့သော နည်းပညာတစ်ခုမှာ SRAM နှင့် array ၏ input port များအကြားတွင် compression unit တစ်ခုလိုအပ်သည်။ သို့သော် systolic array သည် dispatcher မဟုတ်ဘဲ pipeline တစ်ခုဖြစ်သည်။ ၎င်း၏ ထိရောက်မှုအာမခံချက်သည် deterministic cadence တွင်ရောက်ရှိလာသော operands များမှ လာပြီး၊ processing element တိုင်းသည် cycle တိုင်းတွင် အလုပ်များနေသည်။ operands များကို ကျော်သွားခွင့်ပြုခြင်းသည် ကုန်ကျစရိတ်နှစ်ခုအနက် တစ်ခုကို ဖြစ်ပေါ်စေပါသည်။ သုညများတွင် pipeline ကို ရပ်တန့်ပါ၊ ၎င်းသည် architecture ကို အစကတည်းက လှုံ့ဆော်ပေးခဲ့သော efficiency အားသာချက်ကို ဖျက်ပစ်သည်။ သို့မဟုတ် array ထဲသို့မဝင်မီ compressed input မှ full-width stream ကို ပြန်လည်တည်ဆောက်ရန် dedicated decompressor hardware ကိုထည့်ပါ၊ ၎င်းသည် die area ကိုစားသုံးပြီး latency ကို ပေါင်းထည့်လိမ့်မည်။
အရင်းအမြစ်: AWS
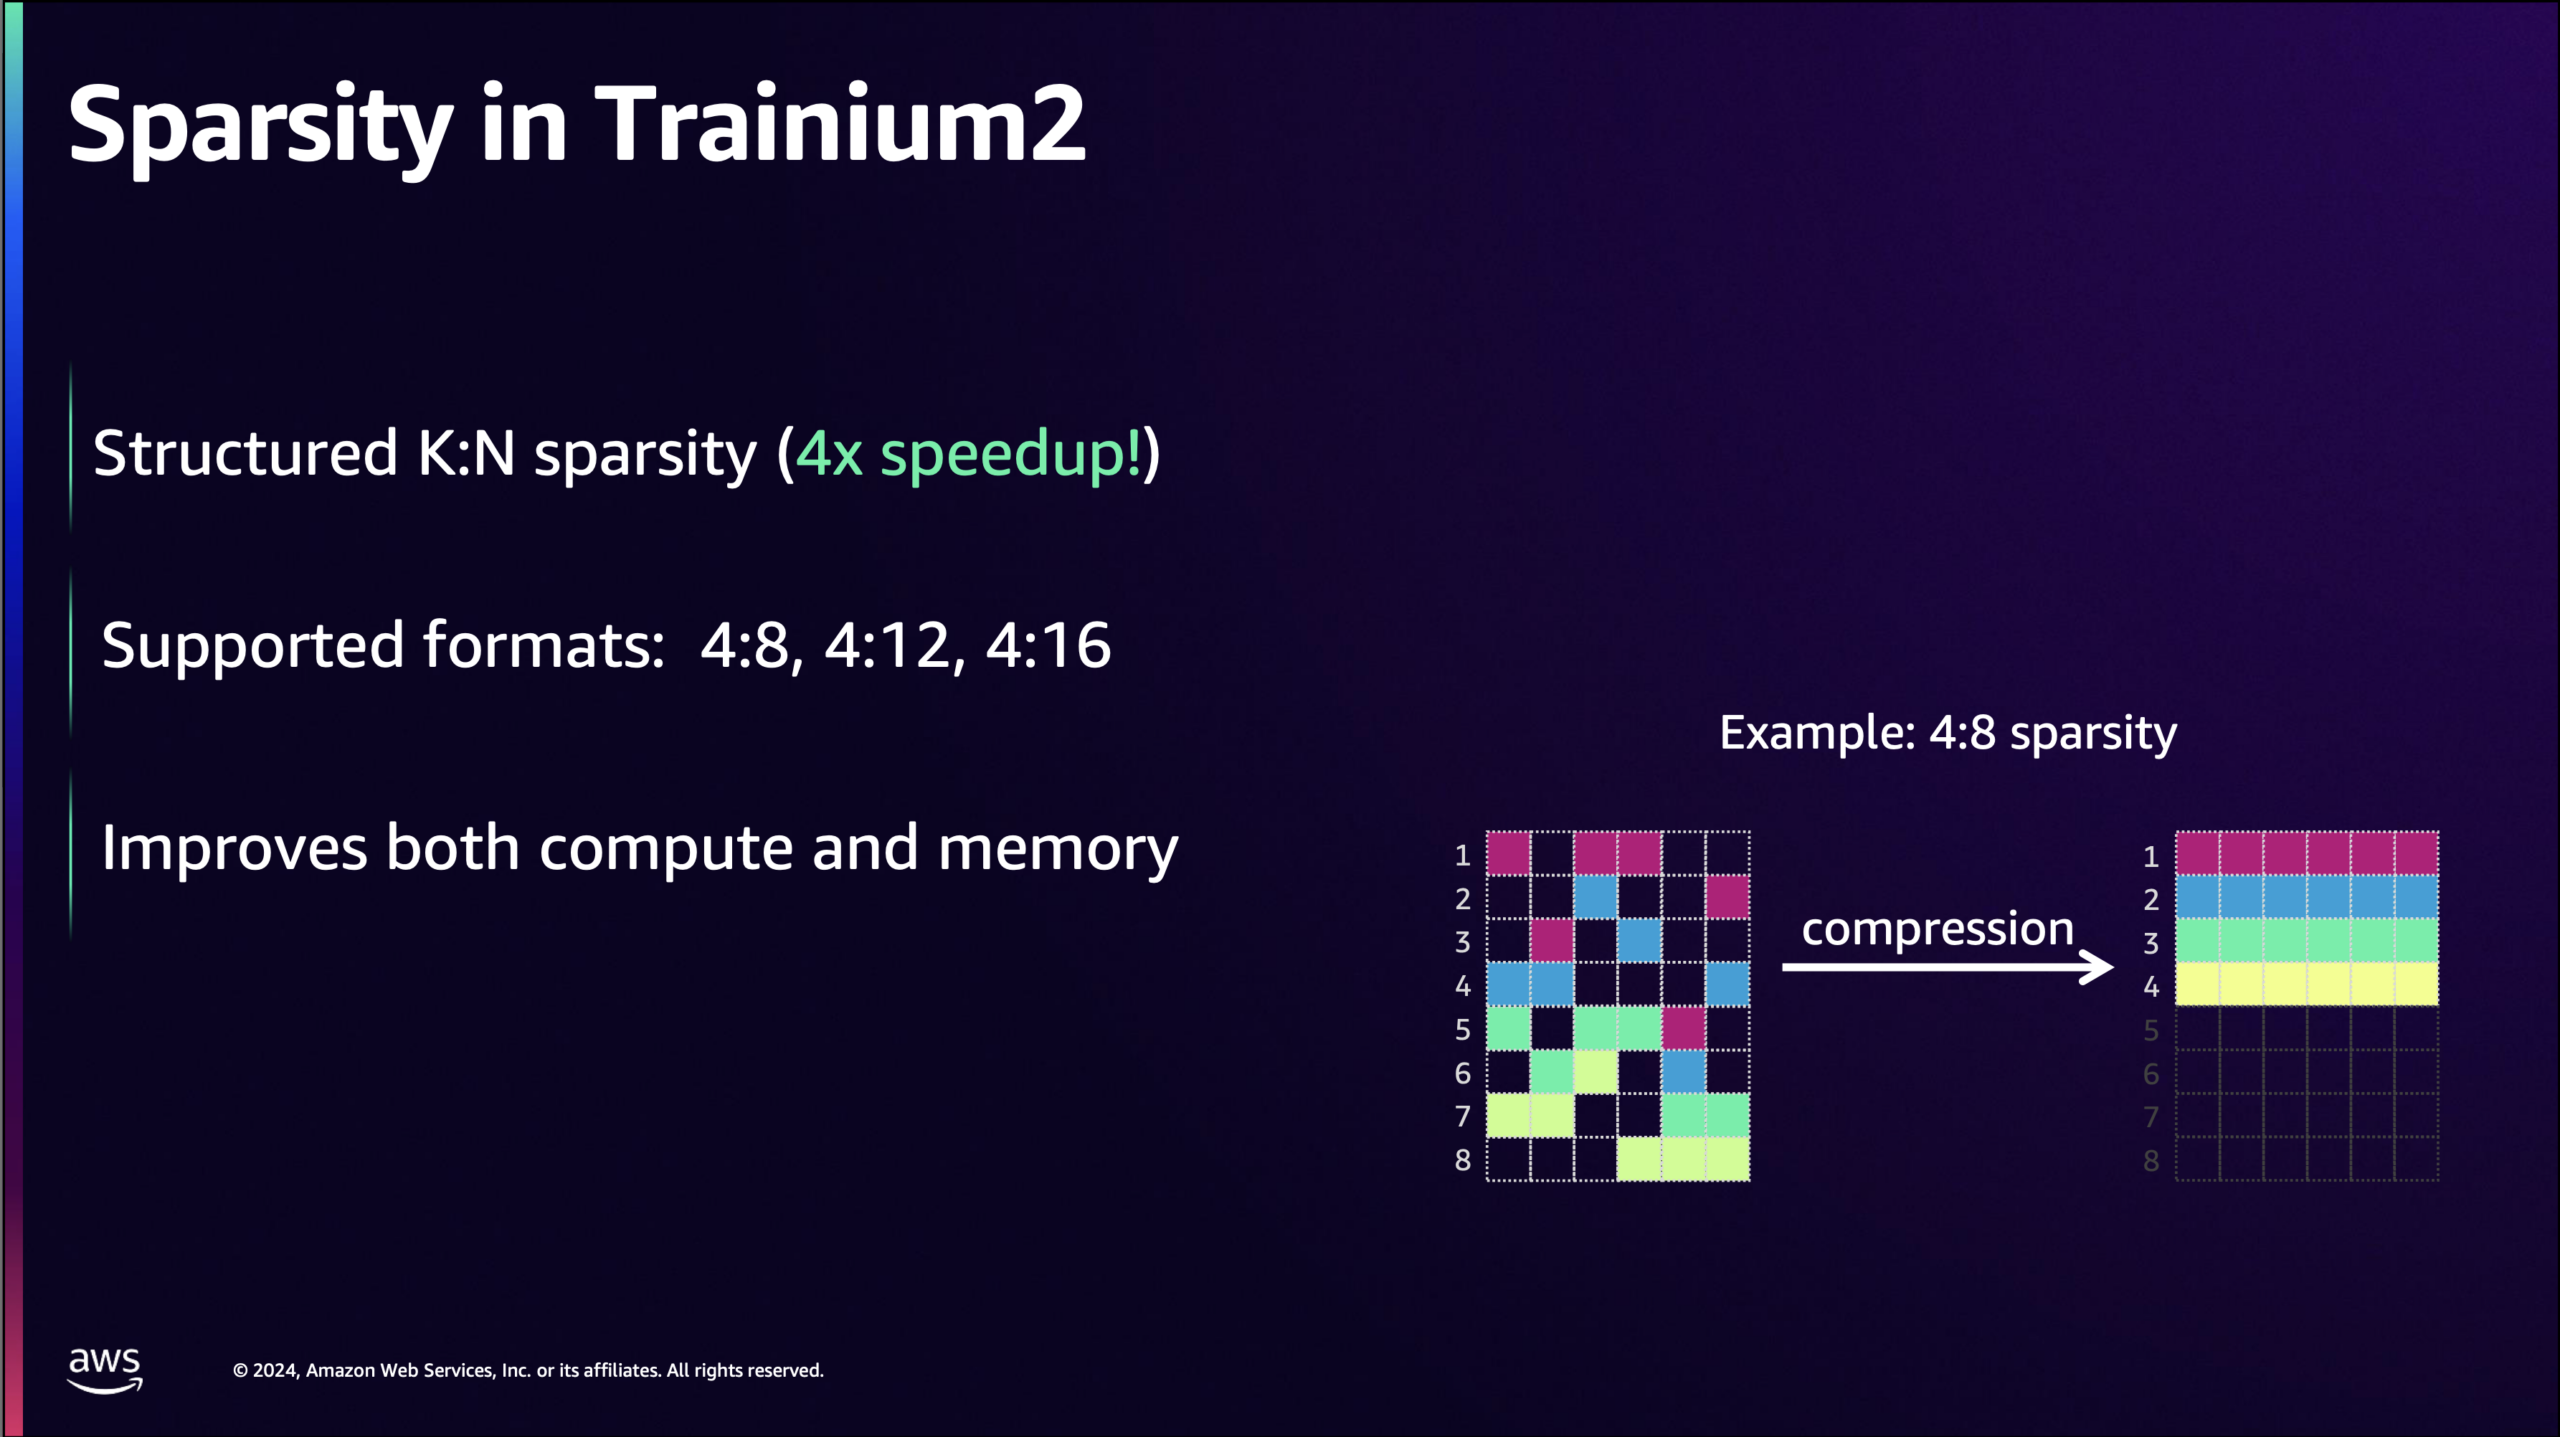
အချို့သော accelerator များသည် sparsity အတွက် hardware support နှင့် systolic array များကို တွဲဖက်ပေးသည်။ AWS သည် Trainium2 နှင့် Trainium3 အတွင်းရှိ engine ဖြစ်သော NeuronCore-v3 ဖြင့် စတင်တည်ဆောက်ထားသည်။ အကောင်အထည်ဖော်မှုက hardware-sparse systolic array ၏ပုံပန်းသဏ္ဌာန်ကို ပြသသည်။ NeuronCore-v3 Tensor Engine သည် 128×128 systolic array တစ်ခုဖြစ်ပြီး stationary weight matrix နှင့် streaming activation matrix ပေါ်တွင် လုပ်ဆောင်ပြီး contraction dimension ကို array ၏ partition dimension နှင့် ချိန်ညှိထားသည်။ sparse mode တွင် input datapath သည် dense BF16 နှင့် FP16 တွင် cycle တစ်ခုလျှင် 2×128 element မှ cycle တစ်ခုလျှင် 5×128 element အထိ ကျယ်ပြန့်လာပြီး stationary side သည် မူရင်း dense weight များအစား weight matrix ၏ compressed representation မှ feed လုပ်သည်။ compile time တွင် weight tensor ကို M:N format သို့ process လုပ်သည်။ contraction dimension တစ်လျှောက်ရှိ contiguous element N ခုမှ M ကိုသာ ထိန်းသိမ်းထားပြီး position များသည် သုညမဟုတ်သော compact bitmask encoding ဖြင့် ရှိနေသည်။ compressed buffer သည် M values များကိုသာ သိမ်းဆည်းပြီး N/M ၏ factor ဖြင့် shrink လုပ်သည်။ matmul ညွှန်ကြားချက်ကို လုပ်ဆောင်သောအခါ၊ hardware သည် ချုံ့ထားသော weight များကို ဖတ်ပြီး bitmask ကို အသုံးပြု၍ stationary tile မှ မှန်ကန်သော processing element များထံ သက်ဆိုင်ရာ activation များကို လမ်းကြောင်းပြောင်းပေးသည်။ သုညဖြင့် မြှောက်မည့် PE များသည် ထို slot အတွက် အလုပ်မရပါ။ bitmask lookup နှင့် routing သည် array ကိုယ်တိုင်တွင်မဟုတ်ဘဲ array ကို feed လုပ်သည့် decompressor တွင် ရှိနေသောကြောင့်၊ pipeline သည် သုညများတွင် ရပ်တန့်နေမည့်အစား သုညမဟုတ်သော တန်ဖိုးများတွင် full throughput ဖြင့် clocking လုပ်နေသည်။
Dense matrix multiplication က TPU တစ်ခုတည်းလုပ်ဆောင်တဲ့အရာမဟုတ်ပါဘူး။ မျိုးဆက်ပေါင်းများစွာကတည်းက TPU တွေဟာ TensorCores နဲ့အတူ SparseCore ကို ထည့်သွင်းထားပါတယ်။ SparseCore ဟာ recommendation model တွေကို သတ်မှတ်ပေးတဲ့ irregular gather-scatter access pattern တွေအတွက် ဒီဇိုင်းထုတ်ထားတဲ့ domain-specific engine တစ်ခုဖြစ်ပါတယ်။ YouTube ranking model ဒါမှမဟုတ် search ad relevance model ဟာ dense transformer နဲ့ မတူပါဘူး။ ၎င်းရဲ့ parameter အများစုဟာ gigabyte ရာပေါင်းများစွာကနေ petabyte scale အထိရှိတဲ့ embedding table တွေမှာ ရှိနေပြီး ၎င်းရဲ့ compute time အများစုကို ထို tab များမှ lookup အသေးစားများကို လုပ်ဆောင်ခြင်း၊ ရယူထားတဲ့ values များကို ပေါ့ပေါ့ပါးပါးပြောင်းလဲခြင်းနဲ့ ရလဒ်များကို ပေါင်းစပ်ခြင်းတို့ ပြုလုပ်ပါတယ်။ အဲဒီ access pattern ဟာ MXU အတွက် အဆိုးဆုံးအခြေအနေဖြစ်ပြီး GPU ရဲ့ cache hierarchy အတွက် အနည်းငယ်သာ ပိုကောင်းပါတယ်။ SparseCores ကို ၎င်းအတွက် တိကျစွာ ချိန်ညှိထားပါတယ်- HBM-resident embedding tab များကို ဆန့်ကျင်တဲ့ high-throughput gather-scatter operations များ၊ embedding pipeline ရဲ့ ကျန်တာတွေ မှီခိုနေရတဲ့ deduplication နဲ့ combine operations များအတွက် hardware support ပါဝင်ပါတယ်။ top-k ရွေးချယ်မှုက expert index တွေကို ထုတ်လုပ်ပေးပြီးတာနဲ့ ကျန်တဲ့ routing လုပ်ငန်းစဉ် (expert မှ token များကို permuting လုပ်ခြင်း၊ chip များတစ်လျှောက် ဖြန့်ဝေခြင်း၊ expert output များကို ပြန်လည်စုဆောင်းခြင်းနှင့် weighted reduction ကို လုပ်ဆောင်ခြင်း) သည် embedding pipeline ကဲ့သို့ gather/scatter/reduce ပုံစံအတိုင်း လိုက်နာပြီး SparseCore ၏ sort support သည် top-k အဆင့်ကိုပင် လွှမ်းခြုံထားသောကြောင့် MoE expert routing တွင်လည်း အထောက်အကူဖြစ်စေပါသည်။
အဲဒီနောက်ခံနဲ့ ကြေညာချက်တွေကို ဖော်ပြပေးလိုက်ပါတယ်။
TPU 8t “နေငါး”
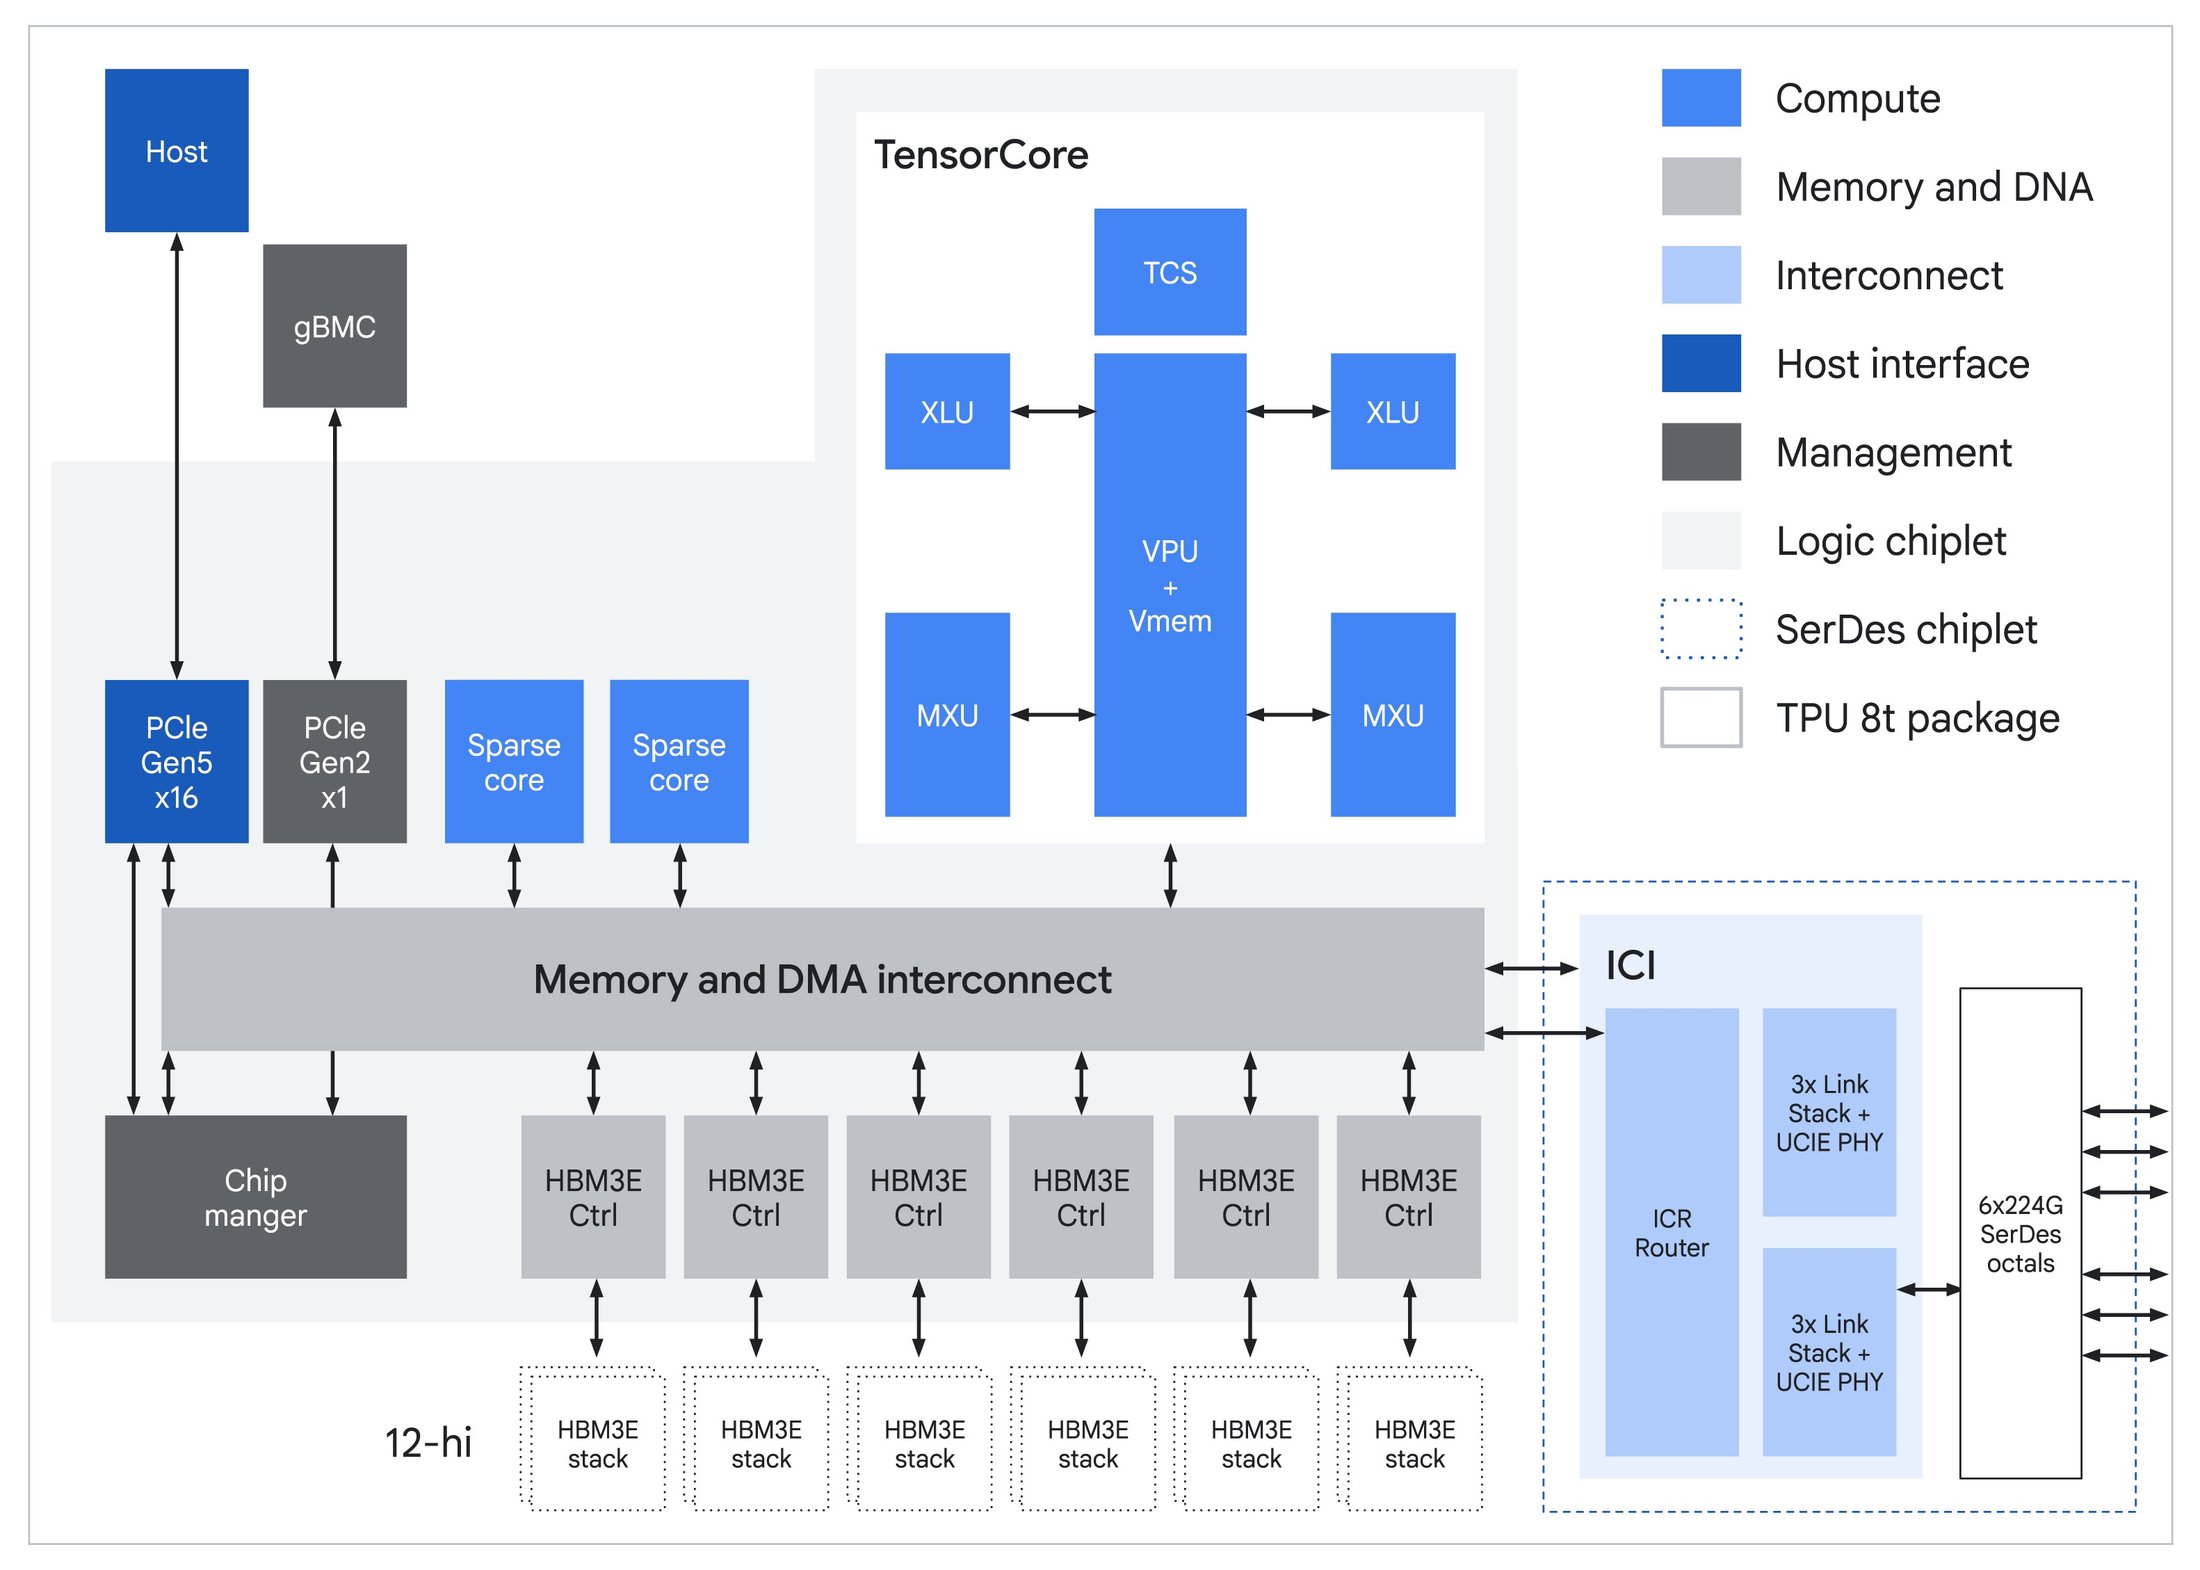
ပထမဆုံးကြေငြာချက်ဖြစ်တဲ့ TPU 8t ကို Sunfish လို့ ကုဒ်နံပါတ်ပေးထားပြီး လေ့ကျင့်ရေးချစ်ပ်အဖြစ် အသုံးပြုထားပါတယ်။ Ironwood ရဲ့ မျိုးဆက်သစ်အဆင့်ဟာ မျှော်မှန်းထားတဲ့လမ်းကြောင်းအတိုင်း အများစုမှာ လိုက်နာပါတယ်- မှတ်ဉာဏ်ပိုများခြင်း၊ bandwidth ပိုများခြင်း၊ ကျဉ်းမြောင်းတဲ့ဒေတာအမျိုးအစားတွေအတွက် native support တို့ပဲ ဖြစ်ပါတယ်။ ချစ်ပ်တစ်ခုစီမှာ 6.5 TB/s နှုန်းနဲ့ 12-Hi HBM3e stack ခြောက်ခုက ထောက်ပံ့ပေးတဲ့ TensorCore တစ်ခုတည်းကို သယ်ဆောင်ထားပြီး Ironwood ရဲ့ stack ရှစ်ခုမှာ 192 GB ထက် ပိုများပါတယ်။ on-chip Vmem SRAM ကတော့ 128 MB မှာ ရှိနေဦးမှာပါ။
MXU မှာရှိတဲ့ Native FP4 က compute jump အများစု လာတဲ့နေရာပါ။ matmuls တွေကို 8-bit အစား 4-bit မှာ run ခြင်းအားဖြင့် တူညီတဲ့ physical array အတွက် cycle တစ်ခုအတွက် throughput ကို double လုပ်ပါတယ်၊ Google က Ironwood ရဲ့ 4.6 PFLOPS FP8 ကနေ 8t ရဲ့ 12.6 PFLOPS FP4 ကို ဘယ်လိုရနိုင်လဲဆိုတာကို ပြသနေပါတယ်။ Mixed-precision training က optimizer step အတွက် weights ရဲ့ FP32 master copy ကို ထိန်းထားပေးပါတယ်။ FP4 က compute time ရဲ့ အများစုကို စားသုံးတဲ့ working tensors တွေကို ကျုံ့စေပါတယ်။
ရင်းမြစ်: Google က
interconnect ဇာတ်လမ်းက ရိုးရှင်းပါတယ်။ ICI bandwidth ဟာ chip တစ်ခုကို 19.2 Tb/s အထိ နှစ်ဆတိုးလာပြီး 9,600-chip superpod က HBM 2 PB နဲ့ EFLOPS 121 ကို စုစည်းထားပြီး 3D torus topology ကိုလည်း ဆက်လက်ထိန်းသိမ်းထားပါတယ်။ torus ဟာ training အတွက် ကျိုးကြောင်းဆီလျော်ပါတယ်၊ ဘာလို့လဲဆိုတော့ frontier jobs တွေကို ring-friendly collectives တွေက လွှမ်းမိုးထားလို့ပါ- data နဲ့ tensor parallelism အတွက် all-reduces၊ FSDP အတွက် all-gathers နဲ့ reduce-scatters နဲ့ pipeline-parallel point-to-point sends တွေပါ။ ဒါတွေအားလုံးက torus axes တွေနဲ့ သပ်ရပ်စွာ ချိတ်ဆက်ထားပါတယ်။
Google သည် v4 မှစ၍ TPU တိုင်းတွင် ပို့ဆောင်ပေးခဲ့သော SparseCores များကိုလည်း ထိန်းသိမ်းထားသည်။ ၎င်းတို့၏ မူလရည်ရွယ်ချက်မှာ DLRM ပုံစံ အကြံပြုချက် မော်ဒယ်များဖြစ်ပြီး၊ တွက်ချက်ချိန်အများစုသည် ကြီးမားသော embedding table များနှင့် နှိုင်းယှဉ်လျှင် မမှန်သော gather-scatter သို့ ရောက်ရှိသွားသည်။ ထို hardware သည် MoE routing ကိုလည်း ကိုင်တွယ်သည်။ JAX သည် ragged all-to-all နှင့် ကိုက်ညီသော ragged_dot ကို ပထမတန်းစား လုပ်ဆောင်ချက်များအဖြစ် ဖော်ထုတ်ပြီး chip တစ်ခုစီသည် peer တစ်ခုစီသို့ မတူညီသော အရွယ်အစားရှိသော chunk တစ်ခု ပေးပို့နိုင်သည်။ ၎င်းသည် MoE dispatch ၏ တကယ့်ပုံသဏ္ဍာန်နှင့် ကိုက်ညီသည်၊ အဘယ်ကြောင့်ဆိုသော် top-k routing သည် data-dependent ဖြစ်ပြီး expert တစ်ခုစီထံ စီးဆင်းသော token အရေအတွက်သည် အဆင့်တိုင်းတွင် မတူညီသောကြောင့်ဖြစ်သည်။ compiler သည် မမှန်သော communication နှင့် မမှန်သော expert matmul ကို တစ်ခုတည်းသော scheduled operation တစ်ခုအဖြစ် ပေါင်းစပ်ပေးပြီး SparseCore သည် ပတ်ဝန်းကျင် sort နှင့် permute ကို ကိုင်တွယ်သည်။ ယခုအခါ frontier မော်ဒယ်များတွင် mixture-of-experts သည် ယခုအခါ လွှမ်းမိုးသော architecture ဖြစ်သောကြောင့်၊ ဤ hardware သည် မူလက ဒီဇိုင်းထုတ်ထားသော ကြော်ငြာများနှင့် ranking workloads များသာမက ခေတ်မီ လေ့ကျင့်ရေးအလုပ်တိုင်းတွင် ၎င်း၏တန်ဖိုးကို သက်သေပြသည်။
၎င်းတို့သည် ဆင့်ကဲဖြစ်စဉ်ဆိုင်ရာ အဆင့်များဖြစ်သည်။ ပိုမိုကြီးမားသော ပြောင်းလဲမှုများမှာ TPUDirect နှင့် Axion-based host များထံ ရွှေ့ပြောင်းခြင်းဖြစ်ပြီး နှစ်ခုစလုံးသည် နယ်စပ်အတိုင်းအတာတွင်သာ မြင်သာလာသော ပိတ်ဆို့မှုများကို ကိုင်တွယ်ဖြေရှင်းပေးသည်။
TPUDirect RDMA နှင့် TPUDirect သိုလှောင်မှု
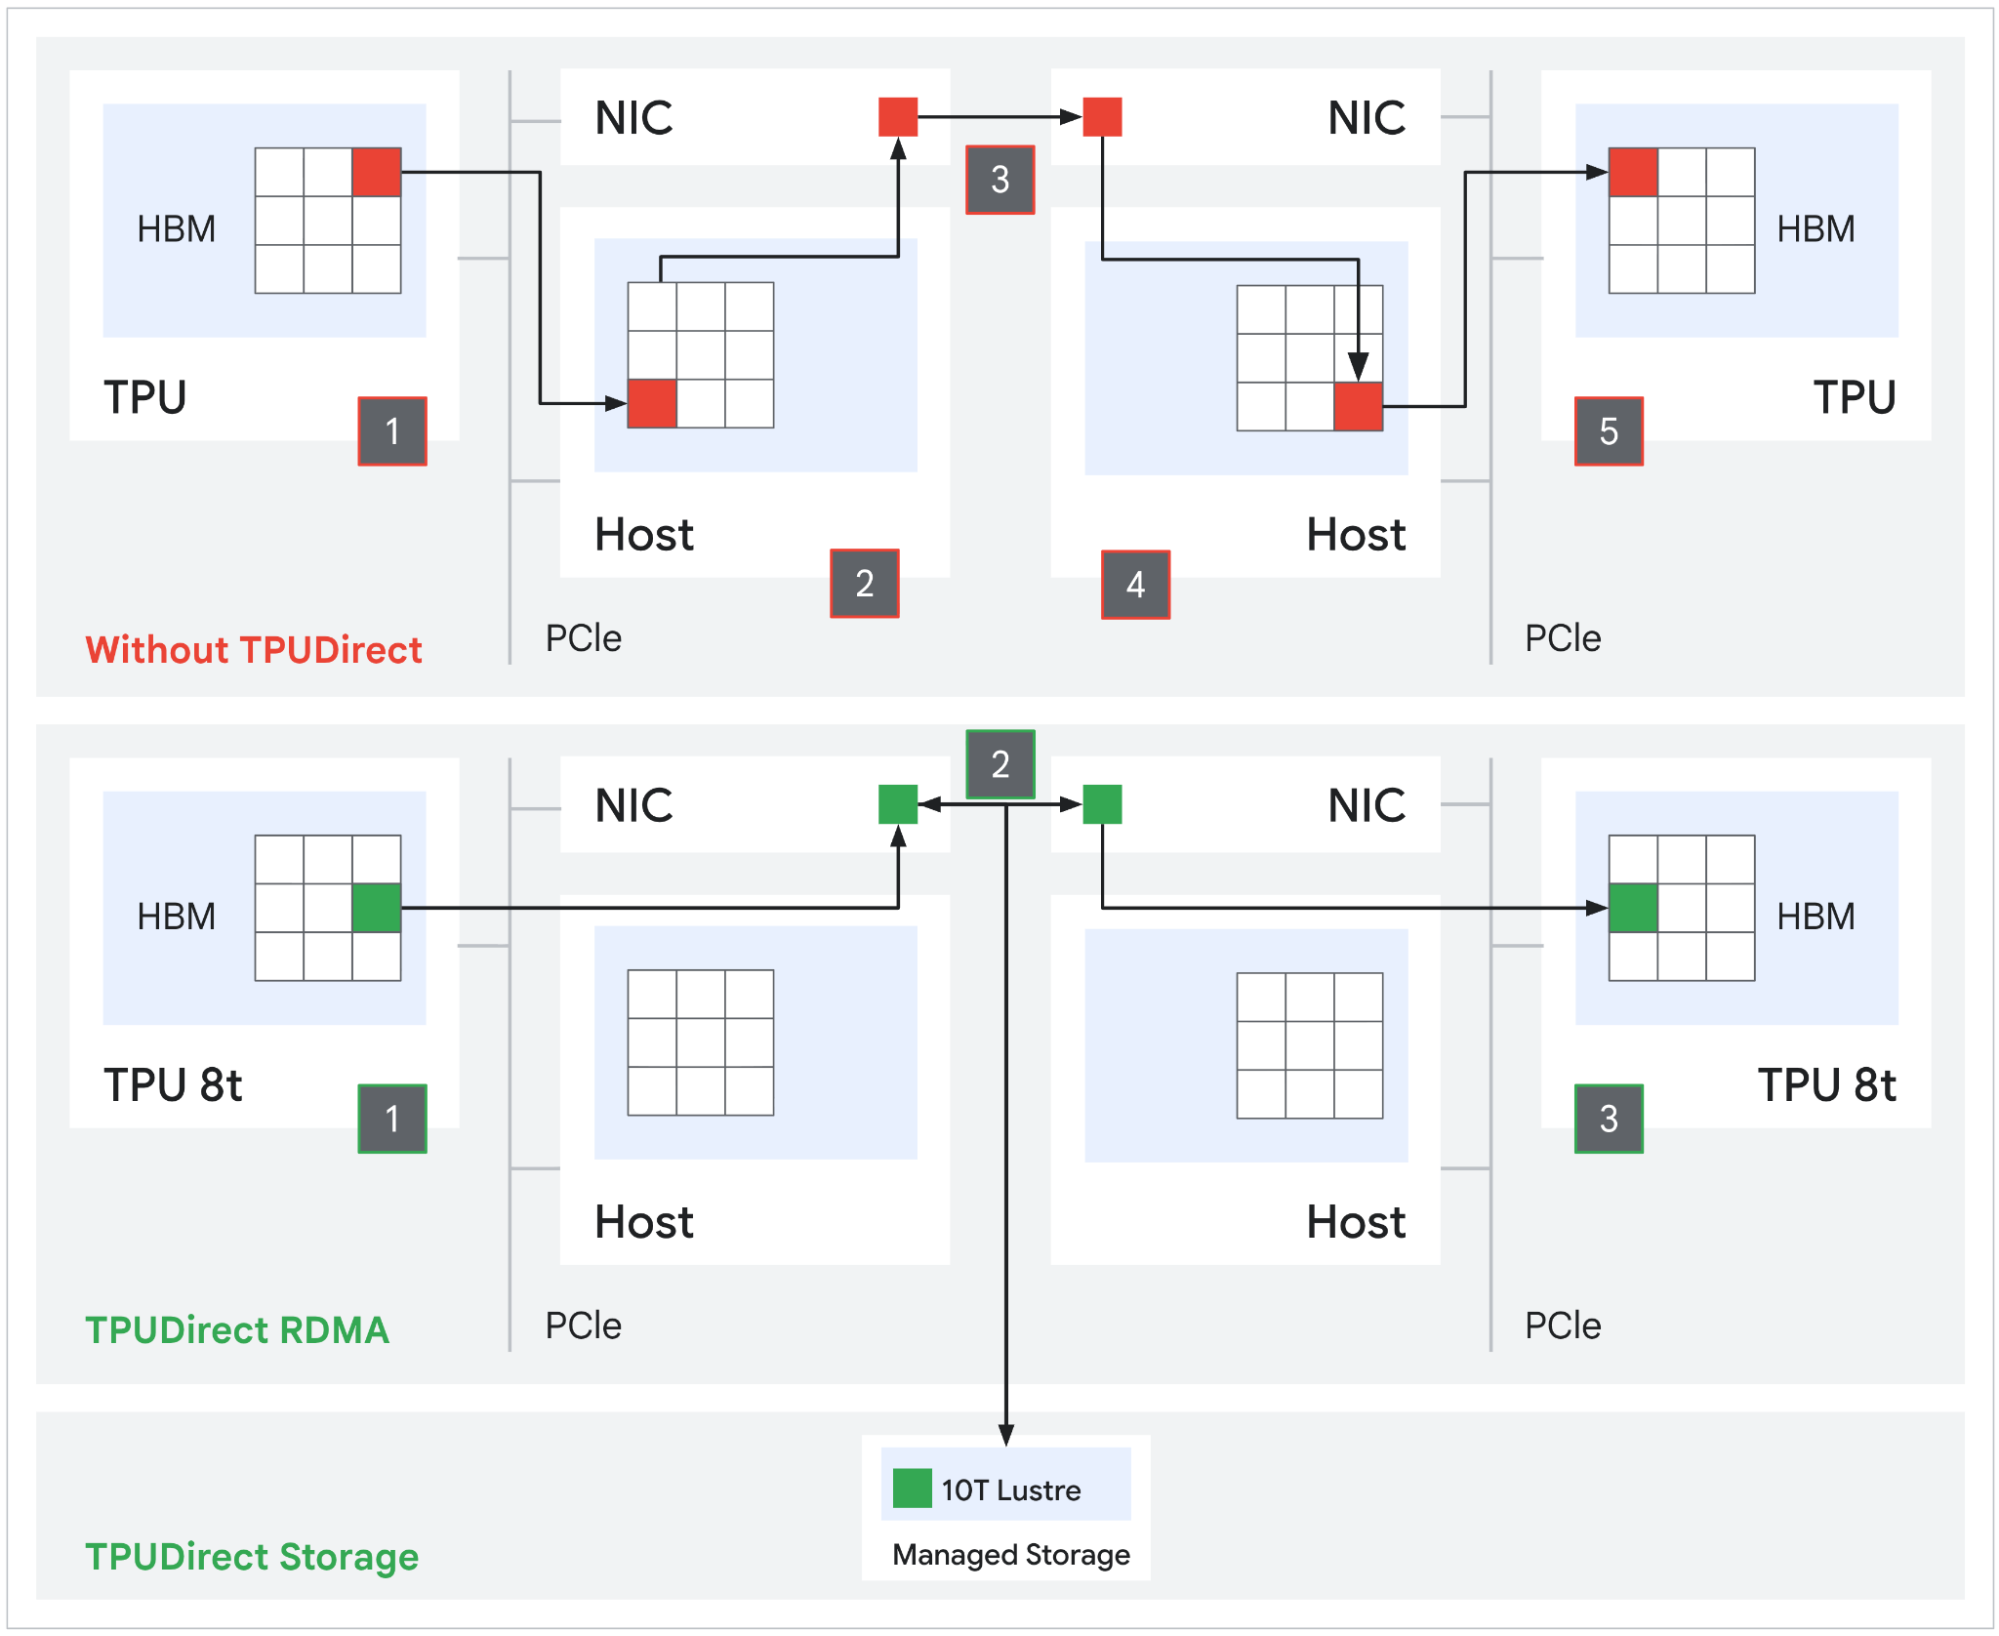
ယခင် TPU မျိုးဆက်များသည် network နှင့် storage I/O အတွက် host-mediated path ကို အသုံးပြုခဲ့သည်- packets များသည် host DRAM တွင် ဦးစွာရောက်ရှိပြီးနောက် သီးခြား DMA တစ်ခုက ၎င်းတို့ကို TPU HBM ထဲသို့ ကူးယူခဲ့သည်။ ၎င်းသည် loop တွင် host CPU ပါရှိသော memory transaction နှစ်ခုဖြစ်သည်။ TPUDirect RDMA သည် bounce buffer ကို ဖယ်ရှားပေးသည်။ NIC သည် PCIe peer-to-peer မှတစ်ဆင့် TPU HBM ကို တိုက်ရိုက်ဖတ်ရှုရေးသားပြီး host ကို data path မှ ဖယ်ရှားပေးသည်။ NVIDIA သည် GPUDirect RDMA နှင့် ညီမျှသောစွမ်းရည်ကို နှစ်ပေါင်းများစွာ ပေးဆောင်ခဲ့ပြီး host-mediated path ထက် ၁၀ ဆခန့် တိုးတက်မှုရှိသည်ဟု ကိုးကားဖော်ပြထားသည်။ Google သည် ယခုအခါ TPU ဘက်တွင် ၎င်းကို ကိုက်ညီအောင် လုပ်ဆောင်နေပါသည်။
ရင်းမြစ်: Google က
TPUDirect Storage သည် ထိုမူကို persistent storage အထိ တိုးချဲ့ထားသည်။ Tensors များသည် TPU HBM နှင့် Managed Lustre အကြား စုစုပေါင်း 10 TB/s နှုန်းဖြင့် တိုက်ရိုက်ရွေ့လျားပြီး Google က Ironwood ရှိ ညီမျှသောလမ်းကြောင်းထက် 10x ပိုမြန်သော storage access ကို ပေးစွမ်းသည်ဟု ဆိုထားသည်။ frontier scale တွင် checkpoints များသည် terabytes ရာပေါင်းများစွာအထိ လည်ပတ်နိုင်သည့် ကွာခြားချက်မှာ ရက်သတ္တပတ်များစွာကြာ လေ့ကျင့်မှုတစ်ခုသည် checkpoints များနှင့် datasets များကို line rate ဖြင့် stream လုပ်ခြင်း သို့မဟုတ် MXU pipeline ကို host I/O တွင် စောင့်ဆိုင်းနေခြင်းကို ရပ်တန့်စေခြင်း ရှိမရှိဖြစ်သည်။
Arm Axion Hosts
ယခင် TPU မျိုးဆက်တိုင်းသည် third-party x86 host များတွင် လည်ပတ်ခဲ့သည်။ 8t သည် Google ၏ကိုယ်ပိုင် Axion processor၊ Arm Neoverse V2-based CPU ကို system header အဖြစ်အသုံးပြုသည့် ပထမဆုံးထုတ်ကုန်ဖြစ်သည်။ TPU pod ပေါ်ရှိ host CPU ၏အလုပ်သည် အမှန်တကယ်ဖြစ်ပြီး frontier scale တွင် ပိုမိုခက်ခဲလာသည်- ၎င်းသည် input pipeline ကို မောင်းနှင်သည်၊ multi-petabyte datasets များကို decode လုပ်၍ shuffle လုပ်သည်၊ JAX/XLA control plane ကို စီမံခန့်ခွဲသည်၊ checkpoint serialization ကို ကိုင်တွယ်သည်၊ နှင့် chip ထောင်ပေါင်းများစွာတွင် SPMD dispatch ကို ညှိနှိုင်းသည်။ host ရပ်တန့်သွားပါက MXU သည် အလုပ်မလုပ်တော့ပါ။
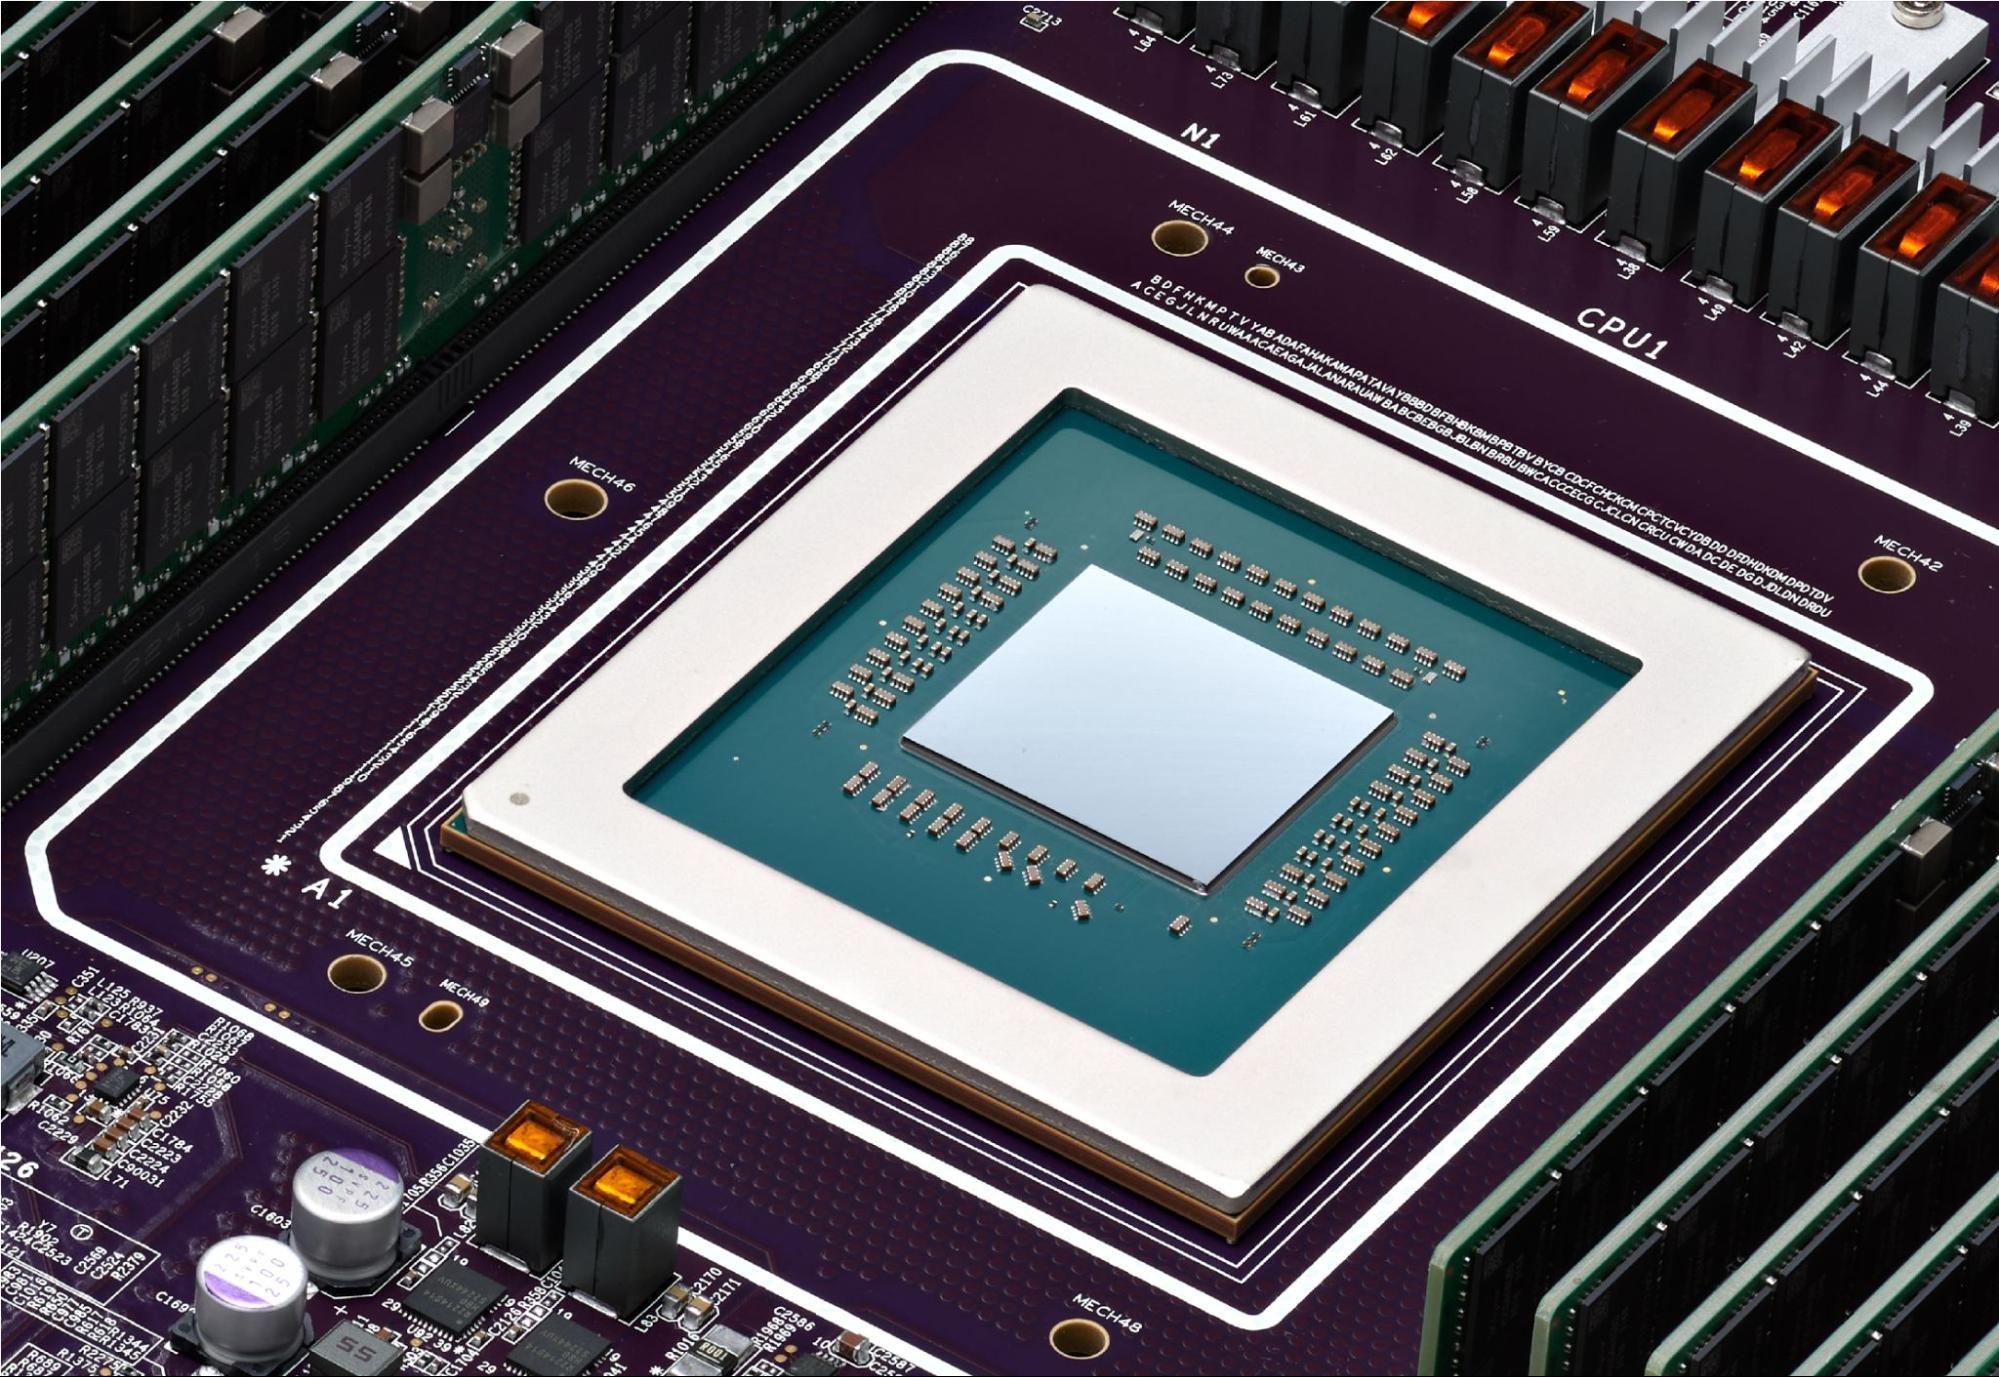
Google က Axion-powered NUMA isolation ကို 8t မှာ host-side jitter တွေ synchronized collective training ရဲ့ ယန္တရားအဖြစ် အထူးဖော်ပြထားပါတယ်။ pod တစ်ခုလျှင် chip ၉၆၀၀ ဖြင့် host တစ်ခုလျှင် အနည်းငယ်သော ချို့ယွင်းချက်များပင် goodput ဆုံးရှုံးမှုကို ဖြစ်စေပါသည်။ TPUDirect သည် bulk transfer များမှ host ကို ဖယ်ရှားခြင်းဖြင့် data-path ဘက်ကို ကိုင်တွယ်ပါသည်။ Axion သည် TPU တစ်ခုစီကို လုံလောက်သော dedicated CPU bandwidth ပေးခြင်းဖြင့် control-path ဘက်ကို ကိုင်တွယ်သောကြောင့် preprocessing သည် bottleneck မဖြစ်တော့ပါ။ Google သည် eighth-generation platform တွင် server တစ်ခုလျှင် physical Axion host များ၏ အချိုးကိုလည်း တိုးမြှင့်ထားပြီး chip အရေအတွက်နှင့်အတူ ချိန်ညှိထားသော orchestration overhead ကို Ironwood ၏ host configuration ထက် ပိုမိုကျယ်ပြန့်စွာ ပံ့ပိုးပေးပါသည်။
TPU 8i “ဇီဘရာငါး”
inference chip က 8t ရဲ့ Axion host platform၊ native FP4 နဲ့ HBM3e memory generation တွေကို မျှဝေအသုံးပြုပေမယ့် အောက်က silicon က ကွဲပြားတဲ့ bottleneck တစ်ခုကို ပစ်မှတ်ထားပါတယ်။ Training က compute-bound ဖြစ်ပြီး inference decode က memory-bandwidth-bound ဖြစ်ပါတယ်။ 8i ရဲ့ architecture ကွာခြားချက်အများစုဟာ အဲဒီကနေ ဆင်းသက်လာပါတယ်။
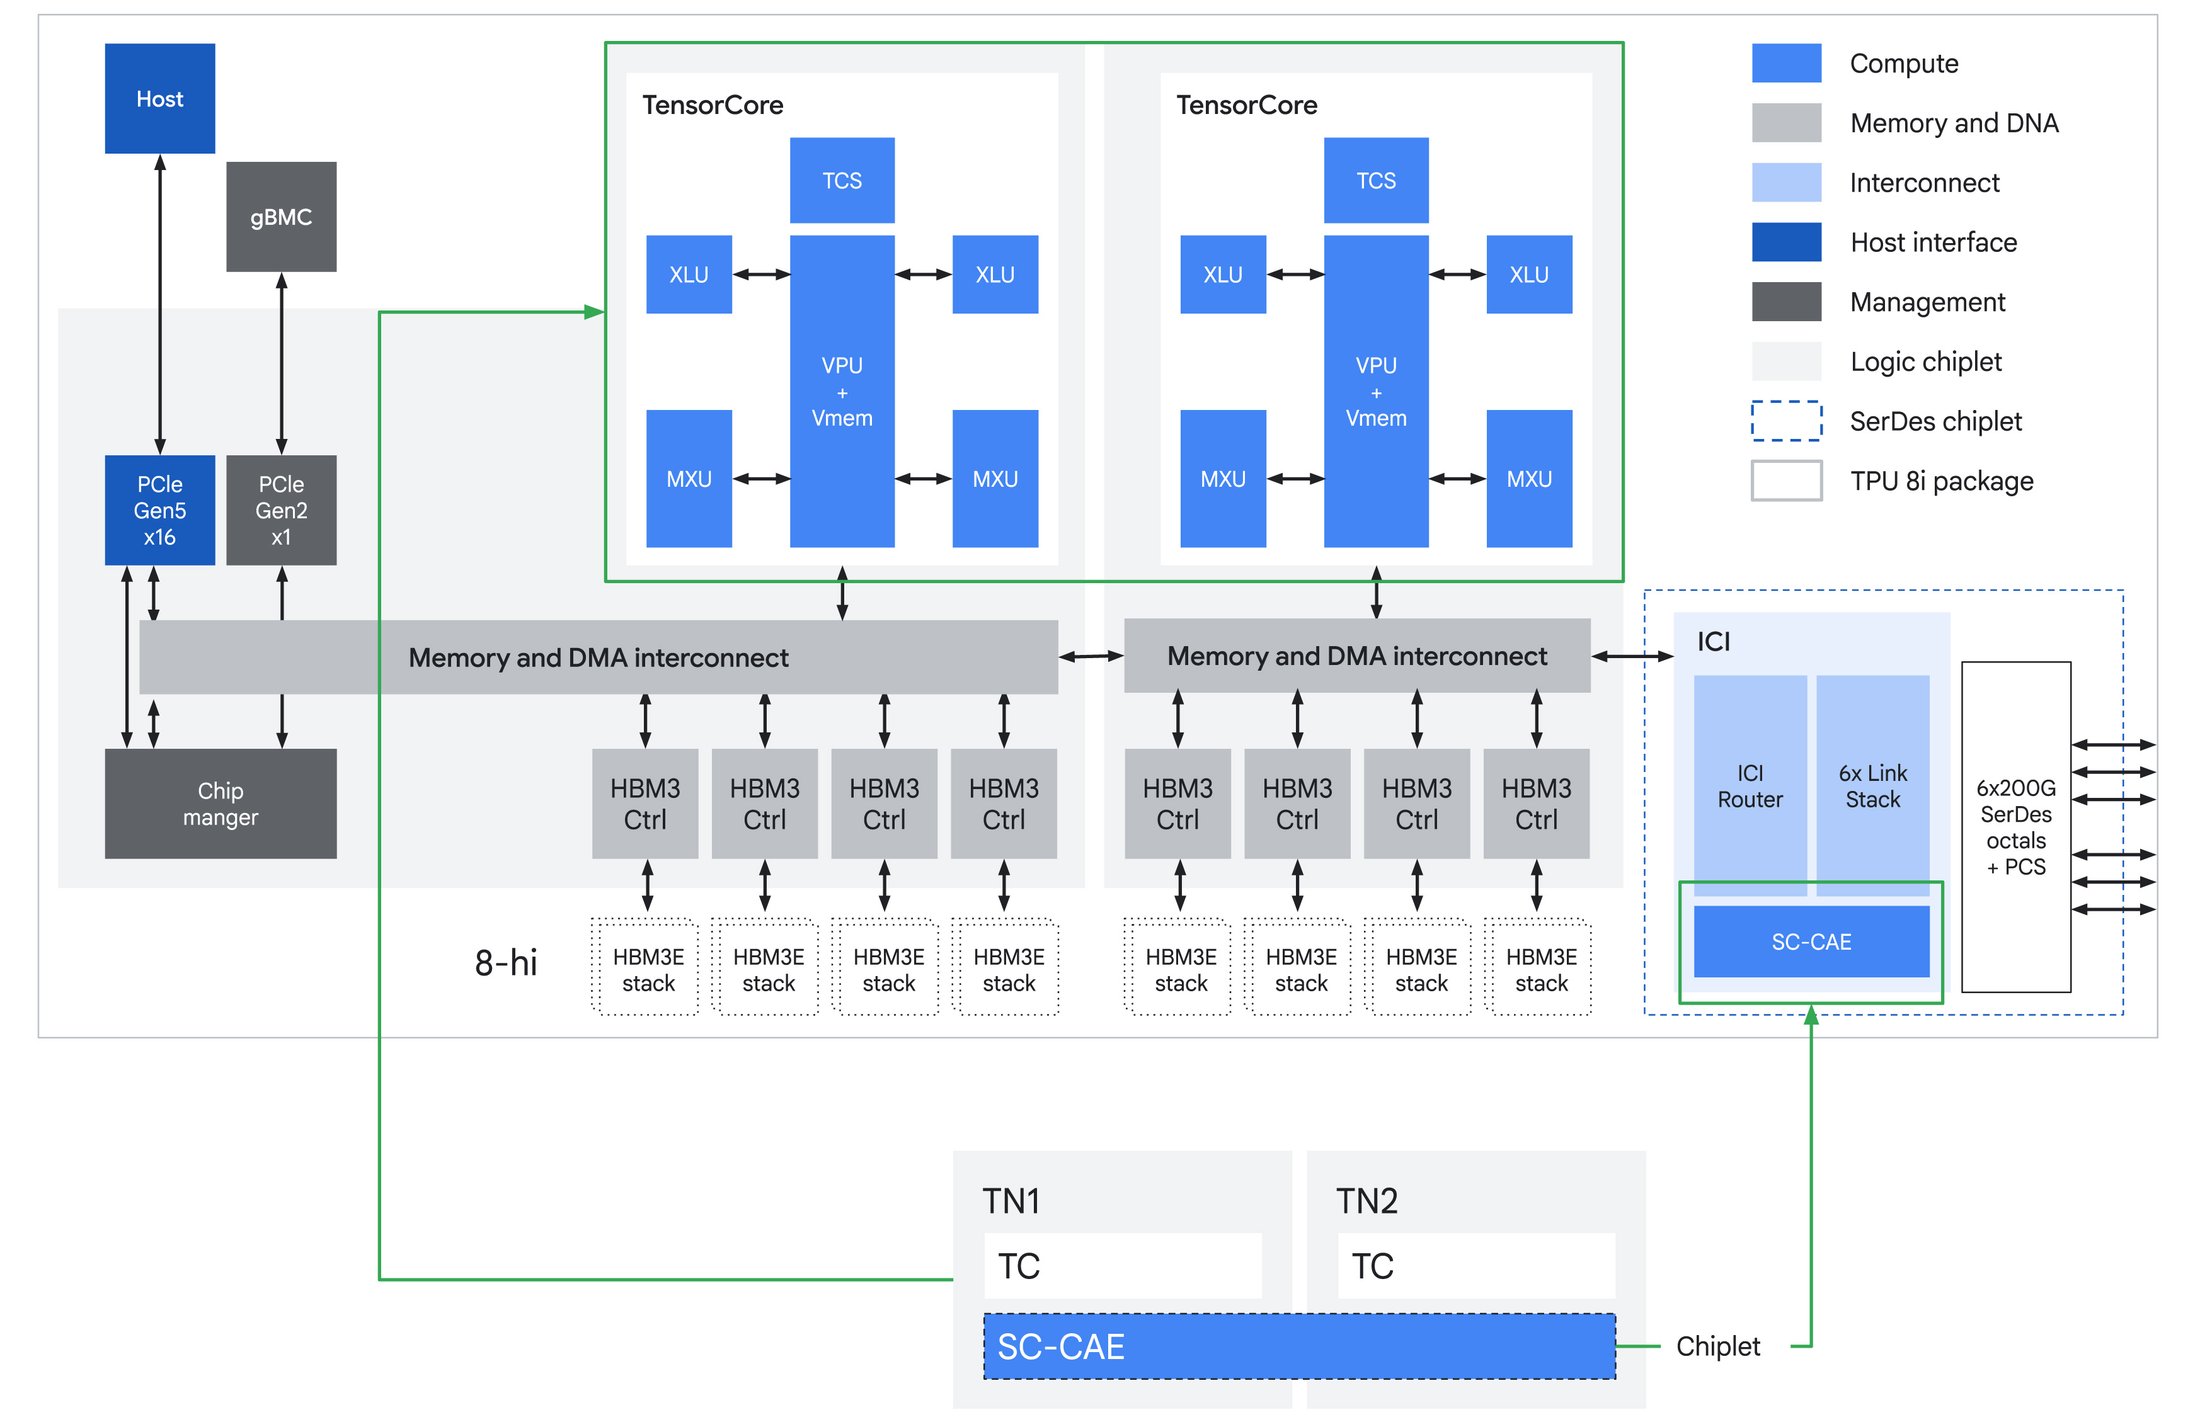
အကြီးမားဆုံးပြောင်းလဲမှုကတော့ on-chip SRAM ပါ။ 8i မှာ Vmem 384 MB ပါဝင်ပြီး Ironwood ထက် သုံးဆပိုများပါတယ်။ ဒီအရေးကြီးတဲ့အကြောင်းရင်းက KV cache ပါ။ long-context decoding လုပ်တဲ့အခါ generated token တစ်ခုချင်းစီမှာ ယခင် token တွေကနေ စုဆောင်းထားတဲ့ key-value state တွေကို ဖတ်ရှုဖို့ လိုအပ်ပါတယ်။ accelerator အများစုမှာ အဲဒီ read ဟာ HBM ကနေ လာတာဖြစ်ပြီး decode throughput ကို compute အစား memory bandwidth နဲ့ gated လုပ်ထားပါတယ်။ 8i ကို silicon ပေါ်မှာ အဓိပ္ပါယ်ရှိတဲ့ KV cache footprints တွေကို အပြည့်အဝသိမ်းဆည်းထားဖို့ အရွယ်အစားသတ်မှတ်ထားပါတယ်။ On-chip SRAM bandwidth ဟာ HBM ထက် အဆပေါင်းများစွာပိုများတာကြောင့် HBM အစား SRAM ကနေ ပေးပို့တဲ့ KV read တိုင်းဟာ per-token latency ပိုတိုပြီး power တူညီတဲ့အချိန်မှာ token-per-second ပိုမြင့်တာကို ဆိုလိုပါတယ်။
ရင်းမြစ်: Google က
TensorCore configuration က နောက်ထပ် အဓိက ကွဲပြားချက်တစ်ခုပါ။ 8t က TensorCore တစ်ခုတည်းကို 12.6 PFLOPS မှာ အသုံးပြုတဲ့အခါ၊ 8i က TensorCores နှစ်ခုကို compute လုပ်တဲ့အခါ ပေါင်းစပ် 10.1 PFLOPS မှာ ပိုင်းခြားပါတယ်။ chip level မှာ inference က ဘယ်လိုပုံစံလဲဆိုတာ မစဉ်းစားမချင်း peak throughput နိမ့်ကျနေပုံရပါတယ်။ Training workloads တွေက batch-dominated ပါ- matmul ကြီးတွေက fixed overhead ကို amortize လုပ်ပြီး၊ MXU ကြီးတစ်ခုကတော့ near-peak utilization ကို ထိန်းထားနိုင်ပါတယ်။ Inference decoding ကတော့ ပြောင်းပြန်ပါပဲ။ Batch size တွေက သေးငယ်ပြီး per-token compute windows တွေက တိုတောင်းပြီး chip က သူ့ရဲ့အချိန်ရဲ့ အစိတ်အပိုင်းတစ်ခုကို pure matmul အစား collectives၊ sampling နဲ့ routing မှာ အသုံးပြုပါတယ်။ အင်ဂျင်ကြီးတစ်ခုဟာ အဲဒီ irregular gaps တွေအတွင်းမှာ ရပ်တန့်သွားပါတယ်။ TensorCores နှစ်ခုအဖြစ် ပိုင်းခြားခြင်းက 8i ကို compute phases တွေကို ပိုမိုထိရောက်စွာ overlap လုပ်စေပြီး TensorCore တစ်ခုစီကို သူ့ရဲ့ကိုယ်ပိုင် directly attached HBM stack လေးခုကနေ ထောက်ပံ့ပေးပြီး package တစ်လျှောက်မှာ 8.6 TB/s မှာ စုစုပေါင်း 288 GB ရှိပါတယ်။ ရလဒ်အနေဖြင့် အပြန်အလှန်တုံ့ပြန်နိုင်သော ဝန်ဆောင်မှုတွင် အမှန်တကယ်လည်ပတ်သည့် အသုတ်အရွယ်အစားများတွင် ပိုမိုမြင့်မားသော ရေရှည်အသုံးပြုမှုဖြစ်သည်။
domain scale-up level မှာ Boardfly pod ထဲက active chip ၁၀၂၄ ခုဟာ HBM ၂၉၅ TB ခန့်၊ on-chip SRAM ၃၈၄ GB နဲ့ FP4 compute ၁၀.၃ EFLOPS အထိ စုစည်းထားပါတယ်။ SRAM နံပါတ်က ကောက်ချက်ချဖို့အတွက် အရေးကြီးဆုံးပါပဲ- domain တစ်လျှောက်မှာ on-chip cache ၃၈၄ GB က HBM ကို မထိဘဲ KV state ကို ထိန်းထားဖို့ လုံလောက်ပါတယ်၊ ဒါကြောင့် latency နည်းတဲ့ long-context serving ကို အသက်ဝင်စေပါတယ်။
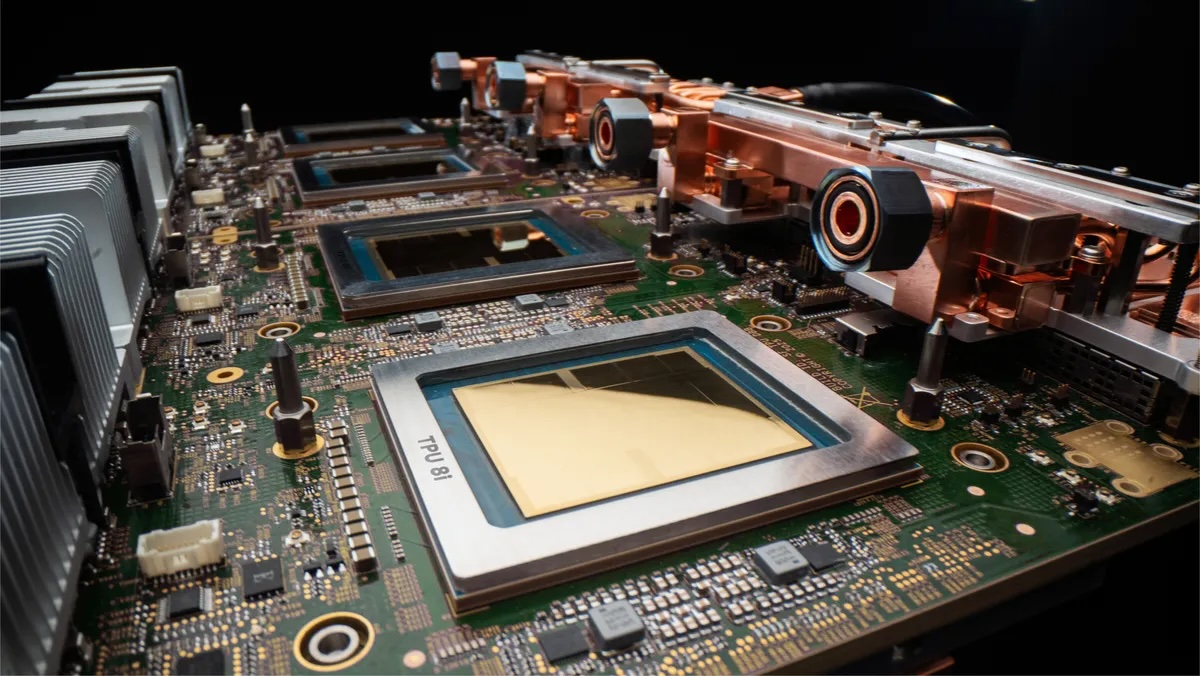
host ဘက်ခြမ်းကလည်း အဲဒီယုတ္တိဗေဒကိုပဲ လိုက်နာပါတယ်။ Ironwood နဲ့ နှိုင်းယှဉ်ရင် 8i မှာ server တစ်ခုချင်းစီရဲ့ physical Axion host အရေအတွက် တိုးလာတယ်လို့ Google က ပြောပါတယ်။ Inference server တွေဟာ tokenization၊ sampling logic၊ routing၊ batching နဲ့ agent runtime orchestration တွေမှာ per-token time ရဲ့ nontrivial part of time ကို အသုံးပြုပါတယ်။ ဒီ overhead တွေဟာ model size ထက် concurrency နဲ့ scale လုပ်ရပြီး agent workloads တွေက generate လုပ်တဲ့ request rate တွေမှာ host ဟာ bottleneck ဖြစ်လာနိုင်ပါတယ်။ accelerator တစ်ခုချင်းစီရဲ့ host CPU ပိုများတာက ရိုးရှင်းတဲ့ ဖြေရှင်းချက်ပါပဲ။
စုပေါင်းအရှိန်မြှင့်အင်ဂျင်
နောက်ထပ် အဓိက on-die ပြောင်းလဲမှုကတော့ Ironwood မှာ ပါဝင်တဲ့ SparseCores လေးခုကို အစားထိုးတဲ့ Collectives Acceleration Engine ပါ။ SparseCores တွေဟာ MoE routing နဲ့ embedding lookups တွေကို dedicated gather-scatter hardware နဲ့ ကိုင်တွယ်ပေးတာကြောင့် 8i က မတူညီတဲ့ bottleneck အတွက် optimize လုပ်ပေးတဲ့ inference chip signals တွေကနေ သူတို့ကို ဖယ်ရှားလိုက်ပါတယ်။
bottleneck CAE address များသည် collective latency ဖြစ်သည်။ decoded token တိုင်းသည် ပါဝင်သော chip များကို synchronize လုပ်ရန် လိုအပ်သည်- attention output များကို အားလုံးလျှော့ချရမည်၊ expert routing metadata ကို broadcast လုပ်ရမည်၊ sampled token များသည် နောက်တစ်ဆင့်သို့ propagate လုပ်ရမည်။ GPU များတွင်၊ ဤညှိနှိုင်းမှုသည် NCCL မှတစ်ဆင့် software တွင် ဖြစ်ပေါ်ပြီး kernel launch များနှင့် network operations များ၏ sequence အဖြစ် collective များကို schedule လုပ်သည်။ 8i တွင်၊ CAE သည် TensorCores နှင့်အတူ ၎င်း၏ကိုယ်ပိုင် chiplet die ပေါ်တွင်တည်ရှိသော dedicated silicon တစ်ခုဖြစ်ပြီး hardware တွင် ဤ synchronization primitives များကို ကိုင်တွယ်သည်။
Google က Ironwood ထက် on-chip collective latency ၅ ဆအထိ လျော့နည်းတယ်လို့ ဆိုပါတယ်။ training-scale batch size တွေမှာဆိုရင် compute time က အဲဒီတိုးတက်မှုကို မျိုချသွားမှာဖြစ်ပြီး collective က step ရဲ့ အစိတ်အပိုင်းလေးတစ်ခုသာ ဖြစ်ပါတယ်။ batch အသေးလေးတွေနဲ့ interactive inference ရဲ့ per-token window တိုတိုလေးတွေမှာ collective latency က per-token time ကို လွှမ်းမိုးထားနိုင်တာကြောင့် ၅ ဆ လျော့ကျမှုဟာ တစ်စက္ကန့်ကို token နဲ့ token တစ်ခုချင်းစီရဲ့ ဈေးနှုန်းနဲ့ ပြသပါတယ်။
8i သည် 3D torus topology မှ Google မှ Boardfly ဟုခေါ်သော hierarchical topology သို့လည်း ရွေ့လျားသွားပြီး၊ ၎င်းသည် ring-collective bandwidth ကို all-to-all latency အတွက် လဲလှယ်ပေးသည့် Dragonfly မှ လှုံ့ဆော်ပေးသော hierarchical topology တစ်ခုဖြစ်သည်။ Boardfly ကို အောက်တွင် အသေးစိတ် စစ်ဆေးပါမည်။
ဘုတ်ဖလိုင်း တိုပိုလိုဂျီ
training နှင့် inference တို့သည် communication patterns များ မတူညီသောကြောင့် 8i သည် 8t ထက် မတူညီသော topology ကို အသုံးပြုသည်။
3D torus သည် ring collective များအတွက် အသင့်တော်ဆုံးဖြစ်သည်- chip တစ်ခုစီတွင် neighbor ခြောက်ခုရှိပြီး data သည် ring ပတ်လည်တွင် လည်ပတ်နေပြီး chip သည် မည်သည့် arbitrary traffic ကိုမျှ လမ်းကြောင်းမသတ်မှတ်ပါ။ လေ့ကျင့်မှုကို ဤ ring-friendly patterns များက လွှမ်းမိုးထားသောကြောင့် 8t သည် torus ကို ထိန်းသိမ်းထားခြင်းဖြစ်သည်။ ring all-reduce သည် torus ဝင်ရိုးတစ်ခုတည်းသို့ ပြီးပြည့်စုံစွာ map လုပ်သည်။ Frontier jobs များသည် ယေဘုယျအားဖြင့် တစ်ဖက်တွင် data parallelism၊ နောက်တစ်ဖက်တွင် tensor parallelism နှင့် တတိယတွင် pipeline parallelism တို့ကို ထားရှိသည်။ topology နှင့် workload ကို ကိုက်ညီစေသည်။
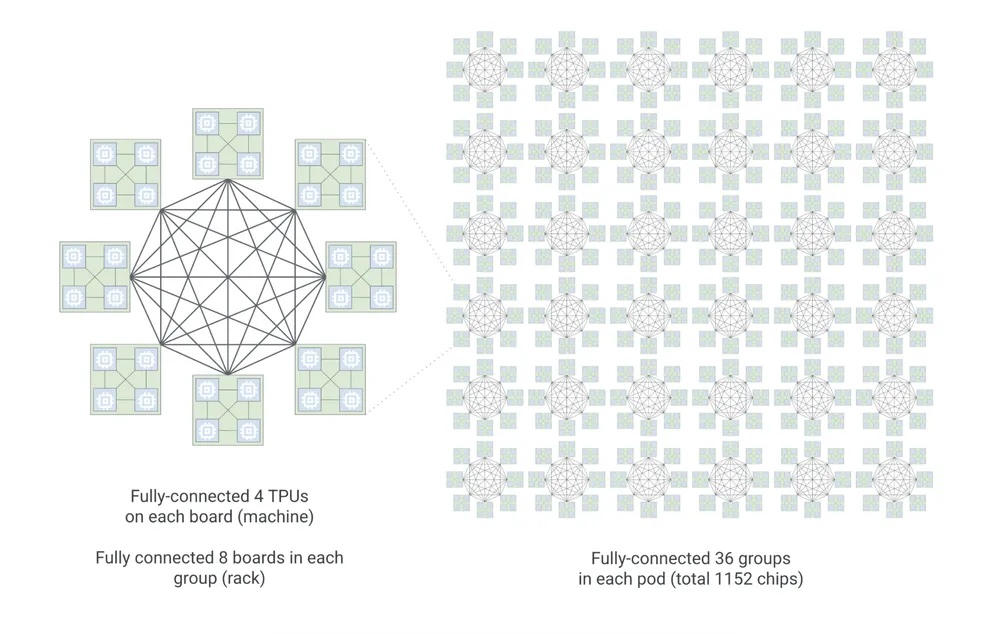
MoE မော်ဒယ်ကြီးတစ်ခုကို ဝန်ဆောင်မှုပေးသည့် ကောက်ချက်သည် ဆက်သွယ်ရေးပရိုဖိုင်ကွဲပြားသည်။ ကျွမ်းကျင်သူများကို ချစ်ပ်များစွာတွင် pin လုပ်ထားပြီး decode လုပ်ထားသော token တိုင်းသည် all-to-all ကို လှုံ့ဆော်ပေးသည်- token များသည် fabric တစ်လျှောက်တွင် ပြန့်ကျဲနေသော ၎င်းတို့၏ သတ်မှတ်ထားသော ကျွမ်းကျင်သူများထံ ရောက်ရှိရမည်ဖြစ်ပြီး ကျွမ်းကျင်သူ output များကို ပြန်ပေးရမည်။ ၎င်းသည် ring မဟုတ်ပါ။ ၎င်းသည် arbitrary point-to-point traffic ဖြစ်ပြီး 1,024-chip 3D torus တွင် မည်သည့်ချစ်ပ်နှစ်ခုကြားရှိ အဆိုးဆုံးလမ်းကြောင်းမှာ 16 hops ဖြစ်သည်။ Google သည် ဤသင်္ချာကို ကျွန်ုပ်တို့အတွက် ခွဲခြမ်းစိတ်ဖြာပေးသည် “3D torus တွင် node များကို dimension တစ်ခုစီသည် ring ကဲ့သို့ ရစ်ပတ်ထားသော grid တွင် စီစဉ်ထားသည်။ 8 x 8 x 16 (1024-chip) configuration တွင် အဝေးဆုံးချစ်ပ်သို့ ရောက်ရှိရန် packet တစ်ခုသည် ring တစ်ခုစီ၏ တစ်ဝက်အကွာအဝေးကို ဖြတ်သန်းရမည်-
၃D တိုရပ်စ် = ၈/၂(X) + ၈/၂(Y) + ၁၆/၂(Z) = ၁၆ ဟော့ပ်
torus သည် dense training ၏ ပုံမှန် အိမ်နီးချင်းမှ အိမ်နီးချင်းသို့ ဆက်သွယ်ရေးအတွက် အလွန်ထိရောက်မှုရှိသော်လည်း၊ ၎င်းသည် all-to-all ဆက်သွယ်ရေးပုံစံများအတွက် latency tax ကို ဖန်တီးပေးသည်။ မည်သည့်ချစ်ပ်မဆို token တစ်ခုကို route လုပ်ရန် အခြားချစ်ပ်တစ်ခုနှင့် စကားပြောရန် လိုအပ်နိုင်သည့် ကျိုးကြောင်းဆင်ခြင်သည့် မော်ဒယ်များနှင့် MoE ခေတ်တွင်၊ ဤ hop အရေအတွက်သည် အရေးပါပါသည်။
latency-sensitive interactive serving အတွက်၊ ထိုအပို hops များသည် per-token latency ကို ၎င်း၏ SLO ပြင်ပသို့ တွန်းပို့သည်။
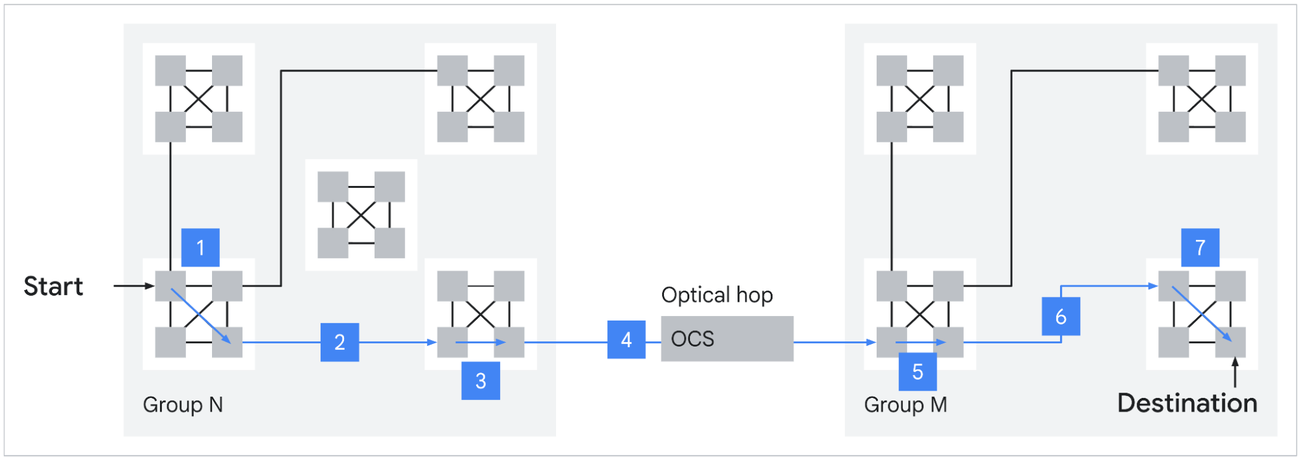
ရင်းမြစ်: Google က
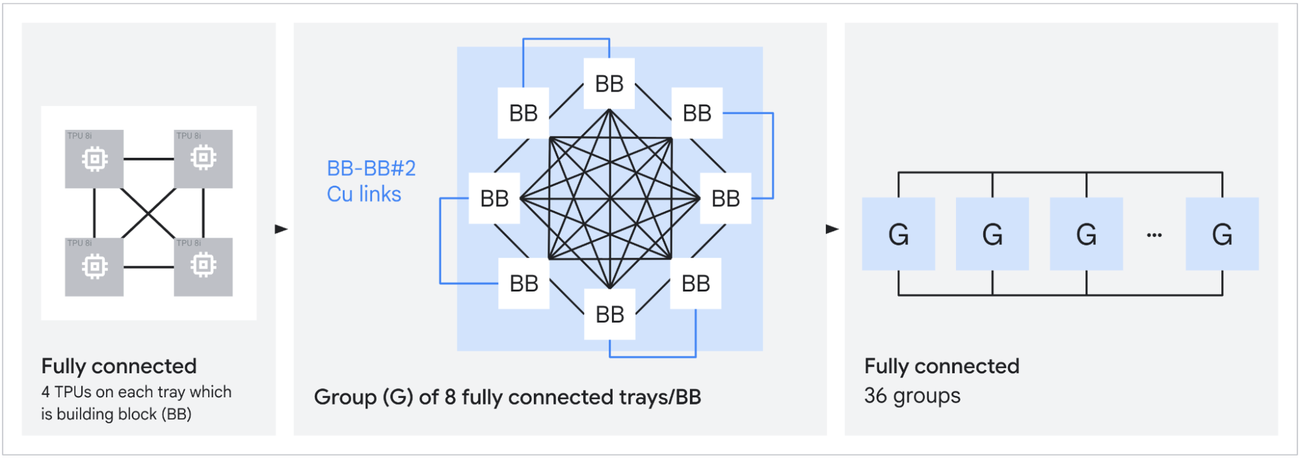
Boardfly သည် Dragonfly မှ လှုံ့ဆော်ပေးသော အဆင့်ဆင့်ပုံစံဖြစ်ပြီး ထိုအချင်းကို ချုံ့ရန် ဒီဇိုင်းထုတ်ထားသည်။ ဖွဲ့စည်းပုံတွင် အဆင့်သုံးဆင့်ရှိသည်။ building block သည် ပြင်ပချိတ်ဆက်မှု ၁၆ ခုပါသော ချစ်ပ်လေးလုံးပါသည့် ring တစ်ခုဖြစ်သည်။ ဤ building block ရှစ်ခုသည် အုပ်စုတစ်ခုဖွဲ့စည်းထားပြီး အုပ်စုတစ်ခုလျှင် ၁၁ ခုပါသော ကြေးနီကြိုးမှတစ်ဆင့် အပြည့်အဝချိတ်ဆက်ထားသည်။ အုပ်စု ၃၆ ခုသည် Optical Circuit Switches များမှတစ်ဆင့် ချိတ်ဆက်ပြီး pod တစ်ခုဖွဲ့စည်းသည်။ ရလဒ်အနေဖြင့် မည်သည့်ချစ်ပ်နှစ်ခုကြားတွင်မဆို အများဆုံး ၇ hop ရှိသည့် ၁၁၅၂-ချစ်ပ် scale-up domain (တက်ကြွသော ၁၀၂၄) ဖြစ်ပြီး torus ထက် ၅၆% လျော့နည်းသည်။ ၎င်းသည် MoE all-to-all ကဲ့သို့သော ဆက်သွယ်ရေးများစွာပါဝင်သော workloads များအတွက် latency ကို ၅၀% အထိ တိုးတက်မှုရရှိစေသည်ဟု Google က ပြောကြားခဲ့သည်။
ပိုမိုကြီးမားသော scale-up domain သည် ကျွမ်းကျင်သူမိတ္တူကူးခြင်းအတွက်လည်း အရေးပါပါသည်။ ICI fabric တစ်ခုလျှင် ချစ်ပ်များပိုမိုများပြားလာခြင်းသည် MoE ကြီးတစ်ခုရှိ ကျွမ်းကျင်သူတစ်ဦးချင်းစီကို အကြိမ်များစွာမိတ္တူကူးနိုင်သည်ဟု ဆိုလိုပြီး ၎င်းသည် routing မညီမျှမှုကို ချောမွေ့စေပြီး token ဖြန့်ဝေမှု စောင်းနေသည့်အခါ decode latency ကို တသမတ်တည်းထားရှိပေးသည်။ Top-k routing သည် data-dependent ဖြစ်ပြီး အချို့သောကျွမ်းကျင်သူများသည် မည်သည့်အဆင့်တွင်မဆို အခြားသူများထက် token များပိုမိုမြင်တွေ့ရမည်ဖြစ်သည်။ မိတ္တူကူးခြင်းသည် ထိုကွဲလွဲမှုကို စုပ်ယူသည်။ ရလဒ် traffic ကိုကိုင်တွယ်ရန် ICI bandwidth ကို ချစ်ပ်တစ်ခုလျှင် 19.2 Tb/s အထိ တစ်စိတ်တစ်ပိုင်းနှစ်ဆတိုးခဲ့သည်။
Virgo ကွန်ရက်
၉,၆၀၀-ချစ်ပ်ပါ superpod သည် ကြီးမားသော်လည်း frontier training run များသည် ပိုမိုလိုအပ်လာပါသည်။ Virgo သည် data center အတွင်းရှိ superpod များကို ချိတ်ဆက်ပေးသည့် scale-out fabric ဖြစ်ပြီး အလုပ်တစ်ခုသည် scale-up domain တစ်ခုတည်းထက် ကျော်လွန်သွားသည့်အခါ pod များအကြား အရှေ့-အနောက် RDMA traffic ကို ကိုင်တွယ်ပေးပါသည်။
Virgo fabric တစ်ခုတည်းသည် 8t ချစ်ပ်ပေါင်း ၁၃၄,၀၀၀ ကျော်ကို non-blocking bisectional bandwidth ၄၇ Pb/s ဖြင့် ချိတ်ဆက်ထားပြီး၊ ယခင်မျိုးဆက်ထက် per-accelerator bandwidth ထက် ၄ ဆအထိ ပိုများပြီး unloaded latency ၄၀% လျော့နည်းသည်။ ၎င်း၏ဗိသုကာလက်ရာသည် multi-planar ဒီဇိုင်းနှင့် လွတ်လပ်သောထိန်းချုပ်မှုဒိုမိန်းများပါရှိသော high-radix switches များတွင်တည်ဆောက်ထားသော flat၊ two-layer non-blocking topology ဖြစ်သည်။
ရိုးရာ Clos fabric များသည် port အရေအတွက်နှင့် ကုန်ကျစရိတ်များကို စီမံခန့်ခွဲနိုင်စေရန်အတွက် မြင့်မားသော tiers များတွင် oversubscribe လုပ်လေ့ရှိသည်။ traffic အများစုသည် မြောက်-တောင်ဖြစ်သည့်အခါတွင် ၎င်းသည် ကောင်းမွန်စွာအလုပ်လုပ်ပြီး ၎င်းသည် general-purpose cloud တွင် ပုံစံဖြစ်သည်- client များသည် load balancers များကို ထိမှန်ပြီး load balancers များသည် application server များကို ထိမှန်ပြီး application server များသည် storage များကို ထိမှန်သည်။ AI training workloads များသည် အရှေ့-အနောက် လုံးဝနီးပါးဖြစ်ပြီး fabric တစ်လျှောက် chip-to-chip ဖြစ်ကာ collective များသည် bisection-dominated ဖြစ်သည်။ မည်သည့် tier တွင်မဆို oversubscribe လုပ်ခြင်းသည် training step time အတွင်းသို့ တိုက်ရိုက်ကျဆင်းသွားသည်။ Virgo ၏ high-radix switch များပါရှိသော flat two-layer ဒီဇိုင်းသည် ASIC တစ်ခုလျှင် port လုံလောက်စွာပါဝင်သော switch များကို တည်ဆောက်ခြင်းဖြင့် spine-tier bottleneck ကို ဖယ်ရှားပေးသည်။
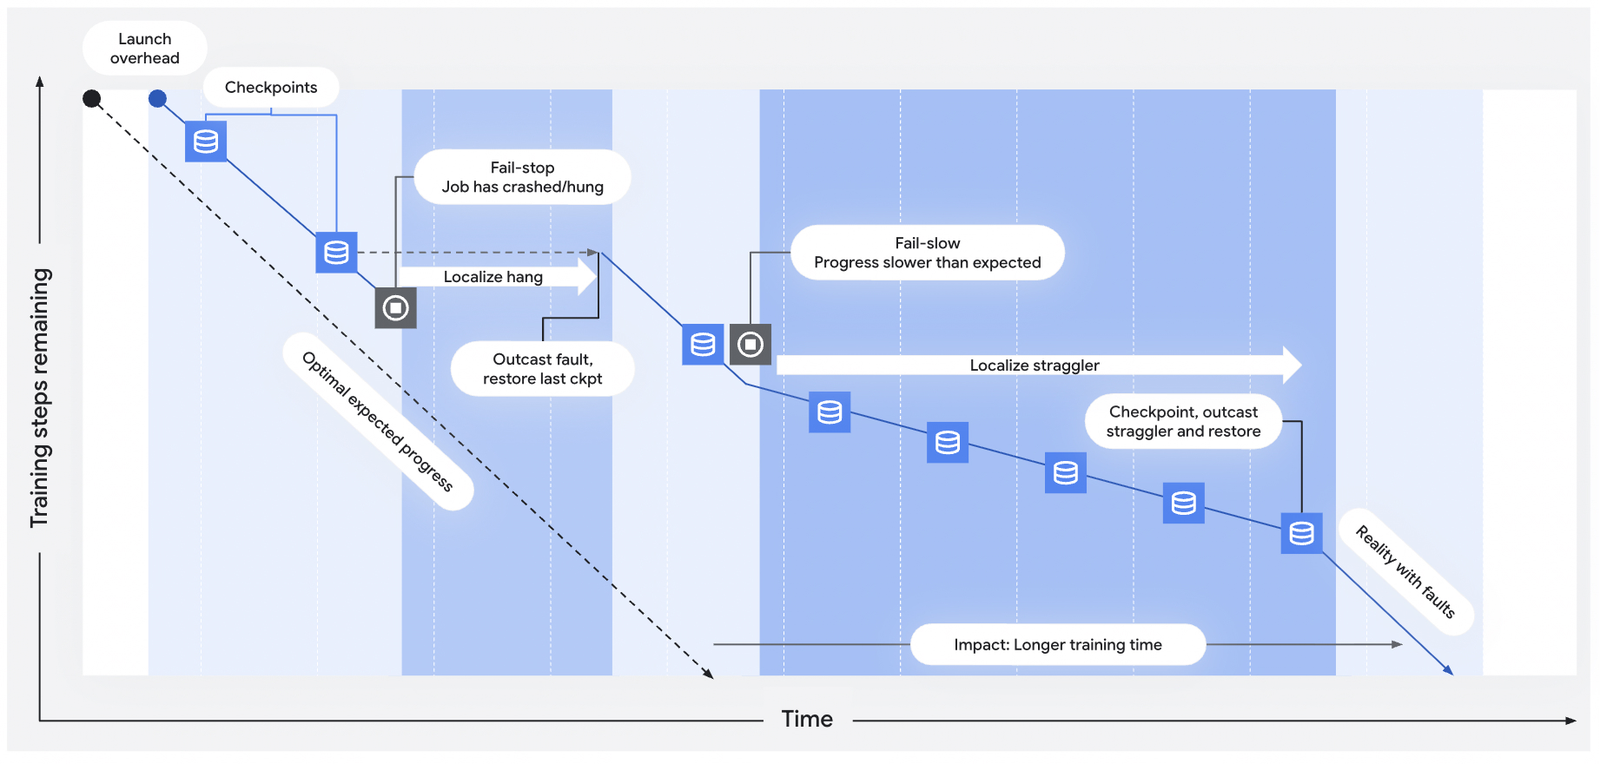
ဒီအတိုင်းအတာမှာ ယုံကြည်စိတ်ချရမှုအင်ဂျင်နီယာက အရေးပါပြီး Google ရဲ့ MEMS-based Optical Circuit Switches တွေပေါ်မှာ အများကြီးမူတည်ပါတယ်။ OCS က Google ကို ဘာမှပြန်မချိတ်ဆက်ဘဲ အလုပ်တွေကြားက ရုပ်ပိုင်းဆိုင်ရာ topology ကို ပြန်လည်ပြင်ဆင်နိုင်စေပြီး ပိုအရေးကြီးတာက ချို့ယွင်းနေတဲ့ chip တွေ ဒါမှမဟုတ် link တွေကို run အလယ်မှာ route လုပ်နိုင်ပါတယ်။ ချို့ယွင်းချက်တစ်ခုကို တွေ့ရှိတဲ့အခါ OCS က fabric ရဲ့ ထိခိုက်နေတဲ့အပိုင်းကို milliseconds အတွင်း ပြန်လည်မြေပုံလုပ်နိုင်ပြီး manual intervention လုပ်စရာမလိုတော့ပါဘူး။ sub-millisecond telemetry က automated straggler နဲ့ hang detection ကို feeds လုပ်ပါတယ်။ fast detection နဲ့ OCS-based rerouting ပေါင်းစပ်မှုက interrupts တွေကြားက mean time နဲ့ 100,000+ chip scale မှာ recovery လုပ်ဖို့ mean time ကို အကောင်းဆုံးဖြစ်အောင် လုပ်ပေးပါတယ်။ multi-week run အတွင်းမှာ ချို့ယွင်းချက်တချို့ရဲ့ statistical define က 100% နီးပါးရှိပါတယ်။ 8t pods အတွက် Google က ကိုးကားထားတဲ့ 97% goodput target က ဒီ infrastructure ပေါ်မှာ မူတည်ပါတယ်။ TPU stack တစ်လျှောက်မှာ OCS နည်းပညာက ပေါ်လာပါတယ်- ICI layer မှာ cube တွေကို superpod တွေအဖြစ် ချုပ်လုပ်တယ်၊ 8i scale-up layer မှာ Boardfly group တွေကို ချိတ်ဆက်တယ်၊ Virgo layer မှာ inter-pod traffic ကို ကိုင်တွယ်တယ်။
ချစ်ပ် ၁၃၄,၀၀၀ တွင် စုစုပေါင်းတွက်ချက်မှုသည် FP4 ၏ EFLOPS ၁,၆၉၀ ခန့် သို့မဟုတ် ၁.၇ ZFLOPS ခန့်သို့ ရောက်ရှိသည်။ Google ၏ ဗိသုကာလက်ရာသည် တစ်ခုတည်းသော logical training cluster တွင် ချစ်ပ်တစ်သန်းအထိ near-linear scaling ကို ပံ့ပိုးပေးသည်ဟု ဖော်ပြသော်လည်း လက်ရှိဖြန့်ကျက်မှုများသည် ထိုအမြင့်ဆုံးအဆင့်သို့ မရောက်ရှိသေးပါ။
ဂျူပီတာနှင့် ဘက်စုံဒေတာစင်တာ စကေး
Virgo သည် ဒေတာစင်တာအတွင်းရှိ အရှေ့-အနောက် accelerator traffic ကို ကိုင်တွယ်ပေးသော်လည်း၊ ၎င်းသည် stack ၏ထိပ်ဆုံးမဟုတ်ပါ။ Jupiter သည် Google ၏ရှိပြီးသား မြောက်-တောင် fabric ဖြစ်ပြီး၊ ယခုအခါ ၎င်း၏ ပဉ္စမမျိုးဆက်တွင် ရှိနေပြီး၊ front-end traffic နှင့် distributed storage နှင့် compute resources များသို့ ဝင်ရောက်ခွင့်ကို ကိုင်တွယ်ပေးပါသည်။ Jupiter ကို Cloud Next တွင် ကြေညာခြင်းမပြုခဲ့ပါ။ ၎င်းသည် 8th generation တွင် တည်ဆောက်ထားသော ရှိပြီးသား infrastructure ဖြစ်သည်။
နောက်ဆုံးပေါ် Jupiter ဗားရှင်းသည် ဒေတာစင်တာအဆောက်အအုံတစ်ခုလျှင် bisectional bandwidth 13 Pb/s ဖြင့် 99.999% ရရှိနိုင်မှုကို ပေးစွမ်းပြီး Apollo MEMS OCS switch များကို OCS တစ်ခုလျှင် 108 W ခန့်ဖြင့် အသုံးပြုထားပြီး ညီမျှသော electrical packet switch တစ်ခုအတွက် 3,000 W ခန့်သာ အသုံးပြုပါသည်။ ၎င်းသည် Google ၏ ဒေတာစင်တာများကို ပြင်ပကမ္ဘာနှင့် အချင်းချင်း ချိတ်ဆက်ပေးသည့် fabric ဖြစ်သည်။
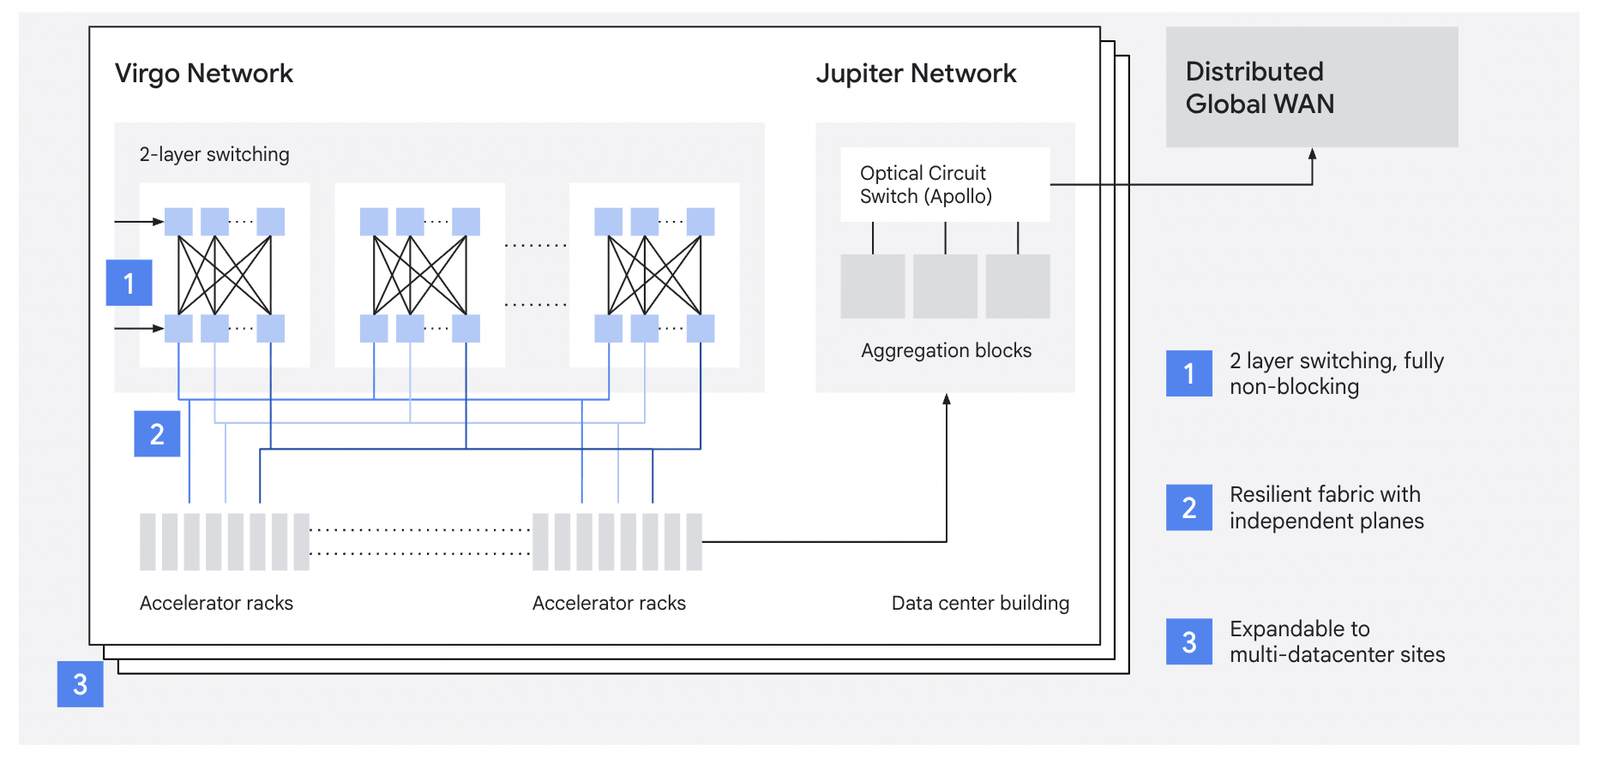
ဒေတာစင်တာတစ်ခုတည်း၏ စွမ်းအားနှင့် အာကာသထက်ကျော်လွန်သော လေ့ကျင့်မှုများအတွက် Jupiter သည် ဆိုက်များစွာတွင် တိုးချဲ့နိုင်စေပါသည်။ ပေါင်းစပ်မှုကို အလွှာလိုက်ဖော်ပြထားသည်- pod တစ်ခုအတွင်းရှိ ICI၊ ဆိုက်တစ်ခုအတွင်းရှိ pod များအကြား Virgo၊ ဆိုက်များအကြား Jupiter။ Google ၏ Pathways software stack သည် ဤ multi-data-center domain များတစ်လျှောက်ရှိ workloads များကို တစ်ခုတည်းသော logical cluster အနေဖြင့် ကိုင်တွယ်ဖြေရှင်းနိုင်သည်။
~1.7 ZFLOPS တွင် Virgo fabric တစ်ခုတည်းသည် ကြေငြာထားသော အကြီးဆုံး AI လေ့ကျင့်ရေး cluster ဖြစ်သည်။ Jupiter မှ ချိတ်ဆက်ထားသော Virgo fabric များစွာသည် TPU ချစ်ပ် တစ်သန်းကျော်ကို ကိုင်တွယ်ဖြေရှင်းနိုင်ပြီး လက်ရှိ ဖြန့်ကျက်မှုများ မရောက်ရှိသေးသည့်တိုင် Google ပစ်မှတ်ထားသည့် အတိုင်းအတာဖြစ်သည်။
ကောင်းမွန်သောစွမ်းဆောင်ရည်နှင့် အသုံးချမှု
အသုံးဝင်သောအလုပ်များကိုထုတ်လုပ်သည့် FLOP များ၏အစိတ်အပိုင်းထက် Raw FLOP များသည် အရေးမကြီးပါ။ Google သည် 8t superpod များအတွက် 97% goodput target ကိုကိုးကားပြီး wall-clock အချိန်၏ 97% ကို recovery၊ stalls သို့မဟုတ် coordination overhead ထက် productive compute အတွက်အသုံးပြုသည်။ ထိုကိန်းဂဏန်းသည် အထက်တွင်ဖော်ပြထားသော OCS-based fault tolerance နှင့် sub-millisecond telemetry ပေါ်တွင်မူတည်သည်။
မော်ဒယ် FLOPs အသုံးပြုမှု (MFU) သည် နောက်ထပ် variable တစ်ခုဖြစ်သည်။ MFU သည် တကယ့် workload တွင် chip သည် အမှန်တကယ် ခံနိုင်ရည်ရှိသော peak theoretical FLOP များ၏ အစိတ်အပိုင်းမည်မျှကို တိုင်းတာသည်။ SemiAnalysis ၏ ခန့်မှန်းချက်အရ 40% TPU MFU တွင်၊ ထိရောက်သော လေ့ကျင့်မှု FLOP တစ်ခုလျှင် ကုန်ကျစရိတ်သည် GB300 NVL72 နှင့် နှိုင်းယှဉ်ပါက 62% ခန့် ကျဆင်းသွားပြီး 15% ခန့် TPU MFU တွင် breakeven ရှိသည်။ Anthropic ၏ လူသိရှင်ကြားထုတ်ဖော်ထားသော TPU စီးပွားရေးအရ ၎င်းတို့သည် ထို breakeven ထက် များစွာ ပိုမိုကောင်းမွန်စွာ လည်ပတ်နေကြောင်း အကြံပြုထားသည်။ မြင့်မားသော goodput (ချစ်ပ်များကို လည်ပတ်နေစေသည်) နှင့် ယှဉ်ပြိုင်နိုင်သော MFU (ချစ်ပ်များကို လည်ပတ်နေစေသည်) ပေါင်းစပ်မှုသည် TPU TCO ကို စကေးဖြင့် အလုပ်လုပ်စေသည့်အရာဖြစ်သည်။
၈ ယောက်ထိုင်တဲ့နေရာ
TPU 8 ကို NVIDIA ရဲ့ လက်ရှိနဲ့ လာမယ့် platform တွေနဲ့ နှိုင်းယှဉ်ဖို့အတွက် unit တွေကို ဂရုတစိုက် အာရုံစိုက်ဖို့ လိုအပ်ပါတယ်။ NVIDIA က NVLink bandwidth ကို bidirectional aggregate အဖြစ် ကိုးကားပါတယ်။ 1.8 TB/s ရှိတဲ့ B200 က NVLink 5 မှာ direction တစ်ခုကို 900 GB/s ရှိပါတယ်။ NVIDIA ရဲ့ headline FLOP တွေက ပုံမှန်အားဖြင့် 2:4 sparse ဖြစ်ပြီး dense ကတော့ အဲဒီထက်ဝက်ပဲ ရှိပါတယ်။ Google ရဲ့ TPU နံပါတ်တွေက dense ဖြစ်ပြီး bidirectional ဖြစ်ပါတယ်။ နှိုင်းယှဉ်ချက်တစ်ခုခုကို ဖတ်တဲ့အခါ bandwidth က unidirectional ဒါမှမဟုတ် bidirectional ဟုတ်မဟုတ်နဲ့ FLOP တွေက dense ဒါမှမဟုတ် sparse ဟုတ်မဟုတ် စစ်ဆေးပါ။
ချစ်ပ်တစ်ခုလျှင် FP4၊ 12.6 PFLOPS သိပ်သည်းဆတွင် 8t သည် GB200 ၏ 10 PFLOPS sparse (5 PFLOPS သိပ်သည်းဆ) နှင့် GB300 ၏ 20 PFLOPS sparse (15 PFLOPS သိပ်သည်းဆ) အကြားတွင် တည်ရှိသည်။ ချစ်ပ်တစ်ခုလျှင် နှိုင်းယှဉ်ချက်မှာ နီးကပ်သည်။ scale-up နှိုင်းယှဉ်ချက်မှာမူ မဟုတ်ပါ။ GB300 NVL72 rack တွင် NVLink domain တစ်ခုတည်းတွင် GPU ၇၂ ခု ပါဝင်သည်။ 8t superpod တွင် တစ်ခုတည်းသော 3D torus တွင် ချစ်ပ် ၉,၆၀၀ ပါဝင်သည်။ ဆိုလိုသည်မှာ တစ်ခုတည်းသော collective domain တွင် ချစ်ပ် ၁၃၃ ဆ ပိုများပြီး ၎င်းသည် frontier training အတွက် platform များကို ပိုင်းခြားထားသော ကွာဟချက်ဖြစ်သည်။
NVIDIA ကတော့ ရပ်တန့်မနေပါဘူး။ Vera Rubin ဟာ ၂၀၂၆ ခုနှစ် ဒုတိယနှစ်ဝက်မှာ package တစ်ခုအတွက် NVFP4 inference ၅၀ PFLOPS နဲ့ တင်ပို့ရောင်းချပါတယ် (ဒါပေမယ့် SemiAnalysis က အဲဒီကိန်းဂဏန်းက adaptive compression လို့ ယူဆလားလို့ မေးခွန်းထုတ်ထားပါတယ်)၊ 22 TB/s မှာ HBM4 ၂၈၈ GB နဲ့ 3.6 TB/s bidirectional မှာ NVLink ၆ တို့ ပါဝင်ပါတယ်။ ၂၀၂၇ ခုနှစ် ဒုတိယနှစ်ဝက်မှာ Rubin Ultra ဟာ reticle die လေးခုကို FP4 ၁၀၀ PFLOPS နဲ့ package တစ်ခုအတွက် HBM4e ၁ TB အထိ ရရှိအောင် ချုပ်လုပ်ပါတယ်။ Kyber NVL576 ဟာ 576 Rubin Ultra GPU တွေကို single rack မှာ 15 EFLOPS FP4 inference နဲ့ ချိတ်ဆက်ပေးပါလိမ့်မယ်။ အဲဒါက Google ရဲ့ scale-up အားသာချက်ကို ကျဉ်းမြောင်းစေပေမယ့် 576 GPU တွေဟာ 8t superpod ထက် အဆပေါင်းများစွာ သေးငယ်နေဆဲပါ။
ဦးဆောင်မှု ၈ ခုတွင်- scale-up domain size (ချစ်ပ် ၉,၆၀၀ နှင့် နှိုင်းယှဉ်ပါက GPU ၇၂ ခု၊ သို့မဟုတ် Kyber ပြီးနောက် ၅၇၆ ခု)၊ single-fabric scale (၄၇ Pb/s တွင် ချစ်ပ် ၁၃၄,၀၀၀+)၊ static XLA အချိန်ဇယားဆွဲခြင်းမှ ဆုံးဖြတ်နိုင်သော latency နှင့် TPU မော်ဒယ်နှင့် ကိုက်ညီသော workloads အတွက် TCO။
လမ်းကြောင်း ၈ ခုရှိသည်- ချစ်ပ်တစ်ခုလျှင် HBM စွမ်းရည် (Rubin ၏ 288 GB HBM4 နှင့် နှိုင်းယှဉ်ပါက 216 GB)၊ ကွဲပြားမှု (NVIDIA တွင် 2:4 hardware path ရှိပြီး Google တွင် မပါ) နှင့် ecosystem breadth (CUDA၊ cuDNN၊ TensorRT-LLM နှင့် PyTorch-first serving stack သည် NVIDIA တွင် ဦးစွာရောက်ရှိပြီး TPU တွင် native PyTorch သည် preview ဖြစ်နေဆဲ)။
ပလက်ဖောင်းနှစ်ခုစလုံးမှာ ဝယ်လိုအားရှိပါတယ်။ Meta ဟာ ၂၀၂၇ ခုနှစ်မှာ စတင်ပြီး သူ့ရဲ့ဒေတာစင်တာတွေမှာ Google TPU တွေကို ဖြန့်ကျက်ဖို့ ဒေါ်လာဘီလီယံပေါင်းများစွာတန်တဲ့ သဘောတူညီချက်တစ်ခုအတွက် ဆွေးနွေးနေတယ်လို့ သတင်းထွက်ပါတယ်။ ၂၀၂၆ ခုနှစ်အစောပိုင်းမှာ Cloud TPU ငှားရမ်းမှုတွေ ရှိလာနိုင်ပါတယ်။ တစ်ချိန်တည်းမှာပဲ Google Cloud က NVIDIA Vera Rubin NVL72 မှာ တည်ဆောက်ထားတဲ့ A5X instance တွေကို ကြေငြာခဲ့ပြီး single site အတွင်းမှာ Rubin GPU ၈၀,၀၀၀ နဲ့ multi-site ဖြန့်ကျက်မှုတွေမှာ GPU ၉၆၀,၀၀၀ အထိ တိုးချဲ့နိုင်ခဲ့ပါတယ်။ Google ဟာ နှစ်ခုလုံးကို အတိုင်းအတာတစ်ခုအထိ တည်ဆောက်နေပါတယ်။
အပြီးသတ်သည်
ရှစ်ခုမြောက်မျိုးဆက် TPU သည် တစ်ခုတည်းမဟုတ်ဘဲ ချစ်ပ်နှစ်ခုဖြစ်ပြီး အထွေထွေရည်ရွယ်ချက် AI workloads များအတွက်မဟုတ်ဘဲ ယခုအခါ ကြီးမားသော လေ့ကျင့်မှုနှင့် agentic inference ပုံစံအတွက် တည်ဆောက်ထားသည်။ 8t သည် superpod တစ်ခုလျှင် ချစ်ပ် ၉,၆၀၀ အထိ တိုးချဲ့နိုင်ပြီး Virgo fabric တစ်ခုလျှင် ချစ်ပ် ၁၃၄,၀၀၀+ အထိ တိုးချဲ့နိုင်သည်။ 8i သည် SparseCores ကို collective-acceleration silicon အတွက် လဲလှယ်ပြီး MoE မှ scale တွင် ဝန်ဆောင်မှုပေးရာတွင် လိုအပ်သော latency targets များကို ဖြည့်ဆည်းရန် 3D torus ကို Boardfly အတွက် လဲလှယ်သည်။ Vera Rubin၊ Rubin Ultra နှင့် Kyber တို့ပါဝင်သော NVIDIA ၏ roadmap သည် ၂၀၂၆-၂၀၂၇ တွင် ဤကွာဟချက်အချို့ကို ကျဉ်းမြောင်းစေမည်ဖြစ်သော်လည်း scale-up domain အားသာချက်မှာ ယခုအချိန်အထိ ဆက်လက်တည်ရှိနေသည်။ ချစ်ပ်ထောင်ပေါင်းများစွာတွင် mixture-of-experts မော်ဒယ်များကို လည်ပတ်နေသော frontier labs များအတွက် 8 သည် Grace Blackwell အတွက် ယုံကြည်စိတ်ချရသော အစားထိုးတစ်ခုဖြစ်ပြီး Meta ၏ ဆွေးနွေးမှုများက ဈေးကွက်သည် ထိုစျေးနှုန်းကို စတင်သတ်မှတ်နေကြောင်း အကြံပြုထားသည်။


 အမေဇုံ