

ဆန်ဟိုဆေးမှာကျင်းပတဲ့ GTC 2026 မှာ NVIDIA ရဲ့ CEO Jensen Huang က ကုမ္ပဏီရဲ့ နောက်မျိုးဆက် AI အခြေခံအဆောက်အအုံပလက်ဖောင်းနဲ့ ဆီလီကွန်၊ စနစ်၊ ဆော့ဖ်ဝဲနဲ့ ဂေဟစနစ်မိတ်ဖက်အဖွဲ့အစည်းတွေ ပါဝင်တဲ့ ကျယ်ပြန့်တဲ့ ကြေငြာချက်တွေကို အနှစ်ချုပ်ပြောကြားခဲ့ပါတယ်။ နိုင်ငံပေါင်း ၁၉၀ ကျော်က တက်ရောက်သူ ၃၀,၀၀၀ ကျော်နဲ့အတူ GTC 2026 ဟာ Blackwell မိတ်ဆက်ပြီးနောက်ပိုင်း NVIDIA ရဲ့ အပြည့်စုံဆုံးပလက်ဖောင်း ပြန်လည်ဆန်းသစ်မှုအတွက် စင်မြင့်အဖြစ် ဆောင်ရွက်ခဲ့ပြီး Vera Rubin ဗိသုကာလက်ရာရဲ့ အပြည့်အဝထုတ်လုပ်မှုနဲ့ NVIDIA ဒေတာစင်တာဂေဟစနစ်ထဲကို Groq 3 LPU နည်းပညာပေါင်းစပ်မှုတို့ကြောင့် အဓိကထားခဲ့ပါတယ်။ Huang က စင်မြင့်ပေါ်မှာ ပြောကြားခဲ့သလိုပဲ အေးဂျင့် AI ပြောင်းလဲမှုအမှတ် ရောက်ရှိလာပြီး Vera Rubin က NVIDIA က သမိုင်းတစ်လျှောက် အကြီးကျယ်ဆုံး အခြေခံအဆောက်အအုံတည်ဆောက်မှုလို့ ဖော်ပြထားတဲ့အရာကို စတင်လုပ်ဆောင်နေပါတယ်။
အဓိကအချက်၏ အဓိကအကြောင်းအရာမှာ စတုတ္ထမြောက် AI scaling ဥပဒေတစ်ရပ် ပေါ်ပေါက်လာခြင်းဖြစ်သည်- agentic scaling ဖြစ်ပြီး၊ AI စနစ်များသည် လူသားများနှင့်သာမက အခြား AI အေးဂျင့်များနှင့်ပါ ဆက်သွယ်ပြောဆိုကာ မကြုံစဖူး စကေးဖြင့် latency နည်းပါးပြီး ကျယ်ပြန့်သော အခြေအနေဆိုင်ရာ ကောက်ချက်ချမှုအတွက် အဆမတန် চাহিদাကို မောင်းနှင်သည်။ NVIDIA သည် ဤနယ်ပယ်အသစ်ကို ဝန်ဆောင်မှုပေးရန် Vera Rubin ပလက်ဖောင်းကို အခြေခံအဆောက်အအုံအုတ်မြစ်အဖြစ် နေရာယူခဲ့သည်။ ၎င်းသည် AI စက်ရုံအတွက် ရည်ရွယ်ချက်ရှိရှိ တည်ဆောက်ထားသော rack-scale စနစ်အသစ် ငါးခုတွင် ပူးတွဲဒီဇိုင်းထုတ်ထားသော ချစ်ပ်ခုနစ်ခုကို ပေါင်းစပ်ထားသည်။ ထိုပလက်ဖောင်းသည် Frontier AI ဓာတ်ခွဲခန်းများမှ ထောက်ခံမှုများကိုလည်း ရရှိခဲ့သည်- Anthropic CEO နှင့် ပူးတွဲတည်ထောင်သူ Dario Amodei က “စီးပွားရေးလုပ်ငန်းများနှင့် developer များသည် ပိုမိုရှုပ်ထွေးသော ကျိုးကြောင်းဆင်ခြင်ခြင်း၊ agent workflow များနှင့် မစ်ရှင်-အရေးပါသော ဆုံးဖြတ်ချက်များအတွက် Claude ကို အသုံးပြုနေကြသည်။ ၎င်းသည် အရှိန်အဟုန်ကို လိုက်လျောညီထွေဖြစ်အောင် လုပ်ဆောင်နိုင်သော အခြေခံအဆောက်အအုံကို တောင်းဆိုသည်။ NVIDIA ၏ Vera Rubin ပလက်ဖောင်းသည် ကျွန်ုပ်တို့၏ဖောက်သည်များ မှီခိုနေရသော ဘေးကင်းမှုနှင့် ယုံကြည်စိတ်ချရမှုကို မြှင့်တင်နေစဉ်တွင် ဆက်လက်ပေးအပ်နိုင်ရန် compute၊ networking နှင့် system design ကို ပေးဆောင်သည်” ဟု ပြောကြားခဲ့သည်။ OpenAI CEO Sam Altman က “NVIDIA အခြေခံအဆောက်အအုံသည် AI ၏ နယ်ပယ်ကို ဆက်လက်တွန်းအားပေးနိုင်သည့် အခြေခံအုတ်မြစ်ဖြစ်သည်။ NVIDIA Vera Rubin ဖြင့် ကျွန်ုပ်တို့သည် ပိုမိုအစွမ်းထက်သော မော်ဒယ်များနှင့် အေးဂျင့်များကို ကြီးမားသော စကေးဖြင့် လည်ပတ်ပြီး လူသန်းပေါင်းများစွာထံ ပိုမိုမြန်ဆန်ပြီး ပိုမိုယုံကြည်စိတ်ချရသော စနစ်များကို ပေးအပ်သွားမည်ဖြစ်သည်။” ဟု ပြောကြားခဲ့သည်။
Vera Rubin ပလက်ဖောင်း- Agentic AI နယ်ပယ်ကို ဖွင့်လှစ်ခြင်း
CES 2026 တွင် ပထမဆုံးထုတ်ဖော်ပြသခဲ့သော Vera Rubin NVL72 ဗိသုကာကို အခြေခံ၍ GTC 2026 သည် ပလက်ဖောင်းကို ပြည့်စုံသော POD-scale AI factory ecosystem အဖြစ် တိုးချဲ့ခဲ့သည်။ NVIDIA သည် ၎င်းကို discrete chips နှင့် standalone server များမှ fully integrated rack-scale systems၊ pod-scale deployments နှင့် southern AI factories များဆီသို့ ပြောင်းလဲခြင်းအဖြစ် ပုံဖော်နေသည်။ Vera Rubin platform သည် NVIDIA Vera CPUs၊ Rubin GPUs၊ NVLink 6 Switches၊ ConnectX-9 SuperNICs၊ BlueField-4 DPUs၊ Spectrum-6 Ethernet Switches နှင့် အသစ်ပေါင်းစပ်ထားသော NVIDIA Groq 3 LPU တို့ကို ပေါင်းစပ်ထားပြီး၊ အားလုံးကို compute၊ networking နှင့် storage တစ်လျှောက်တွင် deep co-design ပါရှိသော တစ်ခုတည်းသော unified AI supercomputer အဖြစ် လည်ပတ်ရန် ဒီဇိုင်းထုတ်ထားပြီး ကမ္ဘာလုံးဆိုင်ရာ supply chain နှင့်အတူ MGX မိတ်ဖက် ၈၀ ကျော်၏ ecosystem မှ ပံ့ပိုးပေးထားသည်။

NVIDIA က ဒီပလက်ဖောင်းဟာ AI workloads တွေရဲ့ အပြည့်အဝ spectrum မှာ Blackwell generation နဲ့ နှိုင်းယှဉ်ရင် watt တစ်ခုလျှင် inference throughput ၁၀ ဆ အထိ ပိုများပြီး token တစ်ခုလျှင် cost ဆယ်ပုံတစ်ပုံ ပိုများတယ်လို့ ဆိုပါတယ်။ Mixture-of-Experts မော်ဒယ်ကြီးတွေကို လေ့ကျင့်ဖို့အတွက် Vera Rubin ဟာ ညီမျှတဲ့စွမ်းဆောင်ရည်ကို ရရှိဖို့အတွက် GPU လေးပုံတစ်ပုံသာ လိုအပ်ပါတယ်။ NVL72 ဟာ NVIDIA Quantum-X800 InfiniBand နဲ့ Spectrum-X Ethernet တို့နဲ့ ချောမွေ့စွာ ချိန်ညှိနိုင်တာကြောင့် ကြီးမားတဲ့ GPU cluster တွေမှာ အသုံးပြုမှုမြင့်မားနေစေပြီး လေ့ကျင့်ချိန်နဲ့ ပိုင်ဆိုင်မှုကုန်ကျစရိတ် စုစုပေါင်းကို လျှော့ချပေးပါတယ်။
မျိုးဆက်နှိုင်းယှဉ်ချက်- Blackwell Ultra vs. Vera Rubin NVL72
| specification | GB300 NVL72 (ဘလက်ဝဲလ် အာလ်ထရာ) | VR NVL72 (ဗီရာ ရူဘင်) |
|---|---|---|
| တွက်ချက်မှု ဗိသုကာ | ||
| GPU အရေအတွက် | Blackwell Ultra GPU ၇၂ ခု | Rubin GPU ၇၂ ခု |
| CPU အရေအတွက် | Grace CPU ၃၆ လုံး | Vera CPU ၃၆ လုံး |
| CPU ကို core | CPU တစ်ခုလျှင် ARM cores ၇၂ ခု | CPU တစ်ခုလျှင် Olympus ARM cores ၈၈ ခု |
| AI စွမ်းဆောင်ရည် | ||
| FP4 ကောက်ချက်ချမှု စွမ်းဆောင်ရည် | ၀.၅ အိတ်ဆာဖလော့ပ်များ | ၀.၅ အိတ်ဆာဖလော့ပ်များ |
| GPU တစ်ခုလျှင် NVFP4 (ကောက်ချက်ချခြင်း) | ၁၁.၁၅ PFLOPS | ၁၁.၁၅ PFLOPS |
| GPU တစ်ခုလျှင် NVFP4 (လေ့ကျင့်ရေး) | ၁၁.၁၅ PFLOPS | ၁၁.၁၅ PFLOPS |
| မှတ်ဉာဏ် | ||
| GPU မှတ်ဉာဏ်အမျိုးအစား | HBM3e | HBM4 |
| GPU Memory Bandwidth | ~၂၂ တီဘီ/စက္ကန့် | ~၂၂ တီဘီ/စက္ကန့် |
| Interconnection | ||
| NVLink ထုတ်လုပ်ခြင်း | NVLink ၆ | NVLink ၆ |
| NVLink Bandwidth (GPU တစ်ခုချင်းစီ) | ၁ TB / s | ၁ TB / s |
| Rack-Scale NVLink Bandwidth | ၁ TB / s | ၁ TB / s |
| Network | ||
| Scale-Out NIC | ConnectX-8 (၈၀၀ Gb/s) | ConnectX-9 (၁.၆ TB/s) |
| CPU-GPU အပြန်အလှန်ချိတ်ဆက်မှု | NVLink-C2C (၉၀၀ GB/s) | NVLink-C2C (၁.၈ TB/s) |
Vera Rubin-based ထုတ်ကုန်များကို ၂၀၂၆ ခုနှစ် ဒုတိယနှစ်ဝက်မှစတင်၍ မိတ်ဖက်များထံမှ ရရှိနိုင်မည်ဖြစ်သည်။ ထိပ်တန်း cloud provider များဖြစ်သည့် Amazon Web Services၊ Google Cloud၊ Microsoft Azure နှင့် Oracle Cloud Infrastructure အပြင် NVIDIA Cloud Partners CoreWeave၊ Crusoe၊ Lambda၊ Nebius၊ Nscale နှင့် Together AI တို့ ပါဝင်သည်။ ကမ္ဘာလုံးဆိုင်ရာ system ထုတ်လုပ်သူများဖြစ်သော Dell Technologies၊ HPE၊ Lenovo နှင့် Supermicro တို့သည် Vera Rubin ထုတ်ကုန်များအပေါ် အခြေခံသည့် server များအပြင် ASUS၊ Foxconn၊ GIGABYTE၊ Inventec၊ Pegatron၊ QCT၊ Wistron နှင့် Wiwynn တို့ကို ပေးပို့ရန် မျှော်လင့်ရသည်။
CPX မှ LPX သို့- NVIDIA ၏ Groq Acquisition သည် Decode Acceleration ကို မည်သို့ပြန်လည်ပုံဖော်ခဲ့သည်
မနှစ်က AI Infra Summit မှာ NVIDIA က CPX rack ကို long-context inference queries တွေကို အရှိန်မြှင့်ဖို့ ဒီဇိုင်းထုတ်ထားတဲ့ configuration နှစ်ခုနဲ့ ကြေညာခဲ့ပါတယ်။ အဲဒီကြေငြာချက်ကို ကျွန်တော်တို့ ဖော်ပြခဲ့တဲ့အခါ CPX ရဲ့ တကယ့်လုပ်ဆောင်ချက်နဲ့ ပတ်သက်ပြီး မေးခွန်းတွေ အများကြီး ပေါ်ပေါက်ခဲ့ပါတယ်။ ပထမတစ်ချက်ကြည့်လိုက်ရင် စိတ်ဝင်စားစရာ ဗိသုကာဆိုင်ရာ concept တစ်ခုဖြစ်ပေမယ့် CPX ဟာ Rubin GPU ထက် ကျော်လွန်ပြီး attention operations အတွက် အပိုအရှိန်မြှင့်ပေးတာကလွဲလို့ ဘာမှ ပေးစွမ်းနိုင်ပုံမပေါ်ပါဘူး။
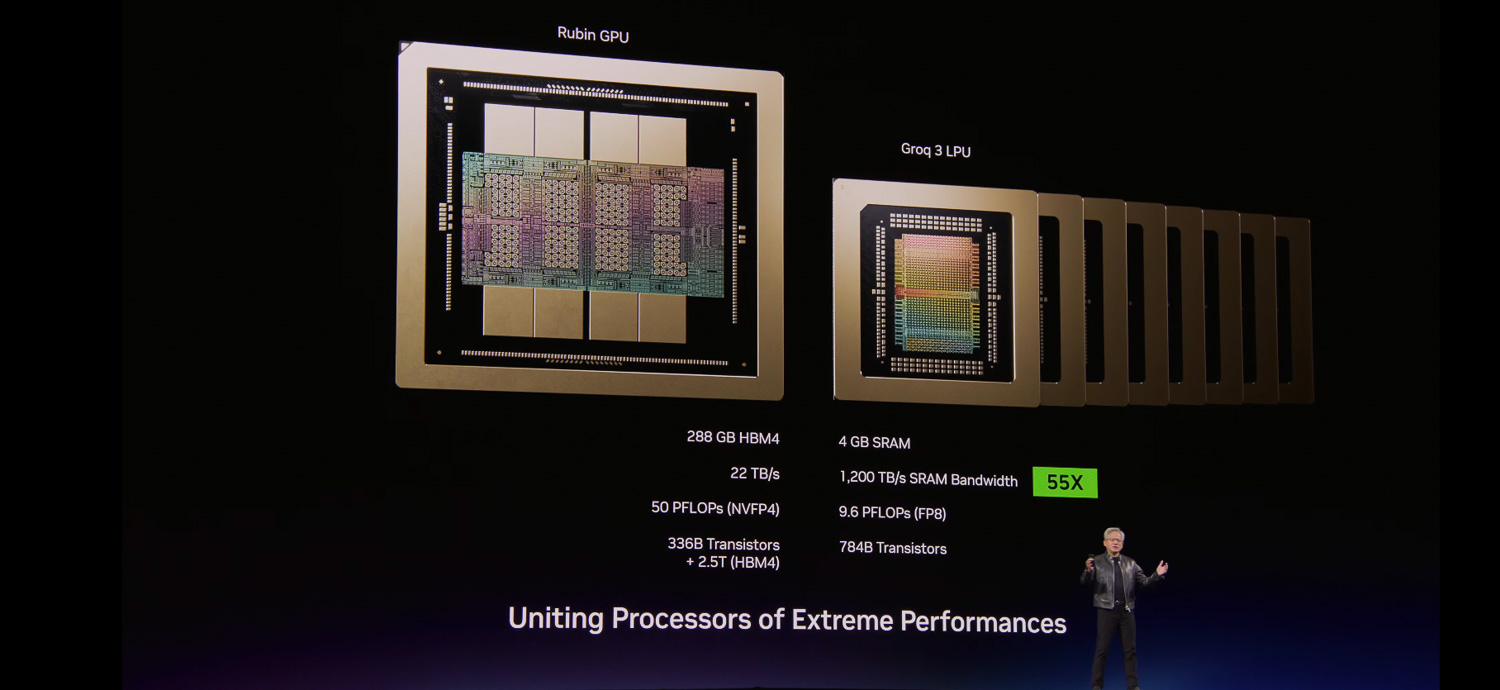
ထို့နောက် Groq ဝယ်ယူမှုသည် လုပ်ငန်းနယ်ပယ်တွင် အလွန်ရေပန်းစားခဲ့ပြီး NVIDIA သည် Groq ၏ LPU နည်းပညာကို ပိုမိုကျယ်ပြန့်သော Vera Rubin ပလက်ဖောင်းထဲသို့ မည်သို့ပေါင်းစပ်မည်နှင့်ပတ်သက်သည့် ထင်ကြေးများကို ဖြစ်ပေါ်စေခဲ့သည်။ NVIDIA သည် GTC 2026 တွင် LPX ကြေငြာချက်ဖြင့် ရှင်းလင်းသွားခဲ့သည်။ တင်ပြခဲ့သည့်အရာများအရ CPX rack သဘောတရားသည် Groq 3 LPX Rack အဖြစ် ပြောင်းလဲလာပုံရပြီး မူလ CPX ၏ context-processing အာရုံစိုက်မှုသည် Groq ၏ silicon ကို အခြေခံ၍ တည်ဆောက်ထားသော decode-acceleration ဗိသုကာကို အစားထိုးပေးခဲ့သည်။
Rubin GPU vs. Groq 3 LPU: ဖြည့်စွက်ဗိသုကာများ
| specification | ရူဘင် ဂရပ်ဖစ် | Groq 3 LPU (LP30) |
|---|---|---|
| memory အမျိုးအစား | HBM4 | Stacked SRAM |
| မှတ်ဉာဏ်စွမ်းရည် (ချစ်ပ်တစ်ခုလျှင်) | 288 GB ကို | 500 ကို MB |
| မှတ်ဉာဏ် Bandwidth | ၁ TB / s | ၁ TB / s |
| ခွန်အား | မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော လေ့ကျင့်မှုနှင့် ကြိုတင်ဖြည့်သွင်းမှု | အလွန်နှေးကွေးသော latency တိုကင်ဒီကုဒ် |
| ဖြန့်ကျက် | VR NVL72 (တစ်ရက်လျှင် ၇၂) | LPX Rack (Rack တစ်ခုလျှင် ၂၅၆ ခု) |
| စုစုပေါင်း ရက်ခ် မှတ်ဉာဏ် | ~၂၀.၇ တီဘီ HBM4 | 128 GB SRAM |
| Bandwidth ကို ချဲ့ထွင်ခြင်း (Rack) | တစ်စက္ကန့်လျှင် ၂၆၀ TB NVLink 6 | ၁ TB / s |
LPX Rack တစ်ခုတည်းတွင် Groq 3 LPU ၂၅၆ ခု ပါဝင်သည်။ LPU တစ်ခုစီတွင် stacked SRAM ၅၀၀ MB ခန့်ပါဝင်ပြီး၊ rack သည် ultra-low-latency decode acceleration အတွက် ရည်ရွယ်ချက်ရှိရှိ တည်ဆောက်ထားသော aggregate on-chip SRAM ၁၂၈ GB ခန့်နှင့် scale-up bandwidth ၆၄၀ TB/s ကို ပေးစွမ်းသည်။ processor အမျိုးအစားနှစ်ခုကြား ကွာခြားချက်မှာ ထင်ရှားသည်- Rubin GPU သည် 22 TB/s bandwidth တွင် HBM4 ၂၈၈ GB ကို ပေးစွမ်းပြီး LPU သည် raw bandwidth အတွက် စွမ်းရည်ကို လဲလှယ်ကာ chip တစ်ခုလျှင် ၎င်း၏ SRAM pool မှ ၁၅၀ TB/s ကို ပေးစွမ်းသည်။ custom Spectrum X-based interconnect မှတစ်ဆင့် VR NVL72 နှင့် ပူးတွဲဖြန့်ကျက်သောအခါ၊ rack နှစ်ခုသည် Rubin နှင့် Feed Forward layer များပေါ်တွင်ရှိပြီးသား attention decode ကို LPU များသို့ offload လုပ်ခြင်းဖြင့် decode token တိုင်းကို ပူးပေါင်းလုပ်ဆောင်ရန် ရည်ရွယ်ထားသည်။ trillion-parameter မော်ဒယ်များနှင့် million-token context အတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသော၊ ပူးတွဲဒီဇိုင်းထုတ်ထားသော LPX architecture သည် Vera Rubin နှင့် တွဲဖက်၍ power၊ memory နှင့် compute တို့တွင် စွမ်းဆောင်ရည်ကို အမြင့်ဆုံးဖြစ်စေသည်။ LPX Rack ကို MGX အခြေခံအဆောက်အအုံပေါ်တွင် တည်ဆောက်ထားပြီး အရည်ဖြင့် အအေးပေးစနစ် အပြည့်အဝ တပ်ဆင်ထားကာ ၂၀၂၆ ခုနှစ် ဒုတိယနှစ်ဝက်တွင် Vera Rubin ကို ပိုမိုကျယ်ပြန့်စွာ ဖြန့်ချိရောင်းချမည့်အချိန်နှင့် တိုက်ဆိုင်စွာ ရရှိနိုင်မည်ဖြစ်သည်။

အရေးကြီးတာက NVIDIA က CUDA ကို ပြောင်းလဲဖို့ မလိုအပ်ဘူးလို့ အတည်ပြုခဲ့ပါတယ်။ LPU ဟာ Vera နဲ့ NVL72 platform မှာ လည်ပတ်နေတဲ့ လက်ရှိ CUDA stack ရဲ့ accelerator အနေနဲ့ လုပ်ဆောင်ပြီး per-token basis ပေါ်မှာ တွက်ချက်မှုတွေကို ပွင့်လင်းမြင်သာစွာ offload လုပ်ပါတယ်။ GTC Q&A အတွင်းမှာ NVIDIA က LPU ကို “decode model booster” အဖြစ် ဖော်ပြခဲ့ပြီး သူတို့ဟာ “ဒီ trillion-parameter model တွေကို ဖြန့်ကျက်နေတဲ့ AI lab တွေနဲ့ AI frontier model builders တွေနဲ့ နက်နက်ရှိုင်းရှိုင်း ပူးပေါင်းလုပ်ဆောင်သွားမယ်” လို့ ရှင်းပြခဲ့ပြီး premium နဲ့ ultra-premium model ရဲ့ နောက်မျိုးဆက်ကို ဝန်ဆောင်မှုပေးနိုင်မှာပါ။ Groq ရဲ့ တည်ထောင်သူနဲ့ အင်ဂျင်နီယာ အများအပြားဟာ NVIDIA မှာ ပါဝင်လာခဲ့ပြီး အဖွဲ့နှစ်ဖွဲ့ကြား ပူးပေါင်းဆောင်ရွက်မှုဟာ MGX infrastructure ထဲကို တည်ဆောက်ဖို့ Groq roadmap ကို ဆွဲထုတ်လိုက်တဲ့အခါ အလွန်ကောင်းမွန်ခဲ့တယ်လို့ သတင်းထွက်ပါတယ်။ LPX ဖြန့်ကျက်မှုဟာ ကနဦးမှာ OEM ရရှိနိုင်မှု ကျယ်ပြန့်တာထက် model builders နဲ့ service provider တွေကို အာရုံစိုက်သွားမှာပါ။ NVIDIA နဲ့ Groq ပေါင်းစပ်မှုကနေ လက်တွေ့ကမ္ဘာရဲ့ စွမ်းဆောင်ရည် တိုးတက်မှုတွေကို မြင်တွေ့ရဖို့ မျှော်လင့်ပါတယ်။
Vera CPU Rack: အားဖြည့်သင်ယူမှုနှင့် အေးဂျင့်လုပ်ငန်းဝန်များအတွက် ရည်ရွယ်ချက်ရှိရှိတည်ဆောက်ထားသော ကွန်ပျူတာ
Agentic AI က CPU အမျိုးအစားအသစ်တစ်ခုကို ဘာကြောင့်တောင်းဆိုရတာလဲ။
NVIDIA ဘာကြောင့် dedicated CPU rack တစ်ခု တည်ဆောက်ခဲ့တယ်ဆိုတာ နားလည်ဖို့အတွက် ခေတ်သစ် AI ဖွံ့ဖြိုးတိုးတက်မှုရဲ့ post-training အဆင့်မှာ reinforcement learning (RL) ဘယ်လိုအလုပ်လုပ်လဲဆိုတာ နားလည်ဖို့ အထောက်အကူဖြစ်စေပါတယ်။ Post-training ဆိုတာ မော်ဒယ်တစ်ခုကို ကြီးမားတဲ့ dataset တစ်ခုမှာ ကြိုတင်လေ့ကျင့်ပြီးနောက် အဆင့်ဖြစ်ပြီး အဲဒီအဆင့်မှာ မော်ဒယ်ကို ပြန်လည်ပြုပြင်ပြီး target use cases တွေအတွက် အထူးပြုလုပ်ထားပါတယ်။
reinforcement learning setup မှာ training loop မှာ core components သုံးခုပါဝင်ပါတယ်- policy model (training လုပ်နေတဲ့ model)၊ model က action တွေလုပ်ပြီး feedback တွေလက်ခံရရှိတဲ့ environment နဲ့ အဲဒီ action တွေရဲ့ quality ကို အကဲဖြတ်တဲ့ reward signal တို့ဖြစ်ပါတယ်။ policy model က candidate output တွေကို generate လုပ်ပြီး environment မှာ execute လုပ်ကာ reward model က score ပေးပြီး ရလာတဲ့ gradient တွေကို policy ကို update လုပ်ဖို့အသုံးပြုပါတယ်။
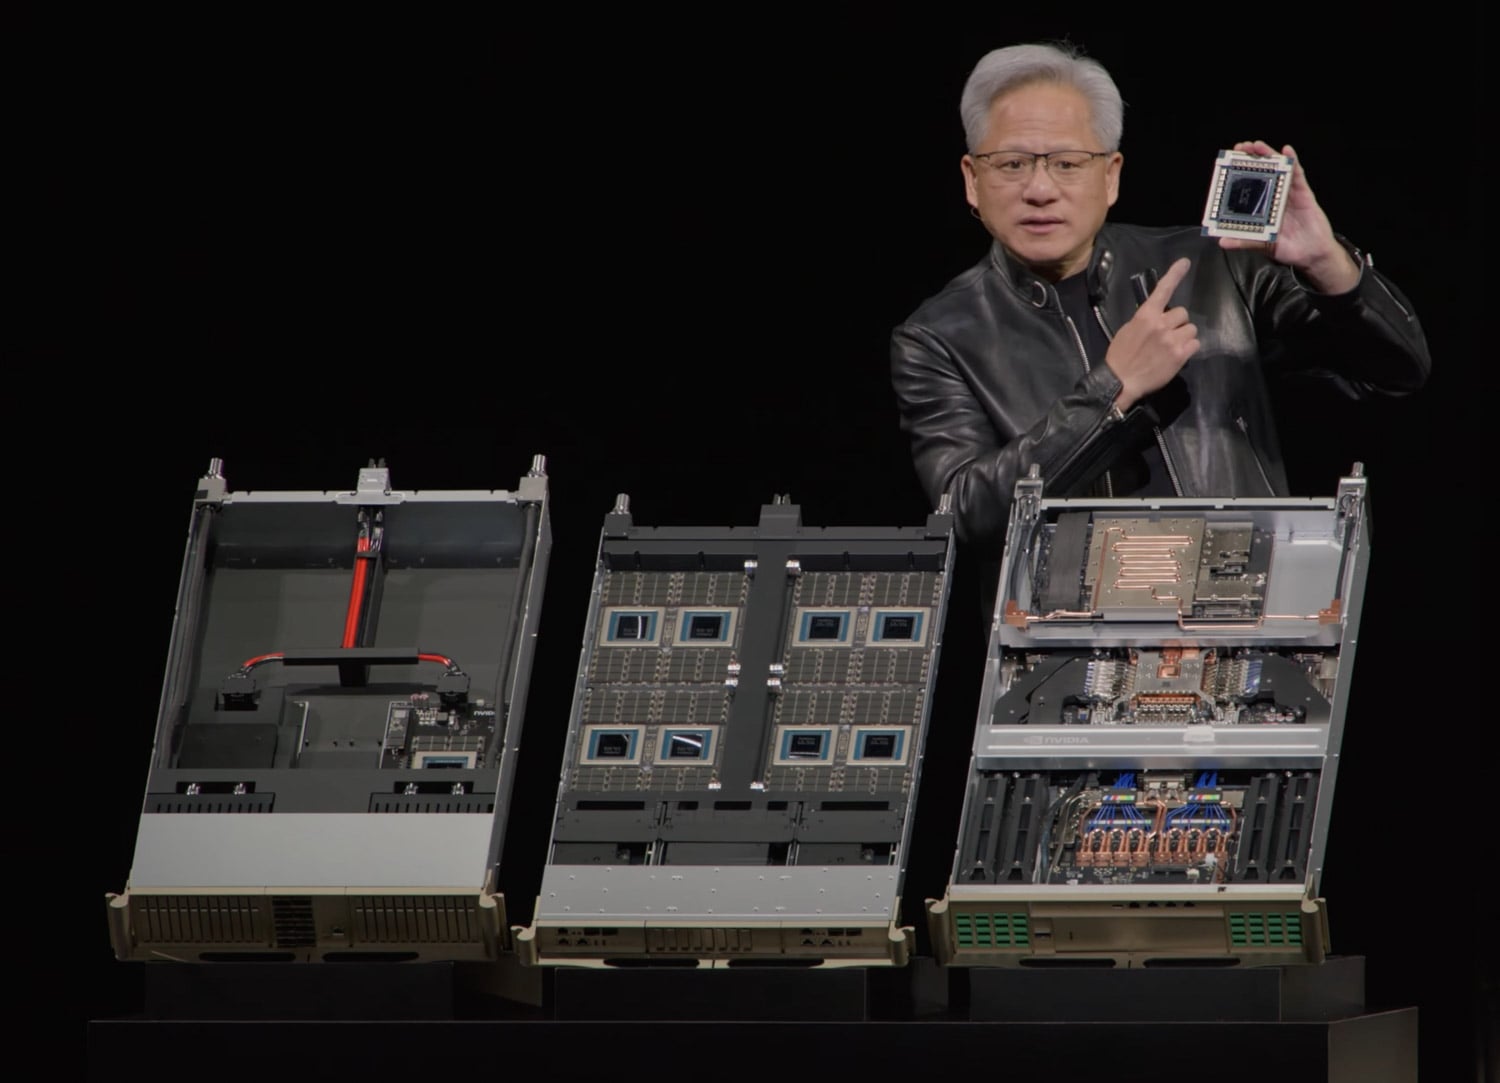
agentic AI workloads များအတွက်၊ ဤ RL environment သည် abstract simulation မဟုတ်ပါ။ ၎င်းသည် စစ်မှန်သော computational sandbox တစ်ခုဖြစ်သည်။ ဥပမာအားဖြင့် Claude Code သို့မဟုတ် အလားတူ autonomous coding agent များပါသည့် agent coding model တစ်ခုကို လေ့ကျင့်ပြီးနောက် စဉ်းစားကြည့်ပါ။ ဤစနစ်တွင်၊ သင်သည် တစ်ပြိုင်နက်တည်း လည်ပတ်နေသော compute pool သုံးခု လိုအပ်ပါသည်။ ပထမအချက်မှာ မူဝါဒပုံစံအလေးချိန်များကို အပ်ဒိတ်လုပ်သည့် GPU accelerators များ၏ လေ့ကျင့်ရေး pool တစ်ခုရှိသည်။ ဒုတိယအချက်မှာ inference accelerators များသည် လက်ရှိမူဝါဒပုံစံ checkpoint ကို လည်ပတ်ပြီး candidate action များ (ကုဒ်တည်းဖြတ်မှုများ၊ tool calls များ၊ file operations) ကို အတိုင်းအတာတစ်ခုအထိ ထုတ်လုပ်ပေးသည်။ တတိယအချက်နှင့် အရေးကြီးသည်မှာ၊ တကယ့် RL environments များ လည်ပတ်သည့် ရိုးရာ CPU compute pool ကြီးတစ်ခုရှိသည်။ ဤ environments များသည် agent များသည် ၎င်းတို့၏ generated code ကို execute လုပ်ခြင်း၊ test suites များကို လည်ပတ်ခြင်း၊ tool calls များ လုပ်ဆောင်ခြင်း၊ SQL queries များ ထုတ်ပေးခြင်း၊ binaries များကို compile လုပ်ခြင်း၊ file systems များနှင့် interact လုပ်ခြင်းနှင့် training loop ထဲသို့ feed back လုပ်သည့် reward signals များကို ထုတ်လုပ်သည့် sandbox operations အားလုံးကို လုပ်ဆောင်သည့်နေရာများဖြစ်သည်။
ဒီရိုးရာတွက်ချက်မှုလိုအပ်ချက်ရဲ့စကေးဟာ များပြားလှပါတယ်။ မူဝါဒပုံစံကနေ လုပ်ဆောင်တဲ့လုပ်ဆောင်ချက်တိုင်းဟာ အဆက်မပြတ် tool call အများအပြားကို ဖြစ်ပေါ်စေနိုင်ပြီး နောက်တစ်ဆင့်မလုပ်ဆောင်ခင်မှာ လုပ်ဆောင်၊ အကဲဖြတ်ပြီး ပြန်ပေးရပါမယ်။ လေ့ကျင့်ရေးလုပ်ငန်းစဉ်တစ်လျှောက်မှာ data point ထောင်ပေါင်းများစွာကို parallel မှာ generate လုပ်နေချိန်မှာ GPU လေ့ကျင့်ရေး cluster ဟာ environment execution မှာ ရပ်တန့်မသွားအောင် မြန်နှုန်းမြင့် CPU အများအပြား လိုအပ်ပါတယ်။ CPU sandbox pool ထဲက latency တိုင်းဟာ idle GPU cycle တွေနဲ့ training compute တွေကို အလဟဿဖြစ်စေပါတယ်။ ဖြန့်ကျက်ထားတဲ့ agent system တွေအတွက် inference time မှာလည်း အလားတူ dynamic သက်ရောက်မှုရှိပါတယ်။ agent တစ်ယောက်က လုပ်ဆောင်တဲ့ tool call၊ code compilation နဲ့ sandbox execution တိုင်းဟာ end-to-end agent pipeline ကို responsive ဖြစ်နေစေဖို့ CPU ရဲ့အလုပ်တွေဖြစ်ပါတယ်။ NVIDIA ရဲ့ press material တွေမှာ ဖော်ပြထားတဲ့အတိုင်း CPU ဟာ model ကို support လုပ်ရုံသက်သက်မဟုတ်တော့ပါဘူး။ မောင်းနှင်နေတာပါ။
Vera CPU Rack: NVIDIA ရဲ့ အဖြေ
ဤလိုအပ်ချက်ကို ဖြည့်ဆည်းရန်အတွက် NVIDIA သည် Vera CPU ကို မိတ်ဆက်ခဲ့ပြီး ကုမ္ပဏီက ကမ္ဘာ့ပထမဆုံး agentic AI နှင့် reinforcement learning ခေတ်အတွက် ရည်ရွယ်ချက်ရှိရှိ တည်ဆောက်ထားသော processor ဟု ခေါ်ဆိုသည်။ Vera CPU Rack သည် continuous CPU environment ၂၂,၅၀၀ ကျော်ကို ခံနိုင်ရည်ရှိပြီး တစ်ခုချင်းစီသည် အပြည့်အဝစွမ်းဆောင်ရည်ဖြင့် သီးခြားစီလည်ပတ်နိုင်သော liquid-cooled Vera processors ၂၅၆ ခုပါ၀င်သည့် dedicated rack-scale system တစ်ခုဖြစ်သည်။ AI factories များသည် single rack တွင် simultaneous instance များနှင့် agent tools ထောင်ပေါင်းများစွာကို လျင်မြန်စွာ deploy လုပ်ပြီး scale လုပ်နိုင်သည်။ rack သည် စုစုပေါင်း memory 400 TB၊ စုစုပေါင်း memory bandwidth 300 TB/s နှင့် BlueField-4 DPU ၆၄ ခုကို ပေးစွမ်းပြီး ၎င်းတို့အားလုံးသည် Vera Rubin နှင့် DGX ecosystems များနှင့် တွဲဖက်အသုံးပြုနိုင်ပြီး NVIDIA MGX modular reference architecture ပေါ်တွင် တည်ဆောက်ထားသည်။
Vera CPU ကိုယ်တိုင်က Armv9.2 အပြည့်အဝ တွဲဖက်အသုံးပြုနိုင်တဲ့ NVIDIA ဒီဇိုင်းထုတ်ထားတဲ့ Olympus cores ၈၈ ခုပေါ်မှာ တည်ဆောက်ထားပါတယ်။ core တစ်ခုစီက NVIDIA Spatial Multithreading ကို အသုံးပြုပြီး တစ်ပြိုင်နက်တည်း အလုပ်နှစ်ခုကို ပံ့ပိုးပေးပါတယ်။ ဒုတိယမျိုးဆက် low-power memory subsystem ကို LPDDR5X ပေါ်မှာ တည်ဆောက်ထားပြီး bandwidth 1.2 TB/s အထိ ပို့ဆောင်ပေးပြီး ယေဘုယျရည်ရွယ်ချက် CPU တွေနဲ့ နှိုင်းယှဉ်ရင် bandwidth နှစ်ဆပိုများပြီး ပါဝါရဲ့ ထက်ဝက်သာရှိပါတယ်။
စွမ်းဆောင်ရည်လက္ခဏာများအပြင် Vera Rack သည် လက်တွေ့ကျသော ထောက်ပံ့ရေးကွင်းဆက်ပြဿနာတစ်ခုကိုလည်း ကိုင်တွယ်ဖြေရှင်းပေးသည်- GPU ထောင်ပေါင်းများစွာဖြင့် AI စက်ရုံများကို လည်ပတ်နေသော အဖွဲ့အစည်းများသည် ပတ်ဝန်းကျင်လုပ်ဆောင်မှုအတွက် CPU များစွာ လိုအပ်ပြီး လိုအပ်သော အတိုင်းအတာနှင့် အချိန်ဇယားတွင် AMD သို့မဟုတ် Intel မှ မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော x86 ပရိုဆက်ဆာများကို ရယူခြင်းသည် သိသာထင်ရှားသော ဝယ်ယူမှုနှင့် ရရှိနိုင်မှုဆိုင်ရာစိန်ခေါ်မှုများကို ဖြစ်ပေါ်စေနိုင်သည်။ ဒေါင်လိုက်ပေါင်းစပ်ထားသော NVIDIA CPU rack သည် ထိုမှီခိုမှုကို ရိုးရှင်းစေသည်။
Vera CPU ကို ဖြန့်ကျက်ရန် NVIDIA နှင့် ပူးပေါင်းလုပ်ဆောင်သော ဖောက်သည်များတွင် Alibaba၊ ByteDance၊ Meta နှင့် Oracle Cloud Infrastructure အပြင် CoreWeave၊ Crusoe၊ Lambda၊ Nebius၊ Nscale၊ Cloudflare၊ Together AI နှင့် Vultr တို့ ပါဝင်သည်။ ထုတ်လုပ်မှုမိတ်ဖက်များတွင် Dell Technologies၊ HPE၊ Lenovo၊ Supermicro၊ ASUS၊ Cisco၊ Foxconn၊ GIGABYTE နှင့် QCT အပါအဝင် အခြားသူများ ပါဝင်သည်။
BlueField-4 STX နှင့် NVIDIA CMX: Inference Context Memory Storage နောက်ကွယ်မှ Reference Architecture
CES 2026 မှာ NVIDIA က Inference Context Memory Storage (ICMS) platform ကို ကြေညာခဲ့ပါတယ်။ ဒါက large-scale LLM inference မှာ KV cache management အတွက် အထူးတည်ဆောက်ထားတဲ့ AI-native storage infrastructure အမျိုးအစားအသစ်ပါ။ GTC 2026 မှာ NVIDIA က reference architecture ကို ပံ့ပိုးပေးတဲ့ BlueField-4 STX ကို မိတ်ဆက်ခဲ့ပါတယ်။ ဒါက agentic context နဲ့ KV cache data အတွက် pod တစ်လျှောက် GPU memory ကို ချောမွေ့စွာ တိုးချဲ့ပေးတဲ့ modular design တစ်ခုပါ။ STX ရဲ့ ပထမဆုံး rack-scale implementation ကတော့ NVIDIA CMX context memory storage platform အသစ်ဖြစ်ပြီး scalable inference နဲ့ agentic system တွေအတွက် high-performance context layer နဲ့ GPU memory ကို တိုးချဲ့ပေးပါတယ်။
transformer-based inference ဘယ်လို scale လုပ်လဲဆိုတာ စစ်ဆေးကြည့်တဲ့အခါ dedicated storage tier တစ်ခုရဲ့ လိုအပ်ချက်က ရှင်းလာပါတယ်။ generated token တိုင်းဟာ attention mechanism ကနေတစ်ဆင့် အရင် token အားလုံးကို ဂရုစိုက်ရမှာဖြစ်ပြီး key-value (KV) cache က precomputed attention matrices တွေကို ပြန်လည်အသုံးပြုဖို့အတွက် သိမ်းဆည်းထားတာကြောင့် ပြန်လည်တွက်ချက်မှုကို ရှောင်ရှားနိုင်ပါတယ်။ ပြဿနာက KV cache size ဟာ sequence length နဲ့ batch size နဲ့အတူ တိုးလာတာပါ။ million-token context windows တွေမှာ concurrent request ထောင်ပေါင်းများစွာကို ကိုင်တွယ်ဖြေရှင်းတဲ့ multi-tenant environment တွေမှာ GPU HBM ကုန်ဆုံးသွားပါတယ်။ Operator တွေဟာ batch size တွေကို လျှော့ချရမယ်၊ context windows ကို တိုစေရမယ်၊ ဒါမှမဟုတ် GPU တွေ ထပ်ထည့်ရမယ်၊ ဒါတွေအားလုံးဟာ စီးပွားရေး ဒါမှမဟုတ် စွမ်းဆောင်ရည်ကို ကျဆင်းစေပါတယ်။
BlueField-4 STX သည် GPU HBM နှင့် ရိုးရာသိုလှောင်မှုကြားတွင်တည်ရှိသော KV cache access patterns အတွက် ရည်ရွယ်ချက်ရှိရှိတည်ဆောက်ထားသော high-bandwidth၊ shared storage layer ကို ပံ့ပိုးပေးခြင်းဖြင့် ဤပြဿနာကို ဖြေရှင်းပေးသည်။ ၎င်းကို Vera Rubin platform မှ အရှိန်မြှင့်ပေးပြီး Vera CPU နှင့် ConnectX-9 SuperNIC၊ Spectrum-X Ethernet networking၊ NVIDIA DOCA နှင့် NVIDIA AI Enterprise software တို့ကို ပေါင်းစပ်ထားသော storage-optimized BlueField-4 processor ကို အသုံးပြုသည်။ NVIDIA သည် CMX platform သည် ရိုးရာသိုလှောင်မှုနှင့် နှိုင်းယှဉ်ပါက တစ်စက္ကန့်လျှင် tokens ၅ ဆအထိ၊ ရိုးရာ CPU architectures များနှင့် နှိုင်းယှဉ်ပါက မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော သိုလှောင်မှုအတွက် ၄ ဆ ပိုမိုမြင့်မားသော စွမ်းအင်ထိရောက်မှုနှင့် enterprise AI data အတွက် ၂ ဆ ပိုမိုမြန်ဆန်သော data ingestion ကို ပေးဆောင်သည်ဟု ဆိုသည်။
NVIDIA သည် DOCA Memos ကိုလည်း မိတ်ဆက်လျက်ရှိပြီး ၎င်းသည် BlueField-4 storage ကို dedicated KV cache processing ဖြင့် အားဖြည့်ပေးသည့် DOCA framework အသစ်တစ်ခုဖြစ်ပြီး inference throughput ကို မြှင့်တင်ပေးသည့်အပြင် power efficiency ကို သိသိသာသာ တိုးတက်စေပါသည်။ ရလဒ်အနေဖြင့် AI agent များနှင့် multi-turn interaction များကို ပိုမိုမြန်ဆန်စွာ ပေးစွမ်းနိုင်သည့် POD-wide context၊ ပိုမိုကျယ်ပြန့်သော scalable AI ဝန်ဆောင်မှုများနှင့် ပိုမိုမြင့်မားသော overall infrastructure utilization ကို ပေးစွမ်းနိုင်သည့် အကျိုးကျေးဇူးများ ရရှိမည်ဖြစ်သည်။ ၎င်းသည် open-source NVIDIA Dynamo project နှင့် ချိတ်ဆက်ထားပြီး disaggregated prefill/decode phases၊ smart routing နှင့် tiered storage offloading အတွက် software framework ကို ပံ့ပိုးပေးပါသည်။
STX သည် NVIDIA မှ တိုက်ရိုက်ရောင်းချခြင်းမဟုတ်ဘဲ သိုလှောင်မှုဂေဟစနစ်မိတ်ဖက်များထံ ပံ့ပိုးပေးသည့် ရည်ညွှန်းဗိသုကာတစ်ခုဖြစ်သည်။ STX တွင် နောက်မျိုးဆက်အခြေခံအဆောက်အအုံကို ပူးတွဲဒီဇိုင်းထုတ်သော သိုလှောင်မှုပံ့ပိုးပေးသူများတွင် Cloudian၊ DDN၊ Dell Technologies၊ Everpure၊ Hitachi Vantara၊ HPE၊ IBM၊ MinIO၊ NetApp၊ Nutanix၊ VAST Data နှင့် WEKA တို့ ပါဝင်သည်။ STX-based စနစ်များကို တည်ဆောက်သည့် ထုတ်လုပ်မှုမိတ်ဖက်များတွင် AIC၊ Supermicro နှင့် QCT တို့ ပါဝင်သည်။ context memory storage အတွက် STX ကို လက်ခံကျင့်သုံးရန် စီစဉ်နေသော ထိပ်တန်း AI ဓာတ်ခွဲခန်းများနှင့် cloud ပံ့ပိုးပေးသူများတွင် CoreWeave၊ Crusoe၊ IREN၊ Lambda၊ Mistral AI၊ Nebius၊ Oracle Cloud Infrastructure နှင့် Vultr တို့ ပါဝင်သည်။ STX-based ပလက်ဖောင်းများကို ၂၀၂၆ ခုနှစ် ဒုတိယနှစ်ဝက်တွင် မိတ်ဖက်များထံမှ ရရှိနိုင်မည်ဖြစ်သည်။
Vera Rubin DSX AI Factory Reference Design နှင့် Omniverse DSX Blueprint
တစ်ဦးချင်း rack များနှင့် pod များအပြင် NVIDIA သည် Vera Rubin DSX AI Factory reference design နှင့် NVIDIA Omniverse DSX Blueprint ၏ ယေဘုယျရရှိနိုင်မှုကို ကြေညာခဲ့ပြီး၊ watt တစ်ခုလျှင် token များကို အမြင့်ဆုံးရရှိစေပြီး ပထမဆုံးထုတ်လုပ်မှုအချိန်ကို အရှိန်မြှင့်ပေးသည့် ပူးတွဲဒီဇိုင်းထုတ်ထားသော AI အခြေခံအဆောက်အအုံကို ဒီဇိုင်းဆွဲခြင်း၊ တည်ဆောက်ခြင်းနှင့် လည်ပတ်ခြင်းအတွက် ပြည့်စုံသော framework တစ်ခုကို ပံ့ပိုးပေးပါသည်။ compute၊ networking၊ storage၊ power နှင့် cooling တို့ကို တင်းကျပ်စွာ ပေါင်းစပ်ခြင်းဖြင့်၊ ဗိသုကာသည် စွမ်းအင်ထိရောက်မှုကို မြှင့်တင်ပေးပြီး AI factories များသည် စဉ်ဆက်မပြတ်၊ မြင့်မားသော intensity workloads များအောက်တွင် ယုံကြည်စိတ်ချစွာ တိုးချဲ့နိုင်စေပြီး အများဆုံး uptime ကို ထိန်းသိမ်းထားနိုင်စေပါသည်။
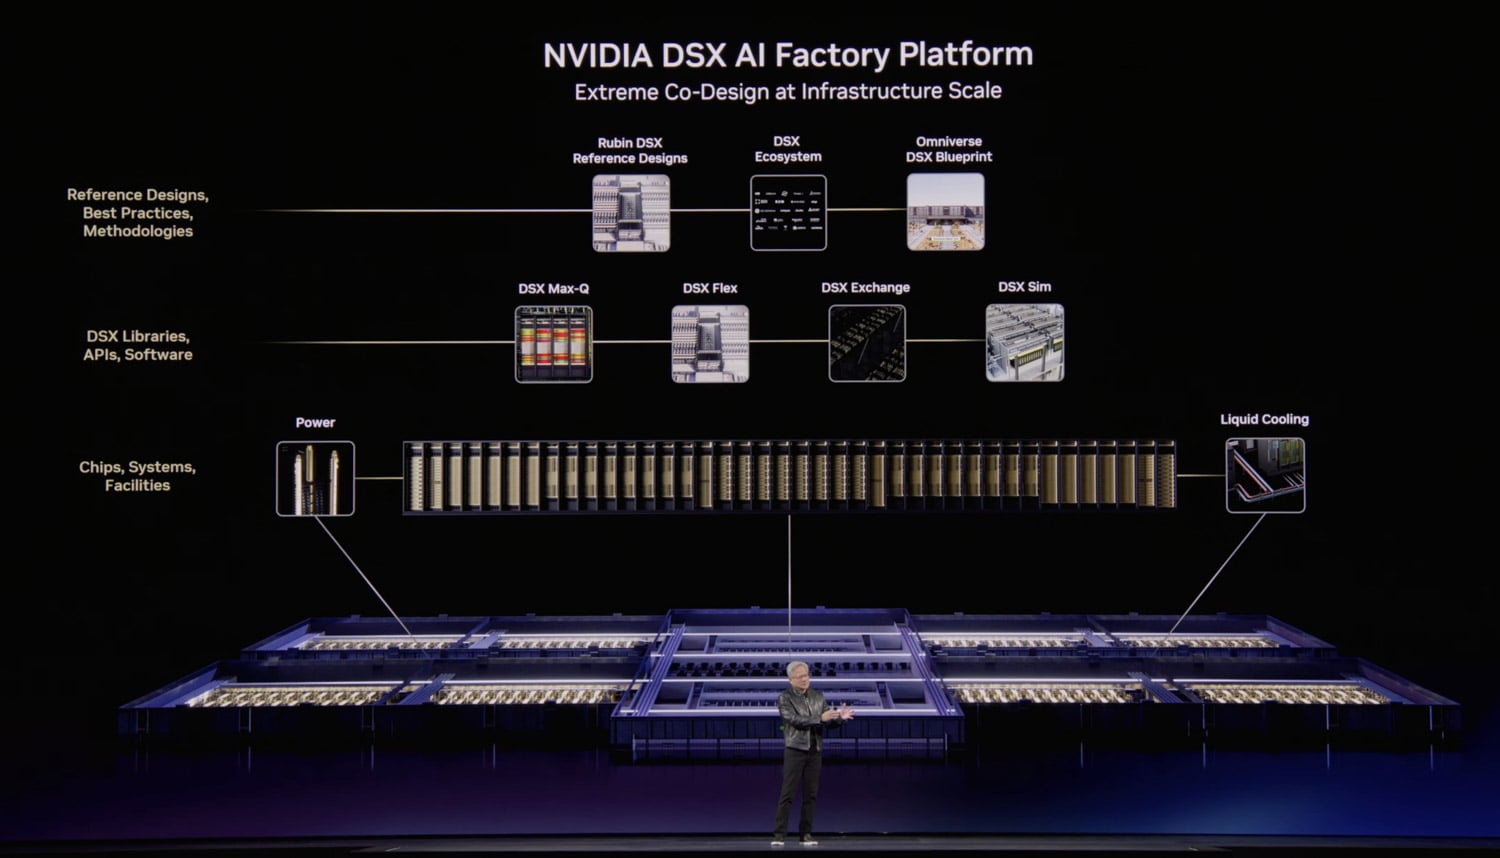
Rubin DSX software stack သည် open, modular နှင့် composable ဖြစ်ပြီး cluster hardware နှင့် power နှင့် cooling system များကို ချိတ်ဆက်ပေးသည်။ ၎င်းတွင် component libraries အများအပြားပါဝင်သည်- DSX Max-Q သည် AI factory တစ်ခုလုံးတွင် dynamic power provisioning ကိုဖွင့်ပေးပြီး fixed-power data center အတွင်း AI infrastructure ၃၀% ပိုမိုဖြန့်ကျက်စေသည်။ DSX Flex သည် AI factories များကို grid-flexible asset များဖြစ်လာစေပြီး NVIDIA ခန့်မှန်းထားသည့် stranded grid power ၁၀၀ gigawatts ကို unlock လုပ်သည်။ ၎င်းသည် ယခုအခါ စွမ်းအင်သည် AI infrastructure buildouts အတွက် အကြီးမားဆုံး bottleneck ဖြစ်နေသောကြောင့် အရေးကြီးသောစွမ်းရည်ဖြစ်ပြီး equipment backlogs ဒေါ်လာ ၃၀၀ ဘီလီယံကျော်နှင့် US interconnection queues များတွင် စောင့်ဆိုင်းနေသော project ၂၀၀ GW ကျော်ရှိသောကြောင့်ဖြစ်သည်။ DSX Exchange သည် IT၊ operational technology နှင့် operations agent များအကြား compute၊ network၊ energy၊ power နှင့် cooling signal များကို scalable နှင့် secure integration လုပ်နိုင်သည်။ DSX Sim model များသည် NVIDIA DSX Air platform ကို အသုံးပြု၍ AI factories များကို high-fidelity digital twins အဖြစ် အတည်ပြုသည်။
Omniverse DSX Blueprint ကို ယခုအခါ build.nvidia.com တွင် ယေဘုယျအားဖြင့် ရရှိနိုင်ပြီး Vera Rubin DSX ရည်ညွှန်းဒီဇိုင်းနှင့် အပြည့်အဝ တွဲဖက်အသုံးပြုနိုင်သောကြောင့် developer များအနေဖြင့် ၎င်းတို့၏ AI စက်ရုံများ၏ ရုပ်ပိုင်းဆိုင်ရာ တိကျသော digital twin များကို တည်ဆောက်နိုင်စေပြီး၊ လုပ်ငန်းလည်ပတ်မှုများကို အချိန်နှင့်တပြေးညီ ပုံစံတူပြုလုပ်နိုင်စေကာ တည်ဆောက်မှု သို့မဟုတ် ဖြန့်ကျက်မှုမစတင်မီ စွမ်းဆောင်ရည်ကို အကောင်းဆုံးဖြစ်အောင် လုပ်ဆောင်နိုင်စေပါသည်။ ၎င်းသည် ဝင်ငွေရရှိရန်အချိန်နှင့် AI ထိရောက်မှုကို အရှိန်မြှင့်တင်ရန် ပါဝါ၊ အအေးပေးစနစ်၊ ကွန်ရက်နှင့် လုပ်ငန်းလည်ပတ်မှုများကို တစ်ခုတည်းသောပတ်ဝန်းကျင်အဖြစ် ပေါင်းစည်းပေးပါသည်။
DSX ဗိသုကာနှင့် ပုံစံဒီဇိုင်းတွင် ပံ့ပိုးပေးသော စက်မှုလုပ်ငန်းခေါင်းဆောင်များတွင် Cadence၊ Dassault Systèmes၊ Eaton၊ Jacobs၊ Nscale၊ Phaidra၊ Procore Technologies၊ PTC၊ Schneider Electric၊ Siemens၊ Switch၊ Trane Technologies နှင့် Vertiv တို့ ပါဝင်သည်။ မှတ်သားစရာကောင်းသည်မှာ Nscale နှင့် Caterpillar တို့သည် ကမ္ဘာ့အကြီးဆုံး AI စက်ရုံများထဲမှ တစ်ခုဟု ဖော်ပြထားသော multi-gigawatt နေရာတစ်ခုတွင် DSX Vera Rubin ရည်ညွှန်းဒီဇိုင်းများကို အနောက်ဗာဂျီးနီးယားရှိ DSX Vera Rubin ရည်ညွှန်းဒီဇိုင်းများကို အသက်သွင်းနေကြသည်။ စွမ်းအင်ဘက်တွင် Emerald AI၊ GE Vernova၊ Hitachi နှင့် Siemens Energy တို့သည် grid စွမ်းရည်ကို လော့ခ်ဖွင့်ရန်နှင့် AI စက်ရုံတည်ဆောက်မှုအသစ်များအတွက် လိုအပ်သော ပါဝါကို ပေးပို့ရန် DSX ရည်ညွှန်းဗိသုကာကို အသုံးပြုနေကြသည်။ Phaidra သည် DSX Max-Q ကို self-learning AI agent တစ်ခုထဲသို့ ပေါင်းစပ်ထားပြီး ဘေးကင်းရေးကို ထိန်းသိမ်းထားပြီး အအေးပေးမှု မြင့်တက်မှုများကို လျှော့ချခြင်းဖြင့် ၁၀% ခန့် ပိုမိုတွက်ချက်မှုကို ပေးစွမ်းသည်။
NVIDIA Agent Toolkit နှင့် OpenCLAW: အလိုအလျောက် အေးဂျင့်များအတွက် ဆော့ဖ်ဝဲလ် စတက်ခ်
TC 2026 သည် အေးဂျင့် AI workloads များ အလျင်အမြန်တိုးတက်လာမှုကိုလည်း အလေးပေးဖော်ပြခဲ့ပြီး NVIDIA သည် ကုမ္ပဏီတွင် မြင်တွေ့ဖူးသမျှတွင် အမြန်ဆုံးတိုးတက်နေသော workload အဖြစ် autonomous agent များကို ဖော်ပြခဲ့သည်။ software ကြေငြာချက်များ၏ အဓိကအချက်မှာ သမိုင်းတွင် အရေးအကြီးဆုံး software ထုတ်ဝေမှုတစ်ခုအဖြစ် ဖော်ပြခံရသည့် OpenCLAW နှင့် CLAW ဟုခေါ်သော ရေရှည်လည်ပတ်နေသော၊ ကိုယ်တိုင်တိုးတက်ပြောင်းလဲနေသော agent များအတွက် orchestration framework တစ်ခုဖြစ်ပြီး တစ်ဦးချင်းတာဝန်များထက် မစ်ရှင်တစ်ခုလုံးကို စီစဉ်၊ လုပ်ဆောင်ပြီး အကောင်အထည်ဖော်နိုင်သော autonomous စနစ်များဖြစ်သည်။ NVIDIA သည် CLAW များကို AI အတွက် application layer အသစ်အဖြစ် ဖော်ပြခဲ့ပြီး "ဘာ၊ ဘယ်လို၊ ဒါမှမဟုတ် ဘာကြောင့်" ဟု prompt လုပ်ခြင်းမှ "တည်ဆောက်၊ ဖန်တီး သို့မဟုတ် ပြုလုပ်" ဟု prompt လုပ်ခြင်းသို့ ရွေ့လျားခဲ့ကြောင်း ထောက်ပြခဲ့သည်။
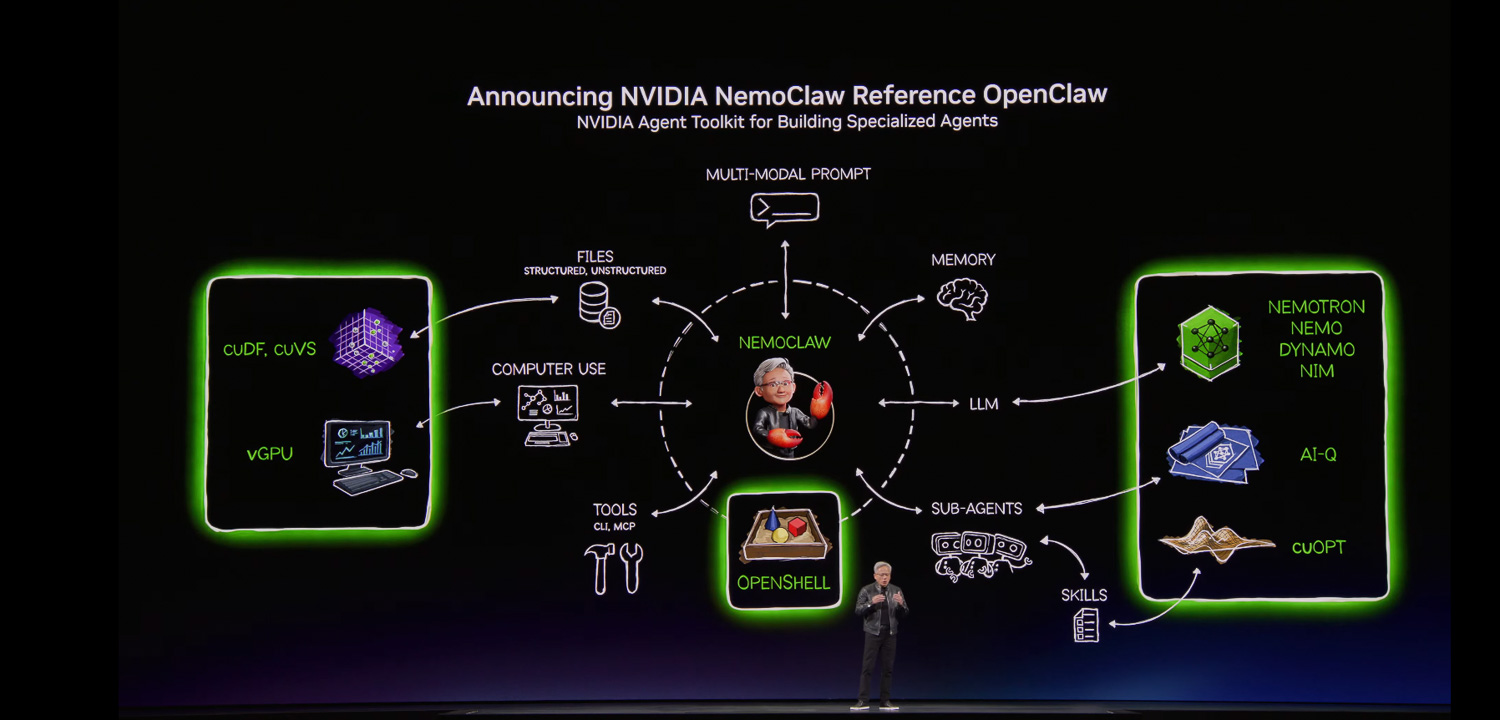
NVIDIA သည် ရေရှည်အသုံးပြုနေသော autonomous agent များတည်ဆောက်ခြင်း၊ အကဲဖြတ်ခြင်းနှင့် အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ရန်အတွက် မော်ဒယ်များ၊ runtime များနှင့် blueprint များ၏ အပြည့်အဝ open-source စုစည်းမှုတစ်ခုဖြစ်သည့် NVIDIA Agent Toolkit ကို ကြေညာခဲ့သည်။ အဓိကအစိတ်အပိုင်းများတွင် ကျိုးကြောင်းဆင်ခြင်ခြင်း၊ coding ခြင်းနှင့် speech အတွက် Nemotron open model များ၊ agent profiling နှင့် customization အတွက် Nemo၊ model inference အတွက် NIM နှင့် scale-out serving အတွက် Dynamo 1.0 တို့ ပါဝင်သည်။ အသစ်ထပ်ထည့်မှုများတွင် agent execution အတွက် policy-based network၊ privacy နှင့် security guardrails များကို ပံ့ပိုးပေးသည့် open-source ဘေးကင်းရေးနှင့် လုံခြုံရေး runtime တစ်ခုဖြစ်သည့် NVIDIA OpenShell နှင့် deep research agent များအတွက် frontier နှင့် open model intelligence တို့ကို ပေါင်းစပ်ထားသည့် open-source blueprint တစ်ခုဖြစ်သည့် IQ တို့ ပါဝင်ပြီး Deep Research Bench 1 နှင့် Complex Deep Research Bench 2 benchmarks နှစ်ခုလုံးထက် သာလွန်သော ပထမဆုံး research system ဖြစ်သည်။ cuOPT skill အသစ်သည် natural language ဖြင့်ဖော်ပြထားသော optimization problems များတွင် ကျွမ်းကျင်မှုကို ယူဆောင်လာပါသည်။
NVIDIA သည် OpenCLAW တည်ဆောက်သူ Peter Steinberger နှင့် ပူးပေါင်း၍ တီထွင်ထားသော OpenCLAW အသိုင်းအဝိုင်းအတွက် ၎င်း၏ပံ့ပိုးကူညီမှုဖြစ်သော Nemo CLAW ကိုလည်း ကြေညာခဲ့သည်။ Nemo CLAW သည် OpenCLAW နှင့်အတူ Nemotron မော်ဒယ်များနှင့် OpenShell runtime ကို command တစ်ခုတည်းတွင် ထည့်သွင်းပြီး သတ်မှတ်ထားသော privacy နှင့် security guardrails များအတွင်း လည်ပတ်နေစဉ်တွင် agent များအတွက် ကျွမ်းကျင်မှုအသစ်များ တိုးတက်စေရန်နှင့် သင်ယူရန် အခြေခံအုတ်မြစ်ကို ပံ့ပိုးပေးသည်။ ၎င်းသည် cloud infrastructure မှ on-premises RTX PC များ၊ DGX Station နှင့် DGX Spark အထိ မည်သည့် platform တွင်မဆို လည်ပတ်နိုင်သည်။
DGX Spark နှင့် DGX Station: ဒေသတွင်း CLAW ဖွံ့ဖြိုးတိုးတက်ရေး ပလက်ဖောင်းများ
developer အများအပြားသည် ၎င်းတို့၏ compute resource များကို အပြည့်အဝထိန်းချုပ်နိုင်သော ဒေသတွင်း development environment များကို နှစ်သက်ကြောင်း အသိအမှတ်ပြုသည့်အနေဖြင့် NVIDIA သည် CLAW agent ဖွံ့ဖြိုးတိုးတက်မှုအတွက် ရည်ရွယ်ချက်ရှိရှိတည်ဆောက်ထားသော platform အသစ်နှစ်ခုကို မိတ်ဆက်ခဲ့သည်။ DGX Spark သည် လုံခြုံပြီး အမြဲတမ်းဖွင့်ထားသော autonomous agent များကို လည်ပတ်ရန်အတွက် မြင့်မားသောစွမ်းဆောင်ရည်၊ ပါဝါချွေတာသော platform တစ်ခုဖြစ်ပြီး DGX Spark နှင့် GB10-based OEM partner systems များကို ကမ္ဘာတစ်ဝှမ်းတွင် ရရှိနိုင်ပြီဖြစ်သည်။ အဆုံးစွန်သော local CLAW development platform အဖြစ် ရပ်တည်ထားသော DGX Station သည် developer များအား cloud connectivity မပါဘဲ frontier-level intelligence ဖြင့် မော်ဒယ်များကို on-premises တွင် လည်ပတ်နိုင်စေပြီး ၎င်းသည် developer များအတွက် အရေးကြီးပြီး အရာအားလုံးသည် လုံးဝထိန်းချုပ်မှုနှင့် လုံခြုံရေးအတွက် local တွင်ရှိနေပါသည်။ DGX Station systems များကို ၂၀၂၆ ခုနှစ် မတ်လ ၁၆ ရက်နေ့မှစ၍ OEM partners များထံမှ မှာယူနိုင်ပါသည်။
Vera Rubin အာကာသမော်ဂျူးများ- ကမ္ဘာမြေပြင်ပရှိ AI အခြေခံအဆောက်အအုံ
NVIDIA မှ ၎င်း၏ နောက်ဆုံးပေါ် အရှိန်မြှင့်ထားသော ကွန်ပျူတာပလက်ဖောင်းများသည် အာကာသဆန်းသစ်တီထွင်မှု၏ ခေတ်သစ်တစ်ခုကို ဖွင့်လှစ်ပေးနေပြီး၊ AI compute ကို orbital data center (ODCs)၊ geospatial intelligence နှင့် autonomous space operations များသို့ ယူဆောင်လာကြောင်း ကြေညာခဲ့သည်။ NVIDIA Vera Rubin Space Module သည် NVIDIA H100 GPU ထက် အာကာသအခြေပြု ကောက်ချက်ချမှုအတွက် AI compute ကို ၂၅ ဆအထိ ပေးစွမ်းနိုင်ပြီး ကြီးမားသော ဘာသာစကားမော်ဒယ်များနှင့် အဆင့်မြင့် အခြေခံမော်ဒယ်များကို orbit တွင် တိုက်ရိုက်လည်ပတ်နိုင်စေပါသည်။ ၎င်း၏ တင်းကျပ်စွာ ပေါင်းစပ်ထားသော CPU-GPU ဗိသုကာလက်ရာသည် အာကာသအခြေပြု ကိရိယာများမှ ကြီးမားသော data stream များကို အချိန်နှင့်တပြေးညီ လုပ်ဆောင်ရန် လိုအပ်သော စွမ်းဆောင်ရည်နှင့် မှတ်ဉာဏ်ကို ပေးစွမ်းသည်။
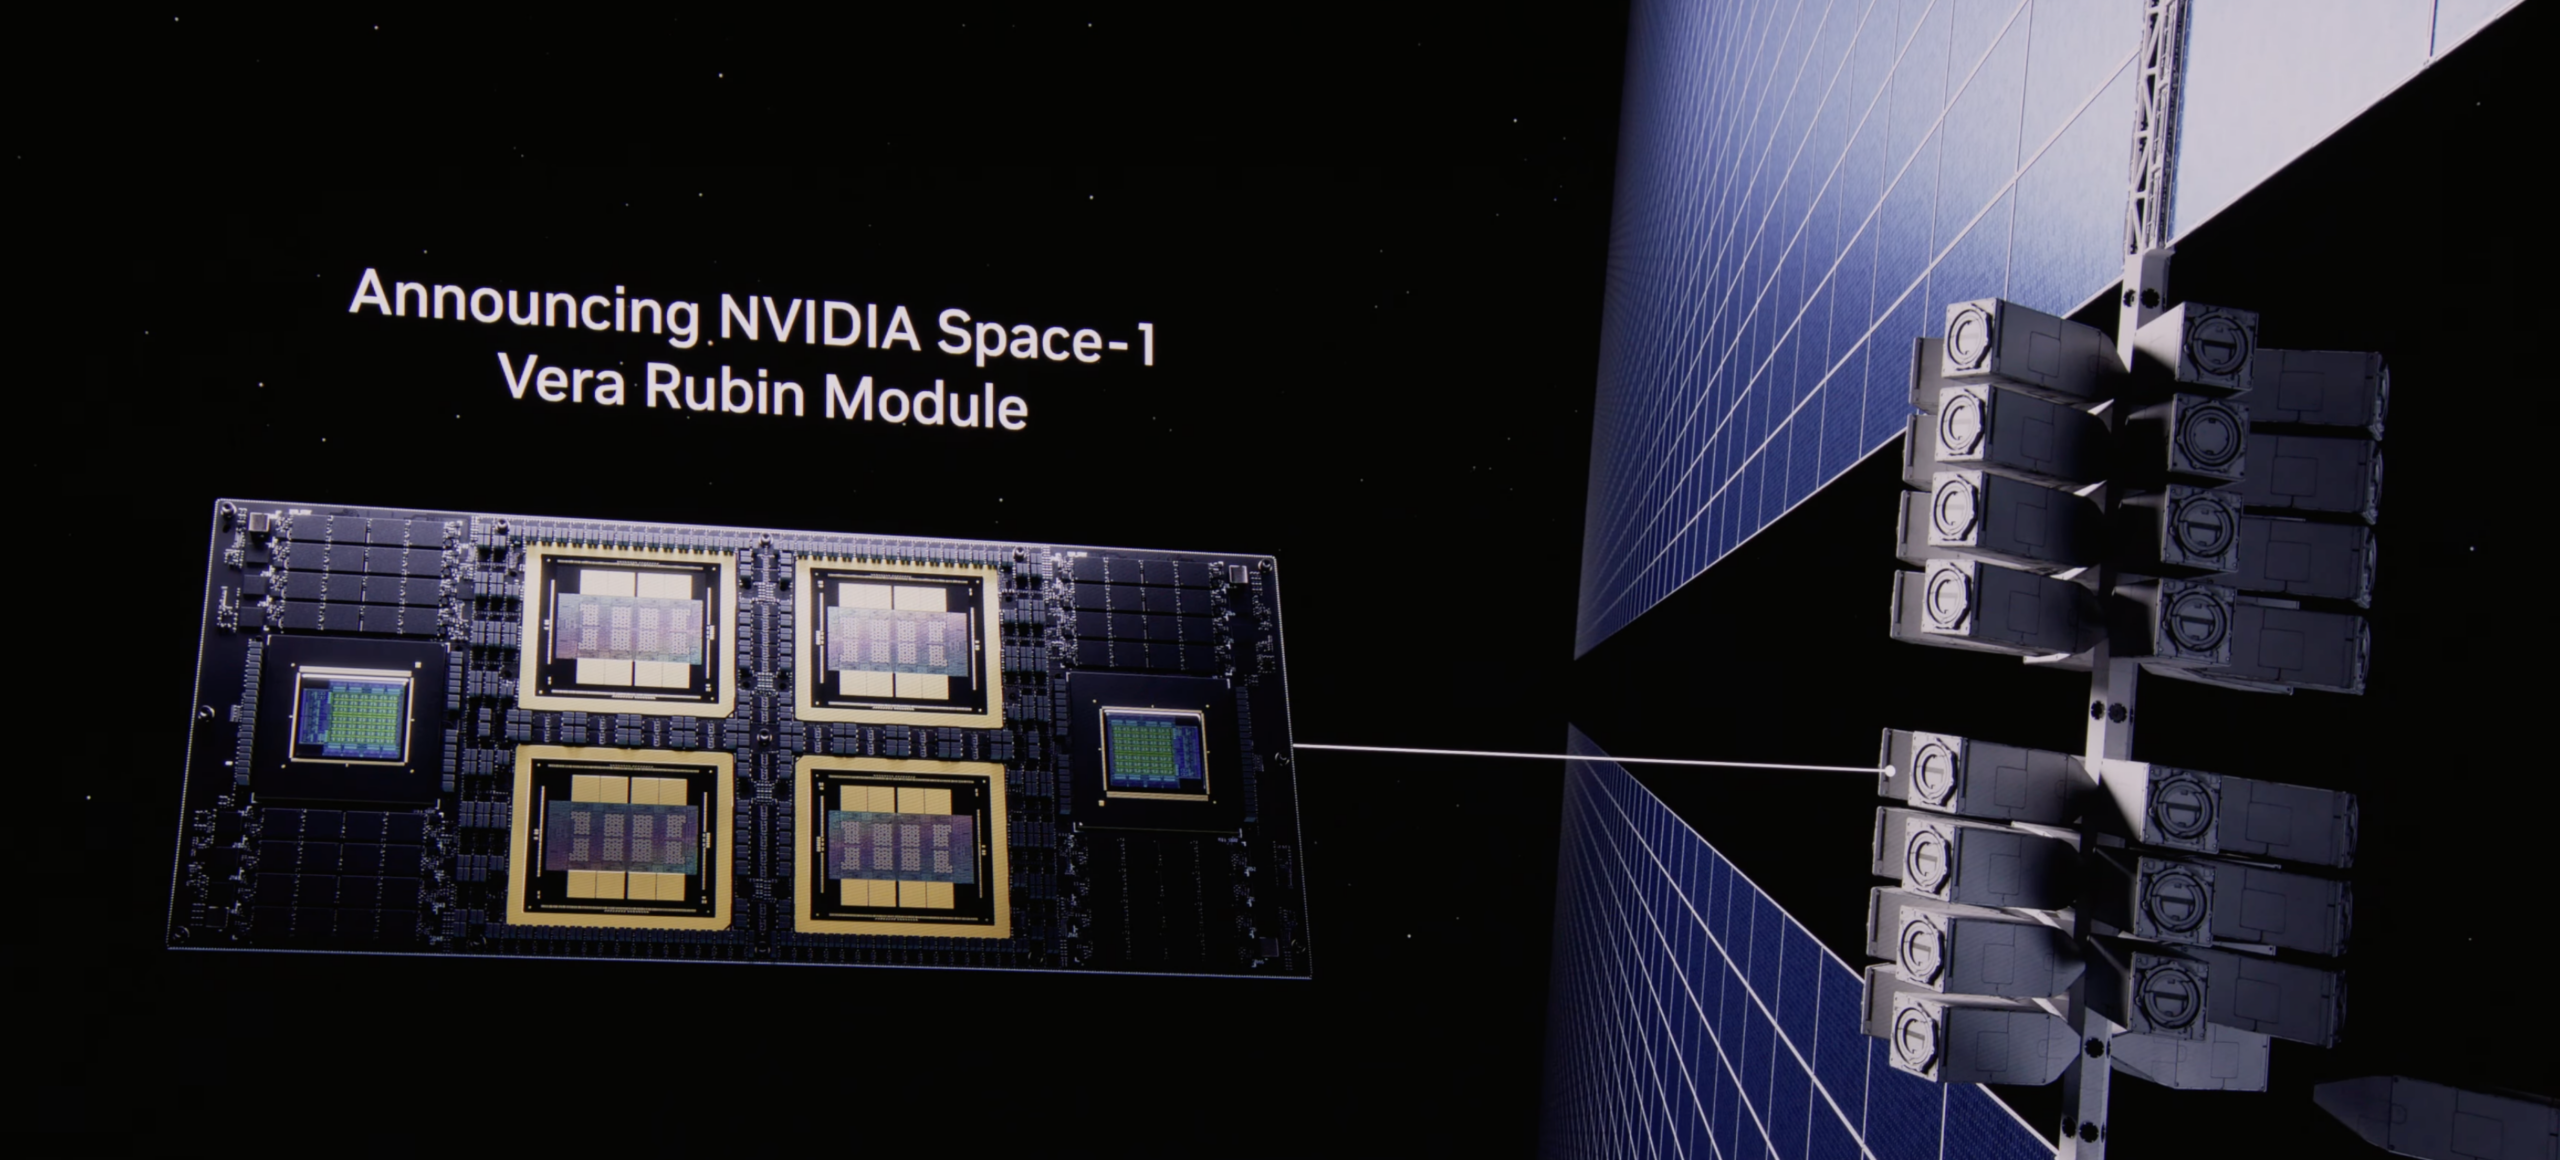
Vera Rubin Space Module နှင့်အတူ NVIDIA IGX Thor သည် ပတ်လမ်းအတွင်းရှိ မစ်ရှင်-အရေးပါသော အစွန်းပတ်ဝန်းကျင်များအတွက် စက်မှုလုပ်ငန်းအဆင့် ကြံ့ခိုင်မှုကို ပေးစွမ်းပြီး Jetson Orin သည် SWaP-constrained အာကာသယာဉ်အတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသော အလွန်သေးငယ်သော မော်ဂျူးတစ်ခုတွင် မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော AI inference ကို ပေးစွမ်းသည်။ မြေပြင်ပေါ်တွင် RTX PRO 6000 Blackwell Server Edition GPU သည် geospatial intelligence processing အတွက် legacy CPU-based batch systems များနှင့်နှိုင်းယှဉ်ပါက 100x အထိ ပိုမိုမြန်ဆန်သော စွမ်းဆောင်ရည်ကို ပေးစွမ်းသည်။ Aetherflux၊ Axiom Space၊ Kepler Communications၊ Planet Labs၊ Sophia Space နှင့် Starcloud အပါအဝင် မိတ်ဖက်များသည် ပတ်လမ်းဒေတာစင်တာများ၊ ကိုယ်ပိုင်အာကာသလုပ်ငန်းများနှင့် အချိန်နှင့်တပြေးညီ ကမ္ဘာမြေစောင့်ကြည့်ခြင်းတို့ကို လွှမ်းခြုံထားသော နောက်မျိုးဆက် အာကာသမစ်ရှင်များအတွက် ဤပလက်ဖောင်းများပေါ်တွင် တည်ဆောက်နေကြသည်။
NVIDIA Dynamo 1.0: AI စက်ရုံများအတွက် Inference Operating System
GTC 2026 ကြေငြာချက်များအပြီးတွင် NVIDIA သည် AI factory inference အတွက် ပထမဆုံး distributed operating system အဖြစ် သတ်မှတ်သည့် Dynamo 1.0 open-source software ဖြင့် ထုတ်လုပ်မှုစတင်ခဲ့သည်။ ကွန်ပျူတာ၏ operating system သည် hardware နှင့် application များကို ညှိနှိုင်းပေးသကဲ့သို့ပင် Dynamo 1.0 သည် AI factories များအတွက် distributed orchestration layer အဖြစ် လုပ်ဆောင်ပြီး cluster တစ်လျှောက်ရှိ GPU နှင့် memory resource များကို ချောမွေ့စွာ စီမံခန့်ခွဲကာ ရှုပ်ထွေးပြီး ကွဲပြားသော AI workloads များကို အတိုင်းအတာတစ်ခုအထိ လည်ပတ်စေသည်။
Dynamo 1.0 သည် GPU များတစ်လျှောက် inference အလုပ်ကို ဉာဏ်ရည်ထက်မြက်သော routing နှင့် GPU များနှင့် ကုန်ကျစရိတ်နည်းသော storage tiers များအကြား data များကို ရွှေ့ပြောင်းနိုင်စွမ်းဖြင့် ပိုင်းခြားပေးသည်၊ ထို့ကြောင့် computation အလဟဿဖြစ်မှုကို လျှော့ချပေးပြီး memory ကန့်သတ်ချက်များကို လျှော့ချပေးသည်။ agentic AI နှင့် long-context workloads များအတွက် Dynamo သည် အစောပိုင်းအဆင့်များမှ အသင့်တော်ဆုံး KV cache data ကို သိမ်းဆည်းထားသည့် GPU များထံ request များကို လမ်းကြောင်းပြောင်းပေးနိုင်သည်၊ ထို့နောက် မလိုအပ်သည့်အခါ ထို memory ကို offload လုပ်နိုင်သည်၊ ၎င်းသည် BlueField-4 STX/ICMS storage architecture နှင့် တိုက်ရိုက်ချိတ်ဆက်ပေးသည့် စွမ်းရည်ဖြစ်သည်။ မကြာသေးမီက စက်မှုလုပ်ငန်း benchmarks များတွင် Dynamo သည် NVIDIA Blackwell GPU များ၏ inference စွမ်းဆောင်ရည်ကို 7x အထိ မြှင့်တင်ပေးခဲ့ပြီး token ကုန်ကျစရိတ်ကို လျှော့ချပေးပြီး အခမဲ့၊ open-source software ဖြင့် ဖြန့်ကျက်ထားသော GPU သန်းပေါင်းများစွာအတွက် ဝင်ငွေအခွင့်အလမ်းများကို တိုးမြှင့်ပေးခဲ့သည်။
NVIDIA သည် Dynamo နှင့် TensorRT-LLM optimization များကို LangChain၊ llm-d၊ LMCache၊ SGLang နှင့် vLLM အပါအဝင် လူကြိုက်များသော inference framework များထဲသို့ ပေါင်းစပ်ခြင်းဖြင့် open-source ecosystem ကို အရှိန်မြှင့်တင်နေပါသည်။ Core Dynamo building blocks၊ memory management အတွက် KVBM၊ GPU-to-GPU data movement မြန်ဆန်စေရန် NIXL နှင့် simplified scaling အတွက် Grove တို့ကိုလည်း standalone modules များအဖြစ် ရရှိနိုင်ပါသည်။ NVIDIA သည် open-source frameworks များထဲသို့ native integration အတွက် FlashInfer project သို့ TensorRT-LLM CUDA kernels များကိုလည်း ပံ့ပိုးပေးပါသည်။
လက်ခံအသုံးပြုမှု ကျယ်ပြန့်မှုမှာ မှတ်သားဖွယ်ကောင်းပါသည်။ NVIDIA inference platform ကို AWS၊ Microsoft Azure၊ Google Cloud နှင့် Oracle Cloud Infrastructure အပါအဝင် cloud provider များအပြင် NVIDIA cloud partner များဖြစ်သည့် Alibaba Cloud၊ CoreWeave၊ Crusoe၊ DigitalOcean၊ Nebius၊ Nscale နှင့် Together AI တို့နှင့် ပေါင်းစပ်ထားသည်။ AI-native ကုမ္ပဏီများဖြစ်သည့် Cursor၊ Hebbia နှင့် Perplexity တို့သည် platform ကို လက်ခံအသုံးပြုခဲ့ကြပြီး inference endpoint provider များဖြစ်သည့် Baseten၊ Deep Infra နှင့် Fireworks တို့သည်လည်း ပလက်ဖောင်းကို လက်ခံအသုံးပြုခဲ့ကြသည်။ Amazon၊ AstraZeneca၊ BlackRock၊ ByteDance၊ Coupang၊ Instacart၊ Meituan၊ PayPal၊ Pinterest၊ Shopee နှင့် SoftBank Corp. အပါအဝင် ကမ္ဘာလုံးဆိုင်ရာ လုပ်ငန်းများသည် NVIDIA inference stack ကို လက်ခံအသုံးပြုခဲ့ကြသည်။ Dynamo 1.0 ကို ကမ္ဘာတစ်ဝှမ်းရှိ developer များအတွက် ယနေ့တွင် ရရှိနိုင်ပါပြီ။


 အမေဇုံ