

NVIDIA GTC 2023 မှာ ထုတ်ကုန်အသစ်တွေ၊ မိတ်ဖက်တွေ၊ ဆန်းသစ်တီထွင်မှုတွေနဲ့ ဆော့ဖ်ဝဲတွေကို မိတ်ဆက်ခြင်းဖြင့် စတင်ခဲ့ပါတယ်။ ကြေငြာချက်တွေရဲ့ အကျယ်အဝန်းကို သိရှိနိုင်ဖို့ အဓိကမိန့်ခွန်းဟာ မိနစ် ၇၈ ကြာခဲ့ပါတယ်။ သီးခြား generative AI inference workload နဲ့ အထူးပြုဆော့ဖ်ဝဲတွေအတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားတဲ့ ပလက်ဖောင်းအသစ်လေးခုကို ကြေညာခဲ့ပါတယ်။
ယင်းပလက်ဖောင်းများသည် NVIDIA ၏ အပြည့်အစုံသော inference software ကို နောက်ဆုံးပေါ် NVIDIA Ada၊ Hopper နှင့် Grace Hopper ပရိုဆက်ဆာများနှင့် ပေါင်းစပ်ထားသည်။ NVIDIA L4 Tensor Core GPU နှင့် H100 NVL GPU ဟူ၍ GPU အသစ်နှစ်ခုကို ယနေ့တွင် မိတ်ဆက်ခဲ့သည်။
NVIDIA L4 for AI Video သည် CPU များထက် 120 ဆ ပိုမို AI-powered ဗီဒီယိုစွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ပြီး 99 ရာခိုင်နှုန်း ပိုမိုကောင်းမွန်သော စွမ်းအင်ထိရောက်မှုတို့ ပေါင်းစပ်ထားသည်။ L4 သည် မည်သည့် workload အတွက်မဆို universal GPU အဖြစ် ဆောင်ရွက်ပေးပြီး မြှင့်တင်ထားသော ဗီဒီယို decoding နှင့် transcoding စွမ်းရည်များ၊ ဗီဒီယို streaming၊ augmented reality၊ generative AI ဗီဒီယိုနှင့် အခြားအရာများကို ပေးဆောင်ပါသည်။
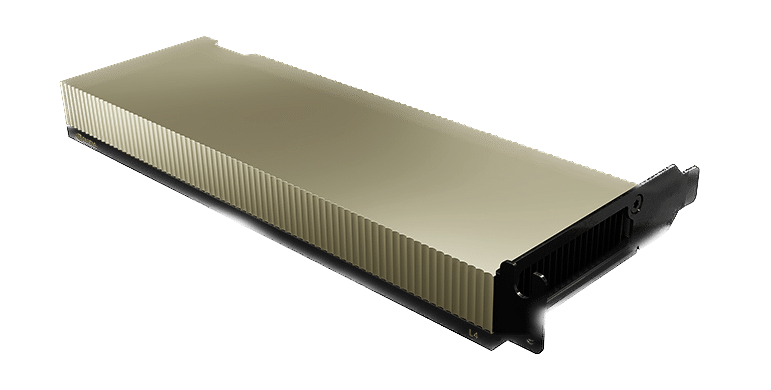
NVIDIA Ada Lovelace L4 Tensor Core GPU သည် enterprise၊ cloud နှင့် edge ရှိ video၊ AI၊ virtualized desktop နှင့် graphics application များအတွက် universal acceleration နှင့် energy efficiency ကို ပေးစွမ်းပါသည်။ NVIDIA ၏ AI platform နှင့် full-stack ဖြင့်
ချဉ်းကပ်မှုအရ၊ L4 ကို အကြံပြုချက်များ၊ အသံအခြေပြု AI avatar လက်ထောက်များ၊ generative AI၊ visual search နှင့် contact center automation အပါအဝင် AI အပလီကေးရှင်းအမျိုးမျိုးအတွက် ကောက်ချက်ချရန်အတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသည်။
L4 သည် mainstream အသုံးပြုမှုအတွက် အထိရောက်ဆုံး NVIDIA accelerator ဖြစ်ပြီး L4 တပ်ဆင်ထားသော server များသည် CPU solution များထက် AI ဗီဒီယိုစွမ်းဆောင်ရည် 120x မြင့်မားပြီး AI စွမ်းဆောင်ရည် 2.7x ပိုမိုကောင်းမွန်သည့်အပြင် ယခင် GPU မျိုးဆက်ထက် ဂရပ်ဖစ်စွမ်းဆောင်ရည် 4x ကျော် ပိုမိုမြင့်မားပါသည်။ NVIDIA L4 သည် ဘက်စုံသုံး၊ စွမ်းအင်ချွေတာသော၊ single-slot၊ low-profile form factor ဖြစ်သောကြောင့် ကြီးမားသော ဖြန့်ကျက်မှုများနှင့် edge location များအတွက် အသင့်တော်ဆုံးဖြစ်သည်။
NVIDIA L40 for Image Generation ကို ဂရပ်ဖစ်နှင့် AI-enabled 2D၊ ဗီဒီယိုနှင့် 3D ရုပ်ပုံထုတ်လုပ်ခြင်းအတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသည်။ L40 ပလက်ဖောင်းသည် NVIDIA Omniverse ၏ အင်ဂျင်အဖြစ် ဆောင်ရွက်ပေးပြီး ဒေတာစင်တာတွင် metaverse အပလီကေးရှင်းများ တည်ဆောက်ခြင်းနှင့် လည်ပတ်ခြင်းအတွက် ပလက်ဖောင်းတစ်ခုဖြစ်ပြီး ယခင်မျိုးဆက်ထက် Stable Diffusion အတွက် inference စွမ်းဆောင်ရည် ၇ ဆ နှင့် Omniverse စွမ်းဆောင်ရည် ၁၂ ဆ ပေးစွမ်းနိုင်သည်။
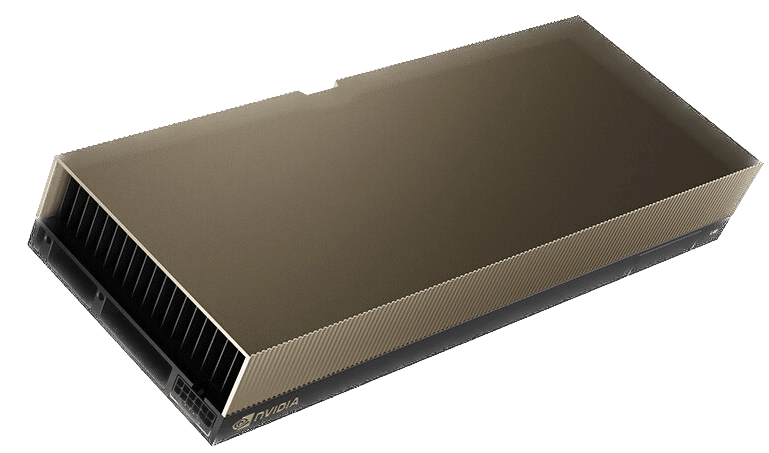
NVIDIA L40 GPU သည် နောက်မျိုးဆက် ဂရပ်ဖစ်များ၊ တွက်ချက်မှုနှင့် AI စွမ်းရည်များဖြင့် ဒေတာစင်တာအတွက် မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော visual computing ကို ပေးဆောင်ပါသည်။ NVIDIA Ada Lovelace ဗိသုကာပေါ်တွင် တည်ဆောက်ထားသော L40 သည် နောက်ဆုံးပေါ်မျိုးဆက် RT၊ Tensor နှင့် CUDA cores များ၏ စွမ်းအားကို အသုံးချပြီး လိုအပ်ချက်များသော ဒေတာစင်တာ workloads များအတွက် visualization နှင့် compute စွမ်းဆောင်ရည်ကို ပေးဆောင်ပါသည်။
L40 သည် ပိုမိုကောင်းမွန်သော throughput နှင့် concurrent ray-tracing နှင့် shading စွမ်းရည်များကို ပေးစွမ်းပြီး ray-tracing စွမ်းဆောင်ရည်ကို တိုးတက်စေပြီး ထုတ်ကုန်ဒီဇိုင်းနှင့် ဗိသုကာ၊ အင်ဂျင်နီယာနှင့် ဆောက်လုပ်ရေးလုပ်ငန်းစဉ်များအတွက် renders များကို အရှိန်မြှင့်တင်ပေးသည်။ L40 GPU သည် structural sparsity အတွက် hardware ပံ့ပိုးမှုနှင့် ပိုမိုမြန်ဆန်သော AI နှင့် data science model training အတွက် out of the box စွမ်းဆောင်ရည်တိုးတက်မှုများအတွက် optimized TF32 format ကို ပေးစွမ်းသည်။ DLSS အပါအဝင် အရှိန်မြှင့်တင်ထားသော AI-enhanced graphics စွမ်းရည်များသည် ရွေးချယ်ထားသော application များတွင် ပိုမိုကောင်းမွန်သော စွမ်းဆောင်ရည်ဖြင့် upscaled resolution ကို ပေးစွမ်းသည်။
L40 ရဲ့ ကြီးမားတဲ့ GPU မှတ်ဉာဏ်ဟာ မှတ်ဉာဏ်အရမ်းများတဲ့ အပလီကေးရှင်းတွေနဲ့ ဒေတာသိပ္ပံ၊ သရုပ်ဖော်ခြင်း၊ 3D မော်ဒယ်လ်လုပ်ခြင်းနဲ့ အလွန်မြန်ဆန်တဲ့ 48GB GDDR6 မှတ်ဉာဏ်နဲ့ rendering လိုမျိုး ဝန်ထုပ်ဝန်ပိုးတွေကို ကိုင်တွယ်ဖြေရှင်းပေးပါတယ်။ ဖန်တီးမှုအဖွဲ့၊ ဒေတာသိပ္ပံနဲ့ ဒီဇိုင်းအဖွဲ့တွေကြားမှာ ကြီးမားတဲ့ ဝန်ထုပ်ဝန်ပိုးတွေကို ဖြန့်ဝေပေးဖို့ vGPU ဆော့ဖ်ဝဲလ်ကို အသုံးပြုပြီး မန်မိုရီကို အသုံးပြုသူအများအပြားဆီ ခွဲဝေပေးထားပါတယ်။
ပါဝါချွေတာသော ဟာ့ဒ်ဝဲနှင့် အစိတ်အပိုင်းများဖြင့် ၂၄×၇ လုပ်ငန်းဒေတာစင်တာလည်ပတ်မှုများအတွက် ဒီဇိုင်းထုတ်ထားသော NVIDIA L40 ကို အရွယ်အစားအလိုက် ဖြန့်ကျက်ရန်နှင့် မတူညီသောဒေတာစင်တာ workloads များအတွက် အမြင့်ဆုံးစွမ်းဆောင်ရည်ကို ပေးဆောင်ရန် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသည်။ L40 တွင် လုံခြုံရေးအလွှာတစ်ခုထပ်ဆောင်းပေးစွမ်းသည့် root of trust နည်းပညာပါရှိသော secure boot ပါဝင်ပြီး ဒေတာစင်တာစံနှုန်းများနှင့်ကိုက်ညီစေရန် NEBS Level 3 နှင့် ကိုက်ညီပါသည်။
NVIDIA H100 NVL for Large Language Model Deployment သည် ChatGPT ကဲ့သို့သော ကြီးမားသော LLM များကို အတိုင်းအတာတစ်ခုအထိ ဖြန့်ကျက်ရန်အတွက် အသင့်တော်ဆုံးဖြစ်သည်။ အသစ်ထွက်ရှိလာသော H100 NVL တွင် Transformer Engine အရှိန်မြှင့်မှုပါရှိသော 94GB မန်မိုရီပါရှိပြီး ဒေတာစင်တာအတိုင်းအတာတွင် ယခင်မျိုးဆက် A100 ထက် GPT-3 တွင် 12 ဆအထိ ပိုမိုမြန်ဆန်သော inference စွမ်းဆောင်ရည်ကို ပေးစွမ်းသည်။
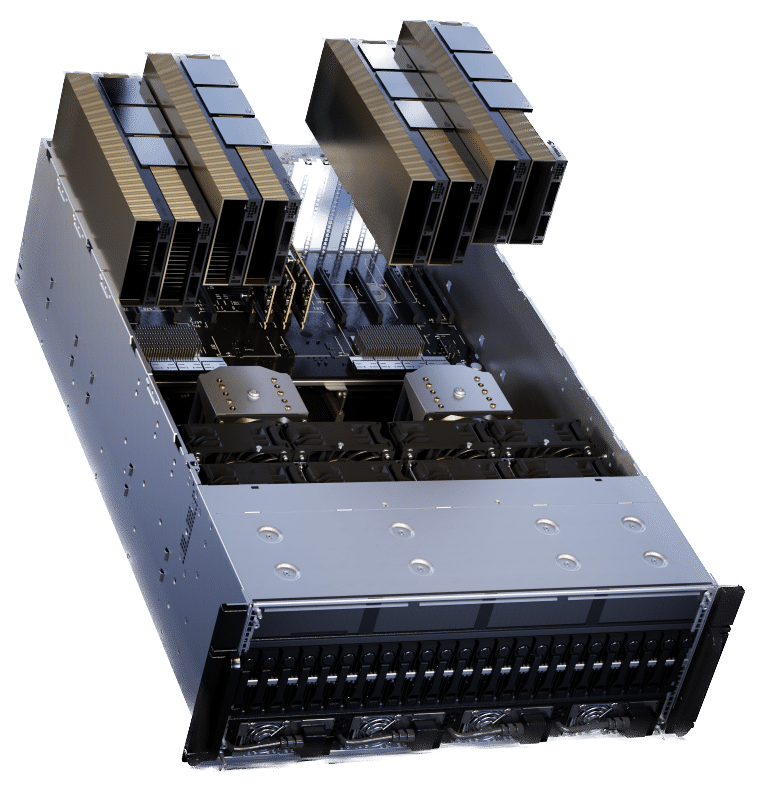
NVLink bridge ပါရှိသော PCIe-based H100 NVL သည် Transformer Engine၊ NVLink နှင့် 188GB HBM3 memory တို့ကို အသုံးပြု၍ data center များတွင် အကောင်းဆုံးစွမ်းဆောင်ရည်နှင့် scaling ကို ပေးဆောင်ပါသည်။ H100 NVL သည် 175 billion parameters အထိ Large Language Models များကို ပံ့ပိုးပေးပါသည်။ H100 NVL GPU များတပ်ဆင်ထားသော server များသည် NVIDIA DGX A100 systems များထက် GPT-175B model performance ကို 12 ဆအထိ မြှင့်တင်ပေးသည့်အပြင် ပါဝါကန့်သတ်ချက်ရှိသော data center environments များတွင် latency နည်းပါးစွာ ထိန်းသိမ်းထားပါသည်။
NVIDIA Grace Hopper for Recommendation Models သည် ဂရပ်အကြံပြုမော်ဒယ်များ၊ vector databases များနှင့် ဂရပ် neural networks များအတွက် အသင့်တော်ဆုံးဖြစ်သည်။ CPU နှင့် GPU အကြား 900 GB/s NVLink-C2C ချိတ်ဆက်မှုဖြင့် Grace Hopper သည် PCIe Gen 5 ထက် 7x ပိုမြန်သော data transfers နှင့် queries များကို ပေးဆောင်နိုင်သည်။
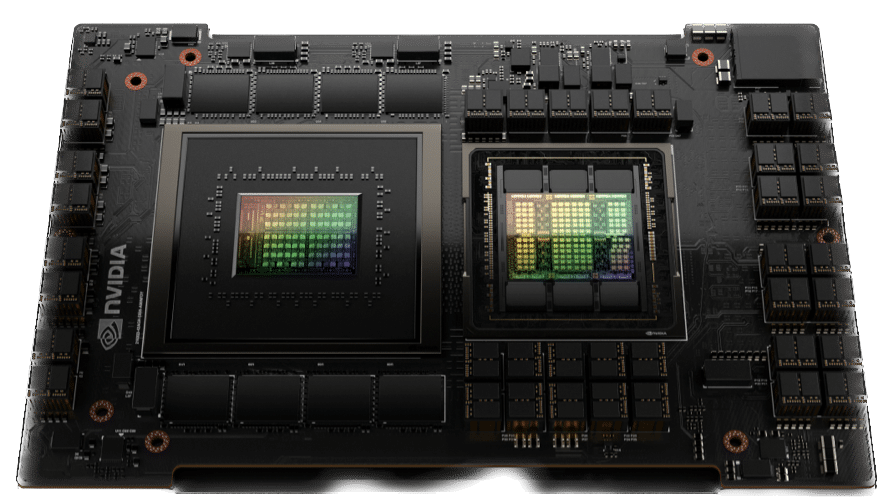
NVIDIA Grace Hopper Superchip သည် ကြီးမားသော AI နှင့် မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော computing (HPC) အပလီကေးရှင်းများအတွက် အခြေခံမှစတင်၍ ဒီဇိုင်းထုတ်ထားသော တိုးတက်မှုအရှိန်မြှင့် CPU တစ်ခုဖြစ်သည်။ superchip သည် terabytes data များကို လည်ပတ်သော အပလီကေးရှင်းများအတွက် 10 ဆအထိ မြင့်မားသောစွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်မည်ဖြစ်ပြီး သိပ္ပံပညာရှင်များနှင့် သုတေသီများအား ကမ္ဘာ့အရှုပ်ထွေးဆုံးပြဿနာများအတွက် မကြုံစဖူးဖြေရှင်းနည်းများ ရရှိစေမည်ဖြစ်သည်။
NVIDIA Grace Hopper Superchip သည် NVIDIA NVLink-C2C ကို အသုံးပြု၍ Grace နှင့် Hopper ဗိသုကာများကို ပေါင်းစပ်ထားပြီး အရှိန်မြှင့်ထားသော AI နှင့် HPC အပလီကေးရှင်းများအတွက် CPU+GPU coherent memory model ကို ပေးပို့သည်။ Grace Hopper တွင် 900 gigabytes per second (GB/s) coherent interface ပါဝင်ပြီး PCIe Gen5 ထက် 7 ဆ ပိုမြန်ကာ NVIDIA DGX A100 နှင့် နှိုင်းယှဉ်ပါက GPU သို့ 30 ဆ ပိုများသော aggregate system memory bandwidth ကို ပေးပို့သည်။ ထို့အပြင် NVIDIA HPC SDK၊ NVIDIA AI နှင့် NVIDIA Omniverse အပါအဝင် NVIDIA software stacks နှင့် platforms အားလုံးကို လည်ပတ်သည်။
ခေတ်သစ် အကြံပြုစနစ် မော်ဒယ်များသည် embedding ဇယားများကို သိမ်းဆည်းရန်အတွက် မှတ်ဉာဏ်များစွာ လိုအပ်ပါသည်။ Embedding ဇယားများတွင် ပစ္စည်းများနှင့် အသုံးပြုသူများ၏ အင်္ဂါရပ်များအတွက် အဓိပ္ပါယ်ဆိုင်ရာ ကိုယ်စားပြုမှုများ ပါဝင်ပြီး ၎င်းတို့သည် စားသုံးသူများအား ပိုမိုကောင်းမွန်သော အကြံပြုချက်များ ပေးအပ်ရန် ကူညီပေးပါသည်။
ယေဘုယျအားဖြင့်၊ ဤ embedding များသည် အချို့သော embedding vector များကို အခြား embedding vector များထက် ပိုမိုမကြာခဏ ဝင်ရောက်ကြည့်ရှုနိုင်သောကြောင့် အသုံးပြုမှုကြိမ်နှုန်းအတွက် power-law distribution ကို လိုက်နာပါသည်။ NVIDIA Grace Hopper သည် high-throughput recommender system pipeline များကို ဖွင့်ပေးသည်
HBM3 မှတ်ဉာဏ်တွင် အသုံးအများဆုံး embedding vector များနှင့် ကျန် embedding vector များကို စွမ်းရည်မြင့် LPDDR5X မှတ်ဉာဏ်တွင် သိမ်းဆည်းသည်။ NVLink C2C interconnect သည် Hopper GPU များအား ၎င်းတို့၏ local LPDDR5X မှတ်ဉာဏ်သို့ high-bandwidth access ပေးသည်။ တစ်ချိန်တည်းမှာပင်၊ NVLink Switch System သည် NVLink ကွန်ရက်ရှိ Grace Hopper Superchips အားလုံး၏ LPDDR5X မှတ်ဉာဏ်အားလုံးသို့ high-bandwidth access ပေးစွမ်းရန် Hopper GPU များအား ၎င်းကို တိုးချဲ့သည်။


 အမေဇုံ