

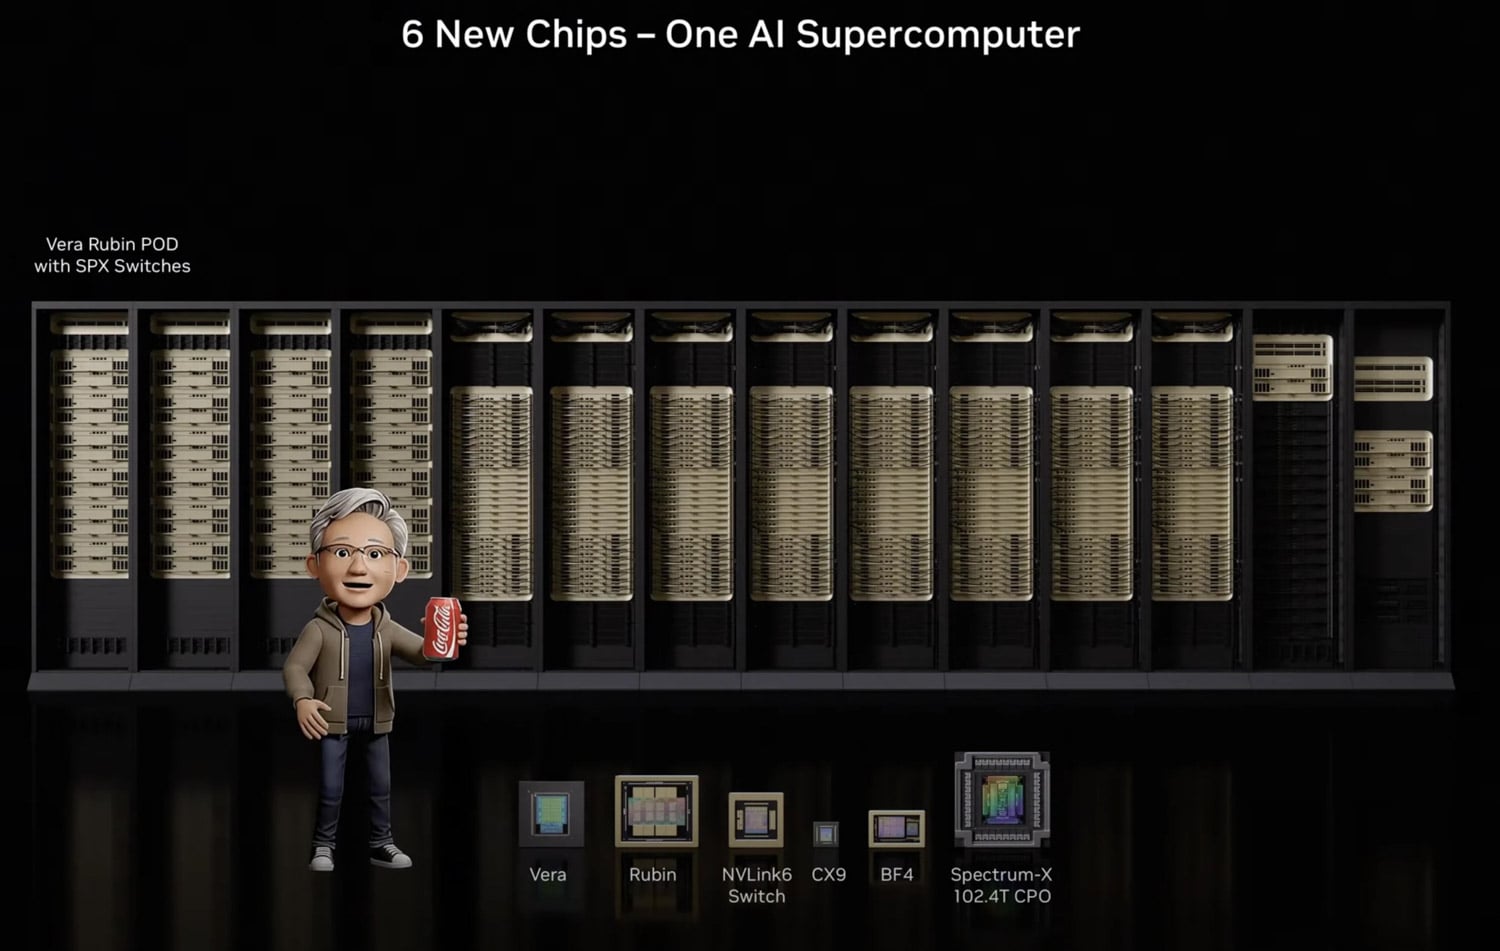
CES 2026 မှာ NVIDIA ဟာ Vera Rubin NVL72 rack-scale စနစ်နဲ့ ချိတ်ဆက်ထားတဲ့ Rubin platform ကို မိတ်ဆက်ခဲ့ပါတယ်။ ဒါဟာ NVIDIA ရဲ့ တတိယမျိုးဆက် rack-scale ဗိသုကာဖြစ်ပြီး ပူးတွဲဒီဇိုင်းထုတ်ထားတဲ့ ချစ်ပ်ခြောက်ခုကို တစ်ခုတည်းသော unified system အဖြစ် ပေါင်းစပ်ထားပါတယ်။ ဒီ platform ကို ၂၀၂၆ ခုနှစ် ဒုတိယနှစ်ဝက်မှာ မိတ်ဖက်တွေဆီကနေ ရရှိနိုင်မှာဖြစ်ပြီး ချစ်ပ်ခြောက်ခုစလုံးကို ထုတ်လုပ်ရေးကနေ ပြန်လည်ထုတ်လုပ်ပြီးဖြစ်ပြီး လက်ရှိမှာ တကယ့် workloads တွေနဲ့ validation လုပ်နေပါတယ်။
Vera Rubin NVL72: ချစ်ပ်ခြောက်ခု၊ ပေါင်းစည်းထားသောစနစ်တစ်ခု
Vera Rubin NVL72 သည် NVIDIA မှ “အလွန်ကြီးမားသော ပူးတွဲဒီဇိုင်း” ဟုခေါ်ဆိုသည့်အရာကို အသုံးပြုထားပြီး ၎င်းတွင် မတူညီသော ချစ်ပ်ခြောက်ခုကို ပေါင်းစည်းထားသော စနစ်တစ်ခုအဖြစ် လုပ်ဆောင်ရန် ဖန်တီးထားသည်။
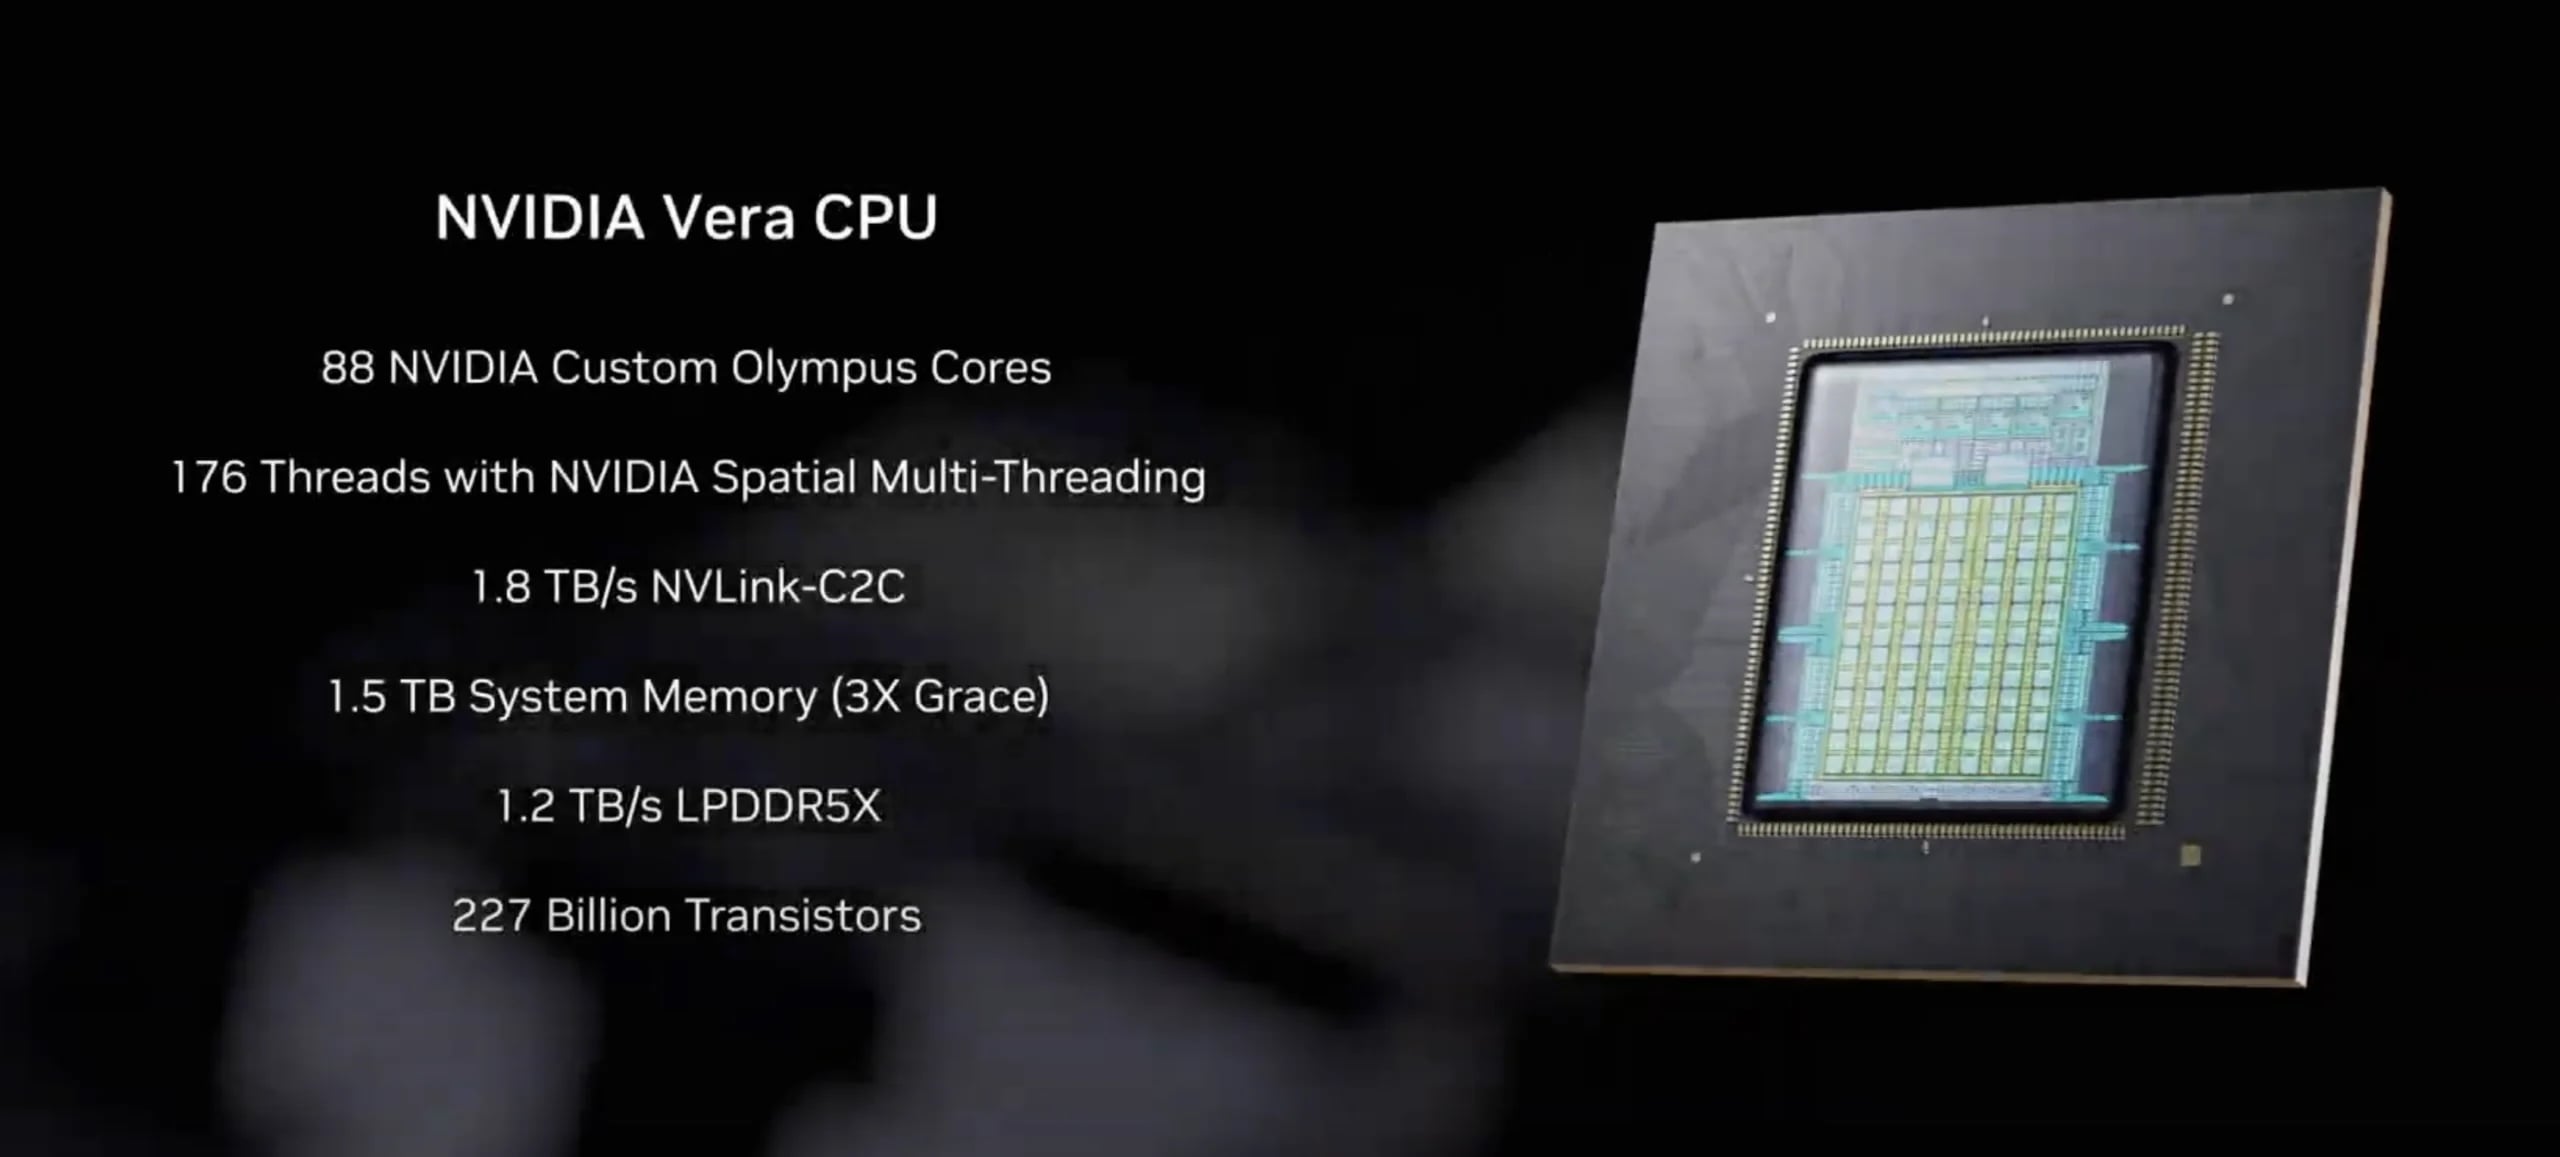
Vera CPU: ARM Silicon သည် AI စက်ရုံများအတွက် ဒီဇိုင်းထုတ်ထားသည်
ပထမဆုံးပြသခဲ့တဲ့ချစ်ပ်ကတော့ NVIDIA Vera CPU ဖြစ်ပြီး NVIDIA က AI workloads အတွက် custom ARM silicon မှာ ရင်းနှီးမြှုပ်နှံမှုကို ဆက်လက်လုပ်ဆောင်နေပါတယ်။ အပြည့်အဝ Armv9.2 တွဲဖက်အသုံးပြုနိုင်မှုရှိတဲ့ custom Olympus ARM cores ၈၈ ခုပေါ်မှာ တည်ဆောက်ထားတဲ့ Vera ကို ခေတ်မီ AI စက်ရုံတွေရဲ့ data movement နဲ့ agentic processing လိုအပ်ချက်တွေအတွက် အထူးဒီဇိုင်းထုတ်ထားပါတယ်။ ၎င်းမှာ NVLink-C2C ချိတ်ဆက်မှုပါဝင်ပြီး Rubin GPU တွေကို 1.8 TB/s bandwidth ပေးစွမ်းနိုင်ပြီး ယခင်မျိုးဆက်တွေထက် C2C bandwidth ကို နှစ်ဆတိုးစေကာ PCIe Gen 6 ထက် ခုနစ်ဆပိုမြန်ပါတယ်။ Vera CPU ဟာ ယခင်မျိုးဆက် Grace CPU ထက် data processing, compression နဲ့ code compilation တွေရဲ့ စွမ်းဆောင်ရည်ကို နှစ်ဆတိုးစေပါတယ်။
မျိုးဆက်နှိုင်းယှဉ်ချက်- Blackwell Ultra vs. Vera Rubin NVL72
| specification | GB300 NVL72 (ဘလက်ဝဲလ် အာလ်ထရာ) | VR NVL72 (ဗီရာ ရူဘင်) |
|---|---|---|
| GPU အရေအတွက် | Blackwell Ultra GPU ၇၂ ခု | Rubin GPU ၇၂ ခု |
| CPU အရေအတွက် | Grace CPU ၃၆ လုံး | Vera CPU ၃၆ လုံး |
| CPU ကို core | CPU တစ်ခုလျှင် ARM cores ၇၂ ခု | CPU တစ်ခုလျှင် Olympus ARM cores ၈၈ ခု |
| FP4 ကောက်ချက်ချမှု စွမ်းဆောင်ရည် | ၀.၅ အိတ်ဆာဖလော့ပ်များ | ၀.၅ အိတ်ဆာဖလော့ပ်များ |
| GPU တစ်ခုလျှင် NVFP4 (ကောက်ချက်ချခြင်း) | ၁၁.၁၅ PFLOPS | ၁၁.၁၅ PFLOPS |
| GPU တစ်ခုလျှင် NVFP4 (လေ့ကျင့်ရေး) | ၁၁.၁၅ PFLOPS | ၁၁.၁၅ PFLOPS |
| GPU မှတ်ဉာဏ်အမျိုးအစား | HBM3e | HBM4 |
| GPU Memory Bandwidth | ~၂၂ တီဘီ/စက္ကန့် | ~၂၂ တီဘီ/စက္ကန့် |
| NVLink ထုတ်လုပ်ခြင်း | NVLink ၆ | NVLink ၆ |
| NVLink Bandwidth (GPU တစ်ခုချင်းစီ) | ၁ TB / s | ၁ TB / s |
| Rack-Scale NVLink Bandwidth | ၁ TB / s | ၁ TB / s |
| Scale-Out NIC | ConnectX-8 (၈၀၀ Gb/s) | ConnectX-9 (၁.၆ TB/s) |
| CPU-GPU အပြန်အလှန်ချိတ်ဆက်မှု | NVLink-C2C (၉၀၀ GB/s) | NVLink-C2C (၁.၈ TB/s) |
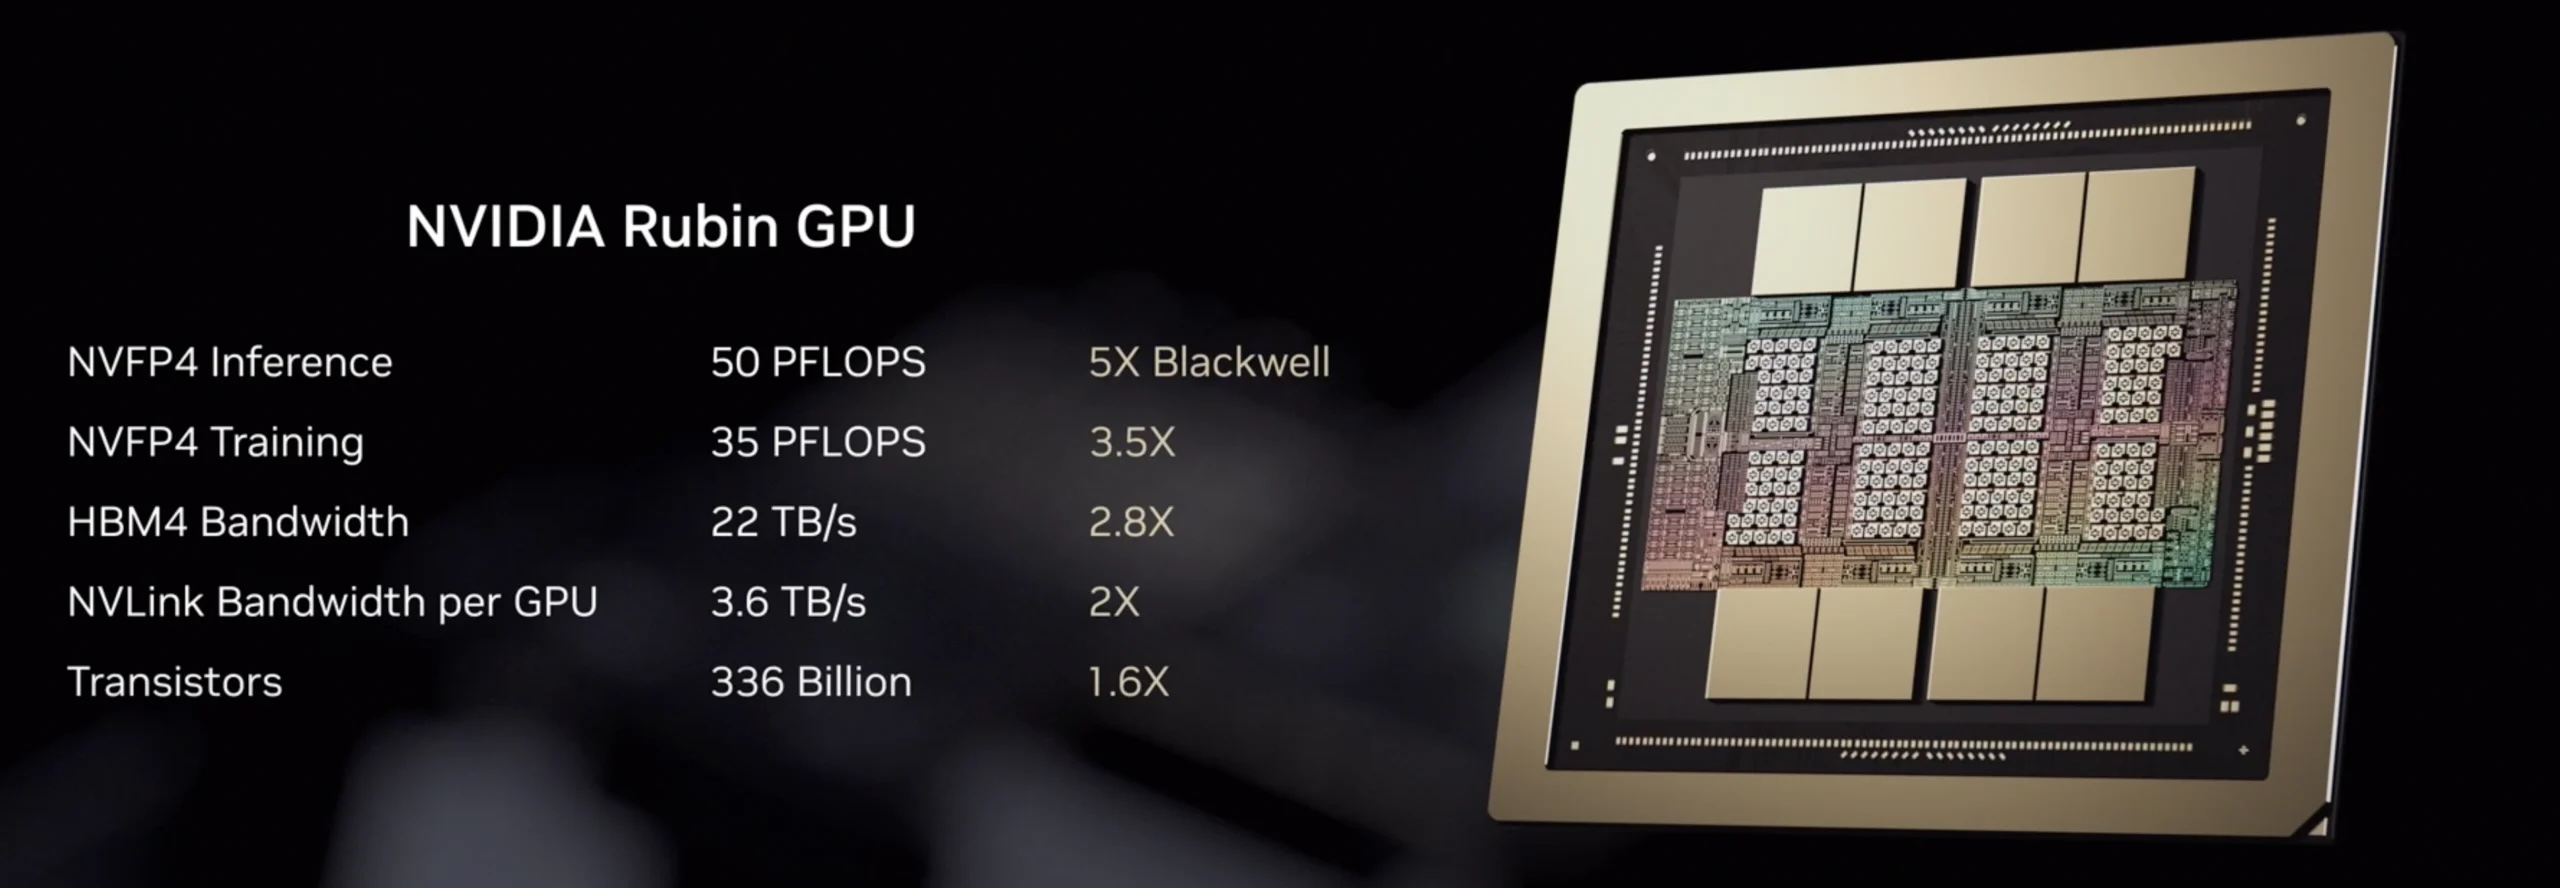
Rubin GPU: Transformer Engines၊ NVFP4 နှင့် HBM4
နောက်တစ်ခုကတော့ ရှိုးရဲ့ကြယ်ပွင့် NVIDIA Rubin GPU ဖြစ်ပြီး hardware-accelerated adaptive compression ပါဝင်တဲ့ တတိယမျိုးဆက် Transformer Engine ပါရှိပါတယ်။ ဒါက transformer layer တွေတစ်လျှောက်မှာ တိကျမှုကို dynamically ချိန်ညှိပေးပြီး တိကျမှုကို လျှော့ချနိုင်တဲ့နေရာတွေမှာ throughput မြင့်မားစွာရရှိစေပြီး အရေးကြီးတဲ့နေရာတွေမှာ တိကျမှုကို ထိန်းသိမ်းထားနိုင်ပါတယ်။ ဒီ NVFP4 အကောင်အထည်ဖော်မှုက compute အတွက် 50 petaflops (5x Blackwell) နဲ့ training အတွက် 35 petaflops (3.5x Blackwell) ကို ပေးစွမ်းပါတယ်။ Rubin GPU ဟာ HBM4 memory ကို 22 TB/s အထိ bandwidth နဲ့ ပေါင်းစပ်ထားတဲ့ ပထမဆုံး GPU ဖြစ်ပြီး MoE မော်ဒယ်ကြီးတွေကို ရင်ဆိုင်နေရတဲ့ memory bandwidth wall ကို သိသိသာသာ ကျော်လွှားနိုင်စေပါတယ်။
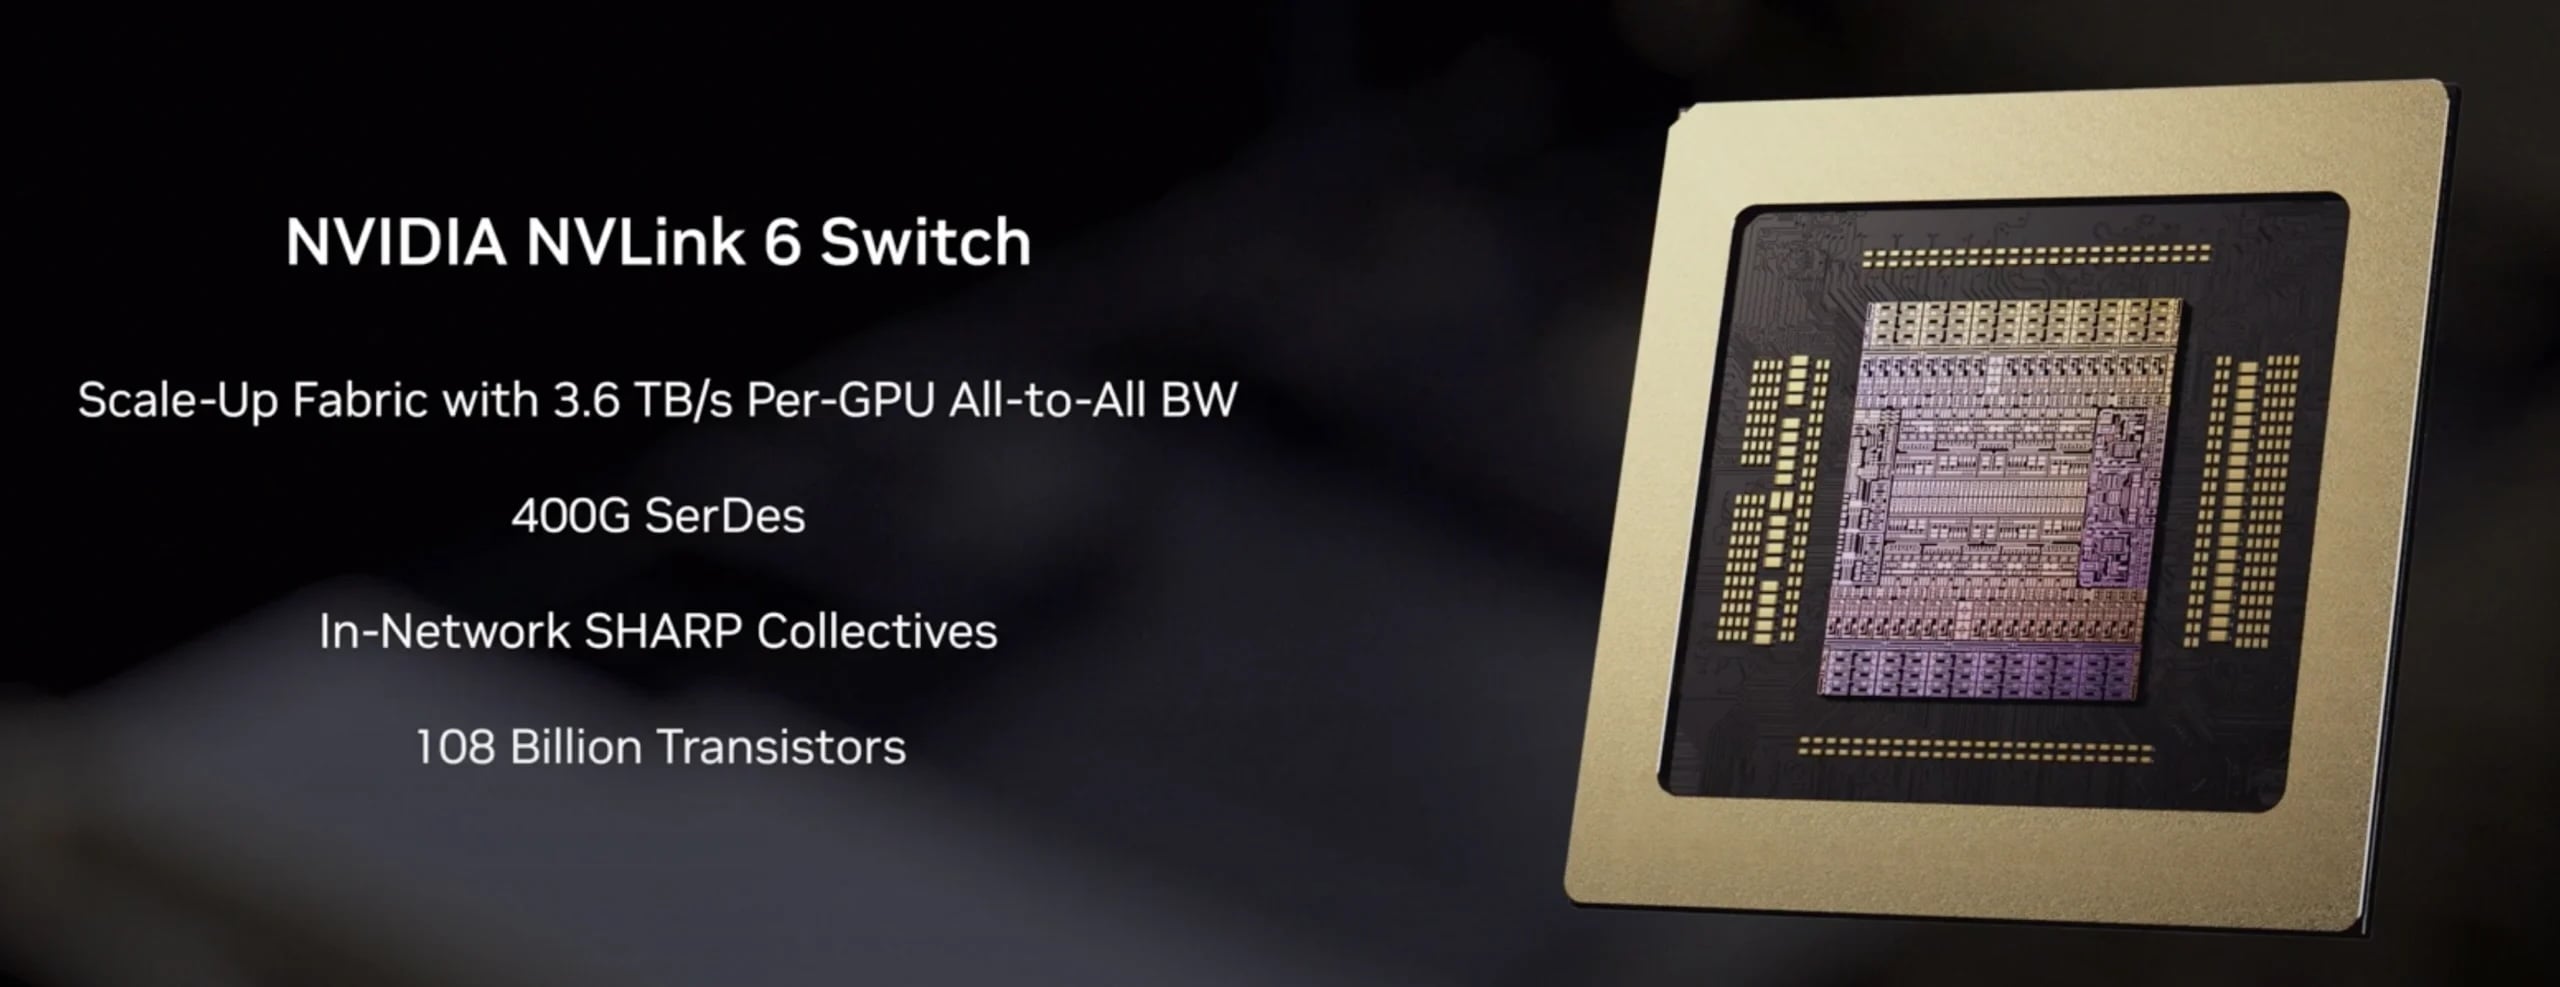
NVLink 6: Rack-Scale All-to-All ဆက်သွယ်ရေး
NVIDIA NVLink 6 Switch သည် GPU တစ်ခုလျှင် bandwidth ကို 3.6 TB/s အထိ နှစ်ဆတိုးစေပြီး၊ full rack သည် 260 TB/s scale-up networking ကို ပေးစွမ်းနိုင်ပြီး ၎င်းသည် ကမ္ဘာလုံးဆိုင်ရာ အင်တာနက်၏ cross-sectional bandwidth ထက် နှစ်ဆကျော် ပိုမိုများပြားပါသည်။ ဤ scale-up fabric သည် GPU တစ်ခုစီကို အခြား GPU တစ်ခုစီနှင့် တစ်ပြိုင်နက်တည်း ဆက်သွယ်နိုင်စေပါသည် (MoE expert parallelism အတွက် လိုအပ်ချက်တစ်ခု)၊ ကျွမ်းကျင်သူအားလုံးသည် cluster တစ်လျှောက်တွင် ရလဒ်များကို မျှဝေရမည်ဖြစ်သည်။ built-in in-network compute သည် စုပေါင်းလုပ်ဆောင်မှုများကို အရှိန်မြှင့်တင်ပေးပြီး ပိတ်ဆို့မှုကို လျှော့ချပေးပြီး GPU လည်ပတ်မှုများကို ကုန်ဆုံးစေမည့် အလုပ်များကို offload လုပ်ပါသည်။
ConnectX-9 SuperNIC: Scale-Out ကွန်ရက်ချိတ်ဆက်မှုကို ပြန်လည်အဓိပ္ပာယ်ဖွင့်ဆိုခြင်း
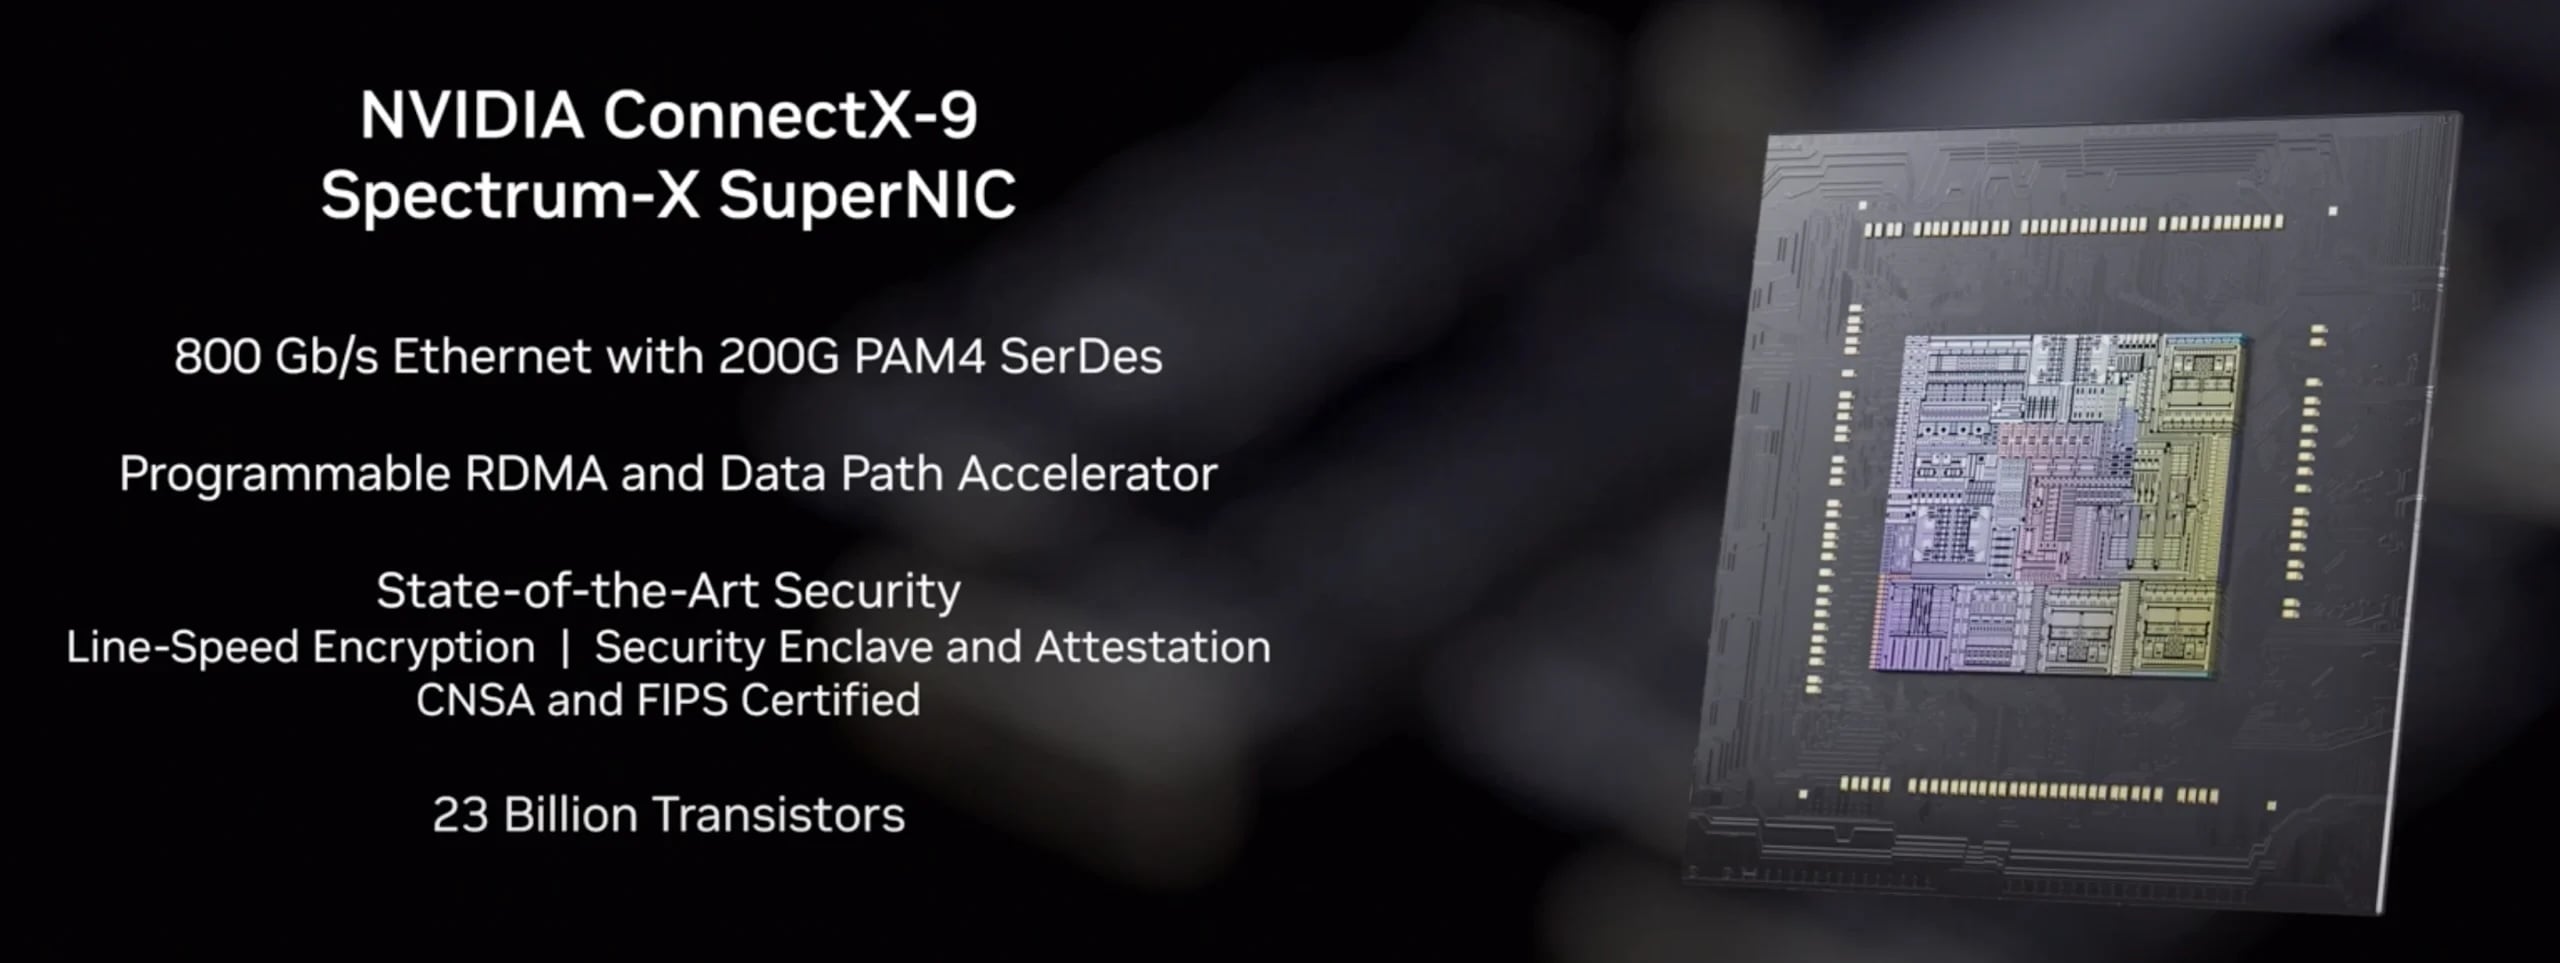
NVIDIA ConnectX-9 SuperNIC သည် scale-out networking ကို ကိုင်တွယ်ပြီး rack ပြင်ပဆက်သွယ်ရေးအတွက် GPU တစ်ခုလျှင် RDMA bandwidth 1.6 TB/s ပေးပါသည်။ ဒေတာလမ်းကြောင်းထိရောက်မှုကို အမြင့်ဆုံးဖြစ်စေရန် ConnectX-9 ကို Vera CPU နှင့် ပူးတွဲဒီဇိုင်းထုတ်ထားပြီး AI ဓာတ်ခွဲခန်းများအနေဖြင့် ၎င်းတို့၏ သီးခြားမော်ဒယ်ဗိသုကာပုံစံများအတွက် အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ထားသော စိတ်ကြိုက်ဒေတာရွေ့လျားမှု အယ်လဂိုရီသမ်များကို အကောင်အထည်ဖော်နိုင်စေမည့် အပြည့်အဝ software-defined၊ programmable၊ accelerated data path ကို မိတ်ဆက်ပေးထားသည်။
BlueField-4 DPU နှင့် ASTRA လုံခြုံသောဗိသုကာ
BlueField-4 သည် NVIDIA ၏ စတုတ္ထမျိုးဆက် ဒေတာလုပ်ဆောင်ခြင်းယူနစ်ဖြစ်ပြီး AI workloads များအတွက် သိုလှောင်မှုနှင့် ကွန်ရက်ချိတ်ဆက်မှုကို အခြေခံကျကျ ပြန်လည်စဉ်းစားခြင်းကို ကိုယ်စားပြုသည်။ DPU အသစ်တွင် BlueField-3 ၏ 16 ARM Cortex-A78 cores များနှင့် နှိုင်းယှဉ်ပါက 64-core NVIDIA အဆင့် CPU ပါဝင်ပြီး တွက်ချက်မှုစွမ်းဆောင်ရည်ကို 6x ဆ ပိုမိုပေးစွမ်းသည်။ ၎င်းတွင် BlueField-3 ရှိ ConnectX-7 နှင့် နှိုင်းယှဉ်ပါက ConnectX-9 SuperNIC ပူးတွဲထုပ်ပိုးထားပြီး ကွန်ရက် bandwidth ကို 800 Gb/s အထိ နှစ်ဆတိုးစေသည်။ ဒေတာသိုလှောင်မှုသို့ GPU ဝင်ရောက်ခွင့်သည် ယခင်မျိုးဆက်ထက် 2 ဆ ပိုမြန်သည်။ သတ်မှတ်ချက်တိုးတက်မှုများအပြင် BlueField-4 ၏ အရေးပါမှုသည် ၎င်းဖွင့်ပေးနိုင်သည့်အရာတွင် တည်ရှိသည်- NVIDIA သည် အတိုင်းအတာတစ်ခုအထိ agent AI အတွက် မရှိမဖြစ်လိုအပ်သည်ဟု သတ်မှတ်နေသော AI-native storage infrastructure အလွှာအသစ်တစ်ခု။
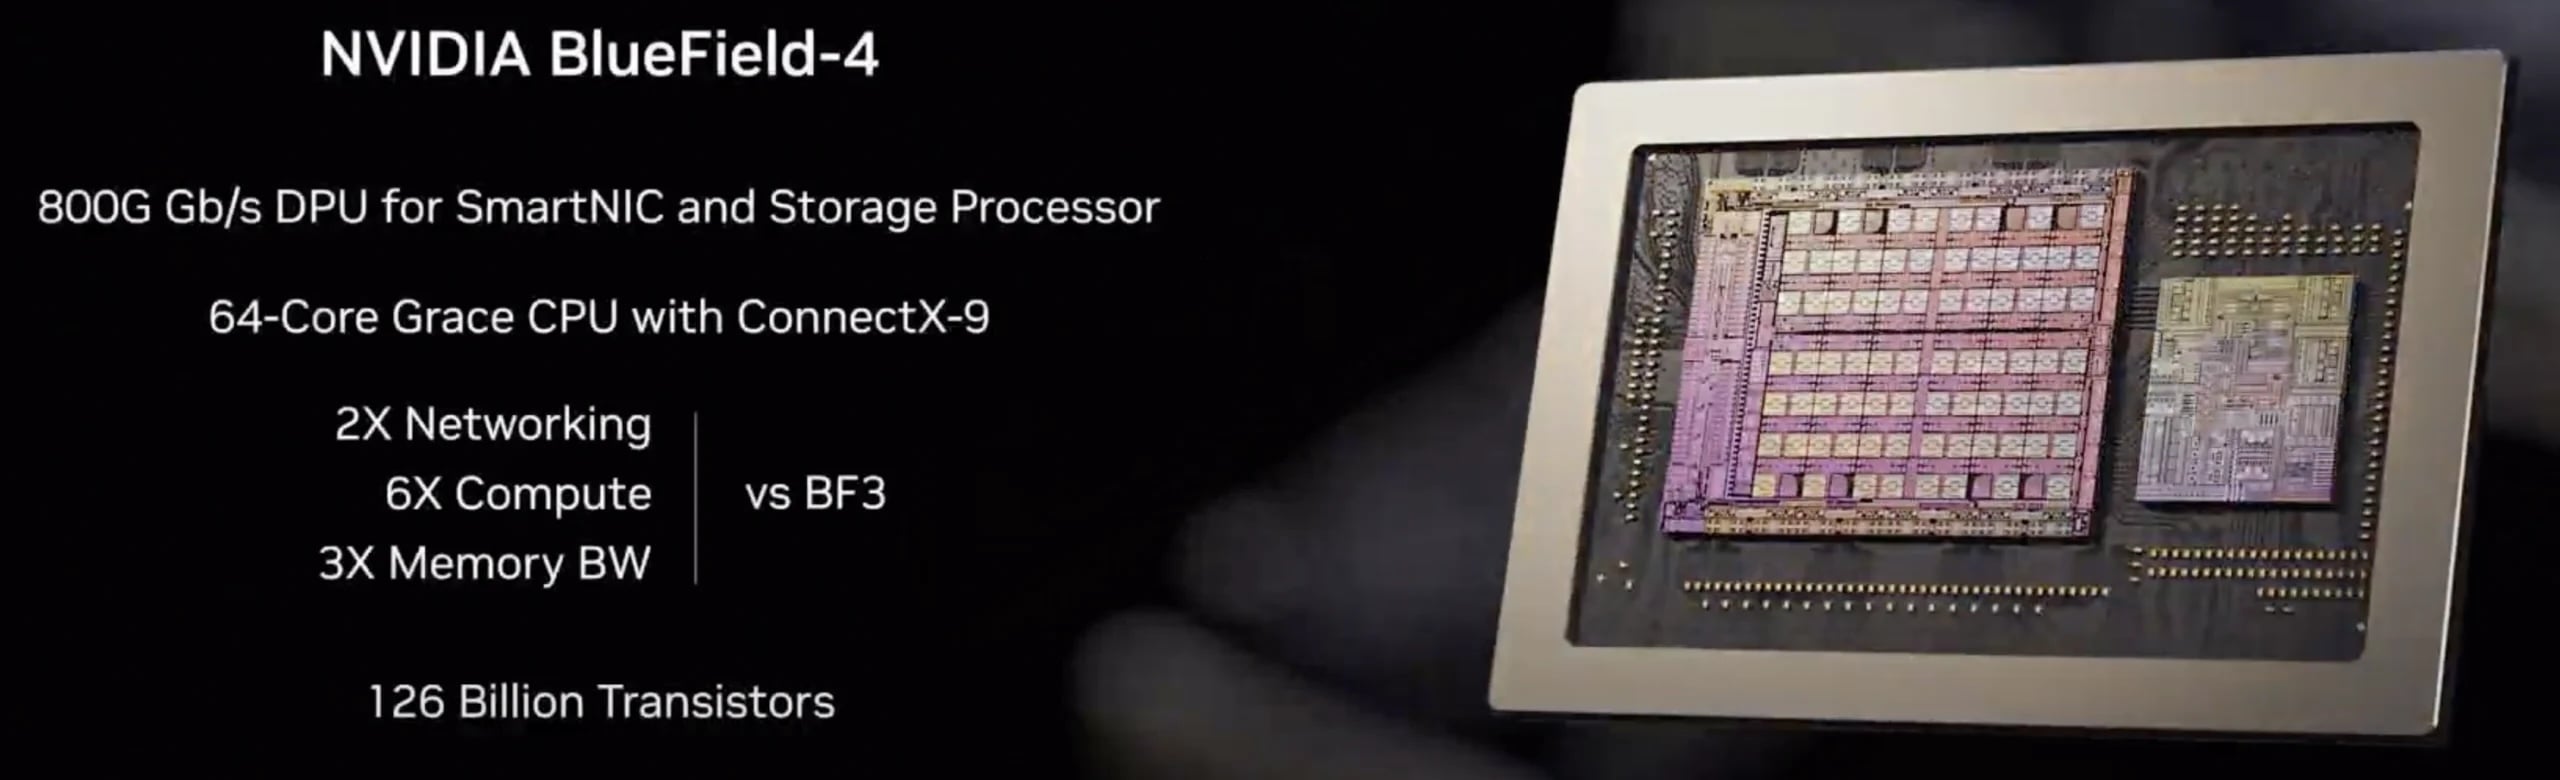
BlueField-4 သည် ကွန်ရက်၊ သိုလှောင်မှုနှင့် လုံခြုံရေး လုပ်ဆောင်မှုတို့ကို လျှော့ချပေးသောကြောင့် Rubin GPU များနှင့် Vera CPU များသည် မော်ဒယ် အကောင်အထည်ဖော်မှုတွင် အာရုံစိုက်နေမည်ဖြစ်သည်။ ၎င်းကို NVIDIA Enterprise AI Factory အတည်ပြုထားသော ဒီဇိုင်းနှင့် အပြည့်အဝ ပေါင်းစပ်ထားပြီး Red Hat၊ Palo Alto Networks၊ Fortinet နှင့် အခြားကုမ္ပဏီများမှ ဂေဟစနစ်ပံ့ပိုးမှုဖြင့် ပြုလုပ်ထားသည်။
BlueField-4 သည် ASTRA (Advanced Secure Trusted Resource Architecture) ကိုလည်း မိတ်ဆက်ပေးပါသည်။ ဤ system-level trust architecture သည် စွမ်းဆောင်ရည်ကို မထိခိုက်စေဘဲ ကြီးမားသော AI ပတ်ဝန်းကျင်များကို လုံခြုံစွာ ပံ့ပိုးပေးခြင်း၊ သီးခြားခွဲထားခြင်းနှင့် လည်ပတ်ခြင်းအတွက် တစ်ခုတည်းသော ထိန်းချုပ်မှုအမှတ်ကို ပေးပါသည်။
Rack တစ်ခုလုံးတွင် လျှို့ဝှက်ကွန်ပျူတာစနစ်
Vera Rubin NVL72 သည် NVIDIA Confidential Computing ကို စနစ်တစ်ခုလုံးတွင် ပေးပို့သည့် ပထမဆုံး rack-scale platform ဖြစ်သည်။ တတိယမျိုးဆက် လျှို့ဝှက်ကွန်ပျူတာသည် CPU၊ GPU နှင့် NVLink domain တစ်ခုလုံးတွင် ဒေတာလုံခြုံရေးကို ထိန်းသိမ်းပေးပြီး bus တိုင်းကို encrypt လုပ်ထားသည်။ ၎င်းသည် shared infrastructure ပေါ်တွင် proprietary model များကို လည်ပတ်နေသော enterprise များနှင့် AI lab များကြားတွင် တိုးပွားလာနေသော စိုးရိမ်မှုကို ဖြေရှင်းပေးသည်- third-party system များတွင် ဖြန့်ကျက်ထားသည့်တိုင် model များ၊ training data နှင့် inference workloads များကို ကာကွယ်ထားနိုင်ကြောင်း အာမခံနိုင်စွမ်း။
NVIDIA Spectrum-6 Ethernet Switch သည် Nvidia ၏ scale-out network များကို စွမ်းအားပေးသည်။ ၎င်းကို co-packaged optics (CPO) ပါရှိသော 200G SerDes နည်းပညာပေါ်တွင် တည်ဆောက်ထားပြီး 102 TB/s switching capacity ရရှိကာ VR NVL72 racks များတစ်လျှောက် အရှေ့-အနောက် traffic ကို စွမ်းအားပေးသည်။ CPO သို့ ရွှေ့ပြောင်းခြင်းသည် အရေးပါပါသည်။ switch silicon နှင့် optics ကို တိုက်ရိုက်ပေါင်းစပ်ခြင်းဖြင့် NVIDIA သည် ရိုးရာ pluggable optics များနှင့် နှိုင်းယှဉ်ပါက 10x ပိုမိုကောင်းမွန်သော ယုံကြည်စိတ်ချရမှု၊ 5x ပိုမိုရှည်လျားသော uptime နှင့် 5x ပိုမိုကောင်းမွန်သော power efficiency တို့ကို ရရှိကြောင်း ပြောကြားခဲ့သည်။

MoE မော်ဒယ်များအတွက် ကုန်ကျစရိတ်နှင့် ထိရောက်မှုတိုးတက်မှုများ
NVIDIA က VR NVL72 ဟာ Blackwell လိုပဲ latency တူညီတဲ့အချိန်မှာ Mixture-of-Experts model inference အတွက် token cost ရဲ့ ခုနစ်ပုံတစ်ပုံကို ပေးစွမ်းနိုင်တယ်လို့ ဖော်ပြခဲ့ပါတယ်။ တူညီတဲ့ MoE model ကြီးကို အချိန်ပမာဏတူ လေ့ကျင့်ပေးဖို့ GPU လေးပုံတစ်ပုံသာ လိုအပ်ပါတယ်။ ဒီ platform ဟာ watt တစ်ခုအတွက် inference compute ရဲ့ 8 ဆ မြန်ဆန်ပါတယ်။
ဤတိုးတက်မှုများသည် မည်သည့်တိုကင်အတွက်မဆို ၎င်းတို့၏ကျွမ်းကျင်သူများ၏ အစုအဖွဲ့တစ်ခုကိုသာ အသက်သွင်းသည့် MoE မော်ဒယ်များ၏ လိုအပ်ချက်များကို ဖြေရှင်းပေးပါသည်။ Kimi K2 Thinking ကဲ့သို့သော မော်ဒယ်များသည် ကျွမ်းကျင်သူ ၃၈၄ ဦးကို ခန့်အပ်သော်လည်း တစ်ကြိမ်လျှင် ရှစ်ဦးသာ အသက်သွင်းသောကြောင့် ကြီးမားသော all-to-all GPU ဆက်သွယ်ရေး လိုအပ်ပါသည်။ VR NVL72 ၏ 260 TB/s scale-up networking သည် ဤဆက်သွယ်ရေးပုံစံကို ကိုင်တွယ်ပါသည်။
ကြီးမားသော စကေးအတွက် ဒီဇိုင်းထုတ်ထားသော ကြိုးမဲ့ စင်
VR NVL72 သည် အတွင်းပိုင်းကြိုးများအစား PCB များနှင့် connector များကိုသာအသုံးပြုသည့် modular၊ cable-free၊ fan-free နှင့် hose-free tray ဒီဇိုင်းကို မိတ်ဆက်ပေးထားသည်။ compute trays များကို rack ထဲသို့ထည့်သွင်းသောအခါ blind-mate connector များမှတစ်ဆင့် ချိတ်ဆက်ထားသောကြောင့် manual cable routing မလိုအပ်တော့ပါ။ ပြင်ပချိတ်ဆက်မှုများမှာ liquid cooling block များနှင့်ချိတ်ဆက်ထားသော liquid inlet နှင့် outlet hoses နှစ်ခုသာရှိသည်။

GB300 NVL72 ကဲ့သို့သော ယခင်စနစ်များသည် တစ်ခုတည်းသော compute tray တစ်ခုကို တပ်ဆင်ရန် မိနစ် ၁၀၀ ခန့် ကြာမြင့်ခဲ့သည်။ ကေဘယ်လ်ချိတ်ဆက်မှုတစ်ခုစီသည် ဖြစ်နိုင်ချေရှိသော ချို့ယွင်းချက်တစ်ခုဖြစ်ပြီး GPU ရာပေါင်းများစွာ၏ စကေးတွင် ၎င်းသည် အရေးပါလာသည်။ ကေဘယ်လ်ချိတ်ဆက်မှုသည် အအေးပေးလမ်းကြောင်းများကို ကန့်သတ်ထားပြီး နေရာယူမှုကို ကုန်ဆုံးစေခဲ့ပြီး ပန်ကာများသည် စက်ပိုင်းဆိုင်ရာ ရှုပ်ထွေးမှုနှင့် ဆူညံသံကို တိုးစေခဲ့သည်။
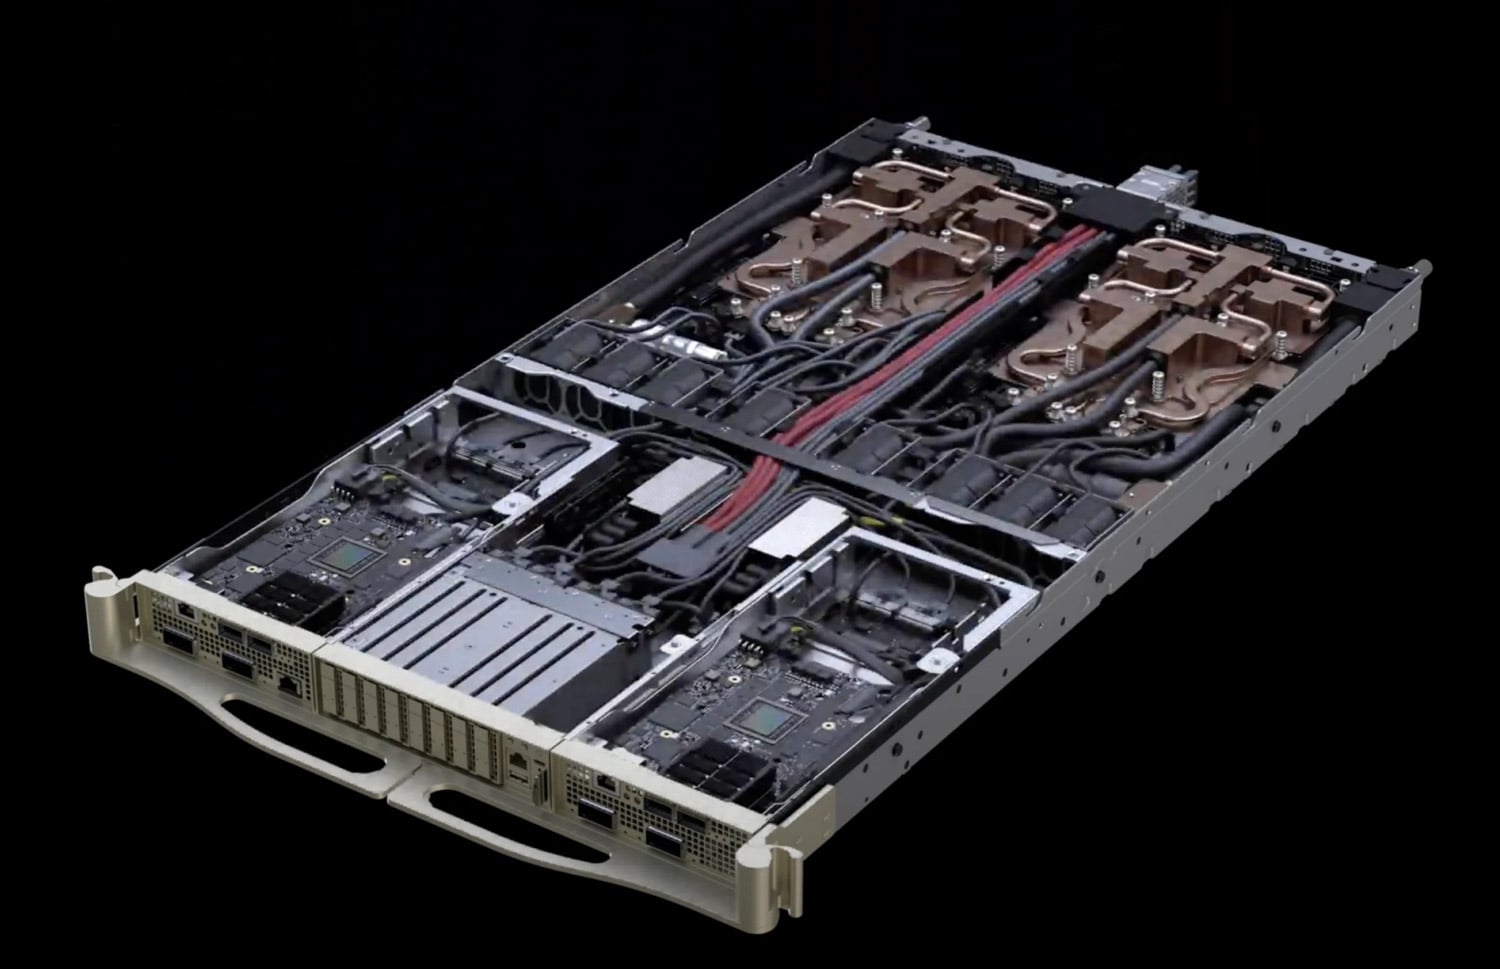
ဒီဇိုင်းအသစ်ကြောင့် တပ်ဆင်ခြင်းနှင့် ဝန်ဆောင်မှုပေးချိန်ကို ၁၈ ဆ လျှော့ချပေးပါသည်။ ယင်းပလက်ဖောင်းတွင် GPU၊ CPU နှင့် NVLink တို့ပါဝင်သော ဒုတိယမျိုးဆက် RAS (Reliability, Availability, Serviceability) အင်ဂျင်လည်း ပါဝင်ပြီး အချိန်နှင့်တပြေးညီ ကျန်းမာရေးစစ်ဆေးမှုများ၊ ချို့ယွင်းချက်ခံနိုင်ရည်ရှိမှုနှင့် ကြိုတင်ပြုပြင်ထိန်းသိမ်းမှုများကို ပေးဆောင်ပါသည်။ NVLink switch trays များသည် ယခုအခါ zero-downtime ပြုပြင်ထိန်းသိမ်းမှုကို ပံ့ပိုးပေးသောကြောင့် switch trays များကို ဖယ်ရှားခြင်း သို့မဟုတ် တစ်စိတ်တစ်ပိုင်းထည့်သွင်းခြင်းပြုလုပ်နေစဉ် rack များကို လည်ပတ်နေနိုင်စေပါသည်။ GPU ရာပေါင်းများစွာဖြင့် ဤဝန်ဆောင်မှုပေးနိုင်မှုတိုးတက်မှုများသည် cluster uptime နှင့် goodput ကို တိုက်ရိုက်အကျိုးသက်ရောက်စေပါသည်။
ဤဗိသုကာလက်ရာသည် အနာဂတ်တွင် ပိုမိုမြင့်မားသော သိပ်သည်းဆရှိသော ဖွဲ့စည်းမှုပုံစံများကို ဖြစ်ပေါ်စေပါသည်။ ၎င်းသည် AI Infra Summit တွင် ကျွန်ုပ်တို့ ယခင်က ထုတ်ဖော်ပြသခဲ့သော Vera Rubin CPX rack ဒီဇိုင်းများကို ခွင့်ပြုရန် အတွက်လည်း အဓိကသော့ချက်ဖြစ်ပြီး ၊ ၎င်းသည် Context Processing GPU များကို တူညီသော compute sled သို့ ထပ်လောင်းထည့်သွင်းပေးသည့် መልእክትထူထပ်သော ဒီဇိုင်းတစ်ခုဖြစ်သည်။
ဆက်စပ်မှု မှတ်ဉာဏ် သိုလှောင်မှု ပလက်ဖောင်း
NVIDIA သည် CES 2026 တွင် KV cache အတွက် သီးသန့်တည်ဆောက်ထားသော AI-native storage infrastructure အမျိုးအစားအသစ်တစ်ခုဖြစ်သည့် Inference Context Memory Storage Platform ကို ကြေညာခဲ့သည်။ ဤ platform ကို BlueField-4 နှင့် Spectrum-X Ethernet networking မှ စွမ်းအားပေးထားသည်။ ၎င်းသည် inference context အတွက် အသုံးပြုသော ရိုးရာ network storage ထက် တစ်စက္ကန့်လျှင် ၅ ဆ ပိုမိုမြင့်မားသော tokens များကို ပေးစွမ်းနိုင်ပြီး TCO တစ်ဒေါ်လာလျှင် ၅ ဆ ပိုမိုကောင်းမွန်သော စွမ်းဆောင်ရည်၊ ၅ ဆ ပိုမိုကောင်းမွန်သော power efficiency နှင့် ၂၀ ဆ ပိုမိုမြန်ဆန်သော time-to-first-token တိုးတက်မှုများ ပေးစွမ်းနိုင်သည်။ BlueField-4 ၏ hardware-accelerated KV cache placement သည် metadata overhead ကို ဖယ်ရှားပေးပြီး data movement ကို လျှော့ချပေးပြီး Spectrum-X Ethernet သည် RDMA-based access အတွက် high-bandwidth နှင့် low-latency fabric ကို ပေးစွမ်းသည်။
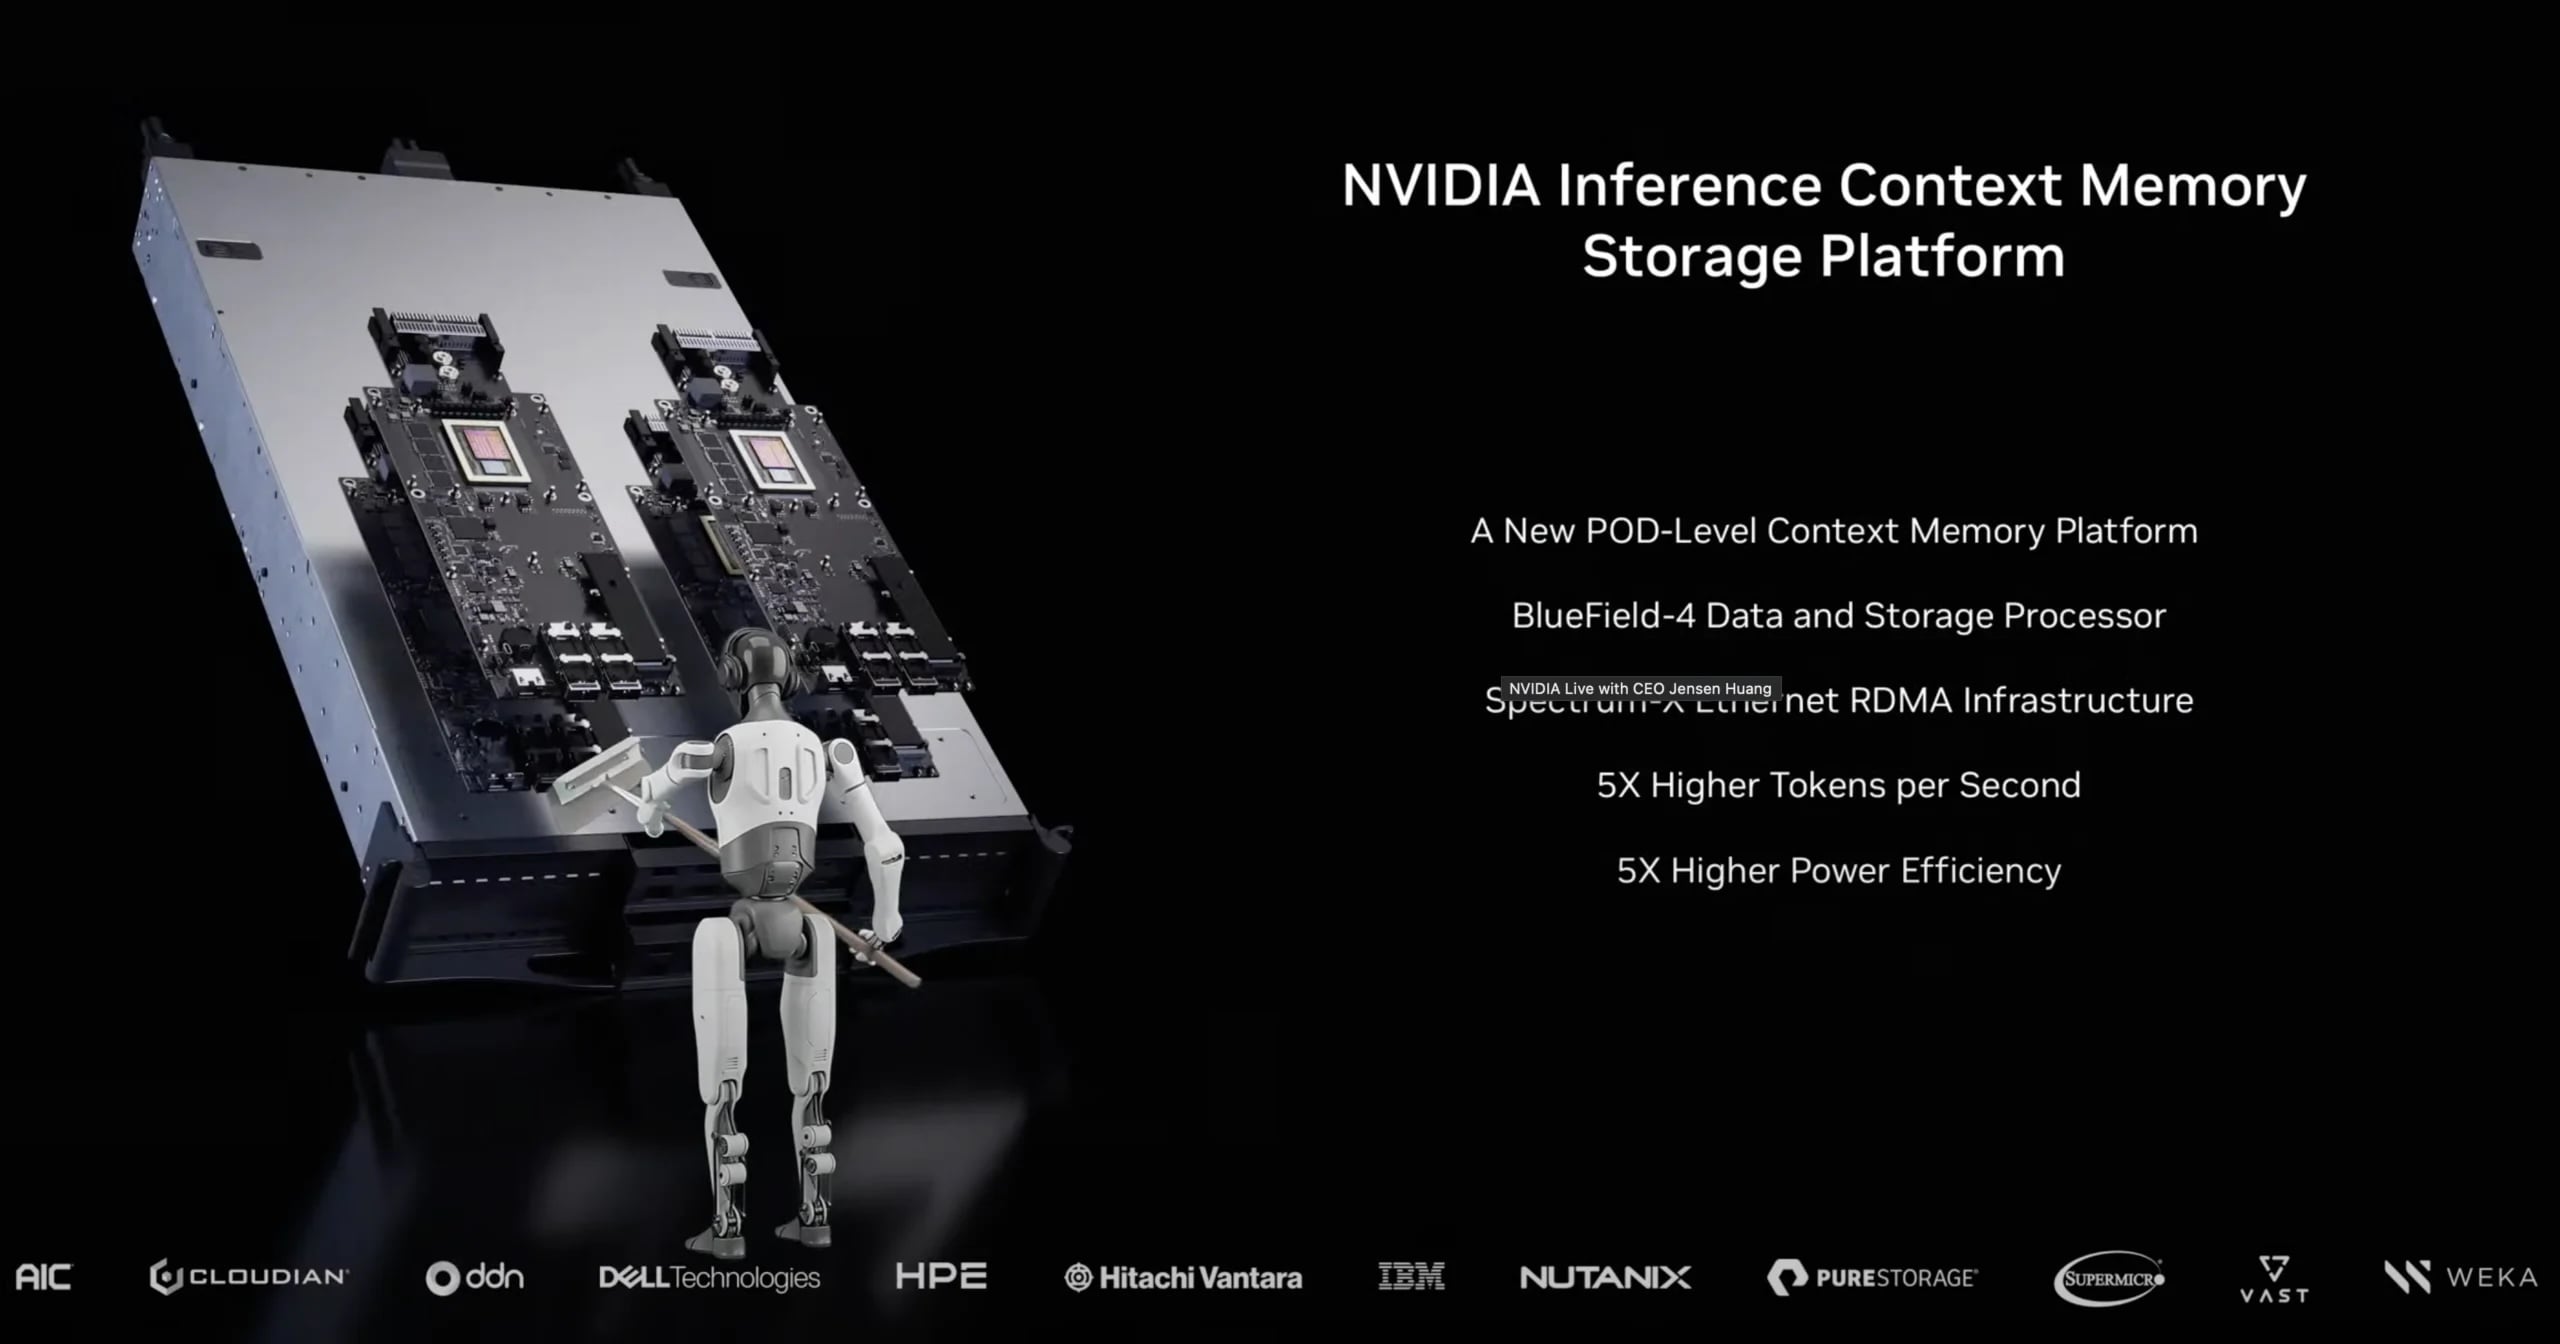
ဤပလက်ဖောင်းသည် LLM ကောက်ချက်တွင် တိုးပွားလာသော အတားအဆီးတစ်ခုကို ကိုင်တွယ်ဖြေရှင်းသည်- KV cache စီမံခန့်ခွဲမှု။ Transformer မော်ဒယ်များသည် ထုတ်လုပ်ထားသော တိုကင်တစ်ခုစီသည် ယခင်တိုကင်အားလုံးကို ဂရုစိုက်ရမည့် အာရုံစိုက်မှုယန္တရားကို အသုံးပြုသည်။ caching မပြုလုပ်ပါက၊ ၎င်းသည် တိုကင်တိုင်းအတွက် key နှင့် value vector များကို ပြန်လည်တွက်ချက်ရန် လိုအပ်ပြီး O(n²) ရှုပ်ထွေးမှုကို ဖြစ်ပေါ်စေပါသည်။ KV caching သည် ဤကြိုတင်တွက်ချက်ထားသော မက်ထရစ်များကို ပြန်လည်အသုံးပြုရန်အတွက် မှတ်ဉာဏ်တွင် သိမ်းဆည်းထားပြီး ရှုပ်ထွေးမှုကို O(n) သို့ လျှော့ချပေးသည်။ ပြဿနာမှာ KV cache အရွယ်အစားသည် sequence အရှည်နှင့် batch အရွယ်အစားနှင့်အတူ linearly ကြီးထွားလာခြင်းဖြစ်သည်။ တစ်ခုတည်းသော long-context conversation သည် memory gigabytes ကို စားသုံးနိုင်သည်။ multi-tenant environments များတွင်၊ token သန်းပေါင်းများစွာအထိ ကျယ်ပြန့်သော context window များတစ်လျှောက် concurrent request ထောင်ပေါင်းများစွာကို ကိုင်တွယ်သောအခါ၊ GPU HBM သည် ကုန်ခန်းသွားသည်။ အော်ပရေတာများသည် batch အရွယ်အစားများကို လျှော့ချရမည်၊ context window များကို တိုတောင်းစေရမည်၊ သို့မဟုတ် GPU များ ပိုမိုဝယ်ယူရမည်။
ရိုးရာကွန်ရက်သိုလှောင်မှုကို KV cache access patterns များအတွက် ဒီဇိုင်းထုတ်ထားခြင်းမဟုတ်ပါ၊ ၎င်းသည် concurrent session များစွာတွင် ပျံ့နှံ့နေသော transient data terabytes များအတွက် latency နိမ့်သော random access လိုအပ်ပါသည်။ Inference Context Memory Storage Platform သည် ဤ workload အတွက် အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ထားသော dedicated storage tier ကို ပေးစွမ်းပြီး GPU HBM နှင့် conventional storage အကြားတွင် တည်ရှိသည်။ ၎င်းသည် AI factories များအား GPU compute မှ သီးခြားစီ context capacity ကို တိုးချဲ့နိုင်စေပါသည်။ Pliops မှ KV Cache accelerator ကို အသုံးပြု၍ NVIDIA Dynamo ဖြင့် KV cache offloading မည်သို့အလုပ်လုပ်သည်ကို ကျွန်ုပ်တို့ ယခင်က ဆွေးနွေးခဲ့ပါသည်။ NVIDIA သည် NVIDIA Inference Context Memory Storage Platform ဖြင့် ၎င်းကို တိုးချဲ့ပြီး ၎င်းတို့၏ open-source Dynamo project တွင် ချိတ်ဆက်ပေးပါသည်။ ၎င်းသည် ဤ platform အသစ်၏ disaggregated prefill/decode phases၊ smart routing နှင့် tiered storage offloading တို့ကို ပေါင်းစပ်ပေးသည့် software framework ကို ပေးစွမ်းပါသည်။
VAST Data၊ NetApp၊ DDN၊ Dell Technologies၊ HPE၊ Hitachi Vantara၊ IBM၊ Nutanix၊ Pure Storage နှင့် WEKA အပါအဝင် သိုလှောင်မှုမိတ်ဖက်များသည် BlueField-4 ဖြင့် ပလက်ဖောင်းများတည်ဆောက်နေကြသည်။ ၎င်းတို့ကို ၂၀၂၆ ခုနှစ် ဒုတိယနှစ်ဝက်တွင် ရရှိနိုင်မည်ဖြစ်သည်။
Alpamayo: အလိုအလျောက်ယာဉ်များအတွက် ကျိုးကြောင်းဆင်ခြင်ခြင်းအခြေခံ ရုပ်ပိုင်းဆိုင်ရာ AI
NVIDIA သည် ဘေးကင်းပြီး ကျိုးကြောင်းဆင်ခြင်မှုအခြေခံ အလိုအလျောက်ယာဉ် (AV) ဖွံ့ဖြိုးတိုးတက်မှုကို အရှိန်မြှင့်တင်ရန် ဒီဇိုင်းထုတ်ထားသော open AI မော်ဒယ်များ၊ simulation tools များနှင့် dataset များပါဝင်သည့် Alpamayo မိသားစုကို ကြေညာခဲ့သည်။ Alpamayo မိသားစုသည် AV ဆုံးဖြတ်ချက်ချမှတ်ခြင်းသို့ လူသားကဲ့သို့သော အတွေးအခေါ်ကို ယူဆောင်လာသည့် အတွေးကွင်းဆက်၊ ကျိုးကြောင်းဆင်ခြင်မှုအခြေခံ vision-language-action မော်ဒယ်များကို မိတ်ဆက်ပေးသည်။ NVIDIA Halo ဘေးကင်းရေးစနစ်သည် ဤစနစ်များကို အခြေခံထားသည်။
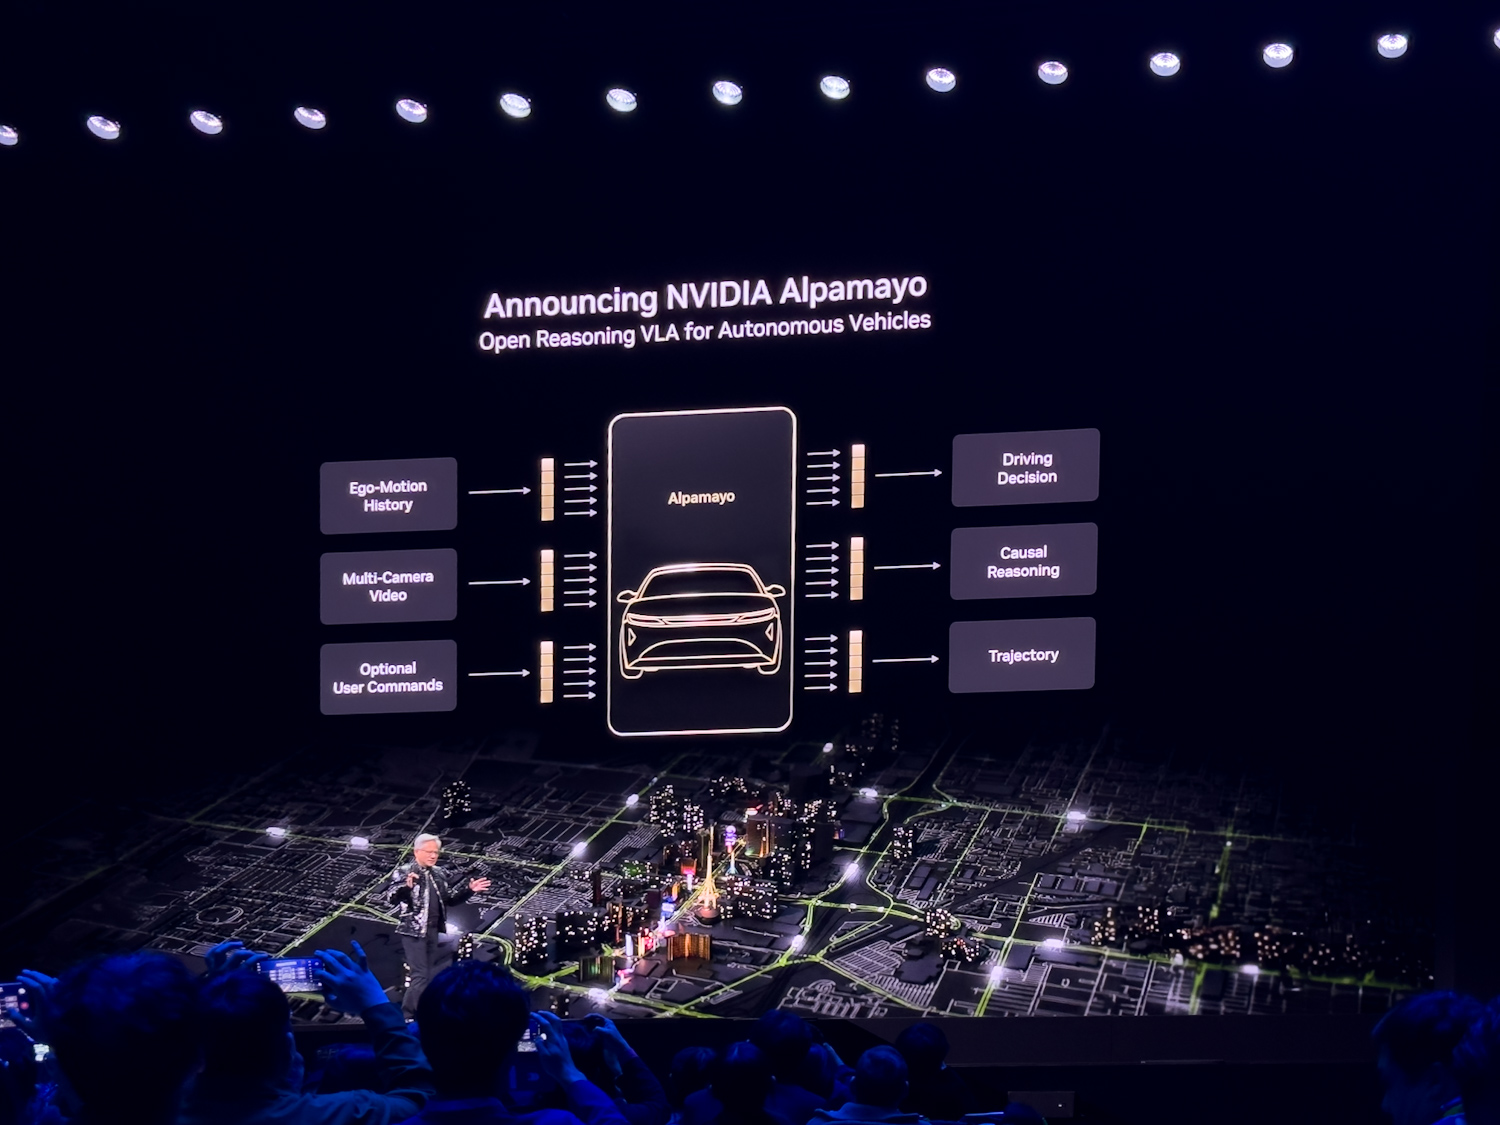
ရိုးရာ AV ဗိသုကာလက်ရာများသည် အာရုံခံစားမှုနှင့် စီမံကိန်းရေးဆွဲခြင်းကို ခွဲခြားထားပြီး၊ ၎င်းသည် အခြေအနေအသစ်များ သို့မဟုတ် ပုံမှန်မဟုတ်သော အခြေအနေများ ပေါ်ပေါက်လာသည့်အခါ တိုးချဲ့နိုင်မှုကို ကန့်သတ်နိုင်သည်။ ရှားပါးပြီး ရှုပ်ထွေးသော အခြေအနေများ၏ “ရှည်လျားသော အမြီး” သည် အလိုအလျောက်စနစ်များအတွက် ဘေးကင်းစွာ ကျွမ်းကျင်ရန် အခက်ခဲဆုံးစိန်ခေါ်မှုများထဲမှ တစ်ခုအဖြစ် ရှိနေဆဲဖြစ်သည်။ Alpamayo သည် မော်ဒယ်များအား အကြောင်းရင်းနှင့် အကျိုးဆက်ကို ကျိုးကြောင်းဆင်ခြင်နိုင်စေခြင်း၊ မောင်းနှင်နိုင်စွမ်းနှင့် ရှင်းပြနိုင်စွမ်းကို မြှင့်တင်ရန် အဆင့်ဆင့် ထူးခြားသော အခြေအနေများကို စဉ်းစားတွေးခေါ်နိုင်စေခြင်းဖြင့် ဤပြဿနာကို ဖြေရှင်းပေးသည်။
ယာဉ်အတွင်း တိုက်ရိုက်လည်ပတ်မည့်အစား Alpamayo မော်ဒယ်များသည် developer များသည် ၎င်းတို့၏ AV stack များ၏ ကျောရိုးများထဲသို့ အသေးစိတ်ချိန်ညှိပြီး ပေါင်းစပ်ထည့်သွင်းနိုင်သည့် ကြီးမားသော teacher မော်ဒယ်များအဖြစ် ဆောင်ရွက်ပါသည်။ developer များသည် Alpamayo ကို ယာဉ်ဖွံ့ဖြိုးတိုးတက်ရေးအတွက် ပိုမိုသေးငယ်သော runtime မော်ဒယ်များအဖြစ်သို့ လိုက်လျောညီထွေဖြစ်အောင် ပြုလုပ်နိုင်သည်၊ သို့မဟုတ် ၎င်းကို reasoning-based evaluators နှင့် auto-labeling systems ကဲ့သို့သော AV ဖွံ့ဖြိုးတိုးတက်ရေးကိရိယာများအတွက် အခြေခံအဖြစ် အသုံးပြုနိုင်သည်။
Alpamayo မော်ဒယ်များ၊ သရုပ်ဖော်မှုနှင့် ပွင့်လင်းသောဒေတာအစုံများ
Alpamayo 1 သည် AV သုတေသနအသိုင်းအဝိုင်းအတွက် ဒီဇိုင်းထုတ်ထားသော လုပ်ငန်း၏ ပထမဆုံး chain-of-thought reasoning VLA မော်ဒယ်ဖြစ်ပြီး Hugging Face တွင် ရရှိနိုင်ပါသည်။ 10-billion-parameter ဗိသုကာဖြင့် Alpamayo 1 သည် ကျိုးကြောင်းဆင်ခြင်ခြင်းခြေရာများနှင့်အတူ လမ်းကြောင်းများကိုထုတ်ပေးရန် ဗီဒီယို input ကို အသုံးပြုပြီး ဆုံးဖြတ်ချက်တစ်ခုစီ၏နောက်ကွယ်ရှိယုတ္တိဗေဒကိုပြသသည်။ Alpamayo 1 သည် open-source မော်ဒယ်အလေးချိန်များနှင့် inference scripts များကို ပံ့ပိုးပေးသည်။ မိသားစုအတွင်းရှိ အနာဂတ်မော်ဒယ်များတွင် ပိုမိုမြင့်မားသော parameter အရေအတွက်များ၊ ပိုမိုအသေးစိတ်ကျသော reasoning စွမ်းရည်များ၊ ပိုမိုကြီးမားသော input နှင့် output ပြောင်းလွယ်ပြင်လွယ်ရှိမှုနှင့် စီးပွားဖြစ်အသုံးပြုရန်အတွက် ရွေးချယ်စရာများ ပါဝင်မည်ဖြစ်သည်။
AlpaSim သည် GitHub တွင် ရရှိနိုင်သော high-fidelity AV ဖွံ့ဖြိုးတိုးတက်မှုအတွက် အပြည့်အဝ open-source၊ end-to-end simulation framework တစ်ခုဖြစ်သည်။ ၎င်းသည် လက်တွေ့ကျသော sensor modeling၊ configure လုပ်နိုင်သော traffic dynamics နှင့် scalable closed-loop testing environments များကို ပံ့ပိုးပေးပြီး လျင်မြန်စွာ validation နှင့် policy refinement ကို ဖြစ်စေသည်။
ရုပ်ပိုင်းဆိုင်ရာ AI Open Dataset များတွင် ကျယ်ပြန့်သော ပထဝီဝင်ဒေသများနှင့် အခြေအနေအမျိုးမျိုးတွင် စုဆောင်းထားသော မောင်းနှင်မှုဒေတာ ၁,၇၀၀+ နာရီကျော် ပါဝင်ပြီး ကျိုးကြောင်းဆင်ခြင်ခြင်းဗိသုကာပုံစံများ တိုးတက်စေရန် မရှိမဖြစ်လိုအပ်သော ရှားပါးပြီး ရှုပ်ထွေးသော လက်တွေ့ကမ္ဘာ အစွန်းအထင်းများကို လွှမ်းခြုံထားသည်။ ဤဒေတာစုများကို Hugging Face တွင် ရရှိနိုင်ပါသည်။
ဆော့ဖ်ဝဲရေးသားသူများသည် Alpamayo မော်ဒယ်ထုတ်လွှတ်မှုများကို ကိုယ်ပိုင် fleet data များဖြင့် အသေးစိတ်ချိန်ညှိနိုင်ပြီး NVIDIA DRIVE AGX Thor အရှိန်မြှင့်တွက်ချက်မှုဖြင့် တည်ဆောက်ထားသော NVIDIA DRIVE Hyperion architecture ထဲသို့ ပေါင်းစပ်နိုင်ကာ စီးပွားဖြစ်ဖြန့်ကျက်မှုမပြုမီ simulation တွင် စွမ်းဆောင်ရည်ကို အတည်ပြုနိုင်သည်။
NVIDIA DRIVE၊ Redundant AV Stacks နှင့် Mercedes-Benz CLA
NVIDIA သည် လူထောင်ပေါင်းများစွာပါဝင်သော အဖွဲ့ဖြင့် ရှစ်နှစ်ကြာ အလိုအလျောက်မောင်းနှင်သော ကားများကို လုပ်ဆောင်နေခဲ့သည်။ ကုမ္ပဏီသည် ချစ်ပ်များ (dual Orins၊ next-generation dual Thors)၊ အခြေခံအဆောက်အအုံ (Omniverse နှင့် Cosmos)၊ မော်ဒယ်များ (Alpamayo) နှင့် application layer တို့ကို တည်ဆောက်ခဲ့သည်။ Mercedes-Benz သည် ဤ stack ကို ဖြန့်ကျက်ရန် လွန်ခဲ့သော ငါးနှစ်က NVIDIA နှင့် ပူးပေါင်းခဲ့သည်။
ပထမဆုံး NVIDIA full-stack autonomous vehicle ဖြစ်တဲ့ Mercedes-Benz CLA ကို အမေရိကန်ပြည်ထောင်စုမှာ ၂၀၂၆ ခုနှစ် ပထမသုံးလပတ်၊ ဥရောပမှာ ဒုတိယသုံးလပတ်နဲ့ အာရှမှာ တတိယ/စတုတ္ထသုံးလပတ်မှာ မိတ်ဆက်ခဲ့ပါတယ်။ Euro NCAP က CLA ကို ၂၀၂၅ ခုနှစ်မှာ တင်သွင်းခဲ့တဲ့ ကားတွေထဲမှာ အမြင့်ဆုံး active safety score နဲ့ အဆင့်သတ်မှတ်ခဲ့ပါတယ်။ စနစ်ထဲက code တိုင်းနဲ့ chip တိုင်းဟာ ဘေးကင်းရေးအသိအမှတ်ပြုလက်မှတ်ရထားပါတယ်။

စနစ်သည် AV stack နှစ်ခုကို တစ်ပြိုင်နက်တည်း လည်ပတ်စေသည်။ Alpamayo stack သည် အတွေးအခေါ် ဆက်စပ်တွေးခေါ်မှုကို အသုံးပြုပြီး ရှုပ်ထွေးသော မောင်းနှင်မှု အခြေအနေများကို ကိုင်တွယ်သည်။ အောက်ဖော်ပြပါ ဒုတိယဂန္ထဝင် AV stack သည် အပြည့်အဝ ခြေရာခံနိုင်ပြီး တည်ဆောက်ရန် ခြောက်နှစ်မှ ခုနစ်နှစ်အထိ ကြာသည်။ မူဝါဒနှင့် ဘေးကင်းရေး အကဲဖြတ်သူသည် ယုံကြည်မှုအဆင့်အပေါ် အခြေခံ၍ မည်သည့် stack ကို အသုံးပြုရမည်ကို ဆုံးဖြတ်သည်။ Alpamayo သည် ယုံကြည်မှုမရှိသော အခြေအနေတစ်ခုကို ကြုံတွေ့ရပါက စနစ်သည် ဂန္ထဝင် stack သို့ ပြန်လည်ရောက်ရှိသွားသည်။ ဆော့ဖ်ဝဲလ်ရှိ ဤကွဲပြားမှုနှင့် ထပ်ဆင့်မှုသည် ဘေးကင်းရေး-အရေးပါသော စနစ်များသည် ဟာ့ဒ်ဝဲ ထပ်ဆင့်မှုကို မည်သို့ကိုင်တွယ်သည်ကို ထင်ဟပ်စေသည်။
NVIDIA သည် Alpamayo ၏ ဗားရှင်းအသစ်များဖြင့် စနစ်ကို ဆက်လက် အပ်ဒိတ်လုပ်သွားမည်ဖြစ်သည်။ JLR၊ Lucid၊ Uber နှင့် Berkeley DeepDrive အပါအဝင် မိုဘိုင်းလ်မိတ်ဖက်များသည် ကျိုးကြောင်းဆင်ခြင်ခြင်းအခြေခံ level 4 ကိုယ်ပိုင်အုပ်ချုပ်ခွင့် ဖွံ့ဖြိုးတိုးတက်ရေးအတွက် Alpamayo ကို အသုံးပြုနေကြသည်။
ရုပ်ပိုင်းဆိုင်ရာ AI မော်ဒယ်အသစ်များနှင့် ရိုဘော့တစ်ဆိုင်ရာ ကြေငြာချက်များ
၎င်း၏ အခြေခံအဆောက်အအုံနှင့် စနစ်ကြေငြာချက်များနှင့်အတူ NVIDIA သည် CES 2026 ကိုလည်း အသုံးပြု၍ ရိုဘော့တစ်ဖွံ့ဖြိုးတိုးတက်မှုကို အရှိန်မြှင့်တင်ရန် open model အသစ်များ၊ framework များနှင့် edge platform များကို ထုတ်ပြန်ခြင်းဖြင့် ၎င်း၏ Physical AI မဟာဗျူဟာကို မြှင့်တင်ခဲ့သည်။ ကုမ္ပဏီသည် ရိုဘော့သင်ယူမှုအတွက် ၎င်း၏ Cosmos world model များနှင့် GR00T reasoning model များကို အပ်ဒိတ်လုပ်ခြင်းအပြင် ကြီးမားသော ရိုဘော့အကဲဖြတ်မှုအတွက် open-source tooling အသစ်များ (Isaac Lab-Arena အပါအဝင်) ကို မိတ်ဆက်ခဲ့သည်။ OSMO သည် မတူညီသော compute environments များတွင် လေ့ကျင့်ရေး workflow များကို ရိုးရှင်းစေရန် ဒီဇိုင်းထုတ်ထားသော edge-to-cloud orchestration framework တစ်ခုဖြစ်သည်။

NVIDIA သည် ၎င်း၏ ရိုဘော့တစ်အစုအဝေးကို ကျယ်ပြန့်သော စက်မှုလုပ်ငန်းတွင် လက်ခံကျင့်သုံးမှုကို မီးမောင်းထိုးပြခဲ့ပြီး Boston Dynamics၊ Caterpillar၊ LG Electronics နှင့် NEURA Robotics အပါအဝင် မိတ်ဖက်များသည် NVIDIA နည်းပညာများဖြင့် တည်ဆောက်ထားသော နောက်မျိုးဆက် အလိုအလျောက်စက်များကို ပြသခဲ့သည်။ ကုမ္ပဏီသည် NVIDIA Isaac နှင့် GR00T မော်ဒယ်များကို open-source LeRobot framework ထဲသို့ ပေါင်းစပ်ရန် Hugging Face နှင့် ပိုမိုနီးကပ်စွာ ပူးပေါင်းဆောင်ရွက်ကြောင်းလည်း ကြေညာခဲ့ပြီး ကမ္ဘာလုံးဆိုင်ရာ ရိုဘော့တစ် developer အသိုင်းအဝိုင်းအတွက် ဝင်ရောက်ခွင့်ကို ပိုမိုတိုးချဲ့ခဲ့သည်။
အစွန်းတွင် NVIDIA သည် Blackwell စွမ်းအင်သုံး Jetson T4000 မော်ဂျူး ရရှိနိုင်မှုကို အတည်ပြုခဲ့ပြီး အလိုအလျောက်စက်များနှင့် စက်မှုလုပ်ငန်းသုံး ရိုဘော့တစ်များအတွက် AI တွက်ချက်မှုနှင့် စွမ်းအင်ထိရောက်မှုကို သိသိသာသာ မြှင့်တင်ပေးပါသည်။ ဤကြေငြာချက်များအားလုံးပေါင်းလိုက်သောအခါတွင် NVIDIA သည် ၎င်း၏ full-stack AI ပလပ်ဖောင်းကို ဒေတာစင်တာထက်ကျော်လွန်၍ ချဲ့ထွင်ရန် တွန်းအားပေးခဲ့ပြီး simulation၊ မော်ဒယ်များ၊ edge compute နှင့် ရိုဘော့တစ်များနှင့် အလိုအလျောက်စနစ်များတစ်လျှောက် လက်တွေ့ကမ္ဘာဖြန့်ကျက်မှုများကို လွှမ်းခြုံထားသည်။


 အမေဇုံ