

Hyperscaler များနှင့် AI-focused infrastructure operator များသည် ကြီးမားသော language model များနှင့် ရှုပ်ထွေးသော reasoning workload များနှင့် လိုက်လျောညီထွေဖြစ်အောင် proprietary AI accelerator များနှင့် XPU များကို တိုး၍တီထွင်လာကြသည်။ proprietary silicon ကို scale တွင် ဖြန့်ကျက်ခြင်း၏ physical၊ memory နှင့် networking ဆိုင်ရာစိန်ခေါ်မှုများကို ဖြေရှင်းရန်အတွက် NVIDIA သည် ၎င်း၏ NVLink Fusion interconnect နှင့် NVHBM custom base-die memory architecture ကို အသေးစိတ်ဖော်ပြထားသည် ။ ပေါင်းစည်းထားသော portfolio ကို custom silicon ကို NVIDIA ၏ရှိပြီးသား scale-up networking နှင့် MGX rack-scale platform များနှင့် ပေါင်းကူးရန် ဒီဇိုင်းထုတ်ထားသည်။
ပထမဆုံးဝယ်ယူသူမှာ Amazon ၏ Annapurna Labs ဖြစ်ပြီး AWS ပူးပေါင်းဆောင်ရွက်မှု၏ GPU ၂ သန်း တိုးချဲ့မှု နှင့်အတူ NVHBM အစီအစဉ်များ ပေါ်ထွက်လာခဲ့သည် ။ ဤကြေငြာချက်သည် ထိုပူးပေါင်းဆောင်ရွက်မှု၏နောက်ကွယ်ရှိ ဗိသုကာကို ပံ့ပိုးပေးပြီး Trainium4 ကို NVLink Fusion ပံ့ပိုးမှုပါရှိသော ပထမဆုံး Trainium မျိုးဆက်အဖြစ် သတ်မှတ်သည်။ NVIDIA သည် မှတ်ဉာဏ်ပံ့ပိုးပေးသူများစွာထံမှ ရရှိနိုင်သော စံ NVHBM အကောင်အထည်ဖော်မှုကိုလည်း တည်ထောင်နေပြီး ၎င်းသည် ပေးသွင်းသူများကြားတွင် မှတ်ဉာဏ်ကို ပေါင်းစပ်ခြင်းနှင့် အရည်အချင်းပြည့်မီခြင်း၏ အင်ဂျင်နီယာဆိုင်ရာ ကြိုးပမ်းအားထုတ်မှုကို လျှော့ချပေးသည်ဟု ဆိုသည်။ “NVHBM သည် bandwidth မြင့်မားသော မှတ်ဉာဏ်စွမ်းဆောင်ရည်နှင့် ထိရောက်မှုကို မြှင့်တင်ရန် ဗိသုကာဆိုင်ရာ ချဉ်းကပ်မှုအသစ်တစ်ခုကို ကိုယ်စားပြုသည်” ဟု Amazon ရှိ Annapurna Labs ၏ ဒုတိယဥက္ကဋ္ဌ Nafea Bshara က ပြောကြားခဲ့သည်။ “အနာဂတ် AWS အခြေခံအဆောက်အအုံဒီဇိုင်းများကို အကျိုးပြုရန် ဤနည်းပညာပူးပေါင်းဆောင်ရွက်မှုကို ကျွန်ုပ်တို့ မျှော်လင့်ပါသည်။”
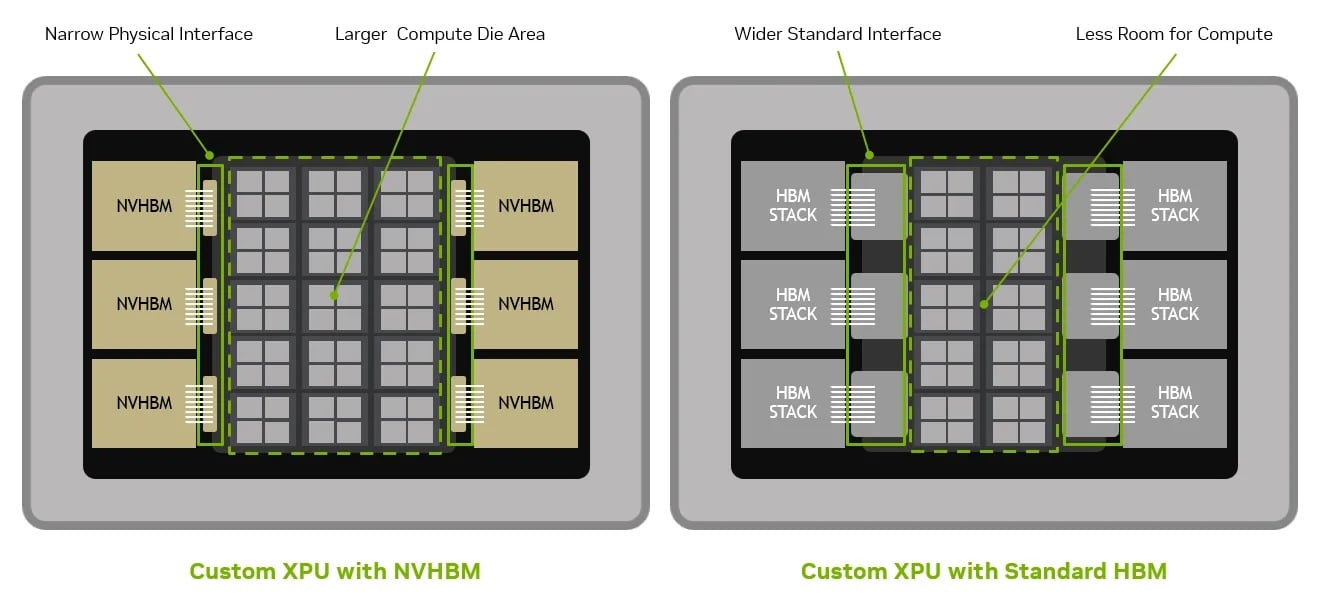
မြင့်မားသောသိပ်သည်းဆဒေတာစင်တာများတွင် စိတ်ကြိုက် XPU များကို ဖြန့်ကျက်ခြင်းသည် compute logic၊ power distribution၊ thermal overhead နှင့် high-bandwidth memory တို့ကို ဟန်ချက်ညီစေရန် လိုအပ်ပါသည်။ ရှေ့ဆောင် memory stack များကို ပေါင်းစပ်ခြင်းနှင့် အရည်အချင်းပြည့်မီအောင်ပြုလုပ်ခြင်းသည် မကြာခဏဆိုသလို သိသာထင်ရှားသော packaging နှင့် ဖွံ့ဖြိုးတိုးတက်မှု bottleneck များကို ဖန်တီးပေးပါသည်။ NVLink Fusion နှင့် NVHBM မှတစ်ဆင့် ဒီဇိုင်နာများသည် ကြိုတင်အတည်ပြုထားသော base dies နှင့် interface IP များကို အသုံးချနိုင်ပြီး integration complexity ကို လျှော့ချပေးပြီး ဈေးကွက်သို့ရောက်ရှိချိန်ကို အရှိန်မြှင့်တင်ပေးနိုင်ပါသည်။
မှတ်ဉာဏ် Bandwidth နှင့် Latency အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ခြင်း
ခေတ်သစ် AI workloads များ၊ အထူးသဖြင့် large-model inference နှင့် agentic pipelines များသည် model weights၊ activations နှင့် key-value (KV) cache entries များကို ဖတ်ရှုရန်အတွက် memory throughput ပေါ်တွင် များပြားသော လိုအပ်ချက်များကို ပေးပါသည်။ NVHBM သည် memory ထုတ်လုပ်သူများနှင့် ပူးပေါင်း၍ တီထွင်ထားသော custom base die ကို ပံ့ပိုးပေးပြီး standard JEDEC HBM4E specification နှင့် နှိုင်းယှဉ်ပါက stack တစ်ခုလျှင် memory bandwidth 30 ရာခိုင်နှုန်းအထိ မြင့်မားစေပါသည်။
| လက္ခဏာ | NVHBM အကျိုးကျေးဇူး |
| bandwidth | စံ HBM4e နှင့် နှိုင်းယှဉ်ပါက မှတ်ဉာဏ် bandwidth ၃၀% အထိ ပိုများသည် |
| ဧရိယာ | ပိုမိုထိရောက်သော interface ချိတ်ဆက်မှုများသည် နောက်ထပ် XPU စွမ်းရည်များအတွက် compute die ဧရိယာကို ၂၅% အထိ ပိုမိုခွင့်ပြုသည် |
| စွမ်းအား | စံ HBM4e နှင့် နှိုင်းယှဉ်ပါက HBM ပါဝါအသုံးပြုမှု ၁၅% အထိ လျော့နည်းသွားခြင်းကြောင့် XPU ထောင်ပေါင်းများစွာတွင် ငွေစုနိုင်စေပါသည်။ |
ဇယား ၁။ NVHBM သည် AI accelerator ပရိုဂရမ်များသို့ အဓိက platform-level အားသာချက်သုံးခုကို ယူဆောင်လာပေးသည်- memory bandwidth မြင့်မားခြင်း၊ package နှင့် silicon area ပိုများခြင်းနှင့် HBM power အသုံးပြုမှု နည်းပါးခြင်း
ဤ bandwidth uplift သည် memory-bound execution အဆင့်များတွင် compute engine starvation ကို လျှော့ချပေးသည်။ HBM stack များနှင့် onboard compute logic အကြား data transfer များကို အရှိန်မြှင့်ပေးခြင်းဖြင့် accelerator များသည် အသုံးပြုမှုမြင့်မားမှုကို ထိန်းသိမ်းနိုင်ပြီး dense inference workloads များအတွင်း per-user token generation rates များကို မြှင့်တင်နိုင်သည်။
သေဧရိယာ ပြန်လည်နေရာချထားခြင်းနှင့် PHY အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ခြင်း
ခေတ်မီ accelerator package များပေါ်ရှိ ဆီလီကွန် အိမ်ခြံမြေသည် တင်းကျပ်စွာ ကန့်သတ်ထားသောကြောင့် ဒီဇိုင်နာများသည် compute ALU များ၊ matrix engine များ၊ on-chip SRAM နှင့် peripheral interface များအကြား နေရာလွတ်ကို ဟန်ချက်ညီအောင် ပြုလုပ်ရန် လိုအပ်ပါသည်။ စံ HBM ဗိသုကာလက်ရာများသည် layout ဧရိယာများစွာကို အသုံးပြုသည့် ကျယ်ပြန့်သော physical interface များ လိုအပ်သည်။
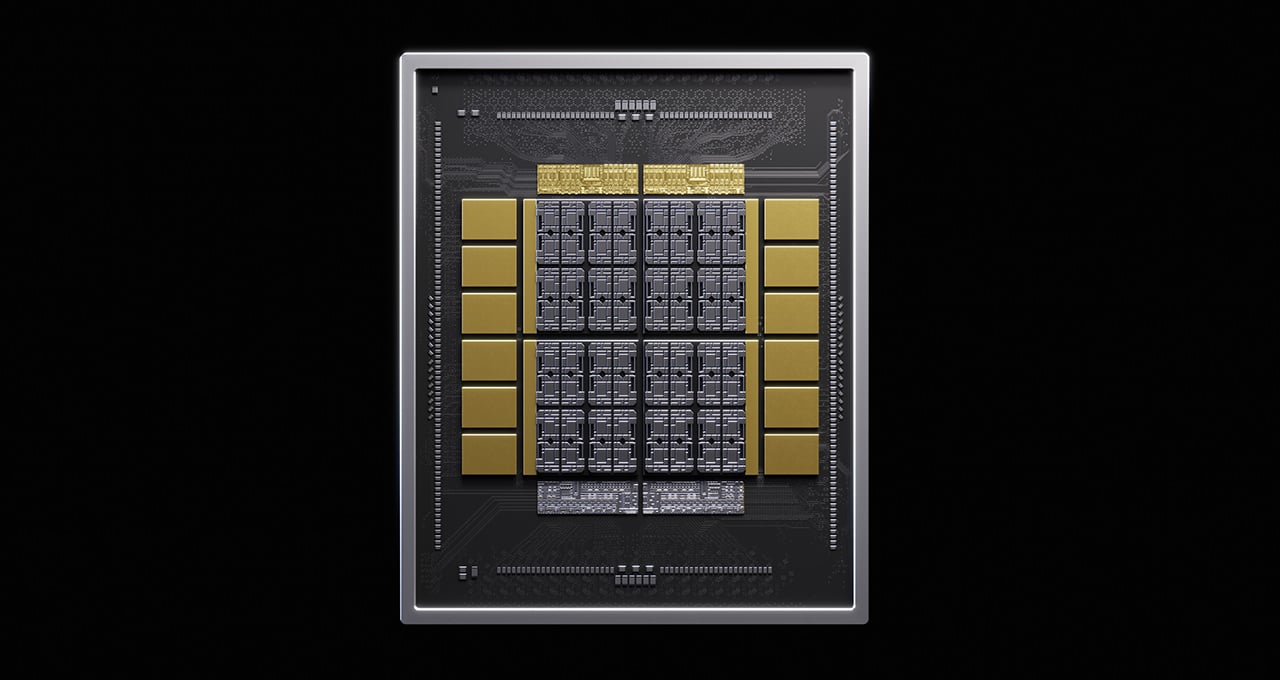
NVHBM သည် memory controller ကို 3D HBM stack ထဲသို့ တိုက်ရိုက်ရွှေ့ပြီး custom physical layer (PHY) ကို အသုံးပြုခြင်းဖြင့် ဤပြဿနာကို ဖြေရှင်းပေးပါသည်။ ဤချဉ်းကပ်မှုသည် စံ HBM4E အကောင်အထည်ဖော်မှုများနှင့် နှိုင်းယှဉ်ပါက PHY နှင့် peripheral support ဧရိယာတွင် ၆၇ ရာခိုင်နှုန်းအထိ လျှော့ချပေးပြီး interposer trace routing ကို ရိုးရှင်းစေပြီး layout တစ်လျှောက်တွင် အသုံးပြုနိုင်သော silicon ၈၀ ရာခိုင်နှုန်းအထိ ပိုမိုရယူနိုင်စေပါသည်။ memory interface ကျဉ်းမြောင်းခြင်းသည် package real estate ကို လွတ်လပ်စွာရရှိစေပြီး ဒီဇိုင်နာများသည် matrix cores၊ vector units သို့မဟုတ် cache hierarchy များကို fixed physical envelope အတွင်း ပိုမိုထည့်သွင်းရန် central AI compute die ကို ၃၀ ရာခိုင်နှုန်းအထိ တိုးချဲ့နိုင်စေပါသည်။
ပါဝါထိရောက်မှုနှင့် အဆောက်အဦအတိုင်းအတာအလိုက် စွမ်းရည်
ပါဝါဖြန့်ဖြူးမှုသည် hyperscale data center လည်ပတ်မှုများတွင် အတင်းကျပ်ဆုံးကန့်သတ်ချက်များထဲမှ တစ်ခုအဖြစ် ဆက်လက်တည်ရှိနေပြီး accelerator thermal design နှင့် cooling လိုအပ်ချက်များကို တိုက်ရိုက်သက်ရောက်မှုရှိသည်။ NVHBM သည် စံ HBM4E နှင့် နှိုင်းယှဉ်ပါက HBM ပါဝါသုံးစွဲမှုကို ၁၅ ရာခိုင်နှုန်း လျှော့ချပေးသည်။
ဆီလီကွန်အဆင့်တွင်၊ မှတ်ဉာဏ်ပါဝါလျှော့ချခြင်းသည် အပူဖိအားကို လျော့ကျစေပြီး၊ ပိုမိုမြင့်မားသော ကြိမ်နှုန်းများတွင် compute cores များကို မောင်းနှင်ရန် လျှပ်စစ်စွမ်းအား အပိုဆောင်းပေးပါသည်။ စက်ရုံအတိုင်းအတာအရ၊ ဤပါဝါချွေတာမှုများသည် သိသိသာသာ များပြားလာသည်။ 2,000-watt XPU များကို ဖြန့်ကျက်ထားသော သီအိုရီဆိုင်ရာ 1-gigawatt ဒေတာစင်တာတွင်၊ မှတ်ဉာဏ်ပါဝါလျှော့ချထားသော ပရိုဖိုင်သည် နောက်ထပ် XPU ၁၅,၀၀၀ အထိ ပံ့ပိုးပေးရန် လုံလောက်သော အပူနှင့် လျှပ်စစ်စွမ်းရည်ကို လွတ်စေနိုင်သည်။
NVLink Fusion မှတစ်ဆင့် Rack-Scale ပေါင်းစပ်ခြင်း
NVHBM သည် တစ်ဦးချင်းပက်ကေ့ဂျ်အဆင့်တွင် စွမ်းဆောင်ရည်ကို အကောင်းဆုံးဖြစ်အောင် လုပ်ဆောင်ပေးသော်လည်း NVLink Fusion သည် စနစ်အဆင့်တံတားအဖြစ် ဆောင်ရွက်ပါသည်။ သီးသန့် NVLink Fusion ချစ်ပ်များကို အသုံးပြုခြင်းဖြင့် custom XPU များသည် ဆဋ္ဌမမျိုးဆက် NVLink scale-up fabric နှင့် တိုက်ရိုက်ချိတ်ဆက်နိုင်ပြီး rack အတွင်းရှိ accelerator အားလုံးကို တစ်ခုတည်းသော ပေါင်းစပ်ထားသော မှတ်ဉာဏ်နှင့် compute domain တစ်ခုအဖြစ် ပေါင်းစည်းပေးပါသည်။
ဤ scale-up fabric သည် expert parallelism (EP) နှင့် WideEP ကဲ့သို့သော အဆင့်မြင့် parallelization ပုံစံများအတွက် အရေးကြီးပါသည်။ ၎င်းတွင် distributed mixture-of-experts မော်ဒယ်များသည် activation များ၏ low-latency synchronization နှင့် multiple physical devices များတစ်လျှောက် hidden state များ လိုအပ်ပါသည်။ Custom processors များသည် NVLink-C2C မှတစ်ဆင့် host CPU များနှင့်လည်း ချိတ်ဆက်နိုင်ပါသည်။
semi-custom silicon ကို ပိုမိုကျယ်ပြန့်သော NVIDIA hardware နှင့် software ecosystem ထဲသို့ ပေါင်းစပ်ခြင်းဖြင့် NVLink Fusion သည် operator များအား custom XPU များကို စံသတ်မှတ်ထားသော MGX rack architecture အောက်တွင် စံ NVIDIA GPU များနှင့် ရောနှောထားသော မတူညီသော environment များကို ဖြန့်ကျက်နိုင်စေပြီး လုပ်ငန်းလည်ပတ်မှုနှင့် workload provisioning ကို ရိုးရှင်းစေသည်။


 အမေဇုံ