

NVIDIA ရဲ့ GTC ညီလာခံမှာ ကဏ္ဍပေါင်းစုံမှာ AI ဖွံ့ဖြိုးတိုးတက်မှုကို ပြောင်းလဲဖို့ ပြင်ဆင်ထားတဲ့ ဆန်းသစ်တီထွင်မှု အများအပြားကို မီးမောင်းထိုးပြခဲ့ပြီး AI ဟာ့ဒ်ဝဲ၊ ဆော့ဖ်ဝဲနဲ့ မိတ်ဖက်အဖွဲ့အစည်းတွေမှာ အောင်မြင်မှုတွေကို ပြသခဲ့ပါတယ်။ GTC 2025 ရဲ့ အဖိုးတန်ဆုံးအရာကတော့ datacenter GPU တွေနဲ့ သူတို့ရဲ့ roadmap ကို ထုတ်ဖော်ပြသခဲ့တာ သေချာပါတယ်။ NVIDIA ရဲ့ ယနေ့အထိ ထုတ်လုပ်မှုမှာ အစွမ်းထက်ဆုံး AI accelerator ကတော့ Blackwell Ultra ဗိသုကာပုံစံနဲ့ တည်ဆောက်ထားတဲ့ B300 ပါ။ Blackwell GPU တွေရဲ့ လုပ်ငန်းမှာ ဦးဆောင်နေတဲ့ စွမ်းဆောင်ရည်ထက် စွမ်းဆောင်ရည် ၁.၅ ဆ တိုးလာပါတယ်။

NVIDIA မှထွက်ရှိထားသော GPU များနှင့်နှိုင်းယှဉ်ပါက စွမ်းဆောင်ရည်တိုးတက်မှုမှာ အံ့မခန်းဖြစ်သည်။
| specification | H100 | H200 | B100 | B200 | B300 |
|---|---|---|---|---|---|
| အများဆုံး မှတ်ဉာဏ် | ၈၀ GB HBM3 | ၂၈၈ GB HBM3e | ၂၈၈ GB HBM3e | ၂၈၈ GB HBM3e | ၂၈၈ GB HBM3e |
| မှတ်ဉာဏ် Bandwidth | ၁ TB / s | ၃.၆ TB/s | ၃.၆ TB/s | ၃.၆ TB/s | ၃.၆ TB/s |
| FP4 Tensor Core | - | - | ၁၁.၁၅ PFLOPS | ၁၁.၁၅ PFLOPS | ၁၁.၁၅ PFLOPS |
| FP6 Tensor Core | - | - | ၁၁.၁၅ PFLOPS | ၁၁.၁၅ PFLOPS | ၁၁.၁၅ PFLOPS* |
| FP8 Tensor Core | ၁၉၇၉ TFLOPS (~၂ PFLOPS) | ၁၉၇၉ TFLOPS (~၂ PFLOPS) | ၁၁.၁၅ PFLOPS | ၁၁.၁၅ PFLOPS | ၁၁.၁၅ PFLOPS* |
| INT 8 Tensor Core | 3958 ထိပ် | 3958 ထိပ် | POPS ၉ ခု | POPS ၉ ခု | ၁၁.၁၅ PFLOPS* |
| FP16/BF16 တန်ဆာ အူတိုင် | ၁၉၇၉ TFLOPS (~၂ PFLOPS) | ၁၉၇၉ TFLOPS (~၂ PFLOPS) | ၁၁.၁၅ PFLOPS | ၁၁.၁၅ PFLOPS | ၁၁.၁၅ PFLOPS* |
| TF32 တန်ဆာ အူတိုင် | 989 TFLOPS | 989 TFLOPS | ၁၁.၁၅ PFLOPS | ၁၁.၁၅ PFLOPS | ၁၁.၁၅ PFLOPS* |
| FP32 (သိပ်သည်း) | 67 TFLOPS | 67 TFLOPS | 30 TFLOPS | 40 TFLOPS | မသိသော အချက်အလက် |
| FP64 Tensor Core (သိပ်သည်း) | 67 TFLOPS | 67 TFLOPS | 30 TFLOPS | 40 TFLOPS | မသိသော အချက်အလက် |
| FP64 (သိပ်သည်း) | 34 TFLOPS | 34 TFLOPS | 30 TFLOPS | 40 TFLOPS | မသိသော အချက်အလက် |
| မက်စ်ပါဝါစားသုံးမှု | 700W | 700W | 700W | 1000W | မသိသော အချက်အလက် |
မှတ်ချက်- “*” ဖြင့်မှတ်သားထားသော တန်ဖိုးများသည် အကြမ်းဖျင်းတွက်ချက်မှုများဖြစ်ပြီး NVIDIA မှ တရားဝင်ကိန်းဂဏန်းများ မဟုတ်ပါ။

Blackwell Ultra B300 သည် ၎င်း၏ Blackwell counterparts များကဲ့သို့ပင်၊ လက်ရှိ H200s များနှင့် နှိုင်းယှဉ်ပါက အထင်ကြီးလောက်သော 30 PFLOPS နှင့် FP6/FP8 တို့၏ စွမ်းဆောင်ရည် 15 PFLOPS* ကို ပေးစွမ်းသည့် FP4 Tensor Cores ဖြင့် တိကျမှုပုံစံအသစ်များကို မိတ်ဆက်ပေးထားသည်။ ၎င်းသည် FP8 compute ကို FP4 နှင့် နှိုင်းယှဉ်သောအခါ 7.5x ခန့် တိုးတက်မှုဖြစ်ပြီး FP8 စွမ်းဆောင်ရည်ကို နှိုင်းယှဉ်သောအခါ 4x နီးပါး တိုးတက်မှုဖြစ်သည်။

NVIDIA ရဲ့ roadmap မှာ နောက်နှစ်မှာ ထွက်ရှိဖို့ စီစဉ်ထားတဲ့ Vera Rubin GPU ပါ။ Vera Rubin ဟာ Blackwell Ultra ရဲ့ စွမ်းဆောင်ရည် ၃.၃ ဆ ပိုကောင်းလာမယ်လို့ မျှော်လင့်ရပြီး B300 ရဲ့ PFLOPS ၁၅ ခုထက် dense FP4 compute ၅၀ PFLOPS ရရှိမှာပါ။ ConnectX-9 နဲ့ NVLink-6 နည်းပညာတွေ ပါရှိမှာဖြစ်လို့ အရင်မျိုးဆက်တွေရဲ့ bandwidth ကို နှစ်ဆတိုးစေမှာပါ။ Vera Rubin GPU တွေမှာ HBM4 memory လည်း ပါရှိမှာဖြစ်ပြီး memory bandwidth ကို ၁.၆ ဆ တိုးစေမှာပါ။ Grace ကနေ Vera CPU တွေကို ပြောင်းလဲအသုံးပြုခြင်းအားဖြင့် CPU-to-GPU interconnect ကို သိသိသာသာ မြှင့်တင်ပေးမှာဖြစ်ပြီး 1.8 TB/s အထိ မြန်နှုန်းရရှိမှာပါ။

NVIDIA သည် ၂၀၂၇ ခုနှစ် ဒုတိယနှစ်ဝက်တွင် မိတ်ဆက်ရန် မျှော်လင့်ထားသည့် Rubin Ultra GPU များကို တွန့်ဆုတ်မနေဘဲ ထုတ်ဖော်ပြသခဲ့သည်။ Rubin Ultra GPU များသည် Vera Rubin ၏ စွမ်းဆောင်ရည်ကို နှစ်ဆတိုးရန် ရည်ရွယ်ထားပြီး GPU တစ်ခုချင်းစီတွင် အံ့မခန်း FP4 compute 100 PFLOPS အထိ ပေးစွမ်းနိုင်သည်။ Rubin Ultra တွင် အဆင့်မြင့် HBM4e မှတ်ဉာဏ် 1TB လည်း တပ်ဆင်ထားမည်ဖြစ်သည်။
NVIDIA DGX Spark
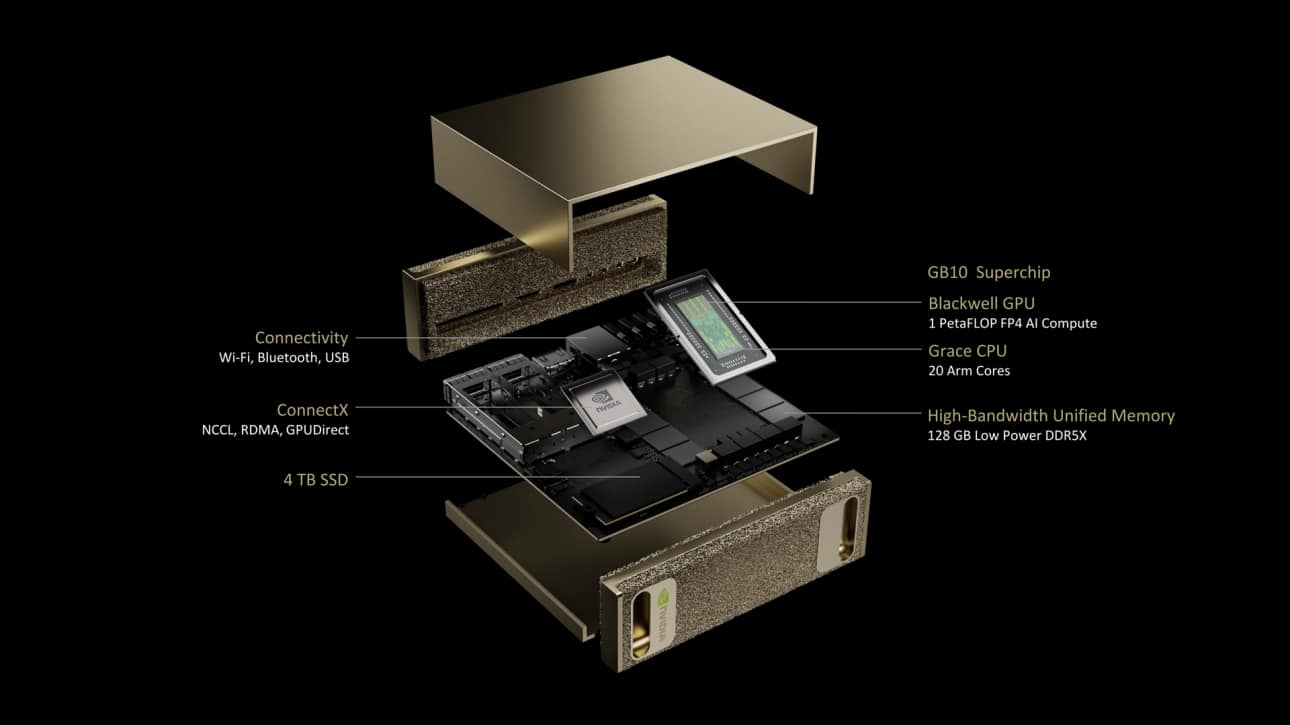
NVIDIA သည် ယခုနှစ်အစောပိုင်း CES တွင် Project Digits အမည် ဖြင့် မိတ်ဆက်ခဲ့သော ၎င်း၏ DGX Spark စနစ်ကို ပြသခဲ့သည် ။ AI developer များ၊ သုတေသီများ၊ data scientists များနှင့် ကျောင်းသားများအတွက် ရည်ရွယ်သည့် DGX Spark သည် GB10 Blackwell ချစ်ပ်အသစ်ကို အသုံးပြုထားပြီး 128 GB unified memory ဖြင့် ပြင်ဆင်ထားသည်။
NVIDIA က ဒီစနစ်ဟာ အလွန်ကောင်းမွန်တဲ့ AI TOPS ၁၀၀၀ ကို ပေးစွမ်းနိုင်ပြီး Spark ရဲ့ စွမ်းဆောင်ရည်ကို RTX 5070 နဲ့ ညီမျှတဲ့ လက်တွေ့ကျတဲ့အဆင့်မှာ ရှိစေမယ်လို့ ဆိုပါတယ်။ Spark ပလက်ဖောင်းမှာ ConnectX 7 SmartNIC ကိုလည်း ပေါင်းစပ်ထားပြီး ဒေတာရွှေ့ပြောင်းမှုကို ချောမွေ့စေဖို့အတွက် Spark ကို 2x 200Gb လင့်ခ်တွေနဲ့ တပ်ဆင်ထားပါတယ်။ ASUS၊ Dell၊ HPE နဲ့ Lenovo အပါအဝင် OEM မိတ်ဖက်တွေက မကြာခင်မှာ အမှတ်တံဆိပ်ဗားရှင်းတွေကို ပေးဆောင်တော့မှာပါ။ ကြိုတင်မှာယူမှုတွေကို ဖွင့်လှစ်ထားပြီးဖြစ်ပြီး ဇူလိုင်လမှာ ပို့ဆောင်မှုတွေ စတင်ဖို့ စီစဉ်ထားပါတယ်။
NVIDIA DGX ဘူတာရုံ
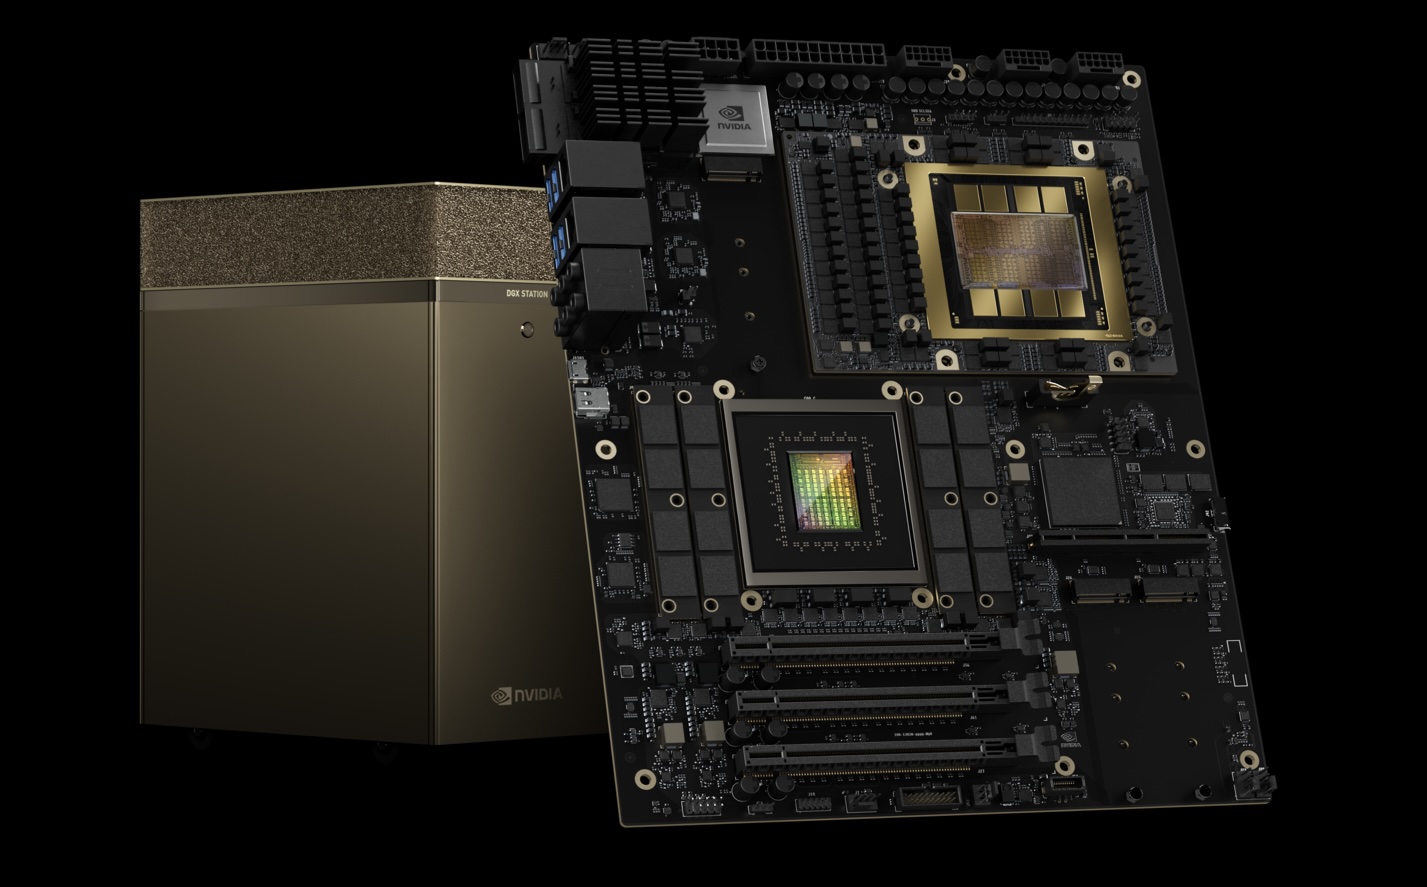
NVIDIA သည် အဆင့်မြှင့်တင်ထားသော DGX Station ကိုလည်း မိတ်ဆက်ခဲ့ပြီး ၎င်းသည် enterprise application များအတွက် အကောင်းဆုံး desktop AI supercomputer အဖြစ် ရပ်တည်ထားပြီး GB300 Grace Blackwell Ultra ချစ်ပ်ဖြင့် တည်ဆောက်ထားသည်။
DGX Station သည် ပေါင်းစည်းထားသော စနစ်မှတ်ဉာဏ် 784GB ပေးစွမ်းပြီး သိပ်သည်းသော FP4 AI စွမ်းဆောင်ရည် 20 petaflops ကို ပေးစွမ်းသည်။ ၎င်းသည် NVIDIA ၏ ConnectX 8 SuperNIC ကို စနစ်ထဲသို့ တိုက်ရိုက်ပေါင်းစပ်ထားပြီး 800 Gb/s ကွန်ရက်ချိတ်ဆက်မှုကို ခွင့်ပြုပေးကာ မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော ကွန်ရက်သည် ၎င်း၏ သိသာထင်ရှားသော တွက်ချက်မှုစွမ်းရည်များ၏ လိုအပ်ချက်များနှင့် ကိုက်ညီကြောင်း သေချာစေသည်။ ASUS၊ Box၊ Dell၊ HPE၊ Lambda နှင့် Supermicro ကဲ့သို့သော OEM မိတ်ဖက်များသည် DGX Station စနစ်များကို တည်ဆောက်ရန် စီစဉ်ထားပြီး ယခုနှစ်နှောင်းပိုင်းတွင် ရရှိနိုင်မည်ဟု မျှော်လင့်ရသည်။
NVIDIA RTX Pro Blackwell
GPU ၏ အရှိန်အဟုန်သည် ထိုနေရာတွင်ပင် မရပ်တန့်ခဲ့ပါ ။ NVIDIA သည် ၎င်း၏ RTX Pro Blackwell စီးရီးကို မိတ်ဆက်ခဲ့ပြီး ၎င်းသည် ပလက်ဖောင်းအားလုံးတွင် AI၊ ဂရပ်ဖစ်နှင့် simulation workloads များကို အရှိန်မြှင့်တင်ရန် ဒီဇိုင်းထုတ်ထားသော ၎င်း၏ ပရော်ဖက်ရှင်နယ် GPU လိုင်း၏ ပြီးပြည့်စုံသော ပြန်လည်ဆန်းသစ်မှုတစ်ခုဖြစ်သည်။ ဤမျိုးဆက်သစ်သည် desktop workstations၊ မိုဘိုင်းစနစ်များနှင့် servers များကို လွှမ်းခြုံထားပြီး flagship RTX Pro 6000 Blackwell တွင် လုပ်ငန်းနယ်ပယ်တွင် ဦးဆောင်နေသော 96GB GPU memory နှင့် AI စွမ်းဆောင်ရည် TOPS 4,000 အထိ ပေးစွမ်းနိုင်သည်။ ဤတိုးတက်မှုများသည် real-time ray tracing၊ မြန်ဆန်သော AI inference နှင့် ယခင်က desktop စနစ်များတွင် မရရှိနိုင်သော အဆင့်မြင့်ဂရပ်ဖစ် workflows များကို ဖြစ်စေသည်။
ဤ GPU များတွင် ထည့်သွင်းထားသော နည်းပညာဆိုင်ရာ ဆန်းသစ်တီထွင်မှုများသည် အလွန်အရေးပါပြီး 1.5x ပိုမိုမြန်ဆန်သော throughput ပါရှိသော NVIDIA ၏ Streaming Multiprocessor၊ ယခင်မျိုးဆက်များထက် နှစ်ဆစွမ်းဆောင်ရည်ပေးစွမ်းသော စတုတ္ထမျိုးဆက် RT Cores နှင့် AI workloads အတွက် FP4 precision အသစ်ကို ပံ့ပိုးပေးသော ပဉ္စမမျိုးဆက် Tensor Cores များ ပါဝင်သည်။ ထပ်ဆောင်းတိုးတက်မှုများတွင် bandwidth နှစ်ဆအတွက် PCIe Gen 5 ပံ့ပိုးမှု၊ အလွန်အမင်း resolution display configuration များအတွက် DisplayPort 2.1 လိုက်ဖက်ညီမှုနှင့် Server Edition တွင် လုံခြုံသော AI workloads အတွက် NVIDIA Confidential Computing တို့ ပါဝင်သည်။
လက်တွေ့ကမ္ဘာအပလီကေးရှင်းများတွင် သိသာထင်ရှားသော စွမ်းဆောင်ရည်တိုးတက်မှုများကို စက်မှုလုပ်ငန်းကျွမ်းကျင်ပညာရှင်များက အစီရင်ခံတင်ပြခဲ့ကြသည်။ Foster + Partners သည် RTX A6000 ထက် 5 ဆ ပိုမြန်သော ray-tracing ကို ရရှိခဲ့ပြီး၊ GE HealthCare သည် ဆေးဘက်ဆိုင်ရာပြန်လည်တည်ဆောက်မှု အယ်လဂိုရီသမ်များအတွက် GPU လုပ်ဆောင်ချိန် 2 ဆအထိ တိုးတက်လာကြောင်း တွေ့ရှိခဲ့သည်။ မော်တော်ကားထုတ်လုပ်သူ Rivian သည် ဒီဇိုင်းသုံးသပ်ချက်များတွင် မကြုံစဖူး VR ရုပ်ထွက်အရည်အသွေးအတွက် GPU အသစ်များကို အသုံးချခဲ့ပြီး SoftServe သည် Llama 3.3-70B ကဲ့သို့သော AI မော်ဒယ်ကြီးများနှင့် အလုပ်လုပ်သည့်အခါ ထုတ်လုပ်မှု 3 ဆ တိုးတက်လာကြောင်း အစီရင်ခံတင်ပြခဲ့သည်။ အထင်ရှားဆုံးမှာ Pixar သည် ၎င်းတို့၏ ထုတ်လုပ်မှုရိုက်ချက်များ၏ 99% သည် GPU တစ်ခုတည်း၏ 96GB မှတ်ဉာဏ်အတွင်း ကိုက်ညီကြောင်း မှတ်ချက်ပြုခဲ့သည်။
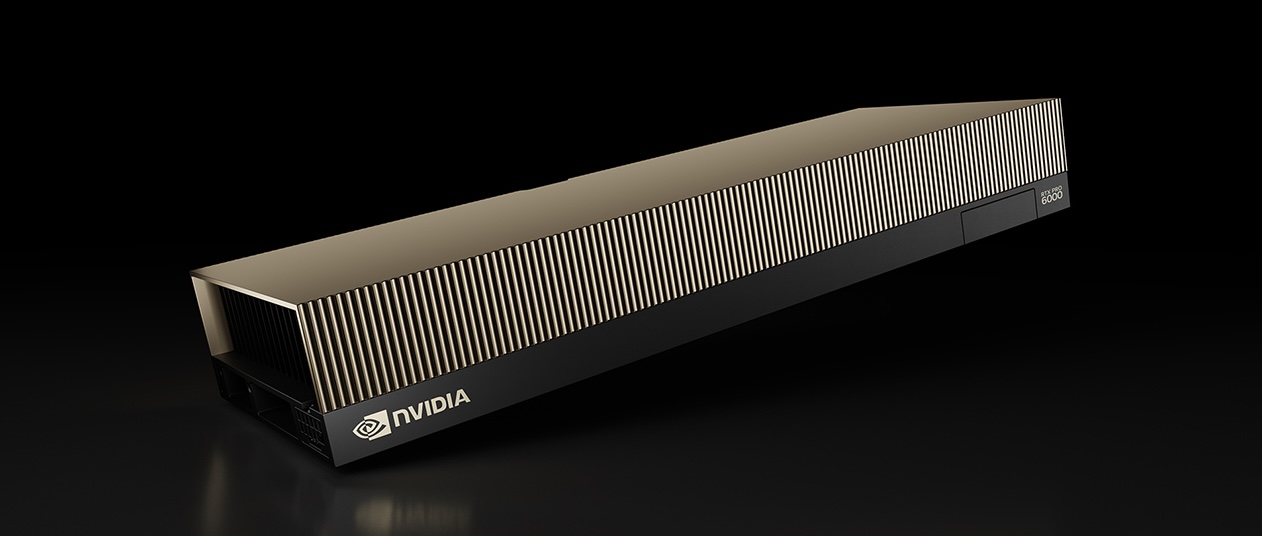
RTX Pro 6000 Blackwell Server Edition သည် ဤစွမ်းရည်များကို ဒေတာစင်တာပတ်ဝန်းကျင်များသို့ ၂၄/၇ လည်ပတ်မှုအတွက် passively cooled ဒီဇိုင်းဖြင့် ယူဆောင်သွားပါသည်။ ဤ server-focused ဗားရှင်းသည် ယခင်မျိုးဆက် hardware ထက် ၅ ဆ မြင့်မားသော large language model inference throughput၊ ၇ ဆ ပိုမိုမြန်ဆန်သော genomics sequencing၊ text-to-video ထုတ်လုပ်မှုအတွက် ၃.၃ ဆ မြန်နှုန်းနှင့် recommender systems inference နှင့် rendering တွင် ၂ ဆ တိုးတက်ကောင်းမွန်လာစေပါသည်။ ပထမဆုံးအကြိမ်အဖြစ် ဤ GPU များသည် vGPU နှင့် Multi-Instance GPU (MIG) နည်းပညာနှစ်မျိုးလုံးကို ဖွင့်ပေးပြီး ကတ်တစ်ခုစီကို fully isolated instance လေးခုအထိ ပိုင်းခြားနိုင်စေပြီး မတူညီသော workloads များအတွက် resource အသုံးချမှုကို အမြင့်ဆုံးဖြစ်စေပါသည်။ ဤ GPU များ၏ Desktop ဗားရှင်းများကို ဧပြီလတွင် ဈေးကွက်သို့ ရောက်ရှိလာရန် စီစဉ်ထားပြီး server counterparts များကို မေလတွင် ဖြန့်ချိမည်ဖြစ်ပြီး OEM-based laptop များကို ဇွန်လတွင် ဖြန့်ချိမည်ဖြစ်သည်။
NVIDIA ဖိုတနစ်စ်

AI ဒေတာစင်တာများအတွင်း optical networking ကိုပြောင်းလဲရန် ရည်ရွယ်ထားသော ဆန်းသစ်တီထွင်မှုတစ်ခုဖြစ်သည့် NVIDIA Photonics သည် hardware ကြေငြာချက်များကို ပြီးပြည့်စုံစေခဲ့သည်။ ရိုးရာ pluggable transceiver များကို switch ASIC နှင့် တူညီသော package တွင်တည်ရှိသော co-packaged optical engine များဖြင့် အစားထိုးခြင်းဖြင့် NVIDIA Photonics သည် ပါဝါသုံးစွဲမှုကို လျှော့ချပေးပြီး ဒေတာချိတ်ဆက်မှုကို ပိုမိုကောင်းမွန်စေသည်။
TSMC ရဲ့ photonic engine optimization တွေကို အသုံးပြုပြီး micro-ring modulators၊ high-efficiency lasers နဲ့ detachable fiber connectors တွေနဲ့ ဖြည့်စွက်ထားတဲ့ Photonics platform အသစ်ကို သမားရိုးကျ solution တွေထက် 3.5x ပိုကောင်းတဲ့ efficiency၊ 10x ပိုမြင့်တဲ့ resiliency နဲ့ 1.3x ပိုမြန်တဲ့ deployment speed တွေ ရရှိအောင် ဒီဇိုင်းထုတ်ထားပါတယ်။ ပိုမိုကျယ်ပြန့်တဲ့ ecosystem approach ကို သရုပ်ပြရာမှာ NVIDIA က အဆင့်မြင့် packaging နဲ့ optical component manufacturing leaders တွေနဲ့ ပူးပေါင်းဆောင်ရွက်မှုဟာ ဒီ performance တိုးတက်မှုတွေကို ရရှိဖို့အတွက် အဓိကကျတယ်ဆိုတာကို အသေးစိတ်ဖော်ပြခဲ့ပါတယ်။
 ဤဖွံ့ဖြိုးတိုးတက်မှုအသစ်များနှင့်အတူ NVIDIA သည် Quantum-X နှင့် Spectrum-X switch မိသားစုများတွင် 200G SerDes ပါရှိသော switch အသစ်သုံးခုကို ပြသခဲ့သည်။ Quantum-X Infiniband စီးရီးတွင် Quantum 3450-LD ပါဝင်ပြီး 800G ၏ port ၁၄၄ ခု သို့မဟုတ် 200G ၏ port ၅၇၆ ခု ပါဝင်ပြီး bandwidth 115Tb/s ပေးစွမ်းနိုင်သည်။ Spectrum-X Ethernet switch များတွင်၊ portfolio တွင် ပိုမိုသေးငယ်သော Spectrum SN6810 မှ 800G ၏ port ၁၂၈ ခု သို့မဟုတ် 200G ၏ port ၅၁၂ ခု ပါဝင်ပြီး 800G ၏ port ၅၁၂ ခု နှင့် 200G ၏ port ၂၀၄၈ ခု ပါဝင်သော high-density Spectrum SN6800 အထိ အမျိုးမျိုးရှိသည်။ ဤ switch အားလုံးတွင် အကောင်းဆုံးစွမ်းဆောင်ရည်နှင့် ထိရောက်မှုကို ထိန်းသိမ်းရန် liquid cooling နည်းပညာ ပါရှိသည်။
NVIDIA Quantum-X Photonics InfiniBand switches များကို ယခုနှစ်နှောင်းပိုင်းတွင် ရရှိနိုင်မည်ဟု မျှော်လင့်ရပြီး NVIDIA Spectrum-X Photonics Ethernet switches များကို ၂၀၂၆ ခုနှစ်တွင် ထိပ်တန်းအခြေခံအဆောက်အအုံနှင့် စနစ်ရောင်းချသူများထံမှ ရရှိနိုင်မည်ဖြစ်သည်။
Nvidia Dynamo နှင့်အတူ Hardware နှင့် Software များကို ပေါင်းစပ်ခြင်း
NVIDIA ရဲ့ ကြေငြာချက်တွေဟာ software နဲ့ hardware နှစ်မျိုးလုံးမှာ တူညီတဲ့ အစိတ်အပိုင်းတွေ ဖြစ်ပါတယ်။ Blackwell GPU အသစ်တွေရဲ့ တွက်ချက်မှုစွမ်းအားကို အပြည့်အဝ အသုံးချနိုင်ဖို့အတွက် NVIDIA ဟာ Dynamo ကို မိတ်ဆက်ခဲ့ပါတယ်။ ဒီ software ဟာ AI မော်ဒယ်တွေကို ကျယ်ကျယ်ပြန့်ပြန့် ဝန်ဆောင်မှုပေးဖို့ အထူးဒီဇိုင်းထုတ်ထားတဲ့ AI inference software တစ်ခု ဖြစ်ပါတယ်။

NVIDIA Dynamo သည် ဒေတာစင်တာတစ်ခုလုံးတွင် ကြီးမားသော AI မော်ဒယ်များ ဖြန့်ကျက်မှုကို အကောင်းဆုံးဖြစ်အောင် ဒီဇိုင်းထုတ်ထားသော open-source inference platform တစ်ခုဖြစ်သည်။ Dynamo ၏ ထူးခြားသော ဖြန့်ဝေထားသော နှင့် ခွဲခြားထားသော ဗိသုကာလက်ရာသည် GPU များစွာတွင် တစ်ခုတည်းသော query ကို ချဲ့ထွင်နိုင်စေပြီး inference workloads များကို သိသိသာသာ အရှိန်မြှင့်တင်ပေးပါသည်။ input token computation နှင့် output tokens များအကြား processing tasks များကို ဉာဏ်ရည်ထက်မြက်စွာ ပိုင်းခြားခြင်းနှင့် NVIDIA ၏ NVLink interconnect ၏ အားသာချက်များကို အသုံးချခြင်းဖြင့် DeepSeek R1 ကဲ့သို့သော ကျိုးကြောင်းဆင်ခြင်မှု အဓိကမော်ဒယ်များအတွက် စွမ်းဆောင်ရည် 30x အထိ တိုးတက်မှုကို ရရှိစေသည်။
အံ့သြစရာကောင်းတာက Dynamo ဟာ နောက်ထပ် hardware မပါဘဲ Hopper GPU တွေမှာ LLAMA လိုမျိုး ရှိပြီးသား LLM တွေရဲ့ throughput ကို နှစ်ဆတိုးစေပြီး AI စက်ရုံတွေအတွက် token generation နဲ့ ဝင်ငွေအလားအလာကို နှစ်ဆတိုးစေပါတယ်။ Dynamo နဲ့အတူ NVIDIA ဟာ hyperscale-level optimization တွေကို လူတိုင်းဆီ ယူဆောင်လာပြီး ရရှိနိုင်စေတာကြောင့် လူတိုင်း AI ရဲ့ အသွင်ပြောင်းနိုင်စွမ်းကို အပြည့်အဝ အသုံးချနိုင်စေပါတယ်။
Dynamo ကို ယနေ့ GitHub တွင် ရရှိနိုင်ပြီး PyTorch၊ BLM၊ SGLang နှင့် TensorRT အပါအဝင် ရေပန်းစားသော backend များကို ပံ့ပိုးပေးပါသည်။
Nvidia AI-Q: Agentic AI စနစ်များ၏ နောက်မျိုးဆက်
NVIDIA သည် AI-Q (အသံထွက် “IQ”) ကိုလည်း မိတ်ဆက်ခဲ့ပြီး AI အေးဂျင့်များသည် ကြီးမားသော လုပ်ငန်းဒေတာနှင့် ကိရိယာများနှင့် ချောမွေ့စွာ ချိတ်ဆက်ရန် ပုံစံတစ်ခုဖြစ်သည်။ ဤ open-source framework သည် အေးဂျင့်များအား စာသား၊ ရုပ်ပုံများနှင့် ဗီဒီယိုအပါအဝင် ဒေတာအမျိုးအစားများစွာကို မေးမြန်းပြီး ကျိုးကြောင်းဆင်ခြင်နိုင်စေသည့်အပြင် ဝဘ်ရှာဖွေမှုနှင့် အခြားအေးဂျင့်များကဲ့သို့သော ပြင်ပကိရိယာများကို အသုံးချနိုင်စေပါသည်။
AI-Q ရဲ့ အဓိကအချက်ကတော့ NVIDIA AgentIQ toolkit အသစ်ဖြစ်ပြီး၊ ဒီ toolkit ဟာ open-source software library တစ်ခုဖြစ်တဲ့ GitHub မှာ ဒီနေ့ထွက်ရှိလာပါတယ်။ AgentIQ ဟာ multi-agent system တွေကို ချိတ်ဆက်ခြင်း၊ profiling လုပ်ခြင်းနဲ့ optimize လုပ်ခြင်းတွေကို လွယ်ကူချောမွေ့စေပြီး enterprise တွေအနေနဲ့ ခေတ်မီ digital workforces တွေကို တည်ဆောက်နိုင်စေပါတယ်။ AgentIQ ဟာ CrewAI၊ LangGraph၊ Llama Stack၊ Microsoft Azure AI Agent Service နဲ့ Letta အပါအဝင် လက်ရှိ multi-agent frameworks တွေနဲ့ ချောမွေ့စွာ ပေါင်းစပ်ထားတာကြောင့် developer တွေအနေနဲ့ တဖြည်းဖြည်း ဒါမှမဟုတ် ပြီးပြည့်စုံတဲ့ solution အနေနဲ့ လက်ခံအသုံးပြုနိုင်ပါတယ်။
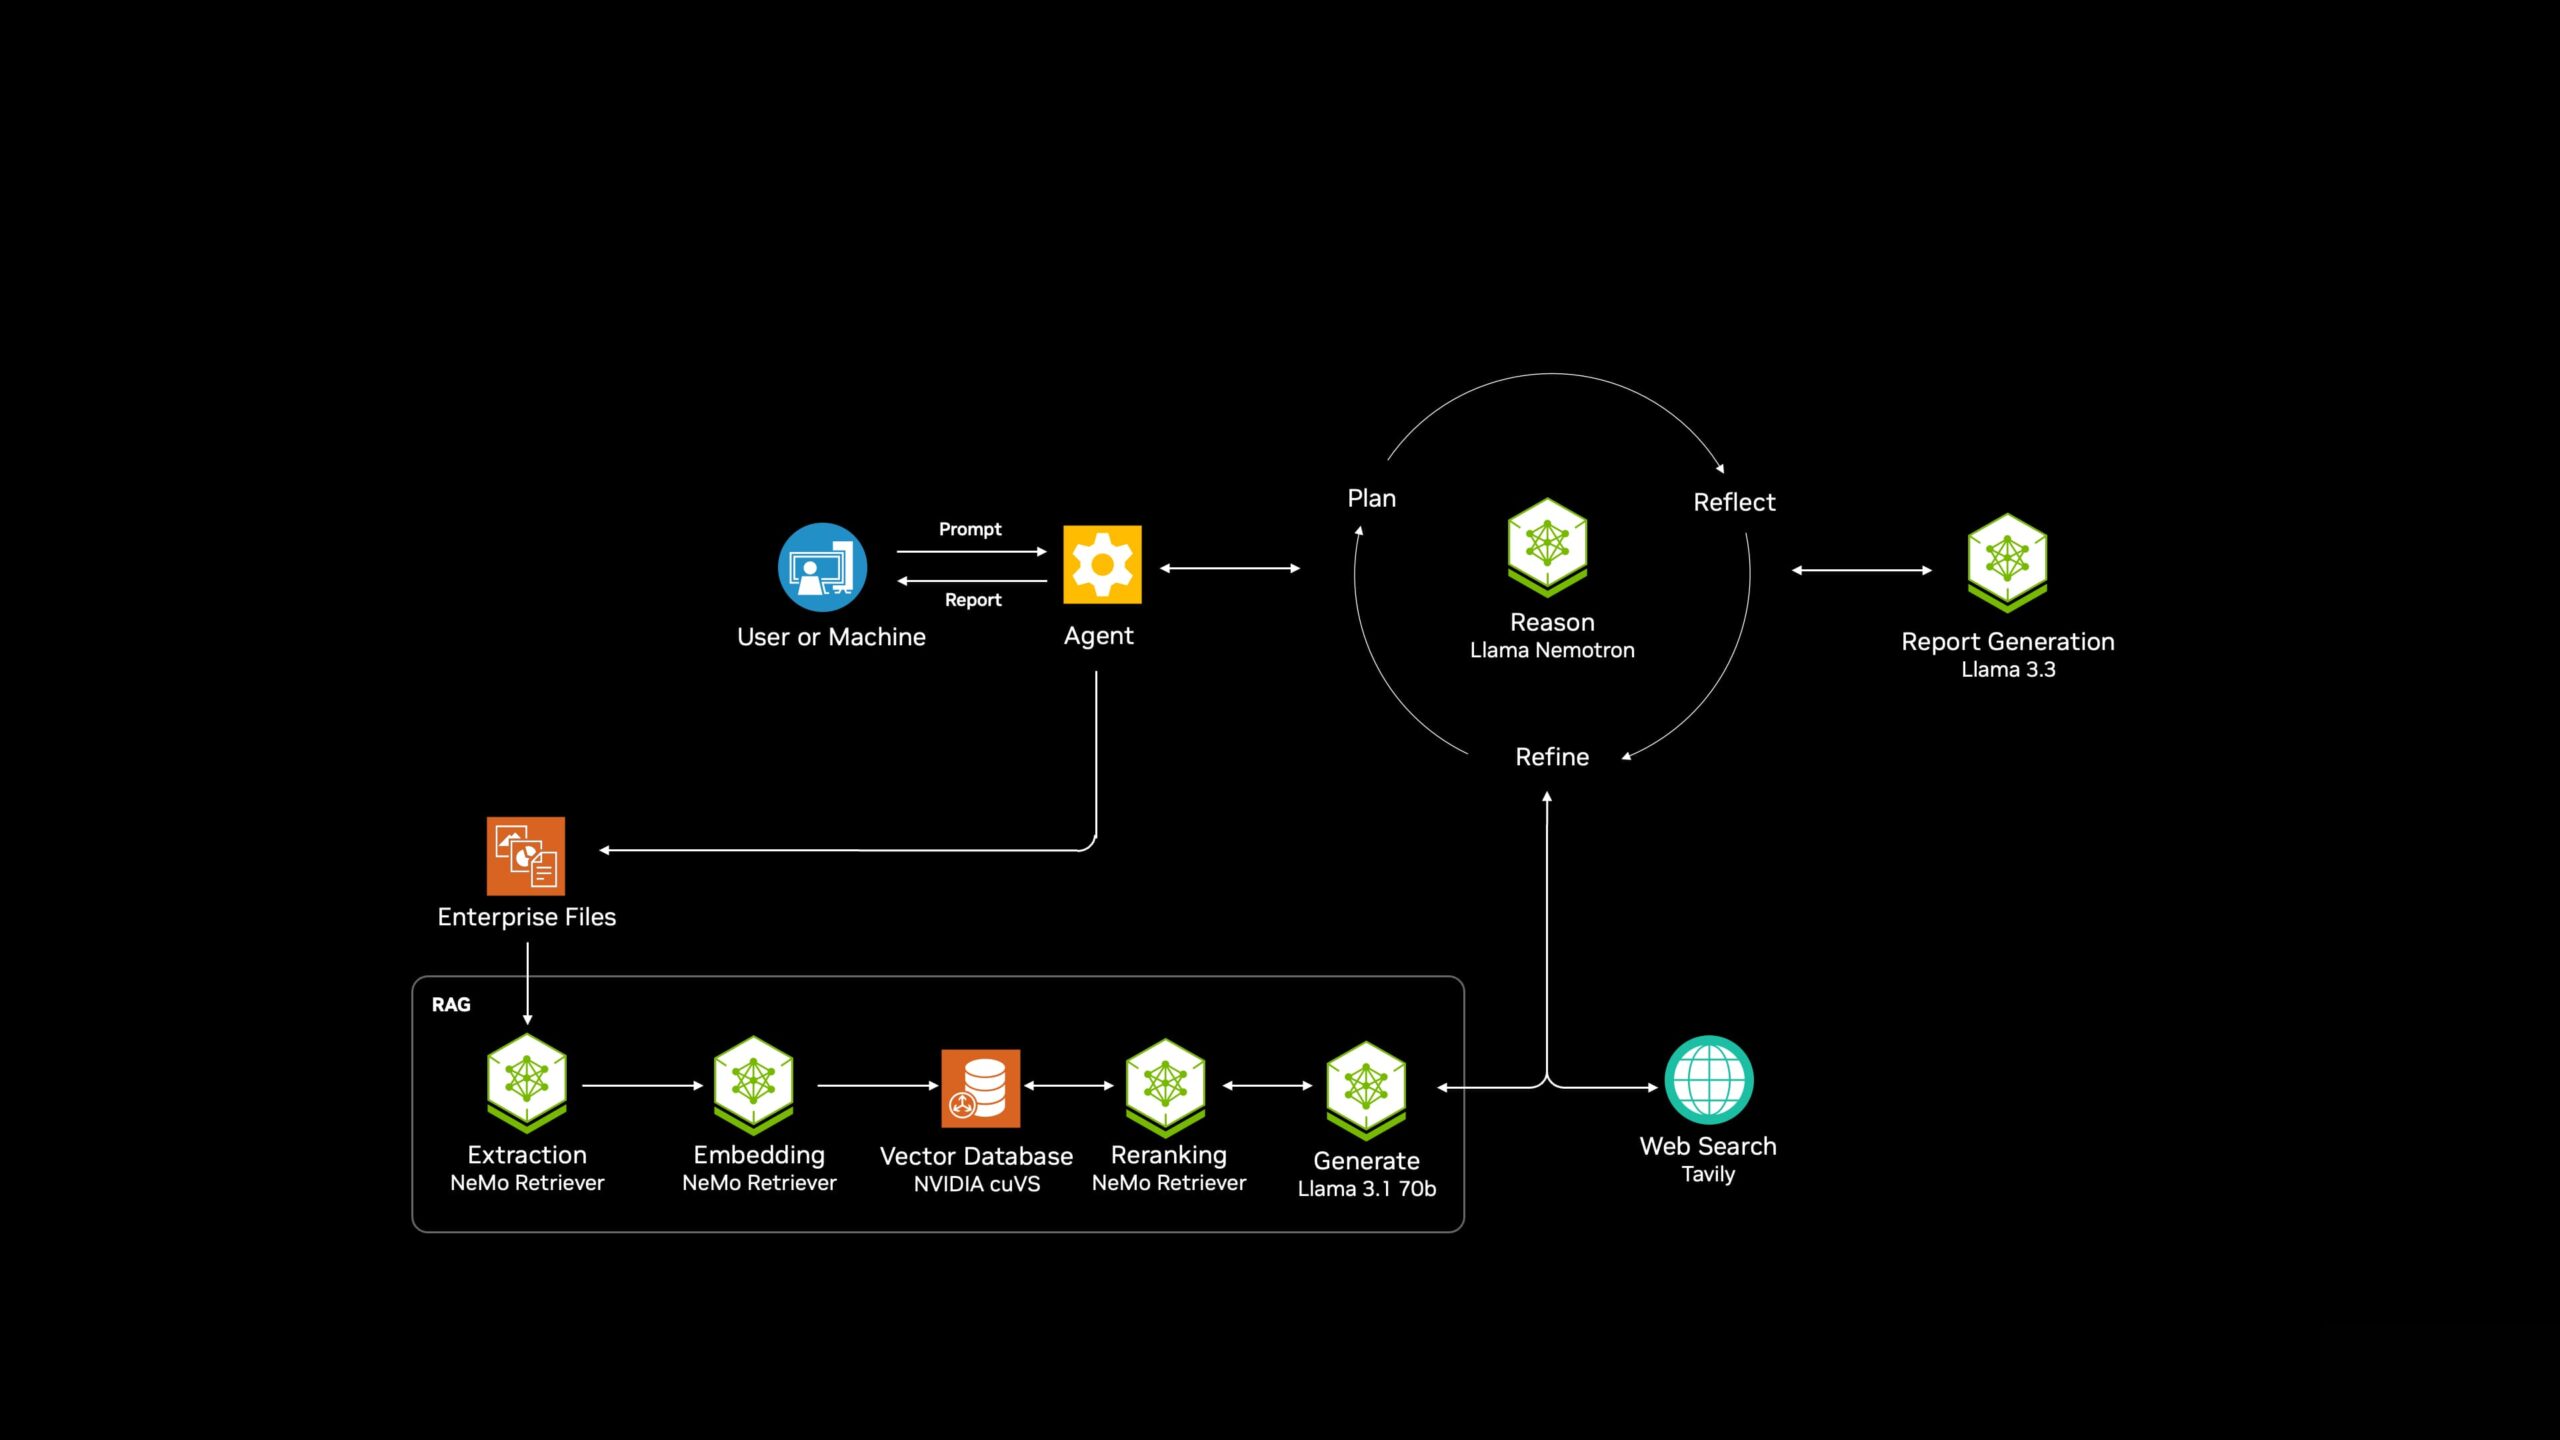
NVIDIA သည် NVIDIA NeMo Retriever၊ AI-Q Blueprint၊ Blackwell GPU များ၊ Spectrum X ကွန်ရက်နှင့် Bluefield DPU များကို ပေါင်းစပ်ထားသည့် AI data platform reference architecture တစ်ခုကို ဖန်တီးရန်အတွက် ဦးဆောင်ဒေတာသိုလှောင်မှုပံ့ပိုးပေးသူများနှင့်လည်း ပူးပေါင်းဆောင်ရွက်လျက်ရှိသည်။ အချိန်နှင့်တပြေးညီ ဒေတာလုပ်ဆောင်ခြင်းနှင့် အသိပညာများကို လျင်မြန်စွာ ပြန်လည်ရယူခြင်းတို့ကို သေချာစေရန်၊ AI အေးဂျင့်များအား မရှိမဖြစ်လိုအပ်သော စီးပွားရေးဆိုင်ရာ အသိဉာဏ်များဖြင့် စွမ်းဆောင်နိုင်စေရန်။
AI-Q ကို developer များ ဧပြီလမှစတင်၍ အသုံးပြုနိုင်မည်ဖြစ်သည်။
NVIDIA မစ်ရှင်ထိန်းချုပ်မှု- AI စက်ရုံကို စီစဉ်ခြင်း
၎င်း၏ ပြည့်စုံသော software မဟာဗျူဟာကို အခြေခံ၍ NVIDIA သည် AI data center များနှင့် workloads များ၏ ရှုပ်ထွေးသော စီမံခန့်ခွဲမှုကို အလိုအလျောက်လုပ်ဆောင်ရန် ဒီဇိုင်းထုတ်ထားသော လုပ်ငန်းနယ်ပယ်၏ တစ်ခုတည်းသော ပေါင်းစည်းထားသော operations နှင့် orchestration software platform ဖြစ်သည့် Mission Control ကို မိတ်ဆက်ခဲ့သည်။ Dynamo သည် inference ကို အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ပြီး AI-Q သည် agentic systems များကို enable လုပ်နေစဉ်တွင် Mission Control သည် AI pipeline တစ်ခုလုံးကို ကျောထောက်နောက်ခံပြုသော critical infrastructure layer ကို ကိုင်တွယ်ဖြေရှင်းပေးသည်။
Mission Control သည် လုပ်ငန်းများအနေဖြင့် AI အခြေခံအဆောက်အအုံများကို မည်သို့ဖြန့်ကျက်ပြီး စီမံခန့်ခွဲပုံ၊ ပံ့ပိုးပေးခြင်း၊ စောင့်ကြည့်ခြင်းနှင့် အမှားရှာဖွေခြင်းအပါအဝင် end-to-end စီမံခန့်ခွဲမှုကို အလိုအလျောက်လုပ်ဆောင်ပုံကို ပြောင်းလဲပေးသည်။ ဤပလက်ဖောင်းသည် Blackwell-based စနစ်များပေါ်တွင် လေ့ကျင့်မှုနှင့် ကောက်ချက်ချမှု workloads များအကြား ချောမွေ့စွာ ကူးပြောင်းနိုင်စေပြီး အဖွဲ့အစည်းများအား ဦးစားပေးမှုများ ပြောင်းလဲလာသည်နှင့်အမျှ cluster အရင်းအမြစ်များကို ပြန်လည်ခွဲဝေနိုင်စေပါသည်။ NVIDIA မှ ဝယ်ယူထားသော Run:ai နည်းပညာကို ပေါင်းစပ်ခြင်းဖြင့် Mission Control သည် အခြေခံအဆောက်အအုံအသုံးပြုမှုကို ၅ ဆအထိ မြှင့်တင်ပေးပြီး manual intervention လိုအပ်သော ရိုးရာနည်းလမ်းများထက် ၁၀ ဆအထိ ပိုမိုမြန်ဆန်သော job recovery ကို ပေးစွမ်းနိုင်သည်။
ဤဆော့ဖ်ဝဲသည် ခေတ်မီ AI workloads များအတွက် အရေးကြီးသော လုပ်ငန်းလည်ပတ်မှု အားသာချက်များစွာကို ပေးစွမ်းပြီး၊ ၎င်းတို့တွင် ရိုးရှင်းသော cluster setup၊ SUNK (Slurm နှင့် Kubernetes) workflows အတွက် ချောမွေ့သော workload orchestration၊ developer-selectable controls ပါရှိသော စွမ်းအင်ကို အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသော power profiles များနှင့် autonomous job recovery capabilities များ ပါဝင်သည်။ အပိုဆောင်း features များတွင် စိတ်ကြိုက်ပြင်ဆင်နိုင်သော performance dashboards၊ on-demand health checks နှင့် ပိုမိုကောင်းမွန်သော cooling နှင့် power management အတွက် building management system integration တို့ ပါဝင်သည်။
Dell၊ HPE၊ Lenovo နှင့် Supermicro အပါအဝင် အဓိကစနစ်ထုတ်လုပ်သူများသည် Mission Control တပ်ဆင်ထားသော NVIDIA GB200 NVL72 နှင့် GB300 NVL72 စနစ်များကို ကမ်းလှမ်းရန် အစီအစဉ်များကို ကြေညာခဲ့သည်။ Dell သည် NVIDIA ပါဝင်သော ၎င်း၏ AI Factory တွင် ဆော့ဖ်ဝဲကို ပေါင်းစပ်မည်ဖြစ်ပြီး HPE သည် ၎င်း၏ Grace Blackwell rack-scale စနစ်များဖြင့် ကမ်းလှမ်းမည်ဖြစ်သည်။ Lenovo သည် Mission Control ပါဝင်စေရန် ၎င်း၏ Hybrid AI Advantage ဖြေရှင်းချက်များကို အပ်ဒိတ်လုပ်ရန် စီစဉ်ထားပြီး Supermicro သည် ၎င်းကို ၎င်းတို့၏ Supercluster စနစ်များထဲသို့ ပေါင်းစပ်မည်ဖြစ်သည်။
NVIDIA Mission Control ကို DGX GB200 နှင့် DGX B200 စနစ်များအတွက် ရရှိနိုင်ပြီး DGX GB300၊ DGX B300 နှင့် GB300 NVL72 စနစ်များအတွက် ယခုနှစ်နှောင်းပိုင်းတွင် ပံ့ပိုးမှု ရရှိမည်ဟု မျှော်လင့်ရသည်။ AI အခြေခံအဆောက်အအုံကို စီမံခန့်ခွဲရန် ရှာဖွေနေသော အဖွဲ့အစည်းများအတွက် NVIDIA သည် cluster အရွယ်အစား မည်သို့ပင်ရှိစေကာမူ Base Command Manager ဆော့ဖ်ဝဲကို စနစ်တစ်ခုလျှင် accelerator ရှစ်ခုအထိ မကြာမီ အခမဲ့ပေးတော့မည်ဟုလည်း ကြေညာခဲ့သည်။
ကောက်ချက်
NVIDIA ရဲ့ GTC 2025 ဟာ AI နည်းပညာမှာ အပြောင်းအလဲကြီးတစ်ခုအတွက် အခြေခံအုတ်မြစ်ချပေးခဲ့ပြီး ဟာ့ဒ်ဝဲ၊ ဆော့ဖ်ဝဲနဲ့ အခြေခံအဆောက်အအုံတွေမှာ 획기적인 တိုးတက်မှုတွေကို ထုတ်ဖော်ပြသခဲ့ပါတယ်။ Blackwell Ultra ဗိသုကာပေါ်မှာ တည်ဆောက်ထားတဲ့ အစွမ်းထက် B300 GPU တွေကနေ တော်လှန်ရေးဆန်တဲ့ DGX Spark နဲ့ DGX Station စနစ်တွေအထိ NVIDIA ဟာ AI computing မှာ ဘာတွေဖြစ်နိုင်လဲဆိုတာကို ဆက်လက်ပြန်လည်သတ်မှတ်နေပါတယ်။ NVIDIA Photonics၊ Dynamo inference software၊ AI-Q agentic frameworks နဲ့ Mission Control orchestration platform တို့ကို မိတ်ဆက်ခြင်းက စီးပွားရေးလုပ်ငန်းတွေကို ဈေးကွက်ထဲ ပိုမိုမြန်ဆန်စွာရောက်ရှိစေပြီး ပိုမိုထိရောက်စွာ တိုးချဲ့နိုင်အောင် ကူညီပေးမှာဖြစ်ပြီး NVIDIA ကို ဒီနယ်ပယ်မှာ ဦးဆောင်သူအဖြစ် ခိုင်မာအောင် ဆက်လက်လုပ်ဆောင်သွားမှာ သေချာပါတယ်။
ဒါပေမယ့် ဒါက ရေခဲတောင်ရဲ့ အဖျားပိုင်းပဲ ရှိပါသေးတယ်။ GTC မှာ စူးစမ်းလေ့လာဖို့ ဆန်းသစ်တီထွင်မှုနဲ့ အတွေးအမြင်တွေ အများကြီးရှိပါသေးတယ်။ နောက်ဆုံးရ ကြေငြာချက်တွေနဲ့ NVIDIA ရဲ့ စိတ်လှုပ်ရှားဖွယ် အနာဂတ်ကို နက်နက်ရှိုင်းရှိုင်း လေ့လာနိုင်မယ့် ကျွန်တော်တို့ရဲ့ အခြားသတင်းဆောင်းပါးတွေကို စောင့်မျှော်ကြည့်ရှုပါ။


 အမေဇုံ