

Qualcomm Technologies သည် ၎င်း၏ ၂၀၂၆ ခုနှစ် ရင်းနှီးမြှုပ်နှံသူနေ့တွင် အပြည့်အဝ အောင်မြင်မှုရရှိခဲ့ပြီး အဓိကကြေငြာချက်သုံးခုကို အခြေခံ၍ တည်ဆောက်ထားသော တက်ကြွသောဒေတာစင်တာမဟာဗျူဟာကို ချမှတ်ခဲ့သည်- AI ဆော့ဖ်ဝဲကုမ္ပဏီ Modular Inc. ကို ဝယ်ယူခြင်း၊ Dragonfly C1000 CPU ကို မိတ်ဆက်ခြင်းနှင့် inference accelerator portfolio ကို တိုးချဲ့ခြင်း၊ နှင့် Hugging Face နှင့် Meta နှင့် မိတ်ဖက်ဆက်ဆံရေးများကို နက်ရှိုင်းစေခြင်းတို့ဖြစ်သည်။ အတူတကွ လုပ်ဆောင်မှုများသည် Qualcomm ၏ ဆီလီကွန်မှ ဆော့ဖ်ဝဲ၊ ဂေဟစနစ်အထိ AI အခြေခံအဆောက်အအုံအားလုံးတွင် ယှဉ်ပြိုင်ရန် ရည်ရွယ်ချက်ကို ညွှန်ပြနေသည်။
Qualcomm က Modular Inc. ကို ဝယ်ယူတော့မည်။
Qualcomm သည် မတူညီသော ဟာ့ဒ်ဝဲဗိသုကာပုံစံများတွင် ထိရောက်သော AI အကောင်အထည်ဖော်မှုကို လုပ်ဆောင်နိုင်စေရန် ဒီဇိုင်းထုတ်ထားသော AI ဆော့ဖ်ဝဲကုမ္ပဏီ Modular Inc. ကို ဝယ်ယူရန် အပြီးသတ်သဘောတူညီချက်တစ်ရပ်ကို ချုပ်ဆိုခဲ့သည်။ စည်းမျဉ်းစည်းကမ်းများ၏ ခွင့်ပြုချက်များနှင့် ထုံးစံပိတ်သိမ်းခြင်းဆိုင်ရာ စည်းကမ်းချက်များအပေါ် မူတည်၍ ၂၀၂၆ ခုနှစ် ဒုတိယနှစ်ဝက်တွင် အရောင်းအဝယ်ပြီးဆုံးရန် မျှော်လင့်ရသည်။
Modular ကို အခြေခံ AI အခြေခံအဆောက်အအုံ ပရောဂျက်များတွင် ပါဝင်ကူညီခဲ့သော အင်ဂျင်နီယာများက တည်ထောင်ခဲ့ပြီး developer များသည် CPU၊ GPU၊ NPU နှင့် custom ASIC architectures များတွင် လည်ပတ်သည့် open, AI-native software stack တစ်ခုကို တည်ဆောက်ခဲ့သည်။ ပလက်ဖောင်း၏ သယ်ဆောင်ရလွယ်ကူမှုသည် အဓိက ခြားနားချက်တစ်ခုဖြစ်ပြီး အဖွဲ့အစည်းများအား တစ်ကြိမ်တည်း တည်ဆောက်နိုင်ပြီး မည်သည့်ပတ်ဝန်းကျင်တွင်မဆို ဖြန့်ကျက်နိုင်စေသည့်အပြင် ပိုင်ဆိုင်မှုစုစုပေါင်းကုန်ကျစရိတ်ကို လျှော့ချပေးပါသည်။
ဤဝယ်ယူမှုသည် AI ဖြန့်ကျက်မှုတွင် တိုးပွားလာနေသော ကန့်သတ်ချက်တစ်ခုကို ဖြေရှင်းပေးပါသည်။ Qualcomm က ၎င်းကို ပုံဖော်ထားသကဲ့သို့၊ መልእክትစွမ်းရည်မဟုတ်ဘဲ ထိရောက်မှုသည် အကန့်အသတ်ဖြစ်စေသောအချက်ဖြစ်လာသည်- ဝပ်တစ်ခုလျှင်စွမ်းဆောင်ရည်သည် ကောက်ချက်ချခြင်း၏ကုန်ကျစရိတ်ကို မောင်းနှင်ပြီး ဆော့ဖ်ဝဲထိရောက်မှုသည် ၎င်းကို စီးပွားရေးအရ တိုးချဲ့ရန်အတွက် အဓိက lever တစ်ခုဖြစ်လာပါသည်။ Modular ၏ stack သည် ထို lever ကို တည့်တည့်ရည်ရွယ်ထားပြီး မတူညီသော၊ ခွဲထားသော compute တစ်လျှောက်တွင် silicon စွမ်းဆောင်ရည်ကို ထိရောက်သော ကောက်ချက်ချမှုအဖြစ်သို့ ပြောင်းလဲပေးသည်။
Qualcomm ရဲ့ ဒေတာစင်တာ မဟာဗျူဟာအတွက် ဒီသဘောတူညီချက်ဟာ edge devices တွေကနေ မတူညီတဲ့ hardware environments တွေမှာ တသမတ်တည်း စွမ်းဆောင်ရည် လိုအပ်တဲ့ hyperscalers တွေအထိ platform အမျိုးမျိုးမှာ အကောင်းဆုံး inference၊ orchestration နဲ့ deployment တွေကို ပေးအပ်နိုင်စွမ်းကို ပိုမိုနက်ရှိုင်းစေပါတယ်။ Qualcomm က ပွင့်လင်းမြင်သာပြီး industry-friendly နဲ့ vendor-neutral အဖြစ် ဖော်ပြတဲ့ Modular ရဲ့ developer community ဟာ AI developer ecosystem ထဲကို ပိုမိုကျယ်ပြန့်တဲ့ ချဉ်းကပ်မှုကို ပေါင်းထည့်ပေးပါတယ်။
Dragonfly C1000 CPU နှင့် ဒေတာစင်တာပလက်ဖောင်း
Qualcomm သည် ၎င်း၏ စိတ်ကြိုက် Oryon cores များအပေါ် အခြေခံ၍ ဒီဇိုင်းထုတ်ထားသော ရည်ရွယ်ချက်ရှိရှိ တည်ဆောက်ထားသော data center CPU တစ်ခုဖြစ်သည့် Dragonfly C1000 ကို မိတ်ဆက်ခဲ့ပြီး၊ agentic AI orchestration၊ အထွေထွေရည်ရွယ်ချက် server workloads နှင့် AI head node applications များကို ပစ်မှတ်ထားသည်။ ဤ processor ကို 250 cores ကျော်ပါရှိသော multi-chiplet architecture ပေါ်တွင် တည်ဆောက်ထားပြီး 5 GHz အထက် ကြိမ်နှုန်းများတွင် လည်ပတ်ကာ ထုတ်ဝေထားသော သတ်မှတ်ချက်များအပေါ် အခြေခံ၍ လက်ရှိယှဉ်ပြိုင်နိုင်သော server CPU ကမ်းလှမ်းချက်များထက် watt တစ်ခုလျှင် 2 ဆ ပိုမိုကောင်းမွန်သော စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ရန် ဒီဇိုင်းထုတ်ထားသည်။
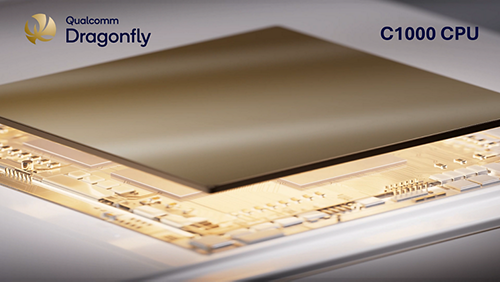
C1000 သည် PCIe Gen 7 ချိတ်ဆက်မှုကို 2 TB/s ကျော်ဖြင့် ပံ့ပိုးပေးထားပြီး မှတ်ဉာဏ်ခွဲထုတ်ခြင်းနှင့် မြန်နှုန်းမြင့်သိုလှောင်မှုနှင့် ကွန်ရက်ပေါင်းစပ်မှုအတွက် CXL ပံ့ပိုးမှုလည်း ပါဝင်သည်။ ၎င်း၏ မှတ်ဉာဏ်ခွဲစနစ်ကို ထိပ်တန်းပါဝါနည်းမှတ်ဉာဏ်နည်းပညာကို အသုံးပြု၍ bandwidth၊ စွမ်းရည်နှင့် ပါဝါထိရောက်မှုမြင့်မားစေရန် ဒီဇိုင်းထုတ်ထားသည်။ ဤပလက်ဖောင်းသည် လေနှင့် အရည်အအေးပေးစနစ် နှစ်မျိုးလုံးကို ပံ့ပိုးပေးပြီး OCP ORv3 ရက်ခ်နှင့် ဆာဗာစံနှုန်းများနှင့် ကိုက်ညီသည်။ ယုံကြည်စိတ်ချရသော အင်္ဂါရပ်များတွင် ECC၊ ချို့ယွင်းချက်ခွဲထုတ်ခြင်းနှင့် ကြီးမားသောလည်ပတ်မှုအတွက် အမှားပြန်လည်ရယူခြင်းတို့ ပါဝင်သည်။ စီးပွားဖြစ်ရရှိနိုင်မှုကို ၂၀၂၈ ခုနှစ်တွင် ရည်မှန်းထားသည်။
C1000 ကို ပုံစံသုံးမျိုးဖြင့် ရရှိနိုင်ပါသည်- မြင့်မားသော throughput orchestration နှင့် low-latency interactive AI အတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသော agentic CPU၊ first-party workloads အတွက် performance-per-TCO နှင့် third-party အသုံးပြုမှုအတွက် vCPU elasticity ကို ပစ်မှတ်ထားသော general-purpose CPU နှင့် high-speed interconnects များပေါ်တွင် low-overhead host processing မှတစ်ဆင့် XPU အသုံးပြုမှုကို အမြင့်ဆုံးဖြစ်စေရန် ဒီဇိုင်းထုတ်ထားသော AI head node CPU တို့ဖြစ်သည်။
Qualcomm မြင့်မားသော Bandwidth Compute (HBC)
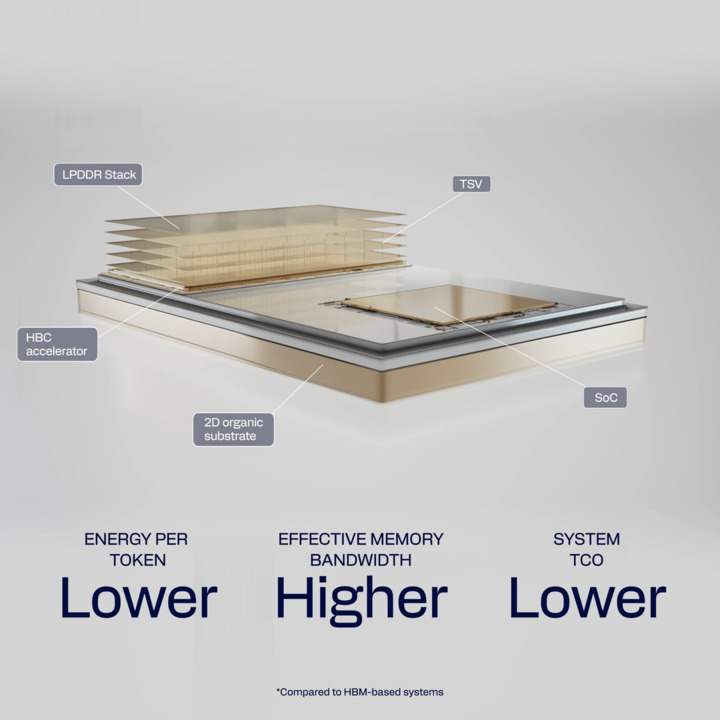
Qualcomm ရဲ့ inference accelerator roadmap ရဲ့ အဓိကအချက်ကတော့ High Bandwidth Compute architecture ဖြစ်ပြီး၊ 3D-stacked silicon solution မှာ compute ကို accelerated memory bandwidth နဲ့ ချိတ်ဆက်ပေးတဲ့ near-memory computing design တစ်ခုဖြစ်ပါတယ်။ HBC ကို HBM အတွက် တိုက်ရိုက်အစားထိုးတစ်ခုအဖြစ် ထားရှိထားပြီး Qualcomm က HBM ထက် watt တစ်ခုလျှင် bandwidth ၆ ဆ ပိုများပြီး SRAM ထက် watt တစ်ခုလျှင် capacity ၂၀၀ ဆ ပိုများတယ်လို့ ဆိုပါတယ်။
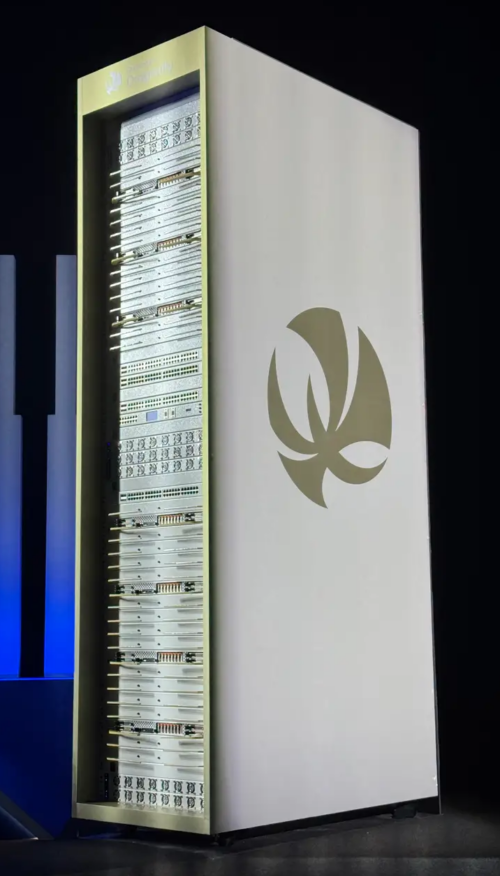
Dragonfly AI250 တွင် ပေါင်းစပ်ထားသော HBC Gen 1 သည် ကတ်တစ်ခုလျှင် ထိရောက်သော မှတ်ဉာဏ် bandwidth 133 TB/s ကို ပေးစွမ်းနိုင်ပြီး LPDDR5X ပါရှိသော AI200 ထက် ၁၈ ဆ တိုးလာပါသည်။ မကြာသေးမီက ကြေငြာခဲ့သော AI300 တွင် ပေါင်းစပ်ထားသော HBC Gen 2 သည် AI200 ထက် ၅၄ ဆ တိုးလာပါသည်။ AI250 ပါရှိသော HBC Gen 1 ကို စီးပွားဖြစ် နမူနာယူခြင်းကို ၂၀၂၇ ခုနှစ်လယ်ပိုင်းတွင် မျှော်လင့်ရပါသည်။
နဂါးဖလိုင်း AI300
AI300 သည် ၂၀၂၅ ခုနှစ် အောက်တိုဘာလတွင် ကြေညာခဲ့သော Qualcomm ၏ rack-scale AI inference platform ၏ တတိယမျိုးဆက်ဖြစ်သည်။ ၎င်းသည် ကြီးမားသော language model နှင့် multimodal model inference အပြင် agentic AI workloads များကို ပစ်မှတ်ထားသည့် compute acceleration အတွက် HBC Gen 2 ကို ပေါင်းစပ်ထားသည်။ Qualcomm သည် ရှိပြီးသား GPU-based architectures များနှင့် နှိုင်းယှဉ်ပါက card တစ်ခုလျှင် watt လျှင် memory bandwidth ၄ ဆ မှ ၈ ဆ အထိ မြင့်မားသည်။ AI300 သည် UALink နှင့် ESUN မှတစ်ဆင့် scale-up ကို ပံ့ပိုးပေးပြီး copper နှင့် optical interconnects များမှတစ်ဆင့် scale-out ကို ပံ့ပိုးပေးသည်။ စီးပွားဖြစ် sampling ကို ၂၀၂၈ ခုနှစ်တွင် ရရှိနိုင်မည်ဟု မျှော်လင့်ရသည်။
connectivity
Qualcomm ရဲ့ ဒေတာစင်တာ ချိတ်ဆက်မှု portfolio မှာ die-to-die၊ copper၊ optical နဲ့ campus-reach interconnects တွေ ပါဝင်ပြီး optical၊ AOC နဲ့ AEC application တွေမှာ 800G နဲ့ 1.6T bandwidth ကို 20 km အထိ ပံ့ပိုးပေးပါတယ်။ ဒီ portfolio ဟာ Qualcomm ရဲ့ SerDes၊ PAM4၊ coherent-lite DSP နဲ့ signal-integrity စွမ်းရည်တွေကို အသုံးပြုပြီး distributed, disaggregated AI infrastructure မှာ စွမ်းဆောင်ရည်ကို ပိုမိုသတ်မှတ်ပေးတဲ့ data movement bottleneck တွေကို ဖြေရှင်းပေးပါတယ်။
စိတ်ကြိုက်ဆီလီကွန်
Qualcomm သည် agent AI နှင့် အထူးပြု workloads များအတွက် bespoke ဒီဇိုင်းများဖြင့် hyperscalers နှင့် cloud provider များကို ပစ်မှတ်ထားသည့် custom silicon ကမ်းလှမ်းမှုတစ်ခုကိုလည်း ဖော်ပြခဲ့သည်။ ဤအစီအစဉ်တွင် silicon၊ system နှင့် software တစ်လျှောက် end-to-end co-design ပါဝင်ပြီး အဆင့်မြင့် packaging နှင့် modular architectures များဖြင့် ပမာဏများများ ထုတ်လုပ်ခြင်း ပံ့ပိုးမှုမှတစ်ဆင့် ဈေးကွက်သို့ ရောက်ရှိချိန်နှင့် အကောင်အထည်ဖော်မှု အန္တရာယ်ကို လျှော့ချရန် ဒီဇိုင်းထုတ်ထားသည်။
မိတ်ဖက်များ- Hugging Face နှင့် Meta
မျက်နှာပွေ့ဖက်
Qualcomm သည် ၎င်း၏ Snapdragon၊ Dragonwing နှင့် Dragonfly ထုတ်ကုန်မိသားစုများကို လွှမ်းခြုံထားသော အဓိကအချက်သုံးချက်အပေါ် အခြေခံ၍ Hugging Face နှင့် ၎င်း၏ မဟာဗျူဟာမြောက်ဆက်ဆံရေးကို တိုးချဲ့လိုက်ကြောင်း ကြေညာခဲ့သည်။ ပူးပေါင်းဆောင်ရွက်မှုကို Qualcomm ၏ device-to-data-center platform များကို Hugging Face ၏ developer အသိုင်းအဝိုင်း ၁၆ သန်းကျော်နှင့် ၎င်း၏ open model ၃ သန်းကျော်စာကြည့်တိုက်နှင့် ချိတ်ဆက်ရန် ဒီဇိုင်းထုတ်ထားသည်။
ပထမအချက်က Hugging Face ရဲ့ storage နဲ့ inference ဝန်ဆောင်မှုတွေကို Qualcomm Dragonfly-powered data center infrastructure နဲ့ ချိတ်ဆက်ပေးပြီး မော်ဒယ်စမ်းသပ်ချက်ကနေ application တွေနဲ့ agent တွေရဲ့ production deployment အထိ တိုက်ရိုက်လမ်းကြောင်းတစ်ခု ဖန်တီးပေးပါတယ်။ ဒုတိယအချက်က မော်ဒယ် deployment automation ကို အာရုံစိုက်ပါတယ်- Hugging Face ecosystem က AI မော်ဒယ်တွေကို agent-based workflow ကနေတစ်ဆင့် Qualcomm platform တွေပေါ်ကို onboard လုပ်သွားဖို့ စီစဉ်ထားပြီး manual integration မလိုအပ်ဘဲ setup၊ optimization နဲ့ deployment တွေကို ကိုင်တွယ်ပေးပါတယ်။ ဒါက smartphones၊ PCs၊ wearables၊ industrial systems၊ automotive platforms နဲ့ data center infrastructure တွေမှာ တစ်ခုတည်းသော workflow ကနေ deployment ကို ရိုးရှင်းအောင် လုပ်ဆောင်ဖို့ ရည်ရွယ်ပါတယ်။
တတိယမဏ္ဍိုင်သည် hybrid environment များတစ်လျှောက် agentic AI orchestration ကိုပစ်မှတ်ထားသည်။ Qualcomm နှင့် Hugging Face တို့သည် agent များသည် on-device နှင့် cloud system များတစ်လျှောက်တွင် လည်ပတ်ပြီး စွမ်းဆောင်ရည်၊ ကုန်ကျစရိတ်၊ privacy နှင့် latency လိုအပ်ချက်များအပေါ်အခြေခံ၍ မော်ဒယ်များနှင့် workflow များကို dynamic routing လုပ်သည့် distributed AI framework တစ်ခုကို ပံ့ပိုးရန်စီစဉ်ထားသည်။ ပူးပေါင်းဆောင်ရွက်မှု၏ တစ်စိတ်တစ်ပိုင်းအနေဖြင့် Hugging Face သည် Qualcomm-powered devices သို့မဟုတ် cloud systems များကိုအသုံးပြုသောဖောက်သည်များအား Hugging Face PRO ကို အသုံးပြုခွင့်ပေးမည်ဖြစ်သည်။ developer များသည် Hugging Face ecosystem မှတစ်ဆင့် Modular ၏ AI software components များနှင့် tools များကိုလည်း ဝင်ရောက်အသုံးပြုနိုင်မည်ဖြစ်ပြီး Modular ဝယ်ယူမှုကို ဤမိတ်ဖက်အဖွဲ့အစည်းနှင့် တိုက်ရိုက်ချိတ်ဆက်ပေးမည်ဖြစ်သည်။
meta
Qualcomm နှင့် Meta တို့သည် Qualcomm သည် Meta သို့ ဒေတာစင်တာ CPU များကို ထောက်ပံ့ပေးမည့် မဟာဗျူဟာမြောက် မျိုးဆက်များစွာ ပူးပေါင်းဆောင်ရွက်မှုကို ကြေညာခဲ့သည်။ Dragonfly C1000 သည် Meta ၏ နောက်မျိုးဆက် ဆာဗာအုပ်စုကို အားဖြည့်ရန် စီစဉ်ထားပြီး Qualcomm ၏ ဒေတာစင်တာ CPU ရည်မှန်းချက်များအတွက် သိသာထင်ရှားသော ဒီဇိုင်းအောင်ပွဲတစ်ခုကို ကိုယ်စားပြုပြီး စွမ်းဆောင်ရည်နှင့် ထိရောက်မှုအရ ကြီးမားသော၊ ချဲ့ထွင်နိုင်သော ဖြန့်ကျက်မှုများအတွက် ပလပ်ဖောင်း၏ အနေအထားကို အတည်ပြုပေးပါသည်။
Meta အပြင် နည်းပညာနှင့် AI ထောက်ပံ့ရေးကွင်းဆက်တစ်လျှောက်ရှိ ဂေဟစနစ်မိတ်ဖက် ၃၅ ဦးကျော်သည် Qualcomm ၏ဒေတာစင်တာရူပါရုံကို ထောက်ခံကြောင်း ဖော်ပြခဲ့ကြပြီး ၎င်းတို့တွင် Arista၊ Lenovo၊ Micron Technology၊ Samsung SDS၊ SK hynix America၊ Supermicro၊ VAST Data နှင့် ODM များ၊ မှတ်ဉာဏ်ပေးသွင်းသူများ၊ ကွန်ရက်ရောင်းချသူများနှင့် AI အခြေခံအဆောက်အအုံပံ့ပိုးပေးသူများ ပါဝင်သည်။
Qualcomm သည် နှစ်စဉ် cadence ပါရှိသော multi-generation data center roadmap တစ်ခုကို ကတိပြုထားပြီး Dragonfly AI300 သည် C1000 CPU platform နှင့် Modular ၏ software stack နှင့်အတူ ဆက်လက်တိုးတက်ပြောင်းလဲနေမည့် inference accelerator lineup တွင် AI200 နှင့် AI250 တို့နှင့်အတူ ပါဝင်လာမည်ဖြစ်သည်။


 အမေဇုံ