

Supermicro သည် လာမည့် NVIDIA Vera Rubin NVL72 နှင့် NVIDIA HGX Rubin NVL8 ပလက်ဖောင်းများကို ပံ့ပိုးရန်အတွက် rack-scale ထုတ်လုပ်မှုစွမ်းရည်ကို တိုးချဲ့ပြီး တိုက်ရိုက်အရည်အအေးပေးသည့်စွမ်းရည်ကို အဆင့်မြှင့်တင်ထားကြောင်း ကြေညာခဲ့သည်။ ကုမ္ပဏီသည် အမေရိကန်အခြေစိုက် အိမ်တွင်းဒီဇိုင်းနှင့် ထုတ်လုပ်မှုတို့ကို ၎င်း၏ Data Center Building Block Solutions (DCBBS) ချဉ်းကပ်မှုနှင့် end-to-end အရည်အအေးပေးနည်းပညာ stack တို့နှင့် ပေါင်းစပ်ခြင်းဖြင့် မြင့်မားသောသိပ်သည်းဆ AI အခြေခံအဆောက်အအုံအတွက် ဖြန့်ကျက်ချိန်ဇယားကို တိုတောင်းစေရန် လှုပ်ရှားမှုကို စီစဉ်နေသည်။
Supermicro ရဲ့ CEO Charles Liang က NVIDIA နဲ့ ကုမ္ပဏီရဲ့ ပူးပေါင်းဆောင်ရွက်မှုနဲ့ building-block design methodology ဟာ အဆင့်မြင့် AI platform တွေ ပေးအပ်မှုကို အရှိန်မြှင့်တင်ဖို့ ရည်ရွယ်တယ်လို့ အလေးပေးပြောကြားခဲ့ပါတယ်။ Supermicro ရဲ့ တိုးချဲ့ထားတဲ့ ထုတ်လုပ်မှု footprint နဲ့ liquid-cooling ကျွမ်းကျင်မှုဟာ hyperscale နဲ့ enterprise environment တွေမှာ Vera Rubin နဲ့ Rubin system တွေကို ထိရောက်ပြီး ယုံကြည်စိတ်ချရတဲ့ ကြီးမားတဲ့ ဖြန့်ကျက်မှုတွေရဲ့ အဓိက အထောက်အကူပြုပစ္စည်းတွေအဖြစ်လည်း အလေးပေးပြောကြားခဲ့ပါတယ်။
Rack-Scale Flagship: NVIDIA Vera Rubin NVL72 SuperCluster
ထိပ်တန်းအဆင့်မှာ Supermicro ဟာ NVIDIA Vera Rubin NVL72 SuperCluster ကို ပံ့ပိုးပေးသွားမှာဖြစ်ပါတယ်။ ဒီ rack-scale system မှာ NVIDIA Rubin GPU ၇၂ ခုနဲ့ NVIDIA Vera CPU ၃၆ ခုအပြင် NVIDIA ConnectX-9 SuperNICs နဲ့ NVIDIA BlueField-4 DPUs တွေကို ပေါင်းစပ်ထားပါတယ်။ ဒီ platform ဟာ intra-rack coherence အတွက် NVIDIA NVLink 6 ကို အသုံးပြုပါတယ်။ NVIDIA Quantum-X800 InfiniBand နဲ့ NVIDIA Spectrum-X Ethernet တွေထက် scale out ဖြစ်အောင် ဒီဇိုင်းထုတ်ထားပြီး လက်ရှိ industry ရဲ့ training, inference နဲ့ agentic AI ဒီဇိုင်းတွေအတွက် rack-as-a-system ဒီဇိုင်းတွေဆီ ဦးတည်နေတဲ့ တွန်းအားပေးမှုနဲ့ ကိုက်ညီအောင် လုပ်ဆောင်ထားပါတယ်။
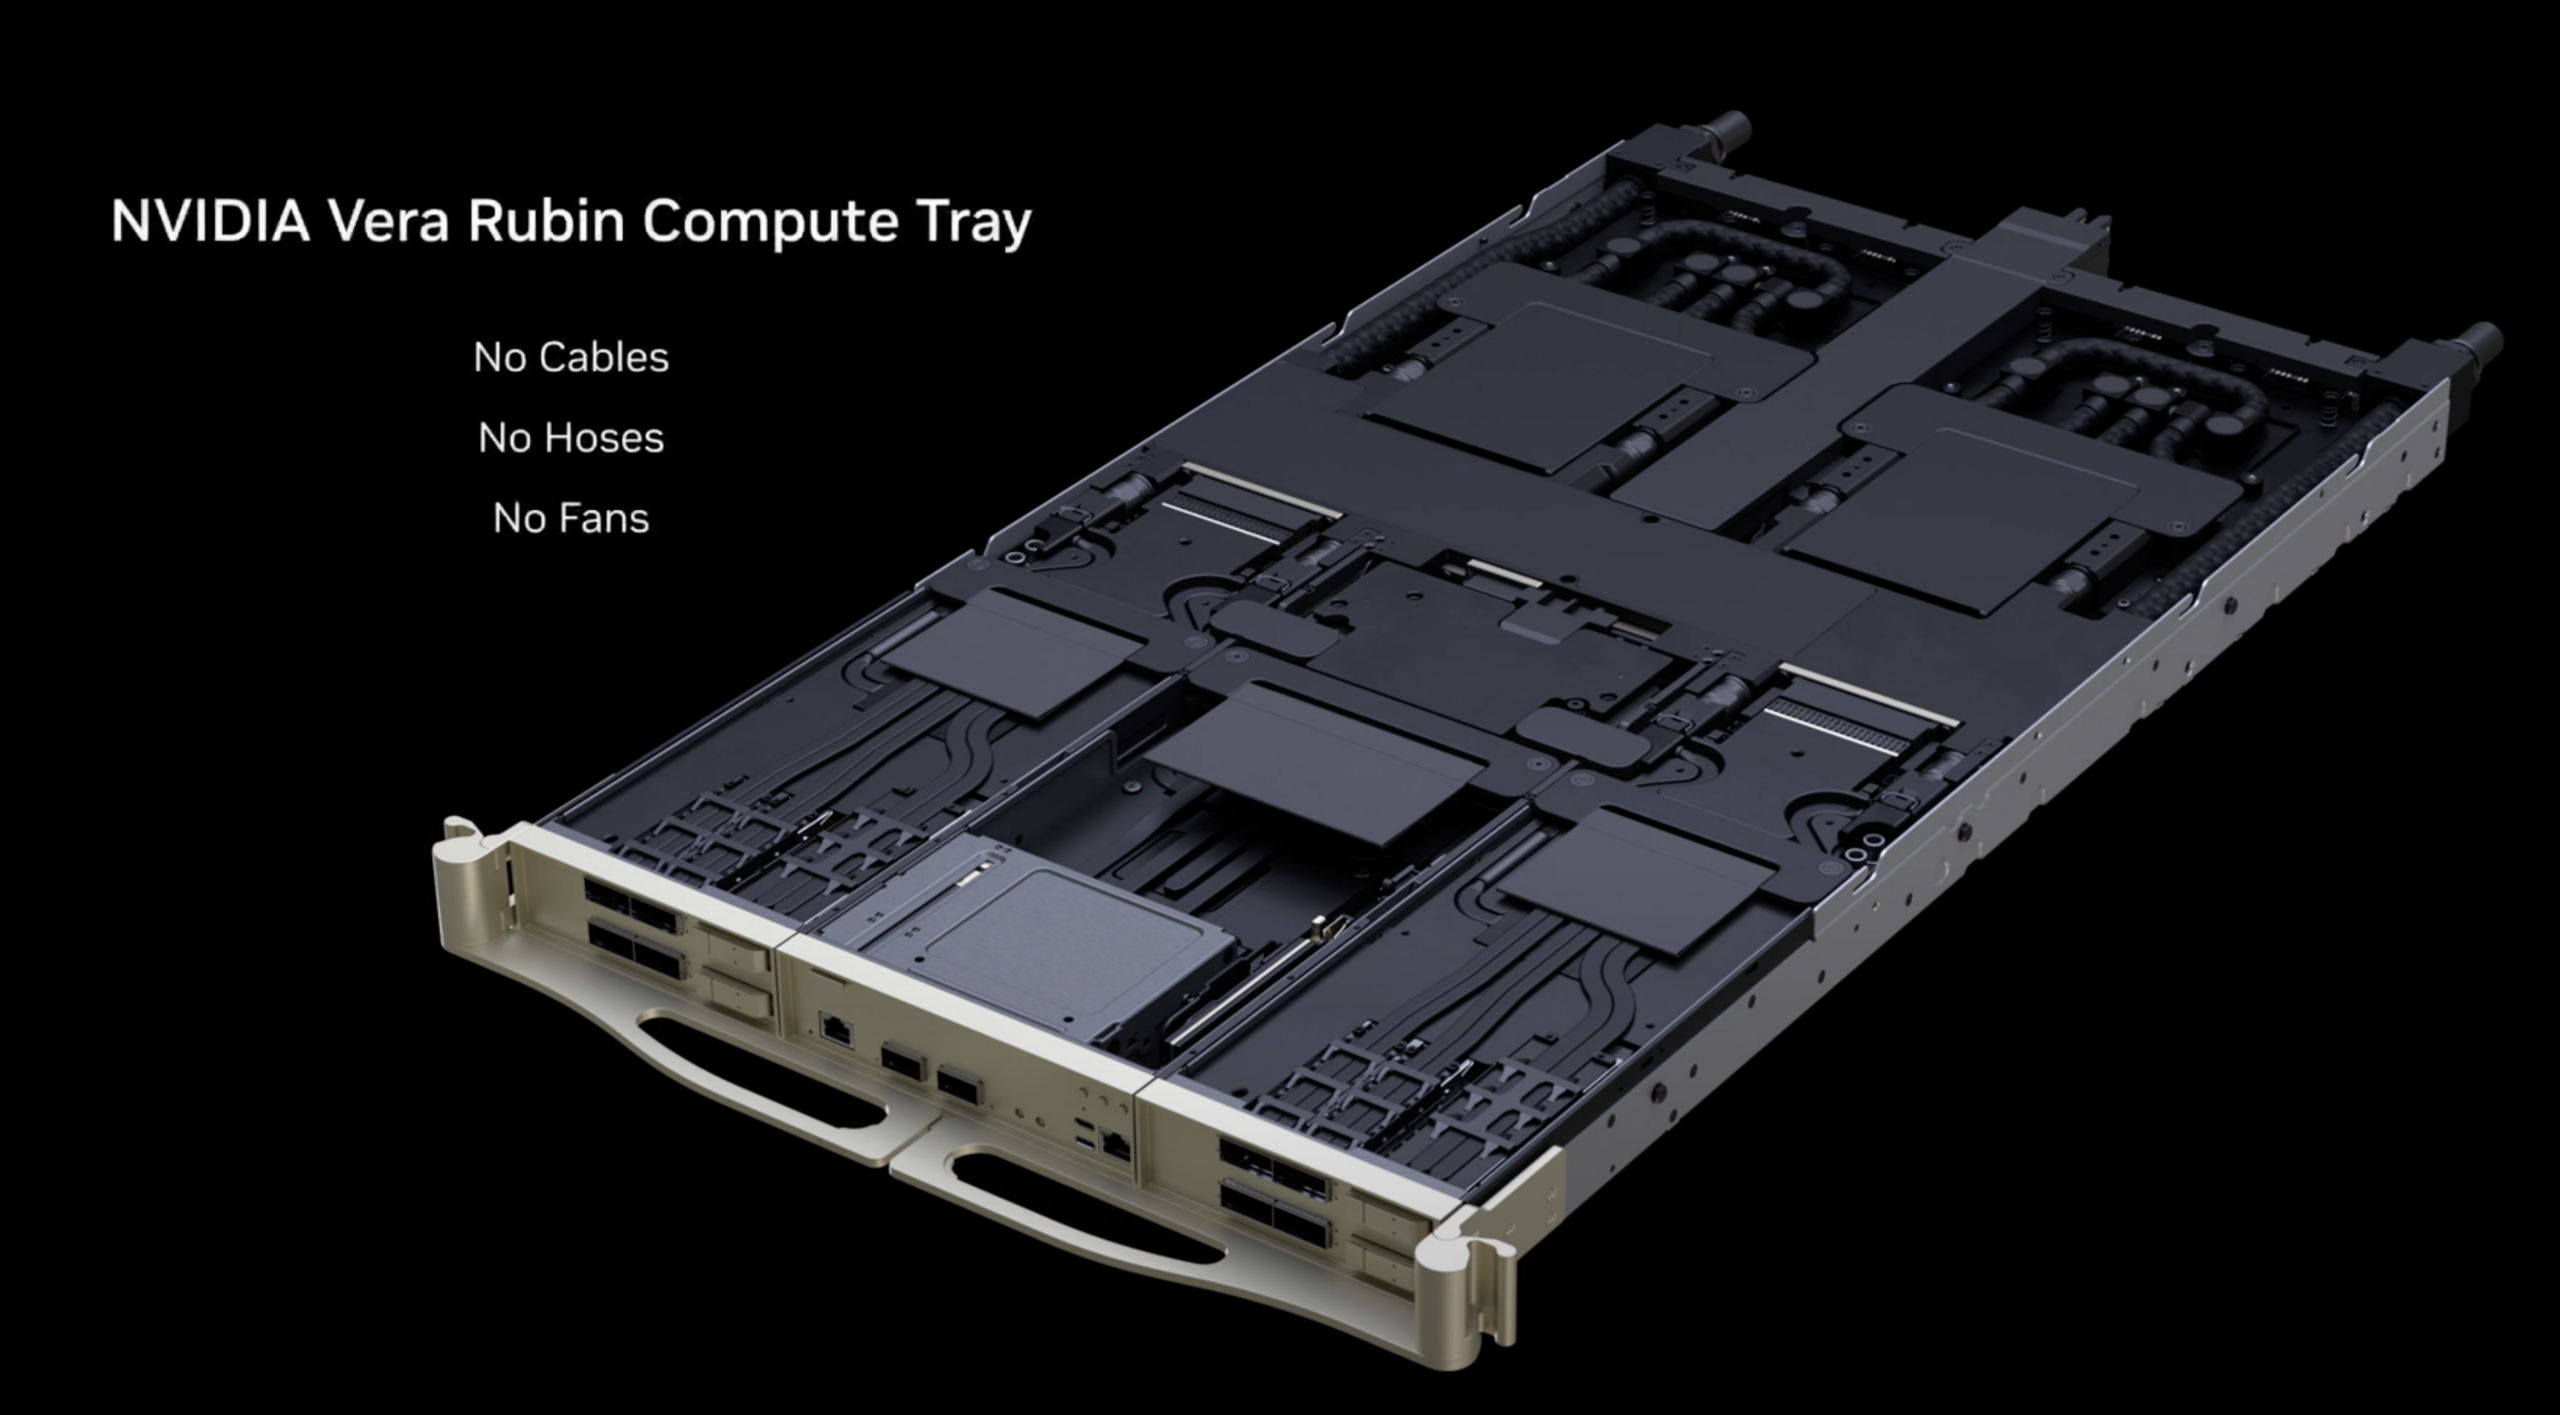
NVIDIA သည် NVFP4 စွမ်းဆောင်ရည်၏ 3.6 exaflops ဖြင့် အဆင့်သတ်မှတ်ပြီး HBM4 bandwidth ၏ 1.4 PB/s နှင့် fast memory 75 TB ဖြင့် ကျောထောက်နောက်ခံပြုထားသည်။ Supermicro ၏ အကောင်အထည်ဖော်မှုကို ဝန်ဆောင်မှုပေးနိုင်မှု၊ ယုံကြည်စိတ်ချရမှုနှင့် cluster လုပ်ငန်းဆောင်တာများကို စဉ်ဆက်မပြတ် ပံ့ပိုးပေးနိုင်ရန် ရရှိနိုင်မှုကို အလေးပေး၍ တတိယမျိုးဆက် NVIDIA MGX rack architecture ပေါ်တွင် တည်ဆောက်ထားသည်။
အအေးပေးစနစ်က ဒီဇိုင်းရဲ့ အဓိကအချက်ပါ။ Supermicro ဟာ Coolant Distribution Units (CDUs) တွေပါဝင်တဲ့ data center-scale liquid-cooling stack ကို ထည့်သွင်းထားပါတယ်။ ရည်ရွယ်ချက်ကတော့ AI workloads တွေအောက်မှာ သိပ်သည်းဆနဲ့ ခန့်မှန်းနိုင်တဲ့ စွမ်းဆောင်ရည်ကို ထိန်းသိမ်းထားနိုင်ချိန်မှာ စွမ်းအင်နဲ့ ရေအသုံးပြုမှုကို လျှော့ချပေးနိုင်တဲ့ scalable warm-water cooling ကို အသုံးပြုနိုင်စေဖို့ပါ။
ကျစ်လျစ်သိပ်သည်းသော ကွန်ပျူတာ- 2U အရည်ဖြင့်အအေးပေးထားသော NVIDIA HGX Rubin NVL8
ပိုမို modular building block ကို ရှာဖွေနေသော enterprise များနှင့် service provider များအတွက် Supermicro သည် 2U liquid-cooled NVIDIA HGX Rubin NVL8 systems ကိုလည်း မီးမောင်းထိုးပြခဲ့သည်။ ဤ 8-GPU platform သည် AI နှင့် HPC workloads များအတွက် ရည်ရွယ်ထားပြီး NVIDIA သည် NVFP4 စွမ်းဆောင်ရည်၏ 400 petaflops ကို ကိုးကားထားသည်။ ဤ platform ကို HBM4 bandwidth 176TB/s နှင့် NVLink bandwidth 28.8TB/s ဖြင့် သတ်မှတ်ထားပြီး SuperNICs မှတစ်ဆင့် NVIDIA ConnectX-9 networking 1600Gb/s ဖြင့် သတ်မှတ်ထားသည်။
Supermicro သည် ဖြန့်ကျက်မှုပြောင်းလွယ်ပြင်လွယ်ရှိမှုကို ထိန်းသိမ်းရန် ရည်ရွယ်သည့် rack-scale ဒီဇိုင်းကို ပေးဆောင်နေပြီး၊ နောက်မျိုးဆက် Intel Xeon နှင့် AMD EPYC ပရိုဆက်ဆာများ အပါအဝင် flagship x86 CPU များပါဝင်သည့် configuration option များပါရှိသည်။ ကုမ္ပဏီသည် rack integration အတွက် high-density 2U busbar ဒီဇိုင်းကိုလည်း အလေးပေးဖော်ပြခဲ့ပြီး၊ ဝန်ဆောင်မှုစွမ်းရည်ကို မထိခိုက်စေဘဲ မြင့်မားသော ရေရှည်တည်တံ့သော power envelope များကို ပံ့ပိုးပေးပါသည်။
Vera Rubin ပလက်ဖောင်းအင်္ဂါရပ်များ
Supermicro ရဲ့ platform support ဟာ cluster design နဲ့ operational planning ကို တိုက်ရိုက်သက်ရောက်မှုရှိတဲ့ Vera Rubin ခေတ်က အဓိကစွမ်းရည်တွေနဲ့ ကိုက်ညီပါတယ်-
- NVIDIA NVLink 6 သည် GPU-to-GPU နှင့် CPU-to-GPU ဆက်သွယ်မှုအတွက် bandwidth မြင့်မားပြီး latency နည်းပါးစေသည့် မြန်နှုန်းမြင့် interconnect fabric တစ်ခုဖြစ်သည်။ ၎င်းသည် ဆက်သွယ်ရေးပုံစံများသည် စွမ်းဆောင်ရည်ကို လွှမ်းမိုးနိုင်သည့် အလွန်ကြီးမားသော ကျွမ်းကျင်သူများ ရောနှောထားသော မော်ဒယ်များ၏ လေ့ကျင့်မှုနှင့် ကောက်ချက်ချမှုအတွက် အထူးသင့်လျော်ပါသည်။
- NVIDIA Vera CPU တွင် NVIDIA ဒီဇိုင်းထုတ်ထားသော Arm cores များပါဝင်ပြီး ယခင်မျိုးဆက်ထက် ၂ ဆ စွမ်းဆောင်ရည်မြှင့်တင်ပေးသည်ဟု ဆိုထားသည်။ CPU သည် 88 cores နှင့် 176 threads ပါရှိသော spatial multithreading ကို ပံ့ပိုးပေးသည့်အပြင် 1.2 TB/s LPDDR5X memory bandwidth နှင့် ပိုမိုမြင့်မားသော memory capacity တို့လည်း ပါဝင်သည်။ Vera သည် ယခင်မျိုးဆက်ထက် ၂ ဆ ပိုမိုမြင့်မားသော NVLink-C2C bandwidth ဖြင့် CPU-to-GPU coupling ကိုလည်း မြှင့်တင်ပေးပါသည်။
- NVIDIA ရဲ့ တတိယမျိုးဆက် Transformer Engine ဟာ long-context နဲ့ narrow-precision acceleration ကို ပစ်မှတ်ထားပြီး ခေတ်သစ် inference ဟာ persistent session တွေ၊ multi-agent pipelines တွေနဲ့ ပိုမိုမြင့်မားတဲ့ concurrency တွေဆီ ပြောင်းလဲလာတာနဲ့အမျှ အရေးပါလာပါတယ်။ ဒီ platform မှာ rack-scale confidential computing အဖြစ် ဖော်ပြထားတဲ့ 3rd Generation Confidential Computing လည်း ပါဝင်ပါတယ်။ ဒီ platform မှာ model တွေ၊ data တွေနဲ့ prompts တွေကို ကာကွယ်ပေးပြီး သီးခြားစီ ခွဲထုတ်ထားတဲ့ unified GPU-level trusted execution environment ပါဝင်ပါတယ်။ AI ကို ထိန်းညှိထားတဲ့ workflow တွေမှာ ဖြန့်ကျက်တဲ့ operator တွေအတွက် confidential computing နဲ့ GPU execution boundary isolation တွေဟာ platform ရွေးချယ်မှု စံနှုန်းတွေ မြင့်တက်လာပါတယ်။
- ဒုတိယမျိုးဆက် RAS အင်ဂျင်က ယုံကြည်စိတ်ချရမှု တိုးတက်မှုများကို ဖွင့်ပေးထားပြီး ၎င်းတွင် အဆင့်မြင့် ကျန်းမာရေး စောင့်ကြည့်ခြင်းနှင့် အချိန်နှင့်တပြေးညီ စစ်ဆေးခြင်းများ ပါဝင်သည်။ အရည်အအေးပေးစနစ် သိပ်သည်းသော ပတ်ဝန်းကျင်များတွင် ပြုပြင်ထိန်းသိမ်းမှု ကာလများသည် စျေးကြီးပြီး မတည်ငြိမ်မှုအတွက် လည်ပတ်မှု ခံနိုင်ရည် နည်းပါးသောကြောင့် ချို့ယွင်းချက် ရှာဖွေတွေ့ရှိခြင်းနှင့် ဝန်ဆောင်မှုပေးနိုင်ခြင်းတို့သည် မရှိမဖြစ် လိုအပ်ပါသည်။
ကွန်ရက်ချိတ်ဆက်မှု- Spectrum-X Ethernet Photonics နှင့် Rack-Scale Throughput
Supermicro သည် ၎င်း၏ Rubin platform ပံ့ပိုးမှုကို Spectrum-6 Ethernet ASIC ပေါ်တွင်တည်ဆောက်ထားသော NVIDIA ၏ Spectrum-X Ethernet Photonics နှင့်လည်း ချိတ်ဆက်ထားသည်။ NVIDIA သည် TSMC 3nm တွင် 200G SerDes co-packaged optics နှင့် fully shared buffers များဖြင့် 102.4 Tb/s switching ကို သတ်မှတ်သည်။
ဖော်ပြထားသော ရည်ရွယ်ချက်မှာ ရိုးရာ pluggable optics များနှင့် နှိုင်းယှဉ်ပါက စွမ်းဆောင်ရည်နှင့် လုပ်ငန်းလည်ပတ်မှု တည်ငြိမ်မှုကို မြှင့်တင်ရန်ဖြစ်ပြီး NVIDIA က ပါဝါထိရောက်မှု ၅ ဆ ပိုများခြင်း၊ ယုံကြည်စိတ်ချရမှု ၁၀ ဆ ပိုများခြင်းနှင့် application uptime ၅ ဆ ပိုများခြင်းတို့ကို ကိုးကားဖော်ပြထားသည်။ NVIDIA သည် liquid-cooled SN6800 (512x 800G ports ပါရှိသော 409.6 Tb/s CPO)၊ SN6810 (102.4 Tb/s CPO ပါရှိသော 128x 800G ports) နှင့် SN6600 (pluggable optics၊ 128x 800G ports၊ air-cooled သို့မဟုတ် liquid-cooled configuration များဖြင့် ရရှိနိုင်ပါသည်) အပါအဝင် switch မော်ဒယ်များစွာကို စာရင်းပြုစုထားသည်။ data center operator များအတွက်၊ ဤဒီဇိုင်းများသည် ပါဝါနှင့် အပူချိန် လက္ခဏာများ တိုးတက်ကောင်းမွန်လာသည့် high-density 800G Ethernet fabrics များကို ညွှန်ပြနေပြီး၊ front-end networking power သည် rack budget များ၏ တိုင်းတာနိုင်သော အပိုင်းတစ်ခု ဖြစ်လာသည်နှင့်အမျှ ၎င်းသည် ပိုမိုသက်ဆိုင်လာပါသည်။
AI စက်ရုံများအတွက် သိုလှောင်မှုပေါင်းစည်းမှု
သိုလှောင်မှုဘက်တွင် Supermicro သည် ၎င်း၏ petascale all-flash storage server နှင့် JBOF စနစ်များတွင် တည်ဆောက်ထားသော ဖြည့်စွက်ဖြေရှင်းချက်များကို မီးမောင်းထိုးပြခဲ့သည်။ ဤပလက်ဖောင်းများသည် NVIDIA BlueField-4 DPU များနှင့် ဒေတာစီမံခန့်ခွဲမှုဖြေရှင်းချက်အမျိုးမျိုးကို ပံ့ပိုးပေးပြီး သိုလှောင်မှုနှင့် ကွန်ရက်ချိတ်ဆက်မှုကို compute layer မှအသုံးပြုသည့် rack-scale၊ အရှိန်မြှင့်ထားသော ဗိသုကာနှင့် ချိန်ညှိပေးသည်။
Supermicro သည် ဤကြေငြာချက်တွင် storage platform များအတွက် စွမ်းဆောင်ရည်ကိန်းဂဏန်းများကို မပေးထားသော်လည်း၊ ပေါင်းစပ်မှုကို အလေးပေးခြင်းသည် AI factory ဖြန့်ကျက်မှုများအတွက် compute၊ network နှင့် storage တို့ကို ပေါင်းစပ်အရည်အချင်းပြည့်မီစေသည့် validated full-stack ဒီဇိုင်းများဆီသို့ ဆက်လက်ရွေ့လျားနေကြောင်း ညွှန်ပြနေသည်။
ထုတ်လုပ်မှုစကေးနှင့် အွန်လိုင်းသို့ရောက်ရှိချိန်
ကြေငြာချက်ရဲ့ လုပ်ငန်းလည်ပတ်မှုဆိုင်ရာ အဓိကအကြောင်းအရာကတော့ ထုတ်လုပ်မှု throughput နဲ့ ဖြန့်ကျက်မှုအလျင်ပဲဖြစ်ပါတယ်။ Supermicro ရဲ့ တိုးချဲ့ထားတဲ့ စက်ရုံတွေနဲ့ အရည်အအေးပေးစနစ်တွေကို အရည်အအေးပေးစနစ်အပြည့်ပါဝင်တဲ့ Vera Rubin နဲ့ Rubin ပလက်ဖောင်းတွေရဲ့ ထုတ်လုပ်မှုနဲ့ ပေးပို့မှုကို ချောမွေ့စေဖို့ ဒီဇိုင်းထုတ်ထားပါတယ်။ တစ်ချိန်တည်းမှာပဲ၊ modular DCBBS ဗိသုကာလက်ရာက မြန်ဆန်တဲ့ configuration၊ validation နဲ့ scaling တွေကို လုပ်ဆောင်နိုင်စေပါတယ်။ Enterprise နည်းပညာဆိုင်ရာ ဝယ်ယူသူတွေအတွက်၊ ခွဲခြားသတ်မှတ်ရမယ့်အချက်က single chassis specification ထက် ခန့်မှန်းနိုင်တဲ့ delivery၊ repeatable rack builds နဲ့ စက်ပစ္စည်းလက်ခံရရှိမှုကနေ တည်ငြိမ်တဲ့ production service အထိ အချိန်လျှော့ချနိုင်မှုပဲ ဖြစ်ပါတယ်။
Supermicro က အရည်အအေးပေးခြင်းသည် ထိပ်တန်း AI သိပ်သည်းဆအတွက် မူရင်းဖြစ်လာသည်နှင့်အမျှ rack-scale ထုတ်လုပ်မှုနှင့် အတည်ပြုခြင်းကို စက်မှုလုပ်ငန်းအဖြစ် ပြောင်းလဲနိုင်သော ရောင်းချသူများသည် တိုးချဲ့ထားသော ပေါင်းစပ်မှုစက်ဝန်းများမပါဘဲ ကြီးမားသော rollout များကို ပံ့ပိုးရန် အကောင်းဆုံးအနေအထားတွင် ရှိနေလိမ့်မည်ဟု အလောင်းအစားပြုလုပ်ထားသည်။


 အမေဇုံ