

Supermicro သည် IBM နှင့် NVIDIA တို့နှင့်အတူ KV cache storage solution တစ်ခုကို ယနေ့ကြေညာခဲ့ပြီး ၎င်းသည် GPU မှ long-context inference နောက်ကွယ်ရှိ key-value state ကို shared all-flash tier သို့ ရွှေ့ပြောင်းပေးသည်။ ၎င်း package တွင် AMD EPYC 9005 processors၊ IBM Storage Scale၊ NVIDIA Dynamo နှင့် NVIDIA Spectrum-X Ethernet ပေါ်ရှိ Supermicro Petascale storage server များကို ပေါင်းစပ်ထားပြီး ကုမ္ပဏီများသည် IBM Redbook အဖြစ်ထုတ်ဝေခဲ့သော validated reference architecture ဖြင့် ကျောထောက်နောက်ခံပြုထားသည်။ အဓိကကိန်းဂဏန်းမှာ context ကို scratch မှပြန်လည်တွက်ချက်သည့် GPU နှင့် နှိုင်းယှဉ်လျှင် 130,000-token prompts များတွင် first token ရရှိရန် အချိန် ၅၆ ဆ လျော့နည်းသွားခြင်း ဖြစ်သည်။
KV Cache မှာ Storage Tier လိုအပ်ရတဲ့ အကြောင်းရင်းကဘာလဲ
Inference သည် အဆင့်နှစ်ဆင့်ဖြင့် လုပ်ဆောင်သည်- prefill သည် prompt ကို tokens များအဖြစ်သို့ ပြောင်းလဲပြီး model မှတစ်ဆင့် တွန်းပို့ကာ intermediate key-value state များကို ထုတ်လုပ်ပေးပြီး decode သည် ထို state များနှင့် ဆန့်ကျင်ဘက် response ကို တစ်ကြိမ်လျှင် token တစ်ခုစီ ထုတ်ပေးသည်။ KV state ကို persistent cache တွင် သိမ်းဆည်းထားခြင်းဖြင့် system သည် ၎င်းကို နောက် turn၊ နောက် agent step သို့မဟုတ် တူညီသော context ကို မျှဝေသော နောက် request အတွက် ပြန်လည်အသုံးပြုနိုင်ပြီး recompute ကို ကျော်သွားနိုင်သည်။
Agentic workflows၊ coding assistants၊ long-context RAG နှင့် multi-turn applications များသည် GPU နှင့် CPU memory ကို လျင်မြန်စွာ overflow လုပ်ရန် ဤအခြေအနေကို လုံလောက်စွာထုတ်ပေးသည်၊ ထို့ကြောင့် Supermicro၊ IBM နှင့် NVIDIA တို့သည် network storage tier တစ်ခုကို ဖန်တီးနေကြသည်။
ဒီဒီဇိုင်းမှာ NVIDIA Dynamo က cache hierarchy ကို စီမံခန့်ခွဲပြီး NIXL ပေါ်မှာ block တွေကို ရွှေ့ပေးပါတယ်။ IBM Storage Scale Erasure Code Edition က shared file tier ကို ပံ့ပိုးပေးပြီး Petascale server တွေက flash နဲ့ နောက်ကွယ်က PCIe Gen5 lanes တွေကို ထောက်ပံ့ပေးပါတယ်။ Supermicro က ကုမ္ပဏီသုံးခုဟာ cluster level မှာ high concurrency နဲ့ noisy-neighbor network traffic အောက်မှာ stack ကို စမ်းသပ်ခဲ့ပြီး factory rack integration နဲ့ on-site deployment ပါဝင်တဲ့ turnkey build အနေနဲ့ ရလဒ်ကို မိတ်ဆက်ခဲ့ပြီး deployment အချိန်ကို ရက်သတ္တပတ်ကနေ ရက်အနည်းငယ်အထိ လျှော့ချပေးတယ်လို့ ဆိုပါတယ်။
စမ်းသပ်ထားသော ဖွဲ့စည်းပုံ
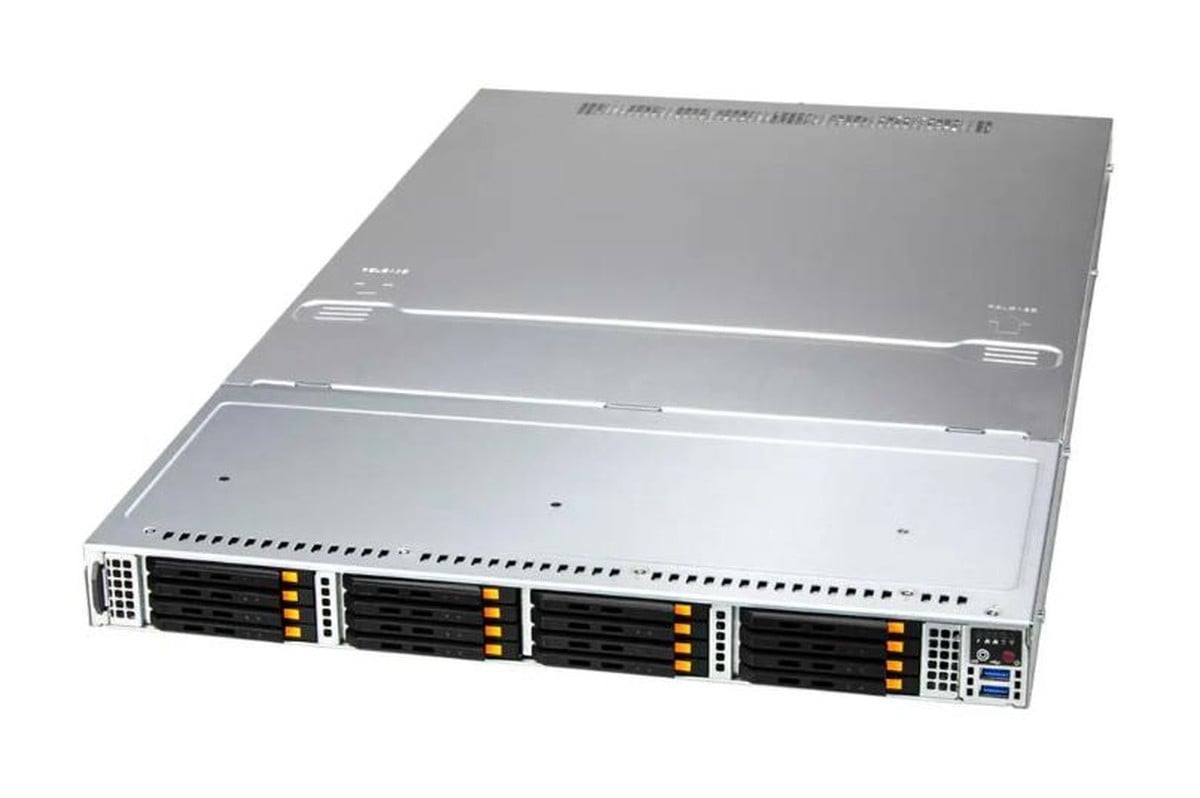
reference architecture မှာ Supermicro ASG-1115S-NE316R Petascale node ရှစ်ခုကို အသုံးပြုထားပြီး၊ တစ်ခုချင်းစီမှာ AMD EPYC 9535 တစ်ခုနဲ့ 16 Micron 7.68TB E3.S NVMe drive တွေပါဝင်တဲ့ 1U system တစ်ခုဖြစ်ပြီး node တစ်ခုစီမှာ raw flash 122.88TB နဲ့ ရှစ်ခုစလုံးမှာ 983TB လောက် သိမ်းဆည်းထားပါတယ်။ node တစ်ခုစီမှာ client ဘက်ခြမ်းမှာ dual-port 200Gb NVIDIA BlueField-3 B3220 တစ်ခုနဲ့ storage backend အတွက် 400Gb ConnectX-7 တစ်ခု ပါဝင်ပြီး spine and leaf layout မှာ Spectrum-X SN5600 switch သုံးခုနဲ့ 800Gb/s uplink တွေ ပါဝင်ပါတယ်။
storage node များသည် RHEL 9.6 နှင့် IBM Storage Scale ECE 6.0.0.1 ကို 8+2P erasure code layout ဖြင့် လုပ်ဆောင်ပြီး IBM သည် ဤ eight-node tier ၏ read throughput ကို အစောပိုင်းစမ်းသပ်မှုမှ 315GB/s တွင် ထားရှိသည်။
| component | KV Cache Reference Architecture (စမ်းသပ်ပြီး) |
|---|---|
| သိုလှောင်မှုအဆင့် | |
| သိုလှောင်မှု node များ | ၈x Supermicro ASG-1115S-NE316R (1U၊ ပလပ်ပေါက်တစ်ခုတည်း) |
| node တစ်ခုလျှင် CPU | AMD EPYC 9535၊ PCIe Gen5 ၏ ၁၂၈ လမ်းကြောင်း (NVMe မှ ၆၄၊ ကွန်ရက်ချိတ်ဆက်မှုမှ ၆၄) |
| node တစ်ခုလျှင် flash | 16x Micron 7.68TB E3.S NVMe (122.88TB ကုန်ကြမ်း) |
| node တစ်ခုလျှင် ကွန်ရက် | NVIDIA BlueField-3 B3220၊ dual-port 200Gb (client ဘက်ခြမ်း) NVIDIA ConnectX-7 400Gb (သိုလှောင်မှု backend) |
| switching | NVIDIA Spectrum-X SN5600 ၃ ခု၊ ကျောရိုးနှင့် အရွက်၊ 800Gb/s uplink များ |
| သိုလှောင်မှုဆော့ဖ်ဝဲ | IBM Storage Scale Erasure Code Edition 6.0.0.1, 8+2P ရထား ၈.၃ |
| ကောက်ချက်ချခြင်း ဖောက်သည် | |
| စံနစ် | Supermicro SYS-212GB-FNR (NVIDIA MGX)၊ Ubuntu 24.04 |
| benchmark တွေအတွက် GPU ကိုသုံးထားပါတယ် | NVIDIA RTX PRO 6000 Blackwell ၁ ခု၊ အလေးချိန်နှင့် CUDA ဂရပ်များပြီးနောက် KV cache အတွက် 19.6GiB ကျန်ရှိသည် |
| ဖောက်သည်ကွန်ရက်ချိတ်ဆက်မှု | ၂x NVIDIA BlueField-3 B3140H 400Gb/s၊ client-facing bandwidth 80GB/s အထိ |
| မော်ဒယ်နှင့် ဆော့ဖ်ဝဲ | openai/gpt-oss-120b (MXFP4) vLLM ၀.၁၄.၁ NVIDIA Dynamo 0.9.0 ပါဝင်သော NIXL NVIDIA AIPerf စံနှုန်း client |
| ကက်ရှ် အဆင့်သတ်မှတ်ခြင်း | Host နှင့် local tiers များကို သုညသို့ သတ်မှတ်ထားပြီး Storage Scale tier မှ cache လုပ်ထားသော token ၁.၄ သန်းလုံးကို ဝန်ဆောင်မှုပေးပါသည်။ |
benchmark client သည် Supermicro SYS-212GB-FNR MGX စနစ်တစ်ခုတည်းဖြစ်ပြီး ရလဒ်များသည် MXFP4 ရှိ vLLM 0.14.1 နှင့် Dynamo 0.9.0 အောက်ရှိ openai/gpt-oss-120b မော်ဒယ်ကို run သည့် NVIDIA RTX PRO 6000 Blackwell GPU တစ်ခုတည်းမှ ထွက်ပေါ်လာသည်။
အလေးချိန်များနှင့် CUDA ဂရပ်များပြီးနောက်၊ GPU မှတ်ဉာဏ် 19.6GiB ကို KV cache အတွက် ချန်ထားခဲ့ပြီး GPU တွင် တိုကင် ၁.၁၄ သန်းခန့်အတွက် လုံလောက်ပါသည်။ စမ်းသပ်မှုများအတွက်၊ cached block တိုင်းသည် Storage Scale မှ ပြန်လည်ရောက်ရှိလာစေရန် host မှတ်ဉာဏ်နှင့် local tiers များကို သုညသို့ သတ်မှတ်ထားသောကြောင့် ရလဒ်များသည် ရောနှောထားသော အဆင့်ဆင့်၏ အကူအညီမပါဘဲ storage path ကို ၎င်းတို့ကိုယ်တိုင် တိုင်းတာပါသည်။
ပထမဆုံးတိုကင်အထိ ၅၆ ဆ၊ Throughput တွင် ၂၂ ဆ
cache မပါဝင်သောကြောင့် 120B မော်ဒယ်အတွက် ပထမဆုံး token သို့ရောက်ရှိရန်အချိန်သည် 10,000 input tokens တွင် 0.572 စက္ကန့်မှ 130,000 တွင် 32.14 စက္ကန့်အထိ မြင့်တက်လာခဲ့သည်။ Storage Scale တွင် KV cache ကို အသုံးပြုခြင်းဖြင့် TTFT သည် တူညီသောအကွာအဝေးတွင် 0.193 မှ 0.57 စက္ကန့်အကြားတွင် ရှိနေခဲ့ပြီး ၎င်းသည် 130,000-token အမှတ်အသားနှင့် Supermicro ၏ ကြေငြာချက်တွင် ကိုးကားထားသော 0.377 စက္ကန့် spread တွင် 56x ကိန်းဂဏန်းဖြစ်သည်။ IBM၊ Supermicro နှင့် NVIDIA တို့သည် ဤစမ်းသပ်မှုများကို လုပ်ဆောင်ခဲ့ပြီး ကျွန်ုပ်တို့သည် ရလဒ်များကို မလုပ်ဆောင်ခဲ့ သို့မဟုတ် audit မလုပ်ခဲ့ပါ။
throughput စမ်းသပ်မှုသည် တစ်ပြိုင်နက်တည်းချိတ်ဆက်မှု ၂၈ ခုမှတစ်ဆင့် request ၂၀၀ ကိုပေးပို့ခဲ့ပြီး၊ token ၂၄ သန်းနှင့် KV cache data ၈၂၅GB စုစုပေါင်းထူးခြားသော prompts ၁၀၀ မှရယူခဲ့ပြီး cache သည် ဗလာစတင်ခဲ့သည်။ ပြန်လည်တွက်ချက်မှုအခြေခံသည် ၁၀၄၈ စက္ကန့်အတွင်း တစ်စက္ကန့်လျှင် request ၀.၁၉ ဖြင့်ပြီးဆုံးခဲ့ပြီး Storage Scale အဆင့်သည် ၄၆.၉၄ စက္ကန့်အတွင်း တစ်စက္ကန့်လျှင် request ၄.၂၆ ဖြင့်ပြီးဆုံးခဲ့ပြီး cache ကိုဖြည့်ခြင်း၏ cold-start cost အပါအဝင် ၂၂ ဆ gain ဖြစ်သည်။
တတိယအကြိမ်လုပ်ဆောင်မှုတွင် တူညီသော fabric တစ်လျှောက်တွင် မသက်ဆိုင်သော network traffic 200GB/s ကို တွန်းပို့သည့် client လေးခုကို ထပ်မံထည့်သွင်းခဲ့ပြီး cached configuration သည် တစ်စက္ကန့်လျှင် request ၃.၆ ခုနှင့် request ၂၀၀ အတွက် ၅၅.၅၆ စက္ကန့် ထိန်းသိမ်းထားနိုင်ပြီး clean run ထက် ကိုးစက္ကန့်ခန့် နှေးကွေးပြီး baseline ထက် ၁၈ ဆ လျော့နည်းနေဆဲဖြစ်သည်။ IBM သည် cache traffic ကို background load မှ ခွဲထုတ်ထားသော Spectrum-X fabric ကြောင့် ပြစ်ဒဏ်အနည်းငယ်သာ ရှိသည်ဟု ယူဆသည်။
“Agentic AI နှင့် long-context application များသည် context ကို အဆင့်များစွာတွင် ထိရောက်စွာ ပြန်လည်အသုံးပြုခြင်းအပေါ် မူတည်ပြီး NVIDIA Dynamo သည် distributed inference ကို စီစဉ်ပေးရန် ကူညီပေးသောကြောင့် enterprise များသည် GPU တိုင်းမှ အသုံးပြုနိုင်သော throughput ပိုမိုရရှိနိုင်ပါသည်” ဟု NVIDIA AI Inference Product Lead ဖြစ်သူ Shruti Koparkar က ပြောကြားခဲ့သည်။ “NVIDIA Dynamo နှင့် Spectrum-X Ethernet တို့ကို Supermicro Petascale storage server များနှင့် IBM Storage Scale တို့နှင့် တွဲဖက်အသုံးပြုခြင်းဖြင့် ဤ KV cache solution သည် redundant computation ကို လျှော့ချပေးနိုင်ခြင်း၊ time-to-first-token ကို တိုးတက်ကောင်းမွန်စေပြီး ဖောက်သည်များအား ခံနိုင်ရည်ရှိသော AI inference ဝန်ဆောင်မှုများကို တိုးချဲ့နိုင်ရန် ကူညီပေးနိုင်သည့် high-performance shared storage tier တစ်ခုကို ဖန်တီးပေးပါသည်။”
အရွယ်အစားနှင့် ဂဏန်းများတွင် မပါဝင်သည်များ
IBM ရဲ့ အရွယ်အစားလမ်းညွှန်မှာ node လေးခုပါတဲ့ build ကို 4+2P မှာထားပြီး 7B မှ 34B မော်ဒယ်တွေအတွက် အသုံးပြုနိုင်တဲ့စွမ်းရည် ၆၇ ရာခိုင်နှုန်းနဲ့ GPU ၆၄ ခုအထိ၊ စမ်းသပ်ထားတဲ့ ရှစ်ခုပါတဲ့ build ကို 8+2P မှာထားပြီး 70B မှ 120B မော်ဒယ်တွေအတွက် ၈၀ ရာခိုင်နှုန်းနဲ့ GPU ၁၀၀ မှ ၂၅၆ ခုအတွက် read bandwidth ၁၀၀ မှ ၃၀၀GB/s လိုအပ်ပြီး node ၁၆ ခု သို့မဟုတ် ထို့ထက်ပိုတဲ့ node ၁၆ ခုကို 16+3P မှာထားပြီး ပိုကြီးတဲ့ မော်ဒယ်တွေနဲ့ GPU ၃၀၀ သို့မဟုတ် ထို့ထက်ပိုတဲ့ GPU ၃၀၀ အတွက် ၈၄ ရာခိုင်နှုန်းနဲ့ 300GB/s နဲ့အထက် အသုံးပြုနိုင်ပါတယ်။ Storage Scale ECE ကိုယ်တိုင်က storage server သုံးခုကနေ ၂၅၆ ခုအထိ တိုးချဲ့နိုင်ပါတယ်။
GPU တစ်ခုတည်းနဲ့ စမ်းသပ်တဲ့ စနစ်က အဓိက သတိပေးချက်ပါ။ reference architecture က GPU ရာပေါင်းများစွာအတွက် အရွယ်အစားသတ်မှတ်ထားပေမယ့် စာတမ်းထဲက ရလဒ်တိုင်းဟာ RTX PRO 6000 တစ်ခုတည်းကနေ လာတာဖြစ်ပြီး IBM က 315GB/s နှုန်းနဲ့ အဆင့်သတ်မှတ်ထားတဲ့ ရှစ်ခုပါ 983TB flash tier နဲ့ ယှဉ်ရင် ထွက်လာတာပါ။ ဒါကြောင့် storage ဘက်ခြမ်းက saturation နဲ့ လုံးဝမနီးစပ်ပါဘူး။ ပြီးတော့ GPU cluster တစ်ခုလုံးက cache ကို တစ်ပြိုင်နက်တည်း ဆွဲယူနေချိန်မှာ TTFT က ဘယ်လိုခံနိုင်ရည်ရှိလဲဆိုတာ စမ်းသပ်မှုတွေက မပြသပါဘူး။
Supermicro သည် packaged solution အတွက် ဈေးနှုန်း သို့မဟုတ် ရရှိနိုင်မည့်ရက်စွဲကို ထုတ်ပြန်ခြင်းမရှိသေးဘဲ ကြေငြာချက်တွင် GPU အသုံးပြုမှုကိန်းဂဏန်းများကို မဖော်ပြထားပါ။ ဤချဉ်းကပ်မှုသည် AI400X3M ရှိ DDN ၏ Dynamo-integrated KV cache acceleration နှင့် တူညီသောနယ်ပယ်တွင် တည်ရှိပြီး ဤ stack သည် IBM ၏ file system အောက်ရှိ commodity Supermicro server များနှင့် Ethernet ပေါ်တွင် လည်ပတ်ခြင်းမှာ ကွာခြားချက်ဖြစ်သည်။
“AI workloads များသည် လေ့ကျင့်မှုမှ inference အထိ တိုးချဲ့လာသည်နှင့်အမျှ၊ agentic AI နှင့် long-context၊ multi-turn generative AI ၏ ဝိသေသလက္ခဏာဖြစ်သော high-throughput inference workloads များကို ဖြန့်ကျက်နေသော enterprise များနှင့် neocloud များသည် GPU စွမ်းဆောင်ရည်ကို မြှင့်တင်ရန်အတွက် bottleneck များကို ဖယ်ရှားရန် လိုအပ်ပါသည်” ဟု Supermicro ၏ ဥက္ကဋ္ဌနှင့် CEO ဖြစ်သူ Charles Liang က ပြောကြားခဲ့သည်။ “IBM နှင့် NVIDIA ပါဝင်သော ကျွန်ုပ်တို့၏ ဖြေရှင်းချက်သည် ဤစွမ်းဆောင်ရည် အကျိုးကျေးဇူးများကို ရှင်းရှင်းလင်းလင်း ပြသနေပါသည်။”



 အမေဇုံ