

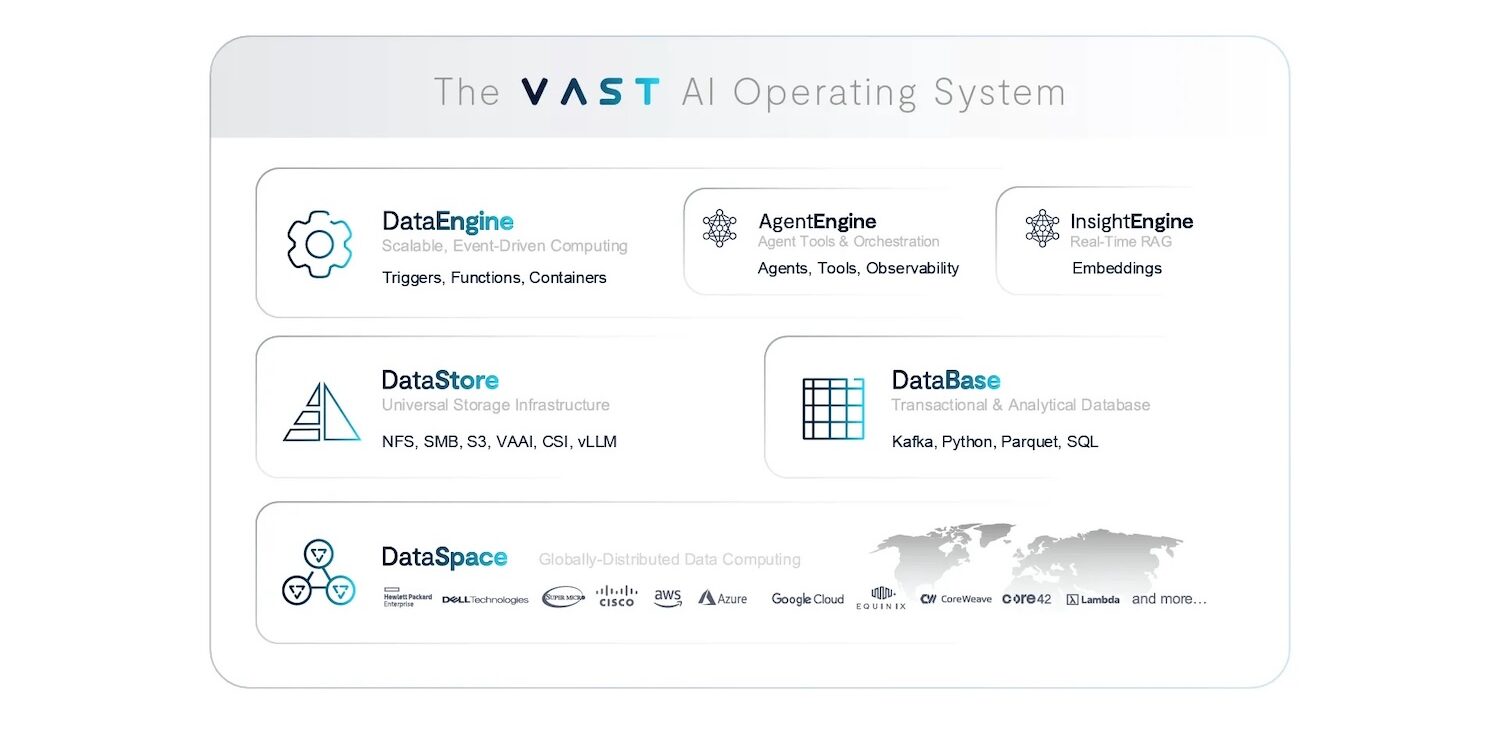
VAST Data သည် NVIDIA Inference Context Memory Storage Platform ကို ပံ့ပိုးပေးသည့် inference architecture အသစ်တစ်ခုကို စတင်လိုက်ပါပြီ။ ဤစနစ်သည် ဆက်လက်လုပ်ဆောင်နေသော၊ multi-turn agent-driven session များပါဝင်သည့် AI application များကို အာရုံစိုက်သည်။ VAST သည် ဤ platform ကို AI အတွက် ဒီဇိုင်းထုတ်ထားသော storage class အဖြစ် တင်ပြထားပြီး key-value (KV) cache ကို ဝင်ရောက်ခွင့် မြှင့်တင်ပေးခြင်း၊ node များအကြား inference context ကို မြန်ဆန်စွာ မျှဝေနိုင်ခြင်းနှင့် ပါဝါထိရောက်မှုကို မြှင့်တင်ပေးခြင်းတို့ကို ပြုလုပ်ပေးသည်။ ဒီဇိုင်းတွင် NVIDIA BlueField-4 DPU များနှင့် Spectrum-X Ethernet networking ကိုအသုံးပြုထားပြီး VAST AI Operating System (AI OS) သည် ဤ shared infrastructure resource ကို ထိရောက်စွာ စီမံခန့်ခွဲရန် လိုအပ်သော software ကို ပံ့ပိုးပေးသည်။
KV Cache ရဲ့ အရေးပါမှုအကြောင်း ပိုမိုသိရှိလိုပါက Pliops ဖြင့် ကျွန်ုပ်တို့ အပြီးသတ်ခဲ့သော ဤနက်ရှိုင်းသော လေ့လာမှုကို ကြည့်ရှုပါ ။
ဤကြေငြာချက်သည် လက်တွေ့ကမ္ဘာအပလီကေးရှင်းများတွင် inference စွမ်းဆောင်ရည်ကို ကန့်သတ်သည့်အချက်များတွင် ပြောင်းလဲမှုတစ်ခုကို အချက်ပြသည်။ inference သည် ရိုးရှင်းသော prompts မှ agent များနှင့် user အများအပြားတွင် continuing reasoning သို့ ပြောင်းလဲလာသည်နှင့်အမျှ၊ context သည် GPU server တစ်ခုတည်းအတွင်းတွင် ရှိနေသည်ဟူသော အယူအဆသည် ခေတ်မမီတော့ပါ။ ဤအခြေအနေများတွင်၊ အလုံးစုံစွမ်းဆောင်ရည်သည် လက်ရှိလည်ပတ်မှုများအတွင်း inference history ကို မည်မျှကောင်းမွန်စွာ သိမ်းဆည်းသည်၊ ပြန်လည်ရယူသည်၊ ပြန်လည်အသုံးပြုသည်၊ တိုးချဲ့သည်နှင့် မျှဝေသည်ပေါ်တွင် ပိုမိုမူတည်သည်။ KV cache သည် internal optimization မှ primary data path သို့ ပြောင်းလဲလာပြီး time-to-first-token (TTFT)၊ GPU အသုံးပြုမှုနှင့် cluster ထိရောက်မှုကို ထိခိုက်စေပါသည်။
DPU များပတ်လည်ရှိ Inference Data Path ကို ပြန်လည်တည်ဆောက်ခြင်း
VAST ရဲ့ ဗျူဟာကတော့ VAST AI OS software ကို NVIDIA BlueField-4 DPU တွေမှာ တိုက်ရိုက် run ဖို့ပါ။ storage နဲ့ context service တွေကို ပုံမှန် client-server model ကနေတစ်ဆင့် ဝင်ရောက်ကြည့်ရှုတဲ့ external components တွေအဖြစ် မမြင်ဘဲ၊ ဒီ architecture က ဒီ data service တွေကို GPU server ထဲကို တိုက်ရိုက် ပေါင်းစပ်ပေးပြီး inference ဖြစ်ပေါ်ကာ dedicated data node configuration တွေကိုလည်း support လုပ်ပါတယ်။ ဒီချဉ်းကပ်မှုက bottleneck တွေကို လျှော့ချဖို့နဲ့ မလိုအပ်တဲ့ copy တွေနဲ့ delay တွေကို ဖယ်ရှားဖို့ ရည်ရွယ်ပါတယ်။
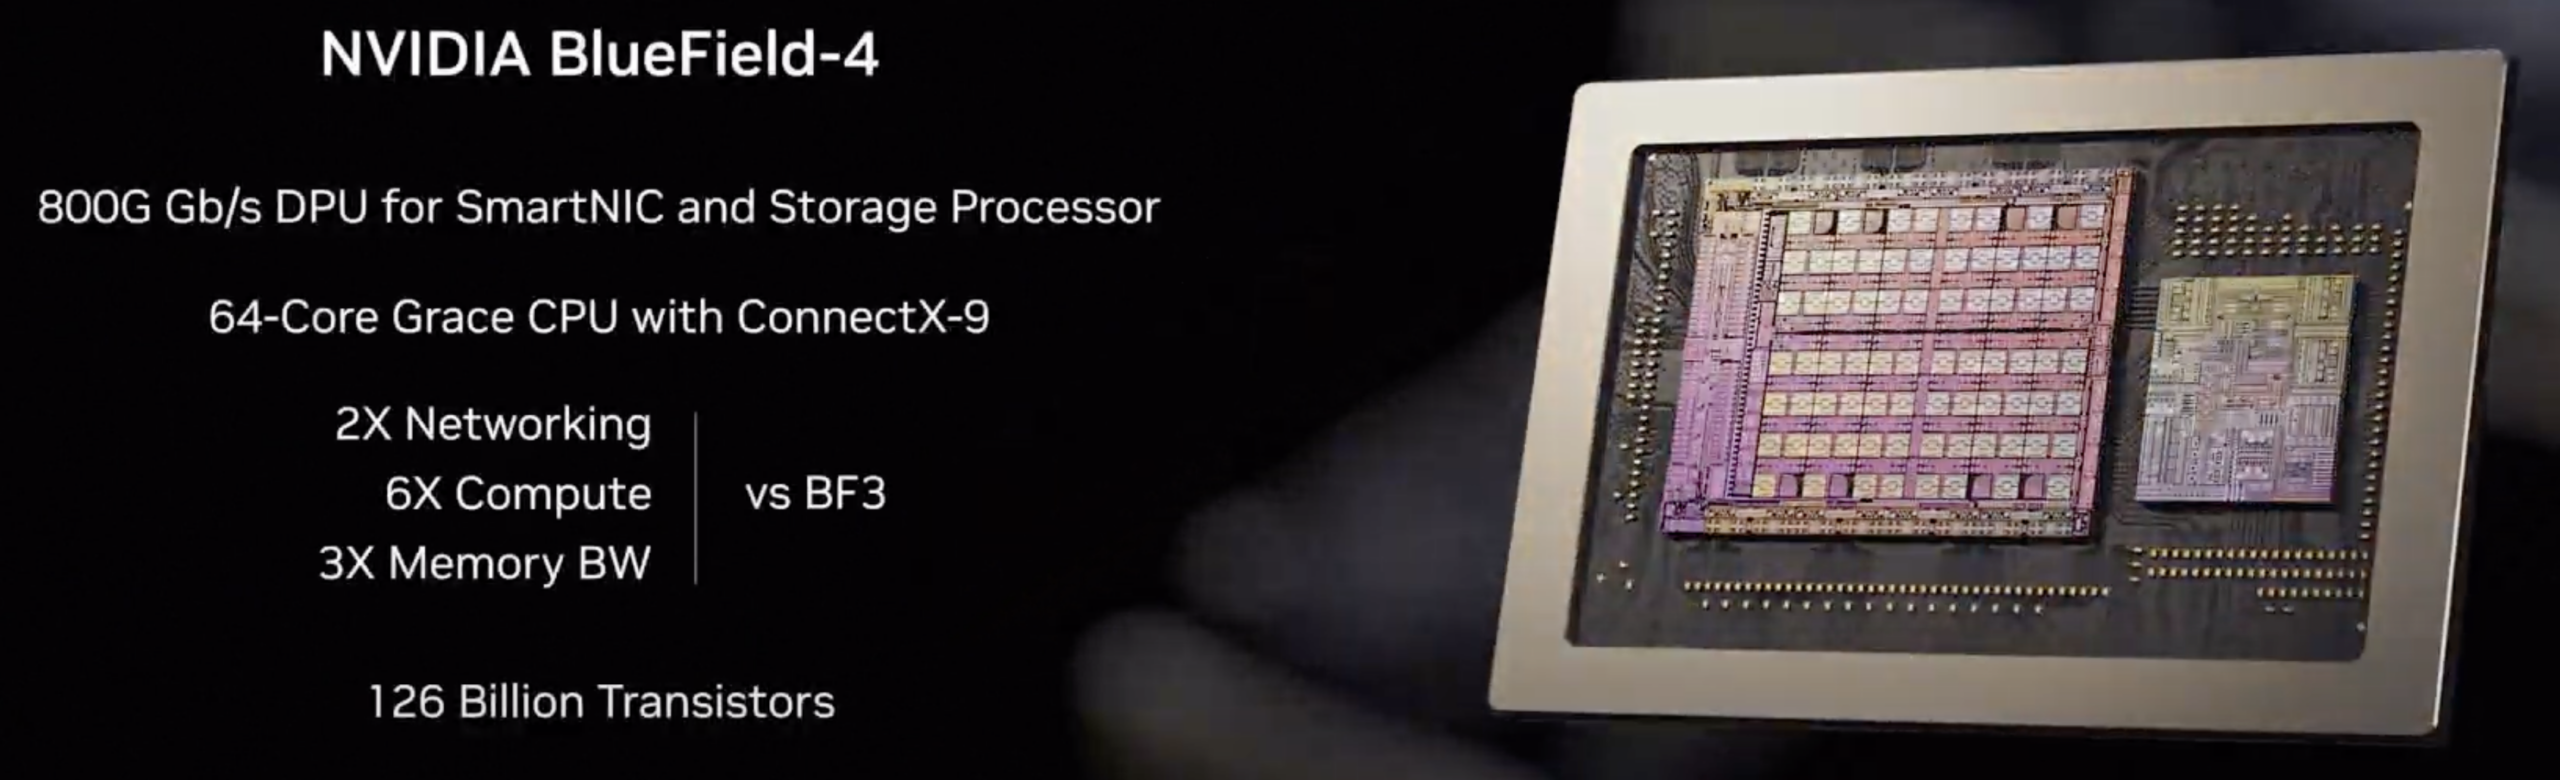
ဤ DPU-native ဒီဇိုင်းသည် ကြီးမားသော inference စနစ်များ၏ လက်တွေ့လိုအပ်ချက်များကို ရှင်းလင်းစွာ ကိုင်တွယ်ဖြေရှင်းပေးပါသည်။ session ရာပေါင်းများစွာ သို့မဟုတ် ထောင်ပေါင်းများစွာ တစ်ပြိုင်နက်တည်း လည်ပတ်နေသည့်အခါ KV cache ကို စီမံခန့်ခွဲခြင်းသည် စဉ်ဆက်မပြတ် input/output (I/O) အလုပ်အဖြစ်သို့ ပြောင်းလဲသွားပါသည်။ စနစ်သည် session များကို ဆက်လက်လည်ပတ်နေစေရန်၊ ရေရှည်အသုံးပြုရန်အတွက် သိမ်းဆည်းရန်နှင့် အခြေခံအဆောက်အအုံသည် လုပ်ငန်းစဉ်များကို နှေးကွေးသောလမ်းကြောင်းများမှတစ်ဆင့် လမ်းကြောင်းပြောင်းပေးသည့်အခါ သို့မဟုတ် ကျယ်ပြန့်သော ညှိနှိုင်းဆောင်ရွက်မှု လိုအပ်သည့်အခါ ထပ်တူလုပ်ဆောင်ခြင်းကို ကာကွယ်ရန် အလုပ်သမားများအကြား မျှဝေရပါမည်။ TTFT တိုးလာပြီး GPU များကို စီမံဆောင်ရွက်မည့်အစား စောင့်ဆိုင်းစေသည်။ BlueField-4 မှတစ်ဆင့် data plane ကို server သို့ ရွှေ့ပြောင်းခြင်းသည် ပိုမိုထိရောက်သော context traffic၊ ပိုမိုမြင့်မားသော throughput နှင့် ပိုမိုယုံကြည်စိတ်ချရသော latency ကို ရရှိစေသည်ဟု VAST က အခိုင်အမာပြောကြားခဲ့သည်။
VAST သည် RDMA fabrics များကို အသုံးပြု၍ GPU memory မှ persistent NVMe storage သို့ ထိရောက်သောလမ်းကြောင်းကိုလည်း အလေးပေးဖော်ပြသည်။ ၎င်းသည် GPU server များနှင့် storage အကြား context ကို ချောမွေ့စွာလွှဲပြောင်းနိုင်စေပြီး ရိုးရာစနစ်များတွင် အဖြစ်များသော ထပ်ခါတလဲလဲဒေတာကိုင်တွယ်မှုကို လျှော့ချပေးသည်။ ရည်ရွယ်ချက်မှာ CPU ပါဝင်ပတ်သက်မှုနှင့် client-side overhead ကို အနည်းဆုံးဖြစ်အောင် လုပ်ဆောင်နေစဉ် context movement သည် high-performance networking ဖြင့် "band တွင်ရှိနေစေရန်" သေချာစေရန်ဖြစ်သည်။
အတိုင်းအတာအလိုက် မျှဝေထားသော၊ ညီညွတ်သော အခြေအနေ
ဗိသုကာပုံစံအသစ်သည် VAST ၏ parallel Disaggregated Shared Everything (DASE) ဒီဇိုင်းနှင့်အတူ အလုပ်လုပ်ပါသည်။ VAST က ၎င်းသည် host တစ်ခုစီအား ပုံမှန်အားဖြင့် စကေးတွင် ပေါ်ပေါက်လာလေ့ရှိသော ညှိနှိုင်းမှုကုန်ကျစရိတ်များမရှိဘဲ မျှဝေထားသော၊ ကမ္ဘာလုံးဆိုင်ရာ ကိုက်ညီသော context namespace ကို ဝင်ရောက်ခွင့်ပြုကြောင်း ရှင်းပြသည်။ ရေရှည်တည်တံ့သော၊ agent-driven inference တွင်၊ ဤအသေးစိတ်အချက်အလက်များသည် အရေးကြီးလာသည်။ context သည် ကြီးမားရုံသာမက ပိုမိုမျှဝေလာပါသည်။
Agentic စနစ်များသည် မကြာခဏဆိုသလို တစ်ပြိုင်နက်တည်း tool အသုံးပြုခြင်း၊ agent များစွာအကြား handoff များနှင့် interaction များအတွင်း memory ကဲ့သို့သော အပြုအမူများ လိုအပ်ပါသည်။ ၎င်းသည် node တစ်ခုတည်းနှင့် ချည်နှောင်မည့်အစား context ကို ပြန်လည်ဖန်တီးပြီး inference workers များအကြား မျှဝေခြင်းထက် ပြန်လည်အသုံးပြုခြင်း လိုအပ်ပါသည်။ စနစ်များသည် အချိန်ဇယားဆွဲခြင်း၊ ဖယ်ရှားခြင်း သို့မဟုတ် failure recovery ကြောင့် context locality ကို မထိန်းသိမ်းနိုင်ပါက၊ ၎င်းတို့သည် ရှည်လျားသော prompt history များကို ပြန်လည်လုပ်ဆောင်ခြင်းမရှိဘဲ session များကို လျင်မြန်စွာ restore လုပ်ကာ ဆက်လက်လုပ်ဆောင်ရပါမည်။ ဤနည်းအားဖြင့် KV cache သည် အရေးကြီးသော cluster resource အဖြစ်သို့ ပြောင်းလဲသွားပြီး synchronization bottleneck မဖြစ်စေဘဲ ကျယ်ကျယ်ပြန့်ပြန့် အသုံးပြုနိုင်ရန် စိန်ခေါ်မှုကို ပြောင်းလဲပေးပါသည်။
VAST ရဲ့ ရှုထောင့်ကတော့ DPU-based data services နဲ့ shared-everything storage setup ကို ပေါင်းစပ်လိုက်တဲ့အခါ တစ်ပြိုင်နက်တည်း session အရေအတွက် တိုးလာတာနဲ့အမျှ ထိရောက်မှုရှိနေဆဲ ကမ္ဘာလုံးဆိုင်ရာ အသုံးပြုနိုင်တဲ့ context layer တစ်ခုကို ဖန်တီးပေးပါတယ်။ သီးခြား context sections တွေ ထပ်ထည့်ခြင်းဖြင့် scaling လုပ်မယ့်အစား ဒီ platform က cluster တွေကို တိုးချဲ့နိုင်စေပြီး ပြန်လည်အသုံးပြုခြင်းနဲ့ မျှဝေခြင်းကနေ အကျိုးကျေးဇူးတွေ ရရှိစေပါတယ်။
စွမ်းဆောင်ရည်အသစ်အတွက် နောက်ခံအခြေအနေ
VAST အမှုဆောင်အရာရှိချုပ် John Mao က ကြီးမားသော inference စနစ်များအတွက် ယှဉ်ပြိုင်နိုင်စွမ်းသည် ရိုးရှင်းသော computing power မှ memory နှင့် context စနစ်များသို့ ပြောင်းလဲနေကြောင်း မှတ်ချက်ပြုခဲ့သည်။ အထိရောက်ဆုံး cluster များသည် အမြင့်ဆုံး FLOPS ရှိသော cluster များသာမက real-time context sharing နှင့် management လုပ်နိုင်သော cluster များဖြစ်ကြောင်း သူက အကျဉ်းချုပ်ပြောကြားခဲ့သည်။ အဓိကစွမ်းဆောင်ရည်နယ်ပယ်တစ်ခုအနေဖြင့် context ကို ချက်ချင်း၊ on-demand access ရယူခြင်း၏ အရေးပါမှုကိုလည်း သူက မီးမောင်းထိုးပြခဲ့ပြီး context ကို လျင်မြန်စွာ ပြန်လည်ရယူခြင်းနှင့် ပြန်လည်အသုံးပြုခြင်းမရှိပါက GPU များသည် အလုပ်မလုပ်ဘဲ စွမ်းဆောင်ရည်ထိခိုက်နိုင်ကြောင်း သတိပေးခဲ့သည်။
မော်ဒယ်များ တိုးချဲ့လာပြီး session အရှည်များ တိုးလာသည်နှင့်အမျှ ဤအမြင်သည် အော်ပရေတာများစွာ၏ အတွေ့အကြုံများနှင့် ကိုက်ညီပါသည်။ Inference fleet များကို အများဆုံး token ထုတ်လုပ်မှုအတွက် မကြာခဏ configure လုပ်လေ့ရှိသော်လည်း အတွေ့အကြုံကို tail latency နှင့် ဖိအားအောက်တွင် TTFT မှ ပုံသွင်းသည်။ prompts များ ရှည်လာပြီး session များ ဆက်လက်တည်ရှိနေချိန်တွင် context management တွင် ကုန်ဆုံးချိန် မြင့်တက်လာပါသည်။ context ကို လျင်မြန်စွာ ပြန်လည်ရယူ၍မရပါက သို့မဟုတ် ပြန်လည်အသုံးမပြုနိုင်ပါက GPU cycle များသည် state ကို ပြန်လည်တည်ဆောက်ခြင်း သို့မဟုတ် data ရွှေ့ရန်စောင့်ဆိုင်းခြင်းတွင် အလဟဿဖြစ်သွားပါသည်။ VAST ၏ ဗိသုကာဆိုင်ရာ ချဉ်းကပ်မှုသည် KV cache ကို shared infrastructure အဖြစ် သဘောထားပြီး ဤပြဿနာများကို လျှော့ချပေးပြီး cluster စွမ်းဆောင်ရည်ကို မြှင့်တင်ပေးပါသည်။
စမ်းသပ်ချက်မှ အုပ်ချုပ်မှုရှိသော၊ ထုတ်လုပ်မှုဆိုင်ရာ ကောက်ချက်ချချက်သို့ ရွေ့လျားခြင်း
VAST သည် စမ်းသပ်ဖြန့်ကျက်မှုမှ စည်းမျဉ်းသတ်မှတ်ထားသောဆက်တင်များအပါအဝင် ထုတ်လုပ်မှုအတွက်အသင့် inference ဝန်ဆောင်မှုများသို့ ကူးပြောင်းခြင်းအဖြစ် ပလက်ဖောင်းကို ඉදිරියටတင်ပြနေပါသည်။ inference သည် သီးခြားလုံခြုံရေးနှင့် လိုက်နာမှုလိုအပ်ချက်များပါရှိသော ဝင်ငွေရှာဖွေပေးသည့် ဝန်ဆောင်မှုတစ်ခုဖြစ်လာသည်နှင့်အမျှ KV cache ကို စီမံခန့်ခွဲခြင်းသည် မြန်နှုန်းထက်ပို၍ လိုအပ်ပြီး ကြီးကြပ်မှုလည်း လိုအပ်ပါသည်။
ရှည်လျားသော အစည်းအဝေးများတွင်၊ အကြောင်းအရာတွင် အာရုံခံနိုင်သော လှုံ့ဆော်မှုများ၊ ကျိုးကြောင်းဆင်ခြင်ခြင်း အဆင့်များ၊ ကိရိယာ အထွက်များနှင့် အသုံးပြုသူမှ ပံ့ပိုးပေးသော အချက်အလက်များ ပါဝင်နိုင်သည်။ စီးပွားရေးလုပ်ငန်းများသည် ထိုအကြောင်းအရာအတွက် မူဝါဒထိန်းချုပ်မှုများ၊ အထီးကျန်မှု တိုင်းတာမှုများ၊ စာရင်းစစ်လမ်းကြောင်းများနှင့် သက်တမ်းစီမံခန့်ခွဲမှုတို့ကို ပိုမိုလိုအပ်လာပါသည်။ VAST က ဤ AI-native data service များကို AI OS တွင် တည်ဆောက်ထားပြီး အဖွဲ့အစည်းများအနေဖြင့် KV cache ကို ယာယီအခြေအနေတစ်ခုထက် စီမံခန့်ခွဲနိုင်သော အရင်းအမြစ်တစ်ခုအဖြစ် သဘောထားနိုင်စေသည်ဟု ဆိုပါသည်။
လုပ်ငန်းလည်ပတ်မှုရှုထောင့်မှကြည့်လျှင် VAST သည် ကြီးမားသော inference ပတ်ဝန်းကျင်များတွင် အဖြစ်များသောစိန်ခေါ်မှုများကို ဖြေရှင်းရန် ရည်ရွယ်သည်- cache များပျောက်ဆုံးသွားခြင်း သို့မဟုတ် မျှဝေ၍မရသည့်အခါ ဖြစ်ပွားသည့် context rebuild storms များနှင့် တွက်ချက်မှုထက် context သည် bottleneck ဖြစ်လာသည့်အခါ GPU အချိန်ဖြုန်းတီးခြင်း။ ကုမ္ပဏီသည် context persistence နှင့် reuse ကို မြှင့်တင်ခြင်းသည် ပြန်လည်တွက်ချက်မှုကို လျှော့ချပေးပြီး အသုံးပြုမှုကို တိုးမြှင့်ပေးမည်ဖြစ်ပြီး၊ ထို့ကြောင့် context size များနှင့် session concurrency မြင့်တက်လာသည်နှင့်အမျှ watt လျှင် throughput နှင့် ဒေါ်လာလျှင် throughput နှစ်မျိုးလုံးကို တိုးတက်ကောင်းမွန်စေမည်ဟု ယုံကြည်သည်။
NVIDIA: Context Management သည် Scaling Economics ကို မောင်းနှင်သည်
NVIDIA ၏ Networking ဆိုင်ရာ အကြီးတန်းဒုတိယဥက္ကဋ္ဌ Kevin Deierling က AI တွင် context ၏ အရေးပါမှုကို အလေးပေးပြောကြားခဲ့ပြီး ၎င်းကို လူ့မှတ်ဉာဏ်နှင့် နှိုင်းယှဉ်ခဲ့သည်။ သူက multi-turn နှင့် multi-user inference ကို ချဲ့ထွင်ရန်အတွက် context ကို ထိရောက်စွာ စီမံခန့်ခွဲခြင်းသည် မရှိမဖြစ်လိုအပ်ပြီး ၎င်းသည် context memory ကို အတိုင်းအတာတစ်ခုအထိ ကိုင်တွယ်ပုံကို ပြောင်းလဲစေကြောင်း ပြောကြားခဲ့သည်။ VAST Data AI OS ကို NVIDIA BlueField-4 နှင့် ပေါင်းစပ်ခြင်းဖြင့် workloads များ တိုးလာသည်နှင့်အမျှ high-throughput၊ တည်ငြိမ်သော data path ကို ပံ့ပိုးပေးခြင်းဖြင့် ၎င်းကို ပံ့ပိုးပေးကြောင်း ၎င်းက ထောက်ပြခဲ့သည်။ ဤပူးပေါင်းဆောင်ရွက်မှုသည် အရေးကြီးပါသည်၊ အဘယ်ကြောင့်ဆိုသော် ၎င်းသည် primary storage access သို့မဟုတ် networking အတွက်သာမက DPU များနှင့် Ethernet fabric ကို core inference context ထဲသို့ ပေါင်းစပ်ထားသောကြောင့်ဖြစ်သည်။ အဓိကအချက်မှာ context သည် GPU ပြဿနာတစ်ခုအပြင် networking နှင့် storage နှစ်ခုလုံးအတွက် စိန်ခေါ်မှုတစ်ရပ်ဖြစ်စေပြီး ခေတ်မီ inference setup များသည် GPU များ ထိရောက်စွာလည်ပတ်နေစေရန် အာရုံစူးစိုက်ထားသော အရှိန်မြှင့်တင်မှုနှင့် ယုံကြည်စိတ်ချရသော data movement လိုအပ်မည်ဖြစ်သည်။
VAST ရဲ့ ဗိသုကာလက်ရာက ကတိပေးထားတဲ့ အကျိုးကျေးဇူးတွေကို ပေးစွမ်းမယ်ဆိုရင် တကယ့်အကျိုးသက်ရောက်မှုက peak benchmark ရမှတ်တွေထက် တသမတ်တည်း ဝန်ဆောင်မှုစွမ်းဆောင်ရည်နဲ့ ပိုသက်ဆိုင်ပါလိမ့်မယ်- session အများအပြား active ဖြစ်နေတဲ့အခါ TTFT နည်းပါးခြင်း၊ context တိုးလာတာနဲ့အမျှ စွမ်းဆောင်ရည်ကျဆင်းမှု နည်းပါးခြင်း၊ context rebuilding ကို လျှော့ချခြင်းဖြင့် ပိုမိုကောင်းမွန်စွာ အသုံးချနိုင်ခြင်း၊ context sharing က အားနည်းချက်ထက် အားသာချက်ဖြစ်တဲ့ multi-node inference ကို ပိုမိုရိုးရှင်းစွာ အသုံးပြုနိုင်ခြင်းတို့ပဲ ဖြစ်ပါတယ်။ ဒါ့အပြင် inference infrastructure ကို “AI-native” model တစ်ခုအဖြစ် တွန်းအားပေးပြီး KV cache ကို persistent NVMe မှ ပံ့ပိုးပေးပြီး tight latency limits ရှိတဲ့ node တွေမှာ မျှဝေအသုံးပြုနိုင်ခြင်းတို့ကို လုပ်ဆောင်ပေးပါတယ်။
VAST ရှေ့သို့ ညီလာခံ
VAST Data သည် ၎င်း၏ မဟာဗျူဟာကို ၂၀၂၆ ခုနှစ် ဖေဖော်ဝါရီလ ၂၄ ရက်မှ ၂၆ ရက်အထိ Utah ပြည်နယ်၊ Salt Lake City တွင် ကျင်းပရန် စီစဉ်ထားသည့် ပထမဆုံး VAST Forward အသုံးပြုသူ ညီလာခံတွင် တင်ပြမည်ဖြစ်သည်။ ကုမ္ပဏီသည် အသေးစိတ် နည်းပညာဆိုင်ရာ အစည်းအဝေးများ၊ လက်တွေ့စမ်းသပ်ခန်းများနှင့် VAST ခေါင်းဆောင်မှု ၊ ဖောက်သည်များနှင့် မိတ်ဖက်များ ပါဝင်သည့် အသိအမှတ်ပြုလက်မှတ် အစီအစဉ်များ ပါဝင်ရန် စီစဉ်ထားသည်။


 အမေဇုံ