

Procyon ရဲ့ AI Text and Image Generation benchmarks တွေကို ဘာသာစကားကြီးတွေနဲ့ image model တွေနဲ့ အလုပ်လုပ်ရတာ ပိုလွယ်ကူအောင် ဒီဇိုင်းထုတ်ထားပါတယ်။ ဒီစမ်းသပ်မှုတွေကို စံသတ်မှတ်ထားပြီး ထပ်ခါတလဲလဲ လုပ်ဆောင်နိုင်ပြီး လက်တွေ့ကမ္ဘာက အခြေအနေတွေကို ထင်ဟပ်စေတဲ့အတွက် စွမ်းဆောင်ရည်ကို တိုင်းတာတဲ့ ရှုပ်ထွေးမှုအတွက် စိတ်ပူစရာမလိုပါဘူး။
AI စာသားနှင့် ရုပ်ပုံထုတ်လုပ်မှု workloads များသည် hardware ကို ၎င်း၏ကန့်သတ်ချက်များအထိ တွန်းပို့နိုင်သောကြောင့် တသမတ်တည်းနှင့် လက်တွေ့ကျသော benchmarks များရှိခြင်းသည် မရှိမဖြစ်လိုအပ်ပါသည်။ သင်သည် မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော GPU တွင်ဖြစ်စေ၊ သေးငယ်သော neural processing unit တွင်ဖြစ်စေ စမ်းသပ်မှုများကို လုပ်ဆောင်နေသည်ဖြစ်စေ Procyon သည် သင့် hardware မည်သို့လုပ်ဆောင်သည်ကို အတိအကျနားလည်ရန် ရှင်းလင်းပြီး လက်တွေ့လုပ်ဆောင်နိုင်သော အသိအမြင်များကို ပေးပါသည်။
အဆင့်မြင့် AI စွမ်းရည်များနှင့် လက်တွေ့စွမ်းဆောင်ရည်တိုင်းတာမှုကြား ကွာဟချက်ကို ပေါင်းကူးပေးခြင်းဖြင့် Procyon သည် အသုံးပြုသူများအား ၎င်းတို့၏စနစ်များသည် ယနေ့ခေတ်၏ အခက်ခဲဆုံး AI အလုပ်များကို မည်မျှကောင်းမွန်စွာ ကိုင်တွယ်ဖြေရှင်းနိုင်သည်ကို ကြည့်ရှုရန် အလိုလိုသိနိုင်သော နည်းလမ်းတစ်ခုကို ပေးစွမ်းသည်။
Procyon AI စာသားထုတ်လုပ်ခြင်း စံနှုန်း
Procyon AI Text Generation Benchmark သည် ကွန်ပျူတာ သို့မဟုတ် စက်ပစ္စည်းတစ်ခုသည် ChatGPT ကဲ့သို့သော ကိရိယာများနောက်ကွယ်ရှိ AI မော်ဒယ်များကို စာသားထုတ်လုပ်ရန် မည်မျှထိရောက်စွာ လုပ်ဆောင်နိုင်သည်ကို အကဲဖြတ်သည်။ ၎င်းသည် စနစ်သည် တုံ့ပြန်မှုများကို မည်မျှမြန်ဆန်စွာ ထုတ်လုပ်နိုင်သည်၊ အကြောင်းအရာရေးသားနိုင်သည် သို့မဟုတ် ညွှန်ကြားချက်များပေးသည့်အခါ အချက်အလက်များကို မည်မျှမြန်ဆန်စွာနှင့် ချောမွေ့စွာ အကျဉ်းချုပ်နိုင်သည်ကို စစ်ဆေးပေးသည့်အပြင် လုပ်ငန်းစဉ်အတွင်း ကွန်ပျူတာ၏ ပရိုဆက်ဆာ၊ ဂရပ်ဖစ်ကတ်နှင့် မှတ်ဉာဏ်ကဲ့သို့သော အရင်းအမြစ်များကို မည်မျှအသုံးပြုသည်ကို စောင့်ကြည့်ပေးသည်။
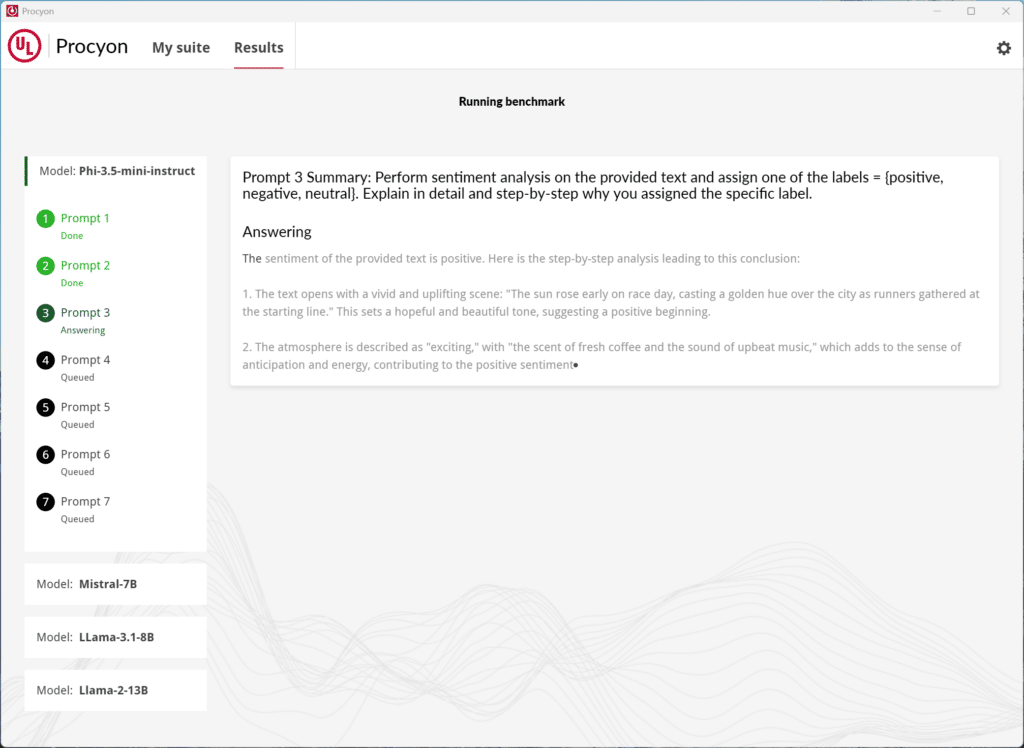
Procyon ရဲ့ benchmark ရဲ့ ထူးခြားချက်ကတော့ ဒေသတွင်း large language model (LLM) စွမ်းဆောင်ရည်ကို အကဲဖြတ်တဲ့ ရှုပ်ထွေးတဲ့ လုပ်ငန်းကို ရိုးရှင်းစေပြီး enterprise professionals၊ hardware reviewers နဲ့ engineering teams တွေလို အသုံးပြုသူတွေအတွက် အသုံးပြုနိုင်အောင် လုပ်ပေးတာပါပဲ။ ရိုးရာ benchmarking မှာ quantization နဲ့ token handling လိုမျိုး variable တွေကို စီမံခန့်ခွဲဖို့ storage အများကြီး၊ download အများအပြားနဲ့ ဂရုတစိုက် configuration တွေ လိုအပ်ပါတယ်။ Procyon က ဒီလုပ်ငန်းစဉ်ကို structured testing framework နဲ့ pre-packaged, optimized AI models တွေနဲ့ ချောမွေ့စေပြီး နည်းပညာပိုင်းဆိုင်ရာ ကျွမ်းကျင်မှု ဒါမှမဟုတ် manual setup မလိုအပ်ဘဲ တသမတ်တည်း၊ ထပ်ခါတလဲလဲ ရလဒ်တွေကို ပေးစွမ်းပါတယ်။
ပရိုစီယွန် ဘယ်လို AI စာသားမျိုးဆက် လုပ်ဆောင်ချက်များနှင့် အဘယ်ကြောင့် အရေးကြီးသနည်း
Procyon သည် ကျယ်ကျယ်ပြန့်ပြန့် အသိအမှတ်ပြုထားသော မော်ဒယ်လေးခုကို ကြိုတင်ထည့်သွင်းခြင်းဖြင့် LLM စမ်းသပ်မှုကို အလိုအလျောက်လုပ်ဆောင်ပေးပြီး၊ ကောက်ချက်ချခြင်းဆိုင်ရာ အလုပ်များ—input prompts များအပေါ်အခြေခံ၍ စာသားများကို အချိန်နှင့်တပြေးညီ ထုတ်လုပ်ခြင်း—၏ မြန်ဆန်ပြီး ယုံကြည်စိတ်ချရသော စွမ်းဆောင်ရည် အကဲဖြတ်မှုကို ပြုလုပ်နိုင်စေပါသည်။ ၎င်းသည် စမ်းသပ်မှုကာလအတွင်း တစ်စက္ကန့်လျှင် တိုကင်များ၊ latency နှင့် hardware resource အသုံးပြုမှု (CPU၊ GPU နှင့် memory) ကဲ့သို့သော အရေးကြီးသော မက်ထရစ်များကို စောင့်ကြည့်ပေးပါသည်။ ပလက်ဖောင်းသည် အချိန်နှင့်တပြေးညီ ထိုးထွင်းသိမြင်မှုများကို ပေးစွမ်းပြီး ကောက်ချက်ချမှုအမြန်နှုန်း၊ အရင်းအမြစ်အတားအဆီးများနှင့် အလုံးစုံထိရောက်မှုကို မီးမောင်းထိုးပြသည့် အသေးစိတ်စမ်းသပ်မှုအပြီး အစီရင်ခံစာများကို ထုတ်ပေးသည်။
ဤရလဒ်များသည် အသုံးပြုသူများအား စွမ်းဆောင်ရည်ကို အကောင်းဆုံးဖြစ်အောင် ကူညီပေးပြီး လုပ်ငန်းများအနေဖြင့် ၎င်းတို့၏ ဟာ့ဒ်ဝဲသည် လိုအပ်ချက်များသော AI အလုပ်ပမာဏကို မည်မျှကောင်းမွန်စွာ စီမံခန့်ခွဲသည်ကို အကဲဖြတ်နိုင်စေပါသည်။
လက်တွေ့ကမ္ဘာစမ်းသပ်မှုအခြေအနေများ
Procyon ရဲ့ benchmarking suite က အဓိက workloads နှစ်ခုကို လွှမ်းခြုံထားတဲ့ ကွဲပြားတဲ့ test prompts ခုနစ်ခုနဲ့ လက်တွေ့ကျတဲ့ use case တွေကို simulate လုပ်ပါတယ်-
| စမ်းသပ်မှုအမျိုးအစား | အလုပ်ဝန်အား အာရုံစိုက်မှု | input ပုံစံ | ထင်ရှားသော အသုံးပြုမှုဖြစ်ရပ် ဥပမာများ | ထူးခြားတဲ့အင်္ဂါရပ်များ |
| Retrieval-augmented Generation (RAG) | မြင့်မားသော ရှုပ်ထွေးမှုရှိသော ပြန်လည်ရယူခြင်း | တိုကင်ပြုလုပ်ထားသောဒေတာ | ဗဟုသုတအခြေခံ အနှစ်ချုပ်များ ဖန်တီးခြင်း | ပြန်လည်ရယူခြင်းပေါင်းစပ်မှုတိကျမှုကိုစမ်းသပ်သည် |
| ဖန်တီးမှုဆိုင်ရာ Non-RAG စာသား | အခမဲ့ပုံစံထုတ်လုပ်ခြင်း | သဘာဝဘာသာစကားစာသား | ဖန်တီးမှုဆိုင်ရာ မူကြမ်းများ၊ ဇာတ်လမ်းများ ရေးသားခြင်း | ဖန်တီးမှုဆိုင်ရာ ကျွမ်းကျင်မှုကို အကဲဖြတ်သည် |
- Retrieval-augmented Generation (RAG)မော်ဒယ်တစ်ခုသည် ပြင်ပဗဟုသုတများကို ၎င်း၏တုံ့ပြန်မှုများထဲသို့ မည်မျှထိရောက်စွာ ပေါင်းစပ်ထည့်သွင်းသည်ကို RAG လုပ်ငန်းတာဝန်များက တိုင်းတာသည်။ ၎င်းတို့တွင် အကျဉ်းချုပ်များထုတ်ပေးခြင်း သို့မဟုတ် LLM ၏ လေ့ကျင့်ရေးအစုံပြင်ပရှိ ဒေတာဝင်ရောက်ခွင့်လိုအပ်သော မေးခွန်းများကို ဖြေဆိုခြင်း ပါဝင်နိုင်သည်။
- ဖန်တီးမှုဆိုင်ရာ Non-RAGအခမဲ့ပုံစံထုတ်လုပ်ခြင်း လုပ်ငန်းများတွင်၊ မော်ဒယ်သည် ၎င်း၏ အတွင်းပိုင်းလေ့ကျင့်မှုကိုသာ အားကိုးသည့်အခါ စာသား၏ ချောမွေ့မှု၊ ညီညွတ်မှုနှင့် ဖန်တီးမှုဆိုင်ရာ အထွက်နှုန်းကို အကဲဖြတ်ရန် အဓိကထားသည်။
Procyon သည် enterprise AI workflows (ဗဟုသုတပြန်လည်ရယူခြင်း) နှင့် ဖန်တီးမှုဆိုင်ရာအကြောင်းအရာထုတ်လုပ်ခြင်း (လွတ်လပ်သောပုံစံတာဝန်များ) အပါအဝင် လုပ်ငန်းတာဝန်နှစ်ခုလုံးကို လွှမ်းခြုံခြင်းဖြင့် လက်တွေ့ကမ္ဘာအသုံးချမှုများကို ထင်ဟပ်စေသည်။
Procyon AI ပုံရိပ်ထုတ်လုပ်မှု စံနှုန်း
စာသားဗားရှင်းကဲ့သို့ပင်၊ Procyon AI Image Generation Benchmark သည် ကွန်ပျူတာ သို့မဟုတ် စက်ပစ္စည်းတစ်ခုသည် စာသားတောင်းဆိုမှုများကို အရည်အသွေးမြင့် ရုပ်ပုံများအဖြစ် ပြောင်းလဲခြင်းကဲ့သို့သော AI-driven image generation လုပ်ငန်းများကို မည်မျှထိရောက်စွာ ကိုင်တွယ်သည်ကို တိုင်းတာသည်။ ၎င်းကို လုပ်ငန်းနယ်ပယ်မှ ခေါင်းဆောင်များထံမှ အကြံဉာဏ်များဖြင့် တီထွင်ခဲ့ပြီး ပညာရှင်များနှင့် နေ့စဉ်အသုံးပြုသူများမှ စာသားမှ ရုပ်ပုံထုတ်လုပ်ရာတွင် ကျယ်ကျယ်ပြန့်ပြန့်အသုံးပြုသည့် Stable Diffusion မော်ဒယ်များကို အသုံးပြု၍ ပါဝါနည်း အာရုံကြောဆိုင်ရာ လုပ်ငန်းစဉ်ယူနစ်များ (NPU) မှ စွမ်းဆောင်ရည်မြင့် GPU များအထိ ဟာ့ဒ်ဝဲအမျိုးမျိုးကို အကဲဖြတ်ခဲ့သည်။
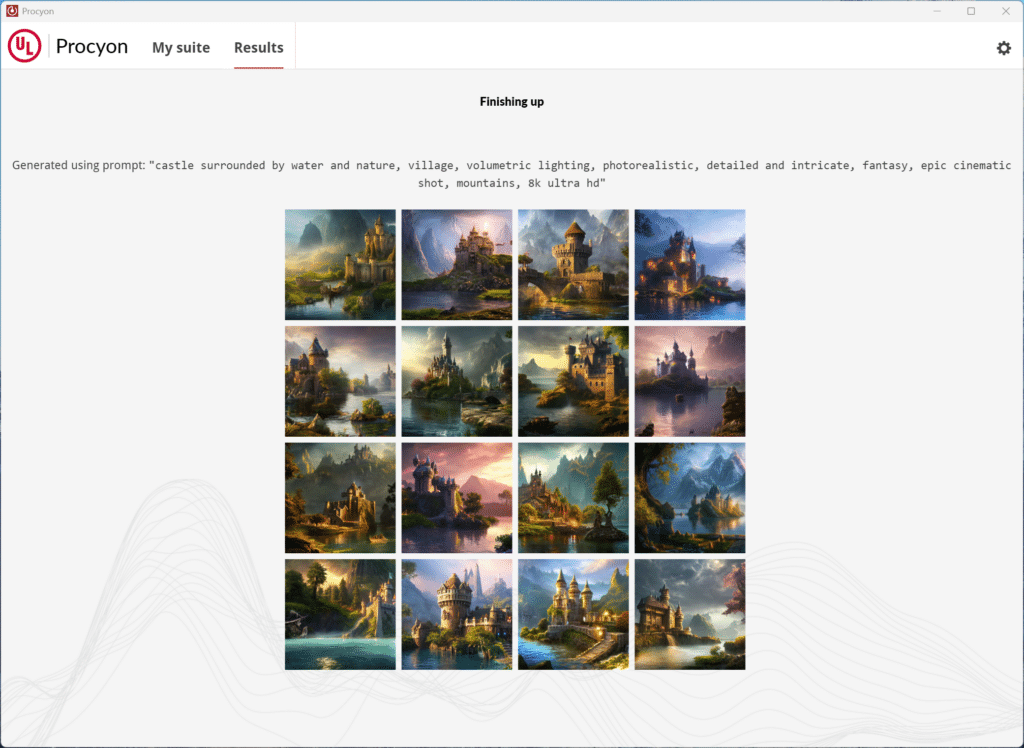
Procyon AI ပုံရိပ်ထုတ်လုပ်မှုစံနှုန်းကို ဘာက အထောက်အကူပြုသလဲ ထူးခြားပါသလား
Procyon ရဲ့ image benchmark က မတူညီတဲ့ hardware စွမ်းရည်တွေအပေါ် မူတည်ပြီး စမ်းသပ်မှု သုံးခုကို ပေးစွမ်းပြီး စက်ပစ္စည်းအမျိုးမျိုးအတွက် ပြည့်စုံတဲ့ အကဲဖြတ်မှုကို သေချာစေပါတယ်-
- တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16): အဆင့်မြင့် GPU များအတွက် ဒီဇိုင်းထုတ်ထားသောကြောင့် ၎င်းသည် အခက်ခဲဆုံးစမ်းသပ်မှုဖြစ်သည်။ ၎င်းသည် အဆင့် ၁၀၀ ဖြင့် 1024×1024 resolution ရုပ်ပုံများကို ထုတ်ပေးသည်။
- တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆): အလယ်အလတ်တန်းစား GPU များအတွက် ဟန်ချက်ညီသော workload တစ်ခု၊ အဆင့် ၄ ဆင့်နှင့် ၁၀၀ အရွယ်အစားရှိသော 512×512 resolution image များကို ထုတ်လုပ်ပေးသည်။
- တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT8): NPU ကဲ့သို့သော ပါဝါနည်းစက်ပစ္စည်းများအတွက် အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ထားသော စမ်းသပ်မှုတစ်ခု၊ အဆင့် ၅၀ ၏ ပိုမိုပေါ့ပါးသောဆက်တင်များနှင့် ပုံတစ်ပုံအသုတ်တစ်ခုတည်းဖြင့် 512×512 ရုပ်ပုံများကို အာရုံစိုက်ထားသည်။
ပရိုစီယွန် ဘယ်လို AI ရုပ်ပုံမျိုးဆက် လုပ်ဆောင်ချက်များနှင့် အဘယ်ကြောင့် အရေးကြီးသနည်း
Procyon သည် ရုပ်ပုံထုတ်လုပ်မှုအမြန်နှုန်း၊ GPU အသုံးပြုမှုနှင့် အလုံးစုံအရင်းအမြစ်ထိရောက်မှုကဲ့သို့သော အရေးကြီးသောအချက်များကို တိုင်းတာခြင်းဖြင့် သင့်စနစ်၏စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည်။ ၎င်းသည် GPU အပူချိန်၊ clock speeds နှင့် memory အသုံးပြုမှုကဲ့သို့သော အချိန်နှင့်တပြေးညီ မက်ထရစ်များကို ခြေရာခံနေစဉ်တွင် ထုတ်လုပ်ထားသော ရုပ်ပုံများ၏ အရည်အသွေးကိုလည်း ခွဲခြမ်းစိတ်ဖြာသည်။ Procyon သည် NVIDIA TensorRT၊ Intel OpenVINO နှင့် ONNX with DirectML အပါအဝင် inference engine များစွာကိုလည်း ပံ့ပိုးပေးသောကြောင့် မတူညီသော platform များနှင့် hardware configuration များတွင် ချောမွေ့စွာလည်ပတ်နိုင်စေပါသည်။
စမ်းသပ်မှုအဆုံးတွင် Procyon သည် စွမ်းဆောင်ရည်ရမှတ်များ၊ အရင်းအမြစ်အတားအဆီးများနှင့် အထွက်အရည်အသွေးကို မီးမောင်းထိုးပြသည့် အသေးစိတ်အစီရင်ခံစာများကို ထုတ်ပေးပြီး ၎င်းတို့၏ ဟာ့ဒ်ဝဲသည် စာသားမှ ရုပ်ပုံသို့ ပြောင်းလဲသည့် အလုပ်များ၏ တွက်ချက်မှုဆိုင်ရာ လိုအပ်ချက်များကို မည်မျှကောင်းမွန်စွာ ကိုင်တွယ်သည်ကို အသုံးပြုသူများအား ရှင်းရှင်းလင်းလင်း နားလည်စေပါသည်။ ၎င်းသည် AI အင်ဂျင်များကို ချိန်ညှိနေသော ဆော့ဖ်ဝဲရေးသားသူဖြစ်စေ၊ စနစ်များကို နှိုင်းယှဉ်နေသော ဟာ့ဒ်ဝဲ ပြန်လည်သုံးသပ်သူဖြစ်စေ၊ သို့မဟုတ် လုပ်ငန်းစဉ်များကို အကောင်းဆုံးဖြစ်အောင် လုပ်ဆောင်နေသော လုပ်ငန်းတစ်ခုဖြစ်စေကာမူ အသုံးပြုမှုကိစ္စအမျိုးမျိုးအတွက် အလွန်ကောင်းမွန်ပါသည်။
စာသားညွှန်ကြားချက်များနှင့် Stable Diffusion မော်ဒယ်များကို အသုံးပြုမှုကို စံသတ်မှတ်ခြင်းဖြင့် hardware တစ်လျှောက် ယုံကြည်စိတ်ချရသော နှိုင်းယှဉ်မှုများကို benchmark က သေချာစေသည်။ ပူးတွဲပါ အစီရင်ခံစာများသည် အသုံးပြုသူများအား ಒಟ್ಟಾರೆစွမ်းဆောင်ရည်ရမှတ်များနှင့် ထုတ်လုပ်ထားသော ရုပ်ပုံများ၏ အရည်အသွေးကို ပြန်လည်သုံးသပ်နိုင်စေပြီး ၎င်းတို့၏စနစ်များသည် စာသားမှ ရုပ်ပုံသို့ ပြောင်းလဲခြင်းလုပ်ငန်းများ၏ တွက်ချက်မှုဆိုင်ရာ လိုအပ်ချက်များကို မည်သို့ကိုင်တွယ်ဖြေရှင်းသည်ကို ပြီးပြည့်စုံသော ရုပ်ပုံလွှာကို ပေးစွမ်းသည်။
Benchmarking စမ်းသပ်မှုများ
AI workloads အတွက် စနစ်များကို အကဲဖြတ်သည့်အခါ hardware များသည် သယ်ဆောင်ရလွယ်ကူသော၊ စားသုံးသူအဆင့် laptop များမှသည် ပရော်ဖက်ရှင်နယ်ပတ်ဝန်းကျင်အတွက် ဒီဇိုင်းထုတ်ထားသော high-end workstation များအထိ ကျယ်ပြန့်စွာ ကွဲပြားနိုင်သည်။ configuration တစ်ခုချင်းစီတွင် အားသာချက်များနှင့် ကန့်သတ်ချက်များ ရှိသောကြောင့် hardware profile အမျိုးမျိုးသည် AI အလုပ်များကို မည်သို့ကိုင်တွယ်သည်ကို နားလည်ရန် မတူညီသော platform များတွင် စမ်းသပ်ရန် အရေးကြီးပါသည်။
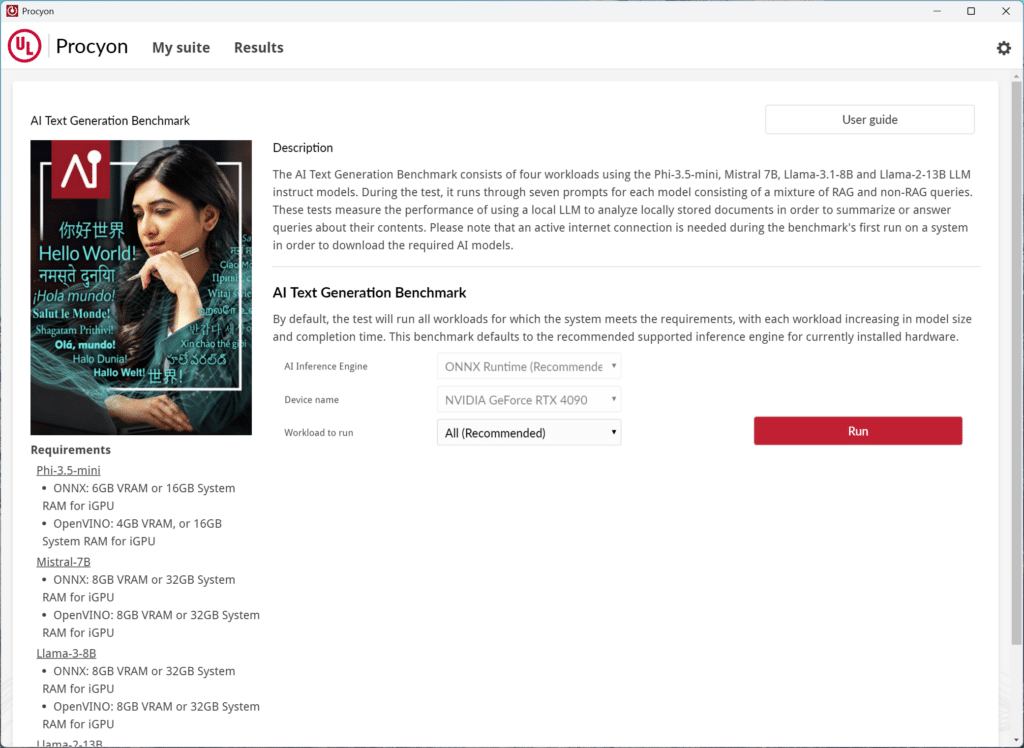
ဤခွဲခြမ်းစိတ်ဖြာမှုအတွက်၊ ဂိမ်းလက်တော့ပ်၊ လုပ်ငန်းသုံး workstation နှင့် ဘက်စုံသုံး ပရော်ဖက်ရှင်နယ် စက်ပစ္စည်းနှစ်ခု အပါအဝင် စနစ်အမျိုးမျိုးတွင် Procyon benchmarks များကို အသုံးပြုခဲ့ပါသည်။ ဤကွဲပြားမှုကြောင့် GPU စွမ်းရည်၊ မှတ်ဉာဏ်ဗိသုကာ၊ သိုလှောင်မှုဖြေရှင်းချက်များနှင့် ပရိုဆက်ဆာအမျိုးအစားများက လွှမ်းမိုးထားသော စွမ်းဆောင်ရည်ကွာခြားချက်များကို ကျွန်ုပ်တို့ လေ့လာနိုင်ခဲ့ပါသည်။
- Alienware လက်တော့ပ် Windows 11 Home ကို အသုံးပြုထားတဲ့ Alienware လက်တော့ပ်ဟာ ဂိမ်းကစားဖို့အတွက် အဓိကဒီဇိုင်းထုတ်ထားပေမယ့် NVIDIA RTX 4090 GPU တပ်ဆင်ထားတာကြောင့် AI workloads တွေအတွက် သင့်တော်ပါတယ်။ Intel Core i9-14900KF processor နဲ့ 32GB DDR4 memory တို့က ကောင်းမွန်တဲ့ computing power ကို သေချာစေပြီး Samsung PM9A1 NVMe SSD က storage ကို ကိုင်တွယ်ပေးပါတယ်။
- တိကျမှု ၅၈၆၀ တာဝါ Enterprise-level performance အတွက် တည်ဆောက်ထားသော Precision 5860 Tower တွင် AI နှင့် 3D rendering ကဲ့သို့သော အလွန်အမင်း workloads များအတွက် စိတ်ကြိုက်ပြင်ဆင်ထားသော professional-grade powerpower တစ်ခုဖြစ်သည့် NVIDIA ၏ RTX 6000 GPU ပါရှိသည်။ ၎င်း၏ Intel Xeon w7-2595X CPU သည် workstation-class processing capabilities များကို ပေးစွမ်းပြီး 128GB DDR5 RAM ဖြင့် ဖြည့်စွက်ထားသည်။
- Lenovo ThinkPad: Lenovo ThinkPad သည် သယ်ဆောင်ရလွယ်ကူမှုနှင့် ပရော်ဖက်ရှင်နယ်အဆင့် စွမ်းဆောင်ရည်ကို ဟန်ချက်ညီအောင် ထိန်းညှိပေးသောကြောင့် စွမ်းဆောင်ရည်ကို မထိခိုက်စေဘဲ ရွေ့လျားနိုင်မှုကို လိုအပ်သော အသုံးပြုသူများအတွက် အသင့်တော်ဆုံးဖြစ်သည်။ ၎င်းတွင် AI နှင့် ဂရပ်ဖစ် workstation အဆင့် ကတ်တစ်ခုဖြစ်သည့် NVIDIA RTX A4000 GPU ပါရှိသည်။ စနစ်တွင် Intel Xeon W-11955M ပရိုဆက်ဆာဖြင့် မောင်းနှင်ထားပြီး 32GB DDR4 မှတ်ဉာဏ်ဖြင့် ပံ့ပိုးပေးထားသည်။ သိုလှောင်မှုဖြေရှင်းချက်မှာ လူကြိုက်များသော NVMe drive တစ်ခုဖြစ်သည့် Samsung 980 Pro SSD ဖြစ်သည်။
- Lenovo ThinkStation: Lenovo ThinkStation သည် အမြင့်ဆုံးတွက်ချက်မှုဝန်ထုပ်ဝန်ပိုးများကို ကိုင်တွယ်ရန် ဒီဇိုင်းထုတ်ထားသော ပရော်ဖက်ရှင်နယ်အဆင့် workstation တစ်ခုဖြစ်သည်။ NVIDIA RTX A5500 GPU နှင့် Intel Xeon Gold 5420+ CPU တို့ဖြင့် အမြင့်ဆုံး AI inference စွမ်းဆောင်ရည်အတွက် ဒီဇိုင်းထုတ်ထားသည်။ 256GB DDR5 မှတ်ဉာဏ်ဖြင့် ကျောထောက်နောက်ခံပြုထားသောကြောင့် ၎င်းသည် ကြီးမားသော multitasking နှင့် data-handling စွမ်းရည်များကို ပေးစွမ်းသည်။ စနစ်တွင် Kioxia Exceria Pro SSD ကိုအသုံးပြုထားပြီး ၎င်းသည် ကြီးမားသောဒေတာလုပ်ဆောင်မှု၏ လိုအပ်ချက်များနှင့် ကိုက်ညီသော မြင့်မားသောခံနိုင်ရည်ရှိပြီး မြန်နှုန်းမြင့် drive တစ်ခုဖြစ်သည်။ အခြားထုတ်ကုန်များကဲ့သို့ပင် ၎င်းသည် Windows 11 Pro တွင် လည်ပတ်သည်။
ဤစနစ်များကို Procyon AI benchmarks များဖြင့် စမ်းသပ်ခြင်းဖြင့် ဤကိရိယာများသည် မည်သို့အလုပ်လုပ်သည်ကို မြင်တွေ့နိုင်သည့်အပြင် မတူညီသော hardware အမျိုးအစားများက AI အလုပ်များကို မည်သို့ကိုင်တွယ်သည်ကို ပြသနိုင်ပါသည်။ ထိပ်တန်း consumer GPU ပါသည့် gaming laptop ဖြစ်စေ၊ heavy-duty workloads များအတွက် တည်ဆောက်ထားသော professional workstation ဖြစ်စေ၊ setup တစ်ခုချင်းစီသည် ထူးခြားသောအရာတစ်ခုကို ပေးဆောင်ပါသည်။
AI စာသားမျိုးဆက်
| စံနစ် | ပုံစံ | ယေဘုယျအားရမှတ် | အထွက် တိုကင်များ |
|---|---|---|---|
| Alienware Procyon (NVIDIA RTX 4090၊ ONNXRuntime-DirectML 1.20.0) |
PHI3.5 | 3031 | 226.56 တိုကင်/s |
| Mistral 7B | 3507 | 171.9 တိုကင်/s | |
| LLAMA3.1 | 3487 | 142.26 တိုကင်/s | |
| LLAMA2 | 3527 | 90.59 တိုကင်/s | |
| Precision 5860 Tower (NVIDIA RTX 6000၊ ONNXRuntime-DirectML 1.20.0) |
PHI3.5 | 2245 | 180.472 တိုကင်/s |
| Mistral 7B | 2725 | 146.639 တိုကင်/s | |
| LLAMA3.1 | 2692 | 118.806 တိုကင်/s | |
| LLAMA2 | 2733 | 77.326 တိုကင်/s | |
| lenovo thinkpad (Intel UHD ဂရပ်ဖစ် (iGPU)၊ Intel OpenVINO 2024.5.0) |
PHI3.5 | 133 | 8.98 တိုကင်/s |
| Mistral 7B | 108 | 5.54 တိုကင်/s | |
| LLAMA3.1 | 107 | 2.93 တိုကင်/s | |
| LLAMA2 | 100 | 8.98 တိုကင်/s | |
| Lenovo Thinkstation (NVIDIA RTX A5500၊ ONNXRuntime-DirectML 1.20.0) |
PHI3.5 | 1551 | 99.43 တိုကင်/s |
| Mistral 7B | 1556 | 64.18 တိုကင်/s | |
| LLAMA3.1 | 1580 | 59.55 တိုကင်/s | |
| LLAMA2 | 1644 | 37.38 တိုကင်/s |
AI ရုပ်ပုံမျိုးဆက်
| စံနစ် | benchmark | ယေဘုယျအားရမှတ် | ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း (/s) |
|---|---|---|---|
| Alienware Procyon (NVIDIA RTX 4090၊ NVIDIA TensorRT) |
တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) | 5995 | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT8) | 49692 | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) | 4944 | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | |
| Precision 5860 Tower (NVIDIA RTX 6000၊ NVIDIA TensorRT) |
တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) | 44169 | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT8) | 3094 | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) | 4182 | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | |
| lenovo thinkpad (NVIDIA RTX A4000၊ TensorRT) |
တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) | 1308 | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT8) | 15133 | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) | 858 | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | |
| Lenovo Thinkstation (NVIDIA RTX A5500၊ NVIDIA TensorRT) |
တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) | 2401 | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT8) | 25489 | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) | 2000 | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
StorageReview ဓာတ်ခွဲခန်းမှတစ်ဆင့် ထွက်ပေါ်လာသော စနစ်အမျိုးမျိုးတွင် ဤစမ်းသပ်မှုအသစ်များကို ဆက်လက်လုပ်ဆောင်နေသည်ကို ဤစာမျက်နှာတွင် စောင့်မျှော်ကြည့်ရှုပါ။


 အမေဇုံ