

Acer Veriton GN100 AI Mini Workstation သည် ကျွန်ုပ်တို့ အကဲဖြတ်နေသော Spark-based စနစ်များစွာထဲမှ တစ်ခုဖြစ်ပြီး NVIDIA ၏ GB10 Grace Blackwell Superchip ကို အခြေခံ၍ တည်ဆောက်ထားသည်။ အခြားစနစ်များကဲ့သို့ပင် GN100 ကို datacenter-class AI compute ကို compact desktop form factor ထဲသို့ ယူဆောင်လာရန် ဒီဇိုင်းထုတ်ထားပြီး developer များနှင့် သုတေသီများသည် cloud infrastructure ကို အပြည့်အဝမှီခိုမည့်အစား ဒေသတွင်းတွင် မော်ဒယ်များကို လည်ပတ်ပြီး ပြုပြင်နိုင်စေပါသည်။
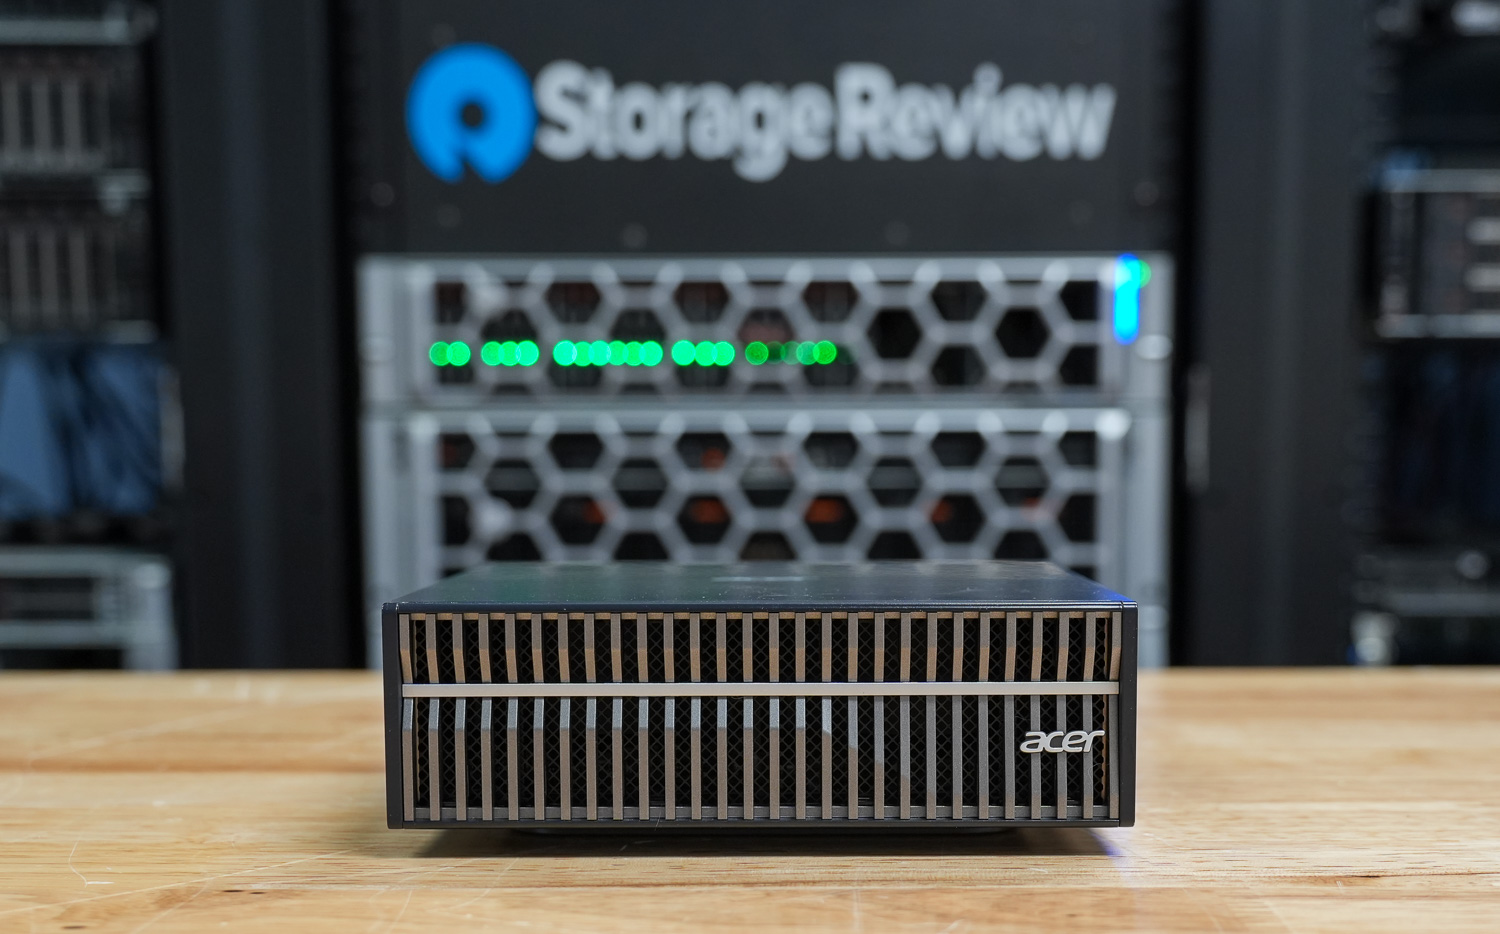
ဤဖွဲ့စည်းပုံတွင် GN100 သည် 20-core Arm-based GB10 processor နှင့် integrated Blackwell graphics တို့ဖြင့် တွဲဖက်ထားပြီး FP4 AI စွမ်းဆောင်ရည်၏ 1 petaFLOP အထိ ပေးစွမ်းနိုင်သည်။ ၎င်းတွင် 128GB LPDDR5x unified memory နှင့် 4TB PCIe Gen5 NVMe SSD တပ်ဆင်ထားသောကြောင့် ဘာသာစကားကြီးများ၊ generative AI workflows နှင့် data-heavy experimentation များအတွက် လိုအပ်သော memory bandwidth နှင့် storage throughput ကို ပေးစွမ်းနိုင်သည်။
ဤအုပ်စုရှိ အခြား Spark စနစ်များကဲ့သို့ပင် GN100 သည် ဒေသတွင်း AI လုပ်ဆောင်မှုကို ပံ့ပိုးပေးပြီး ပေါင်းစပ်ထားသော NVIDIA ConnectX-7 SmartNIC မှတစ်ဆင့် စနစ်မှစနစ်သို့ ချဲ့ထွင်နိုင်စေပါသည်။ တစ်ခုတည်းသော စက်ပစ္စည်းထက်ကျော်လွန်၍ ပိုကြီးသော မော်ဒယ်အလုပ်ပမာဏများကို ပံ့ပိုးပေးရန် ယူနစ်နှစ်ခုကို ချိတ်ဆက်နိုင်သည်။
ဒီစနစ်ကို NVIDIA DGX OS နဲ့ AI software stack အပြည့်အစုံ ကြိုတင်ထည့်သွင်းထားပြီး ဖွံ့ဖြိုးတိုးတက်မှုနဲ့ သုတေသနပတ်ဝန်းကျင်တွေမှာ ချက်ချင်းဖြန့်ကျက်အသုံးပြုနိုင်ပါတယ်။
Acer Veriton GN100 AI သတ်မှတ်ချက်များ
| specification | Acer Veriton GN100 AI (GB10) |
|---|---|
| အရွယ်အစားနှင့်အလေးချိန် | |
| အမြင့် | အတွက် 2 |
| width | အတွက် 5.9 |
| အနက် | အတွက် 5.9 |
| အလေးချိန် | 2.65 ပေါင် |
| processor ကို | |
| ပရိုဆက်ဆာအမျိုးအစား | NVIDIA GB10 (Grace Blackwell Superchip) (20 Cores) |
| ပေါင်းစပ်ဂရပ်ဖစ် | NVIDIA Blackwell GPU (ပေါင်းစပ်ထားသည်) |
| မှတ်ဉာဏ် | |
| memory အမျိုးအစား | LPDDR5x (ပေါင်းစည်းထားသော စနစ် မှတ်ဉာဏ်) |
| မှတ်ဉာဏ် Configuration | 128 GB LPDDR5x၊ ပေါင်းစည်းထားသော စနစ်မှတ်ဉာဏ် |
| မှတ်ဉာဏ် Bandwidth | ၂၇၃ GB/s (၈၅၃၃ MT/s) |
| ကွန်ပျူတာစက်လည်ပတ်ရေးစနစ်ပရိုဂရမ် | |
| ထောကျပံ့ OS ကို | NVIDIA DGX OS |
| ပြင်ပပေါက်များနှင့် အပေါက်များ | |
| Network Ports များ | RJ45 တစ်ခု (10GbE) NVIDIA ConnectX-7 NIC (200G × 2 QSFP) |
| USB port | USB 3.2 Gen 2×2 Type-C (20Gbps) သုံးခု PD in ပါရှိသော USB 3.2 Gen 2×2 Type-C တစ်ခု |
| ဗီဒီယို ပို့တ်(များ) | HDMI 2.1a တစ်ခု |
| ပါဝါအဒက်တာပေါက် | USB Type-C (PD IN) |
| လုံခြုံရေး slot | ကင်းဆင်တန်သော့တစ်ခု |
| ကြိုးမဲ့ | |
| ဝိုင်ဖိုင် | WiFi 7 (AW-EM637၊ 2×2) |
| ဘလူးတုသ် | ဘလူးတုသ် ၅.၀ |
| သိုလှောင်ခြင်း | |
| သိုလှောင်မှုရွေးချယ်စရာများ | 4 TB NVMe SSD (PCIe Gen5) အထိ |
| ပါဝါစ Adapter ကို | |
| ပုံစံ | ၂၄၀ ဝပ် ပြင်ပ အဒက်တာ (USB Type-C) |
Acer Veriton GN100 AI တည်ဆောက်မှုနှင့် ဒီဇိုင်း
Veriton GN100 ရဲ့ ရှေ့ပိုင်းကို ကိုယ်ထည်အကျယ်တစ်လျှောက် ဒေါင်လိုက်ပြားတွေနဲ့ ဖုံးအုပ်ထားပါတယ်။ အလျားလိုက် ပေါ်လွင်တဲ့ မျဉ်းကြောင်းတစ်ခုက grille ကို ဖြတ်သွားပြီး ကျွန်တော်တို့ ကြည့်ဖူးသမျှ Spark-based စနစ်တွေနဲ့ ယှဉ်ရင် ထူးခြားတဲ့ အသွင်အပြင်ကို ပေးစွမ်းပါတယ်။
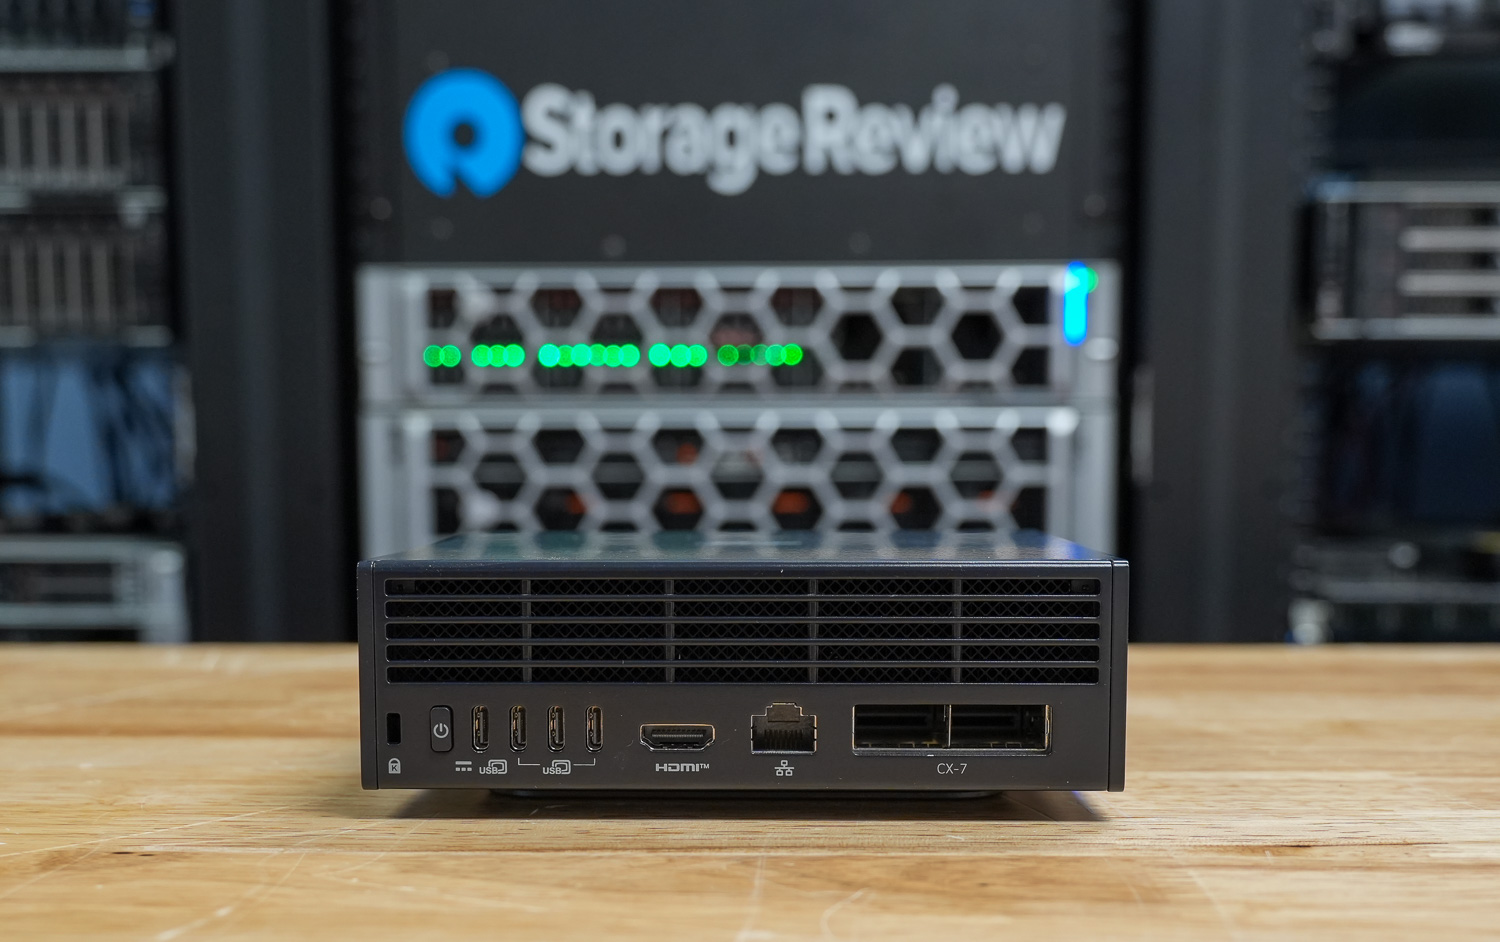
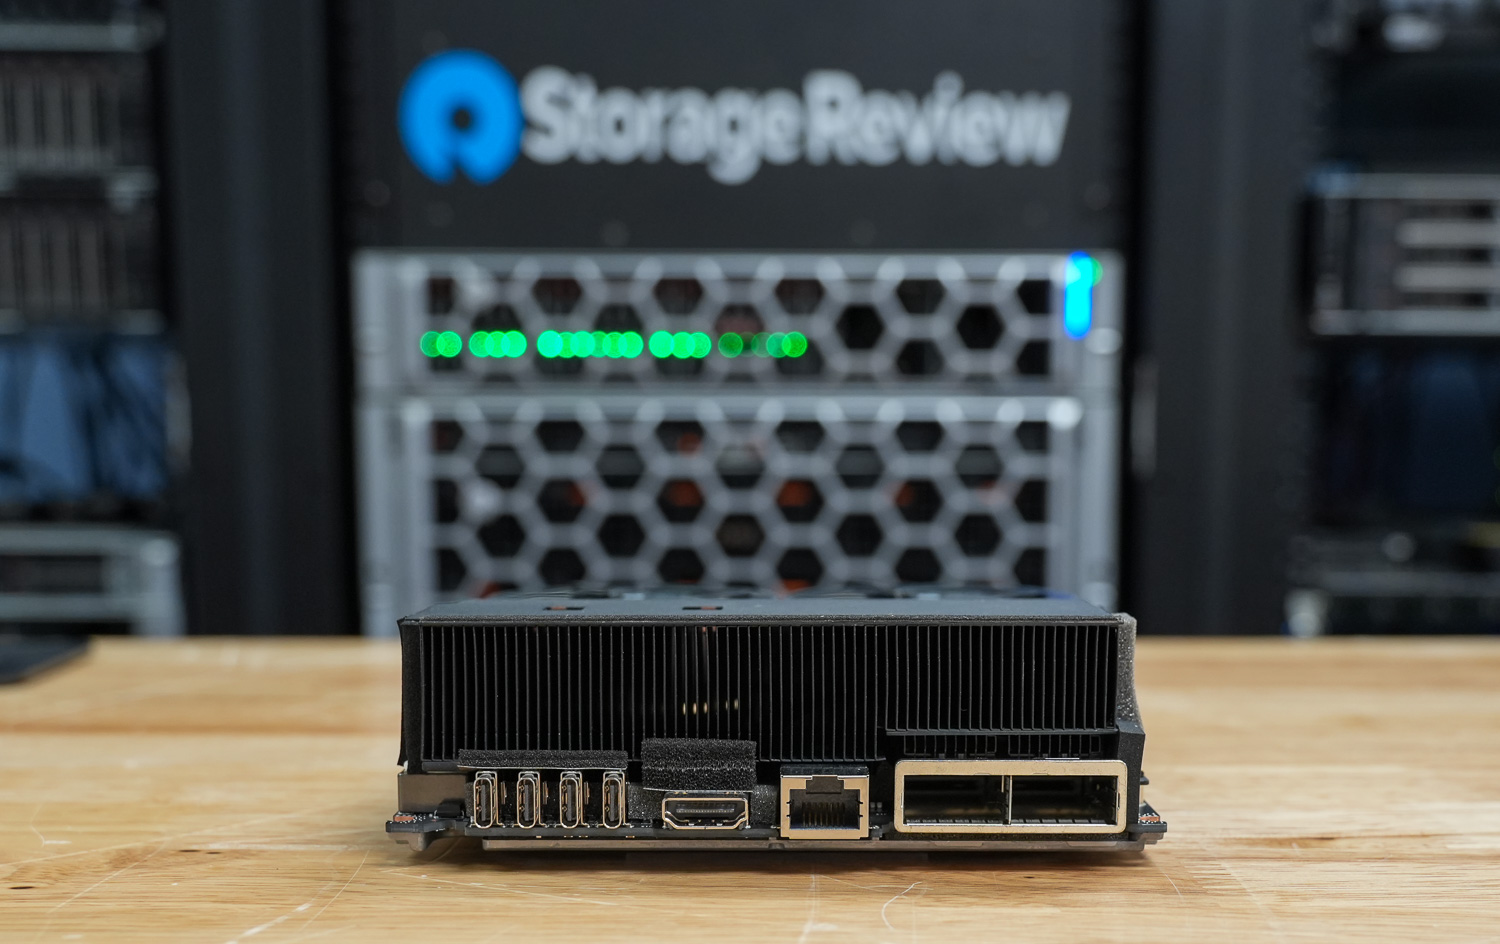
အဓိက I/O အားလုံးကို စနစ်၏နောက်ဘက်တွင် တည်ရှိသည်။ Acer တွင် USB 3.2 Type-C port လေးခုပါဝင်ပြီး တစ်ခုမှာ power delivery ကို ပံ့ပိုးပေးပြီး display output အတွက် HDMI 2.1b port တစ်ခုပါဝင်သည်။ ကွန်ရက်ချိတ်ဆက်မှုတွင် RJ-45 Ethernet port နှင့် NVIDIA ConnectX-7 Smart NIC တို့ ပါဝင်ပြီး bandwidth မြင့်မားစွာ ချိတ်ဆက်နိုင်စေပြီး စနစ်ချိတ်ဆက်နိုင်စေပါသည်။ ကြိုးမဲ့ပံ့ပိုးမှုတွင် Wi-Fi 7 နှင့် Bluetooth 5.1 သို့မဟုတ် နောက်ပိုင်းပါဝင်သည်။ ရုပ်ပိုင်းဆိုင်ရာလုံခြုံရေးအတွက် Kensington lock slot တစ်ခု ရရှိနိုင်ပါသည်။
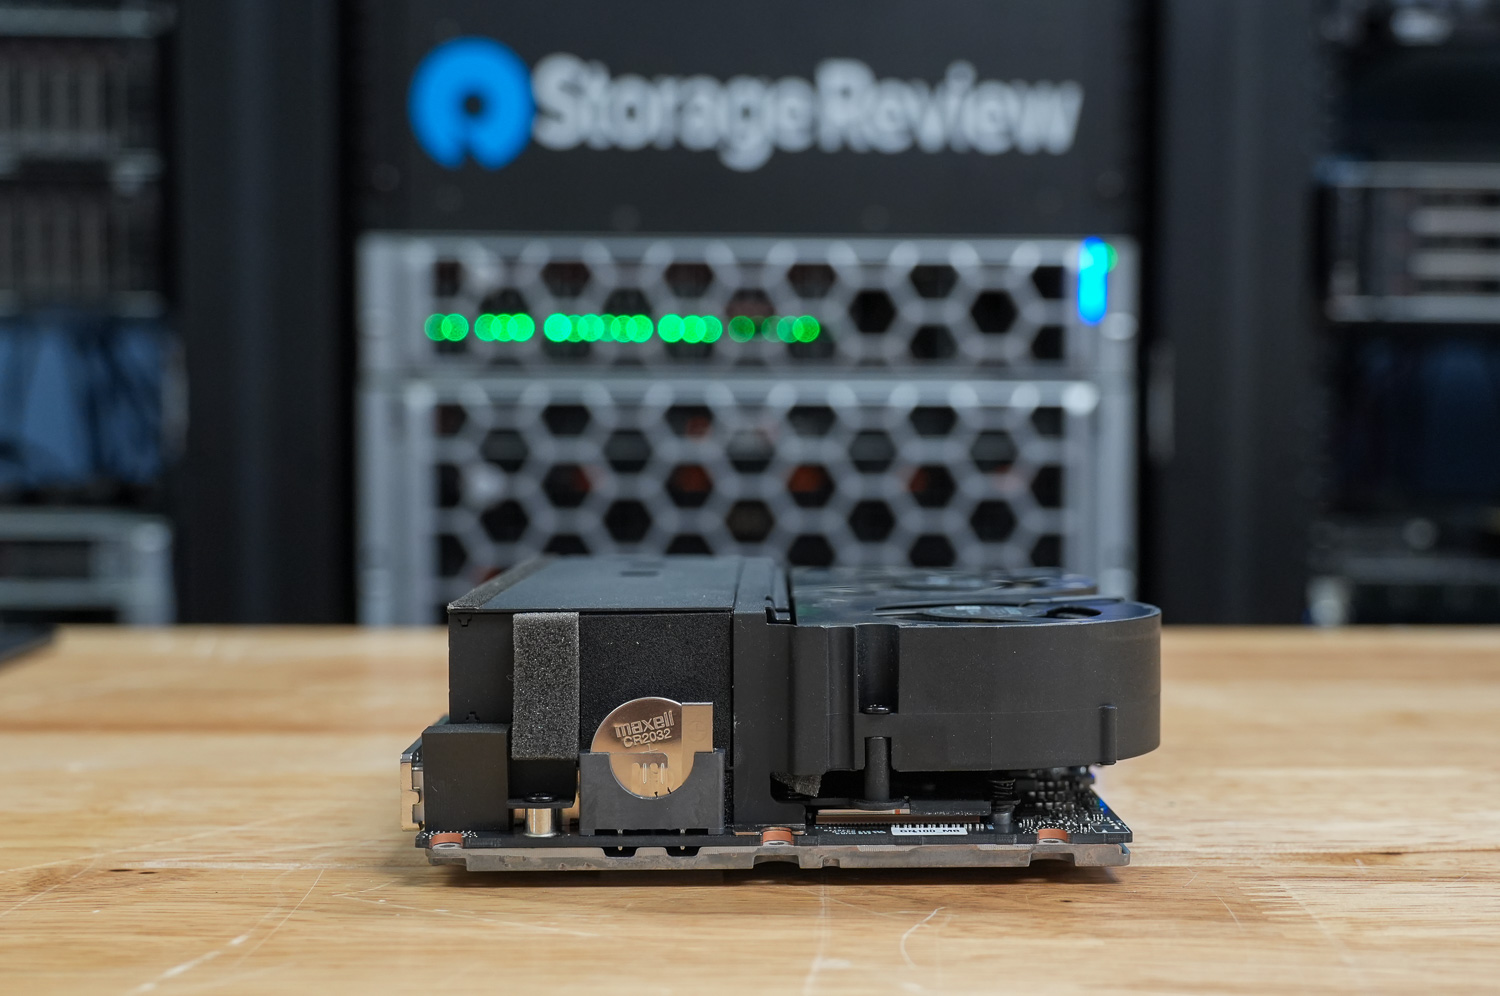
ဤနေရာတွင်၊ အားဖြည့်ဘောင်နှင့် အပူဖြန့်စက် နှစ်မျိုးလုံးအဖြစ် လုပ်ဆောင်သည့် ကိုယ်ထည်တစ်ခုလုံးကို ဖုံးအုပ်ထားသော သတ္တုအကာအကွယ်နှင့် ဖွဲ့စည်းပုံပြားကို သင်တွေ့မြင်နိုင်သည်။ ဘယ်ဘက်အောက်ခြေတွင် အလွယ်တကူ ဝင်ရောက်နိုင်သော M.2 2242 NVMe SSD slot တစ်ခုရှိပြီး ၎င်းကို ဝက်အူတစ်ခုတည်းဖြင့် လုံခြုံစွာ တပ်ဆင်ထားပြီး သတ္တုပြားအောက်တွင် တစ်စိတ်တစ်ပိုင်း ထည့်ထားနိုင်သည်။
Acer ယူနစ်ရဲ့ အောက်ခြေကို ဝင်ရောက်ဖို့အတွက် အောက်ပိုင်း panel ကို သန့်ရှင်းစွာ မြှင့်တင်ဖို့ perimeter screw တွေကို ဖြုတ်လိုက်ပါ။ အထဲကို ရောက်တာနဲ့ layout က ရိုးရှင်းပြီး ကောင်းမွန်စွာ စီစဉ်ထားတာကြောင့် cooling assembly၊ storage area နဲ့ mainboard components တွေကို တိုက်ရိုက်မြင်နိုင်ပါတယ်။ အောက်ခြေ plate ကိုယ်တိုင်က ခိုင်ခံ့ပြီး chassis ရဲ့ အလုံးစုံတောင့်တင်းမှုကို အထောက်အကူပြုပါတယ်။
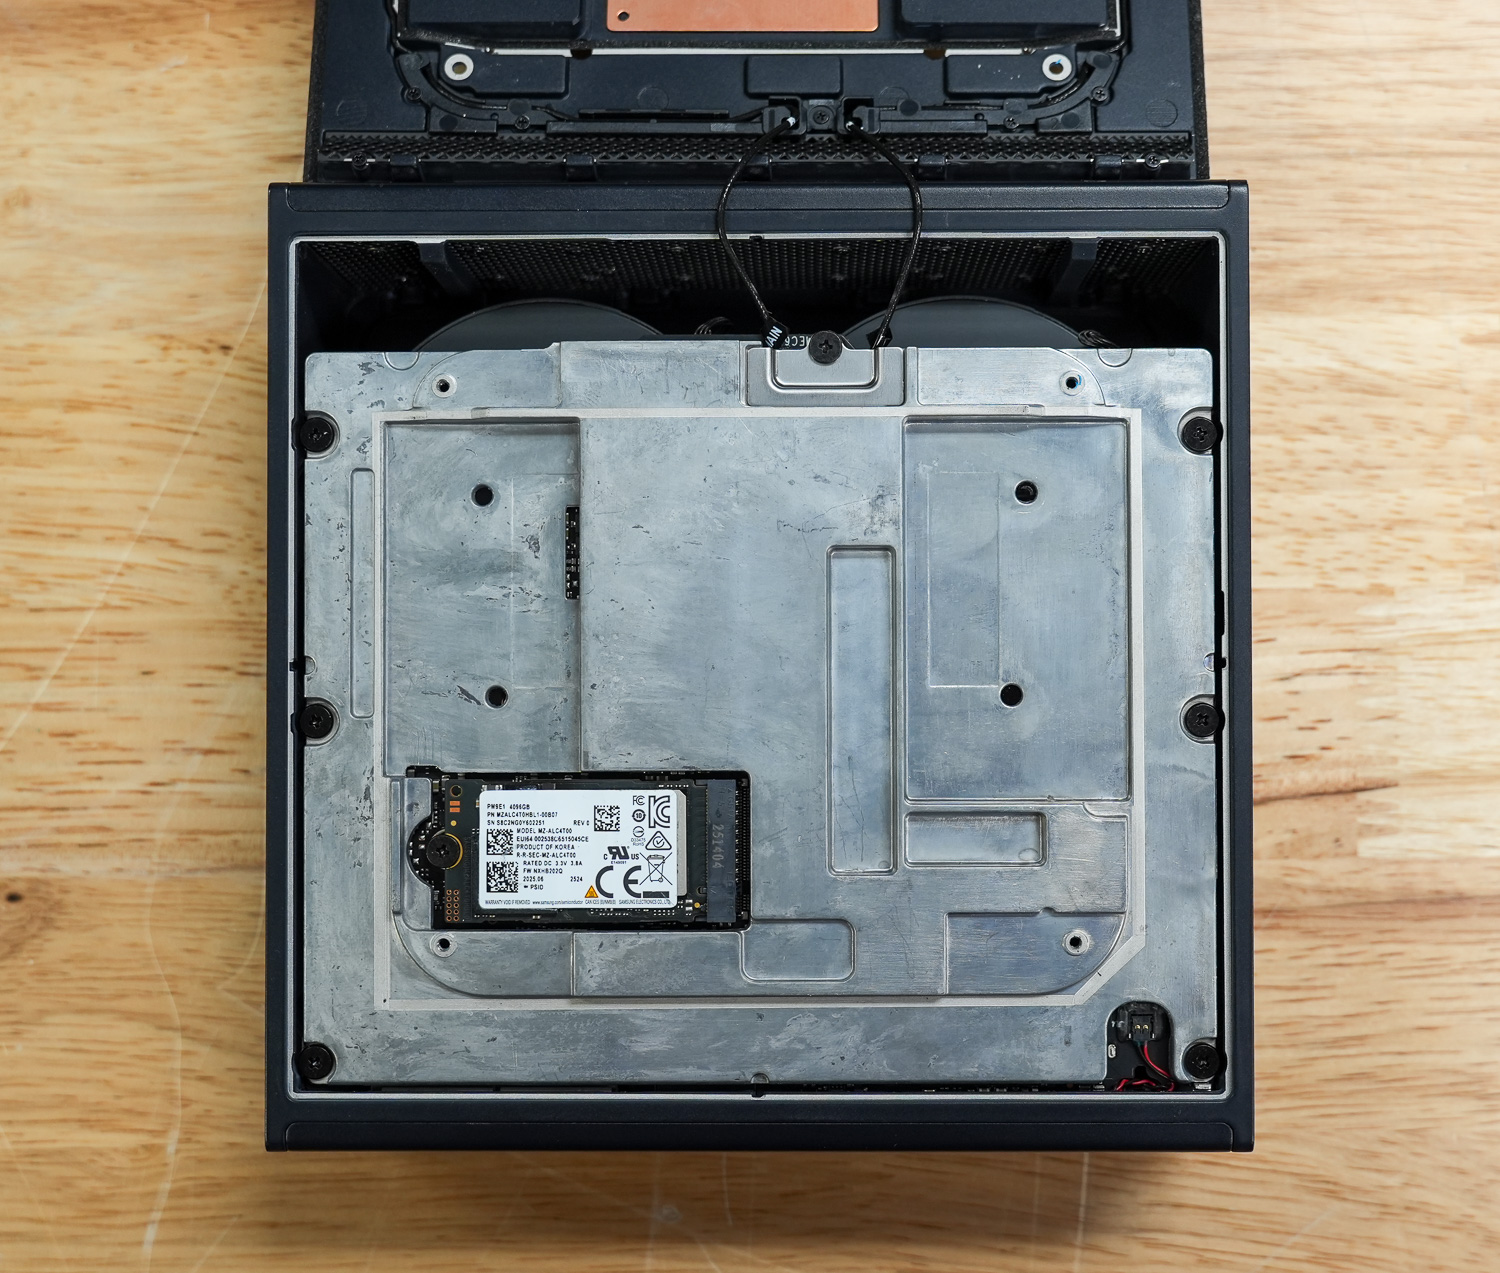
ကျွန်ုပ်တို့ အကဲဖြတ်ထားသော အခြား Spark စနစ်များနှင့် နှိုင်းယှဉ်ပါက Acer သည် ဤနေရာတွင် အနည်းငယ်ကွဲပြားသော ချဉ်းကပ်မှုကို ပြုလုပ်ပါသည်။ Founders Edition နှင့် OEM အကောင်အထည်ဖော်မှုများစွာတွင် ကျွန်ုပ်တို့တွေ့မြင်ခဲ့ရသော ပိုမိုသပ်ရပ်သော ဆေးသုတ်ထားသော သတ္တုအောက်ခြေပြားအစား Acer သည် ကုန်ကြမ်း၊ မပြီးဆုံးသေးသော သွန်းလောင်းထားသော သတ္တုအောက်ခြေပြားကို အသုံးပြုသည်။ အပြီးသတ်သည် ඔප දැමීමနည်းပြီး ပုံသွင်းအသွင်အပြင်ကို မြင်နိုင်သော်လည်း ထူထဲပြီး ဖွဲ့စည်းတည်ဆောက်ပုံ ကောင်းမွန်နေဆဲဖြစ်သည်။ လုပ်ဆောင်နိုင်စွမ်းအရ ၎င်းသည် အားဖြည့်ဘောင်နှင့် ဒုတိယအပူဖြန့်စက်အဖြစ် ရည်ရွယ်ချက်တူညီနေဆဲဖြစ်သော်လည်း ထုတ်လုပ်မှုရွေးချယ်မှုသည် ကွဲပြားသောဒီဇိုင်းနှင့် ကုန်ကျစရိတ်အတွေးအခေါ်ကို ရှင်းရှင်းလင်းလင်းထင်ဟပ်စေသည်။
Acer Veriton GN100 AI အပူချိန်စမ်းသပ်ခြင်း
Acer Veriton GN100 AI thermals တွေကို စမ်းသပ်ဖို့အတွက် Founders Edition နဲ့ Dell, ASUS နဲ့ GIBABYTE လို OEM တွေနဲ့ နှိုင်းယှဉ်ခဲ့ပါတယ်။ ဒီအကြောင်းကို ကျွန်တော်တို့ရဲ့ Spark Thermal Testing စာတမ်း မှာ အသေးစိတ် လေ့လာခဲ့ပါတယ် ။
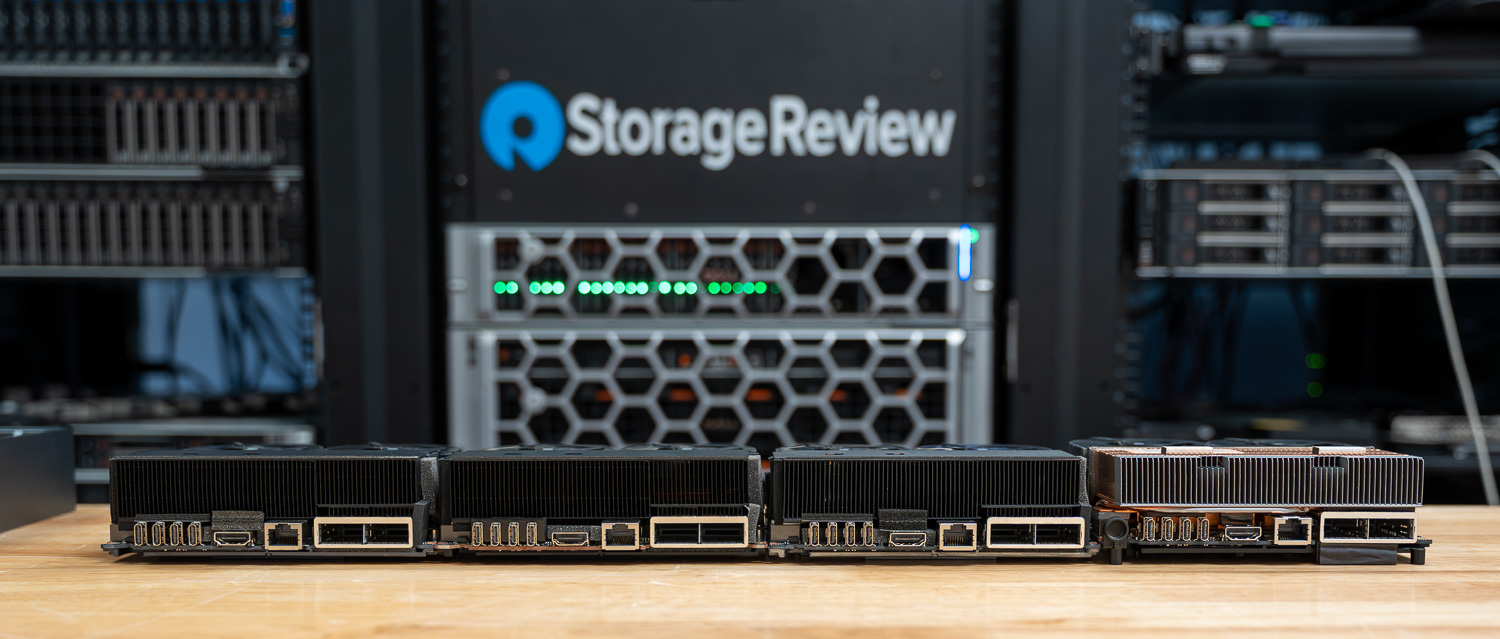
stack တစ်လျှောက်မှာ၊ ကျွန်ုပ်တို့သည် workload အတွက် အဆင့်သုံးဆင့်ဖြင့် သတ်မှတ်ထားသော အချိန်ကာလတစ်ခုအတွင်း component များကို စောင့်ကြည့်ခဲ့ပြီး တစ်နာရီခန့်ကြာ utilization ကို မြှင့်တင်ပေးခဲ့ပါသည်။ ၎င်းက device ကို ကြာရှည်စွာအသုံးပြုမှုနှင့် workload အဆင့်အမျိုးမျိုးတွင် မြင်တွေ့နိုင်စေခဲ့ပါသည်။ ကျွန်ုပ်တို့သည် CPU၊ GPU၊ network၊ NVMe အပူချိန်နှင့် စုစုပေါင်းပါဝါသုံးစွဲမှုကို စောင့်ကြည့်ခဲ့ပါသည်။
CPU အပူချိန်
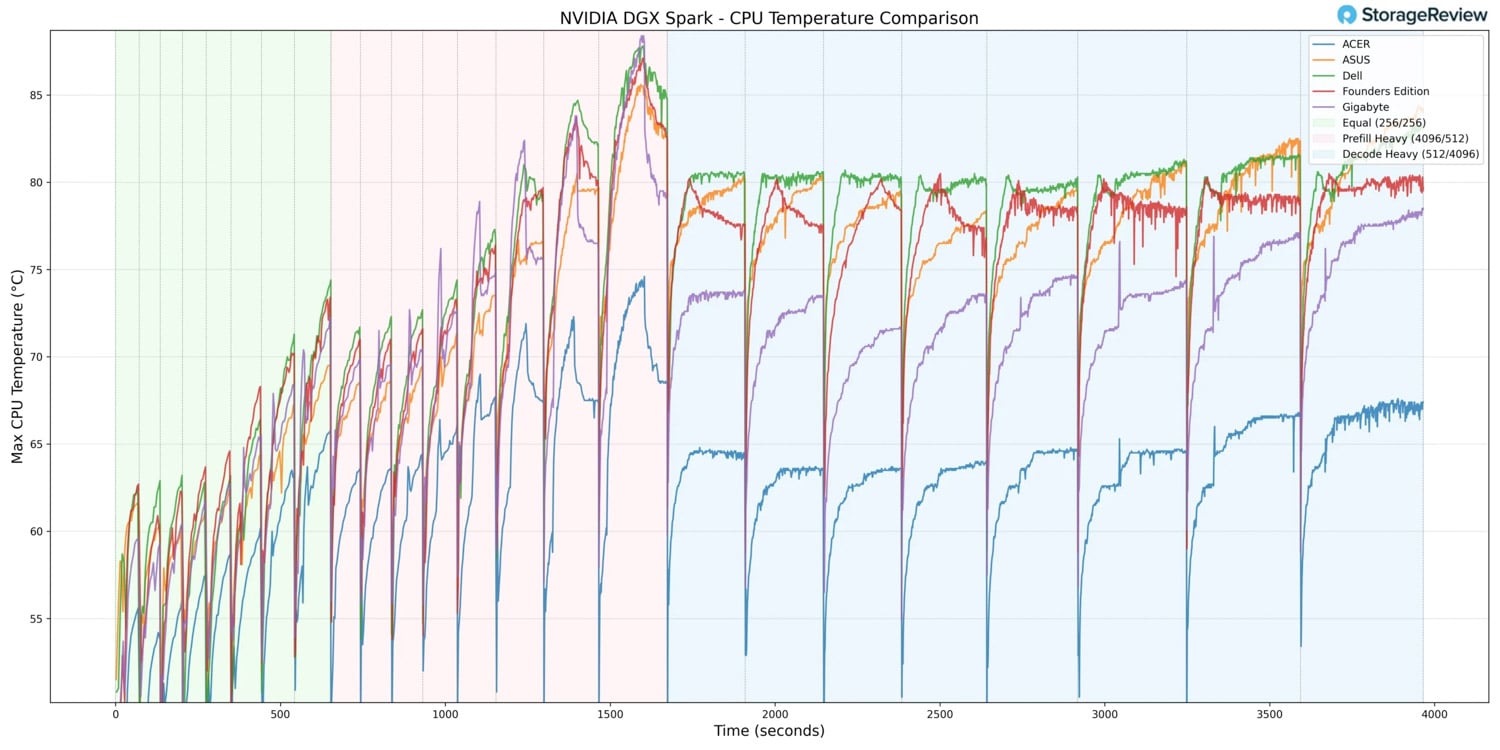
CPU အပူချိန်စမ်းသပ်မှုအတွင်း Acer စနစ်သည် burst-heavy Prefill လုပ်ဆောင်ချက်အတွင်း အမြင့်ဆုံးအပူချိန် 74.7°C သို့ ရောက်ရှိခဲ့သည်။ ၎င်းသည် နှိုင်းယှဉ်အုပ်စုတွင် တွေ့ရှိရသည့် အနိမ့်ဆုံး CPU အပူချိန်များထဲမှ တစ်ခုကို ကိုယ်စားပြုပြီး သိသိသာသာ ထိန်းသိမ်းထားသော သို့မဟုတ် ထိရောက်သော အပူချိန်အကောင်အထည်ဖော်မှုကို ညွှန်ပြနေသည်။
အလုပ်ပမာဏသည် Equal ISL/OSL သို့ ကူးပြောင်းပြီး Decode Heavy အဆင့်များကို စဉ်ဆက်မပြတ် မြှင့်တင်လာသည်နှင့်အမျှ CPU အပူချိန်များသည် ပြင်းထန်သော မြှင့်တင်မှုမရှိဘဲ ကောင်းစွာ ထိန်းချုပ်ထားနိုင်ခဲ့သည်။ ပြိုင်ဘက်စနစ်အချို့တွင် တွေ့ရသည့် အထက် 80°C အတိုင်းအတာသို့ မြင့်တက်မည့်အစား Acer သည် လည်ပတ်မှု band နိမ့်ကျမှုကို ထိန်းသိမ်းထားနိုင်ခဲ့ပြီး ရှည်လျားသော compute load အောက်တွင် အအေးပေးနိုင်စွမ်း မြင့်မားမှုကို ထင်ဟပ်စေခဲ့သည်။
အနိမ့်ဆုံးအဆင့်မှာ CPU ဟာ အားလပ်ချိန် ဒါမှမဟုတ် ပေါ့ပါးတဲ့ ဝန်အားအခြေအနေတွေမှာ အနည်းဆုံး ၃၇.၈°C အပူချိန်ကို မှတ်တမ်းတင်ထားပါတယ်။ ဒီအခြေခံစံနှုန်းက ပိုကျယ်ပြန့်တဲ့ stack နဲ့ ကိုက်ညီပြီး Acer ရဲ့ အအေးပေးစနစ်ဟာ အနားယူနေချိန်မှာရော ဝန်အားအောက်မှာပါ ထိရောက်မှုရှိနေဆဲဖြစ်ကြောင်း အားဖြည့်ပေးပါတယ်။
အလုံးစုံသော် Acer သည် burst နှင့် sustained phases နှစ်မျိုးလုံးတွင် အုပ်စုတွင် အအေးဆုံး CPU thermal profiles များထဲမှ တစ်ခုကို ပေးပို့ခဲ့သည်။
GPU အပူချိန်
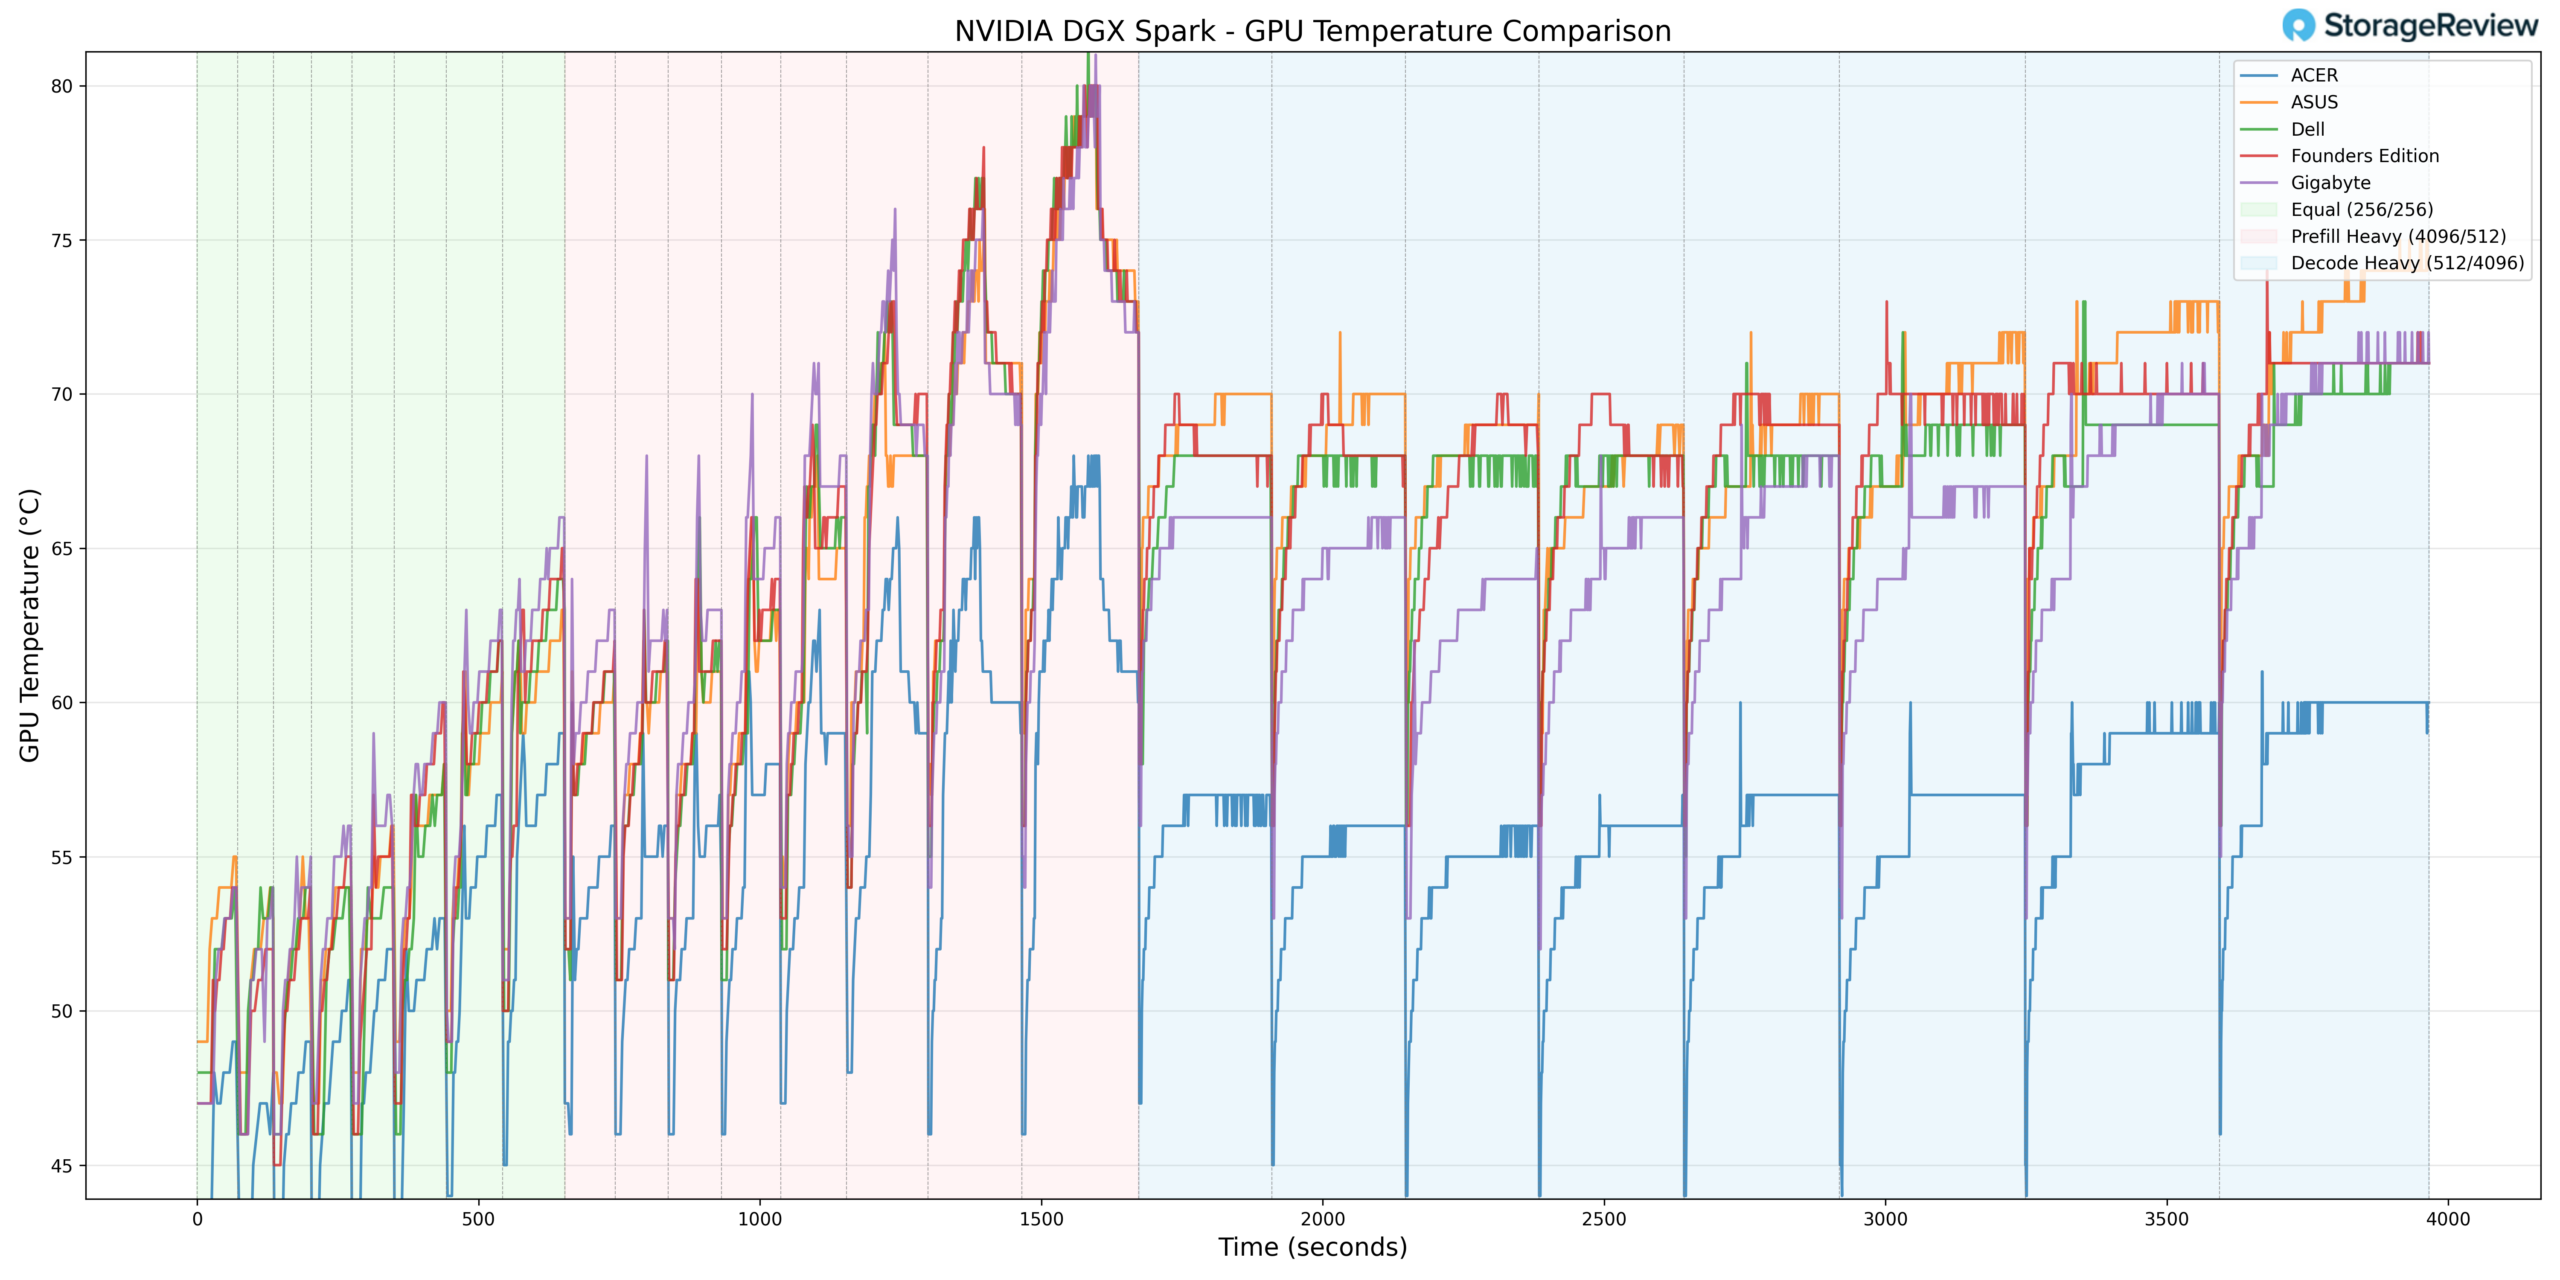
GPU အပူချိန်များသည် အလားတူ ထိန်းညှိမှုပုံစံကို လိုက်နာခဲ့သည်။ Prefill Heavy အရှိန်မြှင့်မှုအတွင်း GPU သည် အမြင့်ဆုံးအပူချိန် 69°C သို့ ရောက်ရှိခဲ့ပြီး ၎င်းသည် burst activity အတွင်း ယှဉ်ပြိုင်သည့် အကောင်အထည်ဖော်မှုများစွာထက် သိသိသာသာ နိမ့်ကျပါသည်။
အလုပ်ပမာဏများသည် Equal ISL/OSL နှင့် Decode Heavy အဆင့်များအထိ တိုးတက်လာသည်နှင့်အမျှ GPU သည် သိသာထင်ရှားသော အပူချိန်မြင့်တက်မှုများမရှိဘဲ ထိန်းချုပ်ထားသော အကွာအဝေးတွင် တည်ငြိမ်လာခဲ့သည်။ စနစ်သည် စဉ်ဆက်မပြတ် decoding အောက်တွင် တည်ငြိမ်သော အပြုအမူကို ပြသခဲ့ပြီး၊ အထက်လည်ပတ်မှုကန့်သတ်ချက်များအောက်တွင် ကျယ်ပြန့်သော အနားသတ်ကို ထိန်းသိမ်းထားခဲ့သည်။
မှတ်တမ်းတင်ထားသော အနိမ့်ဆုံး GPU အပူချိန်မှာ ပိုမိုပေါ့ပါးသောအဆင့်များတွင် 35°C ရှိပြီး stack တွင် အနိမ့်ဆုံး idle baselines များထဲမှ တစ်ခုဖြစ်သည်။
အားလုံးကို ခြုံငုံကြည့်လျှင် Acer သည် burst နှင့် sustained workloads နှစ်မျိုးလုံးအောက်တွင် အအေးဆုံး GPU အကောင်အထည်ဖော်မှုများထဲမှ တစ်ခုကို ပြသခဲ့သည်။
NVMe အပူချိန်
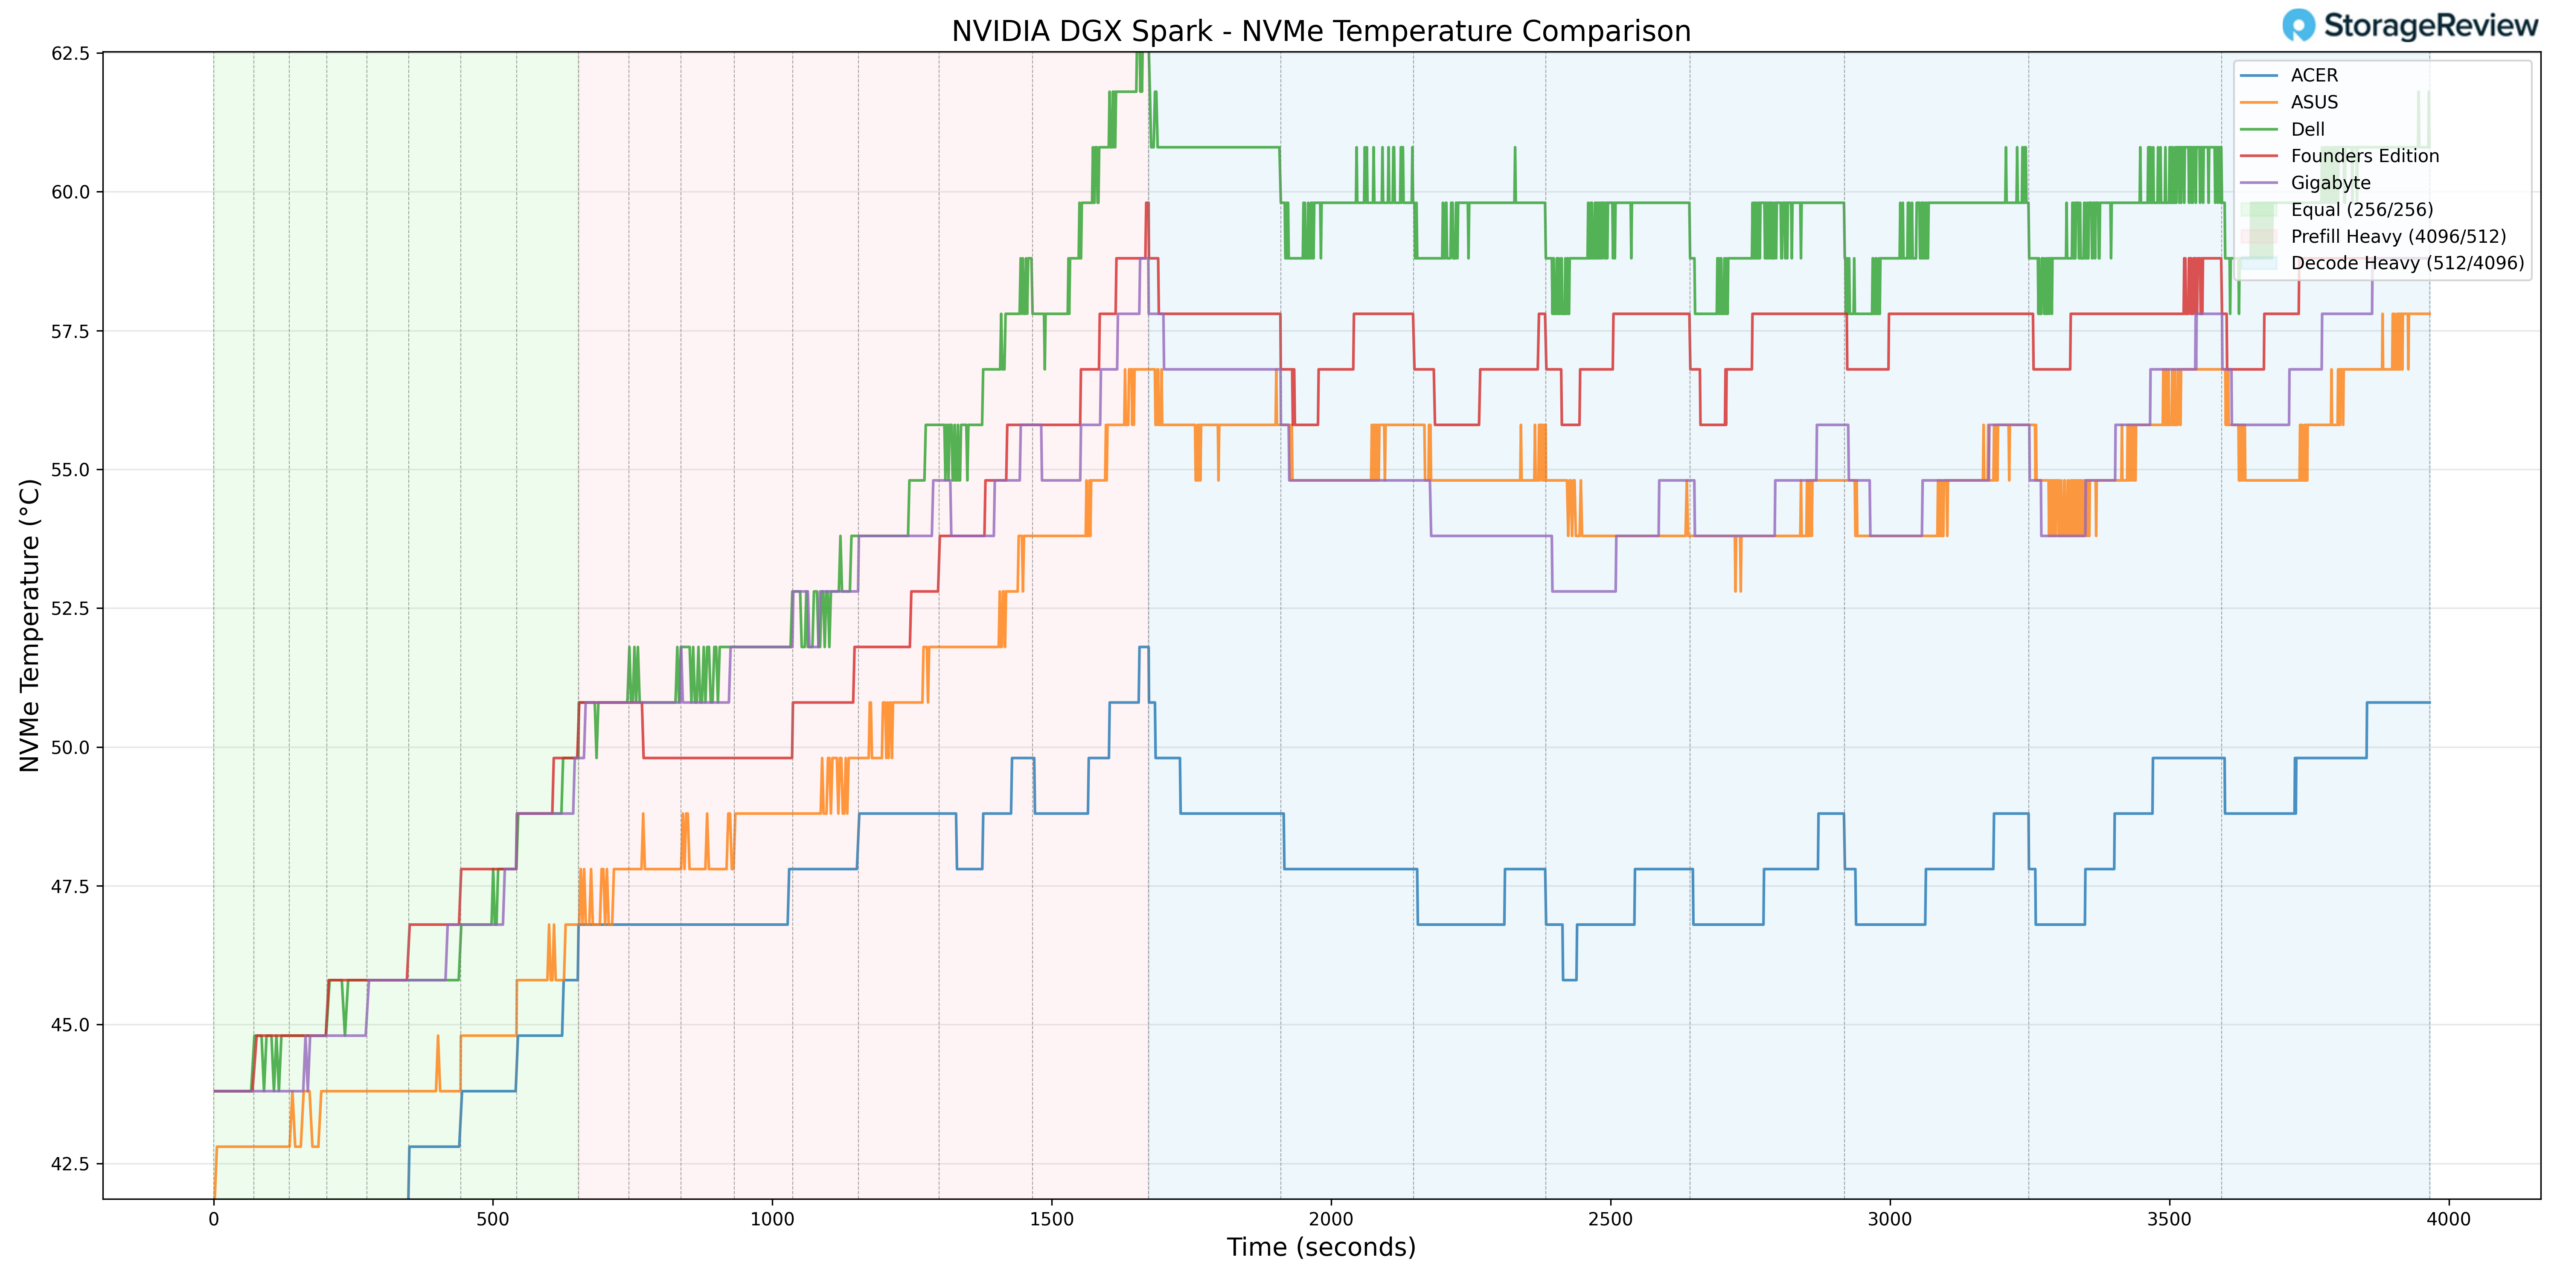
သိုလှောင်မှုအပူချိန်များသည် စမ်းသပ်မှုတစ်လျှောက်လုံးတွင် သတ်မှတ်ချက်အတွင်း ကောင်းစွာရှိနေခဲ့သည်။ NVMe drive သည် အလုပ်ဝန်များသောအဆင့်များတွင် 56.8°C တွင် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး၊ အဖြစ်များသော throttling thresholds အောက်တွင် သက်တောင့်သက်သာရှိနေကာ အဖွဲ့၏ ပိုမိုအလယ်အလတ်သိုလှောင်မှုရလဒ်များနှင့် ကိုက်ညီခဲ့သည်။
အားလပ်ချိန် သို့မဟုတ် ပေါ့ပါးသောအသုံးပြုမှုတွင် NVMe အပူချိန်သည် 36.8°C အထိ ကျဆင်းသွားခဲ့ပြီး သိုလှောင်မှုစနစ်သည် ဝန်နည်းသည့်အခါတွင် အပူချိန်ကန့်သတ်ချက်မရှိကြောင်း ညွှန်ပြနေသည်။
အလုံးစုံသော် Acer သည် ယှဉ်ပြိုင်နိုင်သော NVMe အပူချိန်များကို ထိန်းသိမ်းထားနိုင်ခဲ့ပြီး နိမ့်ကျသော အပူချိန်များနှင့် တည်ငြိမ်သော အခြေခံအပြုအမူကို တွဲဖက်ပေးထားသည်။
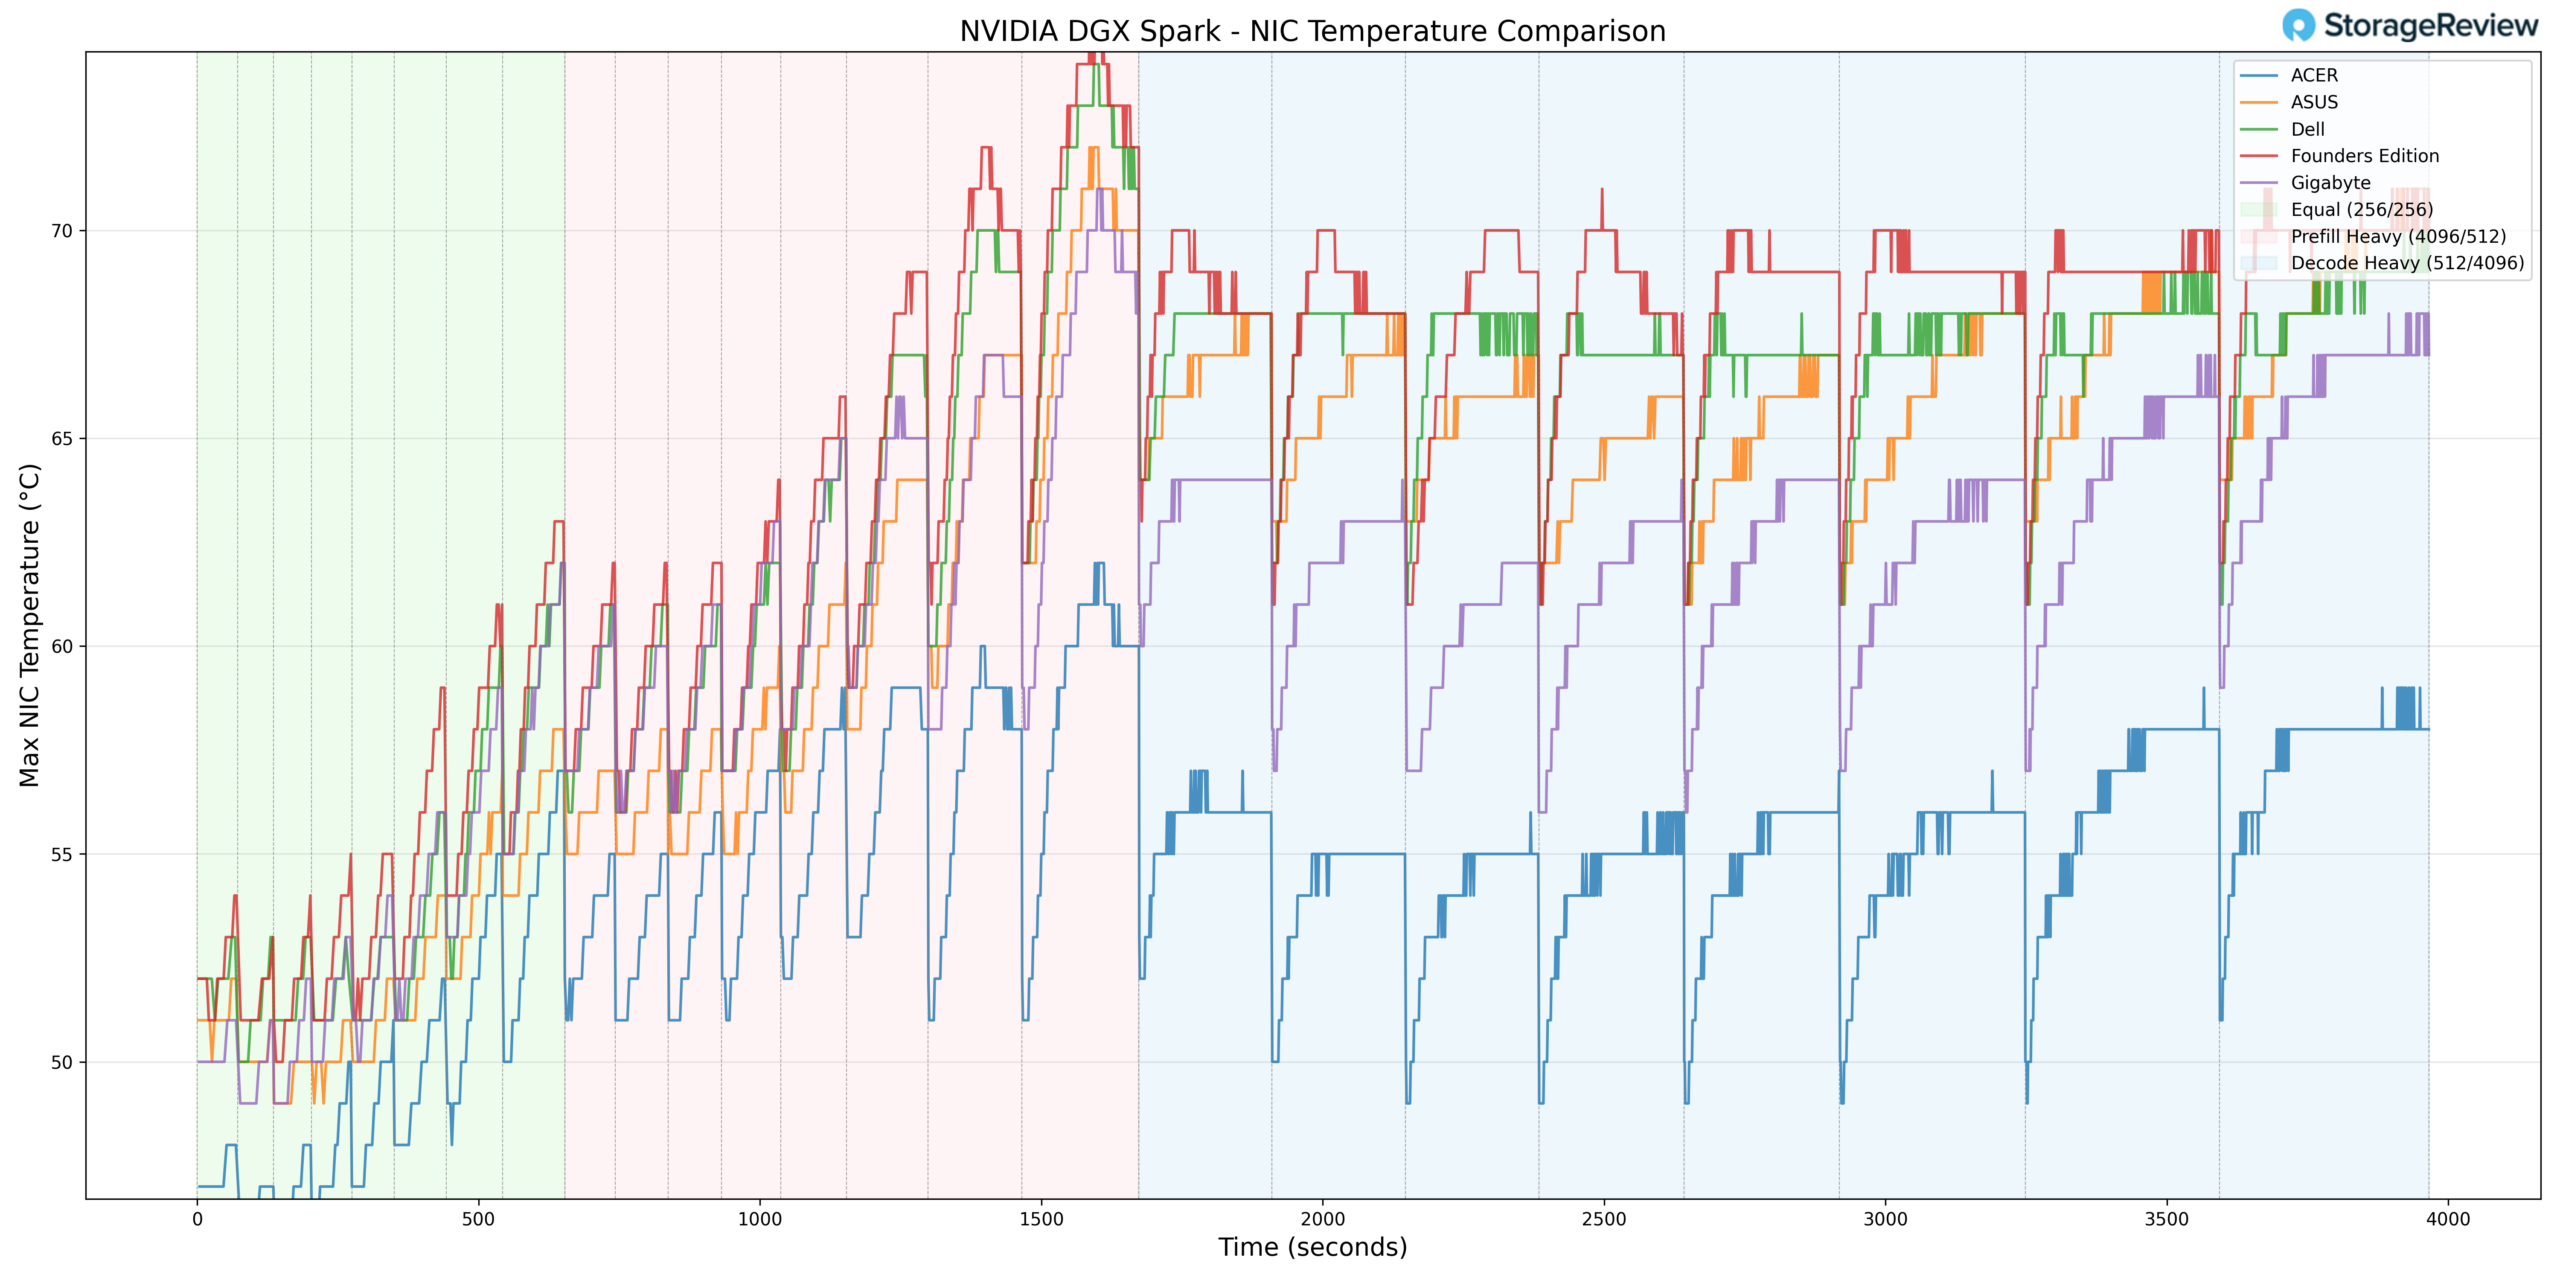
NIC အပူချိန်
NIC အပူချိန်များသည် အလုပ်များသောအဆင့်များတွင် 61°C တွင် အမြင့်ဆုံးရောက်ရှိခဲ့သည်။ ၎င်းသည် နှိုင်းယှဉ်အုပ်စုတွင် တွေ့ရှိရသည့် အနိမ့်ဆုံး NIC အပူချိန်များထဲမှ တစ်ခုကို ကိုယ်စားပြုပြီး ကိုယ်ထည်အတွင်း ထိရောက်သော လေစီးဆင်းမှု သို့မဟုတ် အစိတ်အပိုင်းနေရာချထားမှုကို ညွှန်ပြနေသည်။
မှတ်တမ်းတင်ထားသော အနိမ့်ဆုံး NIC အပူချိန်မှာ ပိုမိုပေါ့ပါးသောအဆင့်များတွင် 39°C ရှိပြီး၊ အခြေခံအပူအပြုအမူကို ထပ်မံထင်ဟပ်စေပါသည်။
စမ်းသပ်မှုတစ်လျှောက်လုံးတွင် ကွန်ရက်ထိန်းချုပ်ကိရိယာသည် အလွန်အကျွံ ချိန်ညှိခြင်းမရှိဘဲ workload demand နှင့် အချိုးကျခြေရာခံခဲ့သည်။
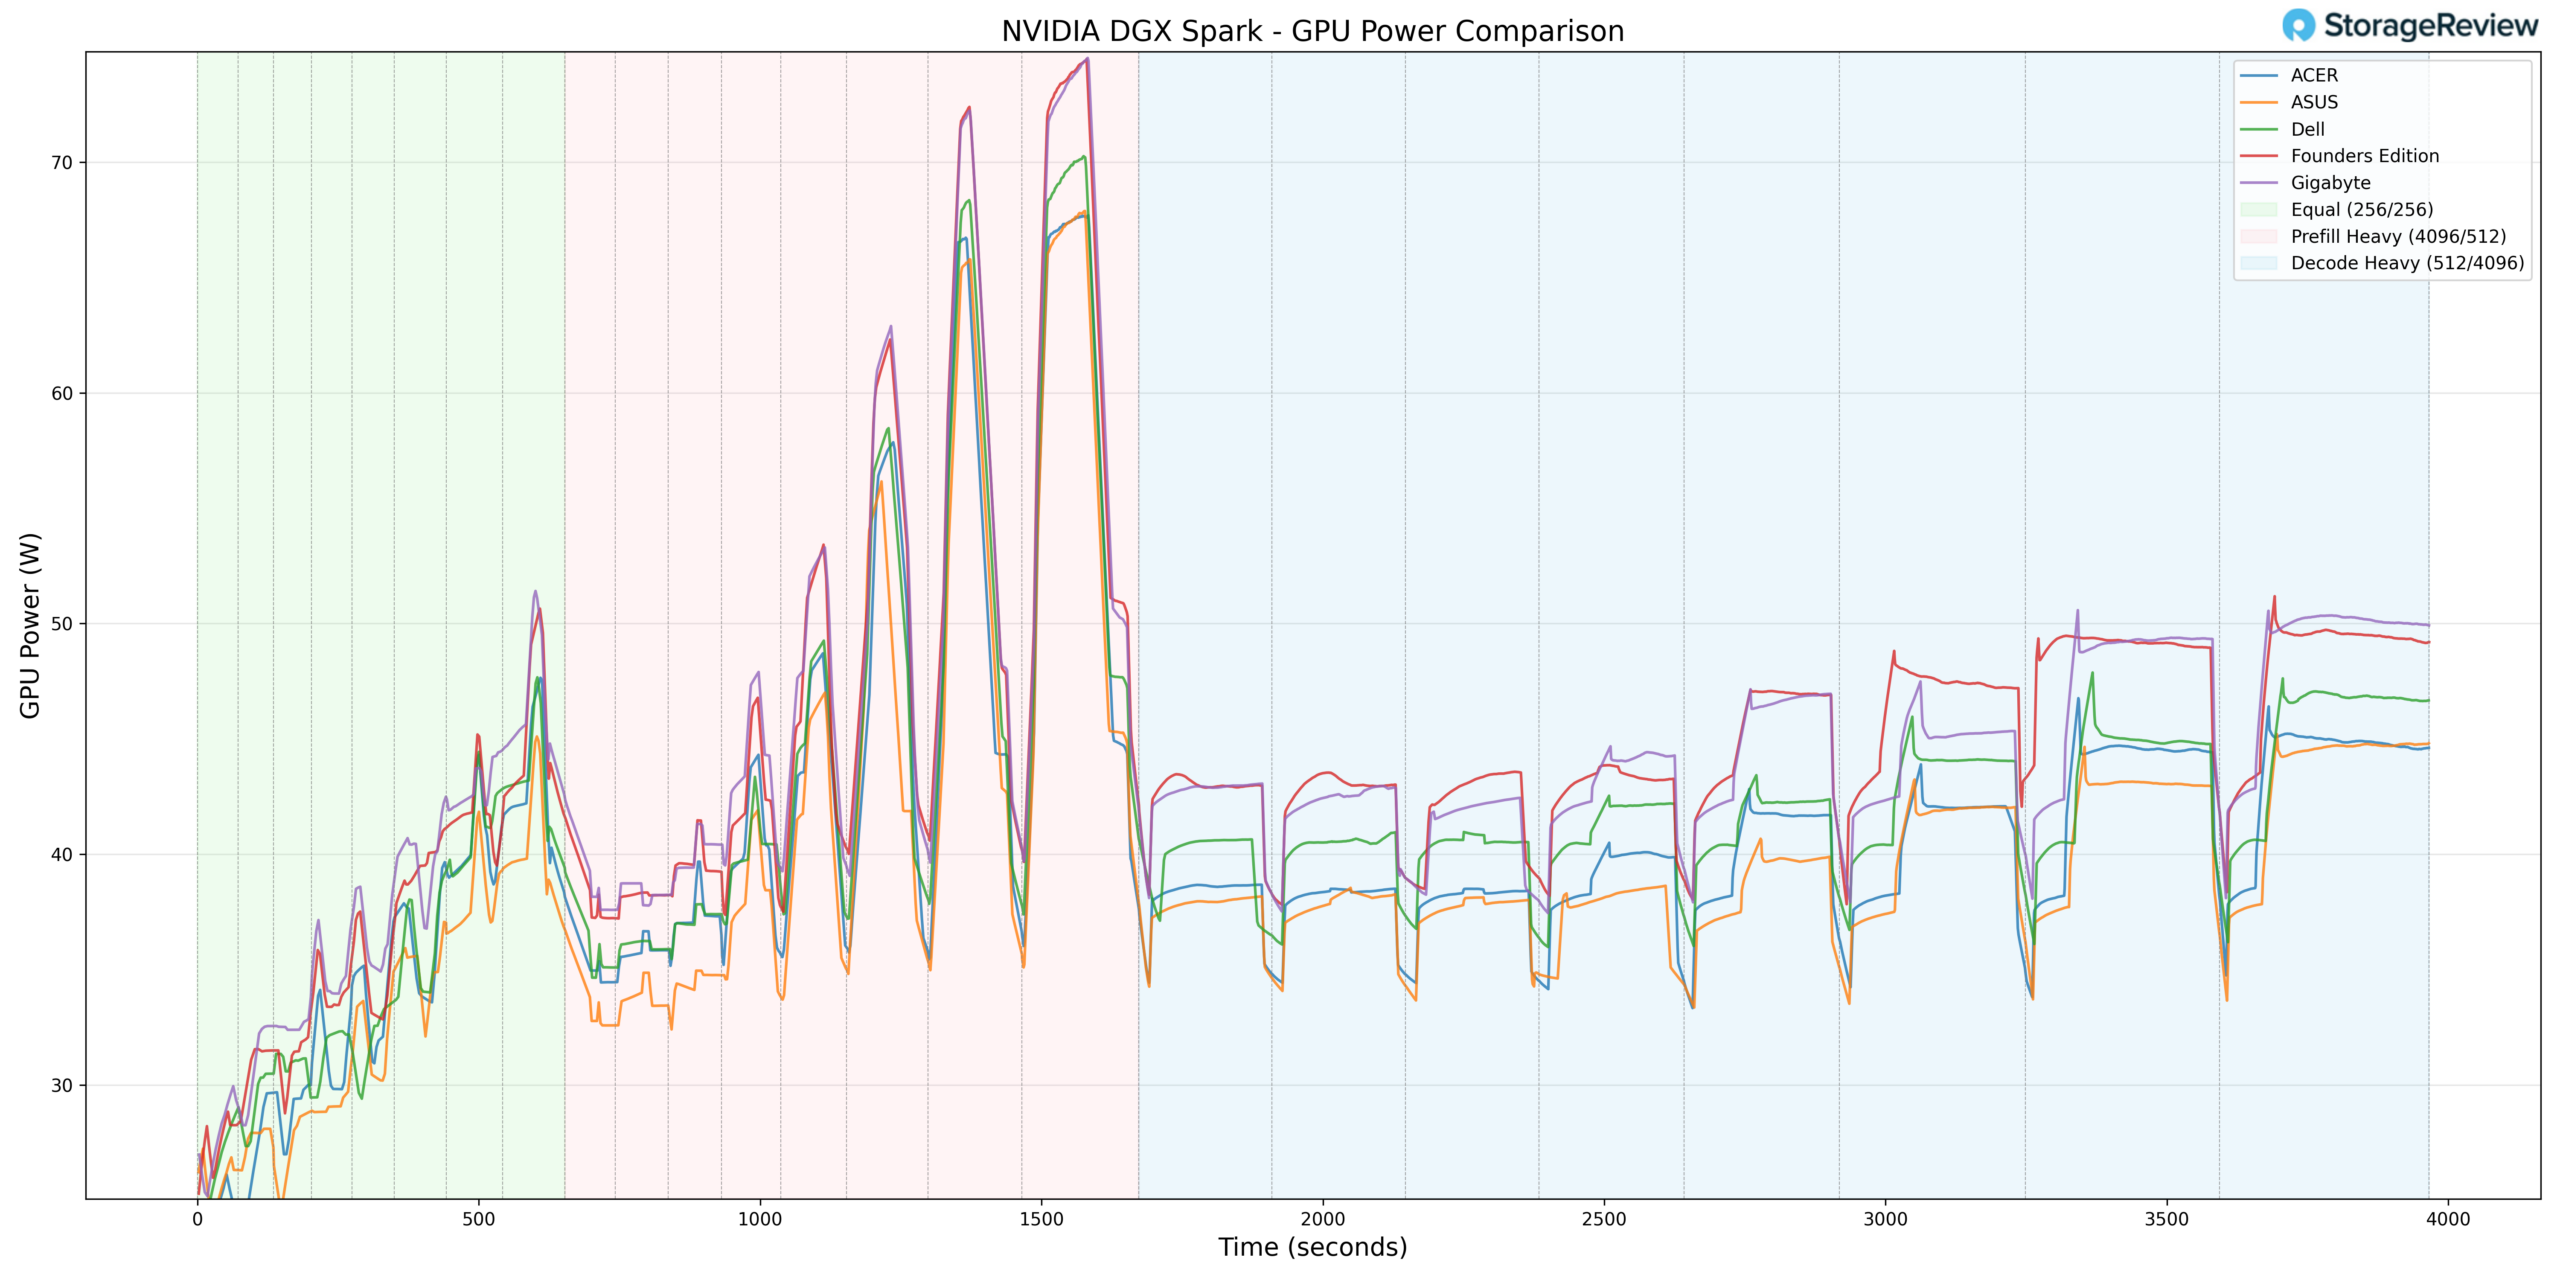
GPU ပါဝါသုံးစွဲမှု
Prefill Heavy အကူးအပြောင်းများအတွင်း GPU ပါဝါသုံးစွဲမှုသည် 69.18W တွင် အမြင့်ဆုံးသို့ ရောက်ရှိခဲ့သည်။ ၎င်းသည် Acer ကို GB10 stack အတွင်း တွေ့ရှိရသည့် အမြင့်ဆုံးပါဝါ ceilings အောက်တွင် အနည်းငယ်နိမ့်ကျစေသည်။
အနိမ့်ဆုံးပါဝါခွဲဝေမှုသည် Acer ၏ အေးမြသော GPU အပူချိန်ပရိုဖိုင်နှင့် တိုက်ရိုက်ဆက်စပ်နေသည်။ ပါဝါအဖုံး၏ အပေါ်ဆုံးကန့်သတ်ချက်သို့ ရန်လိုစွာတွန်းအားပေးမည့်အစား Acer သည် စွမ်းဆောင်ရည်နှင့် အပူချိန်ထိရောက်မှုကို ဟန်ချက်ညီအောင်ထိန်းညှိပေးပုံရပြီး burst phase များအတွင်း အစိတ်အပိုင်းအပူချိန်များကို အဆက်မပြတ်နိမ့်ကျစေသည်။
Decode workloads များကို စဉ်ဆက်မပြတ်လုပ်ဆောင်နေစဉ်အတွင်း ပါဝါသုံးစွဲမှုသည် workload demand နှင့်အညီ တည်ငြိမ်ပြီး ခန့်မှန်းနိုင်ခဲ့ပါသည်။
အပူချိန်အကျဉ်းချုပ်
CPU၊ GPU၊ NVMe နှင့် NIC စောင့်ကြည့်မှုတစ်လျှောက်တွင် Acer GB10 သည် နှိုင်းယှဉ်အုပ်စုတွင် အအေးဆုံး ಒಟ್ಟಾರೆ အပူချိန်ပရိုဖိုင်ကို ပြသခဲ့သည်။ ပေါက်ကွဲမှုများသော အကူးအပြောင်းများအတွင်း CPU သည် 74.7°C နှင့် GPU သည် 69°C တွင် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး NVMe သည် 57°C အောက်တွင် ရှိနေခဲ့ပြီး NIC သည် 61°C တွင် အမြင့်ဆုံးရောက်ရှိခဲ့သည်။ GPU ပါဝါသုံးစွဲမှုသည် 69.18W တွင် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး stack တွင် အမြင့်ဆုံးတွေ့ရှိရသော တန်ဖိုးများထက် အနည်းငယ်နိမ့်ကျနေပါသည်။
အလုံးစုံပြောရလျှင် Acer ၏ အကောင်အထည်ဖော်မှုသည် အပူချိန်ထိရောက်မှုနှင့် ရေရှည်တည်ငြိမ်မှုကို ဦးစားပေးပြီး ပြင်းထန်သော အလုပ်ဝန်ပြောင်းလဲမှုများအတွင်း သိသာထင်ရှားသော အလုပ်ဝန်ကို ထိန်းသိမ်းထားစဉ် ကြာရှည်သော ဝန်အောက်တွင် တသမတ်တည်း စွမ်းဆောင်ရည်ကို ပေးဆောင်ပါသည်။
Acer Veriton GN100 စွမ်းဆောင်ရည်စမ်းသပ်ခြင်း
Acer Veriton GN100 ကို အကဲဖြတ်ရန်အတွက်၊ ကျွန်ုပ်တို့သည် Spark ယူနစ်များကို စမ်းသပ်ခဲ့ပြီး၊ ၎င်းသည် ဘာသာစကားကြီးများအတွက် အကျယ်ပြန့်ဆုံး အသုံးပြုထားသော high-throughput inference နှင့် serving engine ဖြစ်သည့် vLLM Online Serving benchmark ကို အသုံးပြုခဲ့သည်။ vLLM online serving benchmark သည် လည်ပတ်နေသော vLLM server သို့ concurrent request များပေးပို့ခြင်းဖြင့် လက်တွေ့ကမ္ဘာ production workloads များကို တုပပြီး စုစုပေါင်း total token throughput (tokens per second)၊ ပထမဆုံး token သို့ရောက်ရှိချိန်နှင့် output token တစ်ခုလျှင် အချိန်အပါအဝင် အဓိက metrics များကို load condition အမျိုးမျိုးတွင် တိုင်းတာသည်။
ကျွန်ုပ်တို့၏ စမ်းသပ်မှုတွင် dense architectures မှ micro-scaling data types အထိ မော်ဒယ်အမျိုးမျိုး ပါဝင်သည်။ စမ်းသပ်မှုများသည် workload scenarios သုံးမျိုးဖြစ်သည့် Equal ISL/OSL၊ Prefill Heavy နှင့် Decode Heavy တို့တွင် စွမ်းဆောင်ရည်ကို အကဲဖြတ်ခဲ့သည်။ ဤ scenarios များသည် balanced input နှင့် output loads များမှ compute-intensive prompt processing နှင့် memory-bandwidth-bound token generation အထိ ကွဲပြားသော real-world serving patterns များကို ကိုယ်စားပြုသည်။
Acer Veriton GN100 အပြင်၊ ASUS၊ Dell နှင့် GIGABYTE မှ OEM စနစ်များနှင့်အတူ NVIDIA Founders Edition Spark ကို ရည်ညွှန်းချက်အဖြစ် benchmark လုပ်ခဲ့ပါသည်။ ၎င်းက Acer ၏ရလဒ်များကို ပိုမိုကျယ်ပြန့်သော ယှဉ်ပြိုင်မှုရှုခင်းအတွင်း ထည့်သွင်းနိုင်စေပြီး ၎င်းသည် မည်သည့်နေရာတွင် ဦးဆောင်နေသည်၊ မည်သည့်နေရာတွင် လိုက်မီနေသည် သို့မဟုတ် မတူညီသော မော်ဒယ်များနှင့် workload အမျိုးအစားများတွင် ခြေရာခံနေသည်ကို နားလည်နိုင်စေခဲ့ပါသည်။
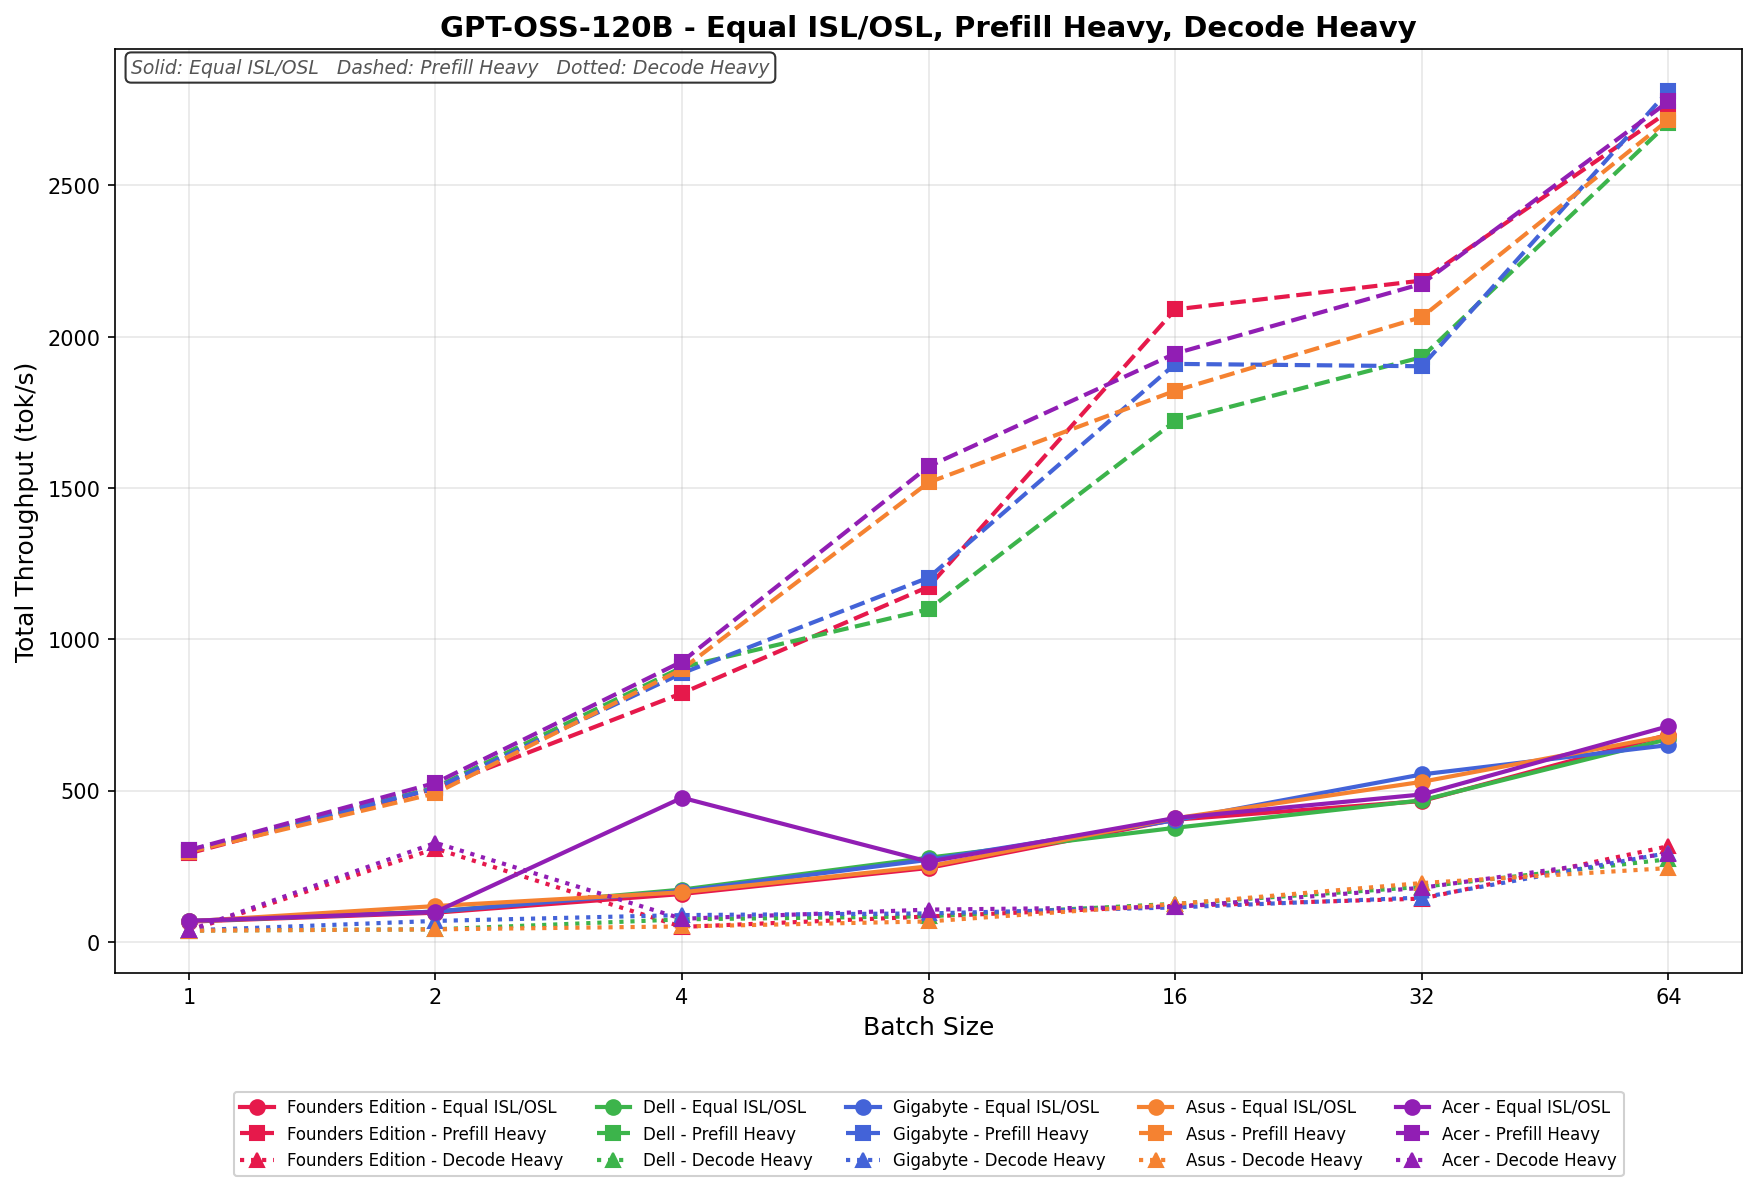
GPT-OSS-120B
Equal ISL/OSL မှာ Acer ဟာ batch sweep တစ်လျှောက်မှာ 69.65 tok/s ကနေ 713.18 tok/s အထိ ချိန်ညှိနိုင်ပါတယ်။ throughput ဟာ batch 8 ကနေ batch 64 အထိ တည်ငြိမ်ပြီး တသမတ်တည်း တိုးတက်မလာခင် batch size နိမ့်တဲ့အခါ ကွဲပြားမှုတချို့ကို ပြသပါတယ်။
Prefill Heavy သည် 303.61 tok/s မှစတင်ပြီး batch size 64 အရ 2,777.56 tok/s အထိ မြင့်တက်လာပါသည်။ တိုးချဲ့မှုသည် တစ်လျှောက်လုံးတွင် အားကောင်းပြီး တိုးတက်နေပြီး batch 8 တစ်လျှောက်လုံးတွင် အထူးသဖြင့် တက်ကြွသော တိုးတက်မှုနှင့် ပိုကြီးသော batch size များတွင် ဆက်လက်တိုးတက်မှုများ ရှိပါသည်။
Decode Heavy သည် 38.38 မှ 292.41 tok/s အထိရှိပြီး၊ batch sweep တစ်လျှောက်တွင် တဖြည်းဖြည်းနှင့် တသမတ်တည်း ချိန်ညှိမှုရှိသည်။ နိမ့်သော batch အရွယ်အစားများသည် throughput တည်ငြိမ်ပြီး batch 16 မှစ၍ တဖြည်းဖြည်းတိုးတက်လာခြင်းမပြုမီ ကွဲပြားမှုအချို့ရှိသည်။
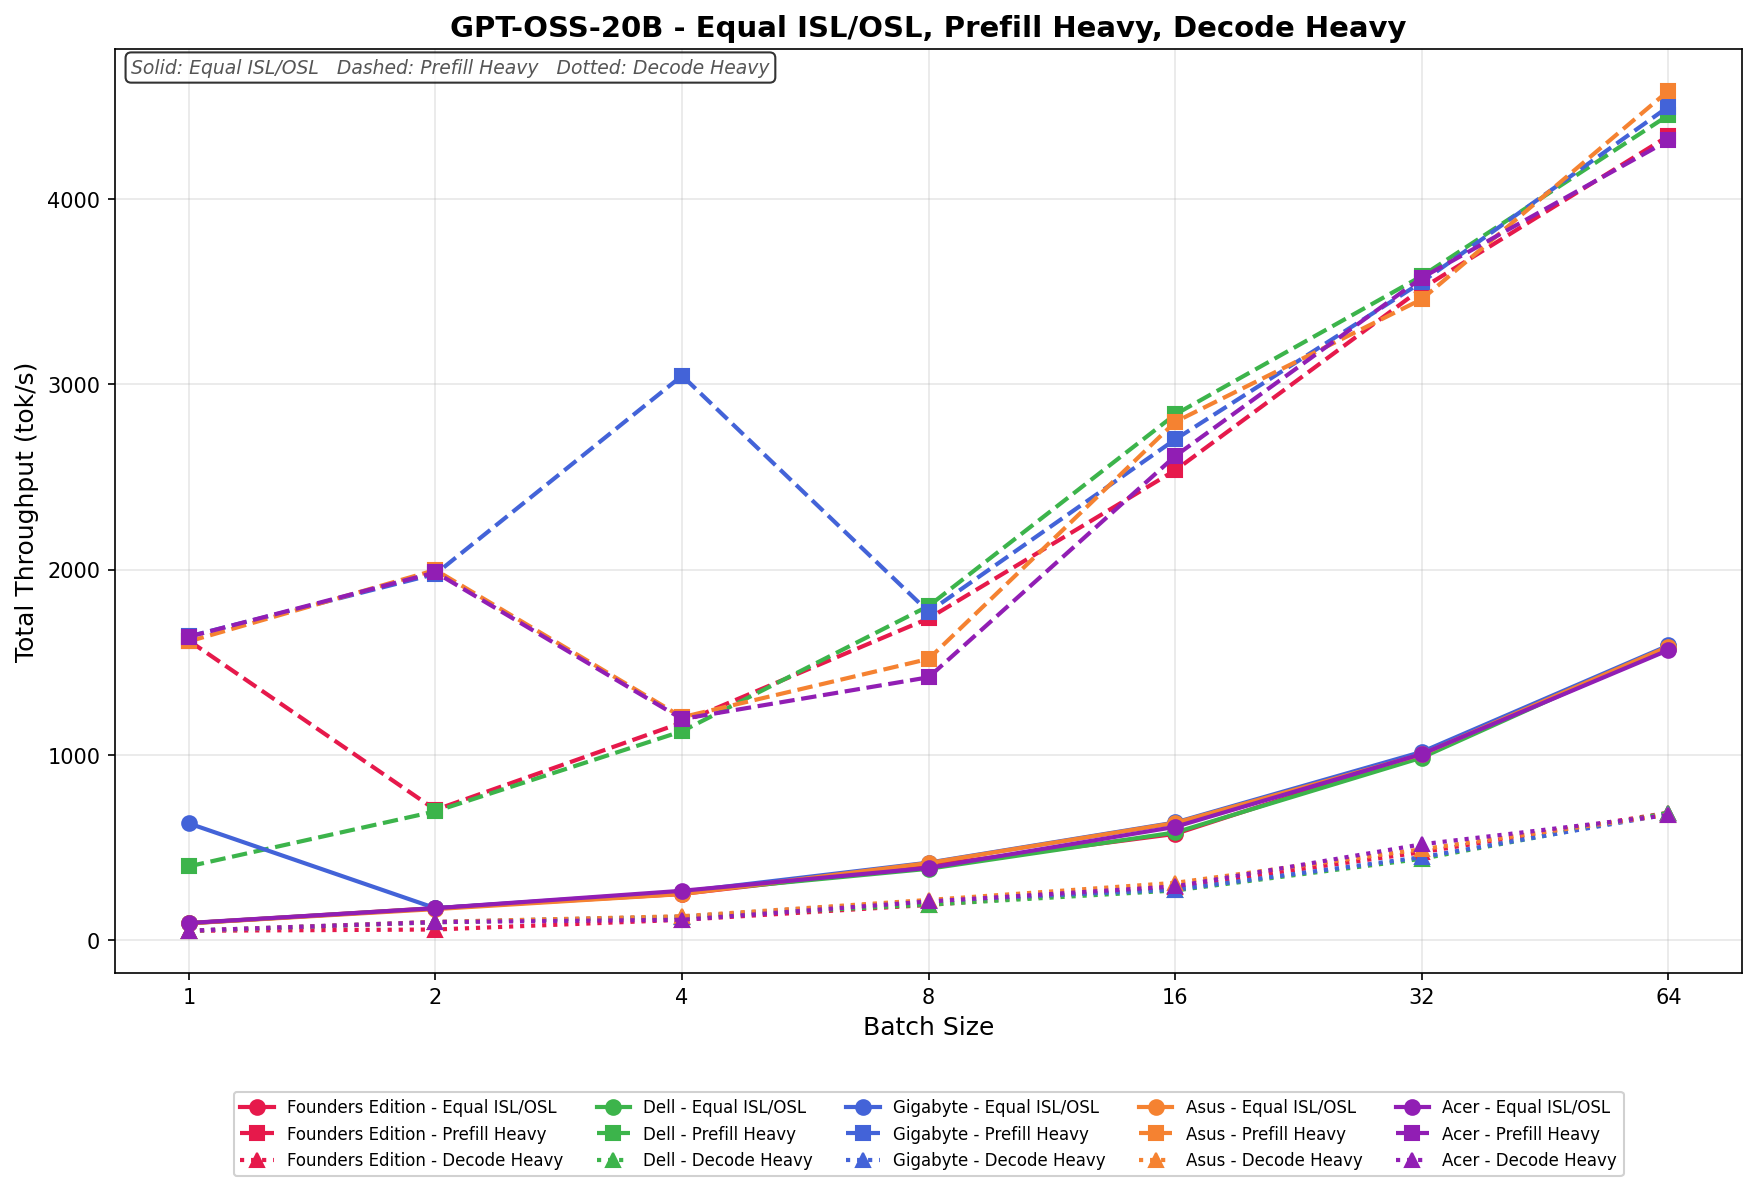
GPT-OSS-20B
Equal ISL/OSL တွင် Acer သည် 91.91 မှ 1,565.62 tok/s အထိ တိုးလာပြီး batch sweep တစ်ခုလုံးတွင် ခိုင်မာပြီး တသမတ်တည်း တိုးတက်မှုရှိသည်။ throughput သည် batch 1 မှ batch 4 အထိ နှစ်ဆခန့် မြင့်တက်လာပြီးနောက် batch 32 နှင့် 64 တွင် ဆက်လက် မြင့်တက်လာသည်။
Prefill Heavy သည် 1,637.72 tok/s မှစတင်ပြီး အသုတ်အရွယ်အစား 64 အထိ တိုးလာသည်နှင့်အမျှ 4,317.73 tok/s အထိ မြင့်တက်လာသည်။ အသုတ် ၂ တွင် တိုးတက်မှုအားကောင်းပြီး အလယ်အလတ်အဆင့်တွင် တည်ငြိမ်သွားကာ အသုတ် 32 နှင့် 64 တွင် ပြန်လည်အရှိန်မြှင့်လာသည်။
Decode Heavy သည် ၄၇.၀၁ မှ ၂၉၉.၄၁ tok/s အထိရှိပြီး၊ batch sweep တစ်လျှောက်တွင် တဖြည်းဖြည်းနှင့် တသမတ်တည်း ချိန်ညှိမှုရှိသည်။
Qwen3 ကုဒ်ဒါ 30B A3B FB8
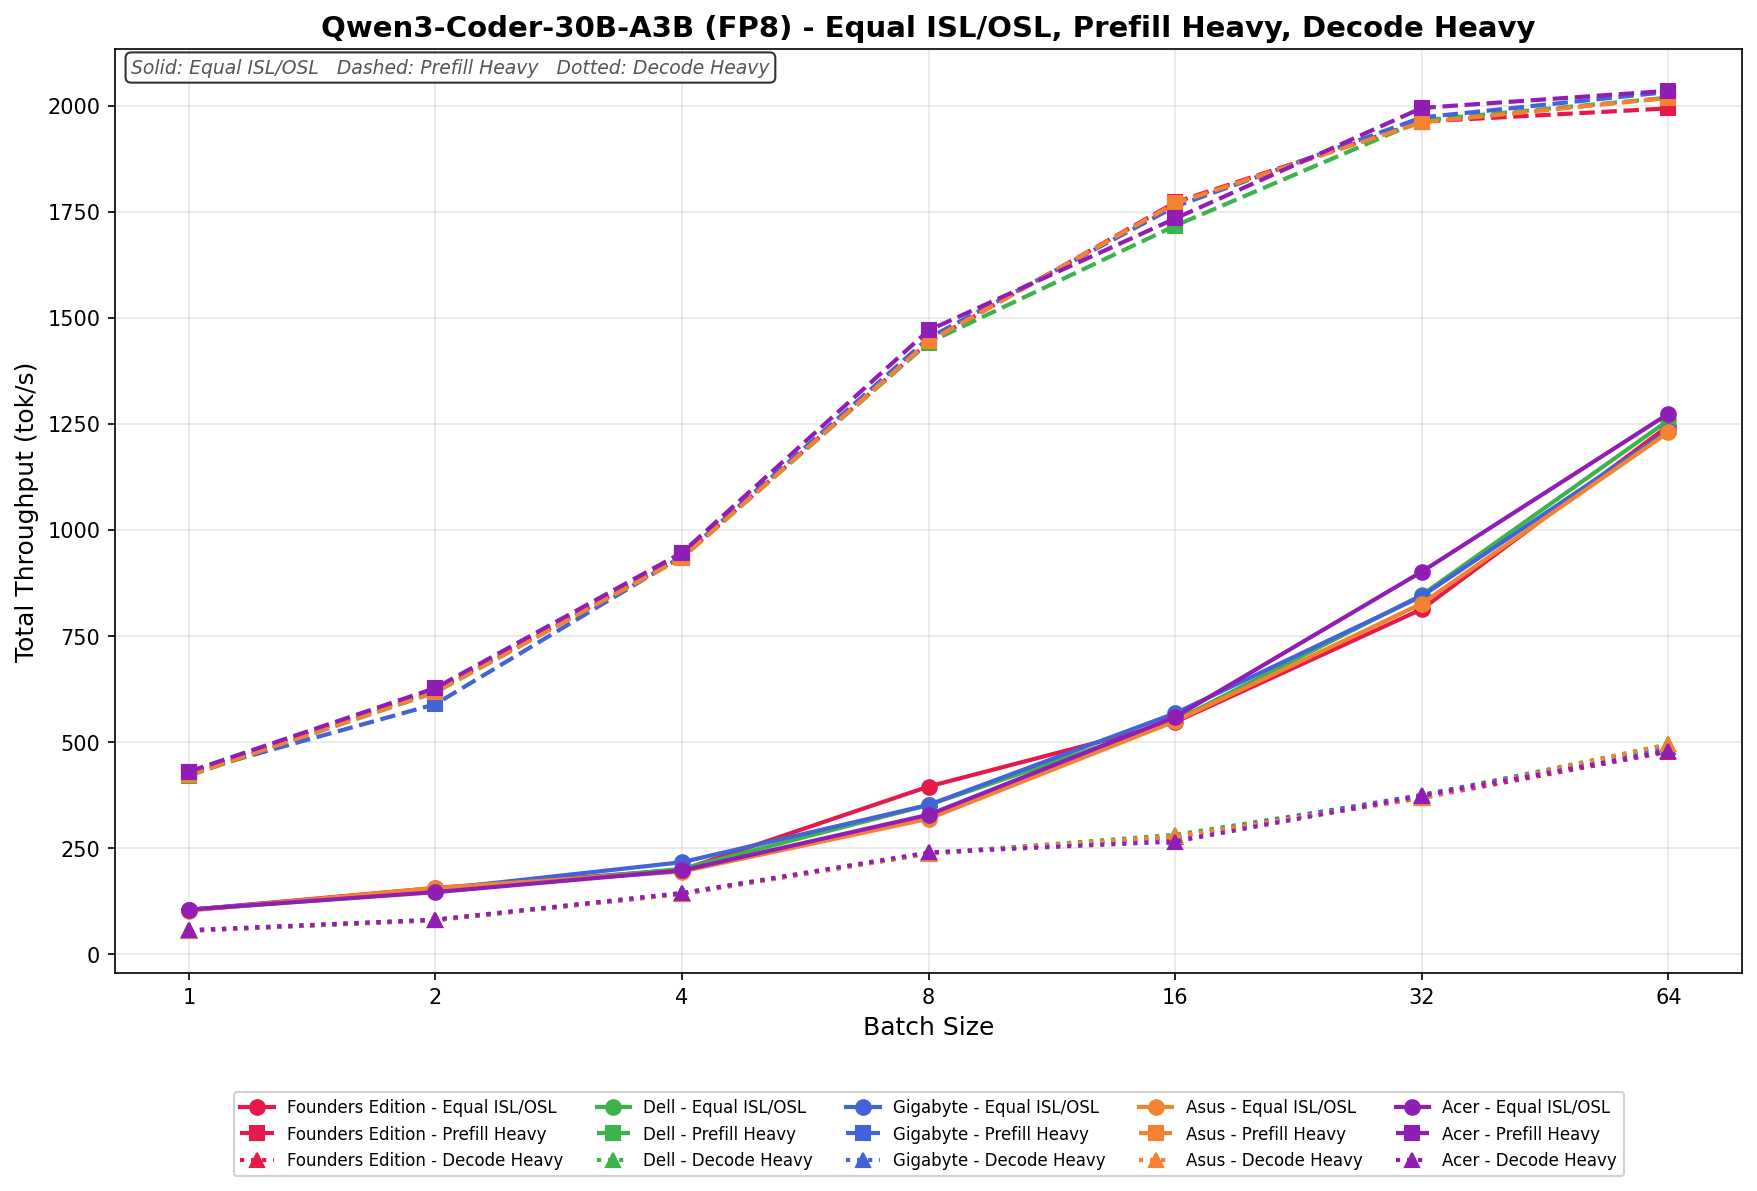
Equal ISL/OSL တွင် Acer သည် 104.64 မှ 1,273.47 tok/s အထိ တိုးလာပြီး batch sweep တစ်ခုလုံးတွင် တည်ငြိမ်ပြီး တသမတ်တည်း တိုးတက်မှုရှိသည်။ batch 16 ၏ အဆင့်တိုင်းတွင် throughput သည် ခန့်မှန်းခြေအားဖြင့် နှစ်ဆတိုးလာပြီးနောက် batch 32 နှင့် 64 တွင် ဆက်လက်မြင့်တက်သွားသည်။
Prefill Heavy သည် 429.86 tok/s မှစတင်ပြီး batch size 64 အရ 2,034.76 tok/s အထိ တိုးလာပါသည်။ batch 8 တွင် တိုးချဲ့မှုအားကောင်းပြီးနောက် batch 32 နှင့် 64 တွင် workload သည် တည်ငြိမ်မှုသို့ နီးကပ်လာသည်နှင့်အမျှ လျော့ကျသွားသည်။
Decode Heavy သည် ၄၇.၀၁ မှ ၂၉၉.၄၁ tok/s အထိရှိပြီး၊ batch sweep တစ်လျှောက်တွင် တဖြည်းဖြည်းနှင့် တသမတ်တည်း ချိန်ညှိမှုရှိသည်။
Qwen3 ကုဒ်ဒါ 30B A3B Base
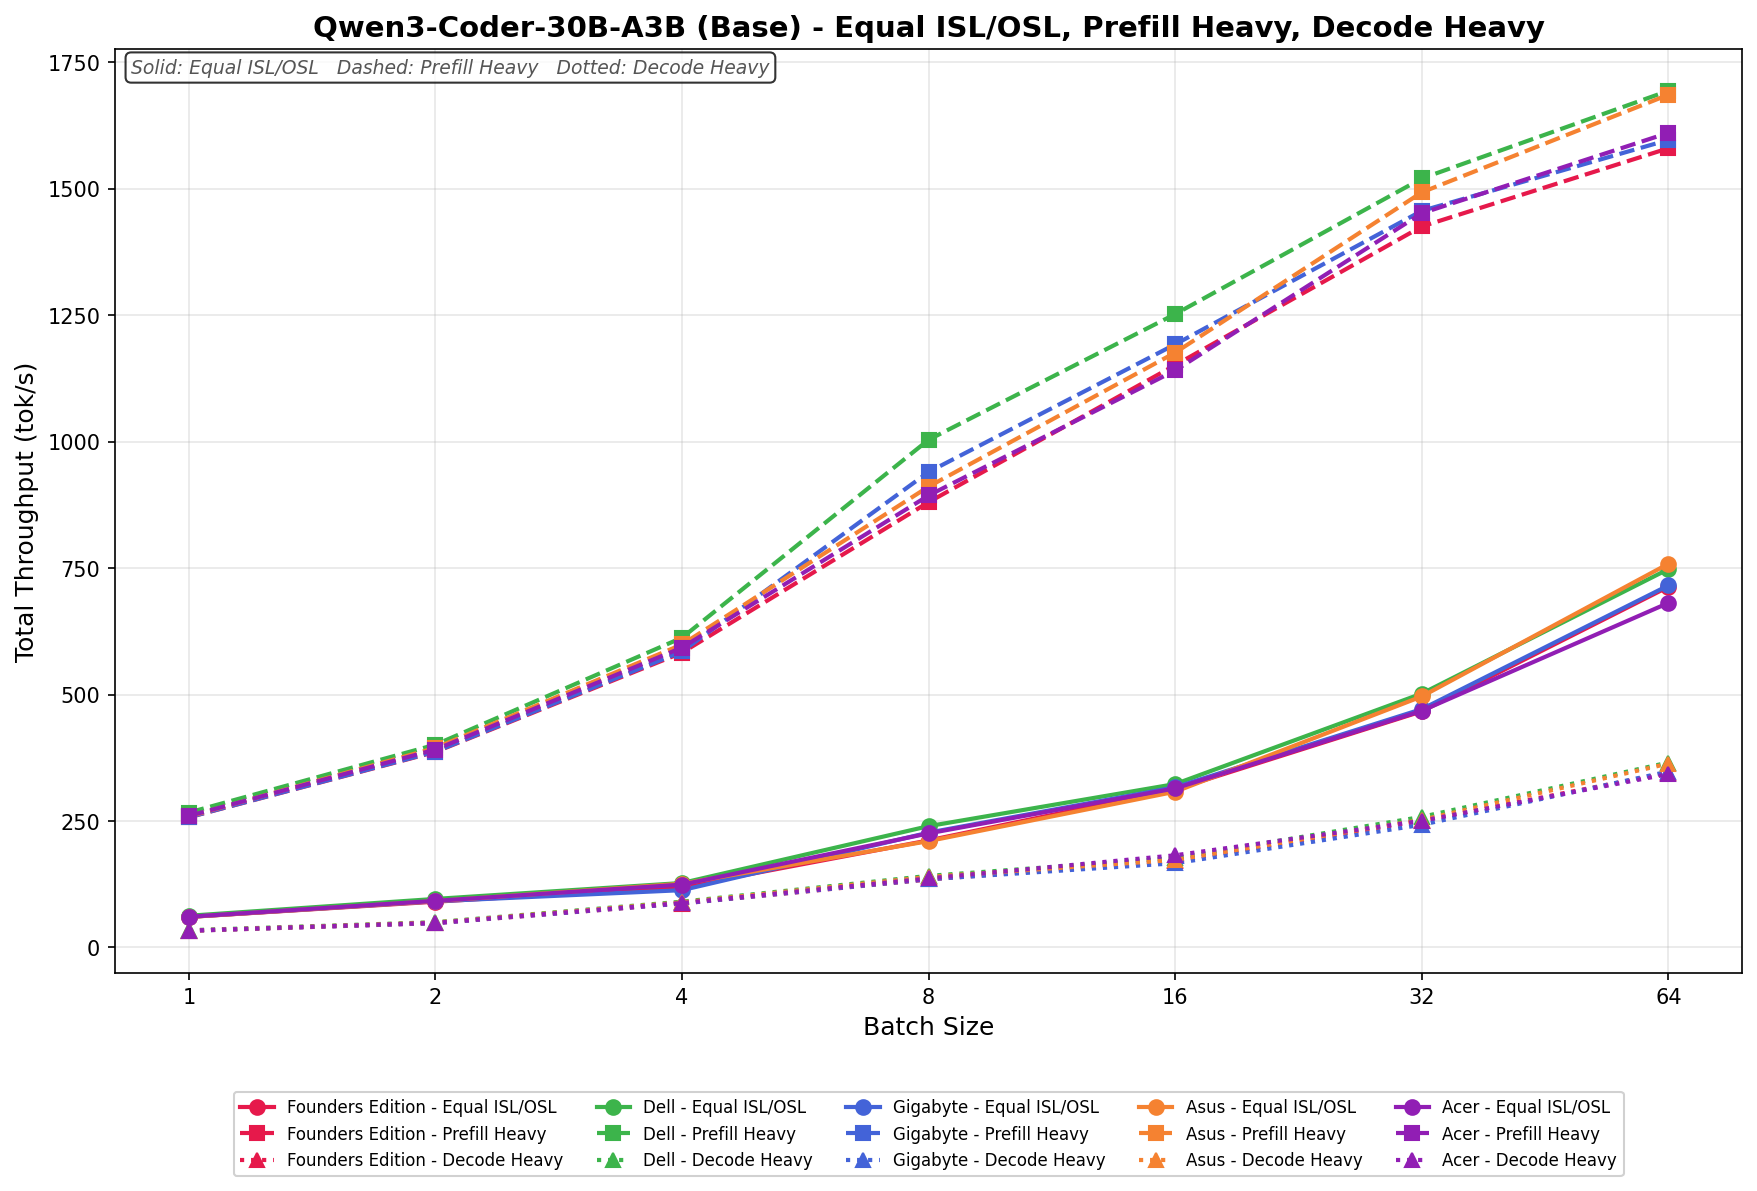
Equal ISL/OSL တွင် Acer သည် 60.71 မှ 681.18 tok/s အထိ တိုးချဲ့ထားပြီး၊ အသုတ်အရွယ်အစားအားလုံးတွင် FP8 မျိုးကွဲထက် သိသိသာသာနိမ့်သော throughput ကို ပေးစွမ်းသည်။ ကြီးထွားမှုမှာ တည်ငြိမ်သော်လည်း အသုတ်အရွယ်အစားပိုများသောအခါ FP8 နှင့် ကွာဟချက်မှာ ကျယ်လာပါသည်။
Prefill Heavy သည် 260.11 tok/s မှစတင်ပြီး batch size 64 အရ 1,610.56 tok/s အထိ မြင့်တက်သွားသည်။ scaling သည် sweep တစ်လျှောက်တွင် တသမတ်တည်းရှိသော်လည်း throughput သည် batch size တိုင်းတွင် FP8 counterpart အောက်တွင် အတော်လေးနိမ့်ကျနေပါသည်။
Decode Heavy သည် ၃၃.၃၁ မှ ၃၄၂.၇၉ tok/s အထိရှိပြီး လုပ်ငန်းစဉ်တစ်လျှောက်လုံး FP8 မျိုးကွဲထက် အထွက်နှုန်းနည်းသည်။ တိုးတက်မှုသည် အသုတ်အရွယ်အစားအားလုံးတွင် တဖြည်းဖြည်းနှင့် တသမတ်တည်းရှိသည်။
လာမာ ၃.၁ ၈ဘီ ညွှန်ကြားချက် FP၄
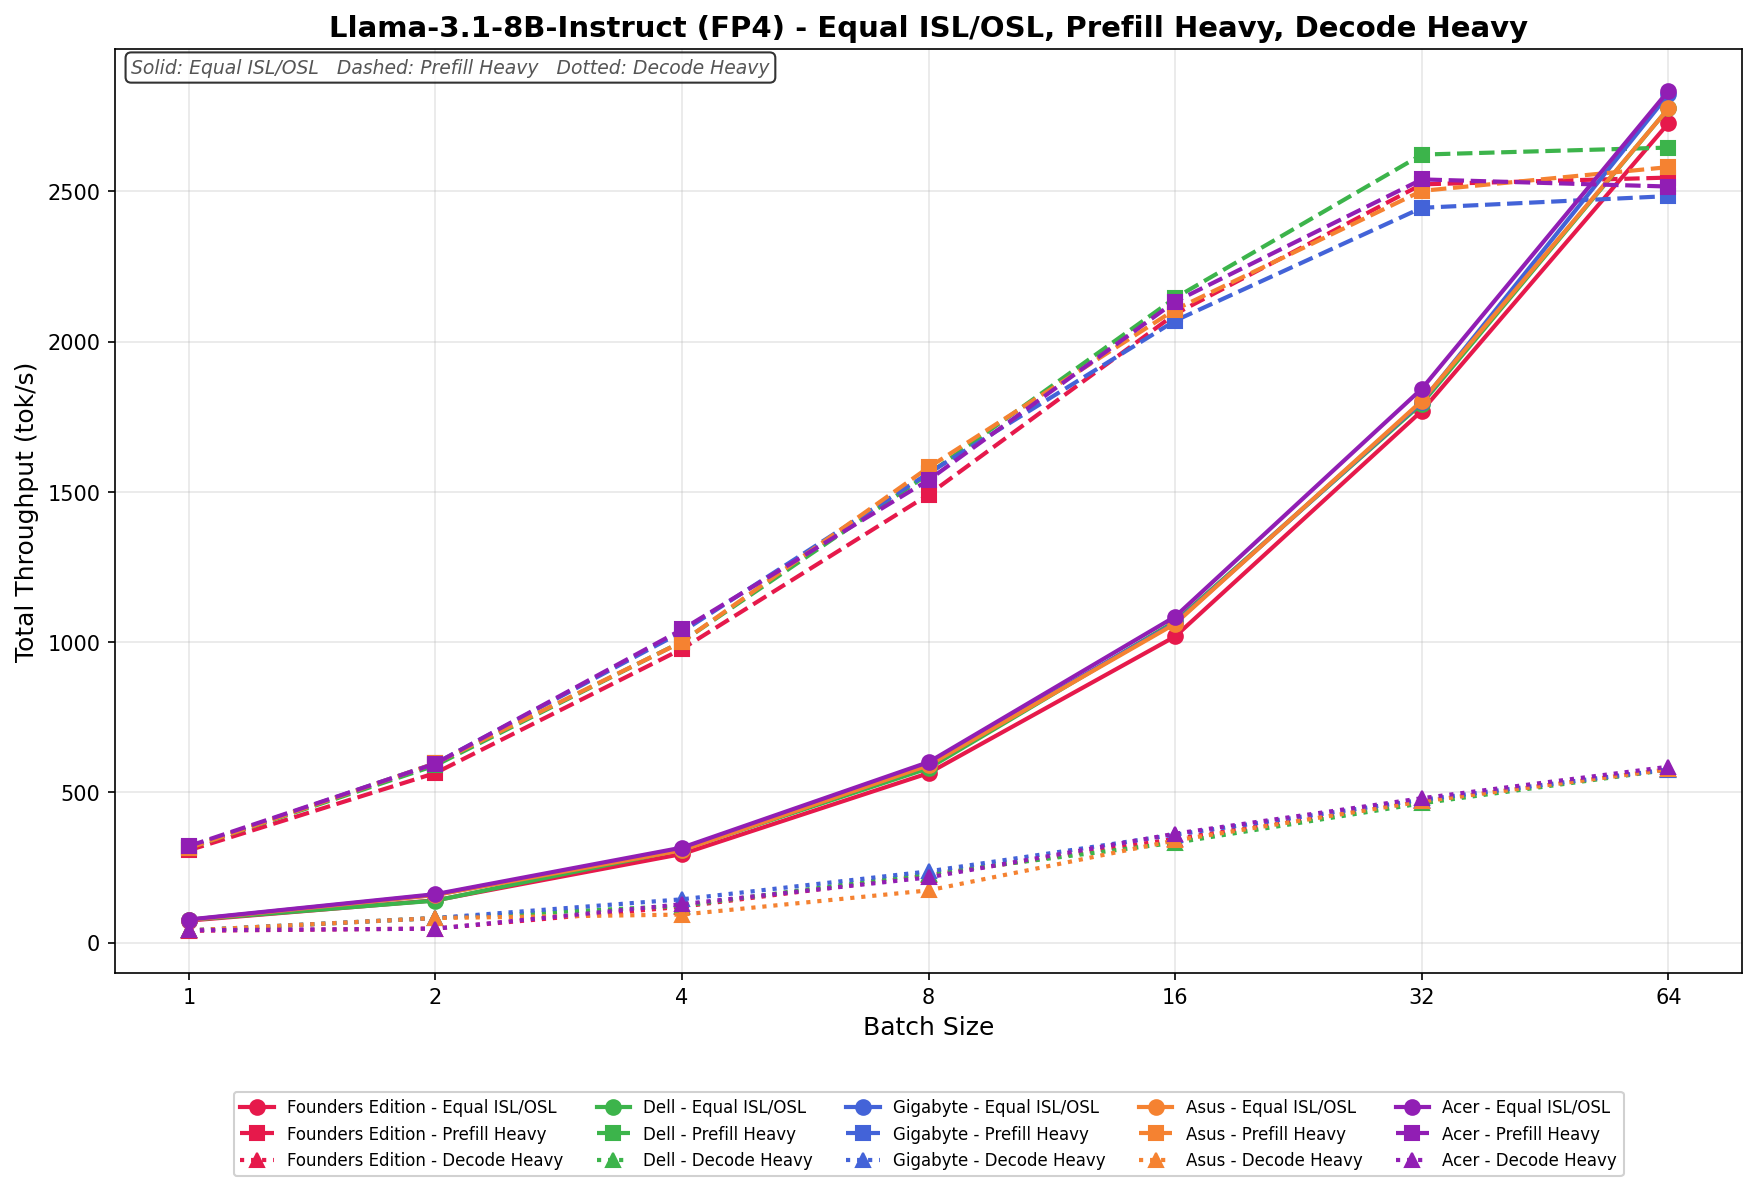
Equal ISL/OSL မှာ Acer ဟာ 77.15 ကနေ 2,834.70 tok/s အထိ တိုးချဲ့နိုင်ပြီး၊ batch အရွယ်အစားအားလုံးမှာ FP8 variant ထက် throughput အားသာချက်ကို ရှင်းရှင်းလင်းလင်း ပေးစွမ်းပါတယ်။ batch 32 တစ်လျှောက်လုံး scaling ဟာ ချောမွေ့ပြီး linear ဖြစ်ပြီး batch 64 မှာ ခိုင်မာတဲ့ တိုးတက်မှုတွေကို ဆက်လက်ရရှိခဲ့ပါတယ်။
Prefill Heavy သည် 321.54 tok/s မှစတင်ပြီး batch 32 တွင် 2,539.85 tok/s အထိ မြင့်တက်ပြီးနောက် batch 64 တွင် 2,516.13 tok/s ဖြင့် အနည်းငယ်တည်ငြိမ်သွားသည်။ FP4 မော်ဒယ်သည် အလတ်စားနှင့် အသုတ်အရွယ်အစားများတွင် ၎င်း၏ FP8 ထက် ပိုမိုမြင့်မားသော throughput ကို ထိန်းသိမ်းထားသည်။
Decode Heavy သည် ၄၁.၂၁ မှ ၅၈၅.၆၃ tok/s အထိရှိပြီး အသုတ်အရွယ်အစားအားလုံးတွင် FP8 မျိုးကွဲထက် အထွက်နှုန်းသိသိသာသာမြင့်မားသည်။ တိုးတက်မှုသည် አዲስ ወጥታዊ ወጥታዊ ဖြစ်သည်။
လာမာ ၃.၁ ၈ဘီ ညွှန်ကြားချက် FP၄
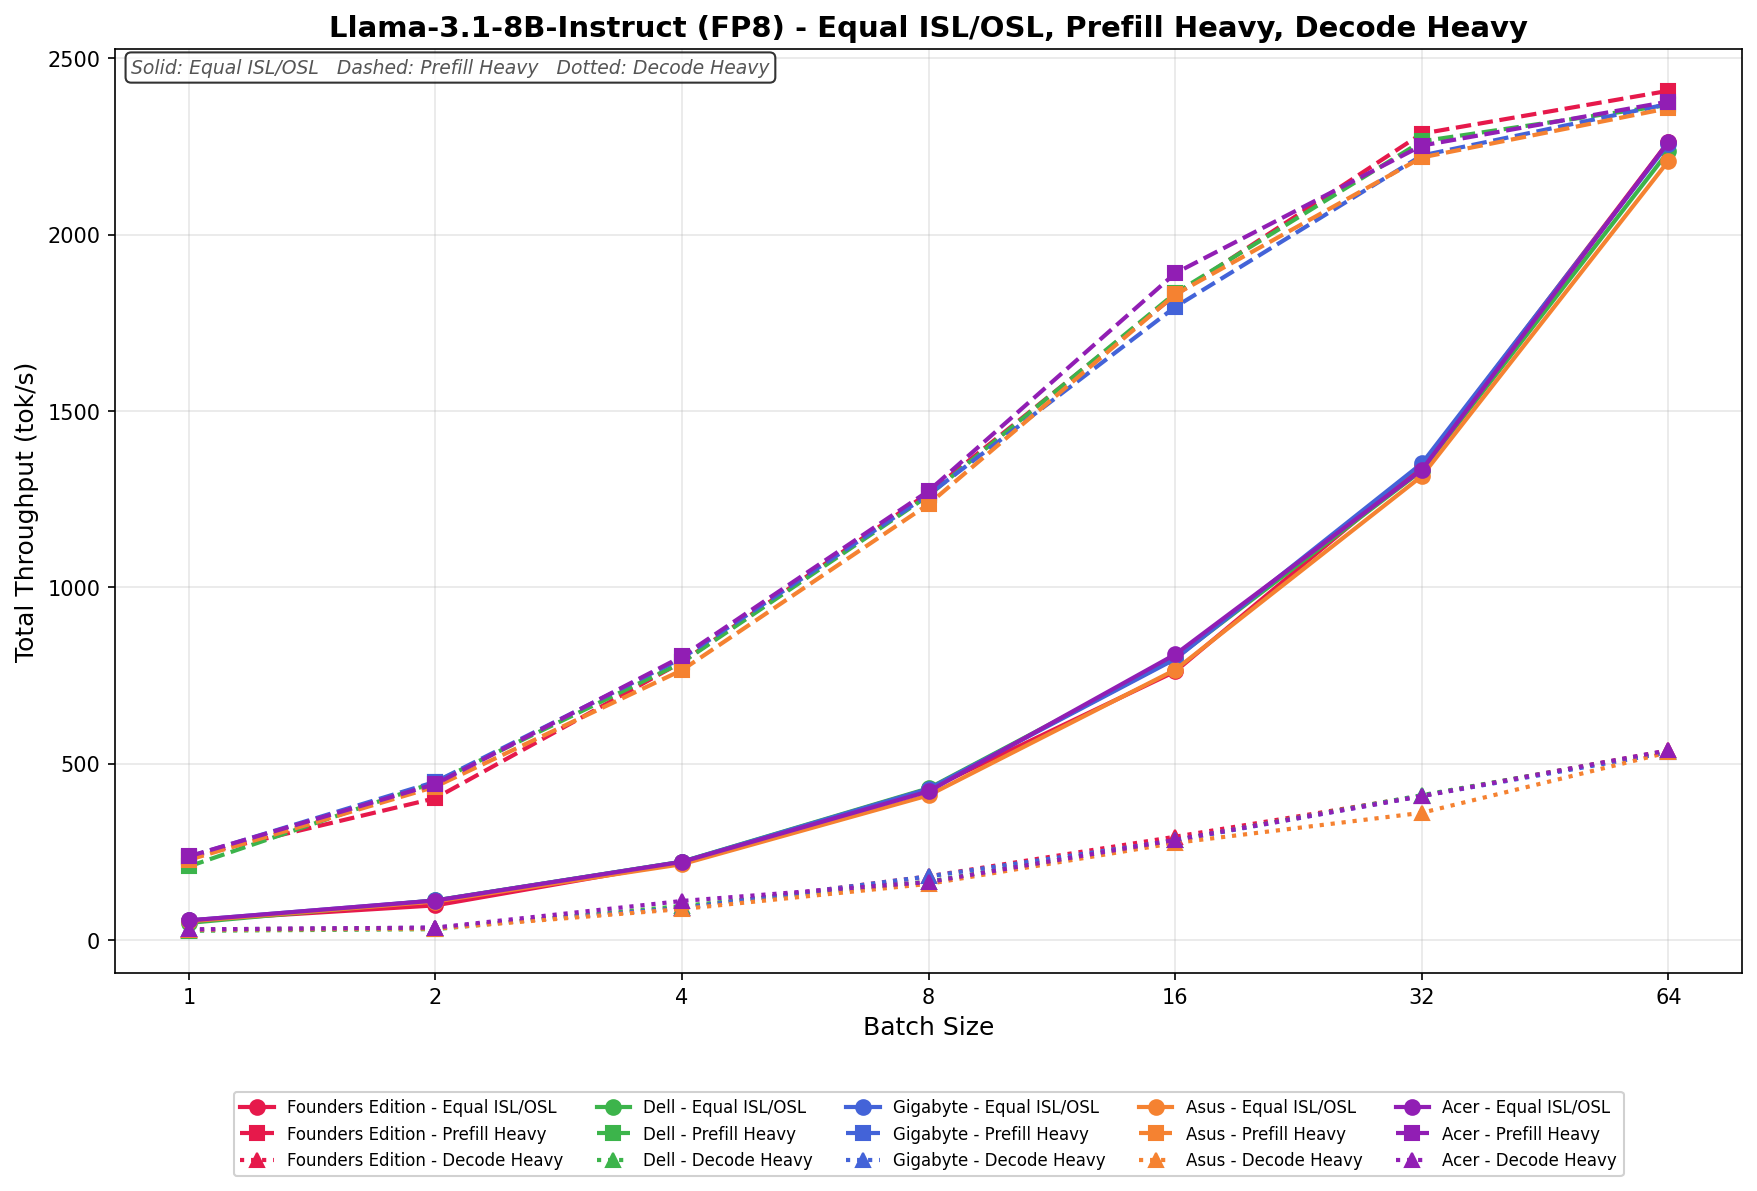
Equal ISL/OSL မှာ Acer ဟာ batch sweep တစ်လျှောက်မှာ 55.93 ကနေ 2,262.73 tok/s အထိ တိုးလာပြီး အဆင့်တိုင်းမှာ တည်ငြိမ်ပြီး တသမတ်တည်း တိုးတက်မှုတွေ ရှိပါတယ်။ throughput ဟာ batch 1 ကနေ batch 8 အထိ နှစ်ဆနီးပါး တိုးလာပြီး batch 32 နဲ့ 64 မှာ ပြည့်ဝမှု လက္ခဏာ မရှိဘဲ ဆက်လက် မြင့်တက်လာပါတယ်။
Prefill Heavy သည် 237.62 tok/s မှစတင်ပြီး batch size 64 အရ 2,376.88 tok/s အထိ တိုးလာပါသည်။ တိုးချဲ့မှုသည် တစ်လျှောက်လုံးတွင် အားကောင်းပြီး တိုးတက်နေပြီး batch တစ်ခုလုံးတွင် throughput သည် တသမတ်တည်း တိုးတက်လာပါသည်။
Decode Heavy သည် ၃၀.၃၉ မှ ၅၃၈.၁၈ tok/s အထိရှိပြီး၊ batch sweep တစ်လျှောက်တွင် တည်ငြိမ်သောတိုးတက်မှုရှိသည်။
GPU တိုက်ရိုက်သိုလှောင်မှု
Spark မှာ ကျွန်တော်တို့ ပြုလုပ်ခဲ့တဲ့ စမ်းသပ်မှုတွေထဲက တစ်ခုကတော့ MagnumIO GPU Direct Storage (GDS) စမ်းသပ်မှုပါ။ GDS ဆိုတာ NVIDIA မှ တီထွင်ထားတဲ့ လုပ်ဆောင်ချက်တစ်ခုဖြစ်ပြီး NVMe drives တွေ ဒါမှမဟုတ် တခြားမြန်နှုန်းမြင့် storage devices တွေမှာ သိမ်းဆည်းထားတဲ့ data တွေကို access လုပ်တဲ့အခါ GPU တွေကို CPU ကိုကျော်ပြီး လုပ်ဆောင်နိုင်စေပါတယ်။ CPU နဲ့ system memory ကနေတစ်ဆင့် data တွေကို routing လုပ်မယ့်အစား GDS က GPU နဲ့ storage device အကြား တိုက်ရိုက်ဆက်သွယ်မှုကို ဖြစ်စေပြီး latency ကို သိသိသာသာ လျှော့ချပေးပြီး data throughput ကို တိုးတက်စေပါတယ်။
Acer က Veriton GN100 AI မှာ 4TB Samsung PM9E1 Gen5 SSD ကို အသုံးပြုထားပြီး လက်ရှိအချိန်အထိ ဈေးကွက်ထဲမှာ မြင်ဖူးသမျှထဲမှာ အမြန်ဆုံး 2242 M.2 drive ဖြစ်ပါတယ်။
GPU Direct Storage ဘယ်လိုအလုပ်လုပ်လဲ
ရိုးရာအစဉ်အလာအရ GPU တစ်ခုက NVMe drive မှာသိမ်းဆည်းထားတဲ့ဒေတာတွေကို စီမံဆောင်ရွက်တဲ့အခါ ဒေတာဟာ GPU ဆီကိုမရောက်ခင် CPU နဲ့ system memory ကနေတစ်ဆင့် ဦးစွာဖြတ်သန်းသွားရပါမယ်။ ဒီလုပ်ငန်းစဉ်က CPU ဟာ ကြားခံအဖြစ်လုပ်ဆောင်ပြီး latency ကိုတိုးစေပြီး အဖိုးတန် system resource တွေကို သုံးစွဲစေတာကြောင့် ပိတ်ဆို့မှုတွေကို ဖြစ်ပေါ်စေပါတယ်။ GPU Direct Storage က GPU ကို PCIe bus မှတစ်ဆင့် storage device ကနေ တိုက်ရိုက်ဒေတာတွေကို ရယူနိုင်အောင် လုပ်ပေးခြင်းအားဖြင့် ဒီထိရောက်မှုမရှိခြင်းကို ဖယ်ရှားပေးပါတယ်။ ဒီတိုက်ရိုက်လမ်းကြောင်းက ဒေတာရွေ့လျားမှု overhead ကို လျော့ကျစေပြီး ဒေတာလွှဲပြောင်းမှုတွေကို ပိုမိုမြန်ဆန်ထိရောက်စေပါတယ်။
AI workloads များ၊ အထူးသဖြင့် deep learning ပါဝင်သည့် workloads များသည် data များစွာအသုံးပြုရပါသည်။ ကြီးမားသော neural network များကို လေ့ကျင့်ပေးရန်အတွက် data terabytes များကို processing လုပ်ရန် လိုအပ်ပြီး data transfer နှောင့်နှေးမှုတစ်စုံတစ်ရာသည် GPU များကို အသုံးမချနိုင်ခြင်းနှင့် လေ့ကျင့်ချိန်ပိုကြာခြင်းတို့ ဖြစ်စေနိုင်ပါသည်။ GPU Direct Storage သည် data ကို GPU သို့ အမြန်ဆုံးပေးပို့ခြင်း၊ အားလပ်ချိန်ကို အနည်းဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းနှင့် တွက်ချက်မှုစွမ်းဆောင်ရည်ကို အမြင့်ဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းဖြင့် ဤစိန်ခေါ်မှုကို ဖြေရှင်းပေးပါသည်။
ထို့အပြင်၊ GDS သည် ဗီဒီယိုလုပ်ဆောင်ခြင်း၊ သဘာဝဘာသာစကားလုပ်ဆောင်ခြင်း သို့မဟုတ် အချိန်နှင့်တပြေးညီ ကောက်ချက်ချခြင်းကဲ့သို့သော ဒေတာအစုအဝေးကြီးများကို streaming လုပ်ခြင်းပါဝင်သည့် workloads များအတွက် အထူးအကျိုးရှိပါသည်။ CPU အပေါ် မှီခိုမှုကို လျှော့ချခြင်းဖြင့် GDS သည် ဒေတာရွှေ့ပြောင်းမှုကို အရှိန်မြှင့်ပေးပြီး အခြားအလုပ်များအတွက် CPU အရင်းအမြစ်များကို လွတ်လပ်စေပြီး စနစ်စွမ်းဆောင်ရည်ကို ပိုမိုမြှင့်တင်ပေးပါသည်။
GDSIO ဖတ်ရှုမှုပမာဏ ၁၆k
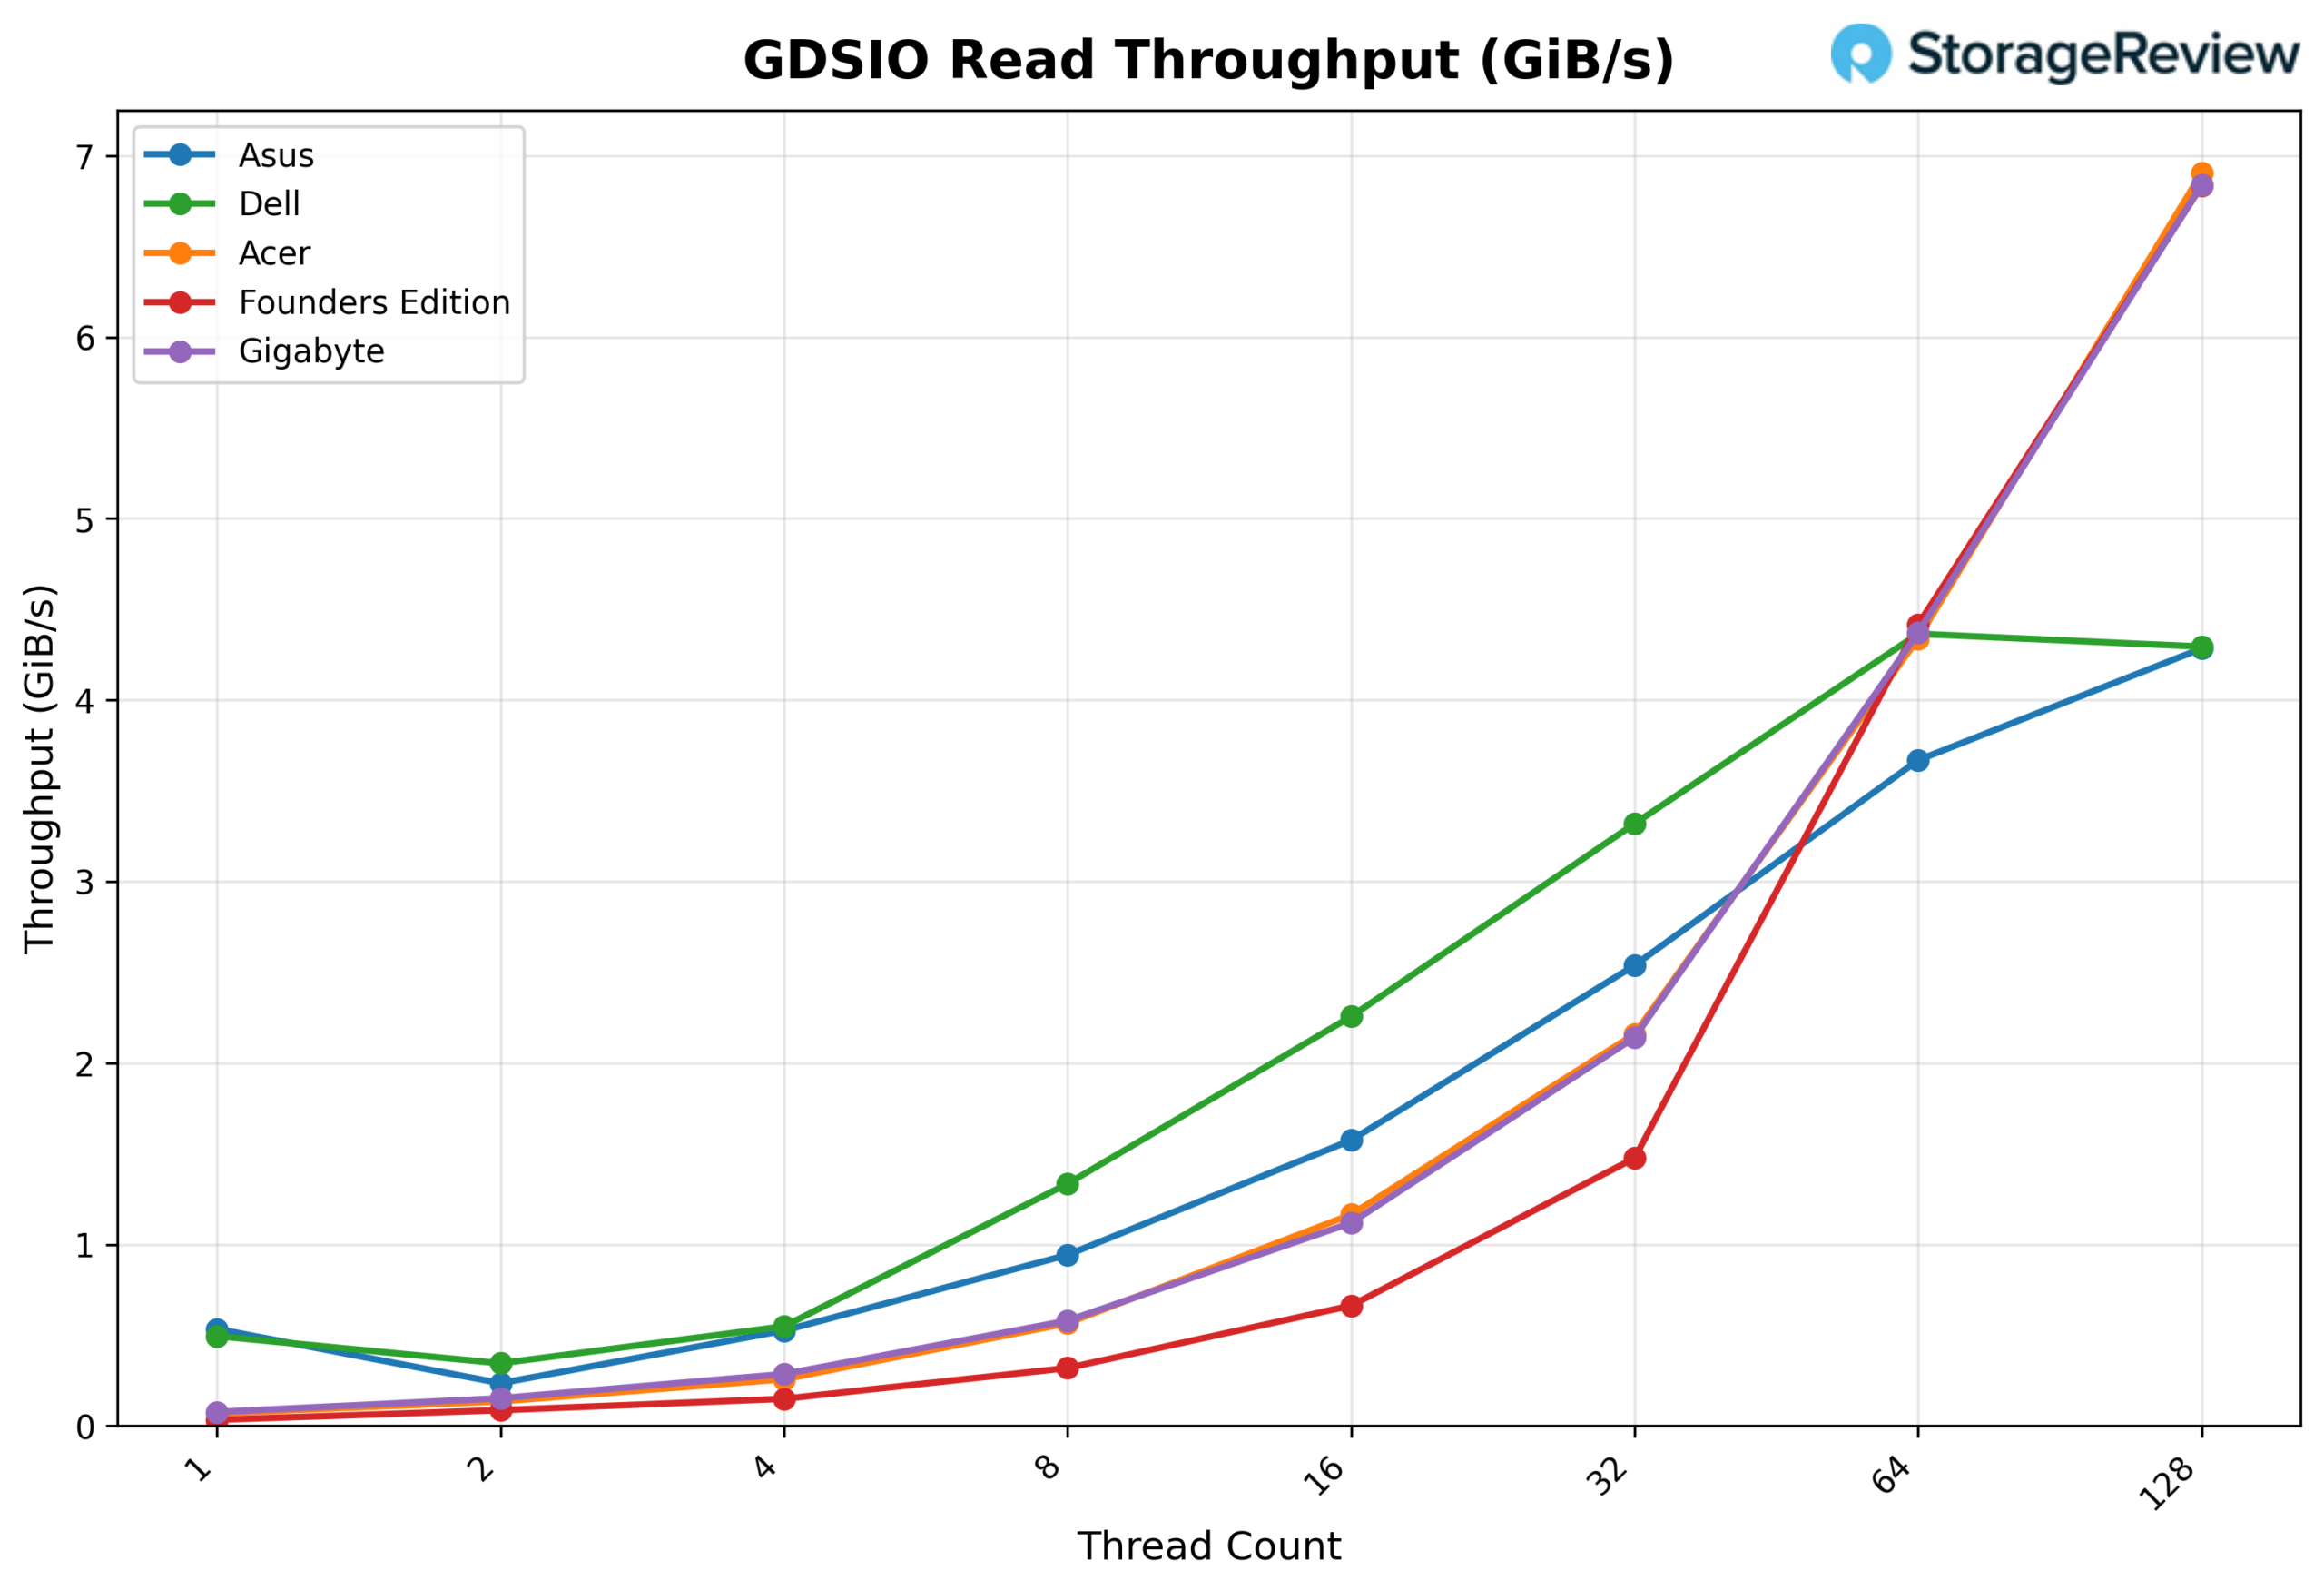
GDSIO Read Throughput 16K ကိုကြည့်မယ်ဆိုရင် Acer ဟာ thread 1 မှာ 0.07 GiB/s ကနေစတင်ပြီး thread 2 (0.13 GiB/s)၊ thread 4 (0.26 GiB/s) နဲ့ thread 8 (0.57 GiB/s) တွေအထိ linearly scale လုပ်ပါတယ်။ Thread 16 (1.16 GiB/s)၊ thread 32 (2.16 GiB/s) နဲ့ thread 64 (4.34 GiB/s) တွေမှာ Throughput ဆက်လက်တက်နေပါတယ်။ thread 128 မှာ throughput 6.91 GiB/s အထိရောက်ရှိပြီး sweep မှာ အမြင့်ဆုံးတွေ့ရတဲ့ရလဒ်ဖြစ်ပြီး platform ဟာ I/O အရွယ်အစားသေးငယ်တဲ့အခါ scale ဆက်လက်တက်နေတယ်ဆိုတာကို ရှင်းရှင်းလင်းလင်းပြသတဲ့ saturation point မရှိပါဘူး။
GDSIO ဖတ်ရှုမှု ပျမ်းမျှနှောင့်နှေးမှု 16K
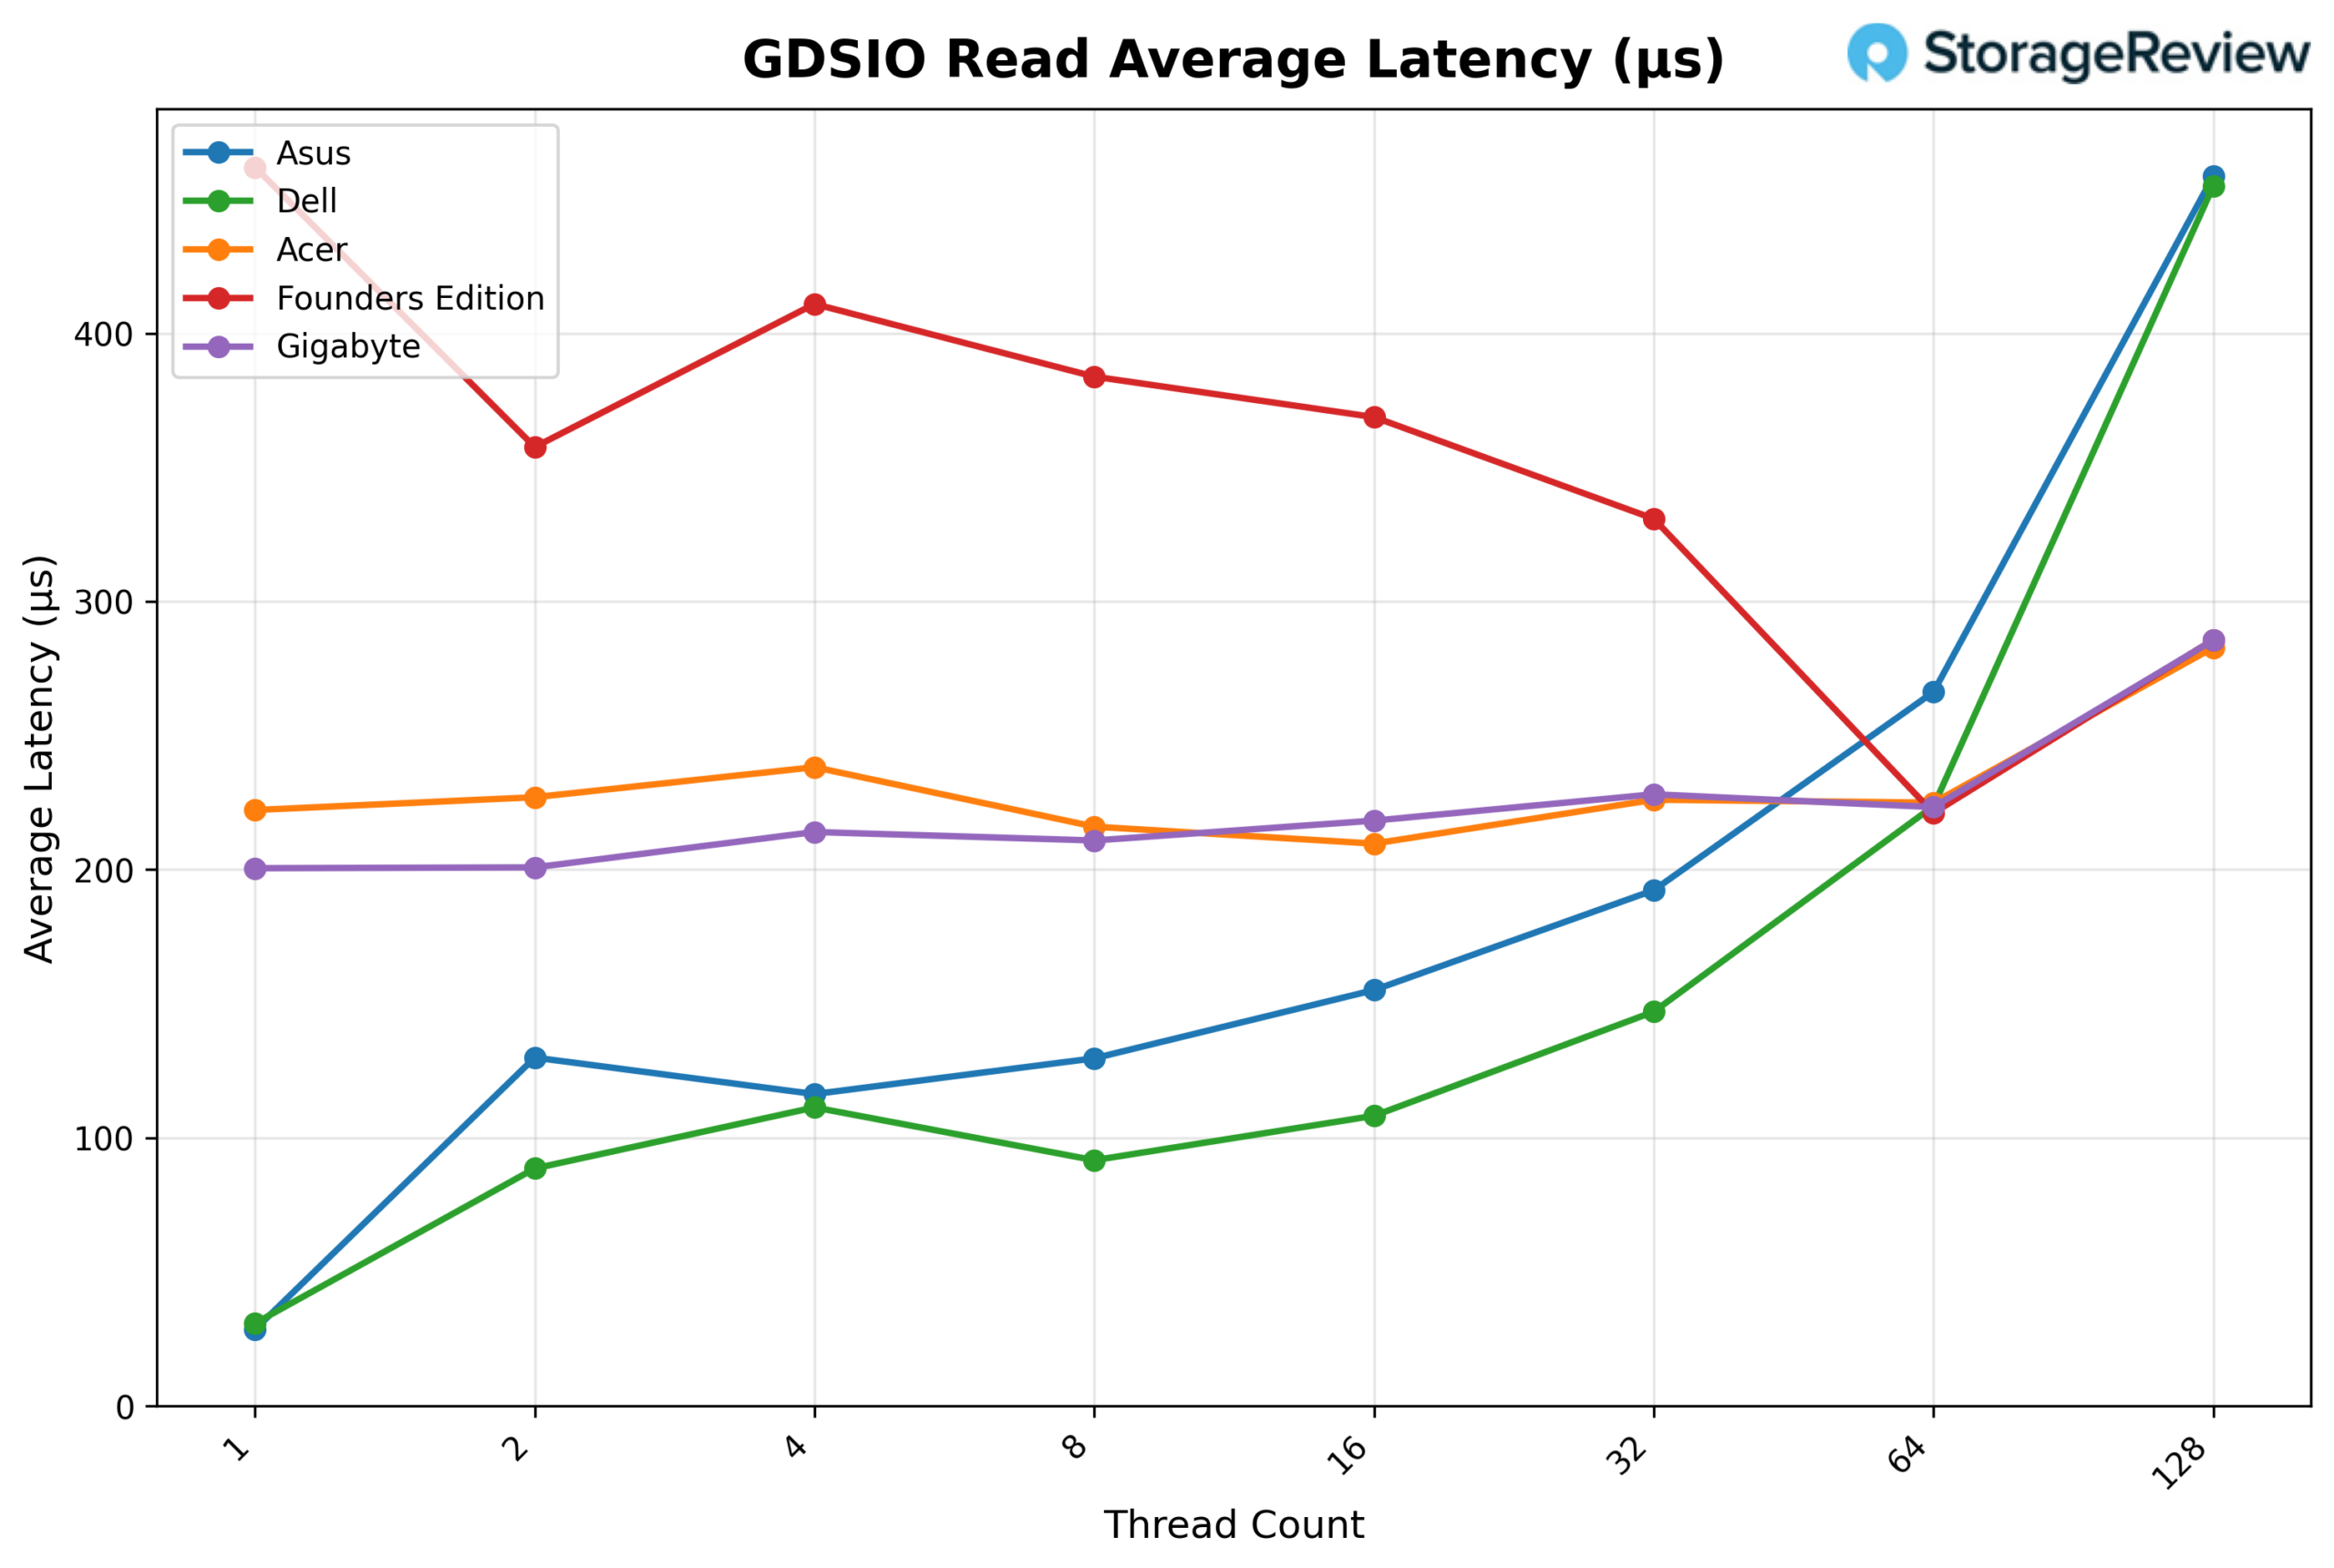
GDSIO Read Average Latency (16K) ကိုကြည့်မယ်ဆိုရင် Acer ဟာ thread 1 ခုမှာ 0.22ms ခန့်ကနေစတင်ပြီး တစ်လျှောက်လုံးမှာ သိသိသာသာတည်ငြိမ်နေပါတယ်- thread 2 ခုမှာ 0.23ms၊ thread 4 ခုမှာ 0.24ms နဲ့ thread 8 ခုမှာ 0.22ms။ Latency ဟာ thread 16 ခု (0.21ms)၊ thread 32 ခု (0.23ms) နဲ့ thread 64 ခု (0.22ms) တို့မှာ အလားတူတည်ငြိမ်နေပြီးနောက် thread 128 ခုမှာ 0.28ms အထိအနည်းငယ်မြင့်တက်လာပါတယ်။ thread count အားလုံးမှာ ဒီနီးပါးပြားချပ်တဲ့ latency profile ဟာ throughput မှာတွေ့ရတဲ့ scaling အပြုအမူကိုထင်ဟပ်စေပါတယ်။
GSDIO ရေးသားမှုပမာဏ ၁၆K
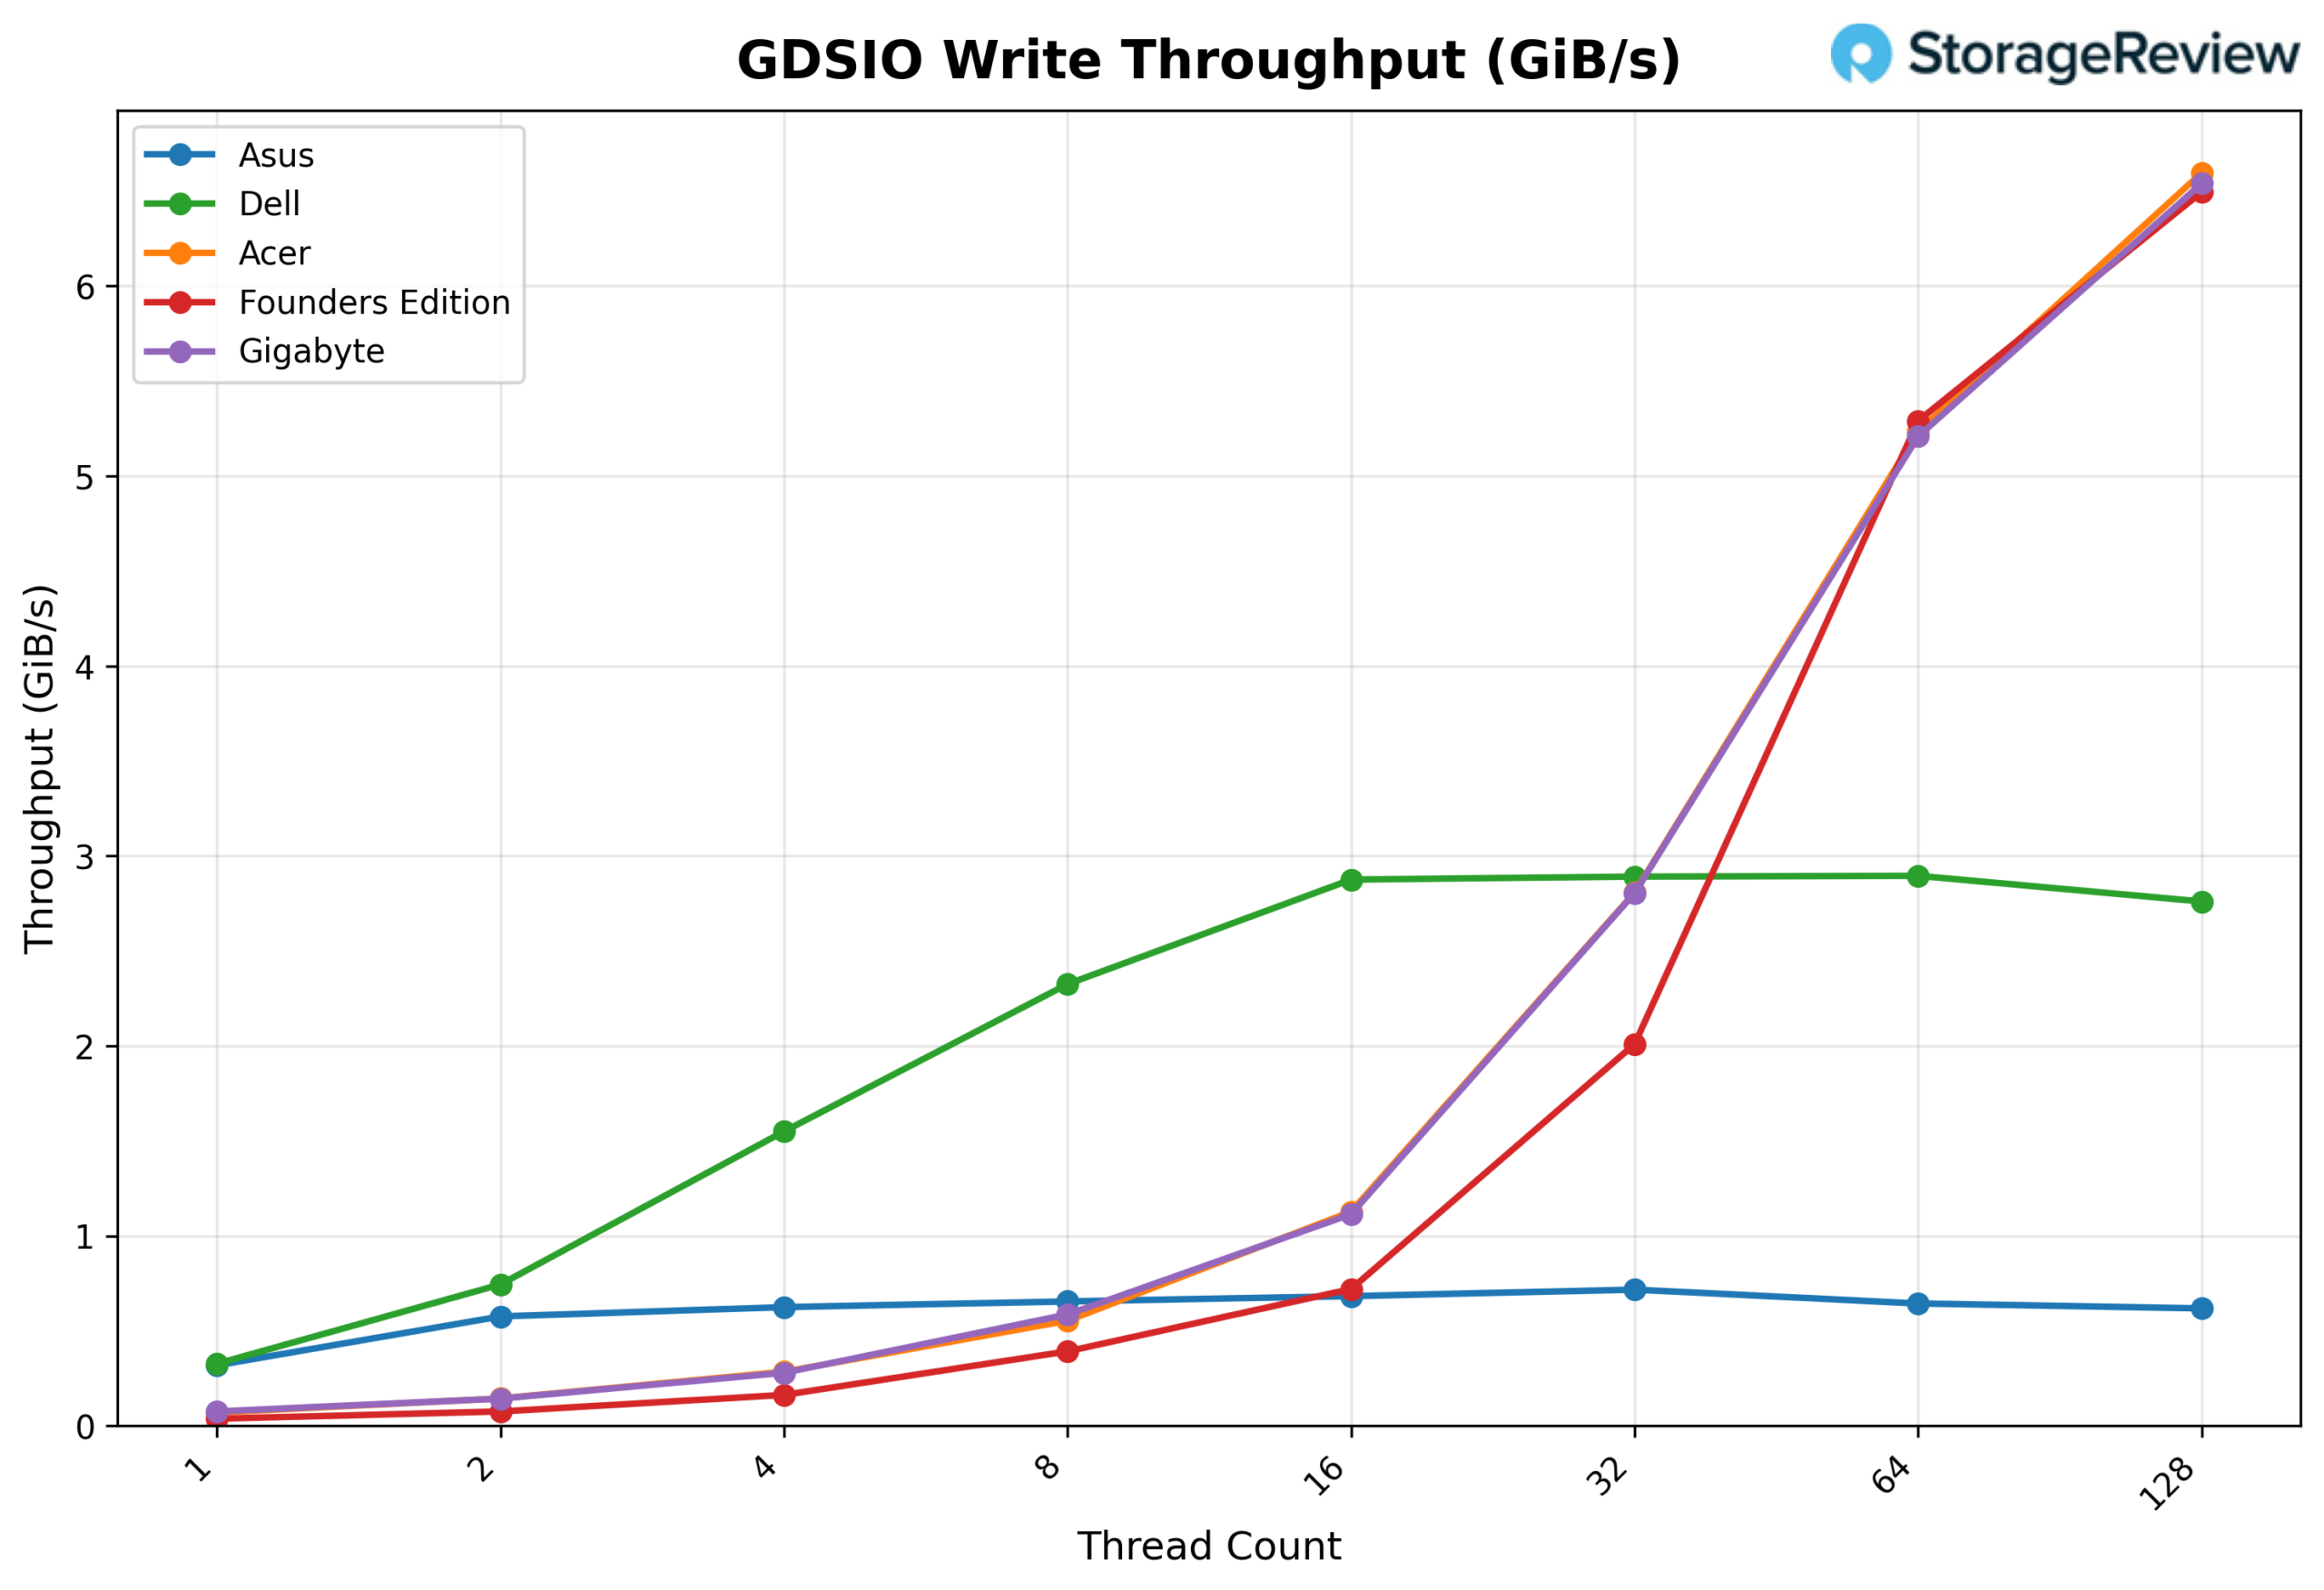
GDSIO Write Throughput 16K ကိုကြည့်မယ်ဆိုရင် Acer ဟာ thread 1 မှာ 0.07 GiB/s ကနေစတင်ပြီး thread 2 (0.14 GiB/s)၊ thread 4 (0.28 GiB/s) နဲ့ thread 8 (0.55 GiB/s) တွေအထိ scale လုပ်ပါတယ်။ thread 16 (1.13 GiB/s)၊ thread 32 (2.81 GiB/s) နဲ့ thread 64 (5.23 GiB/s) တွေမှာ တိုးတက်မှုမြန်ဆန်ပါတယ်။ thread 128 မှာ throughput 6.60 GiB/s အထိရောက်ရှိပြီး sweep ရဲ့ အထွတ်အထိပ်ဖြစ်ပြီး၊ ရှင်းရှင်းလင်းလင်း saturation မတွေ့ရဘဲ block size သေးသေးလေးတွေမှာ scaling ဆက်လက်ဖြစ်ပေါ်နေပါတယ်။
GDSIO ရေးသားမှုပျမ်းမျှနှောင့်နှေးမှု 16K
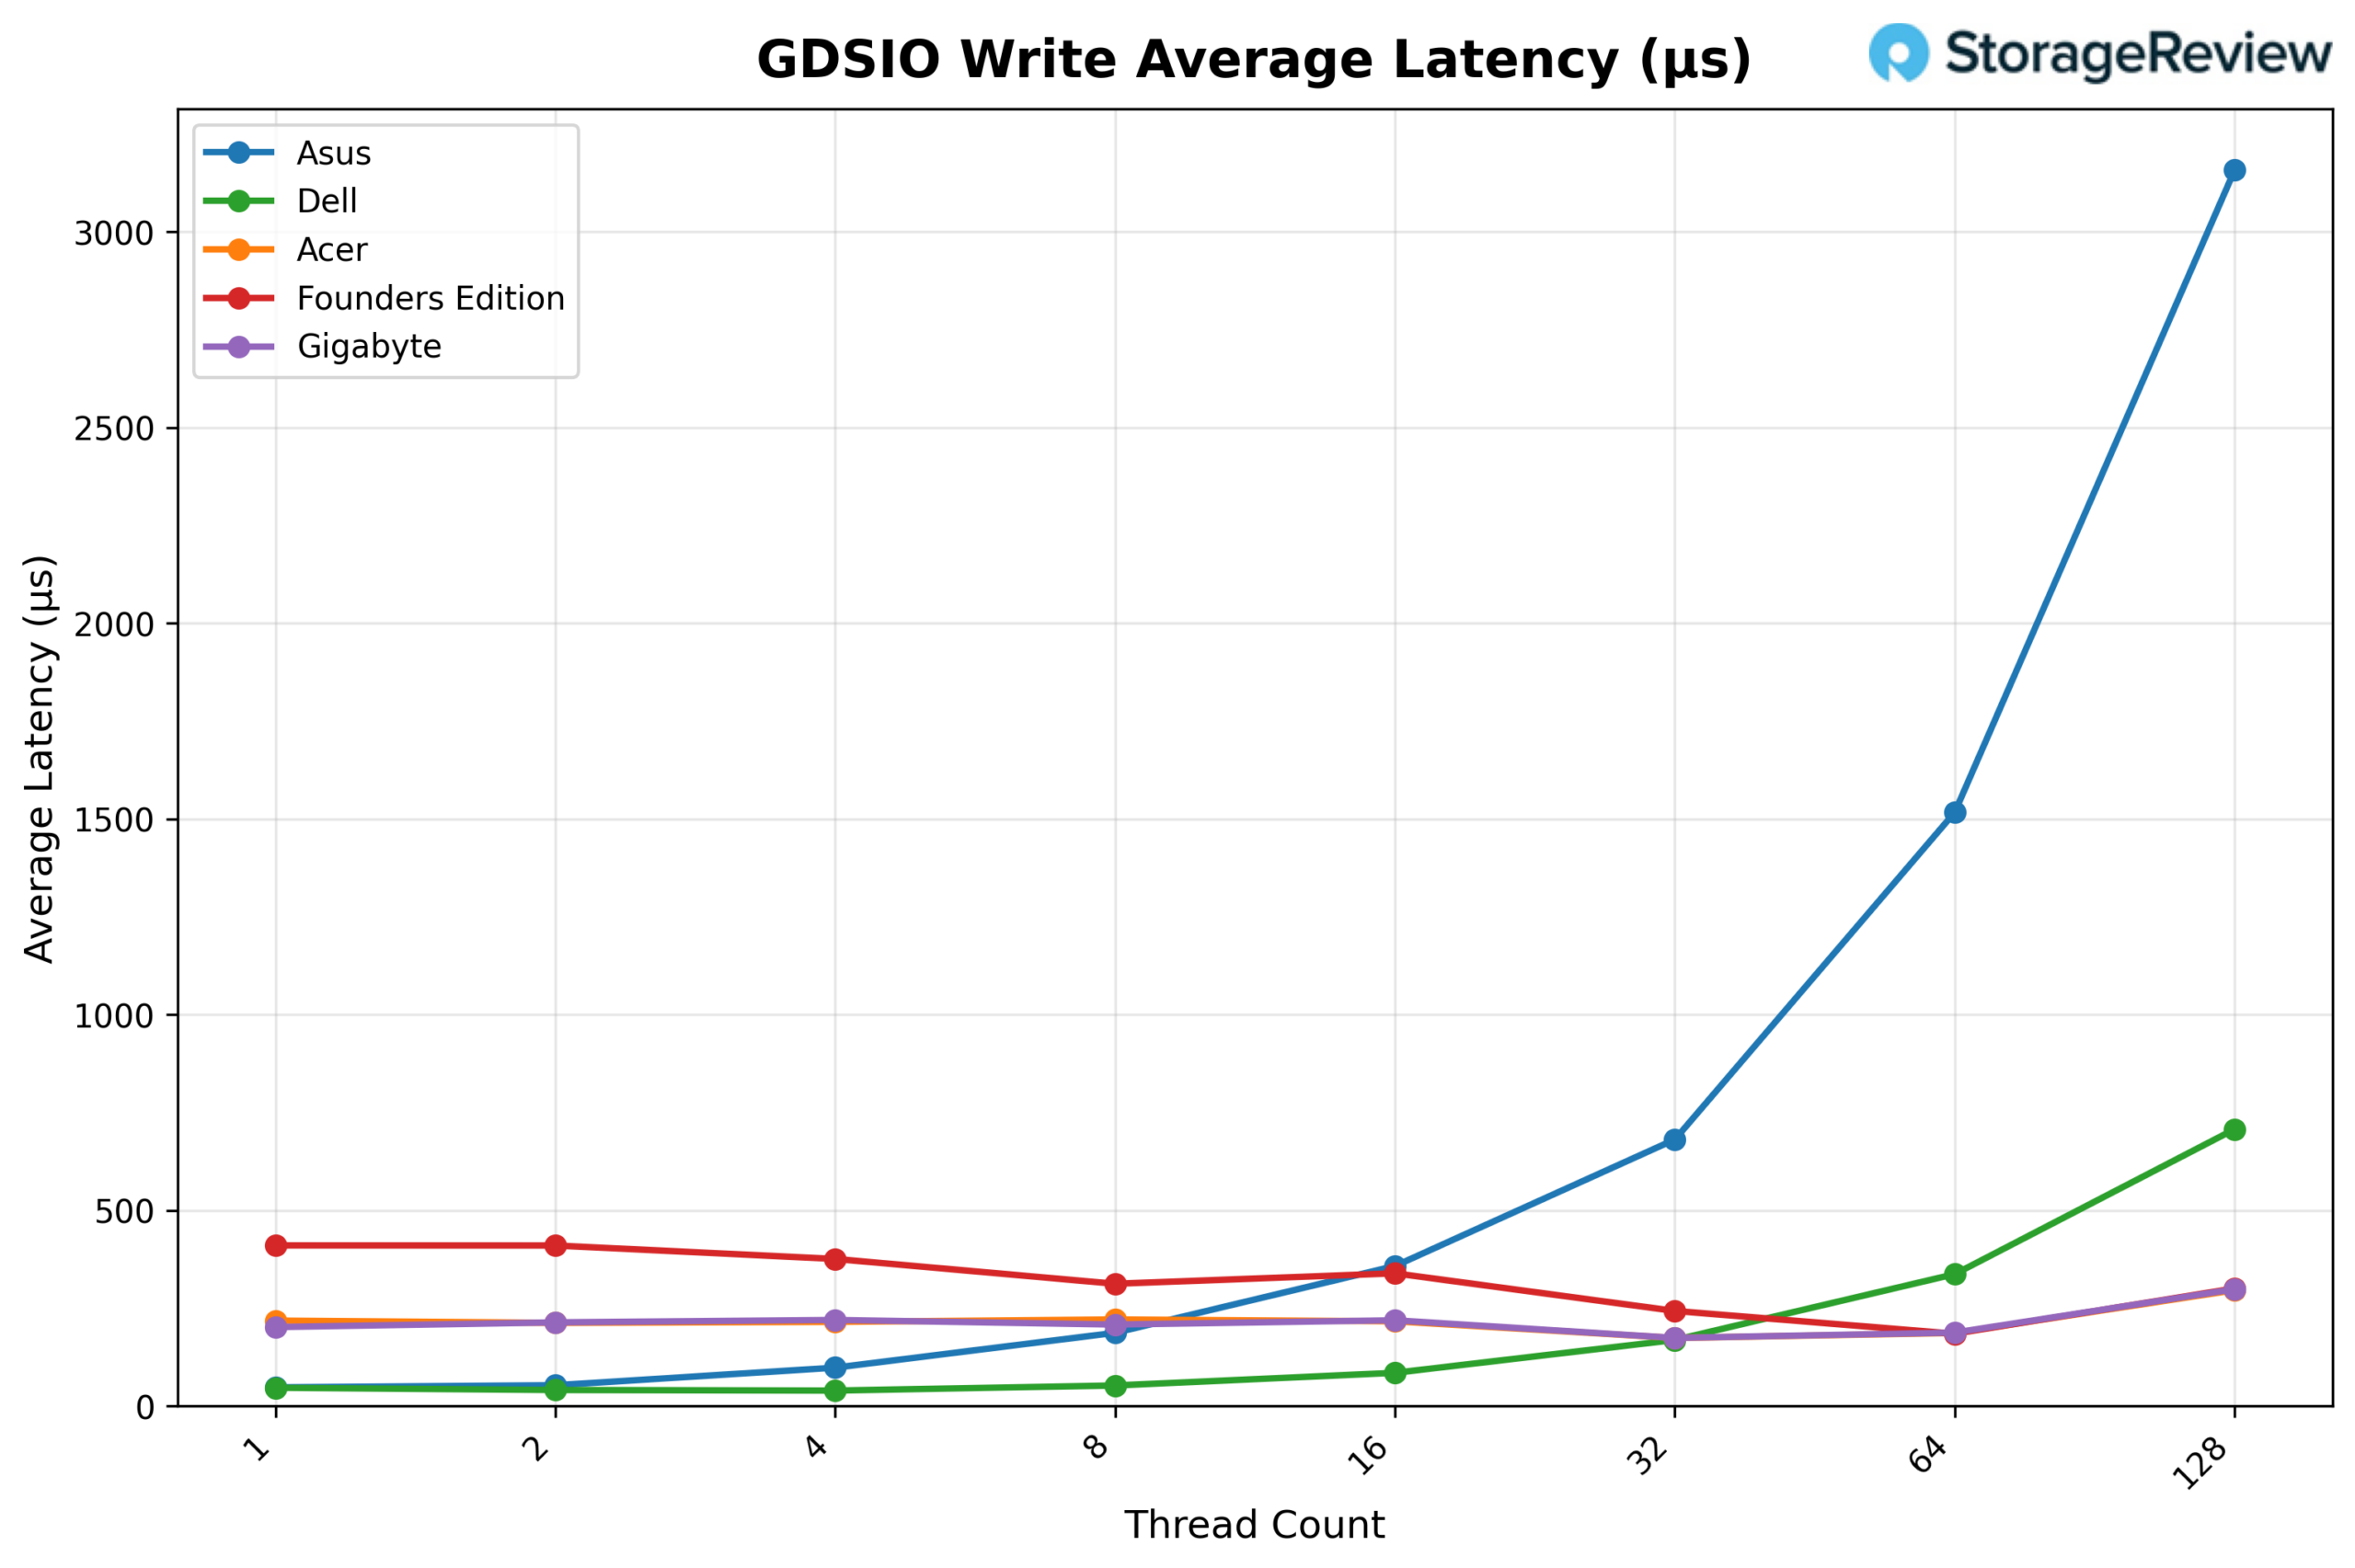
GDSIO Write Average Latency (16K) ကိုကြည့်မယ်ဆိုရင် Acer ဟာ thread ၁ ခုနဲ့ ၀.၂၂ms လောက်ကနေစပြီး thread ၂ ခု (၀.၂၁ms)၊ thread ၄ ခု (၀.၂၂ms) နဲ့ thread ၈ ခု (၀.၂၂ms) မှာတည်ငြိမ်နေပါတယ်။ thread ၃၂ ခုမှာ latency က ၀.၁၇ms အထိအနည်းငယ်ကျဆင်းပြီး thread ၆၄ ခုမှာ ၀.၁၉ms အထိအနည်းငယ်မြင့်တက်လာပါတယ်။ thread ၁၂၈ ခုမှာ latency က ၀.၃၀ms အထိတက်လာပြီး ၁M ရလဒ်တွေနဲ့ယှဉ်ရင် အတော်လေးနိမ့်နေဆဲဖြစ်ပြီး ဒီ I/O အရွယ်အစားသေးငယ်တဲ့ scaling အပြုအမူနဲ့လည်းကိုက်ညီပါတယ်။
GDSIO ဖတ်ရှုမှုပမာဏ 1M
GDSIO Read Throughput 1M ကိုကြည့်မယ်ဆိုရင် Acer ဟာ thread တစ်ခုမှာ 2.64 GiB/s ကနေစတင်ပြီး thread နှစ်ခုမှာ 5.10 GiB/s နဲ့ thread လေးခုမှာ 9.80 GiB/s အထိ တိုးလာပါတယ်။ thread ရှစ်ခုနဲ့ဆိုရင် throughput က 11.23 GiB/s အထိရောက်ရှိပြီး နောက်ပိုင်းမှာ platform က ထိရောက်စွာ saturate ဖြစ်ပါတယ်။ thread ၁၆ ခု (11.22 GiB/s)၊ thread ၃၂ ခု (11.21 GiB/s) နဲ့ thread ၆၄ ခု (11.15 GiB/s) မှာ စွမ်းဆောင်ရည်က တသမတ်တည်းရှိနေပြီး တည်ငြိမ်တဲ့ plateau ကို ပြသနေပါတယ်။ thread ၁၂၈ ခုမှာ throughput က 11.19 GiB/s မှာ တည်ငြိမ်နေပြီး full sweep တစ်လျှောက် saturation ceiling ကို အတည်ပြုပေးပါတယ်။
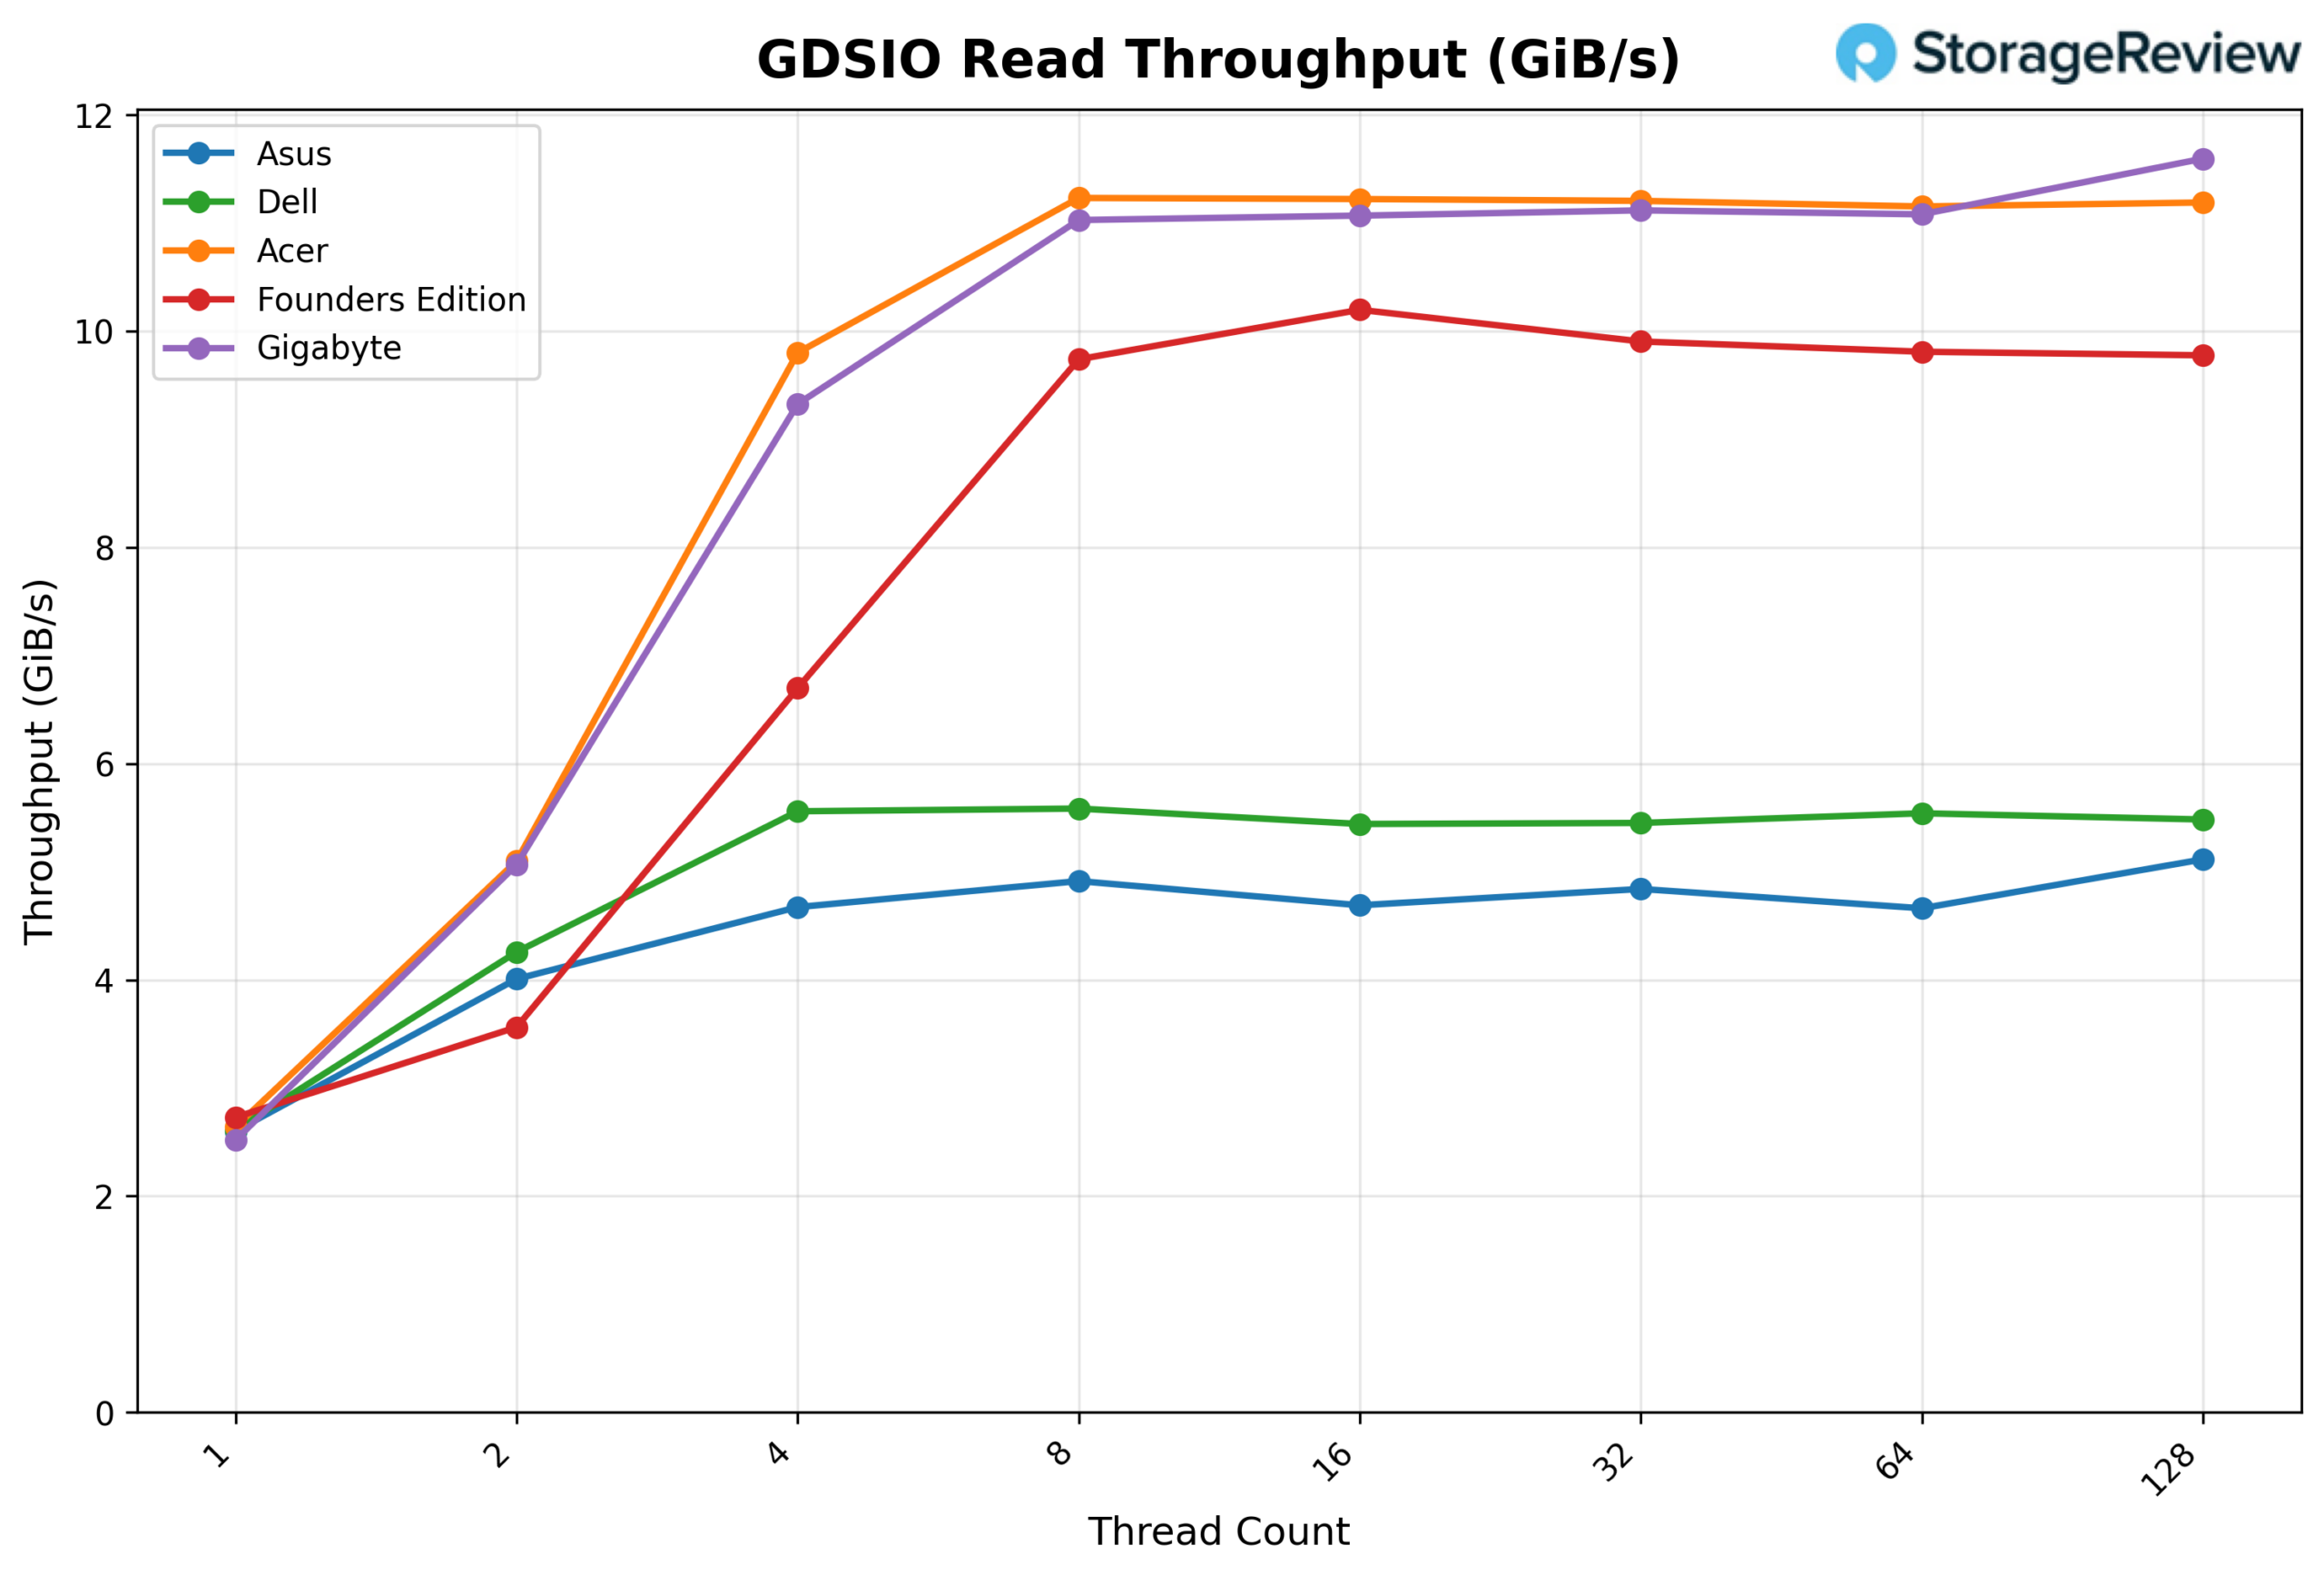
GDSIO ဖတ်ရှုမှု ပျမ်းမျှ နှောင့်နှေးမှု 1M
GDSIO Read Average Latency (1M) ကိုကြည့်မယ်ဆိုရင် Acer ဟာ thread 1 ခုမှာ 0.37ms လောက်ကနေစပြီး thread 2 ခု (0.38ms) နဲ့ thread 4 ခု (0.40ms) မှာ အတူတူပါပဲ။ Latency ဟာ တစ်ပြိုင်နက်တည်းဖြစ်ပေါ်မှုနဲ့အတူ တိုးလာပြီး thread 8 ခုမှာ 0.70ms၊ thread 16 ခုမှာ 1.39ms နဲ့ thread 32 ခုမှာ 2.79ms အထိ မြင့်တက်လာပါတယ်။ thread 64 ခု (5.60ms) မှာ အတက်ဘက်လမ်းကြောင်းက ဆက်လက်ရှိနေပြီး thread 128 ခုမှာ 11.17ms အထိ ရောက်ရှိပြီး အမြင့်ဆုံး တစ်ပြိုင်နက်တည်းဖြစ်ပေါ်မှုအဆင့်တွေနဲ့ ကိုက်ညီပေမယ့် throughput ကတော့ အများအားဖြင့် ထိန်းသိမ်းထားပါတယ်။
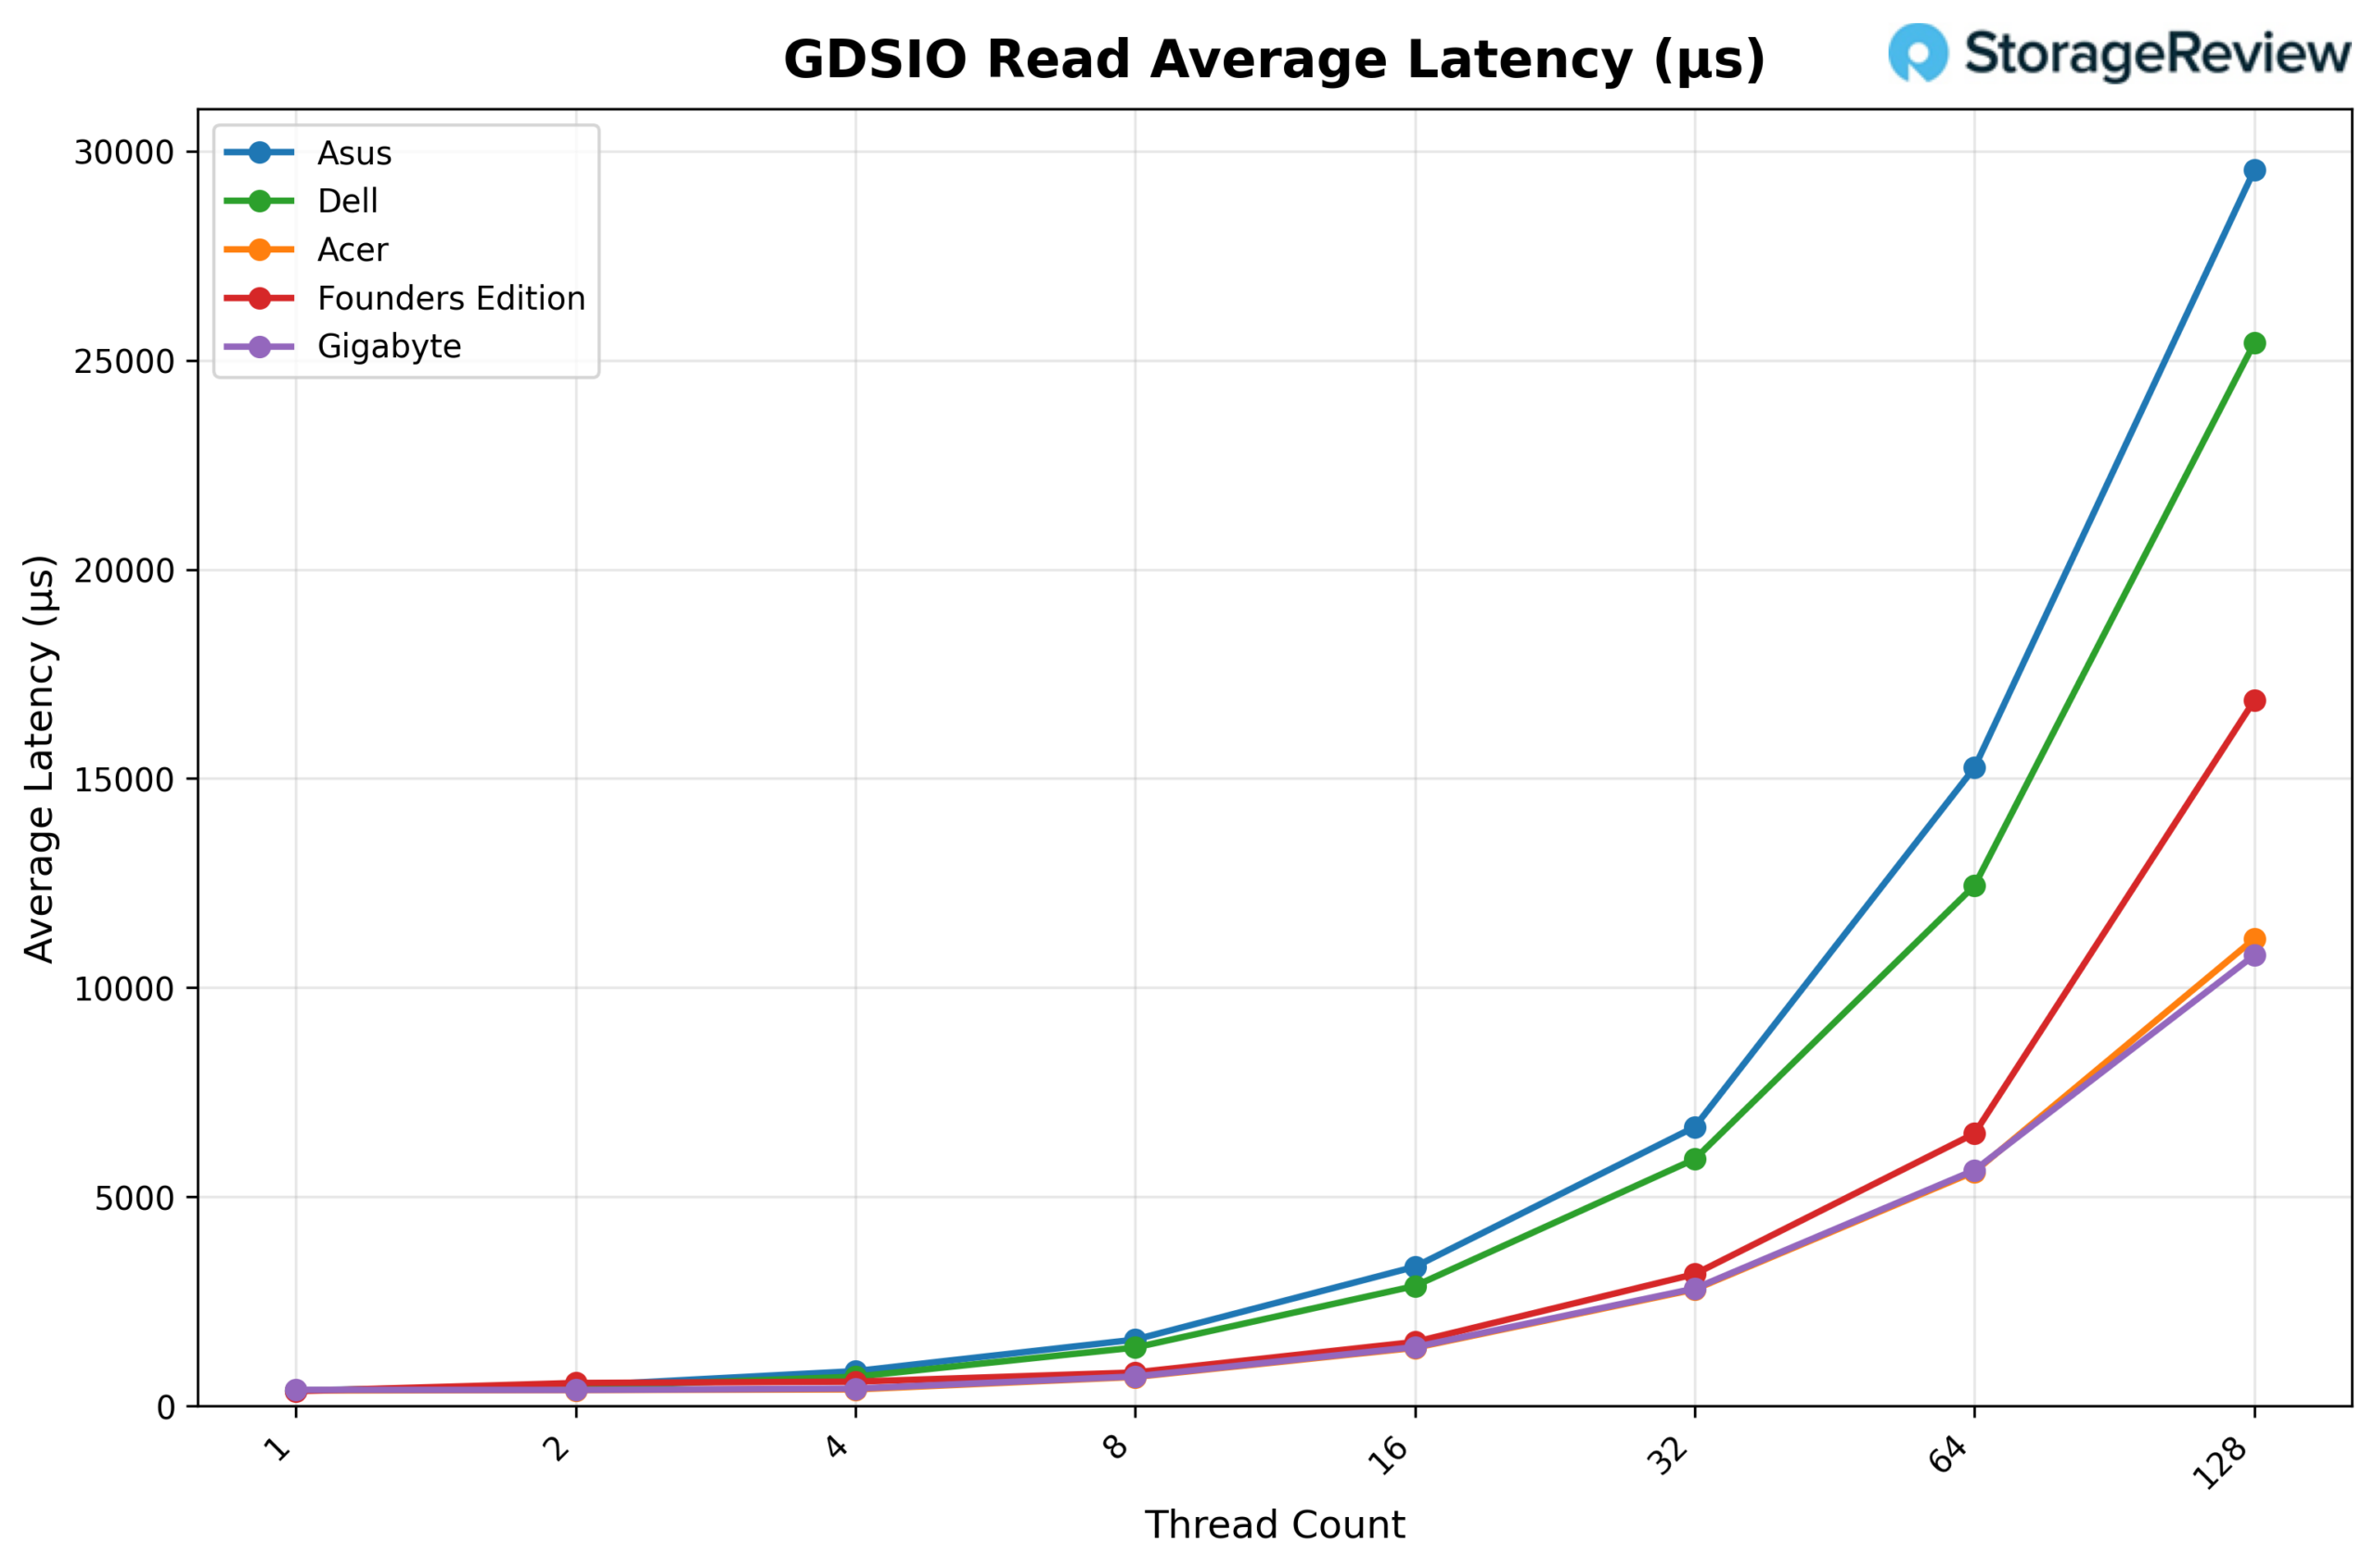
GDSIO ရေးသားမှုပမာဏ 1M
GDSIO Write Throughput 1M ကိုကြည့်မယ်ဆိုရင် Acer ဟာ thread တစ်ခုမှာ 2.79 GiB/s ကနေစတင်ပြီး thread နှစ်ခုမှာ 5.84 GiB/s နဲ့ thread လေးခုမှာ 10.72 GiB/s အထိ အားကောင်းလာပါတယ်။ thread ရှစ်ခုနဲ့ဆိုရင် throughput က 12.20 GiB/s အထိရောက်ရှိပြီး platform က ထိရောက်စွာ saturate ဖြစ်ပါတယ်။ thread ဆယ့်ခြောက်ခု (12.25 GiB/s)၊ thread ၃၂ ခု (12.24 GiB/s) နဲ့ thread ခုနစ်ခု (12.23 GiB/s) တို့မှာ စွမ်းဆောင်ရည်က တသမတ်တည်းရှိနေပြီး တည်ငြိမ်တဲ့ နှုန်းထားကို ပြသနေပါတယ်။ thread ဆယ့်ရှစ်ခုမှာဆိုရင် throughput က 8.94 GiB/s အထိ သိသိသာသာ ကျဆင်းသွားပြီး အမြင့်ဆုံး concurrency အဆင့်မှာ ယှဉ်ပြိုင်မှု ဒါမှမဟုတ် resource ကုန်ခန်းမှုကို ညွှန်ပြနေပါတယ်။
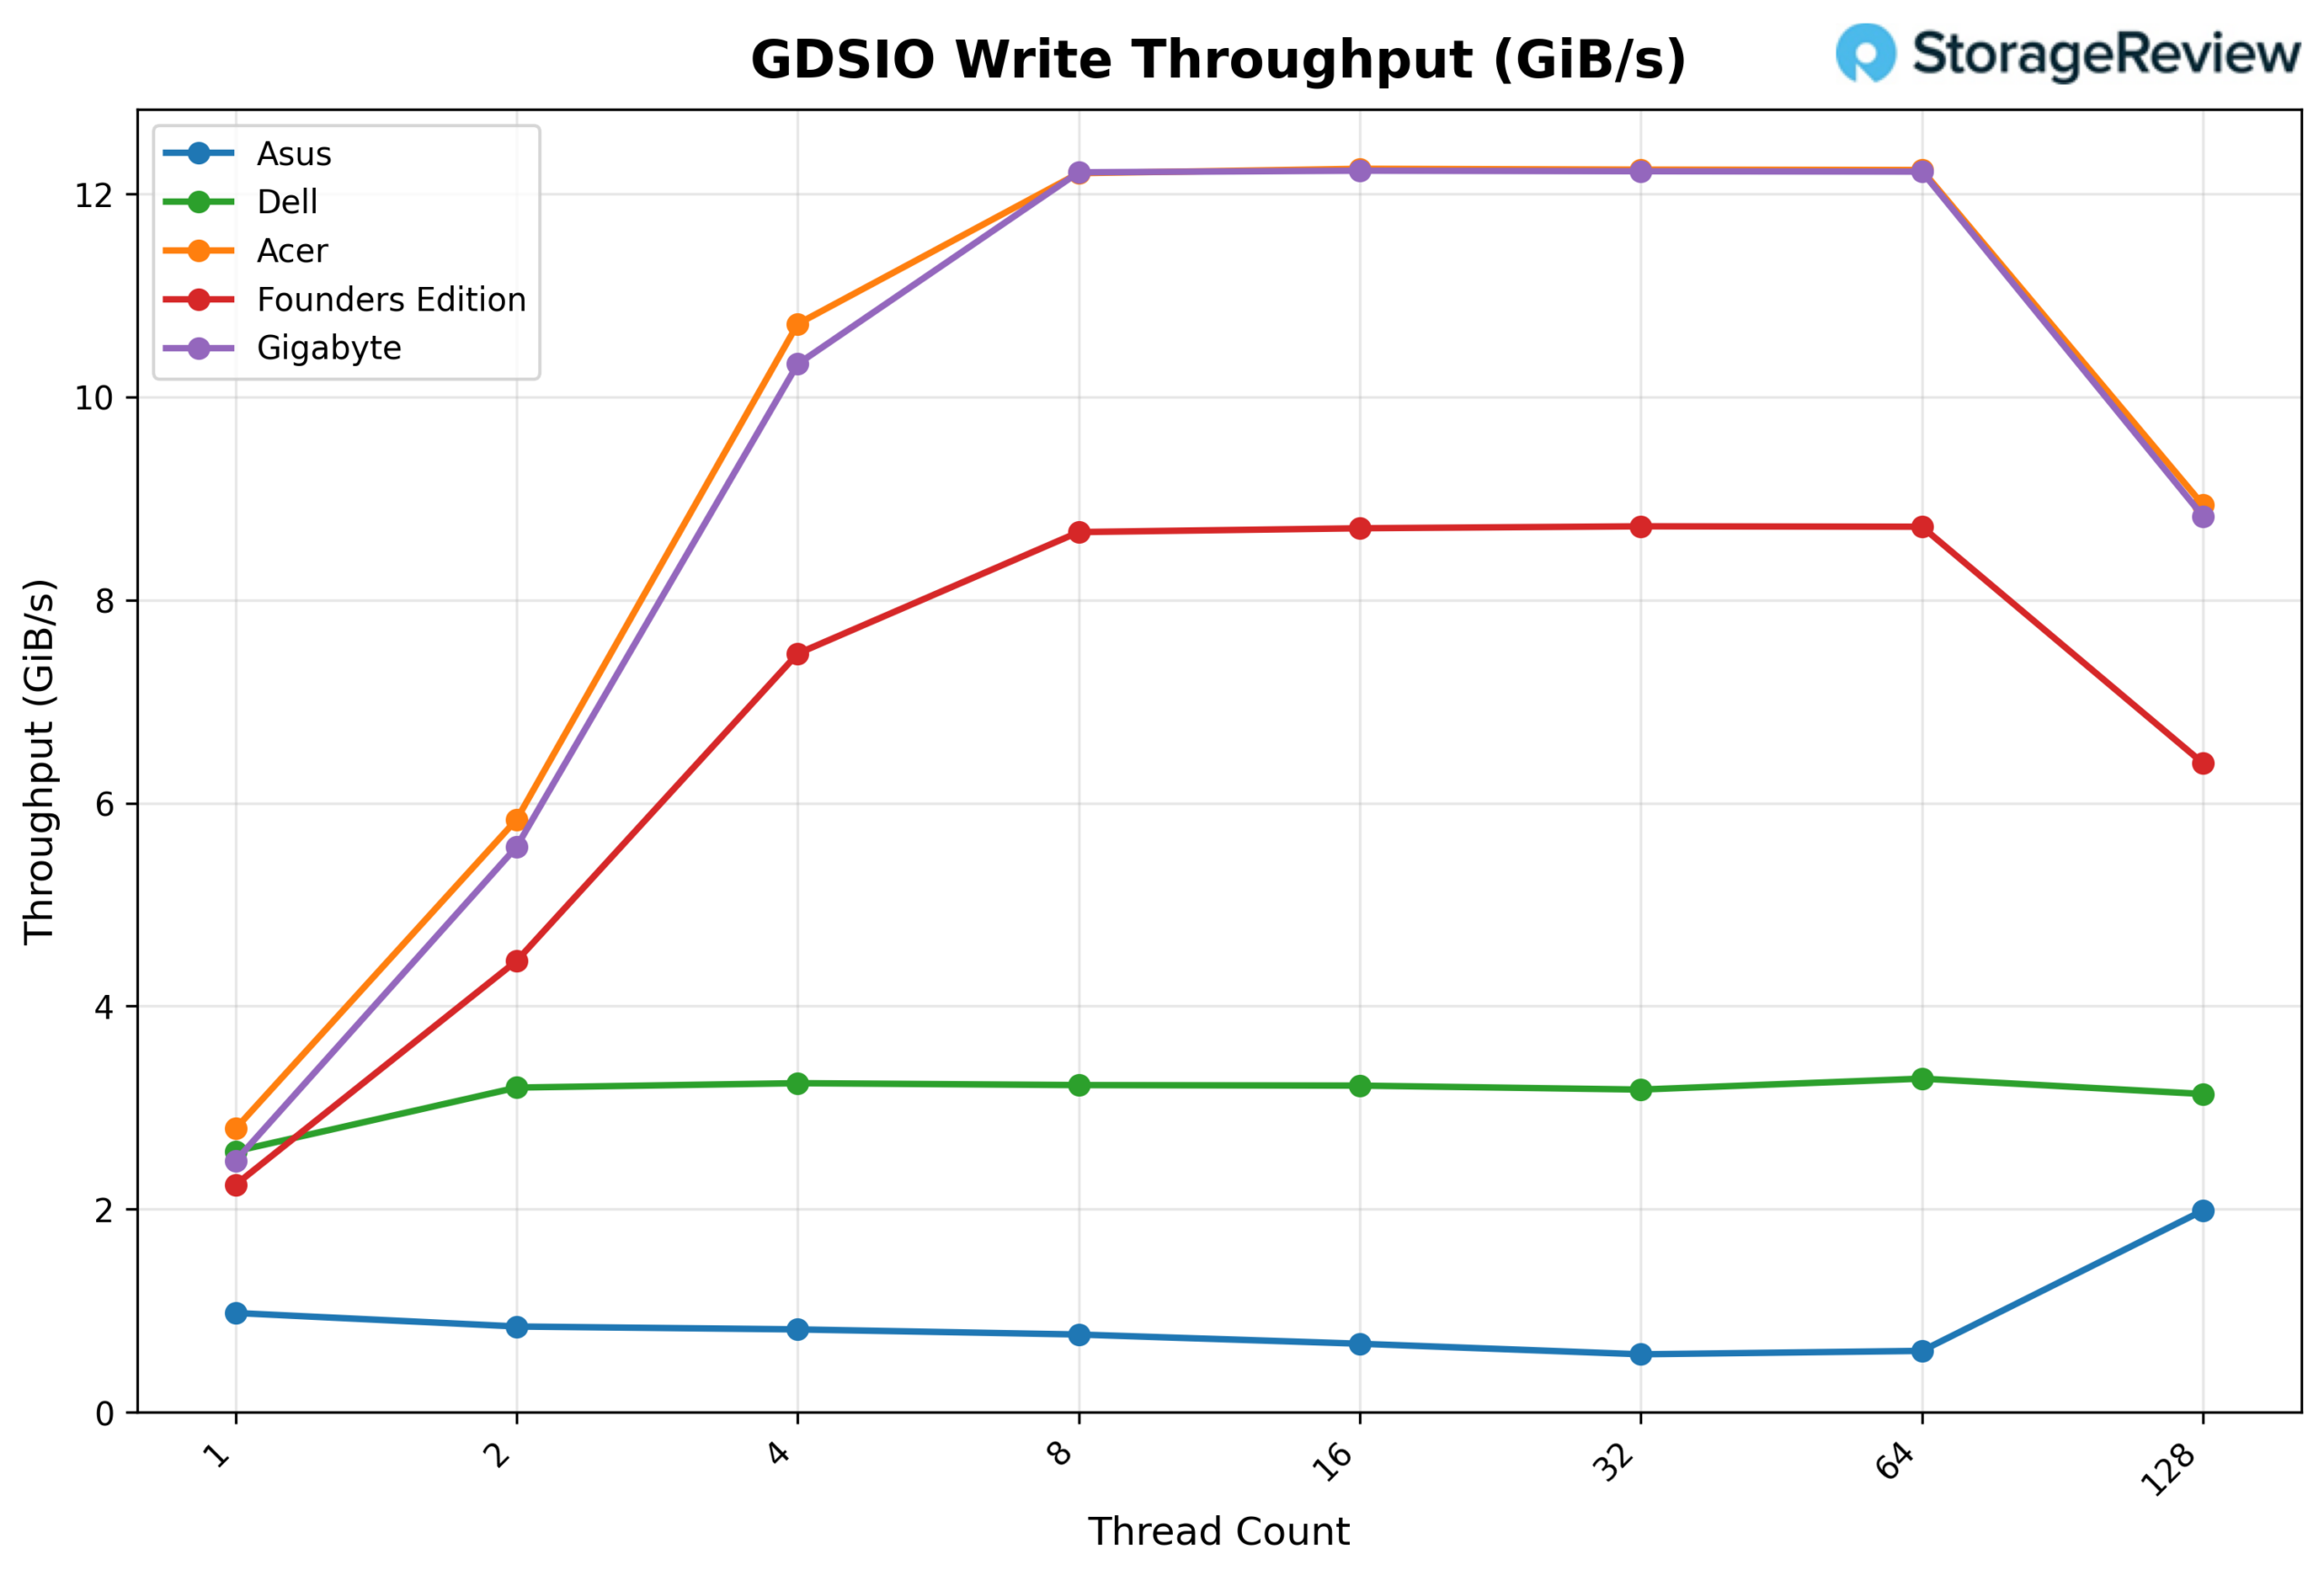
GDSIO ရေးသားမှုပျမ်းမျှ နှောင့်နှေးမှု 1M
GDSIO Write Average Latency (1M) ကိုကြည့်လျှင် Acer သည် thread ၁ ခုဖြင့် ၀.၃၅ms ခန့်မှစတင်ပြီး thread ၂ ခု (၀.၃၃ms) နှင့် thread ၄ ခု (၀.၃၆ms) တွင် နိမ့်နေသေးသည်။ Latency သည် မြင့်မားသော concurrency နှင့်အတူ မြင့်တက်လာပြီး thread ၈ ခုတွင် ၀.၆၄ms၊ thread ၁၆ ခုတွင် ၁.၂၈ms နှင့် thread ၃၂ ခုတွင် ၂.၅၅ms အထိ ရောက်ရှိခဲ့သည်။ thread ၆၄ ခု (၅.၁၁ms) တွင် အပေါ်သို့တက်နေသော လမ်းကြောင်းသည် ဆက်လက်ရှိနေပြီး thread ၁၂၈ ခုတွင် ၁၃.၉၈ms အထိ သိသိသာသာ မြင့်တက်လာပြီး အမြင့်ဆုံး concurrency တွင် တွေ့ရှိရသော throughput degradation နှင့် ကိုက်ညီပါသည်။
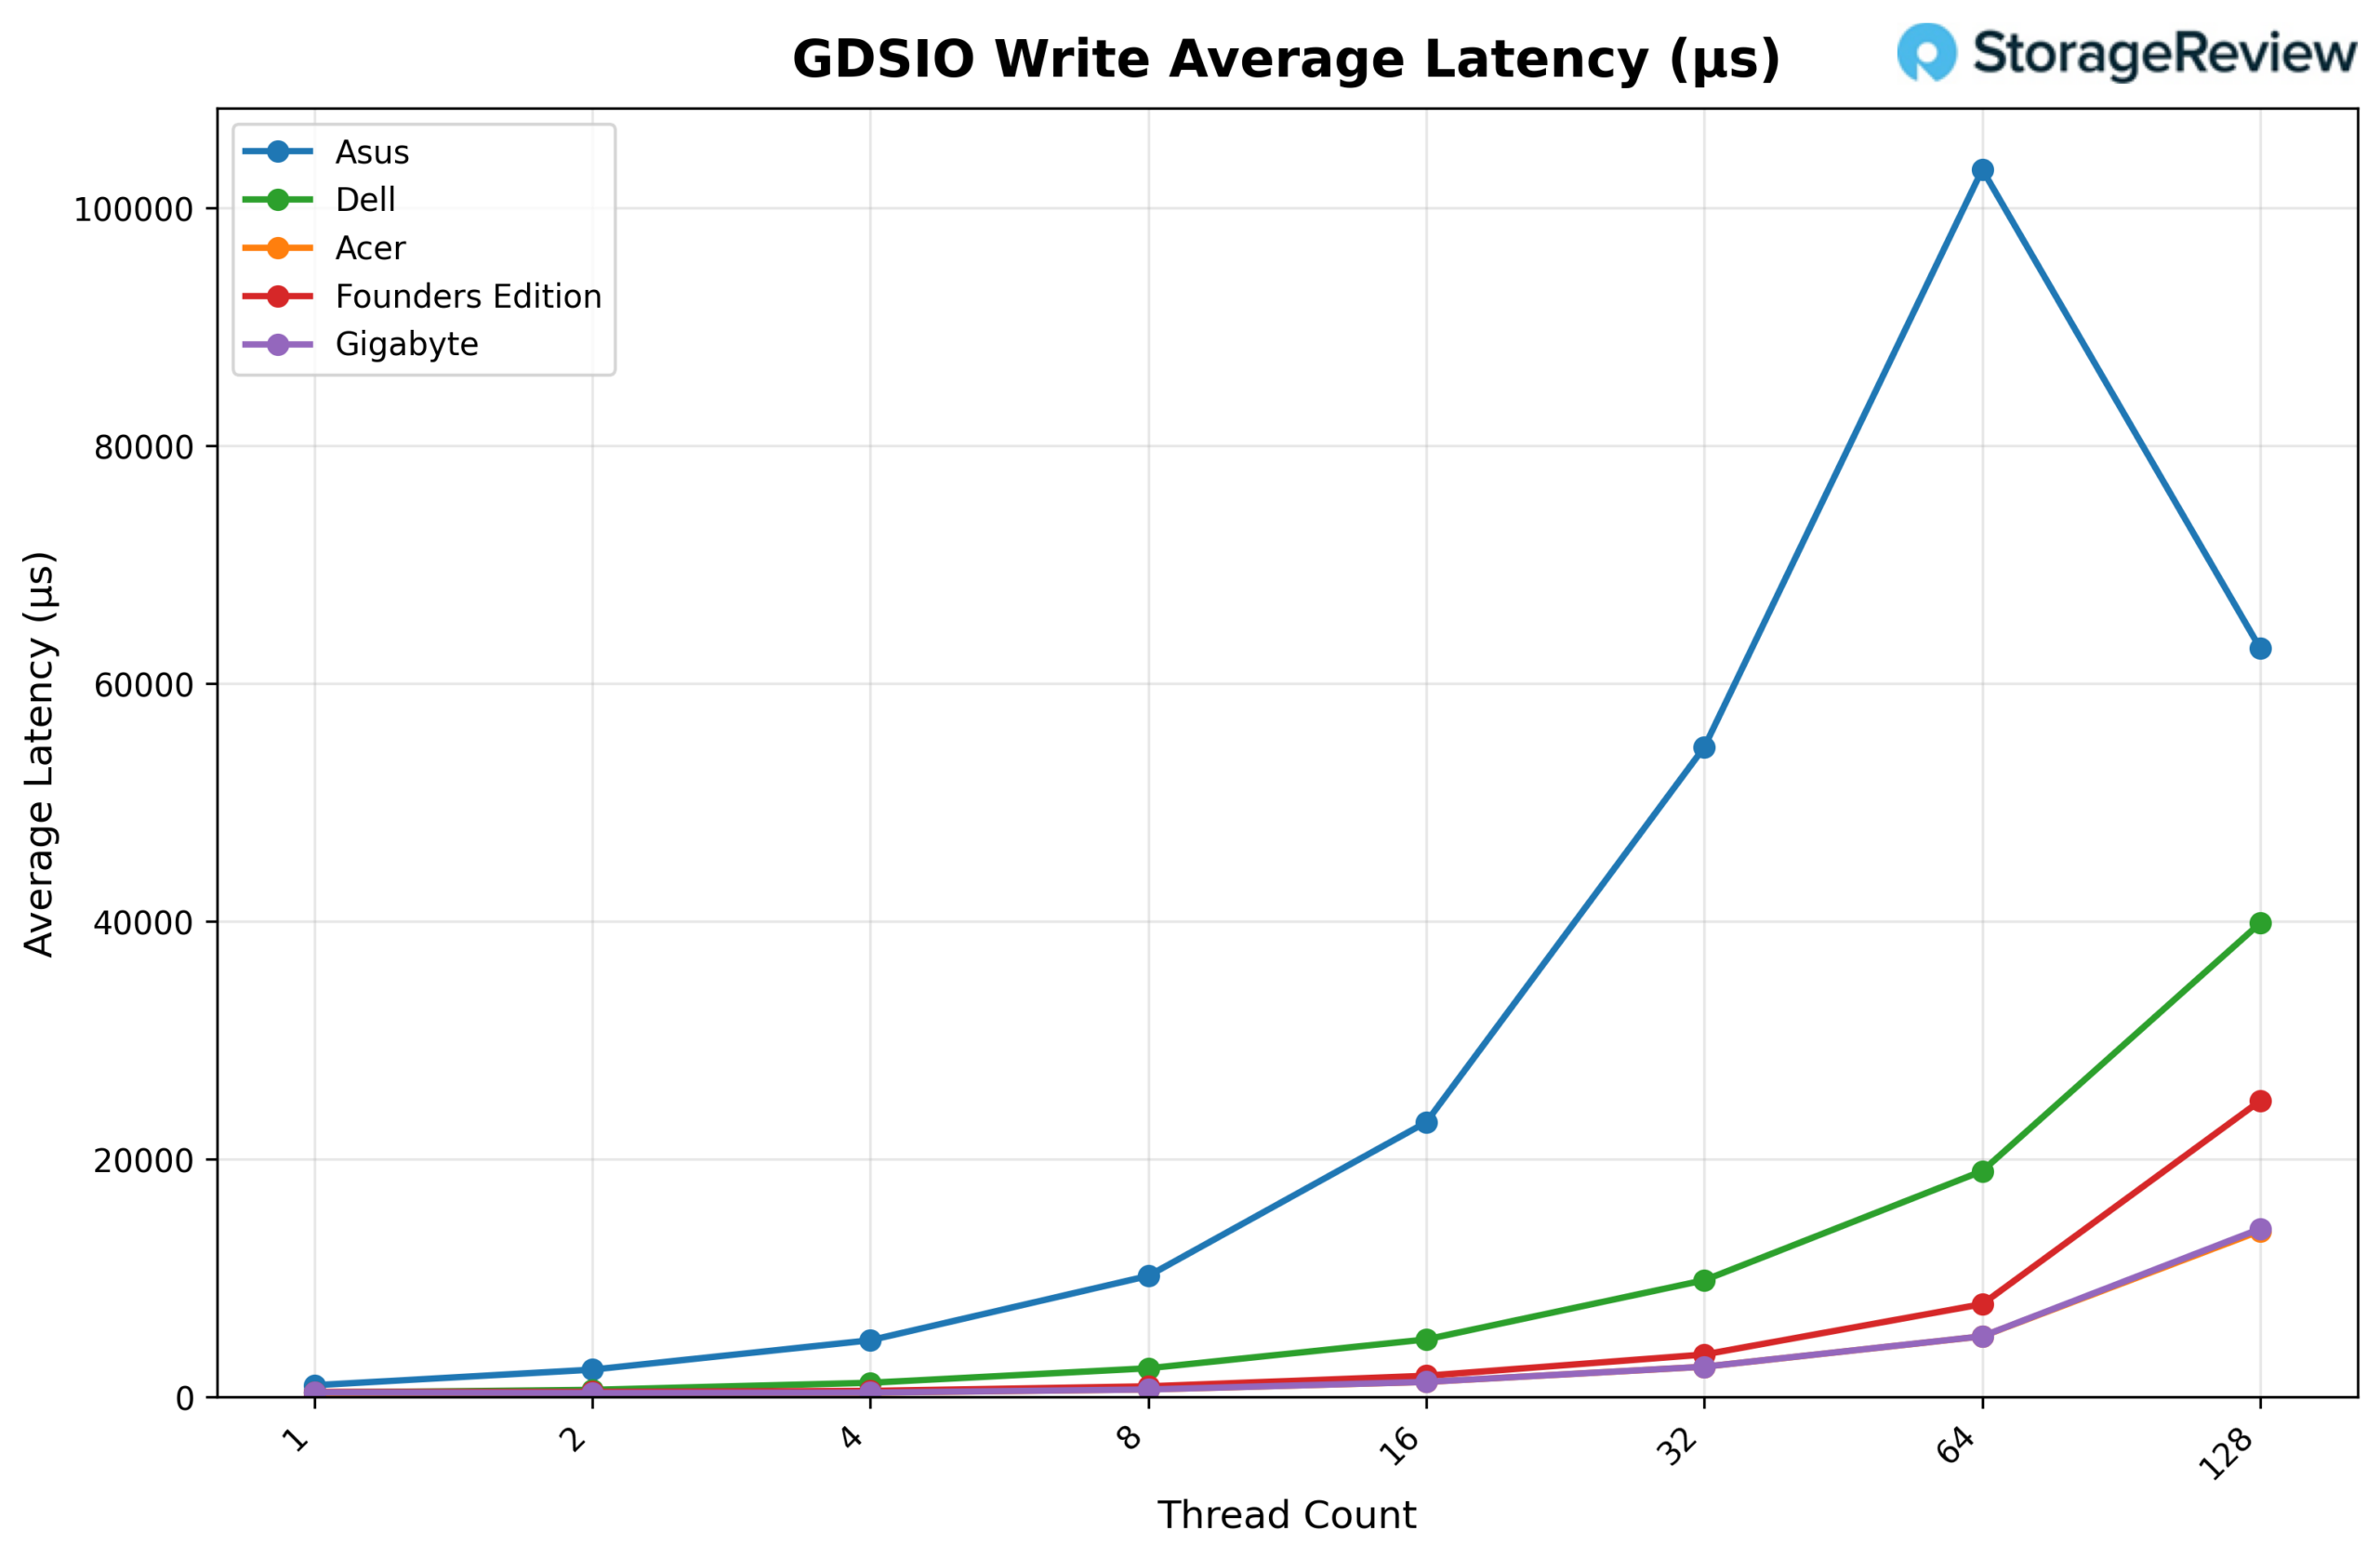
ကောက်ချက်
Acer Veriton GN100 သည် ကျွန်ုပ်တို့၏ Spark နှိုင်းယှဉ်ချက်တွင် အအေးဆုံး ಒಟ್ಟಾರೆ အပူချိန်ပရိုဖိုင်ကို ဖော်ပြခဲ့သည် ။ burst-heavy Prefill transitions နှင့် Decode workloads များကို စဉ်ဆက်မပြတ် လုပ်ဆောင်နေစဉ်အတွင်း ၎င်းသည် အုပ်စု၏ ကျန်အပိုင်းများထက် CPU နှင့် GPU အပူချိန်ကို နိမ့်ကျအောင် အဆက်မပြတ် ထိန်းသိမ်းထားနိုင်ခဲ့သည်။ load အောက်တွင် အထက် 80°C အတိုင်းအတာတွင် လည်ပတ်မည့်အစား၊ ရှည်လျားသော လည်ပတ်မှုများတစ်လျှောက်တွင် ပိုမိုထိန်းချုပ်ထားသော operating band အတွင်း ရှိနေခဲ့ပြီး၊ ထိရောက်သော airflow design နှင့် balanced power tuning ကို ညွှန်ပြသည်။
သိုလှောင်မှုစွမ်းဆောင်ရည်ကလည်း နောက်ထပ်ထင်ရှားတဲ့အားသာချက်တစ်ခုပါ။ 4TB Samsung PM9E1 Gen5 SSD တပ်ဆင်ထားတဲ့ GN100 ဟာ အုပ်စုထဲမှာ အားအကောင်းဆုံး small-block GPU Direct Storage scaling ကို ပေးစွမ်းခဲ့ပါတယ်။ 16K block size မှာ read နဲ့ write latency က thread count တွေမှာ သိသိသာသာ ပြားချပ်နေပြီး throughput ကတော့ ဇယားရဲ့ထိပ်ဆုံးကို သန့်ရှင်းစွာ scale လုပ်ထားပါတယ်။ 1M transfer တွေမှာ platform ဟာ saturation ကို မြန်မြန်ဆန်ဆန်ရောက်ရှိခဲ့ပြီး thread count အမြင့်ဆုံးမှာ လျော့ကျမသွားခင် အလယ်အလတ်အဆင့် concurrency မှာ ယှဉ်ပြိုင်နိုင်စွမ်းမြင့်မားတဲ့ ceilings ကို ထိန်းသိမ်းထားနိုင်ခဲ့ပါတယ်။
vLLM inference testing တွင်၊ GB10 foundation ကို မျှဝေထားသည့်အတိုင်း စွမ်းဆောင်ရည်သည် ပိုမိုကျယ်ပြန့်သော Spark ecosystem နှင့် တင်းကျပ်စွာ အုပ်စုဖွဲ့ထားဆဲဖြစ်သည်။ ခွဲခြားမှုသည် raw compute output တွင်မဟုတ်ဘဲ load အောက်ရှိ thermals နှင့် storage behavior တွင် ပေါ်ပေါက်လာခဲ့သည်။
Spark စီးရီးတစ်လျှောက်တွင်၊ ဗိသုကာပိုင်းဆိုင်ရာ တသမတ်တည်းရှိမှုသည် inference စွမ်းဆောင်ရည်ကို အနီးကပ်ညှိနှိုင်းပေးသည်။ ဤအသုတ်တွင် GN100 ကို ခွဲခြားသိမြင်စေသည်မှာ ၎င်း၏ အေးမြသော စဉ်ဆက်မပြတ်လည်ပတ်မှုပရိုဖိုင်နှင့် ခိုင်မာသော Gen5 NVMe စွမ်းဆောင်ရည်တို့ တွဲဖက်ထားခြင်းကြောင့်ဖြစ်ပြီး ၎င်းသည် ကျွန်ုပ်တို့ ယခုအချိန်အထိ စမ်းသပ်ဖူးသမျှတွင် အပူချိန်ထိရောက်မှုအရှိဆုံးနှင့် သိုလှောင်မှု-ရှေ့ဆောင်အကောင်အထည်ဖော်မှုများထဲမှ တစ်ခုဖြစ်စေသည်။
ထုတ်ကုန်စာမျက်နှာ – Acer Veritron GN 100 AI

ဦးဆောင်သူစာရင်း- Acer Veriton GN100 သည် ကျွန်ုပ်တို့၏ ဒေသတွင်း AI အတွက် အကောင်းဆုံး Desktops စာရင်းတွင် အကောင်းဆုံး GB10 အကောင်အထည်ဖော်မှုနေရာကို ရယူထားသည်။


 အမေဇုံ