

ဇွန်လတွင် AMD သည် စီးပွားရေးလုပ်ငန်းများ၏ လိုအပ်ချက်များကို ဖြေရှင်းရန် လိုအပ်သော အထူးပြု workloads များအတွက် ဒီဇိုင်းထုတ်ထားသော ၎င်း၏ 4th Gen AMD EPYC ပရိုဆက်ဆာမိသားစုအတွက် အပ်ဒိတ်များကို ကြေညာခဲ့သည်။ ယခင်က AMD Bergamo ဟု ကုဒ်နံပါတ်ပေးထားသော 4th Gen AMD EPYC 97X4 ပရိုဆက်ဆာများကို မိတ်ဆက်ခြင်းနှင့်အတူ AMD ၏ Data Center နှင့် AI Technology Premiere ဖွင့်ပွဲတွင် ကြေညာခဲ့သည်။ AMD EPYC 97X4 ပရိုဆက်ဆာများသည် ပိုမိုကောင်းမွန်သော vCPU သိပ်သည်းဆနှင့် cloud တွင် လည်ပတ်နေသော AI အပလီကေးရှင်းများနှင့် အပလီကေးရှင်းများကို ပစ်မှတ်ထားသည့် စွမ်းဆောင်ရည်ကို မြှင့်တင်ပေးပါသည်။

AMD ဘာဂါမို
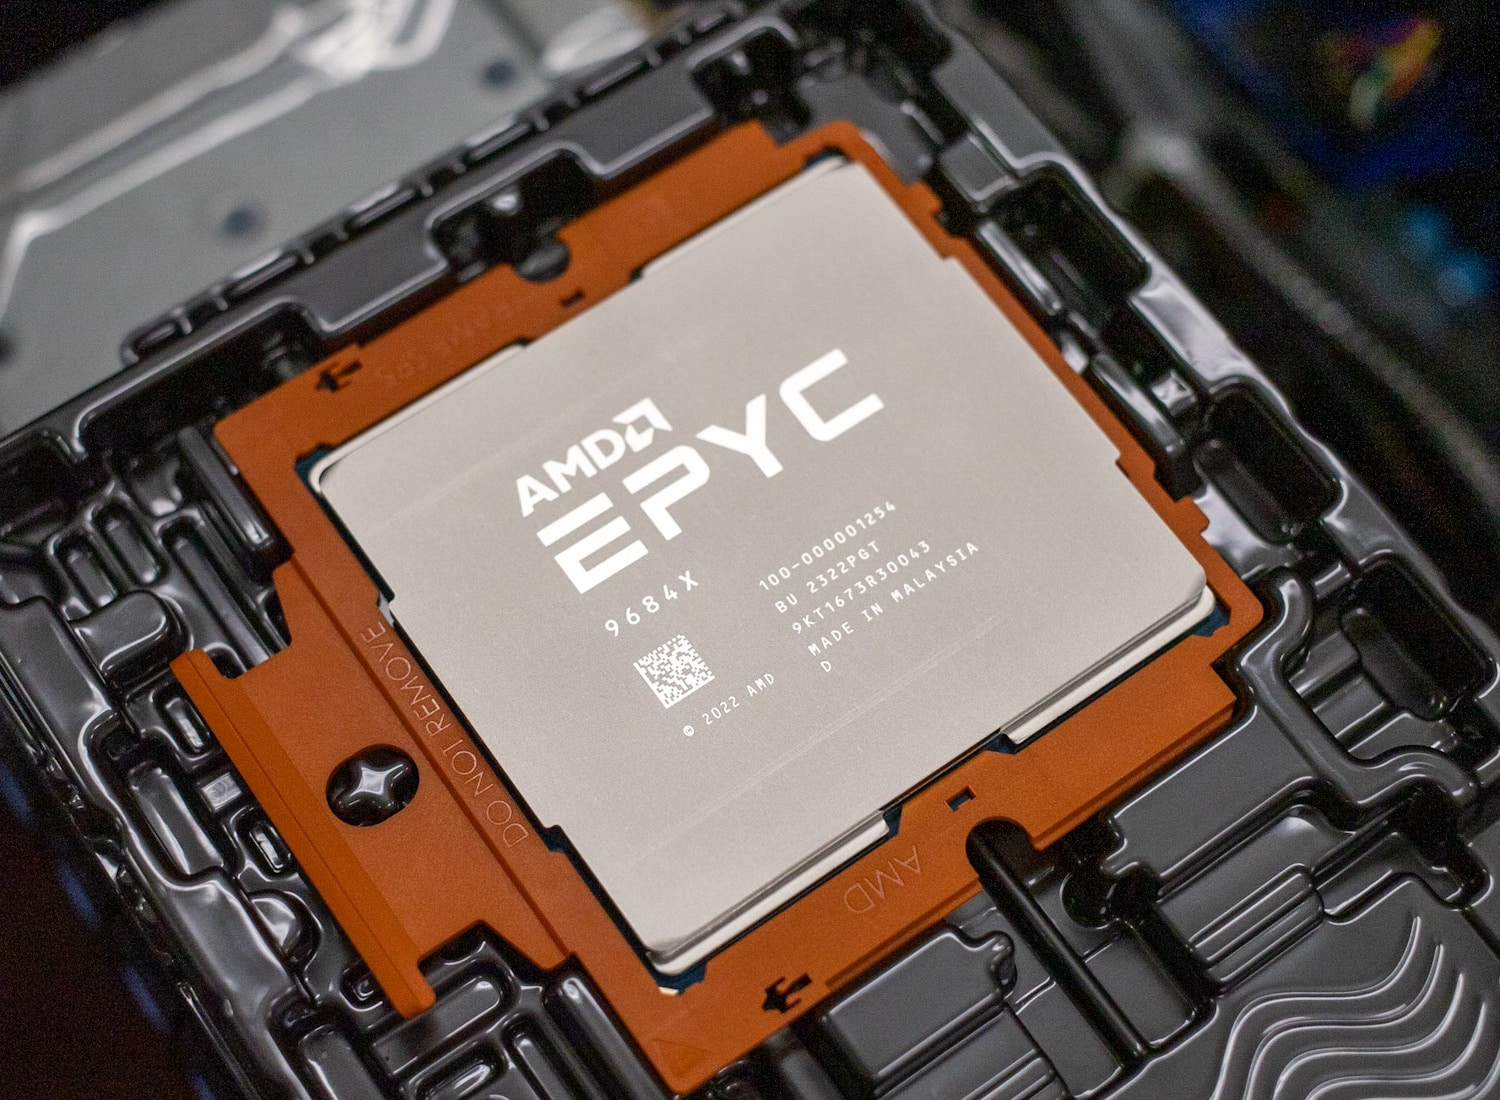
Genoa-X ဟု ကုဒ်ဝှက်ထားသော 3D V-Cache တပ်ဆင်ထားသည့် AMD EPYC Zen 4 ပရိုဆက်ဆာများကို မကြာသေးမီက SPEC.org အစီရင်ခံစာတွင် နည်းပညာဆိုင်ရာ ကွန်ပျူတာအတွက် ဦးဆောင် x86 server CPU အဖြစ် သတ်မှတ်ခဲ့သည်။ ဤပရိုဆက်ဆာများသည် 96-core Zen 4 ချစ်ပ်များသို့ 3D V-Cache ကို ယူဆောင်လာပြီး တောင်းဆိုမှုများသော နည်းပညာဆိုင်ရာ ကွန်ပျူတာ workloads များအတွက် အထူးသင့်လျော်ပါသည်။
AMD ၏ အဆိုအရ ၎င်း၏ ထုတ်ကုန်လမ်းပြမြေပုံကို ဖောက်သည်များ၏ ပတ်ဝန်းကျင်နှင့် ကိုက်ညီအောင် ပြုလုပ်ခြင်းဖြင့် အထွေထွေရည်ရွယ်ချက်၊ cloud-native နှင့် နည်းပညာဆိုင်ရာ computing workloads များအတွက် လိုအပ်သော စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ပါသည်။ AMD သည် အရွယ်အစားတစ်ခုတည်းဖြင့် အားလုံးနှင့် မကိုက်ညီဟူသော ရပ်တည်ချက်ကို ခံယူထားသည်။ ဤ AMD EPYC ပရိုဆက်ဆာအသစ်များကို သီးခြား workloads များအတွက် စွမ်းဆောင်ရည် တိုးမြှင့်ပေးနိုင်ရန်အတွက် ထိုသဘောတရားကို အခြေခံ၍ ဒီဇိုင်းထုတ်ထားသည်။

အပလီကေးရှင်းများကို cloud-native workloads များအတွက် ပိုမိုဒီဇိုင်းထုတ်လာသောကြောင့် အလျင်အမြန် ဖွံ့ဖြိုးတိုးတက်မှု၊ ဖြန့်ကျက်မှုနှင့် အပ်ဒိတ်များကို ခွင့်ပြုပါသည်။ 128 cores ပါရှိသော AMD EPYC 97X4 ပရိုဆက်ဆာများသည် Ampere နှင့် နှိုင်းယှဉ်ပါက အဓိက cloud-native workloads များအတွက် 3.7x ပိုကောင်းသော throughput ကို ပေးစွမ်းနိုင်ပါသည်။
| ပုံစံ | အရောင်များ | မက်စ်ချည်များ | မူရင်း TDP (W) | အခြေခံကြိမ်နှုန်း (GHz) | မြှင့်တင်ရန် ကြိမ်နှုန်း ၁ (GHz) | L3 ကက်ရှ် (MB) |
| 9754 | 128 | 256 | 360W | 2.25 | 3.10 | 256 |
| 9754S | 128 | 128 | 360W | 2.25 | 3.10 | 256 |
| 9734 | 112 | 224 | 320W | 2.20 | 3.00 | 256 |
ပိုမိုမြန်ဆန်သော ဒီဇိုင်းထပ်ခါတလဲလဲလုပ်ဆောင်ခြင်းနှင့် ပြီးပြည့်စုံသော သရုပ်ဖော်မှုများ လိုအပ်မှုကို ဖြေရှင်းပေးသည့် 3D V-Cache ပါရှိသော စတုတ္ထမျိုးဆက် AMD EPYC ပရိုဆက်ဆာများသည် computational fluid dynamics (CFD)၊ finite element analysis (FEA)၊ electronic design automation (EDA) နှင့် structural analysis ကဲ့သို့သော နည်းပညာဆိုင်ရာ computing workloads များအတွက် အကောင်းဆုံး x86 CPU ကို ပေးဆောင်ပါသည်။ ဤပရိုဆက်ဆာများတွင် “Zen 4” cores ၉၆ ခုအထိ နှင့် L3 cache 1GB+ ရှိပြီး ထုတ်ကုန်ဖွံ့ဖြိုးတိုးတက်မှုကို သိသိသာသာ မြန်ဆန်စေနိုင်သည်။
| ပုံစံ | အရောင်များ | မက်စ်ချည်များ | မူရင်း TDP (W) | အခြေခံကြိမ်နှုန်း (GHz) | မြှင့်တင်ရန် ကြိမ်နှုန်း ၁ (GHz) | L3 ကက်ရှ် (MB) |
| 9684X | 96 | 192 | 400W | 2.55 | 3.70 | 1,152 |
| 9384X | 32 | 64 | 320W | 3.10 | 3.90 | 768 |
| 9184X | 16 | 32 | 320W | 3.55 | 4.20 | 768 |
AMD Bergamo နှင့် Genoa-X စံနှုန်းများ
ကျွန်တော်တို့ CPU အသစ်နှစ်ခုကို စမ်းသပ်ပြီး SMT ကို disable လုပ်ခြင်းဖြင့် တတိယတစ်ခုကို simulate လုပ်ခဲ့ပါတယ်။ ဓာတ်ခွဲခန်းမှာ 9754၊ 128 core 256 thread Bergamo chip နဲ့ 9684X၊ 3D L3 cache 1.1 GB ရှိပြီး Genoa ထက် clock ပိုမြင့်တဲ့ 96 core 192 thread Genoa-X chip တို့ ပါဝင်ပါတယ်။ တတိယတစ်ခုကို simulate လုပ်ဖို့အတွက် AMD က multithreading မပါတဲ့ 9754S Bergamo chip ကိုလည်း ထုတ်လုပ်ထားတာကြောင့် ကျွန်တော်တို့ရဲ့ 9754 မှာ SMT ကို disable လုပ်ခဲ့ပါတယ်။ SMT-disabled chip ကို စမ်းသပ်တာက ဒီသုံးသပ်ချက်နဲ့ သီးခြားစီ ဖြစ်ပါလိမ့်မယ်။
မကြာသေးမီကထွက်ရှိထားသော AMD Bergamo နှင့် Genoa-X CPU များ၏ စွမ်းဆောင်ရည်ကို အကဲဖြတ်ရန်အတွက် ကျွန်ုပ်တို့သည် ကျယ်ပြန့်သော benchmark အစုံကို ပြုလုပ်ခဲ့ပါသည်။ Multi-core နှင့် Single-core configuration များတွင် Cinebench R23 စမ်းသပ်မှုများဖြင့် စတင်ခဲ့ပြီး ဤ processor များ၏ rendering စွမ်းရည်များအကြောင်း အဖိုးတန်သော အသိအမြင်များကို ပေးခဲ့ပါသည်။
Cinebench R23 application ကိုယ်တိုင်က thread အများကြီးကို ဘယ်လိုကိုင်တွယ်နိုင်မလဲဆိုတာမှာ အကန့်အသတ်ရှိပုံရပါတယ်။ 128 cores မှာသာ ကန့်သတ်ထားတာကို ကျွန်တော်တို့ သတိထားမိပေမယ့် 96 Core Genoa-X 3D Cache က စွမ်းဆောင်ရည်မှာ တကယ်ကို ထူးချွန်ပြီး စမ်းသပ်မှုအားလုံးမှာ အသုံးများမယ့် themes တွေပါ။

နောက်တစ်ခုအနေနဲ့ y-cruncher ကို ၁ ဘီလီယံနဲ့ ၁၀ ဘီလီယံ ဂဏန်းအဆင့်တွေမှာ တွက်ချက်မှုစွမ်းရည်ကို အကဲဖြတ်ဖို့၊ အထူးသဖြင့် ဂဏန်းတွက်ချက်မှု မြင့်မားတဲ့ အလုပ်တွေအတွက်ပါ။
ဒီမှာ ပိုနိမ့်တာက ပိုကောင်းပါတယ်၊ ကျွန်တော်တို့ရဲ့ 2 processor 96 core Genoa ရလဒ်တွေကို ကျယ်ကျယ်ပြန့်ပြန့် ချိန်ညှိမှုတွေ ပြုလုပ်ပြီး ကောင်းမွန်တဲ့ ဂဏန်းတွေကို ပေးနိုင်ခဲ့ပြီး Genoa-X နဲ့ Bergamo ချစ်ပ်နှစ်ခုလုံးရဲ့ stock configuration က ပိုပြီး အထင်ကြီးစရာကောင်းတဲ့ မှတ်တမ်းဝင် ဂဏန်းတွေကို ပေးစွမ်းနိုင်ဖို့ ချိန်ညှိမှုနဲ့ ချိန်ညှိမှုတို့အတွက် အလားအလာကောင်းတွေကို ပြသနေပါတယ်။

ထို့နောက် ကျွန်ုပ်တို့သည် Blender benchmarks၊ အထူးသဖြင့် Monster၊ Junkshop နှင့် Classroom စမ်းသပ်မှုများကို အသုံးပြု၍ ဤ CPU များသည် ဂရပ်ဖစ်အားဖြင့် အလွန်အမင်း ပြင်းထန်သော rendering အခြေအနေများတွင် မည်မျှကောင်းမွန်စွာ စွမ်းဆောင်ရည်ကို တိုင်းတာခဲ့သည်။
Blender benchmark မှာ 512 threads ရဲ့ raw power က တကယ်ကို ထင်ရှားပြီး stock configuration နဲ့ ဇယားထိပ်ဆုံးမှာ ထပ်မံရပ်တည်နိုင်ခဲ့ပါတယ်။

နောက်ဆုံးအနေနဲ့ single-core နဲ့ multi-core လုပ်ဆောင်ချက်တွေမှာ processor စွမ်းဆောင်ရည်ကို ကျယ်ကျယ်ပြန့်ပြန့် စစ်ဆေးမှုအတွက် လူသိများတဲ့ Geekbench 6 CPU စမ်းသပ်မှုတွေကို ကျွန်တော်တို့ လုပ်ဆောင်ခဲ့ပါတယ်။ ဒီစမ်းသပ်မှုအစုံက AMD Bergamo နဲ့ Genoa-X processor တွေရဲ့ အလုံးစုံစွမ်းရည်၊ အားသာချက်နဲ့ တဖြည်းဖြည်းတိုးတက်မှုတွေကို ပြည့်စုံတဲ့အမြင်နဲ့ ပေးစွမ်းခဲ့ပါတယ်။

စွမ်းဆောင်ရည်ခြုံငုံသုံးသပ်ချက်
benchmark တစ်ခုချင်းစီအတွက် raw scores တွေကို ဖော်ပြပေးလိုက်ပါတယ်။ 96-core Genoa system မှာ tuning နဲ့ configuration လုပ်ဖို့ လပေါင်းများစွာ အချိန်ရခဲ့ပြီး AMD Bergamo အသစ်ရဲ့ stock configuration ကိုပဲ run ခဲ့တယ်ဆိုတာ မမေ့ပါနဲ့။
| benchmark | ၂ ပဲနီ/၉၆ ဆင့် ဂျီနိုအာ | ၁ ပဲ/၉၆ ဂရမ် ဂျီနိုအာ-အိတ်စ် | ဘာဂါမို ၂ ပဲနီ/၁၂၈ ဆင့် | ဘာဂါမို ၂ ပဲနီ/၁၂၈ ဆင့် | |
|---|---|---|---|---|---|
| Cinebench R23 မာလ်တီ | 116744 | 93720 | 103876 | 102125 | |
| Cinebench R23 Single | 1294 | 1301 | 1098 | 1089 | |
| Cinebench MP အချိုး | 90.22 | 72.04 | 94.65 | 93.75 | |
| y-cruncher 1b | 8.882 | 10.296 | 9.568 | 9.184 | |
| y-cruncher 10b | 51.071 | 72.377 | 80.171 | 55.683 | |
| Blender Monster | 1700.647985 | 879.580323 | 1031.49474 | 2038.714424 | |
| Blender အဟောင်းဆိုင် | 1101.839271 | 605.445705 | 704.167826 | 1382.575225 | |
| Blender အတန်းခန်း | 869.476693 | 421.318478 | 506.665693 | 1045.959162 | |
| Geekbench 6 CPU တစ်ခုတည်း | 2048 | 2093 | 1738 | 1723 | |
| Geekbench 6 CPU Multi | 20217 | 21329 | 18683 | 17916 |
AI အတွက် AMD Bergamo
ထိပ်တန်းရောင်းချသူများထံမှ AI inference engine အမျိုးမျိုးကို ထည့်သွင်းထားသော UL Procyon AI Inference Benchmark သည် hardware setup များနှင့် လိုအပ်ချက်အမျိုးမျိုးကို ဖြည့်ဆည်းပေးပါသည်။ benchmark ရမှတ်သည် on-device inferencing စွမ်းဆောင်ရည်၏ အဆင်ပြေပြီး စံသတ်မှတ်ထားသော အနှစ်ချုပ်ကို ပေးစွမ်းသည်။ ၎င်းက ကျွန်ုပ်တို့အား in-house solution များ မလိုအပ်ဘဲ လက်တွေ့ကမ္ဘာအခြေအနေများတွင် hardware setup အမျိုးမျိုးကို နှိုင်းယှဉ်ခွဲခြားနိုင်စေပါသည်။
| processor ကို | ပုံစံ | ပျမ်းမျှ ကောက်ချက်ချချိန် | အလယ်အလတ် ကောက်ချက်ချချိန် | စုစုပေါင်း ကောက်ချက်ချမှု အရေအတွက် |
|---|---|---|---|---|
| ၂ ပဲနီ/၉၆ ဆင့် ဂျီနိုအာ | မိုဘိုင်းကွန်ရက် V3 | 3.61 ms | 3.63 ms | 45,800 |
| ၁ ပဲ/၉၆ ဂရမ် ဂျီနိုအာ-အိတ်စ် | မိုဘိုင်းကွန်ရက် V3 | 2.71 ms | 2.72 ms | 58,631 |
| ဘာဂါမို ၂ ပဲနီ/၁၂၈ ဆင့် | မိုဘိုင်းကွန်ရက် V3 | 3.90 ms | 3.91 ms | 41,538 |
| ဘာဂါမို ၂ ပဲနီ/၁၂၈ ဆင့် | မိုဘိုင်းကွန်ရက် V3 | 4.10 ms | 4.16 ms | 40,008 |
| ၂ ပဲနီ/၉၆ ဆင့် ဂျီနိုအာ | ResNet 50 | 6.36 ms | 6.34 ms | 26,525 |
| ၁ ပဲ/၉၆ ဂရမ် ဂျီနိုအာ-အိတ်စ် | ResNet 50 | 6.66 ms | 6.64 ms | 25,049 |
| ဘာဂါမို ၂ ပဲနီ/၁၂၈ ဆင့် | ResNet 50 | 10.14 ms | 10.08 ms | 16,919 |
| ဘာဂါမို ၂ ပဲနီ/၁၂၈ ဆင့် | ResNet 50 | 8.21 ms | 8.22 ms | 20,842 |
| ၂ ပဲနီ/၉၆ ဆင့် ဂျီနိုအာ | စတင်ခြင်း V4 | 25.98 ms | 25.99 ms | 6,555 |
| ၁ ပဲ/၉၆ ဂရမ် ဂျီနိုအာ-အိတ်စ် | စတင်ခြင်း V4 | 29.19 ms | 29.18 ms | 5,879 |
| ဘာဂါမို ၂ ပဲနီ/၁၂၈ ဆင့် | စတင်ခြင်း V4 | 33.17 ms | 33.04 ms | 5,158 |
| ဘာဂါမို ၂ ပဲနီ/၁၂၈ ဆင့် | စတင်ခြင်း V4 | 30.63 ms | 30.68 ms | 5,573 |
| ၂ ပဲနီ/၉၆ ဆင့် ဂျီနိုအာ | DeepLab V3 | 25.51 ms | 25.33 ms | 5,660 |
| ၁ ပဲ/၉၆ ဂရမ် ဂျီနိုအာ-အိတ်စ် | DeepLab V3 | 28.26 ms | 27.86 ms | 5,394 |
| ဘာဂါမို ၂ ပဲနီ/၁၂၈ ဆင့် | DeepLab V3 | 32.16 ms | 32.09 ms | 4,708 |
| ဘာဂါမို ၂ ပဲနီ/၁၂၈ ဆင့် | DeepLab V3 | 31.16 ms | 30.57 ms | 4,807 |
| ၂ ပဲနီ/၉၆ ဆင့် ဂျီနိုအာ | ယိုလို V3 | 34.10 ms | 34.13 ms | 4,818 |
| ၁ ပဲ/၉၆ ဂရမ် ဂျီနိုအာ-အိတ်စ် | ယိုလို V3 | 43.59 ms | 43.58 ms | 3,831 |
| ဘာဂါမို ၂ ပဲနီ/၁၂၈ ဆင့် | ယိုလို V3 | 44.50 ms | 44.39 ms | 3,739 |
| ဘာဂါမို ၂ ပဲနီ/၁၂၈ ဆင့် | ယိုလို V3 | 41.35 ms | 41.38 ms | 4,001 |
| ၂ ပဲနီ/၉၆ ဆင့် ဂျီနိုအာ | Real-ESRGAN | 2540.04 ms | 2524.03 ms | 71 |
| ၁ ပဲ/၉၆ ဂရမ် ဂျီနိုအာ-အိတ်စ် | Real-ESRGAN | 3725.07 ms | 3720.35 ms | 49 |
| ဘာဂါမို ၂ ပဲနီ/၁၂၈ ဆင့် | Real-ESRGAN | 2734.77 ms | 2717.41 ms | 66 |
| ဘာဂါမို ၂ ပဲနီ/၁၂၈ ဆင့် | Real-ESRGAN | 2291.66 ms | 2301.35 ms | 79 |
နောက်ဆုံးထင်မြင်ချက်များ
128-core AMD Bergamo CPU အသစ်ဖြင့် ကျွန်ုပ်တို့၏ စမ်းသပ်မှုများသည် core အရေအတွက် မြင့်တက်လာမှု၏ မျှော်လင့်ထားသည့် အကျိုးကျေးဇူးများကို ထင်ဟပ်စေသည်။ raw စွမ်းဆောင်ရည်နှင့် ပတ်သက်၍ CPU အသစ်သည် data နှင့် compute-intensive tasks များကို အလွယ်တကူ ကိုင်တွယ်နိုင်ခဲ့သည်။ အထူးသဖြင့် 3D rendering နှင့် computation applications များဖြင့် ကျွန်ုပ်တို့၏ စမ်းသပ်မှုများသည် ဤ extra core များ၏ စစ်မှန်သော စွမ်းရည်ကို ပြသခဲ့သည်။

SMT ကိုဖွင့်ထားခြင်းနှင့် မဖွင့်ထားခြင်းတို့တွင် 96-core Genoa ထက် ပရိုဆက်ဆာအမြန်နှုန်းများ သိသိသာသာတိုးတက်လာသည်ကို ကျွန်ုပ်တို့သတိပြုမိခဲ့ပြီး AMD ၏ chiplet ဒီဇိုင်း၏ ထိရောက်မှုကို မီးမောင်းထိုးပြခဲ့သည်။ အဆင့်မြင့် ultra-high core count computing ခေတ်သို့ ကျွန်ုပ်တို့ ပိုမိုနက်ရှိုင်းစွာ လေ့လာကြည့်ရှုလာသည်နှင့်အမျှ ဤ 128-core၊ 256-thread monster သည် rack density တွင် စံနှုန်းသစ်တစ်ခုကို သတ်မှတ်ပေးခဲ့သည်။


 အမေဇုံ